遗传学:定律、染色体与分子机制
编者导语
本板块把遗传学的前半程合成一条线:先确立「性状」与「遗传」的概念,再解释这些 规律靠什么物理装置实现——染色体在减数分裂中如何把等位基因分到两个配子, 由此推出自由组合定律与连锁交换定律。合并的理由不是章节相邻,而是论证本来连续: 现象在前,机制在后,拆开讲会让读者以为它们是两个学科。 板块含大量遗传学原书插图(杂色穗长的实验模型、果蝇唾腺染色体、玉米双交种的 制种流程等),这些图不是装饰——它们是原书论证的证据,章首的「本板块导读」 已列出前 8 张的图注与所在位置。需要预备知识:没有。后续与统计检验的衔接见 ch07,与基因组的衔接见 ch13。
警告
本章有 25 处原书公式或表格在 MinerU 转换中损坏,已降级为代码块保留残片。这些残片不可直接引用
(其中的系数、矩阵与表达式请回查原书对应页码)。
编者注·本板块导读
图 96 张 案例 12 处 行间公式 20 个。以下清单由正文自动扫出,均为原书内容,未新增。
图(前 8 张;其余见本板块正文)
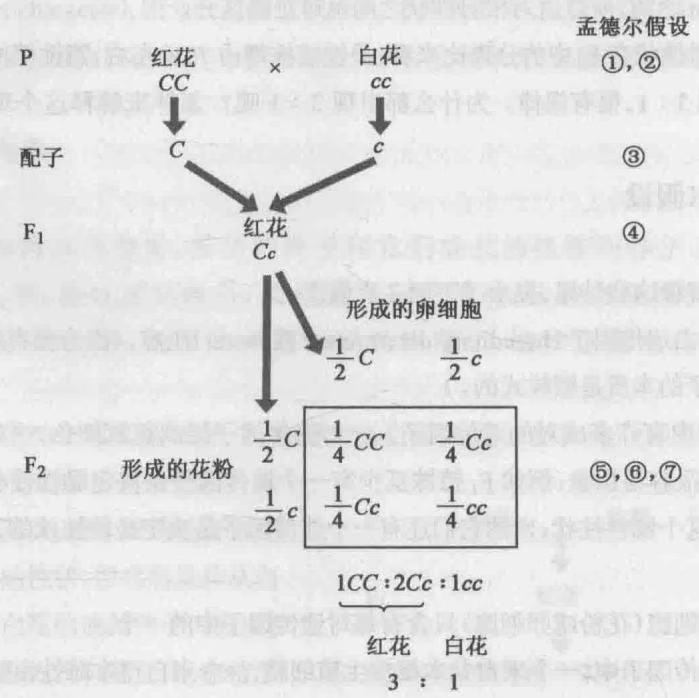
- 图 2-2 豌豆花冠颜色的分离和孟德尔的假设(7 点假设见前文说明) —— ch01
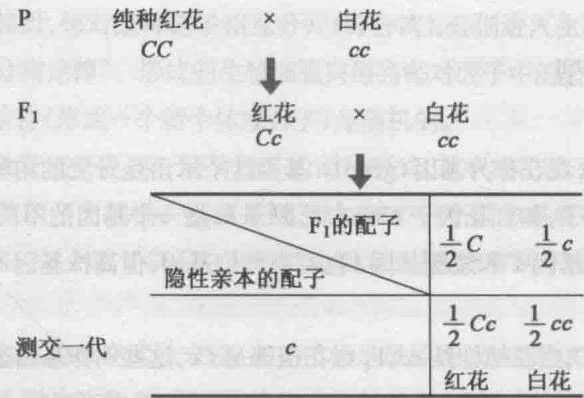
- 图2-3 豌豆花冠颜色的测交试验 —— ch01
- 图 2-4 豌豆花冠颜色的杂交实验中 $F_{3}$ 的分离 —— ch01
- 图 2-5 水稻非糯性和糯性的遗传 —— ch01
- 图 2-6 豌豆两对性状的杂交实验 —— ch01
- 图2-11 用分支法推算孟德尔两对基因杂种产生的基因型和表型 —— ch01
- 图2-12 用分支法推算3对基因杂交产生的基因型和表型 —— ch01
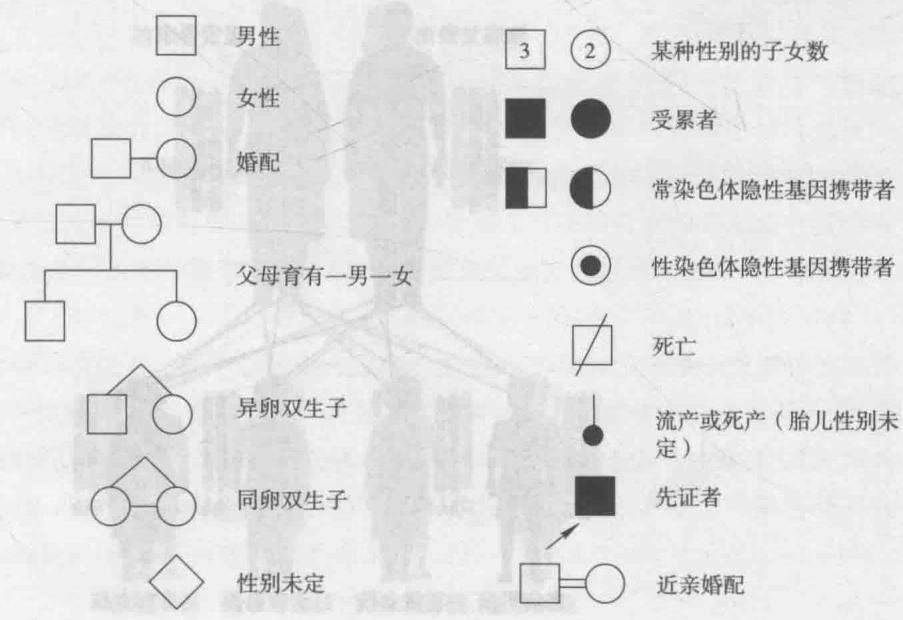
- 图2-14 系谱分析常用符号 —— ch01
- ……其余 88 张见本板块正文
案例(前 6 处)
- 视频2遗传学研究的代表性案例 —— ch01
- 表 2-8 回交后代中,个体数不同时,完全符合理论比例 1:1 的出现概率 —— ch01
- 在线自测 习题答案 —— ch01
- 习题 —— ch01
- 在线自测 习题答案 —— ch01
- 在线自测 习题答案 —— ch01
- ……其余 6 处见本板块正文
公式:本板块含 20 个行间公式,均为原书公式,未改写。若你看到代码块形式的残片,说明该处公式在 OCR 中损坏、已降级,请回查原书对应页码。
本板块由以下原始章节合并而成:ch01、ch02。
第一章 绪论
第一节 遗传学发展历史
视频1
至今未解的生命奥秘
遗传学是一门诞生古老却又发展持续迅猛的生物学分支学科。早在中国1000年前的宋代,就有了“种瓜得瓜,种豆得豆”、“一母生九子,九子各不同”的遗传与变异的初步概念。与所有的学科一样,遗传学也是在人们的生产实践活动中发展起来的。最初的遗传学开始于人们对经济作物的改良和培育。中国是世界上最早的作物和家畜的起源中心之一,在新石器时代的遗址中就发现了粟、小麦和高粱的种子以及家畜猪、羊、狗等的骨骼化石,说明在5000年至1万年前,人类在猎取和采集动物和植物食物时,在初步满足了一时的需求后,对剩余的动、植物开始了驯化和培育活动,于是出现了早期的农作物品种和家养牲畜,并将原始的栽培、驯化逐渐转化为特意的引种、筛选、优化等显现遗传特质的活动。远古时代之后,在人类文明史进程中,人们不断选育出更丰富的经济作物品种、更美丽的花卉类型、更符合需求的牲畜种类,这些人类经济发展和科学进步的必然趋势,有意或无意地催生了遗传学的诞生。例如,玉米、番薯、水稻等作物的产生,牡丹、郁金香等花卉的选育,各类品种的金鱼等观赏动物的出现,都是人类推动遗传学发生的有意义活动。但是这些较为粗浅的遗传学认识尚未形成系统独立的遗传学理论。直到300多年前,人类才开始有意识地对遗传的奥秘进行探索。
一、遗传学代表性研究成果
遗传学科的知识萌芽应该追溯到19世纪初,此后,遗传学知识逐渐发展成为一门独立、系统的生物学分支学科。我们在此列举一些遗传学知识发展过程中的代表性研究工作与成果供读者们了解一二。
1809年,法国学者拉马克(Jean-Baptiste Lamarck,1744—1829)提出获得性状遗传学说。
1822 年,英国植物学家奈特(Thomas Andrew Knight, 1759—1838)开展豌豆杂交试验。
1859年,英国博物学家达尔文(Charles Darwin, 1809—1882)出版《物种起源》,提出了自然选择的生物进化学说,但他没能够说明生物进化的机制。
1866年,奥地利生物学家孟德尔(Gregor Johann Mendel, 1822—1884)发表了《植物杂交实验的遗传学定律》论文,但是他的论文迟至34年后的1900年才被重新发现,遗传学同这个“重新发现”一起诞生。
1869年,瑞士生物学家米歇尔(Johannes Friedrich Miescher,1844—1895)从白细胞的细胞核分离出核酸。
1882 年,德国胚胎学家弗莱明(Walther Flemming,1843—1905)记录了染色体在有丝分裂中的行为,奠定了细胞遗传学的研究基础。
1903年,美国生物学家萨顿(Walter Stanborough Sutton,1877—1916)和德国生物学家博韦里(Theodor Heinrich Boveri,1862—1915)发现孟德尔关于遗传因子的描述与减数分裂中的染色体行为相符,提出了Boveri-Sutton染色体理论。
1905 年,英国医生加洛德(Archibald Edward Garrod, 1857—1936)发现了尿黑酸症,开创了人类医学遗传研究。
1906 年,英国遗传学家贝特森(William Bateson, 1861—1926)积极推广孟德尔理论,并首次将研究生物性状遗传和变异的新学科定名为遗传学(genetics)。
1908年,德国物理学家温伯格(Wilhelm Weinberg, 1862—1937)和英国数学家哈代(Godfrey Hardy, 1877—1947)分别发现了遗传平衡定律(后被定义为哈代-温伯格定律),奠定了群体遗传学研究的重要基础。
1909 年,丹麦植物学家约翰森 (Wilhelm Ludvig Johannsen, 1857—1927) 提出基因 (gene) 一词,用于描述孟德尔所说的遗传因子。
1910 年,美国遗传学家摩尔根(Thomas Hunt Morgan, 1866—1945)利用果蝇为实验材料,揭示基因在染色体上呈直线排列。
1928 年,英国生物学家格里菲斯(Frederick Griffith,1879—1941)通过肺炎双球菌实验发现了在细菌之间转移的遗传物质。
1941年,美国遗传学家比德尔(George Wells Beadle,1903—1989)和塔特姆(Edward Lawrie Tatum,1909—1975)利用粗糙链孢霉的生化突变型提出了“一个基因一个酶”(one gene-one enzyme)假说。
1944年,美国细菌学家艾弗里(Oswald Theodore Avery, 1877—1955)通过肺炎链球菌实验证明遗传物质是DNA。
1950 年,奥地利生物化学家查加夫(Erwin Chargaff, 1905—2002)发现尽管不同物种的 DNA 的碱基组成不同,但每种 DNA 中腺嘌呤和胸腺嘧啶的数目相等,鸟嘌呤和胞嘧啶的数目也相等。
1950 年,美国细胞遗传学家麦克林托克(Barbara McClintock, 1902—1992)首次报道了玉米籽粒色斑不稳定遗传,发现了基因在染色体上可移动的性质。
1953年,美国分子生物学家沃森(James Dewey Watson, 1928—)和英国分子生物学家克里克(Francis Harry Compton Crick, 1916—2004)发现了DNA双螺旋结构。
1956 年, 美籍华裔科学家蒋有兴 (Joe Hin Tjio, 1919—2001) 和瑞典细胞学家莱万 (Albert Johan Levan, 1905—1998) 发现了人类共有 23 对染色体。
1961 年,法国生物学家雅各布(François Jacob, 1920—2013)和莫诺(Jacques Monod, 1910—1976)利用大肠杆菌提出了操纵子模型,揭示了基因表达受到环境因素的调控。
1966 年,美国生物化学家尼伦伯格(Marshall Warren Nirenberg, 1927—2010)等揭示了遗传密码。
1974 年,美籍华裔医学家简悦威(Yuet Wai Kan,1936—)成功将 DNA 分析技术应用于 $\alpha$ -地中海贫血患者的遗传测试,并进一步将此技术应用于多种孟德尔疾病的产前诊断。
1976年,日本生物学家利根川进(Susumu Tonegawa, 1939—)揭示了在B细胞成熟过程中免疫球蛋白基因通过基因重排实现基因表达调控。
1977年,英国生物化学家桑格(Frederick Sanger, 1918—2013)和美国生物学家吉尔伯特(Walter Gilbert, 1932—)等建立了DNA测序技术。
1977年,美国遗传学家夏普(Phillip Allen Sharp,1944—)和英国分子生物学家罗伯茨(Richard John Roberts,1943—)观察到了腺病毒基因的断裂现象,揭示了真核基因的编码序列被内含子间隔开的重要特点。
1980年,美国发育生物学家威绍斯(Eric Wieschaus,1947—)和德国生物学家福尔哈德(Christiane Nüsslein-Volhard,1942—)利用正向遗传学策略成功筛选到控制果蝇早期胚胎发育的关键基因。
1985 年,美国生物化学家穆里斯(Kary Banks Mullis, 1944—2019)等创建 PCR 技术,成功实现体外 DNA 的快速扩增。
1989年,美国微生物学家毕晓普(John Michael Bishop,1936—)和美国科学家瓦尔默斯(Harold Eliot Varmus,1939—)发现,包括人在内的许多生物的正常体细胞里都含有未被激活的癌基因。
1990 年, 人类基因组计划 (Human Genome Project, HGP) 正式启动, 来自美国、英国、法国、德国、日本和中国的六国科学家参与其中。
1997 年,英国罗斯林研究所(Roslin Institute)培育出转基因克隆羊“多莉”。
1998年,美国生物学家法尔(Andrew Zachary Fire, 1959—)和梅洛(Craig Cameron Mello, 1960—)等揭示了RNA干扰现象。
2001 年, 国际人类基因组计划合作组织 (Human Genome Organization, HUGO) 和美国塞莱拉公司 (Celera Corporation) 分别在《自然》和《科学》杂志上同时公布了人类基因组草图图谱及其初步分析结果。
2002 年, 国际单倍型协作组 (International HapMap Consortium) 正式启动了以寻找标记单核苷酸多态的遗传变异的单倍型图谱计划 (Haplotype Map Project)。
2003 年,美国国家人类基因组研究所(National Human Genome Research Institute, NHGRI)启动了名为“DNA 元件的百科全书”(Encyclopedia of DNA Elements, ENCODE)研究计划,旨在对全基因组进行有计划的注释,编写人类基因组的“元件目录”。
2003 年, 人类表观基因组协作组 (Human Epigenome Consortium) 宣布实施人类表观基因组计划 (Human Epigenome Project), 目标是确认、分类和解释人类主要组织中所有基因在基因组水平的 DNA 甲基化模式, 包括在基因组水平绘制不同组织类型和疾病状态下的 DNA 甲基化可变位点图谱。
2004 年,人类基因组精图绘制完成,国际人类基因组计划合作组织在《自然》杂志上发表人类基因组的近完成序列(near-finished sequence)及其分析结果。
2005 年, 罗氏(Roche)公司开发的 454 测序系统开始商业化运行, 代表了第二代测序技术的普及。
2005 年,美国眼科专家爱德华兹(Albert O. Edwards)团队利用全基因组关联分析(genomewide association study, GWAS)完成了年龄相关性黄斑变性的易感因素筛选,是关联分析方法在遗传疾病易感因素分析中的第一项标志性成果。
2006 年, 日本学者山中伸弥(Shinya Yamanaka, 1962—)将 4 种不同的转录因子编码基因导入小鼠的成纤维细胞中, 首次成功地将已分化的体细胞重编程为诱导多能干细胞(induced pluripotent stem cells, iPS cells)。
2006 年,美国国家癌症研究所(National Cancer Institute, NCI)和 NHGRI 联合启动癌症基因组图谱(The Cancer Genome Atlas, TCGA)计划,项目旨在将基因组测序、转录组测序、甲基化等表观组学测序数据加以整合,并结合临床影像数据等,绘制多维度、多癌种的基因组图谱。
2007年,中国香港中文大学病理学家卢煜明(Dennis Yuk-ming Lo,1963—)利用孕妇外周血成功进行21三体的无创产前筛查(non-invasive prenatal testing,NIPT)。
2007年,来自中国深圳华大基因研究院、生物信息系统国家工程研究中心及中国科学院北京基因组研究所的科学家通过协作,完成首个中国汉族男性的全基因组测序。
2008 年,由英国 Sanger 研究所、中国深圳华大基因研究院、美国国立卫生研究院下属的美国人类基因组研究所发起了千人基因组计划(1000 Genome Project),测定来自全球 27 个族群的 2500 人的全部基因组信息,目标是建成开放公共的人类基因组参照数据库。
2010 年,美国克雷格文特尔研究所(John Craig Venter Institute, JCVI)宣布世界首例人造生命 Snythia 诞生。Synthia 只含有人工合成的基因组序列,能够自我复制,是一个有生命的人造生物体。
2012 年, 第一套单分子测序系统问世, 代表仪器是纳米孔测序系统 MinION, 其基本原理是让单链 DNA 上的碱基顺次穿过纳米孔, 通过分析不同碱基组合穿过时的电流变化进行碱基序列分析。MinION 也是第三代测序技术的典型代表。
2012年,德国亥姆霍兹传染研究中心的法籍生物化学家卡彭蒂耶(Emmanulle Charpentier, 1968—)和美国加州大学伯克利分校生物化学家杜德娜(Jennifer Doudna, 1964—)成功开发了“成簇规律间隔短回文重复序列(clustered regularly interspaced short palindromic repeats, CRISPR)和CRISPR相关蛋白9(CRISPR-associated protein 9, Cas9)”系统,即CRISPR/Cas9系统,并应用于真核细胞的基因编辑。
2013年,美国麻省理工学院华裔生物学家张锋(Feng Zhang,1981—)首次将CRIPSR/Cas9基因编辑技术应用于哺乳动物和人类细胞,这项标志性的工作迅速带动了全球科学家将该技术应用在各种物种的基因编辑中,并在疾病治疗、疾病检测和遗传育种等多个领域发挥巨大作用。
2016 年,美国加州大学洛杉矶分校的波格丹(Pasaniuc Bogdan)等人建立了一种与 GWAS 相似的全转录组关联分析(transcriptome-wide association study, TWAS)方法,旨在利用转录组范围的关联研究确定重要的基因表达与性状的关联关系。
2017年,美国食品与药品监督管理局(Food and Drug Administration,FDA)先后通过了抗PD-1(programmed cell death 1)抗体Keytruda用于治疗携带微卫星不稳定(microsatellite instability-high,MSI-H)或错配修复缺陷(mismatch repair deficient,dMMR)的不可切除或转移性的多种癌症,以及嵌合抗原受体T细胞免疫疗法(chimeric antigen receptor T-cell immunotherapy,CAR-T),即Kymriah用于治疗复发或难治性儿童和年轻成人B细胞急性淋巴细胞白血病。两种免疫治疗策略成功走向临床癌症治疗。
2018年,中国科学院神经科学研究所孙强(1973—)团队成功利用体细胞核移植技术克隆出
两只猕猴,首次实现非人灵长类动物的体细胞克隆。
二、遗传学具有里程碑式的发现
我们可以将遗传学知识的发展大致分为4个阶段:达尔文时期、孟德尔时期、分子遗传时期和基因组时期。达尔文时期对生物进化方式的解读蕴藏了遗传变异思想的萌芽,而孟德尔的遗传理论提出了遗传变异的实体是遗传因子的假设,催生了遗传学科的诞生。到了分子遗传时期,随着对基因概念抽丝剥茧般的注释,遗传学知识体系逐渐发展为以基因结构(基因型)与基因功能(表型)为主线,从DNA突变、DNA重组、DNA表达、DNA互作、DNA调控等多个层次揭示DNA遗传变异的规律。随着2000年人类基因组计划宣告完成,遗传学进入了基因组学时代,研究对象从单个基因发展到整个基因组,新的研究技术与手段层出不穷,深入揭示遗传变异与生命演化的机制。
(1) 达尔文的自然选择学说 人类很早就对生命的起源和生物的进化产生了浓厚的兴趣。早在 19 世纪初, 拉马克就提出了“用进废退”的“获得性状遗传”进化学说, 认为生物的性状会主动适应环境, 并按照环境的适应方向进化。19 世纪中叶, 达尔文根据对野生和家养动植物的研究, 总结出“自然选择, 生存斗争”的进化学说。拉马克的进化学说由于将生物的进化机制主要归于生物适应环境的改变而进化, 在分子遗传学发展以后, 逐渐被学者抛弃。不过, 也有一些学者在表观遗传学发展以后, 重新审视了拉马克的进化思想。达尔文的进化理论具有合理的内涵, 但是这个学说虽然也能解释生物进化的现象, 但是鉴于学科发展的局限, 达尔文没有能够解释发生生物变异的根本原因和生物生存的基本机制。20 世纪 60 年代, 日本学者木村资生 (Motoo Kimura, 1924—1994) 对达尔文的学说进行补充, 提出了生物进化的“中性学说”。该学说认为, 生物变异并不能完全归于有害或有利, 很多时候, 生物出现的性状变异是无利也无害的变化, 例如人的 ABO 血型系统。生物存在着很多这类没有利害关系的性状变异。“中性学说”符合基因组的结构组织特点和基因多样性的现实。
进化不仅仅是新物种的形成,进化也不一定就意味着生物由简单到复杂、由低等到高等的进程。生物某些性状或器官的退化其实也是生物的进化。所以,归根结底,进化就是生物性状可遗传的改变。同时,生物进化是以最简约的方式进行的,并且是随机的、没有方向的,构成生物界万千丰富的生物多样性类型几乎都是偶然发生的,生物生存的环境只是一个诱导突变发生和选择压力的作用。从生物发展史观去理解,生物发生是偶然的,生物物种形成是偶然的,而生物灭绝却是必然的。
(2) 孟德尔的遗传理论 孟德尔根据前人的工作和他自己进行8年的豌豆杂交试验,并应用统计方法分析实验数据,提出了遗传因子分离和重组的假设。但是孟德尔的工作在当时并未引起重视,直到1900年,德弗里斯(Hugo Marie de Vries, 1948—1935)、科伦斯(Carl Erich Correns, 1864—1933)和切尔马克(Erich Tschermak, 1871—1962)三位植物学家经过大量的植物杂交试验,在不同的地点、不同的植物上,得出与孟德尔相同的遗传规律,并重新发现了孟德尔的重要论文。孟德尔遗传规律的重新发现标志着遗传学的诞生,从此,遗传学作为一门独立的分支科学,开始了飞速发展。
孟德尔的伟大发现并不是突然产生的,也是在前人的研究基础上逐渐发展而来的。早在
1822年,德国学者奈特就在豌豆杂交试验中取得了令人瞩目的结果,他对豌豆的红花和白花性状的遗传学杂交试验,首先得到了近似3:1的分离比结果。并且,在这个时期遗传因子的概念已经提出,但是关于什么是遗传因子,遗传因子是颗粒状还是体液状,存在于生物的哪个部位,如何传递给后代等问题,一直在激烈地争论着。奈特的实验结果无法突破当时的科学局限。孟德尔的伟大发现在于他善于总结前人的工作经验和教训,并利用开始出现的生物统计学方法将实验数据近似的3:1分离归结于理论的分离比。同时根据遗传因子存在于生殖系统传递给后代已经是被科学家普遍接受的理论,提出了遗传因子传递规律的新的假设。孟德尔的成就在于科学思想的创新。但是我们也清晰地感觉到,他的伟大在于他对科学历史积淀的尊重和发展。所以我们说,科学的创新是在原有基础上的衍生和发展的思维,任何一项创新很难是凌空出现的,没有前人的探索,没有科学原有的基础,就没有真实意义的科学创新,知识的传承是创新思维的必要基础。
(3) 分子遗传和基因组学对遗传学的推动作用 在孟德尔遗传思想诞生之后,遗传因子的本质是什么,遗传因子如何变异、传递等问题就成为了遗传学研究领域的关键问题。1903年,美国生物学家萨顿和德国生物学家博韦里首先发现了染色体的行为与遗传因子的行为很相似,提出了染色体是遗传物质的载体的假设。1909年,丹麦遗传学家约翰逊将遗传因子命名为基因。1910年,摩尔根和他的学生斯特蒂文特(Alfred Henry Sturtevant, 1891—1970)、布里奇斯(Calvin Blackman Bridges, 1889—1938)和马勒(Hermann Joseph Muller, 1890—1967)用果蝇做材料,研究性状的遗传方式,得出连锁交换定律,确定基因直线排列在染色体上。与此同时,埃默森(Rollins Adams Emerson, 1873—1947)等在玉米工作中也得到同样的结论。这样,就形成了一套经典的遗传学理论体系——以遗传的染色体学说为核心的基因论。随后,美国微生物学家比德尔和塔特姆通过对粗糙链孢霉的生化突变型的研究,于1941年提出“一个基因一个酶”学说,把基因与蛋白质的功能结合起来,这又把遗传学的发展向前推进了一步。
1944年,艾弗里、麦克劳德(Colin Munro MacLeod, 1909—1972)和麦卡蒂(Maclyn McCarty, 1911—2005)等从肺炎链球菌的转化实验中发现,转化因子是DNA,而不是蛋白质。1952年,赫尔希(Alfred Day Hershey, 1908—1997)和蔡斯(Martha Cowles Chase, 1927—2003)证明,噬菌体感染大肠杆菌时,DNA进入细菌细胞,而大多数蛋白质留在外面。这些实验证明,DNA是遗传物质。特别是1953年沃森和克里克提出了DNA双螺旋结构模型,用来阐明有关基因的核心问题——遗传物质的自体复制,从而开创了分子遗传学这一新的科学领域。
到了20世纪60年代,蛋白质和核酸的人工合成、中心法则的提出、三联体密码的确定、传递细菌对抗生素抗性的质粒的发现,以及调节基因作用原理的揭示等,已使遗传学的发展走在生物科学的前面。进入20世纪70年代后,由于众多限制性内切酶、核酸连接酶的发现和提纯,研究者实现了体外DNA重组,并可将构建的重组DNA导入大肠杆菌使之表达,自此产生了划时代的基因工程技术。以后用DNA重组技术生产出第一个动物激素——生长激素抑制因子。到了20世纪80年代,用基因工程生产的人胰岛素进入市场;外源基因导入烟草细胞,在再生植株中表达,并能通过有性繁殖遗传下去,从而使人类在定向改造生物方面跨进到一个新阶段。2000年,HUGO宣告人类基因组工作框架图(working draft)提前完成,这项工作在全球掀起了基因组学研究的浪潮,遗传学研究也正式进入了基因组学时代。除了人类基因组DNA序列,大量模式生物基因组DNA序列,人源细胞和/或组织以及其他模式生物的转录组、蛋白质组、表观基因组等信息呈现井喷之势,为生命科学研究开拓了更为广阔和深入的领域,启发了更为深刻和重要的哲学思考。
第二节 遗传与变异
生物通过各种生殖方式繁衍种族。单细胞生物一般通过细胞分裂来繁殖自己,多细胞生物则有无性生殖和有性生殖两种。无论哪种生殖方式,都是保证了生命在世代间的连续,并使子代跟亲代相似。这种世代间相似的现象就是“遗传”(heredity)。遗传是遗传信息世代传递的现象,同一物种只能繁育出同种的生物,同一家族的生物在性状上有类同现象。
有性生殖从精卵结合形成受精卵开始。有一定遗传结构的受精卵从细胞外部吸收物质,在细胞内发生一系列的代谢变化,结果导致细胞的生长、分化和增殖。这些变化在时间上和空间上有相当严密的秩序,从而保证了受精卵沿着一定的途径发育成一定的个体,具有一定的结构和功能,并与外界环境保持一定的关系。生物的这种结构和功能互有差异,这取决于它们的遗传结构的不同和随之而来的代谢过程的差别。生物个体间的差异叫作“变异”(variation)。
无论哪种生物,动物还是植物,高等还是低等,复杂的像人类本身或是简单的像细菌和病毒,都表现出子代与亲代之间的相似或类同。同时,子代与亲代之间、子代个体之间总能察觉出不同程度的差异,这种遗传与变异现象在生物界普遍存在,是生命活动的基本特征之一。遗传与变异是生物生存与进化的基本因素。遗传维持了生命的延续,没有遗传就没有生命的存在,没有遗传就没有相对稳定的物种。变异使得生物物种推陈出新,层出不穷。没有变异就没有物种的形成,没有变异就没有物种的进化。遗传与变异相辅相成,共同作用,使得生物生生不息,造就了形形色色的生物界。
遗传学是研究生物的遗传与变异的科学。如果从基因水平上理解,遗传学就是研究生物的遗传结构、信息传递、基因频率以及基因表达调控的科学。同时,现代遗传学研究已经不再局限于遗传信息的世代之间的传递,同一物种之间,不同物种之间,甚至在动、植物之间,通过人工方法也能够进行遗传信息横向转移,从而开展了遗传信息的传递、表达和对生物产生影响的研究。
视频2遗传学研究的代表性案例
根据不同的分类标准,遗传学可以分成很多分支科学。从遗传学的研究内容划分,有进化遗传学、医学遗传学、免疫遗传学、肿瘤遗传学等;从遗传学的研究层次划分,有群体遗传学、细胞遗传学、分子遗传学等;从遗传学的研究对象划分,有植物遗传学、动物遗传学等。
第三节 遗传学研究与社会发展的紧密关系
遗传学近年来的研究在很多方面已经突破了原有的经典遗传学研究范畴,研究的方法也层出不穷,开辟了现代遗传学的新领域。传统的遗传学是以基因为主线的研究,基因结构改变与否发挥性状变异的决定性作用。但是近年来表观遗传学(epigenetics)的崛起,颠覆了传统遗传学的理论。表观遗传指的是在未发生基因组DNA序列改变的情况下,基因功能也可发生可遗传的改变。DNA甲基化、RNA干扰、组蛋白修饰等都属于表观遗传学的范畴。研究发现,表观遗传是广泛存在于多种生物体中的遗传机制,个体发育、疾病发生、植物性状等的多态性均与表观遗传调控有关,因此表观遗传学已经成为当今遗传学领域中的一个研究热点。
对于遗传信息的结构与功能的研究,通常采用正向遗传学(forward genetics)或反向遗传学(reverse genetics)策略。从表型变异到基因型变异的研究是正向遗传学策略。例如对镰状细胞贫血的研究,可以首先分离得到病变蛋白,并根据肽链的氨基酸序列推测出DNA序列,然后从cDNA文库中筛选得到相应的编码基因,完成染色体定位,并最终得到致病基因序列。反向遗传学是从基因型变异到表型变异的研究方法。例如对亨廷顿舞蹈症的研究,就是首先利用遗传标记进行连锁分析再定位候选目的基因,然后才研究突变基因与表型之间的功能联系。
研究遗传和变异的规律,是为了能动地改造生物,更好地为人类服务。遗传学的基本理论及其最新研究成果必将对农牧业、医学、工业等的发展起着积极的推动作用。在农牧业上,遗传学理论是指导生产实践的主要理论基础之一。提高农畜产品的产量,增进农畜产品的品质,最直接而主要的手段就是育种。应用各种遗传学方法,改造它们的遗传结构,以育成高产优质的品种。人们还试图应用 DNA 重组技术,结合原生质体和细胞培养方法,创造新品种。例如合成具有高赖氨酸含量的玉米,创造能够固氮的粮食作物等。
进入20世纪末,遗传学和医学的联系也密切起来了。目前机制已知的遗传性疾病有6000余种,要了解这些遗传病,为优生而进行产前诊断,进而达到治疗的目的,缺少遗传学的基本理论、特别是分子遗传学的最新成就,那是无法想象的。近年来,CRISPR/Cas9基因编辑技术也在一些孟德尔遗传病的临床实验中取得了非常好的效果。肿瘤是严重危害人类生命的疾病之一,一般认为在细胞的恶性转化过程中,必要的前提是遗传物质的损伤和基因结构的改变,所以从遗传学角度研究所谓癌基因,即研究具有引起细胞恶性转化能力的DNA区段,可望深化对肿瘤的认识,为其防治提供可能性。不论是肿瘤标记物的筛选,还是靶向治疗和免疫治疗方案的开发都与遗传学息息相关。同样,遗传学与药学,尤其是与抗生素的生产,以及与免疫学、环境保护等都有密切的关系,遗传学的发展必将带动这些学科共同前进。
由于孟德尔 140 年前的创造性研究工作,自然科学史上诞生了遗传学学科,但是一直到 20 世纪后期,遗传学依然只是生物学界关注和熟悉的研究领域。但是,进入 20 世纪末,多种生物的基因组测序,物理、化学、数学和计算机科学等学科与遗传学的渗透和交叉,推动了遗传学日新月异的飞速发展,这是让遗传学家也始料不及的事实。另一方面,克隆羊“多莉”的诞生引发了“克隆人”的争论,人类基因组的测序完成引发了遗传信息安全性的争论,转基因生物的推广引发了转基因食物安全性的争论,表观遗传学的发展引发了对传统基因学说的挑战,基因编辑技术的推广引发了能否运用到人类胚胎的全社会思考……诸如此类的很多遗传学问题的不断涌现,使得遗传学领域中的许多专业名词经常成为各种媒体和社会大众关注的话题。社会的进步使得人类更关注人类本身生存的空间和环境,生物资源的保护和利用,以及人类自身的疾病、健康与寿命等问题,并随之推动了社会的发展,未来给遗传学发展提供了更令人鼓舞的挑战和机遇。
第二章 孟德尔定律
孟德尔是奥地利布隆(Brūnn)(现在是捷克的布尔诺Brno)的神甫,他利用部分时间进行生物学实验。他看到当时杂交育种方法已在园艺方面广泛应用,且有相当成就,但还未能总结出一种“杂种形成与发展的普遍适用的规律”,于是,他想提供一些精密可靠的实验基础,以便找到这些规律。
在孟德尔之前,英国植物学家奈特、德国植物学家克尔罗伊特(Joseph Gottlieb Kölreuter, 1733—1806)和格特纳(Karl Friedrich von Gärtner, 1772—1850)等人也做过植物杂交试验,但孟德尔指出,他们的试验都有缺点:①没有对杂种子代中不同类型的植株进行计数;②在杂种后代中没有明确地把各代分别统计,观察每一代中不同类型的植株数;③也没有明确肯定每一代中不同类型植株数之间的统计关系。他认为真正要解决杂交中的遗传问题,必须克服前人的这些缺点,他在1858—1865年间进行了大量的试验工作,以豌豆为主要材料,辅以菜豆、石竹等材料,发现了前人未认识到的规律,这些规律后来被称为孟德尔定律(Mendel’s laws)。
他选豌豆(Pisum sativum)为主要材料,有几个理由:
(1)豌豆具有稳定的可以区分的性状。豌豆各品种间有着明显的形态差异,如有些品种的植株开红花,有些开白花;有些结黄色种子,有些结绿色种子;有些是顶生花序,有些是腋生。这些品种在这些性状上的差异都很稳定,都能真实遗传(breeding true)。就是说,亲本怎样,它们的全部子代植株也都是这样。更重要的是,这些性状在区分时毫无困难,研究者能简单直接地进行分析。
(2) 豌豆是自花授粉植物,而且是闭花授粉,因此没有外来花粉混杂,若人工去雄,用外来花粉授粉也容易。孟德尔对花粉混杂问题特别注意。他指出,如果忽略了这个问题,有外来花粉混杂,而试验者却不知道,那就会得出错误的结论。
(3) 豌豆豆荚成熟后籽粒都留在豆荚中,便于各种类型籽粒的准确计数,这在以籽粒为研究对象时自然是很重要的。
孟德尔将其多年研究结果整理成文,于1865年在布隆博物学会上以《植物杂交试验》为题,分两次报告,第二年(1866年)在学会会刊上发表,并将论文的单行本分送各地,可是没有引起学术界的重视。在孟德尔的论文沉睡了34年之后的1900年,荷兰的德弗里斯用月见草等为材料,德国的科伦斯用玉米和豌豆为材料,奥地利的切尔马克用豌豆为材料进行实验,发表了结论与孟德尔相同的论文,并且都引用了孟德尔的工作。这就是孟德尔定律的再发现,遗传学就是同这个“再发现”一起诞生的。
孟德尔定律通常分为分离定律和自由组合定律。
第一节 分离定律
孟德尔的整个试验工作中贯彻了从简单到复杂的原则。他最初进行杂交时,所用的两个亲本(即父本和母本)都只相差一个性状。或者更精确些说,不论其他性状的差异怎样,他都只把注意力集中在一个清楚的性状差异,或者说一对相对性状上。因为任意选取两个植株,它们一般总会在好几个性状上有差异,有些差异也许一时还未能察觉。是不是可以把其他性状差异暂时不管,只研究一对性状,把一对性状的遗传规律搞清楚后再进一步同时考虑几对性状呢?事实证明,这种方法不但可行,而且还是最合理、最有效的研究方法。
一、显性和隐性
豌豆品种中,有开红花的和开白花的。开红花的植株自花授粉,后代都是开红花的;开白花的植株自花授粉,后代都是开白花的。
如把开红花的植株与开白花的植株杂交,那么这两个植株就叫作亲代(parent generation),记作P。实验时在开花植株上选一朵或几朵花,在花粉未成熟时,把花瓣仔细掰开,用镊子除去全部雄蕊,再把花瓣按原样复好,在花朵外面套上一个纸袋,以防外来花粉授粉。一天之后,从开另一种颜色的花朵上取下成熟花药,放到去雄花朵的柱头上,授粉后仍旧套好纸袋,并在授过粉的花柄上挂一标签,以资识别。待豆荚开始长大时,才把纸袋去掉。这个豆荚中结的种子就是子一代(first filial generation, $F_{1}$ )。把这种子种下,长成的植株就是 $F_{1}$ 植株。孟德尔发现,不论用红花做母本,白花做父本,还是反过来,以红花为父本,白花为母本,正反交(reciprocal crosses)的 $F_{1}$ 植株全部开红花,没有开白花的,也没有开其他颜色的花。这样,红花对白花来讲,是个显性性状(dominant character),因为红花的性状在 $F_{1}$ 中显示出来;白花对红花来讲,是个隐性性状(recessive character),因为白花在 $F_{1}$ 中没有显示出来。合起来讲,这是一对相对性状。
二、分离现象
$F_{1}$ 的红花植株自花授粉, 所得的种子和它们成长的植株叫作子二代 (second filial generation, $F_{2}$ )。 $F_{2}$ 中, 除红花植株外, 又出现了白花植株, 这种白花植株和亲代的白花植株是一样的。在 $F_{2}$ 中, 隐性的白花性状又出现了, 这种现象叫作分离 (segregation) (图 2-1)。
我们平常使用的一些表达方式:“ $F_{2}$ 中分离出白花类型”(表示 $F_{2}$ 个体间有差异),或“ $F_{1}$ 能分离出白花类型”,讲的都是一回事。从这个事实可以看到: $F_{1}$ 植株虽然表现为红花而非白花亲本的性状,但它们显然从白花亲本处得到了白花的遗传因子,而且这个遗传因子在植株内没有起变化,在植株
P 红花 × 白花
↓
F₁ 红花
↓
F₂ 705 红花:224 白花的整个生活史中始终没有和代表红花的遗传因子相混合,未受红花因子的“沾染”, $F_{2}$ 中的白花跟亲本的白花一样白,完全不带红色。这说明遗传绝不是“混合式”的,由此也得出“颗粒遗传”(particulate inheritance)这一重要概念:代表一对相对性状(如红花对白花)的遗传因子在同一个体内分别存在,不相沾染,不相混合。这个概念与“混合遗传”(blending inheritance)的概念是对立的,以后遗传学的发展愈来愈显示出这个概念的正确性和重要性。
孟德尔在豌豆中除了研究红花和白花这一对相对性状外,还研究了其他6对相对性状,它们的遗传方式和上述实验很相似。在 $F_{1}$ 中可以看到显性现象,在 $F_{2}$ 中出现分离现象。他的实验结果如表2-1所示。
表 2-1 豌豆杂交实验的 ${\mathrm{F}}_{2}$ 结果
| 相对性状 | $F_2$ 植株数 | $F_2$ 中显性植株数 | $F_2$ 中隐性植株数 | |||
| 显性 | 隐性 | 数目 | 比例/% | 数目 | 比例/% | |
| 饱满子叶 | 皱缩子叶 | 7324 | 5474 | 74.74 | 1850 | 25.26 |
| 黄色子叶 | 绿色子叶 | 8023 | 6022 | 75.06 | 2001 | 24.94 |
| 红花 | 白花 | 929 | 705 | 75.89 | 224 | 24.11 |
| 成熟豆荚不分节 | 成熟豆荚分节 | 1181 | 882 | 74.68 | 299 | 25.32 |
| 未熟豆荚绿色 | 未熟豆荚黄色 | 580 | 428 | 73.79 | 152 | 26.21 |
| 花腋生 | 花顶生 | 858 | 651 | 75.87 | 207 | 24.13 |
| 高植株 | 矮植株 | 1064 | 787 | 73.97 | 277 | 26.03 |
| 总和 | 19959 | 14949 | 74.90 | 5010 | 25.10 | |
在这 7 对相对性状中, 每一对相对性状之间都可相互区分。以植株高矮这对相对性状来说, 一般植物从高到矮往往是连续的, 难以截然区分; 但孟德尔所用的高植株在 2 m 左右, 而矮植株则仅在 25~50 cm 之间, 所以这对相对性状之间也可正确区分。
就这 7 对相对性状在 $F_{2}$ 中的分离比来看, 显性植株都占 75% 左右, 隐性植株都占 25% 左右。也就是说, 都出现 3:1, 很有规律。为什么都出现 3:1 呢? 怎样来解释这个现象呢?
三、孟德尔假设
孟德尔为了解释这些结果,提出了下面7点假设:
① 遗传性状由遗传因子(hereditary determinant 或 factor)决定。(因为没有看到性状的混合,所以认为遗传因子的本质是颗粒式的。)
② 每个植株内有许多成对的遗传因子。一对遗传因子控制花冠颜色,一对控制种子形状,等等。(这个推理很容易想象:例如 $F_{1}$ 植株至少有一个遗传因子是决定隐性性状的,因为在以后的世代中显示了这个隐性性状;自然它们还有一个遗传因子是决定显性性状的,因为它们显示这个显性性状。)
③ 每一生殖细胞(花粉或卵细胞)只含有每对遗传因子中的一个。
④ 在每对遗传因子中,一个来自父本雄性生殖细胞,一个来自母本雌性生殖细胞。
⑤ 形成生殖细胞时,每对遗传因子相互分开(即分离),分别进入生殖细胞中。这就是我们现在公认的“孟德尔分离定律”。形成的生殖细胞只得到每对因子中的一个。
⑥ 生殖细胞的结合(形成一个新个体或合子)是随机的。
⑦ 红花因子和白花因子是同一遗传因子的两种形式,其中红花因子对白花因子为显性,反过来,白花因子对红花因子为隐性。这就是说,当植株中一个因子是红花,一个因子是白花时,这个植株表现为红花。两个因子都是红花当然表现为红花,只有两个因子都是白花时,才表现为白花。
例如, 拿红花和白花的杂交试验来说, 红花性状是显性性状, 决定该性状的遗传因子用符号 $C$ 来表示; 白花性状是隐性性状, 决定该性状的遗传因子用符号 $c$ 来表示。按照前面的假设, 亲代红花植株的细胞中有两个红花因子, 写作 $CC$ ; 亲代的白花植株的细胞中有两个白花因子, 写作 $cc$ 。红花植株产生的生殖细胞或配子 (gamete) 中, 只有一个 $C$ ; 白花植株产生的生殖细胞或配子中, 只有一个 $c$ 。受精时, 雌雄配子相互结合, 成为合子 (zygote), 两个因子加在一起, 成为 $Cc$ 。合子发育成 $\mathbf{F}_1$ 植株, 因为红花因子 $C$ 对白花因子 $c$ 是显性, 所以 $\mathbf{F}_1$ 的植株都开红花。
$F_{1}$ 产生的配子, 只能得到两个遗传因子中的一个。这时因子 C 与 c 就分离, 产生两种配子(雌雄配子都是两种), 一种有 C, 一种有 c。两种配子的数目相等, 是 1:1。
因为雌雄配子各有两种,受精时就可有4种不同的组合:①C雌配子与C雄配子结合,形成CC;②C雌配子与c雄配子结合,形成Cc;③c雌配子与C雄配子结合,形成cC;④c雌配子与c雄配子结合,形成cc。
因为配子的结合是随机的,所以这4种受精方式的发生机会相等,即各为1/4。而上面第2和第3两种受精方式所产生的合子是相同的,都是Cc,所以 $F_{2}$ 植株中,1/4是CC,2/4是Cc,1/4是cc。但C对c是显性,所以1/4 CC和2/4 C都是开红花的,只有1/4 cc是开白花的。所以 $F_{2}$ 中红花植株与白花植株的比例是3:1(图2-2)。
四、基因型和表型
孟德尔的遗传因子,现在称为基因(gene)。基因这个术语是丹麦的约翰森最初提出。决定同一性状的一对遗传因子,如红花因子C和白花因子c,是一个基因的不同形式,C和c是一对等位基因(allele)。高株基因T和矮株基因t也互为等位基因,但高株基因不是红花基因的等位基因。
亲代红花植株是 CC,白花植株是 $cc, F_{1}$ 红花植株是 Cc,这些叫作基因型(genotype),或称遗传型。基因型是生物体的遗传组成(genetic constituent),是肉眼看不到的,要通过杂交试验才能鉴定。基因型 CC 和 Cc 表现为红花,基因型 cc 表现为白花,这些花色叫作表型(phenotype)或表现型。表型是表现出来的性状,是肉眼可以看到的,或可用物理、化学方法测定。
不同的基因型表现为不同的表型, 如 CC 表现为红花, cc 表现为白花。也有不同的基因型表现为相同的表型的, 如 $F_{1}$ 植株的基因型是 Cc, 但它们的表型跟亲代基因型 CC 的表型相同, 都是红花。CC 和 cc 这两种基因型, 由两个同是显性或同是隐性的基因组合而成, 叫作纯合子 (homozygote); Cc 这种基因型, 由一个显性基因和一个隐性基因组合而成, 叫作杂合子 (heterozygote)。由单独一对等位基因控制的性状 (如 C 和 c 控制的花冠颜色) 属于孟德尔性状 (Mendelian character)。
五、孟德尔假设的验证
孟德尔只是做了杂交试验,他所看到的只是亲代、 $F_{1}$ 和 $F_{2}$ 个体的表型,以及7对相对性状所共有的独特比例3:1。他看到的只是这些表型,图2-2全是根据见到的事实而推想出来的。我们可以试图追索他当时的思考过程:这个假设不是一步就在脑中想定的,而是根据实验事实一步步推想而成的。
但是一种假设,不仅要说明已得到的实验结果,而且还应该能够预期另一些实验的结果。
假使上面说明的假设是正确的,那么 $F_{1}$ 红花植株跟亲代白花植株回交,后代植株的花色该怎样呢?按照假设, $F_{1}$ 的基因型是 Cc,可以形成两种配子(C 和 c),数目相等。亲代白花植株的基因型是 cc,只产生 c 的配子。所以 $F_{1}$ 红花植株与亲代白花植株交配,后代应该一半的基因型是 Cc,开红花;一半的基因型是 cc,开白花。实验结果共得 166 个后代植株,其中 85 开红花,81 开白花,与所预期的完全符合,说明杂合子的确产生两种配子,而且数目相等(图 2-3)。
这种基因型未知的显性个体(此处是 $F_{1}$ 红花植株)与隐性纯合子交配,以鉴定显性个体基因型的方法,叫作测交(test cross)。遗传学上常用这个方法测定显性个体的基因型。
还有, $\mathbf{F}_1$ 自花授粉得到 $\mathbf{F}_2$ ,在表型上只有两种,红花和白花。但表型为红花的植株中,有两种不同的基因型,一种是 $CC$ ,一种是 $Cc$ ,两者的比例是 $1:2$ (见图2-2)。如果 $\mathbf{F}_2$ 红花植株再进行自花授粉,应该有 $1/3$ 的红花植株产生的子三代(third filial generation, $\mathrm{F}_3$ )全是红花植株,而 $2/3$ 的红花植株产生的 $\mathbf{F}_3$ 有红花植株和白花植株,比例也是 $3:1$ 。因为 $1/3$ 的红花植株的基因型是 $CC$ ,自花授粉, $\mathbf{F}_3$ 当然还是 $CC$ ,都是开红花的; $2/3$ 的红花植株的基因型是 $Cc$ ,自花授粉,应该和 $\mathbf{F}_1$ 自花授粉一样,也是 $Cc$ 与 $Cc$ 交配,得到的 $\mathbf{F}_3$ 的基因型应该是 $CC,Cc,Cc$ 和cc,3份是红花,
1份是白花。而 $F_{2}$ 白花植株的基因型是cc,自花授粉的后代应该全部开白花。那么实验的结果怎样呢?
前面讲过孟德尔得到929个 $F_{2}$ 植株,其中705是红花植株,他在这705个植株中任意选取100株,让它们自花授粉,把得到的种子种下,得 $F_{3}$ 。他发现这100个 $F_{2}$ 红花植株中,有36个植株的 $F_{3}$ 全为红花植株,有64个植株的 $F_{3}$ 有3/4是红花,1/4是白花。36:64接近1:2。而 $F_{2}$ 中的白花植株自花授粉后,后代全部是白花(图2-4)。
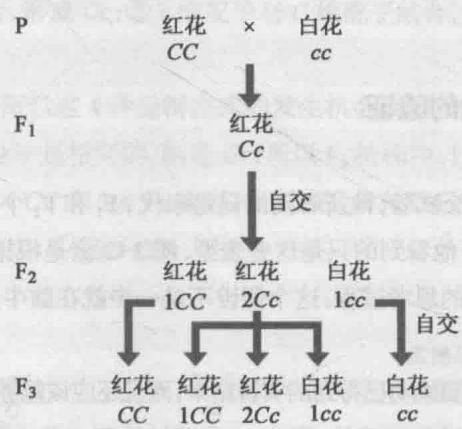
在 $F_{2}$ 中,1/3 红花的 $F_{3}$ 均为红花,2/3 红花的 $F_{3}$ 中又分离出 3:1 的红花与白花;白花的 $F_{3}$ 均为白花。
孟德尔的一对相对性状的实验结果,后人把它归纳为孟德尔第一定律,又称分离定律(law of segregation)。简单地讲,分离定律是杂合子形成配子时,每对等位基因相互分开进入不同的配子中,两种配子数目相同。详细地讲,一对基因在杂合状态中保持相对的独立性,在配子形成时,可独自地分离到不同的配子中去。在一般情况下,杂合子的配子分离比是 $1:1,F_{2}$ 基因型分离比是 $1:2:1,F_{2}$ 表型分离比是 $3:1$ 。分离出来的隐性纯合子和隐性亲本在表型上是一样的,隐性基因并不因为和显性基因在一起而改变它的性质。
六、配子形成时发生分离的证明
孟德尔之后,许多科学工作者在各种生物——从病毒、细菌到人类中做了许多实验,都证实了分离定律。分离定律假定,分离发生在配子形成的时候,那么有没有直观的证据,能够证明这个假定呢?
但是,基因所控制的性状,通常不在配子时期表达,要在个体发育的某个时期才表达出来。例如,豌豆的红花性状要在开花的时候才显示出来。那么有没有一些基因所控制的性状,在配子时期就表达出来呢?有的,请看下面的例子。
水稻(Oryza sativa)有糯性品系和非糯性品系。糯性品系的米粒含有支链淀粉,用稀碘液处理后,米粒呈红褐色,这是碘液原有的颜色。非糯性品系的米粒含有直链淀粉,用稀碘液处理后,米粒呈蓝黑色,这是直链淀粉和碘液起化学反应的结果。
根据杂交试验的结果知道,非糯性对糯性是显性。如用非糯性品系做母本,用糯性品系的花粉来杂交;或者用糯性品系做母本,用非糯性品系的花粉来杂交,所结的种子都是非糯性。把这种非糯性的杂种种子种下去,长成 $F_{1}$ 植株。抽穗时,套上纸袋,让它们自花授粉,结果稻穗上的谷子,3/4是非糯性,1/4是糯性,可见非糯性与糯性的遗传是由一对基因控制的(图2-5)。
非糯性和糯性的遗传实验有个好处,非糯性基因(Wx)和糯性基因(wx)的作用在花粉中已经表现出来了。我们把亲代非糯性品系的花粉放在载玻片上,加一滴碘液,放在显微镜下看,所有的花粉都染成蓝黑色,糯性品系的花粉加上碘液,没有一粒花粉染成蓝黑色,全是红褐色。非糯性品系与糯性品系杂交,得到 $F_{1}$ 种子后,它们的基因型是Wxwx。把它们种下,得到 $F_{1}$ 植株,
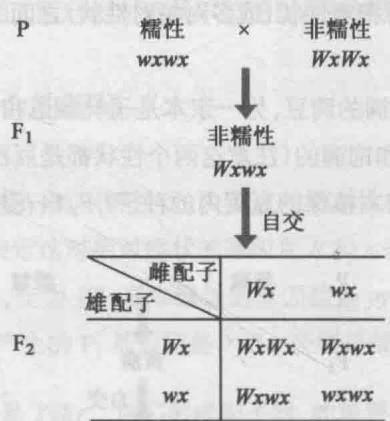
非糯性:糯性=3:1
取它们的花粉放在载玻片上,加一滴碘液,在显微镜下检查,大约半数花粉是蓝黑色,半数花粉是红褐色。这进一步证明了孟德尔的假设, $F_{2}$ 分离的原因是 $F_{1}$ 配子的分离,而且配子分离的比例是 1:1。
这种配子分离的情况在玉米、高粱、黍等其他禾本科作物中也有同样的表现。
七、分离比实现的条件
假使我们研究一对性状的遗传,在 $F_{1}$ 中看到显性现象,在 $F_{2}$ 中看到 3:1,那么下列的几个条件一定是满足的:
(1) $F_{1}$ 个体形成的两种配子的数目是相等的, 它们的生活力是一样的。
(2) $F_{1}$ 的两种配子的结合机会是相等的。举例来说,C 配子跟 C 配子或 c 配子的结合机会是相等的,c 配子跟 C 配子或 c 配子的结合机会也是相等的。
(3) 3 种基因型个体的存活率到观察时为止是相等的。举例来说, 基因型 CC, Cc 与 cc 的个体的存活率是一样的。
(4) 显性是完全的。也就是说, C 对 c 是完全显性的。
应该指出,即使上面列举的几个条件均满足了,我们在 $F_{2}$ 中得到的3:1往往也是近似的,这是什么原因呢?因为花器官形成的雌、雄配子非常多,但能够参加受精并发育成新植株的却很少。这就意味着,要从无数的雌、雄配子中抽取极为少数的一部分来,这样,具有不同基因的配子参与受精的机会就不可能完全相等。例如,在红花植株与白花植株的交配中,每一株 $F_{1}$ 红花植株形成了无数的 C 配子与 c 配子,而在参加受精并发育成新个体时,数目不可能是完全一致的。因为参加受精的 C 配子与 c 配子数不是完全相等的,所以在 $F_{2}$ 中,红花植株与白花植株的比例只可能与 3:1 近似了。
第二节 自由组合定律
上面所讲的一些杂交试验中,孟德尔把注意力集中在一对相对性状。在说明了一对相对性状的遗传规律后,孟德尔就从简单到复杂,从分析到综合,进一步研究两对相对性状的遗传。
一、两对性状的自由组合
我们之所以要用杂交方法来育种,常常是因为两个亲本品种各具有一个优良性状,而我们想把两个优良性状结合在一起,这就是两对相对性状(或多对相对性状)之间的关系问题,孟德尔也研究了这方面的问题。
实验用的一个亲本是子叶黄色和饱满的豌豆,另一亲本是子叶绿色和皱缩的豌豆。把这两个亲本杂交,得到 $F_{1}$ 。 $F_{1}$ 豆粒全是黄色和饱满的(注意这两个性状都是豆粒内子叶的性状,直接表现在 $F_{1}$ 种子。所谓 $F_{1}$ 种子,就是在亲本植株的豆荚内的种子), $F_{1}$ 自花授粉,得到 $F_{2}$ 种子(即
$F_{1}$ 植株的豆荚内的种子), 共计 556 粒豆粒, 其中有黄满和绿皱, 也有黄皱和绿满, 一共 4 种 (图 2-6)。
其中黄满和绿皱两种是亲本原有的性状组合,叫作亲组合(parental combination),而黄皱和绿满是亲本
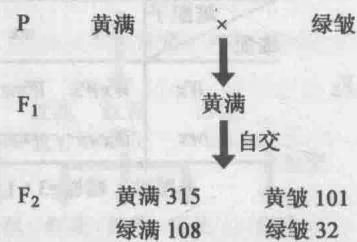
品种原来所没有的性状组合,叫作重组合(recombination)。从 $F_{2}$ 中重组类型的出现可以得出颗粒式遗传的另一基本概念:决定不同性状的遗传因子在遗传传递上有相对独立性,可以完全拆开。在这个例子中,黄色可以和饱满拆开而和皱缩组合,绿色可以和皱缩拆开而和饱满组合。这也是混合式遗传完全没有预期到,而且也不能解释的。
那么怎样定量分析这个实验的结果呢?
我们先看黄和绿这一对相对性状。黄是显性, $F_{1}$ 应该全是黄的, $F_{2}$ 应该 $\frac{3}{4}$ 是黄的, $\frac{1}{4}$ 是绿的。
事实上, $F_{1}$ 全是黄的, $F_{2}$ 556 粒豆粒中,416 粒是黄的,140 粒是绿的,的确是 $\frac{3}{4}$ 和 $\frac{1}{4}$ 。
再看另一对相对性状满和皱。满是显性, $F_{1}$ 应该全是满的, $F_{2}$ 中应该 $\frac{3}{4}$ 是满的, $\frac{1}{4}$ 是皱的。
事实上, $F_{1}$ 全是满的, $F_{2}$ 556 粒豆粒中,423 粒是满的,133 粒是皱的,的确也是 $\frac{3}{4}$ 和 $\frac{1}{4}$ 。
因为不同对的相对性状可以相互组合,如果组合是随机的,那么在 $\frac{3}{4}$ 黄的里面,应该有 $\frac{3}{4}$ 满, $\frac{1}{4}$ 皱;在 $\frac{1}{4}$ 绿的里面,也是 $\frac{3}{4}$ 满, $\frac{1}{4}$ 皱。反过来也是一样,在 $\frac{3}{4}$ 满的里面,应该有 $\frac{3}{4}$ 黄, $\frac{1}{4}$ 绿;在 $\frac{1}{4}$ 皱的里面,也有 $\frac{3}{4}$ 黄, $\frac{1}{4}$ 绿。总而言之,把两对相对性状合起来看,如果组合是随机的,应该是:
1 | \text { 黄满 } = \frac {3}{4} \times \frac {3}{4} = \frac {9}{1 6} \text { 绿满 } = \frac {1}{4} \times \frac {3}{4} = \frac {3}{1 6} |
1 | \mathrm{黄皱} = \frac {3}{4} \times \frac {1}{4} = \frac {3}{1 6} \mathrm{绿皱} = \frac {1}{4} \times \frac {1}{4} = \frac {1}{1 6} |
事实上正是如此,这556粒豌豆中315粒为黄满,108粒为绿满,101粒为黄皱,32粒为绿皱,正好接近 $\frac{9}{16}$ , $\frac{3}{16}$ , $\frac{3}{16}$ 和 $\frac{1}{16}$ ,即9:3:3:1。
从定量数据看来,这两对相对性状不但可以拆开进行重组,而且是自由组合的。
二、对自由组合的解释
子叶黄色和绿色是一对相对性状,决定这对相对性状的基因用 Y 和 y 表示;子叶饱满和皱缩是另一对相对性状,决定这对相对性状的基因用 R 和 r 表示。这样,亲本黄满的基因型是 YYRR,产生的配子只有一种,全为 YR;亲本绿皱的基因型是 yyrr,产生的配子也只有一种,全是 yr。YR 配子与 yr 配子结合,产生的 $F_{1}$ 基因型是 YyRr,表型是黄满。
$F_{1}$ 植株的基因型是 YyRr。它们形成配子时,如单看 Y 和 y,应该 $\frac{1}{2}$ 配子带有 Y 基因, $\frac{1}{2}$ 配子带有 y 基因;如单看 R 和 r 也是一样,应该 $\frac{1}{2}$ 配子带有 R 基因, $\frac{1}{2}$ 配子带有 r 基因。现在把 Yy 和 Rr 合起来看,如果 Y 和 y 的分离与 R 和 r 的分离彼此独立,则在 $\frac{1}{2}$ 带 Y 的配子中,应有 $\frac{1}{2}$ R 和 $\frac{1}{2}$ r, $\frac{1}{2}$ 带 y 的配子中也应有 $\frac{1}{2}$ R 和 $\frac{1}{2}$ r。换句话说,应该是 $\frac{1}{4}$ YR, $\frac{1}{4}$ Yr, $\frac{1}{4}$ yR 和 $\frac{1}{4}$ yr,就是说,产生 4 种配子,数目相等,比例是 1:1:1:1。
雌配子是这4种,雄配子也是这4种,可有16种组合。从图2-7可以看到,表型上9种是黄满,3种是黄皱,3种是绿满,1种是绿皱,与实验结果符合。
三、两对基因杂种的基因型和表型
要在 $F_{2}$ 中得到 9:3:3:1 的表型分离比, $F_{1}$ 配子的分离比必须是 1:1:1:1。这一点可用测交试验进行验证, 即 $F_{1}$ 黄满植株 (YyRr) 与双隐性植株 (yyrr) 杂交。测交结果应该得到 $\frac{1}{4}$ 黄满 $(YyRr)$ , $\frac{1}{4}$ 黄皱 $(Yyrr)$ , $\frac{1}{4}$ 绿满 $(yyRr)$ , $\frac{1}{4}$ 绿皱 $(yyrr)$ 。孟德尔得到的实际数字是:55粒黄满,49粒黄皱,51粒绿满,52粒绿皱,的确和预期一致(图2-8)。
| P | 黄满 | YYRR | × | 绿皱 | yyrr |
|---|---|---|---|---|---|
| 配子 | YR | ↓ | yr | ||
| F1 | YyRr | 黄满 | |||
| 自交 |
| 配子\配子 | YR | Yr | yR | yr |
|---|---|---|---|---|
| YR | YYRR 黄满 | YYRr 黄满 | YyRR 黄满 | YyRr 黄满 |
| Yr | YYRr 黄满 | YYrr 黄皱 | YyRr 黄满 | Yyrr 黄皱 |
| yR | YyRR 黄满 | YyRr 黄满 | yyRR 绿满 | yyRr 绿满 |
| yr | YyRr 黄满 | Yyrr 黄皱 | yyRr 绿满 | yyrr 绿皱 |
图2-7 豌豆两对性状的杂交试验中两对基因的独立分离
由 $F_{1}$ 自花授粉得到的 $F_{2}$ 中,绿皱豆粒 (yyrr) 长成的植株自花授粉后,在 $F_{3}$ 豆粒中是不会分离的。
但绿满豆粒却有两种基因型,其中 $\frac{1}{3}$ 豆粒的基因型是yyRR, $\frac{2}{3}$ 豆粒是yyRr。前者两个基因都是纯合的,后代无分离现象。后者在y方面(绿色)是纯合的,后代无分离,在R和r方面(满和皱)却是杂合的, $F_{3}$ 中应作3:1的分离, $\frac{3}{4}$ 是绿满, $\frac{1}{4}$ 是绿皱。
$F_{2}$ 中的黄皱豆粒也有两种基因型,其中 $\frac{1}{3}$ 是YYrr, $\frac{2}{3}$ 是Yyrr。前者自花授粉后无分离,后者在满或皱这一对性状上不分离,在黄或绿这一对性状上要分离。
$F_{2}$ 中的黄满豆粒有4种基因型,其中 $\frac{1}{9}$ 是YYRR, $\frac{2}{9}$ 是YYRr, $\frac{2}{9}$ 是YyRR, $\frac{4}{9}$ 是YyRr。第一种自花授粉后不分离,第二种在满皱这一性状上要分离,第三种在黄绿这一性状上要分离,而第四种在满皱和黄绿这两对性状上都要分离(表2-2)。
| F1黄满YyRr | × | P绿皱yyrr | ||
| F1植株的配子绿皱植株的配子 | YR | Yr | yR | yr |
| yr | YyRr黄满 | Yyrr黄皱 | yyRr绿满 | yyrr绿皱 |
| 1 | : 1 | : 1 | : 1 |
图 2-8 两对基因杂种的测交
表 2-2 两对基因杂种的 ${\mathrm{F}}_{2}$ 表型和基因型
| 表型 | 基因型 | $F_3$ 的分离情况 |
|---|---|---|
| 9黄满 | $9Y_R_ \begin{cases} 1YYRR \ 2YYRr \ 2YyRR \ 4YyRr \end{cases}$ | 不分离在满皱这一性状上要分离在黄绿这一性状上要分离在黄绿、满皱这两性状上都要分离 |
| 3黄皱 | $3Y_rr \begin{cases} 1YYrr \ 2Yyrr \end{cases}$ | 不分离在黄绿这一性状上要分离 |
| 3绿满 | $3yyR_ \begin{cases} 1yyRR \ 2yyRr \end{cases}$ | 不分离在满皱这一性状上要分离 |
| 1绿皱 | 1yyrr | 不分离 |
$F_{3}$ 的分离情况可用 $F_{2}$ 植株的自花授粉来验证。孟德尔得到 $F_{3}$ 的实际数据见表 2-3。
表 2-3 两对基因杂交 ${\mathrm{F}}_{3}$ 表型
| $F_2$ 种子表型 | $F_2$ 植株数目 | $F_3$ 种子表型种类 | 从 $F_3$ 种子看 $F_2$ 基因型 |
|---|---|---|---|
| 黄满 | 38 | 全部黄满 | YYRR |
| 黄满 | 65 | 黄满,黄皱 | YYRr |
| 黄满 | 60 | 黄满,绿满 | YyRR |
| 黄满 | 138 | 黄满,黄皱,绿满,绿皱 | YyRr |
| 黄皱 | 28 | 全部黄皱 | YYrr |
| 黄皱 | 68 | 黄皱,绿皱 | Yyrr |
| 绿满 | 35 | 全部绿满 | yyRR |
| 绿满 | 67 | 绿满,绿皱 | yyRr |
| 绿皱 | 30 | 全部绿皱 | yyrr |
验证结果又和预期完全符合。
孟德尔所研究的7对相对性状中,任取两对性状进行杂交试验,彼此间都是自由组合,这种情况在不同生物的不同性状间也常常看到。后人把这种现象归纳为孟德尔第二定律,或称自由组合定律(law of independent assortment)。这定律可表达为“不同对等位基因在形成配子时自由组合”。但在20世纪初生物学家们很快就发现了这个定律的例外,同时也搞清了这个定律的适用范围,使遗传学大大向前发展,这要留待后面章节进行说明。
四、多基因杂种
从上面看来,两对基因的遗传,在表面上稍稍复杂些,但在原则上还是简单的。在任何情况下,我们只需把注意力集中于一对基因,如果是纯合的,就没有分离,如果是杂合的,就有分离。假使 $F_{1}$ 是两对基因的杂合子(如 $YyRr$ ),那么就产生4种配子(如 $YR,Yr,yR,yr$ ),配子相互结合,有16种组合, $F_{2}$ 有9种基因型,如显性完全时, $F_{2}$ 的表型分离比是 $(3+1)^{2}=9+3+3+1$ ,有4种不同的表型。如 $F_{1}$ 是3对基因的杂合子,那么就产生8种配子,有64种组合,在 $F_{2}$ 时有27种基因型,如显性完全时,有8种表型,它们的比例是 $(3+1)^{3}$ 的展开。 $F_{1}$ 是4对以上基因的杂合子的情况就不再一一说明了。现在总结成一张表,可以一目了然(表2-4)。
表 2-4 杂交中包括的基因对数与基因型和表型的关系
| 杂交中包括的基因对数 | 显性完全时 $F_2$ 的表型数 | $F_1$ 杂种形成的配子数 | $F_2$ 的基因型数 | $F_1$ 配子的可能组合数 | 表型分离比 |
|---|---|---|---|---|---|
| 1 | 2 | 2 | 3 | 4 | $(3+1)^1$ |
| 2 | 4 | 4 | 9 | 16 | $(3+1)^2$ |
| 3 | 8 | 8 | 27 | 64 | $(3+1)^3$ |
| 4 | 16 | 16 | 81 | 256 | $(3+1)^4$ |
| ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ |
| n | $2^n$ | $2^n$ | $3^n$ | $4^n$ | $(3+1)^n$ |
从上表看来,杂交是增加变异组合的主要方法,所以育种上常常应用这种方法。通过杂交,通过基因的自由组合,可以形成对人类有利的新品种。
例如,有一个小麦品种能抵抗霜害,但容易感染锈病,另一个小麦品种能抵抗锈病,但不能经受霜冻,让这两个品种杂交,就可能在 $F_{2}$ 中找到既能抵抗霜害,又能抵抗锈病的类型。当然也可在 $F_{2}$ 中出现既容易感染锈病又不耐霜冻的类型和其他类型。这里,育种工作者可以通过选择的方法,选留所需要的植株,淘汰不符合要求的植株。
在农牧业上,上述的方法被广泛应用,许多优良的动、植物品种就是通过这样的方法培育成功的。
第三节 遗传学数据的统计处理
孟德尔对他自己所得的分离比例并未做过统计学分析,而且也没有认识到这种处理的必要性。但他已经看到分离比如1:1、3:1等都是要子代个体数较多时才比较接近,子代个体数不多时,常有明显的波动。例如,结饱满豆粒的豌豆植株与结皱缩豆粒的豌豆植株杂交,得到253个 $F_{1}$ 植株,上面共结7324粒 $F_{2}$ 种子,其中5474粒是饱满的,1850粒是皱缩的,相当接近3:1。但从每个 $F_{1}$ 植株分别计算 $F_{2}$ 的分离,那就可看到有波动。孟德尔在上述杂交试验中,随机挑出10个 $F_{1}$ 植株, $F_{2}$ 的分离如表2-5。
表 2-5 ${\mathrm{F}}_{1}$ 单株分离比例
| $F_1$ 植株号码 | 饱满豆粒 | 皱缩豆粒 | $F_1$ 植株号码 | 饱满豆粒 | 皱缩豆粒 |
|---|---|---|---|---|---|
| 1 | 45 | 12 | 6 | 26 | 6 |
| 2 | 27 | 8 | 7 | 88 | 24 |
| 3 | 24 | 7 | 8 | 22 | 10 |
| 4 | 19 | 10 | 9 | 28 | 6 |
| 5 | 32 | 11 | 10 | 25 | 7 |
孟德尔在论文中还提到,最极端的数字为43满与2皱,14满与15皱,可见从单个 $F_{1}$ 植株的后代来计算 $F_{2}$ 的分离,波动很大。
20世纪初期,孟德尔定律被重新发现后,遗传学工作者在自己的实验中也碰到这种现象。他们最初唯有尽可能得到较多的后代个体,来掩盖这种机遇性的波动。但这样做有两个缺点,首先在实践上有一定的限制,后代个体数不可能很多,但更重要的是逻辑缺点。对这种机遇性的波动,必须有严格的逻辑处理。而且不久又发现各种新的分离比例,如 $13:3,15:1$ 等,后来又发现孟德尔定律有真正的例外,这些都使分离比例的机遇性波动问题更加迫切地需要解决。遗传学工作者不久就发现,当时的概率论和统计学方法已能圆满地解决这些比较简单的问题了。
一、概率
所谓概率(probability),是指在反复实验中,预期某一事件的出现次数的比例,它是生物统计学中最基本的概念。要说明这个概念,先从孟德尔的实验数据讲起。
我们可以把表2-5的数据逐株积加,成表2-6的形式。从表2-6可见, $\mathbf{F}_2$ 种子中显性种子的频率始终在0.750左右波动。但随着 $\mathbf{F}_2$ 种子数的逐渐增加,波动范围越来越小,也就是说频率逐渐逼近0.750。在这种情况下,按照概率一词的一般定义,我们就说 $\mathbf{F}_2$ 种子中显性种子的概率是0.750,即3/4。
表 2-6 ${\mathrm{F}}_{1}$ 单株分离比例的积加
| 饱满豆粒 | 皱缩豆粒 | 总数 | 饱满豆粒频率 | |
|---|---|---|---|---|
| 第一个 $F_1$ 植株 | 45 | 12 | 57 | 0.789 |
| 最初2个 $F_1$ 植株总和 | 72 | 20 | 92 | 0.782 |
| 最初3个 $F_1$ 植株总和 | 96 | 27 | 123 | 0.780 |
| 最初4个 $F_1$ 植株总和 | 115 | 37 | 152 | 0.757 |
| 最初5个 $F_1$ 植株总和 | 147 | 48 | 195 | 0.754 |
| 最初6个 $F_1$ 植株总和 | 173 | 54 | 227 | 0.762 |
| 最初7个 $F_1$ 植株总和 | 261 | 78 | 339 | 0.770 |
| 最初8个 $F_1$ 植株总和 | 283 | 88 | 371 | 0.763 |
| 最初9个 $F_1$ 植株总和 | 311 | 94 | 405 | 0.768 |
| 最初10个 $F_1$ 植株总和 | 336 | 101 | 437 | 0.769 |
| ⋮ | ⋮ | ⋮ | ⋮ | ⋮ |
| 最初253个 $F_1$ 植株总和 | 5474 | 1850 | 7324 | 0.747 |
所以孟德尔定律也可说是概率定律、统计定律,正像物理学和化学中的大多数定律一样。由于遗传学实验往往以个体为单位,单位数目比物理学和化学实验中单位数目小得多,所以机遇性波动的现象特别明显,特别需要用统计学方法来处理实验数据。
现在从概率来考虑遗传比例。遗传比例的决定主要根据概率的两个基本法则:
(1) 相乘法则 这一法则认为,两个(或两个以上)独立事件同时出现的概率是它们各自概率的乘积。例如,豌豆豆粒从子叶颜色看,一半是黄色的,一半是绿色的;又从豆粒充实程度看,一半是饱满的,一半是皱缩的。如果一个性状并不影响另一性状,那么一粒豌豆可以同时是黄色和饱满的。因豆粒是黄色的概率是 $\frac{1}{2}$ ,是饱满的概率也是 $\frac{1}{2}$ ,所以豌豆豆粒是黄色而又饱满的概率是 \frac{1}{2} \times \frac{1}{2} = \frac{1}{4} 。因为黄绿和满皱是两个独立事件,黄或绿的发生并不影响满或皱的出现,所以黄满这两性状同时出现的概率就是它们各自概率的乘积。
此外,我们也可问某一事件不出现的概率。例如,豌豆豆粒又黄又满的概率是 $\frac{1}{4}$ ,那么这一事件不出现的概率是多少?也就是问,豌豆豆粒是满的,但不是黄的;或者是黄的,但不饱满;或两者都不是的概率是多少?因为所有事件的总概率是1,而其中 $\frac{1}{4}$ 是黄色而饱满,这样 $1-\frac{1}{4}$ 或 $\frac{3}{4}$ 就是某个豌豆豆粒又黄又满这一事件不出现的概率。
(2) 相加法则 如两个事件是非此即彼的,或相互排斥的,那么出现这一事件或另一事件的概率是两个个别事件的概率之和。用上面的豌豆例子来说,一粒豌豆不可能既是黄色又是绿色——如果是黄色就非绿色,如果是绿色就非黄色,两者是互斥事件。所以在这种情况下,豆粒是黄色或绿色的概率是它们各自概率之和,即 $\frac{1}{2}+\frac{1}{2}=1$ 。另一方面,如果豆粒只有黄色和绿色时,那么豆粒既非黄色又非绿色的概率是1-1=0。
二、遗传比例的计算
根据孟德尔定律,我们已经知道基因型 $Aa$ 的亲本可以产生两型配子, $A$ 和 $a$ 。如果这样一个个体自体受精,或和一个相同杂合子交配,预期在子代中可以出现 3 种不同的基因型 $AA$ , $Aa$ 和 $aa$ 。如基因 $A$ 对 $a$ 是显性,子裔将出现两种不同表型, $A(AA,Aa)$ 和 $a(aa)$ ,这儿 $A$ 和 $a$ 代表表型。另一方面,基因型 $Aa$ 的亲本和 $aa$ 的亲本交配,子代也可出现 $A$ 和 $a$ 两种表型。所以如亲本的基因型未知时,子裔中出现 $A$ 和 $a$ 这两种表型,有两种可能的假设。可是我们怎样在这两种可能假设间作出判断呢?
要对这个问题作出解答,一个办法是根据每一假定,求出预期的基因型和表型的比例。我们假定Aa亲本产生两种配子,A和a,数目相等。aa亲本只产生一种配子,a。配子相互结合,形成合子。因为两亲配子的形成是独立事件,有它们各自的概率,又因为两配子的结合,是两个独立事件同时发生的结果,所以一个特定合子的形成概率相当于构成它们配子的概率的乘积。
要计算有关的数值,我们可以用棋盘法,像上面已讲到过的那样,把每一亲本的配子放在一边,注上各自的概率(P)。如一个亲本形成的两种配子是A和a,概率相等,这样每一配子的概率是 $\frac{1}{2}$ 。棋盘的每一格中填上形成的合子,它的概率是两个配子的频率的乘积。上面提到过的两个假设,可分别列成棋盘,如图2-9。
在 Aa \times Aa 交配中, 可形成 4 种合子, 概率都是 $\frac{1}{4}$ 。然而这些合子都是互斥事件, 一个 $Aa$ 合子, 不可能同时是 $aA, AA$ 或 $aa$ 。所以一个合子是 $Aa$ 或 $aA$ (即杂合子) 的概率是 $\frac{1}{4} + \frac{1}{4}$ , 即 $\frac{1}{2}$ ; 是 $AA, Aa$ 或 $aA$ 的概率是 $\frac{1}{4} + \frac{1}{4} + \frac{1}{4}$ , 即 $\frac{3}{4}$ ; 是 $AA, Aa, aA$ 或 $aa$ 的概率当然等于 1。然而应该注意到, 在基因 $A$ 对 $a$ 是显性的情况下, 纯合子 $AA$ 和两杂合子 $Aa, aA$ 的表型是相同的, 显性表型 $A$ 出现的概率是 3 个互斥事件之和, 得到的总概率是 $\frac{1}{4} + \frac{1}{4} + \frac{1}{4} = \frac{3}{4}$ 。
图2-9 根据两种不同假设,计算形成的合子的概率
| 配子 配子 | A(P=1/2) | a(P=1/2) |
|---|---|---|
| A(P=1/2) | AA 1/4 | Aa 1/4 |
| a(P=1/2) | Aa 1/4 | aa 1/4 |
在 Aa \times aa 交配中形成两种合子, 频率相等。一种合子是显性 A 表型, 另一种合子是隐性 a 表型, 这两种表型的概率都是 $\frac{1}{2}$ 。这样两个假设的差异可以由每一假设所产生的表型比例看到: 一种情况, 表型比 A : a = 3 : 1; 另一种情况, 表型比 A : a = 1 : 1。
棋盘法(punnett square)也可用来计算两对自由组合的基因的分离。例如,两对基因杂合子AaBb产生4种配子:AB, Ab, aB, ab,频率相等。这样两个杂合子杂交时,形成 4 \times 4 的棋盘格,每两个配子的结合各有 \frac{1}{4} \times \frac{1}{4} = \frac{1}{16} 的概率。上面计算孟德尔的两对基因杂种的基因型和表型频率就是应用这个方法。
一个杂交中有关的基因对数在两对以上时,用棋盘格计算预期比例就显得繁琐,例如,3对基因的差异就要有一个8×8的棋盘格。相差的基因对数再多,就显得更为复杂。一个比棋盘格简易的方法是把每对基因分别考虑,单看一对基因的差异,可有6种不同的交配形式,每一种交配形式所产生的子代都有它独特的基因型和表型的组合(图2-10)。
如果亲代的每一性状的基因型已经知道,而且每对基因与另一对基因都是自由组合的,那么预期子代的基因型和表型比例可用分支法(branching process)来推算(图2-11)。例如在孟德尔所做的两对基因杂交实验中,黄(Y)对绿(y)是显性,满(R)对皱(r)是显性。 $F_{1}$ 双杂合子(YyRr)自
图 2-10 涉及一对等位基因(A/a)的6种不同交配方式及杂交结果
每种交配所产生的子代的基因型和表型都有所不同。
| 亲代 | 子代 | |
| 基因型 | 表型 | |
| 1. AA \times AA | 全 $AA$ | 全 A |
| 2. AA \times aa | 全 $Aa$ | 全 A |
| 3. AA \times Aa | $1AA:1Aa$ | 全 A |
| 4. aa \times aa | 全 $aa$ | 全 a |
| 5. aa \times Aa | $1Aa:1aa$ | 1A:1a |
| 6. Aa \times Aa | $1AA:2Aa:1aa$ | 3A:1a |
花授粉时, $F_{2}$ 将出现9种基因型和4种表型,各有一定的频率。现在两对基因分别考虑,每对基因 (Yy\times Yy 和 Rr\times Rr) 将产生3种不同基因型,比例是1:2:1,两种不同表型,比例是3:1(见图2-10,第6交配)。因为每对基因出现的概率跟另一对基因出现的概率是相互独立的,所以 $F_{2}$ 的基因型和表型的概率就是相应概率的相乘结果。
这个方法也可用在两对以上基因的差异,而且双亲不一定对每对基因都是杂合子。例如一个亲本的基因型是 AAbbCc,另一亲本的基因型是 aaBbCc,两个亲本杂交,它们的子代的基因型和表型就会像图 2-12 那样。
其他各种杂交组合,不论差异的基因对数是多少对,都可应用分支法简便而准确地把杂交子代的基因型和表型比例推算出来。
1 | 2 Y y arrayc 1 R R 2 Y y R R |
1 | 1 y y arrayc 1 R R 1 y y R R |
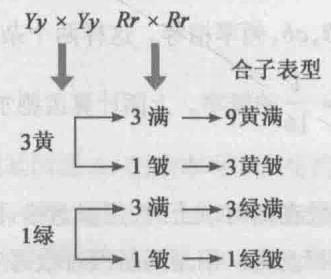
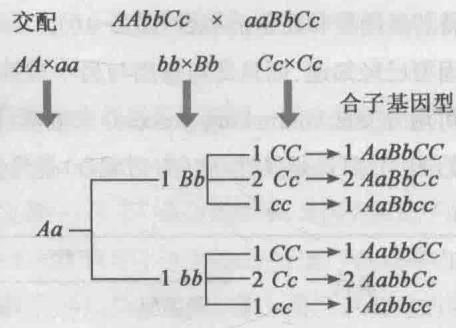
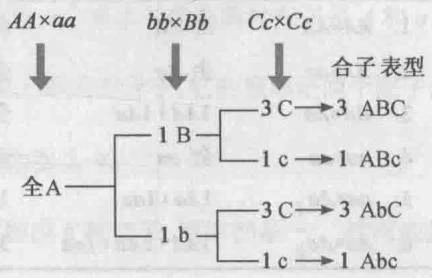
A 代表 A/a 基因对的显性表型 (AA 或 Aa 决定), a 代表隐性表型 (aa 决定)。同样, B 和 C 代表显性表型, b 和 c 代表隐性表型。
三、二项式展开
很多遗传学问题不单是有关某一事件出现的概率,有时也牵涉到某些事件组合出现的概率。例如,一个 Aa \times aa 交配,有两个子裔,要知道这两个子裔具有某种遗传组成的概率,就是要推算两个子裔都是Aa,或两个子裔都是aa,或一个子裔是Aa,另一个子裔是aa的概率。因为一个子裔出现某一基因型并不影响另一子裔的基因型,所以这些是独立事件。在这样一个交配中,出现两个子裔都是Aa的概率就是每一Aa子裔出现的概率相乘, \frac{1}{2} \times \frac{1}{2} = \frac{1}{4} 。所以两个子裔出现各种基因型组合的概率,考虑到顺序,应该像下面这样:
| 第一个子裔 | 第二个子裔 | 概率 |
|---|---|---|
| Aa | Aa | \frac{1}{2} \times \frac{1}{2} = \frac{1}{4} |
| Aa | aa | \frac{1}{2} \times \frac{1}{2} = \frac{1}{4} |
| aa | Aa | \frac{1}{2} \times \frac{1}{2} = \frac{1}{4} |
| aa | aa | \frac{1}{2} \times \frac{1}{2} = \frac{1}{4} |
假使我们不管顺序先后,把相应的数值累加起来,我们就得到下面的概率分布:
两个子裔都是 $Aa$ 的概率 $= \frac{1}{4}$ ;
一个子裔是 $Aa$ ,另一是 $aa$ 的概率 $= \frac{2}{4}$
两个子裔都是 $aa$ 的概率 $= \frac{1}{4}$ 。
这个分布型式是 $1:2:1$ ,是二项分布 $(p + q)^{2} = 1p^{2} + 2pq + 1q^{2}$ 的系数。如果我们用 $Aa$ 代替 $p$ ,用 $aa$ 代替 $q$ ,那么 $[(Aa) + (aa)]^2 = 1(Aa)(Aa) + 2(Aa)(aa) + 1(aa)(aa)$ 。
这一结果用文字来说明是这样的:一个 Aa \times aa 交配,产生两个子裔时,预期两个子裔都是Aa的可能组合数是1,一个是Aa另一个是aa的可能组合数是2,而两个都是aa的可能组合数是1,总共的可能组合数是4。如果用 $\frac{1}{2}$ 代替p和q,那么 $(p+q)^{2}=\left(\frac{1}{2}\right)^{2}+2\left(\frac{1}{2}\right)\left(\frac{1}{2}\right)+\left(\frac{1}{2}\right)=\frac{1}{4}+\frac{2}{4}+\frac{1}{4}$ ,这就是一个 Aa \times aa 交配产生两个子裔时,各种基因型组合的概率。
如果一个 Aa \times aa 交配,有 3 个子裔,要推算 3 个子裔间基因型的各种组合,就相当于 $(p + q)^{3}$ 的展开:
3个子裔都是 $Aa$ 的概率 $= p^{3} = \left(\frac{1}{2}\right)^{3} = \frac{1}{8}$ ;
2个子裔是 $Aa, 1$ 个是 $aa$ 的概率 $= 3p^{2}q = 3\left(\frac{1}{2}\right)^{2}\left(\frac{1}{2}\right) = \frac{3}{8}$ ;
2个子裔是aa,1个是Aa的概率 $=3pq^{2}=3\left(\frac{1}{2}\right)\left(\frac{1}{2}\right)^{2}=\frac{3}{8}$ ;
3个子裔都是aa的概率 $= q^{3} = \left(\frac{1}{2}\right)^{3} = \frac{1}{8}$ 。
这就是一个 Aa \times aa 交配产生 3 个子裔时,各种基因型组合的概率。
这样,子裔的每一特定组合的概率,都可用这一组合的二项分布系数在全部可能组合数中的比例来表达。例如,有4个子裔时,4个子裔的基因型都是 $Aa$ 的概率是 $\frac{1}{16}$ ,因为这相当于 $(p + q)^4 = \left(\frac{1}{2} + \frac{1}{2}\right)^4$ 展开的第一项 $\left(\frac{1}{2}\right)^4 = \frac{1}{16}$ ,或相当于 $[(Aa) + (aa)]^4$ 展开的第一项 $1(Aa)(Aa)(Aa)(Aa)$ ,系数是1,而总共可能的组合数是16。
一般地说,设 p 为某一基因型或表型出现的概率,而 q 或 1-p 是另一基因型或表型出现的概率, $p+q=1$ 。这样,这些事件的每一组合的概率就可用二项分布的展开式来说明。如果不考虑出现的顺序,基因型或表型的每一特定组合的概率可从二项分布的通项公式算出:
$$
\frac {n !}{s ! (n - s) !} p ^ {s} q ^ {n - s}
$$
其中,n 是子裔的数目,s 是有某一基因型(例如 Aa)或表型的子裔数,p 是该基因型或表型的出现概率,而 n-s 是有另一基因型(例如 aa)或表型的子裔数,q 是另一基因型或表型的出现概率。符号!是阶乘,就是从一个数目开始,按整数顺序相乘,一直到 1,例如, n=5,5!=5\times4\times3\times2\times1=120 。应该注意到,0 的阶乘 (0!) 等于 1。如在 Aa\times aa 的交配中,产生 4 个子裔,问这 4 个子裔都是 Aa 的机会是多少?因为 Aa 的概率 $p=\frac{1}{2}, s=4$ ,所以这一项的概率是:
$$
\frac {n !}{s ! (n - s) !} p ^ {s} q ^ {n - s} = \frac {4 !}{4 ! 0 !} \left(\frac {1}{2}\right) ^ {4} \left(\frac {1}{2}\right) ^ {0} = \frac {1}{1 6} = 0. 0 6 2 5
$$
子裔中 $Aa$ 和 $aa$ 个体的各种可能组合,都可用同样方法直接求得。例如,从 Aa \times aa 的一个交配中,产生5个子裔,其中3个是 $Aa, 2$ 个是 $aa$ ,概率是:
$$
\frac {5 !}{3 ! 2 !} \left(\frac {1}{2}\right) ^ {3} \left(\frac {1}{2}\right) ^ {2} = \frac {5}{1 6} = 0. 3 1 2 5
$$
四、适合度测验
像上面所说明的那样,杂交实验中,子代预期的遗传比例可以根据棋盘法或分支法正确地推算,子裔中基因型或表型的各种组合的概率也可根据二项式分布简单地求得。在这基础上,我们可进一步计算实得比例对理论比例的适合度,那就是说,根据实得比例符合理论比例的程度如何,从而判断这次实验结果是否可用这个理论比例来说明,还是必须抛弃这个理论比例,认为另有其他理论比例,或者这次实验结果根本不能用孟德尔定律来说明。
我们试用遗传学上一个具体实验来说明这种方法。
水稻植株中,有的对白叶枯病病菌有抗性,而有的敏感。根据遗传学分析知道,在水稻成株时,抗性性状为显性,抗性植株的基因型有两种,一为纯合子SS,一为杂合子Ss,而敏感性状是隐性,敏感植株的基因型为纯合子 ss,所以水稻对白叶枯病的抗性性状属于孟德尔性状,是由单一基因控制的。
现在设有两株水稻,一为抗性植株,一为敏感植株。把它们杂交,得到20个植株,其中14株是抗性植株,6株是敏感植株。敏感植株的基因型为ss,而抗性植株的基因型有两种可能,一为纯合子SS,一为杂合子Ss,但因杂种后代中除出现抗性植株外,还出现了敏感植株,所以亲本抗性植株的基因型应为Ss。根据理论推算,在 Ss \times ss 的杂交中,子裔的基因型Ss与ss之比应为1:1(图2-10,第5交配)。现有20个子代植株,应该是10株抗性型和10株敏感型,而实验中实际得到的是,14株抗性型和6株敏感型。问实得比例与理论比例适合的程度如何?换句话说,就是问实验所得数据是否与“抗性型与敏感型仅有一对基因之差,且实验中所用的亲代植株的基因型是Ss”这一假设相符合。
如果这个杂交就是 Ss \times ss ,子代中抗性型与敏感型的概率各为 $\frac{1}{2}$ 。20 株植物的各种组合的概率就是 $(p + q)^{n} = \left(\frac{1}{2} + \frac{1}{2}\right)^{20}$ 的展开(表 2-7)。
不包括
表2-7 $\left(\frac{1}{2} +\frac{1}{2}\right)^{20}$ 的展开
| 组合 | 20抗0敏 | 19抗1敏 | 18抗2敏 | 17抗3敏 | 16抗4敏 | 15抗5敏 | 14抗6敏 | 13抗7敏 |
| 概率 | 0.000 001 | 0.000 02 | 0.000 2 | 0.001 | 0.005 | 0.015 | 0.037 | 0.074 |
| 组合 | 12抗8敏 | 11抗9敏 | 10抗10敏 | 9抗11敏 | 8抗12敏 | 7抗13敏 | 6抗14敏 | 5抗15敏 |
| 概率 | 0.120 | 0.160 | 0.176 | 0.160 | 0.120 | 0.074 | 0.037 | 0.015 |
| 组合 | 4抗16敏 | 3抗17敏 | 2抗18敏 | 1抗19敏 | 0抗20敏 | 合计 | ||
| 概率 | 0.005 | 0.001 | 0.000 2 | 0.000 02 | 0.000 001 | 1.000 | ||
理论比为 1:1 时,20 个子代中得到 14 株抗性型和 6 株敏感型的概率是:
$$
\frac {2 0 !}{1 4 ! 6 !} \left(\frac {1}{2}\right) ^ {1 4} \left(\frac {1}{2}\right) ^ {6} = 0. 0 3 7
$$
也就是说,平均每做100次实验中,大概有3次或4次实验会得到这样的结果,这样的概率当然很小,看来这样的实验数据跟理论比例1:1似乎是不相符合的。
可是单是计算实得比例这一项的概率,就作为适合度测验的根据,有一个很明显的缺点,因为植株数目增加时,即使是完全符合理论比例的资料,它们的概率也不断下降。例如,在一对基因回交实验中,如实际分离比刚好1:1,那是完全符合理论比例的,可是得到这一分离比的概率也随着个体数的增加而逐渐下降(表2-8)。
表 2-8 回交后代中,个体数不同时,完全符合理论比例 1:1 的出现概率
| 回交后代个体数 | 2 | 4 | 6 | 8 | 10 | 20 | 40 | 80 |
|---|---|---|---|---|---|---|---|---|
| 得到完全符合1:1比例的概率 | 0.500 | 0.375 | 0.312 | 0.273 | 0.246 | 0.176 | 0.125 | 0.089 |
从上表可看到,当理论比例为1:1,2个子代个体分离为1个与1个时,出现概率是0.50。而子代个体数增加到80时,分离比为40个与40个的出现概率只有0.09。可见单是根据实得比例的出现概率,很容易被引入歧途,显然不能用于适合度测验。
如果我们根据理论比例和子代个体数,用二项式展开法求出子代中各种组合的概率,然后将实得比例与理论比例相比较,把有同样偏差或更大偏差的那些组合的概率加起来,这样,不论子代个体数的多少,完全符合理论比例的概率是一个常数。所以进行适合度测验时,不是单单计算某一实得比例的概率,而是计算偏差与实得比例一样大或更大的概率。
在上述的水稻抗性的一对基因回交实验中,从对理论比例1:1的偏差来说,更多的抗性型和更多的敏感型是同样的偏差,所以把有14株以上抗性型或14株以上敏感型的那些组合的概率加起来,就是有着同样偏差或更大偏差的概率。这概率如用 $P$ 表示,则如表2-9所示, $P = 0.116$ 。
表 2-9 在水稻抗性型与敏感型 (Ss \times ss) 的回交中,与实得比例(14:6)有着相同或更大偏差的理论比例的积加概率
| 组合 | 20抗 0敏 | 19抗 1敏 | 18抗 2敏 | 17抗 3敏 | 16抗 4敏 | 15抗 5敏 | 14抗 6敏 | |
|---|---|---|---|---|---|---|---|---|
| 概率 | 0.000 001 | 0.000 02 | 0.000 2 | 0.001 | 0.005 | 0.015 | 0.037 | |
| 组合 | 6抗 14敏 | 5抗 15敏 | 4抗 16敏 | 3抗 17敏 | 2抗 18敏 | 1抗 19敏 | 0抗 20敏 | 合计 |
| 概率 | 0.037 | 0.015 | 0.005 | 0.001 | 0.000 2 | 0.000 02 | 0.000 001 | 0.116 |
这样看来,实得比例和理论比例符合的情况并不像最初想象的那样坏,而且一般并不认为太坏。的确,0.116的概率是比较低,不过如果我们认为这样的资料与理论比例不符合,那么在每9次实验中就得有一次发生错误。这在大多数场合是常有的事,因而我们不能认为实得数据与理论比例间有显著的差异。
那么怎样的数据才被认为不符合理论比例呢?换句话说,怎样的概率水平才被看作与假设有显著差异而把理论比例加以否定呢?这要从两方面来考虑:一方面,我们希望把否定假设的概率水平定得低些,这样,错误地否定原来是正确的分离比的机会就小了;可是另一方面,又不能把否定假设的概率水平定得太低,因为这样做时,又会偏向另一边,不敢否定本来是错误的假设,从而错误地接受了不正确的分离比。统计学家权衡了这两方面的得失,一般同意,当 $P < 0.05$ 时,认为实得资料与理论比例间有显著的差异,应把假设的分离比否定;如 $P < 0.01$ 时,认为实得数据与理论比例间有极显著的差异,自然更有把握可把假设的分离比否定了。例如,在水稻抗性植株与敏感植株的杂交中,如子代的20株植物分离为15株抗性型和5株敏感型,则偏差跟 $15:5$ 一样大或更大的概率是0.042,表明实得比例与理论比例 $1:1$ 间有显著的差异,因而认为所得的分离数据不能用一对基因的回交来说明。
五、用卡平方来测定适合度
用二项式展开的方法来进行适合度测验,在子代个体数较多时非常费力,而且当子代个体数分成两类以上时更为困难。统计学上有简单的近似法,不论子代个体数分成几类,都可以用一个指数来表示实得数与理论数的差异。这个指数就叫作卡平方,一般写成 $\chi^{2}$ 。 $\chi^{2}$ 的定义是:
$$
\chi^ {2} = \sum \frac {(\mathrm{实得数} - \mathrm{预期数}) ^ {2}}{\mathrm{预期数}}
$$
仍以上述的水稻的抗性实验为例,实得比例为14:6,按1:1的假设,预期数应为10:10,把这些数据代入上式,得
$$
\chi^ {2} = \frac {(1 4 - 1 0) ^ {2}}{1 0} + \frac {(6 - 1 0) ^ {2}}{1 0} = 3. 2 0
$$
如实得比例为 15:5, 则
$$
\chi^ {2} = \frac {(1 5 - 1 0) ^ {2}}{1 0} + \frac {(5 - 1 0) ^ {2}}{1 0} = 5. 0 0
$$
算出 $\chi^2$ 后,查 $\chi^2$ 表(表2-10)。表中数字是各种 $\chi^2$ 值。 $P$ 就是上一节中所说:实得数与理论数相差一样大以及更大的积加概率。 $n$ 表示自由度,意思是在各项预期值决定后,实得数中有几项能自由变动。在分离比例的适合度测验中,自由度一般等于子代分类数减1。在上述一对基因回交实验中,子代分成两类,自由度 $n = 2 - 1 = 1$ ,因为这两个实得数值中,只有一个可以自由变动。例如,若以抗性型植株数为可以自由变动的一项,则敏感型植株数就不能自由变动。因为抗性型植株数确定后,敏感型植株当然也就确定下来。例如,抗性型植株数为14,则敏感型植株必为6,因为子代总数是一定的。自由度 $n$ 可写在 $\chi^2$ 的右下角,若 $n = 1$ ,则写成 $\chi^{2}_{[1]}$ 。
表2-10 $\chi^2$ 表
| $n$ \P | 0.99 | 0.95 | 0.50 | 0.10 | 0.05 | 0.02 | 0.01 |
|---|---|---|---|---|---|---|---|
| 1 | 0.000 16 | 0.003 9 | 0.15 | 2.71 | 3.84 | 5.41 | 6.64 |
| 2 | 0.020 1 | 0.103 | 1.39 | 4.61 | 5.99 | 7.82 | 9.21 |
| 3 | 0.115 | 0.352 | 2.37 | 6.25 | 7.82 | 9.84 | 11.35 |
| 4 | 0.297 | 0.711 | 3.36 | 7.78 | 9.49 | 11.67 | 13.28 |
| 5 | 0.554 | 1.145 | 4.35 | 9.24 | 11.07 | 13.39 | 15.09 |
| ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ | ⋮ |
| 10 | 2.558 | 3.940 | 9.34 | 15.99 | 18.31 | 21.16 | 23.21 |
注:表内数字是各种 $\chi^2$ 值, $n$ 是自由度, $P$ 是在一定自由度下 $\chi^2$ 大于表中数值的概率。
上例实得数 14:6 时, $\chi^{2}{[1]} = 3.20$ , 从表中自由度 n=1 那一行来看, 当 $\chi^{2}{[1]} = 3.84$ 时, P=0.05, $\chi^{2}{[1]} = 2.71$ 时, P=0.10, 现在 $\chi^{2}{[1]} = 3.20$ , 所以 P 在 0.05 与 0.10 之间。上一节中用二项式展开法求得 P=0.116, 所以两种方法有些出入, 这是因为 $\chi^{2}$ 法是个近似法。事实上, 子代个体数越多, 则 $\chi^{2}$ 法越可靠。一般规定, 如果有一项预期数小于 5 时, 就不宜用 $\chi^{2}$ 法, 当个体数小时, 为了精确起见, 宁可用二项式展开法。但一般应用时, $\chi^{2}$ 法已经足够近似了。如以 P<0.05 为显著性的标准, 那么实得比 14:6 与理论比 1:1 之间没有显著差异, 这一结论与由二项式展开法求得的是一致的。
如实得数为 15:5 时, $\chi^{2}_{[1]}=5.00$ ,从表上知道 P 在 0.05 与 0.02 之间,表明实得比例与理论比例之间有显著差异,所以实得数据不宜用一对基因的回交来解释,这个结论也与由二项式展开法求得的一致。
子代个体分类在两项以上,计算方法也一样。
例如,香豌豆(Lathyrus odoratus)的花冠有紫色的和红色的,这是由一对基因决定的;花粉的形状有长形的和圆形的,这也是由一对基因决定的。英国遗传学家贝特森和庞尼特(Reginald Crundall Punnett,1875—1967)把紫色圆形的植株与红色长形植株杂交,得到的 $F_{1}$ 全是紫色长
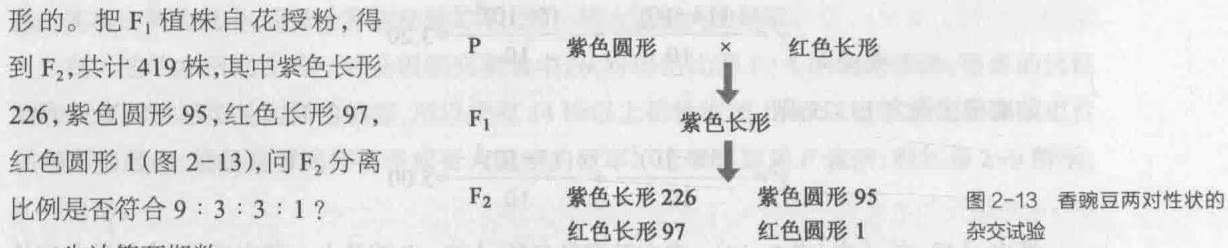
先计算预期数:
紫色长形 419 \times \frac{9}{16} = 235.69 ,紫色圆形 419 \times \frac{3}{16} = 78.56
红色长形 419 \times \frac{3}{16} = 78.56 ,红色圆形 419 \times \frac{1}{16} = 26.19 。
然后写成表2-11的形式,可得:
$$
\chi_ {[ 3 ]} ^ {2} = 3 2. 4 0, \quad n = 3, \quad P < 0. 0 1 。
$$
表 2-11 两对基因杂种 ${\mathrm{F}}_{2}$ 资料的 ${\chi }^{2}$ 测验
| 紫长 | 紫圆 | 红长 | 红圆 | 合计 | |
|---|---|---|---|---|---|
| 实得数 | 226 | 95 | 97 | 1 | 419 |
| 预期数 | 235.69 | 78.56 | 78.56 | 26.19 | 419 |
| 实得数-预期数 | -9.69 | 16.44 | 18.44 | -25.19 | 0 |
| $(实得数 - 预期数)^2$ | 0.40 | 3.44 | 4.33 | 24.23 | 32.40 |
从 $\chi^{2}$ 表上看, $\chi_{[3]}^{2}=11.35$ 时,P=0.01,所以 $\chi_{[3]}^{2}=32.40, P<0.01$ 。因此我们可以说,实得数与预期数相符合的机会明显地小于 1%,实得数据与理论比例的差异,不可能由于机会所造成,因此在这种情况下,两对基因自由组合的假设大可怀疑。事实上,这是自由组合定律方面第一次发现的明显例外。这是由于非等位基因间的连锁造成的,关于这一点将在连锁交换一章中详加讨论。
在本节结束的时候,再强调一下:在进行这种适合度测验时,必须懂得这种方法的真正意义。例如,孟德尔的饱满豌豆与皱缩豌豆的杂交实验中,有一个 $F_{1}$ 植株自交,得到43饱满:2皱缩,似乎很不符合3:1。以3:1为理论比例计算, $\chi^{2}=10.19,P<0.01$ 。这结果似乎与预期数差异“很显著”,是不是意味着这些结果不符合3:1呢?如果你一共只观察一个子代植株,得到43:2,则根据 $\chi^{2}$ 计算,P值的确太小,所以值得怀疑。但孟德尔这个实验一共观察了253个 $F_{1}$ 植株,则253中有一个如此大的偏差,就不很奇怪。相反,如果253个 $F_{1}$ 植株每株都极符合3:1的 $F_{2}$ 分离,那倒反而不符合理论分离比,应该被怀疑,为什么预期应有的偏差看不到,是否作者有意选择数据,把偏差较大的 $F_{2}$ 家系全部丢弃呢? 如果这样,这当然是一个非常不科学的做法。
科学工作者不是单凭 $\chi^{2}$ 测验来证明或否定一个假设的,应该根据重复实验、别种试验,以及科学上已有的别种论据来全面考虑。如果根据 $\chi^{2}$ 测验要否定一个假设,应该提出另一个假设,并做实验证明它。 $\chi^{2}$ 测验结果只是科学论据之一,仅此而已。
第四节 孟德尔遗传与人类疾病
人类的许多遗传性疾病的遗传方式遵循孟德尔定律,这类疾病被称为孟德尔遗传疾病(Mendelian disease),又称单基因病(single-gene diseases/monogenic disease),是指由一个基因的差异引起的遗传疾病。孟德尔遗传疾病有两个基本特征:①具有明确的显隐性关系;②后代有可预测的基因型和表型比例。但是,这里需要指出的是,尽管在孟德尔遗传分析中我们常说一个基因决定了一个性状,但生物的某一性状往往不是由单基因所决定的,而是一系列基因共同或相互作用的结果。研究者在考察某个性状决定基因的遗传方式时,是以其他基因相同或正常为前提条件,再进行目的基因的独立遗传分析的。
人类孟德尔遗传疾病的研究通过系谱分析(pedigree analysis)进行,即观察出现该疾病的家系中疾病的传递规律。系谱是根据遗传亲缘关系绘制出来的家族成员图谱。系谱分析常从先证者(propositus)入手,调查其所在家系成员的亲缘关系及疾病发生状况,按照一定格式绘制出图谱。先证者是指在家族中最先被发现具有某一特定性状或疾病的个体。常用的系谱符号见图2-14。
根据致病基因所在染色体及其突变类型,可以将人类孟德尔遗传疾病分为四大类,包括常染色体显性遗传(autosomal dominant inheritance)、常染色体隐性遗传(autosomal recessive inheritance)、X连锁显性遗传(X-linked dominant inheritance)和X连锁隐性遗传(X-linked recessive inheritance)。由于Y染色体较短,Y连锁的遗传(Y-linked inheritance)疾病较罕见。
一、常染色体显性遗传
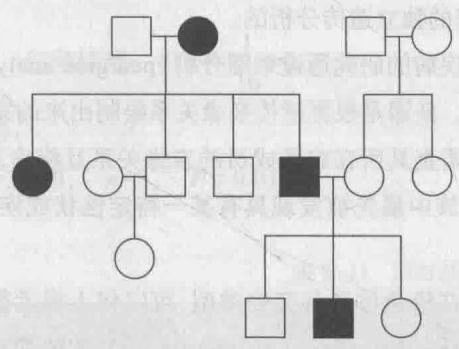
亨廷顿舞蹈病(Huntington’s disease, HD)最早是由美国医生 George Huntington 于 1872 年报道的。患者神经系统逐渐退化,神经冲动弥散,动作失调,出现不可控制的颤搐,并能发展成痴呆,甚至死亡。HD 高发于美洲和欧洲,中年发病居多。HD 的致病基因 HTT 位于 4 号染色体的短臂,杂合子和纯合子都患病,是典型的常染色体显性遗传病。研究发现 HTT 内部有一个三核苷酸(CAG)的串联重复,患者携带的突变基因内 CAG 的重复数目从正常人的 35 以下增加到 40 以上,且重复数越高的患者发病越早,症状越严重。图 2-15 给出了一个 HD 家庭的系谱图,从中我们可以总结出常染色体显性遗传病的基本遗传特征:①患者必然有一个亲代患病;②患者的同胞、子女中均有患病个体,且男女没有差别。
我们假设常染色体显性遗传疾病的致病基因为 H,正常等位基因为 h,一个患病父亲(Hh)和一个正常母亲(hh)生育的孩子中,50% 会患病(Hh),50% 表现正常(hh),且患病概率与性别无关(图 2-16)。除了 HD,
常见的人类常染色体显性遗传病还包括多囊肾病(polycystic kidney disease)、多发性家族性结肠息肉癌(hereditary nonpolyposis colorectal cancer)、马方综合征(Marfan syndrome)、多指/趾症(polydactyly)等疾病。
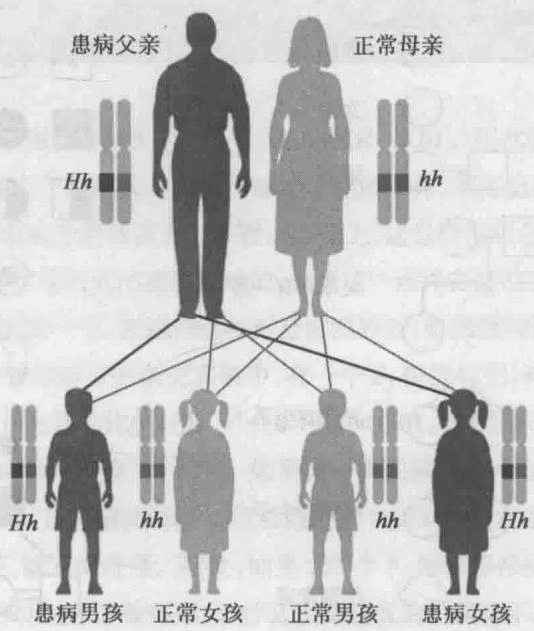
的遗传规律
患病男孩 携带者女孩 携带者男孩 正常女孩
二、常染色体隐性遗传
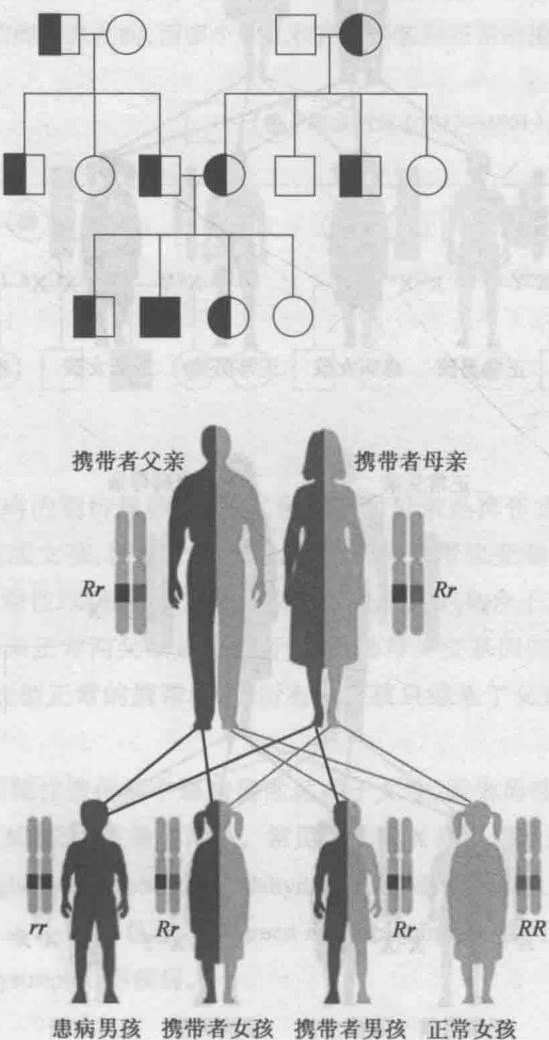
囊性纤维化(cystic fibrosis, CF)是白种人中最常见的致死性常染色体隐性遗传病, 患者会出现外分泌腺的功能紊乱, 黏液腺增生, 分泌液黏稠。不同器官病变程度不一, 主要见于肺、胰及肠道, 可发生慢性阻塞性肺病、胰功能不全及肝硬化, 并导致死亡。CF致病基因定位于7号染色体的长臂, 编码囊性纤维化穿膜传导调节蛋白(cystic fibrosis transmembrane conductance regulator, CFTR), 这是一个氯离子通道蛋白, 参与了氯离子的跨膜运输。常见CFTR编码基因的突变的是非移码的三核苷酸缺失, 导致CFTR第508位的苯丙氨酸缺失, 影响其正常转运功能。图2-17给出了一个CF家庭的系谱图, 患者的双亲都是CF突变基因的携带者, 他们表型正常。
我们假设常染色体隐性遗传疾病的致病基因为 r,正常等位基因为 R,一个携带者母亲 (Rr) 和一个携带者父亲 (Rr) 生育的孩子中,25% 会患病 (rr),50% 是表型正常的携带者 (Rr),还有 25% 是完全正常的个体 (RR)。常染色体隐性遗传疾病的特点是:不是每个世代都出现患者,而且患病概率在男女中没有差别(图 2-18)。除了 CF,常见的人类常染色体隐性遗传病还包括半乳糖血症 (galactosemia)、苯丙酮尿症 (phenylketonuria)、白化病 (albinism) 等疾病。
图2-17 一个CF家庭的家系图
三、X 连锁显性遗传
抗维生素D佝偻病(vitamin D resistant rickets)是一类肾小管遗传缺陷性疾病,常见的低血磷性抗维生素D佝偻病(hypophosphatemic rickets)属于X连锁显性遗传疾病。患者由于磷酸盐再吸收障碍,肾小管磷重吸收率明显降低,尿磷大量丢失,血磷降低。重症患者可表现为严重骨骼畸形、侏儒症、剧烈骨痛等。致病基因PHEX定位于X染色体短臂,编码产物参与磷酸盐、骨矿物质和维生素D的代谢。由于是显性遗传,所以不管男女,只要存在致病基因就会发病,但由于致病基因位于X染色体上,因此拥有两条X染色体的女性的发病率高于男性。图2-19和图2-20分别给出了父亲患病的家系和母亲患病的家系的系谱图(假设突变基因为C,正常基因为 $c$ 。当父亲患病而母亲正常时,所有的女孩因为继承了父亲携带突变基因的X染色体,都是患病者,而所有的男孩继承了父亲的Y染色体和母亲的任意一条正常X染色体,都是正常个体(图2-19)。当母亲患病而父亲正常时,情况则完全不同。母亲的两条X染色体会随机传递给男孩或女孩,因此无论男女,他们获得携带突变基因的X染色体的机会均为 $1 / 2$ ,有 $50%$ 的概率患病, $50%$ 的概率正常(图2-20)。常见的人类X连锁显性遗传疾病还包括遗传性肾炎(hereditary nephritis)、色素失调症(incontinentia pigmenti)等疾病。
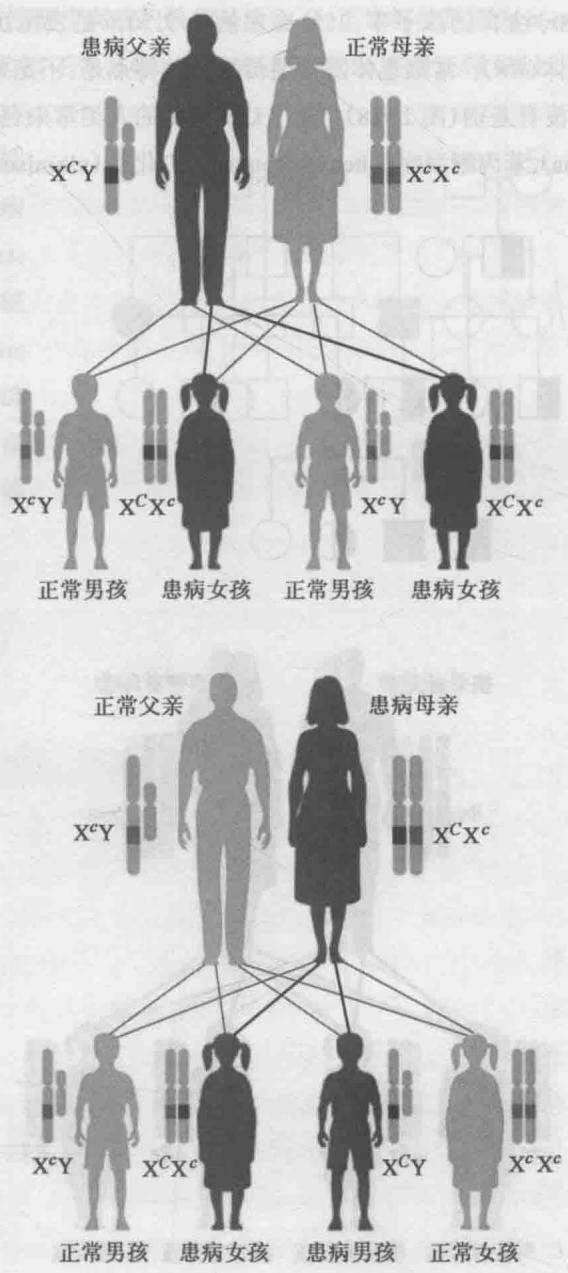
图 2-20 母亲为 X 连锁显性遗传病患者的遗传规律
四、X 连锁隐性遗传
血友病(hemophilia)属于一种先天性出血性疾病,患者常常自发性出血或某处破裂后流血不止,尤以关节腔、肌肉、皮下黏膜及泌尿系统最易出血,最后因流血过多而死亡。血友病的致病原因是凝血因子(blood clotting factor)基因突变导致人体内凝血因子水平降低或缺乏,从而导致出血。根据出现缺陷的凝血因子的不同,血友病主要分为甲型血友病(凝血因子VIII缺陷)和乙型血友病(凝血因子IX缺陷),两者的致病基因都定位于X染色体的长臂。
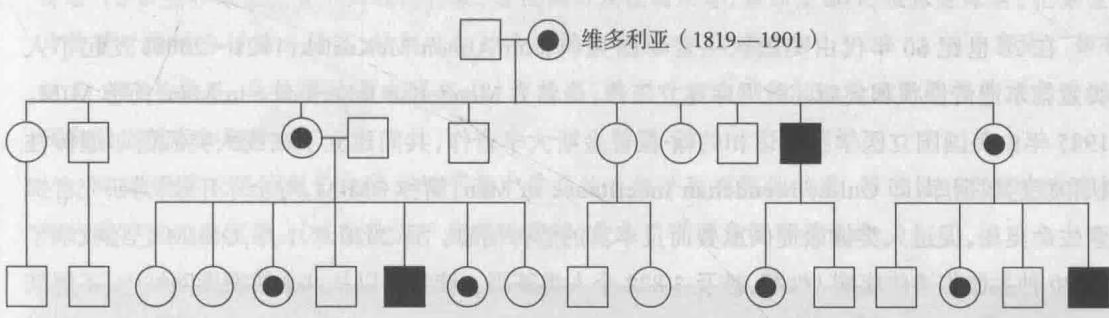
血友病最著名的一个例子是英国“皇家病”,英国皇室与欧洲贵族家庭的联姻导致了血友病在欧洲贵族中的蔓延。图2-21给出了系谱图,维多利亚女王是一个血友病致病基因的携带者,她的多个儿子和外孙均死于血友病,而多个女儿和孙女是表型正常的携带者。
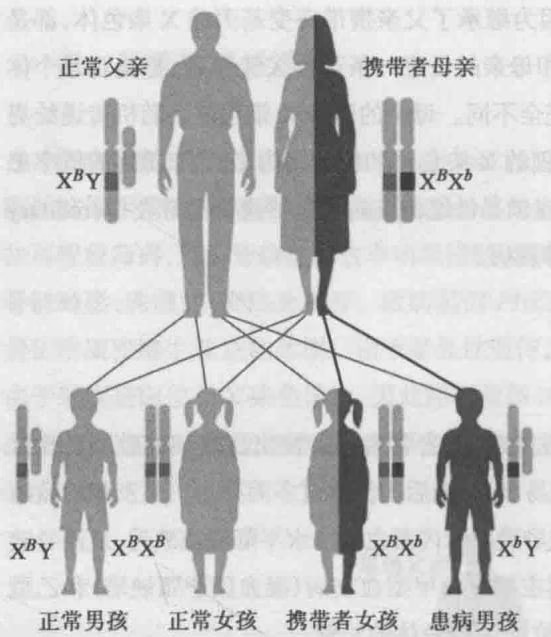
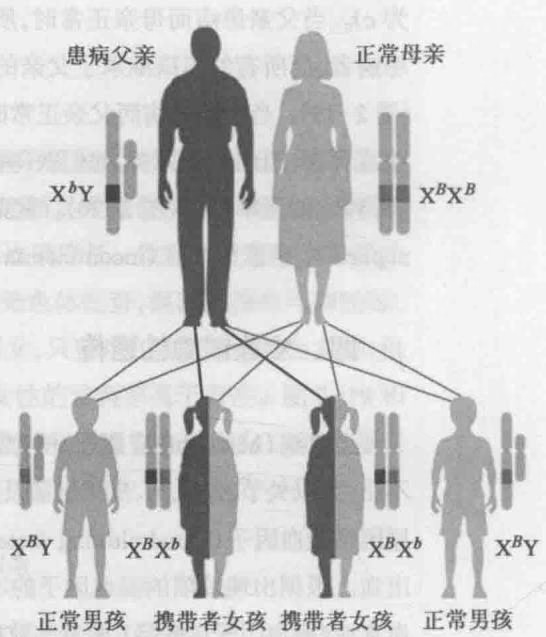
X 连锁隐性遗传病的遗传规律为: 当父亲正常而母亲是携带者时, 母亲的两条 X 染色体会随机传递给男孩或女孩, 因此无论男女, 他们获得携带突变基因的 X 染色体的机会均为 1/2, 但是又因为是隐性致病基因, 所有的女孩都是正常的杂合子, 而所有的男孩均为患病者 (图 2-22)。如果母亲正常而父亲是患病者, 父亲携带突变基因的 X 染色体就会传递给所有女孩, 使她们成为表型正常的携带者, 而所有的男孩只继承了父亲的 Y 染色体, 完全正常 (图 2-23)。
视频4单基因疾病的分类与特点
总的来说,X连锁隐性遗传病中患病男性远多于女性,因为男性只需要一条携带疾病基因的X染色体就会发病,而女性需要两条。常见的人类X连锁隐性遗传疾病还包括6-磷酸葡糖脱氢酶缺乏症(glucose-6-phosphate dehydrogenase deficiency)、无汗性外胚层发育不良症(ectodermal dysplasia I)、红绿色盲(red-green color blindness)、进行性假肥大性肌营养不良(Duchenne muscular dystrophy)等疾病。
五、人类孟德尔遗传性状和疾病数据库
在20世纪60年代由美国医生麦库西克(Victor Almon McKusick,1921—2008)发起了人类孟德尔遗传性状和疾病的数据库建立工作,命名为Mendelian Inheritance in Man,简称MIM。1985年由美国国立医学图书馆和约翰·霍普金斯大学合作,共同建立了在线人类孟德尔遗传性状和疾病数据库,即Online Mendelian Inheritance in Man,简称OMIM,对全球开放,为研究者探索生命奥秘,促进人类健康提供重要而且丰富的遗传信息。到2020年1月,OMIM已经收录了5520种孟德尔遗传疾病/性状,涉及3832个人类基因。读者可以从这个数据库网站中,了解其他人类孟德尔遗传疾病的致病机制、遗传特征等详细信息。
为什么分离现象比显、隐性现象更有重要意义?
在番茄中, 红果色(R)对黄果色(r)是显性, 问下列杂交可以产生哪些基因型, 哪些表现型, 它们的比例如何?
(1) RR \times rr (2) Rr \times rr (3) Rr \times Rr (4) Rr \times RR (5) rr \times rr下面是紫茉莉的几组杂交, 基因型和表型已写明。问它们产生杂种后代的基因型和表型怎样?
(1) Rr \times RR (2) rr \times Rr (3) Rr \times Rr 粉红 红色 白色 粉红 粉红 粉红在南瓜中,果实的白色(W)对黄色(w)是显性,果实盘状(D)对球状(d)是显性,这两对基因是自由组合的。问下列杂交可以产生哪些基因型,哪些表型,它们的比例如何?
(1) WWDD×wwdd (2) WwDd×wwdd (3) Wwdd×wwDd (4) Wwdd×WwDd在豌豆中,蔓茎(T)对矮茎(t)是显性,绿豆荚(G)对黄豆荚(g)是显性,圆种子(R)对皱种子(r)是显性。现在有下列两种杂交组合,问它们后代的表型如何?
(1) TTGgRr×ttGgrr (2) TtGgrr×ttGgrr
在番茄中, 缺刻叶和马铃薯叶是一对相对性状, 显性基因 $C$ 控制缺刻叶, 基因型 $cc$ 是马铃薯叶。紫茎和绿茎是另一对相对性状, 显性基因 $A$ 控制紫茎, 基因型 $aa$ 的植株是绿茎。把紫茎、马铃薯叶的纯合植株与绿茎、缺刻叶的纯合植株杂交, 在 $\mathrm{F}{2}$ 中得到 $9:3:3:1$ 的分离比。如果把 $\mathrm{F}{1}$ : (1) 与紫茎、马铃薯叶亲本回交; (2) 与绿茎、缺刻叶亲本回交; (3) 用双隐性植株测交时, 后代表型比例各如何?
根据第 6 题的题干内容分析下表中番茄的 5 组不同交配的结果, 写出每一交配中亲本植株的最可能的基因型。(这些数据不是实验资料, 是为了说明方便而假设的。)
| 亲本表型 | $F_1$ 数目 | |||
| 紫茎缺刻叶 | 紫茎马铃薯叶 | 绿茎缺刻叶 | 绿茎马铃薯叶 | |
| a. 紫茎缺刻叶×绿茎缺刻叶 | 321 | 101 | 310 | 107 |
| b. 紫茎缺刻叶×紫茎马铃薯叶 | 219 | 207 | 64 | 71 |
| c. 紫茎缺刻叶×绿茎缺刻叶 | 722 | 231 | 0 | 0 |
| d. 紫茎缺刻叶×绿茎马铃薯叶 | 404 | 0 | 387 | 0 |
| e. 紫茎马铃薯叶×绿茎缺刻叶 | 70 | 91 | 86 | 77 |
纯种的紫茎番茄植株(AA)与绿茎的番茄植株(aa)杂交, $F_{1}$ 植株是紫茎。 $F_{1}$ 植株与绿茎植株回交时,后代有482株是紫茎的,526株是绿茎的。问上述结果是否符合1:1的回交比例,用 $\chi^{2}$ 测验。
真实遗传的紫茎、缺刻叶植株(AACC)与真实遗传的绿茎、马铃薯叶植株(aacc)杂交, $F_{2}$ 结果如下:
紫茎缺刻叶 紫茎马铃薯叶 绿茎缺刻叶 绿茎马铃薯叶
247 90 83 34
问这两对基因是否是自由组合的?进行 $\chi^{2}$ 测验。
- 一个合子有两对同源染色体 A 和 A’ 及 B 和 B’, 在它的生长期间,
(1)你预测在体细胞中是下面的哪种组合:AA’BB, AABB’, AA’BB’, AABB, A’A’B’B’, 还是另有其他组合?
(2) 如果这个体成熟了, 你预期在配子中会得到下列哪些染色体组合: (a) AA’, AA, A’A’, BB’, BB, B’B’; (b) AA’, BB’; (c) A, A’, B, B’; (d) AB, AB’, A’B, A’B’; (e) AA’, AB’, A’B, BB’?
如果一个植株有 4 对基因是显性纯合的, 另一植株有相应的 4 对基因是隐性纯合的, 把这两个植株相互杂交, 问 $F_{2}$ 中表型和父本、母本完全相同的各有多少?
如果两对基因 A 和 a, B 和 b, 是独立分配的, 而且 A 对 a 是显性, B 对 b 是显性。
(1) 从 AaBb 个体中得到 AB 配子的概率是多少?
(2) AaBb 与 AaBb 杂交, 得到 AABB 合子的概率是多少?
(3) AaBb 与 AaBb 杂交, 得到 AB 表型的概率是多少?
- 遗传性共济失调 (hereditary ataxia) 的临床表型是四肢运动失调, 呐呆, 眼球震颤。本病有以显性方式遗传的, 也有以隐性方式遗传的。下面是本病患者的一个家系。你看哪一种遗传方式更可能? 请注明家系中各成员的基因型。如这病是由显性基因引起, 用符号 $A$ ; 如由隐性基因引起, 用符号 $a$ 。
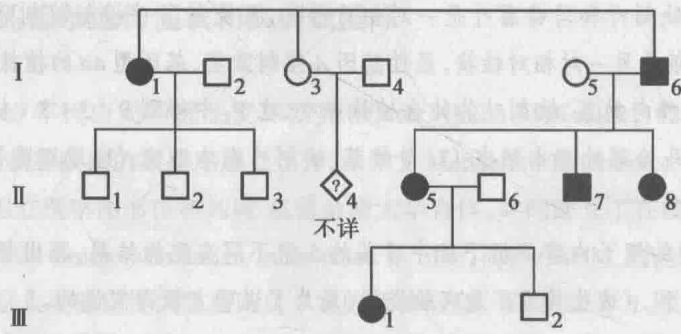
- 下面家系的个别成员患有极为罕见的病, 已知这病是以隐性方式遗传的, 假设患病个体的基因型是 aa。
(1) 注明 I-1, I-2, II-4, III-2, IV-1 和 V-1 的基因型。
(2) V-1 个体的弟弟是杂合子的概率是多少?
(3) V-1 个体的两个妹妹全是杂合子的概率是多少?
(4) 如果 V-1 与 V-5 结婚, 那么他们第一个孩子患病的概率是多少? 如果他们第一个孩子已经出生, 而且已知有病, 那么第二个孩子患病的概率是多少?
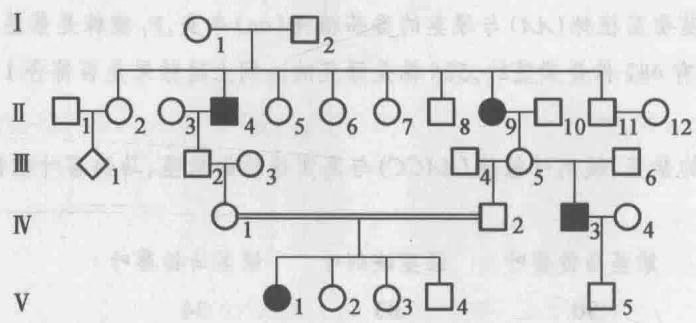
假设地球上每对夫妇在第一胎生了儿子后,就停止生孩子,性别比例将会有什么变化?
你认为孟德尔的豌豆杂交实验能够取得重大遗传发现的原因是什么?
判断以下 4 个家系中,遗传疾病最可能的遗传方式,并简述理由。
(1)
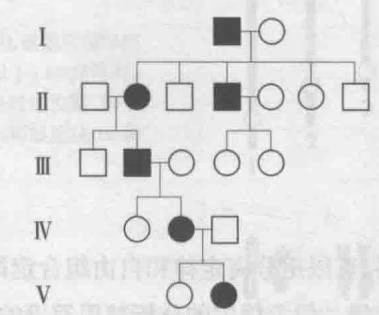
(2)
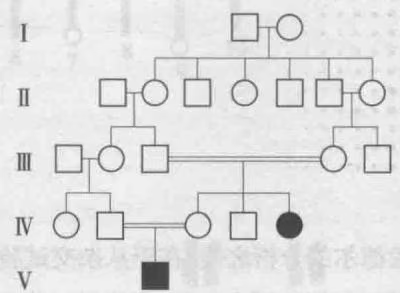
(3)
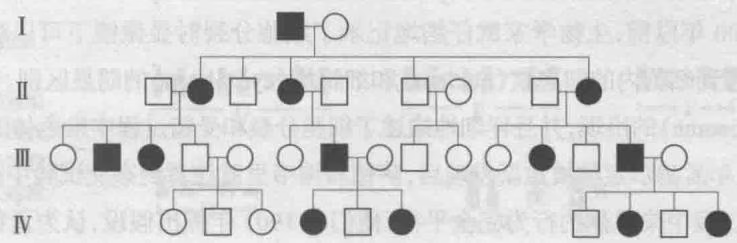
(4)
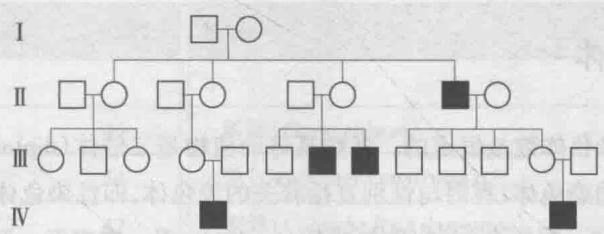
- 假设你在科研中遇到了一种新的疾病,尚无研究报道。
(1) 如何判定该疾病是遗传性的还是散发性的?
(2) 如何判定该疾病是孟德尔遗传还是非孟德尔遗传?
(3) 如果该疾病属于孟德尔遗传, 如何判定致病基因是显性还是隐性?
数字课程学习
在线自测 习题答案
第三章 遗传的染色体学说
孟德尔的分析之美,在于从杂交试验得到的资料,可以用分离定律和自由组合定律来说明;而且还可根据这两个定律,预测另一些杂交试验的结果。但孟德尔的分析都用假设的遗传因子来表示,没有谈到遗传因子的物质基础或遗传因子在细胞中的位置。尽管孟德尔定律在很多生物中得到证实,但下一个问题是:细胞中的什么结构可以和遗传因子,也就是基因相对应?
早在 1900 年以前,生物学家就仔细地记录了细胞分裂时显微镜下可以观察到的一系列变化。他们注意到细胞内的细胞核(nucleus)和细胞质(cytoplasm)的明显区别,也在分裂时看到染色体(chromosome)的出现,并且详细地描述了细胞分裂和受精过程中染色体的行为。
在 1900 年孟德尔定律被重新发现后,萨顿和博韦里就注意到杂交试验中基因的行为跟配子形成和受精过程中染色体的行为完全平行,他们在 1903 年提出假设,认为孟德尔假设的遗传因子在染色体上。为了更好地理解这个假设,我们先详细说明细胞分裂中的染色体行为。
第一节 染色体
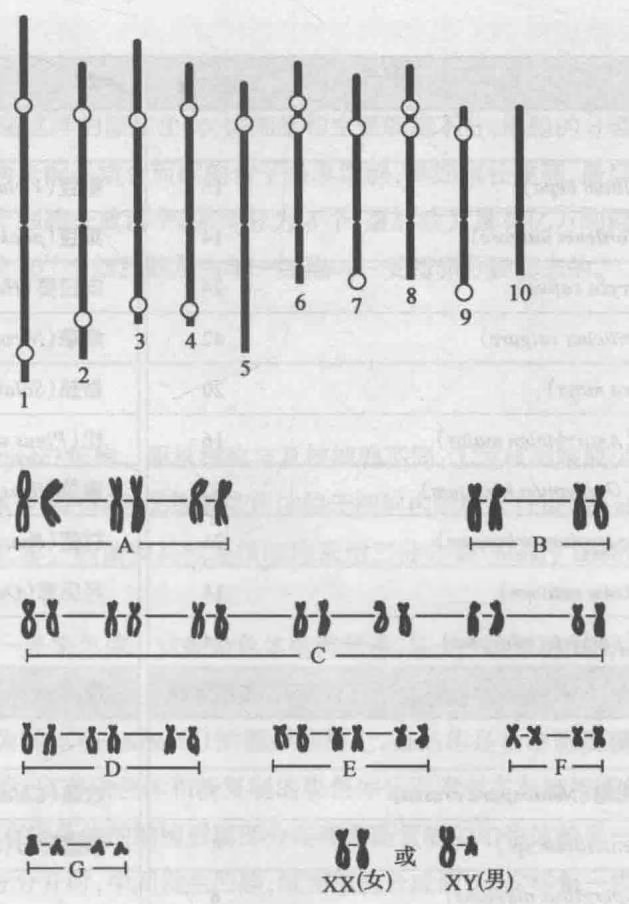
每种生物的染色体数是恒定的。多数高等动植物是二倍体(diploid),也就是说,每一体细胞中有两组同样的染色体(有时与性别直接有关的染色体,即性染色体,可以不完全相同)。亲本的每一配子带有一组染色体,叫作单倍体(haploid),用 $n$ 来表示。两个配子结合后,具有两组染色体,恢复成二倍体,用 $2n$ 表示。例如,玉米的二倍体染色体数是20( $2n = 20$ ),即有10对染色体(图3-1)。人的染色体数是46( $2n = 46$ ),即有23对染色体(图3-2)。但多数微生物的营养体是单倍体,例如,粗糙链孢霉的单倍体染色体数是7。表3-1把各种生物的染色体数择要列出。
染色体在复制以后, 含有纵向并列的两条姐妹染色单体 (sister chromatid), 只在着丝粒 (centromere) 区域仍连在一起。着丝粒在染色体上的位置是固定的。着丝粒把染色体分成长臂 (long arm) 和短臂 (short arm)。着丝粒的位置在染色体中间或中间附近时, 染色体两臂的长度差不多, 这种着丝粒叫作中间着丝粒或亚中间着丝粒。着丝粒的位置靠近染色体的一端时, 根据着丝粒离开端部的远近, 分为近端部着丝粒和端部着丝粒。着丝粒所在的地方往往表现为一个缢痕, 所以着丝粒又称初级缢痕 (primary constriction)。
有些染色体上除了初级缢痕以外,还有一个次级缢痕(secondary constriction),连上一个叫作
图3-1 玉米染色体的模式图
玉米的染色体共10对 $(2n=20)$ ,这里只画每对中的一条,共10条,分别给以1~10的号码。根据染色体的相对长度、着丝粒的位置、核仁形成区的有无和结节的分布,可以把这10条染色体相互区分开来。
图 3-2 正常人体细胞的中期染色体模式图
每对染色体含有两条同源染色体,每条同源染色体含有两条染色单体,经着丝粒连接。根据染色体的相对长度和着丝粒位置,把染色体顺序地排成23对,共8组。A~G组是22对常染色体,标有X和Y的是一对性染色体。
| 生物 | 二倍体数 | 生物 | 二倍体数 |
|---|---|---|---|
| 动物 | |||
| 人(Homo sapiens) | 46 | 豚鼠(Cavia cobaya) | 64 |
| 川金丝猴(Rhinopithecus roxellanae) | 44 | 兔(Oryctolagus cuniculus) | 44 |
| 猕猴(Macaca malatta) | 42 | 家鸽(Columba livia domestica) | 约80 |
| 黄牛(Bos taurus) | 60 | 鸡(Gallus domesticus) | 约78 |
| 猪(Sus scrofa) | 40 | 火鸡(Meleagris gallopavo) | 约80 |
| 狗(Canis familiaris) | 78 | 鸭(Anas platyrhyncho) | 约80 |
| 猫(Felis domesticus) | 38 | 家蚕(Bombyx mori) | 56 |
| 马(Equus calibus) | 64 | 家蝇(Musca domestica) | 12 |
| 驴(Equus asinus) | 62 | 果蝇(Drosophila melanogaster) | 8 |
| 山羊(Capara hircus) | 60 | 蜜蜂(Apis mellifera) | 32♀,16♂ |
| 绵羊(Ovis aries) | 54 | 蚊(Culex pipiens) | 6 |
| 小家鼠(Mus musculus) | 40 | 佛蝗(Phlaeoba infumata) | 24♀,23♂ |
| 大家鼠(Rattus norvegicus) | 42 | 淡水水螅(Hydra vulgaris) | 32 |
| 水貂(Mustela vison)植物 | 30 | ||
| 洋葱(Allium cepa) | 16 | 蚕豆(Vicia faba) | 12 |
| 大麦(Hordeum uulgare) | 14 | 菜豆(phaseolus vulgaris) | 22 |
| 水稻(Oryza sativa) | 24 | 向日葵(Helianthus annuus) | 34 |
| 小麦(Triticum vulgare) | 42 | 烟草(Nicotiana tabacum) | 48 |
| 玉米(Zea mays) | 20 | 番茄(Solanum lycopersicum) | 24 |
| 金鱼草(Antirrhinum majus) | 16 | 松(Pinus sp.) | 24 |
| 陆地棉(Gossypium hirsutum) | 52 | 青菜(Brassica chinensis) | 20 |
| 中棉(Gossypium arboreum) | 26 | 甘蓝(Brassica oleracea) | 18 |
| 豌豆(Pisum sativum) | 14 | 月见草(Oenothera biennis) | 14 |
| 香豌豆(Lathyrus odoratus) | 14 | ||
| 生物 | 单倍体数 | 生物 | 单倍体数 |
| 微生物 | |||
| 粗糙链孢霉(Neurospora crassa) | 7 | 衣藻(Chlamydomonas reinhardi) | 16 |
| 青霉(Penicillium sp.) | 4 | 酿酒酵母(Saccharomyces cerevisiae) | 17 |
| 曲霉(Aspergillus nidulans) | 8 |
随体(satellite)的远端染色体小段。次级缢痕的位置也是固定的。在细胞分裂将结束时,核内出现一个到几个核仁,核仁总是出现在次级缢痕的地方,所以次级缢痕也叫作核仁形成区(nucleolar organizer)(图3-3)。
真核生物的染色体主要由DNA和蛋白质组成。在蛋白质分子的作用下,DNA被包装成染色体的结构(图3-4),储藏在狭小的细胞核中。关于真核生物DNA的包装过程,我们将留到基因组一章进行详细介绍。
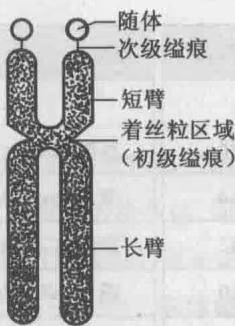
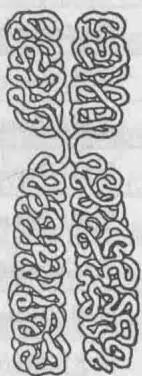
图3-3 染色体模式图
每一中期染色体有两染色单体,中间相连的地方是初级缢痕,也就是着丝粒区域。这个染色体还有一个次级缢痕,通常就是核仁形成区。
图3-4 染色体显微结构的模式图
每一染色单体是一条重复地折叠着的 DNA-蛋白质纤丝。在着丝粒区域,两染色单体的纤丝并合在一起。
第二节 细胞分裂
细胞靠分裂而增殖。像细菌这样的原核生物,体细胞和生殖细胞不分,细胞的分裂就是个体的繁衍。而在高等生物中,由两个配子结合而成的合子是单细胞,单细胞长成胚,最后长成一个成熟的个体的过程,就是由一个细胞分成两个,两个分为4个,最后成为具有亿万细胞的个体的过程。也就是说,成人身体内的 $10^{14}$ 个细胞就是由单一细胞——受精卵分裂而来的。
一、细菌的二分分裂
细菌属于原核生物(prokaryote)细胞。原核细胞与真核细胞不同:①原核细胞缺少某些细胞器,如真核细胞中含有的线粒体、叶绿体等;②细菌染色体位于细胞内的核区(nuclear area)中,核区外面没有核膜,所以有原核之称。细菌和其他原核细胞采用二分分裂(binary fission)的方式实现增殖。
每一原核细胞中通常只有一条染色体。这条染色体结构简单,是一个裸露的 DNA 分子。有时单一细菌细胞中可以含有两条或两条以上的染色体,但位于各自核区中。利用电子显微镜观察,细菌染色体附着在一个称为间体(mesomere)的圆形结构上,该结构是由细胞质膜内陷而成的(图 3-5)。染色体一分为二后,原有染色体和新复制的染色体分别附着在与膜相连的间体上。细菌分裂时,细胞延长,带着原有染色体的细胞质膜部分与带着新复制的染色体的另一细胞质膜部分彼此远离,当两染色体充分分开时,中间发生凹陷,细菌细胞分成两个,这样每一染色体分别处在两个细胞中。
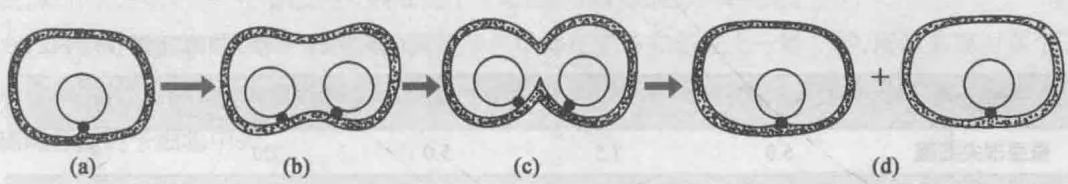
细菌染色体附着在称作间体的细胞质膜陷入部分。(a)单一染色体附着在细胞质膜间体上。(b)染色体复制,两子染色体(daughter chromosome)分别附着在间体上,两间体间的细胞质膜延伸。(c)每一染色体进入一个子细胞(daughter cell)。(d)形成两个子细菌,各有一染色体附着在细胞质膜间体上。
二、真核细胞的有丝分裂
真核细胞的增殖是通过有丝分裂(mitosis)来完成的。有丝分裂的结果是把一个细胞的整套染色体均等地分向两个子细胞,所以新形成的两个子细胞在遗传物质上与原来的细胞相同。有丝分裂可分为两个时相,即分裂间期(interphase)和有丝分裂期(mitotic phase, M 期)。
(1) 分裂间期 我们通常讲的细胞核的形态和结构, 都是指的间期核。间期是指两次分裂的中间时期。间期时细胞核中一般看不到染色体结构, 这时细胞核在生长增大, 代谢很旺盛, 贮备了细胞分裂时所需的物质。很多实验证明, DNA 在间期进行复制合成, 由原来的一条成为两条并列的染色单体。间期又可细分为三个时期, 即合成前期 (gap 1 phase, $G_{1}$ 期), 这时细胞代谢旺盛, 不断生长, 但 DNA 没有开始合成; 进入合成期 (synthetic phase, S 期) 时 DNA 才开始合成, 为细胞分裂做准备; 然后是合成后期 (gap 2 phase, $G_{2}$ 期), 细胞继续生长, 同时进行蛋白质合成, 完成分裂前的其他准备 (图 3-6)。有丝分裂各个时期的长短因各种生物而不同 (表 3-2), 如蚕豆 (Vicia faba) 的根尖细胞, 合成前期是 $5.0 \mathrm{h}$ , 合成期是 $7.5 \mathrm{h}$ , 合成后期是 $5.0 \mathrm{h}$ , 间期总长 $17.5 \mathrm{h}$ , 而人的骨髓细胞的间期达 $40 \sim 50 \mathrm{~h}$ 。
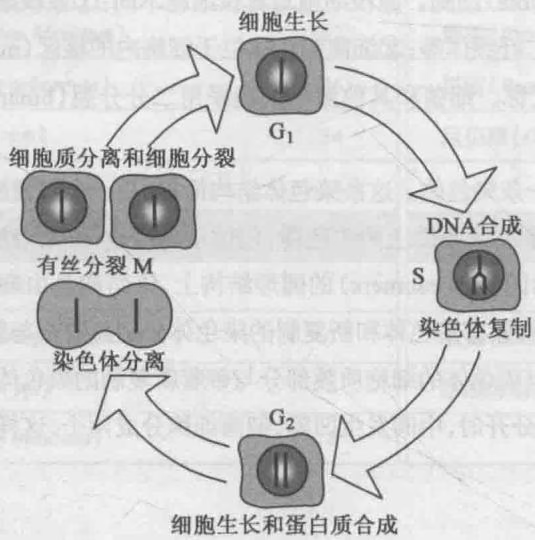
真核细胞的有丝分裂可分为 $G_{1}$ 期(细胞生长)、S期(DNA合成)、 $G_{2}$ 期(蛋白质合成)及M期(染色体分离及细胞质分离)四个时期。前三个时期属于分裂间期。
表 3-2 几种生物的细胞周期(单位:h)
| 细胞类型 | $G_1$ | S | $G_2$ | M | 合计 |
|---|---|---|---|---|---|
| 蚕豆根尖细胞 | 5.0 | 7.5 | 5.0 | 2.0 | 19.5 |
| 小家鼠L细胞 | 9~11 | 6~7 | 2~4 | 1 | 18~23 |
| 人骨髓细胞 | 25~30 | 12~15 | 3~4 | 2 | 42~51 |
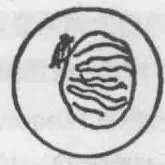
间期结束后,进入有丝分裂期(图3-7)。有丝分裂期又分为前期、前中期、中期、后期、末期。
(2) 前期 (prophase) 核内的染色质细丝开始螺旋化, 染色体缩短变粗。染色体逐渐清晰起来, 着丝粒区域也变得相当清楚。每一染色体含有纵向并列的两条染色单体。在动物和低等植物细胞中, 中心体参与纺锤体 (spindle) 的组装。在分裂间期, 中心体也完成复制, 一分为二。在分裂前期, 两个中心体分开, 向细胞两极分开移动。此时, 微管 (microtubule) 也从中心体辐射出来。高等植物细胞内看不到中心体, 但仍可看到纺锤体的出现。
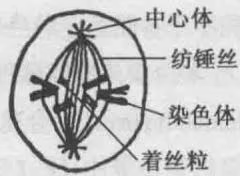
(3) 前中期 (early metaphase, prometaphase) 核仁消失, 核膜崩解。中心体到达细胞两极, 由中心体发出的纺锤体微管捕获到染色体的着丝粒并与之结合, 完成纺锤体的组装。此时的染色体散乱分布在纺锤体中部。
图 3-7 有丝分裂图解
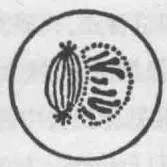
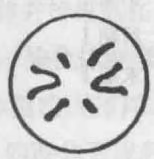
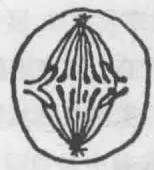
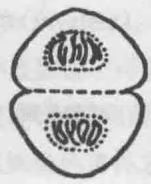
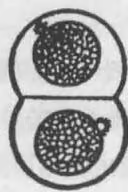
(a)间期:不分裂的细胞。(b)前期:染色体出现,呈细线状,中心体分开。(c)前中期:染色体缩短变粗,核膜将近消失,纺锤体形成。(d)中期:核膜消失,染色体排列在赤道面上。(e)中期(极面观)。(f)后期:并列的两染色单体分别向两极移动。(g)末期:染色体到达两极。核膜渐次出现,胞质分割。(h)核进入休止状态,胞质分割将近完成,一个细胞分裂为两个子细胞,子细胞的染色体数目跟原来细胞一样。
(a)
(b)
(c)
(d)
(e)
(f)
(g)
(h)
(4) 中期 (metaphase) 染色体向赤道面移动, 着丝粒区域排列在赤道面上。此时计算染色体数目最为容易 (图 3-7d, e)。
(5) 后期 (anaphase) 每一染色体的着丝粒一分为二, 相互分离。着丝粒分开后, 即被纺锤丝拉向两极, 相连的染色单体也跟着分开, 分别向两极移动。
(6) 末期(telophase) 染色体到达两极,染色体的螺旋结构逐渐消失,另一方面又出现核的重建过程。这正是前期的倒转。最后两个子核的膜重新形成,核仁重新出现,纺锤体也跟着消失。
分裂期所需的时间,也随生物的种类而异。如蚕豆根尖细胞的分裂期约需2 h。
(7) 胞质分裂(cytokinesis) 两个子核形成后, 接着便发生细胞质的分裂过程。动物细胞在赤道区域收缩, 以后收缩深化, 最后将细胞分成两个。植物细胞在两个子核的中间区域形成细胞板, 最后成为细胞壁, 将母细胞分隔成两个子细胞。这样细胞分裂结束。
有丝分裂前期时,每个染色体的两条染色单体在形态和组成上一模一样,所以末期时两个子细胞内的染色体在数目和形态上也完全一样。由于这个缘故,有丝分裂保证了细胞内染色体精确地分配到子细胞中去。
三、减数分裂
减数分裂是一种特殊的真核细胞的细胞分裂方式,在配子形成过程中发生。这一过程的特点是,连续进行两次核分裂,而染色体只复制一次,结果形成4个核,每个核只含有单倍数的染色体(n),即染色体数减少一半,所以叫作减数分裂(meiosis)。另外一个特点是,前期特别长,而且变化复杂,其中包括同源染色体的配对、交换与分离等。两个配子(n)结合成合子后,染色体数恢复为2n。
整个过程可分为下列几个时期:
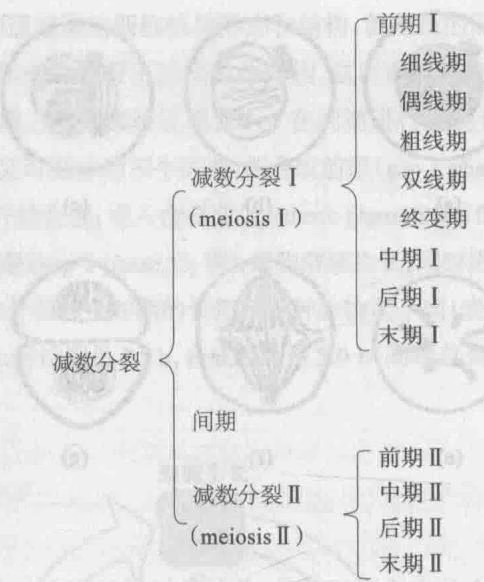
(1)细线期(leptotene) 第一次分裂开始时,染色质浓缩为几条细而长的细线,但相互间往往难以区分。虽然染色体已在间期时复制,每一染色体已含有两染色单体,但在细线期的染色体上还看不出双重性。
(2) 偶线期 (zygotene) 染色体的形态与细线期没有多大变化。两条相同染色体, 即同源染
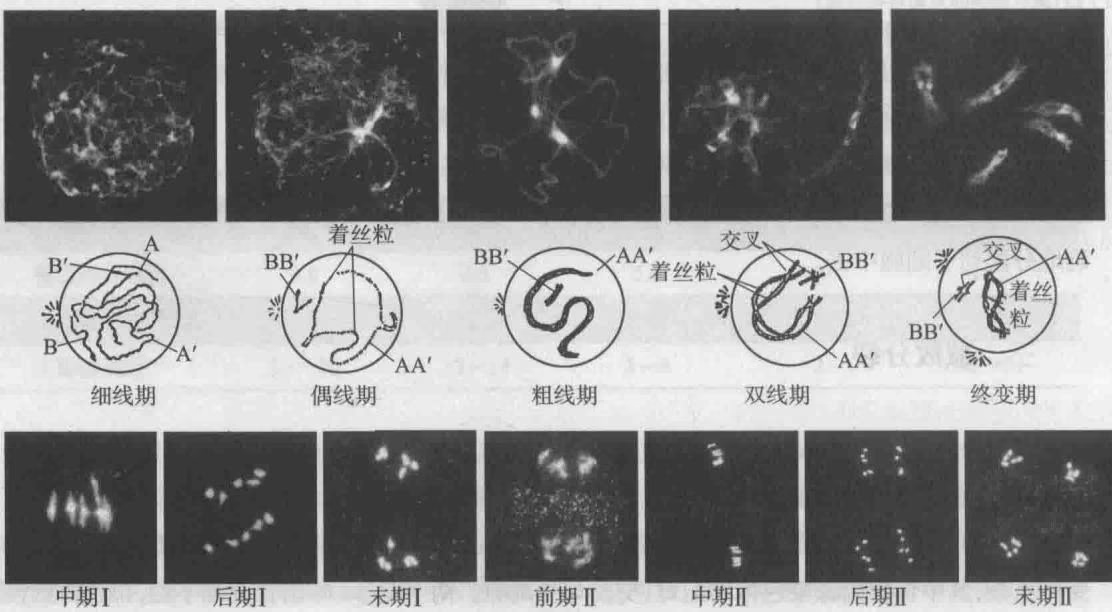
照片显示的是拟南芥花粉母细胞在减数分裂各个阶段经DAPI染色后的染色体形态(引自Wang等,2014)。示意图所示的是减数分裂前期I的五个阶段,以含有同源染色体 $\mathrm{AA}^{\prime}$ 和 $\mathrm{BB}^{\prime}$ 的细胞 $(2n = 4)$ 为例。
色体(homologous chromosomes)开始配对,在两端先行靠拢配对,或者在染色体全长的各个不同部位开始配对。这种配对是专一性的,只有同源染色体才会配对,配对最后扩展到整条染色体上。两条同源染色体的配对过程被称为联会(synapsis)。联合过程中会出现联会复合体(synaptonemal complex),包括两个侧体(lateral element)和一个中体(central element)(图3-9),主要由蛋白质组成。该结构到双线期和终变期时消失,它的形成可能与同源染色体配对和染色体交换有关。完成联会后,两条同源染色体并排排列在一起,被称为双价体(bivalent)。
(3) 粗线期 (pachytene) 染色体继续缩短变粗。在光学显微镜下可以看到, 这一时期的每条染色体由两条姐妹染色单体组成, 它们在着丝粒处相连。这样, 每对同源染色体由 4 条染色单体组成, 称为四联体 (tetrad)。四联体形成后, 四联体中的非姐妹染色单体之间可以发生交换, 彼此间互换相等的染色体区段。这种交换以联会复合体为中介, 可以改变单倍染色体组的遗传信息, 是生物进化中遗传变异的重要来源。我们将在连锁与交换一章中详细讨论这种交换的遗传效应。
(4) 双线期 (diplotene) 双价体中的两条同源染色体开始分开, 但分开又不完全, 并不形成两个独立的单价体, 而是在两个同源染色体之间的若干处发生交叉 (chiasmata) 并相互连接。交叉是染色单体发生交换 (crossing over) 的场所 (图 3-10)。
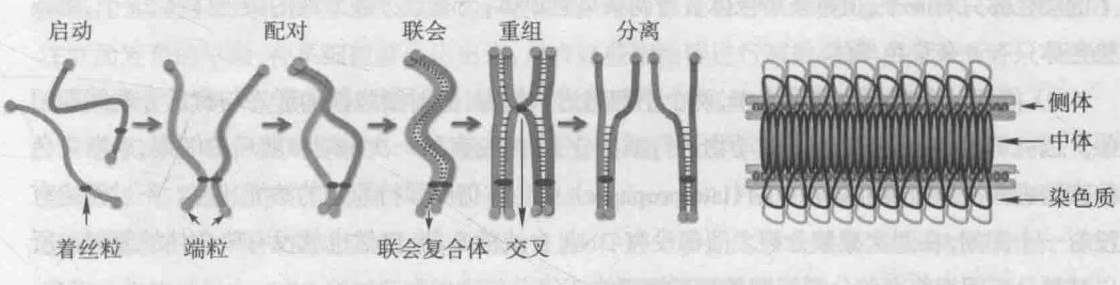
(a)
(b)
图 3-9 联会过程与联会复合体
(a) 同源染色体在减数分裂前期同源染色体互作的全过程。(b) 联会复合体由两个侧体和一个中体组成(引自 Wang 等, 2014)。
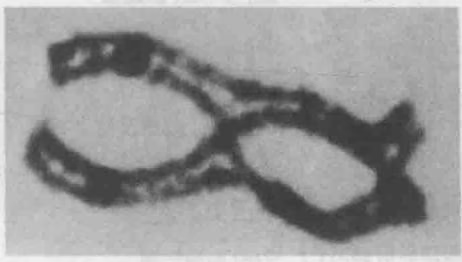
(a)
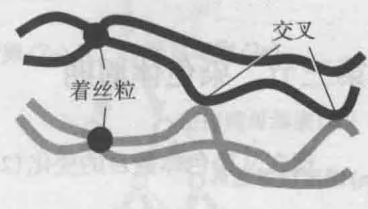
(b)
图3-10 同源染色体之间的交叉
(a) 显微镜下的同源染色体与交叉。(b) 同源染色体与交叉的模式图。
在双线期中,交叉数目逐渐减少,在着丝粒两侧的交叉向两端移动。这个现象称为交叉端化(terminalization of chiasmata),或简称端化。同时,染色体也跟着缩短变粗,螺旋化程度加深。
(5) 终变期 (diakinesis) 两条同源染色体仍有交叉联系着, 所以仍为 $n$ 个双价体。染色体变得更为粗短, 螺旋化达到最高, 以致有时染色体中的染色单体都看不清了。交叉的端化仍旧继续进行。这时核仁和核膜开始消失, 双价体开始向赤道面移动, 纺锤体开始形成。分裂进入中期 I 。
(6) 中期 I 各个双价体排列在赤道面上。纺锤体形成,纺锤丝把着丝粒连向两极。两个同源染色体上的着丝粒逐渐远离,双价体开始分离,但仍有交叉联系着,不过交叉数目已大为减少,一般都移向端部。
(7) 后期 I 双价体中的两条同源染色体分开, 分别向两极移动, 每一染色体有两染色单体, 在着丝粒区相连 (相当于有丝分裂前期的一条染色体)。这样, 细胞两极得到 $n$ 条染色体, 所以说在后期 I 时染色体发生减数了。至于双价体中哪一条染色体移向哪一极, 则完全是随机的。
(8) 末期 I 核膜重建,核仁重新形成,接着进行胞质分裂,成为两个子细胞。染色体渐渐解开螺旋,纤丝折叠程度降低,又变成细丝状。这里要注意到,末期 I 与有丝分裂末期的区别:末期 I 的染色体只有 n 个,但每条染色体含有两条染色单体,而有丝分裂末期的染色体有 2n 个,每条染色体只有一条染色单体。
(9) 间期 在第一次分裂之末,两个子细胞进入间期,这时细胞核的形态与有丝分裂间期相似。但有许多生物,例如大多数动物进行减数分裂时,没有第一次末期和随后的间期,后期染色体直接进入减数分裂Ⅱ的晚前期(late prophase),染色体仍旧保持原来的浓缩状态。不过无论有没有一个间期,在两次减数分裂之间都没有DNA合成的S期,自然也就没有染色体的复制。所以减数分裂间期跟有丝分裂间期是很不相同的。
(10)前期Ⅱ 前期Ⅱ的情况完全和有丝分裂前期一样,也是每一染色体具有两条染色单体,所不同的是只有 n 条染色体罢了。
(11)中期Ⅱ—末期Ⅱ 它们的过程完全和有丝分裂一样,因此不再细述。所不同的就是染色体数目在第一次分裂过程中已经减半,所以第二次分裂时只有 n 条染色体。
一次减数分裂形成 4 个子细胞, 因为细胞分裂两次, 染色体只复制一次, 每个子细胞中只有 n 条染色体。
第三节 染色体周期
现在从染色体数目的变化 $(2n \rightleftharpoons n)$ 来看生物个体的生活史。
一、动物的生活史
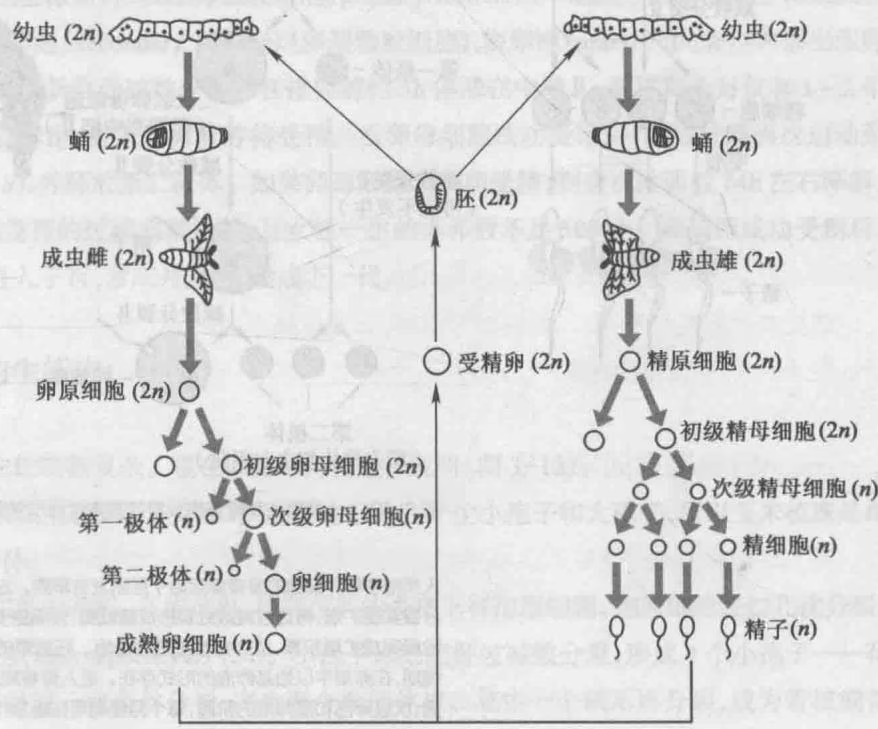
多细胞动物在雄性性腺(即睾丸)中有精原细胞(spermatogonium),在雌性性腺(即卵巢)中有卵原细胞(oogonium),它们的染色体数目与体细胞一样,因为它们也是通过有丝分裂而产生的。精原细胞和卵原细胞经过多次有丝分裂后停止分裂,开始长大,分别成为初级母细胞,在雄性称为初级精母细胞(primary spermatocyte),在雌性称为初级卵母细胞(primary oocyte)。
初级精母细胞(2n)通过减数分裂Ⅰ而产生两个次级精母细胞(secondary spermatocyte)(n),再通过减数分裂Ⅱ而产生4个精细胞(spermatid)(n)。精细胞通过一系列的变化,包括细胞质和细胞器的变化,细胞核不再变化而形成精子,这个过程叫作精子形成(spermatogenesis)。
初级卵母细胞(2n)经过第一次分裂,产生两个细胞,它们在体积上大小悬殊,大的叫作次级卵母细胞(secondary oocyte)(n),小的叫作第一极体(first polar body)(n)。次级卵母细胞再经过一次分裂,也产生两个大小悬殊的细胞,大的叫卵细胞(n),小的叫第二极体(second polar body)(n)。第一极体有再分裂一次的,也有不分裂的,跟第二极体一起都退化了。所以每个初级卵母细胞经过减数分裂,只产生一个有效的配子——卵细胞(n)。
在受精时,精子进入卵细胞内,使卵细胞成为受精卵,也就是合子。精子的细胞核和卵细胞的核融合,成为合子的细胞核。精细胞核内的单倍体染色体数和卵细胞核内的单倍体染色体数相加而成为合子核内的二倍体染色体数。合子经过有丝分裂而产生下一代个体的体细胞,这些细胞也都是二倍体。
有了上面这些说明,我们先用家蚕(Bombyx mori)为例简要介绍动物的生活史(图3-11)。家蚕的性细胞形成和受精过程和其他多数动物一样,都是由种系细胞(germ-line cell)完成的。在胚胎发育的早期,种系细胞就分化出来,只有这些细胞能进行减数分裂,并形成配子。但是这种可能性的实现一定要在身体的体细胞部分经过无数次的有丝分裂后达到成熟的时候。
我们再详细介绍人类精子、卵细胞的形成过程(图3-12)。在人类胚胎发育的第2周,外胚层中部分细胞分化形成原始生殖细胞(primordial germ cell, PGC),它们在胚胎发育第4周迁移至卵黄囊,在第5周末到达正在发育的原始性腺,并进一步分化形成卵原细胞或精原细胞。在迁移和分化的过程中,PGC通过旺盛的有丝分裂不断增加细胞数量。
图 3-11 动物生活史(以家蚕为例)
精原细胞经过减数分裂,形成4个精子。卵原细胞经过减数分裂,只形成一个有功能的卵细胞。精子和卵细胞的染色体数都是n,卵细胞受精后,形成二倍体合子,染色体数是2n。
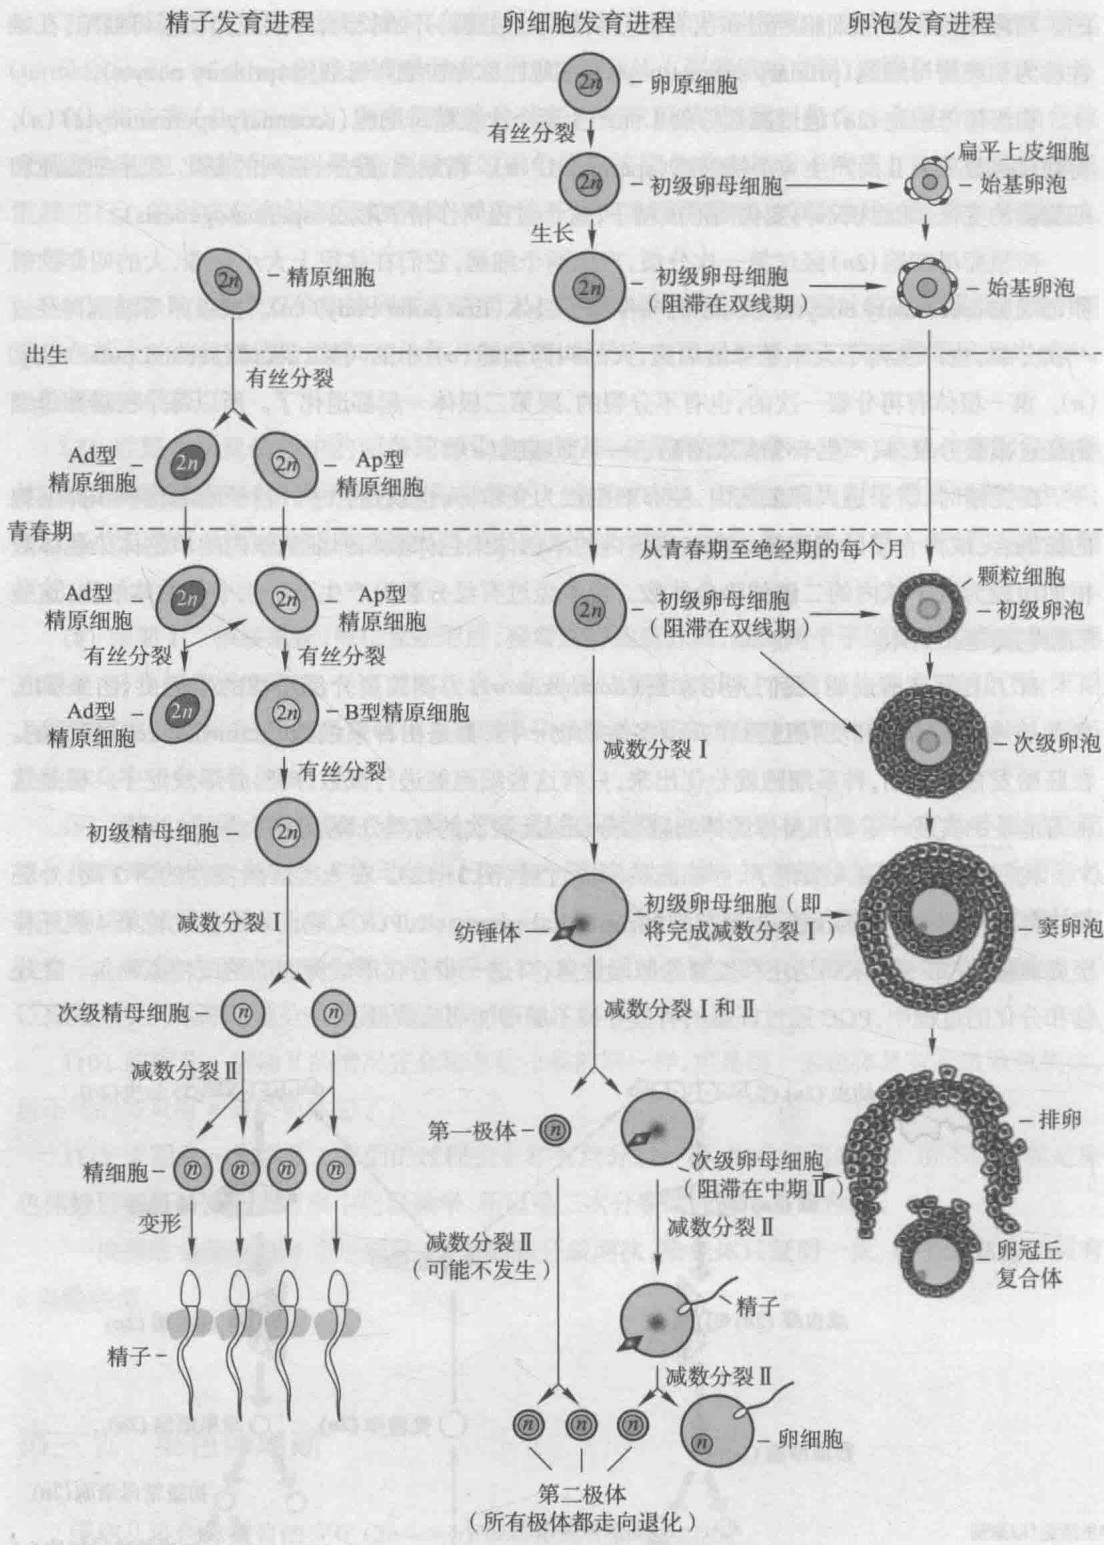
人类精子和卵细胞的发育都起始于胚胎发育早期。左图:精原细胞进入青春期后先通过有丝分裂实现扩增,再通过减数分裂形成精细胞,精细胞变形后成为精子。右图:卵原细胞在胚胎阶段完成扩增积累,成为女性生殖储备池。胚胎期的卵原细胞已进入减数分裂Ⅰ,停滞在双线期,在卵巢中以始基卵泡的形式存在。进入青春期后,始基卵泡自主发育,依次经过初级卵泡、次级卵泡和窦卵泡的阶段,每个月经周期在激素作用下实现排卵。在这个发育的过程中,减数分裂继续进行,在排卵期卵母细胞停留在中期Ⅱ,直至成功受精后完成全部减数分裂。
XY型胚胎中精原细胞发育分化为成熟精子的过程与XX型胚胎中卵原细胞分化为成熟卵细胞的过程截然不同(图3-12)。在XY胚胎时期,PGC迁移至原始性腺后持续进行旺盛的有丝分裂并分化为精原细胞。胎儿出生后2个月左右,精原细胞分化形成两种精原干细胞(spermatogonial stem cell, SSC)(2n):核染色深暗的Ad型精原细胞(dark type A spermatogonia)(2n)和核染色浅淡的Ap型精原细胞(pale type A spermatogonia)(2n),它们都被包裹在曲细精管壁外围的基底层中。进入青春期后,Ap型精原细胞能够通过多次有丝分裂形成B型精原细胞(type B spermatogonium)(2n),后者再经有丝分裂形成初级精母细胞(2n),并连续经过减数分裂I、II形成精细胞(n),并在进入曲细精管的中央腔前完成变态过程,形成可以游动的成熟精子(sperm)。Ad型精原细胞通过有丝分裂不断形成新的Ad型精原细胞和Ap型精原细胞,维持精原干细胞的数量。对于一个健康成年男性,从精原干细胞发育至精子的全过程为48~64天,且每天可以产生0.45亿~2亿个成熟精子。成熟精子经阴道进入女性体内后停留在输卵管的峡部,待女性排卵后游向输卵管壶腹部,并经历精子获能(capacitation)和顶体反应(acrosome reaction)后才能与卵细胞结合得到受精卵(2n)。
对于一个 XX 型胚胎,从卵原细胞分化形成成熟卵细胞则需要至少十余年的时间。从胚胎发育第 3 个月开始,卵原细胞在分裂增殖的同时进一步分化:一些卵原细胞分化成为初级卵母细胞(2n),并进入减数第一次分裂的前期。在胚胎发育第 5 个月,卵巢中卵原细胞数量达到最大,约 700 万个。与此同时,细胞死亡也逐渐开始,大量卵原细胞和初级卵母细胞走向闭锁(atretic)。在胚胎发育第 7 个月,存活的初级卵母细胞全部进入减数分裂 I 的前期。胎儿出生前后,每个初级卵母细胞均被单层扁平上皮细胞包围,形成相互独立的原始卵泡(primordial follicle),数量为 70 万~200 万个,它们构成了卵巢的生殖储备池。在卵母细胞成熟抑制剂(oocyte maturation inhibitor,OMI)的作用下,所有卵母细胞发育停滞在双线期直至排卵。
女性出生后,大多数始基卵泡在个体发育过程中继续走向闭锁。青春期开始后,每个月有15~20个原始卵泡被激活,依次经历初级卵泡(primary follicle)(单层扁平上皮细胞分化成立方形颗粒细胞)、次级卵泡(secondary follicle)(多层颗粒细胞)、窦卵泡(antral follicle)(内部出现卵泡腔)的发育阶段,重新启动减数分裂并在排卵前约3h停滞在中期Ⅱ,最终每个月仅有1~2个成熟的卵母细胞被排出,进入输卵管等待受精。当卵母细胞成功受精后,减数分裂再次启动形成成熟的卵细胞(n),并释放第二极体。如果卵母细胞未成功受精,则会在排卵后24h左右降解。可见,人类卵细胞发育的过程非常漫长,且女性一生的排卵数不足500个。卵细胞成功受精后,受精卵经输卵管进入子宫,着床并发育,形成下一代。
二、植物的生活史
植物的生活史比动物复杂。现在以玉米为例进行说明(图 3-13)。
玉米的同一植株上着生雄花序和雌花序,它们分别产生小孢子和大孢子,所以玉米植株是雌雄同株的,是孢子体。
雄花序着生在茎的端部。在雄花里,雄蕊花药的表皮下有孢原细胞。孢原细胞经过几次分裂,成为小孢子母细胞(microsporocyte)(2n)。小孢子母细胞经过减数分裂,形成4个小孢子——花粉粒(n)。小孢子经过一次有丝分裂,产生两个单倍体核。其中一个核不再分裂,成为管核或营
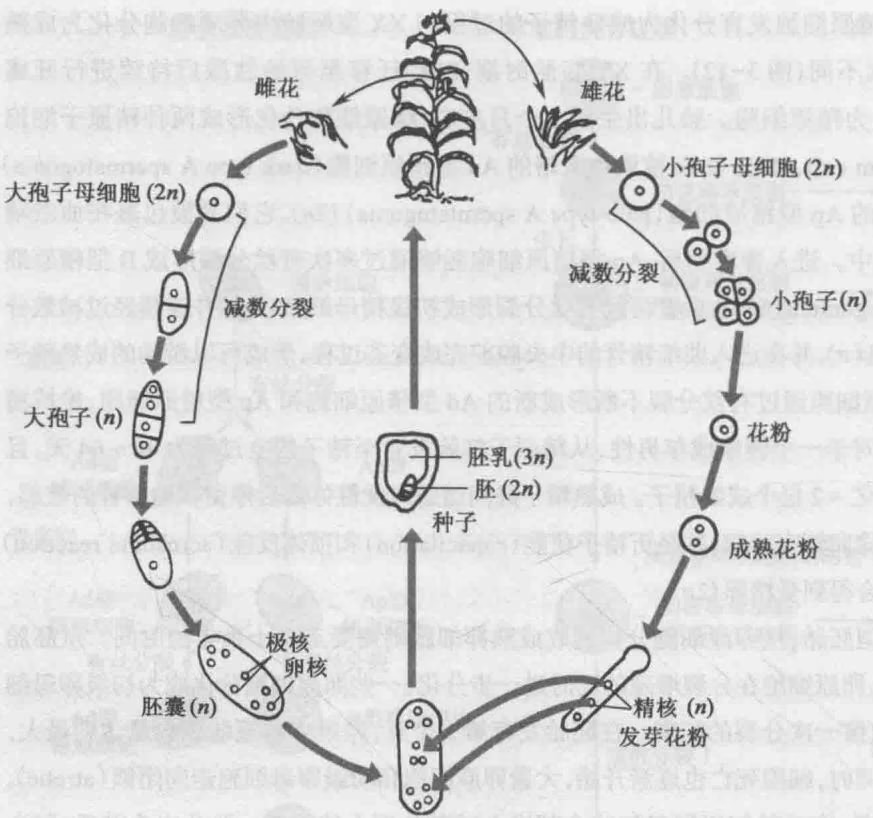
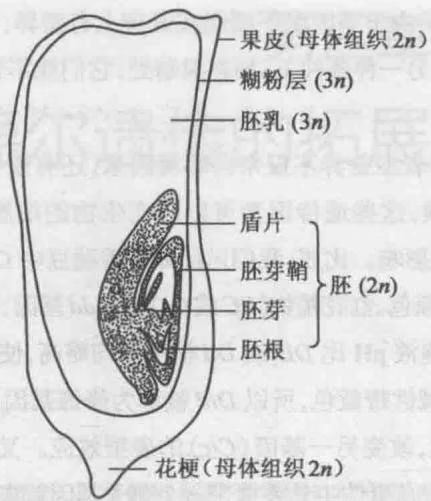
玉米等高等植物并不具有明显的种系,组成花器官的营养细胞(2n),有些分化为大孢子母细胞,有些分化为小孢子母细胞,然后进行减数分裂,形成大孢子和小孢子。大孢子和小孢子通过有丝分裂,成为胚囊和花粉粒。受精时,花粉粒中的一个精核与胚囊中的一个卵核结合形成胚(2n)。花粉粒中另一精核与胚囊中的两个极核结合,形成胚乳(2n)。这是显花植物特有的双受精现象。
养核(n),另一核再进行一次有丝分裂,成为两个精核(n)。这样,雄配子体——成熟花粉粒含有3个单倍体核。
雌花序着生在玉米植株上部叶腋间。在雌花里,雌蕊基部的子房中有孢原细胞。孢原细胞发育成为大孢子母细胞(macrosporocyte)(2n)。大孢子母细胞经过减数分裂,产生4个单倍体核(n),其中3个退化,留下来的一个大孢子又经过三次有丝分裂,形成有8个单倍体核的胚囊。在这8个核中,位于顶端的3个核发育成为反足细胞(antipodal cell),两个核移至中部,成为极核(endosperm nuclei),还有3个核移至胚囊底部,构成两个助核和一个卵核(female gametic nucleus),分别发育成助细胞和卵细胞。成熟的胚囊包括7个细胞,又称为雌配子体。
受粉后,花粉萌发,花粉管沿着花柱长到胚囊。在那里,一个精核跟卵核结合,产生二倍体核(2n),另一精核跟两个极核结合,产生一个三倍体核(3n)。两个精核分别跟胚囊中的卵核和极核结合的过程,叫作双受精(double fertilization)。
通过多次的有丝分裂,二倍体核形成胚,三倍体核形成胚乳。胚和胚乳合在一起,就构成种子。种子萌芽,长成新的植株。
三、动、植物生活史的比较
讲了动物和植物的生活史后,现在把动物和植物的性细胞各个时期作一对照表(表3-3)。通过比较使大家对于动物和植物的生活史有一个更为清晰的概念。
表 3-3 动物和植物的性细胞各时期的对照表
| 雌 | 雄 | ||
| 动物 | 植物 | 动物 | 植物 |
| 卵原细胞↓初级卵母细胞 | 雌孢原细胞↓大孢子母细胞 | 精原细胞↓初级精母细胞 | 雄孢原细胞↓小孢子母细胞 |
| 减数分裂↓1个卵 | 减数分裂↓1个大孢子有丝分裂3次 | 减数分裂↓4个精子 | 减数分裂↓4个小孢子(花粉粒)各有丝分裂1次营养核生殖核有丝分裂1次第一雄核第二雄核1个营养核+2个雄核(在3个核的成熟花粉粒中) |
四、真菌类的生活史
真菌的生活史是单倍体世代占优势,双倍体世代时间较短。现在以粗糙链孢霉(Neurospora crassa)为例加以说明(图3-14)。
粗糙链孢霉的孢子或菌丝的片段落在面包等营养物上面,孢子萌发,菌丝生长。菌丝相互交织在一起,形成菌丝体。菌丝的细胞壁间隔不完全,所以菌丝的细胞质是连续的,每一菌丝细胞
图 3-14 真菌生活史(以粗糙链孢霉为例)
粗糙链孢霉有两个交配型,A 和 a。这两交配型能各自无性生殖,形成菌丝,长出分生孢子(n)。分生孢子散布开去,继续无性生殖,或进行有性生殖。有性生殖时,来自一交配型的分生孢子进入另一交配型的菌丝团——子实体中,与其中的核融合,成为合子(2n)。因为细胞质主要来自子实体,所以视子实体为雌体,视分生孢子为雄体。合子经过一次减数分裂和一次有丝分裂,形成有8个子囊孢子的子囊。子囊孢子萌发,开始新一轮的无性生殖。
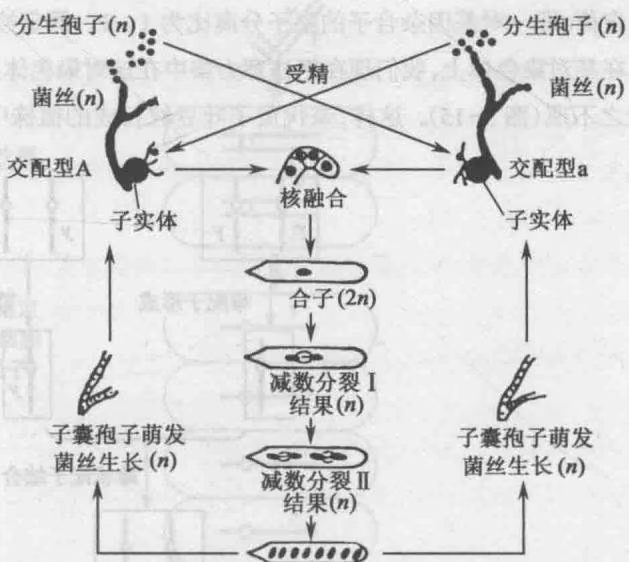
有丝分裂后形成的子囊孢子(n)
是多核的,但每个核的染色体数是单倍的(n)。
有性繁殖时,需要两个不同交配型(mating type)的菌丝体参加。一个交配型的单倍体核(n)通过另一相对交配型的子实体的受精丝,进入子实体中,在那里有丝分裂多次,产生若干单倍体核。这些单倍体核跟子实体中的单倍体核相互结合,形成二倍体核(2n)。粗糙链孢霉只有在这个短暂时间内是二倍体世代。每一个二倍体核经过减数分裂,产生4个单倍体核(n),再经过一次有丝分裂,形成8个核(n)。最后这些核成为子囊孢子,顺次排列在一个子囊中,所以一个子囊中的8个孢子是一次减数分裂和一次有丝分裂的产物。
子囊孢子在适宜环境中萌发,通过连续的有丝分裂,产生新的菌丝体。
第四节 遗传的染色体学说
遗传的染色体学说的证据最早来源于染色体和基因之间的平行现象。例如,配子形成和受精时染色体的行为,跟杂交实验中基因的行为平行。
两者行为间的平行现象表现在下列几点:
(1)染色体可在显微镜下看到,有一定的形态结构。基因是遗传学的单位,每对基因在杂交中仍保持它们的完整性和独立性。
(2) 染色体成对存在,基因也是成对的。在配子中只有一个等位基因,也只有一对同源染色体中的一条。
(3) 个体中成对的基因一个来自母本, 一个来自父本, 染色体也是如此, 两个同源染色体也是分别来自父本和母本。
(4) 不同对基因在形成配子时的分离组合与不同对染色体在减数分裂后期的分离组合, 都是独立的。
因此,萨顿和博韦里在1903年提出遗传的染色体学说,认为基因在染色体上。萨顿指出,如果假定基因在染色体上,那么就可十分圆满地解释孟德尔的分离定律和自由组合定律。
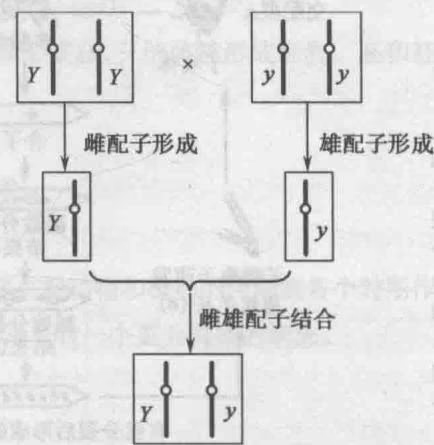
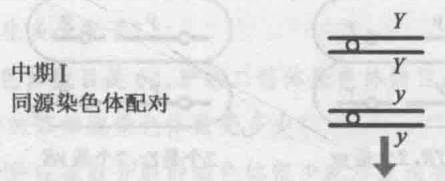
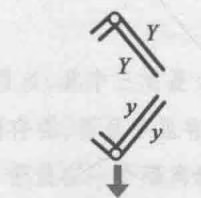
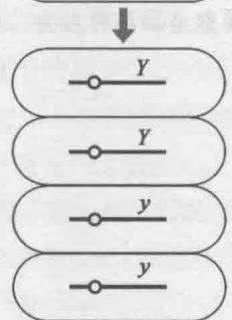
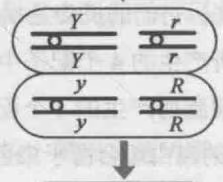
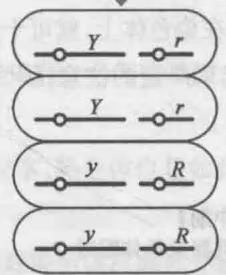
分离定律,即一对基因杂合子的配子分离比为1:1。假定控制豌豆子叶黄绿颜色的一对基因Y和y在某对染色体上,我们现在把注意力集中在这对染色体上,把豌豆的7对染色体中的其余6对置之不理(图3-15)。这样,亲代黄子叶豆粒长成的植株中,每个细胞内这一对染色体的两个成员都带有 $Y$ ,经过减数分裂而产生的每个配子中只有一条这种染色体,所有配子在这条染色体上都带有基因 $Y$ 。亲代绿子叶植株的所有配子在这条染色体上都带有基因 $y$ 。 $\mathbf{F}_1$ 植株的每个细胞内也有这样一对染色体,其中一条从黄子叶植株来,带有 $Y$ ,另一条从绿子叶植株来,带有 $y$ 。 $\mathbf{F}_1$ 植株的初级性母细胞中的染色体与体细胞一样。在减数分裂 I 中期,这一对染色体各有两条染色单体并相互配对(图 3-16)。在减数分裂 I 后期,这对同源染色体分别进入一个次级性母细胞。一个次级性母细胞带有 $Y$ ,而它产生的两个配子也带有 $Y$ ;另一个次级性母细胞带有 $y$ ,由它所产生的两个配子也带有 $y$ 。 $\mathbf{F}_1$ 植株的每个初级性母细胞都产生 4 个配子,其中 2 个带有 $Y, 2$ 个带有 $y$ 。 $n$ 个初级性母细胞产生 4 $n$ 个配子,其中 2 $n$ 带有 $Y, 2n$ 带有 $y$ ,即 1:1。可见基因的分离是染色体分离的结果。
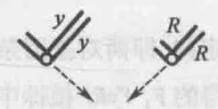
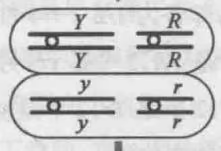
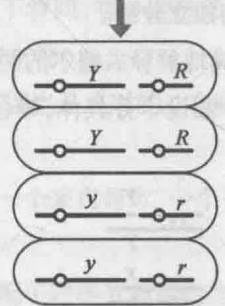
现在再看自由组合定律, 即两对基因杂合子的配子分离比为 1:1:1:1。图 3-17 表示豌豆中黄圆和绿皱杂交所得的 $F_{1}$ YyRr 植株中性母细胞的减数分裂。假定基因 Y 和 y 在一对较长的染色体上, 而基因 R 和 r 在一对较短的染色体上。就这两对染色体而言, 初级性母细胞的减数分裂 I 有两种可能情况, 它们的机会是相等的, 即各为 1/2:一半性母细胞按图 3-17 左栏的方式分裂, 每个性母细胞所产生的 4 个配子中, 2 个是 YR, 2 个是 yr; 另一半性母细胞按 3-17 右栏的方式分裂, 每个性母细胞所产生的 4 个配子中, 2 个是 Yr, 2 个是 yR。所以 4 种配子的比例是 1:1:1:1。可见基因的自由组合源于染色体的独立分配。
所以只要假定基因在染色体上,就可十分圆满地解释孟德尔的两个定律。
萨顿这个假设引起了广泛的注意,因为这个假设十分具体,染色体是细胞中具体可见的结
后期I分向两极
末期I形成2个次级性母细胞
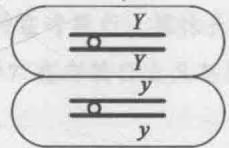
减数分裂结束
一个性母细胞
产生4个配子,
2个带有Y,
2个带有y
图 3-16 一对基因杂合子形成配子时, 染色体的分离和基因的分离
构。但要证实这个假设,进一步自然要把某一特定基因与特定染色体联系起来,首先做到这一点的是美国遗传学家摩尔根,这要留到连锁与交换一章再讨论。
习题
有丝分裂和减数分裂的区别在哪里?从遗传学角度来看,这两种分裂各有什么意义?无性生殖会发生性状分离吗?试加以说明。
水稻正常的孢子体组织中染色体数目是 12 对, 问下列各组织的染色体数目是多少?
(1) 胚乳;(2) 花粉管的管核;(3) 胚囊;(4) 叶;(5) 根端;(6) 种子的胚;(7) 颗片。
用基因型 Aabb 的玉米花粉给基因型 AaBb 的玉米雌花授粉, 你预期下一代胚乳的基因型是什么类型, 比例如何?
某生物有两对同源染色体, 一对染色体是中间着丝粒, 另一对是端部着丝粒, 以模式图方式画出:
(1) 减数分裂Ⅰ的中期图;
(2) 减数分裂Ⅱ的中期图。
蚕豆的体细胞有 12 条染色体,也就是 6 对同源染色体(6 个来自父本,6 个来自母本)。一个学生说,在减数分裂时,只有 1/4 的配子的 6 条染色体完全来自父本或母本,你认为他的回答对吗?
在玉米中:
(1) 5个小孢子母细胞能产生多少配子?
(2) 5个大孢子母细胞能产生多少配子?
(3) 5个花粉细胞能产生多少配子?
(4) 5个胚囊能产生多少配子?
- 马的二倍体染色体数目是 64, 驴的二倍体染色体数目是 62, 请回答:
(1) 马和驴的杂种的体细胞染色体数是多少?
(2) 如果马和驴杂种在减数分裂时染色体很少配对或没有配对,说明马-驴杂种是可育还是不育?
在玉米中, 与糊粉层着色有关的基因很多, 其中三对是 $A / a, I / i$ 和 $Pr / pr$ 。要糊粉层着色, 除其他有关基因必须存在外, 还必须有 $A$ 基因存在, 而且不能有 $I$ 基因存在。如有 $Pr$ 存在, 糊粉层紫色。如果基因型是 $prpr$ , 糊粉层是红色。假使在一个隔离的玉米试验区中, 基因型 $AaprprII$ 的种子种在偶数行, 基因型 $aaPrprii$ 的种子种在奇数行。植株长起来时, 允许天然授粉, 问在偶数行生长的植株上的果穗的糊粉层颜色怎样? 在奇数行上又怎样? (提示: 糊粉层是胚乳的一部分, 所以是 $3n$ 。)
兔的卵没有受精, 经过刺激, 发育成兔。在这种孤雌生殖的兔中, 其中某些兔的有些基因是杂合的。你怎样解释? (提示: 极体受精。)
数字课程学习
在线自测 习题答案
第四章 孟德尔遗传的拓展
尽管孟德尔提出了遗传因子的概念,并很好地解释了生物性状传递的一般规律,但是我们身边的许多生物性状并不能简单用孟德尔遗传来解释。比如说,一对同卵双生子被不同的家庭领养长大,虽然他们具有相同的遗传物质,但在后天的不同环境中,他们的外貌、性格、体质等都会发生明显的分歧。也就是说,环境因素会影响性状的表达。除了环境因素,一对等位基因所调控的性状的实现过程往往也受到其他等位基因的影响,比如在一些单基因遗传病中,基因型相同的患者其发病程度互不相同,并发症类型也不同,其中一个原因就是遗传背景的差异。
因此,基因型和表型之间并不是一对一的关系。在本章中,我们将看到从基因型到表型的实现过程受到环境因素和遗传因素的双重影响,一方面环境因素能够调节基因的表达过程,另一方面,不同等位基因之间可以相互作用,共同调控某一性状。
第一节 环境的影响和基因的表型效应
一、环境与基因作用的关系
从远古时代起,人们就知道,生物体必须在一定的环境中发育。事实上,生物的各种性状特点必须在一定的环境条件之下才能实现。而且更重要的是,环境条件不同也可使性状发生变化,正像基因型不同可造成性状差异一样。
玉米中有些隐性基因(如其中一对是aa)使叶内不能形成叶绿体,造成白化幼苗,它的显性等位基因A是叶绿体形成的必要条件。AA种子在不见光的暗处发芽,长成的幼苗也是白化;而在光照下发芽,则长成绿色幼苗。由此可见,基因型相同的个体在不同条件下可发育成不同的表型。所以A基因是决定叶绿体形成的必要非充分条件。具有A基因的个体(AA或Aa个体),不但有可能形成叶绿体,也有可能不形成叶绿体,只要不给光线,就能实现这后一种可能性。基因型不是决定某一性状的必然实现,而是决定一系列发育的可能性,究竟其中哪一个可能性得到实现,要看环境而定。因此我们说,基因型决定着个体的“反应规范”(reaction norm),即基因型决定着个体对这种或那种环境条件的反应。AA和Aa个体与aa个体的反应规范是不同的:前者在光照下反应为绿色,黑暗中反应为白色;后者则在光照下反应为白色,黑暗中反应也为白色。AA个体和Aa个体的反应规范相同,但基因型不同,这可以从它们后代的有无分离得知。另外也可看到,AA 种子和 aa 种子由于基因型不同而在发育上有差异,但这种差异只有在一定的条件下,即光照下,才能表现;在另一种条件下,如在黑暗处,它们就不表现出差异。这又是基因型不同而表型相同的一个例子。
相同基因型个体的表型差异不仅来自环境因素,还有遗传因素,即与该性状表现有关的其他非等位基因。有时候,这些遗传因素可以改变生物的细胞内环境,从而对基因的表型效应(phenotypic effect)产生影响。比如,我们已经知道香豌豆中 C/c 等位基因影响花色,而有一隐性基因 d 也能影响花冠的颜色。红花植物(CC 或 Cc)如有 dd 基因,它的花色比 DD 或 Dd 的植株蓝些。这是因为 dd 植株的细胞液 pH 比 DD 或 Dd 植株平均略高,使细胞液趋向碱性,而花青素的反应一般在酸性带红色,在碱性带蓝色,所以 D/d 被称为修饰基因(modifier gene)。修饰基因的作用是引起内部环境的变化,改变另一基因(C/c)的表型效应。又如,斑秃(pattern baldness)属于常染色体显性遗传。但是,在男性中只要携带一个斑秃基因就表现出秃顶,而在女性中秃顶只有在纯合个体中才表现出来,且程度较轻,只是头发稀少。这是因为雄性激素能够促进该基因的表达,而雄性激素也是由其他遗传因素决定的。更多的遗传因素对表型的影响体现在非等位基因之间的作用关系上,这些知识将在本章第五节作具体介绍。
对一般生物来讲,几乎任何外部环境条件都可以在一定范围内任意变动,但个体的基因型却在其亲代配子受精时就已决定。因此可以说,生物体的基因型是发育的内因,而环境条件是发育的外因。表型是发育的结果,也是基因型与环境相互作用的结果。这个结论澄清了一个概念,我们不能说哪些性状(或变异)是遗传的,哪些性状(或变异)是不遗传的,只能说在某一特定条件下,个体间性状发育的差异主要是由基因型的差异所决定,还是主要由环境条件的差异所决定。事实上,生物体没有一个性状的发育是与遗传无关的,也没有一个性状的发育是与环境条件无关的。
二、性状的多基因决定
孟德尔在植物杂交论文中,把杂交中有关的遗传因子用符号 $A, a$ 或 $B, b$ 表示,并没有给予描述性的名称。以后遗传学家往往根据影响的性状来命名遗传因子,例如,把控制水稻非糯性胚乳和糯性胚乳中淀粉性质的基因分别称为粳稻基因和糯稻基因,记作 $Wx$ 或 $wx$ ,把影响豌豆子叶黄色或绿色的基因称为黄豌豆基因或绿豌豆基因,记作 $Y$ 或 $y$ 。可是这样就给人以一种印象,好像水稻中单是 $Wx$ 基因或 $wx$ 基因就可决定粳稻或糯稻的性状,豌豆植株中单是 $Y$ 基因或 $y$ 基因就可决定黄豌豆或绿豌豆的性状,而事实并非如此。我们可以说,水稻中非糯性或糯性的性状,以及豌豆中黄子叶或绿子叶的性状跟个体的许多基因都有关系,只不过在 $Wx$ 和 $wx$ ,或 $Y$ 和 $y$ 这对基因有差异时,显现出有关的性状差异来。
举一个具体的例子: 玉米(图 4-1)中 $A_{1}$ 和 $a_{1}$ 这对基因决定花青素的有无, $A_{2}$ 和 $a_{2}$ 这对基因也决定花青素的有无, $C$ 和 $c$ 这对基因决定糊粉层颜色的有无, $R$ 和 $r$ 这对基因决定糊粉层和植株颜色的有无……当 $A_{1}, A_{2}, C$ 和 $R$ 这 4 个显性基因都存在时, 胚乳是红色, 但如有另一显性基因 $Pr$ 存在时, 胚乳成为紫色, 所以胚乳的紫色和红色由 $Pr$ 和 $pr$ 这对基因决定, 但前提是至少 $A_{1}, A_{2}, C$ 和 $R$ 这 4 个显性基因都存在, 否则即使有 $Pr$ 存在, 不要说不显示紫色或红色, 而是无色了。换言之, 紫色胚乳的植株的基因型必须是 $A_{1} _ A_{2} _ C _ R _ Pr$ , 这儿 $A_{1}$ 代表 $A_{1} A_{1}$ 或 $A_{1} a_{1}$ , 即一个基
因是 $A_{1}$ , 另一基因可以是 $A_{1}$ 或 $a_{1}$ , 余类推。所以“Pr 决定紫色, pr 决定红色”这种说法是简单化的说法。比较详细一些的说法应当是: “在其他基因都相同的情况下, 两个个体间某一性状的差异可由一对基因的差异决定”。这一点和我们在介绍“单基因疾病”时的说明是一致的。
虽然性状由很多基因
决定,可是我们在写某一个体的基因型时,非但不可能把所有基因全部写出,而且也没有必要。在任何杂交试验中,只要写出与分离比有关的那些基因就可以了。仍用玉米胚乳颜色的例子:如果只研究紫色和红色,则只要把个体基因型分为 PrPr,Prpr 和 prpr 3 种就可以了, $A_{1},A_{2},C,R$ 等基因都不必写出。但是我们在这儿还要再次强调,影响每一性状的基因数往往很多,用某一性状来称谓基因只是为了说明的方便罢了。
三、基因的多效性
一个性状可以受到若干基因的影响,相反地,一个基因也可影响若干性状。上面谈到的豌豆的红花基因(C)就不只与一个性状有关,这个基因不但控制红花,而且还控制叶腋的红色斑点、种皮的褐色或灰色。此外,它还控制其他性状,只不过没有上述3个性状这样明显而已。我们把单一基因的多方面表型效应叫作基因多效性(pleiotropism)。
基因的多效现象极为普遍,为什么会这样呢?这是因为生物体发育中各种生理生化过程都是相互联系、相互制约的。基因通过生理生化过程而影响性状,所以基因的作用也必然是相互联系和相互制约的。由此可见,一个基因必然影响若干性状,只不过程度不同罢了。我们举一个例子来说明存在相互制约的生理过程。
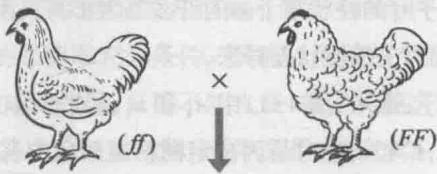
有一种翻毛鸡,羽毛是反卷的。这种鸡与正常的非翻毛鸡有一对基因的差别,翻毛鸡是 $FF$ 正常鸡是 $ff, F$ 对 $f$ 是不完全显性(见本章第二节)。 $FF$ 与 $ff$ 交配,得到杂合子 $Ff$ ,是轻度翻毛
(图 4-2); $F_{2}$ 1/4 翻毛,2/4 轻度翻毛,1/4 正常。Ff 与 ff 回交,得 1/2 轻度翻毛,1/2 正常。这些结果可用一对基因的差异来解释。
翻毛鸡与正常
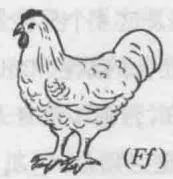
鸡在许多性状上有差别。在小鸡尚未长出硬羽之前,两者已有许多差别,长出硬羽以后,由于羽毛的差别,更引起一系列的其他差别。首先,翻毛鸡的羽毛保持体温的能力不如正常鸡的羽毛,身体热量散失较多,因此翻毛鸡的体温比正常鸡低。体温散失多了,会促进代谢作用来补偿消耗。这样一来,一方面使心跳增加,心脏慢慢扩大,心脏的形状也发生改变,血液增加,与血液有重大关系的器官——脾也因之慢慢扩大;另一方面,代谢作用增强,必然要多吃东西,因而使消化器官、消化腺和排泄器官都发生变化。最后,代谢作用又影响了肾上腺、甲状腺等重要的内分泌腺体,因而使生殖能力降低。
在前面提到的 OMIM 数据库中, 已知近千个人类基因的变异与两种及以上的疾病 / 性状相关。因此说, 在不同物种中, 一个基因影响很多性状, 而一个性状又由很多基因控制的现象普遍存在。
四、表现度和外显率
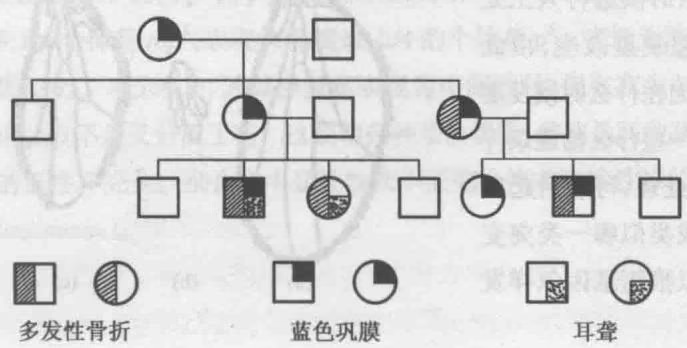
有些基因在不同个体中的表达很一致,但另外一些基因的表型效应在不同个体中有各种变化。这种变化有时来源于环境因子的变动,有时是其他基因的影响,有时是环境和基因的共同作用。具有相同基因型的个体间基因表达的变化程度称为表现度(expressivity)。在黑腹果蝇中有20多个基因与眼的色泽有关,这些基因的表现度很一致,虽然随着年龄的增加,眼的色泽可能稍为深些。另一方面,黑腹果蝇中有一个细眼(lobe eyes)基因影响复眼的大小和形状,它的表型变化则很大:可使眼变得只有针尖大小,也可使眼保持相当大,几乎跟野生型没有差别。人类的成骨不全(osteogenesis imperfecta)是显性遗传病,受单个基因控制,杂合子患者可以同时有多发性骨折、蓝色巩膜和耳聋等症状,也可只有其中一种或两种临床表现(图4-3),表现度很不一致。
基因表达的另一变异方式是不完全外显(incomplete penetrance)。外显率(penetrance)的定义是某一基因型个体显示预期表型的比例。如某个显性基因的效应总是表达出来,则外显率是 $100%$ 。但是有些基因的外显率要低些。由于修饰基因的存在,或者由于外界因素的影响,使某基因的预期性状没有表达出来,这个基因的外显率降低。黑腹果蝇中,隐性的间断翅脉基因i(interrupted wing vein)的外显率不全,只有 $90%$ 。这就是说, $90%$ 的ii基因型个体有间断翅脉,其余 $10%$ 是野生型表型,但这些表型正常的果蝇也有同样的遗传组成ii,它们的子代也有 $90%$ 是有间断翅脉的。人的克鲁宗综合征(Crouzon syndrome)是显性遗传病。根据显性遗传方式,应该代与代间连续,但偶尔会出现代与代间不连续现象(图4-4)。如把致病的显性基因记作Cd,则家系中II-2个体的基因型为Cdcd,因为他把Cd从他母亲(I-2)传给他的儿女(III-2,
图 4-3 一个成骨不全患者的家系(李璞提供)
这是一种显性遗传病,患者父母至少有一方是患者。但是,家系中不同患者的临床表现有差别,说明表现度的变化很大。
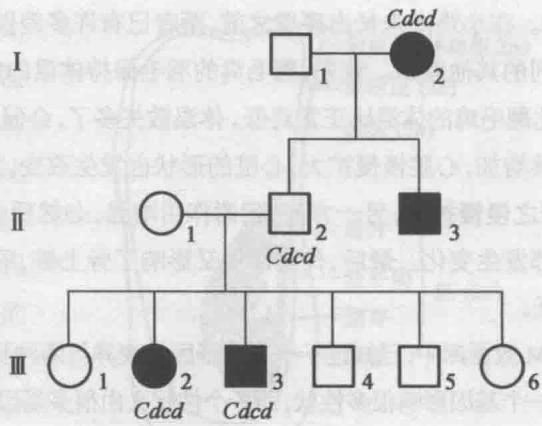
Ⅱ-2个体带有显性致病基因,但他的表型是正常的,所以出现了越代遗传现象。Ⅲ-1,Ⅳ-4等个体是否有这个致病基因不能肯定。
Ⅲ-3),所以他本人应带有显性基因 Cd,但他的表型仍属正常,表明他应为患者而显性基因的效应未能外显,出现越代现象。
视频5表现度和外显率
五、拟表型
前面已讲过,表型是基因型和环境相互作用的结果。这就是说,表型受两类因子的控制:①基因型——遗传;②环境。所以常常遇到这样的情况:基因型改变,表型随着改变;环境改变,表型也常随着改变。环境改变所引起的表型改变,有时与由某基因引起的表型变化很相似,这叫作拟表型(phenocopy)。
例如, 黑腹果蝇 (Drosophila melanogaster) 野生型 (++) 是长翅的, 而突变的类型, 即突变型 (vgvg) 是残翅的, 长翅对残翅是显性。用一定的高温处理残翅果蝇的幼虫, 以后个体长大, 羽化为成虫后, 翅膀接近于野生型 (图 4-5)。不过它们的基因型还是 vgvg, 因为它们和一般突变型个体 (vgvg) 交配, 并在常温下培育子代时, 子代个体的翅膀都是残翅的, 所以在这个例子中, 用高温处理残翅个体, 可使突变型个体接近野生型的表型。
人有一种隐性遗传病,叫作海豹肢畸形(phocomelia),患者的臂和腿部分缺失。这种畸形以前断断续续也有所发生,那是由于隐性基因纯合化的缘故。可是到了20世纪60年代,患者例数突然增多,引起了人们的重视。经过调查研究,知道增多的原因是妇女在妊娠早期,特别是在第3~5周时,服用一种称为反应停(thalidomide)的药物,这种药在发育关键时刻延缓了胎儿四肢的发育,导致了海豹肢畸形。这是药物引起的表型变化,使正常个体模写了突变型的表型。
研究拟表型的意义有下列两点:①什么时候进行人工处理,可以引起表型改变,由此可以推测基因在什么时候发生作用。②用一些什么物理条件或化学药剂处理,可以引起哪一些表型,或类似哪一类突变型,由此可以推测基因怎样发挥作用。
(a)
(b)
(c)
图4-5 果蝇翅的类型
(a) 正常翅。(b) 残翅。(c) 残翅果蝇的幼虫在高温下饲养, 发育形成的翅接近于野生型。
第二节 显隐性关系的相对性
在孟德尔记录的豌豆7对相对性状中,显性现象都是完全的,杂合子(如Cc)与显性纯合子(如CC)在性状上几乎完全不能区别。但后来发现有些相对性状中,显性现象是不完全的,或者显隐性关系可以随所依据的标准而改变。这是孟德尔遗传定律的进一步发展和扩充。
一、不完全显性
显性遗传时,杂合子 $Aa$ 的表型跟显性纯合子 $AA$ 一样,因为在杂合子中隐性基因的作用没有表达出来。可是孟德尔也发现,豌豆的开花时间这个性状不表现为完全的显隐性关系。他曾对开花时间这一性状进行了一些杂交试验,可惜没有完成。在孟德尔以后,不同的遗传学家进行了这方面的实验,发现开花时间受不同遗传因子的影响,其中一对等位基因是 $A$ 和 $a$ 。纯合子 $AA$ 和 $aa$ 的开花时间相差5天。把这两亲本杂交,得到杂合子 $Aa$ ,它们的开花时间大致在两亲之间。如果我们把 $aa$ 植株的开花时间记作0(早),那么不同基因型的开花时间是: $Aa$ 约3.7天(中), $AA$ 约5.2天(晚)。
把杂合子自花授粉,得下述比例:
| Aa | × | Aa | |
|---|---|---|---|
| ↓ | |||
| 基因型 | 1aa | : 2Aa | : 1AA |
| 表型 | 早 | 中 | 晚 |
虽然基因型的比例跟孟德尔的一对基因杂交中显性完全时的期待值一样,但表型比例不是通常的3:1,而是1:2:1了。因为一个基因对另一基因的显性不完全,所以3种不同基因型可以相互区别开来;换一种说法,3种表型直接反映3种不同的基因型。
孟德尔时期以后,遗传学家在动植物的不同性状上都找到不完全显性的例子。在家蚕(Bombyx mori)中,皮肤斑纹的种类很多,黑缟蚕的各个环节都有一黑色带,仅节间膜部分是白色;白蚕的表皮中没有黑色素的沉积,各个环节都呈白色。把黑缟蚕与白蚕杂交(图4-6), $F_{1}$ 全是淡黑缟,它们的色斑在两亲之间,稍稍偏向黑缟斑。 $F_{1}$ 的雌蚕与雄蚕相互交配,得到 $F_{2}$ ,其中1/4个体是黑缟斑,2/4个体是淡黑缟,1/4个体是白蚕。如我们假定黑缟蚕的基因型为 $p^{S}p^{S}$ ,白蚕的基因型为pp,则 $F_{1}$ 的基因型为 $p^{S}p$ 。因为 $p^{S}$ 对p是不完全显性,所以 $F_{1}$ 的表型是淡黑缟。 $F_{1}$ 个体相互交配,得到 $F_{2}$ ,其中1/4个体是 $p^{S}p^{S}$ ,表现为黑缟斑;2/4的个体是 $p^{S}p$ ,表现为淡黑缟;1/4个体是pp,表现为白蚕(图4-7)。可见在 $F_{1}$ 的时候虽然表现为中间性状,但在产生 $F_{2}$ 的时候,黑缟蚕基因 $(p^{S})$ 与白蚕基因(p)不是又分离了吗?这说明杂种呈淡黑缟,并非是两种基因的掺和沾染,而是由于显性基因的显性不完全。杂合子中显性性状不能完全掩盖隐性性状的现象称为不完全显性(incomplete dominance)。
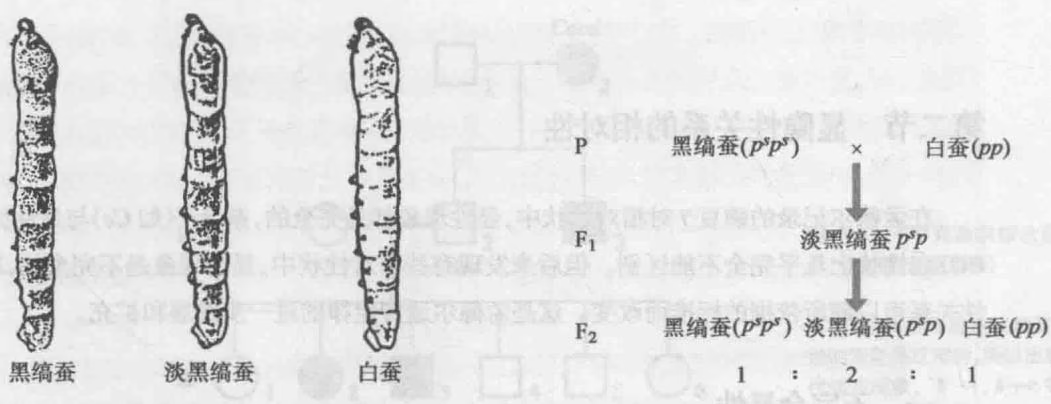
图 4-7 家蚕的黑缟斑纹的遗传
黑缟蚕与白蚕杂交, $F_{1}$ 是淡黑缟。淡黑缟的皮斑颜色在两亲之间,偏向黑缟斑。
二、镶嵌显性
亚洲瓢虫又名异色瓢虫(Harmonia axyrid),属于昆虫纲鞘翅目,广泛分布于多个亚洲国家。异色瓢虫的鞘翅呈现色彩丰富的斑点,大致可分为黄底型(鞘翅以黄色为底色,上面分别带有0~19个黑色斑点)和黑底型(鞘翅以黑色为底色,上面有大小、位置、数目不同的橙色色斑)两大类。黄底型为隐性纯合个体,基因型为ss,黑底型由显性基因控制,不同黑底型的显性基因不同,与s隐性基因共同构成复等位基因(见本章第四节)。我国著名遗传学家谈家桢先生(1909—2008)通过对瓢虫色斑的研究,发现了至少19种色斑决定基因,而且这些等位基因之间表现为镶嵌显性(mosaic dominance)的遗传关系。
瓢虫鞘翅色斑的镶嵌显性包括“包括式”(inclusive)与“重叠式”(overlapping)两种类型。包括式即一种等位基因的表型性状(色斑)完全被另一种等位基因的性状(相同位置不同大小的色斑)“包括”了,比如黑缘型瓢虫(即鞘翅仅前缘部分为黑色,基因型 $S^{A}S^{A}$ )与二窗厚黑缘型瓢虫(即每瓣鞘翅仅中央区域有一个黄色窗口,其余均为黑色,基因型 $S^{C}S^{C}$ )杂交,得到 $F_{1}$ 都是 $S^{C}S^{A}$ 杂合子,表现型是二窗型,因为这种类型的黑底区域包括了另一种类型的黑底区域,而 $F_{1}$ 自交得到的 $F_{2}$ 会出现二窗型 $(S^{C}S^{C},S^{C}S^{A})$ 和黑缘型 $(S^{A}S^{A})$ 两种类型,比例为3:1(图4-8)。值得一提的是,尽管包括式镶嵌遗传的性状比例与完全显性遗传的结果是一致的(3:1),但是得到这一比例的过程略有不同。重叠式即杂交个体的性状(色斑)表现为两种等位基因所控制的色斑的重叠结果,如黑缘型瓢虫 $(S^{A}S^{A})$ 和均色型瓢虫(即鞘翅仅后缘部分为黑色,基因型 $S^{E}S^{E})$ 的杂交 $F_{1}$ 的表型是鞘翅前后端都为黑色的新类型,表现为两种亲本性状的嵌合体,而 $F_{1}$ 自交得到的 $F_{2}$ 发生分离,出现黑缘型、新类型和均色型3种类型,比例为1:2:1(图4-9)。与不完全显性和共显性一样,重叠式镶嵌显性的表型比例与基因型比例相同,因为杂合子和野生型的表型效应是不同的。
三、并显性
血型(blood type)是血液的性状之一,由遗传因素控制。狭义的血型概念指的是红细胞血型,即红细胞表面抗原,它是由遗传因素所决定的个体差异之一。广义的血型概念指血液、体液、分泌液、排泄物及组织细胞表面由遗传所控制的个体性状。奥地利科学家兰德施泰纳(Karl Landsteiner,1868—1943)于20世纪上半世纪先后发现了ABO血型系统、MN血型系统、Rh血型系统等,为临床输血做出了巨大贡献,被称为“血型之父”。迄今,在红细胞表面已发现了25个大类的270种抗原。
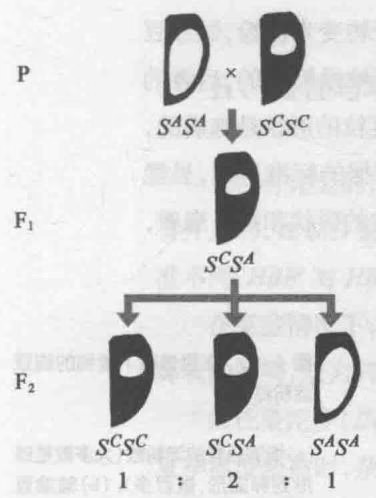
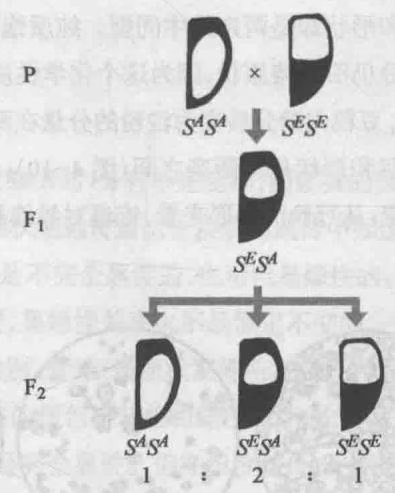
图 4-9 异色瓢虫色斑的镶嵌遗传——重叠式遗传
这里,我们以 MN 血型系统为例介绍并显性(codominance)等位基因关系。人群中有 M 型、N 型和 MN 型 3 种类型的个体。M 型个体的红细胞上有 M 抗原,N 型有 N 抗原,MN 型既有 M 抗原又有 N 抗原。这些血型由一对等位基因决定,这对基因记作 $L^{M}$ 和 $L^{N}$ ,通常也记作 $M$ 和 $N$ 。表 4-1 表示某次调查中 6 种婚配方式的家庭资料,包括父母和子女的 MN 血型类型。
表 4-1 MN 血型的遗传(采自 Stern, 1973)
| 表型 | 基因型 | 家庭数 | 实得子女数 | 理论比 | ||||
| M | MN | N | M | MN | N | |||
| M×M | L^{M}L^{M} \times L^{M}L^{M} | 24 | 98 | — | — | 全 | — | — |
| N×N | L^{N}L^{N} \times L^{N}L^{N} | 6 | — | — | 27 | — | — | 全 |
| M×N | L^{M}L^{M} \times L^{N}L^{N} | 30 | — | 43 | — | — | 全 | — |
| M×MN | L^{M}L^{M} \times L^{M}L^{N} | 86 | 183 | 196 | — | 1 | 1 | — |
| N×MN | L^{N}L^{N} \times L^{M}L^{N} | 71 | — | 156 | 167 | — | 1 | 1 |
| MN×MN | L^{M}L^{N} \times L^{M}L^{N} | 69 | 71 | 141 | 63 | 1 | 2 | 1 |
我们着重观察 M \times N 这一婚配型式。M 型的人的基因型是 $L^{M}L^{M}$ ,N 型的人的基因型是 $L^{N}L^{N}$ ,两人结婚,所生的子女的基因型是 $L^{M}L^{N}$ ,表型是 MN 型,表明这一对等位基因在杂合子中都显示出相对应的表型,这就是并显性现象。
四、显隐性可随所依据的标准而更改
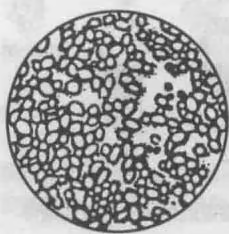
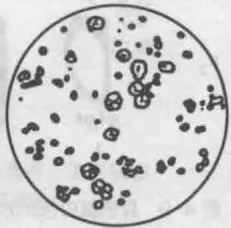
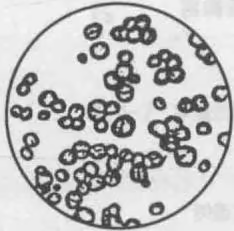
在孟德尔的豌豆试验中,饱满豆粒对皱缩豆粒是完全显性, $F_{1}$ 豆粒全是饱满的,但是 $F_{1}$ 豆粒中淀粉粒的数目和形状却是两亲的中间型。纯质饱满豆粒内的糖分大部分转变为淀粉,皱缩豆粒内的糖分大部分仍旧保持原状,因为这个化学性质的差异,所以前者的豆粒是饱满的,后者的豆粒是皱缩的。 $F_{1}$ 豆粒内糖分转变为淀粉的分量在两亲之间,所以虽然 $F_{1}$ 豆粒的形状是饱满的,但是淀粉粒的数目和形状是在两亲之间(图 4-10)。这个例子说明,随着依据的标准不同,显隐性关系会有所改变:从豆粒的外形来看,饱满对皱缩是完全显性,但从淀粉粒的形状和数目来看,却是不完全显性。
(a)
(b)
(c)
图4-10 在显微镜下看到的豌豆淀粉粒
(a) 饱满豆粒的淀粉粒(大多数是球形到卵圆形,数目多)。(b) 皱缩豆粒的淀粉粒(多角形,有放射状裂纹,数目少)。(c) $F_{1}$ 豆粒的淀粉粒(形状和数目在前两者之间)。
再举一个例子:人类中有一种血液系统的孟德尔疾病,叫作镰状细胞贫血(sickle cell anemia)。该病由一对隐性基因 $HBB^{s}HBB^{s}$ 控制,患者严重贫血,发育不良,关节、腹部和肌肉疼痛,多在幼年期死亡。把这种病人的血液放在显微镜下观察,不使接触氧气,全部红细胞都变为镰状,所以这种病叫作镰状细胞贫血。杂合子的人( $HBB^{A}HBB^{s}$ )表型正常,没有上面提到的病症。但是,把他们的血液放在显微镜下检验,不使接触氧气,也有一部分红细胞成为镰状(图4-11)。从这个例子看来,所谓显性其实是相对的。由临床角度来看,纯合子 $HBB^{s}HBB^{s}$ 是镰状细胞贫血的患者,而杂合子 $HBB^{A}HBB^{s}$ 和纯合子 $HBB^{A}HBB^{A}$ 的人都没有临床症状,所以 $HBB^{s}$ 对 $HBB^{A}$ 是隐性。从红细胞是否出现镰状来看,纯合子 $HBB^{s}HBB^{s}$ 和杂合子 $HBB^{A}HBB^{s}$ 的人的红细胞在缺氧状态下,都出现镰状,所以 $HBB^{s}$ 对 $HBB^{A}$ 是显性。可是从红细胞呈现镰状的数目来看,纯合子 $HBB^{s}HBB^{s}$ 的人的红细胞在缺氧的状态下,全部呈镰状,杂合子 $HBB^{A}HBB^{s}$ 的人的红细胞在缺氧状态下,只有一部分红细胞出现镰状,而正常的人 $HBB^{A}HBB^{A}$ 的红细胞不出现镰状,所以 $HBB^{s}$ 对 $HBB^{A}$ 是不完全显性(表4-2)。这样看来,所谓显隐性关系,因所依据的标准而定,标准不同,显隐性关系也就改变了,只有等位基因的分离现象才有普遍意义。
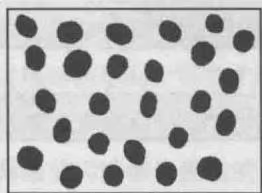
(a)
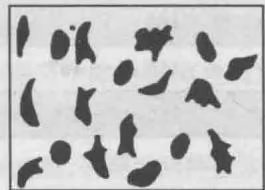
(b)
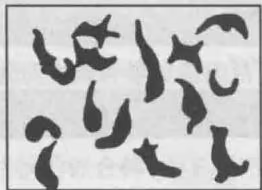
(c)
图 4-11 人的红细胞
(a)正常人 $(HBB^{A}HBB^{A})$ 的红细胞,都是正常的。(b)杂合子 $(HBB^{A}HBB^{a})$ 的红细胞,一部分红细胞镰状化。(c)镰状细胞贫血患者 $(HBB^{a}HBB^{a})$ 的红细胞,全部镰状化。
表 4-2 基因的显隐性与所依据标准的关系
| 依据的标准 | $HBB^{A}HBB^{A}$ | $HBB^{A}HBB^{s}$ | $HBB^{s}HBB^{s}$ | $HBB^{s}$ 对 $HBB^{A}$ |
|---|---|---|---|---|
| 从临床角度看 | 无临床症状 | 无临床症状 | 贫血患者 | 隐性 |
| 从镰状细胞有无来看 | 无 | 有 | 有 | 显性 |
| 从镰状细胞数目来看 | 无 | 少 | 多 | 不完全显性 |
五、显性与环境的影响
显性有完全的,如豌豆子叶的饱满与皱缩(R对r);有不完全的,如家蚕的黑缟对白蚕( $p^{s}$ 对p);有并显的,如MN血型的遗传。我们又从镰状细胞贫血这一疾病的遗传中知道,根据所依据的标准不同, $HBB^{s}$ 对 $HBB^{A}$ 可以是显性的,可以是不完全显性的,也可以是隐性的。
在某些情况下,即使所依据的标准固定,显隐性关系也不是恒定不变的。显隐性关系可以受环境的影响,或为其他生理因素,如年龄、性别、营养、健康状况等所左右。
如在曼陀罗(Datura stramonium)中,茎的颜色有紫色和绿色两种,它们是一对相对性状。在夏季温度较高时,杂种的茎是紫色的,紫茎是完全显性。但在温度较低、光照较弱时,杂种的紫色就比较浅,紫茎基因已不是完全显性了。可见环境条件改变时,等位基因间的显隐性关系也可相应发生改变。
在石竹(Dianthus barbatus)中,花的白色和暗红色是一对相对性状。让开白花的植株跟开暗红色花的植株杂交, $F_{1}$ 的花最初是纯白的,以后慢慢变为暗红色。也就是说,在个体发育中,显隐性关系也可以相互转化。
在奶牛品种爱尔夏牛(Ayrshire cattle)中,毛被的红褐色与红色是一对相对性状。杂种的毛皮色斑与性别有关,雄牛是红褐色,而雌牛是红色。这个例子说明,基因的表达与内环境有关,可能是在激素的影响下雄牛中红褐色基因是显性,而在雌牛中红色基因是显性。可见等位基因的显隐性关系是动态的,并不像孟德尔当时对7对性状所想象的那样绝对化。
第三节 致死基因
孟德尔的论文被重新发现后不久,法国生物学家屈埃诺(Lucien Cuénot, 1866—1951)就发现小鼠(Mus musculus)中黄鼠不能真实遗传,不论黄鼠与黄鼠相交,还是黄鼠与黑鼠相交,子代都出现分离:黄鼠 × 黑鼠→黄鼠2378,黑鼠2398;黄鼠 × 黄鼠→黄鼠2396,黑鼠1235。
从上面第一个交配看来,黄鼠很像是杂种,因为与黑鼠的交配结果,下代分离为1:1。如果黄鼠是杂合子,则黄鼠与黄鼠交配,子代的分离比应该是3:1,可是从上面第二个交配的结果看来,倒是与2:1很适合。那么这是怎么一回事呢?以后研究发现,在黄鼠×黄鼠的子代中,每窝小鼠数比黄鼠×黑鼠少一些,大约少1/4,这表明有一部分合子——纯合子黄鼠在胚胎期死亡了。所以上述的杂交结果可说明如下:
1 | \begin{array}{c c c} \text {黄鼠} A ^ {\mathrm{Y}} a & \times & \text {黄鼠} A ^ {\mathrm{Y}} a \\ & \downarrow & \\ (1 A ^ {\mathrm{Y}} A ^ {\mathrm{Y}}): & 2 A ^ {\mathrm{Y}} a & : 1 a a \\ \text {死亡} & \text {黄鼠} & \text {黑鼠} \end{array} |
那就是说,黄鼠基因 $A^Y$ 影响两个性状:毛皮颜色和生存能力。 $A^Y$ 在体色上有显性效应,它对黑鼠基因 $a$ 是显性,杂合子 $A^Y a$ 的表型是黄鼠。但黄鼠基因 $A^Y$ 在致死作用方面有隐性效应,因为只有纯合子 $A^Y A^Y$ 才引起合子的死亡。
上面讲过的镰状细胞贫血也是隐性致死的,即纯合子 $HBB^{s}HBB^{s}$ 是致死的。这类基因被称为致死基因(lethal gene)。植物中常见的白化基因也是隐性致死的,因为不能形成叶绿素,最后植株死亡。另一方面,基因的致死作用也有在杂合子中表现的,就是所谓显性致死(dominant lethal)。如人的结节性硬化症(tuberose sclerosis, TS)基因只要一份拷贝就可引起皮肤的畸形生长、严重的智力缺陷和多发性肿瘤,所以这对基因的杂合子个体在很年轻时就丧失了生命。
致死基因的作用可以发生在不同的发育阶段,在配子期致死的,称配子致死(gametic lethal);在胚胎期或成体阶段致死的,称合子致死(zygotic lethal)。黄鼠基因 $A^{Y}$ 的致死作用发生在胚泡(blastocyst)植入子宫壁后不久,可能的原因是对胚泡的滋养层发生产生不利影响,导致胚胎死亡,所以是合子致死。
基因的致死效应往往跟个体所处的环境有关。某些基因几乎在任何环境都是致死的,而其他一些基因就不是这样,在某一环境中是致死的,在另一环境中具有正常的生活力。举例来说,园艺学家选育的花卉,色泽鲜艳夺目,花形丰富多彩,可是这些表型只有在园丁的精心培植下才能很好地繁殖,如听之任之,就会被淘汰。这就是说,决定美丽的花色和花形的基因在某一环境中能使植株很好地生长发育,可是在另一环境中就成为致死的了。
在杂交试验中,有时发现观察到的分离比与预期有一定的偏差。例如,在 Aa \times aa 的交配中,如 $A$ 对 $a$ 为完全显性,子代 $Aa$ 与 $aa$ 之比应为 $50% : 50%$ ,可是常常会观察到 $60% : 40%$ , $70% : 30%$ 等,可能的原因包括等位基因 $a$ 是低生活力的或亚致死的。那就是说,致死现象仅出现在一部分个体上。亚致死现象(partial lethality)的致死率可在 $0 \sim 100%$ 之间变动,取决于个体所处的生活环境以及个体遗传组成中的其余基因——遗传背景。由此可见, $3:1$ 的分离比是有条件的,其中一个条件就是各基因型的生活力(至少到观察时)是相等的。
第四节 复等位现象
上面所讲的总是一对等位基因,如豌豆的红花基因与白花基因,果蝇的正常翅基因与残翅基因。其实一个基因可以有很多等位形式(allelic form)或相(phase),如 $a_{1},a_{2},\cdots,a_{n}$ ,但就每一个二倍体细胞来讲,最多只能有其中的两个,而且分离的原则也是一样的。像这样,一个基因存在很多等位形式,称为复等位现象(multiple allelism)。
一、瓢虫的鞘翅色斑
在异色瓢虫中,鞘翅的色斑类型很多。上面已提到过黑缘型和均色型,现在再介绍另一个色斑类型——黄底型。黄底型的基因型是ss,它的鞘翅底色上有微小的黑色斑点。现在来看这3个色斑类型间的相互关系。
这种遗传方式在前面已介绍过。
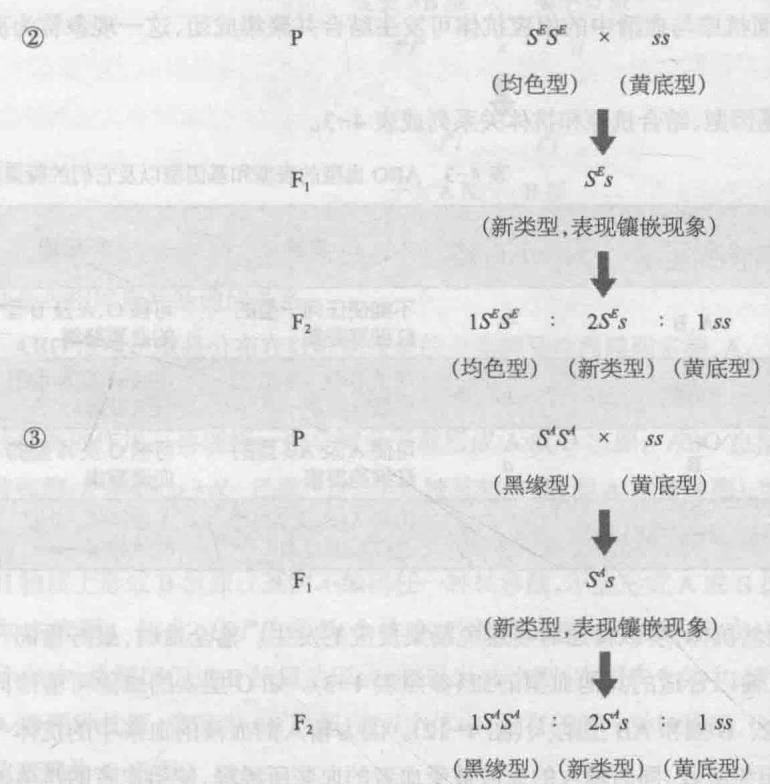
像这样, $S^{E},S^{A},s$ 就构成一个复等位基因系列。对这一复等位基因系列来讲,每一个体只可能有其中的两个基因,或相同,如 $S^{E}S^{E},S^{A}S^{A},ss$ ;或不同,如 $S^{E}S^{A},S^{E}s,S^{A}s$ ,所以一共可构成 $\frac{n(n+1)}{2}=\frac{3(3+1)}{2}=6$ 种不同的基因型。因为 $S^{E},S^{A},s$ 这3个基因相互都表现镶嵌显性现象,所以表型也有6种。
像瓢虫的色斑基因那样,一组等位基因的数目在两个以上,作用互相类似,都影响同一器官的形状和性质,在遗传学上叫作复等位基因(multiple aelles)。
二、ABO 血型
在复等位基因方面,最值得注意的例子是人的血型。前面已谈过 MN 血型,现在来谈另一血
型——ABO 血型。
按照ABO血型,所有的人可分为A型、B型、AB型和O型。ABO血型由3个复等位基因决定,这3个复等位基因是 $I^{A},I^{B}$ 和i,它们组成6种基因型。由于 $I^{A}$ 与 $I^{B}$ 之间表现并显性,而且 $I^{A}$ 和 $I^{B}$ 对i都是完全显性,所以6种基因型只显现4种表型: $I^{A}I^{A}$ 和 $I^{A}i$ 表型相同,都是A型; $I^{B}I^{B}$ 和 $I^{B}i$ 也相同,都是B型; $I^{A}I^{B}$ 杂合子中, $I^{A}$ 和 $I^{B}$ 都是显性,表型是AB型;ii的表型是O型。
ABO 血型与 MN 血型不同, MN 血型在红细胞上有抗原, 但人体内没有天然的抗体, 只有把人的血细胞注入兔子血液后, 才能从兔子中提取含有相应抗体的抗血清。ABO 血型则在红细胞上有抗原, 体内还有天然抗体。如 A 型的人的红细胞上有抗原 A, 血清中有抗 B 抗体 $\beta$ ; B 型的人有抗原 B, 抗 A 抗体 $\alpha$ ; AB 型的人有抗原 A 和 B, 没有抗体, 而 O 型的人没有抗原, 有抗体 $\alpha$ 和 $\beta$ 。这种相互关系的原因还不十分清楚, 可能是人体对环境中天然存在的 A 和 B 抗原类似物的反应结果。红细胞表面抗原与血清中的相应抗体可发生结合并聚集成团, 这一现象称为凝集反应 (agglutination)。
现在把 4 种血型的基因型、结合抗原和抗体关系列成表 4-3。
表 4-3 ABO 血型的表型和基因型以及它们的凝集反应
| 表型(血型) | 基因型 | 抗原(在红细胞上) | 抗体(在血清中) | 血清 | 红细胞 |
|---|---|---|---|---|---|
| AB | $I^A I^B$ | A,B | — | 不能使任何一型的红细胞凝集 | 可被O、A及B型的血清凝集 |
| A | $I^A I^A$ $I^A i$ | A | $\beta$ | 可使B及AB型的红细胞凝集 | 可被O及B型的血清凝集 |
| B | $I^B I^B$ $I^B i$ | B | $\alpha$ | 可使A及AB型的红细胞凝集 | 可被O及A型的血清凝集 |
| O | ii | — | $\alpha, \beta$ | 可使A、B及AB型的红细胞凝集 | 不被任何一型的血清凝集 |
因为 ABO 血型有天然抗体, 所以输血时要避免凝集反应的发生。输全血时, 最好输同一血型的血。如有必要, 也可输以合适的其他血型的血(参照表 4-3)。如 O 型人的血除可输给同型的人以外, 还可输给 A 型、B 型和 AB 型的人(图 4-12)。因为输入的血液的血浆中的抗体一部分被不亲和的受血者的组织吸收, 同时输入的血液被受血者的血浆所稀释, 使给血者的抗体的浓度很大程度地降低, 不足以引起明显的凝血反应, 所以在决定输血后果上, 红细胞的性质比血清的性质更为重要。但是从上面的说明看来, 供血者的抗体如存在的话, 是不能完全忽视的, 所以不同血型的人之间的输血, 如可能的话, 还是以避免为好。
从遗传上来看,如 A 型男人与 B 型女人结婚,他们生了一个 O 型的儿子,那么这 3 人的基因型是怎样的?
O型儿子的基因型是ii,他的一个i来自父亲,另一个i来自母亲,所以A型父亲的基因型应为 $I^{A}i$ ,B型母亲的基因型应为 $I^{B}i$ 。他们的血型的遗传方式如下:
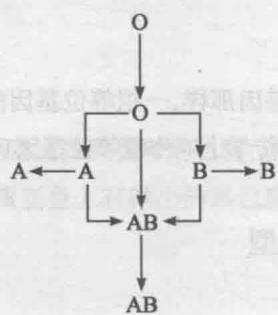
父亲A型 母亲B型
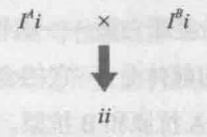
儿子O型
从这个例子看来,虽然子女的血型不像父母,但确确实实是遗传的。
又如,丈夫是 AB 型,妻子是 O 型,问一个 O 型的孩子可能是这对夫妻的子女吗?
AB型丈夫的基因型是 $I^{A}I^{B}$ ,O型妻子的基因型是ii,则他们子女的基因型或为 $I^{A}i$ ,或为 $I^{B}i$ ,也就是说,他们子女的血型是A型或B型。
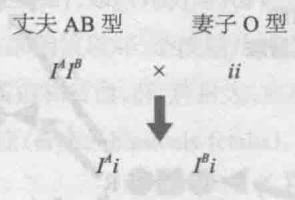
子女A型 B型
根据血型的遗传方式,这对夫妻不可能有 O 型子女。可见不能简单地根据子女血型与双亲血型是否相同来判断遗传关系。
ABO 血型抗原是分布在红细胞表面的一类特异性跨膜脂多糖,A、B、O 抗原的糖链末端的糖基组成有所不同。如图 4-13 所示,ABO 抗原有一个共同的前体,被称为 H 物质,H 物质在糖基转移酶的作用下再连接一个单糖分子就形成 A 或 B 抗原。ABO 血型决定基因编码不同的糖基转移酶: $I^{A}$ 编码 $\alpha-N-$ 乙酰-D-半乳糖胺转移酶(即 A 型转移酶),可将底物上的乙酰半乳糖胺转移到 H 物质上形成 A 抗原; $I^{B}$ 编码 $\alpha-D-$ 半乳糖转移酶(即 B 型转移酶),可将半乳糖转移到 H 物质上形成 B 抗原;i 基因不编码任一种转移酶,不能形成 A 或 B 抗原,但保留了 H 物质(或称为 H 抗原)。因此,在 $I^{A}I^{A}$ 或 $I^{A}i$ 个体中, $I^{A}$ 基因促进 A 抗原的形成,表现为 A 血型;在 $I^{B}I^{B}$ 或 $I^{B}i$ 个体中, $I^{B}$ 基因促进 B 抗原的形成,表现为 B 血型;在 $I^{A}I^{B}$ 个体中,两种转移酶都存在,可以形成 A、B 两种抗原,表现为 AB 血型;在 ii 个体中,没有任何一种转移酶,也就没有 A 抗原或 B 抗原,因此表现为 O 血型。
图 4-13 ABO 血型抗原的生化结构
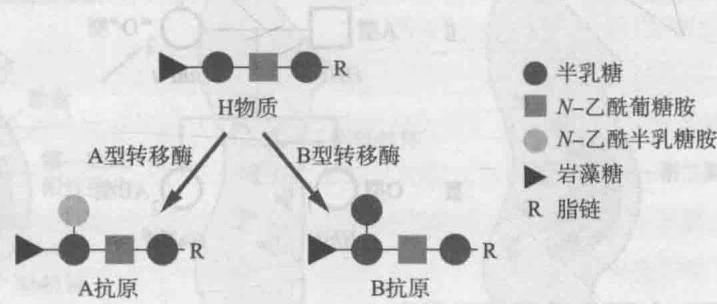
三、孟买型与H抗原
事实上,O型血个体没有抗原A和B是简单化的说法。从ABO血型抗原生化性质分析,我们知道O型的人也有相应的抗原,这个抗原就是H物质。因为每个人都携带H物质(包括O型人在内),所以在正常情况下找不到抗 H 的抗体,从而也就无法检定 H 抗原的存在。
后来发现从植物种子抽提出来的一类蛋白质——植物凝集素(lectin)——可以检出H物质的存在。又知道H物质是ABO血型的前体分子,它的合成受到显性基因H的控制,在 $I^{A}$ 基因或 $I^{B}$ 基因作用下,H物质又进一步形成A抗原和B抗原。ABO血型的形成过程见图4-14所示。
图 4-14 表明, HH 和 Hh 个体能合成 H 物质, H 物质在 $I^{A}$ 或 $I^{B}$ 基因作用下形成 A 抗原或 B 抗原。而 hh 个体不能产生 H 物质, 他们的红细胞不能被植物凝集素或其他抗 H 的抗体所凝集, 这种人被称为孟买型 (Bombay phenotype)。因为这一罕见的血型是在印度孟买发现的, 所以有这个名称。孟买型的人没有 H 物质, 即使有 $I^{A}$ 或 $I^{B}$ 基因, 也不能形成 A 抗原或 B 抗原。
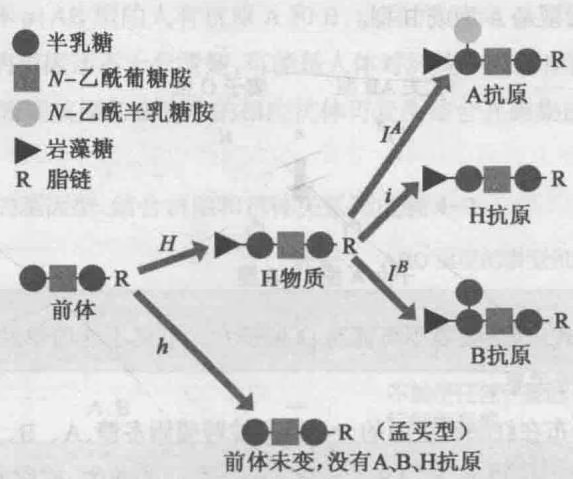
现在来观察一个孟买型个体的家系(图4-15)。在这家系中,妇女Ⅱ-2是O型,她的丈夫(Ⅱ-1)是A型,他们生了一个AB型的孩子(Ⅲ-2)。从家系分析来看,这妇女的真正血型应属B型,但她没有显性基因H,不能形成H物质,从而也不能形成B抗原,在表型上显现为O型。她的基因型应该是 $hhI^{B}i$ 。
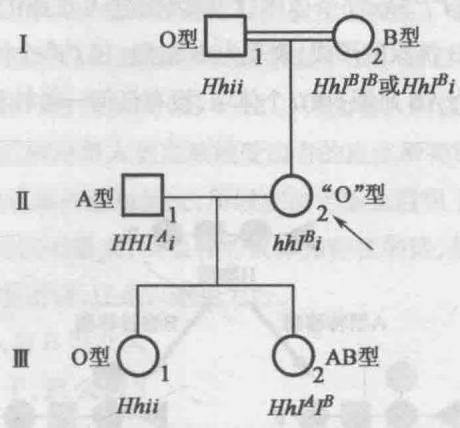
Ⅱ-2是先证者,是最先通过这个成员注意到这个家系的,用箭头表示。从家系分析知道,她带有 $I^{B}$ 基因,但血型表型又受到hh基因型的抑制。请注意,她是近亲结婚所生。
四、Rh血型与母子间不相容
在人类中,Rh 血型是独立于 ABO 血型和 MN 血型的另一血型系统。在这一血型系统发现以前,已经注意到,有时输血发生了反应,而且不能用 ABO 血型不合来说明。这种反应几乎总是发生在多次输血之后,或者发生在经产妇之中。在 Rh 血型发现后,血液学家就把这些现象与 Rh
血型系统联系了起来。
Rh 血型最初发现时,被认为是由一对等位基因 R 和 r 决定的。RR 和 Rr 个体的红细胞表面有 Rh 抗原,这些人是 Rh 阳性。rr 个体没有这种抗原,是阴性。在中国人中,Rh 阴性个体比较少见,大多数人是 Rh 阳性。
Rh 阴性个体在正常情况下并不含有对抗 Rh 阳性细胞的抗体, 可是有两种情况可以产生抗体。一种情况是一个 Rh 阴性个体反复接受 Rh 阳性血液, 这样可能在体内形成抗体, 以后再输入 Rh 阳性血液时, 就会发生输血反应。另一种情况是 Rh 阴性母亲怀了 Rh 阳性的胎儿, 在分娩时, 阳性胎儿的红细胞有可能通过胎盘进入母体血循环中, 使母亲产生对 Rh 阳性细胞的抗体。但这并不影响母亲, 因为母亲的红细胞并不含有 Rh 抗原。这对第一胎也没有影响, 因为抗体是在胎儿出生后形成的。但在怀第二胎时, 如胎儿仍为 Rh 阳性, 则母亲血液中的抗体通过胎盘进入胎儿血液循环时, 就可使胎儿的红细胞被破坏, 造成胎儿死亡。在有些情况下, 胎儿可以活着产下来, 可是新生儿全身浮肿, 有重症黄疸和贫血, 肝、脾肿大, 血液中有很多有核红细胞, 被称为新生儿溶血症或胎儿骨髓成红细胞增多症 (erythroblastosis fetalis)。这就是母婴间 Rh 血型的不相容现象 (incompatibility) (图 4-16)。
知道了新生儿溶血症的发病机理和遗传关系以后,我们自然要问:如果Rh阴性女人跟Rh阳性男人结婚,从第二胎以后,是不是都会生出新生儿溶血症的患儿呢?回答是,比例不高。因为:
① Rh 抗原不是水溶性的,存在于红细胞的表面,只有带有 Rh 抗原的红细胞以足够的数量进入产妇血液中,才有可能形成抗体,但这种情况不是经常发生的。
② 即使有足够数量的、带有 Rh 抗原的红细胞进入产妇血液,有些产妇并不因此形成抗体。
③ 如父亲为 $Rr$ ,只有半数的胎儿是 Rh 阳性的。
④ 在所有可能发生 Rh 血型新生儿溶血症的胎儿中,又可以由于母婴在其他血型上的不相容而受到保护。例如,O 型 Rh 阴性女人怀有一个 A 型 Rh 阳性的胎儿,则在分娩时,即使有足够数量的带有 A 抗原的胎儿红细胞进入母体,也迅速地被母体血液中的 $\alpha$ 抗体所破坏,这样就间接防止了 Rh 阴性孕妇对 Rh 阳性胎儿的免疫现象。
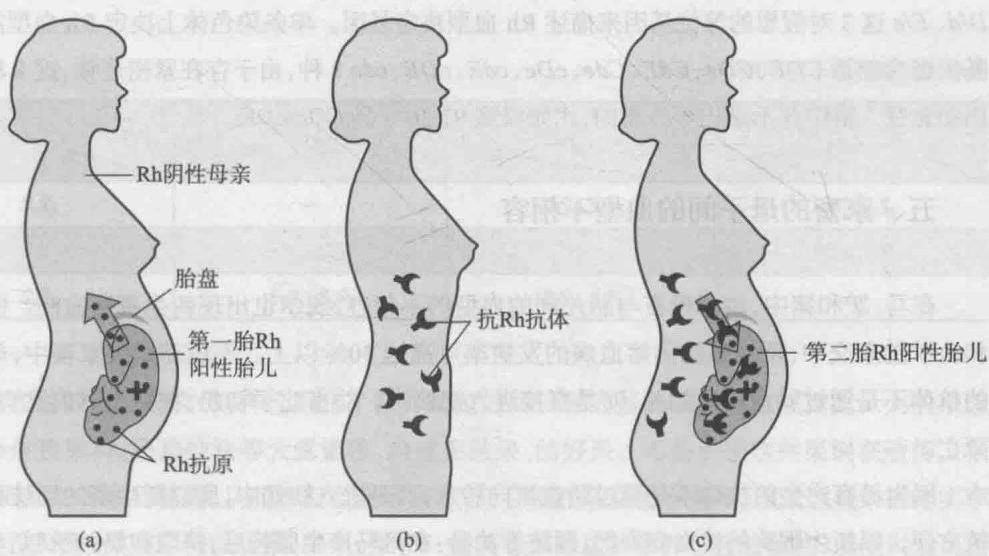
(a)第一次妊娠。(b)两次妊娠中间。(c)第二次妊娠。
由于这些原因,新生儿溶血症的发病率并不高。
一旦出现了新生儿溶血症的患儿,就要用换血的方法来治疗。把胎儿的血液换为既无Rh抗体,又无Rh抗原的血,因此一定要换rr个体(而且不含Rh抗体)的血液。如果给患儿换RR或Rr个体的、带有Rh抗原的血液,那么因为患儿血液中有从母亲来的抗体,还会遭到破坏,仍旧不行。但rr个体很少,找到这种血液较不容易。
在这种病症的遗传学原因未查清以前,医学上也用换血的方法治疗,但那时只能盲目换血,所用的血大多来自 RR 或 Rr 个体,所以大都失败。现在搞清了遗传关系,治疗就很有把握了。
但是换血方法只是事后的补救,如何防患于未然呢?那就要对可能生育新生儿溶血症患儿的母亲,在第一胎分娩后的48 h内,把抗Rh的γ球蛋白注射到母亲的肌肉中去。那就是给产妇以一种抗体,使她自己开始产生抗体以前,就把不相容的Rh阳性红细胞排除了。这样怀第二胎时,阳性胎儿就像第一胎时的阳性胎儿一样,不会发生新生儿溶血症。
此外,母婴间在 ABO 血型上不同,如母亲为 O 型,胎儿为 A 型或 B 型,也可引起新生儿溶血症,但症状一般不像 Rh 引起的那样严重。
现在的研究发现,和 ABO 血型抗原不同,Rh 血型决定抗原是红细胞表面的一类跨膜糖蛋白。Rh 系统涉及相当数目的抗原类型,主要的有 5 个,即 D、C、c、E、e,不存在 d 抗原。其抗原性强弱顺序为 D、E、c、C、e。有无 D 抗原决定了红细胞属于 Rh 阳性还是阴性。现在知道,Rh 抗原是由两个紧密连锁的基因 RHD 和 RHCE 控制的,定位于 1 号染色体的短臂。由于紧密连锁,RHD 和 RHCE 基因在世代传递过程中不发生非等位基因间的重组。RHD 基因决定 D 抗原,RHCE 基因及其等位基因决定了 CE、Ce、cE、ce 4 种复合抗原。在 Rh 阴性个体中发现 RHD 基因发生了缺失或无义突变,因此不能产生 D 抗原。
由于 Rh 血型的分子基础发现得较晚, 研究者目前仍习惯根据 Fisher-Race 命名法, 用 C/c、D/d、E/e 这 3 对假想的等位基因来描述 Rh 血型决定基因。单条染色体上决定 Rh 血型的非等位基因组合包括 CDE、CDe、CdE、Cde、cDe、cdE、cDE、cde 8 种, 由于存在紧密连锁, 这 8 种等位基因组合在人群中并不是均等分布的, 比如汉族 97.36% 是 CDe/cDE。
五、家畜的母子间的血型不相容
在马、驴和猪中,由于母畜与胎儿间的血型的不相容,偶尔也出现新生畜溶血症。但在母马和公驴的杂交中,新生骡驹的溶血病的发病率可高达30%以上。不过在这类家畜中,母畜产生的抗体不是通过胎盘流向胎儿,而是直接进入初奶中。幼畜吃了初奶,在数小时内发病,几天内死亡。
因为母畜产生的抗体不是通过胎盘流向胎儿,而是进入初奶中,所以新生畜的预防和治疗比较方便。以新生骡驹的溶血病为例,预防方法是:在母马产生骡驹后,挤取初奶,把初奶与骡驹红细胞进行凝血反应,测定效价。效价高的初奶挤弃不用,对新生骡驹实行人工哺乳,待母马奶中抗体效价降到安全范围时,即可自由哺乳,这样就不会发生溶血病了。至于患病骡驹的治疗方法,一般是输以合适的马血。先检查患驹的血清中有无破坏给血马红细胞的抗体,如果没有这种抗体,那么这种马血是合适的,就把这种给血马的血液输入患驹。如骡驹病情较重,可先放出一部分血液,然后再输入合适的马血,这样奏效就更为快些。
六、自交不亲和
多数高等植物是雌雄同株的,很多低等动物是雌雄同体的,它们能同时产生两性配子。其中有些生物正常地进行自花授粉或自体受精,如孟德尔所用的豌豆就是这样,但也有一些生物是自交不育的,如海鞘(Ciona)的同一个体的精卵不能接合。在高等植物中,烟草是自交不育的,已知至少有15个自交不亲和相关基因,它们是 $S_{1},S_{2},\cdots,S_{15}$ ,构成一个复等位基因系列。
烟草的不亲和基因的作用是这样的,基因型 $S_{1}S_{2}$ 的植株的花粉受到基因型 $S_{1}S_{2}$ 的植株的花柱抑阻,不能参加受精,但基因型 $S_{1}S_{3}$ 的花粉落在 $S_{1}S_{2}$ 的柱头上时, $S_{1}$ 的花粉受到抑阻,而 $S_{3}$ 的花粉不被抑阻,因而可以参加受精,生成 $S_{1}S_{3}$ 和 $S_{2}S_{3}$ 的合子(图4-17)。为了易于了解,我们把一部分的结果列于表4-4中。
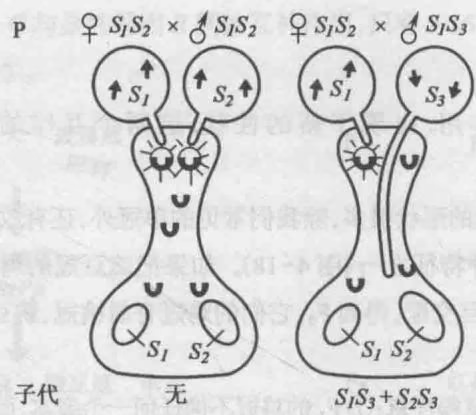
表 4-4 烟草的不亲和基因的作用
| ♂♀ | $S_1S_3$ | $S_1S_2$ | $S_2S_3$ |
|---|---|---|---|
| $S_1S_3$ | — | $S_1S_3,S_2S_3$ | $S_1S_2,S_1S_3$ |
| $S_1S_2$ | $S_1S_2,S_2S_3$ | — | $S_1S_2,S_1S_3$ |
| $S_2S_3$ | $S_1S_2,S_2S_3$ | $S_1S_3,S_2S_3$ | — |
不亲和基因阻止自交,同样也阻止了营养繁殖的同一基因型的植株间相互交配。大的果园往往选择优良果树,用接枝法等大量繁殖,希望多结果、结好果。可是由于这些果树在遗传上相同,具有相同的S系列基因,从而不但自交不亲和,而且相互杂交也不亲和,以致这些果树结实率降低,或几乎不结果实。所以后来,苹果、梨、李、樱桃等果园里都添种了授粉植物,以便供应足量的合适基因型的花粉,促使果实正常发育。现在知道栽培植物中,大约有一半的属都含有自交不亲和的种。
芸薹属园艺植物大都自交不亲和,所以可利用自交不亲和基因的作用,来制造优质高产的杂种种子。以甘蓝为例:先育成对自交不亲和基因是纯合的自交系,例如, $S_{1}S_{1}, S_{2}S_{2}\cdots$ 人们或者要问,不是说过自交不亲和吗?怎样能育成自交系呢?原来自交虽然是高度不育的,但S基因在花柱中发生作用的时间较迟,在蕾期自交是可以的。所以自交系可用蕾期自花授粉来育成和维持。具体方法是:选开花前2~4天的花蕾,用镊子把花瓣轻轻拨开,露出柱头,然后授予同株的新鲜花粉。纯质自交系育成后,再进行配合试验,选定那些种子互相杂交可以产生优良杂种的自交系。然后把选定的不同自交系种在一起,所结的种子就是我们所需要的杂种种子了。
第五节 非等位基因间的相互作用
两对基因是自由组合的,这并不意味着它们在作用上是没有关系的。在这些自由组合的基因中,有些基因影响着同一器官的形状和色泽,从而在它们之间出现了各种形式的相互作用。基因互作是指非等位基因之间通过相互作用影响同一性状表现的现象。
一、互补基因
两对非等位基因相互作用,出现了新的性状,这两个互作的基因叫作互补基因(complementary gene)。
(1) 鸡冠形状的遗传 鸡冠的形状很多,除我们常见的单冠外,还有玫瑰冠、豌豆冠和胡桃冠等,这些不同种类的鸡冠是品种特征之一(图4-18)。如果把豌豆冠的鸡跟玫瑰冠的鸡交配, $F_{1}$ 的鸡冠是胡桃冠。 $F_{1}$ 个体间相互交配,得到 $F_{2}$ ,它们的鸡冠有胡桃冠、豌豆冠、玫瑰冠和单冠,大体上接近9:3:3:1。
在鸡冠的遗传方面,有两点值得注意:① $F_{1}$ 的鸡冠不像任何一个亲本,而是一种新的类型;② $F_{2}$ 出现两种新的类型,一种是胡桃冠,另外一种是单冠。那么怎样来说明这种遗传现象呢?
假定控制玫瑰冠的基因是 R,控制豌豆冠的基因是 P,而且都是显性的,那么玫瑰冠的鸡没有显性豌豆冠基因,所以基因型是 RRpp。与之相反,豌豆冠的鸡没有显性玫瑰冠基因,所以基因型是 rrPP。前者产生的配子全部是 Rp,后者产生的配子全部是 rP,这两种配子相互结合,得到的
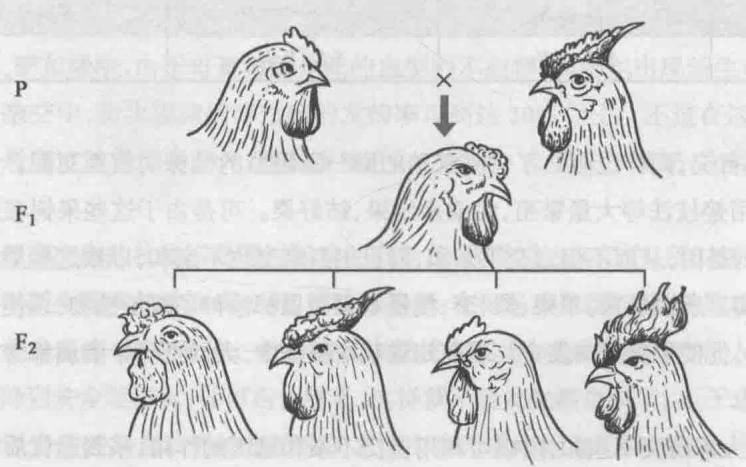
P: 左边是豌豆冠, 右边是玫瑰冠; $F_{1}$ : 胡桃冠; $F_{2}$ : 胡桃冠、玫瑰冠、豌豆冠和单冠。
$F_{1}$ 是 RrPp,由于 R 与 P 的互补作用,出现了胡桃冠。 $F_{1}$ 的公鸡和母鸡都形成 RP, rP, Rp 和 rp 4 种配子,数目相等。根据自由组合定律, $F_{2}$ 应该出现 4 种表型,胡桃冠 (R_P),玫瑰冠 (R_pp),豌豆冠 (rr_P) 和单冠 (rrpp),它们的比例为 9:3:3:1(图 4-19)。在这个例子中,R 与 P 是互补的,形成了胡桃冠,r 与 p 是互补的,形成了单冠,所以 R 与 P, r 与 p 是互补基因。
(2) 香豌豆花色的遗传 香豌豆有许多品种, 花色不同。有一白花品种 A 与普通红花品种杂交时, $F_1$ 红花, $F_2$ 红花比白花是 3:1 。另一白花品种 B 与普通红花品种杂交时, 也是 $F_1$ 红花, $F_2$ 出现 3:1 之比。但是白花品种 A 与白花品种 B 杂交, $F_1$ 全是红花, $F_2$ 红花比白花是 9:7 , 这又是一个新的比例。
这个实验中最突出的还不是 $\mathrm{F}_2$ 比例,而是 $\mathbf{F}_1$ 的表型。从 $\mathbf{F}_1$ 的表型看来,可见白花品种A与白花品种B在基因型上是不同的,由不同的隐性基因决定。如果品种A和品种B在基因型上相同的话, $\mathbf{F}_1$ 的表型应该全是白花。因为品种A和品种B由不同的隐性基因决定,我们可以假定品种A有隐性基因 $rr$ ,品种B有隐性基因 $cc$ ,所以品种A的基因型应该是CCrr,品种B的基因型应该是ccRR。两品种杂交, $\mathbf{F}_1$ 的基因型是CcRr,由于显性基因 $C$ 与显性基因 $R$ 的互补作用,所以花冠为红色。 $\mathbf{F}_1$ 自交, $\mathbf{F}_2$ 中应该9/16是 $C_ R_ ,3 / 16$ 是 $C_ rr,3 / 16$ 是ccR_,1/16是ccrr。同样的,由于显性基因 $C$ 与显性基因 $R$ 间的互补作用,只有9/16的 $C_ R_$ 在表型上是红花,其余7/16都是白花(图4-20)。
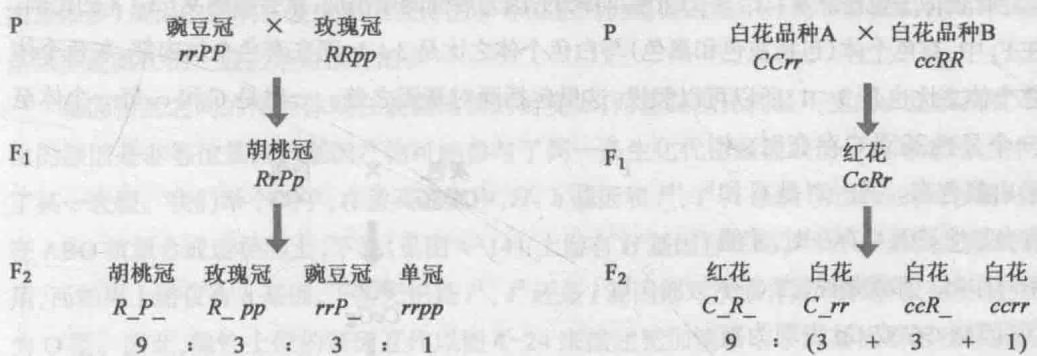
图 4-20 香豌豆花冠颜色的遗传分析
二、修饰基因
有些基因可影响其他基因的表型效应,这些基因称为修饰基因。不同修饰基因的作用不同,有加强其他基因的表型效应的,称为强化基因;有减弱其他基因的表型效应的,称为限制基因;还有完全抑制其他基因的表型效应的,称为抑制基因。
我们在本章第一节中提到的香豌豆中 D/d 基因就是影响 C/c 基因的修饰基因。下面我们再举一个表型效应完全被抑制的例子。
家蚕有结黄茧的,有结白茧的,这也是品种特征之一。把结黄茧的家蚕品种跟结白茧的中国品种交配, $F_{1}$ 全是结黄茧的,这表示中国品种的白茧是隐性的。但把结黄茧的家蚕品种跟结白茧的欧洲品种交配, $F_{1}$ 全是结白茧的,这表明欧洲品种的白茧是显性的。把 $F_{1}$ 结白茧的家蚕相互杂交, $F_{2}$ 结白茧的与结黄茧的比例是 13:3,这是一个新的比例。
这种遗传方式可以用图4-21说明。黄茧基因是 $Y$ ,白茧基因是 $y$ 。另外还有一个非等位的抑配, $F_{2}$ 中应该9/16是 $I_Y_$ ,3/16是 $I_yy$ ,1/16是iiyy,3/16是iiY。同样的,由于I对Y的抑制作用,所以 $F_{2}$ 中表型比是白茧13:黄茧3。
| P | 白茧 | × | 黄茧 | |
| Iyy | iiYY | |||
| ↓ | ||||
| F1 | 白茧 | |||
| IiYy | ||||
| ↓ | ||||
| F2 | 白茧 | 白茧 | 白茧 | 黄茧 |
| I_Y_ | I_yy | iyy | iiY_ | |
| (9 + 3 + 1) : 3 | ||||
三、上位效应
某对等位基因的表现,受到另一对非等位基因的影响,随着后者的不同而不同,这种现象叫作上位效应(epistasis)。
(1) 隐性上位 在家兔中, 灰兔与白兔杂交, $F_{1}$ 全是灰兔, $F_{2}$ 中出现灰兔 9: 黑兔 3: 白兔 4 的比例。这比例似乎也是从 9: 3: 3: 1 衍生而来的, 因为后面两项相加, 就会得到 9: 3: 4 的比例。
在 $F_{2}$ 中, 有色个体(包括灰色和黑色)与白色个体之比是 3:1, 而在有色个体内部, 灰色个体和黑色个体之比也是 3:1, 所以可以假设, 这里包括两对基因之差。一对是 C 和 c, 每一个体至
少有一个显性基因 C 存在时, 才能显示出颜色来。另一对是 G 和 g, 只有当显性基因 C 存在时, 才能显示不同作用。那就是说, 当 C 存在时, 基因型 GG 或 Gg 表现为灰色, gg 表现为黑色; 当显性基因 C 不存在时, 即在 cc 个体中, 不论是 GG, Gg 还是 gg, 都表现为白色, 这些关系如图 4-22。
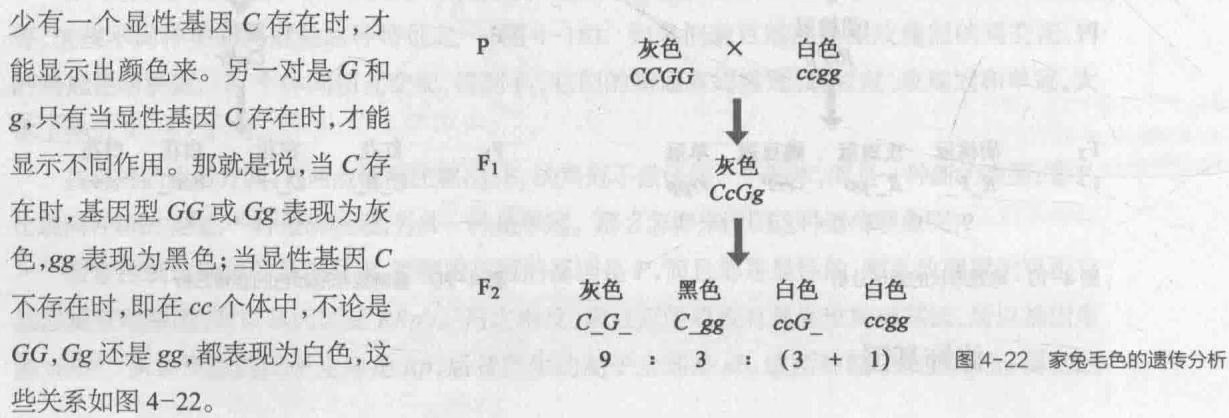
这儿,基因 C 可能决定了黑色素的形成,而 G 和 g 控制黑色素在毛内的分布。没有黑色素的存在,就谈不上黑色素的分布,所以凡是 cc 的个体,G 和 g 的作用都表现不出来。
在这个例子中,C 和 c 这对基因中的隐性基因 c 可遮盖另一对非等位基因 G 和 g 的表现,这种现象叫作隐性上位 (recessive epistasis) 作用。其中 C 和 c 对 G 和 g 是上位,反过来,G 和 g 对 C 和 c 是下位,两对非等位基因的这种关系,就称之为上位效应。
在前述的孟买血型例子中,由于 hh 的存在,使 $I^{A}$ 基因或 $I^{B}$ 基因不能发挥作用,这也是隐性上位作用。
(2) 显性上位 燕麦(Avena sativa)中, 黑颖品系和黄颖品系杂交, $F_{1}$ 全是黑颖, $F_{2}$ 的分离比是: 黑颖 12: 黄颖 3: 白颖 1。这又是一个新的比例, 怎样来说明这样的分离比呢?
因为黑颖与非黑颖之比是3:1,又在非黑颖内部,黄颖和白颖之比也是3:1,所以可以假
图 4-23 燕麦颖壳颜色的遗传分析
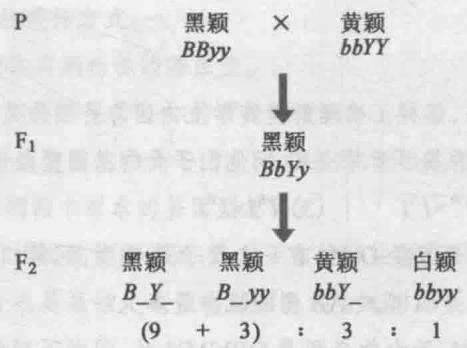
定,这里包括两对基因之差:其中一对是B和b,分别控制黑颖和非黑颖,另一对是Y和y,分别控制黄颖和白颖。只要有一个显性基因B存在,植株就表现黑颖,有没有显性基因Y都一样。如果没有显性
基因 B 的存在, 即在基因型为 bb 的植株中, 表现为黄颖还是表现为白颖, 就得看有没有 Y 的存在而定。有显性基因 Y 存在时, 表现为黄颖, 没有 Y 存在时, 表现为白颖。这样就能圆满地说明上述的杂交结果(图 4-23)。
视频6非等位基因间相互作用
这个例子很容易理解: 黑色素颜色很深, 既有黑色素存在, 有没有黄色素就区别不出。一定要没有黑色素, 才看得出有没有黄色素。这里 B 和 b 对 Y 和 y 是上位, 而 Y 和 y 对 B 和 b 是下位。因为 B 和 b 这对基因中的显性基因 B 可遮盖另一对非对位基因 Y 和 y 的表现, 所以叫作显性上位 (dominant epistasis) 作用。
基因相互作用的方式很多,在此不一一列举。但从上述几例已可看到,性状往往受到若干(其实是很多)基因的影响。发生基因互作的非等位基因仍遵循孟德尔分离和自由组合定律,后代的基因型及其比例一般仍是可预计的。
基因相互之间的作用体现在表型比例的衍变上,而基因型比例是不变的。造成两者不同变化的原因是非等位基因的基因产物可能参与了同一条生化代谢途径或信号转导途径,共同调控了某一表型。我们举个例子,在孟买血型中,H、h 基因和 $I^{A}$ 、 $I^{B}$ 、i 基因(所编码的转移酶)分别处在 ABO 抗原合成途径的上、下游(见图 4-14):上游有 H 基因存在时, $I^{A}$ 、 $I^{B}$ 、i 基因发挥独特的作用,而如果上游仅有 h 基因,下游无论是 $I^{A}$ 、 $I^{B}$ 还是 i 基因都对抗原合成(表型)没有影响,均表现为 O 型。因此,隐性上位的基因互作以图 4-24 来描述更加清晰明了。其他基因互作的关系也
图 4-24 基因互作关系中隐性上位的生化机制
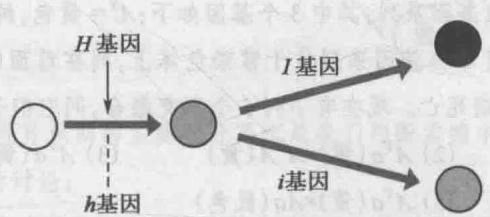
可以用不同的代谢途径去解释,在这里就不一一叙述了。因此,从生化代谢途径或信号转导途径更容易,也能更深入地理解非等位基因之间的相互作用。
从基因与性状之间的关系, 怎样正确理解遗传学上内因与外因的关系?
在血型遗传中, 现把双亲的基因型写出来, 问他们子女的基因型应该如何?
(1) I^{A}i \times I^{B}i (2) I^{A}I^{B} \times I^{B}i (3) I^{B}i \times I^{B}i如果父亲的血型是 B 型, 母亲是 O 型, 有一个孩子是 O 型, 问第二个孩子是 O 型的机会是多少? 是 B 型的机会是多少? 是 A 型或 AB 型的机会是多少?
当母亲的表型是 $\mathrm{ORh}^{-}\mathrm{MN}$ , 子女的表型是 $\mathrm{ORh}^{+}\mathrm{MN}$ 时, 问在下列组合中, 哪一个或哪几个组合不可能是子女的父亲的表型?
$$
\mathrm{ABRh} ^ {+} \mathrm{M}, \mathrm{ARh} ^ {+} \mathrm{MN}, \mathrm{BRh} ^ {-} \mathrm{MN}, \mathrm{ORh} ^ {-} \mathrm{N} 。
$$
某个女人和某个男人结婚,生了4个孩子,有下列的基因型: $iiRRL^{M}L^{N}, I^{A}iRrL^{N}L^{N}, iiRRL^{N}L^{N}, I^{B}irrL^{M}L^{M}$ ,他们父母亲的基因型是什么?
已知兔子的毛色基因存在复等位现象,有4种等位基因类型,包括 $C, c^{ch}, c^{b}, c$ 。请通过下表中不同基因型兔子的表型判断4个等位基因之间的显隐性关系。
| 基因型 | $CC$ $Cc^{ch}$ $Cc^{h}$ $Cc$ | $c^{ch}c^{ch}$ | $c^{ch}c^{h}$ $c^{ch}c$ | $c^{h}c^{h}$ $c^{h}c$ | $cc$ |
|---|---|---|---|---|---|
| 表型 | 野生型棕毛兔 | 灰毛兔(毛白色,毛尖黑色) | 浅灰色 | 爪等体端黑色的白毛兔 | 白毛兔 |
兔子有一种病, 叫作 Pelger 异常。有这种病的兔子, 并没有什么严重的症状, 就是某些白细胞的核不分叶。如果把患有典型 Pelger 异常的兔子与纯质正常的兔子杂交, 下代有 217 只显示 Pelger 异常, 237 只是正常的。你认为 Pelger 异常的遗传基础是什么?
当有 Pelger 异常的兔子相互交配时, 得到的下一代中, 223 只正常, 439 只显示 Pelger 异常, 39 只极度病变。极度病变的个体除了有不正常的白细胞外, 还显示骨骼系统畸形, 生后不久就几乎全部死亡。这些极度病变的个体的基因型是什么? 为什么只有 39 只, 你怎样解释?
在小鼠中, 有一复等位基因系列, 其中 3 个基因如下: $A^{Y} =$ 黄色, 纯合致死; $A =$ 鼠色, 野生型; $a =$ 非鼠色 (黑色)。这一复等位基因系列位于常染色体上, 列在前面的基因对列在后面的基因是显性。 $A^{Y}A^{Y}$ 个体在胚胎期死亡。现在有下列 5 个杂交组合, 问它们子代的表型如何? (1) A^{Y}a(\text{黄}) \times A^{Y}a(\text{黄}) (2) A^{Y}a(\text{黄}) \times A^{Y}A(\text{黄}) (3) A^{Y}a(\text{黄}) \times aa(\text{黑})
(4) $A^{Y}a$ (黄)×AA(鼠色) (5) $A^{Y}a$ (黄)×Aa(鼠色)
假定进行很多 A^{Y}a \times Aa 的杂交,平均每窝生 8 只小鼠。问在同样条件下,进行很多 A^{Y}a \times A^{Y}a 杂交,你预期每窝平均生几只小鼠?
一只黄色雄鼠 $(A^{Y})$ 跟几只非鼠色雌鼠(aa)杂交,你能不能在子代中同时得到鼠色和非鼠色小鼠,为什么?
鸡冠的种类很多, 我们在图 4-18 中介绍过 4 种。假定你最初用的是纯种豌豆冠和纯种玫瑰冠, 问从什么样的交配中可以获得单冠?
Nilsson-Ehle用两种燕麦杂交,一种是白颖,一种是黑颖,两者杂交, $F_{1}$ 是黑颖。 F_{2}(F_{1}\times F_{1}) 共得560株,其中黑颖418,灰颖106,白颖36。
(1) 说明颖壳颜色的遗传方式。
(2) 写出 $F_{2}$ 中白颖和灰颖植株的基因型。
(3) 进行 $\chi^{2}$ 测验。实得结果符合你的理论假定吗?
在家蚕中, 一个结白茧的个体与另一结白茧的个体杂交, 子代中结白茧的个体与结黄茧的个体的比例是 3:1, 问两个亲本的基因型怎样?
在小鼠中, 我们已知道黄鼠基因 $A^Y$ 对正常的野生型基因 $A$ 是显性, 另外还有一短尾基因 $T$ , 对正常野生型基因 $t$ 也是显性。这两对基因在纯合态时都是胚胎期致死, 它们相互之间是独立地分配的。
(1) 问两个黄色短尾个体相互交配, 子代的表型比例怎样?
(2) 假定在正常情况下, 平均每窝有 8 只小鼠。问这样一个交配中, 你预期平均每窝有几只小鼠?
- 有一种观赏植物, 纯合的蓝色品种与纯合的鲜红色品种杂交, $F_{1}$ 均为蓝色。若让 $F_{1}$ 蓝色与纯合鲜红色的品种杂交, 子代的表现型及其比例为蓝色: 鲜红色 = 3:1 。请问:
(1) 写出纯合蓝色品系和纯合鲜红品系的基因型。
(2) 请从生化角度解释 $F_{1}$ 蓝色与鲜红品种杂交后得到蓝色:鲜红色 = 3:1 分离比的原因。
(3) 若将 $F_{1}$ 蓝色植株自花受粉,则 $F_{2}$ 表现型及其比例最可能是什么?
- 在一种植物中, 叶子的颜色由 A, B, C, D 4 个基因控制, 它们的突变型等位基因 a, b, c, d 不能完成相应的催化合成作用。一株基因型为 AaBbCcDd 的植株和一株基因型为 AaBbCcdd 的植株进行杂交, 请问:
(1) 亲本的叶子的颜色是哪种?
(2) $F_{1}$ 中白色叶子的比例占多少?基因型是什么?
(3) $F_{1}$ 中红色、蓝色和紫色叶子的植物比例又是多少?对应的基因型是什么?
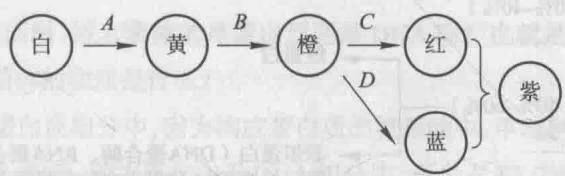
- 后代中是否出现可预期的孟德尔分离比是我们判断孟德尔遗传规律最重要的依据。现有如下两种情况,请分析讨论:
(1) 某同学在进行单对因子杂交的验证性实验(已知该对因子遵循孟德尔遗传规律),但实际结果与孟德尔分离比不符,给出至少3种可能的原因。
(2) 某学者在对一种尚未报道的相对性状的进行遗传规律研究, 发现该性状的遗传并不符合孟德尔的分离比, 给出至少 3 种可能的遗传模式或孟德尔遗传中的特例。
数字课程学习
在线自测 习题答案
第五章遗传的分子基础
前几章已说明了基因在染色体上,也讨论了基因与性状之间的关系。现在将进一步说明基因的化学本质是什么,基因是怎样控制性状的。
第一节 遗传物质是 DNA(或 RNA)
要了解基因的化学本质是什么,首先要考虑基因所在的染色体的化学成分。染色体的化学成分很复杂,由 DNA,两类蛋白质——组蛋白(histone)和非组蛋白(non-histone),以及 RNA 构成。DNA 和组蛋白结合在一起,构成染色体的主要部分,RNA 含量较低(图 5-1)。但这些组分的占比在不同物种、同一物种的不同细胞或同一细胞的不同周期时相中均有差别。
染色体的主要成分是 DNA 和组蛋白,虽然这两种成分都在基因功能上起着重要的作用,但实验证明,基因的主要特性由 DNA 决定,或者说遗传信息贮存在 DNA 中。
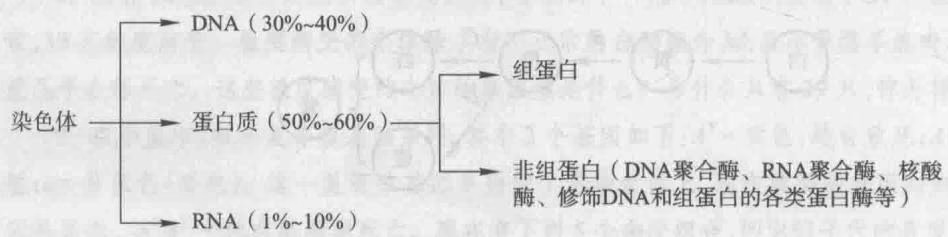
一、DNA是遗传物质的间接证据
间接证据很多,主要有下列各点:
(1) DNA 通常只在核中的染色体上找到。也有某些例外, 如细胞质中的线粒体和叶绿体等有它们自己的 DNA, 且这些结构能自体复制, 有它们自己的遗传连续性。
(2) 同一种生物, 不论年龄大小, 不论身体的哪一种组织, 在一定条件下, 每个细胞核的 DNA 含量基本相同, 而精子的 DNA 含量正好是体细胞的一半 (表 5-1)。蛋白质等其他化学物质不符合这种情况。
表 5-1 几种生物的细胞中的 DNA 含量
| 生物种类 | 肾细胞 | 肝细胞 | 红细胞 | 精子 |
|---|---|---|---|---|
| 鲤鱼 | — | 3.0 | 3.3 | 1.6 |
| 家鸡 | 2.4 | 2.5 | 2.5 | 1.3 |
| 牛 | 6.4 | 6.4 | — | 3.3 |
| 人 | 5.6 | 5.6 | — | 2.5 |
① 表中数字表示每一细胞核中的 DNA 含量(单位: $10^{-12}$ g)。
② 肝中除通常的二倍体(2n)细胞外,还有很多四倍体(4n)细胞。这使细胞的 DNA 平均含量高于二倍体含量。但研究个别细胞时,DNA 含量相当于二倍体,或相当于二倍体的倍数。
(3) 同一种生物的各种细胞中, DNA 在量上恒定, 在质上也恒定。相反地, 蛋白质在量上不恒定, 在质上也不恒定。例如, 在某些鱼类中, 它们的染色体的蛋白质一般都是组蛋白, 且含有少量 RNA, 而在成熟精子中, 组蛋白完全不见了, 全都是鱼精蛋白 (protamine) 了, RNA 的含量也测不出, 可见蛋白质不是恒定的, 不符合遗传物质对稳定性的要求。
(4) 在各类生物中, 能改变 DNA 结构的化学物质一般都可引起突变。
二、DNA是遗传物质的直接证据
如果 DNA 的确是遗传物质,那么能不能把 DNA 和蛋白质分开,单独观察 DNA 的作用呢?这些实验首先在微生物中进行。下面我们就以微生物为例,证明遗传物质的确是 DNA(或 RNA)。
(1)噬菌体的感染 噬菌体的分子组成比较简单。T2 噬菌体约有 60% 蛋白质和 40% DNA,蛋白质构成它的外壳,而 DNA 藏在它的头部中。当一个噬菌体感染大肠杆菌 (E.coli) 时,它的尾部吸附在菌体上。细菌被感染后不再繁殖,在菌体内形成大量的噬菌体,接着菌体裂解,几十个到几百个跟原来一样的噬菌体就释放出来。
那么噬菌体感染细菌时,进入菌体的是蛋白质还是 DNA 呢? 也就是说,在噬菌体的生活史中,连接亲代和子代噬菌体的物质是什么?
硫仅存在于 T2 的蛋白质组分中, 因为构成蛋白质的氨基酸中, 甲硫氨酸和半胱氨酸含有硫, 而 T2 的 DNA 中不含硫; 相反, 磷主要存在于 DNA 组分中, 至少占 T2 中磷含量的 99%。所以赫尔希和蔡斯(1952)用放射性同位素 $^{35}\mathrm{S}$ 来标记蛋白质, $^{32}\mathrm{P}$ 来标记 DNA, 研究 T2 噬菌体遗传信息的传递。把宿主细菌培养在含有 $^{35}\mathrm{S}$ 的培养基中, 或培养在含有 $^{32}\mathrm{P}$ 的培养基中。宿主细菌在生长过程中, 就被 $^{35}\mathrm{S}$ 或 $^{32}\mathrm{P}$ 标记上了。两种放射性同位素不能放在同一培养基中, 因为两种同位素同时存在时, 无法根据放射性进行区分。然后用 T2 噬菌体去感染标记了的细菌。噬菌体在细菌细胞内增殖、裂解后, 释放很多子代噬菌体。这些子代噬菌体被宿主菌的放射性同位素标记上了, 或被标上 $^{35}\mathrm{S}$ , 或被标上 $^{32}\mathrm{P}$ 。
实验的第二步,用标记了的噬菌体去感染未标记的细菌,然后测定宿主细胞的同位素标记。用 $^{35}$ S标记的噬菌体感染时,宿主细胞内很少有同位素标记;而大多数的 $^{35}$ S标记的噬菌体蛋白质附着在宿主细胞的外面——在感染噬菌体的外壳中。用 $^{32}$ P标记的噬菌体感染时,在蛋白质外壳中很少有放射性同位素,而大多数的放射性标记在宿主细胞内(图5-2)。也就是说,在感染时进入细菌的主要是DNA,而大多数蛋白质留在细菌的外面。这样看来,噬菌体注入细菌的物质
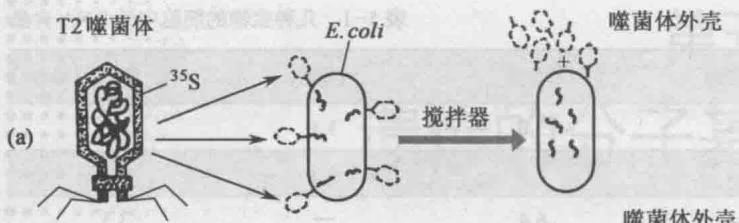
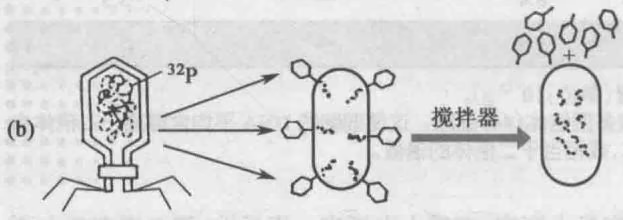
(a) T2 噬菌体用 ${}^{35}$ S 标记, 大多数放射性在细菌外面。(b) T2 噬菌体用 ${}^{32}$ P 标记, 大多数放射性在细菌内部, 并传给子代噬菌体。
是 DNA, 释放的是跟原来一样的噬菌体, 可见在噬菌体的生活史中, 只有 DNA 是连续物质, 所以说 DNA 是遗传物质。
(2) 烟草花叶病毒的重建 对病毒的研究逐渐深入以后, 发现许多病毒含有 RNA 和蛋白质, 却没有 DNA。弗伦克尔-康拉特 (Heinz Fraenkel-Conrat, 1910—1999) (1956) 应用 RNA 病毒进行病毒重建实验, 证明在只有 RNA 而不具有 DNA 的病毒中, RNA 是遗传物质。
实验是用烟草花叶病毒(tobacco mosaic virus, TMV)进行的。TMV 是一种 RNA 病毒, 它有一圆筒状的蛋白质外壳, 由很多相同的蛋白质亚基组成; 内部有一单链 RNA 分子, 沿着内壁在蛋白质亚基间盘旋着(图 5-3)。TMV 约含有 6%RNA 和 94% 蛋白质。在这种 RNA 病毒中, 遗传信息在 RNA 上, 还是在蛋白质上呢?
将 TMV 在水和苯酚中振荡, 把病毒的 RNA 和蛋白质分开, 分别去感染烟草。单是病毒的蛋白质, 不能使烟草感染; 单是病毒的 RNA, 可以使烟草感染, 病毒 RNA 进入烟草细胞, 进行繁殖, 产生正常的病毒后裔。但是单是 RNA 的感染效率很差, 可能是因为 RNA 裸露, 在感染过程中容易被酶所降解。经 RNA 酶处理后的 RNA 完全失去感染力。
TMV 有很多株系,它们可以根据寄主植物的不同和在寄主植物叶上形成的病斑的差异来加
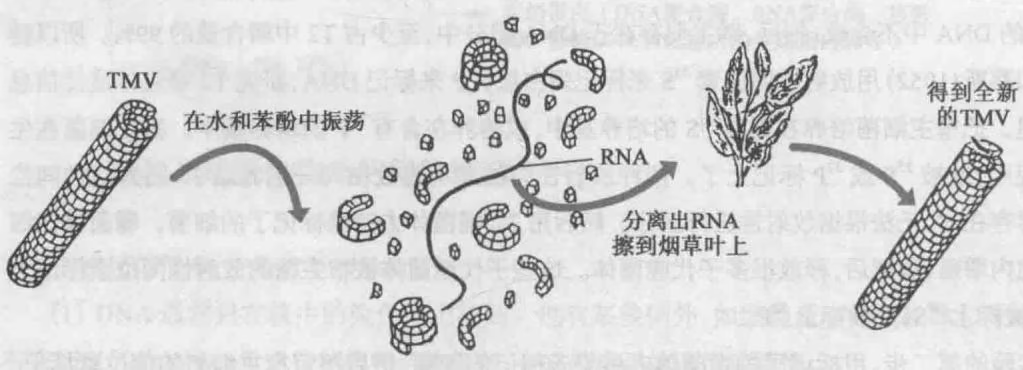
TMV 在烟草等的叶细胞中繁殖。病毒体是杆状的,有一蛋白质外壳,围绕着一个 RNA 核心。把病毒体在水和苯酚中振荡,可把病毒的蛋白质跟 RNA 分开。单用 RNA 擦在烟草的叶子上,烟草植株被感染后,产生很多全新的 TMV。
以区别。例如,有两株系,它们的外壳蛋白不同:S株系(standard strain)的外壳蛋白不具有组氨酸和甲硫氨酸,而HR株系(Holmes Rib-Grass strain)含有这两种氨基酸。两种株系感染烟草的情况如图5-4所示。弗伦克尔-康拉特利用分离而后聚合的方法,先取得S株系的蛋白质外壳和HR株系的RNA,然后把它们结合起来,形成杂种病毒(图5-5a~c)。这类杂种病毒有着S株系的外壳,可被抗S株系的抗体所失活,但不受抗HR株系的抗体的影响。当杂种病毒感染烟草时,病斑与RNA来源——HR株系的病斑一样,从病斑分离的病毒可被抗HR株系的抗体所失活。可见,第二代病毒颗粒具有HR株系的RNA和HR株系的蛋白质外壳。把HR株系的蛋白质和S株系的RNA结合起来,形成杂种病毒(图5-5d~f)。用重建的病毒来感染烟草,得到的病毒颗粒具有S株系的RNA和蛋白质外壳。
此外,小儿麻痹症病毒的 RNA,脑炎病毒的 RNA,都可单独地引起感染。所以我们可以这样
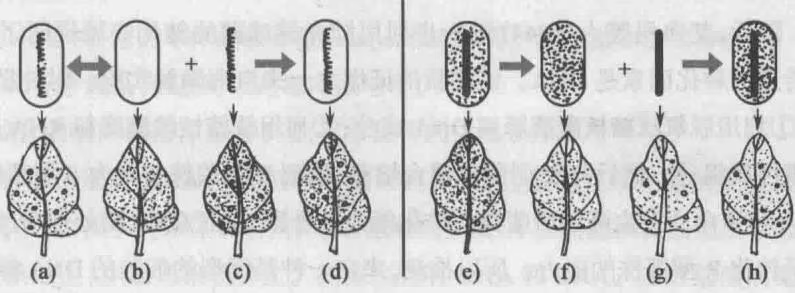
(a)完整的S株系TMV可以使烟草生病,出现一种病斑。(b)单是S株系的蛋白质,不能使烟草生病。(c)单是S株系的RNA,可以使烟草生病,出现一种病斑,不过感染的能力很差。(d)把S株系的RNA和蛋白质加在一起,再去感染,可使烟草生病,出现一种病斑,而且感染能力比单用RNA好。(e)完整的HR株系TMV可使烟草生病,出现一种不同的病斑。(f)单是HR株系的蛋白质,不能使烟草生病。(g)单是HR株系的RNA,可以使烟草生病,但感染能力很差。(h)把HR株系的RNA和蛋白质加在一起,再去感染,可使烟草生病,出现一种病斑,而且效果比单用RNA好。
(a) 单是 S 株系 TMV 的蛋白质, 不能使烟草生病。(b) 单是 HR 株系的 RNA 可使烟草生病, 出现的病斑与由 HR 株系所引起的一样, 不过感染能力很差。(c) 把 S 株系的蛋白质和 HR 株系的 RNA 加在一起, 再去感染, 可使烟草生病, 出现的病斑与由 HR 株系所引起的一样, 而且感染能力比单用 HR 株系的 RNA 好。子裔病毒颗粒具有 HR 株系的蛋白质和 HR 株系的 RNA。(d) 单是 HR 株系的蛋白质, 不能使烟草生病。(e) 单是 S 株系的 RNA 可使烟草生病, 出现的病斑与 S 株系所引起的一样, 不过感染能力很差。(f) 把 HR 株系的蛋白质和 S 株系的 RNA 加在一起, 再去感染, 可使烟草生病, 出现的病斑与由 S 株系所引起的一样, 而且感染能力比单用 S 株系的 RNA 好。子裔病毒颗粒具有 S 株系的蛋白质和 S 株系的 RNA。
说,在不含 DNA 而只含有 RNA 的病毒中,复制和形成新病毒颗粒所必需的遗传信息在 RNA 上。
(3) 肺炎链球菌的转化 DNA 是遗传物质的直接证据主要来自肺炎链球菌 (Streptococcus pneumoniae) 的转化实验。
肺炎链球菌能引起人的肺炎和小鼠的败血症(septicemia)。肺炎链球菌有很多不同菌株(strain),但只有光滑型(S)菌株能引起疾病。这些致病性菌株在细胞外面有多糖类的胶状荚膜,可使它们不被宿主的防御机构所破坏。当生长在合成培养基上时,每一细菌可形成一个明亮的光滑菌落。另外一些菌株没有荚膜,不引起病症,长成粗糙型(R)菌落。格里菲斯(1928)发现,将热杀死的S型细菌和活的无毒的R型细菌共同注射到小鼠中,不仅很多小鼠因败血症而死亡,而且从它们的心脏血液中找到活的S型细菌(图5-6)。活的R型细菌,或死的S型细菌分别注射时,都不引起败血症。这说明,用热杀死的S型细菌把某些R型细菌转化(transformation)为S型细菌,S型细菌有一种物质或转化因素能够进入R型细菌,并引起稳定的遗传变异。
随后,艾弗里等人(1944)进一步利用肺炎链球菌的转化实验证明了在不同肺炎链球菌之间传递的转化因素是 DNA。该实验的证据之一来自酶降解实验。对 S 型菌株分别进行如下处理:①利用脱氧核糖核酸酶降解 DNA 成分;②利用核糖核酸酶降解 RNA 成分;③利用蛋白酶降解蛋白质组分。然后与 R 型菌株混合培养,检测 R 型菌株转化为 S 型菌株的能力。结果发现,RNA 和蛋白质发生降解后菌株的转化能力不受影响,而 DNA 酶处理后的 S 型菌株几乎完全丧失了转化 R 型菌株的能力。所以推测,来自一种基因型的细胞的 DNA 掺入另一不同基因型的细胞中,可引起稳定的遗传变异;DNA 赋有特定的遗传特性,是遗传物质。
我们现在能够毫不迟疑地接受这个证据,认为 DNA 是遗传物质。但是在艾弗里等的实验刚发表的时候,人们还是以怀疑的眼光看待这个发现的。虽然已证明,DNA 酶破坏了转化作用,但仍有人争辩说,转化是 DNA 中污染的少量蛋白质的结果,蛋白质才是有转化作用的因素。随后科学工作者继续纯化 DNA 以证明蛋白质不可能是转化因素。到 1949 年,蛋白质杂质可降低到 0.02%,如此高度纯化的 DNA 不仅仍可引起转化,而且 DNA 纯度越高,转化效率也越高。
转化实验看上去很像定向诱变,也就是用特定处理方法诱发特定变异。其实这是由于转化时,供体 DNA 的一部分整合到受体细胞的 DNA 中的缘故。研究者很快又在肺炎链球菌和枯草杆菌中用同位素标记供体 DNA 进行转化实验,都证明了这一点。
转化是一个直接证据,证明性状本身不能直接遗传,而遗传物质才是可遗传的。在含 DNA 的生物中,DNA 是遗传物质,在不含 DNA 而只含有 RNA 的病毒中,RNA 是遗传物质。
无毒的 R 型活菌和高温杀死的有毒的 S 型死菌在小鼠体内相互作用,产生有毒的 S 型活菌。
第二节 DNA 的分子结构与复制
DNA 是遗传物质,那么它的分子结构是怎样的,它能符合遗传物质的多样化的要求吗?它的复制方式是怎样的,它能符合遗传物质恒定性的要求吗?
一、两种核酸和它们的分布
DNA 和 RNA 都是核酸(nucleic acid)。在说明 DNA 的结构和复制以前,先说明一下这两种核酸的化学组成和它们的分布。
核酸是一种高分子化合物,它的单体是核苷酸(nucleotide)。每一核苷酸由3部分组成:一个磷酸分子、一个糖分子和一个碱基,碱基可以是嘌呤或嘧啶。
两种核酸的化学成分的相同和差异见表5-2,化学结构式见图5-7。
高等动、植物体内,绝大部分 DNA 在细胞核内的染色体上,它是构成染色体的主要成分。有少量 DNA 在细胞质中,存在于叶绿体、线粒体等细胞器内。RNA 在细胞核和细胞质中都有,核内则更多地集合在核仁上,少量在染色体上。细菌也含有 DNA 和 RNA。多数细菌病毒(噬菌体)只有 DNA;植物病毒大多数含有 RNA,少数含有 DNA;动物病毒有些含有 RNA,有些含有 DNA。
二、DNA 的化学结构
DNA 分子是核苷酸的多聚体。脱氧核糖核苷酸由碱基与脱氧核糖和磷酸连接起来构成。因为碱基通常有 4 种,所以脱氧核糖核苷酸也有 4 种,它们的名称是腺嘌呤脱氧核苷酸、胞嘧啶脱氧核苷酸、鸟嘌呤脱氧核苷酸和胸腺嘧啶脱氧核苷酸。更确切地说,DNA 分子就是这 4 种脱氧核苷酸的多聚体(图 5-8),所以也叫作多核苷酸(polynucleotide)。
表 5-2 核苷酸的化学组成
| 核酸种类 | 核苷酸 | ||
| 核苷 | |||
| 碱基 | 糖 | 磷酸 | |
| DNA | 嘌呤 \left\{ \begin{array}{l} \text{腺嘌呤(adenine,A)} \\ \text{鸟嘌呤(guanine,G)} \end{array}\right. 嘧啶 \left\{ \begin{array}{l} \text{胞嘧啶(cytosine,C)} \\ \text{胸腺嘧啶(thymine,T)} \end{array}\right. | 脱氧核糖(deoxyribose) | 磷酸 |
| RNA | 嘌呤 \left\{ \begin{array}{l} \text{腺嘌呤(A)} \\ \text{鸟嘌呤(G)} \end{array}\right. 嘧啶 \left\{ \begin{array}{l} \text{胞嘧啶(C)} \\ \text{尿嘧啶(uracil,U)} \end{array}\right. | 核糖(ribose) | 磷酸 |
腺嘌呤(A)
DNA 分子的单体是核苷酸,核苷酸的组成成分是 4 种含氮碱基(腺嘌呤、鸟嘌呤、胞嘧啶和胸腺嘧啶)、磷酸和脱氧核糖。在 RNA 分子中,其组成成分中尿嘧啶代替胸腺嘧啶,核糖代替脱氧核糖。
嘧啶(胞嘧啶或胸腺嘧啶)
DNA 的主干由磷酸和脱氧核糖交互组成,磷酸和脱氧核糖由 $3’, 5’$ - 磷酸二酯键连接。碱基接在每一脱氧核糖的 1’ 碳原子上。
核苷酸单体的连接依赖于磷酸残基。每一磷酸残基通过磷酸二酯键(phosphodiester bond)把一个脱氧核糖分子的3’-碳原子与下一个脱氧核糖的5’-碳原子相连接(图5-8)。这一点很重要,因为这个不对称性,所以DNA分子有极性(polarity)。如果DNA分子从碳原子在5’位置的那一端开始,那么分子的另一端一定有一个碳原子在3’位置。由于这种极性,如果一个核苷酸与其他核苷酸的位置关系颠倒了,那么这个核苷酸就不能连接到延伸中的多核苷酸链上。
三、DNA的模型
DNA 分子的结构是沃森和克里克最初阐明的。他们从两个线索开始:
(1)大量的结晶资料已经累积起来。用 X 线照射 DNA 分子,观察射线在照相底片上产生的点子,计算点子的分散角度。每一点子的分散角度代表 DNA 分子中的一个原子的位置或若干原子团(group of atoms)的位置。这个技术极为复杂,计算点子的分散角度的程序也极为繁重。所得的数据表明,DNA 分子是细长的,由两条链组成,互相平行。
(2) 查加夫(1949—1951)通过研究不同生物的DNA,得到几个实验法则:①T+C量(嘧啶核苷酸总数)总是等于A+G量(嘌呤核苷酸总数);②A量总是等于T量,C量总是等于G量,但A+T量不一定等于C+G量。
沃森和克里克的 DNA 双螺旋模型就是根据这些线索推导出来的。这个模型的主要特点如下:
第一,DNA 分子是互相旋转的两条长链,成为一种双螺旋(double helix)形式(图 5-9、图 5-10)。每一条链的主线代表交互存在的糖和磷酸,两条链的极性是相反的。就是说,一条链的原子顺序正好与另一条链的原子顺序相反,这两条链是反向平行的(antiparallel)。碱基的排列位置跟主线成直角,向 DNA 分子的中央突出。一条链上的碱基总是跟另一条链的同一水平上的碱基配对,每对碱基由弱氢键(weak hydrogen bond)联结起来(图 5-11)。所有的碱基都是这样一对对地配对,所以 DNA 分子的双链是由碱基对(base pair)的氢键联结在一起的。
腺嘌呤与胸腺嘧啶通过两个氢键配对,鸟嘌呤与胞嘧啶通过3个氢键配对。氢键比连接每一核苷酸的原子共价键弱得多,但已足够保证AT以及GC配对的专一性。由于AT对只有2个氢键,而GC对有3个氢键,所以GC对丰富的DNA比AT对丰富的DNA更稳定些。
第二,碱基的配对不是随机的。嘌呤和嘌呤结合在一起,位置不够,而嘧啶和嘧啶结合在一起,位置有余。而且有两个氢键的碱基(A或T)通常不能和有3个氢键的碱基(C或G)配对,所以A只能与T配对,C只能与G配对。就是说,如在一条链上,某一碱基是A,则另一条链上与它相对的必是T。同理,与T相对的必是A,与C相对的必是G,与G相对的必是C。所以DNA分子中两条链是互补的,可简单地写成:
1 | \begin{array}{l} \dots \dots A - A - C - C - G - C - A - T - T - \dots \\ \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \text { } \end{array} |
所以这个模型要求腺嘌呤和胸腺嘧啶的分子数相等,胞嘧啶和鸟嘌呤的分子数相等,这正是查加夫所观察到的。应该注意到,DNA 分子中碱基顺序没有限制,所以 A+T 量不一定要等于
两条螺旋的带代表糖和磷酸交互地存在着的主线。碱基(六边形)连接在脱氧核糖(圆)上,碱基与碱基由弱氢键(虚线)互相联结起来。每两对碱基间的距离是0.34 nm,每一螺旋的纵距是3.4 nm。
DNA 分子包括两条多核苷酸链, 极性相反。互补的碱基对由氢键(用虚线表示)联结在一起。D, 脱氧核糖; P, 磷酸; A, 腺嘌呤; T, 胸腺嘧啶; G, 鸟嘌呤; C, 胞嘧啶。
G+C 量, 这也是跟查加夫的数据符合的。
一对核苷酸的相对分子质量约为 700, DNA 的相对分子质量据估计为 3 \times 10^{6-12} , 所以一个 DNA 分子大致上有 $4000 \sim 40$ 亿个核苷酸对。一个 DNA 分子是很细很细的纤丝, 从地球到太阳那样的长度, 还没有半克重, 所以显而易见, DNA 分子在细胞中是折叠又折叠, 反复地折叠着的。
两条 DNA 链反向平行,一条走向是 $5’\rightarrow3’$ ,另一条走向是 $3’\rightarrow5’$ ,两条互补链相互缠绕,形成双螺旋。这种双螺旋构型可有几种形式,其中3种具有生物学上的重要性。
(1) B-DNA 这是 Watson-Crick 模型, 是右手螺旋。在正常生理状态时, DNA 分子大都属于这种形式, 碱基的平面对 DNA 分子的中轴是垂直的。事实上, 细胞内 B-DNA 分子每转一圈平均包括 10.4 核苷酸对 (nucleotide pair), 也可说是 10.4 碱基对, 而不是恰好 10 碱基对。
(2) A-DNA 这种构型也是右旋, 每转一圈大约含有 11 个碱基对。在高盐分时, 或在脱水状态时, DNA 常以 A 型方式存在。活体中 DNA 分子可能很少以 A 型方式存在, 但在活体中 DNA-RNA 异源双链 (heteroduplexes, 即 DNA 链的碱基与 RNA 链的碱基互补配对) 或 RNA-RNA 双链是以这种方式存在的, 所以这种构型也值得注意。
(3) Z-DNA 现已证明, 某些 DNA 顺序存在着一种独特的左旋双螺旋形式, 称作 Z-DNA。这里 Z 表示糖-磷酸主干呈 Z 字形, 这种构型的双链中碱基平面对螺旋中轴不再成直角。Z-DNA 每转一圈约有 12 碱基对。这种构型可能与真核生物的基因活性有重要关系。
以前认为 DNA 的结构形式是恒定不变的, 现在看来这种看法需要修改。DNA 的构型可以从一种形式动态地转变为另一种形式, 这种转变与基因活性的调节有密切关系。
四、DNA 的变性和复性
将双链 DNA 在中性盐溶液中加热, DNA 分子的共价键不受影响, 而互补碱基对间的氢键则被打开, 从而使两条多核苷酸链分开成为两条单链, 这叫作 DNA 变性 (denaturation)。
变性后成为单链的 DNA, 在适当条件下又能回复成为双链 DNA, 这称为 DNA 复性 (renaturation) 或退火 (annealing)。把 DNA 放在含有 0.18 mol/L NaCl 和 0.018 mol/L 柠檬酸钠的溶液中, 以 100°C 加热 10 min, 可以完全分开成为单链。变性后的 DNA 如果慢慢冷却, 经过 10 h 以上, DNA 复性完全, 互补的碱基对间又形成氢键。但是如果将加热到 100°C 的溶液迅速冷却, 则 DNA 仍然保持单链状态。
利用加热使溶液中 50% 的 DNA 分子成为单链所需温度称为解链温度 (melting temperature), 记作 $T_{m}$ 。因为 DNA 分子中, A 与 T 配对, 氢键数是两个, G 与 C 配对, 氢键数是 3 个, 所以 GC 含量愈多, DNA 稳定性愈高, 越不容易由热或碱引起变性。
因为变性和复性仅影响互补碱基对间氢键的打开和重新形成,所以通过变性和复性可用来制备单链 DNA,进行多核苷酸链间的分子杂交,测定异源双链的同源性,以及估算 GC 碱基对在 DNA 链中所占的比例等。
五、DNA的复制
如果遗传信息存在于 DNA 分子的碱基顺序上,那么这个顺序在细胞分裂时必须保持不变,所以一个 DNA 分子复制时,产生的两个子分子必须互相一样,而且也与亲代分子相同。
(1) Watson-Crick 模型中双链的互补性是复制方式的基础 DNA 复制时, 碱基对间的氢键断裂, 两条核苷酸链的旋绕松开, 碱基显露出来。形象地说, DNA 分子像拉链一样被拉开了 (图 5-12)。核苷酸链上的碱基显露后, 它们按照互补配对的要求, 吸引带有互补碱基的核苷酸: 腺嘌呤吸引胸腺嘧啶核苷酸, 鸟嘌呤吸引胞嘧啶核苷酸, 等等。然后在邻接的核苷酸间形成磷酸二酯键, 这样一条新的互补核苷酸链就出现了, 当这过程完毕时, 新形成的两个 DNA 分子相互一样, 也与亲代分子一样。
DNA 复制时,每个分子都以它自己为模板,这种复制形式叫作半保留复制(semi-conservative
4种脱氧核苷三磷酸 模板和引物
1 | | arrayc A T |
亲代 DNA 分子(a)的双链打开,每一条链作为新链合成的模板(b),最后形成两条相同的新 DNA 分子(c)。
replication), 因为原来两条链虽然保持完整性, 但它们互相分开, 作为新链合成的模板, 各自进入子 DNA 分子 (daughter DNA molecules) 中。
(2) DNA 的酶促合成 科恩伯格(Arthur Kornberg,1918—2007)(1957)最先发现 DNA 聚合酶(DNA polymerase),并在试管中用脱氧核苷酸成功合成了 DNA。
科恩伯格先把高能的磷酸基团接到4种脱氧核苷酸上,合成4种脱氧核苷三磷酸(deoxyribonucleoside triphosphate)。他把这些化合物放入试管中,添加从E. coli分离的DNA聚合酶以及 $Mg^{2+}$ ,此外再加入从细胞中抽提出来的DNA作为合成的引物(primer)和模板(template),最后合成了许多新的DNA(图5-13),其碱基组成比例与模板DNA相同(表5-3)。换句话说,新合成DNA的特异性不取决于试管中原来的4种脱氧核苷三磷酸含量的比例,也不取决于DNA聚合酶的来源,而是取决于加进去的少量模板DNA。
在反应式中, $n_{1}, n_{2}, n_{3}$ 和 $n_{4}$ 分别代表聚合过程中所消耗的 4 种脱氧核苷三磷酸摩尔数以及掺入新合成 DNA 中的 4 种脱氧核苷单磷酸摩尔数。
表 5-3 在体外合成 DNA 时模板 DNA 和合成 DNA 的碱基比例
| DNA 碱基 DNA 种类 | A | T | G | C |
|---|---|---|---|---|
| T2 噬菌体 | ||||
| 模板 DNA | 1.31 | 1.32 | 0.67 | 0.70 |
| 合成 DNA | 1.33 | 1.29 | 0.69 | 0.70 |
| 大肠杆菌 | ||||
| 模板 DNA | 1.00 | 0.97 | 0.98 | 1.05 |
| 合成 DNA | 1.04 | 1.00 | 0.97 | 0.98 |
| 牛胸腺 DNA | ||||
| 模板 DNA | 1.14 | 1.05 | 0.90 | 0.85 |
| 合成 DNA | 1.12 | 1.06 | 0.85 | 0.85 |
关于 DNA 的酶促合成,还有一点要加以说明,那就是关于添加的 DNA 的作用。添加的少量 DNA 有两个作用:①作为合成反应的起始点,即作为引物。脱氧核苷三磷酸通过磷酸二酯键把脱氧核苷单磷酸(deoxyribonucleoside monophosphate)接到多核苷酸链的 3’—OH 末端,所以一定要有一段 DNA 短链的存在,才可开始 DNA 合成。②作为新合成的 DNA 链的模板。进行聚合时,脱氧核苷三磷酸根据模板链的碱基顺序,通过氢键的形成与模板链配对,并以其磷酸与引物链的 3’—OH 末端相结合,进行聚合反应,所以结果新合成的 DNA 链与模板链是互补的(图 5-14)。
(3) 关于半保留性复制的实验 梅塞尔森(Matthew Stanley Meselson, 1930—)和斯塔尔(Franklin William Stahl, 1929—)(1958)用实验方法证明,DNA复制的确是半保留性的。他们把E.coli培养在含有重同位素 $(^{15}\mathrm{N})$ 的培养基中。在细菌的生长过程中,重同位素进入含氮碱基,然后掺入新合成的DNA链中。在 ${}^{15}\mathrm{N}$ 中经过多次细胞分裂,细菌细胞的DNA充分地被 ${}^{15}\mathrm{N}$ 标记上了。然后把这些细胞移入正常的轻同位素 $(^{14}\mathrm{N})$ 的培养基中,经过一次或两次细胞分裂后抽取细菌样本,从每一样本中提取DNA,进行氯化铯(CsCl)梯度离心。
CsCl 以超速离心时,盐离子由于强大的离心力被拉向离心管底部,同时溶液中存在着的扩散作用又与离心力相对抗,使 $Cs^{+}$ 和 $Cl^{-}$ 分散在整个溶液中。CsCl 溶液经过多小时离心后,溶液达到一种平衡状态,扩散和沉淀的两个相对力量间保持平衡,出现 CsCl 的一个连续的浓度梯度:溶液的密度在离心管底部最大,在离心管顶部最小。如果 DNA 分子溶解在 CsCl 溶液中,它们将逐渐集中在一条狭窄的带上,处在某一特定条带的 DNA 分子的密度恰好与那一点上的 CsCl 密度相等。所以 DNA 用重同位素 ${}^{15}N$ 标记后,在离心管中形成的一条带,位置较低,可以称为重带(heavy band);而含有 ${}^{14}N$ 的轻 DNA 在离心管中也形成一条带,位置较高,可以称为轻带(light band)。
梅塞尔森和斯塔尔发现(图 5-15),细菌在 $^{15}$ N 中经过多代培养后,移到 $^{14}$ N 中培养一代,从这些细胞抽取的 DNA 形成一条带,位置在重带与轻带之间。如果复制是半保留的,这恰恰是所预期的,因为每一 DNA 分子中,应该一条链是 $^{15}$ N 重链,一条链是 $^{14}$ N 轻链。在 $^{14}$ N 中生长两代以后,从这些细胞抽取的 DNA 形成两条带,一条仍在中间位置,另一条在轻带位置,这个观察又跟预期相符合。
还有更使人信服的,他们从在 ${}^{14}N$ 中生长一代的细胞抽取 DNA,通过热变性使 DNA 双链分开,然后离心。这时他们观察到两条带,一条是重的,一条是轻的,证明第一代杂种分子是半保留性复制的产物,它们的双链中,一条来自亲代 $(^{15}N)$ ,一条是新合成的 $(^{14}N)$ ,所以可以记作 ${}^{15}N/{}^{14}N$ 。
图 5-14 DNA 酶促合成中新链延伸时的结构示意图
右侧是引物链,链上的游离3’-OH与已进入的核苷酸5’-磷酸之间形成磷酸二酯键。这样,核苷酸逐个连接上去,DNA链随之以5’→3’方向延伸。新合成链的碱基顺序由左侧的模板链决定。
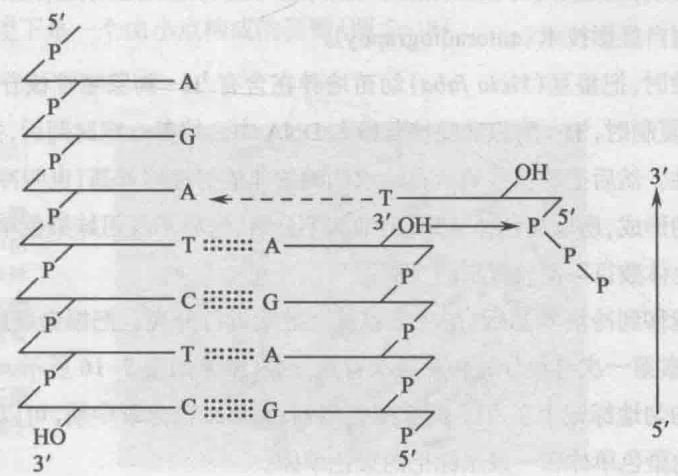
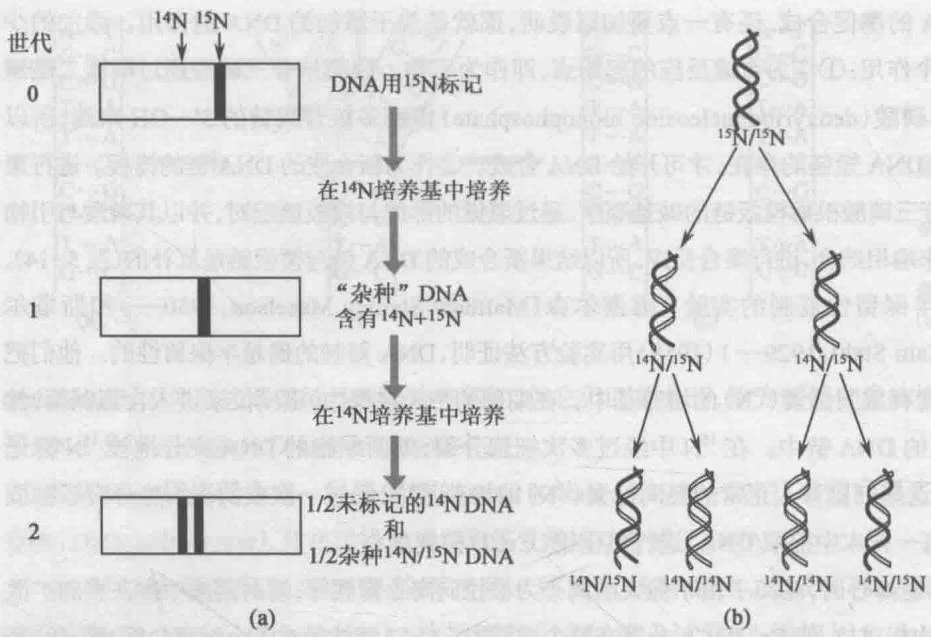
(a)从不同世代的细胞抽取DNA,跟CsCl溶液混合,然后进行离心。高速长时间离心使CsCl在离心管中形成一个密度梯度。这时DNA沉降在CsCl的一定密度处,这密度相当于它自己的密度。因为DNA吸收紫外线,所以用一光源系统照射离心管,在照相底板上记录DNA带的位置。(b)实验结果说明,每一DNA分子以半保留方式复制,所以在 $^{14}$ N中生长一代,所有的分子有一重链 $(^{15}\mathrm{N})$ 和一轻链 $(^{14}\mathrm{N})$ ;在 $^{14}$ N中生长两代,DNA分子复制两次,第一次复制后,形成 $^{14}$ N/ $^{15}$ N杂种分子,再复制一次,形成一个 $^{14}$ N/ $^{15}$ N杂种分子和一个 $^{14}$ N/ $^{14}$ N轻链分子。
(4) 高等生物中染色体的复制 DNA 复制也曾在一些植物中研究过。在这些实验中, 观察单位不是 DNA 分子, 而是含有 DNA 的染色体 (Taylor, 1957)。
染色体用放射性胸腺嘧啶核苷标记,因为这种核苷只进入DNA中。放射性是从氚( $^{3}$ H)来的,氚取代了氢的位置,代入的氚很稳定,很少跟溶液中的氢置换,所以氚可有效地标记掺入的胸腺嘧啶核苷的位置,从而可以标记DNA。将要观察的材料做成片子,用乳胶紧紧地覆盖在玻片上。经一定时间,DNA中氚核裂解后放出的 $\beta$ 粒子使乳胶中的银离子还原。将乳胶显影,拿有标本的玻片和显影后的乳胶同时在显微镜下观察,就可正确地确定氚在染色体中的位置。这种显影方法称为放射自显影技术(autoradiography)。
进行实验时, 把蚕豆 (Vicia faba) 幼苗培养在含有 ${}^{3}H-$ 胸腺嘧啶核苷的培养基 (也叫热培养基) 上, DNA 复制时, ${}^{3}H-$ 胸腺嘧啶核苷掺入 DNA 中。培养一定时间后, 蚕豆根尖细胞的染色体都带有放射性。然后把幼苗移到含有秋水仙碱的非放射性培养基 (也叫冷培养基) 中。秋水仙碱抑制纺锤丝的形成, 所以染色体分裂, 但细胞不分裂, 这样不仅姐妹染色单体留在同一细胞中, 而且存在的染色体数目可反映复制的次数。
根尖细胞移到冷培养基后,在冷培养基上继续进行分裂。把根尖细胞制片、染色,并进行放射自显影,观察第一次有丝分裂和第二次有丝分裂,结果如图5-16所示。第一次分裂中期,两条染色单体都均匀地标记上了 $^{3}$ H-胸腺嘧啶核苷;而第二次分裂中期,可以看到一个染色体中,有一条标记了的染色单体和一条未标记的染色单体。
图 5-16 蚕豆根尖细胞染色体(经 $^{3}$ H-胸腺嘧啶核苷标记)在有丝分裂中的情况(引自 Taylor,1957)
实线表示未标记的 DNA 链, 虚线表示有标记的 DNA 链。虽然 DNA 链未能在显微镜下看到, 但是却可完美地说明观察到的标记型式。在标记后的第一次分裂中期, 两条染色单体都有标记, 而在标记后的第二次分裂中期, 只有一条染色单体有标记。
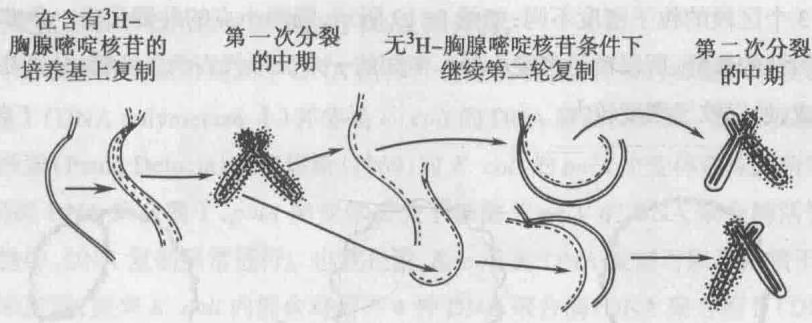
这些结果可以这样说明:在间期的 $G_{1}$ 期,染色体未复制,每一染色体是一条 DNA 双链,进入 S 期后,DNA 双链在 ${}^{3}H-$ 胸腺嘧啶核苷存在下复制,所以经 $G_{2}$ 期而进入标记后第一次分裂期时两条染色单体都被标记上了。第二次复制是在没有放射性胸腺嘧啶核苷的培养基中进行,所以到第二次分裂期时只有一条染色单体是被标记的。这个实验在染色体水平上证明了 DNA 双链的复制是半保留的。
一种新的染色方法可以不用放射自显影技术直接观察染色体的半保留复制。这种方法是,让染色体在含有5-溴脱氧尿嘧啶核苷(5-bromodeoxyuridine, BrdU)的培养液中经过两次复制,然后用吉姆萨(Giemsa)染色,结果就出现所谓色差染色体(harlequin chromosome)。因为在BrdU中所合成的DNA链着色很浅,跟原来的链明显不同。色差染色体的结果与放射自显影所得的结果一样,都证明DNA的复制是半保留的(图5-17,并请参照图5-16)。
(5) 由放射自显影看 DNA 复制 E.coli 的染色体是环状的双链 DNA。凯恩斯(John Cairns, 1922—2018)(1963)用放射性同位素标记 E.coli 染色体,他发现两个圆形的链在复制时分开,每条链分别复制,出现 Y 形复制叉(replication fork)。
凯恩斯的实验过程和解释是这样的:细菌细胞在含 ${}^{3}H-$ 胸腺嘧啶核苷的培养基中生长,DNA 复制时,放射性同位素掺入 DNA。理论上所有新合成的子 DNA 都含有一条放射性(热)链和一条非放射性(冷)链。在热培养基中经过不同时间的培养和不同次数的复制后,从细菌细胞抽取 DNA,转移到膜上,经过放射自显影后,在电子显微镜下进行观察。
在 ${}^{3}$ H-胸腺嘧啶核苷中进行一次复制,在放射自显影图上看到一圈小点,他的解释是,DNA 在热培养基中复制一次后,一条 DNA 链是旧的,没有放射性,另一条 DNA 链是新合成的,有放射性,所以在电子显微镜下是一个由小点构成的圆圈(图 5-18)。
图 5-17 人淋巴细胞的色差染色体(张思仲提供)
细胞在含有 BrdU 的培养液中经过两个周期,每一染色体的两个单体中,一个单体的双链中仍有一条链未被取代,所以着色较深,而另一单体的双链都被 BrdU 所取代,所以着色很浅,这种染色体称为色差染色体。请注意:图中用箭头表示的染色体发生了姐妹染色单体互换(sister chromatid exchange, SCE)。SCE 的意义尚不清楚。目前认为实验中出现的 SCE,可能是由于 DNA 的断裂和随后的愈合。
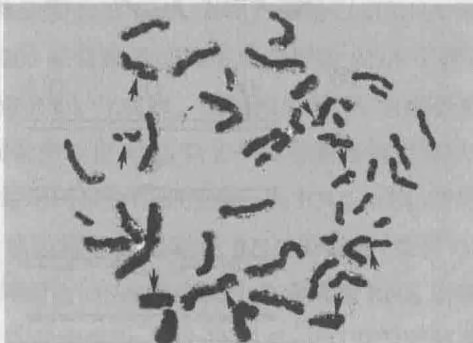
在第二次复制周期中出现了眼球状的结构,两侧各有一个Y形复制叉。还有,放射自显影图中3个区段的粒子密度不同:如图5-19所示,圆形小点的外圈代表一条非放射性的旧链和一条放射性的新链,所以粒子密度小些。中间的一个弧形代表两条新链,分别在第一和第二复制周期合成,所以粒子密度较大。
(a)
(b)
(a)
(b)
图 5-18 E.coli 在热培养基中复制一次后的放射自显影图(a)及解释图(b)
图 5-19 E.coli 在热培养基中进入第二次复制周期的放射自显影图(a)及解释图(b)
(6) 复制的起始点与复制子 E.coli DNA 复制时,“眼球”的大小可以不同,但每一个 DNA 分子的“眼球”数仅限于一个。可见 DNA 的复制从一点开始,随着复制又同时向两侧移动,“眼球”部分渐渐扩大,最后成为两个环状分子,复制完毕(图 5-20 a)。噬菌体和质粒的环状 DNA 大都以这种方式复制,但也有复制从起始点发动后仅向一方进行的。
E.coli、噬菌体以及质粒 DNA 都是独立复制的,这种独立复制的单位称为复制子(replicon)。复制子需要有复制起始点(origin of replication)、与复制有关的蛋白质,如 DNA 聚合酶等起始 DNA 复制。一旦复制开始,即进行到底;也就是说,复制由起始点进行调节。
高等生物的 DNA 是一个很大的分子, 长度可达 E.coli DNA 的数百倍, 在分子内有好几个起始点 (图 5-20 b)。根据放射自显影推断, 起始点与起始点之间的距离随生物种类而异, 大致间隔 3 \times 10^{4} \sim 8 \times 10^{5} 碱基对, 相当于 E.coli 染色体全长的 $1% \sim 20%$ 。
高等生物的染色体是多复制子(multi-replicon),原核生物的染色体是单复制子,两者是不同的。因此,尽管每个复制叉的移动速度以细菌为快,但染色体全长的复制速度还是高等生物快。此外,染色体的复制速度随细胞种类和生理状态而异,但这不是由于复制叉移动速率(即复制速率)不同,而是由复制从哪个起始点开始决定的。
(a)
(b)
(a) E. coli 染色体 DNA 的复制。(b) 高等生物染色体 DNA 的复制。图中 O 代表复制起始点。
(7) DNA 聚合酶 DNA 复制的特点是以 DNA 自体作为模板,但在 DNA 聚合反应中还需要蛋白质,其中一类重要蛋白质是催化核苷酸聚合的 DNA 聚合酶。
有趣的是, 尽管科恩伯格最早成功完成了 DNA 的体外合成实验, 但后来的实验却发现, 他所使用的 DNA 聚合酶 I (DNA polymerase I) 并非是 E. coli 的 DNA 复制关键酶。第一项重要的实验证据来自德卢西亚 (Paula Delucia) 和凯恩斯 (1969) 对 E. coli 的 polA 突变体菌株的研究。由于 polA 基因负责编码 DNA 聚合酶 I ,polA 突变体丧失了该酶 $5’ \rightarrow 3’$ 的 DNA 聚合酶活性, 但是在这样的变异菌株中, DNA 复制照常进行。也就是说, E. coli 的 DNA 复制可以不依赖于该酶的聚合酶活性。后来发现, 原来 E. coli 内部含有另外 4 种 DNA 聚合酶: DNA 聚合酶 II (DNA polymerase II)、DNA 聚合酶 III (DNA polymerase III)、DNA 聚合酶 IV (DNA polymerase IV) 和 DNA 聚合酶 V (DNA polymerase V)。而真正发挥 DNA 复制作用的是 DNA 聚合酶 III, 它在细胞内含量较低, 但具有 3 种重要的酶活性: $5’ \rightarrow 3’$ 聚合酶活性, $3’ \rightarrow 5’$ 外切核酸酶 (exonuclease) 活性和仅对单链 DNA 发挥作用的 $5’ \rightarrow 3’$ 外切核酸酶活性, 这些酶活性是其介导 DNA 复制作用所必需的。相反, DNA 聚合酶 I、II、IV 和 V 则主要在 DNA 损伤修复中发挥了重要作用, 不同的 DNA 损伤需要不同聚合酶的参与, 其详细讨论可见第十二章重组与修复。
高等的真核生物细胞中含有更多的 DNA 聚合酶,迄今已经鉴定出至少 15 种不同的 DNA 聚合酶,分别被命名为 DNA 聚合酶 $\alpha$ 、 $\beta$ 、 $\gamma$ 、 $\delta$ 、 $\varepsilon$ 、 $\zeta$ 、 $\eta$ 、 \theta 、 $\iota$ 、 $\kappa$ 、 $\lambda$ 、 $\mu$ 、 $\sigma$ 、 $\phi$ ……这些 DNA 聚合酶和细菌的 DNA 聚合酶最大的不同在于,核 DNA 的复制需要不止一种 DNA 聚合酶的参与(如 $\alpha$ 参与引物合成, $\delta$ 和 $\varepsilon$ 参与链延伸等)。此外,DNA 聚合酶 $\gamma$ 参与线粒体 DNA 复制, $\beta$ 、 $\zeta$ 和 $\eta$ 则与 DNA 修复有关。
(8) DNA 链的延伸 构成 DNA 的两条核苷酸链是反向平行的, 因此复制叉向两侧推进时, 如在起始点的一侧合成方向为 $5’ \rightarrow 3’$ , 那么在另一侧, 合成方向必然为 $3’ \rightarrow 5’$ 。可是已知的 DNA 聚合酶只能以 $5’ \rightarrow 3’$ 方向合成 DNA。后来的研究发现, DNA 一条链的合成是连续的, 而另一条链的合成是不连续复制 (discontinuous replication)。在不连续合成的链上, 先合成 DNA 短链, 随后与已有的 DNA 长链结合。日本分子生物学家冈崎夫妇 (Reiji Okazaki, 1930—1975 和 Tsuneko Okazaki, 1933—) (1967) 证明, DNA 链的不连续合成确实存在, 这样的 DNA 短链被称为冈崎片段 (Okazaki fragment)。
图 5-21 是 E. coli DNA 复制过程的模式图。随着复制叉的移动,分开的两条 DNA 链分别合成一条新的互补链。在复制起始点的一侧,DNA 合成的方向与复制叉移动的方向相同,这条链被称为前导链(leading strand);但在另一侧,DNA 合成的方向与复制叉移动的方向相反,这条链被称为后随链(lagging strand)。深入研究又发现,DNA 复制需要先形成由若干核苷酸而成的 RNA 引物(RNA primer)。为什么先要合成 RNA 引物?那是因为 DNA 聚合酶不能独立开始新 DNA 的合成。E. coli 以 100 到 200 核苷酸的间隔形成这样的 RNA 引物。催化 RNA 引物合成的是称作引物酶(primase)的特殊 RNA 合成酶。引物酶以 DNA 为模板合成一小段 RNA,形成 DNA-RNA 杂合链。随后 DNA 聚合酶利用 RNA 链的 3’ 端羟基连接脱氧核苷酸,延伸 DNA 新链。
在后随链的不连续合成中,每个冈崎片段都需要一条 RNA 引物,当后面合成的一条冈崎片段在 $5’\rightarrow3’$ 延伸中遇到前面一条冈崎片段 $5’$ 端的 RNA 引物时,负责 DNA 合成的 DNA 聚合酶Ⅲ就会终止这条片段的合成,转而由 DNA 聚合酶 I 负责切除 RNA 引物并在该位置重新合成 DNA。这个 DNA 聚合酶 I 具有两种酶活性:一个是在 $5’\rightarrow3’$ 方向降解多核苷酸链的外切核酸
①单链 DNA 结合蛋白,有保护单链免受降解等的作用。②解旋酶的参与,使复制叉处双螺旋松开。③在引物酶作用下,引物 RNA 合成。④由于 DNA 聚合酶Ⅲ的作用,冈崎片段形成。⑤通过 DNA 聚合酶 I 的作用,引物 RNA 被除去,同时间隙被填补。⑥连接酶的作用,使不连续的短链连接成为 DNA 新链。⑦由于拓扑异构酶的参与,有利于复制叉前沿的 DNA 双螺旋打开。
酶活性,另一个是在同一方向合成 DNA 链的聚合酶活性。由于这两个酶活性,RNA 被除去,同时由于 DNA 链的延伸,填补了留下的空隙,最后由连接酶(ligase)将 DNA 短链与原有的 DNA 长链结合。因为在结合之先,RNA 引物已被切除,所以完成的 DNA 链中看不到 RNA 部分。
DNA 复制还有许多其他蛋白质参与。DNA 双螺旋必须在复制过程中旋转,因为两条链是相互缠绕的。这是由一类拓扑异构酶 (topoisomerase) 来完成的。它可把环状 DNA 从一种构型变为另一种构型 (图 5-22)。例如,拓扑异构酶 II 或促旋酶 (gyrase) 可以促使松环 DNA (relaxed DNA) 形成超螺旋 DNA (supercoiled DNA)。超螺旋的形成,出现很大的扭力,使双链 DNA 易于解开。为了把 DNA 双链分开成为单链,还需要解旋酶 (helicase) 的参与。此外,DNA 的复制还与其他一些蛋白质有关。通过上述这些蛋白质的协同作用,正确的复制过程才得以进行。
(9) DNA 复制过程的概括 DNA 的复制过程是: DNA 双链解开, 每一条链作为新链合成的模板, 最后形成两个相同的 DNA 分子。
图 5-21 中, 下方一条链的起始点右侧, 在 DNA 聚合酶的参与下, 新链连续合成, 方向为 $5’ \rightarrow 3’$ 。在复制叉前沿由于拓扑异构酶的作用, 形成超螺旋, 大大地增加了扭力, 再加上解旋酶等的参与, 使亲代双螺旋松开。松开后露出的单链部分由单链 DNA 结合蛋白 (single-stranded DNA binding protein) 协助, 保持稳定, 促使 DNA 合成连续进行。而在起点左侧, 新链必须间断合成, 因为所有 DNA 聚合酶是以 $5’ \rightarrow 3’$ 方向合成的。所以只有在模板链的新区段松开后, 新链片段才可开始合成。合成时先要有引物酶, 在引物酶的催化下, 以 DNA 为模板, 合成一段 RNA 短链, 作为引物。RNA 引物合成后, 接着在 DNA 聚合酶 III 的催化下, 以 DNA 为模板, 合成冈崎片段或 DNA 短链。当后一 DNA 短链合成后, 在 DNA 聚合酶 I 的参与下, 前一 DNA 短链的
RNA 引物被降解, 切除后留下的空隙被填补。然后在连接酶的催化下, 不连续的短链连接成为 DNA 新链(图 5-23)。最后两条新合成的链连同各自的模板链, 形成两个相同的 DNA 分子。
图 5-23 DNA 的不连续复制
(a) 先合成 RNA 短链(波浪线表示)作为引物, 引发 DNA 短链(直线表示)的合成。(b) 后一 DNA 短链合成完毕时, 前一 DNA 短链的 RNA 引物被降解。(c) 两合成短链间的缺口由 DNA 连接酶封闭。
(a)
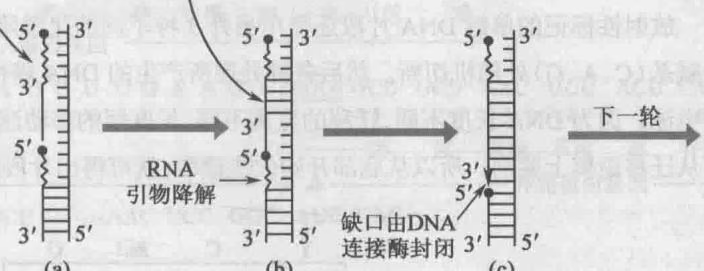
第三节 基因的本质
上面谈了 DNA 的结构与复制, 现在要谈基因的本质。
一、基因与DNA
在染色体中高度盘曲着的 DNA 分子是一条很长的双链。基因是 DNA 分子的片段,但这个片段没有固定的长度。不同基因在序列长短、组成结构和产物性质等方面千差万别。
(1) 核酸测序 要证实基因是 DNA 分子的一个区段, 一个方法是测定基因的核苷酸顺序和由它所决定的蛋白质的氨基酸顺序, 然后根据遗传密码, 比较两者的顺序, 看是否互相对应。关于 DNA 如何指导蛋白质的合成, 我们将在基因表达调控一章作详细介绍。
英国生物化学家桑格对核酸和蛋白质的序列测定都做出了巨大贡献。桑格于1975年提出了利用测定DNA链的长度来推断碱基序列的方法:即利用高分辨率的凝胶电泳分离不同大小的核苷酸序列,所有核苷酸序列的末端都标记了同位素(如 $^{32}$ P),因此可以通过放射自显影得到图像,最后根据胶片上的核酸影像的位置高低读出核苷酸的顺序。在电泳分离前,可以通过两种方法制备核苷酸样品:第一种方法是美国分子生物学家马克西姆(Allan Maxam, 1942—)和吉尔伯特(1977)发明的化学断裂法(chemical cleavage method),即采用不同的化学反应使待测定的核苷酸链分别在A、T、C、G处断裂,然后根据断裂片段的大小判断断裂位点的碱基组成;第二种方法是桑格和库森(Alan R. Coulson)(1977)发明的双脱氧法(dideoxy termination method)或链终止法(chain termination method),即在体外以待测核苷酸链为模板进行DNA合成,通过掺入不同的单核苷酸使得DNA合成分别在A、T、C、G处终止,然后根据合成片段的大小判断合成终止末端的碱基组成。下面我们先介绍如何利用化学断裂法测定DNA序列。
测定 DNA 的碱基顺序时,先要获得单链 DNA 片段。通常 DNA 片段长度为 100~200 核苷酸,于其 5’ 端用 ${}^{32}$ P 标记,如
1 | ^ {3 2} \mathrm{P} - \text { T C A G C C C C A T G G T T A A G A } |
经某种化学处理,使 DNA 片段中含 T 的地方被切断,产生一系列随机片段:
$$
^ {3 2} \mathrm{P} - \mathrm{T}
$$
1 | ^ {3 2} \mathrm{P} - \text { TCAGCCCCAT } |
1 | ^ {3 2} \mathrm{P} - \text { T C A G C C C C A T G G T } |
放射性标记的单链 DNA 片段还需用另外 3 种不同的化学降解法处理, 在核苷酸链的其他 3 个碱基 (C、A、G) 处随机切断。然后各种处理所产生的 DNA 随机片段混合物分别用同一凝胶进行电泳。因为 DNA 长度不同, 迁移的距离不同, 长度短的移动速度快, 即使只有一个碱基之差也可从迁移距离上鉴别。所以从底部开始依次读取, 就可得出片段的碱基顺序 (图 5-24)。
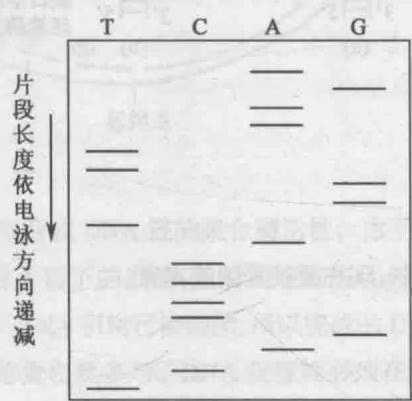
放射性标记的单链 DNA 片段用 4 种化学降解法处理,使核苷酸片段在特定碱基(T、C、A 或 G)处随机切断,产生不同长度的片段。通过电泳把不同长度的片段分开。根据所得的电泳凝胶的放射自显影照片,从底部最短的条带向上,一条条依次地读取,即可得出碱基顺序 5’-TCAGCCCCATGGTTAAGA-3’。
RNA 的序列测定可以直接利用化学或酶学方法将 RNA 进行切割,通过电泳收集同一长度的 RNA 片段,再分别进行碱基序列测定。或者利用分子克隆(molecular cloning)技术在体外条件下以 RNA 为模板合成互补 DNA(complementary DNA,cDNA),再将 cDNA 插入到细菌内染色体外的环状 DNA 分子——质粒(plasmid)中,利用 E.coli 进行质粒扩增。通过这种方法可以富集和 RNA 序列一致的 DNA 片段,供碱基序列测定之用。获得合适的 RNA 或 cDNA 序列后,具体的测序方法和 DNA 测序基本相同。
(2) 基因与多肽噬菌体 MS2 是一种很小的 RNA 噬菌体, 它的 RNA 不仅是遗传物质, 而且同时还是 mRNA。MS2 的 RNA 很容易在 E.coli 细胞中复制, 而且 RNA 分子很小, 仅有 3569 个碱基, 含有 4 个基因, 分别编码 A 蛋白 (也叫成熟蛋白)、外壳蛋白、裂解蛋白和 RNA 复制酶。当 MS2 侵染雄性 E.coli 时, 一个早期基因——RNA 复制酶基因先合成复制蛋白。该蛋白质与细菌细胞中某些蛋白质组合, 形成一种复合酶, 以病毒 RNA 为模板催化合成很多 RNA 分子。随后晚期基因启动, 合成 A 蛋白、外壳蛋白和裂解蛋白。A 蛋白、外壳蛋白负责装配新的病毒粒子, 裂解蛋白负责裂解 E.coli 细胞。
在说明了MS2的遗传组成后,我们可来考察基因与多肽间的共线性(colinearity)。美国分子生物学家菲耶尔(Walter Fiers,1931—2019)团队等经过多年工作,于1972年5月报道了MS2的整个外壳蛋白基因的碱基顺序,随后他们测定了整个RNA分子的核苷酸顺序。把MS2的一部分核苷酸顺序和一部分有关的氨基酸顺序并列起来观察,我们可以在分子水平上对基因的本质有进一步的认识(图5-25)。
从图5-25中可以看到:
① RNA 的核苷酸顺序和蛋白质的氨基酸顺序可以完全对应起来。例如,外壳蛋白有 129 个氨基酸,与这 129 个氨基酸相对应的核苷酸序列就是一个外壳蛋白基因。
② mRNA 的起始密码子是 AUG, 而终止密码子是 UAA、UAG 和 UGA。
③ 基因与基因间有基因间区域(intergenic region)。
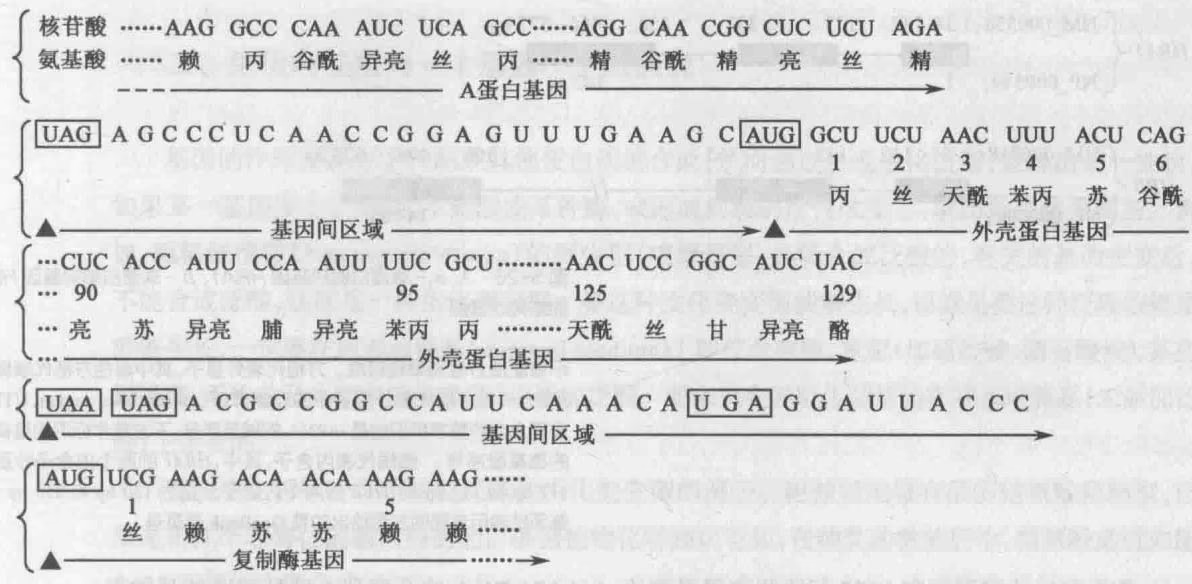
比较 RNA 的核苷酸顺序和蛋白质的氨基酸顺序, 可见两者是相对应的。外壳蛋白基因和复制酶基因的起始密码子都是 AUG, 合成的蛋白质按理应由甲酰甲硫氨酸起始, 但甲酰甲硫氨酸可在翻译后(或翻译时)切除(详见第十五章), 所以外壳蛋白的第一个氨基酸为丙氨酸, 复制酶的第一个氨基酸为丝氨酸。外壳蛋白有两个串联的终止密码子, 而且第二个终止密码子后面的第七个三联体又为一个终止密码子, 这可能使翻译程序在正确位置停止更为可靠。
(3) 割裂基因与重叠基因 进入 20 世纪 70 年代, 基因操作技术发展起来, 以前难以分析的高等生物的基因也可以分析了。结果, 基因概念得到了进一步发展。
从 mRNA 链的起始密码子 AUG 开始到终止密码子为止的连续核苷酸密码所对应的基因序列称为编码序列或编码区 (coding sequence, CDS)。细菌、病毒等的编码序列是连续的,其中的核苷酸顺序都翻译为蛋白质;但在真核生物中,多数基因在转录为初级转录物 (primary transcript) 后,其中的一部分序列在 mRNA 加工过程中被切除,也就不能翻译为蛋白质。真核基因转录后不被切除、保留在成熟 mRNA 中的基因序列被称为外显子 (exon);被切除、未保留在成熟 mRNA 中的部分则被称为内含子 (intron),也曾被称为间插顺序 (intervening sequence)。可见,真核基因的编码序列会被内含子隔开,因此被称为割裂基因 (split gene)(我们将在基因组一章详细介绍割裂基因的发现过程)。
不同真核基因外显子和内含子的组成不同。例如,人的血红蛋白分子有4条多肽链,其中两条 $\alpha$ 链各有142个氨基酸,两条 $\beta$ 链各有147个氨基酸。这两种肽链分别由 $\alpha-$ 珠蛋白基因和 $\beta-$ 珠蛋白基因编码。以 $\alpha_{1}-$ 珠蛋白编码基因HBA1和 $\beta-$ 珠蛋白编码基因HBB为例(图5-26),它们各有3个外显子和2个内含子,编码序列(黑框)被内含子(细线)间隔开。再如,人的视网膜母细胞瘤(retinoblastoma, RB)基因长达 $200\mathrm{kb}$ (kilo base pair, 千碱基对),其中含有26个内含子。但高等生物的基因中也有不具有内含子的,如组蛋白基因等,这类基因为数较少。
据研究,内含子的突变率比外显子高。这可能表明非编码的内含子 DNA 更易发生突变而不受选择上的限制,从而更有利于形成进化上有用的新基因。
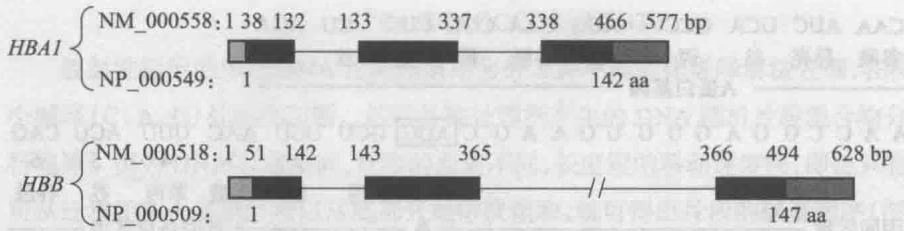
示意图由方框和细线组成。方框代表外显子,其中黑色方框代表编码序列,灰色方框代表外显子中的非翻译区(untranslated region, UTR)。方框上方的数字标识的是 mRNA 的碱基序号,下方数字标识的是多肽的氨基酸序号。细线代表内含子,其中,HBA1 的两个内含子分别为 117 bp 和 149 bp 长,HBB 的两个内含子分别为 130 bp 和 850 bp 长。基因结构示意图的左侧给出的是 GenBank 登录号。
桑格和他的同事们在1977年还测定了噬菌体 $\phi X$ 174 DNA的全序列。这种噬菌体是单链环状DNA分子,它含有的碱基数还不到5400个,可是却编码9种蛋白质,这是一个令人感到迷惑不解的事。根据 $\phi X$ 174 DNA编码的9种蛋白质的相对分子质量,可以估计出编码这些蛋白质所要的核苷酸数,而得出的核苷酸数明显地超出 $\phi X$ 174 DNA分子所能容纳的数量。但在其核苷酸全序列被测定以后,这个看似矛盾的问题立即迎刃而解了。 $\phi X$ 174的一种蛋白质的编码顺序内可以存在着另一种蛋白质的遗传信息,这就是重叠基因(overlapping gene)。这里应当指出,用两个不同阅读框编码两种不同的蛋白质,只是表明基因是重叠的,但每一阅读框的密码子还是不重叠的。图5-27表示 $D$ 基因和 $E$ 基因的阅读框是重叠的,所以它们是重叠基因。
在病毒中发现重叠基因,看来这是节约空间的一个有效方法。但在这种情况下,一个碱基的改变可能会影响有关的两个重叠基因,所以可能因此受到严格的限制。
1 | \text { 前体(N-乙酰瓜氨酸) } \rightarrow \text { 鸟氨酸 } \rightarrow \text { 瓜氨酸 } \rightarrow \text { 精氨酸 } \quad\begin{array}{c}{{\mathrm{NH} _ {2}}}\\{{\mathrm{R}}}\end{array}\quad\begin{array}{c}{{\mathrm{O}}}\\{{\mathrm{C}}}\\{{\mathrm{NH}}}\\{{\mathrm{R}}}\end{array}\quad\begin{array}{c}{{\mathrm{NH} _ {2}}}\\{{\mathrm{C}}}\\{{\mathrm{NH}}}\\{{\mathrm{R}}}\end{array}\quad\begin{array}{c}{{\mathrm{H} _ {2} \mathrm{N}}}\\{{\mathrm{C}}}\\{{\mathrm{NH}}}\\{{\mathrm{R}}}\end{array}\quad\begin{array}{c}{{\mathrm{NH} _ {2}}}\\{{\mathrm{R}: \mathrm{H} - \mathrm{C} - (\mathrm{NH} _ {2}) _ {3} -}}\\{{\mathrm{COOH}}}\end{array} |
换句话说,基因 $arg_{1}$ 突变后,不能由前体转变成鸟氨酸,但鸟氨酸以后的化学反应能正常地进行,所以不仅供应精氨酸后能生长,而且供应鸟氨酸或瓜氨酸后也能生长。基因 $arg_{2}$ 突变后,不能由鸟氨酸转变为瓜氨酸,但瓜氨酸转变为精氨酸的化学反应可照常进行,所以供应瓜氨酸或精氨酸都能生长。基因 $arg_{3}$ 突变后,不能由瓜氨酸转变为精氨酸,所以只有供应精氨酸才能生长。
那么这些基因如何控制生化反应的呢?原来基因决定酶的形成,酶控制生化反应,从而控制代谢。20世纪30年代,比德尔和塔特姆利用粗糙链孢霉的生化突变型提出了“一个基因一个酶”(one gene-one enzyme)假说。根据这个假说,粗糙链孢霉中精氨酸合成过程可以写成下面的式子:
三、人的先天代谢缺陷
人体中苯丙氨酸的代谢有几条路线(图 5-29)。某些苯丙氨酸构成我们身体的蛋白质,某些苯丙氨酸转变为酪氨酸,最后成为黑色素。某些酪氨酸构成我们身体的蛋白质,某些酪氨酸上的氨基为一个氧原子所代替,氧化成为对羟苯丙酮酸,再通过尿黑酸、乙酰乙酸而逐步降解为 $CO_{2}$ 和水。这条代谢途径的每一步都需要特定的酶,这些酶在正常人体中都能产生。
但人类中有一种先天代谢病,叫作尿黑酸尿症(alkaptonuria)。这种患者的尿液在空气中放置一段时间会变黑,而正常人的尿液不会变黑。尿液中变黑的东西是尿黑酸,尿黑酸本身是无色的,但在空气中被氧化后就变黑色。正常人的血液中有一种尿黑酸氧化酶(homogentisic acid oxidase),能把尿黑酸变成乙酰乙酸,最后分解成 $\mathrm{CO}_{2}$ 和水。尿黑酸尿症患者不能形成尿黑酸氧化酶,因此尿黑酸不能进一步转变,就直接在尿液中排泄出来。
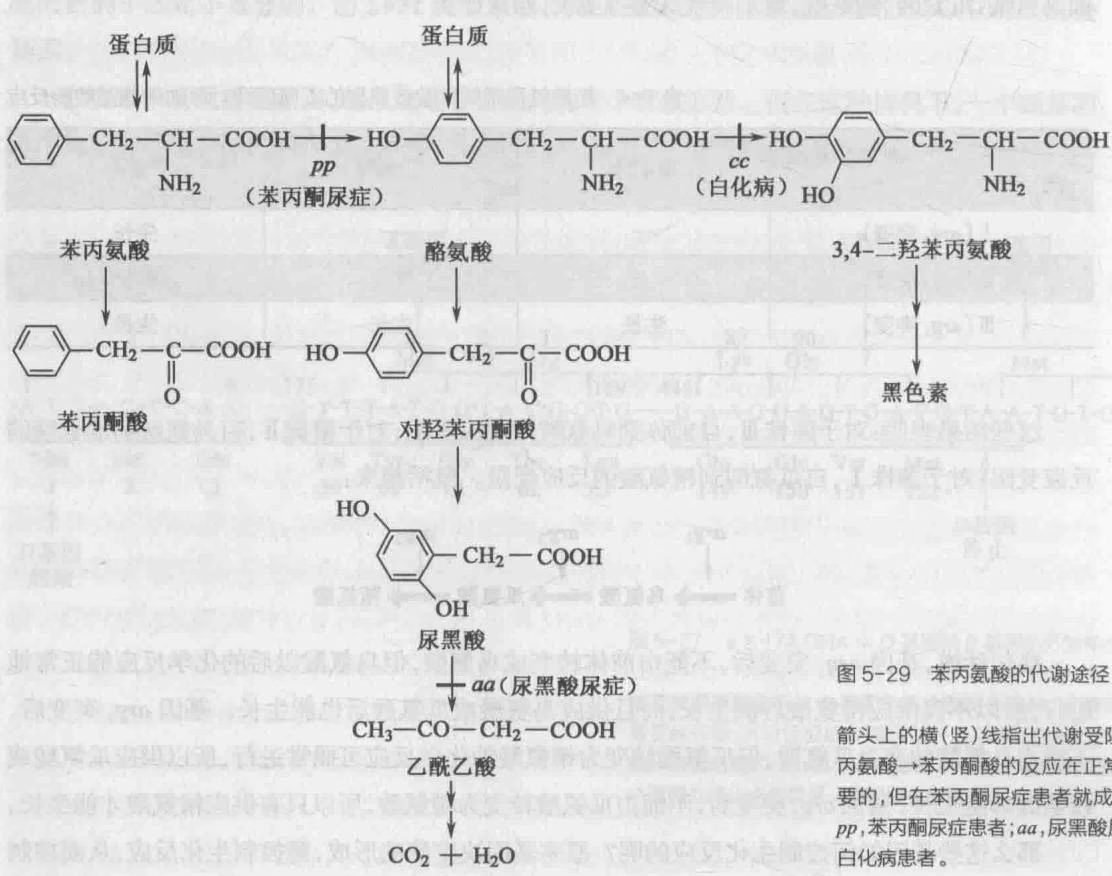
箭头上的横(竖)线指出代谢受阻的地方。苯丙氨酸→苯丙酮酸的反应在正常人中是不重要的,但在苯丙酮尿症患者就成为重要的了。pp,苯丙酮尿症患者;aa,尿黑酸尿症患者;cc,白化病患者。
如果把尿黑酸尿症基因写作 a,那么尿黑酸尿症患者的基因型是 aa,正常人的基因型是 AA 或 Aa,一定要有 A 基因才能形成尿黑酸氧化酶,才能不患尿黑酸尿症病。A 相对 a 显性。
白化病(albinism)也是由于同样的原因。白化病患者黑色素合成发生障碍或几乎不能形成黑色素。全白化的人皮肤很白,带粉红色,头发淡黄色,眼睛的虹膜粉红色,怕光,视力也差些。上面已谈到,黑色素的前体是酪氨酸,酪氨酸经过酪氨酸酶(tyrosinase)的作用成为二羟苯丙氨酸,然后再通过酪氨酸酶系的作用,最后形成黑色素。
白化病患者不能显示出酪氨酸酶的作用。如果我们把决定酪氨酸酶的基因称为 C,则正常人的基因型是 CC 或 Cc,而白化病的人是 cc,因为白化病患者没有 C 基因,就没有酪氨酸酶,不能形成黑色素。
还有苯丙酮尿症(phenylketonuria)也是由于一个隐性基因引起的。pp个体不能形成苯丙氨酸羟化酶(phenylalanine hydroxylase),不能把苯丙氨酸转变为酪氨酸,所以血液中苯丙氨酸累积起来,进一步引起下列变化:①过量的苯丙氨酸损害中枢神经系统,影响智力发育;②苯丙氨酸不能变成酪氨酸,只能通过苯丙氨酸转氨酶的作用,变为苯丙酮酸,在小便中排出,所以叫作苯丙酮尿症;③血液中苯丙氨酸太多,抑制酪氨酸代谢,抑制酪氨酸变成黑色素,皮肤中的黑色素特别少,所以患者的肤色和发色很浅。
既然苯丙酮尿症是由苯丙氨酸过量引起的,那么可否从食物中去除苯丙氨酸呢?苯丙氨酸是必需氨基酸之一,是构成蛋白质的一种原料,而人又是苯丙氨酸依赖型,自己不能制造,必须由食物供应。不过一般饮食中所供应的苯丙氨酸往往过量,所以如能在婴儿期及早诊断明确,控制食物中的苯丙氨酸的分量,就不会过量摄入苯丙氨酸,因而可以防止对中枢神经系统的损害。这是遗传病可以防治的一个例子。
除了氨基酸代谢,脂肪和糖类代谢也可由于缺乏适当的酶而受到阻碍。例如极少数婴儿不能利用半乳糖,所以不能喂以人奶和牛奶,因为奶中含有乳糖,乳糖分解后会产生半乳糖。如果喂以奶类,血中半乳糖水平显著升高,随后排出于尿中。临床症状一般很严重,呕吐和腹泻,肝逐渐肿大,白内障,生长延缓,智能低下,往往导致婴儿期死亡。如这种婴儿的食物中完全没有乳糖和半乳糖,血中半乳糖水平很快降低,健康状况大大改进。如发现得早,食物中不含有半乳糖,则生长发育可以相当正常。如治疗稍迟,肝已某种程度受损,白内障,智能低,一生如此,不能恢复。不能同化半乳糖的病,叫作半乳糖血症(galactosemia)。
半乳糖既可以在身体中形成半乳糖脂,后者是构成神经系统的重要原料,又像其他糖类一样,可以作为能量的来源。把半乳糖导入糖类的代谢途径中,通常需要半乳糖先转变为葡萄糖衍生物,它的代谢途径如下:
1 | ① \text { 半乳糖 } + \mathrm{ATP} \xrightarrow {\text { 半乳糖激酶 }} 1 - \text { 磷酸半乳糖 } + \mathrm{ADP} |
1 | \text { ② } 1 - \text { 磷酸半乳糖 } + \text { 尿苷二磷酸葡糖 } \xrightarrow {\text { 1 - 磷酸葡糖尿苷转移酶 }} \text { 尿苷二磷酸半乳糖 } + 1 - \text { 磷酸葡糖 } |
1 | ③ \text { 尿苷二磷酸半乳糖 } \xrightarrow {\text { 异构酶 }} \text { 尿苷二磷酸葡糖 } |
那么半乳糖血症的人究竟缺少哪种酶,使半乳糖的代谢受阻呢?表5-5是对一些临床患者和正常人的分析结果。
表 5-5 红细胞溶血后半乳糖酶活性比较
| 平均活性 μmol·L-1转换/(h·g细胞)(37°C) | |||
| 半乳糖激酶 | 1-磷酸葡糖尿苷转移酶 | 异构酶 | |
| 正常人(GG) | 0.10 | 4.8 | 0.32 |
| 半乳糖血症患者(gg) | 0.08 | <0.02 | 0.35 |
| 患者的父母(杂合子Gg) | 2.9 | ||
从上表可以看到,半乳糖激酶和异构酶的活性在正常人和患者中是相同的,但转移酶的活性在3种人中差异很大,正常人最高,患者最低,而杂合子约为正常人的一半。因为患者的转移酶活性很低,所以1-磷酸半乳糖很少转变为1-磷酸葡糖,1-磷酸半乳糖就堆积起来,抑制了葡萄糖代谢途径中磷酸葡糖变位酶的作用,阻碍了1-磷酸葡糖向6-磷酸葡糖的转变,葡萄糖代谢受阻,所以半乳糖血症患者就出现上述各种严重症状。
上面所讲的先天代谢缺陷都是由于一种酶的缺陷而造成的,由隐性基因所控制。事实上,早在20世纪初,当孟德尔的工作被重新发现后不久,英国医生加洛德就通过对上述的尿黑酸尿症、白化病等人类代谢疾病的研究提出了“一个突变基因一种代谢障碍”(one mutant gene-one metabolic block)的假说。尽管当时对生化代谢途径还知之甚少,但这一假说第一次提示了基因的功能。到了20世纪30年代,随着生化理论和技术的发展,这一假说被发展成了“一个基因一个酶”假说,在分子水平揭示了基因的功能。再后来,人们又发现大量的酶以及其他蛋白质都是由两条甚至更多的不同肽链组成的多聚体,这些肽链有时相同(形成同源多聚体),更多的时候相互不同(形成异源多聚体),如我们前面所提的血红蛋白就是α链和β链构成的四聚体。不同的肽链由不同的基因编码,所以“一个基因一个酶”假说又被进一步修改为“一个基因一条多肽”(one gene-one polypeptide)。有趣的是,随着我们对生命本质的不断探索,基因的概念还将继续被修改。近年来的研究逐渐发现了许多不具有蛋白质编码功能的非编码RNA(non-coding RNA, ncRNA),它们同样是基因的产物,更参与了细胞内许多重要的生命活动。关于ncRNA的内容,我们将在基因组和基因表达调控两章中作详细介绍。
四、位置效应与顺反子
在前面一节,我们从代谢功能、编码功能的角度定义了基因,提出了基因的本质,但是基因的内部结构是怎样的呢?这段 DNA(或 RNA)序列的内部具有怎样的构造?这些内部构造又决定了基因的哪些特性?为了回答这些问题,我们将在下文中从结构角度分析基因的行为和特征。
(1) 位置效应 果蝇中, 棒眼性状 (Bar) 的遗传方式是伴 X 显性, 它是由 X 染色体的微小重复引起。突变体的复眼数减少, 复眼像棒状, 所以有这个名称。
果蝇的唾腺染色体上有明显的横纹,大小和位置固定,可用作染色体区段的识别标志(详见染色体畸变一章)。如图5-30,X染色体有一“16A”区域。当该区域发生重复,出现相邻的两份拷贝时,出现棒眼性状。如果这个区域回复为1份时,复眼正常,而当这区域增至3份时,出现重棒眼性状,复眼数目进一步减少。
斯特蒂文特(1927)通过杂交,得到各种等位基因型,其中棒眼(B)、重棒眼(BB)和野生型(+)
正常复眼
正常X染色体片段
发生重复的X染色体片段
可以以各种方式组合起来。他为了了解各种基因型的复眼大小,计算了复眼中的小眼数,结果见表5-6。
表 5-6 黑腹果蝇复眼中的平均小眼数
| 基因型 | 雌蝇 | 雄蝇 | |||
| 16A区域的数目 | 小眼数 | 基因型 | 16A区域的数目 | 小眼数 | |
| +/+ | 2 | 780 | + | 1 | 740 |
| +/B | 3 | 360 | B | 2 | 90 |
| +/BB | 4 | 45 | BB | 3 | 30 |
| B/B | 4 | 70 | |||
| BB/BB | 6 | 25 | |||
斯特蒂文特根据这个结果分析得到,棒眼基因(B)是不完全显性,棒眼杂合子(+/B)的小眼数比纯合子(B/B)多得多。而且他特别观察到,B基因位置的不同,对表型也有显著影响。例如B/B个体和BB/+个体都有4个“16A”区域,可是小眼数不同,这就叫作基因的位置效应(position effect)。
在 $+ / BB$ 个体中,两个 $B$ 在同一染色体上,借用化学上的术语,是处于顺式(cis)位置,对小眼数的影响大些,而在 $B / B$ 个体中,两个 $B$ 在不同染色体上,称为反式(trans)位置,对小眼数的影响要小一些。这说明“16A”区域在染色体上的排列影响最后的表型。可见基因在染色体上的位置有功能上的意义。
(2) 顺反子 曲霉 Aspergillus nidulans 的菌丝是单倍体。菌丝的顶部形成一连串的细胞, 即分生孢子。孢子萌发, 又长成菌丝。如果把两个单倍体菌株混合培养, 有时不同菌株的菌丝互相融合, 使两种不同的核处于同一细胞质中。这种情况叫作异核体 (heterokaryon)。在异核体中, 两个核偶尔会发生融合, 形成二倍体核。它们的菌丝产生二倍体分生孢子。这种孢子就可分离出来, 长成二倍体菌落, 进行遗传学分析。
在曲霉中,曾经发现许多依赖腺嘌呤的营养缺陷型,要在培养基中加些腺嘌呤才能生长。其中两个缺陷型对应的突变基因 $ad_{16}$ 和 $ad_{8}$ 在第一染色体上。这两缺陷型的杂合子仍旧是缺陷型,这表明 $ad_{16}$ 和 $ad_{8}$ 是等位的。可是它们的后代中大约出现0.14%的野生型,这又表明 $ad_{16}$ 和 $ad_{8}$ 不是在同一染色体的同一位置上,两者之间可以发生交换。因为这交换不是发生在减数分裂中,而是出现在二倍体菌丝的有丝分裂中,所以叫作体细胞交换(somatic crossing over)或有丝分裂交换(mitotic crossing over)。
我们现在把体细胞交换的过程和所得的结果图示如图5-31。杂合子(2)和(4)是野生型,这表明 $ad_{16}$ 和 $ad_{8}$ 都是隐性的。杂合子(1)是突变型,当然也很容易理解。可是把(3)和(4)相比,两者的基因型相同,单是排列不同,为什么顺式排列 $(ad_{16}ad_{8}/++)$ 是野生型,而反式排列 $(ad_{16}+/+ad_{8})$ 是突变型呢?
顺式杂合子(4)是野生型,而反式杂合子(3)是突变型,顺式和反式的表型效应不同,似乎很难理解。这是因为我们把 $ad_{16}$ 和 $ad_{8}$ 分别来考虑,把它们看作是两个基因座(locus)上的两个基因,认为 $ad_{16}/+$ 的表型应该是野生型, $ad_{8}/+$ 的表型也应该是野生型,现在反式杂合子(3)是突变型,就不好理解。但是如果把 $ad_{16}$ 和 $ad_{8}$ 看作是一个作用单位——顺反子(cistron)——中的两个位点,那么这个现象就容易说明(图5-32)。
在顺式杂合子(4)中,一个顺反子的两个位点都发生突变,而另一顺反子正常,所以杂合子的表型是野生型。而在反式杂合子(3)中,两个顺反子各有一个位点发生突变,没有一个顺反子具有形成正常表型所需的遗传信息,所以它的表型是突变型。
根据上面的顺反实验(cis-trans test),我们可以这样说,如果把作用单位——顺反子看作一个基因,那么基因内的不同位点上可以发生突变,基因内的不同位点间亦可以发生重组。
(3) 互补实验 噬菌体 T4 感染 E. coli, 可以引起溶菌。有一组 T4 突变型能够产生大而边缘清楚的噬菌斑, 叫作快速溶菌 (rapid lysis, r), 而野生型噬菌体的噬菌斑小而边缘模糊。噬菌体染色体的好几个不同座位都可发生突变, 引起速溶。本泽 (Seymour Benzer, 1921—2007) (1960) 对一组叫作 r II 的速溶突变型进行了详细而深入的研究。
突变型 rⅡ能在 E. coli 菌株 B 上生长, 形成大而清楚的噬菌斑, 但不能在 E. coli 菌株 K(λ) 上生长, 这里 K(λ) 表示该菌株带有噬菌体 λ, 是溶原菌。另一方面, 野生型 rⅡ $^{+}$ 在菌株 B 和 K(λ)
(1) 突变型
(2) 野生型
图 5-31 曲霉中体细胞交换的过程及结果
(3) 突变型
(4) 野生型
$ad_{16}$ 和 $ad_{8}$ 是两个腺嘌呤缺陷型突变基因。两缺陷型菌株杂交,二倍体杂种是缺陷型,但在后代中还会出现少量野生型。
上都能生长,形成小而模糊的噬菌斑。它们的关系见表5-7。
表 5-7 T4 的突变型 rⅡ和野生型 rⅡ $^{+}$ 在不同菌株上的噬菌斑
| E.coli菌株 | |||
| B | K(λ) | ||
| T4噬菌体品系 | rII | +(大而清楚) | - |
| rII+ | +(小而模糊) | +(小而模糊) | |
因为 rⅡ的生长是有条件的,所以可用选择技术,把重组子检出。本泽把不同的 rⅡ突变型一对对地进行杂交,测量每对突变位点间的重组频率。方法是这样的:将每对 rⅡ突变型(如 $r^{x}, r^{y}$ )品系对 E. coli 菌株 B 进行复感染。感染一定要同时进行,否则要出现排斥现象,超感染(superinfection)的噬菌体很快地被宿主的 DNA 酶破坏,因而不能参加重组。形成噬菌斑后,收集溶菌液——子代噬菌体。把溶菌液接种在 E. coli 菌株 B 上,估计溶菌液中的全部病毒数,因为两个 rⅡ突变型 $(r^{x}, r^{y})$ 和重组子 $r^{+}$ (或 $r^{x}r^{y}$ )都能生长;同时把溶菌液接种在 E. coli 菌株 K(λ) 上,估计野生型重组子 $r^{+}$ 数,因为只有 $r^{+}$ 重组子能够生长(图 5-33),而双突变型重组子 $(r^{x}r^{y})$ 不能检出。所以我们估计总重组子的方法是,把 $r^{+}$ 重组子的数目乘以 2,再除以总噬菌斑数,公式如下:
1 | \frac {2 \times (r ^ {+} \mathrm{噬菌斑数})}{\mathrm{总噬菌斑数}} = \frac {2 \times \mathrm{在} E . \mathrm{coliK} (\lambda) \mathrm{上才能生长的噬菌斑数}}{\mathrm{在} E . \mathrm{coliB} \mathrm{上才能生长的噬菌斑数}} \times 100 |
现举例说明计算方法。两突变型 $r^{x}$ 与 $r^{y}$ 杂交,将溶菌液稀释为 $10^{-6}$ ,取其 0.1 mL 涂布在 B 株上,生成的噬菌斑数为 525;又将溶菌液稀释为 $10^{-2}$ ,取其 0.1 mL,接种于 K( $\lambda$ ) 株上,得噬菌斑数为 370,则这两突变位点间的重组率为
1 | \frac {2 \times 3 7 0 \times 1 0 ^ {2}}{5 2 0 \times 1 0 ^ {6}} \times 1 0 0 \% = 0. 0 1 4 1 \% |
应用上述方法,即使低至0.0001%的重组率也可简单而正确地检出。根据很多两点杂交的结果,可以作一连锁图(图5-34)。从图上可以看到,图距基本上是相加的。例如,r47与r104间的图距是1.3,r104与r101间的图距是1.0,而位于两边的r47与r101间的图距是2.2,很接近1.3与1.0之和。
本泽又注意到,rⅡ突变型可以分成两组——A和B。A组的一个突变型和B组的一个突变型同时感染E. coli K(λ),可以互补。所谓互补(complementation),就是两个突变型同时感染E. coli
图 5-33 噬菌体基因重组值测定的实验方法
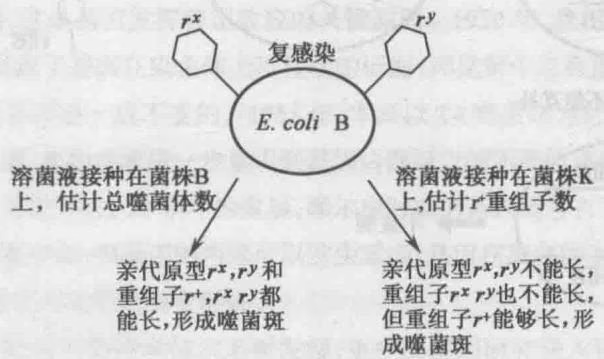
(b) rⅡB的两个突变型不能互补
| r47 | r104 | r101 | r106 | r51 | r102 |
|---|---|---|---|---|---|
| ←1.3→ | ←1.0→ | ←1.6→ | ←1.9→ | ←1.6→ | |
| ←2.2→ | |||||
| ←2.9→ | |||||
| ←3.9→ | |||||
| ←2.2→ | |||||
| ←3.9→ | |||||
| ←5.8→ | |||||
| ←2.8→ | |||||
| ←3.9→ | |||||
| ←5.2→ |
图 5-34 噬菌体 T4 的 rⅡ 区域的部分遗传学图
两 r II 突变型间的距离以重组值表示,去掉 %。图距大致上是相加的。
K(λ)时,可以互相弥补对方的缺陷,共同在菌体内增殖,引起溶菌,释放原来的两个突变型。可是A组内的两个突变型,或B组内的两个突变型不能互补。可见A组的一个功能有缺陷,可为B组所补偿;而B组的一个功能有缺陷,可为A组所补偿(图5-35)。
很有意义的是,实验结果显示,所有 A 组突变型都在 rⅡ区域的一边,是一个作用单位,所有 B 组突变型都在 rⅡ区域的另一边,是另一个作用单位,所以 rⅡ区域包括两个顺反子。
一旦我们接受基因是一个作用单位,我们就可应用互补实验来确定有同一表型效应的两个突变型是等位的,还是非等位的(图5-36)。详细地说,就是看反式排列时是否有互补效应,如反式时互补,说明两突变位点处于不同的顺反子中,如不互补,说明它们属于同一顺反子。已知两个突变型属于同一顺反子后,就可进一步用标准的重组作图法来看是否属于同一位点:如有重组,表明这两突变型处于不同的位点;如测不出重组值,就把它们放在同一位点上。
现在再回过来讲本泽关于 T4 的 rⅡ实验。本泽分析了 rⅡ区域大约 2000 个突变型,知道这些突变分布在 308 个位点上,分属两个相邻的顺反子。他估计,rⅡ区域有 400~500 个突变位点,他把这些突变位点叫作突变子(muton)。根据他的定义,突变子是基因内部序列改变后可以产生非野生型表型的最小单位。
应用重组作图法,计算野生型的出现频率,推算重组值,确定连锁基因的图距和顺序。两个最远的突变型间约有10%的重组值,而两个最近的突变型间约有0.01%的重组值,但很多突变型之间的两点杂交实验中,没有发现重组子,表明这些突变型是在同一位点上。本泽把基因内出现重组的最小区间称为重组子(recon),所以重组子是基因内不能由重组分开的遗传单位。关于连锁重组以及重组作图的方法,我们会在连锁交换一章中作更系统的介绍。
(a) rⅡA和rⅡB的突变型可以互补
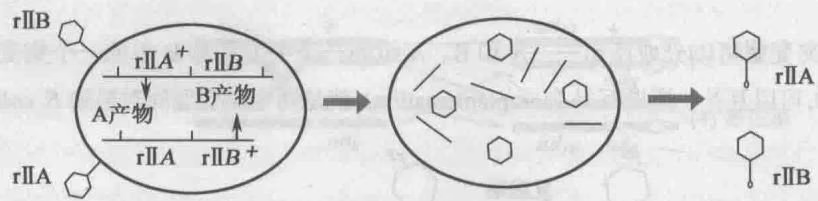
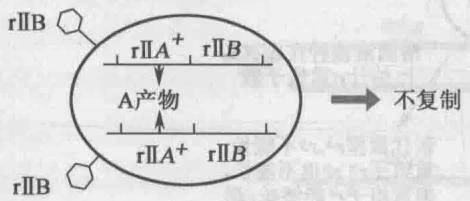
(a) 当 E. coil K( $\lambda$ ) 被 rⅡA 和 rⅡB 突变型同时感染时,rⅡA 突变型有完整的 rⅡB $^{+}$ 基因,能产生 rⅡB $^{+}$ 基因产物(B 产物);同样的,rⅡB 突变型能产生 rⅡA $^{+}$ 基因产物(A 产物)。因为这两基因产物都存在,所以能进行复制,溶菌后,释放 rⅡA 和 rⅡB 突变型。(b) 两个感染的噬菌体突变型都是属于 rⅡB 时,只能产生 rⅡA $^{+}$ 基因产物(A 产物),噬菌体不能复制,不发生溶菌。
| 图5-36 利用互补实验证明两个突变型的等位关系 $m_{1}$ 和 $m_{2}$ 是两个突变。两突变型杂交,反式杂合子是突变型,说明 $m_{1}$ 和 $m_{2}$ 是等位的;反式杂合子是野生型,说明 $m_{1}$ 和 $m_{2}$ 是非等位的。顺式杂合子均为野生型。 |  |
五、基因概念的发展
在前面的内容中,我们列举了大量的实验工作说明基因的本质和特点。现在我们从历史的角度简要回溯一下基因概念发展的历程。
在孟德尔提出了性状由成对遗传因子决定,遵循分离定律和自由组合定律之后,丹麦植物学家约翰森在1909年首次提出基因一词,用于描述孟德尔所说的遗传单位。但基因是否真的存在呢?1910年,摩尔根利用果蝇中红眼、白眼的相对性状和杂交实验,指出基因确实存在,基因在染色体上呈直线排列,而且基因能够决定生物的性状。摩尔根和弟子们继续以果蝇为研究材料开展实验,1915年出版《孟德尔遗传的机制》(Mechanism of Mendelian Heredity),1926年出版《基因论》(The Theory of the Gene),极大地丰富了孟德尔遗传的理论,阐明基因是遗传物质重组、突变和功能的最小单位,简称为“三位一体”的基因概念。
在这之后, 多项生物化学研究进展为进一步明确基因属性提供了关键性证据。20 世纪 40 年代, 艾弗里等人的肺炎双球菌实验证明遗传物质的属性是 DNA。50 年代, DNA 双螺旋结构的发表提供了基因能够自我复制的结构基础。60 年代, 中心法则的提出进一步明确了基因和多肽之间的对应关系。与此同时, 遗传学家则是从遗传分析的角度对基因的遗传属性进行了深入探索。先是马勒的弟子、美国遗传学家奥利弗 (Clarence Paul Oliver, 1898—1991) 在 30 年代末, 利用不同眼色突变的果蝇品系进行研究, 结果发现一个基因的内部也可以发生重组。换句话说, 基因不再是重组的单位。随着连锁交换的进一步研究, 遗传学家发现重组可以在任意的核苷酸对之间发生, 这一属性我们且留到连锁交换一章再做详细介绍。1941 年, 比德尔和塔特姆利用粗糙链孢霉的生化突变型提出了“一个基因一个酶”假说, 为基因是功能的单位做了很好的诠释, 基因能够对应特定的产物酶, 这是基因发挥表型效应的关键原因。1950 年, 麦克林托克报道了玉米籽粒色斑不稳定遗传, 发现了基因在染色体上可移动的证据 (详见第十二章重组与修复), 这说明基因在染色体上的位置并不是一成不变的。1955 年, 本泽以 T4 噬菌体为材料提出了顺反子的概念。根据他的实验结果, 生物学家进一步意识到基因内部可以有不同位点的多个突变, 基因也不是突变的最小单位。可见, 经过 30 余年的发展, 摩尔根时期的基因概念有了巨大的飞跃, 基因是决定一个酶的遗传信息单位, 但基因的内部可以发生重组, 基因在染色体上的位置可能发生移动, 基因内部可以有多种不同类型的突变形式。
在接下来的20年中,分子遗传学技术不断发展,更多的基因研究深入到分子层面,关注基因的结构与表达,揭示了基因的其他重要特点。例如,1961年,雅各布和莫诺在大肠杆菌的乳糖诱导实验中提出了操纵子模型,第一次提出了基因的表达受到环境因素的调控。时至今日,基因的表达调控手段及其机制仍然是遗传学和生物化学的研究热点。事实上一个等位基因能否表达(在合适的时间、合适的位置表达出合适的量),而不是一个等位基因是否存在,决定了表型能否实现。1977年,桑格和同事们测定完噬菌体ΦX174的全部序列之后发现了基因重叠现象,即不同基因可以使用重叠的DNA序列进行遗传信息的编码。这意味着基因在染色体上并不是完全串联的排列。同年,夏普和罗伯茨在观察到腺病毒基因的RNA-DNA杂交结果后,提出真核基因的编码序列是割裂的。这个发现有两个深远的意义:一方面遗传学家意识到真核基因的编码序列在染色体上不是连续的。另一方面,由于割裂的存在,内含子有机会出现不同的切除方式,一个基因可能会产生多个成熟的mRNA,对应多个多肽产物。真核生物利用这种方法增加遗传信息多样性是如此的“智慧”,让研究者们惊叹,我们留到基因表达调控一章再和大家做详细介绍。
毫不夸张地说,基因概念的发展历史几乎就是遗传学前100年的发展历史,离开基因就无法理解遗传变异,也就无法学习和研究遗传的规律了。但基因概念的发展从未停止,我们将在后面的章节中继续和大家一一介绍。
第四节 重组 DNA 技术
随着遗传因子——基因的本质被不断揭示,对特定基因(片段)进行克隆和分析的需求也不断增长。在这样的背景下,重组DNA技术(recombinant DNA technique)于20世纪70年代兴起,它是指在体外将不同来源的DNA进行剪切和重组,形成嵌合DNA分子(chimeric DNA molecule),然后将之导入宿主细胞,使其扩增表达,从而使宿主细胞获得新的遗传特性,形成新的基因产物。重组DNA技术的发展反过来促进了我们对基因性质及功能的研究。
重组 DNA 技术有 3 个基本步骤: ①从合适材料分离或制备目的基因或特定 DNA 片段; ②目的基因或 DNA 片段与载体连接, 构成重组 DNA 分子; ③重组 DNA 分子引入宿主细胞, 在其中扩增和表达。
一、限制性内切酶
在说明如何得到目的基因以前,先介绍一些 DNA 操作中常用的工具酶——限制性内切核酸酶(restriction endonuclease),简称限制性内切酶或限制酶(图 5-37)。
DNA 是生物大分子, 进行 DNA 操作时, 必须加以切割。这就需要内切核酸酶把 DNA 链在特定部位切断。这样的酶长时间求之而未得, 直到 1970 年初才分离得到, 这可以说是开拓基因操作新领域的关键。
限制性内切酶能识别 DNA 的特定碱基序列,并在特定位点切断 DNA 链。限制性内切酶识别的碱基顺序视酶的种类而定,可包括 4 至 7 个碱基顺序。这些碱基顺序大都沿中心轴回转 $180^{\circ}$ 可以相反重合,具有回文对称性。切断点也由酶的种类决定,有两条链在同一位置切断的,
1 | arrayl 5 ^ - C C T CG A G G - 3 ^ |
1 | H p a \text { II } \begin{array}{c} 5 ^ {\prime} - \text { CCGG } - 3 ^ {\prime} \\ 3 ^ {\prime} - \text { GGC } - 5 ^ {\prime} \end{array} |
1 | B a m H I arrayc 5 ^ - G G A T C C - 3 ^ |
1 | \text { Kpn I } \begin{array}{c} 5 ^ {\prime} - \mathrm{GGTACC} - 3 ^ {\prime} \\ 3 ^ {\prime} - \mathrm{CCATGG} - 5 ^ {\prime} \end{array} |
1 | B g l \text { II } \begin{array}{c} 5 ^ {\prime} - \text { AGATCT } - 3 ^ {\prime} \\ 3 ^ {\prime} - \text { TCTAGA } - 5 ^ {\prime} \end{array} |
1 | M b o I arrayc 5 ^ - G A T C - 3 ^ |
1 | E c o R I arrayc 5 ^ - G A A T T C - 3 ^ |
1 | \text { Pat I } \begin{array}{c} 5 ^ {\prime} - \text { CT G CAG } - 3 ^ {\prime} \\ 3 ^ {\prime} - \text { GACGTC } - 5 ^ {\prime} \end{array} |
1 | \begin{array}{l l} \text { E c o R I I } & 5 ^ {\prime} - \mathrm{CC} \left(\frac {\mathrm{A}}{\mathrm{T}}\right) \mathrm{GG} - 3 ^ {\prime} \\ & 3 ^ {\prime} - \mathrm{GG} \left(\frac {\mathrm{T}}{\mathrm{A}}\right) \mathrm{CC} - 5 ^ {\prime} \end{array} |
1 | \text { Sal I } \begin{array}{c} 5 ^ {\prime} - \mathrm{GTCGAC} - 3 ^ {\prime} \\ 3 ^ {\prime} - \mathrm{CAGCTG} - 5 ^ {\prime} \end{array} |
1 | H a e \text { III } \begin{array}{c} 5 ^ {\prime} - G G C C - 3 ^ {\prime} \\ 3 ^ {\prime} - C C G G - 5 ^ {\prime} \end{array} |
1 | \begin{array}{c c} \text {Sma I} & 5 ^ {\prime} - \mathrm{CCCGGG-3} ^ {\prime} \\ & 3 ^ {\prime} - \mathrm{GGCCC-5} ^ {\prime} \end{array} |
1 | H h a I arrayc 5 ^ - G C G C - 3 ^ |
1 | S s t \mathrm{I} \begin{array}{c} 5 ^ {\prime} - \text {GAGCTC} - 3 ^ {\prime} \\ 3 ^ {\prime} - \text {CTCGAG} - 5 ^ {\prime} \end{array} |
图5-37 几种常用的限制性内切酶
1 | arrayc |
1 | T a q I arrayc 5 ^ - TCGA - 3 ^ |
箭头表示识别顺序中的切断部位。请注意:有些限制性内切酶为平切型,如 Hae Ⅲ,但大多数限制性内切酶为错切型,如 Ava I。错切型限制性内切酶在 DNA 双链上造成交错切口,使形成的两限制片段产生黏性末端,即具有自身互补的单链末端。
1 | \begin{array}{c} \downarrow \\ 5 ^ {\prime} - \text { AAGCTT } - 3 ^ {\prime} \\ 3 ^ {\prime} - \text { TTCGAA } - 5 ^ {\prime} \\ \uparrow \end{array} |
1 | X b a I arrayc 5 ^ - TCTAGA - 3 ^ |
1 | H p a I arrayc 5 ^ - G T T A A C - 3 ^ |
1 | X h o I arrayc |
切口为平切类型,如图5-38中的HindⅡ,也有两条链的切断位点相隔几个碱基的,切口属错切类型,如图5-38中的EcoRI。
酶的名称是由细菌学名加上菌株名和号数构成,例如 Hind II 是最早发现的限制性内切酶之一,是从 Haemophilus influenzae Rd 菌株中分离的。又如 EcoR I 是最为常用的限制酶之一,是从有 R 质粒的 E.coli 菌株分离的。
细菌细胞除了含有限制性内切酶以外,还存在有所谓修饰酶(modification enzyme)。修饰酶也能识别特定碱基顺序,但它的作用是在特定部位将碱基甲基化(methylation)。例如使腺嘌呤成为6-甲基腺嘌呤,或使胞嘧啶成为5-甲基胞嘧啶,从而不受限制性内切酶的作用。
例如,Haemophilus influenzae Rd 菌株有一对修饰酶和限制性内切酶,其中修饰酶是 Hind I,限制酶是 Hind II。Hind II 识别由 6 碱基对组成的特定碱基序列,以平切方式切断 DNA 双链,但 Hind I 将其中碱基之一腺嘌呤甲基化,成为 6-甲基腺嘌呤(图 5-38)。一旦被 Hind I 修饰后,该 6 碱基对已不能被 Hind II 切断。EcoR I 的识别部位也受其他修饰酶的修饰,在识别部位中存在的 4 个腺嘌呤中,中间 2 个可被甲基化(图 5-38)。
限制性内切酶和修饰酶常以成对方式存在于细胞内。其中也有集限制性内切酶和修饰酶的
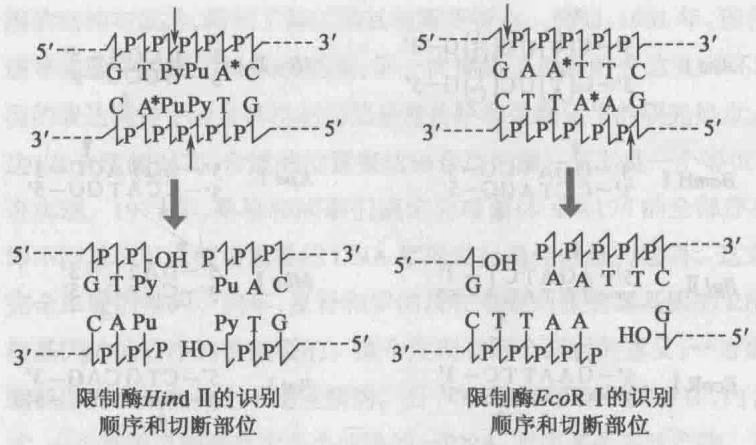
磷酸二酯键结合的切断都发生在3’—OH与磷酸之间,生成的DNA片段的5’端是磷酸,3’端是一OH。请注意,HindⅡ的切口是平切方式,EcoRI的切口是错切方式。因为许多限制酶在DNA双链上产生交错切口,所以限制片段形成自身互补的单链末端。Pu代表嘌呤A或G;Py代表嘧啶T或C。受到修饰后,A*可成为6-甲基腺嘌呤。一旦发生修饰,限制酶就无法再进行切割。
活性于同一酶中的。情况可能是这样的:易受限制性内切酶作用的部位预先由修饰酶加以修饰,这样可以防止细胞内 DNA 被自身限制性内切酶消化。但从外部侵入的噬菌体 DNA 以及由其他细菌来的 DNA 没有这种修饰,所以受到限制性内切酶的作用后即被分解。可见限制性内切酶有保护作用,能抑制外源性 DNA 进入细胞内。
已知的限制性内切酶已超过350种,但识别的顺序仅85种左右。这是因为在很多情况下从不同细菌来的限制性内切酶识别同一顺序,即存在着所谓同切点酶(isoschizomer)之故。
二、目的基因的分离和制备
要得到目的基因或特定 DNA 片段的方法很多,可以人工合成,可以从基因组中分离,也可以用 mRNA 为模板获得互补 DNA 等。
(1) 基因的人工合成 下面介绍一种用化学酶法合成基因。如果我们知道了某种 tRNA 的核苷酸顺序,那么我们马上就可写出与之互补的脱氧核苷酸顺序。这样,我们就有可能从核苷酸出发,合成这种基因。
用化学方法合成寡核苷酸的小片段,并使寡核苷酸小片段间部分互补。通过碱基配对,互补的区段形成双链。添加连接酶,促使小片段核苷酸互相连接。重复这些步骤,就能连接成长链(图5-39)。Khorana等就用这种方法合成了丙氨酸tRNA(tRNA $^{Ala}$ )的基因。
但这个方法现在已不常用,除了要合成小片段 DNA。已经有了其他比较容易的方法来获得目的基因或特定 DNA 片段。
(2) 基因分离 分离和制备的策略随基因类别和目的要求而异。
① 单链酶法 DNA 双链中, G≡C 碱基对有 3 个氢键, A=T 碱基对仅有两个氢键, 所以
(a) 先合成寡核苷酸小片段。(b) 在缓慢的冷却过程中, 互补的区段形成双链。(c) 然后通过核苷酸连接酶的作用, 在邻近的核苷酸间形成共价键, 把相邻的核苷酸区段连接起来。
DNA 分子中 G≡C 碱基对含量高时,稳定性高。当 DNA 分子加热处理时,双链上 A=T 碱基对含量较高的区段首先变性,双链分开成为单链,而 G≡C 碱基对含量较高的区段在这一温度下仍保持双链状态,这样就有可能把 DNA 不同部分区分开来。例如海胆 rRNA 基因含有相当高的 G≡C 碱基对,约占其碱基总量的 65%。当我们用热处理海胆 DNA 分子时,因为 rRNA 基因部分含有的 G≡C 碱基对特别丰富,所以所需的解链温度较高。在合适的热变性条件下,A=T 碱基对含量高的区段可局部打开,形成单链,这时可用专门降解单链的 S1 核酸酶处理,仅保留 G≡C 含量高的双链部分,再通过 CsCl 梯度密度离心,即能获得 rRNA 基因。
② 反转录(reverse transcription)法 细胞生物学家早就知道,有些细胞执行特定功能,含有特定的单一基因产物,例如,家蚕绢丝腺细胞产生大量丝素蛋白(fibroin),哺乳动物胰岛细胞分泌大量胰岛素,红细胞富含血红蛋白等。这类特化细胞含有制造特定蛋白质的大量mRNA,所以从这类细胞制备mRNA比较容易。
mRNA 的 3’ 端附有多聚 A, 所以通过含有寡 dT 柱后, 可以把 mRNA 与其他 RNA (主要是 rRNA) 分开。得到 mRNA 后, 以它为模板, 在反转录酶 (reverse transcriptase) 作用下, 合成 cDNA。反转录酶跟其他 DNA 聚合酶一样, 起反应时要有引物存在, 由于 mRNA 3’ 端带有多聚 A, 有 200 个碱基左右, 可以跟寡 dT 杂交, 起到引物的作用, 在反转录酶催化下, 合成互补 DNA 链。其次, 经碱处理, 除去 RNA 链。这样得到的 cDNA 3’ 端发生折叠, 在分子内部形成部分双链, 再经 DNA 聚合酶的作用, 可合成完整的双链。折转部分以及留下来的单链部分, 用 S1 核酸酶切除。图 5-40 表示整个操作过程, 单拷贝基因的制备常用这种方法。这样得到的 cDNA 可插入质粒, 再导入细菌中, 需要时即可扩增, 得到大量 cDNA。但是应该注意到, cDNA 仅仅是跟 mRNA 互补的 DNA, 不是基因本身。mRNA 5’ 端邻近部分在制备 cDNA 过程中往往丢失, 高等生物的 DNA 在转录后, 内含子部分被切除, 才成为成熟的 mRNA, 所以用上述方法制备的 DNA 丢失了内含子部分。又基因两侧的启动区和终止区也没有了, 因此也无法了解有关基因调控部分的结
图5-40 反转录法制备cDNA的流程图
一条寡dT短链与mRNA的多聚A尾杂交。寡T区段作为反转录酶作用的引物,反转录酶以mRNA为模板合成互补DNA链。产生的cDNA末端有一发夹形环。碱处理后,mRNA链降解,发夹形环成为DNA多聚酶的引物,在该酶的作用下完成配对的另一条链的合成。然后单链环由S1核酸酶切除,形成双链DNA分子。
构。要解决这些问题,必须构建基因组文库,以便从中筛查含有完整基因或完整基因不同区段的重组质粒。
③ 重组 DNA 技术与目的基因的制备 所需要的基因或 DNA 片段得到后, 必须与载体连接起来, 形成重组 DNA 分子, 导入宿主细胞, 进行扩增, 以获得大量目的基因或 DNA 片段。
重组 DNA 技术中所用的载体主要是质粒和噬菌体。质粒是闭环 DNA 分子,能独立复制,如 F 质粒、R 质粒等。质粒能在菌株间、甚至在种间传递抗生素耐性,具有独特的限制性酶切位点。
很多质粒经过遗传改造后具有选择性遗传标记,并有一些可供利用的限制性酶切位点,实验工作者可以根据需要选用。例如广泛应用的质粒 pBR 322 (plasmid number 322 produced by Bolivar and Rodriquez) 就是根据需要改建的,有 5 个独特的酶切位点和两个抗生素耐性基因。质粒经某一限制性内切酶切割,然后把目的 DNA 片段插入,在连接酶的参与下,再形成环状,成为重组 DNA 分子。
病毒,特别是噬菌体,也被广泛地用作载体。病毒比质粒大,遗传上也较复杂,但易于感染宿主细胞。遗传上改造过的λ噬菌体用得很多,这种噬菌体的中央部分不是必需的,可以切除,插入外源DNA,而且插入的片段往往可以大一些。还有,为了特殊需要,还可应用其他形式的载体。例如黏粒(cosmid)是噬菌体与质粒的组合,它有质粒的很多优点,又可包装到噬菌体头部,便于进入宿主细胞。
重组 DNA 分子构建成功后, 要导入宿主细胞进行扩增, 以取得所需要的 DNA 片段(图 5-41)。如载体为病毒, 可以通过感染导入宿主细胞; 如果是纯化的 DNA, 如质粒 DNA, 可通过转化或转染(transfection)进入宿主细胞。把细胞置于 $\mathrm{Ca}^{2+}$ 存在情况下, 在低温中用 DNA 处理, 效果可以提高, 因为这种处理可以使宿主细胞的细胞膜出现漏隙, DNA 易于进入, 结果自然有助于目的基因的制备。
④ 从基因组文库筛查目的基因 什么是基因组文库(genomic library)? 把某种生物的基因组 DNA 切成适当大小, 分别与载体组合, 导入微生物细胞, 形成克隆(clone)。汇集这些克隆, 应包含基因组中的各种 DNA 顺序, 每种顺序至少有一份代表。这样的克隆片段的总汇, 称为基因
(a)用限制性内切酶处理,把质粒DNA和外源DNA在标有箭头处切断。这里假定,质粒只有这种内切酶的一个切割点。(b)切断后,DNA分子有“黏性的”单链末端,外源DNA的长度看两切割点间的距离而定。(c)在外源DNA(供体)和质粒DNA(受体)的黏性末端间形成氢键,再经DNA连接酶的作用,在供体和受体的邻接核苷酸间形成共价键。(d)通过转化,把带有外源DNA的重组质粒导入没有质粒的细菌细胞中。质粒进入新宿主细胞后,在一定条件下,增加拷贝数,扩增所需的DNA片段。
组文库。
把基因组中不同 DNA 片段克隆到载体后, 希望尽可能多地把全基因组 DNA 包括进去。例如人的单倍体基因组约有 3.0 \times 10^{9} bp, 如切成长度为 15~20 kb 的 DNA 片段, 并克隆到 $\lambda$ 噬菌体中, 大约 $10^{6}$ 个独立的重组载体就足以保证全部基因组在这克隆集合体中至少有一份代表了。
建成基因组文库后,要从中选出含有目的基因的克隆,实非易事。一个简易有效的方法是噬菌斑杂交法(plaque hybridization)。先把带有重组载体的细菌接种在平板上,待形成噬菌斑后,取一张易于DNA结合的硝酸纤维素薄膜覆盖在培养基表面,使分布在培养皿中的噬菌斑DNA影印在薄膜上。然后揭下这张薄膜,置于碱溶液中使DNA变性。膜在80℃中真空干燥,使单链DNA附着于膜上。将膜放在含有同位素标记的单链核酸探针溶液中温育,这种探针能与目的DNA顺序互补。探针可以是从某些组织中分离出来的mRNA,也可以是根据所需基因的蛋白质产物的氨基酸顺序而合成的寡聚脱氧核糖核酸(oligodeoxynucleotide),或为来自另一克隆DNA的限制性酶切片段。待放射性探针与膜上互补的DNA顺序杂交后,洗去过剩的探针,用放射自显影法来检测膜上哪一部分与探针杂交,从而可以知道培养皿上哪个位置的噬菌斑带有需要检出的DNA。接着从平板上挑出相应的噬菌斑进行扩增,即可得到所需的外源DNA或目的基因(图5-42)。
如载体为质粒时,可同样地进行检出。先把含有重组质粒的细菌涂平板,再把细菌菌落(或克隆)影印到硝酸纤维素薄膜。把薄膜上的细菌原位溶菌,将其DNA变性,然后用探针进行菌落杂交(colony hybridization),放射自显影后,挑选出相应的菌落,进行扩增,同样可以得到目的基因或所需DNA片段。
利用重组 DNA 技术不仅可以更直接、便捷地研究基因的结构和功能,而且能够在临床患者
图 5-42 噬菌斑杂交法
①把噬菌斑转移到硝酸纤维素薄膜上。②碱变性后,与 $^{32}$ P标记的探针(例如cDNA)温育。③洗净干燥后,紧贴X光底片,使之感光。④放射自显影。⑤平板保存于4℃。⑥把对应于放射自显影底片上的噬菌斑分离出来。
身上进行基因诊断,在生产实践中合成特定蛋白质,等等。现今,重组DNA技术还在不断发展之中,以重组DNA为基础的其他遗传学实验技术也是日新月异,这都极大地促进了遗传学理论的发展,并对其他研究和生产领域产生了积极作用。在本书中,受篇幅所限,我们暂不对这些新的技术内容作更多的介绍。
第五节 基因型分型技术
在摩尔根和他的弟子揭示了基因可在自发或诱发的条件下发生各种类型的突变之后,他们设计了多种突变检测技术来鉴定某个特定突变型等位基因的存在,例如Muller-5技术可以用来检测 X 染色体连锁的隐性突变,尤其是致死突变。在他们之后,比德尔和塔特姆(1945)利用不同培养基的设计实现了粗糙链孢霉的营养突变菌株的筛选。这些突变检出的工作充分依靠了不同等位基因的表型效应不同,且能通过适当技术检测。随着分子遗传学技术如重组 DNA 技术的不断发展,更多的遗传分析研究直接关注 DNA 水平的遗传变异而非表型变化。鉴定 DNA 有无变异、区分不同类型的突变型等位基因成为了新的遗传学分析需求,一系列基因型分型(genotyping)技术应运而生,推动了基因结构和功能的深入研究。
视频7基因型分型技术
基因型分型指利用分子生物学方法分析样本的 DNA 序列,从而确定其基因型的实验过程。简言之,就是确定基因的 DNA 序列组成,从而明确其中是否携带变异以及携带怎样的变异信息。当下的基因型分型技术各式各样,面向各行各业的不同需求。我们按照技术发展的时间顺序,介绍几种代表性的检测技术。
一、Southern印迹
Southern 印迹(Southern blotting)又称 DNA 印迹,是一种基于分子杂交的基因型分型技术。1975 年,牛津大学的分子生物学家萨瑟恩(Edwin Mellor Southern,1938—)以 rRNA 的编码基因为例,建立了将 DNA 转移到硝酸纤维素膜上,再利用 DNA-DNA 杂交检测特定 DNA 片段的方法。这种方法也直接以 Southern 的名字进行了命名。后来人们利用和 Southern 印迹类似的杂交方法去分析 RNA 和蛋白质,将 RNA 的印迹分析称为 Northern 印迹(Northern blotting),常规蛋白质印迹分析称为 Western 印迹(Western blotting),双向电泳后蛋白质分子的印迹分析称为 Eastern 印迹(Eastern blotting)。
印迹法(blotting)是一种将凝胶电泳技术、固定化技术及分子亲和技术融合一体的综合性技术(图5-43a)。在获得特定的DNA样本之后,一般会采用限制性酶切消化的方法进行预处理,这是因为直接从组织或细胞中提取的DNA样本分子量很大,很难分离。酶解后利用凝胶电泳技术将DNA样本分离。凝胶内部是有着特定孔径的胶体组织,在电场的作用下,带负电的DNA向正极移动,由于不同相对分子质量大小的DNA受到的阻力不同,迁移率就不同,从而实现分离。在胶里预先混入核酸的荧光染料,用紫外线照射电泳后的凝胶就可以肉眼观察所有的DNA,它们通常连续分布,呈现弥散条带。接下来需要将已按大小分离的DNA样品转移到固相载体上,这一过程就是印迹,可以通过毛细作用或电场作用。通常用来转移DNA的固相载体是硝酸纤维素膜和尼龙膜等,转移后的固相载体表面可以保持电泳分离的DNA类型,且它们的分布及活性均不变。印迹完成后,利用高浓度的无关DNA(如鲑鱼精DNA)对膜进行封闭,再与已标记同位素的DNA探针进行杂交。杂交的过程中,DNA探针利用互补配对原则识别与之互补的序列,并结合在膜上,经放射自显影成像。
显然, Southern 印迹可以检测不同样本中是否含有具有特定寡核苷酸序列的基因片段, 从而确定该样品属于野生型或突变型。如果不同样本中存在不同类型的突变, 可通过设计不同的 DNA 探针加以区别 (图 5-43 b)。因此探针的设计是 Southern 印迹技术的核心之一。
随着 Southern 印迹技术的推广,生物学家发现了新的问题:Southern 印迹的实验操作较为复杂,同时可检测的样本数量较小,不能适用于大量样本的快速检测。20 世纪 90 年代,同样基于 DNA 杂交原理的 DNA 芯片(DNA chip)技术成功开发和应用于基因型分型。DNA 芯片又称 DNA 微矩阵 (DNA microarray), 它是将一系列已知序列的 DNA 探针分子以高密度固定于支持物上, 通过与标记的 DNA 样品分子进行杂交实现标记 DNA 的序列分析。DNA 芯片技术的重要特点就是高通量、大规模、平行化和集约化, 但是与此同时, 芯片杂交的非特异性要显著高于 Southern 印迹, 芯片杂交结果需要的分子生物学实验加以佐证。
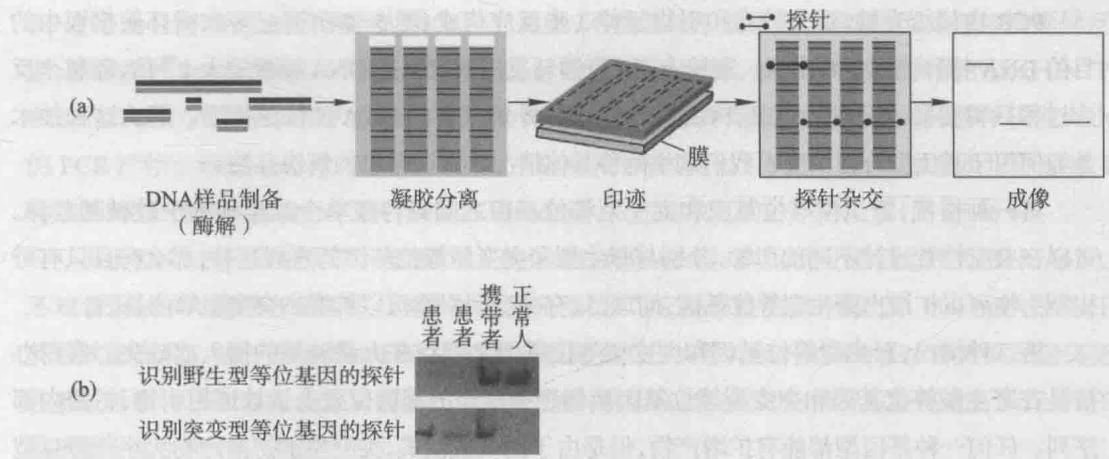
(a) Southern印迹基本流程。(b)利用Southern印迹对4名戈谢病(Gaucher disease)家系成员进行基因型分型(图片引自Theophilus等,1989)。
二、聚合酶链式反应
1985年,美国生物化学家穆利斯(Kary Banks Mullis, 1944—2019)成功开发出聚合酶链式反应(polymerase chain reaction, PCR)技术,这是一种在体外利用DNA聚合酶,将少量DNA模板通过循环反应特异性扩增的实验方法,也是当下最常见的分子生物学技术之一,被广泛用于基因的分离、合成、鉴定与序列分析等。
图 5-44 PCR 基本流程
PCR 的链式反应包括变性、退火和延伸 3 个基本步骤。经过 1 个循环的反应,1 分子的 DNA 可以扩增为 2 个。以此类推,经过 30 个循环,1 分子 DNA 理论上可以扩增至 10 亿多个 DNA。
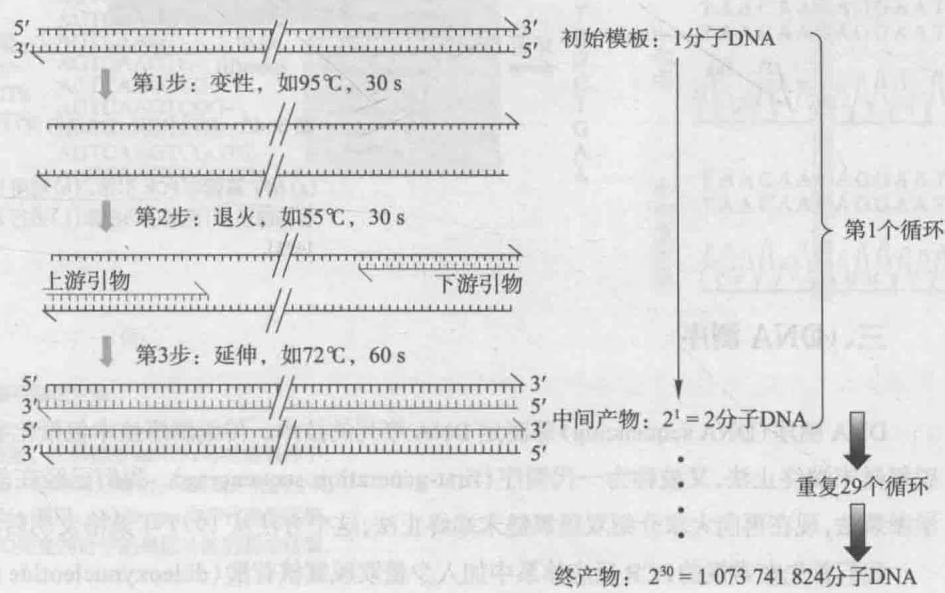
PCR 由模板变性、退火结合和引物延伸 3 步反应构成(图 5-44),通过多次循环使模板中的目的 DNA 特异性地扩增出来。理论上,30 个循环反应就可以把 DNA 模板放大 $2^{30}$ 倍,而整个反应过程只需要数十分钟。可见,PCR 技术能在体外实现目的 DNA 的快速扩增。那么这种技术是如何用于基因型分型的呢?我们试举两种具体情况来说明常见的解决办法。
第一种情况,野生型等位基因和突变型等位基因之间只存在单个或连续的少数碱基差异。可以在突变位置设计不同的引物,分别与野生型和突变型等位基因的序列互补,那么有且只有野生型引物可以扩增出野生型等位基因,同理,只有突变型引物可以扩增出突变型等位基因。
第二种情况,野生型等位基因和突变型等位基因之间存在大量碱基的插入或缺失。常用办法是在野生型等位基因和突变型等位基因两侧序列相同的基因位置上设计通用引物,扩增内部序列。任何一种基因型都能有扩增产物,但是由于插入或缺失,突变型的扩增产物大小与野生型明显不同,通过凝胶电泳进行鉴定。在前面章节的学习中,已知亨廷顿舞蹈病的发病机制是HTT基因内部过多的三核苷酸(CAG)的串联重复数目,通过PCR方法可以根据扩增产物的大小快速鉴定亨廷顿舞蹈病家系成员的基因型(图5-45)。
从以上两种情况的分析中不难发现,利用 PCR 实验进行基因型分型,引物的设计是至关重要的。
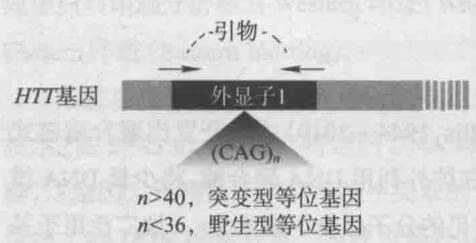
(a)
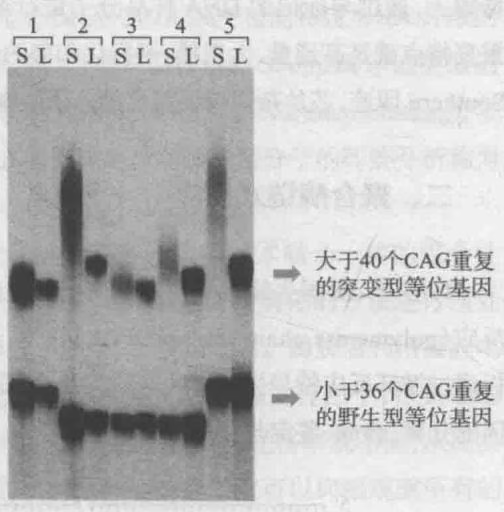
(b)
图5-45 利用PCR技术进行HTT不同等位基因的基因分型
(a) HTT 基因与 PCR 引物。(b) 利用 PCR 技术对 5 名亨廷顿舞蹈病患者的精子(S)和淋巴母细胞(L)进行 HTT 的基因分型(引自 Duyao 等, 1993)。
三、DNA测序
DNA 测序 (DNA sequencing) 即测定 DNA 序列的技术。传统测序技术包括化学断裂法和双脱氧链末端终止法,又被称为一代测序 (first-generation sequencing)。我们已经在前面介绍了化学断裂法,现在再向大家介绍双脱氧链末端终止法,这个方法从 1977 年桑格发明后流行至今。
我们首先在常规的 PCR 反应体系中加入少量双脱氧核苷酸 (dideoxynucleotide triphosphate,ddNTP) 混合物, 这类核苷酸因为缺少了 3’ 羟基, 不能继续形成磷酸二酯键, 因此可终止延伸反应。同时, 各个 ddNTP 用不同的荧光分子进行标记, 便于识别。由于 DNA 聚合酶不区分 dNTP 和 ddNTP, 当少量的 ddNTP 被掺入到 PCR 体系中后, 就会得到以 ddNTP 结尾的各种长度大小的 PCR 产物。经过电泳分离之后, 不同大小的片段依次排开。与此同时, 机器探头可以通过 4 种 ddNTP 上携带的荧光分子进行碱基序列的分辨, 从而读取正确的序列信息 (图 5-46 a)。
由于 DNA 测序直接读取了被测 DNA 的全部序列信息,因此可以用于基因型判断(图 5-46 b)。不难看出,DNA 测序在基因型分型中的适用范围更广,它能够检测出不超过 1 000 bp 大小的任何形式的突变。另一方面,Southern 印迹需要根据突变位点设计互补的探针,PCR 需要根据突变性质设计引物,但 DNA 测序只需要一个测序引物,就能在突变未知的情况下直接进行操作,并在基因型分型的同时获得突变的具体信息。
除了以上3种常用的基因型分型技术,当下基因型分型技术的发展迅速,渗透到了基础研究、生产实践和临床医学等领域。例如,生物学家通过诱变获得了某基因的突变杂合子拟南芥(但事先并不知晓会发生何种表型变化),可以利用基因型分型快速鉴定自交 $F_{1}$ 中哪些是野生型,哪些是杂合子和突变纯合子(而不需要依赖表型分析进行判断)。又如,在临床上,基因型分型技术被应用于各类遗传测试(genetic testing),又称为DNA测试(DNA testing),指的是从DNA水平对人类遗传性疾病进行分析检测的方法。遗传测试根据对象不同可以分为新生儿筛查(newborn screening)、产前诊断(prenatal diagnosis)和携带者测试(carrier testing)。新生儿筛查和产前诊断对新生儿和胚胎的临床常规诊断具有重要的辅助价值,而特定遗传病患者群的携带者测试在人群疾病风险预测中具有重要作用。遗传测试的先驱,华人医学家简悦威(1936—)在20世纪70年代最先利用杂交技术、限制性内切酶酶切技术和Southern印迹开发了α-地中海贫血、镰状细胞贫血和 $\beta-$ 地中海贫血等孟德尔疾病的基因型分型方法,并成功应用于产前诊断。
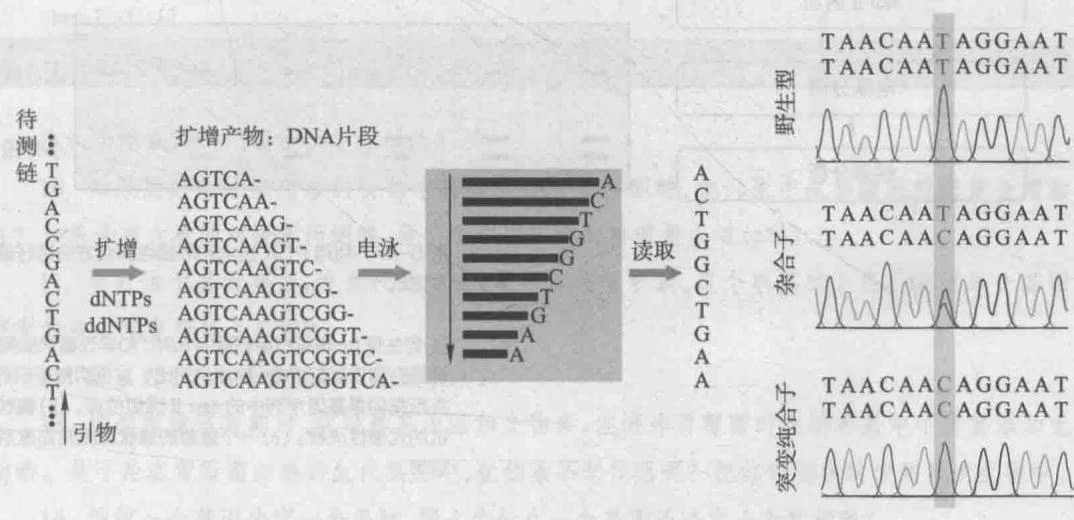
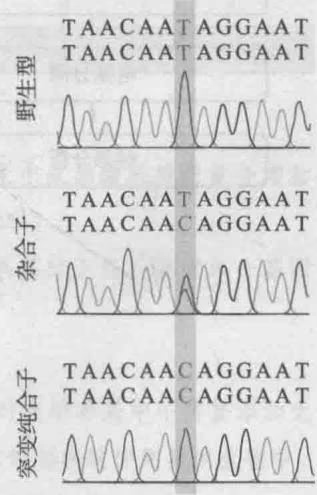
(a) Sanger 测序基本原理的示意图。在引物和 ddNTPs 存在的条件下,PCR 反应形成大小不同的产物。经电泳分离后,可根据产物大小和 ddNTP 标记的荧光信号读取 DNA 顺序。(b) Sanger 测序代表性结果,依次显示的是野生型、杂合子和突变纯合子的基因片段的测序结果,灰色标出的是差异位点。
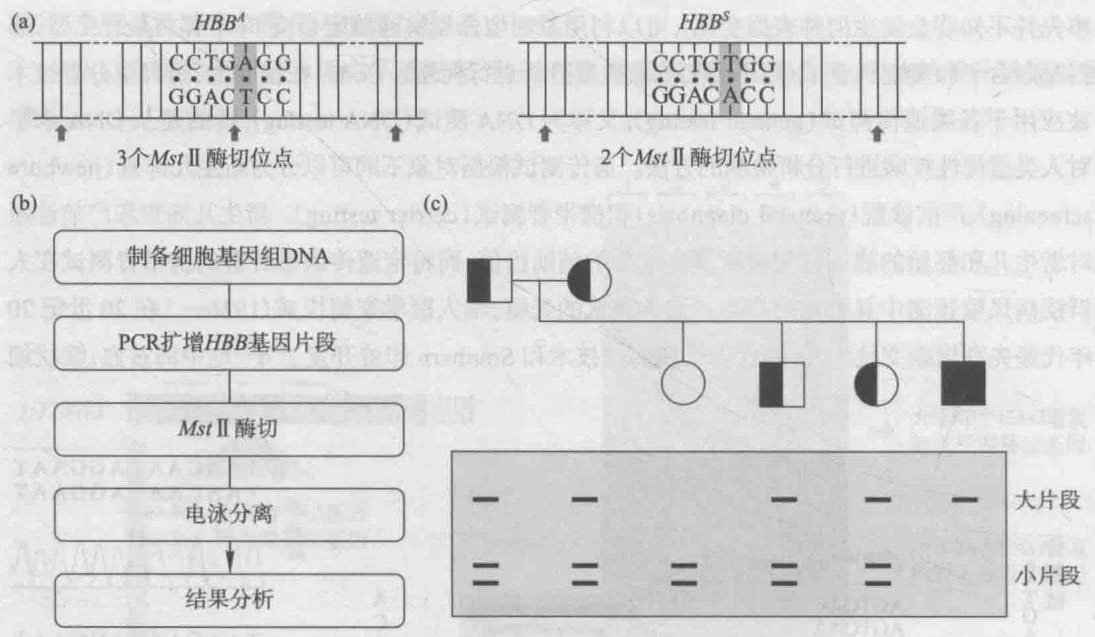
我们在前序章节中介绍过镰状细胞贫血的发病机制是 $\beta-$ 珠蛋白编码基因 $HBB$ 内部发生了一个单核苷酸突变。生物学家分析该突变所在位置发现这个位点的改变造成了野生型等位基因内部一个 $Mst$ II酶切位点发生了丢失(图5-47a)。先利用PCR技术将这一段序列扩增出来,再经过 $Mst$ II酶切处理,通过电泳技术检测酶切后的产物大小,就可以实现基因型分型并完成遗传测试了(图5-47b)。野生型纯合子 $(HBB^{A}HBB^{A})$ 的两条DNA链都含有酶切位点,因此均被切割成较小的片段;镰状细胞贫血 $(HBB^{S}HBB^{S})$ 的两条DNA链都因为突变丢失了酶切位点,因此酶解后的片段较大;而携带者 $(HBB^{A}HBB^{S})$ 两种片段类型都有(图5-47c)。利用这种基因型分型技术,可以对镰状细胞贫血家系中未出生的胚胎进行产前诊断,提前获知胚胎的基因型和患病风险。在这个基因型分型的案例中,我们还看到了一种特殊的现象,即遗传变异可以造成内切酶酶解后片段大小不同,关于这个知识点,我们留到连锁交换一章再作详细介绍。
(a)野生型β-珠蛋白编码基因 $HBB^{A}$ 和导致镰状细胞贫血的突变型β-珠蛋白编码基因 $HBB^{S}$ 的序列对比。灰色阴影标识的是变异碱基。箭头所指的是基因序列中的MstⅡ酶切位点。(b)镰状细胞贫血遗传测试的代表性流程。(c)一个假想的镰状细胞贫血家系及其遗传测试的结果。
解释下列名词:半保留复制、顺反子、突变子、重组子。
哪些实验证明 DNA 是双螺旋结构?这种结构在遗传学上有什么意义?
摩尔根曾提出,基因是功能单位,基因是突变单位,基因是重组单位,即三位一体。利用现代的遗传学观点,你如何看待摩尔根提出的这3点基因属性,请简述理由?
从经典遗传学到分子遗传学,基因的概念有什么发展? 现在基因的概念是怎样的?
有一简单的4核苷酸链, 碱基顺序是A—T—C—G, 问: ①你能识别这条短链吗? 是DNA还是RNA? ②如以这条短链为模板, 形成一条互补的DNA链, 它的碱基顺序怎样? ③如以这条短链为模板, 形成一条互补的RNA链, 它的碱基顺序怎样?
DNA 双链的两条互补链带有相同的遗传信息吗?请说明。
在双链的 DNA 分子中 $(A+T)/(G+C)$ 是否与 $(A+C)/(G+T)$ 的比例相同?请解释。
E. coli 的染色体含有长度约为 $1100 \mu m$ 的 DNA, 问这条染色体有多少核苷酸对? (提示: DNA 双链的每两对碱基间的距离是 0.34 nm。)
粗糙链孢霉的许多不同的营养突变型能在添加精氨酸的基本培养基上生长, 其中一些也能在添加其他物质的基本培养基上生长 (+), 如下表所示:
| 突变类型 | 生长反应 | ||||
| 基本培养基 | 谷氨半醛 | 鸟氨酸 | 瓜氨酸 | 精氨酸 | |
| arg-8,-9 | - | + | + | + | + |
| arg-4,-5,-6,-7 | - | - | + | + | + |
| arg-2,-3,-12 | - | - | - | + | + |
| arg-1,-10 | - | - | - | - | + |
你认为精氨酸的代谢途径是怎样的?
如果黑尿酸尿症患者的食物中含有大量的苯丙酮酸,他们尿中尿黑酸的排泄量会增加吗?如果含有大量的对羟苯丙酮酸,他们尿中尿黑酸的排泄量会增加吗?
有时由于基因突变, 发生代谢障碍, 有化学物质积聚, 这个事实对于我们说明单个基因突变的多效现象有什么启发?
什么叫 DNA 的重链(H)、轻链(L)?
培养粗糙链孢霉时,在培养基中添加生物素,但培养青霉菌时在培养基中不需要添加生物素。是不是在青霉菌细胞的生化反应中,生物素不起作用呢?把你的解答延伸到其他生物中。
假使一个基因决定一个多肽,那么为什么一个基因不决定一个性状呢?
有一基因型 $\frac{+a}{b + }$ , 如果发现互补作用, 表示什么意思? 如果没有互补作用, 又是什么意思?
已知 $a_{1}, a_{2}$ 和 $b$ 都是隐性突变,且仅有 $a_{1}$ 和 $a_{2}$ 位于同一基因内部。请写出下列4种基因型所对应的表型,并简述理由。
1 | \text { 顺式杂合子: } (1) \frac {a _ {1} a _ {2} +}{+ + +} |
1 | arrayc c c a _ 1 & + & b |
反式杂合子:(3) $\frac{a_{1}+ + }{+a_{2}+ }$ (4) $\frac{a_{1}+ + }{++b}$
科学家在一次大规模的诱变筛选中获得了导致果蝇眼睛颜色变为白色的两个隐性纯合突变品系,分别用 $m_{1}m_{1}$ 和 $m_{2}m_{2}$ 表示。请问如何利用杂交实验鉴别这两个突变位于两对非等位基因内部,还是位于同一基因内部?请给出实验的具体步骤和结果分析。
简述重新组 DNA 技术的原理、操作方法及应用。
简述至少 3 种常用的基因型分型的方法,并谈谈它们的不同。
已知镰状细胞贫血症的发病原因是 $\beta-$ 珠蛋白编码基因的单核苷酸突变 (GAG $\rightarrow$ GTG), 该突变可以造成野生型等位基因内部一个 $Mst$ II 酶切位点的丢失。下图是研究者对 4 份 DNA 样本进行基因分型的结果, 研究者首先对 $\beta-$ 珠蛋白编码基因进行 PCR 扩增, 再经 $Mst$ II 酶切后电泳分离, 结果如右图所示。请判断各泳道所对应 DNA 样品 (A、B、C 和 D) 的基因型。
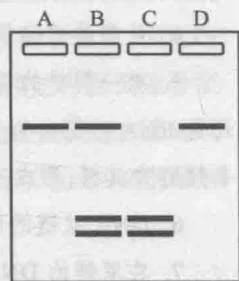
数字课程学习
在线自测 习题答案
第六章 性别决定与伴性遗传
显微镜下染色体的行为与杂交实验中基因的传递方式是平行的,这意味着,基因可能在染色体上。在这一章中将着重介绍性别决定的机理和伴性遗传的规律,并进一步证明基因的确在染色体上,这将使我们对遗传的染色体理论有进一步的理解。
第一节 性别决定
各种两性生物中雌雄个体的比例大都是1:1,这是个典型的孟德尔比例,所以有人猜测,性别和其他性状一样,也是按照孟德尔方式遗传的。1:1是测交比例,这意味着某一性别(例如雌性)是纯合子,而另一性别(例如雄性)是杂合子。麦克朗(Clarence Erwin McClung,1870—1946)(1901)在直翅目昆虫中首次发现性染色体后,就自然地把性别决定与性染色体联系起来。
一、性染色体
体细胞中染色体数是成双的,有 n 对,生殖细胞中染色体数是成单的,有 n 条。可是事实并非全然如此。详细地说,体细胞中有一对染色体的形状相互间往往不同。形成配子时,一部分配子中有一条染色体往往跟另一部分配子中它的同源染色体在形态上有所不同。这一对形态上相互不同的染色体,就是性染色体(sex chromosome),因为它们跟性别决定直接有关。性染色体以外的染色体,被称为常染色体(autosome)。
二、性染色体与性别决定
很多高等植物和某些低等动物是雌雄同花、同株或同体,它们的体细胞中所有染色体都成对,形态上也相同。它们在一个个体中能同时形成雌雄两性配子,所以对它们来说,不是性别决定问题,而是性别分化问题。但是很多动物和某些植物是雌雄异体或异株,它们的体细胞中有一对染色体在雌雄个体中有差异,它们的性别不同由染色体的差异决定。但除此以外,性别决定的方式还有很多,有根据受精与否决定的,有根据环境影响决定的,还有根据基因的差别决定的,等等。现在先介绍性别由性染色体的差异来决定的两种形式,其他决定方式留待这一章的较后部分再讲。
(1) XY 型性别决定 人的体细胞中有 46 条染色体, 可配成 23 对, 其中 22 对在男性和女性中是一样的, 叫作常染色体。另外一对是性染色体, 在女性中成对, 叫作 X 染色体, 而在男性中, X 染色体只有一条, 与一条很小的 Y 染色体成对 (见图 3-2)。经过减数分裂形成生殖细胞时, 男性可以产生两种精子, 一种是 $22 + \mathrm{X}$ , 一种是 $22 + \mathrm{Y}$ , 两种精子的比例相等; 而女性只能产生一种卵子, 就是 $22 + \mathrm{X}$ 。带有 X 的卵子与带有 X 的精子结合得到 XX 合子, 发育成为女性; 带有 X 的卵子与带有 Y 的精子结合, 得到 XY 合子, 发育成为男性。这种性别决定形式如图 6-1 所示。
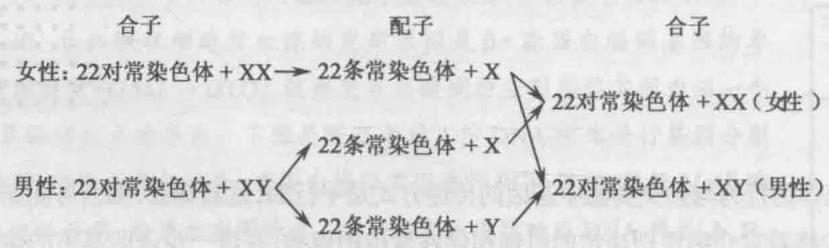
这是 XY 型性别决定,雄是异配性别(heterogametic sex),可以产生两种不同的配子,雌是同配性别(homogametic sex),只能产生一种配子。
XY 型性别决定在生物界中较为普遍, 很多雌雄异株植物、昆虫, 某些鱼、两栖类和全体哺乳动物的性别决定都是 XY 型。在人中, 子女的性别是由精子带有 Y 还是不带有 Y 来决定的。
黑腹果蝇的性别决定也属于 XY 型(图 6-2)。黑腹果蝇的每一体细胞中有 8 条染色体, 可配成 4 对。其中 3 对在雌雄果蝇中是一样的, 是常染色体, 另外一对是性染色体, 在雌果蝇中是 XX, 在雄果蝇中是 XY(图 6-3)。
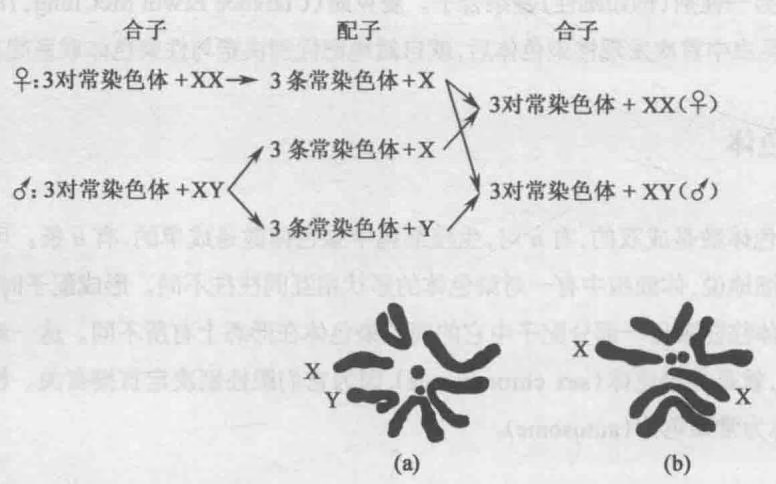
图 6-3 黑腹果蝇的染色体示意图
(a)雄果蝇的染色体,它的性染色体是 XY。(b)雌果蝇的染色体,它的性染色体是 XX。
(2) ZW 型性别决定 这一型的性别决定方式刚好和 XY 型相反。现在用家蚕的性别决定为例来加以说明。
家蚕的体细胞染色体数是28对,其中27对是常染色体,另外一对是性染色体。在雄蚕中,性染色体成对,叫作ZZ(也有叫作XX的),在雌蚕中不成对,叫作ZW(也有叫XY的)。所以雄蚕只能产生一种精子,即 $27+Z$ ,而雌蚕可以产生两种卵,一种是 $27+Z$ ,一种是 $27+W$ ,两种卵的比例相等。带有Z的卵跟带有Z的精子结合,得到ZZ合子,发育成为雄蚕;带有W的卵跟带有Z的精子结合,得到ZW合子,发育成为雌蚕(图6-4)。
图 6-4 家蚕的 ZW 型性别决定
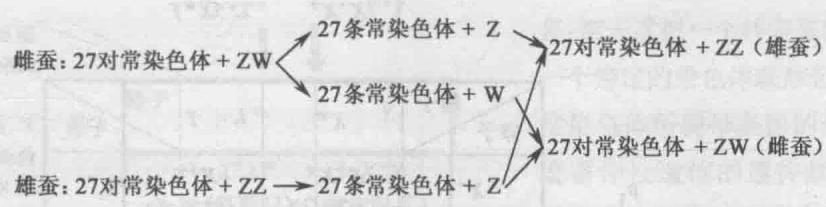
这是ZW型性别决定。这里雌是异配性别,雄是同配性别。所以下代个体的性别是由卵细胞决定的,看卵细胞带的是Z染色体,还是W染色体。这一型性别决定方式多见于鳞翅目昆虫,某些两栖类、爬行类和鸟类等。
第二节 伴性遗传
既然很多生物有性染色体,那么如果基因在染色体上,有些基因就有可能在性染色体上。在性染色体上的基因所控制的性状在遗传方式上自然跟常染色体上的基因有所不同。性染色体上基因的遗传方式有一特点,就是跟性别相联系,这种遗传方式称为伴性遗传(sex-linked inheritance)。我们在孟德尔定律一章中已经介绍了一些人类伴性遗传疾病,在本节中我们再以其他生物为例,介绍几个伴性遗传的案例。
一、果蝇的伴性遗传
摩尔根在 1905 年发现果蝇是极好的实验材料, 它体型小, 饲养容易, 生活史短, 在 25℃时经 12 天就可以完成一个世代, 进而繁殖第二代。果蝇生命力强, 每个雌体能产生几百个后代。果蝇作为遗传学实验材料还有许多其他优点是摩尔根当时没有想到的, 果蝇现在仍然是遗传学研究的好材料。
果蝇的野生型眼色都是红色,但是摩尔根在研究的早期(1910)发现一只雄蝇,其复眼的颜色完全白色。这只白眼雄蝇与正常的红眼雌蝇交配时, $F_{1}$ 不论雌雄都是红眼,但 $F_{2}$ 中雌的全是红眼,雄的半数是红眼,半数是白眼。这显然是个孟德尔比例——如果雌雄不论,则 $F_{2}$ 中3红眼:1白眼。与一般孟德尔比例不同之处是,白眼全是雄蝇。
另外,摩尔根也做了测交试验。最初出现的那只白眼雄蝇和它的红眼女儿交配,结果产生1/4红眼雌蝇,1/4红眼雄蝇,1/4白眼雌蝇,1/4白眼雄蝇,这也是孟德尔比例。
摩尔根根据实验结果,提出他的假设:控制白眼性状的基因 w 位于 X 染色体上,是隐性的。因为这对等位基因在 X 染色体上,所以为明确起见,记作 $X^{w}$ ,野生型等位基因记作 $X^{+}$ ,Y 代表 Y 染色体。因为 Y 染色体上不带有这个基因的显性等位基因,所以最初发现的那只雄蝇的基因型是 $X^{w}Y$ ,表现为白眼,跟这只雄蝇交配的红眼雌蝇是显性基因的纯合子,基因型是 $X^{+}X^{+}$ 。这儿白眼基因 $X^{w}$ 是突变基因,红眼基因 $X^{+}$ 是野生型基因。
白眼雄蝇与纯种红眼雌蝇交配(图6-5),白眼雄蝇的基因型是 $X^{w}Y$ ,产生两种精子,一种精子带有X,上面有w基因,一种精子带有Y,上面没有相应的基因。红眼雌蝇的基因型是 $X^{+}X^{+}$ ,产
$$
\mathbf {F} _ {1}
$$
| 精子 卵子 | Xw | Y |
|---|---|---|
| X+ | X+Xw(红眼♀) | X+y(红眼♂) |
图 6-5 白眼雄绳与纯种红眼雌蝇杂交, $F_{1}$ 不论雌、雄,都是红眼
$X^{*}$ ,带有野生型(红眼)基因的X染色体; $X^{w}$ ,带有突变型(白眼)基因的X染色体;Y,Y染色体上面没有相应等位基因。
生的卵都带有 X,上面都有一野生型基因。两种精子 $(X^{w}$ 和 Y) 与卵 $(X^{+})$ 结合,子代雌蝇的基因型是 $X^{+}X^{w}$ ,因为 + 对 w 是显性,所以表型是红眼,子代雄蝇的基因型是 $X^{+}Y$ ,所以表型也是红眼。
$F_{1}$ 的红眼雌蝇与红眼雄蝇交配时,红眼雌蝇 $(X^{+}X^{w})$ 产生两种卵子:一种是 $X^{+}$ ,一种是 $X^{w}$ ;红眼雄蝇也产生两种精子,一种是 $X^{+}$ ,一种是 Y。卵子与精子相互结合(图 6-6),形成 4 种合子,长大后,雌蝇都是红眼 $(X^{+}X^{+}$ 和 $X^{+}X^{w})$ ,而雄蝇中一半是红眼 $(X^{+}Y)$ ,一半是白眼 $(X^{w}Y)$ ,表型比例是 2:1:1。
在摩尔根所做的测交实验中, $F_{1}$ 红眼雌蝇与白眼雄蝇交配, $F_{1}$ 红眼雌蝇的基因型是 $X^{+}X^{w}$ ,产生两种卵子,一种是 $X^{+}$ ,一种是 $X^{w}$ ;白眼雄蝇的基因型是 $X^{w}Y$ ,产生两种精子,一种是 $X^{w}$ ,一种是 Y。雌雄配子结合(图 6-7),下一代有 4 种表型:红眼雌蝇 $(X^{+}X^{w})$ 、白眼雌蝇 $(X^{w}X^{w})$ 、红眼雄蝇 $(X^{+}Y)$ 、白眼雄蝇 $(X^{w}Y)$ ,比例是 1:1:1:1。
摩尔根圆满地解释了他的实验结果,他为了验证他的假设,设计了3个新的实验:
① 根据假设, $F_{2}$ 雌蝇虽然都是红眼,但基因型有两种,半数是 $X^{+}X^{+}$ ,半数是 $X^{+}X^{w}$ (图6-6),所以 $F_{2}$ 雌蝇与白眼雄蝇做单对交配时,应当半数 $F_{2}$ 雌蝇所产的后裔全部是红眼,半数 $F_{2}$ 雌蝇则与 $F_{1}$ 雌蝇测交所产的后代一样(图6-7),是1/4红眼雌蝇:1/4白眼雌蝇:1/4红眼雄蝇:1/4白眼雄蝇。
② 根据假设,白眼雌蝇与红眼雄蝇交配时,子代中雌蝇都是红眼,雄蝇都是白眼(图6-8)。
③ 根据假设,白眼雌蝇和白眼雄蝇交配时,子代雌雄都是白眼,而且以后也能真实遗传,成为稳定的品系。
这 3 个实验中,以第二个实验最为关键。实验的结果跟预期完全符合,假设得到证实。
$$
\mathrm{F} _ {1}
$$
$$
\mathrm{F} _ {2}
$$
| 精子 卵子 | X+ | Y |
|---|---|---|
| X+ | X+X+(红眼♀) | X+Y(红眼♂) |
| Xw | X+Xw(红眼♀) | XwY(白眼♂) |
图6-6 $F_{1}$ 红眼雌蝇与红眼雄蝇交配结果
$F_{2}$ 雌蝇全为红眼,而雄蝇中,红眼和白眼各占一半。
| 精子 卵子 | Xw | Y |
|---|---|---|
| X+ | X+Xw(红眼♀) | X+Y(红眼♂) |
| Xw | XwXw(白眼♀) | XwY(白眼♂) |
图 6-7 白眼雄蝇与 $F_{1}$ 红眼雌蝇交配结果
下代雌蝇和雄蝇中,红眼和白眼各占一半。
图 6-8 白眼雌蝇与红眼雄蝇交配结果
子代雌蝇是红眼,雄蝇是白眼
| 精子 卵子 | X+ | Y |
|---|---|---|
| Xw | X+Xw(红眼♀) | XwY(白眼♂) |
摩尔根这项工作的意义是:第一次把一个特定基因与一个特定的染色体联系起来。性染色体所携带基因的遗传遵循伴性遗传的遗传规律。因为有关的基因在X染色体上,所以为明确起见,现在称为X连锁遗传。
二、高等植物的伴性遗传
种子植物大部分是雌雄同株的,但是也有是雌雄异株的,例如菠菜、大麻等。
一般雌雄异株植物的两条性染色体在细胞学上区别不大。例如蝇子草属 Silene latifolia 的雄性植株是异配的 (XY), Y 染色体比 X 染色体稍稍大些 (图 6-9)。在减数分裂的时候, X 也跟 Y 配对, 不过分离较早, 在常染色体还没有分开的时候, 两个性染色体就分向两极, 表明 X 染色体跟 Y 染色体的同源部分是很短的, 其余部分已互相分化了。
蝇子草的叶子形状有阔叶和细叶两型。如把阔叶的雌株跟细叶的雄株交配,子代全部是阔叶的雄株。如把杂合的阔叶雌株跟阔叶的雄株交配,子代雌雄都有,但雌株全是阔叶,而雄株中阔叶和细叶约各占半数。这样复杂的遗传方式究竟是怎样发生的呢?从上面的实验结果看来,阔叶和细叶这一对性状跟性别有关。所以如果假设阔叶由基因 $B$ 引起,细叶由基因 $b$ 引起, $B$ 相对 $b$ 完全显性,位于X染色体的已分化部分上,Y染色体上没有相对应的基因;此外再加上一个假设,带有基因 $b$ 的花粉是致死的,这样上述的杂交实验,就可圆满地说明(图6-10)。
| 雄配子 雌配子 | [Xb] | Y |
|---|---|---|
| XB | - | XBY (阔叶♂) |
| 雄配子 雌配子 | $X^B$ | Y |
|---|---|---|
| $X^B$ | $X^BX^B$ (阔叶♀) | $X^{BY}$ (阔叶♂) |
| $X^b$ | $X^BX^b$ (阔叶♀) | $X^{BY}$ (细叶♂) |
图 6-10 蝇子草的阔叶型和细叶型的伴性遗传
$X^{B}$ ,带有基因 B 的 X 染色体; $X^{b}$ ,带有基因 b 的 X 染色体; $[X^{b}]$ ,基因 b 导致花粉致死。
三、鸡的伴性遗传
上面讲过鸟类的性别决定,如果伴性遗传的基因在 Z 染色体上,它的遗传方式又将怎样呢?
举个例子来说,芦花鸡的绒羽为黑色,头上有黄色斑点,成羽有横纹,是黑白相间。如用雌的芦花鸡与雄的非芦花鸡交配,得到的 $F_{1}$ 中,雄的都是芦花,雌的都是非芦花。 $F_{2}$ 中,雌鸡中一半是芦花,一半非芦花,雄鸡中也是如此。
这个遗传现象如何解释呢?可假定芦花基因 B 在 Z 染色体上,而且是显性。这样,雌的芦花鸡的基因型是 $Z^{B}W$ ,雄的非芦花鸡的基因型是 $Z^{b}Z^{b}$ 。两者交配, $F_{1}$ 雄鸡的基因型是 $Z^{B}Z^{b}$ ,是芦花;雌鸡的基因型是 $Z^{b}W$ ,是非芦花。 $F_{2}$ 中,雌鸡的基因型一半是 $Z^{B}W$ ,是芦花;一半是 $Z^{b}W$ ,是非芦花;雄鸡的基因型一半是 $Z^{B}Z^{b}$ ,是芦花,一半是 $Z^{b}Z^{b}$ ,是非芦花(图 6-11)。
在芦花斑纹遗传的这个例子中,决定性状的基因在 Z 染色体上,所以更确切地讲,应为 Z 连锁遗传(Z-linked inheritance)。
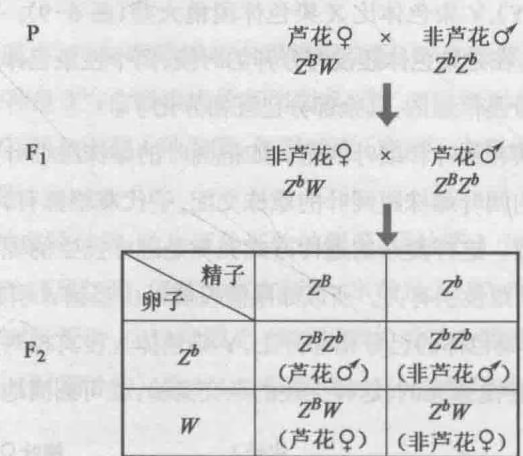
$Z^{B}$ ,带有芦花基因B的Z染色体; $Z^{b}$ ,带有非芦花基因b的Z染色体。
在养禽场里,为了提高鸡的生产性能,可供利用的一个交配是芦花母鸡 × 非芦花公鸡。它们的子代生命力强,而且在孵化时只要根据绒羽上有没有黄色头斑,就可把雏鸡的雌雄区别开来了。
第三节 遗传的染色体学说的直接证明
萨顿在 1903 年提出遗传的染色体假说时, 相关证据还只是基因的行为一般与染色体的行为平行。虽然这个假设极为合理, 但当时没有人认为这是一个可被检验的假设, 因为还没有人能把某一特定基因与某一特定染色体联系起来。摩尔根在 1910 年在果蝇中发现的白眼性状的遗传方式, 第一次把一个特定基因 (w) 与一特定染色体 (X 染色体) 联系起来, 再加上其他伴性遗传的发现, 尤其是 ZW 型性别决定方式和它的伴性遗传的发现, 使一些对遗传的染色体学说持怀疑态度的人接受了这个学说。伴性遗传基因的行为和性染色体的行为完全平行, 而且 XY 型生物和 ZW 型生物在细胞学上情况相反, 在遗传学上情况也完全平行地相反, 这对当时绝大多数生物学家来讲是足够可靠的证明了。但是仍有少数科学家持怀疑态度,认为两者的平行只是偶然的巧合而已。直至摩尔根的学生布里奇斯在1916年发现的果蝇X染色体不分开现象,才无可辩驳地证明了遗传的染色体学说。
用白眼雌蝇 $(X^{w}X^{w})$ 与红眼雄蝇 $(X^{+}Y)$ 交配,子代雌蝇是红眼 $(X^{+}X^{w})$ ,雄蝇是白眼 $(X^{w}Y)$ (见图6-8)。布里奇斯做了很多这样的交配,发现有少数例外。大约每2000个子代个体中,有一个白眼雌蝇或红眼雄蝇。这些例外子代的表型跟它们的同一性别的亲本一样,所以雌蝇是偏母的(matroclinous),雄蝇是偏父的(patroclinous),这些例外子代,叫作初级例外子代(primary exceptional progeny)。
偏父的雄蝇总是不育的,而偏母的白眼雌蝇是可育的。将这种初级例外的白眼雌蝇与正常红眼雄蝇交配,4%的子代是偏母的白眼雌绳和偏父的红眼雄蝇,这样又出现了例外的子裔,不过这次频率较高,而且雄蝇也是可育的。这些初级例外雌蝇的例外子裔称作次级例外子裔(secondary exceptional progeny)(图6-12)。怎样来解释这些例外后裔呢?
那些例外的白眼既然是雌蝇, 必然有两个 X 染色体。它们既然是偏母的, 也就是在表型上像它们的母亲, 那么这两个 X 染色体上必然都带有白眼基因 w。同样的, 那些例外的红眼既然是雄蝇, 必然有一个 X 染色体。既然是偏父的, 也就是在表型上像它们的父亲, 那么这个 X 必然是从父亲来的。但是这种情况是怎样造成的呢? 假定, 极少数初级卵母细胞的减数分裂不正常, 一对 X 染色体在后期 I 时不分向两极, 而是进入同一极: ①或是全部进入次级卵母细胞, 这样就得到两个 X 的卵细胞, ②或是全部进入第一极体, 这样就得到没有 X 的卵细胞。在后期 I 时, 一对同源染色体进入同一极的现象叫作不分离 (nondisjunction) (图 6-13)。
这两种例外的卵细胞可以被带有 X 的精子受精,也可以被带有 Y 的精子受精。XX 卵被 Y 精子受精,则得 XXY 个体,这是例外的白眼雌蝇。无 X 卵被 X 精子受精,得到有 X 而无 Y 的个
图 6-13 果蝇×染色体不分离的遗传效应
子代出现少数例外个体, 它们是偏母的白眼雌蝇和偏父的红眼雄蝇。
减数分裂时卵的两个 X 染色体的不分开, 结果产生有两 X 的卵和无 X 的卵。这两种卵受精后, 产生初级例外个体: 偏母的白眼雌蝇和偏父的红眼雄蝇。
| 精子 卵子 | ${X}^{ + }$ | Y |
|---|---|---|
| ${X}^{w}{X}^{w}$ | ${X}^{ + }{X}^{w}{X}^{w}$ (死亡) | ${X}^{w}{X}^{w}Y$ (白眼♀) |
| O | ${X}^{ + }O$ (红眼♂,不育) | YO(死亡) |
体(XO),这就是例外的红眼雄蝇。另外还可能有Y无X的受精卵(YO),它们不能发育成为成虫;也有3个X的受精卵(XXX),大多数也死亡,偶尔有发育成为成虫的,表现为红眼雌蝇。
初级例外雄蝇的不育是容易说明的,只要假定雄蝇有育性,一定要有Y染色体的存在,事实也的确如此。说到可育的XXY雌蝇,它们在进行减数分裂时,在大多数情况下,两X配对,而Y游离,这样将形成等量的X卵和XY卵。然而我们知道,X与Y可以配对,所以如我们假定大约有 $16%$ 的 $X^{w}X^{w}Y$ 雌蝇中 $X^{w}$ 和 $Y$ 配对,而另一 $X^{w}$ 可随机地分向任何一极,那么这样配对时,一半 $(8%)$ 将形成 $X^{w}$ 卵和 $X^{w}Y$ 卵,而另外一半 $(8%)$ 将形成 $X^{w}X^{w}$ 卵和 $Y$ 卵(图6-14)。
后面两种卵子, $X^{w}X^{w}$ 和 Y 在受精后,有一半机会将产生合子 $X^{+}X^{w}X^{w}$ 和 YY,这些很可能早期死亡,而另外一半机会将形成合子 $X^{w}X^{w}Y$ 和 $X^{+}Y$ ,偏母的雌蝇和偏父的雄蝇,这些就是次级例外个体。现在我们可以了解,为什么次级例外个体中的雄蝇 $(X^{+}Y)$ 是可育的,因为它们从 XXY 母亲那里得到一个 Y(图 6-15)。
| 精子卵子 | X+(50%) | Y(50%) | |
| X-Y配对(16%) | XwXw(4%) | X+XwXw(死亡)(2%) | XwXwY(白眼♀)(2%) |
| Y(4%) | X+Y(红眼♂,可育)(2%) | YY(死亡)(2%) | |
| Xw(4%) | X+Xw(红眼♀)(2%) | XwY(白眼♂)(2%) | |
| XwY(4%) | X+XwY(红眼♀)(2%) | XwYY(白眼♂)(2%) | |
| X-X配对(84%) | XwY(42%) | X+XwY(红眼♀)(21%) | XwYY(白眼♂)(21%) |
| Xw(42%) | X+Xw(红眼♀)(21%) | XwY(白眼♂)(21%) | |
图 6-14 例外的白眼雌蝇 $X^{w}X^{w}Y$ 在减数分裂时的分离分式
如 $X^{w}$ 与 Y 配对而另一 $X^{w}$ 游离,则一半将形成等量的 $X^{w}$ 卵和 $X^{w}Y$ 卵,而另外一半将形成等量的 $X^{w}X^{w}$ 卵和 Y 卵。
后裔中出现次级例外个体:白眼雌蝇 $(X^{w}X^{w}Y)$ 和可育的红眼雄蝇 $(X^{y}Y)$ 。括号内各百分数是从有4%的次级例外后裔这一事实倒推而得的,不是实际得到的数值。
图 6-15 初级例外白眼雌蝇 $X^{w}X^{w}Y$ 与正常红眼雄绳杂交结果
到现在为止,我们假定红眼基因(+)和白眼基因(w)在X染色体上,又假定卵子在减数分裂时偶尔出现不分离现象,从而圆满地说明了例外个体的出现原因。布里奇斯推论,如果上述假设是正确的,那么他可作如下预期,并能通过观察成虫的性原细胞来验证他的预期。
① 遗传学上检出的初期例外雌蝇和雄蝇,应该是 XXY 和 XO。在显微镜下观察,丝毫不差。
② 遗传学上检出的次级例外雌蝇和雄蝇,应该是 XXY 和 XY,在显微镜下观察,果然如此。
③ 例外白眼雌蝇的红眼女儿中,应该一半是 XXY,一半是 XX。在显微镜下观察,确是这样。
视频8摩尔根与基因论
④ 例外白眼雌蝇的白眼儿子中,一半也会产生例外的后裔。会产生例外后裔的全部白眼儿子应该是 XYY。在显微镜下观察,完全证实。
这样,如假定 w 和 + 确实在 X 染色体上,上述例外现象就可用卵子进行减数分裂时性染色体的不分离现象来说明,而且根据不分离现象所作的各项预期又得到了细胞学观察的证实。这就无可辩驳地证明了基因在染色体上。
第四节 其他类型的性别决定
在有雌雄性别的物种中,几乎都有性染色体的存在,但这并不是说只有性染色体能影响性别发育。性别是一个复杂的发育性状,除了性染色体可以决定性别以外,常染色体上的基因也可以影响性别,受精与否以及环境的变化等也可影响性别。
一、蜂的性别决定
蜂类的性别决定,不仅与染色体数有关,而且也与环境有关。
蜜蜂(Apis mellifera)是我们熟悉的益虫,蜂后和雄蜂交配后雄蜂就死了,蜂后得到了足够一生需要的精子,可以用上四五年。她产下来的每一窝卵中,有少数是不受精的,这些卵发育成为雄蜂,它们的染色体数是n=16。
受精卵可以成为正常能生育的雌蜂(蜂后),也可成为不育的雌蜂(工蜂),这主要靠环境——蜂王浆——的影响。蜂王浆是工蜂头部的一些腺体产生的。孵化中的工蜂,只吃两三天蜂王浆,且质差而量少,孵化后经21天才成为成虫。可是对于未来的蜂后则不是那样,她的蜂房由工蜂为之扩大,蜂王浆供应5天且质好而量多。蜂后从卵中出来经16天就能生育,长得比同窝的工蜂大而丰满。这样,蜂后和工蜂的染色体数虽然都是2n=32,但是由于环境影响的不同,或者发育为蜂后,或者发育为工蜂(图6-16)。
到这几读者或许要问:单倍型雄蜂是怎样形成单倍体精子的?原来雄蜂的精母细胞也经过相继的两次分裂。第一次分裂时出现单极纺锤体,仅在细胞的一极挤出一个无核的细胞质芽体,不发生染色体减数。第二次分裂时,则按正常的方式进行,但这次分裂实质上相当于一般有丝分裂。所以结果每一精母细胞仅形成两个精细胞,各保有雄蜂原来的单倍染色体数。
工蜂
(不育的雌蜂)
32条染色体
加2~3天的蜂王浆
蜂后
(可育的雌蜂)
32条染色体
加5天的蜂王浆
雄蜂
(可育的雄蜂)
16条染色体
加任何食料
图6-16 蜜蜂的性别决定
二、后缢的性别决定
性别还可由环境决定,海生蠕虫后螳(Bonellia viridis)就是一个经典的例子(图6-17)。这种蠕虫不但在性别决定方式上特殊,而且两个性别的体型大小悬殊,也特别引起人们的注意。雌虫体大,有5 cm长,身体像一颗豆子,口吻很长,远端分叉。雄虫很小,生活在雌虫的子宫中,像一种寄生虫。这种蠕虫的性别决定原来全凭机遇。自由游泳的幼虫
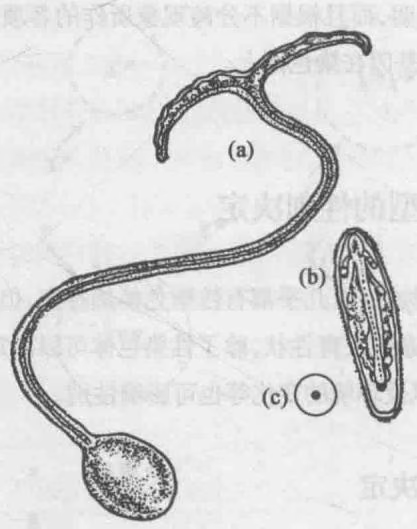
(a)雌体,它有很长的口吻。图比实际的大小大些。(b)雄体,身体退化,缺乏消化器官。(c)雄体的实际大小(指中间一点)。
是中性的;如果它落在海底,就成为雌虫;如果它落在雌虫口吻上,它就发育成为一个雄虫。如果将已经落在雌虫口吻上的幼虫从口吻上移去,让它在离开雌虫的情况下继续发育,它就发育成为间性,而且程度是由它们待在雌虫吻上的时间长短来决定的。
雌虫的口吻上有一种激素类化学物质,能够影响幼虫的性别分化。这是环境在性别决定上发挥重要作用的例子。不过也有证据说,幼虫是落在海底,还是附在雌虫口吻上,也有其遗传基础。如果这样,在这个由环境决定性别的例子中,遗传也同样起着作用。
三、高等植物的性别决定
雌雄异株的植物中,有时也会出现雌雄同株的情况。例如菠菜(Spinacia oleracea)除了纯粹的雌株和纯粹的雄株以外,还出现雄花多而雌花少的,雌花和雄花大致相等的,以及大部分是雌花,只在枝端着生雄花等3种雌雄同株类型,这表明性别的分化也是植物进化过程中自然发生的。在实际栽培中,雄株抽薹早,是不受欢迎的,所以想通过人工选择,选出雄株较少的品种,这样做也获得了一定程度上的成功,可是选择一放松,雄株又增加了。
(c)
与女娄菜和菠菜不同,玉米是雌雄同株的。顶生的垂花是雄花序,侧生的穗是雌花序。已知玉米中有若干基因可以改变玉米植株的性别,也就是能把雌雄同株转变为雌株或雄株。例如基因 $ba$ 在纯合时,植株没有雌花序,成为雄株。基因 $ts$ 在纯合时,垂花成为雌花序,不产生花粉。因而 $babatsts$ 的植株是雌株,它没有果穗,但在垂花上产生卵细胞,而 $babaTsTs$ 植株是雄株(图6-18)。我们适当地改变玉米的基因型,让雌株 $babatsts$ 跟雄株 $babaTsts$ 交配,后代植株中雌雄的比例是 $1:1$ 。这样就在玉米中建立起一个新的性别决定系统。植株的性别由 $Tsts$ 的分离决定。 $ts$ 基因所在的染色体就成为“性染色体”,雄株可以产生 $Ts$ 和 $ts$ 两种配子,所以雄株是异配性别,跟蝇子草和菠菜的雄株一样(图6-19)。
图6-18 玉米的3种性别类型
(a) 雌雄同株,基因型一般是BaBaTsTs,这是常见的正常植株。(b) 雄性植株,基因型babaTsTs或babaTsts,长雌花序的地方不能长出雌花序。(c) 雌性植株,基因型babatsts,在长雄花序的地方结出种子。
(a)
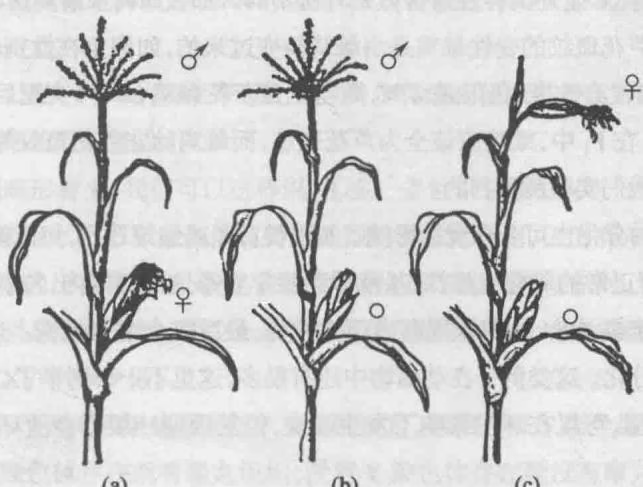
(b)
图6-19 Ts基因决定的玉米性别
通过基因型的改变,可把玉米从雌雄同株变为雌雄异株;如图所示的交配中,后裔中雌株和雄株的比例是相等的。
| 精子卵子 | baTs | bats |
|---|---|---|
| bats | babaTsts♂ | babatsts♀ |
四、环境对性别分化的影响
我们现在再举几个例子来说明环境对性别分化的影响。
牛一般是怀单胎的,但有时也可怀双胎,如怀双胎,且性别不同时,生下的雌犊往往受到影响,虽然外部生殖器基本上像正常雌性,但性腺很像睾丸,所以没有生育能力。众所周知,牧场里只选留极少数雄犊,所以对个别雄犊的不育并不介意,而对雌犊则尽量多留,以增加牛奶产量。可是现在一胎生下雌雄两犊时,偏偏雄犊不受影响,而雌犊的性别分化受到影响,这是什么原因呢?原来牛怀双胎时,两个胎儿的胎盘是共通的,绒毛膜的血管相互连通,所以引起了两种结果:①当两个胎儿的性别不同时,往往雄性胎儿的睾丸先发育,先分泌雄性激素,通过绒毛膜血管,流向雌性胎儿,从而影响了雌性胎儿的性腺分化,使性别分化趋向间性,失去生育能力。②细胞也可通过这种吻合的绒毛膜血管,流向对方,在孪生雄犊中曾发现有XX组成的雌性细胞,在孪生雌犊中曾发现有 XY 组成的雄性细胞。鉴于 Y 染色体在哺乳动物中具有强烈的雄性化作用,所以 XY 组成的雄性细胞可能会干扰孪生雌犊的性别分化,造成不育。异性双胎中雌犊不育的这个事实清楚地告诉我们,虽然性别在受精时已经决定,但是性别分化的方向可以受到激素或外来异性细胞的影响而发生变更。
雌鸡停止产卵,并开始向雄鸡转化,这样的例子也时有所闻;可是性别的转变往往不完全,不能进行遗传学研究。我们偶然得到一只非芦花斑纹的变性雄鸡,以前产过卵,后来不产卵了,逐渐向雄鸡变化,最后能和雌鸡交配。把这只非芦花变性雄鸡跟芦花雌鸡交配,得到的 $F_{1}$ 中,雄的全为芦花斑纹,这和上述的伴性遗传结果一样;可是雌鸡的斑纹有两种,有的是非芦花斑纹,有的却是芦花斑纹,显然和上述的伴性遗传方式有所不同。那么如何来解释这种例外的结果呢?
我们这只非芦花斑纹的变性雄鸡是由雌鸡转变过来的,如假定在性别转变过程中,性别是改变了,但遗传结构没有改变,仍旧是 $Z^{b}W$ ,则与正常芦花雌鸡 $(Z^{g}W)$ 交配后,下代应得如图6-20结果。那就是说,在 $F_{1}$ 中,雄鸡应该全为芦花斑纹,而雌鸡除非芦花斑纹外,还应该有芦花斑纹,这样的结果正是我们实验所得到的。
植物性器官的分化也可受环境的影响。如延长日照或缩短日照,可以改变大麻的性别。大麻在夏季播种,只有正常的雌株或雄株,从秋季到翌年春季这段时间内,特别是在12月里,把大麻播种在温室里,50%~90%的雌株逐渐出现性转变,最后完全变为雄株。这些实验表明,日照长短可以影响性别分化。这类例子在动植物中还有很多,这里不一一列举了。综上,我们得出结论,性别也是一种表型,可以在环境影响下发生改变,但基因型一般不会随环境改变而发生相应的改变。
| 变性雄鸡 $Z^{b}W$ × 正常芦花雌鸡 $Z^{B}W$ | |||
| 芦花斑纹♂ $Z^{B}Z^{b}$ | 芦花斑纹♀ $Z^{B}W$ | 非芦花斑纹♀ $Z^{b}W$ | 死亡?WW |
图 6-20 非芦花变性公鸡与正常芦花母鸡交配(刘祖洞、梁志成, 1980)
第五节 人类的性别决定
人的性别主要由性染色体决定,性染色体的数目有了增减,性别决定的机制会受到干扰,进而影响性别分化的过程,导致各种性别畸形的出现。
一、几种性别畸形
现在以比较常见的几种性别畸形为例,略加说明如下。
(1) 克兰费尔特综合征(Klinefelter syndrome) 又称先天性睾丸发育不全。患者的外貌是男性, 身长较一般男性为高, 但睾丸发育不全, 不能看到精子形成。用组织学方法检查, 精细管玻璃样变性, 尿中促性腺激素的排泄量上升, 常出现类似女性的乳房, 智力一般较差。患者无生育能力。他们的体细胞染色体数是 $2n = 47$ , 除可看到 22 对常染色体和 1 对 X 染色体外, 还有 1 条 Y染色体,所以性染色体组成是XXY,一般记作47,XXY。
(2) XYY 综合征(XYY syndrome) 外貌男性,症状类似克兰费尔特综合征患者。部分患者的智力稍差。行为异常,性情粗暴,常有攻击性行为。有生育能力,但所生男孩中有部分仍为XYY 患儿。他们的体细胞染色体数是 2n=47,除了可以看到 22 对常染色体外,还可看到 1 条 X 和 2 条 Y,一般记作 47,XYY。
(3) 特纳综合征(Turner syndrome) 又称先天性卵巢发育不全。患者的外貌像女性, 身长较一般女性为矮, 第二性征发育不良, 卵巢完全缺失, 或仅存少量结缔组织。原发性闭经, 无生育能力。婴儿时颈部皮肤松弛, 长大后常有蹼颈, 肘外翻, 往往有先天性心脏病。智力低下, 但也有智力正常的。她们的体细胞染色体数是 $2n = 45$ , 包括 22 对常染色体和 1 条 X 染色体, 性染色体组成是 XO, 一般记作 45, X。
特纳综合征患者(XO个体)的发生率远比克兰费尔特综合征患者(XXY个体)为低,这可能是XO受精卵的致死率较高的缘故。
从上面几种性别畸形看来,我们可以这样说:①多一条性染色体,或少一条性染色体,常使性腺发育不全,失去生育能力。②Y染色体有特别强烈的男性化作用,因为有Y染色体存在时,性别分化就趋向男性,体内出现睾丸,外貌也像男性;而没有Y染色体存在时,性别的分化就趋向女性,体内出现卵巢,外貌也像女性。③少一条性染色体的影响比多一条性染色体的影响要大些,所以XO个体远比XXY个体少见。
我们应该注意到,虽然人和果蝇都是 XY 型性别决定,但在人中 Y 染色体在性别决定上所起的作用很重要,有 Y 染色体存在就有睾丸组织,没有 Y 染色体存在就没有睾丸组织,而 XO 个体是不育女性;而在果蝇中,Y 只跟育性有关,所以 XO 个体是不育的雄蝇。表 6-1 列举了两者的异同。
表 6-1 人和果蝇的几种性别畸形的比较
| XO | XXY | XYY | 备注 | |
|---|---|---|---|---|
| 人 | 不育女性 | 不育男性 | 可育男性 | Y决定雄性性别 |
| 果蝇 | 不育雄蝇 | 可育雌蝇 | 可育雄蝇 | Y决定育性 |
二、遗传变异与人类性别决定
Y 染色体虽有强烈的男性化作用,但它的作用也不是绝对的。因为某些个体有 XY 型性染色体组成,身体内有睾丸,可是外貌跟正常女性一样,有丰满的乳房和女性外生殖器。“她们”常因闭经和不育来找医生。现在通过家系分析知道,像这样的“睾丸女性化”(testicular feminization)是基因突变的结果。
图6-21就是我们详细分析过的一个家系。
这个家系中的睾丸女性化患者的性染色体组成是 XY,本来应该是男性,而事实也与这个推测相符合,因为这个家系中女性特别多。具有 XY 性染色体组成的人中,有一部分人的 X 染色体上有突变基因 tf,而 Y 染色体上没有相应的基因,所以就表现为睾丸女性化患者。而她们的母亲的一个 X 染色体上虽然也有这样的一个突变基因 (tf),但另一 X 染色体上具有显性的正常基因(+), 所以她们的母亲是正常的女性, 但是突变基因 $tf$ 的携带者 $(X^{+}X^{tf})$ , 正因为这个缘故, 她们的母亲所生的子女性别比例是 $3:1$ (图6-22)。
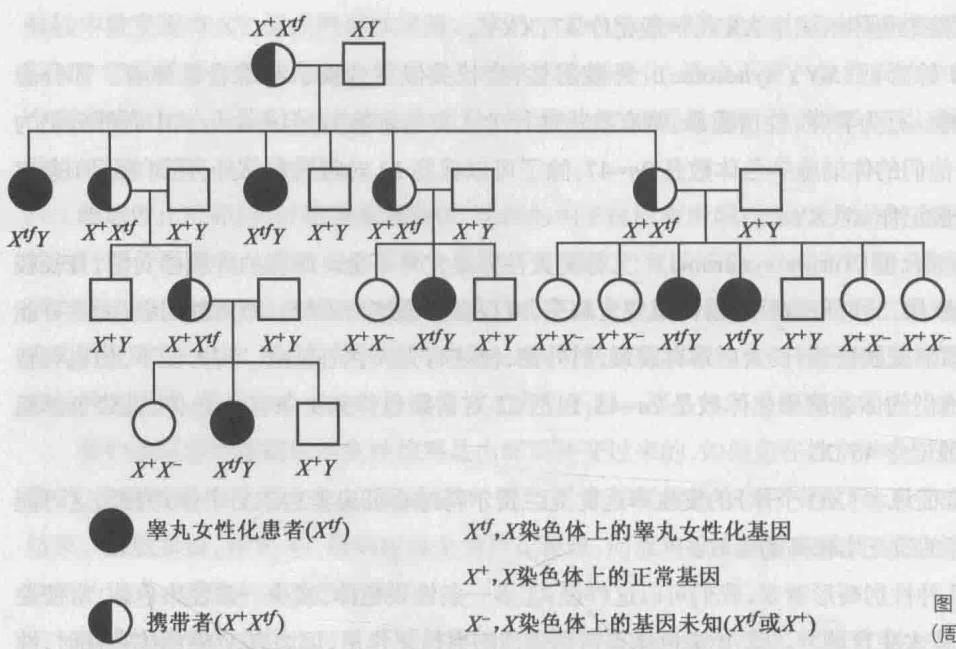
后来在一小家鼠家系中,也发现了睾丸雌性化个体。那么怎么会在小家鼠中发现的呢?原来最初在统计雌雄比例时,发现雌性家鼠的比例远远地超过半数,而且在其中某些雌鼠中,显示出跟雄鼠一样的X连锁基因的效应。检查她们的性染色体组成,显示是XY。这样就告诉我们,X染色体上可能有一睾丸雌性化基因,在XY组成的个体中显示出睾丸雌性化的效应来。以后的遗传学实验证实,睾丸雌性化基因的传递方式的确是X连锁的。
这种小家鼠在外观上跟正常雌鼠没有区别,只是其中某些个体的阴道没有开口。她们不跟正常雄鼠交配和打架,她们的尿液中没有雄性外激素(feromone),精子形成过程无法进行到减数分裂时期。利用这些动物材料进行遗传学实验,可以加深我们对于人类性别决定的认识。
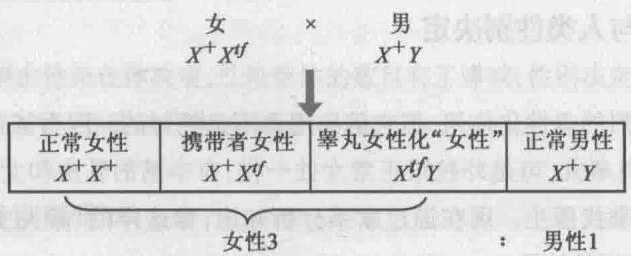
我们在遗传学的研究中,有时会发现例外的现象,好像某一遗传学规律需要修改了。但是经过深入研究,却使我们对于有关遗传学规律更加坚信了。例如上面谈到过果蝇的 X 染色体的不分离现象,现在我们再来看一个人类方面的例子。
例如进行性假肥大性肌营养不良(Duchenne muscular dystrophy, DMD), 一般在三岁左右发病。这种疾病大多是由 X 连锁的隐性基因控制的。患者的腰带和肩带最先受到影响, 假性肥大,特别是小腿更为明显,以后逐渐进展,骨骼变形,最后呼吸道感染或营养不良,多在二十岁前后死亡。
有一个DMD家系,根据分析,知道是X连锁遗传的(图6-23)。这性状一般仅在男性中出现,患者的基因型是 $X^{md}Y$ ,只要X染色体上有一隐性肌营养不良基因就显示出病症来,而女性中很少会有,因为基因型 $X^{+}X^{md}$ 的女性在表型上是正常的。现在有一家系中有一女性患者,而她的父亲是正常的,那么这个现象怎样解释呢?后又发现这个女性较矮,性发育不良,检查她的染色体,知道她是特纳综合征患者(XO),这样疑团就迎刃而解了。因为她只有一个X,所以跟男性一样,这X上带有隐性基因md时,就直接在表型上显示出来了。
图6-23 一个DMD家系
$X^{md}$ , X 染色体上带有 DMD 致病等位基因 md; $X^{+}$ , X 染色体上带有与 md 相对应的正常基因。
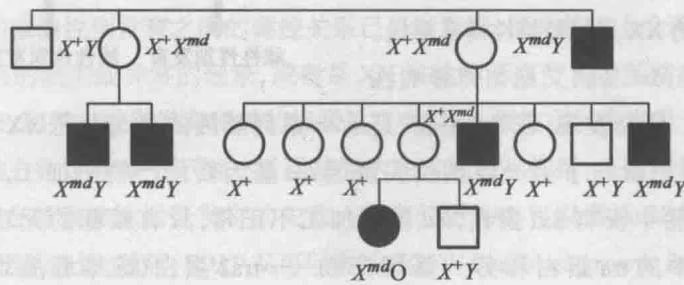
第六节 基因与性指数
随着遗传学的发展,人们逐渐认识到由染色体决定的性别发育实际上是一系列性别相关基因调控的发育过程,环境因素可以通过影响这些性别相关基因的表达或相互作用从而实现对性别发育的调控。研究还发现,性别相关基因不仅位于性染色体上,常染色体上也有影响性别发育的关键基因,也就是说,常染色体也参与性别发育的调控。下面我们就以果蝇和人为例,详细介绍与性别决定有关的基因行为。
一、果蝇的性指数
前面我们已经提过,果蝇的性别决定是 XY 型,XX 个体是雌蝇,XY 个体是雄蝇。1932 年,布里奇斯进一步揭示果蝇的性别是由早期胚胎的性指数(sex index)所决定的,即 X 染色体的数目与常染色体组数的比例(X:A)。在一只二倍体果蝇中,如果它只有一条 X 染色体,则 X:A=1:2=0.5,即 1 条 X 染色体与两套常染色体组数的比值为 0.5,这只果蝇会发育成为雄性;如果它有两条 X 染色体,则 X:A=2:2=1,即两条 X 染色体与两套常染色体组数的比值为 1,这只果蝇发育成为雌性。因此说,果蝇的性别决定既与 X 染色体的数目有关,也与常染色体组的套数有关,而与 Y 染色体的有无没有关系,Y 染色体只决定雄蝇的可育性。XO 的果蝇是不育的雄性,而 XXY 的果蝇是正常的雌性。
那么,X:A 这一比值是如何调控果蝇的性别发育的呢?这其中涉及了一系列基因的“级联”反应(图 6-24)。首先,X:A 的比值决定了 X 染色体连锁基因产物和常染色体基因产物之间的相对丰度,X:A 比值高时,充足的 X 染色体连锁基因产物可以和受精卵中积累的母体效应
基因(详见遗传与个体发育一章)产物相互作用, 激活性别相关基因 Sxl 的早期(受精后 2 h 内)转录, Sxl 的早期表达产物随后参与了自身 mRNA 的加工成熟, 最终合成大量的 Sxl 蛋白质, 促进雌性果蝇的性别分化。但在 X: A 比值低时, 没有充足的 X 染色体基因产物的积累, 也就不能在早期激活 Sxl 基因的表达, 亦没有 Sxl 蛋白质的积累, 果蝇发育成为雄性。因此, Sxl 基因突变的 XX 果蝇是雄性而非雌性。
那接下来, $Sxl$ 基因又是如何影响性
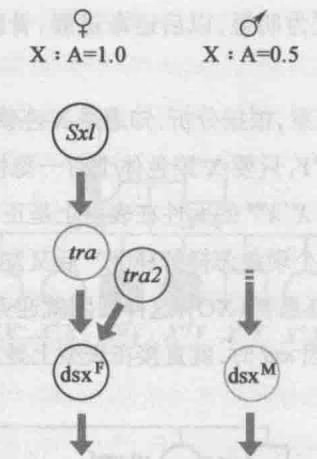
雌性性别发育 雄性性别发育
图6-24 果蝇的性别决定途径
别发育的呢?研究发现,在Sxl下游,还有一系列基因的参与。在XX胚胎中,由早期转录产生的Sxl蛋白参与了另一性别相关基因tra基因转录产物的加工,得到有功能的tra蛋白,而XY胚胎中没有Sxl蛋白,tra基因加工不正常,只有截断的无功能的多肽产物。随后,XX个体中的tra蛋白和另一基因产物——tra2蛋白(雌雄胚胎均表达)共同调控下游dsx基因产物的加工成熟,得到雌性特异的dsx蛋白 $(\mathrm{dsx}^{\mathrm{F}})$ ,它可以抑制雄性性别发育,因此胚胎发育成雌性。而在XY胚胎中,由于没有tra蛋白,dsx被加工成了另一种形式的dsx蛋白 $(\mathrm{dsx}^{\mathrm{M}})$ ,它可以抑制雌性性别发育,因此胚胎发育成雄性。可见,果蝇的性别决定的“级联”反应是一系列性别相关基因共同调控的结果,最后由dsx蛋白的性质决定性别发育的方向。如果一只果蝇的胚胎缺失了dsx基因,那么它将同时发育出雌性和雄性的特征。
二、人类的睾丸决定因子
哺乳动物的性别决定分为初级性别决定(primary sex determination)和次级性别决定(secondary sex determination),前者是性腺的发育,后者是性腺以外的第二性征的发育,受性腺分泌的激素所调控。和果蝇不同,人类的性别决定由Y染色体决定,XXY个体是男性,而XO个体是女性。在没有Y染色体的胚胎中,性腺原基发育成卵巢,卵巢产生的雌激素促使米勒管(中肾旁管)发育成阴道、宫颈、子宫和输卵管。如果有Y染色体,性腺原基则发育成睾丸,分泌出抗米勒激素,抑制雌性生殖器官的生成,同时分泌睾酮,促进胎儿生成附睾、输精管、精囊等雄性生殖器官。
人 Y 染色体上的关键性别决定因子, 即睾丸决定因子 (testis-determining factor, TDF) 的基因克隆经历了几个研究阶段。研究者先是从一些 Y 染色体缺失的 XY 突变个体中发现, 仅有 Y 染色体短臂而没有 Y 染色体长臂的个体是男性, 仅有 Y 染色体长臂没有 Y 染色体短臂是女性, 说明 TDF 编码基因位于 Y 染色体的短臂。后来利用 DNA 原位杂交的方法将 TDF 区域缩小至 35 kb 的 Y 染色体区域。具体方法是, 利用覆盖 Y 染色体短臂不同区域的特异 DNA 探针与 XX 男性和 XY 女性患者的 DNA 样本进行分子杂交, 发现所有 XX 男性中在 X 染色体或常染色体上出现了一些杂交信号, 说明有 Y 染色体片断易位 (详见染色体畸变一章) 到了这些染色体上,能够表达 TDF, 促进雄性特征的发育。而所有的 XY 女性中, 在 Y 染色体上都出现了一定的缺失, 不能正常表达 TDF, 抑制了雄性特征的发育而促进了雌性特征的发育。仔细分析后又发现, XX 男性在 X 或常染色体上增加的片段与 XY 女性 Y 染色体上缺失的是相同的 Y 染色体区段, 长度约 35 kb。1990 年, 研究者从 35 kb 的 Y 染色体区域中分离出了编码 TDF 的候选基因 (Sinclair, 1990), 称为 Y 染色体性别决定区 (sex-determining region of Y, SRY) (图 6-25)。SRY 编码一条由 204 个氨基酸组成的多肽, 是一个有功能的 DNA 转录因子, 只在睾丸中特异表达。由于人 SRY 基因紧挨着 X 染色体和 Y 染色体能够发生重组交换的拟常染色体区 (pseudoautosomal region), 因此有时候会因为不正常交换从 Y 染色体转移到 X 染色体上, 形成含有缺乏 SRY 的 Y 染色体的配子以及含有 SRY 的 X 染色体的配子, 导致 XY 女性和 XX 男性个体的出生。
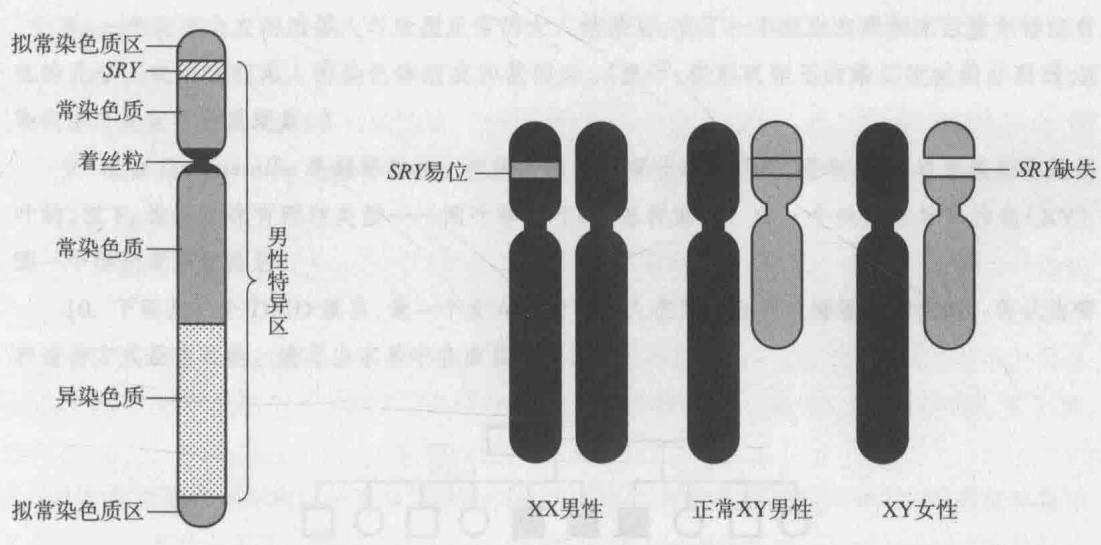
(a)
(b)
图6-25 人的性别决定
尽管 SRY 基因和雄性性别发育之间的调控关系已毋庸置疑,但是临床上会遇到个别 XY 女性中未发现 SRY 基因的缺失或异常的现象,或者是 XX 男性却不携带 SRY 的情况,这又是什么原因造成的呢?原来,和果蝇性别发育所需的级联反应类似,人类性别发育也是一个级联反应,SRY 调控雄性性别的分化还依赖于下游一系列基因的表达和相互作用,当这些基因异常时,即使 SRY 完全正常,也会导致雄性性征发育的失败。现在知道 SRY 可以激活 SOX9(SRY related HMG-box gene 9)基因的表达,随后,SOX9 又可以激活 FGF9(fibroblast growth factor 9)的表达,后者参与了性腺的分化。此外,在 SRY、SOX9、FGF9 顺序激活的同时,与雌性性征发育相关的基因,如 WNT4(wingless-type MMTV integration site family,member 4)等,则被抑制,进一步保证了性别发育的方向。值得一提的是,SOX9 和 FGF9 基因均位于常染色体上,换句话说,常染色体也参与了人的性别发育。即使 Y 染色体完整无缺,SRY 基因序列正常,如果常染色体上的 SOX9 或 FGF9 发生了缺失突变,也会导致睾丸发育受阻,同时,位于 X 染色体上的 WNT4 不再受到抑
(a) Y 染色体示意图, Y 染色体的两端是拟常染色体区, 可以和 X 染色体的两端区域联会配对并发生交换。其余部分是男性特异区。SRY 基因位于 Y 染色体短臂邻近拟常染色体的区域。(b) 正常 XY 男性的性染色体与 XX 男性、XY 女性的性染色体组成。
制作用,可以促进卵巢的发育。
随着分子遗传学的不断发展,基因调节性别发育的分子途径以及相应的生化代谢途径会更加清晰。性别是生物众多性状中的一种,是由染色体及其携带的基因所决定的,但在性别分化这一性状实现的过程中,亦会受到环境因素的影响。
哺乳动物中,雌雄比例大致接近 1:1,怎样解释?
你怎样区别某一性状是常染色体遗传, 还是伴性遗传的? 举例说明。
在果蝇中, 长翅 $(Vg)$ 对残翅 $(vg)$ 是显性, 这基因在常染色体上; 红眼 $(W)$ 对白眼 $(w)$ 是显性, 这基因在 X 染色体上。果蝇的性别决定是 XY 型, 雌蝇是 XX, 雄蝇是 XY, 问下列交配所产生的子代, 基因型和表型如何?
(1) WwVgvg \times wvgvg (2) wwVgvg \times WVgvg
纯种芦花公鸡和非芦花母鸡交配, 得到 $F_{1}$ 。 $F_{1}$ 个体互相交配, 问 $F_{2}$ 的芦花性状与性别的关系如何?
在鸡中, 羽毛的显色需要显性基因 $C$ 的存在, 基因型 $cc$ 的鸡总是白色。已知, 羽毛的芦花斑纹是由伴性 (或 $Z$ 连锁) 显性基因 $B$ 控制的, 而且母鸡是异配性别。一只基因型是 $ccZ^{b}W$ 的白羽母鸡跟一只芦花公鸡交配, $\mathbf{F}_{1}$ 都是芦花斑纹, 如果这些子代个体相互交配, 它们的子裔的表型分离比是怎样的? (注: 基因型 $C_Z^{b}Z^{b}$ 和 $C_Z^{b}W$ 鸡的羽毛是非芦花斑纹。)
在火鸡的一个优良品系中, 出现一种遗传性的白化症, 养禽工作者把 5 只有关的公禽进行检测, 发现其中 3 只带有白化基因。当这 3 只公禽与无亲缘关系的正常母禽交配时, 得到 229 只幼禽, 其中 45 只是白化的, 而且全是母的。育种场中可以进行一雄多雌交配, 但在表型正常的 184 只幼禽中, 育种工作者除了要消除白化基因外, 想尽量多地保存其他个体。你看火鸡的这种白化症的遗传方式怎样? 哪些个体应该淘汰, 哪些个体可以放心地保存? 你怎样做?
有一视觉正常的女子,她的父亲是色盲。这个女人与正常视觉的男人结婚,但这个男人的父亲也是色盲。问这对配偶所生的子女视觉如何?
一个没有血友病的男人与表型正常的女人结婚后,有了一个患血友病和克兰费尔特综合征的儿子。说明他们两人的染色体组成和基因型。(提示:在形成卵子的第二次减数分裂时,X染色体可发生不分离现象。)
植物 Lychnis alba 是雌雄异株。把阔叶雌株与窄叶雄株杂交,得到的 $F_{1}$ 雌雄植株都是阔叶的,但 $F_{2}$ 雄性植株有两种类型——阔叶和窄叶,你怎样解释?哪一个性别是异配性别(XY),哪一个性别是同配性别?
下面是一个 DMD 家系, 是一个女人和两个男人在两次分别的婚姻中产生的。你认为哪种遗传方式最有可能。请写出家系中各成员的基因型。
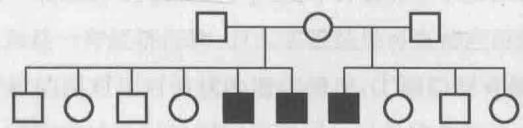
请问:①双亲都是色盲,他们能生出一个色觉正常的儿子吗?②双亲都是色盲,他们能生出一个色觉正常的女儿吗?③双亲色觉正常,他们能生出一个色盲的儿子吗?④双亲色觉正常,他们能生出一个色盲的女儿吗?
在黑腹果蝇中, 截刚毛 (bobbed bristles) 基因存在于 X 和 Y 的同源区域, 所以 X 和 Y 上都有这基因。这基因记作 bb, 它对野生型基因 (+) 为隐性。隐性纯合子的刚毛短而细。如果将截刚毛雌蝇 $(X^{bb}X^{bb})$ 与纯合子正常刚毛雄蝇 $(X^{+}Y^{+})$ 交配,问 $\mathbf{F}_1$ 和 $\mathbf{F}_2$ 的基因型和表型的比例如何?
火鸡的卵有时能孤雌生殖, 这有 3 个可能的机制: ①卵没有经过减数分裂, 仍为二倍体; ②卵核被极体受精; ③卵核染色体加倍。你预期每一假设机制所产生的子代的性比如何? (假定雏鸡要能活下去, 一个 Z 染色体是必须存在的。)
在小家鼠中,有一突变基因使尾巴弯曲。现在有一系列杂交实验,结果如下:
| 杂交 | 亲代 | 子代 | ||
| 雌 | 雄 | 雌 | 雄 | |
| 1 | 正常 | 弯曲 | 全部弯曲 | 全部正常 |
| 2 | 弯曲 | 正常 | 1/2弯曲,1/2正常 | 1/2弯曲,1/2正常 |
| 3 | 弯曲 | 正常 | 全部弯曲 | 全部弯曲 |
| 4 | 正常 | 正常 | 全部正常 | 全部正常 |
| 5 | 弯曲 | 弯曲 | 全部弯曲 | 全部弯曲 |
| 6 | 弯曲 | 弯曲 | 全部弯曲 | 1/2弯曲,1/2正常 |
问:①这突变基因是显性还是隐性? ②是常染色体遗传,还是伴性遗传? ③表中6个杂交中,亲代和子代的基因型各如何?
假设果蝇的 X 染色体 (X) 和常染色体组 (A) 的组成分别为 (1X, 2A)、(2X, 2A)、(3X, 3A)、(2X, 4A)、(4X, 4A),试分析这些果蝇的性别表型。
一只性染色体组成为 XY 的小鼠胚胎, 如果 Y 染色体上缺失了 Sry 基因, 它将发育成雌鼠还是雄鼠? 另一只性染色体组成为 XY 的小鼠胚胎的 Sry 基因正常, 但它常染色体上的 Sox9 基因缺失, 这只小鼠又将发育成什么性别?
数字课程学习
在线自测 习题答案
指出所,有会指出所各区,中等点指出五指出一个一出土地门面,皆为多指出,仅①问解。11. 且现合参见②:指下式指自合十一出土地门面,带面设意用③:指上式指在五指合一个一出土地门面。
第七章 连锁交换与连锁分析
遗传的染色体学说建立以后,进一步就要了解染色体与基因的关系。一个生物有很多基因,而染色体数目比较少,这又怎样解释呢?正如布里奇斯研究果蝇眼色的遗传时发现了例外个体,使他注意到了新的现象一样,遗传学工作者研究两对基因的杂交,发现有时候 $F_{2}$ 分离比例与预期的9:3:3:1有非常显著的差异,这使他们注意到了连锁现象。连锁现象不仅证明了一条染色体带有很多基因,而且证明了这些基因在染色体上是以直线方式排列的。
第一节 连锁与交换
连锁现象是贝特森和庞尼特(1906)最初发现的。他们研究香豌豆的两对性状的遗传时发现来自同一亲本的基因较多地连在一起,这就是所谓基因的连锁(linkage),但是他们未能提出正确的解释。摩尔根(1910)发现果蝇白眼性状的伴性遗传后,同年又发现几个伴性遗传的性状。他进一步同时研究了两对伴性性状的遗传,发现凡是伴性遗传的基因,相互之间都是连锁的。这就证实了同一染色体上的基因有连锁现象。
这里应用玉米的例子,从遗传学上说明连锁现象,并在细胞学上加以解释。
一、连锁
用玉米研究基因的连锁,好处很多:①很多性状可在种子上看到,种子虽然长在母本的果穗上,但已是下一代了;②同一果穗上有几百粒种子,便于计数分析;③雌、雄蕊长在不同花序上,去雄容易,杂交也方便;④玉米是一种经济作物,有些实验结果可直接应用到生产上。
我们现在来看玉米籽粒的两对相对性状的遗传情况:①糊粉层有色的种子(C)对糊粉层无色的种子(c)是完全显性;②饱满种子(Sh)对凹陷种子(sh)是完全显性。
有色饱满粒的植株与无色凹陷粒的植株杂交,如果两对基因是独立分配的, $F_{1}$ 应该产生 4 种配子—— $CSh$ 、 $Csh$ 、 $cSh$ 、 $csh$ ,而且它们的比例相等。要检验这个假定是否成立,最简易的方法是把 $F_{1}$ 植株跟双隐性植株杂交,看测交一代中 4 种籽粒的比例是否相等。因为双隐性个体只能产生一个配子 $csh$ ,这两个基因都是隐性的, $F_{1}$ 植株所产生的 4 种配子 $CSh$ 、 $Csh$ 、 $cSh$ 、 $csh$ 跟双隐性植株所产生的 $csh$ 配子结合时,测交一代的表型能够如实反映配子类型(图 7-1)。
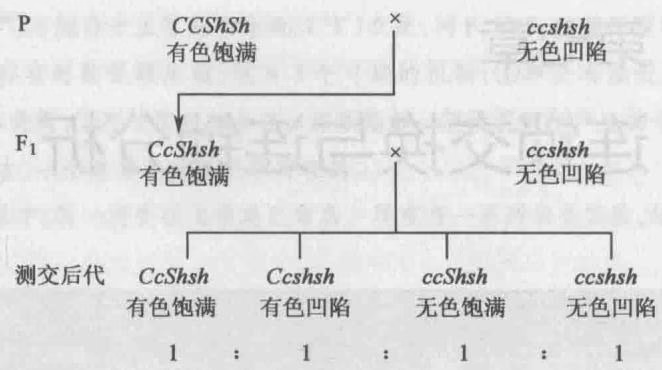
如果有关的两对基因自由组合,预期测交后代比例为 1:1:1:1。
但是实验的结果不是这样。在测交后代中,与亲代相同的类型比预期多得多,而亲代没有的新类型比预期少。这表明 C 与 Sh, c 与 sh 倾向于相互结合在一起,仅以某一较低的比例分开,两者之间有一定程度的连锁。所以我们换一个写法,把同一条染色体上的两个基因写在一起,中间用斜线隔开,并把实验所得数据写出来(图 7-2)。
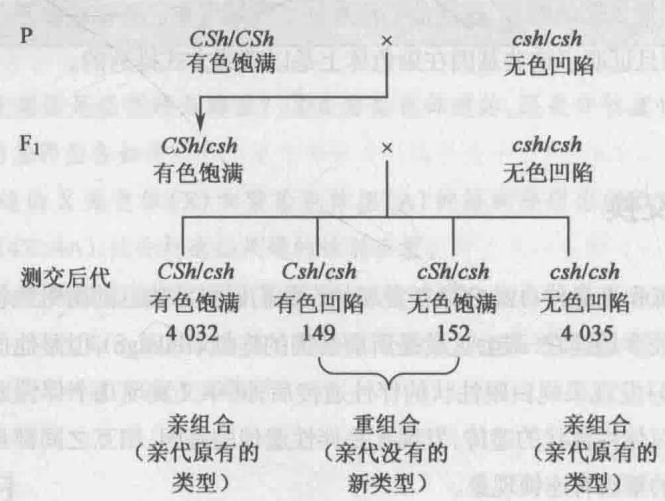
两个非等位基因之间存在连锁,测交子代中亲组合比重组合多得多。
根据上面的数值进行计算,发现有色饱满和无色凹陷的籽粒比较多,这些是亲代原有的组合,它们在总数中占96.4%,而有色凹陷和无色饱满的籽粒比较少,这些是亲代没有的新组合,它们在总数中只有3.6%,即
1 | \begin{array}{l} \text {亲组合} \\ \text {重组合} \end{array} \left. \begin{array}{c c} C S h & 4032 \\ c s h & 4035 \end{array} \right\} 8067 8067 / 8368 = 96.4 \% \\ \left. \begin{array}{c c} C s h & 149 \\ c S h & 152 \end{array} \right\} 301 301 / 8368 = 3.6 \% \end{array} |
这样的比值显然跟两对基因是独立分配的假定不相符合。
如换一种交配方式,把无色饱满粒的植株与有色凹陷粒的植株杂交, $F_{1}$ 跟双隐性植株杂交,则得另一组结果(图7-3)。
把亲组合与重组合分别加起来,并计算它们的百分比,得
1 | \text{亲组合} \left. \begin{array}{l} C s h 2 1 3 7 9 \\ c S h 2 1 9 0 6 \end{array} \right\} 4 3 2 8 5 4 3 2 8 5 / 4 4 5 9 5 = 9 7. 0 6 |
重组合
$$
\left. \begin{array}{l} C S h \quad 638 \ c s h \quad 672 \end{array} \right} 1310 \quad 1310 / 44595 = 2.94%
$$
可见不论用哪种交配方式,结果都是一样:亲组合的比例很高,占97%左右,而重组合的比例很低,仅占3%左右。重组合类型明显少于亲组合类型,说明有连锁存在。
图7-3 无色饱满植株与有色凹陷植株的 $\mathsf{F}_1$ 测交的真实结果
两个非等位基因之间仍然存在连锁,测交子代中亲组合比重组合多得多。
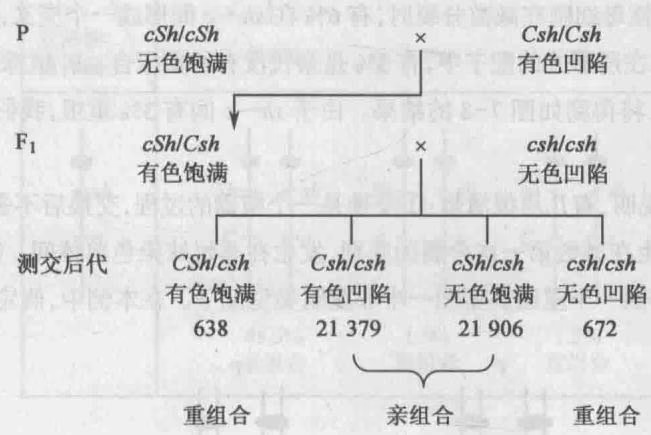
二、交换
带有亲本原有基因组合的配子比带有新的基因组合的配子多,这个情况在动植物的连锁遗传实验中都可看到。而且每一对连锁基因的重组频率是固定的,或者说,连锁强度是固定的,但不同基因间的连锁程度却是不同的。
如果假定,相互连锁的基因是在同一染色体上,那么为什么不是100%连锁,而仍有一定比例的重组呢?例如c与sh间有97%保持亲本原有的组合,而有3%相互分开,重新组合,形成亲代所没有的新组合,那又如何解释呢?
让森斯(Frans Alfons Janssens,1865—1924)(1909)通过观察两栖类和直翅目昆虫的减数分裂,在摩尔根等确立遗传的染色体学说之前,提出了交叉型假设(chiasmatype hypothesis)。这个假设有两个要点:
① 在减数分裂前期,尤其是双线期,配对中的染色体不是简单地平行,而是在某些点上显出交叉缠结的图像。每一点上的这样一个图像称为一个交叉,是同源染色体间对应片段发生交换的地方(图 7-4)。
② 相互连锁的两个基因位于同一染色体的不同位置,如果这两个位置之间发生交换,就导致这两个连锁基因的重组(recombination)。
以后的研究证实了这两点假设。现在我们仍以玉米的 $sh - c$ 的连锁为例,用图解方式说明交叉与交换的关系。
有色饱满粒的植株与无色凹陷粒的植株杂交, $F_{1}$ 植株用双隐性植株测交,各杂交植株用双线
图 7-4 同源染色体交换的示意图
有两个交叉(用箭头指出), 表示非姐妹染色单体间发生过交换。
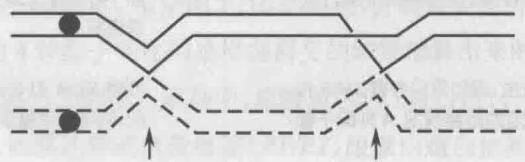
期时的4条染色单体表示,并在染色单体旁注明有关的基因符号(图7-5)。
$F_{1}$ 植株的性母细胞在减数分裂时,如交叉出现在 sh-c 外侧,那么这两基因之间没有交换,形成的配子都是亲组合(图 7-6)。如交叉出现在 sh-c 内部,两条非姐妹染色单体就在这两基因之间发生交换,所形成的配子中,有一半是亲组合,另一半是重组合(图 7-7)。
如 $F_{1}$ 植株的性母细胞在减数分裂时,有 6% 在 sh-c 间形成一个交叉,染色单体在 sh-c 间发生了交换,那么在所形成的配子中,有 3% 是亲代没有的重组合。 $F_{1}$ 植株的配子与双隐性植株的配子随机组合,将得到如图 7-8 的结果。由于 sh-c 间有 3% 重组,我们可以说,sh 与 c 间的交换值是 3%。
根据上面的说明,有几点很清楚:①交换是一个精确的过程,交换后不多一个基因,不少一个基因。②交换发生在减数第一次分裂的前期,发生在非姐妹染色单体间。③在连锁的基因间每发生一个交叉,得到一半重组类型和一半非重组类型配子。在本例中,假定6%细胞在sh-c间
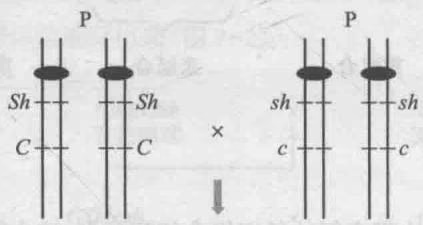
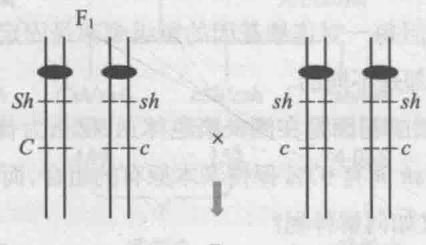
用双线期染色体表示。
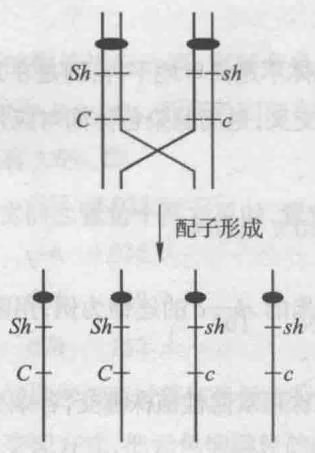
尽管有重组事件发生,但如果只考察 Sh/sh 和 C/c 这两对等位基因的组合情况,4 种配子都是亲组合
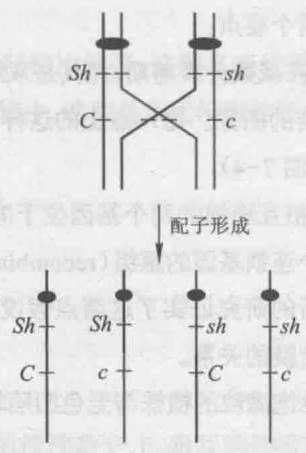
考察 Sh/sh 和 C/c 这两对等位基因的组合情况, 两种配子是亲组合, 两种配子是重组合图 7-8 $F_{1}$ 有色饱满的双杂合玉米植株测交后代分离比
如 $F_{1}$ 植株在减数分裂时有 6% 在 sb-c 间形成一个交叉,则用双隐性植株测交时,测交后代将出现 3% 的重组合。
 |  |  |  |  |
| 48.5% | 1.5% | 1.5% | 48.5% | |
 |  |  |  |  |
| 48.5%亲组合 | 1.5%重组合 | 1.5%重组合 | 48.5%亲组合 |
有一交叉,因此重组率或交换率是3%。
因为测交比例直接反映配子的分离比例,所以实际操作中,将 $F_{1}$ 有色饱满植株(CSh/csh)用双隐性植株(csh/csh)测交(图7-2),重组率或交换率可直接用下式简易地求得:
1 | \frac{\text{重组合}}{\text{亲组合} + \text{重组合}} = \frac{301}{8067 + 301} = 3.6\% |
一般地说,交换率愈小,基因间的连锁愈易察觉,测交比例与1:1:1:1相差愈大;交换率愈大时,例如超过40%接近50%时(但不会超过50%),基因间的连锁愈难察觉,测交比例与1:1:1:1很接近,需要有大量的测交后代,否则不易鉴别。
三、雌雄的连锁不同
很多动物如鸡、小鼠、猫、人等,连锁基因的重组率在雌雄中大致上是一样的。但也有极少数的动物的交换值在雌雄间不同,例如雄果蝇和雌家蚕中通常不发生交换,基因完全连锁,不发生重组。
黑腹果蝇中,突变型体色黑体(b)对野生型体色“略近灰体”(+)是隐性,又突变型眼色紫眼(pr)对野生型眼色红眼(+)是隐性。如把黑体红眼 $(b+/b+)$ 与灰体紫眼 $(+pr/+pr)$ 杂交, $F_{1}$ 是灰体红眼 $(b+/+pr)$ 。现在如把 $F_{1}$ 雄蝇 $(b+/+pr)$ 与双隐性雌蝇 $(bpr/bpr)$ 交配,因为雄蝇不发生交换,所以只产生两种精子,即 $b+$ 和 $+pr$ ,而且比例相等,而双隐性雌蝇只产生一种卵,即bpr,所以测交后代只有灰体紫眼和黑体红眼两种,比例为1:1,如图7-9所示。
但是,如果我们用 $F_{1}$ 雌蝇 $(b+/+pr)$ 跟双隐性雄蝇 $(bpr/bpr)$ 交配,所产生的后代会出现4种表型。实验结果如图7-10所示。根据图7-10的数据,计算重组率,得 $(1+1)/(1+19+19+1)=5%$ 。图中 $F_{1}$ 雌蝇所产生的4种配子的比例是根据测交的结果推算出来的。
现在再来看家蚕的一个例子。家蚕中,血液黄色(Y)对白色(y)是显性,幼虫皮斑普通斑(P)对素白斑(p)是显性,如果让普通斑黄血蚕(PY/PY)跟素白斑白血蚕(py/py)杂交, $F_{1}$ 是普通斑黄血蚕 $(PY/py)$ 。现在让 $F_{1}$ 的雌蚕跟双隐性雄蚕 $(py/py)$ 交配,因为在雌蚕中没有交换,所以只产生两种卵,即PY和py,而且比例相等,而双隐性雄蚕只产生一种精子,即py,所以测交后代只有普通斑黄血蚕和素白斑白血蚕两种,比例为1:1,如图7-11所示。
如果我们用 $F_{1}$ 雄蚕 (PY/py) 跟双隐性雌蚕 (py/py) 交配,所产生的后代则出现 4 种表型,即普通斑黄血蚕、普通斑白血蚕、素白斑黄血蚕、素白斑白血蚕(图 7-12)。同理,图中 $F_{1}$ 雄蚕所产生的 4 种配子的比例是根据交配的结果推算出来的。从上述两个实验看来,p-y 间重组率,雌蚕是 0,雄蚕是 $(1+1)/(3+1+1+3)=25%$ 。换句话说,家蚕的情况刚好和果蝇相反,雌的连锁完全,
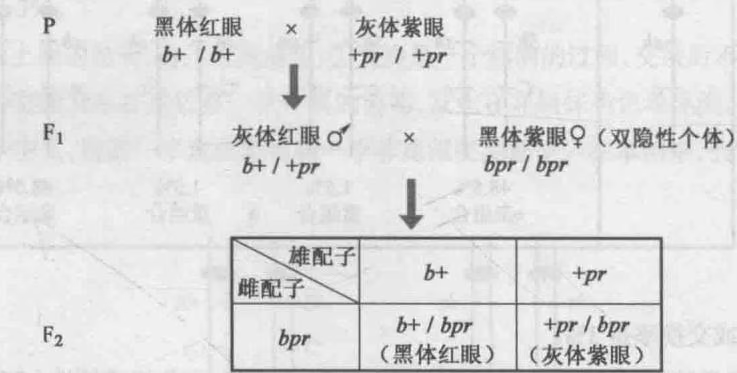
测交后代只有两种表型, 比例为 1:1, 没有重组类型出现, 表现为完全连锁。
$$
\mathrm{F} _ {1}
$$
$$
\mathrm{F} _ {2}
$$
| 雌配子\雄配子 | bpr |
|---|---|
| 1 ++ | ++/bpr(灰体红眼,1) |
| 19 +pr | +pr/bpr(灰体紫眼,19) |
| 19 b+ | b+/bpr(黑体红眼,19) |
| 1 bpr | bpr/bpr(黑体紫眼,1) |
图 7-10 $F_{1}$ 杂合子雌蝇与双隐性雄蝇的测交结果
测交后代有 4 种表型,亲组合比重组合多得多,表现为紧密连锁。
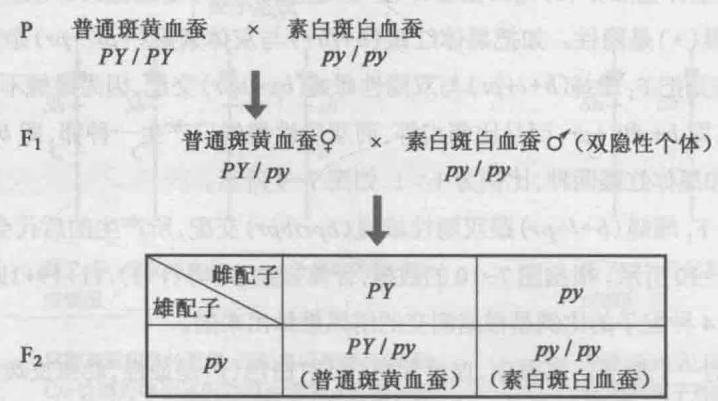
| 雌配子 雄配子 | PY | py |
|---|---|---|
| py | PY/py (普通斑黄血蚕) | py/py (素白斑白血蚕) |
图7-11 $F_{1}$ 杂合子雌蚕的测交结果
测交后代只有两种表型, 比例为 1:1, 没有重组类型出现, 表现为完全连锁。
图7-12 $\mathsf{F}_1$ 杂合子雄蚕的测交结果
出现了重组类型,但亲组合比重组合多,表现为不完全连锁。
| 雌配子\雄配子 | 3 PY | 1 Py | 1 pY | 3 py |
|---|---|---|---|---|
| py | PY/py(普通斑黄血蚕) | Py/py(普通斑白血蚕) | pY/py(素白斑黄血蚕) | py/py(素白斑白血蚕) |
雄的连锁不完全。
所以在果蝇中用双杂合子雄蝇与双隐性雌蝇交配,在家蚕中用双杂合子雌蚕与双隐性雄蚕交配,每次都能毫无疑问地察觉连锁。但这对估计重组率毫无用处,因为在雄果蝇和雌家蚕中两对基因要么是连锁而重组率为0,要么自由组合而重组率为50%。因此,在果蝇中,所谓重组率,都是指雌蝇的重组率;在家蚕中,所谓重组率,都是指雄蚕的重组率。
四、连锁群
遗传学工作者用上述方法对许多生物中的很多基因进行实验后,得出两条行之有效的规则:①如果A基因与B基因连锁,B基因与C基因连锁,那么A基因与C基因连锁。②如果A基因与B基因连锁,B基因与C基因不连锁,那么A基因一定不与C基因连锁。这两条规则当然与染色体机制完全符合。这样就得出“连锁群”(linkage group)的概念。设有A,B,C,D4个基因,A与B连锁,C与D连锁,而A与C不连锁,则A和B属于同一连锁群,C和D属于另一连锁群。
果蝇由于雄体完全连锁,连锁群的测定稳定可靠。摩尔根等在1914年已发现果蝇一共只有4个连锁群。到1942年为止,在果蝇中至少测定了494个基因,分别属于这4个连锁群之一。
连锁群的次序一般按发现先后而定。果蝇只有4对染色体,很容易想到每个连锁群相当于一对染色体。第一连锁群包括全部伴性遗传的基因,肯定是相当于X染色体。第四连锁群的基因数最少,可能相当于那对最小的点状染色体,以后的实验证实了这些猜想。第二和第三连锁群分别相当于两对大的V形染色体。
凡是在遗传学上充分研究过的生物中,连锁群的数目理论上应该等于单倍体染色体数(n),而事实确是如此(表7-1),这也是遗传的染色体理论的有力证据。人有22对不同的常染色体以及一对性染色体,已绘制出了24个连锁群 $(22+X+Y)$ 。
表 7-1 几种生物的连锁群数目等于单倍体染色体数目
| 生物种类 | 连锁群数 | 单倍体染色体数 | 生物种类 | 连锁群数 | 单倍体染色体数 |
|---|---|---|---|---|---|
| 小鼠 | 20 | 20 | 番茄 | 12 | 12 |
| 黑腹果蝇 | 4 | 4 | 豌豆 | 7 | 7 |
| 玉米 | 10 | 10 | 粗糙链孢霉 | 7 | 7 |
| 大麦 | 7 | 7 |
五、三点试验与基因直线排列
到现在为止,还未曾说明重组率大小是由什么因素决定的。摩尔根(1911)曾提出设想,重组率可能是由两个基因在染色体上的距离决定的,这个设想可以用实验方法来验证。研究重组值问题,最容易想到的方法就是研究几个相互连锁的基因间的重组率之间的关系。例如a,b,c这3个基因是相互连锁的,则可研究a-b,b-c,a-c这3个重组率之间的关系,需要做3次试验。但是摩尔根和他的学生斯特蒂文特等早就发现,可以把这3个基因包括在同一次交配中,例如用三杂合子 $abc/+++$ 或 $ab+/++c$ 与三隐性个体abc/abc测交。这种试验叫作三点测交(three-point test cross),简称三点试验。进行这种试验,一次试验就等于3次“两点试验”,而且还有另外两个优点:
① 一次三点试验中得到的3个重组率是在同一基因型背景,同一环境条件下得到的;而3次“两点试验”就不一定这样。重组率既受基因型背景的影响,也受各种环境条件的影响。所以严格地讲,只有从三点试验所得到的3个重组率才是可以相互比较的。
② 通过三点试验还可得到 3 次两点试验所不能得到的资料, 就是关于双交换的资料, 这在下面将要谈到。
现在拿黑腹果蝇中的一些三点试验的实得数据来说明。3个突变基因是ec(echinus,棘眼),sc(scute,缺少某些胸部刚毛)和cv(crossveinless,翅上横脉缺失),都是X连锁遗传的。把棘眼果蝇与缺胸刚毛、缺横脉果蝇杂交,得到三杂合子 $ec++/+sc\ cv$ (不代表基因的次序,因为在未做试验之前是不知道的)。三杂合子与三隐性雄蝇(ec sc cv/Y,这儿Y代表Y染色体)交配,试验中实得的个体数如表7-2。
表 7-2 三杂合雌蝇与三隐性雄蝇交配,得到的测交子代的数据
| 表型 | 实得数 | ||
| ec | + | + | 810 |
| + | sc | cv | 828 |
| ec | sc | + | 62 |
| + | + | cv | 88 |
| + | sc | + | 89 |
| ec | + | cv | 103 |
| 合计 | 1980 | ||
因为三隐性雄蝇产生的配子,或为 $ecsc cv,3$ 个基因都是隐性,或为Y,上面不带有相应的等位基因,所以三杂合子雌蝇所产生的各种配子跟三隐性雄绳所产生的配子结合时,雌蝇的各配子的比例能如实地在表型比例上反映出来。我们根据表7-2中的测交子代的个体数目就能求得3个重组率。先来计算 $ec - sc$ 的重组率。我们不看 $cv / +$ ,把它放在括号中,只考虑 $ec - sc$ 这一对。
1 | arrayc c c c e c & + & (+) & 8 1 0 |
亲组合是 $810+828+89+103=1\ 830$ ,重组合是 $62+88=150$ ,所以 ec—sc 间的重组率是 $150/(1\ 830+150)=7.6%$ ,去掉 % 后,就是两基因在遗传学图上的图距(map distance)。
1 | arrayc c c e c & 7. 6 & s c |
现在再来计算 $ec - cv$ 的重组率,这时我们忽略 $sc / +$
1 | \begin{array}{r r r r} \text {ec} & (+) & + & 8 1 0 \\ + & (s c) & c v & 8 2 8 \\ e c & (s c) & + & 6 2 \\ + & (+) & c v & 8 8 \\ + & (s c) & + & 8 9 \\ e c & (+) & c v & 1 0 3 \\ \hline & & & 1 9 8 0 \end{array} |
亲组合是 $810+828+62+88=1\ 788$ ,重组合是 $89+103=192$ ,所以 ec—cv 间的重组率是 $192/(1\ 788+192)=9.7%$ , ec 与 cv 在遗传图上的图距是 9.7。
1 | arrayc c c e c & 9. 7 & c v |
得到 $ec - sc$ 间的图距是7.6, $ec - cv$ 间的图距是9.7之后,我们可以有两种画法:
1 | \begin{array}{c c c}e c&7. 6&s c c v\\\hline \leftarrow 9. 7 \rightarrow\end{array} \text {或} \quad\begin{array}{c c c}s c&7. 6&e c&9. 7&c v\\\hline\end{array} |
现在来看 sc-cv 间的重组率是多少?用同样方式,这次是忽略 ec/+。
1 | arrayr r r r (e c) & + & + & 8 1 0 |
亲组合是 $810+828=1638$ ,重组合是 $62+88+89+103=342$ ,所以 sc-cv 间的重组率是 342/1980=17.3%,图距是 17.3。现在我们知道图应该这样画了:
1 | arrayc c c c s c & 7. 6 & e c & 9. 7 |
图中,3个重组率间的关系十分清楚,即 $sc - cv$ 的重组率等于 $sc - ec$ 重组率与 $ec - cv$ 重组率之和 $(7.6% + 9.7% = 17.3%)$ 。我们把这种关系说成是直线关系,就上述试验来说,这3个基因的直线顺序是 $sc - ec - cv$ 。根据摩尔根的假设,就是基因在染色体上按这个次序直线排列。
现在按照 sc—ec—cv 的顺序, 把表 7-2 的资料重新排列, 算出百分数, 并注明重组发生在哪两个基因之间, 这样重组率的计算就显得更为方便了(表 7-3)。
表 7-3 三点试验中, 重组率的计算 ( +ec+/sc+cv \times sc\ ec\ cv/Y )
| 表型 | 实得数 | 比例 | 重组发生在 | ||||
| sc—ec | ec—cv | sc—cv | |||||
| + | ec | + | 810 | 82.7% | |||
| sc | + | cv | 828 | ||||
| sc | ec | + | 62 | 7.6% | √ | √ | |
| + | + | cv | 88 | ||||
| sc | + | + | 89 | 9.7% | √ | √ | |
| + | ec | cv | 103 | ||||
| 合计 | 1980 | 100% | 7.6% | 9.7% | 17.3% | ||
在上面这个试验中,测交后代中只有6种表型,因此重组率之间的关系比较简单。在多数三点试验中,回交后代可以有8种表型,现在试举一例说明。
这次3个基因是ec(棘眼),ct(cut,截翅)和cv(横脉缺失)。把棘眼、截翅个体与横脉缺失个体交配,得到三杂合子 $(ec\ ct+/++cv)$ 。三杂合雌蝇与三隐性雄蝇 $(ec\ ct\ cv/Y)$ 测交,测交后代有8种表型(表7-4)。
表 7-4 三点试验中, 重组率的计算 (ec ct+/++cv × ec ct cv/Y)
| 表型 | 实得数 | 比例 | 重组发生在 | ||||
| ec—ct | ec—cv | ct—cv | |||||
| ec+ | ct+ | + | 2 125 | 81.5% | |||
| cv | 2 207 | ||||||
| ec+ | + | cv | 273 | 10.1% | √ | √ | |
| ct | + | 265 | |||||
| ec+ | + | + | 217 | 8.3% | √ | √ | |
| ct | cv | 223 | |||||
| +ec | + | + | 5 | 0.1% | √ | √ | |
| ct | cv | 3 | |||||
| 合计 | 5 318 | 100% | 18.4% | 10.2% | 8.4% | ||
图 7-13 果蝇 X 染色体上 ec, cv, ct 3 个基因的图距
ec—ct 的重组率并不刚好等于另外两个重组率之和。
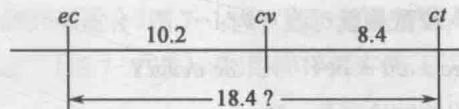
所得的后代数据(表7-4)当然不符合孟德尔的3对基因独立分配的测交比例。我们仍旧用上
面讲过的方法,每次只注意两个基因对间的重组,而把第三个基因对暂时忘掉。先看 $ec-ct$ 的重组率, $ec+$ 和 $+ct$ 是重组的个体,重组率是 $10.1%+8.3%=18.4%$ 。用同样方法,计算 $ec-cv$ 的重组率, $ec cv$ 和 $++$ 是重组子,重组率是 $10.1%+0.1%=10.2%$ 。最后计算 $ct-cv$ 的重组率, $ct cv$ 和 $++$ 是重组子,重组率是 $8.3%+0.1%=8.4%$ 。然而 $ec-cv$ 的重组率( $10.2%$ )和 $ct-cv$ 的重组率( $8.4%$ )加起来,等于 $18.6%$ ,比 $ec-ct$ 的重组率( $18.4%$ )大(图 7-13),这是什么缘故呢?
我们注意到,有8只果蝇(+++和ec ct cv),计算时用过两次,计算ec—cv的重组率时用到它,计算cv—ct的重组率时又用到它,可是计算ec—ct的重组率时却没有把它计算在内,而实际上染色体在ec—ct间已有过两次交换。现在我们看图7-14,对ec—ct来讲,双交换的结果对它们来说等于不交换。只有当基因对cv/+存在时,我们才能认出双交换。所以如有双交换的存在,在计算ec—ct间的距离时,一定要加上两倍的双交换数 (2\times 0.1%) ,即 18.4% +2\times 0.1% = 18.6% 。因为每个双交换包括ec—ct间发生的两次单交换,而这两次单交换是在计算ec—ct间的重组率时所没有估计在内的。
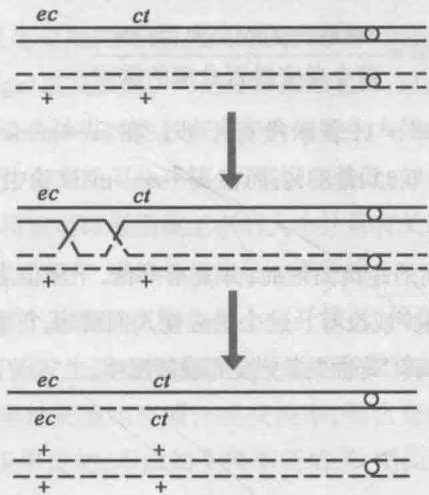
三点试验使我们有可能觉察两边两个基因对间的双交换。三点试验中,两边两个基因对间的重组率一定等于另外两个重组率之和减去两倍的双交换率。在我们这个例子中,ec—ct 间的重组率是:
1 | 10.2\% + 8.4\% - 2 \times 0.1\% = 18.4\% |
这个法则就叫作基因直线排列定律,是斯特蒂文特在1913年最初确立的。
在任何三点试验中,在测交后代的8种可能的表型中,个体数最少(甚至完全没有)的两种表型是双交换的产物。根据这一点,不必计算重组率,一眼就能正确无误地断定这3个基因的次序。例如在上面这个例子中,三杂合亲本的基因型是 $(ecct + / + + cv)$ ,而三隐性个体的基因型是 $(ecctcv / Y)$ ,这儿基因型外面加上括号,表示基因在染色体上的相对顺序不明。现在从表7-4知道,表型 $+++$ 和 $ecctcv$ 个体数目最少,应是双交换产物。由此可以推论,基因 $cv$ 一定位于中间,而
3 基因的相对顺序是 ec cv ct, 这样, 交配型就可改写为:
1 | e c + c t / + c v + \times e c c v c t / Y |
这自然跟我们在上面已经得出的结论完全一致。
用三点试验(或多点试验)来判断基因的顺序是很可靠的,但是得到三杂合子不很容易,所以常常要根据3次两点试验来判断3个基因的相对顺序,因为重组率最大的两个基因总应该位于两边。可是前面讲过,同样两个基因对间的重组率在不同实验中可能有些波动,因此当3点中有两点相当“接近”时,重组值很小,例如小于3%时,根据3次两点试验判断3个基因的顺序,就不是那么可信了。
我们已经看到,双交换频率很低,这就是说,在三点试验中,中间一个基因跟它两旁的两个基因同时分开的机会很小。如果两个基因对间的单交换并不影响邻近两个基因对间的单交换,我们预期双交换的频率就是两个单交换频率的乘积,可是实际上观察到的双交换频率往往低于预期值。例如在 $ec - cv - ct$ 试验中, $ec - cv$ 间的重组率是 $10.2%$ , $cv - ct$ 间的重组率是 $8.3%$ ,如果一次交换不影响它的邻近再发生一次交换,那么这3点之间发生双交换的概率应该是 10.2% \times 8.4% = 0.86% ,但实验所得到的双交换只有 $(5 + 3) / 5318 = 0.15%$ ,可见每发生一次单交换时,它的邻近也发生一次交换的机会要减少一些,这种现象叫作干涉(interference)。像 $sc - ec - cv$ 试验中,预期双交换频率是 7.6% \times 9.7% = 0.74% ,但实验中一个双交换个体也没有,所以“干扰”是完全的。一般用并发率(coincidence)来表示干涉的大小,公式如下:
$$
\mathrm{并发率} = \frac {\mathrm{观察到的双交换百分率}}{\mathrm{两个单交换百分率的乘积}}
$$
并发率愈大,干涉愈小;并发率=1,表示没有干涉。在ec—cv—ct的试验中,并发率=0.15%/0.86%=0.17,干涉=1-0.17=0.83或83%;而在sc—ec—cv试验中,并发率=0/0.74%=0,干涉=1-0=100%。
从一般实验结果来看,基因对间的距离缩短时,并发率降低,干涉值上升。所以3基因间发生交换的距离短时,双交换的发生很少或没有。这个效应使人们猜想,可能染色单体有某种物理学上的韧性,可在某一距离范围内妨碍“弯曲”或交换的重复发生。
六、连锁图
根据基因在染色体上直线排列的定律,我们可以把每个连锁群画成一个连锁图(linkage map),或称遗传学图(genetic map)。这种图是大量实验材料的简明总结,是以后实验工作和育种工作的重要参考资料。
已知一对染色体上有几个基因时,利用三点试验可以测定基因在染色体上的次序和它们相互之间的距离。基因在染色体上的相对距离由重组率决定,把重组率去掉%后作为图距。例如sc—ec—cv的试验中,sc—ec间的重组率是7.6%,图距即为7.6,ec—cv间的重组率是9.7%,图距即为9.7。在有些材料中或某些基因对间有时不能进行三点试验,不易得到三隐性个体或双隐性个体,那也可以根据3个两点试验,分别求得重组率,并决定有关基因的次序。
例如在玉米中,花青素基因(a)、棕色中脉基因(bm)和易碎胚乳基因(bt)都在第5连锁群上,a和bm间的重组值是6%,a和bt间的重组率是7%。单是这样的资料,还不能把3个基因画在连锁群上,因为有两种排列都适合(图7-15Ⅰ、Ⅱ)。可是知道bm和bt间的重组值是1%后,a—bm—bt的次序就可确立了(图7-15Ⅲ)。利用同样的方法,还可把其他基因放上去,这样就作成了遗传学图(图7-16)。
关于遗传学图,还要补充说明几点:①基因在遗传学图上有一定的位置,这个位置叫作基因座(locus)。一般以最先端的基因位置为0,但随着研究进展,发现有基因在更先端的位置时,把0点让给新的基因,其余的基因位置作相应的移动。②重组率在0到50%之间,但在遗传学图上,可以出现50单位以上的图距。例如玉米第1连锁群上,sr与 $bm_{2}$ 间的图距是172,但实际上sr与 $bm_{2}$ 间的重组率不超过50%,这是因为这两基因间发生了多次交换的关系,所以由实验得到的重组率与遗传图上的数值不一定是一致的。遗传图上数值对应的基因间的重组率只限于邻近的基因座间。
七、重组率与交换率
对于重组率与交换率的关系,要多说几句。重组率或重组值是指双杂合子测交产生的重组型配子的比例,即
1 | \mathrm{重组率} = \frac {\mathrm{重组配子数}}{\mathrm{总配子数(亲组合+重组合)}} \times 100 |
上面已说明,重组是交换的结果,所以重组率(recombination fraction)通常也称作交换率(crossing over percentage)或交换值。可是仔细推敲起来,这两个数值是不尽相同的。
如果我们假定,沿染色体纵长的各点上交换的发生大体上是随机的。那么可以这样认为,如果两个基因座相距很近,由交换而分开较少,重组率就低;如果两基因座离开很远,交换发生的次数较多,重组率就高。所以可以根据重组率的大小计算有关基因间的相对距离,把基因顺序地排列在染色体上,绘制出基因图。遗传学家就是这样做的。
可是如果有关的两个基因座在染色体上分开较远,例如重组率在 $12% \sim 15%$ 以上,那么进行杂交试验时,其间可能发生双交换或四交换等更高数目的偶数交换,形成的配子却仍然是非重组型的。这时如简单地把重组率看作是交换率,那么交换率就要被低估了。因为遗传图是以 $1%$ 交换率作为图距单位的,所以如交换率低估了,图距自然也随之缩小了,这就需要校正。校正的公式较多,可根据自己得出的连锁与交换试验的结果,提出专用适用于某一生物的校正公式。一般来说,一个合适的校正公式应该满足下列两个条件:①最大的重组率不超过0.5或 $50%$ ,因为这数值说明两个基因之间遵循自由组合;②较小的重组率应该大致上是加性的。现在常用的较简单的公式是霍尔丹(John Burdon Sanderson Haldane,1892—1964)推导的作图函数:
$$
R = \frac {1}{2} (1 - e ^ {- 2 x})
$$
式中,R 代表重组率,x 代表交换率,e 是自然对数的底。该式表示重组率与图距的关系,而图距的单位是 1% 交换率。
现在来说明一下 Haldane 曲线(图 7-17)的几点性质:
① 曲线的起始一小段基本上是直线, 斜率接近于 1, 重组率可以直接看作是图距, 所以重组
I
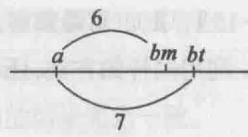
II
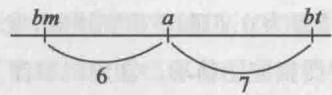
Ⅲ
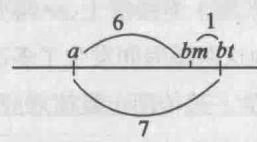
1 | arrayc c c c c c c c c c c c c c c c 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 1 0 |
| 基因符号 | 名称 | 基因符号 | 名称 | 基因符号 | 名称 |
|---|---|---|---|---|---|
| sr | 条纹叶 | Ga | 配子体因子 | bd | 果穗分叉无花丝 |
| p | 果皮颜色 | su | 糖质胚乳 | ms | 雄性不育 |
| as | 不联会 | zb | 斑状条纹 | j | 日本型条斑 |
| br | 短节植株 | a | 花青素 | mn | 小型 |
| gl | 发光幼苗 | bt | 易碎胚乳 | Dt | 斑点 |
| bm | 褐色中脉 | Pr | 紫糊粉层 | C | 有色糊粉层 |
| ws | 白色叶鞘 | v | 嫩绿苗 | sh | 凹陷胚乳 |
| ts | 雄花序结籽 | po | 多次有丝分裂 | wx | 糯质胚乳 |
| Ch | 褐色果皮 | Y | 黄胚乳 | Rp | 抗锈病 |
| cr | 皱缩叶 | pl | 紫色植株 | du | 黯色胚乳 |
| rt | 无次生根 | py | 矮小植株 | R | 花青素 |
| ba | 不孕杆 | Hs | 多毛叶鞘 | I | 金黄色苗 |
| A | 花青素 | ra | 分叉果穗 | ||
| ga | 配子体因子 | ij | 埃型条班 | ||
| de | 缺陷种子 | Bn | 褐糊粉层 |
图 7-16 玉米 10 个连锁群的遗传学图
仅标出已正确定位的基因中的一部分,圆形黑点表示着丝粒。连锁群上的数字是图距单位,遗传学上最先端的一个基因为零点,由此算起,依次累加。只有第9连锁群上的零点同时也是细胞学上的零点。
图7-17 重组率与图距的关系
纵轴是 R,代表重组率;横轴是 100x,代表图距,x 是交换率。
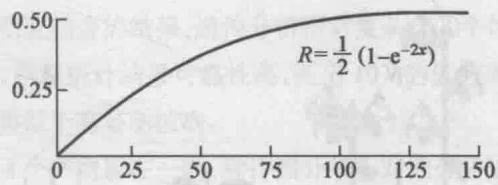
率是加性的。
② 在曲线的曲度较大的区域,重组率就不是加性的了。当图距比较大,两端的基因的重组率就要小于
相邻两个重组率之和,即 $R_{ab} + R_{bc} > R_{ac}$ ,例如 $a, b, c$ 是3个连锁基因,两两间的重组率 $R$ 如下:
1 | arrayc c ca&b |
请注意,R 值是非加性的,0.23+0.32>0.40。现在把 Haldane 公式加以改写:
1 | x = - 12 (1 - 2 R) |
把上面 R 值代入公式, 我们可以求得 3 个连锁基因间的 x 值如下:
1 | arrayc c 0. 3 1& |
现在 $0.31+0.51$ 稍大于 0.81, x 值大致上恢复成为加性的了。
③ 标记基因间的图距很大时,重组率与图距无关,接近或等于1/2。
所以重组率大致代表交换率,但当重组率逐渐增大时,重组率往往小于交换率,需要加以校正。在实际应用时,还要看研究的生物而定。像黑腹果蝇那样,各染色体上定位的基因已经很多,标记的区域已划分得很细,就无需用作图函数来校正了。但对一种新的生物开始进行连锁研究,可供利用的标记基因很少,这时最好用作图函数来加以校正,以得到更接近实际的图距。
八、孟德尔研究过的7对基因位于7对不同染色体上吗
研究遗传学问题也像研究其他自然科学问题一样,大都是从众多类似现象中抽出若干现象加以观察,归纳出一般规律,然后从这规律出发,演绎说明其他类似现象。孟德尔就是用这种方法研究了豌豆的7种单因子杂种的分离方式,在这基础上进而研究了两因子杂种和三因子杂种的分离方式。结果他得出结论说,一对因子的分离与另一对因子的分离是独立的,两者是自由组合的。这样的结论在相当一段时期内被认为是孟德尔研究过7对基因分别位于7对不同染色体上的证据。鉴于豌豆的单倍染色体数也恰好是7,理所当然地会产生这样的问题:事情真有这样的巧合吗?
如图 7-18 所示, 豌豆的单倍染色体组中共含有 7 条染色体, 现在知道孟德尔遗传研究所利用的 7 对相对性状的决定基因分别定位在 6 条染色体上。子叶黄绿基因 (I/i) 定位于第 I 染色体, 花冠红白基因 (A/a) 定位于第 II 染色体, 植株高矮基因 (Le/le) 定位于第 III 染色体, 豆粒满皱基因 (R/r) 和未熟豆荚绿黄基因 (Gp/gp) 定位于第 V 染色体。此外, Fas/fas (第 III 染色体) 和 Fa/fa (第 IV 染色体) 两对基因均能控制花腋生或顶生, 而 P/p (第 VI 染色体) 和 V/v (第 III 染色体) 两对基因均能控制成熟豆荚是否分节, 孟德尔研究所用的豌豆品系到底对应哪对基因差异暂不能确定。
我们知道孟德尔的两因子杂种研究的是豆粒满皱基因 $(R/r)$ 和子叶黄绿基因 $(I/i)$ 这两对基因的分离,而三因子杂种研究的是豆粒满皱基因 $(R/r)$ 、子叶黄绿基因 $(I/i)$ 和花冠红白基因 $(A/a)$
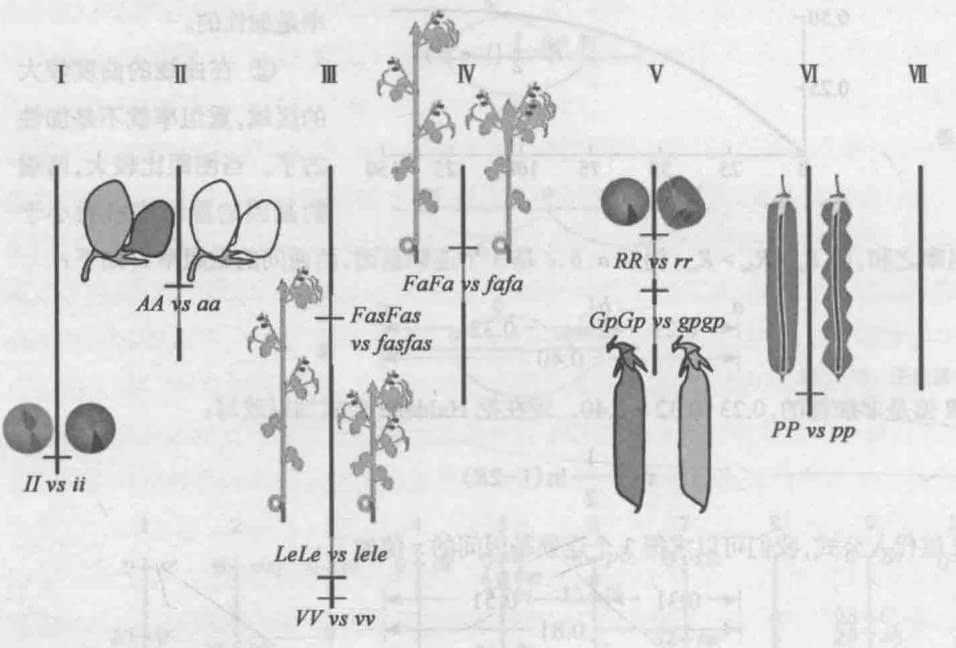
图中标出了孟德尔研究的7对相对性状以及这些性状决定基因所在的染色体位置。
这3对基因的分离。结果发现, $\mathbf{F}_2$ 分离数据均符合自由组合的原则。乍看之下,这和连锁定律揭示的某些基因之间相互连锁的规律有矛盾,但实际并非如此。不难发现,豆粒满皱基因 $(R / r)$ 、子叶黄绿基因 $(I / i)$ 和花冠红白基因 $(A / a)$ 这3对基因恰巧分别位于3对不同的染色体上,因此,它们之间的确可以自由组合。
那么,我们不禁好奇,孟德尔是否有研究过其他的两因子杂种呢,比如豆粒满皱和未熟豆荚绿黄这两对性状,它们的决定基因(R/r 和 Gp/gp)均位于第 V 染色体,且距离较近,可能存在一定的连锁。如果用这两个相对性状做两因子杂交实验,我们推测所得数据将与自由组合的理论比例有明显差异。
那时孟德尔会不会碰到不符合自由组合的比例,而又没有想到连锁,从而把难以解释的资料弃置一旁呢?这是一个疑案。但鉴于他的论文上有这样一句话:“用豆粒性状进行试验,可以最简单和最正确地达到试验目的”,所以我们猜测他可能没有做过植株高矮和豆荚形状这种较复杂的两因子杂种分离试验。他可能单是根据已做过的一些两因子杂种和三因子杂种的分离试验,对所得的结果加以归纳,推而广之,演绎地认为所有7对基因间都是自由组合的。不过不论怎样,孟德尔从两因子和三因子杂交试验归纳出来的自由组合原则在一定范围内(请读者想一想,这范围指什么?)是正确的,是经得起考验的。
视频9孟德尔工作的质疑
第二节 真菌类的连锁分析
粗糙链孢霉(Neurospora crassa)属于真菌类中的子囊菌(Ascomycetes),它是遗传分析的又一种好材料,这是因为:①它是单倍体,没有显隐性的复杂问题,基因型直接在表型上反映出来。②一个小囊中的孢子是一次减数分裂的产物,易于分析配子比例。二倍体合子是两个不同减数分裂产生的配子相互结合的结果,遗传分析相对复杂。③个体小,长得快,易于培养,一次杂交可以产生大量后代,所以统计结果可靠性高,低至 $10^{-8}$ 的低频率也可测出。④进行有性生殖,染色体的结构和功能类似于高等动植物。
单一减数分裂的4个产物留在一起,称作四分子。对四分子进行遗传学分析,称作四分子分析(tetrad analysis)。粗糙链孢霉的减数分裂的4个产物不仅留在一起,而且以直线方式排列在子囊中,这种顺序四分子(ordered tetrad)在遗传学分析上有很多好处:①这是遗传学分析的好材料,可以简单明了地看出分离比和计算重组率。②可以把着丝粒作为一个基因座,计算某一基因与着丝粒的重组率。③子囊中子囊孢子的正确对称性质,证明减数分裂是一个交互过程。④可以检验染色单体的交换有无干涉现象,而且还可用它来进行基因转变(gene conversion)的研究。关于基因转换在以后讨论。⑤四线分析(4-strand analysis)证明,每一交换只包括四线中的两线,但多重交换可以包括两线、三线或四线。
一、着丝粒作图
从野外采集的粗糙链孢霉能在简单的、成分清楚的培养基上生长和繁殖,一般称之为野生型或原养型(prototroph)。在实验室中得到的某一粗糙链孢霉菌株,一定要在培养基中添加某一营养物质才能生长,一般称之为营养缺陷型(auxotroph)。例如有一菌株一定要在培养基中添加赖氨酸才能生长,一般就称之为赖氨酸依赖型(lysine dependent)或赖氨酸缺陷型(lysine deficient)。
现在用一实验说明着丝粒作图(centromere mapping)。如把赖氨酸缺陷型(记作 $lys^{-}$ 或 -)与野生型(记作 $lys^{+}$ 或 +)杂交,则所得子囊中的孢子,分离为4个黑的(+)与4个灰的(-)。野生型的子囊孢子成熟后是黑色的,但赖氨酸缺陷型的成熟较迟,所以灰色。根据黑色孢子和灰色孢子在子囊中的排列次序,共有6种子囊型:
1 | \text { 非交换型 } \left\{ \begin{array}{l l} (1) + + - - \\ (2) - - + + \end{array} \right. |
1 | \text {交换型} \left\{ \begin{array}{l l} (3) + - + - \\ (4) - + - + \\ (5) + - - + \\ (6) - + + - \end{array} \right. |
这儿,我们为了方便起见,只写下4个孢子对,而不把8个孢子的基因型都写出来。
我们顺便要提一提,(1)和(2)互为镜像,同样,(3)和(4)、(5)和(6)也互为镜像,说明减数分裂是一个交互过程。
那么子囊型(1)和(2)是怎样产生的呢?从图7-19可以看到,减数分裂I(此处简写为 $\mathbf{M}_1$ )时,带有 $lys^{+}$ 的两染色单体移向一极,而带有 $lys^{-}$ 的两染色单体移向另一极。这样,就 $lys^{+}/lys^{-}$ 这一基因对而言,在 $\mathbf{M}_1$ 时就分离了,所以子囊型(1)和(2)属于第一次分裂分离(first division segregation)。减数分裂II(此处简写为 $\mathbf{M}_2$ )时,每一染色单体相互分开,所以在每一子囊中两个 $lys^{+}$ 的孢子排列在一起,两个 $lys^{-}$ 的孢子排列在一起。再经过一次有丝分裂(此处简写为M),最后形成4个孢子对,排列顺序是 $++ - -$ 或 $- - + +$ 。因为在形成这两种子囊型时,在着丝粒和基因
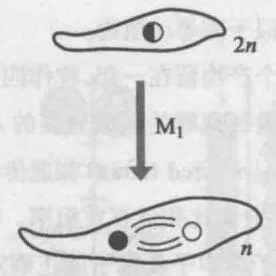
$lys^{+}$ 和 $lys^{-}$ 在后期Ⅰ时分离,此时带有 $lys^{+}$ 的两染色单体分向一极,带有 $lys^{-}$ 的两染色单体分向另一极。 $M_{1}$ 时,双价体在赤道板上正常排列并发生规则分离。同源染色体间至少应有一个交叉,现在假定交叉不发生在 $lys^{+}/lys^{-}$ 与着丝粒间,两个 $lys^{+}$ 连在同一着丝粒上,在后期Ⅰ时,一起移向一极,另外两个 $lys^{-}$ 也一样,所以只产生子囊型(1)或(2),都是非交换型。
对 $lys^{+}/lys^{-}$ 间未发生过交换, 所以称为非交换型。
至于子囊型(3)和(4)的形成经过,可看图7-20。由于前期I在着丝粒和 $lys^{+}/lys^{-}$ 之间有交叉,造成包括 $lys^{+}/lys^{-}$ 在内的染色区段的互换,在 $M_{1}$ 时,分到每一子核的两染色单体都是一个带有 $lys^{+}$ ,一个带有 $lys^{-}$ ,所以 $M_{1}$ 时没有出现分离现象。到 $M_{2}$ 时,带有 $lys^{+}$ 的染色单体才和带有 $lys^{-}$ 的染色单体相互分开。再经过一次M,最后形成4个孢子对,排列顺序是+–+(或-+-+)。所以就 $lys^{+}/lys^{-}$ 这一基因对来说,到 $M_{2}$ 时才出现分离现象,所以子囊型(3)和(4)属于第二次分裂分离(second division segregation)。因为这种情况是由于 $lys^{+}/lys^{-}$ 与着丝粒间发生一个交换造成的,所以子囊型(3)和(4)是交换型。
还有(5)和(6)这两个交换型,也可以根据上面的图解画出来,我们在这里不再重复说明,由读者自己去画,作为练习。
因为有交换型出现,表明交换发生在两条非姐妹染色单体间。
在(3)~(6)的4种子囊型中,只有两对孢子交换位置,其余两对孢子维持原位。例如在交换型(3)中,如果说第2孢子对跟第3孢子对交换了位置,那么第1和第4两个孢子对维持原位。也就是说,每发生一个交叉,一个子囊中有半数孢子发生重组。所以在粗糙链孢霉中,着丝粒与有关基因的重组率可依下式计算:
1 | \mathrm{基因与着丝粒的重组率} = (\frac {\mathrm{交换型子囊数}}{\mathrm{交换型子囊数} + \mathrm{非交换型子囊数}}) \times 100\% \times \frac {1}{2} |
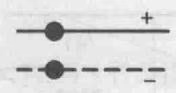
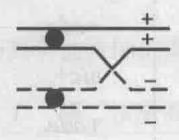
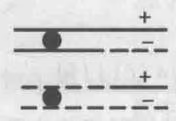
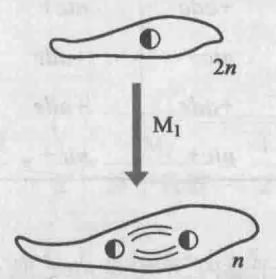
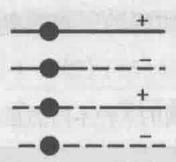
$lys^{+}$ 和 $lys^{-}$ 在后期Ⅱ时才分离,这时带有 $lys^{+}$ 的染色单体分向一极,而带有 $lys^{-}$ 的染色单体分向另一极。交叉发生在 $lys^{+}/lys^{-}$ 与着丝粒之间,所以子囊型(3)或(4)是交换型。
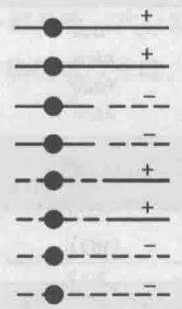
例如有 9 个子囊对 lys 基因是非交换型, 有 5 个子囊对 lys 基因是交换型, 那么交换型子囊的百分比是
1 | \frac {5}{9 + 5} \times 100 \% = 36 \% |
lys 与着丝粒间的重组率即为
1 | 36 \% \times \frac {1}{2} = 18 \% |
换句话说,lys 与着丝粒间的图距是 18,这就是着丝粒作图。
二、粗糙链孢霉的连锁
着丝粒作图也可跟常规基因作图一起进行。例如有这样一个杂交, nic+ \times + ade ,这儿 nic 是烟酸依赖型,要在培养基中添加烟酸才能生长,ade 是腺嘌呤依赖型,要在培养基中添加腺嘌呤才能生长。上面已讲过,一对基因杂交,有 6 种不同的子囊型,两对基因杂交,有 6 \times 6 = 36 种不同的子囊型。但是,我们可以忽略半个子囊内的基因型次序,如子囊型(5)(表 7-5)实际代表了以下 4 种子囊类型:
| (1) | (2) | (3) | (4) |
|---|---|---|---|
| +ade | nic+ | +ade | nic+ |
| nic+ | +ade | nic+ | +ade |
| +ade | +ade | nic+ | nic+ |
| nic+ | nic+ | +ade | +ade |
这是因为,在半个子囊内,不论是 nic+ 孢子对在“上面”,+ade 孢子对在“下面”,还是 +ade 孢子对在“上面”,nic+ 孢子对在“下面”,不过反映了着丝粒的随机趋向而已,所以可把 36 种不同的子囊型归纳为 7 种基本子囊型。现在把 7 种子囊型和实得的子囊数列于表 7-5。
表 7-5 nic + \times + ade 得到的 7 种不同的基本子囊型和相应的子囊数
| 子囊型 | (1) | (2) | (3) | (4) | (5) | (6) | (7) |
| 基因型次序 | +ade | ++ | ++ | +ade | +ade | ++ | ++ |
| +ade | ++ | +ade | nic ade | nic+ | nic ade | nic ade | |
| nic+ | nic ade | nic+ | ++ | +ade | ++ | +ade | |
| nic+ | nic ade | nic ade | nic+ | nic+ | nic ade | nic+ | |
| 分离发生的时期 | $M_1M_1$ | $M_1M_1$ | $M_1M_2$ | $M_2M_1$ | $M_2M_2$ | $M_2M_2$ | $M_2M_2$ |
| 子囊型分类 | (PD) | (NPD) | (T) | (T) | (PD) | (NPD) | (T) |
| 实得子囊数 | 808 | 1 | 90 | 5 | 90 | 1 | 5 |
考虑到各型子囊的起源(图 7-21),还有另一种分类:
① 亲二型(parental ditype, PD), 它们只有两种基因型, 而且跟亲代一样。包括子囊型(1)和(5)。
② 非亲二型(non-parental ditype, NPD), 有两种基因型, 都跟亲代不一样, 是重组型。包括
(1)
1 | \mathrm{PD} (+ a d e + a d e n i c + n i c +)\tag{2} |
1 | \mathrm{NPD} \left(+ + + + n i c a d e n i c a d e\right)\tag{3} |
1 | \mathrm{T} \left(+ + + a d e n i c + n i c a d e\right)\tag{4} |
1 | \mathrm{T} (+ a d e n i c a d e + + n i c +)\tag{5} |
1 | \mathrm{PD} (+ a d e n i c + + a d e n i c +)\tag{6} |
1 | \mathrm{NPD} \left(+ + n i c a d e + + n i c a d e\right)\tag{7} |
$$
\mathrm{T} \left(+ + n i c a d e + a d e n i c +\right)
$$
图7-21 顺序四分子的重组子囊中孢子对的排列
子囊型(2)和(6)。
③ 四型(tetratype, T), 有 4 种基因型, 两种基因型跟亲代一样, 两种基因型跟亲代不一样, 包括(3)、(4)和(7)。
我们先计算 nic 与其着丝粒间的重组率:
1 | \begin{aligned} \frac{\text{交换型子囊数}}{\text{总子囊数}} & \times \frac{1}{2} = \frac{\text{第二次分裂分离子囊数}}{\text{总子囊数}} \\ & \times \frac{1}{2} = \frac{\mathrm{M}_{2}}{\text{总子囊数}} \\ & = \frac{(4) + (5) + (6) + (7)}{\text{总子囊数}} \\ & \times \frac{1}{2} = \frac{5 + 90 + 1 + 5}{1000} \\ & \times \frac{1}{2} = 5.05\% \end{aligned} |
再计算 ade 与其着丝粒间的重组率:
1 | \frac {\mathrm{M} _ {2}}{\text {总子囊数}} \times \frac {1}{2} = \frac {(3) + (5) + (6) + (7)}{\text {总子囊数}} \times \frac {1}{2} = \frac {9 0 + 9 0 + 1 + 5}{1 0 0 0} \times \frac {1}{2} = 9.30 |
算出上述两个重组率后,还有3种可能性要考虑(图7-22)。在1000个子囊中,有808个是亲二型,+/nic和+/ade都是第一次分裂分离 $(\mathbf{M}_1\mathbf{M}_1)$ ,而重组型数目偏少,所以这两基因对不可能是自由组合,第一种可能性可以排除。那么第二种连锁关系有无可能呢?我们把资料用另一种方式排列,得表7-6。
表 7-6 粗糙链孢霉的 nic+×+ade 的分离资料 (按照分离时期来排列)
1 | \begin{array}{c c c} \text { nic } & \text { ade } \\ 5. 0 5 & 9. 3 0 \\ \text { nic } & \text { ade } \\ 5. 0 5 & 9. 3 0 \\ \text { nic } & \text { ade } \\ 5. 0 5 & 9. 3 0 \end{array} |
(1) 无连锁, 位于两条不同的染色体上
(2) 有连锁, 位于一条染色体的着丝粒的两侧
(3) 有连锁, 位于一条染色体的着丝粒的一侧
图 7-22 着丝粒, nic/+ 和 ade/+ 间的 3 种连锁可能性
| +/nic | +/ade | 子囊数 |
| $M_1$ | $M_1$ | 809 |
| $M_1$ | $M_2$ | 90 |
| $M_2$ | $M_1$ | 5 |
| $M_2$ | $M_2$ | 96 |
| 1 000 | ||
从表中看到, 着丝粒—nic(·—nic)间不发生交换而着丝粒—ade(·—ade)间发生交换 $\left(\mathrm{M}{1}\mathrm{M}{2}\right)$ 的子囊数是90/1 000, ·—ade间不发生交换而·—nic间发生交换 $\left(\mathrm{M}{2}\mathrm{M}{1}\right)$ 的子囊数是5/1 000, 两子囊数相差悬殊, 两者之比为 $\frac{90}{1\ 000}:\frac{5}{1\ 000}=18:1$ , 远远超过两重组率之比9.30%:5.05%=1.84:1。这表明, ·—nic间的交换与·—ade间交换不是相互独立的, 而是密切相关的, 所以认为nic与ade在着丝粒两侧的第二种可能性也可排除。
又从表 7-6 可以看到,·—nic 间发生交换时,大部分时间在·—ade 间也发生交换,101 次中
有96次,那就是说,同一交换使+/nic在 $M_{2}$ 分离,也使+/ade在 $M_{2}$ 分离,这是强有力的证据,证明是第三种的连锁关系,即nic与ade位于着丝粒的同一侧(图7-23)。
nic/+ 和 ade/+ 位于着丝粒的一侧。着丝粒—nic 的一个交换,也是着丝粒—ade 间的一个交换。
已经确定第三种可能性是正确的,我们就可以计算 nic 和 ade 间的重组率。可是简单地求两重组率之差,即将 9.30% 减去 5.05%,并不能得出正确的数值,它的理由我们已在果蝇的三点试验中说明过。
我们求·—ade 间的重组率时, 是把所有第二次分裂分离型的子囊数加起来, 除以二倍的总子囊数。这种计算方法会将少量在·—ade 间发生交换的子囊遗漏。例如子囊型(4)对 +/ade 来讲, 是第一次分裂分离, 但是我们确定了·—nic—ade 顺序后, 知道这些子囊中发生了二线双交换(图 7-24), 可是在计算·—ade 间的重组率时, 并没有把这两次单交换计算在内, 因而使·—ade 间重组率的估计偏低。
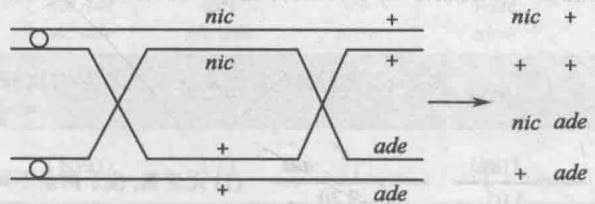
子囊型(4)对 $+ / ade$ 来说是在 $\mathbf{M}_1$ 分离,但同时考虑 $+ / nic$ 时,知道在这些子囊中实际发生了二线双交换。
从图 7-21 可以看到, 非亲二型 (NPD) 子囊中, 4 个孢子对全部都是重组基因型, 而四型 (T) 子囊中, 有一半孢子对是重组基因型, 所以我们计算 nic—ade 间的重组率可用公式:
1 | \text{重组率} = \frac {\mathrm{NPD} + \frac {1}{2} \mathrm{T}}{\text{总子囊数}} = \frac {(1 + 1) + \frac {1}{2} (90 + 5 + 5)}{1000} = 5.2\% |
现在我们可以画出最正确的遗传学图,如图 7-25 所示。
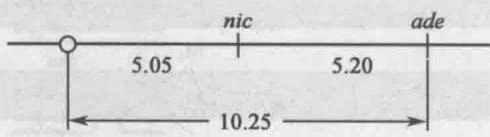
三、染色单体干涉
上面已提到了,应用四分子分析也可以检验染色单体的交换有无干涉现象。详细地说,在两非姐妹染色单体间发生一个交换后,会不会影响相同两染色单体间发生第二次交换的出现概率。要了解这个问题,最好的办法是要知道第一个交换发生在两非姐妹染色单体间后,第二个交换发生在任意两非姐妹染色单体间是不是随机的,如图7-26所示。
如第二个交换发生在任意两个非姐妹染色单体间的机会是相等的,那么二线双交换:三线双交换:四线双交换之比应该是1:2:1(图7-26)。如果实得比例与理论比例有明显偏差,我
图 7-26 染色单体交换的干涉现象
图示第一个交换的发生固定后(2-3交换),第二个交换发生在任意两非姐妹染色单体间的4种可能性。这4种可能性都可在子囊基因型上区分开来。
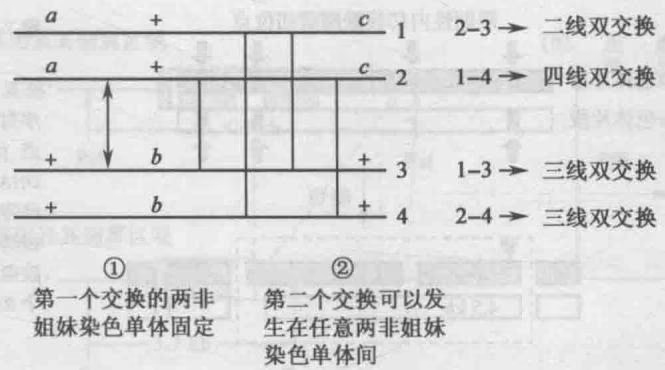
们可以认为有染色单体干涉(chromatid interference)。
第三节 人类孟德尔遗传病的连锁分析
上文中我们利用模式生物介绍了不同基因对之间的连锁关系,以及如何利用连锁分析计算不同基因对之间的遗传距离的方法。在对模式生物进行研究时,我们常采用性状标记(如果蝇复眼的颜色、粗糙链孢霉的营养缺陷型等)来进行连锁分析,通过人为设计的杂交方案进行杂交,分析后代表型。但是,对于人类而言,一方面,我们不能采用指定婚配的方法,而且可供追踪的家系的数目和大小也非常有限,另一方面,人类有23对染色体,已知的性状标记在基因组中的覆盖度极低,很难仅利用它们实现人类的连锁分析。随着分子生物学技术的发展,许多分子水平的遗传标记被开发出来,极大地拓展了遗传标记的数量,被广泛应用到了人类连锁分析中。我们在这一节先简单介绍一种遗传标记,其他标记将在基因组一章中作详细介绍,再和读者们讨论如何利用分子遗传标记进行连锁分析。
一、限制性片段长度多态性
限制性片段长度多态性(restriction fragment length polymorphism, RFLP)是第一代分子遗传标记。前面章节中我们曾介绍过,限制性内切酶是一种能够在特定DNA序列上切割DNA分子的酶类,经它处理之后,一条DNA链可以被消化成为特异大小的限制性片段。在人类基因组中有很多无明显表型效应的碱基变化,这些变化有时可以产生新的限制性酶切位点,或者使原来存在的酶切位点发生丢失。新酶切位点的出现可使限制性片段(restriction fragment, RF)的长度缩短,而旧酶切位点的丢失可使限制性片段长度增大。这样一来,在不同个体的同一基因间或者同一个体的两个等位基因间会出现某一限制性内切酶产生的片段长度的不同,也就是出现了RFLP(图7-27)。需要指出的是,RFLP不是一种新的变异形式,而是碱基顺序改变的结果,由于碱基变异形成了不同长度的RF,可以根据RF长度大小来表示不同形式的等位基因。
和传统的遗传标记不同,RFLP是DNA水平的遗传标记,与基因的表达和表型的实现无关,因此无表型效应,更不受环境条件和发育阶段的影响。更重要的是,RFLP遵循共显性的遗传方式,可以很容易地区分杂合子和纯合子,通过成熟的基因型分型技术如Southern印迹准确地
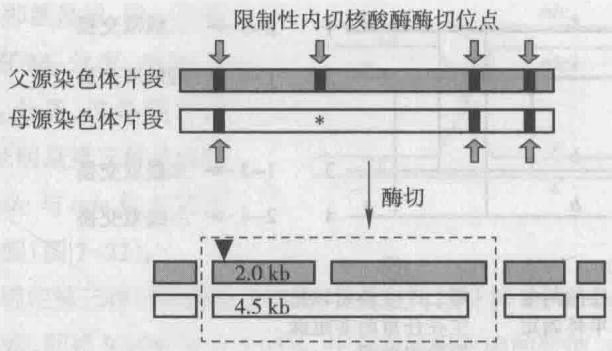
在某个体的一条染色体片段上,来自父亲的 DNA 序列中存在 4 个特定限制性内切核酸酶酶切位点,而来自于母亲的 DNA 序列在 * 处与父源 DNA 序列有差异,造成了一个酶切位点的丢失。经酶切后得到的 RF 数目不同,大小亦不相同(虚线框内)。▼ 指示的是探针位置,酶切后通过凝胶电泳和 Southern 印迹可以鉴定该个体在这个 RFLP 标记上为 2.0 kb/4.5 kb 的杂合子。
进行 RFLP 基因型的鉴定。此外,非等位的 RFLP 标记之间互不干扰,可以同时进行多个 RFLP 的遗传分析。RFLP 来自于人类基因组自身的变异,全基因组中大约有 4000 多个 RFLP,可以较好地覆盖整个基因组。因此,从 20 世纪 80 年代开始,RFLP 被广泛应用到了人类的遗传分析中。
二、连锁分析与孟德尔遗传病的间接遗传测试
在遗传的分子基础一章中我们曾以镰状细胞贫血的产前诊断为例,介绍过孟德尔疾病的遗传测试。深入分析该案例可以看出,准确的遗传测试需要提前获得患者携带的遗传变异的具体信息,并根据遗传变异位点设计合适有效的基因型分型方法。我们将这种直接分析样本DNA中是否携带致病性遗传变异位点的遗传测试方法称为直接的遗传测试。但在20世纪80年代,遗传学家遇到了新的问题:在一些孟德尔遗传病的发病机制未知,即基因的变异信息未知的情况下,能否通过遗传测试的改进实现产前诊断,避免患儿的出生呢?答案是肯定的。当遗传学家充分利用了遗传标记和连锁分析,一些问题迎刃而解,我们把这种改进的方法称为间接的遗传测试——在不知道致病基因的遗传变异信息的情况下,利用与疾病基因紧密连锁的遗传标记进行遗传测试。这其中运用到的核心连锁分析思想是:如果已知某遗传标记和致病基因紧密甚至完全连锁,那么即使不检测该致病基因的序列,也能在家系中根据父母和子女遗传标记的传递情况推导与之连锁的疾病基因的传递规律。我们再以另一种血液疾病为例详细介绍遗传测试操作与连锁分析的过程。
β地中海贫血(β thalassemia)是一种遗传性溶血性贫血症,在我国南方发病率较高,本病目前尚无理想的治疗方法。其中 $\beta^{\circ}$ 地中海贫血是不能产生 $\beta-$ 珠蛋白的一种重症贫血,是由 $\beta-$ 珠蛋白基因部分缺失引起的,属常染色体隐性遗传。今举一例,有一孕妇以前生育过 $\beta^{\circ}$ 地中海贫血儿子,该患儿于生后一年死亡,她现在又怀孕,要求对她的胎儿进行产前诊断(图7-28)。用限制性内切酶Pst I消化正常人基因组DNA后,与 $\beta-$ 珠蛋白基因探针杂交,得到一条4.4 kb的RF信号带。孕妇及其丈夫已生育过一个 $\beta^{\circ}$ 地中海贫血儿子,因此他们都是 $\beta^{\circ}$ 地中海贫血携带者,基因型均为 $+/\beta^{\circ}$ 。经同样处理后,夫妻俩的DNA样品中出现4.4 kb和3.7 kb两条RF信号带,说明3.7 kb的RF条带与突变 $\beta^{\circ}$ 珠蛋白基因连锁,而4.4 kb的RF条带和正常 $\beta$ 珠蛋白基因连锁。抽取孕妇羊水,直接从羊水细胞中提取胎儿的DNA,经Pst I酶切后,发现仅有3.7 kb的RF信号带,说明这一胎儿是一个突变 $\beta^{\circ}$ 珠蛋白基因的纯合子,因此也是一名 $\beta^{\circ}$ 地中海贫血患者。在这一诊断结果的指导下,家属要求进行人工流产,防止了患儿的出生。
图 7-28 $\beta^{\circ}$ 地中海贫血的基因诊断
(a)基因结构示意图。(b) Southern印迹结果。 $\beta$ 正常 $\beta-$ 珠蛋白基因; $\beta^{\circ}$ 异常 $\beta-$ 珠蛋白基因(有缺失);Pst,PstI酶切位点。
(a) $\beta$ 基因及其侧翼区域
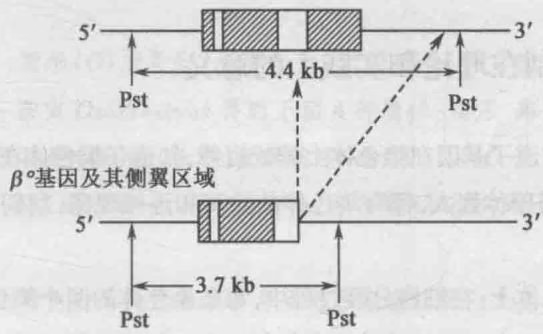
外显子 内含子
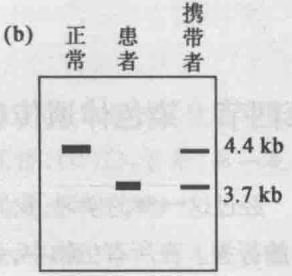
在上面的案例中,由于患者的 $\beta-$ 珠蛋白基因内部发生了大段缺失,所以珠蛋白基因两侧的 Pst I 位点酶切后形成了大小不同的片段,换句话说,基因缺失形成了一个 RFLP,因此,RFLP 的基因型可以完全代表致病基因的等位形式。但是,如果 RFLP 和疾病基因并无直接联系,而是位于致病基因的周围,那么两者之间就有可能在世代传递中发生交换。在这种情况下进行基因诊断时,致病基因和 RFLP 的连锁程度愈是紧密,重组率愈低或愈接近于零,基因诊断的可靠性愈大。
我们再举一例,苯丙酮尿症是由于苯丙氨酸羟化酶(phenylalanine hydroxytlase, PH)基因异常引起的,因为PH基因编码的蛋白质将苯丙氨酸转化为酪氨酸的代谢反应仅局限在肝内进行,所以在羊水细胞中测不出PH活性,也就无法用生化手段对未出生胎儿进行疾病诊断。但是,我们仍然可以利用PH基因所在染色体邻近座位上的RFLP对PH基因进行基因诊断。
PH 基因所在染色体周围存在有 Msp I 的多态位点, 利用 Msp I 限制性内切酶和 PH 基因探针可以特异性识别 PH 基因旁的 RFLP。在人群中, 有些个体的两条同源染色体上各含有两个 Msp I 位点, 杂交可以得到单一的 23 kb 的信号条带; 又有些个体的两条同源染色体各含有 3 个 Msp I 位点, 杂交可以得到单一的 19 kb 的信号条带; 还有些个体的一条染色体上有两个 Msp I 酶切位点, 另一条染色体有 3 个 Msp I 酶切位点, 则为 23 kb 与 19 kb 的杂合子。
在一家系中,父亲是23 kb纯合子,母亲是23 kb/19 kb的杂合子,他们的一个患儿是23 kb纯合子,这表明在母方,突变基因与23 kb DNA相连锁,而正常基因与19 kb DNA相连锁。现在待诊断胎儿是23 kb/19 kb杂合子,其19 kb RF来自母方,此RF与正常基因相连,而另一23 kb RF来自父亲,此RF可能与突变基因相连,也可能与致病基因相连。由于该疾病是常染色体隐性遗传病,胎儿已有与19 kb RF相连的一个正常等位基因,所以隐性纯合子(患病)的可能性可以排除。通过出生前基因诊断,我们可以劝告孕妇继续妊娠,生下来的孩子的表型是正常的(图7-29)。
图 7-29 苯丙酮尿症的基因诊断
(a) PH 基因及其侧翼区域的结构示意图。Msp, Msp I 酶切位点。(b) 家系图: 每个成员的 RF 大小已标出。(c) Southern 印迹结果。
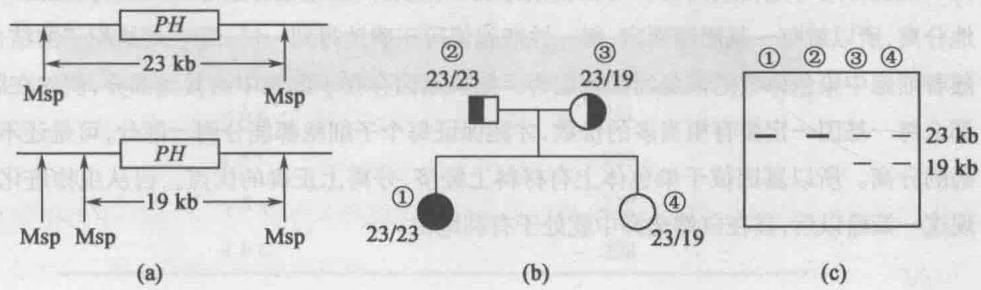
第四节 染色体遗传机制在理论和实践上的意义
经过这一章的学习,我们知道了基因在染色体上排成直线,知道了染色体在减数分裂和受精时的行为。在所有生物中,从噬菌体到人,都有染色体的分离和连锁现象,我们现在来看看这种机理的意义。
首先,我们知道基因在染色体上,在细胞分裂过程中,每条染色体的两个染色单体,各自进入一个细胞。染色体在间期复制时,上面所带的基因也复制一次。细胞分裂一次,形成的两个子细胞中,染色体完全一样,所有的基因也完全一样,所以双亲的遗传特性可以通过受精卵的连续有丝分裂而正确地传递下来。
生殖细胞形成时,进行减数分裂。在减数分裂时,不同对的染色体彼此独立分离,同时同源染色体间又可相互部分交换,这就造成多种配子,形成更多合子。这是生物变异的重要原因之一,为生物进化或培育新品种提供了丰富的素材。
其次,我们知道,有减数分裂才有分离现象,没有减数分裂,就没有分离现象。只有进行有性生殖的生物,才有减数分裂,才出现分离现象,这就能解释许多遗传现象。植物中的分根、插枝、嫁接等是无性繁殖,不进行减数分裂,所以没有分离,后代的基因型完全一样,遗传特性非常一致。
果树差不多都是很复杂的杂合子,如用种子繁殖,就有复杂的分离,无法保持母株所有的品质。所以要保持母株的特性,一定要用嫁接等无性繁殖的方法。
第三,我们知道,基因在染色体上作直线排列,这对育种工作者有一定帮助。在育种工作中,要把几个连锁的有利基因重新组合,或把有利和有害基因分开,最好能够预先了解有关基因间的重组率,以便在制定育种程序时加以考虑。如基因间的距离比较远,重组或分开都比较容易,育种工作当然容易取得成果,如果连锁相当紧密,重组或分开的机会较小,育种时间就要延长。
例如毡毛烟草(Nicotiana glutinosa)能抵抗烟草花叶病病毒,而烟草(N. tabacum)的栽培品种往往缺少这种抗性。为了把毡毛烟草的花叶病抗性转育到烟草的栽培品种中去,把毡毛烟草与烟草的栽培品种杂交,可是选育出的抗性植株对日烧病很敏感。测验结果表明,决定花叶病抗性的基因座跟决定日烧病敏感性的基因座是紧密连锁的。在这种情况下,为了不使育种时间延长,就要扩大选育对象,或采取另外措施,如后续章节将要谈到的辐射育种等。
最后,我们还要谈一点:为什么基因主要位于染色体上,而不是坐落在细胞中其他部分呢?这是因为基因位于染色体上时,每一基因座上的基因只要两份就可保证基因的正确分离和组合。在有丝分裂时,随着染色体的等分,位于其上的基因也均等地分向两极,所以就每一基因座而言,每一细胞都均等地得到两份。而在减数分裂中,随着同源染色体的分离,位于其上的基因也正确地分离,所以就每一基因座而言,每一性细胞都可正确地得到一份。而在雌雄配子的结合过程中,随着细胞中染色体数的恢复而重新组合。如果基因存在于细胞中的其他部分,例如在细胞质中,那么每一基因一定要有相当多的份数,才能保证每个子细胞都能分到一部分,可是还不能保证正确的分离。所以基因位于染色体上有材料上经济、分离上正确的优点。自从生物进化过程中出现这一策略以后,其在自然选择中就处于有利地位。
习题
在番茄中, 圆形 $(O)$ 对长形 $(o)$ 是显性, 单一花序 $(S)$ 对复状花序 $(s)$ 是显性。这两对基因是连锁的, 现有一杂交 Os / oS \times os / os 得到下面 4 种植株: 圆形、单一花序 $(OS)23$ , 长形、单一花序 $(oS)83$ , 圆形、复状花序 $(Os)85$ , 长形、复状花序 $(os)19$ 。问: $O - s$ 间的重组率是多少?
根据上一题求得的 O-s 间的重组率, 你预期 Os/oS \times Os/oS 杂交结果, 下一代 4 种表型的比例如何?
在家鸡中,白色由于隐性基因 $c$ 与 $o$ 的两者或任何一个处于纯合态,有色要有两个显性基因 $C$ 与 $O$ 的同时存在,今有下列的交配:
1 | \begin{array}{c c c} \text { ♀ 白色 } C C o o & \times & \text { ♂ 白色 } c c O O \\ & \downarrow & \\ & \mathrm{F} _ {1} \text { 有色 } \end{array} |
$F_{1}$ 用双隐性个体 ccoo 测交。做了很多这样的支配,得到的后代中,有色 68 只,白色 204 只。问:o—c 之间有连锁吗?如有连锁,重组率是多少?
- 双杂合子产生的配子比例可以用测交来估算。现有一交配如下:
1 | \begin{array}{c c c c} A A B B \times a a b b \\ \downarrow \\ A a B b \times a a b b \\ \downarrow \\ A a B b & A a b b & a a B b & a a b b \\ (1 - p) & p & p & (1 - p) \end{array} |
问:①独立分配时,p=?②完全连锁时,p=?③有一定程度连锁时,p=?
在家鸡中,px 和 al 是引起阵发性痉挛和白化的伴性隐性基因,相应的野生型等位基因为 Px 和 Al。今有一双因子杂种公鸡 pxAl/Pxal 与正常母鸡交配,孵出 74 只小鸡,其中 16 只是白化。假定小鸡有一半是母鸡,没有一只早期死亡,而 px 与 al 之间的重组率是 10%,那么在小鸡 4 周龄时,显出阵发性痉挛时,①在白化小鸡中有多少数目显出这种症状,②在非白化小鸡中有多少数目显出这种症状?
因为 $px$ 是致死的, 所以该基因只能通过公鸡传递。上题的小公鸡既不显示 $px$ , 也不显示 $al$ , 因为它们从正常母鸡得到 $Px, Al$ 基因。问多少小公鸡带有 $px$ ? 多少小公鸡带有 $al$ ?
在果蝇中, 有一品系对 3 个常染色体隐性基因 $a, b$ 和 $c$ 是纯合的, 但不一定在同一条染色体上, 另一品系对显性野性型等位基因 $A, B, C$ 是纯合子, 把这两品系交配, 用 $\mathrm{F}_{1}$ 雌蝇与隐性纯合雄蝇亲本回交, 观察到下列结果:
| 表型 | 数目 |
|---|---|
| a b c | 211 |
| A B C | 209 |
| a B c | 212 |
| A b C | 208 |
问:①这3个基因中哪两个是连锁的?②连锁基因间重组率是多少?
- 在番茄中, 基因 $o$ (oblate = flattened fruit), $p$ (peach = hairy fruit) 和 $s$ (compound inflorescence) 是在第二染色体上。用 + 表示这 3 个基因的野生型等位基因。将一个 3 基因杂合子与隐性纯合个体进行测交, 得到下列结果:
| 测交的子代表型 | 数目 |
|---|---|
| +++ | 73 |
| ++s | 348 |
| +p+ | 2 |
| +ps | 96 |
| o++ | 110 |
| o+s | 2 |
| op+ | 306 |
| ops | 63 |
问:①这3个基因在第二染色体上的顺序如何? ②两个纯合亲本的基因型是什么? ③这些基因间的图距是多少? ④并发率是多少?
- 下面是位于同一条染色体上的 3 个基因的隐性基因连锁图,并注明了遗传图距。
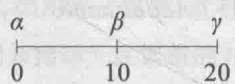
如果并发率是 $60%$ ,在 \alpha \beta \gamma / + + + \times \alpha \beta \gamma / \alpha \beta \gamma 杂交的1000个子代中预期表型频率是多少?
减数分裂过程中包括两次分裂,染色体的减数发生在减数分裂I的时候。我们已经知道基因在染色体上,既然染色体在第一次分裂时减数,为什么位于染色体上的基因有时可以在第二次分裂时分离呢? (提示:参考图7-20。)
某次交换如下图所示, 设第一次交换发生在非姐妹染色单体 2—3 间, 如第二次交换可发生在任意两非姐妹染色单体间, 机会相等, 请画出 4 种可能的双交换, 并分别写出子囊的基因型。
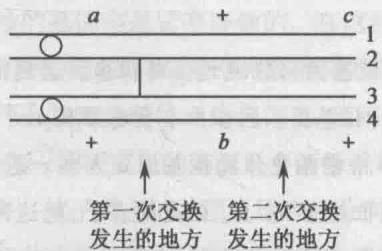
- 根据表 7-5 的资料, 计算重组率, 得到
1 | arrayl l - n i c & 5.05 \% |
为什么 $5.05% + 5.20% > 9.30%$ 呢?因为·—ade间的重组值低估了。我们看下表:
| 子囊型 | 每一子囊被计算为重组子的染色单体数 | 子囊数 | 在所有子囊中被计算为重组子的染色单体数 | ||||
| ·—nic | nic—ade | ·—ade | ·—nic | nic—ade | ·—adc | ||
| 2 | 0 | 4 | 0 | 1 | 0 | 4 | 0 |
| 3 | 0 | 2 | 2 | 90 | 0 | 180 | 180 |
| 4 | 5 | ||||||
| 5 | 90 | ||||||
| 6 | 1 | ||||||
| 7 | 5 | ||||||
| 总计 | 202 | + 208 ≠ 372 | |||||
这里, $\frac{202+208-372}{4000}=0.95%$ ,是低估了的重组率。把这低估的数值加上去,就完全符合了:
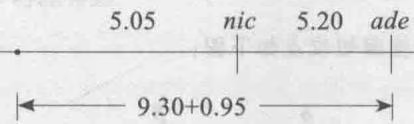
请在表中空白处填上数字。
- 雌果蝇 X 染色体的遗传组成是
$$
\frac {+ + + + + +}{a b c d e f}
$$
有一隐性致死基因 l 位于上面一条 X 染色体的某处,但不知其确切位置。经杂交后,统计此雌蝇产下的 1000 个雄性子代,其表型如下:
| 表型 | 数目 |
|---|---|
| a b c d e f | 750 |
| a b c d e | 60 |
| a b c d | 20 |
| a b c | 30 |
| d e f | 70 |
| c d e f | 40 |
| b c d e f | 30 |
| 合计 | 1 000 |
为简易起见,不考虑多次交换,而且已经知道所给的基因顺序是正确的。请写出这些基因间的距离以及致死基因 l 的位置。
- $\beta$ 地中海贫血为一种常见的遗传性贫血症,重型患者( $\beta^{T}/\beta^{T}$ ,T代表thalassmia)常因心力衰竭而死亡。目前对此病尚无根治方法,仅能通过产前诊断,以防患儿出生。
曾溢滔等利用他们备有的几种 DNA 探针和几种限制性内切酶,对 5 例 $\beta$ 地中海贫血家系的患者及其父母进行 RFLP 分析。根据所得结果,随即选用特定的限制性内切酶和探针对胎儿的绒毛或羊水细胞 DNA 进行产前基因诊断。
下面是选出的两个 $\beta$ 地中海贫血家系。请根据 RFLP 分析结果, 对要进行产前诊断的胎儿作出你的判断, 并加以讨论。
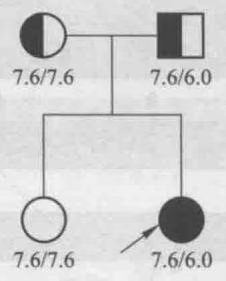
(1)
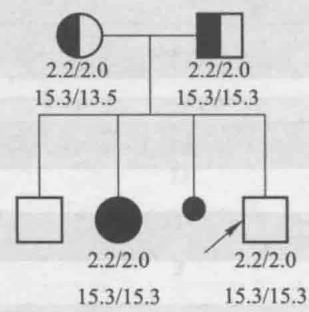
(2)
家系(1):用限制性内切酶 HincⅡ和探针 $\Psi\beta_{1}$ 进行分析。
家系(2):用限制性内切酶 AvaⅡ和探针 βIVS 以及限制性内切酶 HindⅢ和探针 pRK28 进行分析。
家系(2)解答提示:
(1) $\beta$ 珠蛋白基因簇上限制性酶切位点如下图:
(2) 从 Ava II 酶切位点多态性来看: 患儿得父 2.2 与母 2.0, 或得父 2.0 与母 2.2; 胎儿也是如此, 所以胎儿或为 $\beta^{+}/\beta^{+}$ (正常纯合子), 或为 $\beta^{T}/\beta^{T}$ (为什么?)
再从 HindⅢ酶切位点多态性来看: 患儿从母亲得到的 15.3 这一染色体上有 $\beta^{T}$ 基因, 所以胎儿不可能是正常纯合子, 从而必为 $\beta^{T}/\beta^{T}$ (重型患者)。
以 RFLP 为代表的分子遗传标记与传统标记相比,有哪些优点和缺点?
下图所示的是某常染色体隐性遗传病的一个家系,在致病基因附近有两个完全连锁的RFLP遗传标记(SphI和HindIII)。分型结果如下,请判断孩子2和3的基因型和表型,并简要写出分析过程。
- 下图的家系中表示了两种 X 染色体连锁的隐性遗传病的传递, 请问:
(1) 请写出 I-1, I-2 个体的基因型。(甲病基因用 A/a 表示, 乙病基因用 B/b 表示)
(2) Ⅲ代中,哪些个体是重组型?
I
II
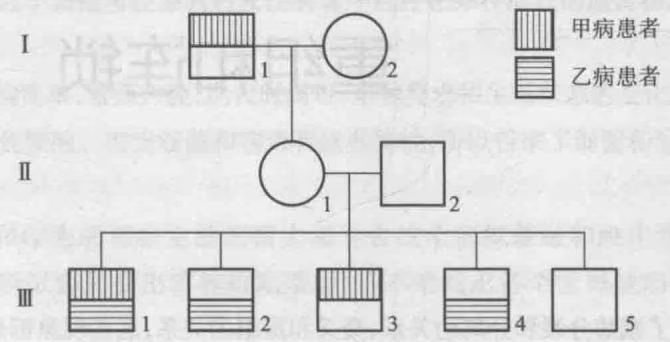
数字课程学习
在线自测
习题答案
第八章 细菌和噬菌体的 重组和连锁
我们已经看到了减数分裂和分离的关系、交叉和重组的关系,这些现象都是真核生物的基因传递方式的特征,是有性生殖过程所特有的。细菌在拟核和细胞质之间不存在明显的核膜,病毒没有细胞结构,这类生物的基因传递方式显然是非减数分裂式的。我们将在这一章里讨论它们的遗传物质如何从一个世代到另一世代。
第一节 细菌和病毒在遗传学研究中的地位
细菌的结构简单,世代时间短,通常20 min一代,而且容易得到它们的生化突变型,所以细菌已成为最常用的遗传学实验材料之一。
细菌是单细胞生物,形状和大小变化很多,它的遗传物质是一个大型的环状核酸分子,称为基因带(genophore),也可称为染色体。细菌通常利用简单的二分分裂增殖,通过这种无性的分裂,一个细菌可在固体培养基上形成一个菌落。当某个细菌的遗传组成偶尔发生突变时,由这种突变细菌所形成的菌落就跟其他菌落不同了。如这种细菌的菌落或菌株丧失产生某种营养物质(如氨基酸)的能力,就称为营养缺陷型,相对于缺陷型,野生型菌株可以叫作原养型。
相当长的一段时间,人们认为细菌只是无性生殖的,各个细菌间没有遗传物质的交换。在1946年,莱德伯格(Joshua Lederberg,1925—2008)和塔特姆发现两型大肠杆菌(Escherichia coli)间有遗传物质的交换。他们观察到,如果一型大肠杆菌仅对某一化学成分是缺陷型,而另一型对另一化学成分是缺陷型,将它们混合后培养,偶尔会出现能自主产生两种化学成分的原养型细菌。
这些结果当然也可能是由于实验的误差,例如污染、新的突变或其他原因,但通过各种实验,他们可以肯定,上述原养型细菌的起源可归于细菌与细菌接触中遗传物质的直接交换。微生物遗传学家进一步研究清楚这些物质交换是怎样产生的,这也是我们这一章中要详述的内容。
病毒是比细胞更简单的一种生命存在形式。它们自身没有代谢机能,不能单独地生长和增殖,必须寄生在活细胞中,利用活细胞的代谢机器进行增殖。
病毒根据宿主细胞的不同,可以分为动物病毒、植物病毒和细菌病毒3种。细菌病毒又称噬菌体(bacteriophage,简写为 phage)。病毒的结构包括蛋白质的外壳和包裹在中间的病毒遗传物质——核酸分子,这个核酸分子也称为基因带或染色体。
病毒似乎是无性的,可是德尔布吕克(Max Ludwig Henning Delbruck,1906—1981)等发现,当具有不同特性的噬菌体被添加到细菌中一起培养,在它们的后裔中会出现不同于原有病毒性状的新组合。当排除了其他可能原因后发现病毒中也存在某种形式的遗传物质交换,这些过程也将在本章中讨论。
细菌和病毒结构简单,繁殖力强,世代时间短,培养要求和生理状态的变化多,大都能在一定成分的培养基上生长繁殖。因为细菌和病毒有这些特性,所以带来了细菌和病毒作为遗传学研究材料的优越性:
① 细菌本身和作为病毒宿主的细菌大都能合成全部氨基酸和维生素,能在一定成分的培养基上生长,所以容易找出营养缺陷型,并且不难找出各个营养缺陷型所需要的营养物质。
② 研究基因的作用时,常常要用到营养缺陷型,也常常需要对代谢产物或细菌本身进行化学分析。细菌繁殖迅速,代谢作用旺盛,在培养中短时间内能累积大量代谢产物,所以便于基因作用的研究。
③ 尽管细菌基因突变的频率很低,要在几十个培养皿中才能观察到一个突变型。但是如果所观察的性状是抗链霉素突变型,只要在培养基中加入链霉素,那么敏感的细菌就不能形成菌落,而只有发生抗性突变的细菌才能在培养基上长成菌落,所以可以在培养基中观察若干亿细菌中所发生的少数突变。这种选择性培养方法是遗传学研究中一个很有用的方法。
④ 研究基因的精细结构,必须获得某一基因内大量不同位点的突变型,然后通过重组分析测定它们的位置。由于这些突变发生在同一基因中,它们的位置非常接近,所以要观察极大量的子代才能发现少数重组子,这只有用细菌和噬菌体作材料,应用选择性培养的方法,才能做到。
⑤ 细菌的生命机制简单,便于着手研究。尽管在细菌中得到的结论不一定能应用到高等生物中,但是可以从中得到启发,推动高等生物中这些问题的研究。
此外,细菌和病毒作为遗传学研究的材料还有很多其他方便之处,如便于建立纯系,便于长期保藏等。细菌和病毒在医学上也很重要,研究它们还有实际意义。
第二节 细菌的遗传分析
细菌中,大肠杆菌是使用最为广泛的遗传学实验材料,因为它容易培养,可以在含有盐类和葡萄糖的简单培养基上生长,而且大肠杆菌也和人类的健康与生活息息相关。
一、细菌的杂交
细菌的杂交最初是在大肠杆菌中发现的。大肠杆菌有很多菌株,有的对抗生素是敏感的,有的则是有抗性的。例如在含有链霉素的培养基中,所有对链霉素敏感的细菌都会被杀死,但有链霉素抗性的细菌能够生长。有的营养缺陷型菌株在基本培养基上不能生长,需要添加一些特殊的物质,如氨基酸之类。例如野生型大肠杆菌能在基本培养基上生长,而甲硫氨酸营养缺陷型只能在加有甲硫氨酸的基本培养基上生长,生物素缺陷型只能在加有生物素的基本培养基上生长。
这些细菌菌株通常都能真实遗传,也就是说,子代细胞跟亲代细胞一样,有同样的生长需求。一旦我们知道了菌株间的遗传差异后,我们就可探讨细菌杂交以及是否有基因的交换了。
为了方便起见,这些菌株按照它们所短缺的、不能合成的物质来命名,取前面3个字母,右上角写上负号“-”,或正号“+”,负号代表缺陷型或突变型,正号代表野生型。例如上面已提到过的,甲硫氨酸缺陷型写作 $met^{-}$ ,生物素缺陷型写作 $bio^{-}$ ,而与它们相对的、能合成这种物质的野生型写成 $met^{+}$ 和 $bio^{+}$ 。对抗生素敏感或抗性的品系,也取前面3个字母,不过在右上角写上s或r,分别代表敏感(sensitive)或抗性(resistant)。例如对链霉素敏感的写成 $str^{s}$ ,对链霉素抗性的写成 $str^{r}$ 。
现在看莱德伯格和塔特姆(1946)的一个实验:大肠杆菌 K-12 的两个菌株 A 和 B,菌株 A 需要在基本培养基上补充甲硫氨酸和生物素,菌株 B 需要在基本培养基上补充苏氨酸、亮氨酸和维生素 B₁(thiamine),因此它们的基因型可以写作:
1 | \text { 菌株 A } m e t ^ {-} b i o ^ {-} t h r ^ {+} l e u ^ {+} t h i ^ {+} |
1 | \text { 菌株B } m e t ^ {+} b i o ^ {+} t h r ^ {-} l e u ^ {-} t h i ^ {-} |
菌株 A 与 B 在基本培养基上都不能生长,将它们分别涂布在基本培养基的固体平板上,培养几天后都没有看到任何菌落。若是把 A 和 B 混合培养在含有以上 5 种物质的液体培养基中,几小时后,离心培养物,把沉淀细胞洗涤后再涂布在基本培养基上,发现长出了菌落,频率是 $10^{7}$ 中有一个 (1 \times 10^{-7}) (图 8-1)。
1 \times 10^{-7} 是一个很低的数值,从 1 000 万个细胞中挑出一个来,在果蝇等传统实验材料中很难
不同的营养缺陷型细菌在完全培养液中混合培养过夜,离心洗去完全培养液后,各取 $10^{8}$ 细胞混合后涂布在基本培养基上,可发现数十个原养型菌落。如将不同的营养缺陷型细菌独立培养,在离心洗涤后,各取 2\times10^{8} 细胞,分别涂布于基本培养基上,看不到原养型菌落的出现。
做到这一点,可是在细菌中,由于只有原养型 $(met^{+}bio^{+}thr^{+}leu^{+}thi^{+})$ 能在基本培养基上生长,即使比 1\times10^{-7} 还要低的频率都可轻而易举地挑出来,所以这种选择技术是非常有用的。
这种与亲代不同的能在基本培养基上生长的细菌是由于营养上的互补,即一些物质从一个菌株的细胞中泄漏出来而为另一菌株的细胞所吸收呢?还是菌株A和菌株B发生杂交,交换遗传信息后,出现重组,产生 $met^{+}bio^{+}thr^{+}leu^{+}thi^{+}$ 的细菌呢?我们再来看一个实验。
戴维斯(Bernard David Davis,1916—1994)设计了一种U型管,中间有过滤器隔开,滤器的孔很小,细菌不能通过,但培养液和营养物质可以通过(图8-2)。U型管的一臂添加菌株A,另一臂添加菌株B。在U型管中培养一段时间,再测定每一臂的细菌,发现没有一个细菌能在基本培养基上生长。看来要有原养型细胞的形成,两个菌株间的直接接触是必不可少的。这个实验排除了营养互补的可能。
概括上面的两个实验,我们可以这样说,菌株A和菌株B通过接触后,可能就像高等生物的有性生殖过程一样,发生了杂交,遗传物质有了交换,产生与两个亲代菌株不同的野生型 $met^{+}bio^{+}thr^{+}leu^{+}thi^{+}$ 菌株。
图 8-2 大肠杆菌的重组需要两种菌株的直接接触
一种 U 型管,一臂放菌株 A,一臂放菌株 B,中间由一滤器隔开。加压力或吸力后,培养液可以在两臂间流通,但细菌细胞不能通过。经几小时培养后,将菌液 A、B 分别涂布于基本培养基上,未见有原养型菌落的出现。
二、F因子与接合
在大肠杆菌的遗传学研究中,很早就知道,它们的遗传物质的传递方式跟具有典型减数分裂过程的生物不同。例如两个亲本类型对它们子裔的遗传贡献并不相等,有些亲代基因组合出现在子裔中,而另一些则不见了。而且所有在子裔中出现的基因都是连锁的。对这些特点有各种说法,直至哈耶斯(Willam Hayes,1913—1994)(1953)证明大肠杆菌有性的分化后,才逐渐清楚。他做了一个杂交实验,用的菌株跟莱德伯格和塔特姆用的相似:
1 | \begin{array}{c c} \text {菌株A} & \text {菌株B} \\ m e t ^ {-} t h r ^ {+} l e u ^ {+} t h i ^ {+} \times m e t ^ {+} t h r ^ {-} l e u ^ {-} t h i ^ {-} \end{array} |
但是他用链霉素处理菌株 A 或菌株 B,这种处理并不杀死它们,只是阻碍它们的分裂。他将处理过的菌株 A 跟未处理的菌株 B 混合,或将处理过的菌株 B 跟未处理的菌株 A 混合,结果大不相同。菌株 B 经处理后,在基本培养基上没有活下来的;但是菌株 A 经过处理后,基本培养基上有活下来的,而且频率跟未经处理的对照一样。
这是怎么一回事呢?一个可能的解释是:大肠杆菌中遗传物质的交换不是交互的。事实上一个菌株(菌株 B)作为遗传物质的受体(recipient),而另一菌株(菌株 A)是供体(donor)。供体经链霉素处理后不能分裂,但仍能转移基因,而受体未受处理,当然仍能分裂,所以接受转移过来的基因后,有可能在基本培养基上形成菌落。这种单向的基因交换可以比作性的差别,把供体看作是雄的,而受体是雌的。
随后的研究发现供体和受体间性行为的不同,是由一个微小的可转移的因子叫作 F 因子引起的。F 因子(F factor)又称性因子(sex factor)或致育因子(fertility factor),它是能独立增殖的环状 DNA 分子。供体细胞含有 F 因子,记作 $F^{+}$ 。 $F^{+}$ 细菌的表面有称作性伞毛(sex pili)的细长纤毛,由此与 $F^{-}$ 细菌接合(conjugation)(图 8-3)。F 因子具有能形成性伞毛的基因,此外 F 因子还可改变细胞表面的构造,以防止 $F^{+}$ 细菌间的接合。因此接合仅发生在 $F^{+}$ 与 $F^{-}$ 之间,而 $F^{+}$ 与 $F^{+}$ 间以及 $F^{-}$ 与 $F^{-}$ 间是不会发生的。
细菌分裂增殖时,从 $F^{+}$ 细菌产生 $F^{+}$ 细菌,从 $F^{-}$ 细菌产生 $F^{-}$ 细菌。但 $F^{+}$ 细菌与 $F^{-}$ 细菌混合培养时, $F^{-}$ 细菌变为 $F^{+}$ 细菌。这是因为 $F^{+}$ 细菌与 $F^{-}$ 细菌接合,F 因子通过性伞毛从 $F^{+}$ 细菌转移到 $F^{-}$ 细菌。在转移时, $F^{+}$ 细菌中的 F 因子复制,其中一个虽转移到 $F^{-}$ 细菌,原来的细菌仍为 $F^{+}$ 。因此,在 $F^{-}$ 细菌的培养液中添加少量 $F^{+}$ 细菌培养后,几乎所有的细菌都成为 $F^{+}$ 细菌,但细菌的染色体很少通过接合而转移到 $F^{-}$ 细菌,即染色体上基因的重组率很低,还不到百万分之一。
另一方面, $F^{+}$ 细菌如果丢失F因子,就成为 $F^{-}$ 细菌。要把 $F^{+}$ 细菌变为 $F^{-}$ ,最有效的方法是用吖黄素(acriflavine)处理。调节吖黄素的浓度,使这浓度不妨碍细菌的增殖,但可选择性地阻碍F因子的复制,如此培养 $F^{+}$ 细菌,所有的细菌都能转变为 $F^{-}$ 。
右侧是供体细胞 $\left(\mathrm{F}^{+}\right)$ ,左侧是受体细胞 $\left(\mathrm{F}^{-}\right)$ 。两者形态上不同,不是由于 $F^{+}$ 和 $F^{-}$ 的不同,而是为了便于区别,选用了不同细菌。 $F^{+}$ 细菌和 $F^{-}$ 细菌的特征性区别是 $F^{+}$ 细菌的表面有性伞毛的存在,而 $F^{-}$ 细菌没有性伞毛。 $F^{+}$ 细菌跟 $F^{-}$ 细菌的接触可能通过一条性伞毛实现。一旦接触后,性伞毛发生改变,成为两细胞间的原生质通道,由于它的性质,特称为接合管(conjugation tube)。接合管外面附着有对它特异性结合的噬菌体,在电镜下看得更清楚了。
三、高频重组与中断杂交技术
卡瓦利-斯福尔扎(Luigi Luca Cavalli-Sforza,1922—2018)偶然间在菌株A中发现一个新菌株,跟菌株B(F⁻)杂交时,出现重组子的频率很高,几乎比F⁺×F⁻杂交高1000倍。这个新菌株就叫作高频重组(high frequency of recombination)菌株,或简称Hfr菌株。上面已谈到过,在F⁺×F⁻杂交中,几乎所有F⁻细菌都转变为F⁺,而在Hfr×F⁻杂交中,尽管出现高频率的重组,但F⁻细菌很少有转变为F⁺细菌的。这个问题曾使遗传学家感到迷惑不解。
(1) 用中断杂交技术作连锁图 沃尔曼 (Elie Wollman, 1917—2008) 和雅各布研究了这个问题, 他们想了解在交配中, Hfr 细菌什么时候把基因转移给 F⁻ 细菌。他们把如下两个菌株混在一
起,进行杂交:
1 | \text { thr } ^ {+} \text { leu } ^ {+} \text { azi } ^ {r} \text { ton } ^ {r} \text { lac } ^ {+} \text { gal } ^ {+} \text { str } ^ {s} \times \text { thr } ^ {-} \text { leu } ^ {-} \text { azi } ^ {s} \text { ton } ^ {s} \text { lac } ^ {-} \text { gal } ^ {-} \text { str } ^ {s} |
菌株的基因符号的说明见表8-1。把这两菌株在培养液中进行通气培养,Hfr细菌与 $\mathbf{F}^{-}$ 细菌开始接触,形成接合管。每隔一定时间取样,把菌液放在搅拌器内搅拌,断开接合管,使配对的细菌分开。然后稀释菌液,防止再度配对。把稀释后菌液涂布在含有链霉素但不含有苏氨酸和亮氨酸的培养基上。在这培养基上,带有 $thr^{+}$ 和 $leu^{+}$ 的Hfr菌对链霉素是敏感的,而带有 $str^{r}$ 的 $\mathbf{F}^{-}$ 菌不能合成苏氨酸和亮氨酸,都不能生长,所以只有带有 $thr^{+}$ 和 $leu^{+}$ 的Hfr菌和带有 $str^{r}$ 的 $\mathbf{F}^{-}$ 菌的重组子可以生长。重组子 $thr^{+} leu^{+} str^{r}$ 的菌落影印培养(replica plating,使一系列培养皿的相同位置上出现相同菌落的接种培养方法)在若干不同的选择培养基(selective media,即缺少一种或几种营养物质,而含有其他生长必需物质的培养基)上,分析Hfr染色体上其他非选择性标记基因进入 $\mathbf{F}^{-}$ 细菌的顺序和所需时间,绘制出连锁图。这种根据供体基因进入受体细胞的顺序和时间绘制连锁图的技术,称为中断杂交技术(interrupted mating technique)。
表 8-1 细菌杂交实验中所用的若干基因符号
| ara | 阿拉伯糖利用 | leu | 亮氨酸合成 | pyr | 嘧啶合成 |
|---|---|---|---|---|---|
| arg | 精氨酸合成 | lys | 赖氨酸合成 | rha | 鼠李糖利用 |
| att | 原噬菌体附着点 | mal | 麦芽糖利用 | str | 链霉素抗性 |
| ade | 腺嘌呤合成 | man | 甘露糖利用 | thi | 维生素 $B_1$ 合成 |
| azi | 叠氮化钠抗性 | met | 甲硫氨酸合成 | thr | 苏氨酸合成 |
| bio | 生物素合成 | mtl | 甘露糖醇利用 | ton | 噬菌体T1抗性 |
| cys | 胱氨酸合成 | pdx | 吡哆醇合成 | trp | 色氨酸合成 |
| gal | 半乳糖利用 | phe | 苯丙氨酸合成 | tsx | 噬菌体T6抗性 |
| his | 组氨酸合成 | pro | 脯氨酸合成 | tyr | 酪氨酸合成 |
| lac | 乳糖利用 | pur | 嘌呤合成 | xyl | 木糖利用 |
* 不同基因影响同一性状时,在基因符号后加一大写字母以资区别,如 metA, metB 等。
结果发现(表8-2),在两菌株混合后 $8\mathrm{min}$ 取样时,还未见有供体菌的非选择性标记基因进入 $\mathbf{F}^{-}$ 细胞。在混合后 $9\mathrm{min}$ ,开始出现少量叠氮化钠抗性菌落,但此时受体菌对T1噬菌体还是敏感的,说明 $ton^{r}$ 基因尚未进入 $\mathbf{F}^{-}$ 细菌中。混合后 $11\mathrm{min}$ 时,开始出现对T1噬菌体有抗性的菌落。混合后 $18\mathrm{min}$ 和 $25\mathrm{min}$ ,又陆续出现乳糖能利用 $(lac^{+})$ 和半乳糖能利用 $(gal^{+})$ 菌落,而在这以前,全部菌落都属于不能利用型。
表 8-2 Hfr 的非选择性标记基因进入 F 所需的时间
| 时间/min | 转移的Hfr基因 |
|---|---|
| <9 | 无 |
| 9 | $azi^{r}$ |
| 11 | $azi^{r} ton^{r}$ |
| 18 | $azi^{r} ton^{r} lac^{+}$ |
| 25 | $azi^{r} ton^{r} lac^{+} gal^{+}$ |
Hfr 菌株的各非选择性标记基因进入 F $^{-}$ 细菌中的时间不同, 到达最高水平的时间也不同。
从图 8-4 还可以看到,从 Hfr 菌株的基因在 F⁻ 细菌中出现开始,随着时间的推移,携带这一基因的菌落逐渐增加,直到某一百分数为止;而且某一基因出现的时间愈早,它所达到的百分数也愈高。例如叠氮化钠抗性基因出现最早,在 24 min 时就出现在大约 90% 的 F⁻ 菌落;半乳糖发酵基因出现最迟,即使在混合后 60 min 时取样,也只有 30% 的菌落属于半乳糖能利用型。
这些事实说明,Hfr 细菌的基因按一定的时间顺序依次地出现在 $F^{-}$ 细胞中。由于基因是在染色体上,也就是说,染色体是从一端开始以线性方式进入 $F^{-}$ 细胞中,这一端称为原点 (origin) 或 O。基因离开原点越远,进入 $F^{-}$ 细胞越迟。离开原点较远的基因,可能在转移过程停止以前仍未转移,因而斜率较低,达到的最高值也较小(图 8-4)。
沃尔曼和雅各布认识到,根据中断杂交技术,用杂交后 Hfr 基因最初在受体细菌中出现的时间作为指标,可以绘制连锁图。这里距离的单位是 min,那就是说,如果 ton 在 azi 开始进入 F 细胞后 2 min 进入,那么 azi 和 ton 相隔 2 单位。注意这种连锁图是根据遗传学资料作成的,并不能准确反映基因间真实的物理距离(图 8-5)。
图 8-5 根据中断杂交技术制作的大肠杆菌连锁图
| O | azi | ton | lac | gal |
|---|---|---|---|---|
| 0 | 9 | 11 | 18 | 25 |
基因距离(图距)的单位是 min, 数值注明在下方。
如果让 Hfr \times F^{-} 杂交继续进行, 长达 2 h, 然后使之中断, 这样发现某些 $F^{-}$ 受体转变为 Hfr。换句话说, 致育因子最后转移到受体, 并使它们成为供体, 但效率很低, 是线性染色体的最后一个单位。
(2) 大肠杆菌的染色体呈环形 用不同 Hfr 菌株进行中断杂交实验, 都可作成连锁图, 可是基因转移的顺序、转移起点和转移方向却很不相同 (表 8-3)。
乍一看,似乎很难理解,但如仔细比较基因转移顺序,却有一定线索可寻。每一 Hfr 菌株的基因顺序虽不相同,但不是随机的。例如所有 trp 基因的两侧都是 mal 和 gal;其他基因也是如此,除非它们是在连锁群的另一端。又例如两个菌株 H 和 P72 的次序是 O gal trp mal,而另外两个菌株 C 和 J4 的次序是 O mal trp gal,两者的转移顺序正好相反。还有,上面已提到过,致育因子是最后转移,所以总是在远离原点的另一端。
表 8-3 几个 Hfr 菌株的基因顺序
| 菌株 | 转移顺序 |
|---|---|
| Hfr H | O thr azi lac tsx gal trp mal xyl metB thi F |
| Hfr C | O tsx lac azi thr thi metB xyl mal trp gal F |
| Hfr J4 | O thi metB xyl mal trp gal tsx lac azi thr F |
| Hfr P72 | O metB thi thr azi lac tsx gal trp mal xyl F |
科学工作者把上面这些事实贯穿起来,提出假设:如果 $F^{+}$ 雄性细胞的染色体是环状的,而且还有一个 F 因子,那么任何线性的 Hfr 染色体的形成都可用 F 因子插入环状染色体的不同地点来说明(图 8-6,另见图 8-15)。
实际上每一线性序列是同一圆形基因顺序的不同排列。小黑方块代表 F 因子插入环形染色体的位置,箭头表示各 Hfr 菌株的染色体的转移起点和方向。图中基因符号见表 8-1。
四、F因子整合到细菌染色体的过程
细菌染色体是环状的,这是从遗传学资料推导出来的,这在当时是难以置信的概念,在若干年后才得到证实。F 因子的插入决定了 Hfr 染色体的极性,F 因子所在的地方是末端,而 F 因子的另一侧是原点,即 Hfr 菌株染色体转移的起点(图 8-6)。那么 F 因子是怎样插入到环状染色体上的呢?
现在知道,F 因子也是环状 DNA 分子,跟细菌的染色体一样。在环状的细菌染色体和环状的 F 因子间的一个简单交换,可形成一个较大的环(图 8-7)。
图 8-7 Hfr 形成过程
环状 F 因子通过交换整合到环状的细菌染色体中, 形成 Hfr 染色体。
F 因子是质粒的一种。质粒是染色体外遗传因素,它可以自我复制,并在细胞分裂时分配到子细胞中。有的质粒除了可在染色体外自主复制以外,还可整合到染色体上,成为染色体的一部分,这样的质粒被特称为附加体(episome)。F 因子或 F 质粒在 $F^{+}$ 细菌中存在于细胞质内,在 Hfr 细菌中整合到染色体,所以 F 质粒也是附加体的一种。
环状的 F 因子包括几个部分: ①原点, F 因子自身转移的起点; ②形成性伞毛的基因群, 使细菌表面出现一至若干性伞毛, 通过性伞毛与 F⁻ 细菌接合; ③ DNA 复制酶基因, 与 F 因子本身的复制有关; ④插入序列 (insertion sequence, IS), 与其插入细菌染色体的过程有关 (详见重组与修复一章) (图 8-8)。
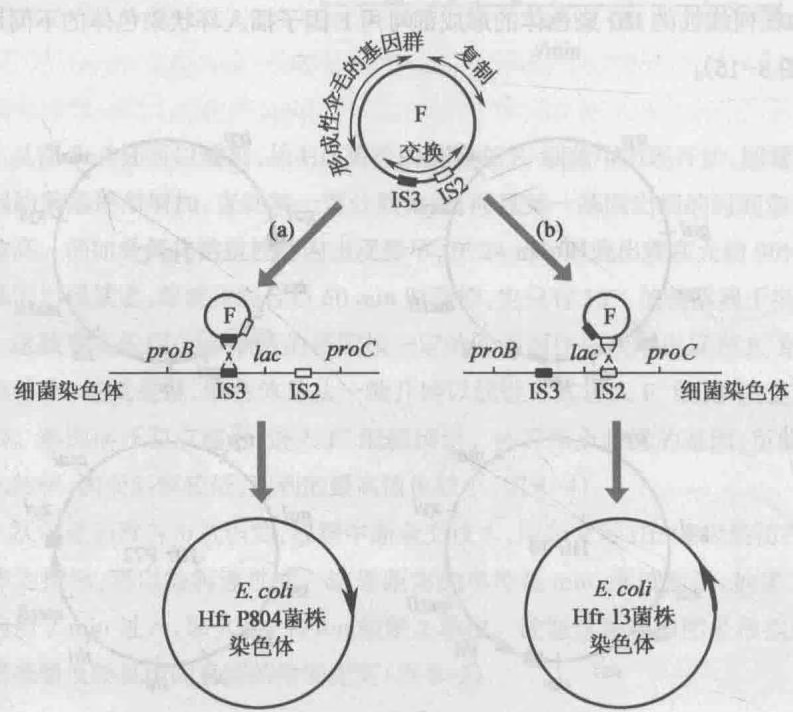
F 因子在 $F^{+}$ 细菌中以游离状态存在, 整合时 F 的 IS 与细菌染色体的 IS 间发生一个简单的交换, F 因子整合到细菌染色体, $F^{+}$ 菌成为 Hfr 菌。
F 因子含有的 IS 聚集于 F 因子的某个区域, 另一方面, 在大肠杆菌染色体的各个区域也有许多 IS 存在。如 F 因子内的一个 IS 与细菌染色体上的一个 IS 配对, 发生交换, F 因子就整合到染色体上。IS 有极性, 或者向左, 或者向右, 所以交换后整合到细菌染色体的 F 方向也就随着定了。如图 8-8(a) 所示, F 因子的 IS3 跟染色体的 proB 和 lac 之间的 IS3 发生交换时, F 以顺时针方向插入 proB 与 lac 之间。若如 (b) 所示, 则 F 的 IS2 跟 lac 与 proC 间的 IS2 配对, F 以逆时针方向插入 lac 与 proC 之间。结果两者的染色体转移方向正好相反。所以前述各 Hfr 菌株染色体的原点和转移方向的不同, 可以认为是 F 因子整合到细菌染色体的不同 IS 部位的结果。
五、细菌基因的交换过程
到现在为止,我们只讨论了杂交中遗传信息的转移过程,这是根据杂交中产生的重组子推论出来的。然而在重组子被检出以前,转移过去的基因必须通过一种交换过程整合到受体的基因中去。我们现在来讨论一下这种交换过程的某些特点。原核类中的遗传交换并不像真核类那样在两整套染色体组间进行,而是在一个完整的环状染色体(称作 F 内基因子,endogenote)与一条来自供体细胞不完整的染色体(称作供体外基因子,exogenote)间进行,所以是在部分二倍体(partial diploid)或部分合子间进行(图8-9)。大肠杆菌的性过程概括在图8-10中。
这儿还有一点要提出来说明:部分合子中完整的 F 染色体与部分 Hfr 染色体间发生单交换是没有用的,因为环断裂后,只能产生不平衡的部分二倍体线性染色体(图 8-11)。
只有 F⁻ 染色体与部分 Hfr 染色体间发生偶数的交换, 才能产生有活性的重组子和片段(图 8-12)。片段是部分基因组, 也就是说, 只有全部基因内容的一部分, 大都在以后的细胞分裂中丢失。所以细菌的重组有两个特点: ①只有偶数交换才能产生平衡的重组子; ②相反的重组子不出现, 所以在选择培养上只出现一种重组子。
图 8-9 部分合子模式图
图 8-10 大肠杆菌的性过程模式图(根据 Suzuki 等改绘, 1986)
(a) $F^{+}a^{+}$ 细菌与 $F^{-}a^{-}$ 细菌配对,接合管形成, $F^{+}$ 细胞中 F 因子复制,其中一个通过接合管进入 $F^{-}$ 细菌。一般,转移只限于 F 因子,细菌染色体的转移频率极低。两个接合后体(exconjugant)都是 $F^{+}$ 。(b) Hfr $a^{+}$ 与 $F^{-}a^{-}$ 杂交时,接合管形成,Hfr 染色体复制。一个拷贝的原点和附近的基因通过接合管进入受体细菌。在复制和转移过程中,接合管断裂,交配中细菌分开。Hfr 的部分染色体进入受体细菌,F 因子位于 Hfr 染色体的最后端,极少进入。形成的部分合子中,完整的 $F^{-}$ 染色体与 Hfr 的部分染色体发生重组,产生重组子。
图8-11 单交换产生不平衡的线性染色体
图 8-12 双交换产生有活性的重组子和片段, 片段在以后的细胞分裂中失去, 所以相反的重组子不出现
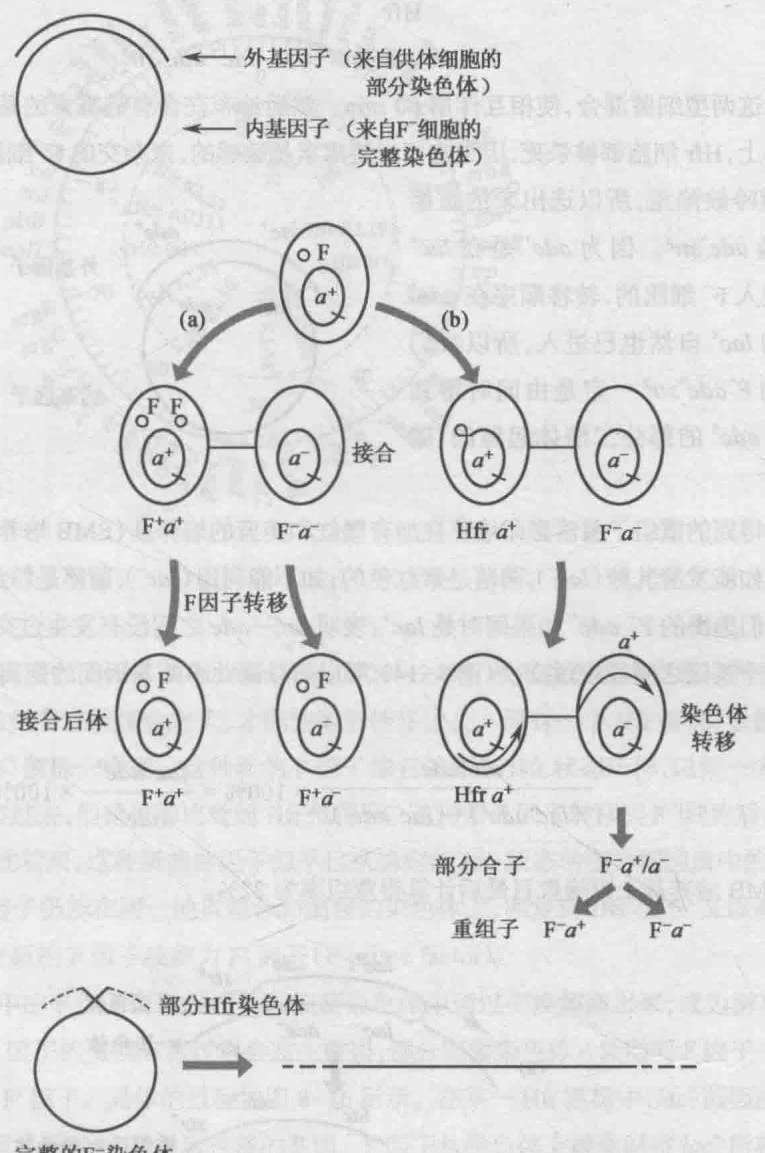
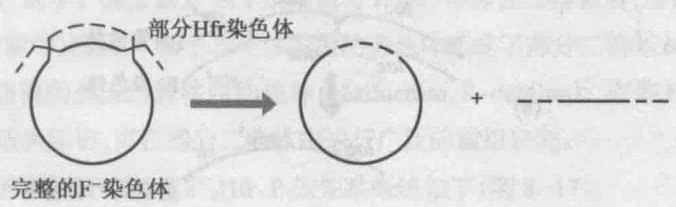
六、重组作图
在中断杂交实验中,可以根据基因转移的先后次序,以时间为单位,得出基因的连锁关系。如果两基因间转移的时间单位接近2 min,那么用中断杂交技术测定基因间的图距就不很可靠。这时可用传统的重组作图法。
例如有两个基因,lac 和 ade,根据中断杂交实验,知道这两基因是紧密连锁的,而且就某些 Hfr 供体来说,ade 是 lac 之后进入 F 受体的。这样我们就可以做如下杂交实验:
1 | \begin{array}{c c c} \text {Hfr} & & \text {F} ^ {-} \\ l a c ^ {+} a d e ^ {+} s t r ^ {\mathrm{s}} & \times & l a c ^ {-} a d e ^ {-} s t r ^ {\mathrm{r}} \end{array} |
把这两型细菌混合,使相互作用 60 min。然后涂布在含有链霉素的基本培养基上。在这种培养基上,Hfr 细胞都被杀死,因为它们对链霉素是敏感的,未杂交的 F⁻ 细胞也被杀死,因为它们
子都是 $ade^{+}str^{r}$ 。因为 $ade^{+}$ 是在 $lac^{+}$ 之后进入 $F^{-}$ 细胞的,转移顺序在 $ade^{+}$ 前面的 $lac^{+}$ 自然也已进入,所以我们选出的 $F^{-}ade^{+}str^{r}$ 一定是由同时得到 $lac^{+}$ 和 $ade^{+}$ 的部分二倍体起源的(图8-13)。
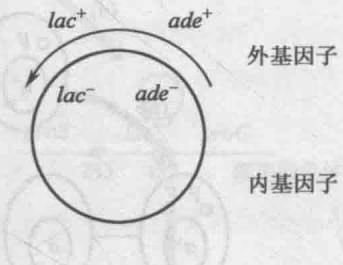
把得到的重组子菌落影印培养在加有曙红和美蓝的培养基(EMB 培养基)上,鉴定能否利用乳糖。如能发酵乳糖 $(lac^{+})$ ,菌落是紫红色的;如不能利用 $(lac^{-})$ ,菌落是粉红色的。
我们选得的 $F^{-}ade^{+}$ 如果同时是 $lac^{+}$ ,表明 lac—ade 之间没有发生过交换;如果是 $lac^{-}$ ,表明在这两个基因之间发生过交换(图 8-14),所以可以据此求两基因间的距离,或所谓重组率,用下式表示:
1 | \frac {l a c ^ {-} a d e ^ {+}}{(l a c ^ {+} a d e ^ {+}) + (l a c ^ {-} a d e ^ {+})} \times 100 \% = \frac {l a c ^ {-} a d e ^ {+}}{a d e ^ {+}} \times 100 \% |
根据 EMB 培养基上克隆数目最后计算得重组率为 22%。
(b)
(a) 重组子同时含有供体标记基因 $lac^{+}$ ,基因型是 $lac^{+}ade^{+}$ 。(b) 重组子只含有 $ade^{+}$ ,基因型是 $lac^{-}ade^{+}$ 。
像 lac 和 ade 这样两个基因座,根据中断杂交技术中的时间单位方法,距离是 1 min,用重组方法,重组率是 22%,时间单位和重组率的关系,大致上是,1 个时间单位(1 min)相当于 20% 重组率。用重组率所测得的基因间距离和由 Hfr 基因进入 F 细菌的时间先后所测得的基因间距离基本上是符合的。
遗传学家在20世纪80年代根据中断杂交实验、基因重组实验以及其他基因定位实验的结果,绘制出大肠杆菌的环状遗传学图,包括52个准确定位的基因座和数百个初步定位的基因(图8-15)。
图 8-15 大肠杆菌 K-12 的环状遗传学图(引自 Gardner, 1984)
外圈内的阿拉伯数字标明基因在图上的位置。图距单位是min,根据中断杂交技术的结果定下来的。从thr基因座起算,把它的位置定为0 min,循着时针方向依次递加,直到100 min。图上标明了共52个确切的基因座,是菌株K-12连锁图上的常用界标。内圈表示几个Hfr菌株染色体的进入位置和转移方向。
七、性导
在 1959 年阿德尔贝格 (Edward Allen Adelberg, 1920—2009) 在大肠杆菌中发现一种新的 F 因子。正常的 Hfr 菌株只有在性接合之末,才把性因子转移进去。而有一个 Hfr 菌株,它的性因子的转移频率似乎跟 F⁺ 菌株一样高。这种新的 F 因子像它的原来 Hfr 状态一样,以同一方向和顺序把细菌染色体转移过去,但是效率比普通 Hfr 低得多。这种新 F 因子转移到 F⁻ 细胞后,使 F⁻ 细胞变为 F⁺ 细胞。由此看来,这种新的性因子似乎已从稳定的 Hfr 状态转变为细胞质中的 F⁺ 状态。但是这种新的 F 因子仍能在同一地点整合到细菌的染色体上,回复到 Hfr 状态,又以高频率转移细菌染色体。这种新的 F 因子被称为 F’ 因子 (F-prime factor)。
原来,整合在 Hfr 中的 F 因子可以反过来从细菌染色体中通过交换解离出来,成为游离的 F 因子。但是,有时候,F 因子的交换解离过程会发生错误,部分细菌染色体片段随同 F 因子一起脱离染色体,这就形成了 F’ 因子。具体的过程如图 8-16 所示。在某一 Hfr 菌株中, $lac^{+}$ 基因座接近 Hfr 染色体的末端,也就是说, $lac^{+}$ 是最后转移的基因。F 因子从染色体上解离时将 $lac^{+}$ 所在的基因片段一起切下,形成 F’ 因子。携带该 F’ 因子的细菌与 $F^{-}lac^{-}$ 细菌发生接合后,可以高频率地将 $lac^{+}$ 基因转移到受体细菌中,而且 F’ 因子与受体细菌的染色体形成了部分二倍体 $lac^{+}/lac^{-}$ 。
利用 F’ 因子进行细菌间基因的转移叫作性导(sexduction, F-duction)。有些 F’ 因子带有大部分的细菌染色体,如适当标记,可在部分二倍体中进行广泛的重组研究。
最后,把雄性菌株的不同致育因子 $F’$ 、Hfr、F的关系概述如下(图8-17)。
(1) F’ 是带有部分细菌染色体的 F 因子, 它的性质介于 F 和 Hfr 之间。Hfr 可以形成带有部分细菌染色体的 F’ 因子, 而 F’ 因子又可重新整合到细菌染色体上的原来位置, 回复到以前的 Hfr 状态。
(2) F’ 因子连同它所带有的部分细菌染色体可一起转移到 F⁻ 细胞, 其转移速率近于 F 因子。利用 F’ 可以形成部分二倍体, 进行重组研究。F’ 因子偶尔也可把它所在的供体细菌的染色体转移到 F⁻ 细胞, 基因的转移方向和顺序跟 F’ 所来自的 Hfr 一样。
整合在染色体中的F因子
(a) Hfr 菌株中, F 因子的不精确解离将部分染色体基因片段一同切下 $(lac^{+})$ , 形成 $F’$ 因子。(b) 在新的接合受体细菌中, $F’$ 因子与细菌染色体形成了部分二倍体。
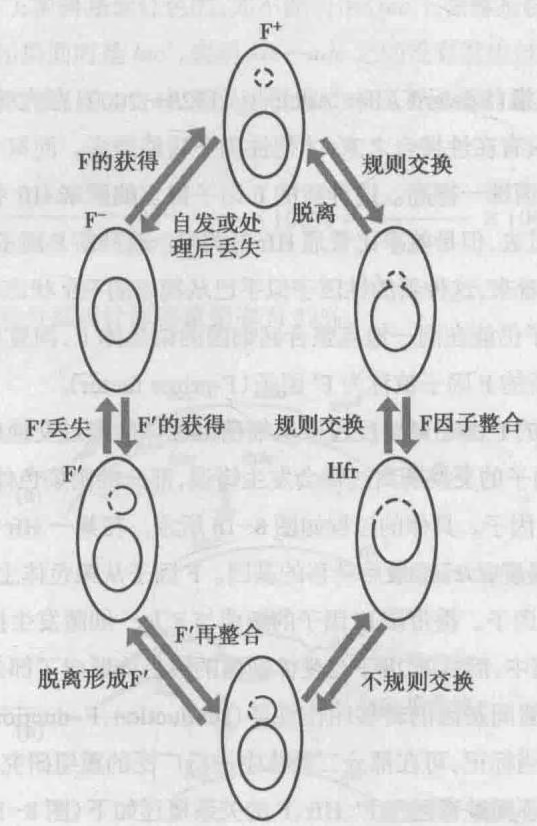
图 8-17 大肠杆菌不同致育因子间的关系
在大肠杆菌细胞内, 小圆形(虚线)的 F 质粒和大圆形(实线)的细菌染色体间, 通过交换和重组、整合和脱离, 形成 Hfr、 $F^{+}$ 或 $F’$ 。
(3) 有 F 因子的细胞是 $F^{+}$ 细胞, 没有 F 因子的细胞是 $F^{-}$ 细胞。每一 $F^{+}$ 细菌有 1~3 个 F 因子, F 因子的复制是自主进行的。 $F^{+}$ 与 $F^{-}$ 杂交, F 因子由 $F^{+}$ 进入 $F^{-}$ , 使受体细胞成为 $F^{+}$ , 但供体细胞仍为 $F^{+}$ , 且其染色体很少转移。F 因子可通过简单交换整合到细菌染色体上, 形成 Hfr 染色体。反过来, 通过简单交换, 又可从 Hfr 染色体解离产生 F 因子。不同的 Hfr 菌株的染色体转移起始点和方向不同, 这是由于 F 因子整合的位置和方向不同的缘故。
(4) Hfr 能以高频率把细菌染色体转移到 $F^{-}$ 细菌中, 而 F 因子因位于 Hfr 染色体的最末端, 极少进入。F 因子很容易转移到 $F^{-}$ 细胞中, 但供体染色体的转移率很低。 $F’$ 因子可以将自身连接的部分染色体基因以较高的频率转移到 $F^{-}$ 细胞中。
第三节 噬菌体的遗传分析
很多细菌都能被噬菌体感染。噬菌体是化学成分最简单的生物,它没有一般的细胞结构,由核酸和蛋白质外壳构成。不同噬菌体的结构和大小差异悬殊,图8-18给出了几种噬菌体的形态和相对大小。
一、烈性噬菌体
烈性噬菌体(virulent phage)是使宿主菌发生裂解的噬菌体。它在侵染细菌时,先吸附到菌体表面的特异受体上,利用自身编码的酶的作用在细菌细胞壁上形成一个微孔,把它头部所含的遗传物质——核酸注入菌体内。噬菌体核酸所带的遗传信息把宿主菌的生物合成装置接收过来,停止合成细菌成分,转为合成更多的噬菌体成分,最后细菌细胞裂解,释放出很多子代噬菌体(图8-19)。
虽然噬菌体非常小,只有在电子显微镜下才能看到,但它有一些特殊的遗传性状易于研究,例如噬菌斑形态。一个噬菌体裂解一个细菌后,子代噬菌体感染邻近的细菌,这些细菌又裂解,再侵染其他细菌,这是一个指数增加的现象。这种实验开始后,过一夜,第二天就可在长满细菌的不透明菌苔上看到一个圆形的透明区——噬菌斑(plaque)。一个噬菌斑中通常含有
图8-18 几种噬菌体的形状和它们的相对大小
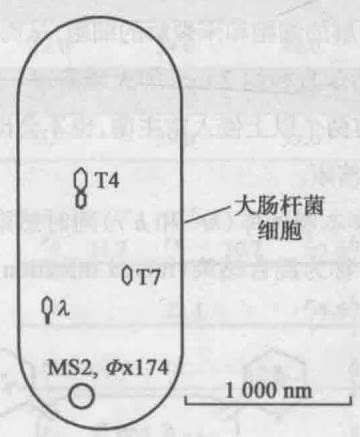
$10^{7}\sim10^{8}$ 噬菌体,这是由一个噬菌体起源的。所以一个噬菌斑中的噬菌体在遗传上是均一的,相当于一个克隆。由于不同噬菌体的基因型不同,噬菌斑可以是大的或小的,边缘清晰的或模糊的,等等。除了噬菌斑,遗传上可以分析的噬菌体性状还有宿主范围(host range),某些细菌菌株不受噬菌体的吸附,而噬菌体能感染和裂解的细菌菌株也可以不同。
噬菌体遗传物质
图8-19 烈性噬菌体的生活史
(a)感染,噬菌体粒子以尾部吸附在菌体上,没有尾部的噬菌体可能直接吸附在菌体上,或通过性伞毛等。(b)噬菌体遗传物质进入细菌细胞质中。(c)细菌染色体断裂,噬菌体遗传物质复制。(d)噬菌体遗传物质继续复制,根据噬菌体的基因合成噬菌体蛋白质。(e)噬菌体遗传物质和噬菌体蛋白质结合,形成子代噬菌体。(f)菌体裂解,噬菌体释放出来。
二、噬菌体的基因重组
从野生型噬菌体可以分离出突变型,各突变型的性质可以传给后裔。用两种突变型噬菌体感染同一宿主菌,它们的后裔可以出现重组子。在20世纪40年代早期,德尔布吕克就注意到了噬菌体的这些性质,进行了遗传学分析。
我们现在来看烈性噬菌体 T2 的两对性状及其重组。
第一对性状有关宿主范围(h)。野生型 $h^{+}$ 噬菌体能侵染和裂解大肠杆菌菌株B,但不能侵染菌株B/2,因为菌株B/2的细胞表面能阻止噬菌体对它的吸附。所以把野生型噬菌体接种到B和B/2的混合培养物时,噬菌斑是半透明的。突变型h的宿主范围扩大,除了能够侵染菌株B外,还能侵染菌株B/2,所以接种到B和B/2的混合培养物后,能够形成透明的噬菌斑。
另一对性状有关噬菌斑形态。野生型 $r^{+}$ 噬菌体在侵染细菌后,形成小噬菌斑,直径1 mm左右,周边有朦胧的光环。光环是这样形成的:早期受侵染的细菌裂解后,形成侵染中心,由此释放的噬菌体数量增多,往往有两个以上的噬菌体侵染一个细菌,这时出现溶菌阻碍现象,使宿主菌的裂解延迟,所以侵染中心的外周混有裂解的细胞和未裂解的细胞,从而在周边形成朦胧的光环。在众多的野生型小噬菌斑中,偶尔会出现直径约2 mm的大噬菌斑。这是由称为快速溶菌的突变型r噬菌体引起的。r噬菌体即使有两个以上侵入宿主菌,也不会出现溶菌阻碍现象,所以r噬菌体形成的噬菌斑不仅大,而且边缘清晰。
进行重组实验时,将上述两个突变型亲本噬菌体 $(hr^{+}$ 和 $h^{+}r)$ 同时感染菌株B,噬菌体的浓度要高,细菌同时受到两种噬菌体的感染,称为混合感染(mixed infection)或双重感染(double
infection)(图 8-20)。把释放出来的噬菌体(子代噬菌体)接种在同时长有菌株B和B/2的培养基上,可以看到4种噬菌斑(表8-4,图8-21)。
表 8-4 {hr}^{ + } \times {h}^{ + }r 中出现的 4 种噬菌斑
| 表型 | 推导的基因型 |
|---|---|
| 透明,小 | $hr^{+}$ |
| 半透明,大 | $h^{+}r$ |
| 半透明,小 | $h^{+}r^{+}$ |
| 透明,大 | hr |
图 8-21 4 种噬菌斑照片(引自 Strickberger, 1976)
把宿主范围突变型 $(hr^{+})$ 和快速溶菌突变型 $(h^{+}r)$ 的噬菌体对菌株B和B/2进行混合感染,结果可以看到4种不同噬菌斑。
4种噬菌斑中,透明而小 $(hr^{+})$ 和半透明而大 $(h^{+}r)$ 是亲组合,半透明而小 $(h^{+}r^{+})$ 和透明而大 $(hr)$ 是重组合。所以重组率可用下式计算:
1 | \mathrm{重组率} = \frac {\mathrm{重组噬菌斑数}}{\mathrm{总噬菌斑数}} = \frac {(h ^ {+} r ^ {+}) + (h r)}{\mathrm{总噬菌斑数}} \times 100 |
用上述公式求得的重组率,去掉%,通常即可作为图距。不同的快速溶菌突变型在表型上不同,记作 $r_{a},r_{b},r_{c}$ 等。用不同快速溶菌突变型 $(h^{+}r_{x})$ 与宿主范围突变型 $(hr^{+})$ 杂交,结果如表8-5。
我们可以根据表8-5的结果,作一连锁图。亲组合 $(h^{+}r$ 和 $hr^{+})$ 出现的频率愈高,重组合的频率愈低,重组率随 $r$ 基因的不同而有变化。3种不同的重组值,表示3个 $r$ 基因的基因座是不同的,所以有4种可能的连锁图(图8-22)。
我们能在这些可能的排列间作出抉择吗?首先我们只考虑 $r_b, r_c$ 和 $h$ ,看排列顺序是 $r_c - h - r_b$ ,还是 $h - r_c - r_b$ 。我们进行杂交 r_c r_b^+ \times r_c^+ r_b ,把得到的重组率跟 $r_b - h$ 间的距离比较。如 $r_c - r_b$ 的重组率大于 $r_b - h = 12.3$ ,我们可以认为 $h$ 位于 $r_b$ 和 $r_c$ 之间,实验结果证明排列顺序是 $r_c - h - r_b$ 。
表 8-5 h^{+}r_{x} \times hr^{+} ,出现的4种噬菌斑的数目和求得的重组率( $r_{x}$ 代表不同的r基因)
| 杂交 | 每一基因型的% | 重组率 | |||
| $h^{+}r^{+}$ | $h^{+}r_{x}$ | $hr^{+}$ | $hr_{x}$ | ||
| h^{+}r_{a}\times hr^{+} | 12.0 | 34.0 | 42.0 | 12.0 | 24/100=24.0% |
| h^{+}r_{b}\times hr^{+} | 5.9 | 32.0 | 56.0 | 6.4 | 12.3/100.3=12.3% |
| h^{+}r_{c}\times hr^{+} | 0.7 | 39.0 | 59.0 | 0.9 | 1.6/99.6=1.6% |
图8-22 $r$ 基因与 $h$ 基因的连锁图
根据3个 $r$ 基因与 $h$ 的重组值,可以有4种不同的基因顺序。
$r_{a}$ 11.7 $r_{b}$ 10.7 $r_{c}$ 1.6 h $r_{a}$ 22.4 $r_{c}$ 1.6 h 12.3 $r_{b}$ $r_{a}$ 11.7 $r_{b}$ 12.3 $h$ 1.6 $r_{c}$ $r_{a}$ 24.0 $h$ 1.6 $r_{c}$ 10.7 $r_{b}$
剩下来的问题是 $r_a$ 在 $h$ 的哪一边?靠近 $r_b$ 还是靠近 $r_c$ ?这个问题不能单把 $r_a$ 跟 $r_b$ 和 $r_c$ 杂交来回答,因为资料得不出明确的答案。当很多不同的T2品系被发现后,我们才发现两种排列顺序都是正确的。为什么 $r_a - r_c - h - r_b$ 和 $r_c - h - r_b - r_a$ 都正确呢?原来T2噬菌体的连锁图也是环状的
(图 8-23)。事实上,T2 连锁群的图距总长约有 1500 图距单位。
三、溶原性细菌
烈性噬菌体感染细菌后,总是使菌体裂解。而另一类噬菌体感染细菌后,除偶尔情况外,不出现溶菌现象。这一类噬菌体被称为温和噬菌体(temperate phage)。
温和噬菌体感染细菌后,可采取两种增殖周期中的一种(图 8-24)。其中一种是溶菌周期,细菌受到感染后,菌体内噬菌体迅速增殖,菌体被裂解,子代噬菌体释放出来。这一周期是温和噬菌体偶尔自发产生的,但是烈性噬菌体所必然采取的。另一种是溶原周期,细菌受噬菌体感染后,好像未被感染一样,细菌继续增殖。这时受感染的细菌具有下列两个特征:
① 细菌细胞内已有了侵入的噬菌体,再也不会受到同一种噬菌体的侵染,也就是说,有了免疫性。这种免疫性的特异程度很高。例如受 $\lambda$ 噬菌体侵染的细菌仅对 $\lambda$ 噬菌体有免疫性,对其他温和噬菌体就没有免疫性,仍可被感染。
② 这种细菌即使没有外来噬菌体的感染,偶尔也会自发地释放噬菌体。如用紫外线照射,或以丝裂霉素 C 等化学药剂处理,进行诱导,则能释放成熟噬菌体。
像这样,有些细菌带有某种噬菌体,但并不立即导致溶菌,这种现象称为溶原性(lysogeny),而这样的细菌称为溶原性细菌或溶原菌(lysogenic bacteria)。受温和噬菌体感染的细菌,几乎都成为溶原菌,而且能把这种特性传给子代细胞。从单个溶原菌开始的培养中,所有的细菌都是溶原菌,只要不进行诱导,溶原性可以半永久性地传下去。
细菌的溶原性能一代代传下去,在诱导后又能产生成熟的噬菌体,所以细菌细胞内必然含有
温和噬菌体侵染细菌后,或进入溶菌周期,噬菌体增殖,菌体裂解后,成熟噬菌体释放出来。或进入溶原周期,溶原性形成,溶原菌特性一代代传下去;但在紫外线诱导时,或在偶尔自发溶菌时,即转入溶菌周期。“○”表示原噬菌体。
无感染能力的噬菌体。如把处于这种状态的噬菌体称为原噬菌体(prophage),那么原噬菌体以何种方式存在于细菌细胞内呢?它在细胞质中是否有多份拷贝?它是否与染色体联系在一起呢?现在知道,溶原菌中原噬菌体的存在形式有两种:一种是染色体外以游离形式存在,另一种是整合到细菌染色体上。原噬菌体在细菌细胞中采取哪一种形式视噬菌体的种类而定。P1以游离状态存在,而 $\lambda$ 以及 $\phi 80, \mu$ 等以整合状态存在(图8-25)。
图 8-25 溶原菌中原噬菌体的存在形式
(a) 游离于细胞质中, 复制与细菌染色体不同步。原噬菌体数一般比染色体多。(b) 整合到细菌染色体中, 复制与染色体同步。整合的位置视噬菌体的种类而定。
(a)
(b)
事有巧合,莱德伯格等所用的原始大肠杆菌菌株对于 $\lambda$ 温和噬菌体来说是溶原菌。 $\lambda$ 噬菌体是一种富有特点的噬菌体,受到了广泛的研究。值得注意的是,如果 $F^{+}$ 与 $F^{-}$ 细胞间进行杂交,发现杂交结果与所用的溶原菌菌株有关。如 F^{+} \times F^{-}(\lambda) ,即 $F^{-}$ 细胞是带有 $\lambda$ 噬菌体的溶原菌时,可偶尔产生溶原性重组子;而反交 F^{+}(\lambda) \times F^{-} ,即 $F^{+}$ 细胞是带有 $\lambda$ 噬菌体的溶原菌时,几乎不产生溶原性重组子。那么这些结果该如何解释呢?
当 Hfr 菌株被用于遗传学分析以后, 这些结果就容易理解了。在杂交 \mathrm{Hfr} \times \mathrm{F}^{-}(\lambda) 中, Hfr 基因转移到 $F^{-}$ 细胞, 所以有 Hfr 基因的溶原性 $F^{-}$ 重组子很容易得到。然而在反交 \mathrm{Hfr}(\lambda) \times \mathrm{F}^{-} 中, Hfr 菌株的前端基因可在 $F^{-}$ 受体中出现, 但后端基因的重组子得不到。因为溶原性 Hfr 跟非溶原性 $F^{-}$ 受体杂交时, 经过一定时间, $\lambda$ 原噬菌体进入一个无免疫能力的细胞, 原噬菌体随即开始复制, 使细胞裂解, 释放出游离的噬菌体, 这个现象叫作合子诱导 (zygotic induction)。原噬菌体进入非溶原性细胞后, 使受体细胞裂解, 这样在 $\lambda$ 噬菌体转移以后才进入 $F^{-}$ 细胞的 Hfr 后端基因就无法得到了。上面谈到的 \mathrm{F}^{+}(\lambda) \times \mathrm{F}^{-} 几乎不出现溶原性重组子, 就是因为 $\lambda$ 进入 $F^{-}$ 细胞后, 使 $F^{-}$ 细胞裂解, 所以就得不到溶原性重组子了。
通过中断杂交技术可以证明, $\lambda$ 原噬菌体在一特定时间进入F细胞,这时间跟gal的进入时间密切有关,表示 $\lambda$ 原噬菌体所在的地点就在gal基因座的附近。关于这一点,下一节中还要谈到。
四、转导
细菌杂交发现以后,过了几年又发现了转导(transduction)。转导是指以噬菌体为媒介,将细菌的小片段染色体或基因从一个细菌转移到另一个细菌的过程。转导有两种,一为普遍性转导,一为特异性转导。
(1) 普遍性转导 细菌杂交是在大肠杆菌中发现的。1951年, 莱德伯格和津德(Norton David Zinder, 1928—2018)为了了解鼠伤寒沙门氏菌(Salmonella typhimurium)中是否也有同样现象, 用沙门氏菌的两个突变菌株进行实验, 一个菌株是phe try tyr⁻, 另一突变株是met his⁻。这两菌株分别在基本培养基上培养时, 没有发现野生型细胞。然而把这两突变株在基本培养基上进行混合培养时, 大约在 $10^{5}$ 细胞中得到一个原养型菌落, 这个频率好像跟大肠杆菌的重组没
有什么不同。
然而将这两菌株放入 U 型管的两臂, 中间用一滤板隔开, 防止细胞接触, 结果也得到了野生型细胞。这说明沙门氏菌的基因重组不是通过细胞接合, 而是通过过滤因子而发生的。之后发现这过滤因子就是噬菌体 P22——一种已知的沙门氏菌的温和噬菌体, 因为: ① 过滤因子的大小和质量与 P22 相同; ② 过滤因子用抗 P22 血清处理后失活。这项实验虽然没有证明沙门氏菌中有接合现象, 却发现了由噬菌体介导的基因转移过程——转导。
现在知道,P22感染细菌细胞时,细菌染色体断裂成小片段。在形成噬菌体颗粒时,偶尔错误地将细菌染色体的片段,而不是其自己的遗传物质组合到头部。因为决定感染细菌能力的是外壳蛋白质,所以这种病毒或转导颗粒可以吸附到细菌细胞上,注入它们的内容物,现在这内容物包含了宿主细菌的部分基因。当转导中的噬菌体内容物注入一个受体细胞后,形成一个部分二倍体,然后导入的基因通过重组,整合到宿主菌的染色体上,就形成转导子(图8-26)。
利用转导和部分二倍体,还可测定细菌基因间的连锁关系。例如,用大肠杆菌的 P1 噬菌体进行下列转导实验:
1 | \text { 供体 } t h r ^ {+} l e u ^ {+} a r a ^ {+} \longrightarrow \text { 受体 } t h r ^ {-} l e u ^ {-} a r a ^ {-} |
我们可以在受体中选择一个或几个供体的标记基因,然后鉴定非选择性标记基因的有或无(表8-6)。
噬菌体 P22 感染野生型 $(leu^{+})$ 菌株,细菌染色体断裂成片段,小段细菌染色体偶尔组合到噬菌体头部。细菌裂解,释放出的转导颗粒再感染缺陷型受体细胞 $(leu^{-}$ ,亮氨酸缺陷型),把从野生型供体来的染色体片段注入,形成部分二倍体。注入的染色体片段跟受体染色体的相应部分发生重组,把受体细胞转导为原养型 $(leu^{+})$ 。如果受体细胞被一正常的 P22 颗粒感染时,或使受体细胞裂解,或成为溶原菌。
表 8-6 用 P1 进行的大肠杆菌的转导实验
| 选择标记 | 非选择标记 |
|---|---|
| $leu^{+}$ | 50% $azi^{r}$ ,2% $thr^{+}$ |
| $thr^{+}$ | 3% $leu^{+}$ ,0% $azi^{r}$ |
| $thr^{+}leu^{+}$ | 0% $azi^{r}$ |
以 $leu^{+}$ 为选择标记, 得知被转导的供体菌染色体中, 同时有 50% 为 $azi^{r}$ , 2% 为 $thr^{+}$ 。这表明 leu 比较靠近 azi, 而离 thr 较远。所以排列顺序是
| thr | azi | leu |
|---|---|---|
或
| thr | leu | azi |
|---|---|---|
以 $thr^{+}$ 为选择标记, 发现同时被转导到受体菌的, 有 3% 为 $leu^{+}$ , 而未检出有 $azi^{r}$ , 这表明 thr 比较靠近 leu, 所以基因顺序应该是:
| thr | leu | azi |
|---|---|---|
如果同时选择 $thr^{+}$ 和 $leu^{+}$ ,则被转导的受体菌染色体中都没有包括 azi。这样看来,转移噬菌体所带有的供体菌染色体片段从 thr 开始,有时延伸到 leu,但没有扩展到 azi 的。根据细菌接合实验等,这段染色体长度相当于细菌染色体的 1/100,大致上也就是噬菌体染色体的长度。
一般地说,根据转导实验构建的遗传学图与依照接合实验作成的遗传学图是一致的,但前者更为精细些。
上面谈到的 P22、P1 这一类噬菌体可以转移细菌染色体的很多不同部分, 所以称为普遍性转导 (generalized transduction)。
(2) 特异性转导 我们现在介绍另一类噬菌体, 它们所进行的转导是特异性转导(specialized transduction)或局限性转导(restricted transduction), 这类噬菌体只转移细菌染色体的特定部分。
上面讲到过的 $\lambda$ 噬菌体是特异转导者的一个很好例子。大肠杆菌的一个溶原菌株K-12(λ)可由紫外线诱导用来进行转导。唯一成功的转导包括gal基因座。根据实验知道, $\lambda$ 总是附看到gal座位的邻近位置,该位置含有 $\lambda$ 噬菌体整合所需的特定序列。 $gal^{+}$ 供体 $\rightarrow$ $gal^{-}$ 受体的转导过程可用图8-27的模式简要地说明。转导过程中有一些值得注意的特点:
① 所有 $gal^{+}$ 转导子对 $\lambda$ 噬菌体的超数感染都是免疫的,但 $gal^{+}$ 转导子在菌体裂解时不能产生成熟的 $\lambda$ 噬菌体,可见带有 $gal^{+}$ 的 $\lambda$ 噬菌体是有缺陷的,记作 $\lambda d , gal^{+} (\lambda - defective , gal^{+})$ 。
图8-27 $\lambda$ 噬菌体的特异性转导的模式说明
图中小黑方格代表整合位置(integration site)。1. $\lambda$ 噬菌体附着到E.coli染色体的 $gal^{+}$ 座位附近,噬菌体染色体通过交换整合到细菌染色体,成为原噬菌体。带有原噬菌体的细菌菌株K-12成为溶原菌K-12( $\lambda$ )。2. 通过不规则交换,产生转导噬菌体 $\lambda d gal^{+}$ 。转导噬菌体约丧失 $25%$ 的噬菌体基因,却获得了整合位置附近的细菌基因 $gal^{+}$ 等。3. 转导噬菌体 $\lambda d gal^{+}$ 感染 $gal^{-}$ 细菌,形成转导子 $\lambda d gal^{+}/gal^{-}$ 。转导子中少数是稳定的 $gal^{+}$ 型,这是由gal座位上的重组形成的(3a);但大多数是不稳定转导子,是 $\lambda d gal^{+}/gal^{-}$ 型(3b)。4. 不稳定转导子在少数情况下会分离出 $gal^{-}$ 细胞,这可用 $\lambda d gal^{+}$ 染色体的切除来说明,因为 $\lambda d$ 不能复制,所以在细胞分裂中丢失或被稀释。
② $\lambda d gal^{+}$ 转导颗粒丧失约 25% 的噬菌体染色体,但具有完整的 $\lambda$ 外壳,所以仍能感染细菌。
③ 以 $\lambda d\ gal^{+}$ 转导颗粒去感染 $gal^{-}$ 细菌, 所形成的 $gal^{+}$ 转导子中有相当一部分是不稳定的, 能持续地产生 $gal^{-}$ 分离子 (segregant), 这些不稳定转导子是部分二倍体, 除了含有受体染色体上的 $gal^{-}$ 外, 还有 $\lambda d$ 原噬菌体上的 $gal^{+}$ , 基因型为 $\lambda d\ gal^{+}/gal^{-}$ 。
最后关于细菌和病毒的遗传分析还要说几句话。在20世纪40年代以前,人们认为细菌的分裂是无丝的(amitotic),那时自然不会想到细菌会有类似于性过程的现象。40年代以后,由于细菌和病毒遗传学的迅速发展,不仅了解了细菌和病毒染色体的结构,还知道了细菌和病毒染色体的复制形式,而且还发现细菌有类似于性过程的现象,以及细菌和病毒的基因连锁和基因重组。学习细菌和病毒的遗传分析,不仅使我们认识到遗传规律在微生物和高等生物中的一致性,而且还使我们意识到,学习细菌和病毒的遗传分析方法,对我们的实验设计和结果分析也具有相当大的帮助与启发。
习题
1.为什么说细菌和病毒是遗传学研究的好材料?
大肠杆菌的遗传物质的传递方式与具有典型减数分裂过程的生物有什么不同?
解释下列名词: $F^{-}$ 菌株, $F^{+}$ 菌株, Hfr 菌株; F 因子, $F’$ 因子, 质粒, 附加体; 溶原性细菌, 非溶原性细菌; 烈性噬菌体, 温和噬菌体, 原噬菌体; 部分合子 (部分二倍体)。
部分合子在细菌的遗传分析中有什么用处?
什么叫转导、普遍性转导、特异性转导(局限性转导)?
转导和性导有何不同?
一个基因型为 $a^{+}b^{+}c^{+}d^{+}e^{+}$ 并对链霉素敏感的大肠杆菌 Hfr 菌株与基因型为 $a^{-}b^{-}c^{-}d^{-}e^{-}$ 并对链霉素抗性的 F-菌株接合, 30 min 后, 用链霉素处理, 然后从成活的受体中选出 e+ 型的原养型, 发现它们的其他野生型 (+) 基因频率如下: $a^{+}70%$ , $b^{+}0%$ , $c^{+}85%$ , $d^{+}10%$ 。问: $a, b, c, d$ 个基因与供体染色体起点 (最先进入 F-受体之点) 相对位置如何?
为了能在接合后检出重组子, 必须要有一个可供选择用的供体标记基因, 这样可以认出重组子。另一方面, 在选择重组子的时候, 为了不选择供体细胞本身, 必须防止供体菌株的继续存在, 换句话说, 供体菌株也应带有一个特殊标记, 能使它自己不被选择。例如供体菌株是链霉素敏感的, 这样当结合体在含有链霉素的培养基上生长时, 供体菌株就被杀死了。问: 如果一个 Hfr 菌株是链霉素敏感的, 你认为这个基因应位于染色体的哪一端为好, 是在起始端还是在末端?
有一个环境条件能使 T 偶数噬菌体 (T-even phages) 吸附到寄主细胞上, 这个环境条件就是色氨酸的存在。这种噬菌体称为色氨酸需要型 (C)。然而某些噬菌体突变成色氨酸非依赖型 $(C^{+})$ 。有趣的是, 当用 $C$ 和 $C^{+}$ 噬菌体感染细菌时, 将近一半的色氨酸非依赖型子代在进一步的实验中表现为基因型 $C$ 。你如何解释这个发现?
Doerman 用 T4 噬菌体的两个品系感染大肠杆菌。一个品系是小噬菌斑(m)、快速溶菌(r)和浑浊噬菌斑(tu)突变型。另一个品系对这 3 个标记都是野生型(+++)。把这种感染的溶菌产物涂平板,并分类如下:
| 基因型 | 噬菌斑数 | ||
| m | r | tu | 3467 |
| + | + | + | 3729 |
| m | r | + | 853 |
| m | + | tu | 162 |
| m | + | + | 520 |
| + | r | tu | 474 |
| + | r | + | 172 |
| + | + | tu | 965 |
| 10342 | |||
问:①计算 m-r,r-tu 和 m-tu 的连锁距离。②你认为这 3 个基因的连锁序列怎样?③在这个杂交中,并发系数是多少?它意味着什么?
- 用一野生型菌株抽提出来的 DNA 来转化一个不能合成丙氨酸(Ala)、脯氨酸(Pro)和精氨酸(Arg)的突变型菌株, 产生不同转化类型的菌落, 其数如下:

1 | arrayl l l l 8 4 0 0 & a l a ^ + p r o ^ + a r g ^ + & 8 4 0 & a l a ^ + p r o ^ - a r g ^ - |
问:①这些基因间的图距为多少? ②这些基因的顺序如何?
- 利用中断杂交技术, 检查了 5 个 Hfr 菌株 (1,2,3,4,5), 想知道这几个菌株把若干不同基因 (F,G,O,P,Q,R,S,W,X,Y) 转移到一个 F-菌株的顺序。结果发现, 各个 Hfr 菌株都以自己特有的顺序转移, 如下所示 (各品系只记下最初转移进去的 6 个基因):
| 转移顺序 | Hfr菌株 | ||||
| 1 | 2 | 3 | 4 | 5 | |
| 第一 | Q | Y | R | O | Q |
| 第二 | S | G | S | P | W |
| 第三 | R | F | Q | R | X |
| 第四 | P | O | W | S | Y |
| 第五 | O | P | X | Q | G |
| 第六 | F | R | Y | W | F |
问:这些 Hfr 菌株的原始菌株的基因顺序如何? (提示:Hfr 品系是环状 DNA。)
- 为了检出λ噬菌体的4个基因 $(co_{1},mi,c$ 和s)间的连锁关系,Kaiser做了一个杂交实验,下面是杂交结果的一部分数据:
| 亲本 | 子代 |
|---|---|
| (a) $co_1+×+mi$ | 5162 $co_1+$ ,6510+mi,311++,341 $co_1mi$ |
| (b) $mi+×+s$ | 502 $mi+$ ,647+s,65++,56 $mi s$ |
| (c) $c+×+s$ | 566 $c+$ ,808+s,19++,20 $cs$ |
| (d) $c+×+mi$ | 1213 $c+$ ,1205+mi,84++,75 $cm i$ |
问:①每个杂交组合的重组率是多少? ②画出 $co_{1}$ , mi, c 和 s4 个基因的连锁图。
- 用 P1 进行普遍性转导, 供体菌是 $pur^{+}nad^{+}pdx^{-}$ , 受体菌是 $pur^{-}nad^{-}pdx^{+}$ 。转导后选择具有 $pur^{+}$ 的转导子, 然后在 100 个 $pur^{+}$ 转导子中鉴定其他供体菌基因有否也转导过来。所得结果如右表:
| 基因型 | 菌落数 |
|---|---|
| $nad^{+}pdx^{+}$ | 1 |
| $nad^{+}pdx^{-}$ | 24 |
| $nad^{-}pdx^{+}$ | 50 |
| $nad^{-}pdx^{-}$ | 25 |
| 合计 | 100 |
问:①pur 和 nad 的共转导频率是多少? ②pur 和 pdx 的共转导频率是多少? ③哪个非选择性基因座最靠近 pur? ④nad 和 pdx 在 pur 的同一侧,还是在它的两侧? ⑤根据你得出的基因顺序,解释实验中得到的基因型的相对比例。
数字课程学习
在线自测 习题答案