生物信息学导论:学科定位、数据与检索
编者导语
本板块是全书的入口,回答三个问题:这门学科在做什么、数据存在哪里、怎么找。 它把原来的学科导论、中文教材的开篇与数据库检索三段合在一起——因为读者在 动手算之前必须先建立坐标系,而这三件事其实是一件事:先知道在算什么,才知道 去哪里找数据。本板块以叙述为主、公式很少(这是它的性质,不是缺陷), 但给出了 12 处检索与判断的实例。读完可直接跳到序列分析一编的 ch20,或按兴趣进入 ch13。若只想知道这门学科与遗传学、 结构生物学是什么关系,先读本板块,再读 ch01。
警告
本章有 1 处原书公式或表格在 MinerU 转换中损坏,已降级为代码块保留残片。这些残片不可直接引用
(其中的系数、矩阵与表达式请回查原书对应页码)。
编者注·本板块导读
图 46 张 案例 10 处 行间公式 0 个。以下清单由正文自动扫出,均为原书内容,未新增。
图(前 8 张;其余见本板块正文)
- 图1-1 脱氧核糖核苷酸的化学结构 —— ch06
- 图 1-2 DNA 结构 —— ch06
- 图1-3 DNA的X射线衍射照片 —— ch06
- 图1-4 RNA结构 —— ch06
- 图 1-5 20 种氨基酸的化学结构 —— ch06
- 图1-6 氨基酸共价连接成二肽 —— ch06
- 图1-7 分子生物学中心法则 —— ch06
- 图 1-8 真核细胞中的遗传信息传递 —— ch06
- ……其余 38 张见本板块正文
案例(前 6 处)
公式:本板块不涉及需要推导的数学表达式。
本板块由以下原始章节合并而成:ch06、ch09、ch10。
第1章 分子生物学基础
道生一,一生二,二生三,三生万物。——老子《道德经》
本章简单介绍生物大分子DNA、RNA和蛋白质,以及基因表达、基因结构的基础知识,涉及生物遗传信息的存储、传递和利用等,是学习本书后续内容的理论基础,还介绍使用在线SMS工具分析生物序列的基本方法。
◎导学案例
生物信息学(bioinformatics)是一门集生物学、统计学与计算机科学等学科的方法和技术于一体,以理解海量的生物医学数据为目的的新兴交叉学科。简单地说,生物信息学是使用计算机工具,以数学的方法,解决生物学问题的一门学科。随着基因测序技术的进步以及大数据和人工智能技术的广泛应用,生物信息学在肿瘤防治、病原体检测、分子诊断和药物研发等方面都有重要应用。
王国维在《人间词话》描述做学术有三个境界,古今之成大事业、大学问者,必经过三种之境界:昨夜西风凋碧树,独上高楼,望尽天涯路,此第一境也。衣带渐宽终不悔,为伊消得人憔悴,此第二境也。众里寻他千百度,蓦然回首,那人却在,灯火阑珊处,此第三境也。
与之类似,从事生物信息学研究也有三个层次。
(1)能利用已有的一些计算机工具,或编写脚本处理数据等,是生物信息学研究的第一层次。生物信息学需要处理大量的数据,并从中得到规律性的知识,如通过测序数据与参考基因组序列比对检测突变位点,以及根据已知基因序列推断各物种的进化关系等。
(2)能掌握生物信息工具的算法,理解其背后的统计学原理,并能开发新的分析工具等,是生物信息学研究的第二层次,如序列比对工具BLAST的算法、RNA-seq数据分析工具DESeq2分析差异表达基因都有特定的数学模型。
(3)能选择或提出有意义的生物学问题,是生物信息学研究的最高层次。生物信息学研究要解决的问题是生物学问题,正如爱因斯坦说过“提出问题比解决问题更重要”。总之,计算机决定研究的效率,数学决定研究的高度,而生物学决定了研究的境界。
地球上生存着丰富多样的生物物种(species),一般可分为动物、植物、微生物等。它们从形态上来看千姿百态,例如蚂蚁、大象与金鱼。但是,从微观或分子层面上看,它们却有许多共同特点,如大多数生物(除了病毒)都由细胞构成,都有利用碳水化合物产生能量的生化代谢途径,并以DNA作为遗传信息的载体等。那么,为什么不同生物在分子水平上如此相似呢?答案可能就在于生物进化(evolution)。地球上所有生物都是起源于共同祖先(common ancestor),各种生物彼此之间都有或近或远的亲缘关系。我们的地球大约有45亿年历史,据估计,第一个生命形式大约在地球形成10亿年之后产生,那时的地球环境已经变得适合生命生存,如有水、有空气、温度适宜等。地球上初始的生命形式非常简单,后经历漫长进化,形成各种新的、复杂的物种。1859年,达尔文出版了著作《物种起源》(The Origin of Species),首次提出了进化学说。地球上现有生物具有丰富的物种多样性,据估计地球上的物种数量至少有200万种。瑞典植物学家林奈(Carl Linnaeus)基于达尔文进化思想对物种进行系统分类与命名,其创立的双名法(属名+种名)沿用至今,如人的分类名是Homo sapiens,Homo是人属,种名sapiens是智慧的意思)。直到现在还不断有新物种被发现。
漫长的生物进化过程伴随遗传信息的变异,即突变(mutation)。而这些变异是否会在种群(population)中保留下来,是由自然选择(natural selection)决定,即适者生存(survival of the fittest)。达尔文提出自然选择学说用于解释生物进化的机理。例如,人类的大脑更发达,因此相对其他灵长类动物更有选择优势,这是长期进化的结果,而不是神创造了人与其他动物不一样的特征。
早期的进化研究主要基于形态、解剖及生理生化特征等的观察数据,而现代分子生物学的大量数据进一步证明生物进化理论的科学性。例如,一个生物的大多数基因在其他物种中也有相似度很高的序列,说明它们可能来源于一个共同祖先,相似序列预示有同源性(homology)。原核生物(如细菌)和真核生物(如酵母、植物及动物)不仅使用相同的核苷酸“字母”储存信息,而且采用相同的一套遗传密码子来表达信息,说明在地球早期出现的生命中就已经设计出DNA“语言”及其解读规则,而且它们至关重要,因此几十亿年来变化很小。毋庸置疑,进化是生物学的基本原则之一。进化论涵盖了生物学的一切领域,也是生物信息学与基因组学的理论基础。许多生物信息分析都与进化相关,常见的应用是通过基因序列的比对来推测基因功能。例如,一个生物学家克隆一条新的人类DNA序列,要想知道它有什么功能,他会用这条序列与数据库中的其他物种序列进行比较,如果其他物种(小鼠、酵母等)中也有与这条DNA序列相似的序列(即同源基因),而且它们在这些物种中的功能已经被研究清楚,就可以推断出它在人体内也具有相似的功能。
1.1 生命的基本物质
1.1.1 DNA: 遗传信息的载体
DNA 为英文 deoxyribonucleic acid(脱氧核糖核酸)的缩写, 它是生物的主要遗传物质, 携带生物的遗传信息, 指导蛋白质合成及生命机能运作。孩子可以遗传妈妈的大眼睛或爸爸的高鼻子, 这些都是遗传信息的直接作用结果。一般把在遗传水平上控制这些生命特征的
DNA序列称为基因(gene)。
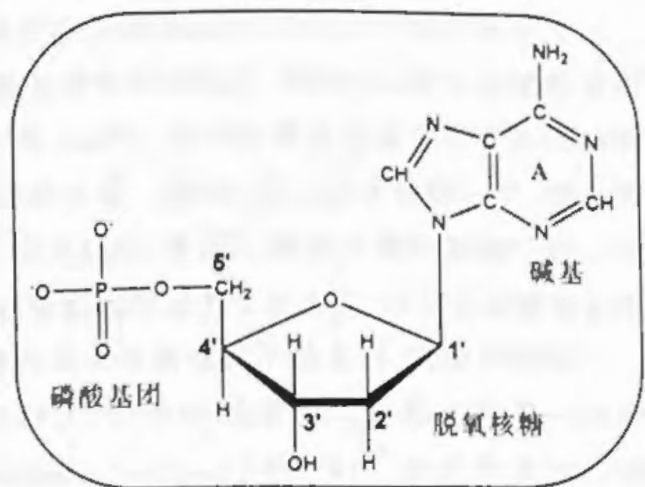
DNA是由脱氧核糖核苷酸(nucleotide, nt)组成,每个脱氧核糖核苷酸由3部分组成:一个磷酸基团、中间的一个脱氧核糖和一个含氮碱基(图1-1)。DNA分子中只有4种不同的碱基:腺嘌呤(A)、鸟嘌呤(G)、胞嘧啶(C)和胸腺嘧啶(T)。含氮碱基与磷酸基团和脱氧核糖结合形成脱氧核糖核苷酸。不同脱氧核糖核苷酸的差异在于它们所结合的含氮碱基的不同。类似于计算机二进制使用一连串的0和1两个数字,或英文使用26个不同的字母来表达信息,基
因所包含的信息来自4种不同核苷酸沿DNA分子的排列顺序(图1-2)。一个复杂的基因可有几千个核苷酸,而生物体的所有遗传信息(基因组),则由几百万甚至几十亿个核苷酸组成,如人类基因组约为 3\times10^{9}nt 。
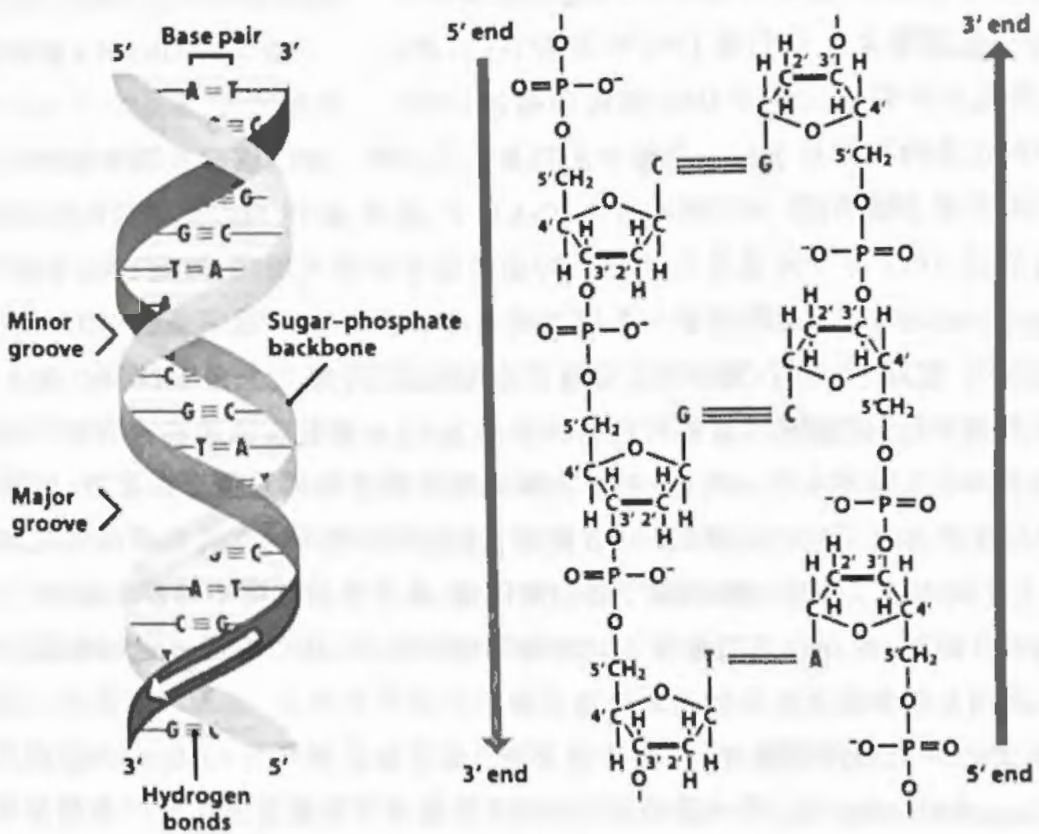
两个脱氧核糖核苷酸通常是通过磷酸二酯键(phosphodiester bond)连接的。该键将一个脱氧核糖核苷酸的磷酸基团与另一个脱氧核糖核苷酸的脱氧核糖连接(图1-2)。磷酸二酯键含有两个酯键(酯键是指那些由氧原子参与连接的键),分别位于磷原子的两侧。多个核苷酸相互连接形成多聚核苷酸链(polynucleotide),并在更高层次上形成染色体。
化学家用数字(1’到5’)标记脱氧核糖的5个碳原子。任何单一的、未结合脱氧核糖核苷酸的磷酸基团都在5’碳端,当新的核苷酸连接到多聚核苷酸链的时候,其5’端的磷酸基团与DNA链的3’端的脱氧核糖相结合。因此,核苷酸链的一端总是与另一个核苷酸结合的5’碳端连接,另一端是未结合的3’碳端。建立磷酸二酯键时,核苷酸只能结合在DNA分子的3’端上。核苷酸链的两个末端(5’端和3’端)决定了DNA分子的方向(polarity),犹如我们知道读英文时要从左到右、从上到下才能理解信息内容一样。
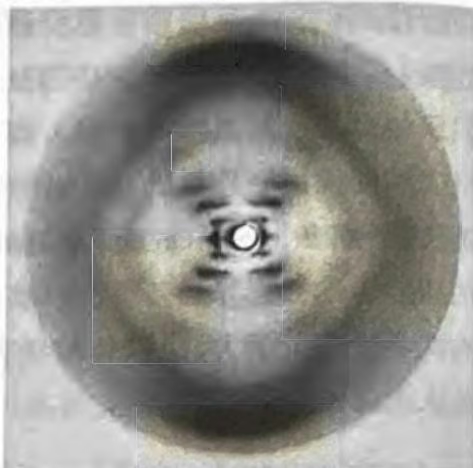
众所周知,生物大分子的结构决定其功能是生物学的一条基本原则。20世纪50年代,人们开始了解DNA的化学结构。1950年,Rosalind Franklin拍到了一张精美的DNA的X射线衍射图(图1-3),这是推测DNA分子结构的最重要数据;1952年,Erwin Chargaff发现DNA分子中A与T的数量相等,而G与C的数量相等,即查盖夫规则(Chargaff’s rules);后来JamesWaston和Fracis Crick在综合前人研究的基础上提出DNA双螺旋结构模型,这对于理解DNA遗传物质的传递规律具有重要意义。他们在1953年发表在《自然》(Nature)的论文中有一段关于DNA结构的描述:DNA
一条链中的信息内容相对于另一条链中的信息是冗余的。DNA通过双链分离并且分别以两条链作为模板而合成新链,从而形成新的DNA分子,这样,DNA可以忠实地代代传递。
如前所述,DNA分子的遗传信息来自特定的核苷酸排列顺序,然而DNA双链上的碱基是互补(complementary)的,即对于一条链上的每个G或A,都有另一条链上的C或T与之对应,反之亦然。实际上,G与C配对(在G与C之间形成三个氢键)、A与T配对(在A与T之间形成两个氢键)可形成稳定的碱基对(base pairs,bp)。G的化学结构中含有两个环,若与同样含有两个环的A或另一个G配对,则会因两条链间的空间不足而无法配对;同样道理,若含一个环的T与含一个环的C或另一个T配对,会因两条链间的空间距离过大而无法配对。G与T、A与C间的相互作用的障碍除了受空间限制,还受化学基团不相容的影响。只有G与C配对,A与T配对,才有合适的空间及化学基团相互作用,从而形成稳定的碱基对,碱基之间的相互作用足以将两条互补的链结合在一起。
虽然 DNA 分子的两条链互补,但方向不同,是互为反向平行(antiparallel)或反向互补(reverse complementary)的,即一条链的5’端与互补链的3’端相对应。若一条链的碱基序列是5’-GTATCC-3’,则另一条链是3’-CATAGG-5’。由于细胞内DNA的复制过程是沿5’端到3’端进行的,所以通常从5’到3’的顺序表示此条DNA序列。另外,一般将位于一个基因5’端前的序列通常称为该基因的”上游(upstream)”序列,而位于基因3’端后的称为”下游(downstream)”序列。
1.1.2 RNA: 遗传信息的中介
核糖核酸(ribonucleic acid, 缩写为 RNA)是存在于生物细胞中的重要生物大分子之一。传统观念一般认为 RNA 的功能主要是遗传信息从 DNA 到蛋白质传递过程的中介分子,即 RNA 是由 DNA 转录而来。但部分病毒(如 HIV 病毒)、类病毒也以 RNA 为遗传物质。RNA 的化学结构与 DNA 非常相似,都由核苷酸单元组成(图 1-4),但有 3 个区别:
(1) RNA 的糖基为核糖而不是脱氧核糖, 即在核糖第 2 位碳原子上是羟基 (—OH), 而不是 DNA 的氢 (H);
(2) RNA 用含氮碱基尿嘧啶 (U) 代替 DNA 中的胸腺嘧啶 (T);
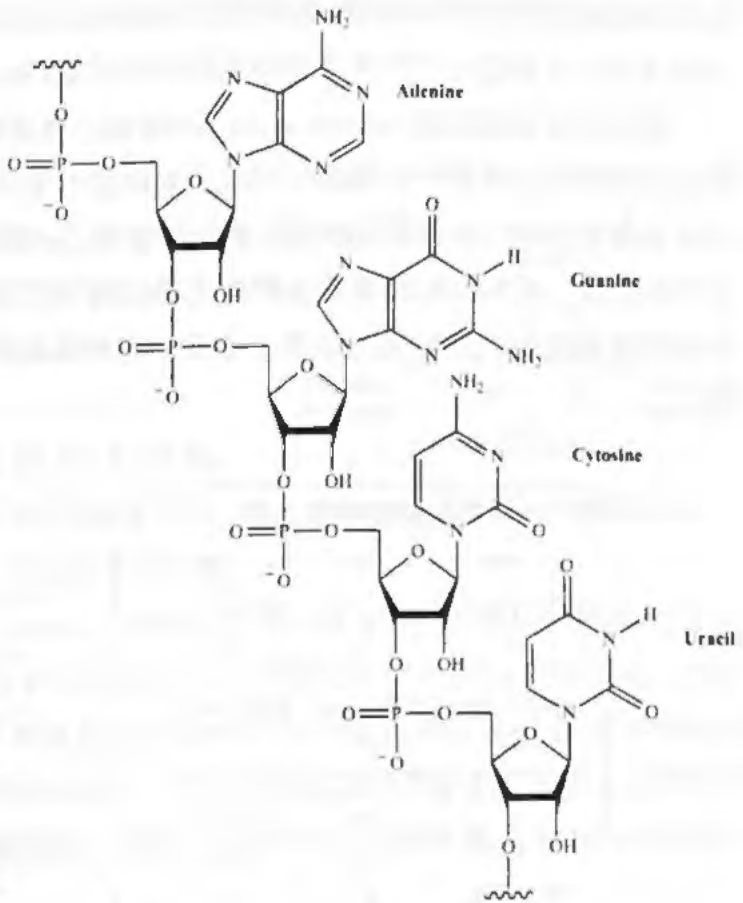
(3) RNA 一般是单链,但与 DNA 一样有 5’ 到以下 3’ 方向性。
RNA主要有三种形式存在,即mRNA(信使RNA)、tRNA(转运RNA)与rRNA(核糖体RNA)。mRNA的功能为生物遗传信息的中间载体,指导蛋白质合成,其作用类似信使(messenger)。tRNA连接密码子与mRNA,指导氨基酸的合成,是蛋白质合成过程中氨基酸转运的工具。目前在脊椎动物中发现了22种tRNA(一种tRNA分子可识别一种以上的同一种氨基酸的密码子)。rRNA作为结构支架与核糖体蛋白共同形成核糖体,为蛋白质合成所需要的mRNA、tRNA和多种蛋白因子提供相互作用的场所。按沉降系数(S)不同,真核生物的rRNA包括28S、18S、5.8S、5S四种;原核生物的rRNA包括23S、16S、5S三种。因此,RNA长期以来被认为是结构单位,其作为功能单位的重要性被忽视。直到1982年,Tomas Cech发现了具有催化功能的RNA(核酶),这个发现使人们认识到RNA的功能远非“传递遗传信息”那么简单。最新的研究还发现许多非编码RNA,包括非编码小RNA(如siRNA、miRNA)、长链非编码RNA(lncRNA)等。这些非编码RNA参与细胞内的复杂基因表达调控过程,利用其调控机制建立的RNA干扰(RNAi)技术已成为生物学中研究基因功能的一种新方法。
1.1.3 蛋白质:生命的构建单元
蛋白质(protein)是生物体的基本组成成分,protein来自希腊语“protos”,为“第一”和“最重要的”的意思。几乎所有的细胞都含有蛋白质,而且细胞内蛋白质的含量较多,约占细胞固体成分的45%。人体细胞内约有21000种不同的蛋白质,执行特定的不同功能,如酶催化生命活动的各种生化反应(胃蛋白酶可分解食物),膜蛋白可作为细胞膜上的离子运输通道 $\left(\mathrm{Na}^{+}\right.$ 通道),结构蛋白可作为维持细胞结构的骨架(胶原蛋白维持结缔组织)等。
蛋白质是由氨基酸(amino acids, aa)组成。氨基酸的基本结构是:与羧基(—COOH)相邻的α碳原子上都有一个氨基(—NH₂), α碳原子上还与一个侧链(用—R表示)相连。常见的氨基酸有20种, 20种氨基酸都有相同的氨基、α-碳原子和羧基, 但是每个氨基酸都有其独特的R基团。图1-5为20种氨基酸的化学结构, 不同之处在于它们各自不同的R基团, 可以根据氨基酸侧链的特性进行分类。在图1-5中给出了每种氨基酸的名称与1个字母的标准缩写。
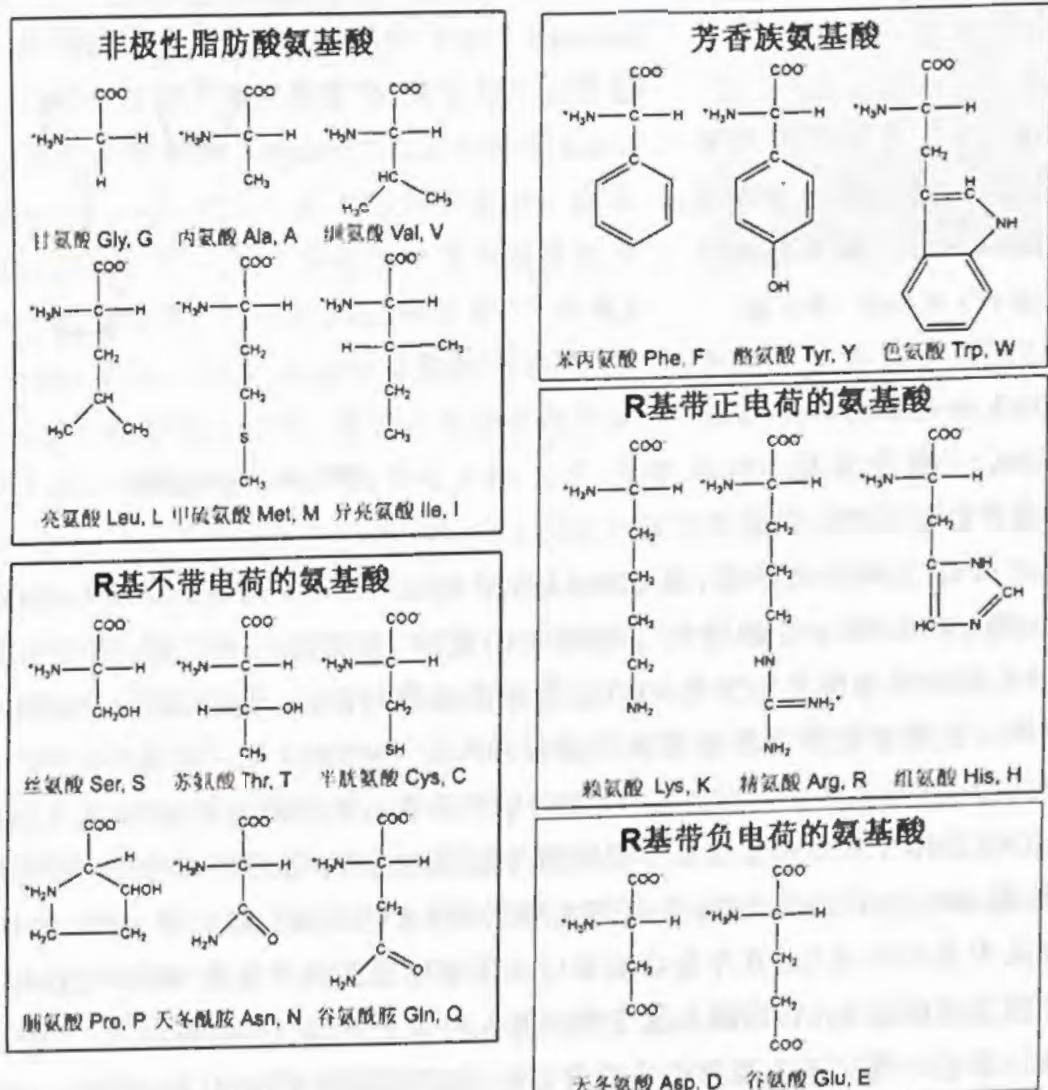
氨基酸通常被分为3类:第一类为疏水(hydrophobic)氨基酸,其侧链大多或全部由碳原子和氢原子组成,因此这些氨基酸不大可能与水分子形成氢键,如丙氨酸(Ala)、苯丙氨酸(Phe)等。第二类为极性(polar)氨基酸,其侧链通常由氧原子或氮原子组成,它们比较容易与水分子形成氢键,如丝氨酸(Ser)、谷氨酰胺(Gln)等。第三类为带电(charged)氨基酸,它们在生物pH环境带有正电或负电,如带正电的精氨酸(Arg)、带负电的谷氨酸(Glu)。蛋白质中每个氨基酸的特性都会影响蛋白质的结构与功能,因此了解每个氨基酸的结构与特性非常重要。
几个氨基酸组成的氨基酸链被称为肽(peptide)。当两个氨基酸共价结合时,通过脱去一分子水生成一个二肽(图1-6)。连接两个氨基酸间的共价链为肽键(peptide bond)。由于氨基酸中的一些原子在肽链形成过程中作为水分子丢失了,所以此氨基酸在多肽中通常也被称为氨基酸残基(residue)。
多个氨基酸组成的氨基酸链称为多肽(polypetide)。与DNA分子一样,多肽链也具有方向性。多肽链的氨基端(amino terminus,简称N端)带有
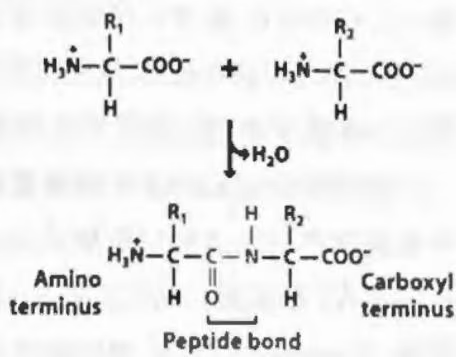
一个氨基,而在它的羧基端(carboxy terminus,简称C端)为一个羧基(注意不是羰基)。蛋白质序列通常被认为是从N端开始,延伸到C端结束。这个氨基酸序列称为蛋白质的一级结构(primary structure)。组成蛋白质的氨基酸序列决定了这个蛋白质的三维结构与理化性质。如前所述,结构决定蛋白质功能是生物学的一条基本原则,因此氨基酸序列决定高级结构,后者又决定了蛋白质的生物学功能。关于蛋白质结构的更多内容参见本书第7章蛋白质结构预测部分。
1.2 基因表达——遗传信息的流动
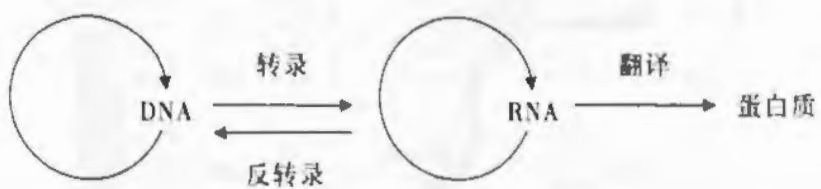
虽然 DNA 序列储存遗传信息,但是蛋白质才是生命功能的执行者,如细胞的各项生化反应都需要酶来催化完成。基因最初的一个定义就是:基因是细胞生产蛋白质所必需的 DNA 序列。因此,基因表达是指遗传信息从基因的核苷酸序列中被读出,用来指导蛋白质合成的过程,这个过程对地球上的所有生物都是相似的,分子生物学家称之为中心法则 (central dogma),是生物学的基本原则之一。如图 1-7 所示的分子生物学中心法则中,生物的遗传信息从 DNA 中传递到 RNA 中(转录),再从 RNA 到蛋白质中(翻译),同时 DNA 分子在细胞分裂过程中完成自我复制。但有些病毒(如 HIV 病毒、烟草花叶病毒)以 RNA 为遗传物质,RNA 可以自我复制,也可以反转录生成 DNA,这是对中心法则的重要补充。
1.2.1 转录与翻译
由 DNA 中储存的信息指导合成一条寿命较短的单链核苷酸(RNA)的过程叫作转录(transcription),这个过程由 RNA 聚合酶(RNA polymerase)催化完成。用来合成 RNA 的核苷酸(G、A、U 和 C,其中 U 代表尿嘧啶)与 DNA 分子中的核苷酸(分别是 G、A、T 和 C)是一一对应的。RNA 转录与 DNA 复制过程有相似之处,两者都以 DNA 的一条链为模板(模板链)产生新的一条核苷酸链。除了用 U 代替 T,RNA 序列与 DNA 编码链的序列相同。
转录产生的mRNA可指导蛋白质的合成。将mRNA中的核苷酸序列信息转换成蛋白质中氨基酸序列的过程叫作翻译(translation)(图1-8)。这就像从一种语言(核苷酸)翻译成另一种语言(氨基酸)。转运RNA(tRNA)负责核酸语言与蛋白质语言的翻译。翻译过程在核糖体(ribosome)上进行,核糖体由蛋白质和rRNA组成。
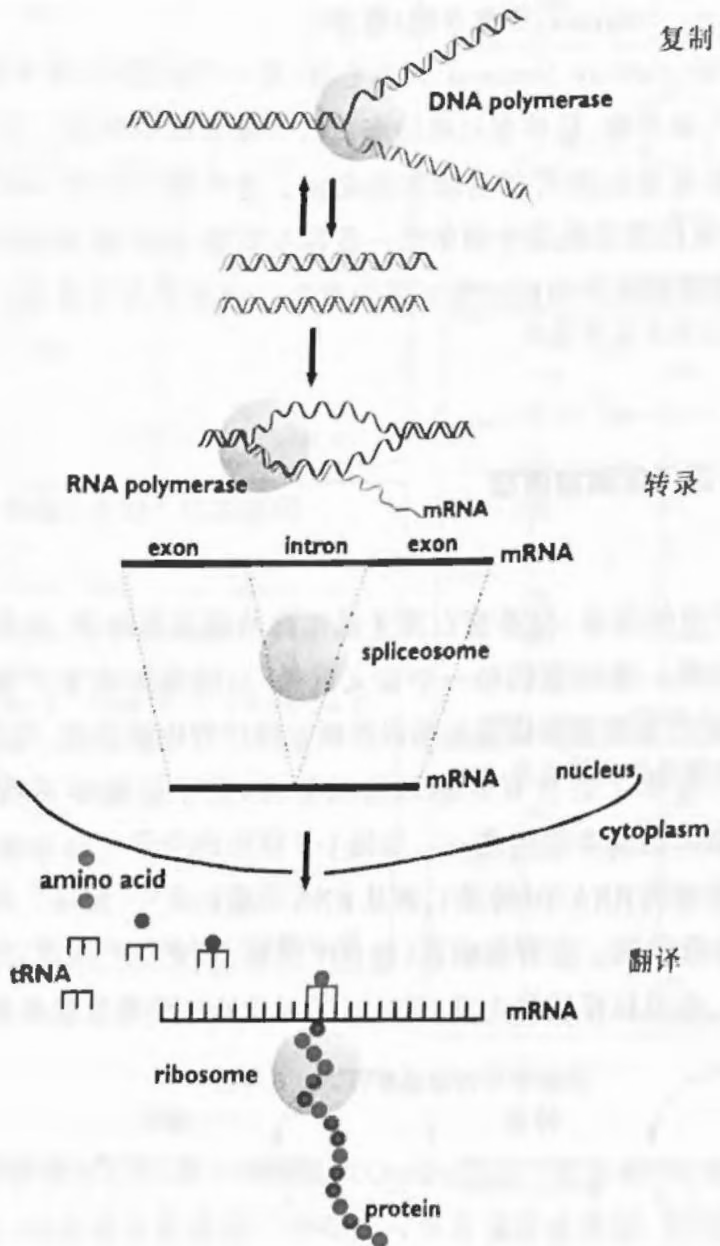
基因转录与翻译过程可统称为基因表达(gene expression)。但不是所有基因都能表达蛋白质, 表达蛋白质的基因称为蛋白编码基因(protein-coding genes), 还有些基因只表达RNA, 如各种非编码RNA基因(tRNA、microRNA等)。因此, 后来基因定义又扩展为编码RNA的DNA序列(The RNA-encoding segments of the DNA are called genes)。基因表达过程在转录与翻译水平上受不同调控。
在原核生物细胞中,蛋白质的翻译过程是随着DNA的转录而同时进行的,而在真核生物中,基因表达的两个步骤被核膜在空间上分开,转录只发生在细胞核内,而翻译仅当mRNA被运送到细胞质中后才发生。真核RNA聚合酶转录的RNA分子在运送到核糖体之前需要进行修饰,如加polyA尾巴、剪切内含子等。
1.2.2 遗传密码
核苷酸是构成核酸分子(DNA和RNA)的基本单位,细胞利用这些分子储存和传递遗传信息。氨基酸是构成蛋白质的基本单位,蛋白质是细胞功能的主要执行者。蛋白质的功能取决于翻译过程中核糖体装配的氨基酸的序列,而该序列又取决于由RNA聚合酶转录的mRNA分子中编码的核苷酸序列。RNA和DNA分子只有4种不同的核苷酸(nt),而在蛋白质构成中却有20种不同的氨基酸(aa)。因此,基因的核苷酸与蛋白质的氨基酸之间不是一种简单的一对一关系(1 nt≠1 aa;4<20),需要一种复杂的编码机制。考虑两个核苷酸的组合,总共有16种可能的组合(2 nt≠1 aa;4<20),因此,两个核苷酸的组合也不能作为一种编码机制。然而,若3个核苷酸结合在一起,则4种核苷酸有64种不同的组合形式(4>20)。
20世纪60年代,遗传密码被成功破译,确认核糖体利用三联密码子将RNA序列翻译成蛋白质中的氨基酸序列。在RNA中的蛋白编码部分,每三个核苷酸为一个密码子(codon),对应一种特定的氨基酸。如表1-1是64种三联遗传密码编码的20种常用的氨基酸(氨基酸的三位标准缩写)。只有3个例外,密码子UAA、UAG、UGA的功能并非编码一个特定的氨基酸,而是引起翻译的终止,所以称为终止密码子(stop codon)。另一个甲硫氨酸(methionine)的编码密码子AUG也称为起始密码子(start codon),可作为多肽链合成的起始信号。
表 1-1 64 种三联遗传密码编码的氨基酸
| U | C | A | G | ||
|---|---|---|---|---|---|
| U | UUUUUCUUAUUG | UCUUCCUCAUCG | UAUUACUAA UAG | UGUUGCUGA UGG | UCAG |
| C | CUUCUCCUACUG | CCUCCCCCACCG | CAUCACCAA CAG | CGUCGCCCGA CGG | UCAG |
| A | AUUAUCAUA AUG | ACUACCACA ACG | AAUAACAAA AAG | AGUAGC AGA AGG | UCAG |
| G | GUUGUCGUA GUG | GCU GCCGCA GCG | GAUGACGAA GAG | GGUGGC GGA GGG | UCAG |
共有61个三联密码子能编码氨基酸,而氨基酸只有20种。除了甲硫氨酸与色氨酸,其他18个氨基酸具有多个密码子,这种特性叫作密码子的简并性(degeneracy)。由于密码子的简并性,在DNA复制或转录过程中发生错误不会使蛋白质的氨基酸序列受到影响,尤其当突变发生在密码子的第3位(最后1位)时更是如此。氨基酸可划分为4类:极性的、非极性的、带正电荷的和带负电荷的氨基酸。通常三联密码子中一个碱基的改变不足以引起所编码的氨基酸从一类变成另一类。简而言之,遗传密码是非常可靠的,可以尽可能地减少由于基因中核苷酸序列错误而导致所编码氨基酸的错误。
除极个别情况外,现在地球上的所有生物共用一套遗传密码。密码子在动物(包括人类)、植物、真菌、古细菌、细菌和病毒都具有普遍性,但在线粒体和某些微生物中密码子存在一些小的改变。例如,在一些细菌的基因中,终止密码子UGA能编码在自然界中发现的第21种氨基酸,即硒代半胱氨酸。作为绝大多数生物终止密码子的UAG在一些细菌和真核生物中编码第22种氨基酸,即吡咯赖氨酸。
1.2.3 开放阅读框(ORF)
蛋白质翻译是从 mRNA 的起始密码子开始, 到终止密码子结束。这一长串未被终止密码子打断的密码子序列被称为开放阅读框(open reading frame, ORF)。遗传密码有一个密码子(AUG)作为起始密码子(start codon), 但有 3 个密码子(UAA、UAG、UGA)用作终止密码子(stop codon)。密码子 AUG 也可用来编码甲硫氨酸, 所以还需要其他信号(如 promoter、Shine-Dalgarna 序列等)来准确识别翻译起始位置。
ORF是基因预测的结果,并不是所有ORF都能表达出蛋白质序列。与ORF类似的名词CDS(coding sequence)是指能编码一段蛋白产物的序列。
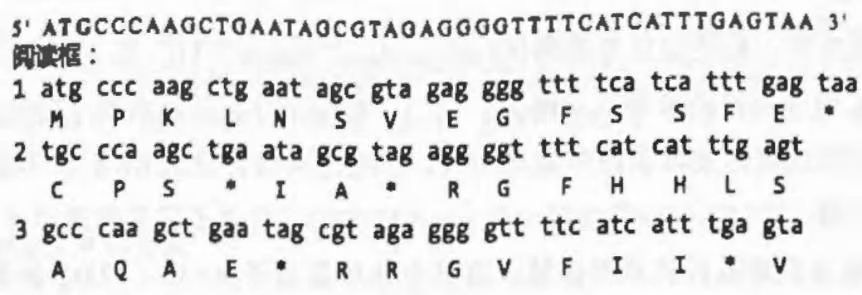
阅读框是由起始密码子决定的,只有当核糖体在正确的相位或阅读框(reading frame)中阅读,才能够准确地翻译(图1-9)。一条mRNA序列可以有3种不同的阅读框,如序列ACUGCCAC…可以是ACU|GCC|AC…(对应氨基酸Thr-Ala…),或第二相位:A|CUG|CCA|C…(对应氨基酸Leu-Pro…),或第三相位:AC|UGC|CAC…(对应氨基酸Cys-His…)。如果是一条DNA序列,由于DNA的双链中任一条正、负链都可能是编码链,因此有六个阅读框。
开放阅读框是许多原核生物和真核生物基因的明显特征(图1-9)。多数基因的阅读框具有长的密码子串,如大多数基因编码的蛋白质序列长度为几百个氨基酸,而且在这个密码子串中没有终止密码子。而在随机产生的序列中,终止密码子发生率约为1/20(64个密码子中的3个),意味着在长度为20个左右的密码子串中就会出现一个终止密码子。如果基因突变造成基因阅读框的变化(frame shift),则会改变突变位点下游编码的每一个氨基酸,这种改变通常会产生提前的终止密码子,从而产生缩短的蛋白质,使蛋白质失去生理功能。
1.2.4 内含子和外显子
原核生物的基因序列与其转录的mRNA序列完全对应。然而,真核生物的基因结构比较复杂,大都是由外显子(exon)与内含子(intron)构成的嵌合体。多数真核基因的RNA初始转录本需要经过剪接(splicing)过程,将内含子的序列精确剪切掉,并将其两侧的外显子重新连接(图1-10)。多数真核基因具有多个内含子,研究表明 $95%$ 的人类基因具有内含子。一个极端的例子是与人类囊性纤维症有关的基因(CFTR),含有24个内含子及超过100万个核苷酸,但在核糖体中的成熟mRNA却只有1000个核苷酸。剪接绝不是一个简单的过程,真核生物中负责剪接的酶复合体称为剪接体(spliceosomes)。大多数真核生物的内含子遵照“GT—AG规则”,即所有内含子DNA序列的头两个核苷酸是GT,而结尾两个核苷酸是AG。在不同类型的细胞中,剪接结果有所不同,相同的几个外显子可通过不同组合产生不同的基因产物。这种可变剪接(alternative splicing)是由识别内含子/外显子边界的剪接体及附属蛋白的精巧机制实现的,大大增强了真核生物蛋白质的多样性。
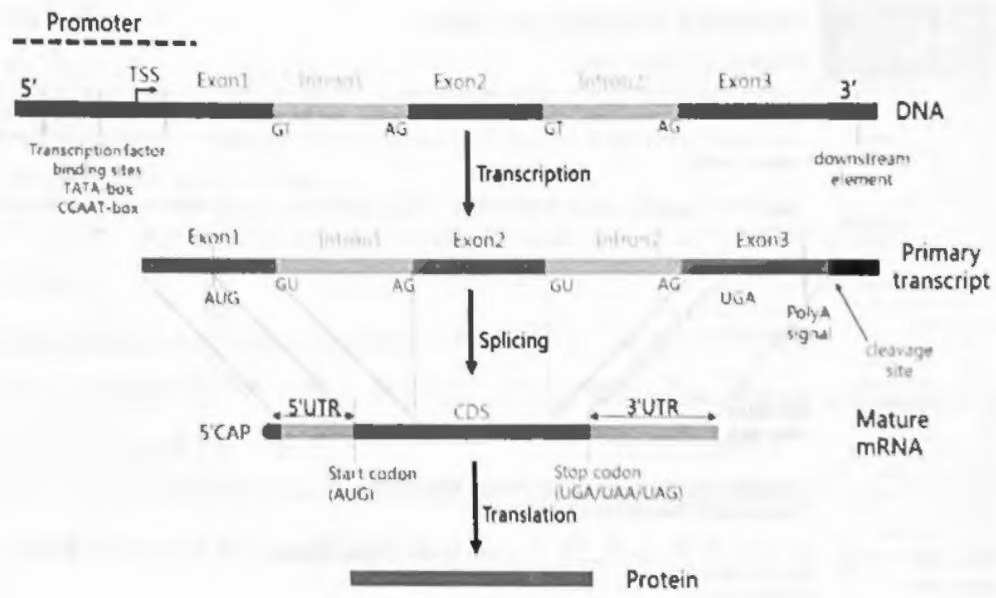
图 1-10 是对真核基因的 RNA 初级转录本的剪接, 将内含子切去, 并将外显子精确地连接在一起。一旦内含子序列被切去, mRNA 经适当修饰后, 将从细胞核中被运出, 在核外的核糖体进行翻译。
此外,基因序列一般还包括非翻译区(untranslated region, UTR)、启动子(promoter)、增强子(enhancer)区域等调控基因表达的部分。它们一般位于外显子和内含子的两侧,是基因的“控制区”,调控基因表达成转录的时间和方式。UTR序列会转录成RNA,但不会被翻译成蛋白质,一般位于第一个(5’UTR)或最后一个exon(3’UTR)。启动子区是转录因子(transcription factor)识别并结合启动基因转录的区域。真核生物的启动子在-30~-25bp处有段特定序列的TATA框,在-70~-78bp处有CAAT框。UTR和启动子通过影响mRNA的转录和降解,参与基因表达水平的调控。例如,启动子区域可控制某个基因是否应该在肝脏或大脑中表达,而基因的3’UTR区可与一些miRNA结合降解mRNA等。真核生物的增强子则会大大增加基因转录的水平。
1.3 生物序列处理
现代分子生物学实验往往产生大量的数据,为方便进行数据分析,现已开发大量的生物信息学分析工具。此处我们以在线工具SMS(Sequence Manipulation Suite)为例,简单介绍如何进行生物序列处理,如DNA序列的反向、互补、翻译等操作。其他各种生物信息工具将在下一章介绍。
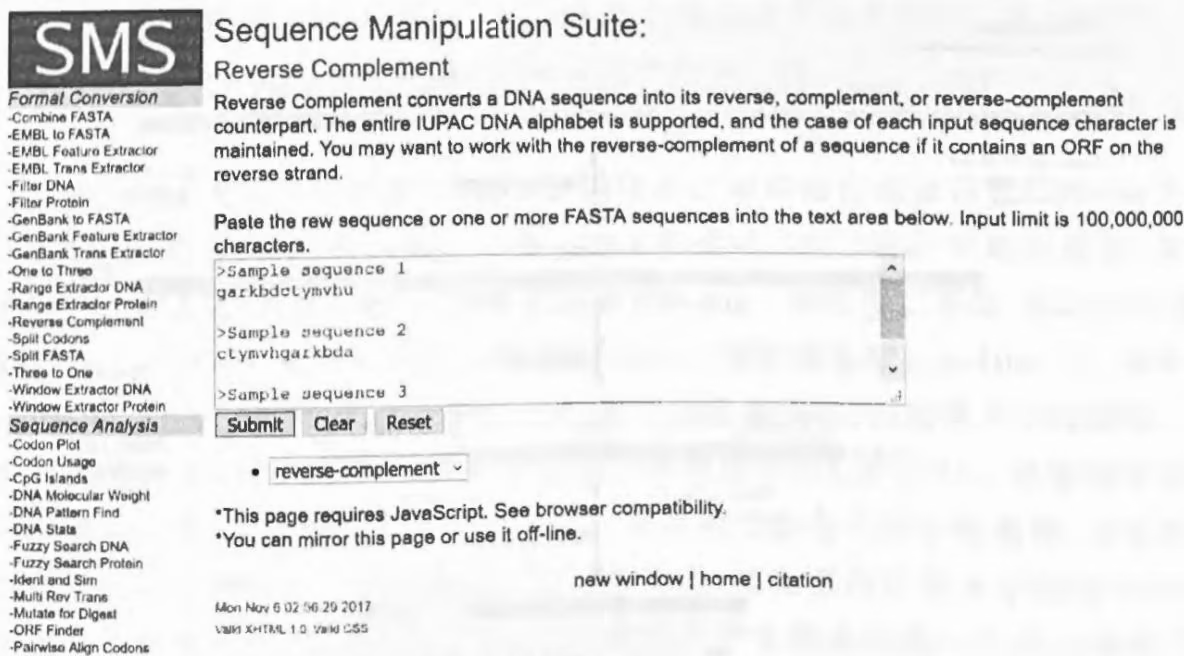
SMS 是用 JavaScript 编写的序列操作工具, 可在任何网络浏览器中运行, 只要打开 SMS 网站即可使用。SMS 主页左边栏列出了多种常用分析工具(图 1-11)。
这里我们利用SMS处理一个DNA序列,请用记事本打开文件DNA_sequences.txt查看,部分序列如下:
1 | 1 gtcgacccac gcgtccgtct tgaaagaata tgaagttgta aagagctggt aaagtggtaa |
1.3.1 SMS序列分析
(1)由于此文件中含有数字、空格等非DNA字符,需要先把DNA序列提取出来,可利用SMS的“Filter DNA”工具。
选择左边栏的“Filter DNA”工具,只要将文本复制粘贴到文本输入框,再点击“Submit”就可以得到过滤后的DNA序列。过滤后的DNA序列只含有字符“ACGT”,以FASTA格式输出,可用于后续的序列分析。
FASTA 格式是记录基因或蛋白质序列最常用的一种文件格式,每一条记录分成两部分。
第一部分为标题行,以“>”开头,记录序列的相关注释信息,如序列名称(ID)、序列来源等。
第二部分为序列行,从标题行的下一行开始,记录序列的具体字符串,字符必须为标准IUB/IUPAC核苷酸或氨基酸符号。一般FASTA格式中每一行序列不多于80个字符,字符的大小写同义。
1 | >sequence1 information |
注意,标题行“>”之后紧跟的内容不能有空格,而且注释信息内容不能超过一行;序列行可以有多行,直到遇到下一个“>”。
(2)如果要得到这条DNA序列的反向互补序列,可以利用SMS的“Reverse Complement”工具。
选择左边栏的”Reverse Complement”工具(图1-11),将过滤后的DNA序列复制到输入框,再点击“Submit”就可以得到反向互补的DNA序列。此工具还有一个参数可选择,默认是“Reverse-Complement”(反向互补),也可在选择框中选择“Reverse”(反向)或“Complement”(互补)。
(3)如果要得到DNA翻译成蛋白质,可利用SMS的“Translate”工具。
选择左边栏的“Translate”工具,将过滤后的DNA序列复制到输入框,再点击“Submit”可以得到DNA序列翻译的氨基酸序列。在氨基酸序列中,终止密码子用“*”表示。ORF序列一般是以编码甲硫氨酸(M)的ATG开头(有些细菌可能以CTG或其他密码子为起始密码子),在起始密码子前面的密码子都被核糖体忽略而不编码蛋白质。
由于DNA的双链中任一条正、负链都可能是编码链,所以一条DNA序列有六个阅读框,默认参数是“reading frame 1”与“direct strand”,你可以选择不同的参数,得到不同的结果。通过比较正链的3个不同ORFs,发现ORF3(“reading frame 3”)的氨基酸序列比较长,最可能是正确的编码序列。
(4)如果要得到编码蛋白的DNA序列部分,可利用SMS的“Range Extractor DNA”工具可以通过氨基酸序列找到M(ATG)与终止密码子的位置。这里以上面ORF3为例,可以通过氨基酸序列找到M(23)与终止密码子*(159)的位置分别对应DNA位置为ATG(69)与TGA(477)。由于阅读框3需要往后第2位开始编码氨基酸,所以TGA在DNA上的实际位置为 $477+2=479$ 。
选择左边栏的“Range Extractor DNA”工具,将过滤后的DNA序列复制到输入框,再输入位置范围69..479,点击“Submit”就可以得到ORF序列。检查一下起始密码子ATG,与终止密码子TGA。
(5)再用“Translate”工具得到ORF序列的氨基酸序列。使用默认参数“Reading frame 1”与“Direct strand”。如果操作都正确,最终的蛋白质序列含有136个氨基酸。
(6)序列比对是把两条序列并排在一起查看序列差异的部分。先用记事本新建一个文件,并把步骤5中得到的ORF序列拷贝到此处,分别复制粘贴两次,将第一条序列名称改成“>raw_seq”,另一个序列名称改成“>mut_seq”,并对mut_seq序列做任意修改或删除几个碱基的编辑操作。
(7) 利用 SMS 的“Pairwise Align DNA”工具, 分别复制粘贴这两个 ORF 序列到相应的输入框中, 点击“Submit”提交后产生两个比对好的序列。
(8)通过“Color Align Conservation”比对可视化工具,把上一步“Pairwise Align DNA”比对后的序列复制粘贴到输入框,点击“Submit”就可以查看两条序列间的差异位点。使用默认参数比对后的结果如图1-12所示,差异碱基的背景是白色,而相同碱基背景为黑色。

习题
试画出 DNA 分子中的脱氧核糖和 RNA 分子中的核糖的化学结构。
现有一条 mRNA 序列 5’-AUGGGAUCGACGCGCAAG-3’, 它的模板链序列是什么?若它被核糖体翻译,将形成怎样的氨基酸序列?
将上文 1.3 部分的 ORF 序列, 先翻译成蛋白质序列, 再利用 SMS 进行蛋白质序列比对。
- 简述 gene、ORF、mRNA、CDS、promoter、exon、intron、UTR 的含义。
第2章 计算机技能基础
工欲善其事,必先利其器。——《论语·卫灵公》
本章介绍生物信息分析需要用到的一些 Windows 基础技能, 如文本编辑器、搜索引擎和生物软件 (BioEdit) 的使用, 并介绍 Linux 系统的安装与基本命令操作等。
◎导学案例
比尔·盖茨(Bill Gates)创办微软(Microsoft)公司的最初动机是他想写出“最伟大的软件”,最终微软推出了划时代的计算机产品——Windows操作系统。比尔·盖茨从小就喜欢看书,具有良好的数学基础,使得他在编程方面有着天然的优势。在哈佛大学期间,有一次数学老师克里斯托斯·潘帕莱米托(Christos Papadimitriou)给他们出了一道难题:一个厨师做了一叠大小不同的煎饼,他要不断从上面拿起几个煎饼翻到下面。假设有N个煎饼,厨师需要翻动多少次,才能完成这个排列?比尔·盖茨想出了解决这道难题的一个比较好的办法。潘帕莱米托利用暑假时间将比尔·盖茨的方法写成一篇论文发表在《离散数学》杂志上(Gates W H & Papadimitriou C H. Bounds for sorting by prefix reversal. Discrete Mathematics, 1979, (27):47-57.)。据说比尔·盖茨的这个解法是解决这一难题的突破性进展。比尔·盖茨喜欢编程是因为程序本身蕴含的运算性与逻辑性。他在大学二年级时退学创办了微软公司,追求自己的兴趣。后来哈佛大学授予他荣誉学位,表彰这位最成功的辍学者,而发给他的证书其实不是博士学位证书,而是学士学位证书。
随着信息技术的发展,计算机已经成为人们日常工作和生活的重要工具。生物信息学就是计算机在生物学研究中的应用。生物高通量实验技术的发展,产生了海量的生物数据,大多数生物实验室都需要利用一些生物信息学工具来分析实验数据。个人计算机(PC)普遍使用微软的Windows操作系统,它具有图形化界面,操作简单。本书假设读者已经熟悉Windows的基本操作技能,如安装软件、文件管理、浏览网络和使用Office软件办公等。许多生物信息学软件需要在Linux系统下运行,在开始学习生物信息学之前,首先也需要学习Linux系统的一些操作技能。Linux是开源、自由的免费系统,广泛应用于多种网络服务器。虽然Windows系统的使用比较方便,但在数据处理与程序运行方面,Windows系统不如Linux系统运行效率高。因此,许多生物信息分析软件都是基于Linux系统开发,尤其高通量测序数据分析,一般只能在Linux服务器上通过命令行终端(terminal)进行处理。另外,最好还要学习一门编程语言(如Python或R),当遇到没有现成工具可用的问题,可以自己编码解决,如编写一些脚本进行特殊的数据格式转换等。更多关于Linux与编程等计算机技能的介绍可扫描章末二维码查看。本书假设读者使用的计算机已安装Windows 10系统,并安装Windows的Linux子系统用于Linux基本命令的学习。本书后续章节还会介绍具体生物信息分析软件在Linux下的安装与使用。
2.1 文本编辑器
文本编辑器是用来编写普通文字的应用软件,它以纯文本形式进行文件储存,如记事本用来编写程序源代码。而办公软件,如微软的Word,具有强大的编辑和排版功能,可改变文字字体、颜色、显示图片等,并以二进制格式进行储存文件。文本编辑器是生物信息学的重要工具之一,如绝大多数生物信息分析软件的输入输出数据是纯文本,因此可用文本编辑器进行数据查看或处理,并且编写分析脚本一般也只需要文本编辑器。
Windows 默认记事本的功能比较弱,有时不能胜任生物序列数据处理的任务,如打开大的基因组序列文件的速度很慢、不能识别 Linux 系统的换行符等。这里推荐使用 Notepad2 代替 Windows 的记事本(图 2-1),你也可以使用其他文本编辑器,如 Notepad++、UltraEdit、EditPlus 等。
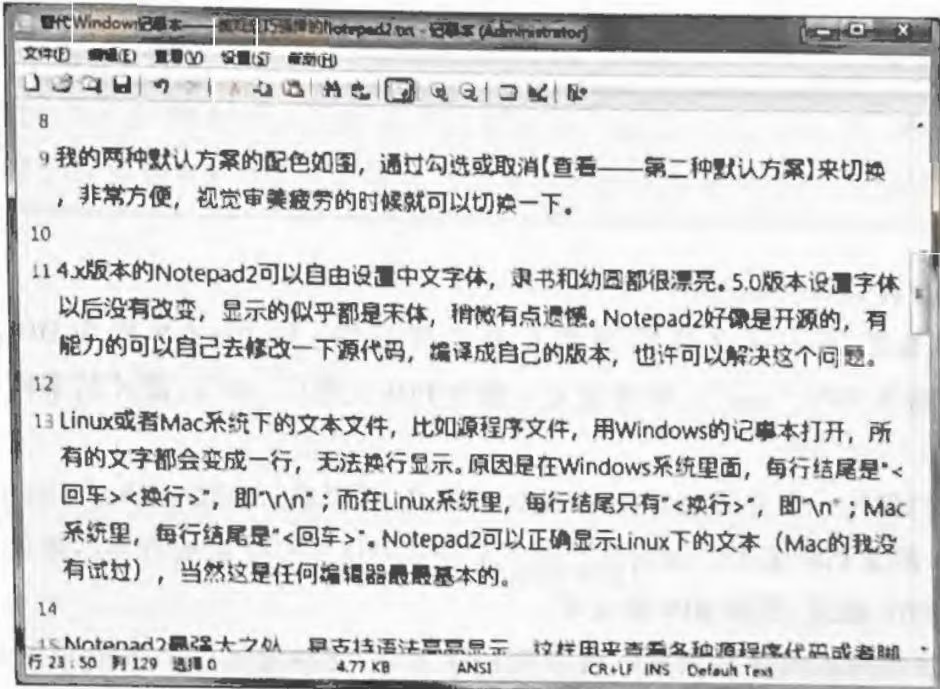
Notepad2 是一个优秀的轻量级文本编辑器, 具有很多特色功能, 如代码高亮、编码转换、行号显示、多步撤销 (Ctrl+Z) 等。Notepad2-mod 是 Notepad2 的修改版, 并增强了一些编辑功能, 如代码折叠、自动代替 Windows 记事本等。
Notepad2的安装与配置说明,可扫描章末二维码查看。
2.2 网络搜索
学习过程经常会遇到各种问题,对于常见的生物信息问题,一般前人都遇到过,很多可以直接从网上找到解决方法。因此,学习生物信息的第一步就是要掌握常用的搜索工具的使用方法。根据关键词在百度或 Google 搜索相关问题的答案,是生物信息学的必备技能之一。英文信息可以优先查 Google,中文资料可优先在百度中查找。目前随着手机移动网络的发展,各种自媒体平台的信息快速增加,如微博和微信公众号等。自媒体发布的内容一般都比较新,如果要查找微博和微信公众号的信息可以优先在 Sogou 查找。
各种搜索引擎的使用方法基本相似。
下面以 Google 为例,介绍搜索工具的一些搜索小技巧。
(1)关键词精确匹配(“AB”)
大多数用户可能没有意识到, Google 默认在一次搜索输入的所有关键词之间是一种“和(AND)”的逻辑关系。也就是说, 如果你输入两个词, 它就会假定你所寻找的页面包含这两个词。它不会反馈给你仅包含其中一个词的页面。而搜索“A OR B”可以得到含有 A 或 B 关键词的页面。如果要精确匹配中间含空格的关键词(如 16S rRNA), 要前后加入引号(“16S rRNA”), 加引号与不加引号的搜索结果完全不同。
16S rRNA 的正确写法是“16S”与“rRNA”之间有空格,而“16”与大写“S”之间没有空格,经常有同学写错,从以上的搜索结果也可以看到网上有许多错误的写法。
(2)限定文件类型(filetype)
Windows 系统的不同文件类型都有对应的后缀,如 Word 文档为 DOC(“.doc”), PowerPoint 文稿为 PPT(“.ppt”), 学术论文一般为 PDF 文件(“.pdf”), 图片的常用格式有 PNG(“.png”), JPG(“.jpg”)等。
例如,我们要找一个介绍16S rRNA基因的论文,可以输入“16S rRNA filetype:PDF”,即限定搜索结果都是PDF文档。搜索其他格式文件都可以在要搜索的内容后添加相应的文件格式,如图片PNG格式,视频MP4格式等。
(3)限定在某网站内搜索(site)
由于一般搜索结果的数据量比较多,如果我们只对某个网站的信息感兴趣,那么只要在关键词后加“site:xxx(网址)”。
例如,知乎是一个真实的网络问答社区。如果你想知道怎么学生物信息学,可以指定在知乎网站搜索答案:“生物信息学 site:zhihu.com”。
国内网络受防火墙(GFW)影响,经常不能访问国外的一些网站。一般可以花钱购买VPN网络代理,或使用一些免费的代理软件,如浏览器插件Hoxx VPN Proxy,浏览器Chrome与Firefox都可以用这个插件。
2.3 常用生物软件
生物软件是用于蛋白质或核酸序列分析与数据处理的工具。Internet互联网上有大量的免费生物软件,一般分在线与离线两种形式。在线工具软件只要通过浏览器就可使用,如序列处理在线工具包SMS(The Sequence Manipulation Suite)、PCR引物设计Primer3等。而离线工具要先下载软件,在本地电脑上安装使用,如综合序列分析软件BioEdit、EMBOSS(European Molecular Biology Open Software Suite)等。还有一些更容易使用的商业化的生物软件,但购买价格比较贵,如Genesius、DNAstar、SnapGene等。一般只要学习使用免费软件就可以完成常见的生物信息分析任务,本书学习内容主要使用免费工具SMS、BioEdit来完成。
BioEdit是一款免费的综合序列分析软件,非常适合序列比对、编辑和分析结果显示。
BioEdit是Windows图形界面软件,主要功能都提供了明显且易用的菜单选项,操作非常方便。BioEdit的序列窗口如图2-2所示。
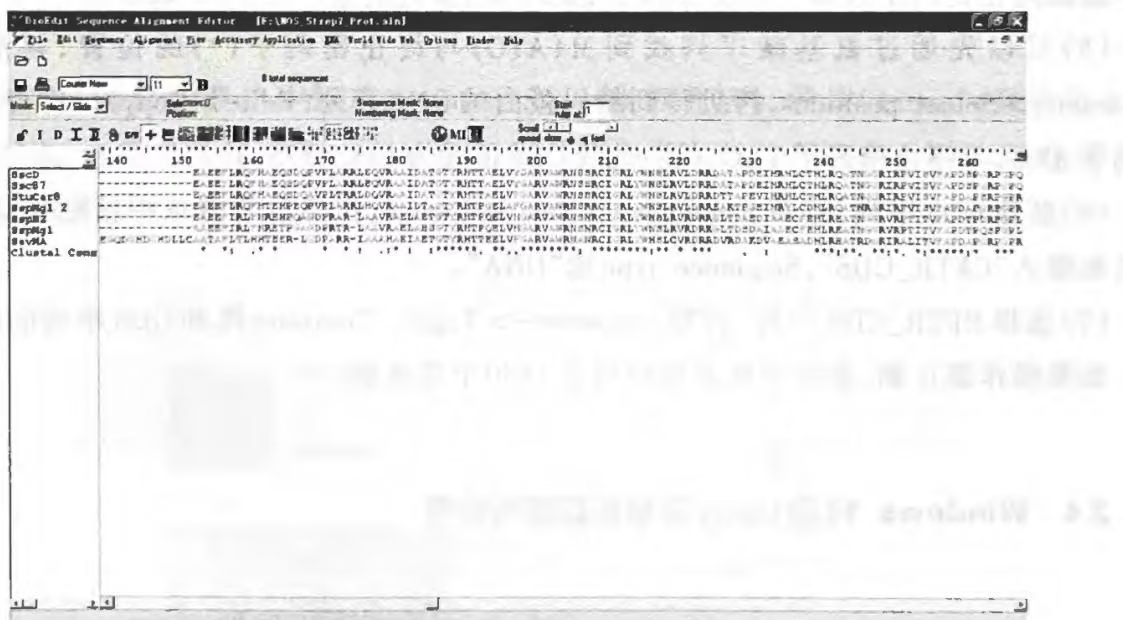
BioEdit提供多种序列分析功能,如把DNA序列翻译成蛋白质、转换互补链、序列比对、蛋白质疏水性分析、质粒图制作等。序列分析功能主要在Sequence菜单,如其中的Nucleic Acid(核酸)菜单可对核酸序列进行分析处理,包含核酸组成、互补、反向互补、DNA和RNA转换、翻译、ORF预测等功能;Toggle Translation(翻译切换)可把DNA翻译为氨基酸序列,在对编码蛋白质的DNA序列比对时,利用这个功能把DNA临时翻译为氨基酸序列,比对结束后再转换回原来的DNA序列,这时的DNA比对已经按密码子为单位排列,这样的比对通常更好地把同源位点排列在一起。
BioEdit 程序还集成了序列比对的常用程序 BLAST 和 ClustalW,以及其他一些著名序列分析网站的链接,如 Primer3、ExPASy proteomics tools 等。BioEdit 优良的序列编辑分析环境可以很方便地对 ClustalW 的比对结果进行编辑,直到获得满意结果。BioEdit 程序也可以进行多种序列格式的转换,方便用于其他程序的数据分析,如将 ClustalW 多序列比对结果的默认 CLUSTAL 格式转换成 FASTA 格式或 PHYLIP 格式等。
(1)从 NCBI 网站的 gene 数据库检索并下载 CFTR 基因的 mRNA 序列(索引号:NM_000492.3),保存为 FASTA 格式文件(CFTR_mRNA.fasta),并用记事本打开,把注释行改成:>CFTR_mRNA。
(2)用 BioEdit 打开 CFTR_mRNA.fasta 文件。注意: 此 mRNA 序列的 U 已经都被 T 代替。
(3) 如果想得到此 mRNA 的 DNA 模板链(template)序列, 可以通过 BioEdit 菜单 Sequence->Nucleic acid->Complement 得到。
(4) 将此 mRNA 翻译成蛋白质: Sequence->Nucleic acid->Translate->Frame 1 (或 Frame 2/Frame 3)。一条 mRNA 序列可以有 3 种不同的阅读框, 如序列 ACUGCCAC…可以是 ACU|GCC|AC… (对应氨基酸 Thr-Ala…) 或 A|CUG|CCA|C… (对应氨基酸 Leu-Pro…) 或 AC|UGC|CAC… (对应氨基酸 Cys-His…)。假设 CFTR 编码区域会占用大多数 mRNA 序列, 并不能被终止密码子打断。终止密码子 TAG/TGA 在氨基酸序列中用 * 表示。
(5)可以先通过氨基酸序列找到M(ATG)与终止密码子(*)的位置,再通过菜单Sequence->Select positions,拷贝得到编码蛋白的DNA序列(Edit->Copy)。检查序列起始密码子ATG,与终止密码子TAG。(注:此处CDS位置为133..4575。)
(6) 新建 CDS 序列: 菜单 Sequence->New sequence, 在跳出的窗口中粘贴 CDS 序列, 序列名称输入 “CFTR_CDS”, Sequence type 选 “DNA”。
(7)选择CFTR_CDS序列,再用Sequence->Toggle Translate得到CDS序列的氨基酸序列。如果操作都正确,最终的氨基酸序列是1480个氨基酸。
2.4 Windows 10 的 Linux 子系统安装与使用
微软在 Windows 10 新推出 Linux 子系统功能, 可在 Windows 系统下直接使用 Linux 系统的操作命令或运行原生 Linux 程序。WSL 是 “Windows Subsystem for Linux” 的缩写, 也就是 Windows 系统的 Linux 子系统。WSL 可以通过微软商店 (Microsoft Store) 进行安装, 像安装其他应用一样, 非常方便。
下面简要介绍下 WSL 安装过程, 注意 WSL 只能在 Windows 10 64bit 系统下使用, 而且安装 WSL 前需要将 Windows 10 64bit 升级到最新版本(至少要 Windows 10 1709 Fall Creators Update 以上版本)。
2.4.1 WSL安装
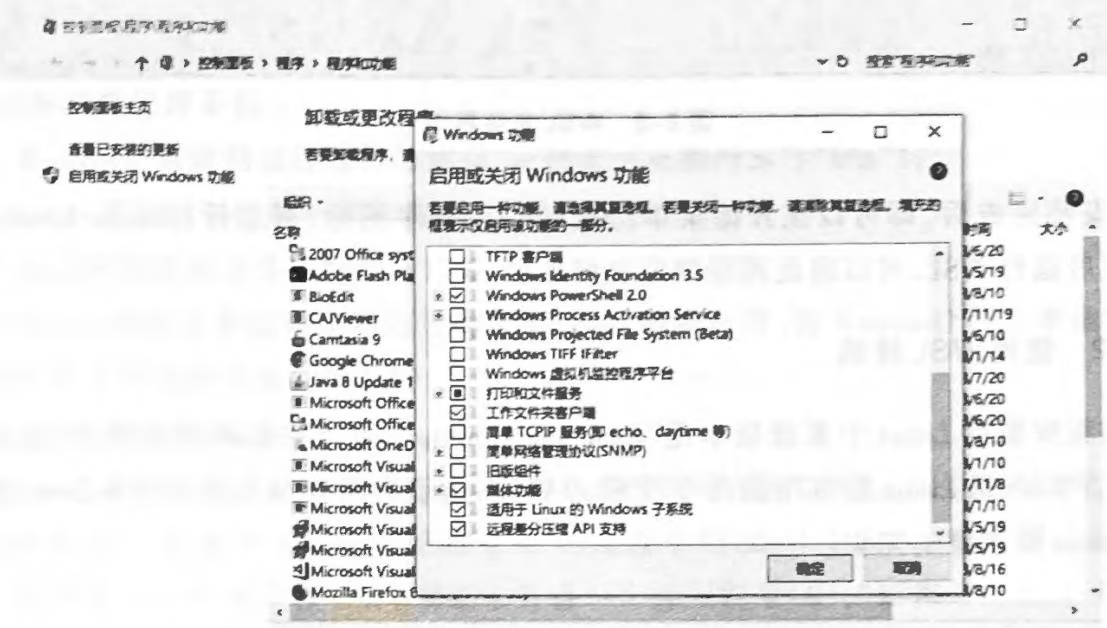
(1) 开启 WSL 功能
打开控制面板,选择“应用”->“程序与功能”->“启用或关闭 Windows 功能”(图 2-3),在弹出的面板中选中“Windows Subsystem for Linux”来启用 WSL 功能,点“OK”后重启系统。
(2) 在 Windows 开始菜单中打开 Microsoft Store(微软商店), 搜索“Linux”, 目前有 5 个 Linux 系统可选, 这里选择并下载 Ubuntu 系统(默认第一个), 即点击图 2-4 中的 Get 按钮, 文件大约只有 200Mb, 下载非常快。
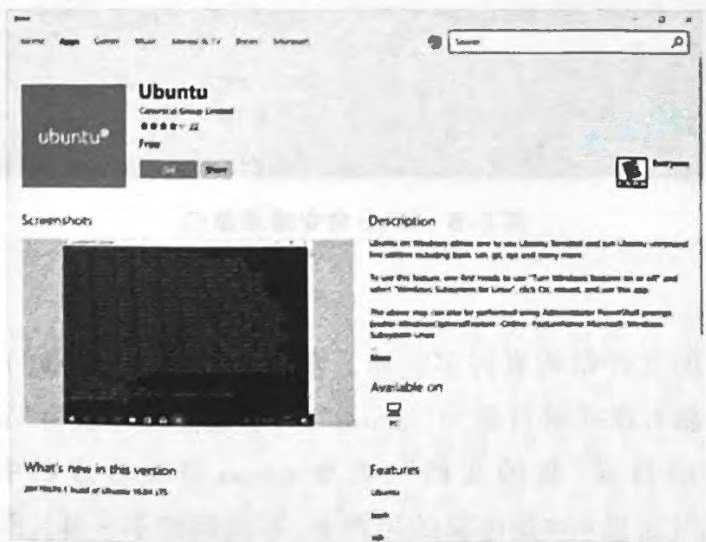
(3)当 Ubuntu 应用下载完成后,图 2-4 中的按钮变成“Launch”,点击“Launch”启动安装。安装过程会出现一个控制台窗口(图 2-5),并会提示你创建 Linux 用户账号,输入英文用户名,后再输入密码。这个用户名(username)与密码(password)与你电脑 Windows 系统的用户名密码没有任何关系,可以设置成不一样,也可以一样。
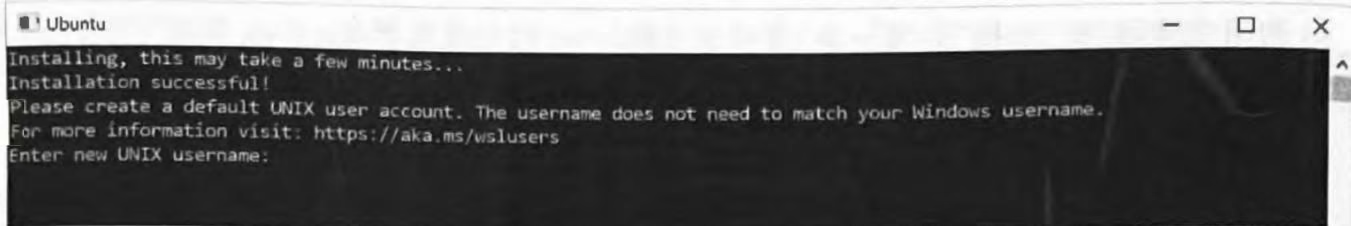
(4) 安装完成后, 即可以在开始菜单出现 Ubuntu 程序图标, 可运行 Ubuntu Linux 系统。为方便以后运行 WSL, 可以将此图标固定到任务栏。
2.4.2 使用WSL终端
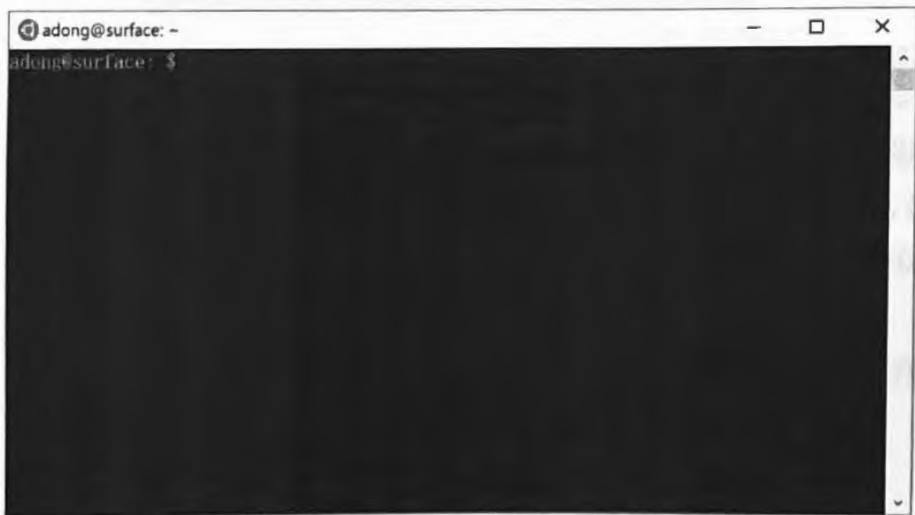
本教程安装的 Linux 子系统版本是“Bash on Ubuntu”,可以在 Bash 终端执行 Linux 命令(图 2-6)。Bash 是 Linux 最常用的命令行 Shell 终端,这里先只介绍几点在 Windows 10 系统下使用 Linux 要注意的知识。
(1) 文件目录
Linux 与 Windows 的文件结构有许多差异。在 WSL 环境中,电脑的各个硬盘分区都挂载在“/mnt”目录下,即电脑 C 盘挂载目录为“/mnt/c”,而 D 盘挂载目录为“/mnt/d”,以此类推。例如 Windows 系统常用的目录“我的文档”,在 Windows 资源管理器中显示的路径是:“C:\Users\xxxxDocuments\”(这里×××是电脑的用户名,不同用户不一样),而在 WSL 中,对应的路径是:“/mnt/c/Users/xxx/Documents/”。(注意:Windows 路径是用反斜杠“\”分隔目录。Linux 系
统的路径是用斜杠“/”分隔目录。)
在 WSL 下对此目录文件的读写操作,与在 Windows 资源管理器下对它们的操作没有区别。因此,在 WSL 下可以直接访问 Windows 的硬盘,我们可以把数据放在 Windows 的某个目录,然后切换到 WSL 对应的目录下运行 Linux 命令处理数据,并能在 Windows 资源管理器下用文本编辑器查看输出结果。因此,WSL 方便了对 Linux 不熟悉的生物学家进行生物信息数据分析与处理。
(2) 文本文件格式
Linux系统下创建的文本文件,比如多行基因序列文件,拷贝到Windows系统用记事本打开时,会发现所有的字母都会变成一行,无法换行显示,十分混乱。原因是Windows与Linux文件的换行符不同:
- Windows 系统的文件每行结尾是“<回车><换行>”("r\n”);
- Linux系统的文件每行结尾只有“<换行>”(“\n”);
- MacOS系统的文件每行结尾只有“<回车>”(“\r”)。
Windows 系统自带记事本不能正确识别 Linux 的换行符, 而 Notepad2 等文本编辑器则可以自动识别不同操作系统的换行符。
(3) Linux 命令行终端
Linux命令行终端(terminal)就是一个文本窗口程序(图2-6),如GNOME桌面环境的Terminal或KDE桌面的Konsole,通过它可使用命令行Shell, Ubuntu系统默认的Shell是Bash。终端显示一个提示符,Bash的提示符是一个美元符号($),“$”符号后面是光标位置,用户可以在此输入命令。如果当前用户是管理员(root),则命令提示符变成“#”号。由于系统安全性原因,一般不推荐用root用户登录使用Linux。Linux系统支持打开多个终端,如果有多个终端窗口,则当前终端窗口的光标是实心方块,可进行命令输入;其他窗口是空心方块,不能输入命令。
图2-6“$”符号前面显示“adong@surface:~”,其意义为:adong是当前用户名;surface是主机名,当你远程登录另一台服务器,主机名就会变化;“~”是用户主(home)目录的指示符,代表当前目录是/home/adong, Linux系统为每个用户自动分配一个自己使用的home目录。“@”与“:”是系统设定的分隔符号。退出终端可直接用鼠标点击窗口关闭按钮或输入命令“exit”并敲下回车退出。
终端常用技巧
- Tab 键自动补全名称: 输入命令、文件或目录名称的开头几个字母, 然后按 Tab 键, 名称中的其他部分会自动补充完成。如输入 his+[Tab], 就会输入 history 命令。如果 shell 找到多个以输入字母开头的名称, 将会响铃提醒, 可再输入几个字符再按 Tab 键。
- 向上(↑)或向下键(↓):可以显示最近终端中使用过的命令,如可以调出以前输入过的长命令,不用再重新输入,节省时间。
- 如果输入有误,可以用 Ctrl+U(同时按下 Ctrl 键与 U 键)取消整个输入行内容。
- 编辑命令可快速移动光标: Ctrl+A 可以把光标定位到行首, 而 Ctrl+E 移到行尾
- 清理终端显示内容:Ctrl+L,功能相当于命令“clear”。
- 终止进程: Ctrl+C(同时按下 Ctrl 键与 C 键终止命令)。
2.4.3 Linux简单命令
精通 Linux 系统对初学者来说非常困难,但其实只需掌握一些 Linux 简单命令就可以做生物信息学分析。这里介绍几个 Linux 最常用的命令的使用,最好先学习 Linux 的文件系统结构与命令终端的知识。
常用Linux命令
- ls: 显示文件或目录,如:$ls -l(显示目录详细信息)
- cd: 改变目录,如:$cd~(切换到用户目录)
- pwd: 显示当前工作目录
- mkdir:创建目录,如:$mkdir dirname(目录名)
- rm:删除文件或目录,如:$rm filename(删除文件)
- mv:移动/重命名文件,如:$mv filename1 filename2(将filename1重命名为filename2)
- cp:复制文件,如:$cp filename1 filename2(将filename1复制为filename2)
- cat: 阅读文件内容,如:$cat > cat filename(将标准输出放在 filename 文件中)
- echo: 输出字符串
- kill:结束进程,如:$kill PID(进程ID)
- top:查看进程
- sudo:授予超级用户权限执行命令
(1) 打开一个终端, 进入电脑 C 盘, 看里面有什么文件。
$ ls #在终端输入“ls”并回车,显示当前目录内容
$ cd /mnt/c #切换到 Windows 系统的 C 盘根目录
$ ls -al #加上选项(-al)显示当前目录的所有文件及其详细信息
$ pwd #显示当前目录为: /mnt/c
(2) 在电脑 C 盘下创建一个目录(test),并转到 test 目录
$ mkdir test #创建目录
$ cd test #切换到此目录
(3) 新建一个文本文件(test.txt),并输入当前目录下的所有文件名。
$ ls /mnt/c > test.txt #此命令中“>”符是Linux的输入输出重定向符,将前面命令的输
出作为后面命令的输入。
(4) 用 Notepad2 打开 test.txt,并在文件末尾输入任何句子,如“Linux 挺好玩!”,并保存。回到 WSL 终端,显示 test.txt 文件。
1 | \$cat test.txt |
(5) 将 test 目录下的文件复制到用户的 Home 目录 (~), 查看后又删除 Home 目录下 test.txt。
$ cp test.txt ~ #注意命令、文件及Home目录(~)三者之间都有空格
$ cd ~ #切换到Home目录
$ ls #列出当前目录文件
$ rm test.txt #删除文件
$ cp sources.list ~/sources.list.bak #修改前先备份文件(后缀.bak)
$ cp sources.list /mnt/c/test #将文件复制到 test 目录
注:这里可以使用 Linux 终端的自动补全功能,如只要输入“cp sou”再按[Tab]键,就可补充成“sources.list”。如果还有多个选项,终端会响铃提醒,然后再多输入几个字母再按[Tab]就可以完成自动输入。
(6)最后,更改 Ubuntu 系统的更新源为国内的镜像站。默认是国外的网站,安装程序速度会非常慢。
$cd /etc/apt #切换到/etc/apt目录
$cp sources.list ~/sources.list.bak #修改前备份文件
$cp sources.list /mnt/c/test #将文件复制到test目录
(7) 在 Windows 下用 Notepad2 打开 test 目录下的 sources.list,并用章末二维码提供的文件 ubuntu_sources.list 内容全部替换,再保存文件,将 Ubuntu 软件源更改为阿里云镜像。
$pwd #确定还是在/etc/apt目录
$sudo cp /mnt/c/test/sources.list . #此处点(“.”)代表当前目录/etc/apt
(8)然后,执行如下命令更新系统软件仓库:
$ sudo apt update #更新软件仓库索引
$ lsb_release -a #查询 Ubuntu 版本
注意,必需要使用与前面安装的 Ubuntu 系统版本号一致的源文件,不然会更新失败!
此命令显示将安装或更新多少个软件包,需要占用多少磁盘空间等,提示是否继续。[Y/n],输入 Y,将更新系统。
这里的 Ubuntu 更新源是 Ubuntu 20.04LTS 版本, 如果你的 Ubuntu 系统不是这个版本, 则不能用此文件, 请自行上网查询相应版本的国内源。
$lsb_release -a #查询 Ubuntu 版本
习题
用生物软件 BioEdit 对一条序列进行 DNA 翻译、互补链、序列比对等操作。
打开 WSL 终端, 进行常见命令的练习, 并将所有练习的历史命令保存为一个文件。
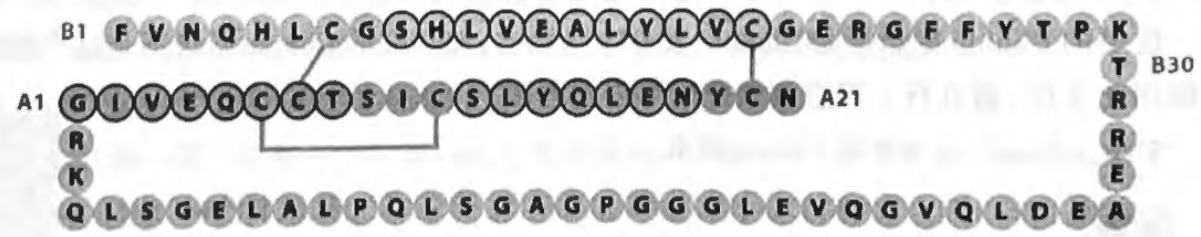
第一章 生物信息学的概念及发展历史
本章提要
自从 1990 年美国启动人类基因组计划以来,人与模式生物基因组的测序工作进展极为迅速。美国最新公布的 GenBank 数据库版本拥有的 DNA 序列总量已超过 1 万亿个碱基对,与其同步增长的还有
氨基酸序列,序列信息像潮水般向人们涌来。因此,有人说,基于序列的生物学时代已经到来。生物学家面临的最主要的一个困难就是处理浩瀚的数据,序列数据并不等于信息和知识,却是信息和知识的源泉,关键在于如何从中挖掘它们,这就催生了一门新兴的交叉科学——生物信息学。21世纪是生命科学的世纪,离不开生物信息学的发展。生物信息学是将计算机与信息科学技术运用到生命科学,尤其是分子生物学研究中的交叉学科。
第一节 生物信息学的发展历史
随着基因组计划的进展,海量的生物学数据必须通过生物信息学的手段进行收集、分析和整理,才能成为有用的信息和知识。人类基因组计划为生物信息学提供了兴盛的契机。目前,生物信息学已经深入生命科学的方方面面。
欧美国家一直非常重视生物信息学的发展,各种专业研究机构和公司如雨后春笋般涌现出来,生物科技公司和制药企业内部的生物信息学部门的数量与日俱增。但由于对生物信息学的需求是如此迅猛,即使是像美国这样的发达国家也面临着人才匮乏、供不应求的局面。
目前,各类生物信息学专业期刊门类繁多,包括纸质期刊和电子期刊两种,如 Bioinformatics(前身为 Applications in the Biosciences)、Nucleic Acids Research、Briefings in Bioinformatics、Genomics、Proteomics & Bioinformatics、PLoS Computational Biology、BMC Bioinformatics、Journal of Computational Biology 及 Journal of Integrative Bioinformatics 等。
从网络资源来看,国外互联网上的生物信息学网点繁多,大到代表国家级研究机构,小到代表专业实验室。大型机构的网点一般提供相关新闻、数据库服务和软件在线服务;小型科研机构一般是介绍自己的研究成果,有的还提供自行设计的算法在线服务。总体而言,它们基本都是面向生物信息学专业人士,各种分析方法虽然很全面,但却分散在不同的网点,分析结果也需专业人士来解读。
目前,绝大部分的核酸和蛋白质数据库由美国、欧洲及日本的三家数据库系统产生,它们共同组成了 GenBank/ENA/DDBJ 国际核酸序列数据库,每天交换数据,同步更新。其他一些国家,如德国、法国、意大利、瑞士、澳大利亚、丹麦和以色列等,在分享网络共享资源的同时,也分别建有自己的生物信息学机构、次级或者衍生的具有各自特色的专业数据库及自己的分析技术,服务于本国生物医学研究和开发,有些服务也开放于全世界。
国内对生物信息学领域的研究也越来越重视,自北京大学于1996年建立了国内第一个生物信息学网络服务器以来,我国生物信息学的研究得到蓬勃发展。较早开展生物信息学研究的单位主要有:北京大学、清华大学、浙江大学、中国科学院生物物理研究所、中国科学院上海生命科学研究院、中国科学院遗传与发育生物学研究所等。北京大学、天津大学分别于1997年、1998年成立了生物信息学中心,中国科学院上海生命科学研究院也于2000年3月成立了生物信息学中心。如今,生命科学的基础研究与技术开发对生物信息学的科研与人才需求越发迫切,越来越多的高等院校、科研单位开展了生物信息学教育和科研工作,少数如哈尔滨医科大学专门设置了生物信息科学与技术学院,越来越多的生物信息学技术服务机构或公司也提供了相应的科技服务。
表 1-1 列出了生命科学、计算机科学及生物信息学大事记,从中可以看出其发展进程及中国的贡献。
表 1-1 生命科学、计算机科学及生物信息学相关大事记
| 生命科学 | 年份 | 计算机科学 |
| 1642 | Blaise Pascal 发明机械计算器 | |
| Robert Hooke 在其著作中描述了细胞结构 | 1665 | |
| John Ray 提出了物种分类 | 1686 | |
| 1858 | 电报 | |
| 达尔文的《物种起源》出版 | 1859 | |
| 孟德尔遗传定律提出 | 1865 | |
| Nirenberg 和 Khorana 破译了遗传密码字典的全部 64个三联体密码子 | 1966 | 美国计算机协会设立图灵奖 |
| 首次分离得到 DNA | 1869 | |
| 1876 | 电话 | |
| Walter Flemming 观察到有丝分裂 | 1879 | |
| 确认孟德尔遗传定律 | 1900 | |
| 疾病可以有序遗传;遗传的染色体理论 | 1902 | |
| 术语“基因”的出现 | 1909 | |
| 染色体理论在果蝇中得到验证 | 1911 | |
| Alfred H. Sturtevant 绘制了第一张遗传连锁图谱 | 1913 | |
| “一个基因一个酶”假说 | 1941 | |
| DNA 的 X 射线衍射 | 1943 | 第一台电子管计算机 ENIAC 研发并于 1946 年诞生 |
| DNA 可以改造细胞的特性;跳跃基因的发现 | 1944 | |
| O. T. Avery 证明 DNA 是遗传物质 | 1944 | |
| 1945 | 第一个计算机 Bug | |
| Lederberg 和 Tatum 证实了遗传重组现象 | 1946 | |
| 发现 DNA 配对法则 | 1952 | 第一个编译器的发明 |
| Francis Crick、James Watson 和 Maurice Wilkins 发现 DNA 的双螺旋结构 | 1953 | |
| 人类 46 条染色体的确定;DNA 聚合酶的发现;第一个蛋白质序列(牛胰岛素)被测定 | 1955 | |
| 血红蛋白的一个氨基酸改变可以导致镰状细胞贫血 | 1956 | |
| DNA 的半保留复制 | 1958 | 中国第一台电子管计算机诞生 |
| 染色体异常致病被发现 | 1959 | |
| 1960 | 计算机 COBOL 处理电话交换 | |
| mRNA将信息从细胞核内传递到细胞质 | 1961 | |
| 1963 | 美国信息互换标准代码(ASCII);鼠标 | |
| 1964 | BASIC语言 | |
| 中国人工合成牛胰岛素结晶;Margaret Dakley Daghoff收集蛋白质序列,并在随后一年提出PAM模型 | 1965 | |
| 发现第一个限制酶 | 1968 | |
| 1969 | UNIX操作系统 | |
| 1970 | Needleman-Wunsch序列比对算法 | |
| 1971 | 个人电脑 | |
| 第一个重组DNA | 1972 | C语言 |
| 第一个动物基因被克隆 | 1973 | 文件传输协议(FTP)出现 |
| DNA测序工作的开启 | 1975 | 微软公司成立 |
| 第一个遗传工程公司成立 | 1976 | 苹果公司成立 |
| Sanger研究小组完成了第一个噬菌体全基因组的测序;内含子的发现 | 1977 | |
| 1978 | 第一个电子布告栏系统(BBS)的出现 | |
| 1979 | 新闻组(Newsgroup)的出现 | |
| 中国实现酵母丙氨酸转移核糖核酸的人工合成 | 1981 | 第一个计算机病毒Eld Cloner出现;Smith-Waterman序列比对算法;MS-DOS 1.0发布 |
| 1982 | Sun公司推出第一个工作站Sun 100;英特尔80286处理器 | |
| 1983 | 微软Windows系统命名 | |
| 1984 | 互联网节点数超过1000个 | |
| Kary Mullis创立PCR技术;生物信息学专业期刊(CABIOS)创刊;德国生物信息学会议(GCB)举行 | 1985 | Bjarne Stroustrup创建C++语言 |
| 日本核酸序列数据库DDBJ诞生;蛋白质数据库Swiss-Prot建立;中国开始实施国家高技术研究发展计划(863计划) | 1986 | 标准通用置标语言(SGML)ISO标准公布 |
| 1987 | Perl语言 | |
| 美国国家生物技术信息中心(NCBI)成立 | 1988 | Pearson实现FASTA程序 |
| 1989 | 英特尔发布486处理器 | |
| 国际人类基因组计划(HGP)启动;第一届国际电泳、超级计算和人类基因组会议在美国佛罗里达州会议中心举行 | 1990 | Altschul实现BLAST程序;HTTP 1.0标准发布 |
| 1991 | Linux出现;Python语言发布 | |
| 欧洲生物信息学研究所(EBI)获准成立;第一届ISMB国际会议在美国国家医学图书馆(NLM)举行;HGP新5年计划,中国开始参与人类基因组计划 | 1993 | 英特尔发布奔腾处理器 |
| Marc Wilkins提出蛋白质组(proteome)的概念;细菌基因组计划 | 1994 | 雅虎公司成立;Perl 5发布 |
| 人类基因组物理图谱完成;日本信息生物学中心(CIB)成立 | 1995 | Sun正式发布Java;Apache HTTP项目启动;微软发布Windows 95系统 |
| Affymetrix 生产商用 DNA 芯片;北京大学蛋白质工程和植物遗传学工程国家实验室加入欧洲分子生物学网络(EMBnet) | 1996 | 微软发布 IE 3.0 |
| 大肠杆菌基因组测序完成;北京大学生物信息学中心(CBI)成立;中国科学院召开“DNA 芯片的现状与未来”和“生物信息学”香山会议 | 1997 | 微软发布 IE 4.0;IBM 深蓝计算机击败国际象棋世界冠军 |
| 亚太生物信息学网络(APBioNet)成立;瑞士生物信息学研究所(SIB)成立;美国 Celera 遗传公司成立;线虫基因组测序完成;CABIOS 期刊更名为 Bioinformatics;中国人类基因组研究北方中心(北京)和南方中心(上海)成立 | 1998 | W3C 发布可扩展标记语言 XML 1.0;微软发布 Windows 98 |
| 人类 22 号染色体序列测定完成;中国获准加入人类基因组计划,成为第 6 个国际人类基因组计划参与国 | 1999 | 英特尔发布奔腾III处理器 |
| 德国、日本等国科学家宣布基本完成人体第 21 对染色体的测序工作;果蝇基因组测序完成;中国科学院上海生命科学研究院生物信息中心(SIBI)成立 | 2000 | 微软发布 Windows 2000 和 Windows Me 简单对象访问协议(SOAP) |
| 美国、日本、德国、法国、英国、中国 6 国科学家和美国 Celera 公司联合公布人类基因组图谱及初步分析结果;中国首届全国生物信息学会议(CCB)举行;中国完成籼稻基因组工作框架图 | 2001 | 微软发布 Windows XP;Linux 内核 2.4 |
| 小鼠基因组测序完成 | 2002 | |
| HGP 完成;第二代测序技术(NGS) | 2003 | 微软发布 Windows Server 2003;Linux 内核 2.6 |
| 蛋白质组学;解码基因组;大鼠和鸡基因组草图完成 | 2004 | |
| 大猩猩和犬全基因组测序完成;人类 HapMap 项目完成 | 2005 | |
| 我国研制出全球首例骨髓分析生物芯片 | 2006 | |
| 世界首份“个人版”基因图谱完成 | 2007 | 谷歌和 IBM 合作推动云计算 |
| 千人基因组测序计划启动;拟南芥 1001 株系测序启动 | 2008 | 英特尔发布酷睿 i7 处理器 |
| 黄瓜、高粱和两个玉米品种的基因组测序 | 2009 | |
| 外显子测序 | 2010 | 我国“天河一号”成为全球运算速度最快的超级计算机;苹果公司发布 iPad 平板电脑 |
| 体细胞重编程技术;“垃圾”DNA 得到正名 | 2012 | |
| CRISPR 基因编辑技术将成为基因编辑的常用工具 | 2013 | 我国“天河二号”超越美国 “Titan 号”,再次成为全球运算速度最快的超级计算机 |
| 癌症的 CAR-T 疗法和 HIV 的 T 细胞疗法 | 2014 | |
| Roadmap Epigenomics Program 发布表观基因组图谱 | 2015 | |
| 深圳国家基因库 CNGB 正式运营 | 2016 | 基于强化学习的 AlphaGO 程序击败围棋世界冠军;采用国产核心处理器的“神威·太湖之光”超过“天河二号”成为世界上运算速度最快的超级计算机 |
| 人类细胞图谱计划启动;首次合成包含两种人工碱基的生命体 | 2017 | 光量子计算机诞生 |
| 单细胞水平细胞谱系追踪技术;世界首例单条染色体真核细胞出现;小麦基因组图谱历经 13 年绘制完成 | 2018 | 我国新一代“天河三号 E 级原型机系统”首次亮相 |
| DNA 显微镜研制成功;新型人造 DNA 结构信息密度可加倍;国家基因组科学数据中心(NGDC)成立;国家生物信息学中心挂牌成立 | 2019 | 新型类脑计算芯片——“天机芯”芯片研发成功;中国正式进入 5G 商用元年 |
| 首张人类细胞图谱公布;CRISPR 基因编辑技术首次用于临床治疗;mRNA 疫苗首次投入使用 | 2020 | 量子计算原型机“九章”实现量子优越性;基于深度学习的 AlphaFold 解决蛋白质折叠难题 |
第二节 生物信息学的研究领域
虽然生物信息学可以理解为 “生物学+信息学(计算机科学及应用)”,但作为一门学科,它有自己的学科体系,而不是简单的叠加。需要强调的是,生物信息学是一门工程技术学科。必须注意到,生物信息学的研究内容与研究对象或客体(应用方面)是不同的概念。很显然,生物信息学的研究对象是生物数据。其中,最 “经典” 的是分子生物学数据,即基因组技术的产物——DNA 序列。后基因组时代将从系统角度研究生命过程的各个层次,走向探索生命过程的每个环节,包括微观(深入到研究单个分子的结构和运动规律)和宏观(结合宏观生态学,从大的角度来研究生命过程)两个方向,着重于 “序列→结构→功能→应用” 中的 “功能” 和 “应用” 部分。就研究面来说,其涉及并参与生命科学各个领域的研究(陈铭,2004)。
分子生物学与细胞生物学 该领域以 DNA-RNA-蛋白质为对象,分析编码区和非编码区中信息结构和编码特征,以及相应的信息调节与表达规律等。由于生物功能的主要体现者是蛋白质,研究蛋白质的修饰加工、转运定位、结构变化、相互作用等活动将推动对基因的功能、表达和调控的理解,对细胞活动及器官、系统、整体活动的调控都很关键。
生物物理学 生物物理学其实是物理学的一个分支,研究的是生物的物理形态,涉及生物能学、结构生物学、生物力学、生物控制论、电生理学等。但这方面的生物数据获取和分析也越来越依赖于计算机的应用,如模型的建立、光谱和成像数据的分析等。
脑和神经科学 脑是自然界中最复杂的组织,长期以来,通过神经解剖、神经生理、神经病理和临床医学研究,获得了大量有关脑结构和功能的数据。近年来,神经生物学研究也取得了大量科研成果,但是这些研究大多是在组织、细胞和分子水平进行的,不能很好地在系统和整体水平上反映人脑活动的规律。随着核磁共振成像和正电子发射断层成像的发展,应用计算机技术,我们有可能在系统和整体水平上无创地研究人脑的功能定位、功能区之间的联系及神经递质和神经受体等。由此产生的神经信息学研究,将对我们了解脑、治疗脑和开发脑产生重大的作用。
医药学 人类基因组计划的目的之一就是找到人类基因组中的所有基因。如何筛选分离各疾病的致病基因,获得疾病的表型相关基因信息的工作才刚开始。我们需要在现有的基因测序的工作平台上,强化生物信息学平台的建设,从而加快对突发性疫情、公共卫生的监控,以及对致病源进行快速有效的分析和解决。此外,结合生物芯片数据分析,确定药物作用靶点,再利用计算机技术进行合理的药物设计,将是新药开发的主要途径。
农林牧渔学 基因组计划也加快了农业生物功能基因组的研究,加快了转基因动植物育种所需生物信息学研究的步伐。通过比较基因组学、表达分析和功能基因组分析识别重要基因,为培育转基因动植物、改良动植物的质量和数量性状奠定了基础。通过分析病虫害、寄生生物的信号受体和转录途径组分,进行农业化合物设计,结合化学信息学方法,鉴定可用于杀虫剂和除草剂的潜在化学成分。此外,通过此方法可以进行动植物遗传资源研究,保护生物多样性;还可以对工业发酵菌进行代谢工程的研究,有目的地控制产品的生产。
分子和生态进化 另一个重要的研究对象就是分子和生态进化。通过比较不同生物基因组中各种结构成分的异同,可以大大加深我们对生物进化的认识。从各种基因结构与成分的进化、密码子使用的进化,到进化树的构建,各种理论上和实验上的课题都等待着生物信息学家的研究。
第三节 生物信息学的主要应用
一、生物信息学数据库
生物信息学很大一部分工作体现在生物数据的收集、存储、管理与共享上,包括:建立国际基本生物信息库和生物信息传输的国际联网系统;建立生物信息数据质量的评估与检测系统;生物信息工具开发和在线服务;生物信息可视化和专家系统。
比较著名的与生物有关的数据资源有 NCBI、EMBL、KEGG 等。
(一)数据库建设
生物数据库的建设是进行生物信息学研究的基础,尽管目前已有许多公共数据库可供使用,如 GenBank,且它们还同时集成开发了相应的生物分析软件工具,如 NCBI 的 BLAST 系列工具(http://blast.ncbi.nlm.nih.gov/Blast.cgi)。但我们进行专项研究时,往往需要组建新的数据库。建立自己的数据库,就必须分析数据库的储存形式和复杂程度,选择什么数据库,怎么开发信息交流平台,要不要提供相应的分析程序,甚至要不要将各搜索算法硬件化,实行并行计算、显卡处理器(GPU)计算和先进的内存管理以提高速度等。此外,也需要考虑架设数据库的成本。Oracle(http://www.oracle.com)这类大型数据库的价格较高,而免费的 MySQL(http://www.mysql.com)则可能会有功能上的缺失。目前来看,基于 UNIX 开发的共享数据库 PostgreSQL(http://www.postgresql.org)较为适宜。此外,XML 类数据库亦可提供一些解决方案。
(二)数据库整合和数据挖掘
生物数据库覆盖面广,分布分散且异质。当根据一定的要求将多个数据库整合在一起提供综合服务、提供数据库的一体化和集成环境时,最简单的方法是用超级链接或进行拷贝再整理。但往往简单的链接并不能符合要求,再整理涉及数据下载和更新的问题,而且不是真正意义上的“整合”。目前使用较多的是联合数据库系统,它是IBM分布式数据库解决方案的重要组成部分,支持用户或应用程序在同一条SQL语句中查询不同数据库甚至不同数据库管理系统中的数据。也有直接基于Internet技术而进行远程查询,从而进行文本数据挖掘和再整理的。由于生物的分支学科较多,整合时还需从语义学的角度考虑不同数据库的一致性问题,其实这已经成为了通过标准查询机制来连接数据库的一大阻碍,Ontology技术可能可以解决这一问题。
二、序列分析
(一)序列比对
生物信息学最基本的操作对象是核酸序列和氨基酸序列。
1955 年桑格(Frederick Sanger)完成了第一个蛋白质——牛胰岛素化学结构的测定。1977 年,他领导的研究小组再一次成功地测定了第一个噬菌体 $\Phi X174$ 全基因组 5386 个碱基对的核苷酸序列,并发明了快速测定 DNA 序列的新方法。此后,全世界生物科学研究进入了分子水平。在使用鸟枪法进行 DNA 测序时,完整的 DNA 链被打散为成千上万条长 600~800个核苷酸的 DNA 片段,这些 DNA 片段的两端相互重叠,只有依照正确的顺序组合,才能还原为完整的 DNA 序列。对于较大的基因组,鸟枪法能够迅速地测定 DNA 片段的序列,但将它们组装起来的工作则相当复杂。由于现今几乎所有基因序列均由鸟枪法测定,基因重组算法是生物信息学研究的重点课题。
比较序列的目的是发现相似的序列,得到保守的区域,它们可能有结构、功能或进化上的关系。对于一个感兴趣的 DNA 或蛋白质序列,寻找到与它同源的序列是基本工作。目前已开发了很多的算法,其中 BLAST 或 FASTA 都是不错的算法。在此基础上开发的 PSI-BLAST 和 megaBLAST 等,针对不同情况有更好的性能。
(二)基因序列注释
越来越多的物种测序工作的开展,迫切需要全基因组的自动注释,这一直都是生物信息学的研究领域。Ensembl 是由 EBI 和 Sanger 研究院合作的一个项目,利用大型计算机根据已有的蛋白质证据来对 DNA 序列进行自动注释。自动寻找基因和调控元件的工作通常的步骤包括:翻译起始点和终止点的确定,潜在的阅读框、剪切位点的识别,基因结构的构建,各种反式和顺式调控元件的识别等。除此以外,转录起始位点和可变剪切体的鉴定等工作都可利用计算生物学方法从庞大的基因组数据中提取出生物学信息,把它注释并图形化显示给生物学家。
三、其他主要应用
(一)比较基因组学
各种模式生物基因组测序任务的陆续完成,为从整个基因组的角度来研究分子进化提供了条件。比较基因组学的核心课题是识别和建立不同生物体的基因或其他基因组特征的联系。利用比较基因组学方法可以研究不同物种间的基因组结构的关系和功能。发现基因组中新的非编码功能元件是很有前途的应用。起初,真核生物中基因预测依靠概率模型预测得到,该方法的缺点是会产生很多的假阳性。通过比较不同物种间的同源基因可以大大提高预测的精度和准度。例如,在人类基因预测上,老鼠的基因信息起到了很重要的作用。
(二)基因和蛋白质的表达分析
进入后基因组时代,高通量技术高速发展并得到广泛应用。多种生物学技术可以用于测量基因的表达,如微阵列、表达序列标签、基因表达连续分析、大规模平行信号测序、多元原位杂交法等。这些方法均严重依赖于环境并能产生大量高噪声的数据,而生物信息学致力于发展一套统计学工具,并从中提取有用的信息。
通过蛋白质微阵列技术或高通量质谱分析对生物标本进行测量所获得的数据中,包含大量生物标本内蛋白质的信息,生物信息学被广泛地应用于这些数据的分析。对于前者,生物信息学所面临的问题与 RNA 微阵列数据分析中遇到的问题相似;对于后者,生物信息学将所获得的大量质谱数据与通过已知蛋白质数据库预测的数据进行比较,并使用复杂的统计学方法进行进一步分析。
(三)生物芯片大规模功能表达谱的分析
生物芯片因为其具有高集成度、高并行处理能力及可自动化分析的优点,可对不同组织来源、不同细胞类型、不同生理状态的基因表达和蛋白质反应进行监测,从而获得功能表达谱。此外,生物芯片还可进行 DNA、蛋白质的快速检测及药物筛选等。由此可见,无论是生物芯片还是蛋白质组技术的发展都更强烈地依赖于生物信息学的理论与工具。鉴于生物芯片固有的缺陷及实验重复性等问题,以及有关表达谱的分析还不很精确,仍需大量的工作来提高对斑点图像处理的能力和系统的分析。
近年来,随着第二代测序技术的使用,人们已普遍运用 RNA-Seq 技术来进行大规模转录组表达谱的分析(第六章)。
(四)蛋白质结构的预测
蛋白质结构的预测是生物信息学最重要的任务之一。蛋白质的一级结构决定其高级结构,而后者又决定着它的生物学功能,目标是通过氨基酸序列来预测出蛋白质的三维空间结构。这方面的用途在医药工业上特别突出,如药物设计、各种特殊用途的酶设计等。对于序列同源性大于25%的蛋白质,可以使用比较同源模建的方法预测蛋白质结构,如SWISS-MODEL和Modeller软件。对于没有合适模板的蛋白质预测可以使用折叠识别方法。折叠识别方法尝试寻找该目标序列可能适合的已知的蛋白质三维结构。如果前两种方法都无效,则要从头预测(de novo modeling),它的缺点是计算量大、耗时,而且仅适用于长度为几十个氨基酸的蛋白质片段,因此该方法目前主要作为前两种基于模板预测法的补充。整体来看,蛋白质结构预测领域还有待发展,特别是深度学习技术的成功应用有望推动该领域进入一个新的阶段。
(五)蛋白质与蛋白质相互作用
蛋白质与蛋白质相互作用与识别是当今生命科学研究的前沿和热点。基因的复制与转录、蛋白质的翻译与加工、免疫识别、信号传导等重要细胞生理过程都是通过蛋白质相互作用实现的。能够鉴定特定蛋白质是否相互作用的生物学实验技术有很多种,如免疫共沉淀、酵母双杂交系统、双分子荧光互补等,但这些方法无法反映出蛋白质从空间结构的角度是如何相互作用的。X射线晶体衍射和核磁共振等结构生物学技术可以高分辨率地展示蛋白质之间在空间上是如何结合的,但实验操作十分困难且昂贵。利用计算机技术有望基于蛋白质的各种性质,如理化性质、初级结构、三维结构等,来对蛋白质互作进行预测。其中,卷积神经网络、循环神经网络等深度学习技术已经大幅提高了蛋白质互作的预测精度,但其对训练集的依赖较大且可解释性仍有待提高。
(六)表型组学
表型组学即通过评估生物体的形态、生理和生化特征,以及与遗传、表观遗传和环境因素的相关性,对表型进行高通量组学分析。近年来,表型组学在植物学研究中应用广泛,且被认为可能是未来粮食安全和第二次绿色革命的关键。植物表型组学是对植物生长发育、性状等的调查分析。植物表型分析则是从图像和传感器数据中提取和分析有关植物结构和功能的定量数据。这种方法可以将基因型与表型差距对应,已普遍用于植物育种、通过遗传标记预测表型等领域。一些高通量的自动化表型分析平台已被用于不同环境条件下的植物表型组学研究,有助于研究人员将多参数表型信息与遗传变异联系起来。其中,植物表型图像的识别与处理是表型组学的重点与难点。一些自动成像分析方法可将图像信息转换为生长、生理特征,以及抗性和产量等表型测量值。基于深度学习的图像识别处理技术将会是一个重要的研究方向。
(七)生物系统模拟
生物体是个复杂的系统,整个系统可以分成多个亚系统。现在的生物学家越来越清楚地认识到网络涉及生物的方方面面,从而兴起了一个新概念——系统生物学。Leroy Hood认为系统生物学是确定、分析和整合生物系统在遗传或环境的扰动下所有内部元件间相互作用关系的一门学科。模拟生物系统对于更好地理解生命的本质活动至关重要。细胞水平下的代谢网络、信号转导通路、基因调控网络的构建,以及分析和可视化工作都给生物信息学带来了挑战。另外,人工生命或虚拟进化的研究往往致力于通过计算机模拟简单的生命形式来理解进化过程。
(八)代谢网络建模分析
代谢网络涉及生化反应途径、基因调控及信号转导过程(蛋白质间的作用)等。后基因组时代将研究大规模网络的生命过程,又称为“网络生物学”研究。
预测调控网络 尽管目前已有多个代谢网络途径数据库,有些数据可以直接参考使用,而且这些数据库本身除了手工和自动检索文献以补充数据外,也有开发预测工具的,但是都有局限性和准确性的问题,还需要从基因组来预测网络,或有针对性地去整合某些数据,研究其规律,开发算法模型等。已有若干研究小组从事“基因组到代谢网络”的预测。
网络普遍性分析 构建调控网络之后,人们对网络的“图论”方面的属性做了分析,如最短距离、连接度等,试图给出一些重要的结论;也有分析其最小单元的代谢途径等。越来越多的人开始开发专门的软件工具来自动分析大规模网络系统的物理属性,提供路径导航、模式搜索、图形简化等分析手段。
建立模型分析 目前已有若干个比较优秀的代谢网络建模工具,如 Copasi(http://www.copasi.org)、E-cell(http://www.e-cell.org)等,它们大都基于代谢控制分析原理,使用常微分方程来求解反应速率。基于标准化数据输出输入考虑,已经组成了合作组,共同支持 SBML(http://sbml.org)数据交换。其他形式的建模工具也很多,如用随机方法处理的,因为毕竟确切的动态参数目前还很难得到。其他如用 Petri net 进行建模的,由于其强大的数学计算功能和明了的示图形式,也越来越多地引起人们的兴趣。另外,如何自动建立大规模的代谢网络,也是个正在进行中的课题。
与代谢分析直接相关的便是系统生物学研究,它将是后基因组时代最为突出的研究方向。它要求我们看待生命活动过程要用系统的眼光,而不能只盯住一个方面的数据分析而隔离联系。所谓的“Virtual Cell(虚拟细胞)”模型就是基于系统考虑。
(九)计算进化生物学
引入信息学到进化生物学中,使得生物学家可以通过测量 DNA 上的变化来追踪大量生物的进化事件。通过比较全基因组,还可以研究更复杂的进化事件,如基因复制、水平基因转移、物种形成等,为种群进化建立复杂的计算模型,以预测种群随时间的演化。
(十)生物多样性研究
生物多样性数据库集合了物种的各种信息。计算模拟种群动力学过程,或计算人工培育下或濒危情况下的遗传健康状况。生物信息学在这方面一个重要的前景是保存大量物种的遗传信息,可以把自然的遗传信息保存成电子信息,为濒危物种建立基因库,将各物种的基因组信息保存下来,这样即便在将来这些物种灭绝了,人类也可能利用它们的基因组信息重新创造出它们。
(十一)合成生物学
合成生物学这个术语是由波兰遗传学家瓦克罗·斯巴斯基(Waclaw Szybalski)在1974年提出的。目前合成生物学仍然没有一个明确的定义,一般认为合成生物学是依据生物学、化学、物理学和工程学等原理设计的优越的或新型的生物系统。合成生物学涉及许多不同的生物学研究领域,如功能基因组学、蛋白质工程、化学生物学、代谢工程、系统生物学和生物信息学,它将自然科学和工程科学结合到一起进行生物学上的研究。由于近几年来在系统生物学和DNA合成与测序等新技术上取得了长足的进步,合成生物学逐步形成了自己的研究领域,广泛应用于医药、化学、食品和农业等行业。
(十二)生物医学文本挖掘
近年来,生物医学领域的文献数量迅速增加。这些文献作为科学研究成果的载体,大多以电子格式提供且易于获取。如何从海量的文献中挖掘蕴藏的知识对于生物医学研究和应用至关重要。融合自然语言处理技术的生物医学文本挖掘应运而生。其任务包括生物医学命名实体识别、文本分类、关系抽取、知识图谱构建等。其中,命名实体识别是具有挑战性的关键基础任务。常用于生物医学命名实体识别的模型有基于规则、基于字典、基于机器学习(尤其是深度学习)的方法。目前,命名实体识别面临的问题包括同义词、替换表达、一词多义或歧义、缩写等,因而可能需要大量的人工标注。如何在保持精度的同时减少标注训练集、运用迁移学习和半监督学习等是生物医学文本挖掘的发展方向。
第四节 生物信息学面临的挑战
近年来,生物信息学家已经取得了多项研究成果,获得了海量的生物数据,确定了数千个基因的功能,其中包括搜索碱基对序列匹配的有效方法、统计学工具,利用新的计算机工具组装整个基因组等,但生物信息学的发展面临着新的挑战,迫切需要新的研究手段和研究方法。
生物信息学并不是一个足以乐观的领域,究其原因,它是基于分子生物学与多种学科交叉而成的新学科,现有的形势仍表现为各种学科的简单堆砌,相互之间的联系并不是特别紧密。在处理大规模数据方面,没有行之有效的一般性方法,而对于大规模数据内在的生成机制也没有完全明了,这使得生物信息学的研究短期内很难有突破性的结果。那么,要得到真正的解决,最终不能从计算机科学得到,真正的解决方法可能还是得从生物学自身,从数学上的新思路来获得本质性的动力。毫无疑问,正如 Dulbecco 在 1986 年所说:“人类的 DNA 序列是人类的真谛,这个世界上发生的一切事情,都与这一序列息息相关”。然而,要完全破译这一序列及相关的内容,我们还有相当长的路要走。
我们很难预测生物信息学在未来几十年将给生物学的发展带来什么样的根本性突破,但是人类科学研究史表明,科学数据的大量积累将导致重大的科学规律的发现。例如,对数百颗天体运行数据的分析导致开普勒三大定律和万有引力定律的发现;数十种元素和上万种化合物数据的积累导致元素周期表的发现;氢原子光谱学数据的积累促成量子理论的提出,为量子力学的建立奠定了基础。我们有理由认为,今日生物学数据的巨大积累也将导致重大生物学规律的发现。
统计学原理表明,在一定程度上,统计结果的显著性与数据量的对数成正比。因此,随着数据库中数据量的飞速增长,基于数据库的研究工作必将有所突破。可以相信,随着人类基因组计划的完成及蛋白质组学研究的逐步开展,生物信息学在揭示生命的奥秘中会更加成熟和完善,生物信息学科也将随之得到巨大发展。相信生物信息学将发挥越来越大的作用,并推动生物学进入一个全新的境界。
《第三次技术革命》里有这样的描述:“一场与工业革命和以计算机为基础的革命有相同影响力的变化正在开始。下一个伟大时代将是基因组革命时代,它现在处于初期阶段”。基因组学的发展已经进入后基因组研究阶段,致力于蛋白质功能研究的蛋白质组学和功能蛋白质组学正在蓬勃发展,在生物信息学发展的带动下,我们必定能够揭示各种生命现象的奥秘,并带动多个学科的跨越式发展。生物信息学的发展将对分子生物学、药物设计、工作流管理和医疗成像等领域产生巨大的影响,极有可能引发新的产业革命。此外,生物信息学所倡导的全球范围的资源共享也将对整个自然科学,乃至人类社会的发展产生深远的影响。

思考题
登陆 GenBank/ENA/DDBJ 三大数据库网站,进行了解学习。
生物信息学的主要应用有哪些?
从表 1-1 中你能总结出生命科学与计算机科学发展的哪些规律?
查阅代谢网络建模分析的最新进展。
有人说,生物将是下一场技术革命的热土,你认为生物信息学对生物的产业化有哪些方面的贡献?

主要参考文献
陈铭.2004.后基因组时代的生物信息学.生物信息学,2(2):29-34
李霞.2010.生物信息学.北京:人民卫生出版社
孙啸,陆祖宏,谢建明.2005.生物信息学基础.北京:清华大学出版社
张春霆.2000.生物信息学的现状与展望.世界科技研究与发展,22(6):17-20
Edward D. 2009. Bioinformatics. New York: Springer
Lesk A M. 2014. Introduction to Bioinformatics. 4th ed. Oxford: Oxford University Press Mount D W. 2003. 生物信息学. 钟扬, 王莉, 张亮主译. 北京: 高等教育出版社 Pevsner J. 2006. 生物信息学与功能基因组学. 孙之荣译. 北京: 化学工业出版社
Historical Introduction and Overview
The first sequences to be collected were those of proteins, 2 DNA sequence databases, 3 Sequence retrieval from public databases, 4 Sequence analysis programs, 5 The dot matrix or diagram method for comparing sequences, 5 Alignment of sequences by dynamic programming, 6 Finding local alignments between sequences, 8 Multiple sequence alignment, 9 Prediction of RNA secondary structure, 9 Discovery of evolutionary relationships using sequences, 10 Importance of database searches for similar sequences, 11 The FASTA and BLAST methods for database searches, 11 Predicting the sequence of a protein by translation of DNA sequences, 12 Predicting protein secondary structure, 13 The first complete genome sequence, 14 ACEDB, the first genome database, 15 REFERENCES, 15
many individuals from varied scientific backgrounds. This chapter provides a brief historical account of the more significant advances that have taken place, as well as an overview of the chapters of this book. Because many contributors cannot be mentioned due to space constraints, additional references to earlier and current reference books, articles, reviews, and journals provide a broader view of the field and are included in the reference lists to this chapter.
THE FIRST SEQUENCES TO BE COLLECTED WERE THOSE OF PROTEINS
Margaret Dayhoff
The development of protein-sequencing methods (Sanger and Tuppy 1951) led to the sequencing of representatives of several of the more common protein families such as cytochromes from a variety of organisms. Margaret Dayhoff (1972, 1978) and her collaborators at the National Biomedical Research Foundation (NBRF), Washington, DC, were the first to assemble databases of these sequences into a protein sequence atlas in the 1960s, and their collection center eventually became known as the Protein Information Resource (PIR, formerly Protein Identification Resource; http://watson.gmu.edu:8080/pirwww/index. html). The NBRF maintained the database from 1984, and in 1988, the PIR-International Protein Sequence Database (http://www-nbrf.georgetown.edu/pir) was established as a collaboration of NBRF, the Munich Center for Protein Sequences (MIPS), and the Japan International Protein Information Database (JIPID).
Dayhoff and her coworkers organized the proteins into families and superfamilies based on the degree of sequence similarity. Tables that reflected the frequency of changes observed in the sequences of a group of closely related proteins were then derived. Proteins that were less than 15% different were chosen to avoid the chance that the observed amino acid changes reflected two sequential amino acid changes instead of only one. From aligned sequences, a phylogenetic tree was derived showing graphically which sequences were most related and therefore shared a common branch on the tree. Once these trees were made, they were used to score the amino acid changes that occurred during evolution of the genes for these proteins in the various organisms from which they originated (Fig. 1.1).
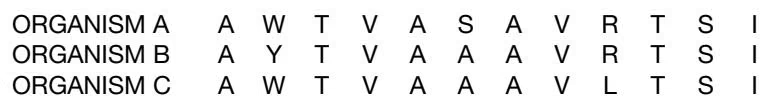
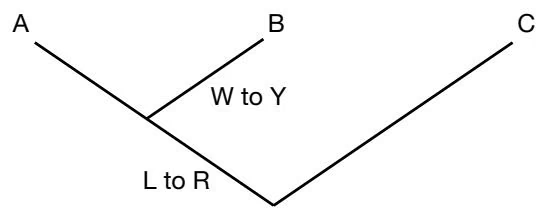
Subsequently, a set of matrices (tables)—the percent amino acid mutations accepted by evolutionary selection or PAM tables—which showed the probability that one amino acid changed into any other in these trees was constructed, thus showing which amino acids are most conserved at the corresponding position in two sequences. These tables are still used to measure similarity between protein sequences and in database searches to find sequences that match a query sequence. The rule used is that the more identical and conserved amino acids that there are in two sequences, the more likely they are to have been derived from a common ancestor gene during evolution. If the sequences are very much alike, the proteins probably have the same biochemical function and three-dimensional structural folds. Thus, Dayhoff and her colleagues contributed in several ways to modern biological sequence analysis by providing the first protein sequence database as well as PAM tables for performing protein sequence comparisons. Amino acid substitution tables are routinely used in performing sequence alignments and database similarity searches, and their use for this purpose is discussed in Chapters 3 and 7.
DNA SEQUENCE DATABASES
Walter Goad
DNA sequence databases were first assembled at Los Alamos National Laboratory (LANL), New Mexico, by Walter Goad and colleagues in the GenBank database and at the European Molecular Biology Laboratory (EMBL) in Heidelberg, Germany. Translated DNA sequences were also included in the Protein Information Resource (PIR) database at the National Biomedical Research Foundation in Washington, DC. Goad had conceived of the GenBank prototype in 1979; LANL collected GenBank data from 1982 to 1992. GenBank is now under the auspices of the National Center for Biotechnology Information (NCBI) (http://www.ncbi.nlm.nih.gov). The EMBL Data Library was founded in 1980 (http://www.ebi.ac.uk). In 1984 the DNA DataBank of Japan (DDBJ), Mishima, Japan, came into existence (http://www.ddbj.nig.ac.jp). GenBank, EMBL, and DDBJ have now formed the International Nucleotide Sequence Database Collaboration (http://www. ncbi.nlm.nih.gov/collab), which acts to facilitate exchange of data on a daily basis. PIR has made similar arrangements.
Many types of sequence databases are described in the first annual issue of the journal Nucleic Acids Research.
Initially, a sequence entry included a computer filename and DNA or protein sequence files. These were eventually expanded to include much more information about the sequence, such as function, mutations, encoded proteins, regulatory sites, and references. This information was then placed along with the sequence into a database format that could be readily searched for many types of information. There are many such databases and formats, which are discussed in Chapter 2.
The growth of the number of sequences in GenBank can be tracked at http://www. ncbi.nlm.nih.gov/Gen Bank/genebankstats. html.
The number of entries in the nucleic acid sequence databases GenBank and EMBL has continued to increase enormously from the daily updates. Annotating all of these new sequences is a time-consuming, painstaking, and sometimes error-prone process. As time passes, the process is becoming more automated, creating additional problems of accuracy and reliability. In December 1997, there were 1 . 2 6 \times 1 0 ^ { 9 } bases in GenBank; this number increased to 2 . 5 7 \times 1 0 ^ { 9 } bases as of April 1999, and 1 . 0 \times 1 0 ^ { 1 0 } as of September 2000. Despite the exponentially increasing numbers of sequences stored, the implementation of efficient search methods has provided ready public access to these sequences.
To decrease the number of matches to a database search, non-redundant databases that list only a single representative of identical sequences have been prepared. However, many sequence databases still include a large number of entries of the same gene or protein sequences originating from sequence fragments, patents, replica entries from different databases, and other such sequences.
SEQUENCE RETRIEVAL FROM PUBLIC DATABASES
David Lipman
An important step in providing sequence database access was the development of Web pages that allow queries to be made of the major sequence databases (GenBank, EMBL, etc.). An early example of this technology at NCBI was a menu-driven program called GEN-INFO developed by D. Benson, D. Lipman, and colleagues. This program searched rapidly through previously indexed sequence databases for entries that matched a biologist’s query. Subsequently, a derivative program called ENTREZ (http://www.ncbi.nlm.nih.gov/Entrez) with a simple window-based interface, and eventually a Web-based interface, was developed at NCBI. The idea behind these programs was to provide an easy-to-use interface with a flexible search procedure to the sequence databases.
Sequence entries in the major databases have additional information about the sequence included with the sequence entry, such as accession or index number, name and alternative names for the sequence, names of relevant genes, types of regulatory sequences, the source organism, references, and known mutations. ENTREZ accesses this information, thus allowing rapid searches of entire sequence databases for matches to one or more specified search terms. These programs also can locate similar sequences (called “neighbors” by ENTREZ) on the basis of previous similarity comparisons. When asked to perform a search for one or more terms in a database, simple pattern search programs will only find exact matches to a query. In contrast, ENTREZ searches for similar or related terms, or complex searches composed of several choices, with great ease and lists the found items in the order of likelihood that they matched the original query. ENTREZ originally allowed straightforward access to databases of both DNA and protein sequences and their supporting references, and even to an index of related entries or similar sequences in separate or the same databases. More recently, ENTREZ has provided access to all of Medline, the full bibliographic database of the National Library of Medicine (NLM), Washington, DC. Access to a number of other databases, such as a phylogenetic database of organisms and a protein structure database, is also provided. This access is provided without cost to any user—private, government, industry, or research—a decision by the staff of NCBI that has provided a stimulus to biomedical research that cannot be underestimated. NCBI presently handles several million independent accesses to their system each day.
A note of caution is in order. Database query programs such as ENTREZ greatly facilitate keeping up with the increasing number of sequences and biomedical journals. However, as with any automated method, one should be wary that a requested database search may not retrieve all of the relevant material, and important entries may be missed. Bear in mind that each database entry has required manual editing at some stage, giving rise to a low frequency of inescapable spelling errors and other problems. On occasion, a particular reference that should be in the database is not found because the search terms may be misspelled in the relevant database entry, the entry may not be present in the database, or there may be some more complicated problem. If exhaustive and careful attempts fail, reporting such problems to the program manager or system administrator should correct the problem.
SEQUENCE ANALYSIS PROGRAMS
Because DNA sequencing involves ordering a set of peaks (A, G, C, or T) on a sequencing gel, the process can be quite error-prone, depending on the quality of the data.
Methods for DNA sequencing were developed in 1977 by Maxam and Gilbert (1977) and Sanger et al. (1977). They are described in greater detail at the beginning of Chapter 2.
As more DNA sequences became available in the late 1970s, interest also increased in developing computer programs to analyze these sequences in various ways. In 1982 and 1984, Nucleic Acids Research published two special issues devoted to the application of computers for sequence analysis, including programs for large mainframe computers down to the then-new microcomputers. Shortly after, the Genetics Computer Group (GCG) was started at the University of Wisconsin by J. Devereux, offering a set of programs for analysis that ran on a VAX computer. Eventually GCG became commercial (http://www.gcg.com/). Other companies offering microcomputer programs for sequence analysis, including Intelligenetics, DNAStar, and others, also appeared at approximately the same time. Laboratories also developed and shared computer programs on a no-cost or low-cost basis. For example, to facilitate the collection of data, the programs PHRED (Ewing and Green 1998; Ewing et al. 1998) and PHRAP were developed by Phil Green and colleagues at the University of Washington to assist with reading and processing sequencing data. PHRED and PHRAP are now distributed by CodonCode Corporation (http://www.codoncode.com).
These commercial and noncommercial programs are still widely used. In addition, Web sites are available to perform many types of sequence analyses; they are free to academic institutions or are available at moderate cost to commercial users. Following is a brief review of the development of methods for sequence analysis.
THE DOT MATRIX OR DIAGRAM METHOD FOR COMPARING SEQUENCES
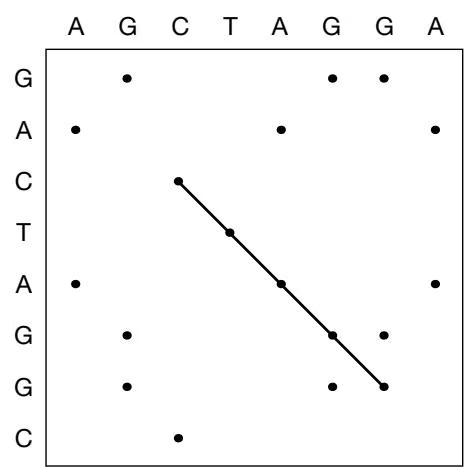
In 1970, A.J. Gibbs and G.A. McIntyre (1970) described a new method for comparing two amino acid and nucleotide sequences in which a graph was drawn with one sequence written across the page and the other down the left-hand side. Whenever the same letter appeared in both sequences, a dot was placed at the intersection of the corresponding sequence positions on the graph (Fig. 1.2). The resulting graph was then scanned for a series of dots that formed a diagonal, which revealed similarity, or a string of the same characters, between the sequences. Long sequences can also be compared in this manner on a single page by using smaller dots.
The dot matrix method quite readily reveals the presence of insertions or deletions between sequences because they shift the diagonal horizontally or vertically by the amount of change. Comparing a single sequence to itself can reveal the presence of a repeat of the same sequence in the same (direct repeat) or reverse (inverted repeat or palindrome) orientation. This method of self-comparison can reveal several features, such as similarity between chromosomes, tandem genes, repeated domains in a protein sequence, regions of low sequence complexity where the same characters are often repeated, or self-complementary sequences in RNA that can potentially base-pair to give a double-stranded structure. Because diagonals may not always be apparent on the graph due to weak similarity, Gibbs and McIntyre counted all possible diagonals and these counts were compared to those of random sequences to identify the most significant alignments.
Maizel and Lenk (1981) later developed various filtering and color display schemes that greatly increased the usefulness of the dot matrix method. This dot matrix representation of sequence comparisons continues to play an important role in analysis of DNA and protein sequence similarity, as well as repeats in genes and very long chromosomal sequences, as described in Chapter 3 (p. 59).
ALIGNMENT OF SEQUENCES BY DYNAMIC PROGRAMMING
Although the dot matrix method can be used to detect sequence similarity, it does not readily resolve similarity that is interrupted by regions that do not match very well or that are present in only one of the sequences (e.g., insertions or deletions). Therefore, one would like to devise a method that can find what might be a tortuous path through a dot matrix, providing the very best possible alignment, called an optimal alignment, between the two sequences. Such an alignment can be represented by writing the sequences on successive lines across the page, with matching characters placed in the same column and unmatched characters placed in the same column as a mismatch or next to a gap as an insertion (or deletion in the other sequence), as shown in Figure 1.3. To find an optimal alignment in which all possible matches, insertions, and deletions have been considered to find the best one is computationally so difficult that for proteins of length 300, 1088 comparisons will have to be made (Waterman 1989).
To simplify the task, Needleman and Wunsch (1970) broke the problem down into a progressive building of an alignment by comparing two amino acids at a time. They started at the end of each sequence and then moved ahead one amino acid pair at a time, allowing for various combinations of matched pairs, mismatched pairs, or extra amino acids in one sequence (insertion or deletion). In computer science, this approach is called dynamic programming. The Needleman and Wunsch approach generated (1) every possible alignment, each one including every possible combination of match, mismatch, and single insertion or deletion, and (2) a scoring system to score the alignment. The object was to determine which was the best alignment of all by determining the highest score. Thus, every match in a trial alignment was given a score of 1, every mismatch a score of 0, and individual gaps a penalty score. These numbers were then added across the alignment to
SEQUENCE A A G Λ Λ C D E V I G SEQUENCE B A G E Y C D Λ I I G
Figure 1.3. An alignment of two sequences showing matches, mismatches, and gaps (). The best or optimal alignment requires that all three types of changes be allowed.
obtain a total score for the alignment. The alignment with the highest possible score was defined as the optimal alignment.
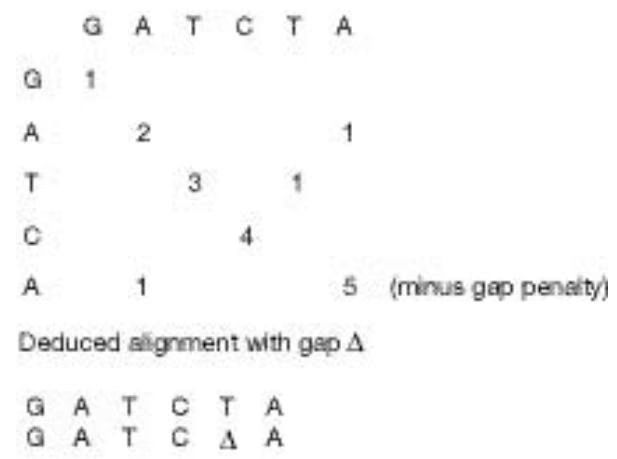
The procedure for generating all of the possible alignments is to move sequentially through all of the matched positions within a matrix, much like the dot matrix graph (see above), starting at those positions that correspond to the end of one of the sequences, as shown in Figure 1.4. At each position in the matrix, the highest possible score that can be achieved up to that point is placed in that position, allowing for all possible starting points in either sequence and any combination of matches, mismatches, insertions, and deletions. The best alignment is found by finding the highest-scoring position in the graph, and then tracing back through the graph through the path that generated the highest-scoring positions. The sequences are then aligned so that the sequence characters corresponding to this path are matched.
FINDING LOCAL ALIGNMENTS BETWEEN SEQUENCES
Mike Waterman
Temple Smith
The above method finds the optimal alignment between two sequences, including the entirety of each of the sequences. Such an alignment is called a global alignment. Smith and Waterman (1981a,b) recognized that the most biologically significant regions in DNA and protein sequences were subregions that align well and that the remaining regions made up of less-related sequences were less significant. Therefore, they developed an important modification of the Needleman-Wunsch algorithm, called the local alignment or Smith-Waterman (or the Waterman-Smith) algorithm, to locate such regions. They also recognized that insertions or deletions of any size are likely to be found as evolutionary changes in sequences, and therefore adjusted their method to accommodate such changes. Finally, they provided mathematical proof that the dynamic programming method is guaranteed to provide an optimal alignment between sequences. The algorithm is discussed in detail in Chapter 3 (p. 64).
Two complementary measurements had been devised for scoring an alignment of two sequences, a similarity score and a distance score. As shown in Figure 1.3, there are three types of aligned pairs of characters in each column of an alignment—identical matches, mismatches, and a gap opposite an unmatched character. Using as an example a simple scoring system of 1 for each type of match, the similarity score adds up all of the matches in the aligned sequences, and divides by the sum of the number of matches and mismatches (gaps are usually ignored). This method of scoring sequence similarity is the one most familiar to biologists and was devised by Needleman and Wunsch and used by Smith and Waterman. The other scoring method is a distance score that adds up the number of substitutions required to change one sequence into the other. This score is most useful for making predictions of evolutionary distances between genes or proteins to be used for phylogenetic (evolutionary) predictions, and the method was the work of mathematicians, notably P. Sellers. The distance score is usually calculated by summing the number of mismatches in an alignment divided by the total number of matches and mismatches. The calculation represents the number of changes required to change one sequence into the other, ignoring gaps. Thus, in the example shown in Figure 1.3, there are 6 matches and 1 mismatch in an alignment. The similarity score for the alignment is 6/7 0.86 and the distance score is 1/7 0.14, if the required condition is given a simple score of 1. With this simple scoring scheme, the similarity and distance scores add up to 1. Note also the equivalence that the sum of the sequence lengths is equal to twice the number of matches plus mismatches plus the number of deletions or insertions. Thus, in our example, the calculation is 8 9 2 - (6 1) 3 17. Usually more complex systems of scoring are used to produce meaningful alignments, and alignments are evaluated by likelihood or odds scores (Chapter 3), but an inverse relationship between similarity and distance scores for the alignment still holds.
A difficult problem encountered in aligning sequences is deciding whether or not a particular alignment is significant. Does a particular alignment score reveal similarity between two sequences, or would the score be just as easily found between two unrelated sequences (or random sequence of similar composition generated by the computer)? This problem was addressed by S. Karlin and S. Altschul (1990, 1993) and is addressed in detail in Chapter 3 (p. 96).
An analysis of scores of unrelated or random sequences revealed that the scores could frequently achieve a value much higher than expected in a normal distribution. Rather, the scores followed a distribution with a positively skewed tail, known as the extreme value distribution. This analysis provided a way to assess the probability that a score found between two sequences could also be found in an alignment of unrelated or random sequences of the same length. This discovery was particularly useful for assessing matches between a query sequence and a sequence database discussed in Chapter 7. In this case, the evaluation of a particular alignment score must take into account the number of sequence comparisons made in searching the database. Thus, if a score between a query protein sequence and a database protein sequence is achieved with a probability of 107 of being between unrelated sequences, and 80,000 sequences were compared, then the highest expected score (called the EXPECT score) is 1 0 ^ { - 7 } \times 8 \times 1 0 ^ { 4 } \stackrel { - } { = } 8 \times 1 0 ^ { - 3 } = 0 . 0 \dot { 0 } 8 . A value of 0.02–0.05 is considered significant. Even when such a score is found, the alignment must be carefully examined for shortness of the alignment, unrealistic amino acid matches, and runs of repeated amino acids, the presence of which decreases confidence in an alignment.
MULTIPLE SEQUENCE ALIGNMENT
In addition to aligning a pair of sequences, methods have been developed for aligning three or more sequences at the same time (for an early example, see Johnson and Doolittle 1986). These methods are computer-intensive and usually are based on a sequential aligning of the most-alike pairs of sequences. The programs commonly used are the GCG program PILEUP (http://www.gcg. com/) and CLUSTALW (Thompson et al. 1994) (Baylor College of Medicine, http://dot.imgen.bcm.tmc.edu:9331/multi-align/multi-align.html). Once the alignment of a related set of molecular sequences (a family) has been produced, highly conserved regions (Gribskov et al. 1987) can be identified that may be common to that particular family and may be used to identify other members of the same family. Two matrix representations of the multiple sequence alignment called a PROFILE and a POSITION-SPECIFIC SCORING MATRIX (PSSM) are important computational tools for this purpose.
Multiple sequence alignments can also be the starting point for evolutionary modeling. Each column of aligned sequence characters is examined, and then the most probable phylogenetic relationship or tree that would give rise to the observed changes is identified.
Another form of multiple sequence alignment is to search for a pattern that a set of DNA or protein sequences has in common without first aligning the sequences (Stormo et al. 1982; Stormo and Hartzell 1989; Staden 1984, 1989; Lawrence and Reilly 1990). For proteins, these patterns may define a conserved component of a structural or functional domain. For DNA sequences, the patterns may specify the binding site for a regulatory protein in a promoter region or a processing signal in an RNA molecule. Both statistical and nonstatistical methods have been widely used for this purpose. In effect, these methods sort through the sequences trying to locate a series of adjacent characters in each of the sequences that, when aligned, provides the highest number of matches. Neural networks, hidden Markov models, and the expectation maximization and Gibbs sampling methods (Stormo et al. 1982; Lawrence et al. 1993; Krogh et al. 1994; Eddy et al. 1995) are examples of methods that are used. Explanations and examples of these methods are described in Chapter 4.
PREDICTION OF RNA SECONDARY STRUCTURE
In addition to methods for predicting protein structure, other methods for predicting RNA secondary structure on computers were also developed at an early time. If the complement of a sequence on an RNA molecule is repeated down the sequence in the opposite chemical direction, the regions may base-pair and form a hairpin structure, as illustrated in Figure 1.5.
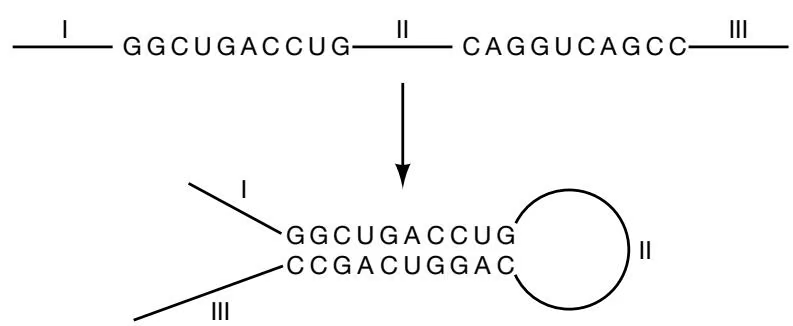
Tinoco et al. (1971) generated these symmetrical regions in small oligonucleotide molecules and tried to predict their stability based on estimates of the free energy associated with stacked base pairs in the model and of the destabilizing effects of loops, using a table of energy values (Tinoco et al. 1971; Salser 1978). Single-stranded loops and other unpaired regions decreased the predicted energy. Subsequently, Nussinov and Jacobson (1980) devised a fast computer method for predicting an RNA molecule with the highest possible number of base pairs based on the same dynamic programming algorithm used for aligning sequences. This method was improved by Zuker and Stiegler (1981), who added molecular constraints and thermodynamic information to predict the most energetically stable structure.
Another important use of RNA structure modeling is in the construction of databases of RNA molecules. One of the most significant of these is the ribosomal RNA database prepared by the laboratory of C. Woese (1987) (http://www.cme.msu.edu/RDP html/index.html). RNA secondary structure prediction is discussed in Chapter 5. Alignment, structural modeling, and phylogenetic analysis based on these RNA sequences have made possible the discovery of evolutionary relationships among organisms that would not have been possible otherwise.
DISCOVERY OF EVOLUTIONARY RELATIONSHIPS USING SEQUENCES
Variations within a family of related nucleic acid or protein sequences provide an invaluable source of information for evolutionary biology. With the wealth of sequence information becoming available, it is possible to track ancient genes, such as ribosomal RNA and some proteins, back through the tree of life and to discover new organisms based on their sequence (Barns et al. 1996). Diverse genes may follow different evolutionary histories, reflecting transfers of genetic material between species. Other types of phylogenetic analyses can be used to identify genes within a family that are related by evolutionary descent, called orthologs. Gene duplication events create two copies of a gene, called paralogs, and many such events can create a family of genes, each with a slightly altered, or possibly new, function. Once alignments have been produced and alignment scores found, the most closely related sequence pairs become apparent and may be placed in the outer branches of an evolutionary tree, as shown for sequences A and B in Figure 1.1 (p. 2). The next most-alike sequence, sequence C in Figure 1.1, will be represented by the next branch down on the tree. Continuing this process generates a predicted pattern of evolution for that particular gene. Once a tree has been found, the sequence changes that have taken place in the tree branches can be inferred.
The starting point for making a phylogenetic tree is a sequence alignment. For each pair of sequences, the sequence similarity score gives an indication as to which sequences are most closely related. A tree that best accounts for the numbers of changes (distances) between the sequences (Fitch and Margoliash 1987) of these scores may then be derived. The method most commonly used for this purpose is the neighbor-joining method (Saitou and Nei 1987) described in Chapter 6. Alternatively, if a reliable multiple sequence alignment is available, the tree that is most consistent with the observed variation found in each column of the sequence alignment may be used. The tree that imposes the minimum number of changes (the maximum parsimony tree) is the one chosen (Felsenstein 1988).
In making phylogenetic predictions, one must consider the possibility that several trees may give almost the same results. Tests of significance have therefore been derived to determine how well the sequence variation supports the existence of a particular tree branch (Felsenstein 1988). These developments are also discussed in Chapter 6.
IMPORTANCE OF DATABASE SEARCHES FOR SIMILAR SEQUENCES
As DNA sequencing became a common laboratory activity, genes with an important biological function could be sequenced with the hope of learning something about the biochemical nature of the gene product. An example was the retrovirus-encoded v-sis and v-src oncogenes, genes that cause cancer in animals. By comparing the predicted sequences of the viral products with all of the known protein sequences at the time, R. Doolittle and colleagues (1983) and W. Barker and M. Dayhoff (1982) both made the startling discovery that these genes appeared to be derived from cellular genes. The Sis protein had a sequence very similar to that of the platelet-derived growth factor (PDGF) from mammalian cells, and Src to the catalytic chain of mammalian cAMP-dependent kinases. Thus, it appeared likely that the retrovirus had acquired the gene from the host cell as some kind of genetic exchange event and then had produced a mutant form of the protein that could compromise the function of the normal protein when the virus infected another animal. Subsequently, as molecular biologists analyzed more and more gene sequences, they discovered that many organisms share similar genes that can be identified by their sequence similarity.
These searches have been greatly facilitated by having genetic and biochemical information from model organisms, such as the bacterium Escherichia coli and the budding yeast Saccharomyces cerevisiae. In these organisms, extensive genetic analysis has revealed the function of genes, and the sequences of these genes have also been determined. Finding a gene in a new organism (e.g., a crop plant) with a sequence similar to a model organism gene (e.g., yeast) provides a prediction that the new gene has the same function as in the model organism. Such searches are becoming quite commonplace and are greatly facilitated by programs such as FASTA (Pearson and Lipman 1988) and BLAST (Altschul et al. 1990).
The methods used by BLAST and other additional powerful methods to perform sequence similarity searching are described further in the next section and in Chapter 7.
THE FASTA AND BLAST METHODS FOR DATABASE SEARCHES
As the number of new sequences collected in the laboratory increased, there was also an increased need for computer programs that provided a way to compare these new sequences sequentially to each sequence in the existing database of sequences, as was done
PORTION OF SEQUENCE A _ W I V – PORTION OF SEQUENCE B – W I V –
Figure 1.6. Rapid identification of sequence similarity by FASTA and BLAST. FASTA looks for short regions in these two amino acid sequences that match and then tries to extend the alignment to the right and left. In this case, the program found by a quick and simple indexing method that W, I, and then V occurred in the same order in both sequences, providing a good starting point for an alignment. BLAST works similarly, but only examines matched patterns of length 3 of the more significant amino acid substitutions that are expected to align less frequently by chance alone.
Bill Pearson
to identify successfully the function of viral oncogenes. The dynamic programming method of Needleman and Wunsch would not work because it was much too slow for the computers of the time; today, however, with much faster computers available, this method can be used. W. Pearson and D. Lipman (1988) developed a program called FASTA, which performed a database scan for similarity in a short enough time to make such scans routinely possible. FASTA provides a rapid way to find short stretches of similar sequence between a new sequence and any sequence in a database. Each sequence is broken down into short words a few sequence characters long, and these words are organized into a table indicating where they are in the sequence. If one or more words are present in both sequences, and especially if several words can be joined, the sequences must be similar in those regions. Pearson (1990, 1996) has continued to improve the FASTA method for similarity searches in sequence databases.
An even faster program for similarity searching in sequence databases, called BLAST, was developed by S. Altschul et al. (1990). This method is widely used from the Web site of the National Center for Biotechnology Information at the National Library of Medicine in Washington, DC (http://www.ncbi.nlm.nih.gov/BLAST). The BLAST server is probably the most widely used sequence analysis facility in the world and provides similarity searching to all currently available sequences. Like FASTA, BLAST prepares a table of short sequence words in each sequence, but it also determines which of these words are most significant such that they are a good indicator of similarity in two sequences, and then confines the search to these words (and related ones), as described in Figure 1.6. There are versions of BLAST for searching nucleic acid and protein databases, which can be used to translate DNA sequences prior to comparing them to protein sequence databases (Altschul et al. 1997). Recent improvements in BLAST include GAPPED-BLAST, which is threefold faster than the original BLAST, but which appears to find as many matches in databases, and PSI-BLAST (position-specific-iterated BLAST), which can find more distant matches to a test protein sequence by repeatedly searching for additional sequences that match an alignment of the query and initially matched sequences. These methods are discussed in Chapter 7.
PREDICTING THE SEQUENCE OF A PROTEIN BY TRANSLATION OF DNA SEQUENCES
Protein sequences are predicted by translating DNA sequences that are cDNA copies of mRNA sequences from a predicted start and end of an open reading frame. Unfortunately, cDNA sequences are much less prevalent than genomic sequences in the databases. Partial sequence (expressed sequence tags, or ESTs) libraries for many organisms are available, but these only provide a fraction of the carboxy-terminal end of the protein sequence and usually only have about 99% accuracy. For organisms that have few or no introns in their genomic DNA (such as bacterial genomes), the genomic DNA may be translated. For most eukaryotic organisms with introns in their genes, the protein-encoding exons must be predicted and then translated by methods described in Chapter 8. These genome-based predictions are not always accurate, and thus it remains important to have cDNA sequences of protein-encoding genes. Promoter sequences in genomes may also be analyzed for common patterns that reflect common regulatory features. These types of analyses require sophisticated approaches that are also discussed in Chapter 8 (Hertz et al. 1990).
PREDICTING PROTEIN SECONDARY STRUCTURE
There are a large number of proteins whose sequences are known, but very few whose structures have been solved. Solving protein structures involves the time-consuming and highly specialized procedures of X-ray crystallography and nuclear magnetic resonance (NMR). Consequently, there is much interest in trying to predict the structure of a protein, given its sequence. Proteins are synthesized as linear chains of amino acids; they then form secondary structures along the chain, such as helices, as a result of interactions between side chains of nearby amino acids. The region of the molecule with these secondary structures then folds back and forth on itself to form tertiary structures that include helices, sheets comprising interacting strands, and loops (Fig. 1.7). This folding often leaves amino acids with hydrophobic side chains facing into the interior of the folded molecule and polar amino acids that can interact with water and the molecular environment facing outside in loops. The amino acid sequence of the protein directs the folding pathway, sometimes assisted by proteins called chaperonins. Chou and Fasman (1978) and Garnier et al. (1978) searched the small structural database of proteins for the amino acids associated with each of the secondary structure types— helices, turns, and strands. Sequences of proteins whose structures were not known were then scanned to determine whether the amino acids in each region were those often associated with one type of structure. For example, the amino acid proline is not often found in helices because its side chain is not compatible with forming a helix. This method predicted the structure of some proteins well but, in general, was about as likely to predict a correct as an incorrect structure.
As more protein structures were solved experimentally, computational methods were used to find those that had a similar structural fold (the same arrangement of secondary structures connected by similar loops). These methods led to the discovery that as new protein structures were being solved, they often had a structural fold that was already known in a group of sequences. Thus, proteins are found to have a limited number of ~500 folds (Chothia 1992), perhaps due to chemical restraints on protein folding or to the existence of a single evolutionary pathway for protein structure (Gibrat et al. 1996). Furthermore, proteins without any sequence similarity could adopt the same fold, thus greatly complicating the prediction of structure from sequence. Methods for finding whether or not a given protein sequence can occupy the same three-dimensional conformation as another based on the properties of the amino acids have been devised (Bowie et al. 1991). Databases of structural families of proteins are available on the Web and are described in Chapter 9.
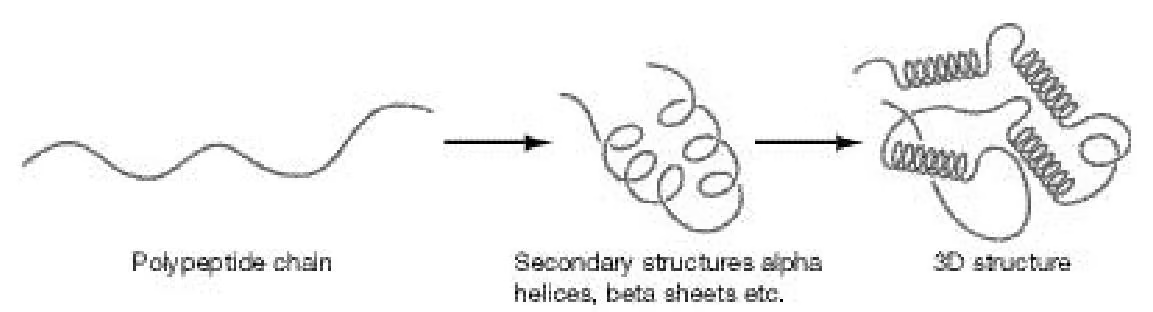
Amos Bairoch (Bairoch et al. 1997) developed another method for predicting the biochemical activity of an unknown protein, given its sequence. He collected sequences of proteins that had a common biochemical activity, for example an ATP-binding site, and deduced the pattern of amino acids that was responsible for that activity, allowing for some variability. These patterns were collected into the PROSITE database (http://www.expasy. ch/prosite). Unknown sequences were scanned for the same patterns. Subsequently, Steve and Jorga Henikoff (Henikoff and Henikoff 1992) examined alignments of the protein sequences that make up each MOTIF and discovered additional patterns in the aligned sequences called BLOCKS (see http://www.blocks.fhcrc.org/). These patterns offered an expanded ability to determine whether or not an unknown protein possessed a particular biochemical activity. The changes that were in each column of these aligned patterns were counted and a new set of amino acid substitution matrices, called BLOSUM matrices, similar to the PAM matrices of Margaret Dayhoff, were produced. One of these matrices, BLOSUM62, is most often used for aligning protein sequences and searching databases for similar sequences (Henikoff and Henikoff 1992) (see Chapter 7).
Sophisticated statistical and machine-training techniques have been used in more recent protein structure prediction programs, and the success rate has increased. A recent advance in this now active field of research is to organize proteins into groups or families on the basis of sequence similarity, and to find consensus patterns of amino acid domains characteristic of these families using the statistical methods described in Chapters 4 and 9. There are many publicly accessible Web sites described in Chapter 9 that provide the latest methods for identifying proteins and predicting their structures.
THE FIRST COMPLETE GENOME SEQUENCE
Although many viruses had already been sequenced, the first planned attempt to sequence a free-living organism was by Fred Blattner and colleagues (Blattner et al. 1997) using the bacterium E. coli. However, there was some concern over whether such a large sequence, about 4 - 106 bp, could be obtained by the then-current sequencing technology. The first published genome sequence was that of the single, circular chromosome of another bacterium, Hemophilus influenzae (Fleischmann et al. 1995), by The Institute of Genetics Research (TIGR, at http://www.tigr.org/), which had been started by researcher Craig Venter. The project was assisted by microbiologist Hamilton Smith, who had worked with this organism for many years. The speedup in sequencing involved using automated reading of DNA sequencing gels through dye-labeling of bases, and breaking down the chromosome into random fragments and sequencing these fragments as rapidly as possible without knowledge of their location in the whole chromosome. Computer analysis of such shotgun cloning and sequencing techniques had been developed much earlier by R. Staden at Cambridge University and other workers, but the TIGR undertaking was much more ambitious. In this genome project, newly read sequences were immediately entered into a computer database and compared with each other to find overlaps and produce contigs of two or more sequences with the assistance of computer programs. This procedure circumvented the need to grow and keep track of large numbers of subclones. Although the same sequence was often obtained up to 10 times, the sequence of the entire chromosome ( 2 \times 109 bp), less a few gaps, was rapidly assembled in the computer over a 9-month period at a cost of about $106.
This success heralded a large number of other sequencing projects of various prokaryotic and eukaryotic microorganisms, with a tremendous potential payoff in terms of utilizable gene products and evolutionary information about these organisms. To date, completed projects include more than 30 prokaryotes, yeast S. cerevisiae (see Cherry et al. 1997), the nematode Caenorhabditis elegans (see C. elegans Sequencing Consortium 1998), and the fruit fly Drosophila (see Adams et al. 2000). The plant Arabidopsis thaliana and the human genome sequencing projects are ongoing and will be completed during 2000 or shortly thereafter.
The Human Genome Project, a large, federally funded collaborative project, will complete sequencing of the entire human genome by 2003. The project was developed from an idea discussed at scientific meetings in 1984 and 1985, and a pilot project, the Human Genome Initiative, was begun by the Department of Energy (DOE) in 1986. National Institutes of Health funding of the project began in 1987 under the Office of Genome Research. Currently, the project is constituted as the National Human Genome Research Initiative. In 1998, a new commercial venture under the leadership of Craig Venter was formed to sequence the majority of the human genome by 2001. This group, which uses a whole genome shotgun cloning approach and intensive computer processing of data, has already completed the Drosophila sequence and will sequence the mouse genome following completion of the human genome. Both groups simultaneously announced completion of the sequencing of the human genome in 2000.
ACEDB, THE FIRST GENOME DATABASE
As more genetic and sequence information became available for the model organisms, interest arose in generating specific genome databases that could be queried to retrieve this information. Such an enterprise required a new level of sharing of data and resources between laboratories. Although there were initial concerns about copyright issues, credits, accuracy, editorial review, and curating, eventually these concerns disappeared or became resolved as resources on the Internet developed. The first genome database, called ACEDB (a C. elegans database), and the methods to access this database were developed by Mike Cherry and colleagues (Cherry and Cartinhour 1993). This database was accessible through the internet and allowed retrieval of sequences, information about genes and mutants, investigator addresses, and references. Similar databases were subsequently developed using the same methods for A. thaliana and S. cerevisiae. Presently, there is a large number of such publicly available databases. Web access to these databases is discussed in Chapter 10 (Table 10.1, p. 482).
REFERENCES
Adams M.D., Celniker S.E., Holt R.A., Evans C.A., Gocayne J.D., Amanatides P.G., Scherer S.E., Li P.W., Hoskins R.A., Galle R.F., et al. 2000. The genome sequence of Drosophila melanogaster. Science 287: 2185–2195.
Altschul S.F., Gish W., Miller W., Myers E.W., and Lipman D.J. 1990. Basic local alignment search tool. J. Mol. Biol. 215: 403–410.
Altschul S.F., Madden T.L., Schaffer A.A., Zhang J., Zhang Z., Miller W., and Lipman D.J. 1997. Gapped BLAST and PSI-BLAST: A new generation of protein database search programs. Nucleic Acids Res. 25: 3389–3402.
Bairoch A., Bucher P., and Hofmann K. 1997. The PROSITE database, its status in 1997. Nucleic Acids Res. 25: 217–221.
Barker W.C. and Dayhoff M.O. 1982. Viral src gene products are related to the catalytic chain of mammalian cAMP-dependent protein kinase. Proc. Natl. Acad. Sci. 79: 2836–2839.
Barns S.M., Delwiche C.F., Palmer J.D., and Pace N.R. 1996. Perspectives on archaeal diversity, thermophily and monophyly from environmental rRNA sequences. Proc. Natl. Acad. Sci. 93: 9188–9193.
Blattner F.R., Plunkett III, G., Bloch C.A., Perna N.T., Burland V., Riley M., Collado-Vides J., Glasner J.D., Rode C.K., Mayhew G.F., Gregor J., Davis N.W., Kirkpatrick H.A., Goeden M.A., Rose D.J., Mau B., and Shao Y. 1997. The complete genome sequence of Escherichia coli K-12. Science 277: 1453–1474.
Bowie J.U., Luthy R., and Eisenberg D. 1991. A method to identify protein sequences that fold into a known three-dimensional structure. Science 253: 164–170.
C. elegans Sequencing Consortium. 1998. Genome sequence of the nematode C. elegans: A platform for investigating biology. Science 282: 2012–2018.
Cherry J.M. and Cartinhour S.W. 1993. ACEDB, a tool for biological information. In Automated DNA sequencing and analysis (ed. M. Adams et al.). Academic Press, New York.
Cherry J.M., Ball C., Weng S., Juvik G., Schmidt R., Adler C., Dunn B., Dwight S., Riles L., Mortimer R. K., and Botstein D. 1997. Genetic and physical maps of Saccharomyces cerevisiae. Nature (suppl. 6632) 387: 67–73.
Chothia C. 1992. Proteins. One thousand families for the molecular biologist. Nature 357: 543–544.
Chou P.Y. and Fasman G.D. 1978. Prediction of the secondary structure of proteins from their amino acid sequence. Adv. Enzymol. Relat. Areas Mol. Biol. 47: 45–147.
Dayhoff M.O., Ed. 1972. Atlas of protein sequence and structure, vol. 5. National Biomedical Research Foundation, Georgetown University, Washington, D.C.
. 1978. Survey of new data and computer methods of analysis. In Atlas of protein sequence and structure, vol. 5, suppl. 3. National Biomedical Research Foundation, Georgetown University, Washington, D.C.
Doolittle R.F., Hunkapiller M.W., Hood L.E., Devare S.G., Robbins K.C., Aaronson S.A., and Antoniades H.N. 1983. Simian sarcoma onc gene v-sis is derived from the gene (or genes) encoding a platelet-derived growth factor. Science 221: 275–277.
Eddy S.R., Mitchison G., and Durbin R. 1995. Maximum discrimination hidden Markov models of sequence consensus. J. Comput. Biol. 2: 9–23.
Ewing B. and Green P. 1998. Base-calling of automated sequence traces using phred. II. Error probabilities. Genome Res. 8: 186–194.
Ewing B., Hillier L., Wendl, M.C., and Green P. 1998. Base-calling of automated sequence traces using phred. I. Accuracy assessment. Genome Res. 8: 175–185.
Felsenstein J. 1988. Phylogenies from molecular sequences: Inferences and reliability. Annu. Rev. Genet. 22: 521–565.
Fitch W.M. and Margoliash E. 1987. Construction of phylogenetic trees. Science 155: 279–284.
Fleischmann R.D., Adams M.D., White O., Clayton R.A., Kirkness E.F., Kerlavage A.R., Bult C.J., Tomb J.F., Dougherty B.A., Merrick J.M., et al. 1995. Whole-genome random sequencing and assembly of Haemophilus influenzae Rd. Science 269: 496–512.
Garnier J., Osguthorpe D.J., and Robson B. 1978. Analysis of the accuracy and implications of simple methods for predicting the secondary structure of globular proteins. J. Mol. Biol. 120: 97–120.
Gibbs A.J. and McIntyre G.A. 1970. The diagram, a method for comparing sequences. Its use with amino acid and nucleotide sequences. Eur. J. Biochem. 16: 1–11.
Gibrat J.F., Madej T., and Bryant S.H. 1996. Surprising similarity in structure comparison. Curr. Opin. Struct. Biol. 6: 377–385.
Gribskov M., McLachlan A.D., and Eisenberg D. 1987. Profile analysis: Detection of distantly related proteins. Proc. Natl. Acad. Sci. 84: 4355–4358.
Henikoff S. and Henikoff J.G. 1992. Amino acid substitution matrices from protein blocks. Proc. Natl. Acad. Sci. 89: 10915–10919.
Hertz G.Z., Hartzell III, G.W., and Stormo G.D. 1990. Identification of consensus patterns in unaligned DNA sequences known to be functionally related. Comput. Appl. Biosci. 6: 81–92.
Johnson M.S. and Doolittle R.F. 1986. A method for the simultaneous alignment of three or more amino acid sequences. J. Mol. Evol. 23: 267–268.
Karlin S. and Altschul S.F. 1990. Methods for assessing the statistical significance of molecular sequence features by using general scoring schemes. Proc. Natl. Acad. Sci. 87: 2264–2268.
- Applications and statistics for multiple high-scoring segments in molecular sequences. Proc. Natl. Acad. Sci. 90: 5873–5877
Krogh A., Brown M., Mian I.S., Sjölander K., and Haussler D. 1994. Hidden Markov models in computational biology. Applications to protein modeling. J. Mol. Biol. 235: 1501–1531.
Lawrence C.E. and Reilly A.A. 1990. An expectation maximization (EM) algorithm for the identification and characterization of common sites in unaligned biopolymer sequences. Proteins Struct. Funct. Genet. 7: 41–51.
Lawrence C.E., Altschul S.F., Boguski M.S., Liu J.S., Neuwald A.F., and Wootton J.C. 1993. Detecting subtle sequence signals: A Gibbs sampling strategy for multiple alignment. Science 262: 208–214.
Maizel Jr., J.V. and Lenk R.P. 1981. Enhanced graphic matrix analyses of nucleic acid and protein synthesis. Proc. Natl. Acad. Sci. 78: 7665–7669.
Maxam A.M. and Gilbert W. 1977. A new method for sequencing DNA. Proc. Natl. Acad. Sci. 74: 560–564.
Needleman S.B. and Wunsch C.D. 1970. A general method applicable to the search for similarities in the amino acid sequence of two proteins. J. Mol. Biol. 48: 443–453.
Nussinov R. and Jacobson A.B. 1980. Fast algorithm for predicting the secondary structure of singlestranded RNA. Proc. Natl. Acad. Sci. 77: 6903–6913.
Pearson W.R. 1990. Rapid and sensitive sequence comparison with FASTP and FASTA. Methods Enzymol. 183: 63–98.
. 1996. Effective protein sequence comparison. Methods Enzymol. 266: 227–258.
Pearson W.R. and Lipman D.J. 1988. Improved tools for biological sequence comparison. Proc. Natl. Acad. Sci. 85: 2444–2448
Saitou N. and Nei M. 1987. The neighbor-joining method: A new method for reconstructing phylogenetic trees. Mol. Biol. Evol. 4: 406–425.
Salser W. 1978. Globin mRNA sequences: Analysis of base pairing and evolutionary implications. Cold Spring Harbor Symp. Quant. Biol. 42: 985–1002.
Sanger F. and Tuppy H. 1951. The amino acid sequence of the phenylalanyl chain of insulin. Biochem. J. 49: 481–490.
Sanger F., Nicklen S., and Coulson A.R. 1977. DNA sequencing with chain terminating inhibitors. Proc. Natl. Acad. Sci. 74: 5463–5467.
Smith T.F. and Waterman M.S. 1981a. Identification of common molecular subsequences. J. Mol. Biol. 147: 195–197.
———. 1981b. Comparison of biosequences. Adv. Appl. Math. 2: 482–489.
Staden R. 1984. Computer methods to locate signals in nucleic acid sequences. Nucleic Acids Res. 12: 505–519.
—. 1989. Methods for calculating the probabilities of finding patterns in sequences. Comput. Appl. Biosci. 5: 89–96.
Stormo G.D. and Hartzell III, G.W. 1989. Identifying protein-binding sites from unaligned DNA fragments. Proc. Natl. Acad. Sci. 86: 1183–1187
Stormo G.D., Schneider T.D., Gold L., and Ehrenfeucht A. 1982. Use of the ‘Perceptron’ algorithm to distinguish translational initiation sites in E. coli. Nucleic Acids Res. 10: 2997–3011.
Thompson J.D., Higgins D.G., and Gibson T.J. 1994. CLUSTAL W: Improving the sensitivity of progressive multiple sequence alignment through sequence weighting, position-specific gap penalties and weight matrix choice. Nucleic Acids Res. 22: 4673–4680.
Tinoco Jr., I., Uhlenbeck O.C., and Levine M.D. 1971. Estimation of secondary structure in ribonucleic acids. Nature 230: 362–367.
Waterman M.S., Ed. 1989. Sequence alignments. In Mathematical methods for DNA sequences. CRC Press, Boca Raton, Florida.
Woese C.R. 1987. Bacterial evolution. Microbiol. Rev. 51: 221–271.
Zuker M. and Stiegler P. 1981. Optimal computer folding of large RNA sequences using thermodynamics and auxiliary information. Nucleic Acids Res. 9: 133–148
Additional Reading
Reference Books and Special Journal Editions
Baldi P. and Brunck S. 1998. Bioinformatics: The machine learning approach. MIT Press, Cambridge, Massachusetts.
Baxevanis A.D. and Ouellette B.F., Eds. 1998. Bioinformatics: A practical guide to the analysis of genes and proteins. John Wiley & Sons, New York.
Doolittle R.F. 1986. Of URFS and ORFS: A primer on how to analyze derived amino acid sequences. University Science Books, Mill Valley, California.
—, Ed. 1990. Molecular evolution: Computer analysis of protein and nucleic acid sequences. Methods Enzymol., vol. 183. Academic Press, San Diego.
—, Ed. 1996. Computer methods for macromolecular sequence analysis. Methods Enzymol., vol. 266. Academic Press, San Diego, California.
Durbin R., Eddy S., Krogh A., and Mitchison G., Eds. 1998. Biological sequence analysis. Probabilistic models of proteins and nucleic acids. Cambridge University Press, Cambridge, United Kingdom.
Gribskov M. and Devereux J., Eds. 1991. Sequence analysis primer. University of Wisconsin Biotechnology Center Biotechnical Resource Ser. (ser. ed. R.R. Burgess). Stockton Press, New York.
Gusfield D. 1997. Algorithms on strings, trees, and sequences: Computer science and computational biology. Cambridge University Press, Cambridge, United Kingdom.
Martinez H., Ed. 1984. Mathematical and computational problems in the analysis of molecular sequences (special commemorative issue honoring Margaret Oakley Dayhoff). Bull. Math. Biol. Pergamon Press, New York.
Nucleic Acids Research. 1996–2000. Special database issues published in the January issues of volumes 22–26. Oxford University Press, Oxford, United Kingdom.
Salzberg S.L., Searls D.B., and Kasif S., Eds. 1999. Computational methods in molecular biology. New Compr. Biochem., vol. 32. Elsevier, Amsterdam, The Netherlands.
Sankoff D. and Kruskal J.R., Eds. 1983. Time warps, string edits, and macromolecules: The theory and practice of sequence comparison. Addison-Wesley, Don Mills, Ontario.
Söll D. and Roberts R.J., Eds. 1982. The application of computers to research on nucleic acids. I. Nucleic Acids Res., vol. 10. Oxford University Press, Oxford, United Kingdom.
. 1984. The application of computers to research on nucleic acids. II. Nucleic Acids Res., vol. 12. Oxford University Press, Oxford, United Kingdom.
von Heijne G. 1987. Sequence analysis in molecular biology — Treasure trove or trivial pursuit. Academic Press, San Diego, California.
Waterman M.S., Ed. 1989. Mathematical analysis of molecular sequences (special issue). Bull. Math. Biol. Pergamon Press, New York.
. 1995. Introduction to computational biology: Maps, sequences, and genomes. Chapman and Hall, London, United Kingdom.
Yap, T.K., Frieder O., and Martino R.L. 1996. High performance computational methods for biological sequence analysis. Kluwer Academic, Norwell, Massachusetts.
Journals That Routinely Publish Papers on Sequence Analysis
Bioinformatics (formerly Comput. Appl. Biosci. [CABIOS]). Oxford University Press, Oxford, United Kingdom. http://bioinformatics.oupjournals.org/cabios/.
Journal of Computational Biology. Mary Ann Liebert, Larchmont, New York. http://wwwhto.usc.edu/jcb/.
Journal of Molecular Biology. Academic Press, London, United Kingdom. http://www.hbuk.co.uk/jmb.
Nucleic Acids Research (sections on Genomics and Computational Biology). Oxford University Press, Oxford, United Kingdom. http://nar.oupjournals.org.
第3章 生物数据库
科学是有序的知识,智慧是有序的生活。——Immanuel Kant
本章以常用的NCBI综合数据库为例,介绍生物数据库的基本知识,重点介绍GenBank数据格式及NCBI数据库的查询方法,并介绍UniProt蛋白质数据库与UCSC基因组浏览器的使用方法。
◎ 导学案例
糖尿病是一种由胰岛素分泌缺陷或胰岛素作用障碍导致的高血糖代谢性疾病。主要症状为过度口渴、多尿和体重减轻等。持续高血糖与长期代谢紊乱等可导致全身组织器官功能障碍和衰竭,严重会导致死亡。据世界卫生组织(WHO)统计,2016年全世界有超过4亿人患糖尿病,中国是全世界较为严重的地区之一。
胰岛素(insulin)是动物胰脏内的胰岛β细胞受内源性或外源性物质,如葡萄糖、乳糖、精氨酸等刺激而分泌的一种蛋白质激素,是体内唯一的降血糖激素,在维持血糖恒定,增加糖原、脂肪和蛋白质合成,调控多种代谢途径等方面都有重要作用。胰岛素于1921年被加拿大的外科医生弗雷德里克·班廷(Frederick Banting)首先发现,并用于临床治疗糖尿病。1955年英国桑格小组测定了牛胰岛素的全部氨基酸序列(图3-1),成熟胰岛素由A与B两条链通过两个二硫键连接而成,包含51个氨基酸。1965年,中国科学家首次人工合成具有生物活性的结晶牛胰岛素。班廷因为首次发现并提取了胰岛素,被称为“胰岛素之父”,并获得1923年的诺贝尔生理医学奖。
B1 F V N Q H L C G S H L V E A L Y L V C G E R G F F Y T P K
A1 GIVEQCCTSICSLYQLENYCN A21 T B30 R R E QLSGELALPQLSGAGPGGGGLEVQGVQLDEA
图3-1 人胰岛素的序列
随着各种高通量实验与测序技术的发展,生物分子数据急剧增加,如 GenBank 数据库中的 DNA 数据近几年呈指数方式增长。为有效利用这些数据,大量生物数据库已经被开发用来存储、分析与维护这些数据。著名分子生物学杂志《核酸研究》(Nucliec Acids Research, NAR)每年会出版一期 Database 专辑,截至 2014 年,已经收录 1552 个在线分子生物学数据库,而且每年还在增多。生物数据库对海量的生物数据进行分门别类,有助于从中发现隐藏的生物知识,正所谓 Half day on the web, saves you half month in the lab,利用好这些生物数据库将大大提高生物医学的研究效率。
生物信息数据库大致可以分为几个类型:核酸序列数据库(如 GenBank)、蛋白质序列与结构数据库(如 UniProt、PDB)、基因组数据库(如 UCSC、SGD)、综合数据库(如 NCBI、EMBL)和其他主要数据库(如 KEGG、IMG)等。国际核酸序列数据库联盟(INSDC)由欧洲分子生物学实验室(EMBL),美国 GenBank 和日本 DNA 数据银行(DDBJ)联合组成(1986 年 EMBL 和 GenBank 加入,1987 年 DDBJ 加入),主要负责制定规范化数据格式,报告核苷酸序列的最简信息,并促进数据库之间数据共享。
下面我们简要介绍常用的NCBI综合数据库,重点介绍其中的核酸数据库(GenBank)的使用方法及其数据格式。
3.1 NCBI综合数据库
NCBI是美国生物技术信息中心(National Center for Biotechnology Information)的简称。NCBI成立于1988年,现已是当今世界上最大的基于互联网的生物医学研究中心,其主要任务是开发新的信息技术,来帮助理解控制人类健康和疾病的基本分子机制。NCBI创建并维护了一系列不同的生物医学数据库,包含核酸、蛋白质与基因组等数据,代表性的数据库有GenBank、RefSeq、Genome、PubMed、OMIM、dbSNP等。
NCBI 网址(ncbi.nlm.nih.gov)只要理解它的单位组成结构就很容易记忆。它隶属于美国国立医学图书馆(National Library of Medicine, NLM)。nlm又是美国国立卫生研究院(National Institutes of Health, NIH)的一个部门。最后的gov代表政府部门网址。
NCBI所有数据库都有一个统一的检索系统Entrez。它是一个集成了序列、分类、文献和三维结构等数据的搜索系统,并提供Web界面方便用户检索所有数据库(图3-2)。利用Entrez系统,用户可以跨库搜索(all database),也可以只选择查询单个数据库,如Nucleotide(核酸数据库)、Genome(基因组数据库)和PubMed(文献数据库)等。

下面介绍一下最重要的 GenBank 核酸数据库(Nacleotide)。
3.1.1 GenBank数据库
GenBank 是 NCBI 于 1979 年创建并维护的核酸序列数据库。GenBank 包含了所有已知的核酸序列,以及与其相关的文献与生物学注释信息。GenBank 的数据主要由用户提交,NCBI 网站提供在线提交工具 Bankit,用户提交测序所得 DNA 序列时,还需要一起提供序列的注释信息,如蛋白质编码区、蛋白质序列、重复序列和调控元件等。
GenBank 数据的每一个记录代表一个单独的、连续的并附有注释的 DNA 或 RNA 片段(如为 RNA 则是其对应的 cDNA 序列),并以固定的格式文件保存。GenBank 序列格式已经成为序列标准格式之一,以文本文件保存,GenBank 格式文件 (GenBank flat file, GBFF) 是 GenBank 数据库的基本信息单位。简单地讲,GenBank 记录可以分为三个部分,第一部分是关于整个记录的信息,包含对序列的简要描述、学名、物种分类、参考文献。第二部分是注释这一记录的序列特征 (features),包含对序列的生物学特征注释,如编码区、蛋白质序列、转录单位、重复序列、变异位点等。第三部分是核苷酸序列本身的信息 (ORIGIN),GenBank 格式记录的末尾必须以“//”结束。
我们以 GenBank 网站的一个样本文件(U49845)为例,详细讲解 GenBank 格式文件。由于 GenBank 格式文件比较长,这里只能分成两部分展示:头部分与序列特性部分,并省略其中核苷酸序列与氨基酸序列的一部分内容,全部内容可到相关网址查看。
3.1.2 头部分(header)
头部分含有描述整个 GenBank 记录的信息, 分不同的字段进行详细的说明, 如序列名称、提交日期、物种来源、参考文献等(图 3-3)。每个字段位于左侧第一列。
第一行LOCUS是序列的简单描述,包括序列名称、序列长度、核酸类型、生物体种属来源以及修订日期,图中序列名称为SCU49845,序列长度5028bp,核酸类型DNA,物种来源PLN(植物、真菌和藻类),最后一次数据修订日期1999.06.21。核酸类型也可为RNA(mRNA,tRNA,rRNA),GenBank中储存的RNA序列实为其对应的反转录cDNA序列。
1 | LOCUS SCU49845 5028 bp DNA PLN 21-JUN-1999 |
图3-3 GenBank格式文件头部分
GenBank 中的数据按照惯例被分成独立的 18 个类别, 主要类别有细菌类 (BCT), 病毒类 (VRL), 噬菌体 (PHG), 植物、真菌和藻类 (PLN), 灵长类 (PRI), 啮齿类 (ROD), 人工合成序列 (SYN), 专利序列 (PAT), 以及新增的表达序列标签 (EST) 数据, 高通量基因组数据 (high-throughput genomic sequences, HTG)、环境样品数据 (environment sample, ENV) 等。
在LOCUS下面的DEFINITION行是序列的简明注释,用于说明该DNA序列的来源物种和已知基因或蛋白质的名称。图3-3中的DEFINITION表示该物种为酿酒酵母,基因序列编码三个蛋白质TCP1-beta, Ax12p和Rev7p。该DNA包含TCP1-beta的部分序列(partial cds)和另外两个基因的完整序列(complete cds)。字母cds(常用大写字母CDS)表示蛋白编码序列(coding sequence),也就是说,CDS是表达蛋白质的核苷酸序列。Axl2p和Rev7p序列是完整的,因为它们的 CDS 从起始密码子到终止密码子都被记录,而 TCP1-beta 基因只是记录部分序列。
DEFINITION 下面的词是 ACCESSION(检索号), 检索号是序列记录的唯一标识, 是从数据库中检索到一个记录的主要关键词。通常由一个字母加 5 个数字(U12345)或两个字母加 6 个数字(AF123456)组成。检索号在数据库中是独一无二的且永远不会改变的, 即使数据的提交者改变数据的内容。值得注意的是, 经专家人工注释的 RefSeq 数据库中记录的检索号与其他序列不同, 它用两个字母加一下划线后再加 6 个或更多个数字组成, 如: NM_006744, 代表 mRNA 序列; NP_006735, 代表 Protein 序列; NC_123456, 代表 Genome 序列等。通常检索 GenBank 数据库会得到多个序列结果, 一般可根据 RefSeq 记录号的特征, 优先选择 RefSeq 数据库的序列用于后续分析。
VERSION(版本号)的格式是检索号.版本号。数据更新后,版本号将会增加,而检索号不变。U49835.1中小数点后面的“1”表示序列是版本1。版本号与后面的GI(GenInfo identifier)号是平行的,当一条序列改变后,它将被赋予一个新的GI号,同时它的版本号将增加。
KEYWORDS包括该序列的基因产物及其他相关信息,由该序列的提交者提供。如果该行没有任何内容那么就只包含一个“.”。
SOURCE(物种来源)表示此DNA序列的来源物种,ORGANISM表示物种名与分类,以NCBI的分类数据库为依据,指定物种的正式科学命名。
REFERENCE(参考文献)列出了与该数据有关的参考文献,最先发表的文献列于第一位。如果所引用文献存在于PubMed数据库中,将出现PUBMED关键字,允许链接到PubMed数据库相应记录。
3.1.3 序列特性部分(FEATURES)
序列特性部分显示基因和基因产物,以及与序列相关的其他生物学特征的信息。序列特征分为两列,第一列是特征关键字(feature key),第二列是序列位置(location)与限定词(qualifiers),序列位置与限定词之间通过“/”分开。这个数据记录有三个特性关键词:source、CDS 和 gene。source 表示此段完整序列的范围(1—5028),CDS 表示此段序列内的蛋白质编码序列,gene 表示完整基因序列的位置,注意在一段序列位置内可能有不止一个限定词。
(1) 特征关键词 source
source 通常包含序列来源生物的简称,有些时候也包含分子类型。第一个限定词 organism 表示物种分类,描述限定词的内容放在等号后面的引号中(如=”Saccharomyces cerevisiae”)。当限定词内容只是一个数字时,则不需要用引号。许多限定词是不同数据库之间的相互引用,如图 3-4 第二个限定符 db_xref 表示在物种分类数据库中的交叉索引号为 4932。
(2) 特征关键词 CDS
CDS 是一个重要的基因特性, 表示蛋白编码序列。如图 3-4 所示, source 下为 GenBank 记录中的 CDS 特征词, 第二列的数字表示编码氨基酸序列的核苷酸范围, 包括终止密码子。
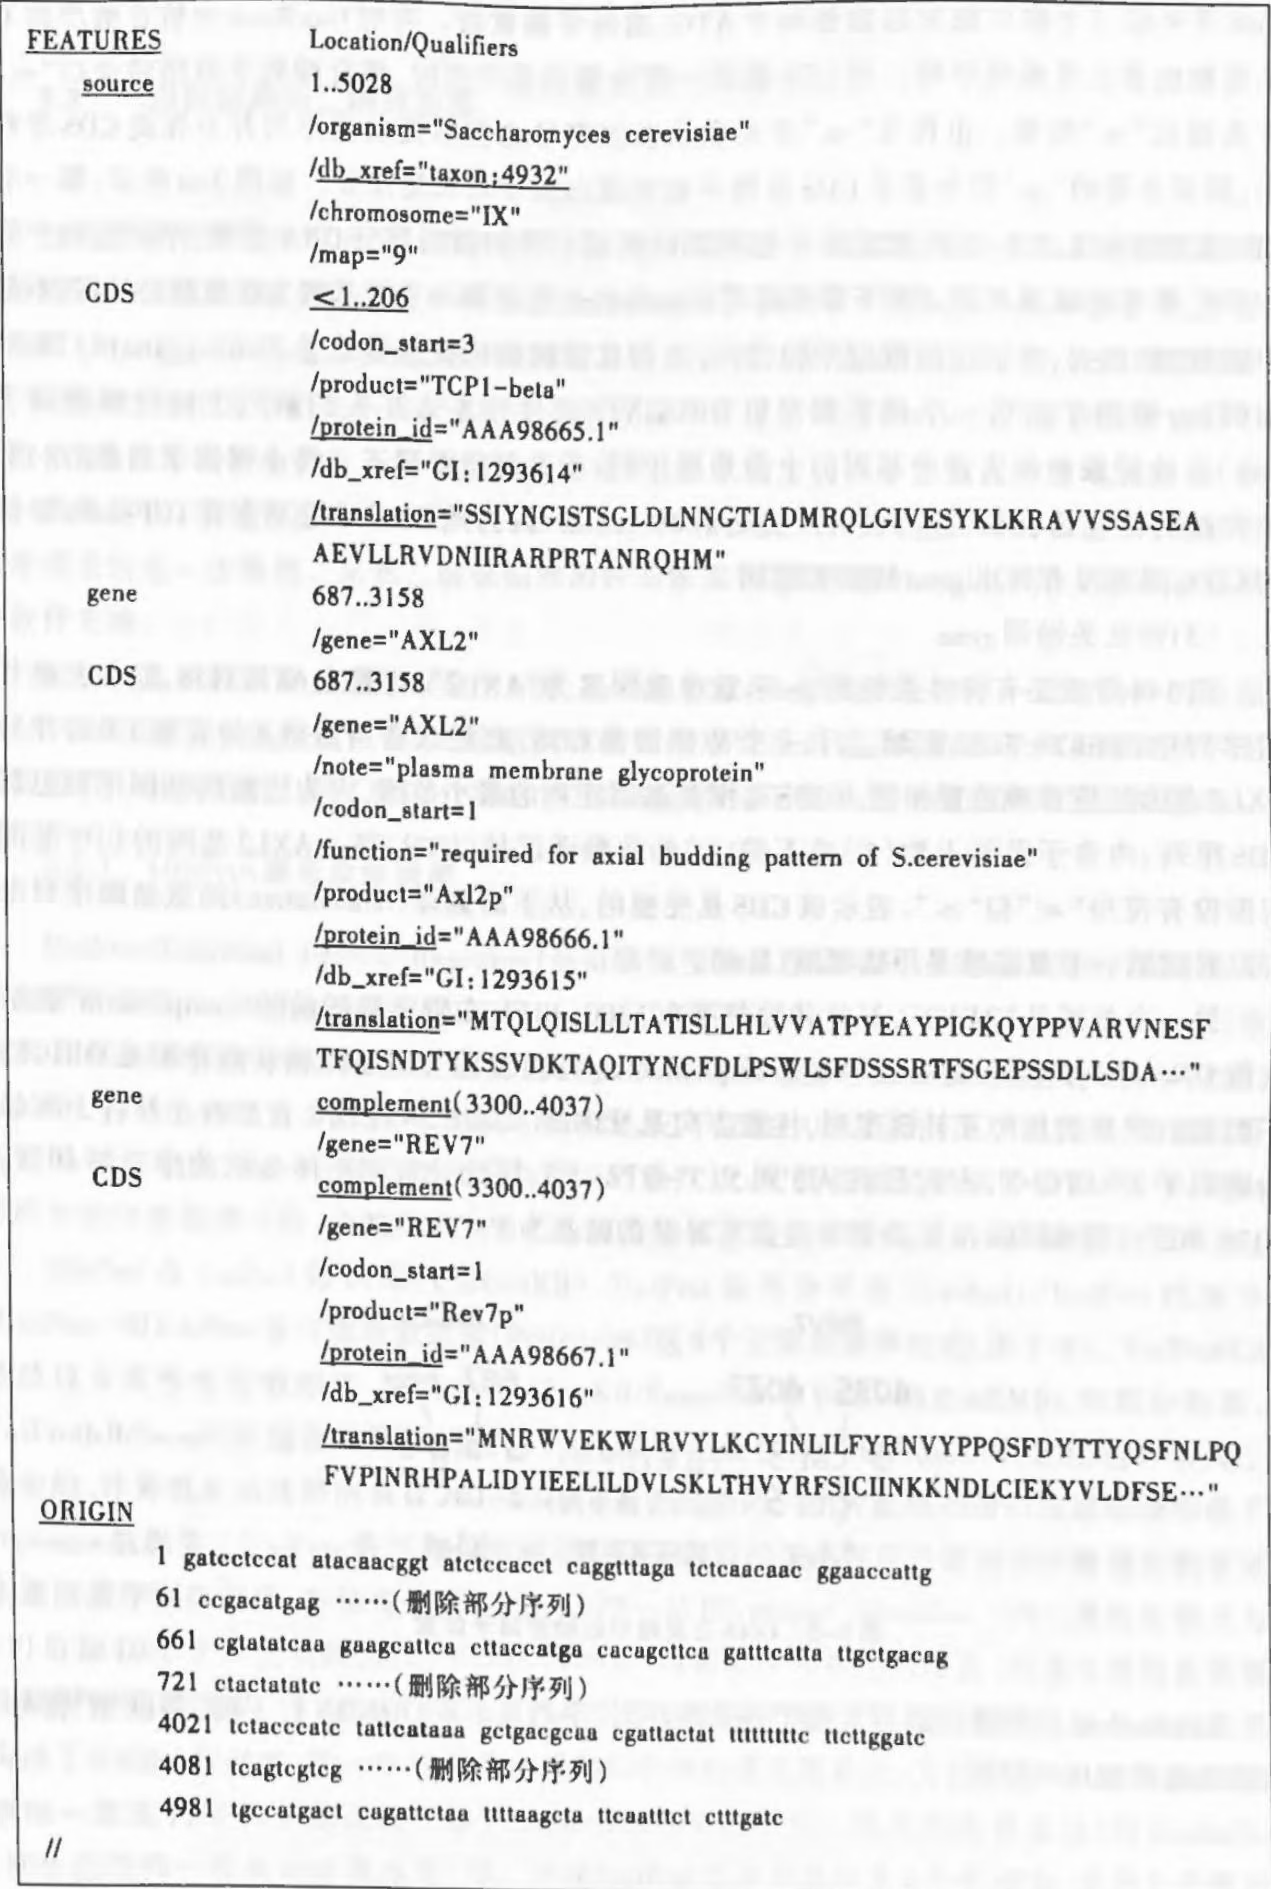
CDS序列前三个核苷酸为起始密码子ATG,编码甲硫氨酸。有时GenBank中核苷酸序列不是完整的蛋白质编码序列。当CDS表示一部分蛋白质序列时,核苷酸数字范围将会以“<”开头或以“>”结尾。由符号“<”开头表示在该符号之前的蛋白质序列并不在此CDS序列中,同样末尾的“>”符号表示CDS序列不包括蛋白质序列末尾部分。如图3-4所示,第一个CDS范围是<1..206,表示此记录不包括编码此蛋白质的前面部分DNA序列,序列起始于第一个已测序的碱基之前。往下看限定符translation,注意第一个氨基酸为丝氨酸(Ser)而不是甲硫氨酸(Met),表示这段数据不包含Ser上游区域的编码氨基酸信息。“codon_start=3”表示编码Ser密码子的第一个核苷酸来自ORIGIN下面序列左边开头的第三个核苷酸密码子(tcc)。此记录中缺失这个基因的上游片段序列,没有起始密码子。终止密码子的最后一个核苷酸的位置是206。该基因的产物是TCP1-beta。因为此DNA片段不含有TCP-beta完整的CDS,因此没有列出gene特性关键词。
(3)特征关键词 gene
图3-4后面还有特性关键词gene,这个基因名为“AXL2”,位置在687..3158,即在此核苷酸序列中的687—3158区域。下一个特征词是CDS,此记录含有AXL2的完整CDS,并与AXL2基因的核苷酸位置相同。CDS范围是基因序列的最小范围,因为完整的基因序列包括CDS序列、内含子及其上游(5’)或下游(3’)的非翻译区域(UTR)等。AXL2基因的CDS范围前面没有符号“<”和“>”,表示该CDS是完整的,从下面翻译(/translation)的氨基酸序列也可以看到第一个氨基酸是甲硫氨酸(Met)。
另一个基因是“REV7”,其核苷酸范围在3300..4037,在数字范围前的“complement”表示这段DNA序列的编码链在互补链(complementary strand)上,即编码核苷酸序列是ORIGIN下面显示序列的反向互补链序列,注意方向是反向的。如图3-5所示,在反向互补链上的起始密码子5’-ATG-3’,方向变成从3’到5’(3’-GTA-5’),即此处末尾粗体显示的序列第4035、4036、4037三个碱基c、a、t,分别对应其互补链的碱基为3’-GTA-5’。
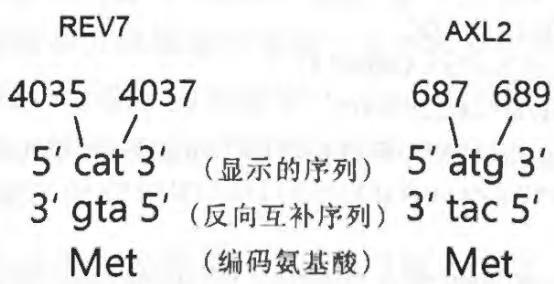
GenBank 记录的第三部分为整个核苷酸序列, 序列显示在 ORIGIN 行下面, 并以“//”符号表示该核苷酸序列结束。
3.2 一级数据库与二级数据库
分子生物学数据库可分为一级数据库与二级数据库。一级数据库的数据都直接来源于实验获得的原始数据,只经过简单的归类整理和注释。因此,一级数据库具有容量大、更新速度快、用户面广等特点,其运行维护也需要具有高性能计算机硬件和专门的数据库管理系统,如欧洲生物信息学研究所维护EMBL用的数据库管理软件是Oracle。二级数据库也称专门数据库,是根据生命科学不同领域的实际需要,对原始生物分子数据进行整理和分类,即在一级数据库、实验数据和理论分析的基础上,针对特定的目标衍生而来的数据库,是对生物学信息的进一步整理。虽然二级数据库的种类繁多,但其容量小,可以不用大型商业数据库软件支撑。
生物信息学数据库大致可以分为4类:基因组数据库、核酸和蛋白质一级结构序列数据库、生物大分子(主要是蛋白质)三维空间结构数据库以及由这3类数据库和文献资料为基础构建的二级数据库。除了前面介绍的NCBI数据库外,下面补充介绍两种常见的数据库。
3.2.1 UniProt蛋白质数据库
UniProt(Universal Protein Resource)是由欧洲生物信息研究所(EMBLE-EBI)、瑞士生物信息学研究所(Swiss Institute of Bioinformatics)以及PIR(Protein Information Resource)三家机构共同组成的UniProt协会所创建的蛋白质资源数据库。UniProt是整合Swiss-Prot、TrEMBL和PIR-PSD三个数据库的数据而成的,它不仅集中收录蛋白质序列资源,还能与其他资源相互联系,是一个目前收录蛋白质序列最广泛、功能注释最全面的数据库。UniProt对所有使用者免费开放,全球科研人员都可以登录其网址进行在线搜索并下载蛋白质序列。
UniProt 由 UniProt 知识库(UniProtKB)、UniProt 参考资料库(UniRef)、UniProt 档案库(UniParc)和 UniProt 蛋白质组数据库(Proteomes)这4个主要数据库组成(图3-6)。UniProtKB 是经过专家校验的数据集,主要由 UniProtKB/SwissProt 和 UniProtKB/trEMBL 两部分构成,UniProtKB/SwissProt 包含专家检查过的、手工注释的条目,而 UniProtKB/trEMBL 包含未人工检查的、计算机自动注释的条目。UniProtKB 里面属于同一物种完整的蛋白质组记录构成了 Proteome 数据集。UniParc 数据库是对现有可公开获得的蛋白质序列数据进行整合后的非冗余蛋白质序列数据库,并给每个蛋白质一个唯一的 ID(unique identifier,UPI),其命名格式为 UPI 后加10个十六进制数,如 UPI000000000A。该数据库只有序列信息,其他注释信息需要链接至来源数据库。UniProtKB 和 UniParc 数据库里面的属于同一蛋白质簇(cluster)的数据构成了 UniRef 数据库,按一个簇内蛋白质序列的相似度及覆盖度,又可细分为 UniRef100(簇序列一致或11个以上氨基酸一致),UniRef90(90%的序列一致及80%覆盖度)与 UniRef50(50%的序列一致及80%覆盖度)等。可在 UniProt 主页点击以上4个数据集,查看各个数据集的情况。
3.2.2 UCSC基因组数据库
UCSC基因组数据库是由加利福尼亚大学克鲁兹分校(University of California at Santa Cruz)开发的一个开放的、收录众多物种基因组序列及其注释信息的数据库。UCSC基因组数据库拥有人类、多种脊椎动物及主要模式生物的基因组序列数据资源,并且集成大量来自序列比对分析或实验研究的注释信息。基因组数据、浏览工具与可下载数据文件都可以在其网站找到,并可通过Table Browser下载多个物种的基因序列及相关注释数据。值得一提的是,UCSC Genome Browser(基因组浏览器)可根据基因组的位置、基因ID等信息方便进行浏览,并可放大或缩小染色体来显示所有注释信息(图3-7)。UCSC基因组浏览器的具体使用方法可扫描章末二维码查看。
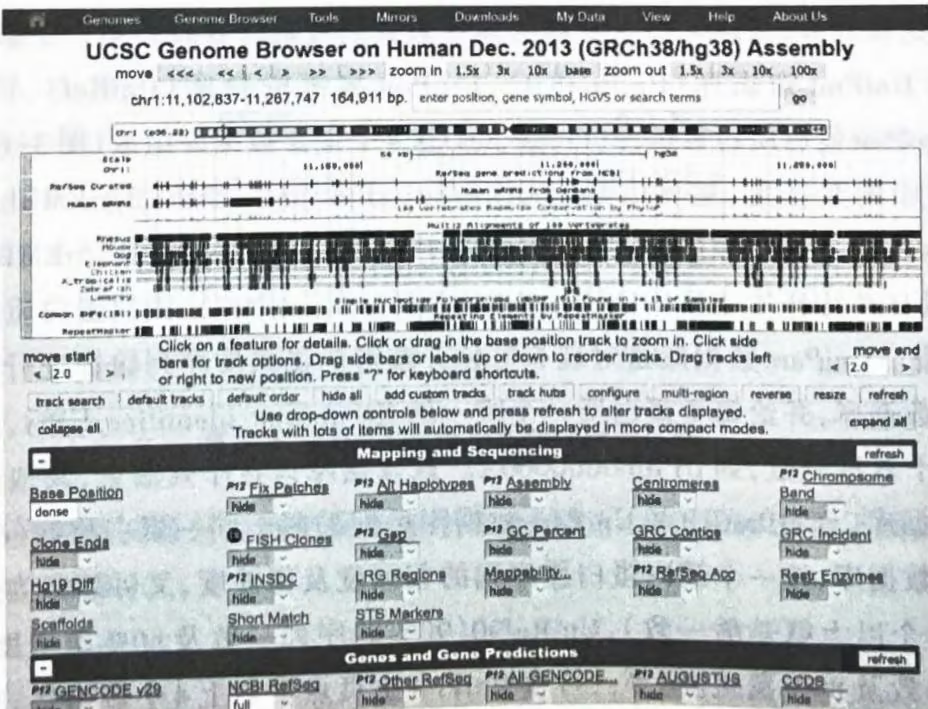
3.3 NCBI查找胰岛素基因序列
假设我们需要克隆人的胰岛素(insulin)基因,用于表达蛋白质或进化分析就需要了解基因的相关信息。下面介绍在NCBI中如何找到胰岛素基因(INS)。
3.3.1 序列查询
(1) 打开 NCBI 主页。
(2) 先在查询栏中选择 Nucleotide 数据库, 在搜索框中输入 “insulin”, 你可以看到会有许多条结果。
(3)那么我们需要加限定词,限定只查看入的胰岛素,输入insulin[Title] AND homo sapiensOrganism。现在少了一些,但还有上千条,许多不是insulin基因,而是与之有关的类似物(insulin like)、受体(insulin receptor)等基因。
(4)另外可用页面左边栏的选项限制结果数量,如选择 Source databases 为 RefSeq,就只剩 100 个左右条目。RefSeq 数据库只收录 GenBank 中的一部分原始类型序列 (wild-type sequences),是非冗余、高质量的序列。
(5)再选择限制项 Molecular types 为“genomic DNA/RNA”,只有 20 项左右了。通过在查询结果页面中查看,可以找到人的胰岛素基因 INS: Homo sapiens insulin(INS), RefSeqGene on chromosome 11。
如果已经知道基因名,可以通过Gene name限定词查询:INS[Gene Name],也可以直接查询”insulin[Title] AND homo sapiens[Organism] AND INS[Gene Name]”得到较少结果。
3.3.2 序列显示
(1)点击这条索引号为NG_007114.1的序列,可以查看它的信息(图3-8),默认显示的是GenBank格式,包括三部分:①描述部分,含参考文献;②各种特征列表;③核苷酸序列显示在最末端,并以//结束。可以鼠标上下移动网页观察这三部分的内容。
(2) 如果想要只显示 DNA 序列, 可以点击上面的 FASTA 链接, FASTA 格式只包括序列 (没有空格与数字), 第一行为注释, 最前面必须是 > 号, 后跟任意注释信息。
(3) 现在点击上面 GenBank 链接返回到 Genbank 格式, 并选择 Customize view 中的 “Gene, RNA and CDS features only” 看一看各个特征值 (CDS, mRNA, exons 等)。点击某一个特征就可以显示并只高亮此特征的序列, 而且在网页底部出现一个信息栏, 可以选择显示不同的特征信息。
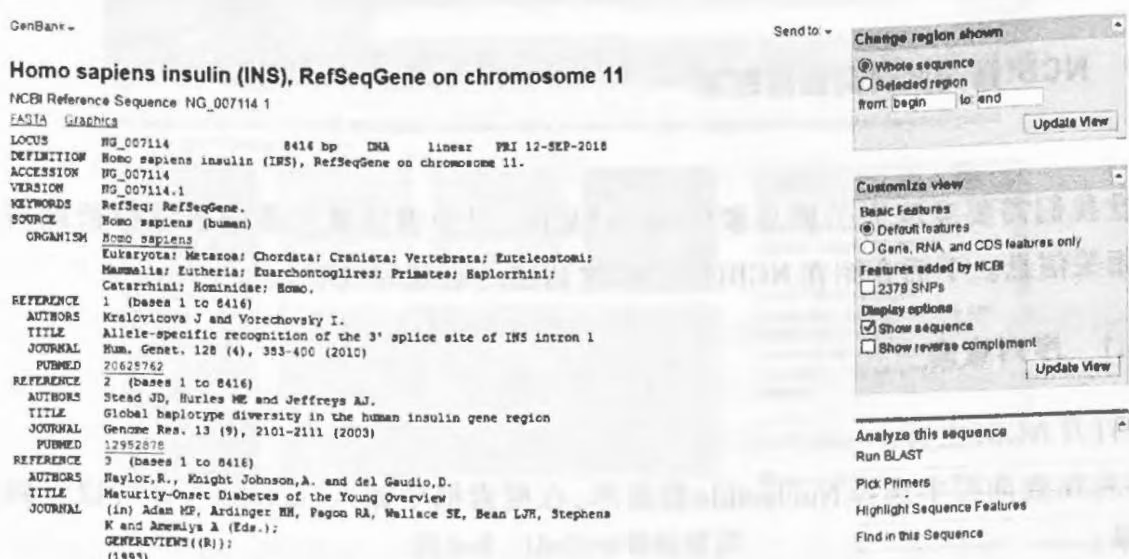
试试显示任一个 gene、mRNA、CDS,并比较它们的差异。
(4) 在网页的右边“Related information”是关于这个基因的其他资源链接。例如 OMIM 数据库可以查看此基因的疾病关联信息。PubMed 数据库可以查看此基因的文章,Gene 或 Protein 数据库可以链接到此基因或蛋白质的数据库条目等。
(5) Display 的另一个 Graphics 链接是用一个小基因组浏览器显示基因的结构与基因组位置等图形信息。它可以放大或缩小,显示基因的内含子与外显子。
3.3.3 序列下载
(1)如果要下载INS基因的编码蛋白质的核苷酸序列,可以找到注释为INS的CDS特征(/gene=”INS”),可在浏览器中查询“/gene=INS”,再点击前面的CDS链接,在跳出的信息栏中选Display(显示)为FASTA,即显示为FASTA格式,可以复制FASTA格式序列,并保存到一个文本文件。
NG_007114.1:5224-5410,6198-6343 Homo sapiens insulin (INS), RefSeqGene on chromosome 11 ATGGCCCTGTGGATGCGCCTCCTGCCCCTGCTGGCGCTGCTGGCCCTCTGGGGACCTGACCCAGCCGCAG CCTTTGTGAACCAACACCTGTGCGGCTCACACCTGGTGGAAGCTCTCTACCTAGTGTGCGGGGAACGAGG CTTCTTCTACACACCCAAGACCCGCCGGGAGGCAGAGGACCTGCAGGTGGGGCAGGTGGAGCTGGGCGGG GGCCCTGGTGCAGGCAGCCTGCAGCCCTTGGCCCTGGAGGGGTCCCTGCAGAAGCGTGGCATTGTGGAAC AATGCTGTACCAGCATCTGCTCCCTCTACCAGCTGGAGAACTACTGCAACTAG
(2) 同理, 如果要下载此 INS 基因的氨基酸序列, 只要在跳出的信息栏中点击“/protein_id = NP_000198.1”的链接即可。除了复制粘贴序列, 也可直接下载序列, 点右上角的“Send to”, 并在下拉框中选择“File”, 就可以保存为一个本地文件。
习题
(1)请在 NCBI 中查找猩猩 chimpanzee(Pan troglodytes)的胰岛素的蛋白质序列,并用 BioEdit 工具比较其与人胰岛素序列的差异。
(2)请分别在 NCBI 的 Gene 和 Nucleotide 数据库搜索胰岛素基因(“INS[Gene Name] AND homo sapiens[Organism]”),并比较搜索结果的差异。
(3)请在UCSC genome browser中查阅在人的胰岛素基因(“INS”)全长范围内有多少种注释信息。
第 4 章 序列比对(Alignment)
凡是过往,皆为序章(What’s past is prologue)——莎士比亚《暴风雨》
本章简要介绍了序列比对的基本概念、打分矩阵与动态规划算法,重点介绍双序列比对与多序列比对的基本原理及其常用软件的操作方法。
◎ 导学案例
流感病毒(influenza virus)是引起人类呼吸道感染的RNA病毒。它通过受感染者咳嗽或打喷嚏的飞沫进行传播,并可在人体外存活。欧洲在1918年暴发大规模流感疫情造成近5000万人死亡。大多数流感患者肺部受病毒侵害,免疫力变弱,发生细菌感染,老年人更容易受到侵害。
典型的流感病毒颗粒呈球状(图4-1),颗粒内为核衣壳,内含有核蛋白与RNA基因组。流感病毒颗粒外膜由两种表面糖蛋白覆盖:血细胞凝集素(hemagglutinin,H)与神经氨酸酶(neuraminidase,N)。它们都是病毒繁殖所必需的蛋白质,也是药物的靶点。常见的抗流感病毒药物,如达菲(奥司他韦)与瑞乐沙(扎那米韦)都是神经氨酸酶的抑制剂。
流感病毒公认含有13个血细胞凝集素(H)与9个神经氨酸酶(N),因此可将流感病毒分为HxNx共135种亚型,例如1918年欧洲爆发的流感病毒为H1N1型。其中H1、H5、H7亚型对人类感染性比较大。人类季节性流感病毒(human seasonal influenza virus)属于H1型,如1918和2009年大流行的流感病毒为H1N1变异株。而最近几年爆发的禽流感病毒(avian influenza viruses)被归类为H5型。禽流感病毒H5N1通常只能感染鸟类,有时也能跨越物种障碍,感染哺乳动物猪,进而演化成为超强病毒危害人类。
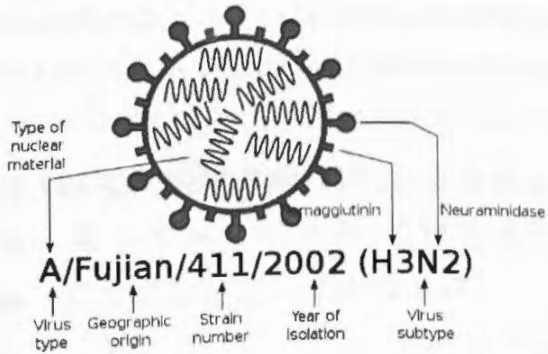
比较是科学研究中最常用的方法之一,通过将研究对象进行相互比较,以寻找它们可能具备的一些共同特征。序列比对(sequence alignment),又称序列联配。简单说就是寻找生物序列相似关系的过程。运用某种特定的算法,找出两个或多个序列之间的最大匹配碱基或氨基酸残基数,判断序列之间的相似程度,从而推测它们的结构、功能及进化上的联系。序列比对按同时参与比对的序列数目不同,可分为双序列比对(pairwise alignment)和多序列比对(multiple sequence alignment)。两条序列的比对称为双序列比对;三条或以上序列的比对称为多序列比对。
序列比对是生物信息学的重要方法之一,可以说是生物信息学这所大厦的“基石”,其他各种方法大多是基于序列比对才发展起来的。通过序列比对可以解决许多关键问题,如确定新发现基因的功能,预测蛋白质的三维结构,推断物种之间的进化关系等。
4.1 序列比对基础
序列比对的理论基础之一是进化学说,即所有的生物都起源于同一个祖先;不同序列不是随机产生,而是在进化上,不断演变而来的。因此,通过序列比对可以发现生物序列从它们最近的共同祖先进化到现在的进化路径。序列比对的另一个基本假设是生物学中序列决定结构,结构决定功能的普遍规律,将核酸序列和蛋白质序列都看成由基本字符组成的字符串,检测序列之间的相似性,可发现生物序列中的功能、结构和进化的信息。
比对(alignment)是指两条序列字符间简单的两两匹配,又称序列联配。如图4-2是两条很短的核苷酸序列的比对结果。
-GCGC-ATGGATTGAGCGA TGCGCCATTGAT-GACC-A
图4-2 序列比对结果
在序列比对的一个位置可能会发生3种不同情况,一是字符相同(match/identity),如DNA的某一位置都是某种碱基,或蛋白质都是某一个氨基酸;二是字符替代(mismatch),在比对某位置上是不同的碱基或氨基酸,即氨基酸或碱基之间发生替换;三是插入和缺失(insertion/deletion),在比对某位置上有一条序列是插入或删除一个或多个位点。由于无法判断是在一条序列上插入碱基或是在另一条序列发生删除碱基,所以一般把插入和删除合并,称插入删除(inDel)。通常在此位置加入空位(gap)来反映此类变化(空位一般用横杠“-”表示)。
4.1.1 序列的相似性与同源性
序列相似性(similarity)与序列同源性(homology)是两个完全不同的概念。序列之间的相似性可以用一个数值来衡量,即序列比对结果中序列之间相同核苷酸或氨基酸所占比例的大小;而同源性是指从某一个共同祖先经趋异进化而形成的不同序列。两条序列要么是同源的,要么是不同源的,不存在同源性的程度大小问题。例如家鼠与小龙虾的胰蛋白酶的蛋白质序列有41%的相似性,但不说明它们有41%的同源性。两条或多条同源序列间的比对可以反映出它们的进化关系。一般同源序列之间的核苷酸或氨基酸序列具有显著的一致性(identity)。在实际应用中,可以根据序列的相似程序来推断比对序列是否具有同源性。但两序列间具有很高的相似性并不等于它们就有同源性,也可能是趋同进化(convergent evolution)造成的。
1 | similarity=an observable quantity often expressed as % identity. |
4.1.2 序列比对的打分
序列比对根据序列的条数和每条序列长度不同往往有多种结果,如这样两条序列:s=GCATGACGAATCAG,t=TATGACAAACAGCA。最简单的就是把它们上下排列在一块,两条序列没有什么相似之处,只有一个相同碱基(图4-3(a));如果将序列t右移一位,并排列后就可以发现它们有许多相同的碱基(图4-3(b));如果把t序列第6位后的序列再往右移一位,就会出现更多的序列相似之处(图4-3(c))。由此可以看出,考虑由插入与删除事件引起的空位将导致比对的复杂性大大增加。
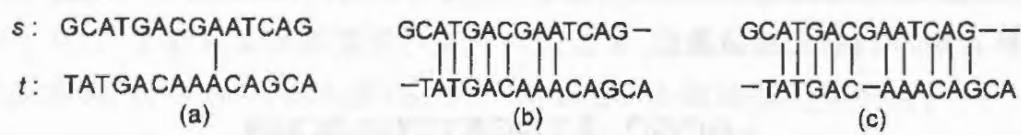
序列比对的多种结果中,有一种或几种结果能够揭示序列的最大相似度,这个比对结果被称为最优比对。为了判断多种比对中哪一种是最优的,需要决定如何为每个比对进行评估或打分,计算序列的相似分数来从众多的比对结果中找出最优的比对。
那么如何计算序列间的相似度呢?序列比对中某一位点比对有三种可能性:匹配、不匹配和空位。根据字符相似度,当比对的字母相同时就奖励(匹配得分,match score),反之则罚分(失配得分,mismatch score),而对含有空位的比对打分时,则要罚分(空位罚分,gap penalty)。简单的打分公式如下:
匹配得分:如果没有空位,而且 $seq1_{i}=seq2_{i}$
失配得分:如果没有空位,而且 seq1_{i}\neq seq2_{i}
空位罚分: 如果 seq1=“-”或 seq2=“-”
假设我们用如下一个简单的打分公式:
假设打分 $\left{\begin{aligned}&匹配得分:1\ &失配得分:0\ &空位罚分:-1\end{aligned}\right.$
我们先来看一个双序列比对的简单例子, 序列 VDSCY 与 VESLCY 的两种可能比对如下:
| 序列1: | V | D | S | - | C | Y | V | D | S | C | Y | - |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 序列2: | V | E | S | L | C | Y | V | E | S | L | C | Y |
| 比对分数: | 1 | 0 | 1 | -1 | 1 | 1 | 1 | 0 | 1 | 0 | 0 | -1 |
两序列比对的总分: Score=Σ(ΛΛ pair scores)-gap penalty
那么,前面一个比对得分为 $1 + 1 - 1 + 1 + 1 = 3$ ,后面一个比对得分为 $1 + 1 - 1 = 1$ 。因此,前一种比对是比较好的比对结果。
4.1.3 打分矩阵
前面打分公式在计算比对的得分时,没有考虑不同氨基酸替换的差别。实际上不同类型的氨基酸替换,其代价是不一样的,某些氨基酸可以很容易地相互取代,而不会改变它们的理化性质。如一条蛋白质序列在某一位置上是丙氨酸,如果该位点被替换成另一个较小且疏水的氨基酸,如缬氨酸,那么对蛋白质功能的影响可能较小;如果被替换成较大且带电的残基,如赖氨酸,那么对蛋白质功能的影响就比较大。因此,理化性质相同似的氨基酸残基之间替换显然应该比理化性质相差甚远的氨基酸残基之间替换的得分要高。同理,对于核酸序列,嘌呤和嘧啶间替换的代价要大于嘌呤与嘌呤间或嘧啶与嘧啶间替换的代价。
基于以上原因提出了打分矩阵(scoreng matrix)的概念。打分矩阵详细地列出各种氨基酸替换的得分,从而使得计算序列之间相似度更为合理。为了得到氨基酸打分矩阵,常用的方法是统计自然界中各种氨基酸残基的相互替换概率,得到氨基酸替代概率模型。打分矩阵为20种氨基酸的 20\times20 非对称替换矩阵(图4-4),其中的元素为每个氨基酸替换概率的对数值,因此又被称为对数几率矩阵(log odds matrix)。打分矩阵的构建方法可扫描章末二维码查看。
PAM 矩阵(point accepted mutation, 点接受突变)是目前蛋白质序列比对中广泛使用的打分矩阵之一, 如常用的 PAM250 矩阵。Dayhoff 等在 1978 年通过统计 71 个蛋白质家族的序列比对 (相似度 >85%) 中总共 1572 个氨基酸的替换概率, 得到氨基酸替代概率模型。如果两种氨基酸间替换发生的比较频繁, 说明自然选择容易接受这种替换, 那么对这两种氨基酸残基比对位点的打分会比较高, 反之则比较低。另一种常用的打分矩阵是 BLOSUM 矩阵 (blocks substitution matrices), 如 BLOSUM65 矩阵。它是通过聚类统计技术来对相关蛋白质的保守功能域的无空位比对进行分类, 并计算类间的氨基酸替换概率。PAM250 矩阵和 BLOSUM62 矩阵都是用于序列相似性的常用记分矩阵 (图 4-4)。如在 BLOSUM62 矩阵中可以看到 D->E 替换分值为 2, 分数越高两氨基酸间越容易发生突变。
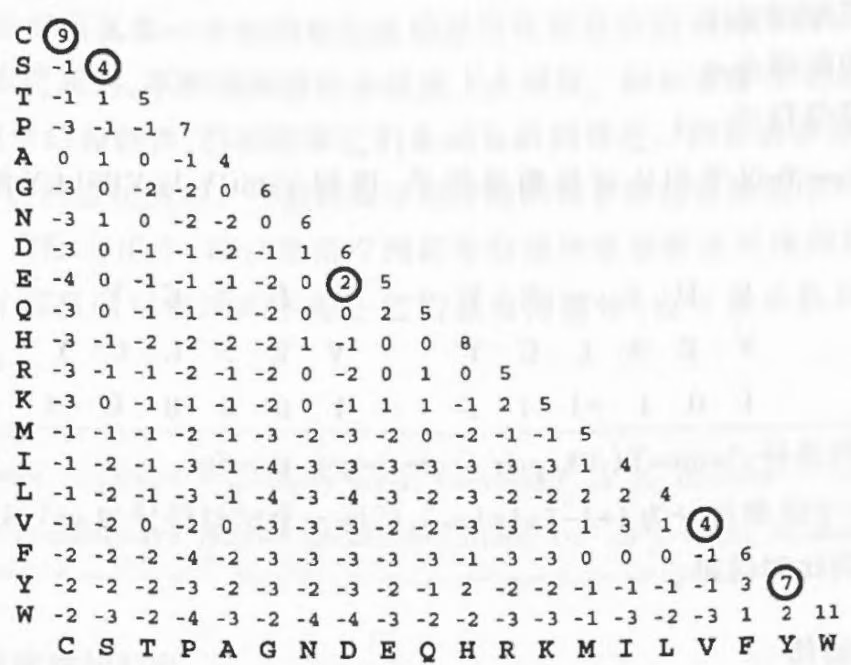
PAM矩阵与BLOSUM矩阵都有一系列的矩阵(PAMx或BLOSUMx)。可根据序列亲缘关系的不同来选择不同PAMx(BLOSUMx)矩阵的进行序列比对。然而,BLOSUMx矩阵中x的意义与PAMx矩阵正好相反,即x值较低的PAM矩阵适合用来比较亲缘关系近的序列,而x值较低的BLOSUM矩阵适合用来比较亲缘关系远的序列。如PAM1和BLOSUM90矩阵适用于关系较近的序列,而另一些矩阵,如PAM100和BLOSUM35,可能更适合那些亲缘关系较远的序列。
BLOSUMx 中数字 x 代表构建此矩阵所用序列的相似度, 如 BLOSUM62 代表由相似度为 62% 的序列构建。较高的 BLOSUM 数字和较低的 PAM 数字代表可用于更相似的序列比对!
1 | \text {序列相似度高} \xleftarrow [ \mathrm{BLOSUM90} ]{\mathrm{PAM1}} \xrightarrow [ \mathrm{BLOSUM35} ]{\mathrm{PAM100}} \text {序列相似度低} |
在序列比对中,打分矩阵的选择是一个很重要的问题。使用不合适的矩阵通常会使比对结果很差,可以尝试不同的矩阵来得到最佳结果。由于PAM矩阵与BLOSUM矩阵建立的理论基础不同,PAM矩阵是从蛋白质序列的全局比对结果推导出来的,而BLOSUM矩阵是基于最相似的蛋白质序列块(BLOCKS)比对,所以在实际应用中,PAM矩阵可用于寻找蛋白质的进化起源,而BLOSUM矩阵适合用于发现蛋白质的保守区域。
4.2 动态规划算法(Dynamic Programming)
一旦选定了为序列比对打分的方法, 就可以为寻找最佳比对设计算法了。最简单的方法就是对所有可能的比对进行穷举搜索, 但这一般是不可行的, 因为两序列比对的数量是序列长度的指数函数, 计算量很大, 所以必须设计高效的算法。例如, 考虑两条不算长的核苷酸序列, 长度分别为 100 和 95。如果在较短的那条序列中插入 5 个空位, 而设计的算法是为所有可能的比对进行计算和打分, 那么我们的程序将要测试大约 55M 个可能比对。随着序列长度的增长, 所有可能比对数将飞速增长, 就不可能在有限的时间内完成计算。
我们可以利用动态规划(dynamic programming)解决这个问题,动态规划往往被用于一个复杂的空间中以寻找一条最优路径。这个方法把一个问题分解成计算量合理的子问题,并用这些子问题的结果来计算最终答案。S. Needleman与C. Wunsch首次运用动态规划方法来进行序列比对。他们的算法与以下即将介绍的很相似,是生物信息学最重要的算法之一。
理解如何运用动态规划算法进行序列比对的关键在于理解如何把比对问题分成若干个子问题。下面以这两条氨基酸序列VESLCY和VDSCY比对为例进行介绍(表4-1),并假定我们使用BLOSUM62蛋白质序列比对打分矩阵。那么第一个位点的比对就存在3种可能:①可以给第一条序列加一个空位;②给第二条序列加入一个空位;③两条序列都不加空位。在前两种情况中,第一个位点的空位罚分是相同的,而余下的得分是根据如何对两条序列剩余部分进行比对而定。在最后一种情况下,第一个位点的比对会得到匹配奖励,因为我们比对的是两个V,而余下的得分同样是根据如何对剩余序列进行比对而定。对这个问题的说明如表4-1所示。
表 4-1 两条序列 VESLCY 和 VDSCY 比对第一位点的 3 种情况
| 第一位点 | 得分 | 待比对的剩余序列 |
| V | +4 | ESLCY |
| V | DSCY | |
| - | -11 | VESLCY |
| V | DSCY | |
| V | -11 | ESLCY |
| - | VDSCY |
如果知道了ESLCY与DSCY最佳比对的得分,就可以立即计算出表中第一行的得分,同样地,如果知道了表中第二、第三行剩余序列的最佳比对的得分,就可以计算出起始位点不同的三种比对得分。有了这三种得分,就可以轻易从第一位点这3种可能中选出具有最佳
比对得分的起始比对。
假设我们选择表4-1第一行的方式来开始比对,并比对了各自序列起始点的V,接着便要计算序列ESLCY与DSCY比对的得分。当继续搜索所有可能的序列比对时,常会遇到同样的问题:ESLCY与DSCY比对的最佳可能得分是多少?动态规划算法使用了一个表格来储存部分比对得分,因此就不用重复计算它们。算法中用到的这个表格的横轴与纵轴分别表示这两条被比对的序列VESLCY和VDSCY。表格中某一个单元格的得分是从它的上单元格、左单元格和左上单元格变化过来所得分值中的最大值(图4-5(A)~(B))。
(A)
1 | F _ i j = arrayl F _ i - 1, j - 1 + s (x _ i, y _ j) |
(B)
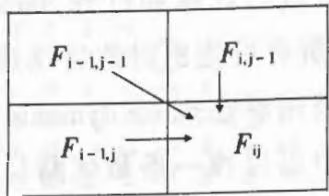
(C)
| - | V | D | S | C | Y | |
|---|---|---|---|---|---|---|
| - | 0 | -11 | -22 | -33 | -44 | -55 |
| V | -11 | 4 | ||||
| E | -22 | |||||
| S | -33 | |||||
| L | -44 | |||||
| C | -55 | |||||
| Y | -66 |
(D)
| - | V | D | S | C | Y | |
|---|---|---|---|---|---|---|
| - | 0 | -11 | -22 | -33 | -44 | -55 |
| V | -11 | 4→ | -7 | |||
| E | -22 | |||||
| S | -33 | |||||
| L | -44 | |||||
| C | -55 | |||||
| Y | -66 |
(E)
| - | V | D | S | C | Y | |
|---|---|---|---|---|---|---|
| - | 0 | -11 | -22 | -33 | -44 | -55 |
| V | -11 | 4 | -7 | -18 | -29 | -40 |
| E | -22 | -7 | 6 | -5 | -16 | -27 |
| S | -33 | -18 | -5 | 10 | -1 | -12 |
| L | -44 | -29 | -16 | -1 | 9 | -3 |
| C | -55 | -40 | -27 | -12 | 8 | 7 |
| Y | -66 | -51 | -38 | -23 | -3 | 15 |
(F)
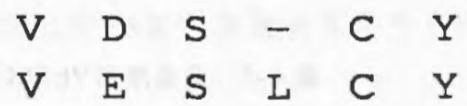
(A) Needleman-Wunsch 算法;(B)(C)(D)(E) 计算得分并回溯;(F) 序列比对结果
动态规划算法计算局部序列比对得分并填入一个表格,直到整个序列比对被计算出来,由此得到最优比对。两条序列的比对等同于从表格左上角到右下角的一条路径。表格中横向的移动表示在纵轴序列中加入一个空位,纵向的移动表示在横轴序列中加入一个空位,而斜对角向的移动表示两序列各自相应的核苷酸进行了比对。
图4-5所示为序列VESLCY和VDSCY的部分比对打分表,其中空位罚分为-11。在方格(1.1)处填入第一个得分0。在算法开始时,用空位罚分的倍数对表格第一行与第一列进行初始化,如图4-5(C)所示。现在开始填写表格的第二行的第二个空格(2.2),这个位置对应于比对的第一列。前面提过,对于第一个位置存在三种可能:第一条序列加上的空位,第二条序列加上的空位,以及序列间核苷酸的比对(无空位)。因此,可以给表格中“-”个位置填上3种可能分值之一:
①把左边(2,1)位置的值加上空位罚分,这表示给纵轴序列加入一个空位;
②把上方(1,2)位置的值加上空位罚分,这表示给横轴序列加入一个空位;
③把左上方(1,1)位置的值加上两轴上相应核苷酸间的匹配奖励或失配罚分,这表示两个核苷酸间进行了比对。
对于这3种选择,选取其中的最大值填入表格。在本例中,得到这3种选择的值分别是-11、-11与4(图4-5(C))。所以选择最大值4。这等同于两条序列起始位点处V的比对。填完(2,2)这一格以后,便可以用同样的方法填写第二行余下的空格,现在用前例的方法来考虑表中(2,3)这一格。填写这一格有3种选择:
①将左边格中的4加上空位罚分(-11),结果为-7;
②将上方格中的-22加上空位罚分,结果为-33;
③将左上方格中的-11加上失配得分,因为该位点两个核苷酸(V和D)不匹配得分(-3),结果为-14。
所以要选择这3者中的最大值,将-7填入(2,3)这一格。
接着填第三行,直至填完整个表格。图4-5(E)显示了已经填满了的表格。表格填满以后,右下角方格的值代表了两序列间最优带有空位比对的得分。在图4-5所示的例子中,可以看到最优比对的得分为15。从计算过程可以看出,为得到这个得分,并不需要为两条序列间所有可能的比对进行打分,即没有搜索所有可能的比对。
为了利用打分表重建比对,需要找出一条由表格中最右下角到最左上角的路径(回溯)。为了建立这条回溯路径,要从表格中当前位置开始找出下一个位置,这个位置必须可以产生当前位置的得分。用图4-5(E)最右下方的位置来说明,这一方格的得分为15。在3种可能产生这一得分的选择中,仅有一种选择产生的得分为15:斜对角的元素的值为8,再加上Y与Y匹配得分(7)便是15。因为这是该位置仅有的一种能够得到15的方法,画一个箭头指向斜对角的元素,如图4-5(E)所示。在(6,5)这个新位置开始,仅有一种方法得到8这个得分:斜对角的元素-1加上C与C匹配得分9。所以箭头指向这个元素。继续这一过程直到所有可能的路径都回到了(1,1)这一格。这些路径代表着两序列间所有的最优比对。图4-5(E)中箭头指示了打分表中从右下角到左上角的一条合法路径。
要把路径转换成序列比对,仅需要根据此打分阵列的意义,一个纵向的移动表示在横轴序列中加入一个空位,一个横向的移动表示在纵轴序列中加入一个空位,而一个斜对角的移动表示两序列当前位点的核苷酸进行了一次比对。如观察图4-5(E)中回溯的那条路经。路径移动从右下到左上排列起来是 $\uparrow$ $\backslash$ $\backslash$ .利用这条线路,可以从右至左地“回溯”重建比对。第一个箭头是斜对角指向,所以比对最后两个核苷酸:
1 | Y |
再后面的一个箭头是纵向的,所以在横轴序列中加入一个空位,将此空位与纵轴序列下一个核苷酸进行比对:
从右至左继续这一过程,便可以得到以下这个得分为15的最优比对(图4-5(F)):
有时会发现不止一个比对有最优得分,还可得到同样得分的其他路径。若有其他路径,还可以通过跟踪局部打分表中所有的路径,可以重建两序列间所有可能的最优比对。
4.3 全局比对与局部比对
序列比对如果从比对范围来考虑,可分为全局比对(global alignment)与局部比对(local alignment)。全局比对从全长序列出发,将两条序列从整体上进行比较;而局部比对则着眼于序列中的一部分序列(子序列),比较这些子序列之间的相似性。例如要比较一条较长的序列“AAACACGTGTCT”与一条较短序列“ACGT”,在若干序列比对中,我们最感兴趣的可能是:
AAACACGTGTCT
—ACGT—-
这种局部比对结果表明短序列完整地出现在较长的序列之中。局部序列相似性往往有重要的生物学意义,如酶的功能活性位点是由较短的序列组成的,尽管在序列的其他位置有各种突变,但这些功能位点的序列却相当保守。全局比对算法却很难发现它们,而局部比对可以发现这种保守序列。
20世纪70年代,S. Needleman与C. Wunsch提出了End-to-End的全局比对算法,即Needleman-Wunsch算法,但是直到1981年,F. Smith与M. Waterman对全局算法进行修改,首次提出局部比对算法,即Smith-Waterman算法。Smith-Waterman算法的主要创新点是给Needleman-Wunsch算法增加了一个最低得分不低于0的选项,这个0只是赋予了局部重新开始的机会。局部比对算法与全局比对一样,当填写打分表时,给表中得分小于0的位置填上0,这样最后就很容易从表中找到最大的局部比对得分,如图4-6所示,得到匹配子序列TATA。当处理数千甚至百万个碱基的长序列时,局部比对算法可以识别子序列,而全局比对是不可能做到的。基因组学研究过程中经常要遇到这种情况,如要找出一条基因序列与酵母基因组具有相似部分的任何一条子序列。
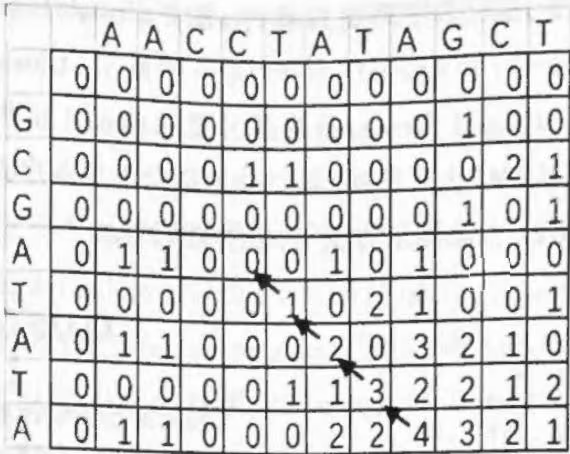
4.4 多重序列比对
多重序列比对(multiple sequence alignment, MSA)是研究基因或蛋白质功能的常用方法, 可以发现同源序列中的保守结构域, 预测蛋白质结构及构建分子进化树等。多重序列比对可直接应用前面讨论过的动态规划算法, 但MSA计算时间复杂度是 $O(L^{N})$ , L代表序列长度, N代表序列数量, 即时间是序列长度的序列数量幂次方。随着序列数量增多, 计算复杂度迅速增大, 那么在现有计算能力下的计算时间将变得非常长。因此, 多序列比对算法大多是基于渐进比对(progressive alignment)的思想, 在两两序列比对的基础上, 逐步优化多序列比对的结果, 这类方法不能保证产生最优比对, 但能找出一个近似最优的比对。
D. G. Higgins 和 P. M. Sharp 在 1988 年首次提出 Clustal 算法(图 4-7),这种算法开始时先比对亲缘关系较近的序列,再将其他亲缘关系较远的序列加入其中,从而产生一个完整的多重序列比对。具体过程如下。
(1)首先,将所有的序列利用动态规划算法进行两两比对,计算得到包含每对序列分歧程序的距离矩阵;
(2) 然后, 根据距离矩阵构建一棵指导树 (guide tree), 以此来确定被比较序列间的亲缘关系 (相似程度);
(3) 最后, 按这棵指导树的分支顺序进行渐进比对, 从亲缘关系最近的两条序列开始, 逐步引入临近的序列, 并不断重新构建比对, 最终得到全部序列的全局比对结果。
Clustal系列程序是最常用的多序列比对软件,包含Clustal Omega、ClustalW和ClustalX三个程序。ClustalW(图4-7)和ClustalX使用同一种算法,ClustalW是命令行程序,而ClustalX是图形界面软件。Clustal Omega是最新开发的Clustal程序,使用了隐马尔科夫模型(Hidden Markov Model, HMM)比对算法,可以快速进行上千条序列的比对,但只能使用命令行模式运行。Custal Omega也提供了方便使用的在线网站。
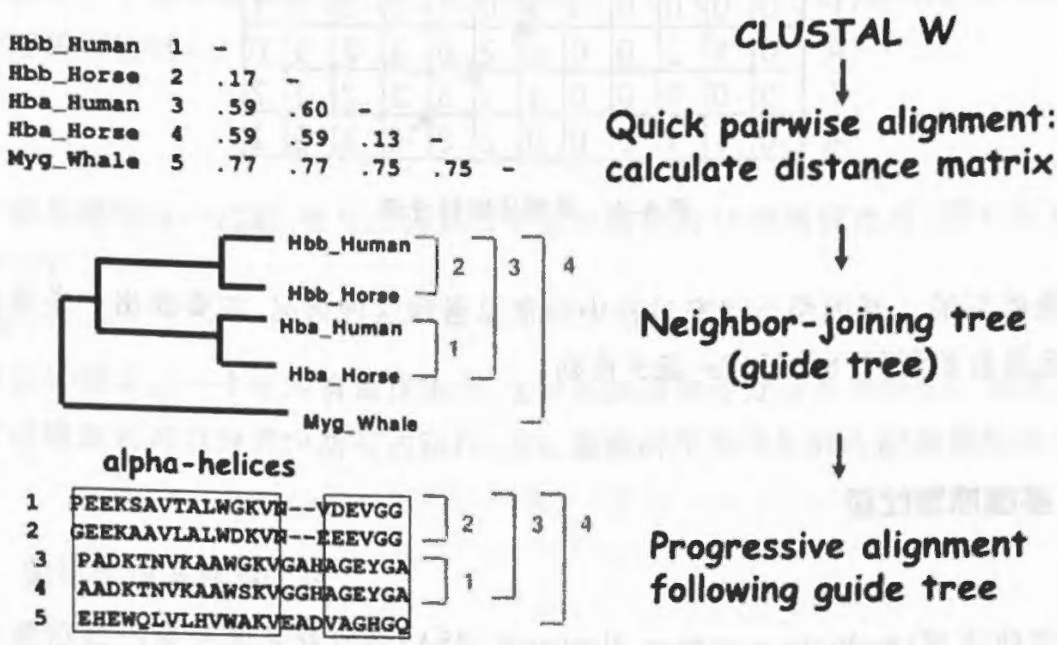
在多重序列比对中,打分矩阵的选择对比对结果有重要的影响。一些矩阵适用于亲缘关系较近的序列,如PAM-1和BLOSUM-90,而另一些矩阵适合关系较远的序列,如PAM-100和BLOSUM-35。使用不合适的打分矩阵通常会得到很差的比对结果。为使比对结果更有生物学意义,多重序列比对一般要根据蛋白质的结构与功能方面的信息进行手工调整或改进,如酶活性位点、二级结构元件等具有较保守序列。
4.5 双序列比对实践
流感病毒的基因组可分成八个片段,每一段大致编码一个蛋白质,第4片段是编码凝集素的基因(HA)。凝集素是病毒与宿主细胞之间进行相互接触所必需的病毒表面蛋白。病毒首先要结合宿主细胞,才能复制及导致疾病,因此HA是特定病毒能感染宿主的关键决定因子。人类季节性流感病毒(human seasonal influenza virus)的HA都属于H1型,而最近爆发的严重禽流感病毒(avian influenza viruses)的HA被归类为H5型。这些分型是基于已知特异性抗体的结合实验,但序列比对可提供更详细的信息,如相似性、差异位点等。
我们可以利用 Needleman-Wunsch 算法来比较流感病毒 HA 片段。首先, 让我们看看 2009 年美国的 H1N1 病毒参考毒株 A/California/07/2009(H1N1) 与另一个中国流行的人类季节性 H5N1 病毒 A/goose/Guangdong/1/1996(H5N1) 的序列比对。
4.5.1 序列查找
(1) 打开 NCBI 网站。
(2) 在网页上方搜索栏中将数据库类型从“All Datebases”改为“Nucleotide”,并在输入栏里键入所需病毒名称,如 A/California/07/2009(H1N1),点击“Search”按钮。
(3)点击结果页面的左边栏“Source databases”的“RefSeq”,限定只显示 RefSeq 数据库中的序列,可在结果中找到含(HA)的结果:Influenza A virus(A/California/07/2009(H1N1)) segment 4 hemagglutinin(HA) gene, complete cds(Accession: NC_026433.1)。
(4) 点击上面 HA 结果链接, 在出现的页面中 FEATURES 部分找到 CDS, 点击 CDS 链接, 页面下方出现序列显示工具栏, 选择 “Display: FASTA”, 即可得到 CDS 序列。复制此 CDS 序列到一个文本文件, 或选择右上角 “Send to”, 再选择 “File”, 保存到一个文件。注意: 此时请勿关闭网页。
(5)再回退到前面结果页面,找到HA的蛋白质注释(/protein_id=”YP_009118626.1”),并点击“protein id=”后链接;在新出现的结果页面中选择右上角“Send to”,再选择“File”,并选择“FASTA”格式,即可保存氨基酸序列(图4-8)。
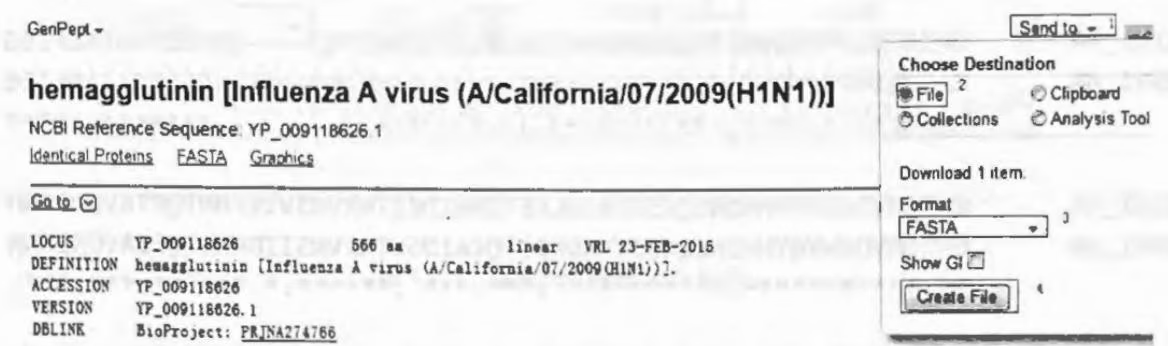
(6) 同上方法查找 H5N1 病毒 A/goose/Guangdong/1/1996(H5N1)及其他流感病毒的基因与蛋白质序列。
4.5.2 序列比对
我们使用欧洲生物信息研究所(European Bioinformatics Institute)开发的一套比对工具Clustal对齐序列。首先打开网址https://www.ebi.ac.uk/Tools/msa,并选择Clustal Omega;点击“Louch Clustal Omega”链接数据类型默认是“Protein”(如是DNA要选择DNA),并复制前面下载的两条序列到序列输入框;其他参数都采用默认设置,点“Submit”运行比对序列;比对结果如图4-9所示,顶部显示比对所用的程序ClustalO,后面显示序列比对结果,匹配的核苷酸由“*”字符表示,点(.或:)代表不匹配,但氨基酸的理化性质相似,短划线(-)填补空位(gap)。
| CLUSTAL O(1.2.4) multiple sequence alignment | |
| H1N1_HAH5N1_HA | MKAILVVLLYTFATANADTLCIGYHANNSTDTVDTVLEKNVTVTHSVNLLEDKHNGKLCK-MEKIVLLLAIVSLVKSDQICIGYHANNSTEQVDTIMEKNVTVTHAQDILEKTHNGKLCD: *:** . : ::* :********: ***:::********: ::**.*******. |
| H1N1_HAH5N1_HA | LRGVAPLHLGKCNIAGWILGNPECESLSTASSWSYIVETPSSDNGTCYPGDFIDYEELRELNGVKPLILRDCSVAGWLLGNPMCDEFINVPEWSYIVEKASPANDLCYPGDFNDYEELKH*.* ** * . * :***:**** * :: .. .********. * . ***** *******. |
| H1N1_HAH5N1_HA | QLSSVSSFERFEIFPKTSSWPNHDSNKGVTAACPHAGAKSFYKNLIWLVKKGNSYPKLSKLLSRTNHFEKIQIIPK-SSWSNHDASSGVSSACPYHGRSSFFRNVVWLIKKNSAYPTIKR** .. **::::*:** *** ***:..**:::***: * .**::::*:::**..:**.::: |
| H1N1_HAH5N1_HA | SYINDKGKEVLVLWGIHHPSTSADQQSLYQNADAYVFVGSSRYSKKFKPEIAIRPKVRXXSYNNTNQEDLLVLWGIHHPNDAAEQTKLYQNPTTYISVGTSTLNQRLVPEIATRPKVNGQ** * : ::::********: ;:* .**** ::* :**:* .::: :**** *******. |
| H1N1_HAH5N1_HA | EGRMNYYWTLVEPGDKITFEATGNLVVPRYAFAMERNAGSGIIISDTPVHDCNTTCQTPKSGRMEFFWTILKPNDAINFESNGNFIAPEYAYKIVKKGDSAIMKSELEYGNCNTKCQTPM.***:::**:::*.* *.*:.*:.*:.*: : :...*.* : * :***.**** |
| H1N1_HAH5N1_HA | GAINTSLPFQNIHPITIGKCPKYVKSTKLRLATGLRNIPSI----QSRGLFGAIAGFIEGGAINSSMPFHNIHPLTIGECPKYVKSNRLVLATGLRNTPQRERRRKKRGLFGAIAGFIEG****:*:::**:****:***:********:*.***** * . :.************ |
| H1N1_HAH5N1_HA | GWTGMVDGWYGYHHQNEQGSGYAADLKSTQNAIDEITNKVNSVIEKMNTQFTAVGKEFNHGWOGMVDGWYGYHHSNEQGSGYAADKESTQKAIDGVTNKVNSIIDKMNTQFEAVGREFNN** *******.*******:***:*** :*******:*:******** ***:***: |
| H1N1_HAH5N1_HA | LEKRIENLNKKVDDGFLDIWTYNAELLVLLENERTLDYHDSNVKNLYEKVRSQLKNNAKELERRIENLNKQMEDGFLDVWTYNAELLVLLMENERTLDFHDSNVKNLYDKVRLQLRDNAKE** :********: ::*****:********:********:*******:*** ** :**** |
| H1N1_HAH5N1_HA | IGNGCFEFYHKCDNTCMESVKNGTYDYPKYSEEAKLNREEIDGVKLESTRIYQILAIYSTLGNGCFEFYHKCDNECMESVKNGTYDYPQYSEEARLNREEISGVKLESMGTYQILSIYST:******* *******:*****:*****:*****.***** *******:****:**** |
| H1N1_HAH5N1_HA | VASSLVLVVSLGAISFWMCSNGSLQCRICI VASSLALAIMVAGLSLWMCSNGSLQCRICI*****.*: : ...: *:********** |
图4-9 Clustal格式
序列比对结果的下方有3种符号:
“*”: 代表该列氨基酸完全相同;
“:”:代表该列氨基酸发生改变,但有较高度保守的氨基酸;
“.”:代表该列氨基酸发生改变,但含有一般保守的氨基酸。
而没有上述符号标志的氨基酸位点差异较大。
4.6 BioEdit进行多序列比对、编辑与美化
(1) 启动 BioEdit, 并导入序列文件: 选菜单 File→Open…→选择 flu-HA_aa.fasta 文件。
(2) 序列比对: 鼠标选中两条序列的标题, 点击 Accessory application→ClustalW multiple alignment, 在跳出窗口中点“run ClustalW”, 运行后就可以在新的窗口看见比对结果。
(3)导出文件:点菜单 File→Save as …→选择 FASTA 格式→保存为 flu-HA_aa_aligned.fasta。后续工作可直接导入序列比对后保存的文件。
(4)查看比对结果,可选中工具栏中的“View conservation by plotting identities to a standard as a dot”,以点显示与第一行相同的字母(图4-10)。如果观察到有些位置的序列比对不合理,可进行序列编辑,或调整空位(gap)位置等。(注意:修改前需要把工具栏中Mode的状态改成“Edit/Insert”,再进行删除或修改操作。)
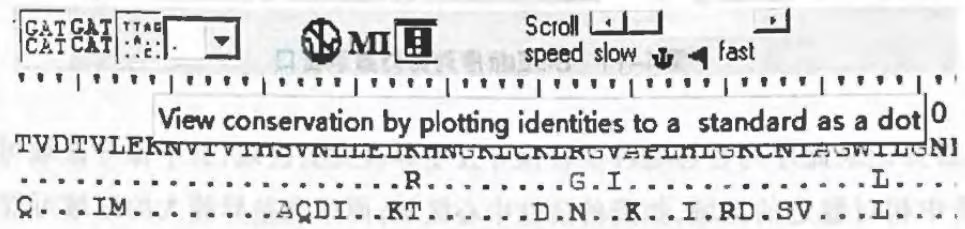
(5) 显示序列比对: File→Graphic view, 可以对比对显示进行美化(图 4-11)。有许多显示参数可修改, 但有些参数修改后需要按右上角的 Redraw 按钮察看结果。
修改每行的碱基数(Residues per row): 修改为 60 或 80。
如果每行有碱基不能显示, 则调整画布页面的高(page height)与宽(page width)。
设置显示阴影的域值(Threshold for shading)为50或80, 并勾上“Id./Sim. Shading”方框。并可以改变Similar及Identical的背景(back)及字体(font)颜色。
再试试改变其他一些选择参数察看各个设置的作用。
(6) 编辑完后, 可以保存结果为图片: Edit→Copy as Bitmap 或 Edit→Copy as Enhanced Windows Metafile。保存的图片可以直接插入到 MS WORD 中, 或用画图及 Photoshop 程序进行进一步的修饰。
生物信息学与基因组分析入门
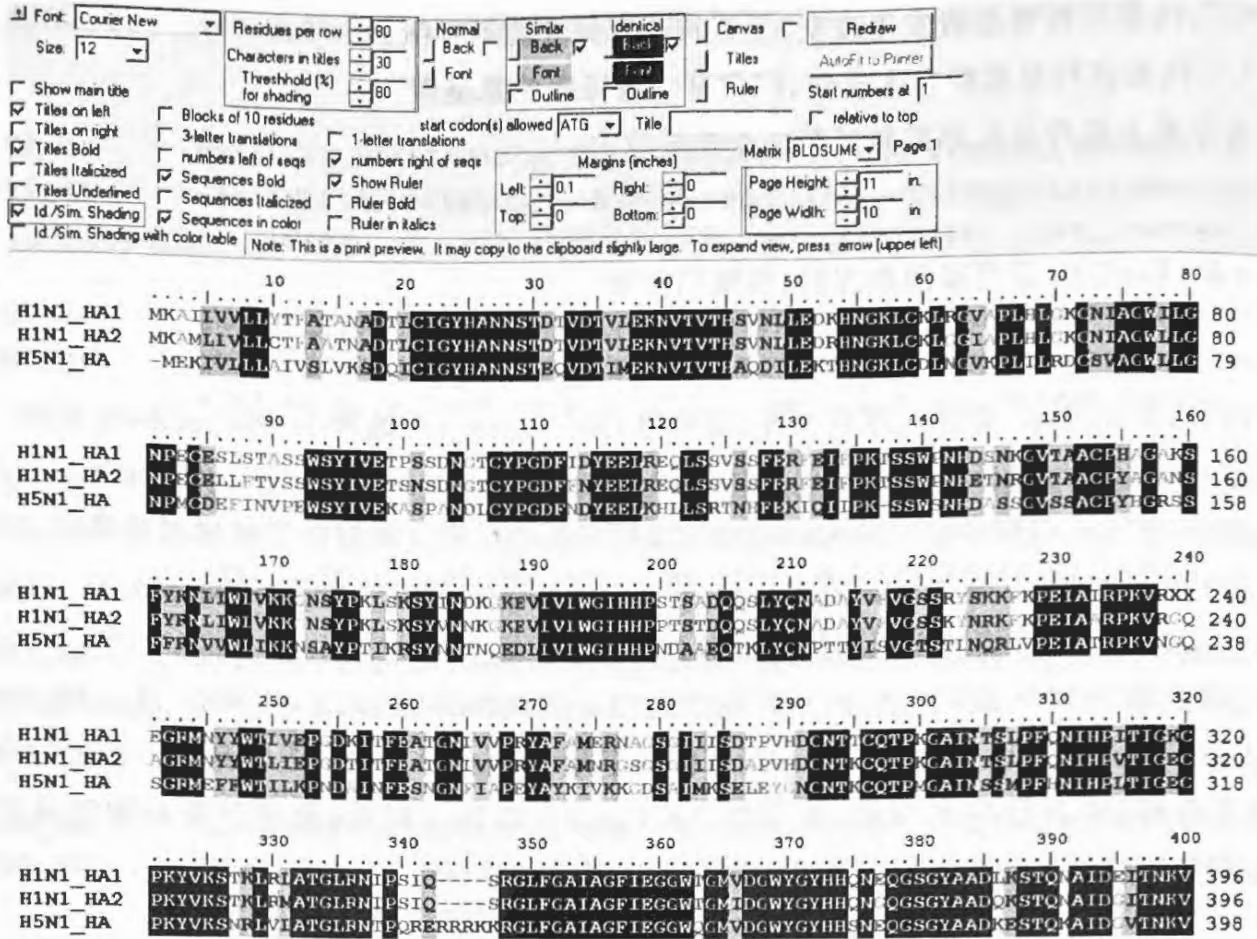
(7) 观察并记录此序列在各物种中较保守及变异较大的区域, 其中保守区域可能对应凝集素蛋白质中相对稳定的区域, 如酶的活性中心区域; 而序列差异较大的区域可能与流感病毒产生耐药性有关。
习题
以流感病毒 HA 蛋白质的 DNA 序列文件重复上述过程, 注意 DNA 与蛋白质在序列比对及编辑时的一些差异。
试以 BioEdit 核苷酸比对的打分方法 (Match: 2; Mismatch: -1; Gap Initiation: -3; Extending Gap by 1: -1), 手工计算下面两条序列的最优比对结果:
GTCAC
GTACC
- 下表是依据两条核苷酸链 S=ACACACTA; T=AGCACACA, 做出的 dynamic programming method 得分矩阵表, 按单位矩阵打分值已经给出了初始行、列的得分 (匹配得分 =+1, 失配得分 =0, 空位罚分 =-1), 请:
(1) 计算其他矩阵位点的得分。
(2)画出最优路径。
(3) 据此给出两条序列的比对结果。
表 4-2 两条序列的比对结果
| Gap | A | C | A | C | A | C | T | A | |
|---|---|---|---|---|---|---|---|---|---|
| Gap | 0 | -1 | -2 | -3 | -4 | -5 | -6 | -7 | -8 |
| A | -1 | 1 | 0 | -1 | |||||
| G | -2 | 0 | -1 | ||||||
| C | -3 | ||||||||
| A | -4 | ||||||||
| C | -5 | ||||||||
| A | -6 | ||||||||
| C | -7 | ||||||||
| A | -8 |
第 5 章 序列数据库搜索(BLAST)
如果教育不是让人学会如何学习的过程,那又会是什么呢?——Peter Alexander Ustinov(英国演员和艺人)
本章介绍了 BLAST 工具的类型及算法, 包括 PSI-BLAST 的算法, 并以实例介绍 NCBI 在线 BLAST 工具与本地 BLAST 的使用方法及结果解读。
◎ 导学案例
雾霾给人类的健康带来了隐忧,其颗粒中的微生物被认为有可能造成部分呼吸道疾病和过敏症状,以及诱发癌症。据报道,2014年欧洲每年有43万人因空气污染早亡,平均每人“折寿”约38天。一篇名为“The structure and diversity of human, animal and environmental resistomes”,其中提到取自北京的14份雾霾天空气样本中检测出了抗生素抗性基因。该文章一经发表便引起了民众的高度关注,被误会成空气中含有耐药性病菌,一度引起恐慌。
细菌中的抗生素抗性基因使细菌对氨苄青霉素、氯霉素等抗生素产生抗性。在一个细菌群体中,不是所有的个体都有抗性基因。而且绝大多数细菌对于人体都是无害甚至是有益的,只有少数细菌是致病菌。只有当空气中存在了相当密度的、携带抗性基因的、并具有活性的致病菌时才会对人体造成伤害。所以对于雾霾中检测出抗性基因,大家并不需要觉得恐慌。但是这个现象背后的趋势还是要重视,要严防抗生素滥用。
抗生素是人类日前对抗细菌的主要武器。在抗生素发明后的十几年里,它在人和动物上都得到了广泛的应用。当人们沾沾自喜以为终于消灭了病菌的时候,环境中已经充满了抗生素的抗性基因。越来越多曾经绝迹的细菌感染疾病最近有卷土重来之势。
因为抗性基因往往是通过基因突变产生,但基因频率较低,所以自然界中耐药细菌比较少。如果一个菌群受到抗生素作用,其中没有抗性基因的细菌会被杀死,导致耐药细菌的比例增加。抗生素不会制造耐药细菌,但会使那些已经有抗性基因的细菌在种群中的数量增加。因此,使用抗生素越多,在人体、动物以及在环境中的抗性细菌就会越普遍。
细菌还可以通过基因水平转移(horizontal gene transfer, HGT)快速传播抗性基因。HGT是指遗传物质从一个细胞转移到另一个细胞。例如,携带抗性基因质粒的细菌通常可以将该质粒转移到其周围的非抗性细菌中。这种转移可以通过细胞与细胞的接触(conjugation),通过病毒转导(transduction),或通过直接摄取环境中DNA的转化(transformation)来进行。抗生素抗性基因也经常位于转座子中,转座子可在基因组内移动,进一步促进其转移。由于饲养动物大量使用抗生素,动物体内产生的耐药菌通过食品或其他方式进入人体,在人体内耐药菌与致病菌通过HGT交换遗传物质,从而产生超级耐药致病菌。
BLAST(basic local alignment search tools)可能是生物信息学中最常用的序列分析工具。BLAST可以把查询序列(query sequence)与数据库中的序列进行快速序列比对(图5-1),找出与查询序列相似的目标序列(subject sequence)。在生物研究过程中经常要用到BLAST工具,例如你克隆到一条新基因序列,想知道它的功能,就可以将这条序列与GenBank数据库进行BLAST比对,搜索到那些与此新基因相似的序列。这些相似序列可能在其他物种中已经有基因功能的注释,据此可以推测这个新基因的可能功能。随着生物信息学数据大量积累,通过BLAST比对可以有效地获得你感兴趣的基因或蛋白质的功能和进化等信息。
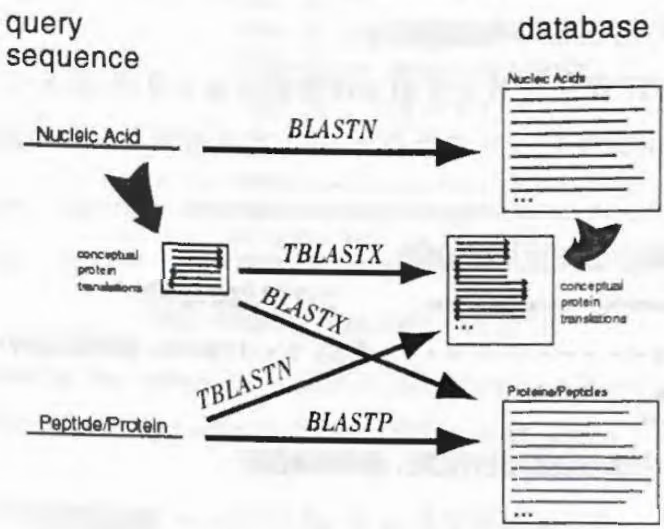
BLAST工具有多种程序,用于不同的序列比对目的(图5-1),如BLASTN是用核酸序列搜索核酸数据库,而BLASTP是用蛋白质序列搜索蛋白质库。常用的BLAST工具有五种可能的序列比对方式:
(1) BLASTN(nucleotide BLAST): 核酸序列与核酸库做比对, 直接比较核酸序列的相似性。数据库中存在的每条序列都将同查询序列进行一对一的核酸序列比对。
(2) BLASTP(protein BLAST): 蛋白质序列与蛋白质库做比对, 直接比对蛋白序列的相似性。数据库中存在的每条序列都将同查询序列进行一对一的蛋白质序列比对。
(3) BLASTX: 核酸序列与蛋白质库做比对, 先将核酸序列翻译成蛋白质序列 (一条核酸序列会被翻译成可能的 6 条蛋白质序列), 再对翻译成的每一条序列做一对一的蛋白质序列比对。
(4) TBLASTN: 蛋白质序列与核酸库做比对, 先将核酸库中的核酸翻译成蛋白质序列, 然后进行比对。
(5) TBLASTX: 核酸序列与核酸库做比对, 查询核酸序列与核酸库中的核酸序列都先按六种阅读框翻译成蛋白质序列, 然后对蛋白质序列进行比对。每次比对会产生 36 种比对阵列, 是最耗时的一种比对方法。
通常根据查询序列的类型(核酸或蛋白质)来决定选用何种 BLAST 工具。例如进行核酸与核酸库检索, 可选择 BLASTN 或 TBLASTX。
5.1 BLAST算法
BLAST算法是由S. Altschul等人在1990年提出的一种双序列局部比对算法,采用一种短片段匹配算法和一种有效的统计模型来找出查询序列和数据库序列之间的最佳局部比对结果。它在保持较高精确度的情况下,可以大大减少程序运行的时间,是大规模序列对比在速度和精确度上都可以接受的一个解决方法。
下面我们以 BLASTP 算法为例介绍 BLAST 搜索的基本原理(图 5-2)。BLASTP 算法利用 PAM 或 BLOSUM 矩阵对无空位比对进行打分,并以此来搜索数据库中匹配的蛋白质序列。
① 查询序列分为不同的words列表
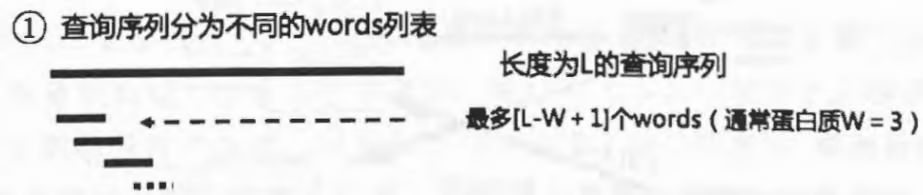
② Words列表与数据库进行比较,确保精确匹配
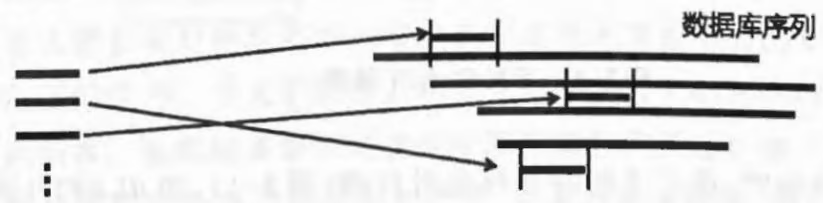
③ 从每个匹配的word的两端进行延伸,直到局部比对得分低于给定的阈值S
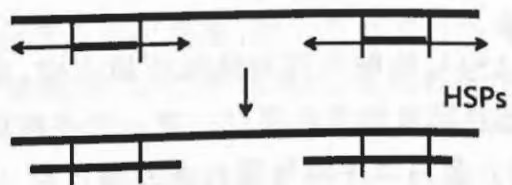
BLAST算法过程可简单描述为:
(1)首先将查询序列(query)打断成一个个单词(word),或说是定长的子序列(BLASTP默认长度为3aa)。
查询序列的所有 words 可通过在查询序列上移动与 words 等长的窗口来得到, 如一个蛋白质查询序列 AILVPTV 可得到 5 个不同的 words(长度为 3aa): AIL, ILV, LVP, VPT, PTV。
对于那些序列复杂度低(如重复序列)的 words, 或由常见氨基酸组成的 words, 由于信息含量少, 可将它从 words 列表中直接去除, 以提高搜索速度和降低假阳性。
(2)然后在数据库序列中搜索余下 words 的匹配 (matches)。
BLAST为提高灵敏度(sensitivity)也考虑序列相似性高的邻里词(neighborhood words)。如图5-3所示,根据打分矩阵为word所有字母对打分,并指定一个阈值T,留下高于T的word匹配对,作为后面延伸(extend)的种子(seed)。
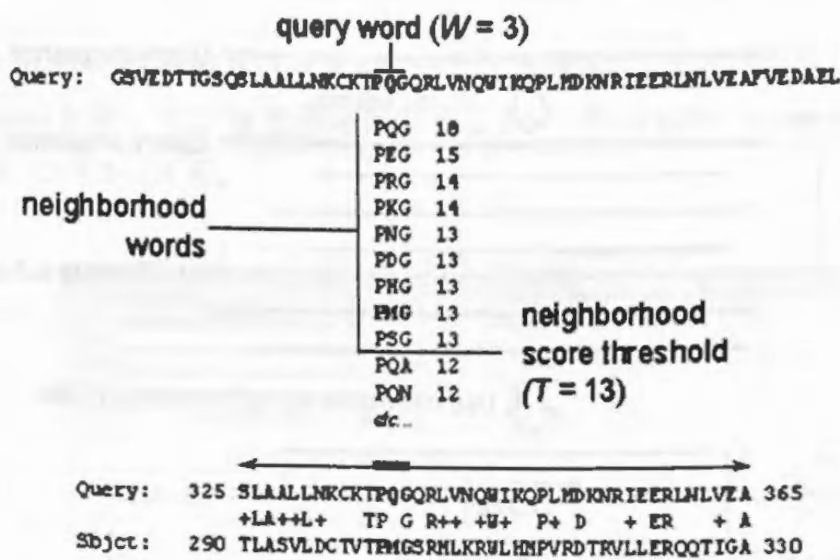
High-scoring Segment Pair (HSP)
图5-3 Increasing the sensitivity in BLAST by considering word neighbours(引自 https://www.ncbi.nlm.nih.gov/books/NBK62051/bin/blast\_glossary-Image001.jpg)
(3)每当从数据库中找出一个word的匹配,就从该单词两端进行延伸匹配,并根据打分矩阵重新计算得分,直到比对得分低于给定的阈值(S)为止。延伸阈值是一个很重要的搜索参数,因为它决定了结果序列与查询序列在生物学意义上的同源性有多大。
(4) 最后, 此延伸匹配被回切到序列比对的最高分 (>阈值 S) 部分, 这部分匹配简称高分对 (high-scoring segment pair, HSP)。最后 BLAST 返回结果是 HSP 的序列比对及其比对分值。
为了提高分析速度,标准 BLAST 牺牲了一定的准确度,牺牲掉的准确度对高度相似的序列,也就是亲缘关系近的序列不会构成威胁,不会把它们落掉,但是对于那些只有一点点相似,也就是远源的序列,就很可能被落掉,从而不能被 BLAST 发现。
5.1.1 PSI-BLAST算法
为解决 BLAST 不能发现序列差异比较大的远源序列这个问题,后来又开发了 PSI-BLAST 算法。PSI 是 position specific iterated(位点特异性迭代)的简写。PSI-BLAST 把序列搜索的结果归纳入一个位置特异性打分矩阵(position specific matrix, PSSM)中,有助于蛋白质的结构建模及功能的预测。
PSI-BLAST的算法是搜完一遍再继续搜索一遍,且从第二次搜索开始,每次搜索前都利用上一次搜索到的结果创建一个位置特异权重矩阵以扩大本次搜索的范围,如此反复直至没有新的结果产生为止(图5-4)。即前面的搜索结果出来后会作为查询序列进行再次搜索,除了考虑序列信息还考虑到序列的保守性信息,适合查找关系较远的同源序列。如现在著名的基因编辑技术CRISPR/CAS9中的CAS9家族蛋白就是通过这个方式发现的。
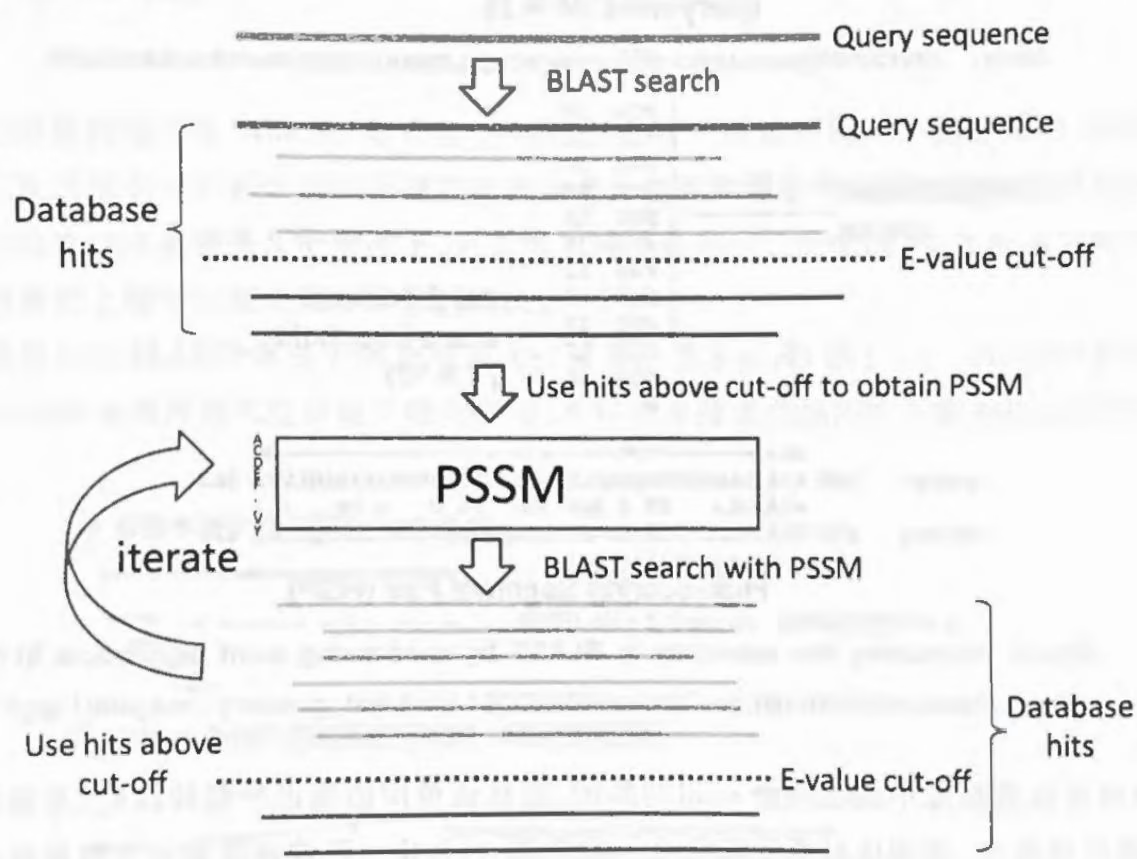
5.2 NCBI网站BLAST搜索
假设医生从被细菌感染的病人中分离培养出细菌,并提取了样品DNA。经测序后得到细菌的DNA序列,细菌来源DNA序列保存在文件whatami.fasta。若希望能确定这个DNA来源于什么病原体,可以使用NCBI的在线BLAST搜索数据库中的细菌同源序列,确定细菌的物种分类。
5.2.1 网络 BLAST 操作过程
(1)用浏览器打开NCBI BLAST主页(图5-5)。
(2)选择 BLAST 类型:你可以看到 BLAST 有许多程序,主要程序是核苷酸(nucleotide)与蛋白质(protein)比较。由于这里所用的序列是 DNA,所以选择“nucleotide BLAST”,进入 BLASTN 页面,如图 5-6 所示。
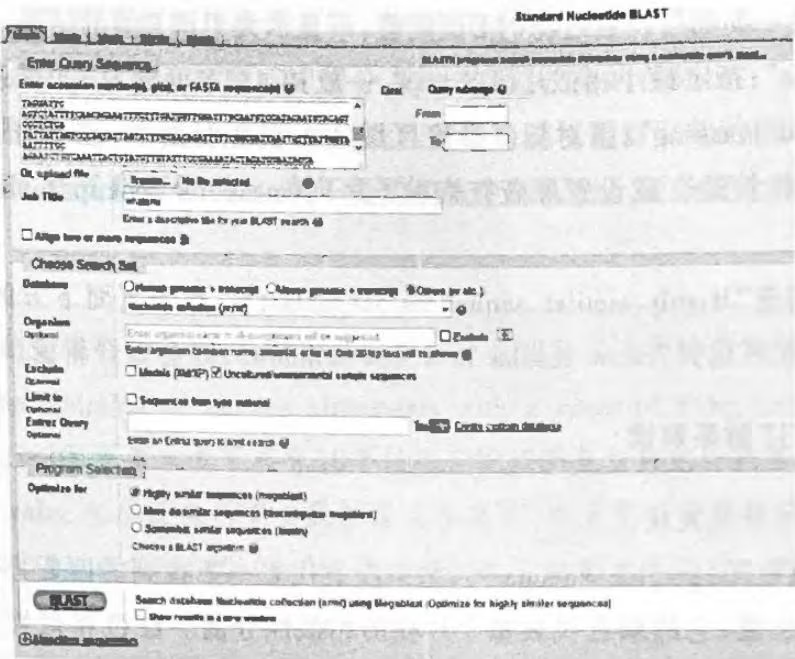
(3)输入序列:将 FASTA 格式的序列复制粘贴到序列输入框(enter query sequence),也可以通过点击浏览按钮(Browse…)上传序列文件。给这次 BLAST 任务写个标注(job title),如“whatami”。如果只需要比较两个序列的相似性,可以在上图的 BLASTN 初始页面勾选“Align two or more sequences”,就可分别输入序列进行比较。
(4)数据库选择:在“Choose Search Set”部分可以指定搜索的序列。默认的数据库是Nucleotide collection(nr/nt),这是GenBank的非冗余序列(“nonredundant”,nr)数据库,还有蛋白质数据库(nr/protein)。点击旁边的图标(⑨)可以查看数据库的更详细介绍。
如果我已经知道查询序列可能来自什么物种,可以在“Organism”输入框中设置特定的物种名或分类,如输入bacteria可以只查数据库中细菌的序列。
另外, GenBank 的序列许多来自未培养环境样品的 DNA, 这些序列对我们查找序列的来源物种没有帮助, 因此勾选“Exclude”中的“Uncultured/environmental sample sequences”, 将它们排除。
(5)程序选择:在“Program Selection”选择BLAST搜索程序,如“Highly similar sequences (megablast)”或“Somewhat similar sequences (blastn)”。Megablast适合相似度较高的序列(大于95%一致性)之间的比对,速度非常快;“Discontiguous megablast”会忽略一些比对不一致的情况;BLASTN算法运算最慢,但可以对相似度低的序列进行比对。
(6)程序参数:如果把底部的“Algorithm parameters”点开,你可以看到选不同的BLAST程序,它们的算法参数也会不一样,如megablast的WORD SIZE默认值是28,而BLASTN是11。其他如打分参数(scoreng parameters)等也会不一样,一般我们用它们的默认值就可以。
- “Max target sequences”: 指定显示的最大结果数。
- “Expect threshold”: 设置过滤的 E 值阈值, 不显示大于该 E 值的结果。
- “Word size”: 指定最小相似片段的长度, 一般 BLASTN 可设为 7 个碱基。
- “Filter and masking”: 指对低复杂度区域(low complexity regions)的序列进行过滤,使其不参与显著性检验。或设置屏蔽查询种子序列(mask for lookup table only)只用于扫描数据库。
(7)这里我们选“Highly similar sequences(megablast)”,点击页面下方的“BLAST”按钮,就可进行搜索。如果选择“Show results in a new window”,则会打开新窗口显示比对结果。
5.2.2 BLAST结果解读
BLAST结果可分三大块:
(1)顶部是总览图(graphic summary),每条线条代表一条找到的匹配序列,线条的长度代表匹配片段的长度,它的颜色代表每个片段的相似性分值。红色相似性最高,排在最前面,其他几种颜色相似性逐渐降低,黑色最低。鼠标单击哪条线条就会显示其代表的序列信息,比对分值等。单击其中的“Alignment”链接就可以显示序列比对的详细信息(图5-7)。
(2) 中间的序列比对结果描述(descriptions)部分,每一条比对结果都有序列的描述与其GenBank登录号(accession)。点击登录号可以显示序列比对的详细信息。另外有五个与序列匹配质量有关的参数:
- “Max score”: 最佳匹配片段的分数, 匹配片段越长、相似性越高, 则 Score 值越大 (注意 BLAST 是局部比对, 不是全局比对, 会有多个匹配片段)
- “Total score”: 所有匹配片段的总分。如果只有一个匹配, 总分等于最大分数。
- “Query coverage”: 查询序列匹配部分占其自身总长度的百分比。
- “E value”: 它是一个统计度量, 估计此匹配是由随机配对引起的概率。E 值越低说明两条序列匹配越可能是同源性引起, 而不是随机发生的配对。两条完全相同的序列配对, E 值就是 0。
E value 指在随机情况下,获得比当前比对分数相等或更高分数的可能比对序列条数 (the expected number of chance alignments with a score of S or better)。如果一个比对的 E value=10,就意味着可能有 10 个随机匹配获得与当前比对相等或更高的分数。
注意: E value 大小还与所查询数据库大小有关, 由于现在核酸数据库序列都比较多, 一般要求 E value < 0.00001( $1e^{-5}$ ), 即查询到的匹配有十万分之一的概率可能是错误的。
- “Identity”: 查询序列与目标序列匹配部分的相似度, 即匹配上的碱基数占序列总长的百分数。
通过查看前面几个匹配最好的序列描述,确定该查询序列可能来自什么物种(图5-8)。
注:为一种病毒 Mimivirus。
(3)第三部分是序列比对的详细信息(图5-9)。查询序列与数据库中匹配序列垂直对应,相同碱基用竖线(“|”),空位用横线(“-”)表示。由于序列比对较长,鼠标移动不方便,可以通过右上角的“Descriptions”链接快速回到中间的描述部分。
通过查看目标序列与查询序列匹配部分的起始与结束位置,记录前后位置区间为597667—605113,再打开目标序列的AP017645.1的GenBank格式网页,在右上角的“Change region shown”输入此前后位置,点击“Update view”按钮,就可以查看有几个hypothetical protein在这个区间。
“Expect”(E值)、“Identities”(一致性百分数)、“Gaps”(空位数)三项是评价blast结果的指标。E值接近零或者为零时,说明接近完全匹配。
在每个 BLAST 结果页面的顶部,都有一个 RID(request ID),可以在 24 小时再次查看结果,而不用再次做相同的 BLAST 搜索。把 RID 复制粘贴到记事本,下次查看结果时,打开 BLAST 网页主页,打开右上角“Recent Results”,把 RID 的编号输入“Request ID”查询即可。如果要本地保存 BLAST 结果,可以通过结果页面顶部的“Download”链接,选择一种格式(如 text),下载到本地文件夹。
5.3 本地BLAST
NCBI还提供BLAST本地运行程序,方便用户进行本地大型序列数据库的比对搜索。当一个新物种的基因组刚测序,NCBI网络数据库还没有收录这个物种的基因组数据,如果要在这个基因组中搜寻一个基因,就只能在本地进行BLAST了。
2009年, NCBI推出了新版本的独立BLAST程序BLAST+代替原来的BLAST程序。新版本有许多改进, 可以加快搜索速度。这里以一个实例来介绍本地BLAST+的安装与使用方法。
关于本地 BLAST 的更多内容, 可扫描章末二维码查看。
假如实验室刚对一个未知细菌进行基因组测序,得到一个不完全组装的序列(LX-4_contigs.fa),现在想知道此基因组中是否存在一个gyrB基因,需要把基因序列(文件gyrB.fa)与基因组序列文件LX-4_contigs.fa进行比对。
本例练习前,先把两个文件放在同一个目录下,如在电脑C盘下新建一个test目录,对应WSL下目录为“/mnt/c/test/”,打开WSL终端,并切换此目录为当前目录:$cd /mnt/c/test/。
5.3.1 在 WSL 下安装 BLAST
1 | \$sudo apt-get install ncbi-blast+ |
如果正确显示 BLAST 版本, 安装成功。
5.3.2 格式化数据库
BLAST程序需要有特定格式的数据库才能进行搜索,所以执行 BLAST 程序前要先用 makeblastdb 命令格式化目标(subject)序列文件。
1 | \$makeblastdb -in db.fasta -dbtype nucl -out dbname -parse_seqids |
参数说明:
-in: 待格式化序列的输入文件(FASTA格式)。
-dbtype: 数据库序列类型, prot(蛋白质)或 nucl(核酸)。
-out: 数据库名。
-parse_seqids: 参数可选, 表示从输入 FASTA 格式中解析序列标识符 (SeqIds)。
本例中执行以下命令:
1 | \$makeblastdb -in LX-4_contigs.fa -dbtype nucl -out LXcontigs -parse_seqids |
Makeblastdb运行后将会产生如下几个文件:
1 | LXcontigs.nhr LXcontigs.nin LXcontigs.nog LXcontigs.nsd LXcontigs.nsi LXcontigs. |
注意,格式化后产生的文件必须与输入的查询序列文件放在同一目录下。
5.3.3 运行BLAST比对程序
这里以核酸序列比对核酸数据库(BLASTN)为例:
1 | \$blastn -task blastn -query seq.fasta -out seq.blast -db dbname -outfmt 6 -evalue 1e-5 -num_threads 4 |
参数说明:
-task: 共五个程序选择 ‘blastn’ ‘blastn-short’ ‘dcmegablast’ ‘megablast’ ‘rmblastn’, 默认 megablast。
-query: 输入文件的路径及文件名。
-out: 输出文件的路径及文件名。
-db:格式化后得到的数据库路径及数据库名。
-outfmt: 输出文件格式, 总共有 18 种格式, 0 是默认比对格式, 6 是 TABULAR 格式, 17 是 SAM 格式。
-evalue: 设置输出结果的 e-value 值。
1 | -num_threads: 使用的线程数。 |
其他 BLAST 程序用法与 BLASTN 类似, 如蛋白序列比对蛋白数据库 (BLASTP) 以及核酸序列比对蛋白数据库 (BLASTX) 等。
本例中执行以下命令:
1 | \$blastn -query gyrB.fa -out gyrB_blast.txt -db LXcontigs -outfmt 6 -evalue 1e-5 -num_threads 4 |
最后查看 BLAST 比对结果:
1 | \$more gyrB_blast.txt |
结果中从左到右每一列的意义分别是:
- Query id: 查询序列标识符,如“gb|CP000422.1|:4284-6230”。
- Subject id: 数据库中比对的目标序列标识符, 如“LX-4_contig1”。
- % identity: 查询序列与目标序列比对的一致性(%),如“99.28”。
- alignment length: 查询序列与目标序列比对上的片段长度, 如“1947”。
- mismatches: 查询序列与目标序列比对错误的计数, 如“14”。
- gap openings: 空位数, 如“0”。
• q. start: 查询序列比对起始位点, 如“1”。
• q. end: 查询序列比对终止位点, 如“1947”。
- s. start: 目标序列比对起始位点, 如“148455”。
- s. end: 目标序列比对终止位点, 如“150401”。
- e-value: E value 值, 如“0.0”。
- bit score: 序列匹配得分, 如“3518”。
或在 Windows 资源管理器中,用文本编辑器 Notepad2 打开查看。你可以再尝试用不同的参数,如 outfmt 用 0(或不加此参数,即默认值为 0),8,17 等不同输出格式再查看运行结果的差异。
习题
简述 gap 空位、E value、bit score 这些序列比对参数的含义。
通过blast搜索人胰岛素的同源基因,下载它们的编码序列(CDS),并保存为FASTA格式文件。
在 NCBI 下载微生物的 16S rRNA 全部序列, 建立一个本地数据库, 再任选一条 16S rRNA 基因序列进行本地 BLASTN 比对, 并使用不同的 E value 值 (如 $1e^{-2}, 1e^{-5}, 1e^{-8}$ ) 和 outfmt 值 (如 0,5,6) 看看所得结果的差别。