遗传分析:从数量性状到基因表达
编者导语
本板块处理「从表型反推基因」这一整件事:单基因性状讲完之后,真实的农艺性状 ——产量、抗病性、身高——都由许多基因共同贡献,于是有了多基因假说、遗传力估计 与数量性状基因座(QTL)的定位方法;再往后是基因在什么层面被调控, 以及突变如何在肿瘤中累积。板块末尾并入了 BSA-seq 的方法学论文, 因为它就是 QTL 思想的高通量实现——同一件事在实验规模变大后的样子。 本板块是全书案例最密集的部分之一(21 处可提取的例题与案例), 适合边读边算。统计口径请配合 ch24,算法背景配合 ch22。
前置:ch01。
警告
本章有 11 处原书公式或表格在 MinerU 转换中损坏,已降级为代码块保留残片。这些残片不可直接引用
(其中的系数、矩阵与表达式请回查原书对应页码)。
编者注·本板块导读
图 155 张 案例 21 处 行间公式 45 个。以下清单由正文自动扫出,均为原书内容,未新增。
图(前 8 张;其余见本板块正文)
- 图 9-1 两对基因的独立分离, 不完全显性现象的理论模型 —— ch07
- 图9-2 不同穗长度玉米品系的杂交结果 —— ch07
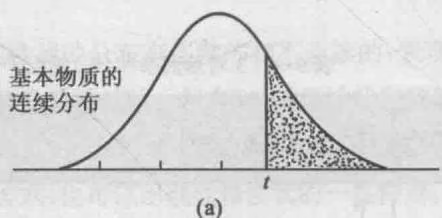
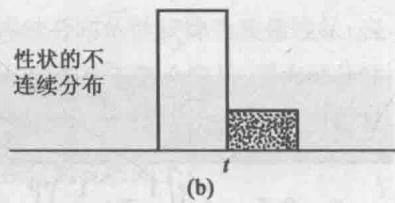
- 图 9-3 有些多基因控制的性状, 在外观上表现为质量性状, 但其基本物质或原因物质可能是连续分布的, —— ch07
- 图9-5 同胞兄妹交配所生仔畜中一个基因座上纯合的可能性 —— ch07
- 图 9-7 经过不同类型的近交, 纯合子的百分比在世代中改变的情况 —— ch07
- 图 9-10 玉米双交种的制种过程 —— ch07
- 图 10-1 染色体结构变异的类型 —— ch07
- 图 10-3 黑腹果蝇唾腺染色体的显微照片 —— ch07
- ……其余 147 张见本板块正文
案例(前 6 处)
公式:本板块含 45 个行间公式,均为原书公式,未改写。若你看到代码块形式的残片,说明该处公式在 OCR 中损坏、已降级,请回查原书对应页码。
本板块由以下原始章节合并而成:ch07、ch08、ch33。
第九章数量性状遗传
前几章中所讲的性状差异,大多是明显的不连续差异。例如水稻的粳与糯、鸡羽的芦花斑纹和非芦花斑纹,这类性状在表面上都显示质的差别,所以叫作质量性状(qualitative character)。质量性状的遗传可以比较容易地由分离定律、自由组合定律和连锁定律来分析。
除质量性状外,还广泛地存在着另一类性状差异,这些性状的变异呈连续状态,界限不清楚,不易分类,这类性状叫作数量性状(quantitative character)。动、植物的许多重要经济性状往往都是数量性状,如作物的产量、成熟期,奶牛的泌乳量,棉花的纤维长度、细度等,都属于数量性状。
质量性状的区别可以用文字描述,而数量性状的差异要用数字表示,如水稻种子的千粒重,不能明显地划分为“重”和“轻”两类。如果它们的千粒重在25 g到35 g之间,可以有26 g,27.5 g,27.6 g……很难分类。
数量性状的遗传似乎不能直接用孟德尔定律来分析,但在1909年,尼尔松埃勒(Herman Nilsson-Ehle,1873—1949)就指出,这类性状的遗传在本质上仍与孟德尔式的遗传一样,可以用多基因理论来解释。
第一节 数量性状的遗传学分析
一、数量性状的多基因假说
依据多基因假说(multiple gene hypothesis), 每一个数量性状是由许多基因共同作用的结果, 其中每一个基因的单独作用较小, 与环境影响所造成的差异差不多, 因此, 各种基因型所表现的表型差异就成为连续的数量变异了。
例如玉米穗长度这一数量性状,我们假定它是由两对基因共同控制的,一对是A和a,一对是B和b。又假定A对a来讲,使玉米穗长度增加,而且是不完全显性。AA植株的玉米穗最长,aa最短,Aa恰好是两者的平均。B对b的作用也一样,而且A和B的作用在程度上也一样。又A和B不连锁,独立分离。假定两个亲本,一个是AABB,平均玉米穗最长;一个是aabb,平均玉米穗最短。杂交得到 $F_{1}$ 是AaBb,平均玉米穗长度在两个亲本之间。 $F_{1}$ 自交得 $F_{2}$ ,它的基因型和表型如图9-1。
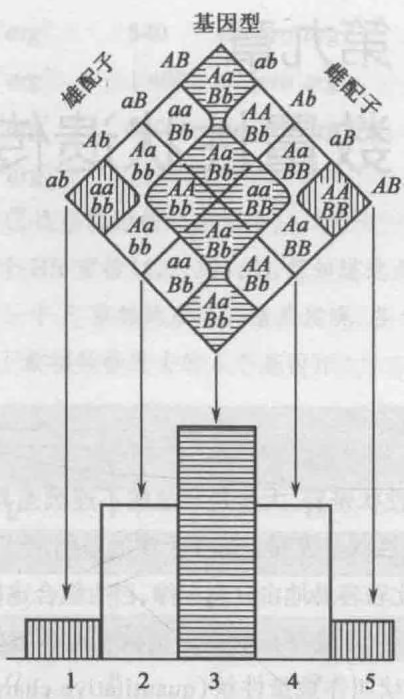
A 和 B 的作用相等而且相加, 表型按大写字母的数目可分为 5 类 (1、2、3、4、5)。
从图 9-1 可见, 因为 A 和 B 的作用相等而且可相加, 所以 $F_{2}$ 的表型决定于基因型中大写字母的数目, 可分 5 类:
① 一个大写字母也没有(aabb),占1/16,其表型应该与玉米穗短的亲代植株一样;
② 一个大写字母(Aabb 和 aaBb),占 4/16;
③ 两个大写字母(AAbb, aaBB 和 AaBb), 占 6/16, 其表型应与 $F_{1}$ 植株一样, 即两个亲本的平均;
④ 三个大写字母(AABb 和 AaBB),占 4/16;
⑤ 四个大写字母(AABB)占1/16,其表型应与玉米穗长的亲本一样。
所以,如果 $F_{2}$ 植株的确可以清清楚楚分成这 5 类,其比例应为 1:4:6:4:1。
如果基因的数目不止两对,而且邻近两类基因型之间的差异与环境所造成的差异差不多大小,那么 $F_{2}$ 植株就不能清清楚楚分成 5 类。玉米穗的长度,从最短到最长呈连续分布,形似钟形,其中最短的很少,最长的也很少,两头少,中间多。总的平均数在中间,与 $F_{1}$ 的平均数相等。
$F_{1}$ 植株虽然基因型彼此全都相同(都是 AaBb),但由于环境的影响,也存在一些表型差异,玉米穗的长度也是连续变异的,两头少、中间多。但 $F_{2}$ 与 $F_{1}$ 不同,除了环境影响之外,还有基因型差异,所以虽然 $F_{2}$ 的平均数与 $F_{1}$ 一样,并且也是两头少,中间多,但总的变异范围要比 $F_{1}$ 大。
现在看看这个简单化的模型与实际实验结果符合的程度如何。有这样两个玉米品系,一个玉米品系的穗是短的,长5~8 cm;另一玉米品系的穗是长的,长13~21 cm。将它们作为亲本,两亲本品系中各种长度的玉米穗分布情况,以及 $F_{1}$ 、 $F_{2}$ 的各种长度的玉米穗分布情况如表9-1。
| 玉米穗长度/cm | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 亲本短穗品系数量 | 4 | 21 | 24 | 8 | |||||||||||||
| 亲本长穗品系数量 | 3 | 11 | 12 | 15 | 26 | 15 | 10 | 7 | 2 | ||||||||
| $F_1$ 数量 | 1 | 12 | 12 | 14 | 17 | 9 | 4 | ||||||||||
| $F_2$ 数量 | 1 | 10 | 19 | 26 | 47 | 73 | 68 | 68 | 39 | 25 | 15 | 9 | 1 |
表中数字是玉米穗数目,例如,测量了57个亲本短穗玉米的玉米穗,其中4个是5 cm,21个是6 cm(这里的5 cm是指4.50~5.49 cm,6 cm是指5.50~6.49 cm,其余类推)。
用图 9-2 表示这个实验的结果。实验结果符合我们的预期:两个亲本品系和 $F_{1}$ 的变异范围都比较小, $F_{1}$ 的平均数在两个亲本平均数的中间; $F_{2}$ 的平均数差不多与 $F_{1}$ 的平均数一样,但变异范围大得多,最短的与短穗玉米亲本近似,最长的与长穗玉米亲本相近。
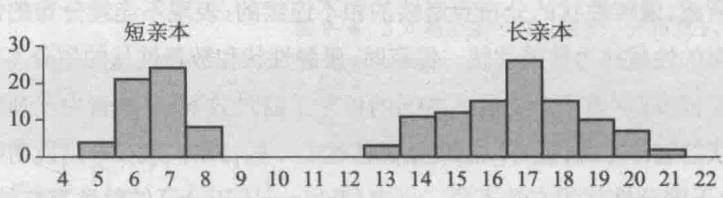
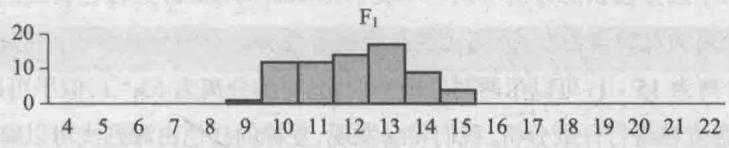
横坐标是穗长,单位 cm;纵坐标是玉米植株数。
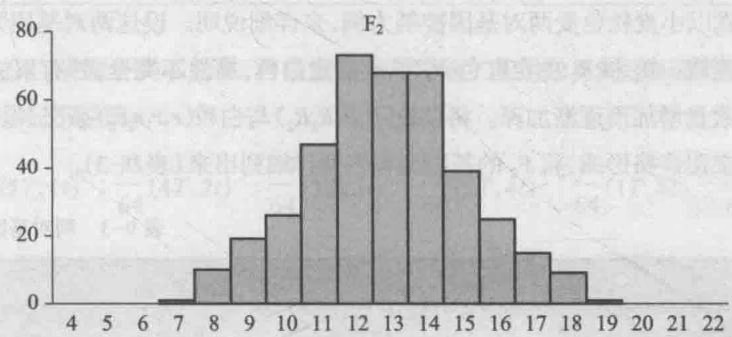
数量性状的遗传实验结果大都如此。许多数量性状是由多基因控制的,每个基因间的相互作用在数量方面的表现,可以是相加的,可以是相乘的,也可能有更复杂的相互作用形式。
“多基因”既然很多,单个染色体上则可能有多个,那么必然有一部分“多基因”与某一普通基因的显隐性现象成为连锁。事实的确如此。有一种菜豆(Phaseolus vulgaris),种皮紫色的种子较大,种皮白色的种子较小。杂交后,在 $F_{2}$ 中,紫色比白色为3:1, $F_{2}$ 紫色个体自交得 $F_{3}$ ,其中1/3不分离,2/3作3:1的分离。所以知道紫色和白色是由一对基因控制的,孟德尔的单因子分析方法适用。PP(紫色纯合子):Pp(紫色杂合子):pp(白色纯合子)为1:2:1。但菜豆的种子大小呈连续变异,其遗传情况符合多基因理论。将 $F_{2}$ 植株按PP、Pp和pp分成3类,结果发现在这3类中,每一类的种子平均大小也是不同的,如表9-2。可见控制种子质量的多基因中,
有一部分与控制种皮颜色的 P 和 p 基因连锁。
表 9-2 菜豆种子质量的遗传与种皮颜色基因型的关系
| $F_{2}$ 植株数目 | 种皮颜色基因型 | 种子平均质量/g |
|---|---|---|
| 45 | PP(紫色) | 0.307 |
| 80 | Pp(紫色) | 0.283 |
| 41 | pp(白色) | 0.264 |
这一类实验证明,控制数量性状的多基因也均位于染色体上,它们的传递法则(如分离、连锁等)也与遵循孟德尔遗传的基因是相同的。
二、数量性状与质量性状的关系
如前所述,遗传性状的分布有连续的和不连续的:表现不连续分布的性状称为质量性状;表现连续分布的性状称为数量性状。但有时,质量性状和数量性状的划分不那么容易,因为区分性状的方法不同,或者用于杂交的亲本间的相差基因对数不同,或者由于观察层次的不同,可以显示质量性状的遗传方式,也可以出现数量性状的一些特点。现在分别说明如下:
(1)由于区分性状的方法不同 小麦(Triticum vulgare)的粒色有红的和白的。红粒与白粒杂交, $F_{2}$ 分离为红粒与白粒,分离比随杂交组合而异。有的分离为 3:1,这显然是一对基因决定的;有的分离为 15:1,可以用两对基因来说明;有的分离为 63:1,似乎可以用 3 对基因来解释。但如对红色麦粒进行仔细分析,我们将会发现,麦粒的红色由深到浅可以有各种不同程度。
现在就以小麦粒色受两对基因控制为例,来详细说明。设这两对基因为 $R_{1}$ 和 $r_1, R_2$ 和 $r_2$ ,它们相互不连锁。 $R_{1}$ 和 $R_{2}$ 决定红色, $r_1$ 和 $r_2$ 决定白色,显性不完全,并有累加效应,所以麦粒的颜色随 $R$ 的数量增加而逐渐加深。将红粒 $(R_{1}R_{1}R_{2}R_{2})$ 与白粒 $(r_{1}r_{1}r_{2}r_{2})$ 杂交,得 $\mathrm{F}{1}(R{1}r_{1}R_{2}r_{2}), \mathrm{F}{1}$ 自交,得 $\mathrm{F}{2}$ 。现在用表格形式,将 $\mathrm{F}_{2}$ 的基因型和表型详细列出来(表9-3)。
表 9-3 两对基因决定的小麦粒色的遗传
| 基因型 | $1R_{1}R_{1}r_{2}r_{2}$ | ||||
| $2R_{1}R_{1}R_{2}r_{2}$ | $4R_{1}r_{1}R_{2}r_{2}$ | $2R_{1}r_{1}r_{2}r_{2}$ | |||
| $1R_{1}R_{1}R_{2}R_{2}$ | $2R_{1}r_{1}R_{2}R_{2}$ | $1r_{1}r_{1}R_{2}R_{2}$ | $2r_{1}r_{1}R_{2}r_{2}$ | ||
| 基因型比例 | 1 | 4 | 6 | 4 | |
| 显性基因数 | 4 | 3 | 2 | 1 | |
| 表型比例 | 细分 | 1深红 | 4中红 | 6浅红 | 4淡红 |
| 粗分 | 15红 | 1白 | |||
从表 9-3 可以清楚地看到, 如麦粒颜色分为红色和白色两种, 可以看作是质量性状; 如将红色麦粒再加细分, 从深红到淡红间有一系列变化, 就表现出数量性状的特点。所以如区分性状时, 采用非白即红的办法, 就表现为质量性状, 如采用定量的方法, 就表现为数量性状。
(2) 由于用于杂交的亲本间相差基因对数的不同 植株的高矮,一般多表现为数量性状。但是有些品种间杂交,可以明显地分为高矮两类,中间没有连续性变化,完全可以看作是质量性状。孟德尔的豌豆杂交实验中,高植株和低植株就是界限分明的质量性状。水稻的高品种和矮品种杂交,大都表现为数量性状遗传,可是也有表现为质量性状遗传的。如有一种水稻突变型,称作“万年青”,植株很矮,与普通水稻品种杂交时, $F_{2}$ 分离为3高1矮,说明是一对基因决定的。
那么同样的一个性状,例如植株的高度,为什么有时表现为数量性状,有时表现为质量性状呢?
为简单起见,我们假定水稻植株的高矮由3对基因控制。高植株 $(T_{1}T_{1}T_{2}T_{2}T_{3}T_{3})$ 与矮植株 $(t_{1}t_{1}t_{2}t_{2}t_{3}t_{3})$ 杂交,得到 $F_{1},F_{1}$ 是3对基因杂合子 $(T_{1}t_{1}T_{2}t_{2}T_{3}t_{3})$ 。根据大写/小写基因的作用相等(即 $T_{1}=T_{2}=T_{3}=T,t_{1}=t_{2}=t_{3}=t$ )而且可以累加的假定, $F_{1}$ 配子的种类和比例是 $\left(\frac{1}{2}T+\frac{1}{2}t\right)^{3}$ 的展开,而 $F_{2}$ 的合子分布是 $\left(\frac{1}{2}T+\frac{1}{2}t\right)^{6}$ 的展开(表9-4)。
表 9-4 3 对基因杂种 $\left( {\mathrm{F}}{1}\right)$ 的配子分布及 ${\mathrm{F}}{2}$ 的合子分布
| $F_1$ 配子 | $\left( \frac{1}{2} T + \frac{1}{2} t \right)^3 = \left( \frac{1}{8} TTT + \frac{3}{8} TTt + \frac{3}{8} Ttt + \frac{1}{8} ttt \right)$ | ||||||
| $F_2$ 合子 | $\left[ \left( \frac{1}{2} T + \frac{1}{2} t \right)^3 \right]^2 = \left( \frac{1}{2} T + \frac{1}{2} t \right)^6$ | ||||||
| $F_2$ 表型 | TTTTTT | TTTTTt | TTTTtt | TTTttt | TTtttt | Tttttt | tttttt |
| $F_2$ 频率 | $\frac{1}{64}$ | $\frac{6}{64}$ | $\frac{15}{64}$ | $\frac{20}{64}$ | $\frac{15}{64}$ | $\frac{6}{64}$ | $\frac{1}{64}$ |
根据表9-4列出的 $F_{2}$ 表型种类和频率,再根据植株高度随T基因数目的递加而增高的假设,对植株的高度分布可作如下说明:
$$
\frac {1}{6 4} (6 T, 0 t): \frac {6}{6 4} (5 T, 1 t): \frac {1 5}{6 4} (4 T, 2 t): \frac {2 0}{6 4} (3 T, 3 t): \frac {1 5}{6 4} (2 T, 4 t): \frac {6}{6 4} (1 T, 5 t): \frac {1}{6 4} (0 T, 6 t)
$$
最高 很高 高 中等 矮 很矮 最矮
$F_{2}$ 这样的分布, 已接近连续分布, 再加上环境对基因作用的影响, 自然表现出数量性状的特点了。
但是,如果更换杂交亲本的品系,将高植株 $(T_{1}T_{1}T_{2}T_{2}T_{3}T_{3})$ 与矮植株 $(t_{1}t_{1}T_{2}T_{2}T_{3}T_{3})$ 杂交,两亲仅有一对基因的差别,实际上就是高植株 (T_{1}T_{1})\times 矮植株 $(t_{1}t_{1}),F_{2}$ 的分布应该是 $\left(\frac{1}{2}T+\frac{1}{2}t\right)^{2}=\frac{1}{4}(TT)+\frac{2}{4}(Tt)+\frac{1}{4}(tt)$ ,相对地说就表现为不连续变异,也就是说成为质量性状了。
所以虽然性状本身由多对基因决定,应表现为数量性状,但如果用于交配的双亲就这一性状而言只有一对基因的差别,就会表现为质量性状。
(3) 由于观察的层次不同 某些性状, 如单胎动物的每胎仔数, 一般为单胎, 少数为多胎; 又如某些哺乳动物的指(趾)数, 多数个体有正常数目的指(趾)数, 但少数个体出现多指(趾)。这些“全或无”性状看似质量性状,但根据遗传学分析,不能归于简单的孟德尔式遗传。通常这类性状的遗传既受多基因的作用,又受环境的影响。那么这又如何解释呢?
我们假定,性状的差异在外观上虽是不连续的,而导致性状差异的基本物质的分布是连续的,而且还假定,在这连续分布上有一界标——阈值。当有关基本物质低于此阈值时,个体具有一种表型,而当有关基本物质高于此阈值时,个体呈现另一表型(图9-3)。例如单胎动物的每胎仔数,可简单分为单胎和多胎,是不连续的,但其基本物质可能是引起超数排卵的激素水平,是连续分布的。当激素水平低于某一阈值时,每胎为一个胎儿,如激素水平超过某一阈值时,每胎仔数将会是两个或两个以上。又如动物的指(趾)数,多数个体有正常的指(趾)数,仅有少数个体出现多指(趾)。这个性状是非此即彼,是不连续的,而有关的基本物质可设想为一种形态建成物质,是连续分布的。当这种建成物质的水平低于某一阈值时,指(趾)数正常,如这物质的含量超过阈值,就出现多指(趾)。根据阈值模型(threshold model),我们可以这样理解,如基本物质的含量处于某一范围内,表型是正常的,如超过某一阈值,就出现畸形(当然也可反过来)。
(a)
| 年份 | 所选用的亲代种子平均质量/g | 所得子代种子平均质量/g | ||
| 轻的种子 | 重的种子 | 来自轻的种子 | 来自重的种子 | |
| 第一年 | 0.30 | 0.40 | 0.36 | 0.35 |
| 第二年 | 0.25 | 0.42 | 0.40 | 0.41 |
| 第三年 | 0.31 | 0.43 | 0.31 | 0.33 |
| 第四年 | 0.27 | 0.39 | 0.38 | 0.39 |
| 第五年 | 0.30 | 0.46 | 0.38 | 0.40 |
| 第六年 | 0.24 | 0.47 | 0.37 | 0.37 |
1 | \frac {4 \times 5 + 2 1 \times 6 + 2 4 \times 7 + 8 \times 8}{5 7} = 6. 6 3 |
1 | arrayr l (x - x) ^ 2 & = (x ^ 2 - 2 x x + x ^ 2) |
1 | h ^ {2} = \frac {V _ {\mathrm{G}}}{V _ {\mathrm{P}}} \times 100\% = \frac {V _ {\mathrm{G}}}{V _ {\mathrm{G}} + V _ {\mathrm{E}}} \times 100\% |
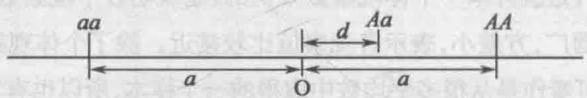
中间的 O 点是两亲本的中间值。杂合子 Aa 位于 O 点的右侧,距离为 d。
在这图中,偏差从O点算起,aa在O的左侧,偏差为-a,AA在O点的右侧,偏差为a,所以两个纯合亲本的中点是 $\frac{a+(-a)}{2}=0$ ,它们的距离是 $a-(-a)=2a$ 。
杂合子 $Aa$ 位于 O 点的右侧, 靠近 $AA$ 一边, 表示更像 $AA$ 一些。 $Aa$ 离开两亲中点的显性偏差用 $d$ 表示, 如 $d = 0$ , 没有显性, 遗传变异完全由于相加的效应; 如 $d = a$ , 完全显性。举个数字例子, 如 $AA, Aa, aa$ 的平均值是 20、17、10, 则 $a = 5, d = 2$ 。
现在来计算 $F_{2}$ 的方差(表9-6)。 $F_{2}$ 中,存在着 $\frac{1}{4}AA, \frac{1}{2}Aa, \frac{1}{4}aa; f$ 是各基因型子代出现的频率,频率的总和 $\sum f = 1; x$ 是观察值,在这里是各基因型的平均效应。 $F_{2}$ 的平均值是 $\bar{x} = \frac{1}{4}a + \frac{1}{2}d + \frac{1}{4}(-a) = \frac{1}{2}d$ 。 $F_{2}$ 的遗传方差是:
$$
\sum x ^ {2} - \frac {(\sum x) ^ {2}}{n} = \frac {1}{2} a ^ {2} + \frac {1}{2} d ^ {2} - \frac {1}{4} d ^ {2} = \frac {1}{2} a ^ {2} + \frac {1}{4} d ^ {2}
$$
表 9-6 ${\mathrm{F}}_{2}$ 平均值和遗传方差的计算
| $f$ | $x$ | $fx$ | $fx^{2}$ | |
|---|---|---|---|---|
| $AA$ | $\frac{1}{4}$ | $a$ | $\frac{1}{4}a$ | $\frac{1}{4}a^{2}$ |
| $Aa$ | $\frac{1}{2}$ | $d$ | $\frac{1}{2}d$ | $\frac{1}{2}d^{2}$ |
| $aa$ | $\frac{1}{4}$ | $-a$ | $-\frac{1}{4}a$ | $\frac{1}{4}a^{2}$ |
| 合计 | 1 | $\sum x=\frac{1}{2}d$ | $\sum x^{2}=\frac{1}{2}a^{2}+\frac{1}{2}d^{2}$ |
本例中已算出,a=5,d=2,所以 $F_{2}$ 的遗传方差是:
$$
V _ {\mathrm{G}} = \frac {1}{2} (5) ^ {2} + \frac {1}{4} (2) ^ {2} = 1 3. 5
$$
如果控制同一性状的有 A, a; B, b; $\cdots$ ; N, n 等多对基因,这些基因相互之间不连锁,没有相互作用,则 $F_{2}$ 的遗传方差应为:
$$
\frac {1}{2} a _ {a} ^ {2} + \frac {1}{2} a _ {b} ^ {2} + \dots + \frac {1}{2} a _ {n} ^ {2} + \frac {1}{4} d _ {a} ^ {2} + \frac {1}{4} d _ {b} ^ {2} + \dots + \frac {1}{4} d _ {n} ^ {2}
$$
现在设
$$
a _ {a} ^ {2} + a _ {b} ^ {2} + \dots + a _ {n} ^ {2} = V _ {\mathrm{A}} \quad d _ {a} ^ {2} + d _ {b} ^ {2} + \dots + d _ {n} ^ {2} = V _ {\mathrm{D}}
$$
这里, $V_{A}$ 是由基因的相加效应所产生的方差,即加性方差(additive variance)。 $V_{D}$ 是由基因在杂合态时的显性效应所产生的方差,即显性方差(dominance variance)。如果同时考虑到由环境影响所产生的环境方差 $V_{E}$ ,则 $F_{2}$ 的表型方差是:
$$
V _ {\mathrm{F} _ {2}} = \frac {1}{2} V _ {\mathrm{A}} + \frac {1}{4} V _ {\mathrm{D}} + V _ {\mathrm{E}}
$$
那么 $V_{E}$ 怎样求呢?因为两个亲本都是纯种,我们可以认为每个亲本的基因型都是一样的,遗传变异对表型的影响等于 0,所以表型变异完全来自环境变异。此外,因为两个亲本都是纯种,所得的 $F_{1}$ 杂合子的基因型也是一致的,所以同理, $F_{1}$ 的表型变异也完全来自环境变异。根据这些关系, $V_{E}$ 的计算可以根据实际情况,或依据两个亲本的表型方差 ( $V_{P_{1}}$ 和 $V_{P_{2}}$ ) 计算,或从两个亲本和 $F_{1}$ 的表型方差 ( $V_{F_{1}}$ ) 计算,即
1 | V _ {\mathrm{E}} = \frac {1}{2} (V _ {\mathrm{P} _ {1}} + V _ {\mathrm{P} _ {2}}) \text {或} V _ {\mathrm{E}} = \frac {1}{3} (V _ {\mathrm{P} _ {1}} + V _ {\mathrm{P} _ {2}} + V _ {\mathrm{F} _ {1}}) |
有了这些计算公式,我们就可以用实际例子进行运算了。
例如,仍用短穗玉米和长穗玉米的杂交材料,现在再一次把全部数据抄下来。并把平均数、标准误和方差附在后面,看怎样从这个资料来求遗传率。根据表9-7求得 $V_{P_{1}}=0.67,V_{P_{2}}=3.56,V_{F_{1}}=2.31,V_{F_{2}}=5.07$ 。按表9-8所列项目分别填入并计算,最后根据定义计算遗传率:
1 | h _ {\mathrm{B}} ^ {2} = \frac {V _ {\mathrm{G}}}{V _ {\mathrm{P}}} \times 100\% = \frac {\frac {1}{2} V _ {\mathrm{A}} + \frac {1}{4} V _ {\mathrm{D}}}{\frac {1}{2} V _ {\mathrm{A}} + \frac {1}{4} V _ {\mathrm{D}} + V _ {\mathrm{E}}} \times 100\% = \frac {V _ {\mathrm{F} _ {2}} - V _ {\mathrm{E}}}{V _ {\mathrm{F} _ {2}}} \times 100\% = \frac {5 . 0 7 - 2 . 1 8}{5 . 0 7} \times 100\% = 57\% |
这种计算求得的是广义遗传率(heritability in the broad sense), 所以在 $h^{2}$ 的下脚注以符号 B。
为什么叫作广义遗传率?因为在遗传方差中,包括了基因的相加效应的方差 $(V_{\mathrm{A}})$ 和基因的非相加效应或显性效应等的方差 $(V_{\mathrm{D}})$ 。但基因在杂合态时所表现的变异,只有一部分能遗传,那就是 $V_{A}$ 部分,另一部分在纯合态时就要消失,那就是 $V_{D}$ 部分,所以由基因的显性效应所表现的变异在选择上没有什么效果,只有相加效应那部分才是可靠的。在上面的公式中,把基因的相加效应的方差 $(V_{\mathrm{A}})$ 和基因的非相加效应的方差 $(V_{\mathrm{D}})$ 都算在一起,作为遗传方差,所以叫作广义遗传率。如只计算基因的相加效应的方差 $(V_{\mathrm{A}})$ 部分在总的表型方差中所占的比例,那就是狭义遗传率(heritability in the narrow sense),记作 $h_{N}^{2}$ 。
表 9-7 短穗玉米和长穗玉米的杂交及其后代穗长的分布情况
| 长度/cm\频率 | 亲(短) | 亲(长) | $F_1$ | $F_2$ |
|---|---|---|---|---|
| 5 | 4 | |||
| 6 | 21 | |||
| 7 | 24 | 1 | ||
| 8 | 8 | 10 | ||
| 9 | 1 | 19 | ||
| 10 | 12 | 26 | ||
| 11 | 12 | 47 | ||
| 12 | 14 | 73 | ||
| 13 | 3 | 17 | 68 | |
| 14 | 11 | 9 | 68 | |
| 15 | 12 | 4 | 39 | |
| 16 | 15 | 25 | ||
| 17 | 26 | 15 | ||
| 18 | 15 | 9 | ||
| 19 | 10 | 1 | ||
| 20 | 7 | |||
| 21 | 2 | |||
| n | 57 | 101 | 69 | 401 |
| $\overline{x}±s_{\overline{x}}$ | 6.63±0.11 | 16.80±0.19 | 12.12±0.18 | 12.89±0.11 |
| V | 0.67 | 3.56 | 2.31 | 5.07 |
表 9-8 方差成分的计算
| 项目 | 方差成分 | 方差的实验值 |
|---|---|---|
| V_{\text{F}_2} | $\frac{1}{2}V_A+\frac{1}{4}V_D+V_E$ | 5.07 |
| \frac{1}{3}(V_{\text{P}1}+V{\text{P}2}+V{\text{F}_1}) | $V_E$ | $\frac{1}{3}(0.67+3.56+2.31)=2.18$ |
要计算狭义遗传率,先要分别求出 $F_{1}$ 个体回交两个亲本后得到的子代个体的遗传方差。计算方法如下:设 $F_{1}$ 个体 Aa 回交 AA 亲本的子代个体为 $B_{1}$ , 则 $B_{1}$ 的遗传方差可按表 9-9 所示计算。
表 9-9 ${\mathrm{B}}_{1}$ 的平均数和遗传方差的计算
| $f$ | $x$ | $fx$ | $fx^{2}$ | |
|---|---|---|---|---|
| $AA$ | $\frac{1}{2}$ | $a$ | $\frac{1}{2}a$ | $\frac{1}{2}a^{2}$ |
| $Aa$ | $\frac{1}{2}$ | $d$ | $\frac{1}{2}d$ | $\frac{1}{2}d^{2}$ |
| 合计 | 1 | $\frac{1}{2}(a+d)$ | $\frac{1}{2}(a^{2}+d^{2})$ |
$Aa$ 回交 $AA, B_{1}$ 中有 $\frac{1}{2} AA, \frac{1}{2} Aa$ , 合计 $\sum f = 1$ 。 $B_{1}$ 的平均值是 $\overline{x} = \frac{1}{2}(a + d)$ 。 $B_{1}$ 的遗传方差是:
$$
\frac {1}{2} (a ^ {2} + d ^ {2}) - \frac {1}{4} (a + d) ^ {2} = \frac {1}{4} (a - d) ^ {2} = \frac {1}{4} (a ^ {2} - 2 a d + d ^ {2})
$$
$\mathbf{B}_1$ 的遗传方差有 $ad$ 的存在,表示 $a$ 和 $d$ 两个成分是不能分割的。
又设 $F_{1}$ 个体 Aa 回交 aa 亲本的子代个体为 $B_{2}$ ,则 $B_{2}$ 的遗传方差可按同样方式计算(表 9-10)。
表 9-10 ${\mathrm{B}}_{2}$ 的平均数和遗传方差的计算
| f | x | fx | $fx^2$ | |
|---|---|---|---|---|
| Aa | $\frac{1}{2}$ | d | $\frac{1}{2}d$ | $\frac{1}{2}d^2$ |
| aa | $\frac{1}{2}$ | -a | $-\frac{1}{2}a$ | $\frac{1}{2}a^2$ |
| 合计 | 1 | $\frac{1}{2}(d-a)$ | $\frac{1}{2}(a^2+d^2)$ |
$Aa$ 回交 $aa, \mathrm{B}_2$ 中有 $\frac{1}{2} Aa, \frac{1}{2} aa$ , 合计 $\sum f = 1$ 。 $\mathrm{B}_2$ 的平均值是 $x = \frac{1}{2}(d - a), \mathrm{B}_2$ 的遗传方差是:
$$
\frac {1}{2} (a ^ {2} + d ^ {2}) - \frac {1}{4} (d - a) ^ {2} = \frac {1}{4} (a + d) ^ {2} = \frac {1}{4} (a ^ {2} + 2 a d + d ^ {2})
$$
$\mathbf{B}_2$ 的遗传方差也有 $ad$ 的存在,可见 $a$ 和 $d$ 两个成分也不能分割。但是如果把 $\mathbf{B}_1$ 的遗传方差和 $\mathbf{B}_2$ 的遗传方差加在一起,求平均值,则得
$$
\frac {1}{2} \left[ \frac {1}{4} (a - d) ^ {2} + \frac {1}{4} (a + d) ^ {2} \right] = \frac {1}{4} (a ^ {2} + d ^ {2})
$$
现在 a 和 d 两个成分可用加法计算, 可以分割开来了。
假设控制同一性状的基因有很多对,这些基因相互不连锁,也没有相互作用,再考虑到环境对基因型的影响,则回交一代的平均表型方差可以写成
$$
\frac {1}{2} (V _ {\mathrm{B} _ {1}} + V _ {\mathrm{B} _ {2}}) = \frac {1}{4} V _ {\mathrm{A}} + \frac {1}{4} V _ {\mathrm{D}} + V _ {\mathrm{E}}
$$
现在就可利用下述公式来计算狭义遗传率了:
1 | h _ {\mathrm{N}} ^ {2} = \frac {\frac {1}{2} V _ {\mathrm{A}}}{V _ {\mathrm{P}}} \times 100\% = \frac {\frac {1}{2} V _ {\mathrm{A}}}{\frac {1}{2} V _ {\mathrm{A}} + \frac {1}{4} V _ {\mathrm{D}} + V _ {\mathrm{E}}} \times 100\% |
仍用一个例子来说明公式的运用。不过这次不再详细地把有关资料列出来,因为我们已知道了平均数和方差的算法,所以单把各有关项目的平均数和方差注明就可以了(表9-11)。
表 9-11 小麦抽穗期的遗传学分析
| 世代 | 平均抽穗日期(从某一选定日期开始) | 表型方差(实验值) |
|---|---|---|
| $P_1$ (早抽穗品种) | 13.0 | 11.04 |
| $P_2$ (晚抽穗品种) | 27.6 | 10.32 |
| F_1(P_1 \times P_2) | 18.5 | 5.24 |
| F_2(F_1 \times F_1) | 21.2 | 40.35 |
| B_1(F_1 \times P_1) | 15.6 | 17.35 |
| B_2(F_1 \times P_2) | 23.4 | 34.29 |
相加的遗传方差的计算方式如表9-12。
表 9-12 相加的遗传方差的求法
| 项目 | 方差成分 | 实验值 |
|---|---|---|
| 1 $V_{F_2}$ | $\frac{1}{2}V_A+\frac{1}{4}V_D+V_E$ | 40.35 |
| 2 $\frac{1}{2}(V_{B_1}+V_{B_2})$ | $\frac{1}{4}V_A+\frac{1}{4}V_D+V_E$ | $\frac{1}{2}(17.35+34.29)=25.82$ |
| 1-2 | $\frac{1}{4}V_A$ | 14.53 |
计算狭义遗传率时,要使分子和分母中 $V_{A}$ 的系数相同。把上述数值代入,得狭义遗传率
1 | h _ {\mathrm{N}} ^ {2} = \frac {\frac {1}{2} V _ {\mathrm{A}}}{\frac {1}{2} V _ {\mathrm{A}} + \frac {1}{4} V _ {\mathrm{D}} + V _ {\mathrm{E}}} \times 100 \% = \frac {2 \times (14.53)}{40.35} \times 100 \% = 72 \% |
可见小麦抽穗期的遗传率还是相当大的。
最后,还可利用上面求得的一些数据,求平均显性程度。根据定义,
$$
\mathrm{平均显性程度} = \frac {d}{a} = \sqrt {\frac {V _ {\mathrm{D}}}{V _ {\mathrm{A}}}}
$$
平均显性程度的具体计算方式如表9-13。
表 9-13 显性的遗传方差的求法
| 项目 | 方差成分 | 实验值 |
|---|---|---|
| 1 $V_{F_2}$ | $\frac{1}{2}V_A + \frac{1}{4}V_D + V_E$ | 40.35 |
| 2 $\frac{1}{3}(V_{P_1} + V_{P_2} + V_{F_1})$ | $V_E$ | $\frac{1}{3}(11.04 + 10.32 + 5.24) = 8.87$ |
| 3 | $\frac{1}{2}V_A$ | 2 \times 14.53 = 29.06 |
| 1-2-3 | $\frac{1}{4}V_D$ | 2.42 |
把数值代入公式,我们得
1 | \mathrm{平均显性程度} = \sqrt {\frac {V _ {\mathrm{D}}}{V _ {\mathrm{A}}}} = \sqrt {\frac {4 \times (2 . 4 2)}{2 \times (2 9 . 0 6)}} = 0. 4 1 |
显性虽然不完全,但明显的是存在的,因为 $F_{1}$ 的平均值(18.5)低于两亲的平均值 $\left[\frac{1}{2}(13.0+27.6)=20.3\right]$ 。表明早抽穗是不完全显性。
视频10遗传率的定义与计算
如果所有基因都没有显性,那么显性程度等于0;如显性完全,那么显性程度等于1;如有显性,但不完全,那么不管显性方向是正是负,都会得出不等于0的数值来。
估计遗传率的方法除上面介绍的几种以外,还有亲子相关、方差分析等方法,这儿不再详说了。现在列举人和几种经济动植物的生产性能的遗传率(表9-14)。
表 9-14 人和几种经济动植物的生产性能的遗传率
| 种类 | 性状 | 近似遗传率/% |
| 人 | 身高 | 50 |
| 出生时体重 | 50 | |
| 奶牛 | 一年泌乳量 | 30 |
| 乳脂率 | 50 | |
| 怀孕率 | 3 | |
| 猪 | 一胎仔数 | 20 |
| 六月龄时体重 | 30 | |
| 鸡 | 卵重 | 60 |
| 体重 | 31 | |
| 产卵数 | 30 | |
| 生存率 | 10 | |
| 孵化率 | 16 | |
| 水稻 | 株高 | 86 |
| 穗数 | 10 | |
| 小麦 | 粒重 | 10 |
| 穗长 | 60 | |
| 玉米 | 产量 | 20 |
| 株高 | 70 | |
| 穗的直径 | 70 | |
| 烟草 | 株高 | 59 |
| 叶数 | 65 |
从上表可以知道,随着性状的不同,遗传率的变化很大,有的性状的遗传率很高,如水稻的株高,高达86%,而有的性状的遗传率很低,如奶牛怀孕率,仅为3%。
遗传率怎样算高,怎样算低,没有统一标准。不过一般认为:高遗传率>50%;中遗传率=20%~50%;低遗传率<20%。
二、对遗传率的几点说明
遗传率是一个统计学概念,针对群体,而不适用于个体。例如人类身高的遗传率是50%,并不是说某一个体的身高一半由遗传控制,一半由环境决定。这只是说,在群体身高总变异中,50%与遗传差异有关,其余50%与环境因子的差异有关;或者说,群体中身高变异的50%是由遗传差异造成的。
因为遗传率是对特定群体而言的,是某一群体的遗传变异和环境变异在表型变异中所占的相对比例,所以如果遗传变异更改,或者环境变异更改,所得的遗传率自然也随之更改。因此,估算同一群体在两个不同环境中的遗传率,或者测定两个群体在同一环境中的遗传率,很可能得到不同的结果。
上面谈到过约翰森从大小不等的19粒菜豆,建立了19个株系,他称这些株系为纯系。一个纯系内的豆粒仍然参差不齐,例如在一个豆荚内由于豆粒所处的位置不同,豆粒大小相差悬殊,可是其平均粒重与亲代几乎没有差异,所以他认为纯系内豆粒变异是不遗传的 $(V_{\mathrm{G}}=0)$ ,在纯系内选择无效。一个纯系内豆粒的表型变异应该说纯粹是由环境差异引起的 $(V_{\mathrm{P}}=V_{\mathrm{E}})$ 。
一般地说,遗传率高的性状,选择较易;遗传率低的性状,选择难些,所以进行育种时,能够知道遗传率的大小是有帮助的。在育种时,如能运用杂交等方法,增加遗传变异,同时力求饲养方式和栽培条件等一致,使环境变异降低,这样遗传率增大,育种进度可以加快。
第四节 近亲繁殖和杂种优势
近亲繁殖和杂交的遗传学效应有显著的差别。近亲繁殖或近交(inbreeding)可以使原来杂交的生物增加纯合性(homozygosity),从而提高基因型的稳定性,但往往也会带来严重的衰退现象。杂交可以使自交的动植物增加杂合性(heterozygosity),出现杂种优势(heterosis),但杂种优势不能用有性繁殖方法固定下来。所以在动、植物的改良上,往往要交互地使用近交和杂交的方法,使我们能够得到近交和杂交的好处,但同时又能减少它们的不利影响。
一、近交和近交系数
近交是指有亲缘关系的个体相互交配,繁殖后代。因为有亲缘关系的个体在遗传上更相似些,所以近交的结果会增加纯合子的比例。在各类近交中,亲缘关系最近的交配是自交(selfing),就是同一个体产生的雌雄配子相互结合,繁殖下一代的新个体。
近交的遗传效应可用近交系数(coefficient of inbreeding)来表示。近交系数常记作 $F$ ,这是指一个个体从某一祖先得到一对纯合的,而且遗传上等同的基因的概率。同一基因座的两个基因如果分别来自无亲缘关系的两个祖先,即使这两个基因的结构相同,也不是遗传上等同的,只有同一祖先的特定基因的两个拷贝,才可称为遗传上等同的。
一个杂合子 $Aa$ 自交时,下一代的基因型出现大家熟悉的 $1:2:1$ 分离比,其中一半是杂合子,一半是纯合子。杂合子 $Aa$ 的两基因结构不同,当然不是遗传上等同的,但在纯合子 $AA$ 和 $aa$ 中,两个基因是等同的,因为这两基因是杂种亲本 $(Aa)$ 仅有的那个基因 $(A$ 或 $a)$ 的两份拷贝,所以自交第一代个体中,纯合子的比例为 $\frac{1}{2}$ ,也就是具有遗传上等同的基因的个体比例,即近交系数 $F$ 。
纯合子杂交, 只产生纯合子后代, 这些纯合子的一对等位基因是遗传上等同的。自交第一代得到的 $\frac{1}{2}$ 纯合子将这样保持下去。此外每代从剩下的杂合子中再分离出 $\frac{1}{2}$ 纯合子来, 这些纯合子的两基因自然也是遗传上等同的, 所以自交第二代, F = \frac{1}{2} + \frac{1}{2} \times \frac{1}{2} = \frac{3}{4} 。在以后的每一代中, $F$ 值将以上一代杂合子频率的 $\frac{1}{2}$ 的数值增加。经过 $n$ 代自交后, 杂合子的比例等于 $\left(\frac{1}{2}\right)^n$ , 其余的个体为 $1 - \left(\frac{1}{2}\right)^n$ , 这些都是纯合子, 而且是遗传上等同的, 所以在自交第 $n$ 代, $F = 1 - \left(\frac{1}{2}\right)^n$ (表9-15)。
表 9-15 在逐代自交中杂合子 ${Aa}$ 在群体中递减
| 世代 | 基因型 | 杂合子在群体中的比例 | F | ||
| AA | Aa | aa | |||
| 0 | — | 1 | — | 1 | 0 |
| 1 | $\frac{1}{4}$ | $\frac{2}{4}$ | $\frac{1}{4}$ | $\frac{1}{2}$ | $\frac{1}{2}$ |
| 2 | $\frac{3}{8}$ | $\frac{2}{8}$ | $\frac{3}{8}$ | $\frac{1}{4}$ | $\frac{3}{4}$ |
| 3 | $\frac{7}{16}$ | $\frac{2}{16}$ | $\frac{7}{16}$ | $\frac{1}{8}$ | $\frac{7}{8}$ |
| 4 | $\frac{15}{32}$ | $\frac{2}{32}$ | $\frac{15}{32}$ | $\frac{1}{16}$ | $\frac{15}{16}$ |
| 5 | $\frac{31}{64}$ | $\frac{2}{64}$ | $\frac{31}{64}$ | $\frac{1}{32}$ | $\frac{31}{32}$ |
| ... | ... | ... | ... | ... | ... |
| 10 | $\frac{1\,023}{2\,048}$ | $\frac{2}{2\,048}$ | $\frac{1\,023}{2\,048}$ | $\frac{1}{1\,024}$ | $\frac{1\,023}{1\,024}$ |
| ... | ... | ... | ... | ... | ... |
| n | $\frac{2^n-1}{2^{n+1}}$ | $\frac{2}{2^{n+1}}=\frac{1}{2^n}$ | $\frac{2^n-1}{2^{n+1}}$ | $\frac{1}{2^n}$ | $1-\frac{1}{2^n}$ |
二、近交系数的计算
上面已谈到自交后代的近交系数,现在要介绍一下近交系数的一般算法。
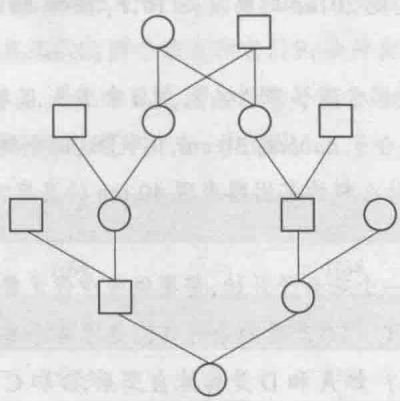
先以动物育种中常用的兄妹交配为例加以说明。图9-5是兄妹交配所生仔畜的家系图。这是一种新的家系图画法,为的是便于近交系数计算法的说明。在图中, $\mathbf{P}_1$ 和 $\mathbf{P}_2$ 是两个无血缘关系的亲本,它们各供应一个配子给同胞兄妹 $\mathbf{B}_1$ 和 $\mathbf{B}_2$ ,而仔畜S(或雌或雄)从 $\mathbf{B}_1$ 和 $\mathbf{B}_2$ 各
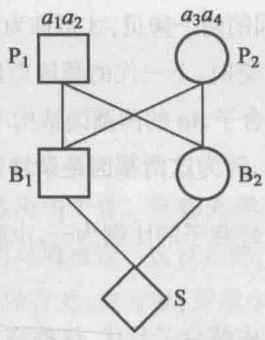
图中 $B_{1}$ 和 $B_{2}$ 为同胞, $P_{1}$ 和 $P_{2}$ 为它们的父母,S 是它们所生的仔畜。
得一个配子。因为 $\mathbf{P}1$ 和 $\mathbf{P}2$ 无血缘关系,所以我们假定它们在某一基因座上的一对基因不是遗传上等同的。 $\mathbf{P}1$ 的两个基因用 $a_1a_2$ 表示, $\mathbf{P}2$ 的两个基因用 $a_3a_4$ 表示(这儿用不同下标1、2、3、4表明这些基因不是遗传上等同的,但这并不意味着这些基因在结构上不相同)。双亲的基因型是 $a_1a_2$ 和 $a_3a_4$ ,它们的仔畜就应该是 $1 / 4a{1}a{3},1 / 4a{1}a{4},1 / 4a_{2}a_{3}$ 和 $1 / 4a_{2}a_{4}$ 。我们想知道的是,这对同胞兄妹所生的仔畜S对它们的亲畜 $\mathbf{P}_1$ 和 $\mathbf{P}_2$ 的任何一个等位基因是纯合子( $a_1a_1,a_2a_2,a_3a_3$ 或 $a_4a_4)$ 的概率是多少?
从表 9-16 来看,有 1/4 \times 1/4 的仔畜具有共同祖先 $\mathrm{P}{1}$ 的一个等位基因 $a{1}$ 的两份拷贝;这就是说,这 1/16 的仔畜具有的一对等位基因不仅是纯合的,而且是遗传上等同的。我们把这些纯合的仔畜频率加起来,就得出兄妹交配所生仔畜的 $F$ 值,即 F = 4 \times \left(\frac{1}{4}\right)^{2} = \frac{1}{4} 。
表 9-16 兄妹交配所生仔畜的 $F$ 值
| 父 $a_1a_2$ 母 $a_3a_4$ | ||||
| 兄妹的基因型 $\frac{1}{4}a_1a_3$ $\frac{1}{4}a_1a_4$ $\frac{1}{4}a_2a_3$ $\frac{1}{4}a_2a_4$ | ||||
| 雌配子\雄配子 | $\frac{1}{4}a_1$ | $\frac{1}{4}a_2$ | $\frac{1}{4}a_3$ | $\frac{1}{4}a_4$ |
| $\frac{1}{4}a_1$ | 1 | 0 | 0 | 0 |
| $\frac{1}{4}a_2$ | 0 | 1 | 0 | 0 |
| $\frac{1}{4}a_3$ | 0 | 0 | 1 | 0 |
| $\frac{1}{4}a_4$ | 0 | 0 | 0 | 1 |
F=\left(\frac{1}{4}\right)^{2}\times(4\times1)=\frac{1}{4} ,这是兄妹交配所生仔畜得到一对不仅是纯合的,而且是遗传上等同的基因的概率。
了解了近交系数的意义和算法后,我们可以用另一种简便的方法来算。仍用图9-5,同胞兄妹的父畜 $P_{1}$ 的某一基因座上的一对等位基因是 $a_{1}a_{2}$ ,而它们的母畜的相应等位基因是 $a_{3}a_{4}$ 。先计算同胞兄妹 $B_{1}$ 和 $B_{2}$ 所生仔畜S是 $a_{1}a_{1}$ 的机会是多少。 $P_{1}$ 把 $a_{1}$ 基因传给 $B_{1}$ 的机会是1/2,而 $B_{1}$ 得到这基因后又把它传给S的机会也是1/2;又 $P_{1}$ 也把 $a_{1}$ 传给 $B_{2}$ ,机会是1/2,如 $B_{2}$ 得到这基因后,又把这基因传给S,机会又是1/2。所以如要S的基因型是 $a_{1}a_{1}$ ,那么 $P_{1}$ 的等位基因 $a_{1}$ 一共要传递4步,每方亲本各2步。又因为每传递一步的概率是1/2,所以通过所有4步的传递概率是 $\left(\frac{1}{2}\right)^{4}$ 。运用同样方法,我们可以计算S是 $a_{2}a_{2}$ 、 $a_{3}a_{3}$ 和 $a_{4}a_{4}$ 的概率,自然也都是 $\left(\frac{1}{2}\right)^{4}$ 。从而同胞兄妹所生仔畜的纯合子总概率 F=4\times\left(\frac{1}{2}\right)^{4}=\frac{1}{4} ,这数值与上面得出的结果(表9-16)完全一致。
图9-6 表兄妹结婚所生子女一个基因座上纯合的可能性
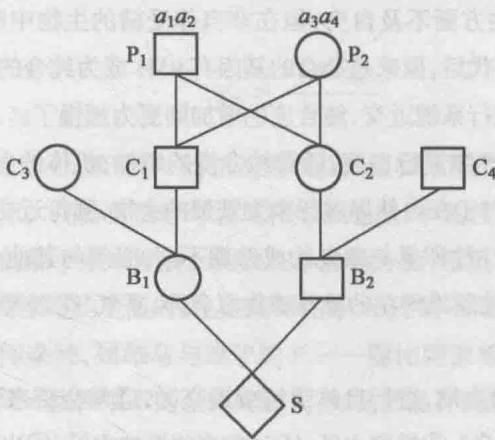
我们可以把这种方法推广到人类社会中最常见的表兄妹结婚(图9-6),计算他们所生子女的近交系数。仍设共同祖先 $P_{1}$ 和 $P_{2}$ 的基因型是 $a_{1}a_{2}$ 和 $a_{3}a_{4}$ ,那么后裔S在基因座上基因纯合且在遗传上等同的概率
是多少?为了使这个近交后裔 S 的基因型成为 $a_{1}a_{1}$ ,共同祖先 $P_{1}$ 的等位基因 $a_{1}$ 必须传递 6 步,由 $P_{1}$ 经 $B_{1}$ 传给 S 计 3 步,由 $P_{1}$ 经 $B_{2}$ 传给 S 也计 3 步,所以总共传递 6 步。因为每一步的传递概率是 1/2,所以通过所有 6 步的传递概率是 $\left(\frac{1}{2}\right)^{6}$ 。这个概率同样也适用于 $a_{2}a_{2}, a_{3}a_{3}$ 和 $a_{4}a_{4}$ ,所以表亲结婚所生子女的近交系数是 4 \times \left(\frac{1}{2}\right)^{6} = 1/16 。以此类推,各种血缘个体间交配所生子裔的近交系数见表 9-17。
表 9-17 各种近交所生子裔的近交系数 $F$
| 交配型式 | F | 交配型式 | F |
|---|---|---|---|
| 自交 | 1/2 | 堂表兄妹(first cousins) | 1/16 |
| 同胞兄妹 | 1/4 | 从表兄妹(second cousins) | 1/64 |
| 叔父侄女 | 1/8 | 再从表兄妹(third cousins) | 1/256 |
近交系数的高低既可表示群体中某一基因座上纯合子频率的增减,也可表示某一个体中全部基因座上纯合基因座比例的升降。
三、近交的遗传效应
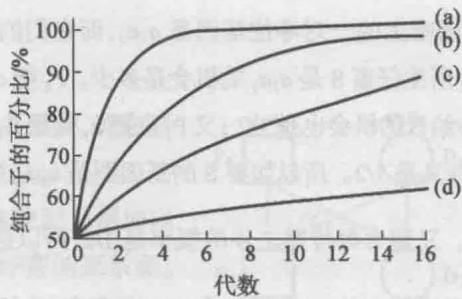
在动、植物育种中,为了获得某种程度的纯合性,有时要进行系统的近交。如每代进行同一形式的近交,群体的纯合度将逐代增加。图9-7表示自交、兄妹交配以及更远一些的近交的接近纯合性的情况。自交接近纯合性最快,经过4代自交,纯合度已超过 $90%$ ,经过5代,已超过 $95%$ 。兄妹交配在提高纯合性方面不及自交,但在非自体受精的生物中则是最强烈的近交了。进行系统兄妹交配时,经过11代后,原来是杂合的基因有 $95%$ 成为纯合的了,但仍有 $5%$ 是杂合的。至于血缘更远的个体间进行系统近交,纯合度的增加则更为缓慢了。
| 物种 | 性状 | 减少量 | 减少率/% |
| 人 | 10岁时身高/cm | 2.0 | 1.6 |
| 智商/% | 4.4 | 4.4 | |
| 牛 | 产奶量/kg | 13.5 | 3.2 |
| 绵羊 | 羊毛量/kg | 0.29 | 5.5 |
| 1岁体重/kg | 1.32 | 3.7 | |
| 猪 | 每胎仔数/活产数 | 0.24 | 3.1 |
| 154天体重/kg | 2.6 | 4.3 | |
| 小家鼠 | 每胎仔数 | 0.56 | 7.2 |
| 6周体重/g | 0.19 | 0.6 | |
| 玉米 | 株高/cm | 5.65 | 2.3 |
| 籽粒产量/g·株-1 | 9.65 | 6.8 |
1 | P A A b b C C D D e e \dots \times a a B B c c d d E E \dots |
1 | \mathrm{F} _ {1} A a B b C c D d E e \dots (\text {出现杂种优势}) |
1 | \begin{array}{c c c} {a _ {1} a _ {1} b _ {1} b _ {1} c _ {1} c _ {1} d _ {1} d _ {1} e _ {1} e _ {1} \dots} & {\times} & {a _ {2} a _ {2} b _ {2} b _ {2} c _ {2} c _ {2} d _ {2} d _ {2} e _ {2} e _ {2} \dots} \\ & {\downarrow} & \\ {a _ {1} a _ {2} b _ {1} b _ {2} c _ {1} c _ {2} d _ {1} d _ {2} e _ {1} e _ {2} \dots (\text {出现杂种优势})} \end{array}\tag{\( F_{1} \} |
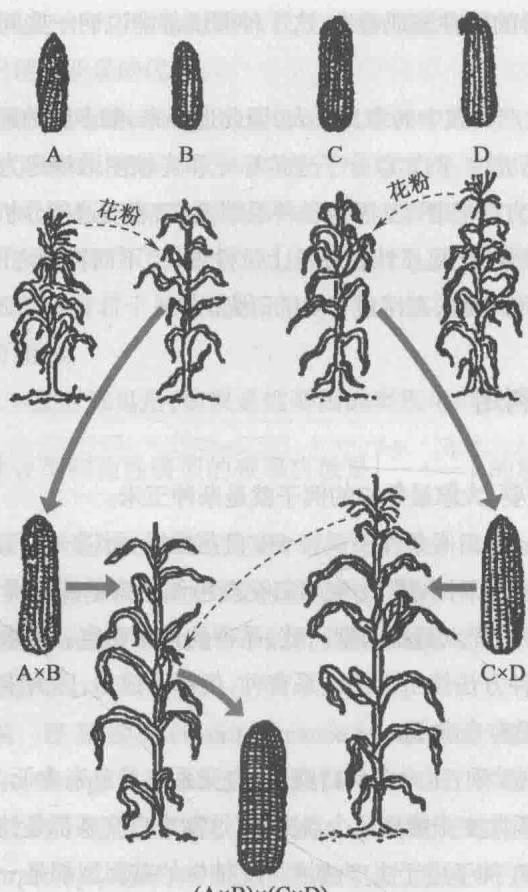
A、B、C 和 D 代表 4 个适宜的自交系,它们都是高度纯合化的纯系,生活力弱,产量低。A 和 B 是一个杂交组,结果产生出杂种 AB。C 和 D 是另一杂交组,结果产生出杂种 CD。然后把杂种 AB 与杂种 CD 交配,产生出杂种 ABCD,产量很高,这就是播种用的杂种种子。
(A×B)×(C×D)
(尤其是葱韭类和茄果类),也广泛地利用杂种优势。至于小麦、棉花和油菜的杂种优势的研究正在大力开展,并已取得初步成果,正式应用是很有希望的。
在杂种优势利用方面有这样一个原则:杂种优势的强弱与两亲本遗传差异的大小成比例。可是有时差异太大,特别是在种间杂交时,虽有强大的杂种优势,也会同时出现杂种弱势。例如雌马与雄驴杂交, $F_{1}$ 个体——骡身强力壮,可是雄骡不育。但如能根据育种对象的不同,巧妙配合,还可两蒙其利。例如罗非鱼(Tilapia,又称非洲鲫鱼)的种间杂种就有这种可能。这类鱼原产非洲,现已广泛养殖于我国南方各地。罗非鱼繁殖很快,鱼池里不久就显得过于拥挤,相互间竞争激烈,每条鱼每年只能长250 g不到。可是如选择合适罗非鱼鱼种,进行种间杂交,产生的杂种雄鱼是不育的,可是长得快,又健壮。鱼池里放养这类杂种鱼,群体不扩大,鱼群密度合适,每条鱼每年可以长1 000~1 500 g。这是一个利用杂种弱势、促使杂种优势充分表达的例子。
习题
数量性状在遗传上有些什么特点, 在实践上有什么特点? 数量性状遗传和质量性状遗传有什么主要区别?
解释名词: 遗传率、广义遗传率、狭义遗传率、平均显性程度。
自然界中杂交繁殖的生物强制进行自交或其他方式近交时生活力降低,为什么自然界中自交的生物继续自交没有不良影响呢?
约翰森用菜豆做实验, 得出纯系学说。这个学说的重要意义在哪里, 它有什么局限性?
纯种或自交系的维持比较困难, 那么制造单交种或双交种时, 为什么要用纯种或自交系呢?
在数量性状遗传中, 已知某小麦籽粒颜色是由 3 对等效可相加的等位基因控制, 且基因作用可以相加, 子代表型取决于等位基因中显性基因的个数。实验发现将纯系红粒小麦 (AABBCC) 与纯系白粒小麦 (aabbcc) 杂交, 得到的 $\mathrm{F}_{2}$ 的表型颜色有深有浅, 从深到浅的分离比为 $1:6:15:20:15:6:1$ 。请结合下图解释这一分离比的由来。
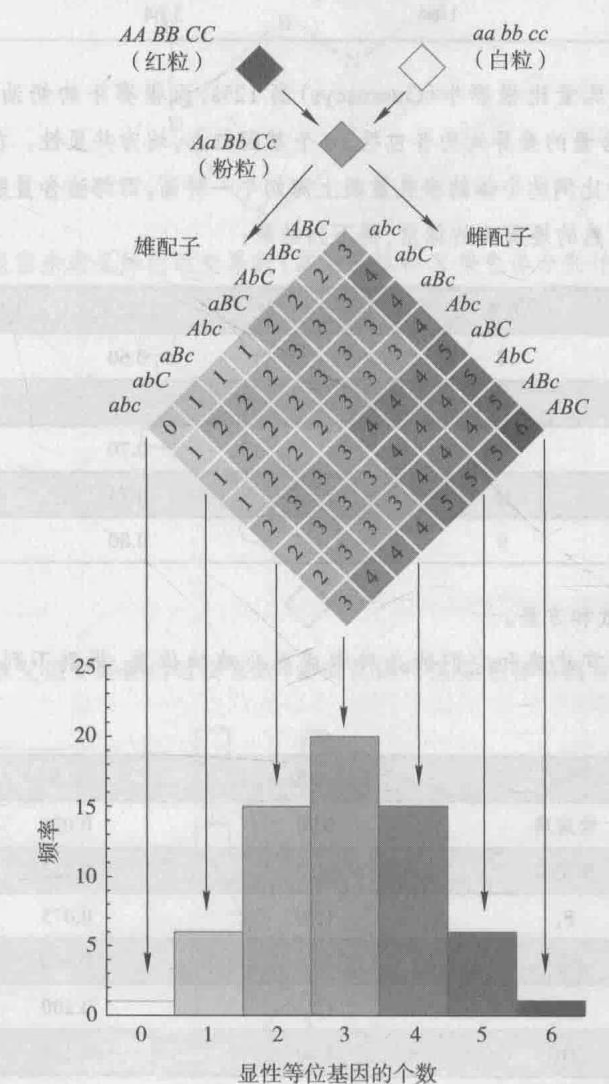
假设多对等位基因控制了某一表型,用计量数值衡量各个等位基因对该表型的遗传贡献。如: $A_{0}$ 、 $B_{0}$ 、 $C_{0}$ 等位基因的表型贡献各是5个单位,而 $A_{1}$ 、 $B_{1}$ 、 $C_{1}$ 等位基因的表型贡献各是10个单位,请计算 $A_{0}A_{0}B_{1}B_{1}C_{1}C_{1}$ 和 $A_{1}A_{1}B_{0}B_{0}C_{0}C_{0}$ 两个亲本和它们 $F_{1}$ 杂种表型的计量数值。设:①共显性;② $A_{1}$ 对 $A_{0}$ 是完全显性;③ $A_{1}$ 对 $A_{0}$ 是完全显性, $B_{1}$ 对 $B_{0}$ 是完全显性。
根据上题的假定, 导出下列的 $F_{2}$ 频率分布, 并作图。
| 计量数值 | (1) | (2) | (3) |
|---|---|---|---|
| 30 | 1/64 | 1/64 | 1/64 |
| 35 | 6/64 | 4/64 | 2/64 |
| 40 | 15/64 | 9/64 | 7/64 |
| 45 | 20/64 | 16/64 | 12/64 |
| 50 | 15/64 | 19/64 | 15/64 |
| 55 | 6/64 | 12/64 | 18/64 |
| 60 | 1/64 | 3/64 | 9/64 |
上海奶牛的泌乳量比根赛牛(Guernseys)高 $12%$ ,而根赛牛的奶油含量比上海奶牛高 $30%$ 。泌乳量和奶油含量的差异大约各包括10个基因位点,均为共显性。在上海奶牛和根赛牛的杂交中, $\mathbf{F}_2$ 中有多少比例的个体的泌乳量跟上海奶牛一样高,而奶油含量跟根赛牛一样高?
测量 101 只成熟的矮脚鸡的体重, 得下列结果:
| 只数 | 体重/kg |
|---|---|
| 8 | 0.60 |
| 17 | 0.65 |
| 52 | 0.70 |
| 15 | 0.75 |
| 9 | 0.80 |
计算体重的平均数和方差。
- 测量矮脚鸡、芦花鸡和它们的杂种中成熟公鸡的体重, 得到下列的平均体重和表型方差:
| 平均体重/kg | 方差 | |
|---|---|---|
| 矮脚鸡 | 0.70 | 0.025 |
| 芦花鸡 | 3.30 | 0.125 |
| $F_1$ | 1.70 | 0.075 |
| $F_2$ | 1.80 | 0.300 |
| $B_1$ | 1.25 | 0.200 |
| $B_2$ | 2.40 | 0.250 |
计算显性程度以及广义和狭义遗传率。
设亲本植株 AA 的高度是 20, aa 的高度是 10, $F_{1}$ 植株 Aa 的高度是 17。计算 $F_{2}$ 植株的平均高度和方差。
假定有两对基因, 每对各有两个等位基因, A/a 和 B/b, 以相加效应的方式决定植株的高度。纯合子 AABB 高 50 cm, 纯合子 aabb 高 30 cm, 问: ① 这两个纯合子之间杂交, $F_{1}$ 的高度是多少? ② 在 F_{1} \times F_{1} 杂交后, $F_{2}$ 中什么样的基因型表现 40 cm 的高度? ③ 这些 40 cm 高的植株在 $F_{2}$ 中占多少比例?
一连续自交的群体,由一个杂合子开始,需要经多少代才能得到大约 $97%$ 的纯合子?
预测双交种 (\mathbf{A} \times \mathbf{B}) \times (\mathbf{C} \times \mathbf{D}) 产量的最好方法是求4个单交种 \mathbf{A} \times \mathbf{C} 、 \mathbf{B} \times \mathbf{C} 、 \mathbf{A} \times \mathbf{D} 和 \mathbf{B} \times \mathbf{D} 的产量的平均数,为什么?如A和D是姊妹自交系,B和C也是姊妹自交系,为了使双交种的杂种优势最强,在这些可能的单交中,你将选哪两个单交种进行杂交?
下面是一个箭头式的家系。家系中 S 是 D 和 P 的子裔,D 是 C 和 B 的子裔等。问:① 谁是共同祖先?② 谁是近交子裔?③ 计算近交子裔的近交系数。
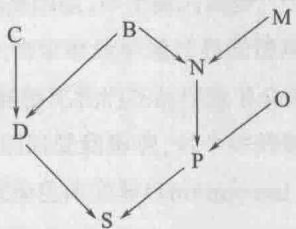
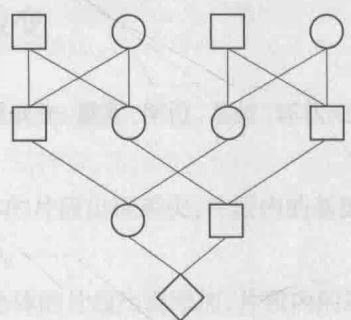
- 请计算以下双重亲表兄妹的近交系数(常染色体和 X 染色体分别计算)。
- 请计算以下叔父侄女婚配的近交系数(常染色体和 X 染色体分别计算)。
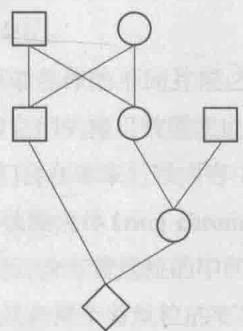
- 请计算以下从表兄妹婚配的近交系数(常染色体和 X 染色体分别计算)。
数字课程学习
在线自测 习题答案
第十章
遗传物质的改变(一) ——染色体畸变
根据前几章中讲过的一些遗传学基本定律,我们知道分离与组合、连锁与交换,均可使子代得到新性状,或性状的新组合。但这些“新”性状,追溯起来并不是真正的新性状,其实都是祖先中原来有的。这两章我们将介绍真正的新性状的产生原因——遗传物质的改变。只有遗传物质的改变,才出现新的基因,形成新的基因型,产生新的表型。
遗传物质的改变就是变异。生物学家最早通过显微镜观察到了遗传物质水平的变异,包括染色体结构和数目的改变,这些变异相比我们在前序章节介绍的基因内部的变异显然要大很多,往往是多个基因和/或基因外序列同时受到影响,对个体的影响巨大,我们把这类变异称为染色体畸变(chromosomal aberration)或染色体变异(chromosomal variation)。
第一节 染色体结构的改变
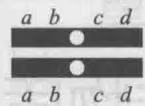
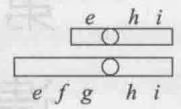
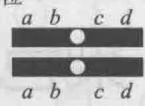
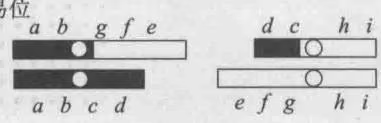
染色体的结构变异主要包括缺失、重复、倒位、易位、环状染色体、双着丝粒染色体、等臂染色体和插入等(图 10-1)。
(1)缺失(deletion) 染色体的片段出现丢失,片段内的基因和/或基因外序列减少为单拷贝(杂合缺失)或零拷贝(纯合缺失)。
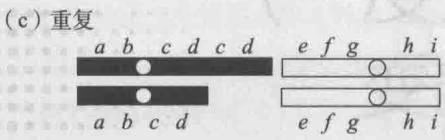
(2) 重复 (duplication) 染色体的片段出现添加, 片段内的基因和/或基因外序列增加为两个以上的多个拷贝。
(3) 倒位 (inversion) 染色体一个区段发生了 $180^{\circ}$ 颠倒, 造成染色体内基因和/或基因外序列的重新排列, 但它们的拷贝数没有变化。
(4) 易位(translocation) 非同源染色体的不同片段之间的位置转移,造成非同源染色体间基因和/或基因外序列的重新排列,但它们的拷贝数通常也没有变化。
以上 4 种结构变异较为常见,我们会在本章后续内容中详细介绍它们。
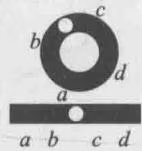
其他结构变异类型还包括:①环状染色体(ring chromosome),指的是闭合成环的染色体,可能起源于单条染色体的长、短臂断裂后,含有着丝粒的中间片段的两端错误重接。②双着丝粒染色体(dicentric chromosome),指的是具有两个着丝粒的变异染色体,可能起源于两条染色体的断裂后,两个具有着丝粒的染色体片段重接。③等臂染色体(isochromosome),指的是一条染色体的两条臂在形态和遗传结构上完全相同,可能起源于在细胞分裂中着丝粒发生异常的横裂,得到
(a) 正常
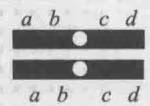
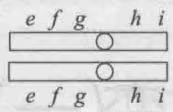
(b) 缺失
(d) 倒位
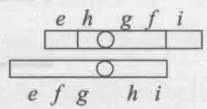
(e) 易位
(f) 环状染色体
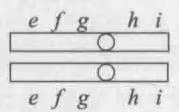
(g) 双着丝粒染色体
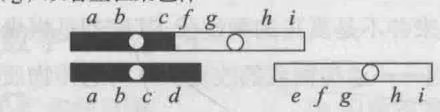
(h) 等臂染色体
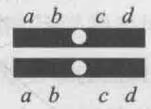
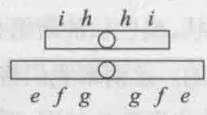
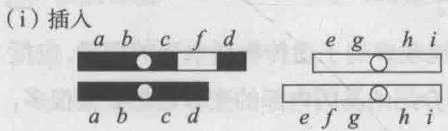
(a)两对正常染色体,abcd表示一对染色体上的基因顺序,efghi表示另一对染色体上的基因顺序。(b)缺失杂合子,一条染色体缺失了fg片段。(c)重复杂合子,一条染色体重复了cd片段。(d)倒位杂合子,一条染色体上fgh片段发生颠倒。(e)易位杂合子,两对染色体各有一条相互交换了cd和efg片段。(f)环状染色体杂合子,一条染色体发生环化。(g)双着丝粒染色体杂合子,两对染色体各自带着丝粒的片段 $ab\cdot c$ 和 $fg\cdot hi$ 融合到一起。(h)等臂染色体,一对染色体的两条短臂hi相互连接,两条长臂efg相互连接。(i)插入杂合子,一条染色体上的片段f插入到另一条染色体内部。
分别含有两个长臂、两个短臂的衍生染色体。④插入(insertion),指的是一条染色体的片段插入另一条染色体中间的现象,可能起源于一条染色体的两次断裂产生了一条染色体片段,又插入了发生一次断裂的另一条染色体内部,也是一种错误重接。
一、染色体畸变的研究材料和研究方法
每种生物的细胞都有一定数目的染色体,各条染色体的形态结构也是恒定的。如果它们的数目或结构改变了,就可以知道发生了畸变。
玉米是研究染色体畸变的好材料, 玉米的 10 对染色体在形态上可以互相区别。特别是在减数分裂的粗线期, 那时染色体是细长的染色丝, 两条同源染色丝紧密地配合在一起。细长的细线上又有各种标记, 如着丝粒的位置、两臂的相对长短、球节 (knob) 的存在与否, 以及染色丝上着色较浓的染色粒 (chromomere) 的分布等 (图 10-2)。对每一条染色体来讲, 这些标记都是以一定的顺序直线排列的, 所以如果这些标记不见了或重复出现, 或者它们的原有排列顺序改变了, 就是染色体畸变的明确证据。
果蝇的染色体在减数分裂时形状很小,不易研究。但是果蝇幼虫的唾腺细胞的核特别大,其中的染色体比减数分裂时的染色体和其他体细胞的染色体还要大上几百倍。
图 10-3 是黑腹果蝇的唾腺染色体照片。图 10-4 是普通染色体与唾腺染色体的对照模式图,该模式图说明了唾腺染色体是怎样形成的。唾腺染色体上有明显的横纹,横纹的相对大小和空间排列是恒定的,可以作为识别标志。这些横纹在染色后看得特别清楚,在不染色的活细胞中也易分辨。
一般认为唾腺染色体处于分裂间期或有丝分裂前期状态。由于唾腺细胞内的染色体连续复制,复制后形成的染色丝并不相互分开,而是纵向地密集排列在一起,所以唾腺染色体被称
图10-2 玉米的粗线期染色体
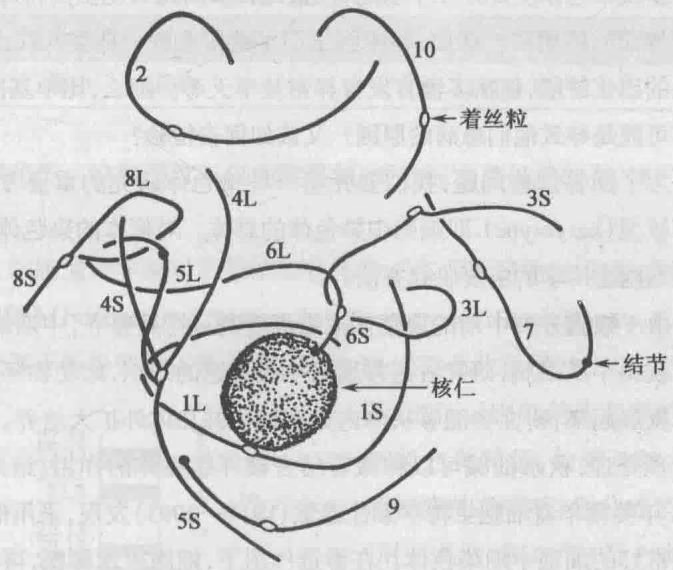
图中描绘了玉米的粗线期染色体(10Ⅱ)和一个核仁。数字代表染色体号码;L,长臂;S,短臂。
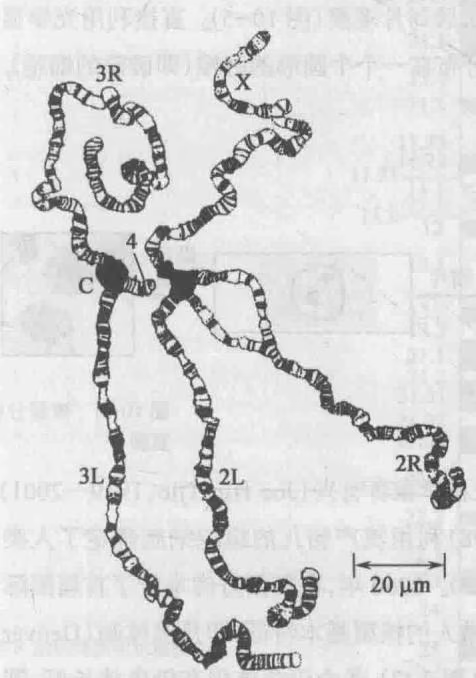
X, X 染色体, 即第一染色体; 2~4, 第二, 第三和第四染色体; L, 左臂; R, 右臂; C, 染色中心。
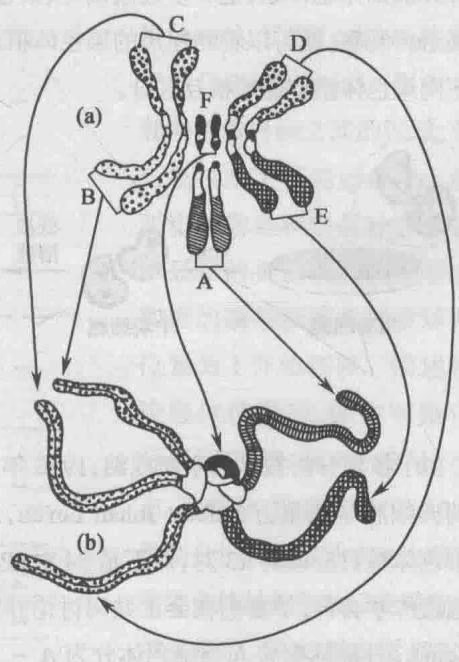
(a)分裂中期的普通染色体。(b)幼虫的唾腺染色体。A, X 染色体; BC, 第二染色体; DE, 第三染色体; F, 第四染色体。
为多线染色体(polytene chromosome)。染色体的着丝粒及其邻近部分相互聚合,形成染色中心(chromocenter)。多线染色体中每一染色丝是一条与蛋白质结合在一起的 DNA 双链,在两条横纹之间的区域,螺旋化程度较低,而在横纹的地方,螺旋化程度要高一些。
因为同源的唾腺染色体总是像减数分裂期的粗线期染色体一样,紧密地结合在一起,所以当两条同源染色体之间有差别时,就很容易看出来。由于这些原因,唾腺染色体是研究果蝇染色体畸变的好材料。
多线染色体主要存在于双翅目、直翅目和鳞翅目昆虫的特殊组织细胞中,那其他生物的染色体变异该如何研究?例如,临床医生很早就留意到一些婴儿在出生时表现出比孟德尔疾病严重得多的出生缺陷,包括多器官发育异常及早夭等。那么,比单基因变异严重得多的染色体畸变有没有可能是导致他们患病的原因?又该如何去检验?
为了回答这些问题,我们要介绍一种染色体研究的重要方法——核型分析(karyotyping)。所谓核型(karyotype),即细胞中染色体的总体。对标本的染色体构成进行检查被称为核型分析,它是细胞遗传学的主要研究方法。
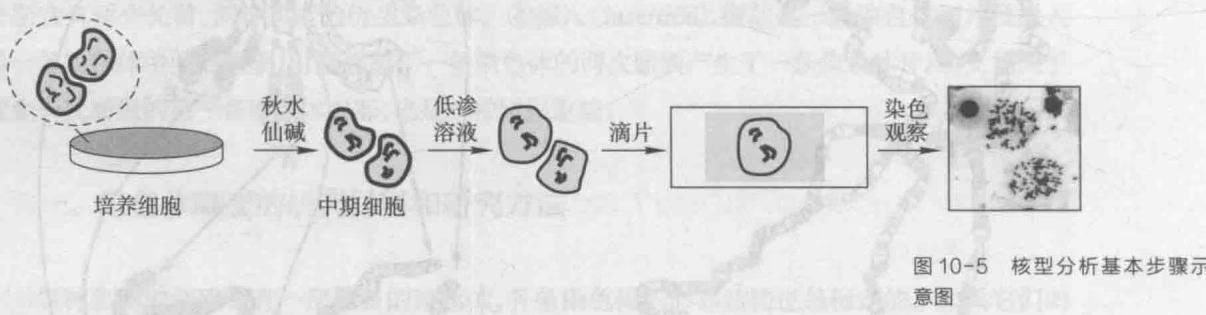
由于细胞分裂中期的染色体浓缩程度高且排列整齐,中期细胞常用来进行核型分析。最初为了获得中期细胞,研究者通常选用生长迅速的组织,如动物胚胎和植物根尖。后来,细胞培养技术发展起来,研究者能够从体内分离细胞并在体外扩大培养。利用化学试剂秋水仙碱对细胞进行预处理,秋水仙碱可以和微管结合破坏纺锤体的作用,结果大量细胞都停滞在分裂中期。1952年美籍华裔细胞生物学家徐道觉(1917—2003)发现,采用低渗溶液预处理细胞能得到分散得非常好的细胞中期染色体。在渗透作用下,细胞吸水膨胀,再悬空滴到载玻片上,就能发生破碎并释放出染色体组,进一步通过固定、染色和洗涤,最后封片观察(图10-5)。直接利用光学显微镜进行观察,就可以看到粗短的染色体相对集中地分布在一个个圆形的区域(即破碎的细胞),且不同染色体能清楚地相互区分。
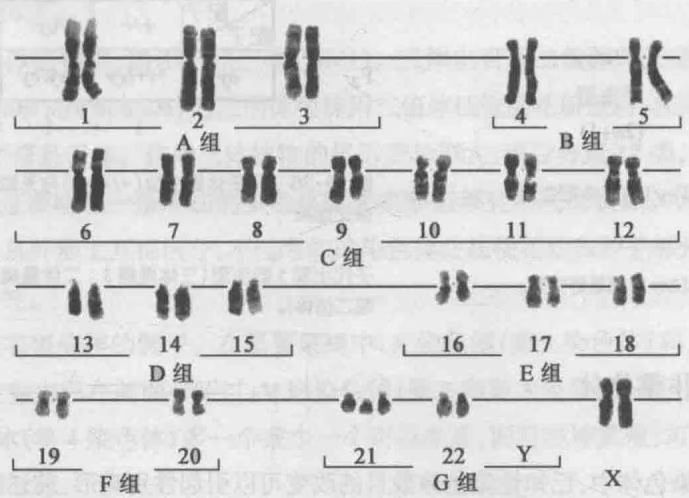
由于核型分析技术的不断成熟,1956年,美籍华裔科学家蒋有兴(Joe Hin Tjio, 1919—2001)和瑞典细胞学家莱万(Albert Johan Levan, 1905—1998)利用流产胎儿的组织细胞确定了人类的染色体数目应该为23对,而不是24对(Painter, 1923)。1960年,在美国丹佛举行了首届国际细胞遗传学会议,学者们在会上共同讨论并定义了正常人的核型基本特征,即丹佛体制(Denversystem)。丹佛体制将人类染色体分为A~G共7组(图3-2),各个染色体组在染色体长度、着丝粒的位置、有无随体等方面相互不同(表10-1)。
在染色体分组的基础之上,细胞遗传学家进一步发展了染色体显带技术,借助特殊的染色体处理方法,通过染料将染色体沿长轴染成宽窄及明暗不同的条带,以供更加精细的染色体辨别和染色体变异鉴定。常见的显带技术有 G 显带(G banding),即将染色体经热、碱或蛋白酶等预处理后进行吉姆萨染色,从而获得带型。这些带纹不仅观察简便,而且标本易长期保存,被广泛应用到了核型分析的技术之中。
表 10-1 人类染色体组
| 组号 | 染色体号 | 大小 | 着丝粒位置 | 随体 | 次级缢痕 |
|---|---|---|---|---|---|
| A | 1、2、3 | 最大 | 中央(1、3)及亚中央(2) | 无 | 1 常见 |
| B | 4、5 | 次大 | 亚中央 | 无 | 无 |
| C | 6、7、8、9、10、11、12、X | 中等 | 亚中央 | 无 | 9 常见 |
| D | 13、14、15 | 中等 | 近端 | 有 | 无 |
| E | 16、17、18 | 小 | 中央(16)、亚中央(17、18) | 无 | 16 常见 |
| F | 19、20 | 次小 | 中央 | 无 | 无 |
| G | 21、22、Y | 最小 | 近端 | 21、22 有 | 无 |
在显带技术的发展基础上,细胞遗传学家对显带的染色体模式作了详细规定,编撰成册,即《人类细胞遗传学命名的国际体制》(International System for Chromosome Nomenclature, ISCN)。ISCN随着染色体观察技术的发展不断得到修正和完善。人类23对染色体根据ISCN规定的界
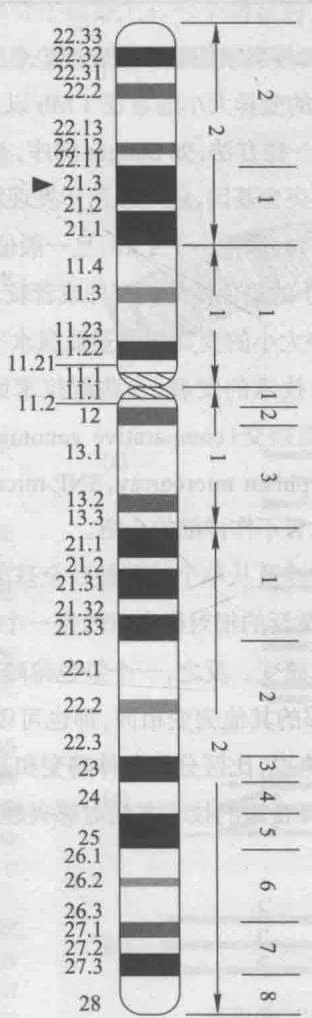
染色体左侧是各个显带的编号,右侧是区、带的范围。箭头所指染色体位置的完整表示为Xp21.3,读作“X染色体短臂2区1带3亚带”。
标(对于识别染色体有重要帮助的染色体特征,如着丝粒、末端和恒定的条带等)划分成了长臂(用q表示)和短臂(用P表示),每条臂划分为若干个区(region)、带(band)、亚带(sub-band)和次亚带(sub-sub-band)。区表示相邻染色体界标之间的区域,带是显色技术下可见的条带。亚带和次亚带是利用高分辨显带技术显示的更加精细的条带。区和带的编号都以靠近着丝粒的位置为1开始编算。描述特定染色体位置时,依次写染色体号、长/短臂、区号、带号、小数点、亚带号、次亚带号(图10-6)。核型分析和显带技术也为研究人类染色体结构和数目变异带去了很多便利,研究者根据ISCN的规则规定了常见染色体结构变异的书写方法(表10-2)。
表 10-2 常见染色体结构变异的书写方法和含义
| 结构变异 | 表述范例 | 表述含义 |
|---|---|---|
| 缺失 | 46,XY,del(3)(q21q31) | 46条染色体,性染色体组成XY。3号染色体长臂的2区1带至3区1带发生了缺失。 |
| 重复 | 46,XY,dup(4)(q13q31) | 46条染色体,性染色体组成XY。4号染色体长臂的1区3带至3区1带发生了重复。 |
| 倒位 | 46,XX,inv(4)(q13q24) | 46条染色体,性染色体组成XX。4号染色体长臂的1区3带至2区4带发生了倒位。 |
| 相互易位 | 46,XY,t(4;20)(q25;q12) | 46条染色体,性染色体组成XY。4号染色体长臂的2区5带至末端,与20号染色体长臂的1区2带至末端发生了相互易位。 |
| 环状染色体 | 46,XY,r(2)(p21q31) | 46条染色体,性染色体组成XY。2号染色体短臂的2区1带至长臂的3区1带之间形成了闭合环。 |
| 双着丝粒染色体 | 46,XX,dic(5;9)(q31;q21) | 46条染色体,性染色体组成XX。5号染色体长臂3区1带至短臂末端,和9号染色体长臂2区1带至短臂末端之间形成了双着丝粒染色体。 |
| 等臂染色体 | 46,XX,i(12q) | 46条染色体,性染色体组成XX。12号染色体的长臂形成了等臂染色体。 |
| 插入 | 46,XY,ins(18;5)(q21;q31q35) | 46条染色体,性染色体组成XY。5号染色体长臂3区1带至5带插入到了18号染色体长臂2区1带的位置。 |
有了核型分析,借助光学显微镜,遗传学家能够准确发现染色体畸变。但这种技术显然也受制于显色技术和显微镜的分辨率,适用的变异大小通常在3 Mb以上。我们在遗传的分子基础一章中还介绍过基因分型技术。其中的一些方法,如Sanger测序,并不需要提前获知基因的变异方式,因此它不仅可以用于鉴定已知的突变基因,还可以用于发现新的基因突变。与核型分析相反,Sanger测序能够发现的是较小的变异,通常小于1 kb,且一般位于单个基因的内部。那么,比3 Mb小但比1 kb大的遗传变异,即较小的染色体结构变异或者较大的基因突变是否存在呢?答案自然是肯定的,我们现在将这类中等大小的变异称为亚显微水平的结构变异(submicroscopic structural variation)。随着现代生物学技术的发展,一些新技术如荧光原位杂交(fluorescence in situ hybridization,FISH)、比较基因组杂交(comparative genomic hybridization,CGH)、单核苷酸多态芯片(single nucleotide polymorphism microarray,SNP microarray)等能够有效检测介于1 kb~3 Mb之间的遗传变异,我们在此暂不作详细的介绍。
需要再次强调的是,遗传变异可能涉及从单个核苷酸到全基因组的各个尺度。本章染色体畸变和下一章基因突变只是两个比较宽泛的相对概念。如果一个较大的基因发生变异,核型上可以分辨出来,那它也可以称为染色体畸变。反之,一个染色体畸变涉及的 DNA 区域内只有一个功能基因,表型与发生在该基因内部的其他突变相同,那也可以认为这种染色体畸变是一种新的等位基因类型。对于一名研究者来说,比区分染色体畸变和基因突变这两个概念更重要的是——认识到遗传变异的多样性并选择合适的技术方法对感兴趣的遗传变异进行有效的筛查、鉴定和研究。
二、缺失
当染色体的一个片段不见了,其中所包含的基因也随之丢失了。如果同源染色体中一条染色体有缺失,而另一条染色体是正常的,那么在同源染色体相互配对时,因为一条染色体缺了一个片段,它的同源染色体在这一段不能配对,因此拱了起来,形成一个弧状的结构,被称为缺失环(deletion loop)。缺失的横纹可以从缺失环上的正常染色体认出来(图10-7)。
染色体片段缺失影响个体的生活力。如果缺失的部分太大,那个体通常是不能生活的。一般缺失纯合子的生活力比缺失杂合子的生活力更低,这是容易理解的,因为在纯合子中,缺失片段的两个拷贝都不存在,缺失基因所担负的重要机能都不能进行了。
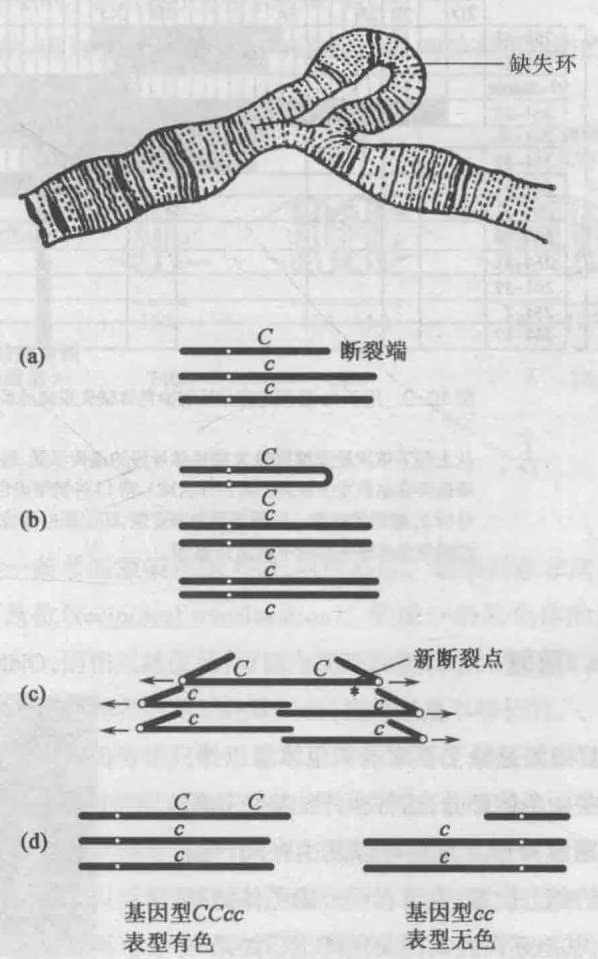
一些不致死的缺失往往引起特殊的表型效应。例如,一个杂合子 $Aa$ ,如果缺失了带有显性基因 $A$ 的染色体片段,隐性基因 $a$ 就在表型上显现出来。在玉米中,糊粉层核是三倍体,如果除了显性基因 $C$ 以外,其他对色素形成所需要的基因也都存在,那么基因型 $Ccc$ 的糊粉层是有色的。假如带有显性基因 $C$ 的那条染色体的端部有一缺失,那么在有丝分裂过程中,经过“断裂-融合-桥的循环”(breakage-fusion-bridge cycle)(McClintock,1938),显性基因 $C$ 所在的染色体片段可能从某些细胞中消失,结果糊粉层表现为花斑。也就是说,一个籽粒的糊粉层上,有色组织和无色组织(有 $C$ 基因和无 $C$ 基因的细胞)掺杂在一起。图10-8说明了这样的花斑是怎样起源的。因为一个显性基因的缺失,致使原来不应显现出表型的一个隐性等位基因的效应显现了出来,这种现象叫作拟显性(pseudodominance)。又如在雌性果蝇中,Notch(缺刻翅)基因位于X染色体上,缺失Notch的杂合子翅缘上有一个明显的凹口,而纯合Notch缺失是致死的,所以它既是一个隐性纯合致死基因,又有显性的缺刻表型效应。将一种红眼缺刻翅雌蝇与白眼正常
图 10-7 黑腹果蝇幼虫唾腺染色体发生缺失的一段染色体
每条唾腺染色体由来自雌亲和雄亲的一对同源染色体组成。图中表示一条染色体缺少了一个片段,它的正常同源染色体在这一段不能配对,因而拱了起来,形成一个缺失环。
图 10-8 玉米的花斑型糊粉层颜色可能起因于“断裂-融合-桥的循环”的作用
基因 C 位于第 9 号染色体上,对于合成糊粉层颜色是必需的。它的等位基因 c 在纯合时,糊粉层是无色的。糊粉层核是 3n。(a) 一个基因型 Ccc 的核;带有等位基因 C 的染色体在靠近基因 C 基因座的地方有个新近形成的断裂端。(b) 在有丝分裂前期,带有基因 C(发生断裂的)的两个姐妹染色单体在断裂端的地方相连接,发生“融合”,形成一条双着丝粒染色单体。(c) 在有丝分裂后期,融合染色单体的双着丝粒分别被两极的纺锤体微管牵引,在细胞两极间形成一个“桥”。随着纺锤体微管的不断牵拉,“桥”在新断裂点发生断裂,断裂后的染色单体分别移向细胞两极。其他成对的染色单体同时被牵向两极。(d) 由于新断裂点位于两个基因 C 的同侧,因此,在分裂完成后形成的两个子核中:一个子核缺失了部分染色体片段,不含 C 等位基因,基因型为 cc,表型为无色;另一个子核的部分染色体重复,含有两个 C 等位基因,基因型为 CCcc,表型为有色。如此“断裂-融合-桥的循环”可以在糊粉层的发育过程中不断继续下去。
翅雄蝇杂交时,得到的部分 $F_{1}$ 果蝇是白眼的。后来发现,该缺刻翅品系是一个染色体缺失的品系,缺失区域不仅包括 X 染色体 $3C_{7}$ 区域的 Notch 基因,还包括了相邻的 $3C_{2}$ 区域的 white 基因。由于缺失的存在,只携带一个 white 基因突变的杂合子代表现出了拟显性,为白眼。
在黑腹果蝇中,分析不同突变品系的拟显性表型特征及发生缺失的染色体区段可以反过来推导表型决定基因所在染色体位置,这种方法被称为缺失作图(deletion mapping)。如图10-9,小眼不齐基因(facet,fa)在除258-11、259-14以外的品系中均出现拟显性现象,所以fa基因一定是在 $3C_{7}$ 这一横纹之中。
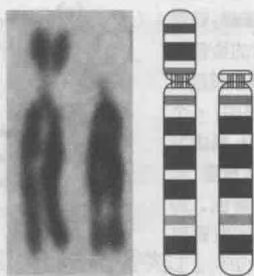
在人中,染色体缺失通常也显示有害影响。例如第5染色体短臂缺失(5p⁻¹)的儿童出现一系列症状,包括两眼距离较远,耳位低下,智力迟钝,生活力差等,患儿多在生命早期死亡(Lejeune,1963)。患儿最明显特征是哭声轻,音调高,很像猫叫,所以称为猫叫综合征(cri-du-chat syndrome)(图10-10)。
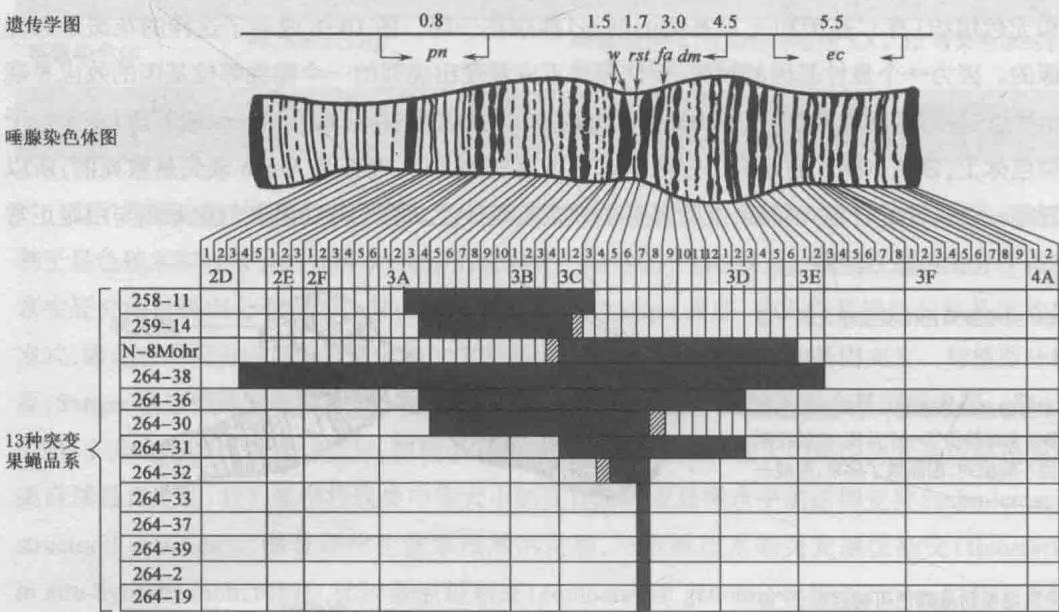
从上而下依次是黑腹果蝇 X 染色体片段的遗传学图、唾腺染色体图和突变果蝇品系的染色体片段缺失示意图(灰框代表各突变品系发生缺失的染色体区域)。将 13 种携带染色体缺失的突变果蝇品系分别与小眼不齐纯合突变的果蝇杂交,分析 F₁ 雌蝇的表型。如果表型为突变型,即出现拟显性现象,说明染色体缺失区域包含了 fa 基因;如果表型为野生型,说明染色体缺失部分不包含 fa 基因。
三、重复
重复指的是除了正常的染色体组以外,多了一些染色体部分,这种额外的染色体部分叫作重复片段。重复可以发生在同一染色体上的邻近位置,也可在同一染色体的其他地方,甚至还可在其他染色体上。如果一
条染色体有重复的片段,而另一条染色体是正常的,那么在粗线期染色体或唾腺染色体上也会出现一个弧状的结构,不过这时拱出来的一段是重复的片段,因为正常的同源染色体上没有这一段,不能配对,所以就拱了出来。
染色体重复了一个片段,这个额外片段上的基因也随之重复了。重复的遗传学效应比缺失来得缓和,但重复太大,也会影响个体的生活力,甚至引起个体的死亡。
我们在图10-8中已经清楚地表明,在玉米中,“断裂-融合-桥的循环”可以产生缺失,同时也会引起重复。如果重复的片段包括糊粉层色素基因 $C$ ,那么一个核内显性基因的数目就会各种变化,或是一个、两个,或是三个、四个,甚至更多。当基因数目有这样一系列变化的时候,胚乳花斑上的色泽强度往往也出现从浅到深的程度变化,暗示着色泽的深浅可能跟显性基因的数目有对应关系。正常糊粉层中有一个显性基因 $C$ 时,颜色最浅,当突变体细胞有两个显性基因 $C$ 颜色深些,而有3个显性基因 $C$ 时颜色最深,这为我们推断色泽强度和基因数目有对应关系提供了实验依据。
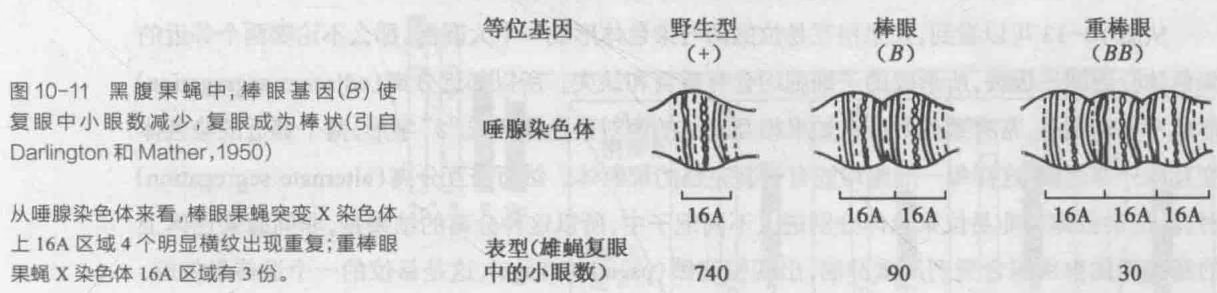
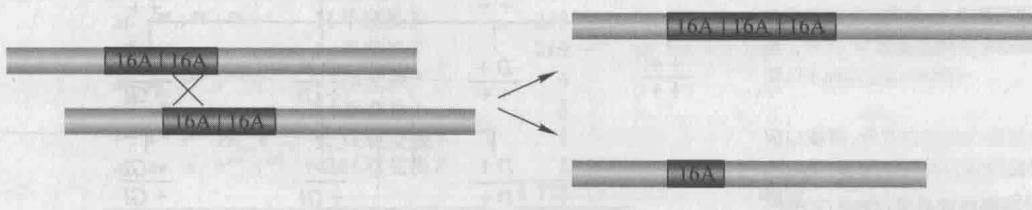
染色体某些区域的重复可以产生特定的表型效应。例如果蝇的显性基因 B(\text{Bar}, \text{棒眼}) 的主要表型效应是使复眼中的小眼数减少,所以复眼呈棒状,而不是正常的卵圆形(见图5-30)。从突变体的唾腺染色体来看,棒眼果蝇的X染色体上16A区的4个明显的横纹发生了重复。纯合的棒眼雌蝇 $(B / B)$ 所产生的子裔中,大约有1/1600的机会复眼极度细小,叫作重棒眼(BB, double bar)。检查这种个体的唾腺染色体,发现16A区域又重复了一次。可见16A区域的重复有累加作用,重复次数增加愈多,复眼中的小眼数减少愈多(图10-11)。
从进化观点来讲,重复是很重要的,因为它们提供了额外的遗传物质,有执行新功能的可能。
四、易位
一条染色体的一段错误连接到一条非同源染色体上去,叫作易位。如果两条非同源染色体互相交换染色体片段,叫作相互易位(reciprocal translocation)。假设一条染色体的顺序是ABCDE,另一条染色体的顺序是LMNO,则相互易位后,可能出现两条新顺序的染色体ABCNO和LMDE(图10-12)。相互易位的两个染色体片段可以是等长的,也可以是不等长的。
易位的细胞学效应比较复杂,我们这里的讨论只限于最常见的相互易位。相互易位的纯合子没有明显的细胞学特征,它们在减数分裂时的配对是正常的,所以跟原来的未易位的染色体相似,可以从一个细胞世代传到另一细胞世代。在易位杂合子中,在粗线期时,由于同源部分的紧密配对,出现了富有特征性的十字形图像。以后随着分裂过程的进行,十字形图像逐渐开放,成为一个圆圈或“8”字形(图10-13)。在相互易位杂合子的花粉母细胞中,大约有50%的配对同源染色体呈圆形,50%呈“8”字形,说明4个着丝粒是随机趋向两极的(图10-13)。
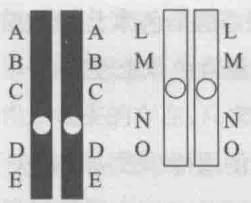
野生型纯合子
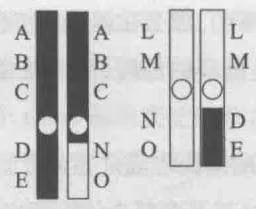
相互易位杂合子
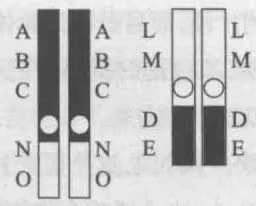
相互易位纯合子
图10-12 易位染色体的纯合子和杂合子
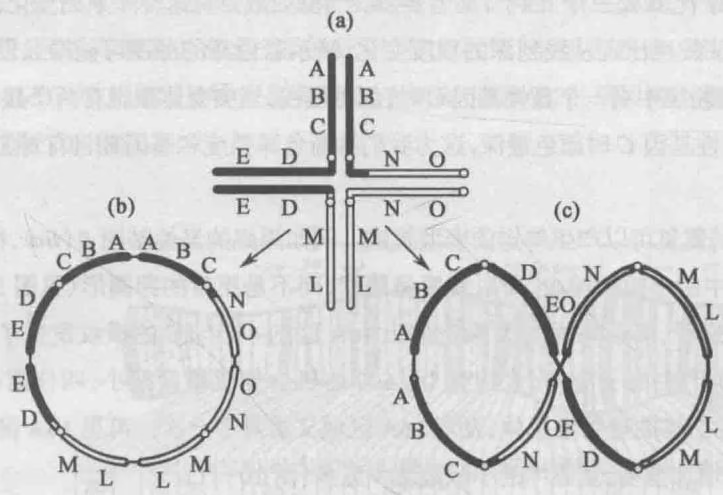
一个相互易位杂合子在粗线期的时候,由于染色体的同源部分相互配对,出现十字形图像(a)。随着分裂过程的前进,十字形图像逐渐开放,到第一次分裂中期时,或形成一个大圆圈(b),或出现一个“8”字形图像(c)。为了简单起见,图像仅用染色体表示,没有将染色单体表示出来。
从图 10-13 可以看到,如果相互易位的两对染色体形成一个大圆圈,那么不论哪两个邻近的染色体分到同一极去,所形成的子细胞均含有重复和缺失。所以邻近分离(adjacent segregation)形成不平衡配子,常有致死效应。如果相互易位的两对染色体形成“8”字形,两个邻近的染色体交互地分向两极,这样每一细胞均能有一套完整的染色体。然而交互分离(alternate segregation)时,易位染色体和非易位染色体分别进入不同配子中,所以这种分离的结果是,非同源染色体上的基因间的自由组合受到严重抑制,出现拟连锁(pseudolinkage),这是易位的一个遗传学效应。这在雄果蝇中尤其清楚,因为雄果蝇没有交换,是完全连锁的。
例如雄蝇的第2和第3染色体的易位杂合子,在非易位的第2和第3染色体上分别带有基因bw(brown eye,褐眼)和e(ebony body,黑檀体)。当易位杂合子雄蝇与纯合的隐性雌蝇回交时,只产生野生型 $(bw / bw^{+}e / e^{+})$ 和双突变体 $(bw / bw e / e)$ ;而单一突变型褐眼 $(bw / bw e / e^{+})$ 、黑檀体 $(bw / bw^{+}e / e)$ 都不会在子裔中出现的。因为它们有缺失和重复,所以不能存活(图10-14)。
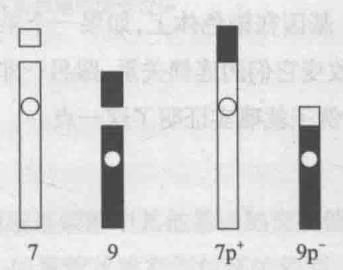
上面已谈到,一个易位杂合子在形成配子时,一部分细胞中的染色体有缺失和重复,换句话说,相互易位可以引起合子的不良遗传效应,甚至死亡。例如在人类中,发现有一个体,除有正常染色体7和正常染色体9外,还有相互易位后形成的一个衍生染色体 $7p^{+}$ 和一个衍生染色体 $9p^{-}$ (图10-15),是一个7/9易位携带者。该个体的遗传物质没有什么缺失和重复,我们称为是平衡的,所以是表型正常的平衡易位携带者(balanced translocation carrier)。但是易位染色体以杂合态存在,影响减数分裂时染色体的正常分离,所以平衡易位携带者除产生平衡配子外,还产生不平衡配子(图10-16)。平衡配子与正常配子结合,形成正常子代个体和平衡易位携带者,而不平衡配在黑腹果蝇中,易位杂合子雄蝇与纯合的隐性雌蝇测交,子代中只出现亲代类型,出现拟连锁现象。
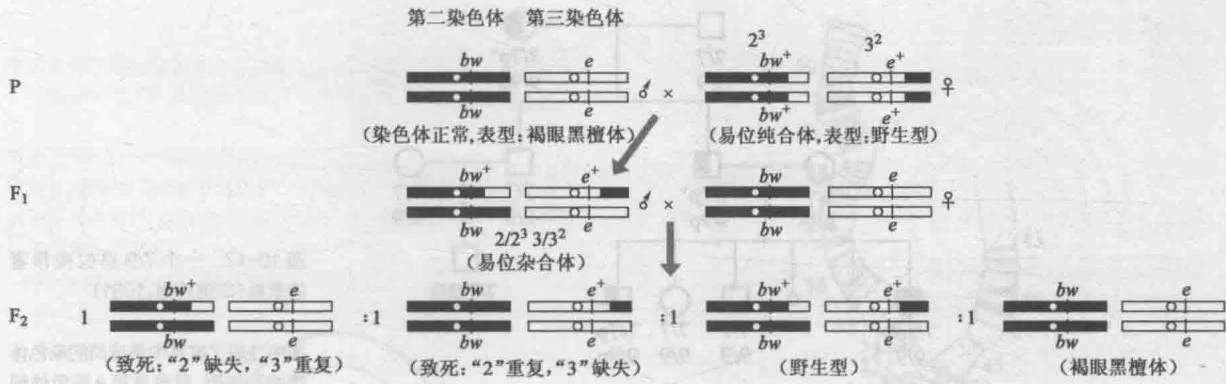
图10-15 人类的7/9染色体相互易位的起源
第7和第9染色体各有一个断裂,都发生在短臂上,但形成的断片长度不等。断片互换并愈合后,形成两个衍生染色体,一个是 $7p^{+}$ (第7染色体短臂长度增加),一个是 $9p^{-}$ (第9染色体短臂长度缩短)。
7/9 易位杂合子可产生 4 型配子,这 4 型配子与正常配子结合,产生的子代可有 4 种类型。
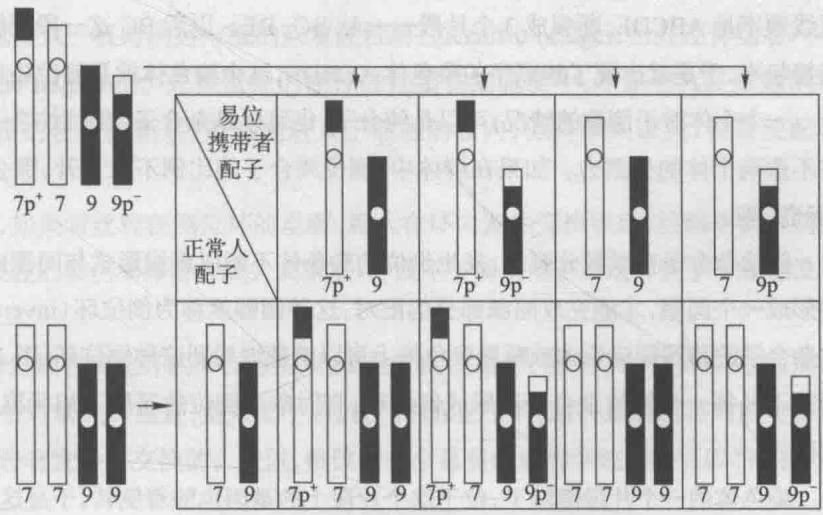
部分三体患者 平衡易位携带者 正常 部分单体患者
子与正常配子结合,形成有重复的个体和有缺失的个体。带有重复的个体是9号染色体部分三体,遗传物质不平衡,出现染色体病(chromosomal disease),患者具有多重畸形,智力严重迟钝;而带有缺失的个体是第9染色体部分单体,未被发现,可能早期流产。图10-17是第9染色体部分三体患者的一个家系。因为平衡易位携带者虽然表型正常,但结婚后有可能生育染色体病患儿,所以夫妇一方为平衡易位携带者时,应进行产前诊断,检查胎儿的染色体组成,以防止患儿的出生。
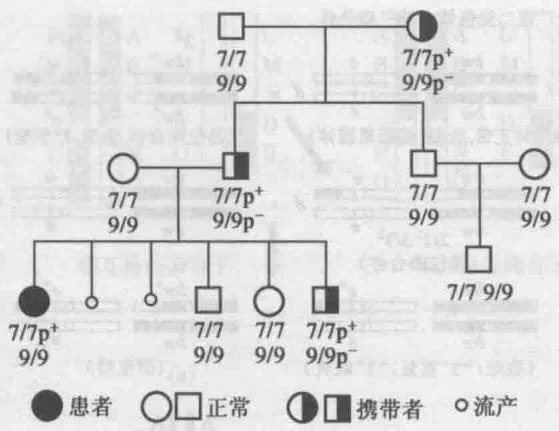
图中注明了家系中各成员的染色体结构和表型,患者是第9染色体部分三体。
相互易位的另一个遗传学效应是配子的部分不育(partial sterility)。例如把易位杂合子的玉米的花粉放在显微镜下观察,大约有一半的花粉特别小,经染色后,看不到淀粉的内含物。这些花粉粒之所以不育,也是因为由于邻近分离,它们含有的染色体带有重复和缺失的缘故。
易位还会改变非等位基因的连锁关系。基因在染色体上,如果一个染色体片段搭到另一非同源染色体上,那么这个片段上的基因就要改变它们的连锁关系,跟另一非同源染色体上的基因相互连锁了。我们在后面要讲的家蚕易位的例子就确实证明了这一点。
视频11染色体相互易位
五、倒位
一个染色体片段断裂了,倒转 $180^{\circ}$ ,重新又搭上去,这个现象叫作倒位。例如一条染色体的直线顺序是 ABCDE,断裂成 3 个片段——A、BC、DE。以后 BC 这一段倒转 $180^{\circ}$ ,又跟 A 和 DE 连接起来,于是就出现了新顺序的染色体 ACBDE,这个染色体就是倒位染色体(图 10-18)。
一个个体对于倒位的情况,可以是纯合子,也可以是杂合子。倒位纯合子一般是完全正常的,并不影响个体的生活力。如果在群体中,倒位纯合子的比例不断上升,那么很可能倒过来,成为“标准”型。
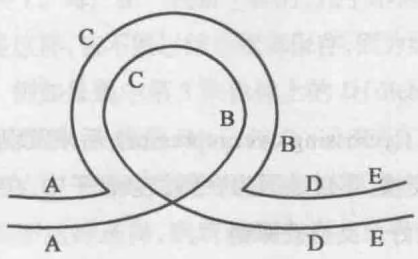
倒位杂合子在减数分裂时,发生倒位的染色体不能以直线形式与同源染色体进行配对,通常要形成一个圆圈,才能完成同源部分的配对,这种圆圈就称为倒位环(inversion loop)。从一个倒位杂合子的粗线期染色体或唾腺染色体上可以清楚地看到这种倒位环(图10-19、图10-20)。然而并不是每一个倒位杂合子都形成倒位环,有时单是倒位的区段不和标准顺序的同源部分配对而已。
染色体的一个片段倒转了,位于这个片段上的基因也随着倒转,于是这些基因在连锁群中的
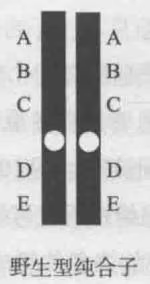
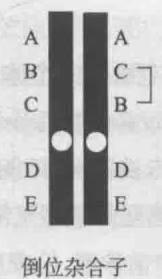
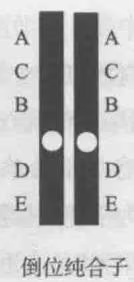
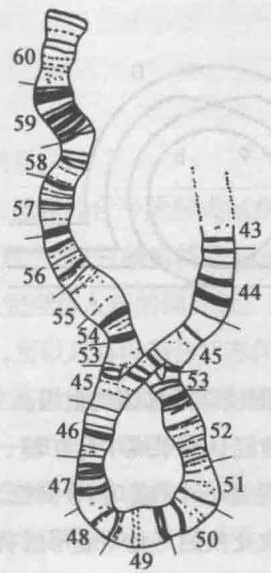
图上的数字是唾腺染色体上横纹的号码,从号码上可以看出,倒位部分包括横纹45号到53号。
顺序改变了,这些基因跟连锁群中其他基因的交换值也改变了。
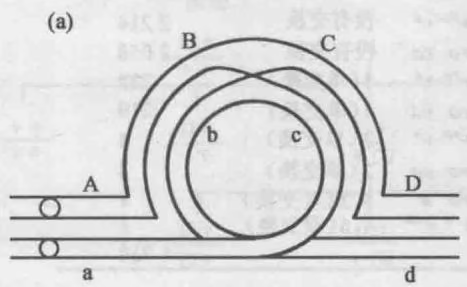
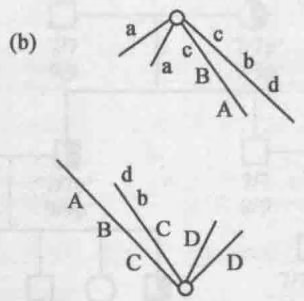
一个倒位杂合子,如果着丝粒在倒位环的外面,那么在减数分裂后期Ⅰ时,有时会出现一种特殊的图像,叫作“桥和断片”。如图10-21,由于在倒位环内发生了一个交换,产生一条有两个着丝粒的染色单体,成为从一极跨向另一极的双着丝粒桥(dicentric bridge),另外还伴随着一个无着丝粒断片(acentric fragment)。无着丝粒的断片往往留在细胞质中,不能进入子细胞的核内,而有着两个着丝粒的桥被拉断后,虽然能进入子细胞的核内,但有很大缺失,往往使配子死亡。
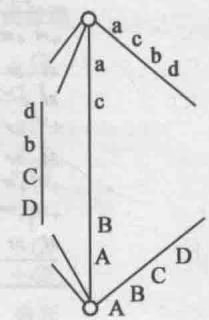
一个倒位杂合子,如果着丝粒在倒位环的里面,那么在环内发生交换以后,虽然不会出现桥和断片,但也会使交换过的染色单体带有缺失或重复,形成不平衡的配子。这种配子一般也没有生活力(图 10-22)。
这样看来,不论着丝粒在倒位环的外面,还是在倒位环的里面,只要在环内有交换发生,那么交换过的染色单体都带有缺失和重复,进入配子后,往往引起配子的死亡,最后所得到的可存活配子几乎都是在环内没有发生过交换的。所以,倒位的一个重要的遗传学效应是可以“抑制”或
图 10-21 着丝粒在倒位环外面的倒位杂合子在倒位环内部发生交换,产生“桥和断片”
(a)一个倒位杂合子在减数分裂前期时,形成一个倒位环,着丝粒在倒位环的外面,环内发生一个交换。(b)在后期时,两个染色单体是正常的(ABCD和acbd),另外两个染色单体发生交换,成为双着丝粒桥(ABca)和无着丝粒断片(dbCD)。
(b)
(a)
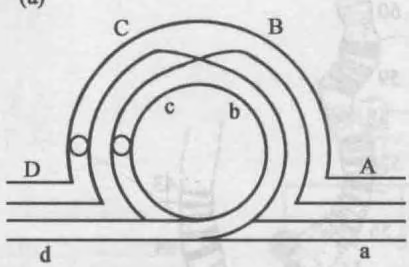
(a) 一个倒位杂合子在减数分裂前期时,形成一个倒位环。着丝粒在倒位环的里面,环内发生一个交换。(b) 在后期时,两条染色单体是正常的(ABCD 和 acbd),另外两条染色单体发生交换,都带有缺失和重复(ABca 和 dbCD)。
大大地“降低”倒位环内基因的重组。
遗传学家曾经认为果蝇中存在着一种交换抑制因子(C, crossing over repressor), 后来发现该类因子本身不过是一个(或几个)倒位。而所谓“抑制”交换, 不过是因为在倒位杂合子中, 在倒位环内发生单次交换的产物不能形成有活力的配子, 因而好像交换被抑制了。
例如果蝇有一倒位品系,CⅢB,在第3染色体上有一倒位,但外观上是野生型。另有一纯合突变品系,第3染色体正常,突变基因是 st(\text{scarlet},\text{猩红眼}), sr(\text{stripe},\text{条纹胸}), e(\text{ebony},\text{黑檀体}), ro(\text{rough},\text{毛糙眼}) 和 ca(\text{claret},\text{紫红眼}) 。把这两品系杂交, $F_1$ 杂合子雌蝇回交纯合突变品系,如图10-23所示。在 $e - ro$ 区域以及 $ro - ca$ 区域没有单交换个体出现,表明倒位包括了这个区域。而倒位附近的 $sr - e$ 间,单交换数也降低很多,由预期的 $8%$ 降低到 $0.15%$ ,说明倒位可能部分地伸展到这个区域。离开倒位稍远,在 $st - sr$ 间,交换值降低,由预期的 $18%$ 减到 $9.6%$ ,然而还是很高,说明这个区域在倒位区以外。只发现有两个不寻常的基因型 $+^{st} +^{sr} +^{ca} ro e; st sr e +^{ro} +^{ca}$ ,可用倒位区内的双交换来说明,因为倒位区内两线双交换所形成的产物没有重复和缺失,是正常的。这一例子说明,倒位可以大大地降低倒位环内基因的重组。
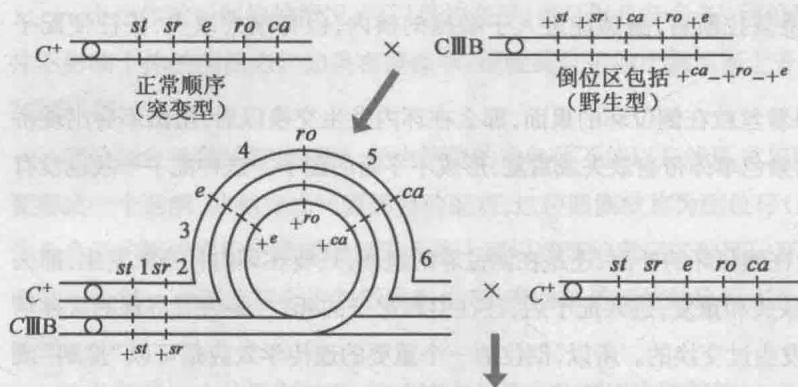
| 回交后裔 | 交换区域 | 数目 |
| $+^{st} +^{sr} +^{ca} +^{ro} +^{e}$ | 没有交换 | 2 214 |
| st sr e ro ca | 没有交换 | 2 058 |
| st $+^{sr} +^{ca} +^{ro} +^{e}$ | 1(单交换) | 238 |
| $+^{st} sr e ro ca$ | 1(单交换) | 219 |
| st sr $+^{ca} +^{ro} +^{e}$ | 2(单交换) | 4 |
| $+^{st} +^{sr} e ro ca$ | 2(单交换) | 3 |
| $+^{st} +^{sr} +^{ca} ro e$ | 5,3(双交换) | 1 |
| st sr e $+^{ro} +^{ca}$ | 4,6(双交换) | 1 |
| 4 738 | ||
图 10-23 黑腹果蝇的 st、sr、e、ro、ca 纯合突变品系的雄蝇 C+ 与基因顺序为 +st、+sr、+ca、+ro、+e 的倒位纯合子雌蝇 CⅢB 杂交结果 (Sturtevant, 1926)
可以看到,所有的交换产物基本上都在倒位区以外,可见倒位可以抑制倒位区内基因的重组。
六、平衡致死系
利用倒位的交换抑制效应,可以保存带有致死基因的品系。
带有致死基因的品系本来是不容易保存的。一般品系都以纯合子的形式保存下来,因为纯合子是真实遗传的。例如果蝇的白眼品系,在实验室培养瓶中,每只雌蝇都是w/w,每只雄蝇都是w/Y。每产生一代新个体时,几乎不需要逐只观察,可以完全移入新的饲养瓶。但致死基因就不是这样,它不能以纯合状态保存,因为纯合个体是致死的,所以只有以杂合状态保存。
例如果蝇中第3染色体上的 $D$ (dichaete, 展翅) 是显性基因, 但也是隐性致死基因。要培养这个品系, 只能把 D / + \text{♀} 与 D / + \text{♂} 交配, 下一代是 $2/3 D / +, 1/3 + / +$ (理应是 $1:2:1$ , 但 $D / D$ 个体死亡)。在保存这个品系时, 必须逐个观察每代个体, 把 $+ / +$ 个体淘汰, 只让 $D / +$ 个体留种。如果不这样选择, 则培养瓶中必然进行着自然选择。因为 D / + \text{♀} \times D / + \text{♂} 所产生的子代数只有 + / + \text{♀} \times + / + \text{♂} 所产子代数的 $75%$ , 所以如果不把 $+ / +$ 个体人工淘汰, 则饲养瓶中 $D / +$ 个体比例必然逐代降低, 几代之后饲养瓶中就主要是 $+ / +$ 个体, 而很少 $D / +$ 个体, 也就是说, $D$ 这个基因“遗失”了, 再也找不回来, 无法再对它进行研究 (例如要把 $D$ 在连锁图上定位, 在唾腺染色体图上定位, 研究它的致死作用的生理机理等)。
但是为了保存致死基因,每一代都要逐个观察是极费人力和时间的,在保存果蝇品系较多的遗传学实验室中这个问题尤其严重。摩尔根的学生马勒想出一个巧妙的办法,就是用另一致死基因来“平衡”待保存的致死基因,不过这第二个致死基因与第一个致死基因之间必须不发生交换重组才行。
例如可用 Gl(glued, 黏胶眼) 来 “平衡” D 基因。Gl 也是第 3 染色体上的显性基因,但纯合致死。把 D 个体与 Gl 个体交配,挑选后代中既表现 D 又表现 Gl 的雌雄个体传代,后代全是 D+/+Gl,而不会有分离(图 10-24)。
其实并不是真的不分离,而是分离出来的纯合个体全部致死而已。这种永远以杂合状态保存下来,不发生分离的品系,叫作永久杂种(permanent hybrid),也叫作平衡致死系统(balanced lethal system)。
不过 D 与 Gl 之间必须不发生交换才行。因为一旦发生交换,则除了 DGl 染色体之外,还有 ++ 染色体,则后代中就会出现 ++/++ 个体;几代之后就又会把 D 和 Gl 这两个基因都淘汰掉。好在 D 与 Gl 两者在连锁图上位置极近,两者间几乎没有交换。可是并不是每个致死基因都能由它附近另一个致死基因来平衡的。利用倒位可以很好地解决这个问题。例如果蝇第 2 染色体上倒位品系 Cy(curly, 翻翅)在ⅡL(第2染色体左臂)有个倒位, 在ⅡR(第2染色体右臂)也有个倒位, 几乎可把整个第2染色体的交换全部抑制。而 Cy 的纯合是致死的, 因此第2染色体上任何致死基因都可用 Cy 来平衡。
 |
所以要保持一个平衡致死系统,必须满足下面两个条件:①一对同源染色体的两个成员各带有一个基因座不同的隐性致死基因。②这两个非等位的隐性致死基因始终处于两条同源染色体上。要满足第二个条件,通常要有一个“交换抑制因子”,使两个非等位的致死基因不致由于交换而分布在一个染色体上,倒位正是这样一个交换抑制因子。
视频12染色体倒位
七、染色体结构变异的发生机制
细胞内是如何产生不同类型的染色体变异的?当下的遗传学家还在继续研究这个问题。我们在这里先介绍两种主要的染色体结构变异产生机制——非等位同源重组(nonallelic homologous recombination, NAHR)和非同源末端连接(non-homologous end joining, NHEJ)。
前面已经提到,纯合棒眼果蝇的子裔中有一定比例的重棒眼果蝇,它的唾腺染色体上出现了三拷贝的16A区重复。这种重复的产生是因为在纯合棒眼果蝇的配子生成过程中,非等位的棒眼基因之间发生了交换,得到了一条含有三拷贝16A的染色体(图10-25)。研究者最早将这种在同源染色体联会时发生差错,在不完全对等的位置上发生交换,称为不等交换(unequal crossover),现在称为NAHR。NAHR可以发生在减数分裂和有丝分裂的过程中,它是包括染色体重复在内的各类染色体结构变异的重要产生机制之一。发生NAHR的前提是染色体非等位的基因座上存在高度同源的较长的DNA序列(例如基因组内的低拷贝重复,我们将在基因组一章进行介绍),这是同源重组的结构基础。
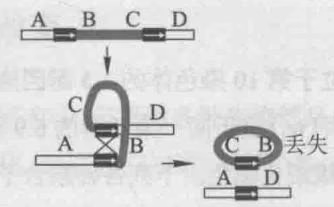
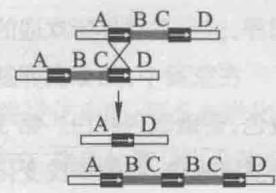
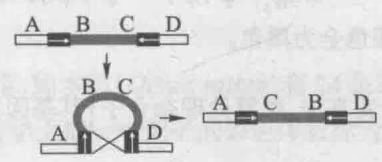
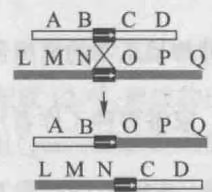
我们利用图 10-26 进行细致的说明。假定有两条染色体,染色体 1 的直线顺序是 ABCD,染色体 2 的直线顺序是 LMNOPQ。如果在染色体 1 的 AB 和 CD 之间有一对正向重复的 DNA 序列,发生在重复序列之间的 NAHR 可以造成染色体(BC 片段)缺失(10-26a)。发生在两条同源染色体的非等位的重复序列之间的 NAHR 可以造成一条染色体(BC 片段)重复和一条染色体(BC 片段)缺失(10-26b)。如果在染色体 1 的 AB 和 CD 之间有一对反向重复的 DNA 序列,那么发生在重复序列之间的 NAHR 可以造成染色体倒位(BC 区域颠倒)(10-26c)。如果在染色体 1 的 BC 之间和染色体 2 的 NO 之间有一对正向重复的 DNA 序列,那么发生在重复序列之间的 NAHR 可以造成染色体相互易位,形成两条衍生染色体,直线顺序分别为 ABOPQ 和 LMNCD(10-26d)。
除了 NAHR, NHEJ 是另一种重要的染色体结构变异的产生机制。这种机制发生的前提是染色体发生了双链断裂。但如果断裂能够被正确修复,也不会产生变异。只有当断裂后发生了
(a) NAHR诱导的缺失
(c) NAHR诱导的倒位
(b) NAHR诱导的重复与缺失
(d) NAHR诱导的易位
(e) NHEJ诱导的缺失
(f) NHEJ诱导的重复与缺失
1 | \begin{array}{c} \text { A } \xrightarrow {\text { B }} \text { C } \text { D } \\ \text { 丢失 } \\ \text { A } \text { D } \end{array} |
(g) NHEJ诱导的倒位
(h) NHEJ诱导的易位
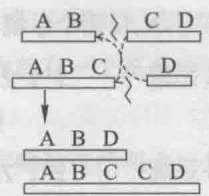
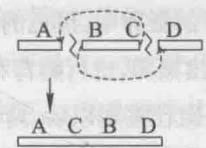
图10-26 染色体结构变异形成的两种常见机制
表示重复 DNA 片段; \times 表示同源重组; \times 表示染色体断裂; $\rightarrow$ 表示断点连接。
1 | \begin{array}{c} \text {A B C D} \\ \text {LMN O P Q} \\ \text {A B O P Q} \\ \text {LMN CD} \end{array} |
错误的修复,才能产生染色体结构变异。NHEJ正是这样一类错误倾向性的DNA修复方式。我们仍然以染色体ABCD和染色体LMNOPQ为例。如果在染色体1的AB和CD之间各发生一个DNA双链断裂,非同源的A末端和D末端可能发生NHEJ形成AD片段,造成染色体(BC片段)缺失(10-26e)。在染色体1的两条同源染色体的非等位位置上各发生了一个DNA双链断裂(一个在BC间,一个在CD间),同源染色体的非同源末端相连,形成了缺失染色体ABD和重复染色体ABCCD(10-26f)。如果在染色体1的AB和CD之间各发生一个DNA双链断裂,丢失的BC片段颠倒180°后,非同源的A末端和C末端相接,B末端和D末端相接,就造成染色体倒位(ACBD)(10-26g)。如果在染色体1的BC之间和染色体2的NO之间各产生了一个DNA双链断裂,非同源染色体的非同源末端发生了连接,就形成了衍生的易位染色体ABOPQ和LMNCD(10-26h)。
除了 NAHR 和 NHEJ, 复制叉停顿和模板转换 (fork stalling and template switching, FoSTeS) 以及我们将在后续章节介绍的反转录转座 (retrotransposition) 也是结构变异的形成机制, 我们在此暂不作介绍。总之, 染色体结构变异的产生与多样化的形成机制密不可分。
八、染色体结构变异在育种上的应用
染色体结构变异已被应用到生产上。例如养蚕业中,希望利用雄蚕进行生产,因为雄蚕的桑叶利用率高,还有单用雄蚕的茧缫丝,可以提高生丝质量。所以如有一个办法,单是选出雄蚕来饲养,这是蚕丝界所欢迎的。
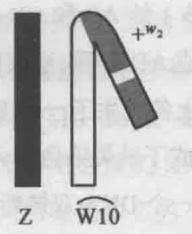
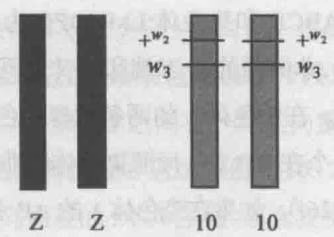
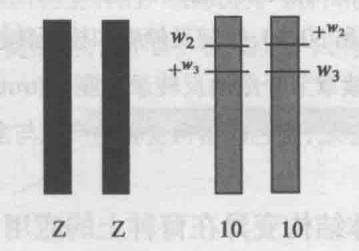
在家蚕中,第2白卵基因 $(w_{2})$ 位于第10染色体的3.5基因座上。纯合子的卵在越冬时呈杏黄色,蚕蛾眼色纯白。第3白卵基因 $(w_{3})$ 位于同一染色体的6.9基因座上,纯合子的卵在越冬时呈淡黄褐色,卵色深浅变化较大,蚕蛾眼色黑色。下列各种杂合子
1 | \frac {w _ {2} + ^ {w _ {3}}}{+ ^ {w _ {2}} w _ {3}}, \frac {+ ^ {w _ {2}} w _ {3}}{+ ^ {w _ {2}} + ^ {w _ {3}}} \text {和} \frac {w _ {2} + ^ {w _ {3}}}{+ ^ {w _ {2}} + ^ {w _ {3}}} |
的卵都呈正常的紫黑色,蚕蛾眼色全为黑色。
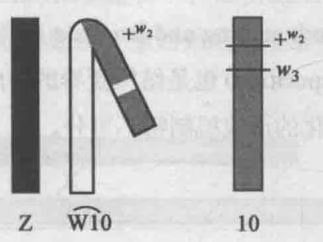
家蚕育种工作者用辐射诱变方法, 反复处理杂合子 \left(\text{其基因型经推定为 }\frac{w_{2}+^{w_{3}}}{+^{w_{2}}w^{3}}\right) ,通过严格选择,先使第 10 染色体产生缺失,缺失的片段或者包括 $w_{2}$ 座位,或者包括 $w_{3}$ 座位,并使有缺失的第 10 染色体易位到 W 染色体上,再经过系统选育,使生活力逐渐提高,以适应饲养的要求,终于育成了 A, B 两个系统:
A 系统
1 | \begin{array}{c c} \text { ♀ ♀ } & Z W + ^ {w _ {2}} / w _ {2} + ^ {w _ {3}} \\ & \text { 卵黑色 } \end{array} \begin{array}{c c} \text { ♂♂ZZw } _ {2} + ^ {w _ {3}} / w _ {2} + ^ {w _ {3}} \\ & \text { 卵杏黄色 } \end{array} |
B 系统
1 | \begin{array}{c c} \text { ♀ ♀ } & \widehat {\mathrm{ZW} ^ {+ w _ {3}} / + ^ {w _ {2}} w _ {3}} \\ & \text { 卵黑色 } \end{array} \begin{array}{c c} \text { ♂♂ZZ } ^ {+ w _ {2}} w _ {3} / + ^ {w _ {2}} w _ {3} \\ & \text { 卵淡黄褐色 } \end{array} |
如将 A 系统雌蛾与 B 系统雄蛾交配, 所产的蚕卵中, 黑色的全为雄性, 淡黄褐色的全为雌性 (图 10-27)。然后通过电子光学自动选别机选出黑卵, 进行孵育和饲养。比较黑卵和淡色卵孵化的蚕强健性, 在稚蚕期, 淡色卵的强健度稍差, 但壮蚕期以后, 两者之间没有本质性的差异, 所以有希望用到生产上。至于 B 系统的雌蛾与 A 系统的雄蛾交配, 下一代基因型和表型怎样, 请读者自己去演算。
黑色卵♀
淡黄褐色卵。
1 | Z W + ^ w _ 2 / w _ 2 + ^ w _ 3 |
$$
Z Z + ^ {w _ {2}} w _ {3} / + ^ {w _ {2}} w _ {3}
$$
淡黄褐色卵 ♀ ♀
1 | Z W + ^ w _ 2 / + ^ w _ 2 w _ 3 |
黑色卵
$$
Z Z w _ {2} + ^ {w _ {3}} / + ^ {w _ {2}} w _ {3}
$$
图 10-27 利用染色体的缺失和易位,育成家蚕的性别自动鉴别品系
它们产下的卵中, 黑色卵是雄性的, 黄褐色卵是雌性的。
第二节 染色体数目的改变
各种生物的染色体数目有多有少,但既然各种生物都是由共同祖先进化来的,那么在进化过程中染色体数目一定在发生变化。现在我们知道,不仅染色体结构会改变,染色体数目也会改变。
一、染色体数目变异的分类
各种生物的染色体数目恒定,如水稻(Oryza sativa)有24条染色体,配成12对,形成的正常配子都含有12条染色体。遗传学上把一个配子的染色体数称为染色体组(genome)。此术语是德国遗传学家温克勒(Hans Winkler, 1877—1945)在1920年提出的,原意是整套染色体及其基因。现在,genome又译作基因组,指的是单倍体配子中携带的全部遗传物质,包括全部基因及基因外序列,详见基因组一章),用 $n$ 表示。一个染色体组由若干染色体组成,它们的形态和功能各异,但又互相协调,共同控制生物的生长和发育、遗传和变异。每个生物都有一个基本的染色体组,如玉米 $n = 10$ ,兔子(Oryctolagus cuniculus) $n = 22$ ,黑腹果蝇 $n = 4$ 等。
知道了染色体组的含义以后,我们就可以导出整倍数改变和非整倍数改变的概念。凡是体细胞细胞核中含有一个完整染色体组的,就叫作单倍体(haploid),如蜜蜂(Apis mellifera)的雄蜂,n=16;含有两个染色体组的叫作二倍体,如人(Homo sapiens)2n=46;含有3个染色体组的叫作三倍体(triploid),如三倍体西瓜,3n=33,依此类推。这类染色体数的变化是以染色体组为单位的增减,所以称作倍数性改变,这类生物个体称为整倍体(euploid)。超过两个染色体组的,统称多倍体(polyploid)。另一类发生变化的染色体数不是完整的倍数,通常以二倍体(2n)染色体数作为标准,在这基础上增减几个染色体,称为非整倍性改变,该类生物个体属于非整倍体(aneuploid)。例如2n-1是单体(monosomy),2n-2是缺体(nullisomy),2n+1是三体(trisomy)等。常见的染色体数目变异,可按表10-3分类。
表 10-3 染色体数目变异的一些基本类型
| 类型 | 公式 | 染色体组 |
| 整倍体 | ||
| 单倍体 | n | (ABCD) |
| 二倍体 | 2n | (ABCD)(ABCD) |
| 三倍体 | 3n | (ABCD)(ABCD)(ABCD) |
| 同源四倍体 | 4n | (ABCD)(ABCD)(ABCD)(ABCD) |
| 异源四倍体 | 4n | (ABCD)(ABCD)(A'B'C'D')(A'B'C'D') |
| 非整倍体 | ||
| 单体 | 2n-1 | (ABCD)(ABC) |
| 三体 | 2n+1 | (ABCD)(ABCD)(A) |
| 四体 | 2n+2 | (ABCD)(ABCD)(AA) |
| 双三体 | 2n+1+1 | (ABCD)(ABCD)(AB) |
| 缺体 | 2n-2 | (ABC)(ABC) |
注:A、B、C、D代表4条非同源染色体。
单倍体只含有一个染色体组,所以只存在单套的基因。单倍体可以是正常的或异常的。如一些低等植物的配子体和一些昆虫的雄体(如蜂类等膜翅目昆虫),都是正常的单倍体。正常单倍体形成的配子仍为单倍体,这是因为在进化过程中它们的减数分裂过程已有了变化:把减数分裂I省略了,所以形成的配子仍为单倍体。但本来是二倍体的生物成为单倍体后,情况就不是这样。在中期I时,它们的染色体是单价体,没有可以配对的同源染色体,从而被随机分向两极,形成的配子是高度不育的。因为每一染色体分到这一极或那一极的机会都是1/2,所有染色体都分到一极的机会就是 $(1/2)^{n-1}$ ,这里n等于单倍染色体数。如玉米n=10,单倍体植株只有 $(1/2)^{9}=1/512$ 的机会产生一个n=10的有效配子,可见育性是很低的。
现在广泛地应用花药培养法来获得单倍体植株。单倍体自发的或经人工处理,可成为二倍体,该二倍体的全部基因都是纯合的,自交的后代不会分离。如果利用近交的方法来培育纯系,要经过很多代才能获得。利用单倍体植株,再经加倍,则要快得多,而且全是纯合的,所以是一条可利用的育种捷径。
但花药培养产生单倍体的技术并不是对所有生物或所有基因型都适用的。近来对一种重要作物——大麦开发出另一种有用技术。当二倍体大麦(Hordeum vulgare)用二倍体野生近缘种H. bulbosum授粉时,虽然也发生受精,但在随后体细胞分裂时,可能出于不同物种的染色体间的遗传不亲和性,H. bulbosum的染色体率先从合子细胞中被排除,结果形成的胚胎是单倍性的。单倍性胚胎经秋水仙碱处理后可以加倍,得到二倍体植株。应用这一新技术已育成了一些大麦新品种,而且这技术还成功地推广到其他一些作物上。
三、同源多倍体
染色体已经复制,而细胞质不分离,可形成同源多倍体(autopolyploid),未减数分裂的配子相互结合,也可发育成多倍体。在同源多倍体中,所有的基因仍和原来的一样,只不过相同基因座上的基因拷贝数增加了而已。同源多倍体的可育性不高,例如在同源四倍体中,同样的4条染色体,在减数分裂I时,要两条分向一极,两条分向另一极,才可产生平衡的可育配子。少数同源四倍体可以正常繁殖,如四倍体曼陀罗(Datura stramonium)(4n=48),减数分裂I时形成12个四价体,每个四价体中的两条分向一极,两条分向另一极,所以形成的配子是可育的;又如四倍体番茄(4n=48),每个花粉母细胞几乎全是双价体,只有少数四价体,所以形成的配子大都也是可育的。
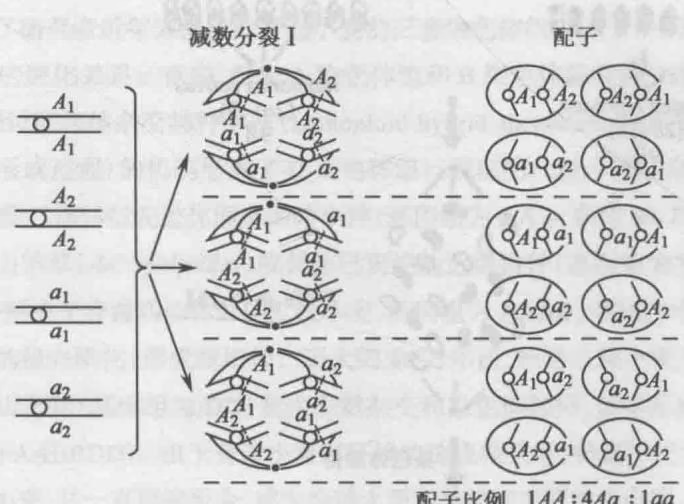
四倍体的基因分离比较复杂。对一对基因 A/a 来讲,二倍体只有一种杂合子,即 Aa;四倍体却有 3 种杂合子,即 AAAa(三显体,triplex),AAaa(二显体,duplex)和 Aaaa(单显体,simplex)。假定 4 条同源染色体在减数分裂后期 I 时两两分离,染色体随机组合,则对一个基因座来讲,各种杂合子所产生的配子比例以及自交时后裔的表型比例如表 10-4。
我们现在以二显体(AAaa)为例,用图10-28详细说明。四倍体与二倍体杂交可以得到三倍体。三倍体多为同源三倍体(autotriploid),具有3个相同的染色体组。同源三倍体的育性很低,问题同样牵涉到减数分裂时染色体的配对和分离。3条同源染色体在第一次分裂前期时,或组成一个双价体和一个单价体,或组成一个三价体。在后期时,双价体分离正常,单价体一般随机进入两极中的一极;三价体一般是两条进入一极,一条进入另一极。所以如用 $a_{1}$ 、 $a_{2}$ 和 $a_{3}$ 代表3条同源染色体,那么分离方式不外乎下列3种:
表 10-4 同源四倍体的各种杂合子的配子比例和自交后裔的表型比例
| 基因型 | 配子比例 | 自交后裔的表型比例(假定只要有一个A基因,就可产生A表型) |
|---|---|---|
| AAAa | 1AA:1Aa | 全部A |
| AAaa | 1AA:4Aa:1aa | 35A:1a |
| Aaaa | 1Aa:1aa | 3A:1a |
$$
\frac {\mathrm{a} _ {1} + \mathrm{a} _ {2}}{\mathrm{a} _ {3}} \quad \frac {\mathrm{a} _ {1} + \mathrm{a} _ {3}}{\mathrm{a} _ {2}} \quad \frac {\mathrm{a} _ {2} + \mathrm{a} _ {3}}{\mathrm{a} _ {1}}
$$
结果得到平衡配子(2n或n)的机会只有 $(1/2)^{n-1}$ ,而绝大多数配子的染色体数在2n与n之间,是不平衡的,形成平衡合子的机会自然更少了,所以同源三倍体是高度不育的。例如同源三倍体的香蕉(Musa nana)(3n=33)、黄花菜(Hemerocallis fulva)(3n=33)、水仙(Narcissus tazetta)(3n=30)等都没有种子,只能依靠营养体来繁殖。
多倍体植株比起二倍体来,因为染色体数增多,所以细胞的体积要大些。多倍体植株的一般特征是茎粗、叶大、花大、果实大,但往往生长慢,矮生,成熟也较迟。
多倍体在动物中比较少见。这是因为动物大多数是雌雄异体,染色体稍微不平衡,容易引起不育,甚至使个体不能生活。多倍体个体通常只能依靠无性生殖来维持。例如甲壳类中,有一种丰年鱼(Artemia salina),二倍体个体(2n=42)进行两性生殖,而四倍体个体(4n=84)由单性生殖来繁殖。不过在这个例子中,有84条染色体的个体是否是同源四倍体,还有待于进一步实验的证明。此外,在蝾螈、蛙以及家蚕等物种中都发现过三倍体和四倍体,不过还没有听说这些三倍体可以一代代维持下去的。
| 同源四倍体的自交 | 1AA | 1AAAA | 4AAAAa | 1AAaa | |
| 4Aa | 4AAAAa | 16AAaa | 4Aaaa | ||
| 1aa | 1AAaa | 4Aaaa | 1aaaa |
四、异源多倍体
两个不相同的种杂交, 它们的杂种再经过染色体加倍, 就形成了异源多倍体 (allopolyploid)。一个有名的例子就是萝卜甘蓝 (Raphanobrassica), 萝卜 (Raphanus sativus, 2n=18) 和甘蓝 (Brassica oleracea, 2n=18) 杂交, 所得的杂种是 2n=18 (图 10-29)。这两个亲本属于十字花科中不同的属, 是比较远缘的, 萝卜的染色体和甘蓝的染色体之间没有对应性, $F_1$ 杂种在减数第一次分裂时, 形成 18 个单价体 (18 I)。后期时单价体的分离完全随机, 非常不规则, 因此 $F_1$ 所产生的配子几乎全部不育。但这种杂种偶尔结了少数几粒种子, 发芽后, 有一棵植株长得株形很大, 叶像甘蓝, 根像萝卜, 而且是可育的。检查它的染色体, 发现是 2n=36。如果把萝卜的 9 条染色体写作 R, 甘蓝的 9 条染色体写作 B, 那么 $F_1$ 杂种可写作 RB, 而可育的 $F_2$ 显然是由 $F_1$ 的染色体加倍而成, 可写作 RRBB。 $F_2$ 在减数分裂时, R 与 R 配对, B 与 B 配对, 形成 18 个双价体 (18 II), 后期时分离正常, 每个配子都得到 18 条染色体, 其中 9 条是 R, 9 条是 B, 所以是可育的。像这样的四倍体, 它的染色体来自两个不相同的种, 叫作异源四倍体。
异源多倍体在自然界中是比较多见的。在栽培作物中,普通小麦(Triticum aestivum)、陆地棉(Gossypium hirsutum)、海岛棉(Gossypium barbadense)、胜利油菜(Brassica napus)、烟草(Nicotiana tabacum)等都是异源多倍体。要证明某一个现有的种是异源多倍体,先做染色体组分析,然后根据分析结果,利用人工杂交重新合成这个种。
自然界中有一些种的染色体数目组成某种“多倍系列”。例如小麦属(Triticum)中,一粒小
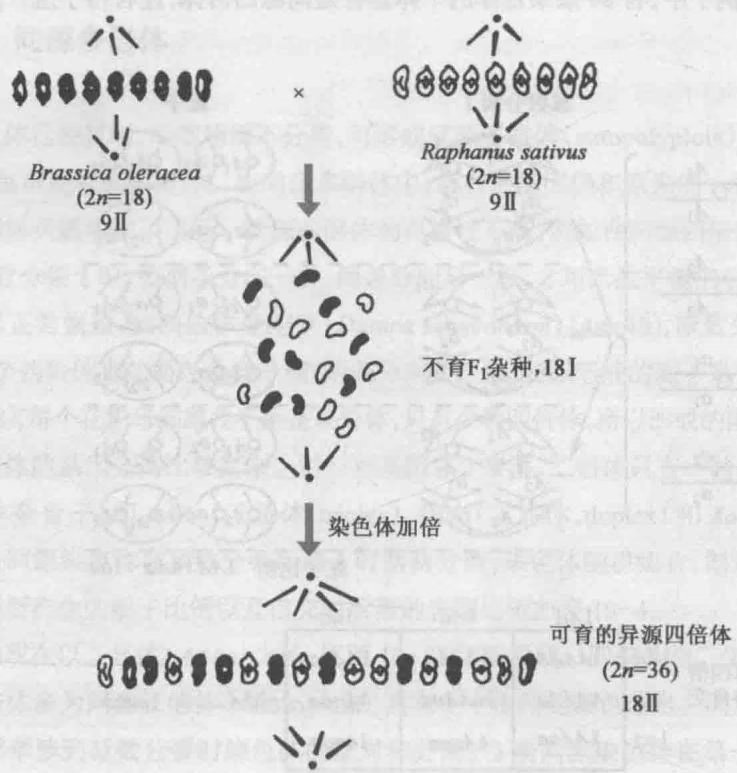
萝卜与甘蓝杂交, $F_{1}$ 杂种不育,减数分裂中期Ⅰ时只形成18个单价体。染色体数加倍后,形成可育的异源四倍体,减数分裂中期Ⅰ时形成18个双价体。
麦(T. monococcum)的染色体数是14,二粒小麦(T. turgidum ssp. dicoccoides)的染色体数是28,而普通小麦(T. aestivum)的染色体数是42,可分别把它们看作二倍体、四倍体和六倍体。所谓染色体组分析,就是将所要分析的多倍体的种和比它倍数低的种(尤其是二倍体种)进行杂交,然后观察杂种减数分裂中染色体配对情况。例如,为了分析普通小麦的染色体组,在小麦属和山羊草属(Aegilops)内几个有关种之间进行杂交,结果见表10-5。
表 10-5 小麦属和山羊草属的几个种间杂种在减数分裂中期 I 时的染色体配对情况
| 亲本组合 | 杂种染色体数 | 配对情况 | 推定的染色体组 |
|---|---|---|---|
| T. monococcum × T. turgidum | 21 | 7II+7I | AAB |
| T. monococcum × T. aestivum | 28 | 7II+14I | AABD |
| T. turgidum × T. aestivum | 35 | 14II+7I | AABBD |
| T. turgidum × Ae. tauschii | 21 | 21I | ABD |
| T. monococcum × Ae. tauschii | 14 | 14I | AD |
| Ae. tauschii × T. aestivum | 28 | 7II+14I | ABDD |
| T. turgidum × Ae. speltoides | 21 | 7II+7I | ABB |
从杂交结果看来,二粒小麦配子的14条染色体中,有7条与一粒小麦配子中7条染色体对应,另外7条不对应。如果把这对应的7条染色体合称为一个染色体组,用A表示,而把不对应的7条染色体也合称为一个染色体组,用B表示,那么一粒小麦的染色体组是AA,二粒小麦的染色体组为AABB。由一粒小麦与普通小麦,以及二粒小麦与普通小麦杂交的结果看来,普通小麦的42条染色体中有14条是AA,另外14条BB,还有14条既非AA,又非BB。从普通小麦、一粒小麦、二粒小麦与粗山羊草(Ae. tauschii)杂交结果看来,普通小麦中剩下的这14条染色体对应粗山羊草的染色体组,用D表示,因此普通小麦的染色体组是AABBDD。
图10-30给出了研究者近年来提出的普通小麦的三套染色体组(A、B、D)与小麦属、山羊草属的祖先种之间的进化关系。首先,祖先A染色体组和B染色体组在约650万年前发生分化,在约550万年通过同倍体杂交物种形成(homoploid hybrid speciation,即没有发生染色体数目变化的杂交物种形成过程)的机制形成了D染色体组。现在的一粒小麦和乌拉尔图小麦(T. urartu)是由A基因组二倍体祖先进化而来的两个种(基因组为AA)。在约80万年前,乌拉尔图小麦和拟斯卑尔托山羊草(Ae. speltoides)或其他已灭绝的近缘物种(基因组为BB)发生了天然杂交和染色体加倍,形成了异源四倍体野生二粒小麦,基因组为AABB。野生一粒小麦和野生二粒小麦先后被人类的祖先驯化,形成栽培种。到大约40万年前,栽培二粒小麦又偶然与另一种野生二倍体物种粗山羊草(基因组为DD)发生天然杂交和染色体加倍,最终形成了异源六倍体普通小麦(基因组为AABBDD)。由于普通小麦对环境的适应性更好,迅速取代了早先栽培的二倍体小麦和四倍体小麦,并一直延续至今,成为全球大面积种植的主要粮食作物。
在动物中,马蛔虫(Parascaris equorum)有2n=2和4n=4两种,这可能是动物中有倍数关系的唯一实例。在涡虫中,也有过报告说,一个属内的几个种的染色体呈倍数关系,但还没有一致的看法。据说有44条染色体的金仓鼠(Mesocricetus auratus)是异源四倍体,它是由普通仓鼠(Cricetus cricetus)(2n=22)与花背仓鼠(Cricetulus barabensis)(2n=22)的杂种经过染色体加倍后形成的,但同样有待于实验的证明。总的看来,假使在动物中有以异源多倍体方式形成新种的话,也是极为罕见的。
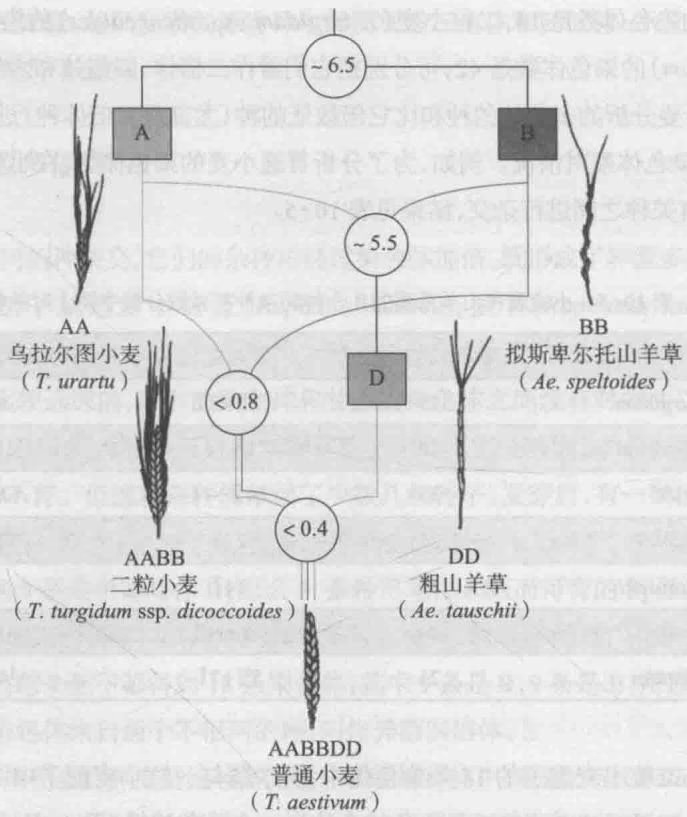
数字单位为百万年。
五、多倍体的诱发与实践应用
要得到多倍体,可用高温、低温、离心、超声波、嫁接和切断等物理方法。例如把茄属植物的梢端切断,把长出来的侧枝除去,这样就从切断部分的愈伤组织长出不定芽。这些不定芽长成枝条,其中10%是四倍体,把这些枝条切下来,插枝,就可得到四倍体植株。
不过要得到多倍体,应用化学试剂更为有效,如秋水仙碱、萘骈乙烷、异生长素等,都可诱发多倍体,其中以秋水仙碱使用最为广泛。配制秋水仙碱水溶液(0.1~10 g/L),将萌芽阶段的种子浸在其中,处理一定时间后,取出洗净,然后播种。也可以采用其他处理方法,例如把秋水仙碱溶液注入幼植物体内,或切开幼苗的生长锥,滴入秋水仙碱溶液,或者在上面放一个沾有秋水仙碱溶液的棉花小球等。秋水仙碱的作用主要是抑制细胞分裂时纺锤体的形成,结果导致复制后的染色体仍留在一个细胞内,所以染色体数就加倍了。这种细胞维持原状,继续分裂,就形成多倍性的组织。如果秋水仙碱的作用继续存在,这些细胞又可形成染色体倍数更高的细胞。
根据组织培养等研究,植物的各种组织细胞在合适的培养条件下都有可能再生成一个完整植株,所以植物细胞具有全能性(totipotency)。此外,从多倍性组织分化出来的性细胞,有可能通过有性生殖方式把多倍性遗传下去。可是在高等动物中,细胞再生能力有限,且往往仅限于胚胎细胞或成体的未分化细胞,而且还不是全能的,所以诱发处理后形成的多倍性细胞难以繁衍下去。
植物多倍体在生产上有重要意义。如四倍体番茄所含的维生素 C 比二倍体大约多了一倍。四倍体萝卜的主根粗大,产量比最好的二倍体品种还要高。三倍体甜菜比较耐寒,含糖量和产量都较高,成熟也较早。三倍体的杜鹃花因为不育,所以开花时间特别长。还有三倍体西瓜,因为很少能产生有功能的性细胞,所以没有种子。
现在特别把同源三倍体无籽西瓜和异源八倍体小黑麦详细谈一谈。
(1)无籽西瓜 一般将食用二倍体西瓜(Cilrullus vulgaris,2n=22)在幼苗期用秋水仙碱处理,可以得到四倍体。四倍体植株的气孔大,花粉粒和种子也较大。把四倍体作为母本,二倍体作为父本,在四倍体的植株上就结出三倍体的种子(3n=33)。三倍体种子种下去后长出三倍体植株来。三倍体植株上的花一定要用二倍体植株的花粉来刺激,这样才能引起无籽果实的发育。因此必须把三倍体与二倍体相间种植,以保证有足够的二倍体植株的花粉传到三倍体植株的雌花上去。
在培植无籽西瓜时,还有下列几点要注意:
① 为了保证所结的种子是三倍体,可用显性基因来标记二倍体父本,跟隐性的四倍体母本杂交。例如:将果皮呈嫩绿色、无条纹(如马铃瓜,隐性性状)的四倍体母本与果皮具有深绿色平行条斑(如解放瓜,显性性状)的二倍体父本杂交,在四倍体母本上结出的是含有3n种子的西瓜,将这些3n种子播种得到三倍体植株,授粉后结出的就是无籽西瓜。由于无籽西瓜的果皮细胞都是3n的杂合子,因此表现为显性性状,具有深绿色平行条斑。
② 用于亲本的品种要选用合适,这样就有可能使无籽西瓜的产量超过一般二倍体西瓜两倍之多。不仅所结的瓜多,而且每个西瓜的质量也可增加。
③ 如以 \varphi2n\times\delta4n ,同样也可以得到 3n,但这种 3n 植株的雌花中的胚珠会生成硬壳,像有种子一样,所以这种杂交方案不能采用。
④ 三倍体植株的第一朵雌花的胚珠可能生成硬壳,所以最好摘去第一朵雌花。
(2) 小黑麦 异源多倍体的合成是作物育种中常用的方法, 目的是要把两个亲本种的优良特性汇集在一起。可是事实并不理想, 但小黑麦是个例外。普通小麦与黑麦 (Secale cereale) 杂交, 并经染色体加倍, 得到小黑麦 (Triticale)。
小麦能否与黑麦杂交,是由小麦的可杂交基因决定的,与黑麦品种无关。这些含有可杂交基因的小麦品种就称为“桥梁品种”。桥梁品种间的杂交一代和它们的后代都很容易与黑麦杂交。非桥梁品种也可先与桥梁品种杂交,使可杂交基因传递给杂种后代,这样就可广泛利用小麦资源来与黑麦杂交,有效地解决了属间杂交不易成功的困难。
利用小麦品种间杂种第一代或第二代做母本,与黑麦进行杂交。普通小麦有21对染色体,它的雌配子有21条染色体,包括3个染色体组(ABD);黑麦有7对染色体,它的雄配子有7条染色体,是一个染色体组(R)。小麦的雌配子与黑麦的雄配子结合,所产生的 $F_{1}$ 有28条染色体,包括4个染色体组(ABDR)。因为这4个染色体组来自不同属的种,染色体的结构和功能已有很大的分化,它们之间的同源性已经很少,所以在减数分裂时不能形成二价体, $F_{1}$ 不育。当染色体加倍后,杂种的28条染色体成为28对,育性大大提高,能够结实繁殖后代了。因为小麦和黑麦的染色体基数都是7,加倍后小黑麦的28对染色体是7的8倍,它们又来自不同的种,所以称它为异源八倍体小黑麦(图10-31)。
染色体加倍后的八倍体小黑麦是纯种,它们的后代不出现分离现象,但是都表现不同程度的
普通小麦
(6n=42, AABBDD)
配子:ABD
× 黑麦
(2n=14, RR)
配子:R
↓ 杂交
杂种F₁
(4n=28, ABDR)
↓ 染色体加倍
小黑麦
(8n=56, AABBDRR)
图 10-31 异源八倍体小黑麦的合成(鲍文奎等)
结实率低和种子饱满度不高等共同缺点。但经过几年的连续选择,已成功地培育成小黑麦新品种。小黑麦新品种产量高,抗逆性和抗病性强,耐瘠耐寒,面粉白,蛋白质含量高,发酵性能好,茎秆可作青饲料,适于高寒山区种植,比当地小麦增产30%~40%,比黑麦增产20%左右。但为了使小黑麦在平原地区的产量赶上或超过普通小麦,还要继续选育,不断改进。
六、非整倍体
以上所讲的染色体数目变异是成套数目的改变,改变后的染色体数目还是整倍数的,所以都叫作整倍体。另有一种染色体数目的变异,是增减一条或几条染色体,增减后的染色体数目不是整倍数,所以叫作非整倍体。
二倍体缺一条染色体是单体 $(2n-1)$ 。大多数动、植物的单体都不能生活,甚至像玉米和番茄那样,虽然单倍体能够生活,但单体却活不下去。缺少单条染色体的影响比缺少一套染色体的影响还要大,说明遗传物质平衡的重要性。但在多倍体植物中,获得单体比较容易。例如小麦是异源六倍体,2n=42,理论上可得到21种不同的单体,事实上也得到了21种单体。这些单体虽然不很正常,但能活下去,并能很好地繁殖。可见遗传物质的缺失对多倍体的影响比对二倍体的影响来得小。
单体自交可得缺体 $(2n-2)$ ,从小麦的21种不同单体可以得到21种不同的缺体。利用单体和缺体,可把基因定位在染色体上。例如小麦中发现一个新的隐性突变体,可以把它跟21种缺体杂交:如果跟某一种缺体的杂交中,突变性状在 $F_{1}$ 显现出来,就知道这突变基因定位在缺体中没有的那对染色体上。
在有些二倍体植物中,偶尔出现三体 $(2n+1)$ 。三体也可从二倍体与三倍体的杂交中得到。例如曼陀罗(Datura stramonium)的三倍体植株用二倍体植株的花粉授粉,在所结的少量种子中,大约有53%的子裔是三体。这些三体植物的果形变异很大,可以分成12类,而曼陀罗的单倍体数也正好是12,这表明每一条增加的染色体对果实形态都有不同的贡献。大多数其他植物中,不同的三体不易从外形上互相区分,不过增加的染色体往往使花粉和种子部分不育,这是所有三体植株的共同特性。
动物中也有非整倍体的例子。在黑腹果蝇中,X染色体(第1染色体)和Y染色体多一个或少一个会影响生育力已在前面介绍过;V形染色体(第2和第3染色体)多一个或少一个都是致死的;点状染色体(第4染色体)多一个或少一个可以生活,而且能够繁殖,可以用它们来进行遗传学研究(图10-32)。
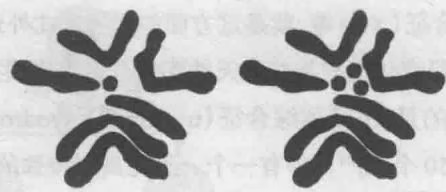
图 10-32 黑腹果蝇的单体和三体
(a) 第 4 染色体单体。(b) 第 4 染色体三体。
(a)
(b)
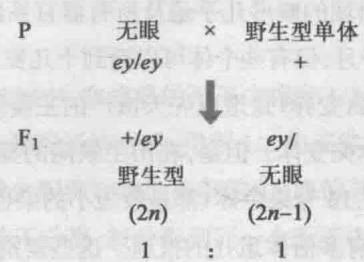
第 4 染色体单体的果蝇身体小, 刚毛细, 生活力弱。如把果蝇的无眼个体 (ey/ey, eyeless, 复眼小或无) 与正常个体交配, $F_{1}$ 为野生型, $F_{2}$ 分离为野生型 3: 无眼 1(图
10-33)。但如将无眼个体(ey/ey)与第4染色体单体的正常个体 $(+)$ 杂交,则 $\mathrm{F}_{1}$ 分离为野生型1:无眼1(图10-34)。
野生型 1:无眼 1 是单体果蝇的子 $F_{1}$ 分离比。从上面的实验中,知道 ey 基因呈现单体的分离比,同时知道一个亲本的第 4 染色体是单数,所以这就证明,ey 基因在第 4 染色体上。
第 4 染色体三体的果蝇 $(2n+1)$ 形态变化较小,身上刚毛稍稍粗些。如把无眼果蝇 $(ey/ey)$ 与第 4 染色体三体的果蝇 $(+/+/+)$ 交配, $F_{1}$ 全为野生型(图 10-35)。如把 $F_{1}$ 的三体果蝇 $(+/+/ey)$ 与无眼果蝇 $(ey/ey)$ 杂交,则下代分离为野生型 5:无眼 1(图 10-36)。野生型 5:无眼 1 是三体果蝇的测交分离比,与一般的测交分离比 1:1 不同。这同样证明了 ey 基因在第 4 染色体上。
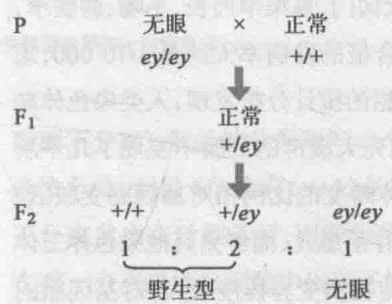
$F_{1}$ 为野生型, $F_{2}$ 分离为 3 野生型:1 无眼。
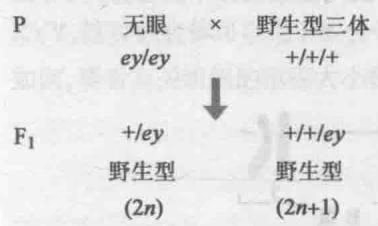
$F_{1}$ 的正常个体(2n)与三体(2n+1)都是野生型。
图 10-34 无眼个体(ey/ey)与第 4 染色体单体的野生型个体(+)的杂交结果
$F_{1}$ 出现 1:1 分离比。
| 配子 配子 | +/+ | ey | +/ey | + |
|---|---|---|---|---|
| ey | +/+/ey | ey/ey | +/ey/ey | +/ey |
图10-36 $F_{1}$ 三体野生型 $(+ / + / ey)$ 与无眼个体 $(ey / ey)$ 的杂交结果
子代出现 5 野生型(三体果蝇 3:二体果蝇 2):1 无眼(正常二倍体)。
七、人类的非整倍体
在人类的所有染色体中,已知性染色体数目的改变可以引起性别畸形,前述的克兰费尔特综合征(XXY)、XYY个体和特纳综合征(XO)等,就是这方面的例子。此外还有很多报道表明,在22对常染色体中,个别染色体的数目变化也与某些先天性疾病有着因果关系。
在这些先天性疾病中, 最常见的是 21 三体综合征 (trisomy 21 syndrome), 又称唐氏综合征 (Down syndrome), 发病率大约为 650 个活产儿中有一个。患儿具有特殊的面貌, 头颅前后径短, 枕骨扁平, 眼小, 两眼外侧高而内侧低, 鼻梁扁平且宽, 口半张, 舌常伸出口外, 舌有龟裂。掌纹和指纹特殊, 常为通贯手。发育迟缓, 智力低下。平均寿命很短, 大约到 10 岁时已有 1/3 患者死亡。1956 年蒋有兴和莱万等确立了人类正常染色体数为 46 后不久, 勒热纳 (Jérôme Jean Louis Marie Lejeune, 1926—1994) 等分析唐氏综合征患者的染色体组成时发现: 患者多了一个小小的近端着丝粒染色体——第 21 号染色体, 所以这种患者的体细胞染色体数是 $2n+1=47$ , 属于 21 三体 (trisomy 21), 记作 (47, XX 或 XY, +21) (图 10-37)。
此外,临床上还有两种常见的由非整倍性常染色体引起的先天性疾病——13三体综合征(trisomy 13 syndrome)和18三体综合征(trisomy 18 syndrome)。13三体综合征是13号染色体三体,记作(47,XX或XY,+13),发病率约为1/5000。患者头小、兔唇和(或)腭裂,先天性心脏病,严重智力迟钝等。患者常在出生后3个月内死亡,也有少数活到5岁的。18三体综合征是由于18号染色体三体,记作(47,XX或XY,+18)。患者头小而长,大囟门,鼻梁窄而长,小嘴,腭狭窄,耳低位,短颈等,出现的畸形几乎遍及所有器官系统。这种综合征的发病率大约是1/10000,患者平均寿命为6个月,但有些个体可以活到十几岁。对临床数据的统计分析发现,人类染色体畸变(包括结构和数目变异)是造成先天流产的主要原因,而且在先天流产的胚胎中发现了几乎所有常染色体的三体突变体。但是,在出生缺陷的婴儿中,染色体畸变的比例相对基因突变较低,且临床可见21、18、13号染色体(都是较短小的染色体)三体的存活患儿,而鲜见其他染色体三体的存活患儿,亦未有多倍体患儿的报道。这些差别提示,当遗传物质变异程度较大,对基因组的功能造成严重影响时,会导致胚胎致死,而只有一些相对“轻微”的变异能够在出生后的胎儿中“保留”下来。
非整倍体的出现通常是由于配子形成时染色体不分开现象造成的,即减数分裂不分离。如图10-38,减数分裂不分离可以发生在减数分裂I(图10-38a)或减数分裂II(图10-38b)的后期。以人的生殖细胞形成为例,当不分离发生在后期I时,配对的同源染色体不发生分离(等位基因不分离), 而是被分配到同一个次级性母细胞中, 在成熟的配子中将有 $1/2$ 的配子含有 $(n+1)$ 条染色体, 而另 $1/2$ 含有 $(n-1)$ 条染色体, 和正常配子结合后, 得到 $1/2$ 的三体和 $1/2$ 的单体。当不分离发生在后期 II 时, 同源染色体仍旧正常分配到次级性母细胞中 (等位基因分离), 但随后, 在某一个次级性母细胞中出现了姐妹染色单体不分离, 被分配到同一个配子中, 因此在成熟的配子中, 有 $1/2$ 的配子是正常的野生型配子 (n), 还有 $1/4$ 配子含有 $(n+1)$ 条染色体, $1/4$ 配子含有 $(n-1)$ 条染色体, 和正常配子结合后, 分别得到 $1/2$ 正常二倍体、 $1/4$ 三体和 $1/4$ 单体。
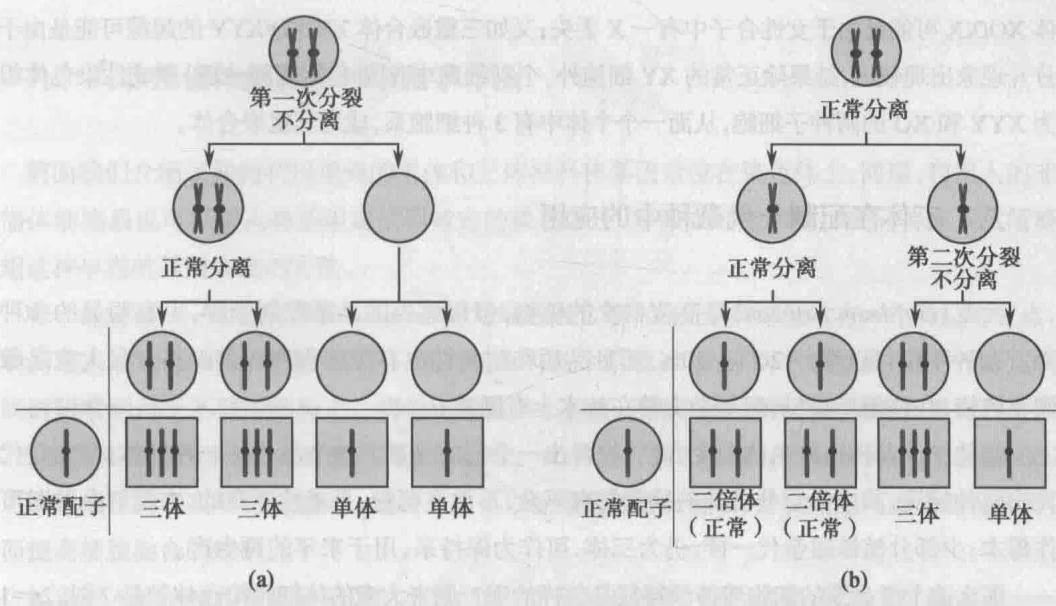
图中仅画出发生数目变异的一对染色体。
染色体不分开现象也可出现在合子形成以后的有丝分裂中。如出现在卵裂期或以后,就有可能形成由不同基因型细胞所组成的个体,也就是嵌合体(mosaic)。人类中最常见的嵌合体是性染色体嵌合体,他们的身体可以同时具有男性组织和女性组织。例如,有一型嵌合体是XO/XYY,这种嵌合体可以用XY合子中Y染色体的不分开来说明(图10-39)。这种个体的表型性别如何,要看有关组织的范围大小和所处位置而定。其他性嵌合体的起源也有不同的机制。如嵌合
图 10-39 XO/YYY 染色体嵌合体的形成过程
有丝分裂时 Y 染色体由于不分开而同趋一极,产生一子细胞为 XYY,另一子细胞为 XO。这两细胞继续分裂,形成两个含有不同性染色体组成的细胞系。
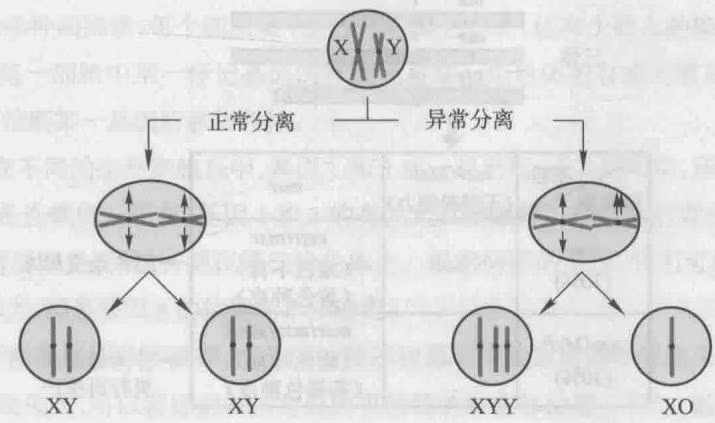
体 XO/XX 可能是由于女性合子中有一 X 丢失;又如三重嵌合体 XY/XO/XYY 的起源可能是由于不分开现象出现较迟,结果除正常的 XY 细胞外,个别细胞中 Y 染色体同趋一极,形成性染色体组成为 XYY 和 XO 的两种子细胞,从而一个个体中有 3 种细胞系,成为三重嵌合体。
八、三体在配制一代杂种中的应用
视频13非整倍体与人类疾病
大麦(Hordeum sativum)是高度自交的植物,但用适当的品系配制杂种,也有明显的杂种优势。杂种不仅可以增产20%~30%,而且品质和耐病性也有某种程度上的提高。但大麦是雌雄同花植物,往往闭花授粉,配制杂交种在技术上有困难。
育种工作者利用染色体畸变方法,培育出一个新的品系。这个品系是一种三体,自交后代分离出两种植株,其中大部分植株的雄蕊发育不全,不散发花粉,是雄性不育的,在配制杂种时可用作母本;少部分植株跟亲代一样,仍为三体,可作为保持系,用于来年的再生产。
那么这个新品系的细胞遗传学特征是怎样的呢?原来大麦的体细胞染色体数是7对,2n=14,而新品系除了正常的14条染色体外,还带有易位片段的额外染色体1条,成为 $2n+1$ 的三体。
该品系的某一对染色体上有紧密连锁的两个基因,一个是雄性不育基因(ms),使植株不能产生花粉,另一个是黄色基因(r),控制种皮颜色。这两基因的显性基因是能形成正常花粉的Ms和控制茶褐色种皮的R,带有这两个显性基因的染色体片段通过易位搭到另一染色体片段上,形成了一个额外染色体,成为 $2n+1$ 的三体,如图10-40所示那样。三体植物在减数分裂时,形成7个双价体(7Ⅱ),一个额外染色体因有易位片段往往形成单价体(1Ⅰ)。在后期时,双价体中的两条同源染色体各自分向两极,而额外染色体随机分配,或分向这一极,或分向另一极,所以三体植株可以产生两种不同配子。其中一种配子含有一套正常染色体,其中一染色体上有ms基因和r基因(n=7);另一种配子除含有一套正常染色体以及ms基因和r基因外,还含有一额外的易位染色体,上有Ms基因和R基因(n=8)。卵细胞中这两种配子比例大概是7:3,都可受精,但花粉中有额外染色体的配子不能授粉。结果自花授粉后所结的种子中,约有70%是有黄色种皮的雄性不育个体(msr/msr),余下的30%是有茶褐色种皮的花粉正常的个体(msr/msr/MsR),跟亲本完全一样。因为种皮有两种颜色,所以可用机械把两者分开。黄色种子是雄性不育系,植株长大后,如由另一合适的品系的花粉授粉,可配制一代杂种;而茶褐色种子可作保持系用,供第二年的再生产。因此,大麦中利用“三体”技术配制一代杂种,是相当成功的。
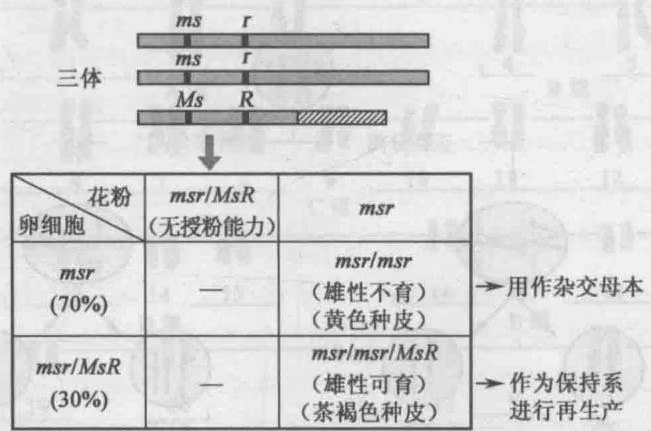
| 卵细胞\花粉 | msr/MsR(无授粉能力) | msr |
|---|---|---|
| msr(70%) | — | msr/msr(雄性不育)(黄色种皮)→用作杂交母本 |
| msr/MsR(30%) | — | msr/msr/MsR(雄性可育)(茶褐色种皮)→作为保持系进行再生产 |
图 10-40 利用三体维持大麦雄性不育系的方法
ms,雄性不育基因;Ms,正常等位基因;r,种皮黄色基因;R,种皮茶褐色基因。图中斜线部分是额外染色体的易位部分。图中与标记基因无关的6对染色体省略。
九、人非整倍体细胞系与细胞学作图
前面我们介绍了如何利用果蝇的单体和三体材料将基因定位在染色体上,同理,利用人的非整倍体细胞系也可以将人类基因定位到特定的染色体上,并做成细胞学图。我们将在下文简要介绍这种早期的基因作图的方法。
有一种病毒——仙台病毒(Sendai virus)对细胞融合很有用处。病毒通常有一个特定附着点,附着到宿主细胞上,并由此进入细胞。仙台病毒有几个附着点,如果两个细胞靠近在一起,它就能同时附着到两个不同的细胞上。病毒比细胞要小得多,所以它所附着的两个细胞靠得很近很近,因而在某些情况下,两个细胞的膜可以融合。化学试剂聚乙二醇(polyethylene glycol, PEG)也可取代仙台病毒实现细胞融合。这种试剂可以使细胞膜部分降解,并在细胞间形成细胞质桥,从而提高细胞融合的效率。
如果把人体细胞和营养缺陷型的小鼠细胞(或仓鼠细胞等)混合培养,再加上促融因子——紫外线灭活的仙台病毒或PEG,那么两种细胞就有可能融合。融合细胞中有两个核,称为异核体(heterokaryon)。异核体的两个核融合,形成杂种细胞。如果所用的小鼠细胞是营养缺陷型,那么要使这种细胞能够生长,非得在培养基上添加某种营养物不可。我们通过细胞融合技术,把小鼠细胞和人体细胞融合,形成杂种细胞,杂种细胞含有小鼠染色体和人染色体,小鼠的营养缺陷可由人染色体上的有关基因来弥补,所以培养基上即使不添加某种营养物质,杂种细胞也可保持下去。这种细胞往往有整套的小鼠染色体和丢失后保留下来的少许人染色体,其中当然含有能补偿小鼠营养缺陷的那条染色体。通过不同的选择技术,再加上机遇性的变化,可以形成各种杂种细胞系,它们含有不同数目和不同类型的人染色体(图10-41)。
上述这些过程可以在显微镜下追寻。应用荧光染色法和其他特殊染色技术,可使染色体上呈现各种不同的分带。这些分带的位置、宽狭和浓淡等随染色体编号的不同而不同。但就某一种分带技术来说,每一染色体的分带模式是高度专一和恒定的。所以在杂种细胞中,不但小鼠染色体很容易跟人染色体区分开来,而且人染色体的丢失过程也可追寻,杂种细胞中保留下来的人染色体也比较容易辨认。
叙述到这里,我们可以说明怎样把人的基因定位在某一染色体了。假定某人体细胞有一个或几个标记基因,这些基因可能控制营养需要或药物代谢,也可能控制细胞表面抗原或异常蛋白的形成等。我们实验的目的是要把它们定位到特定的染色体上。
我们有了不同的杂种细胞系,每个细胞系中除了小鼠染色体外,还有少数人的染色体。我们检验这些细胞系,把每一细胞中某一标记基因的有或无与某一染色体的有或无联系起来,像表10-6所示那样,从而推断某一基因所在染色体。
我们可以看到,在不同的杂种细胞系中,基因1和3或一起出现,或共同不见,所以我们可以下结论说,这两基因是连锁的。还有,基因1和3的有或无直接跟第二染色体的有或无有关,所以我们可以认为这两基因是同线的,都在第二染色体上。根据同样的推理,我们可以说,基因2一定是在第一染色体上,但是基因4的位置尚不能确定。
可是细胞作图不能像连锁分析那样,把基因的顺序和基因间的距离都推算出来。利用其他技术,如染色体微小缺失法,可以将标记基因定位到更精细的染色体位置。例如,酸性磷酸酯酶
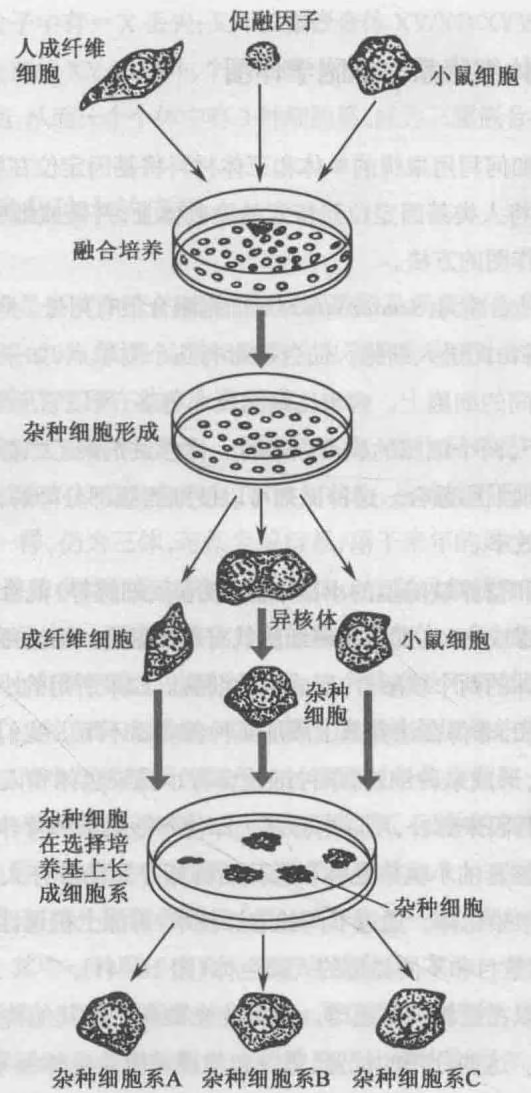
人的成纤维细胞与带有选择性遗传标记的小鼠细胞混合培养,在促融因子作用下,有些细胞融合,先形成异核体,然后是杂种细胞。细胞接种到选择培养基上,未融合的小鼠细胞和人体细胞被淘汰,只有杂种细胞能够生长。在传代培养中,杂种细胞内有些染色体丢失,保留整套小鼠染色体和若干人染色体。人染色体的丢失是随机的,所以各杂种细胞系保留的人染色体是不同的,从而可用于细胞学作图。
表 10-6 杂种细胞中标记基因的存在与人染色体间的关系
| 杂种细胞系 | ||||||
| A | B | C | D | E | ||
| 人基因 | 1 | + | - | - | + | - |
| 2 | - | + | - | + | - | |
| 3 | + | - | - | + | - | |
| 4 | + | + | + | - | - | |
| 人染色体 | 1 | - | + | - | + | - |
| 2 | + | - | - | + | - | |
| 3 | - | - | - | + | + | |
基因 ACP1 就是通过体细胞杂交技术和染色体微小缺失方法被正确地定位于 2p23 的,因为在一杂种细胞系中携带 2 号染色体 (ACP1 所在染色体) 的缺失体而不携带 ACP1 基因。
习题
什么叫染色体畸变?
解释下列名词: 缺失, 重复, 倒位, 易位。
什么叫平衡致死品系?在遗传学研究中,它有什么用处?
解释下列名词: 单倍体, 二倍体, 多倍体; 单体, 缺体, 三体; 同源多倍体, 异源多倍体。
用图解说明无籽西瓜制种原理。
异源八倍体小黑麦是如何育成的?
为什么单倍体的个体多不育?是否有例外?请举例说明。
有一玉米植株, 它的一条第9染色体有缺失, 另一条第9染色体正常, 该植株对第9染色体上决定糊粉层颜色的基因是杂合的, 缺失的染色体带有产生色素的显性基因 $C$ , 而正常的染色体带有无色隐性等位基因 $c$ , 已知含有缺失染色体的花粉不能成活。如以这样一种杂合子玉米植株作为父本, 以 $cc$ 植株作为母本, 在杂交后代中, 有 $10%$ 的有色籽粒出现。你如何解释这种结果?
已知某二倍体物种的两条野生型染色体的基因顺序分别为 12345·678 和 abcde·fgh(·表示着丝粒)。请判断以下畸变染色体的结构变异名称,并绘出畸变杂合子染色体联会时的形态。
(1) 1235·678 (2) 1232345·678 (3) 14325·678 (4) abcd5·678; 1234e·fgh
- 某实验小组利用 X 射线诱变野生型的雄性果蝇,然后将这些雄蝇与纯合隐性突变的雌蝇杂交,该雌蝇在 X 染色体上一共携带了 5 个隐性突变,具体顺序为:y - cv - ct - sn - m。分析杂交 $F_{1}$ 雌蝇,发现大多数雌蝇都是野生型,但有一只雌蝇表现出 ct 和 sn 突变表型。该小组成员继续将这只例外的突变果蝇与野生型雄蝇杂交,得到的后代中雌、雄比例为 2:1。
请问:(1)那只例外的 ct sn 突变雌蝇发生了何种变异?你的依据是?
(2)请绘出例外的 ct sn 突变雌蝇减数分裂时 X 染色体联会时的形态。
(3)请写出例外的 ct sn 突变雌蝇与野生型雄蝇杂交后代的全部类型(绘出染色体,并标示基因名称)。
相互易位并不改变细胞内遗传物质的总量,但也可以引起严重的表型。例如,9号染色体和22号染色体的相互易位可以导致慢性髓系白血病的发生。请问造成这一疾病表型的遗传机制是什么?
在玉米中, 蜡质基因和淡绿色基因在正常情况下是连锁的, 然而发现在某一品种中, 这两个基因是独立分配的。问: ①你认为可以用哪一种染色体畸变来解释这个结果? ②哪一种染色体畸变将产生相反的效应, 即干扰基因之间预期的独立分配?
曼陀罗有 12 对染色体,有人发现 12 种可能的“2n+1”型。问有多少个“2n+1+1”型?
无籽西瓜为什么没有种子?是否绝对没有种子?
有一个三倍体, 它的染色体数是 $3n = 33$ 。假定减数分裂时, 或形成三价体, 其中两条分向一极, 一条分向另一极; 或形成二价体与一价体, 二价体分离正常, 一价体随机地分向一极, 问可产生多少可育的配子?
同源三倍体是高度不育的。已知得到平衡配子 $(2n$ 和 $n)$ 的机会仅为 $(1/2)^{n-1}$ ,问这数值是怎么求得的?又如假定只有平衡的配子是有受精功能的,且假定受精过程随机,问得到不平衡
合子的机会是多少?
为什么多倍体在植物中比在动物中普遍得多?你能给出一些解释吗?
有一种四倍体植物, 它的两个植株的基因型是 AAAa 和 Aaaa。假定: ① A 基因在着丝粒附近; ② 各个染色体形成的姐妹染色单体各移向一极。则每个植株产生的各种双倍体配子比例如何?
两个21三体的个体结婚,在他们的子代中,患唐氏综合征的个体占多少比例?(假定 $2n+2$ 的个体是致死的。)
一对表型正常的男人与女人结婚后,生育了一个同时患有血友病和克兰费尔特综合征的儿子。请说明患儿及其父母的染色体组成和基因型。
平衡易位杂合子 $(7/7p^{+},9/9p^{-})$ 形成生殖细胞,在粗线期时,其有关染色体的配对图形是怎样的?
有一男子, 他是一个 13、14 平衡易位携带者, 他的染色体组成为 45, XY, -13, -14, t(13q; 14q)。①把有关染色体画出来。②有关染色体在第一次减数分裂时配对的图像如何? ③可能的分离情况如何? 形成的配子中, 有关染色体的组成如何? ④正常卵被这些精子受精后, 子代有关染色体组成如何? 预期的子代表型效应如何?
[提示:可能的分离情况为:(14)对(14+13;13)(邻近分离);(14+13;14)对(13)(邻近分离);(13+14)对(13;14)(交互分离)。]
数字课程学习
在线自测
习题答案
第十一章
遗传物质的改变(二) ——基因突变
在介绍了影响范围较大的染色体变异之后,这一章我们重点介绍基因突变。通俗地讲,基因突变指的是发生在基因内部的,较小的 DNA 序列信息的变化,通常可用 Sanger 测序的方法进行检出。有了基因突变的概念,就需要定义一个正常的等位基因形式。在遗传学研究中,研究者将自然界大量存在的或者实验室保存的标准品系的等位基因形式作为研究生物体基因变异的出发点或标准类型,它们被规定为野生型等位基因,一般记为 + ,或者 $A^{+}$ , $ab^{+}$ 等(简单起见,也可用大写英文字母表示野生型,例如 A、Ab 等)。任何偏离野生型等位基因的变异可以形成突变型等位基因,常用 - 号或者小写字母表示,如 a、ab 等。需要和读者说明的是,遗传学家在很多场合提到的基因突变是中性的,指的是基因从一种等位基因形式变成另一种等位基因形式的变异过程,变异的结局是否有害取决于变异的具体类型和位置等。
第一节 基因突变概述
基因突变在生物界中普遍存在,而且突变后所出现的性状跟环境条件之间看不出对应关系。例如有角家畜中出现无角品种,禾谷类作物中出现矮秆植株,有芒小麦中出现无芒小麦,大肠杆菌中出现不能合成某些氨基酸的菌株等,都看不出突变性状与环境之间的对应关系。
突变在自然情况下产生,称为自然突变或自发突变(spontaneous mutation);由人们有意识地应用一些物理、化学因素诱发的,则称为诱发突变(induced mutation)。
一、突变体的表型特性
突变后出现的表型变化多种多样。根据突变对表型的效应,可以分为:
(1) 形态突变(morphological mutation) 突变主要影响生物的形态结构,导致形状、大小、色泽等的改变。例如普通绵羊的四肢有一定的长度,但安康羊(Ancon sheep)的四肢很短,因为这类突变可在外观上看到,所以又称可见突变(visible mutation)。
(2) 生化突变(biochemical mutation) 突变主要影响生物的代谢过程,导致一个特定的生化功能的改变或丧失。例如粗糙链孢霉的生长本来不需要在培养基中另添氨基酸,而在突变后,一定要在培养基中添加某种氨基酸才能生长,这就属于生化突变。
(3) 致死突变(lethal mutation) 突变主要影响生活力,导致个体死亡。致死突变可分为显性致死或隐性致死。显性致死在杂合态即有致死效应,而隐性致死则要在纯合态时才有致死效应。一般以隐性致死突变较为常见,如镰状细胞贫血症的基因就是隐性致死突变。植物中常见的白化基因也是隐性致死的,因为不能形成叶绿素,最后植株死亡。当然,有时致死突变不一定伴有可见的表型改变。
致死突变的致死作用可以发生在不同的发育阶段,在配子期、胚胎期、幼龄期或成年期都可发生。如蝇子草的细叶基因 b 是配子致死,而小鼠的黄鼠基因 $A^{Y}$ 在纯合时是合子致死。
致死基因的作用也有变化。基因型上属于致死的个体,有全部死亡的,也有一部分或大部分死亡的。根据基因的致死程度,可以分为全致死(使90%以上个体死亡)、半致死(semilethal,使50%~90%个体死亡)和亚活力(subvital,使10%~50%个体死亡)等不同类型。
(4) 条件致死突变 (conditional lethal mutation) 在某些条件下是能成活的, 而在另一些条件下是致死的。例如 T4 噬菌体的温度敏感突变型在 25°C 时能在大肠杆菌宿主中正常生长, 形成噬菌斑, 但在 42°C 时不能存活。
上面这样的分类,只是为了叙述和研究的方便,事实上这些突变类型之间是有交叉的。
突变可在个体发育的任何时期发生。如某一动物的性腺中某一个配子发生了基因突变,则与这个配子结合而产生的子代个体就是这突变基因的杂合子。发生在配子中的突变被称为种系突变(germline mutation)。这类突变发生得越早,可能影响越多的后代,甚至亲代自身的育性。又如,某一动物的受精卵在进行第一次核分裂时,一对子染色体中的一条发生突变,那么长成的个体中,有一半体细胞有该突变基因,就出现所谓嵌合体。这类突变则被称为体细胞突变(somatic mutation)。一般地说,在个体发育过程中,突变发生的时期越晚,则生物体表现突变的部分越少。例如有一种金银眼猫,猫一只眼的虹彩是黄褐色,另一只眼的虹彩是蓝色,就是个体发育较晚阶段发生突变的案例。又如,在植物里,一个幼芽在发育的极早时期发生突变,该芽长成枝条后,上面着生的叶、花和果实跟其他枝条不同,这叫作枝变或芽变。芽变往往自发产生,没有明显的外因。芽变在农业生产上占有重要地位,因为果树和花卉的许多新品种就是由芽变得来的。例如,温州早橘有许多品系来自温州蜜橘(Citrus reticulata)的芽变。一般芽变仅限于某一性状,或某一些相关性状,而其他许多性状仍跟原来品种一样,所以应用嫁接、压条等无性繁殖方法把这些优良性状保存下来,再经过适当选择,可以繁育成为新品种。
二、突变率
在正常的生长条件和环境中,突变率(mutation rate)往往是很低的。果蝇的X连锁隐性致死基因的突变率约为0.1%,即每1 000个测验过的配子中,有1个X染色体有隐性致死突变。果蝇的第2染色体的自发致死突变率较高,约为0.5%。果蝇的第3染色体的长短跟第2染色体相似,突变率也差不多。果蝇的第4染色体是点状染色体,突变率自然也较低。所以果蝇总的致死突变率约为1%,即每100个配子中有1个配子带有新产生的致死突变。如果我们把产生半致死或亚活力效应的突变也包括在内,那么果蝇中自发产生有害效应的基因的总突变率约为5%,即20个配子中有1个。
这 5% 的数值包括全部染色体基因座上的突变, 所以每一基因座上的突变率应该低得多。
果蝇中,测得的单一基因座的突变率大致上在 $10^{-5}$ 范围。生物的基因突变率随基因的不同也各异。例如在玉米中,蜡质基因 $wx$ 的突变率几乎检测不到,而无色糊粉层基因 $r^r$ 的突变率可高达每10万个配子中有49个突变(表11-1)。
人类突变率的估计方法之一是根据家系中显性性状患儿的出现。在这些家系中,祖先各代没有这些性状,患者是由新产生的突变造成的,称为新生突变(de novo mutation)。如双亲一方也有同一遗传病,则这名患儿是由于继承了双亲之一携带的突变基因而患病,应除去不计。
例如软骨发育不全(achondroplasia)由常染色体基因显性突变引起,患者四肢粗短。根据调查(Mørch,1941),在94 075个活产儿中,发现10例患者,其中两例的一方亲本也是患者,所以应该除去不计,其余8例的双亲正常,可认为是新生突变的结果。因为该病是显性遗传,而且外显率基本完全,所以某个新生儿被认定患有软骨发育不全时,就表示形成该儿童的两个配子中有一个配子发生了显性突变,因此该基因的突变率是
1 | \frac {1 0 - 2}{2 \times (9 4 0 7 5 - 2)} = 4. 3 \times 1 0 ^ {- 5} |
尼尔(James van Gundia Neel,1915—2000)根据多方面的资料,估计了人的9个不同基因的突变率,发现人类基因的突变率大致与果蝇基因的突变率相似,都在 $10^{-5}$ 的范围(表11-1)。
表 11-1 各种生物代表性基因座的自发突变率
| 生物 | 性状,突变基因 | 频率 | 单位 |
| 噬菌体 | |||
| T2 | 溶菌抑制 $r \rightarrow r^{+}$ | 1 \times 10^{-8} | 每次复制的突变基因频率 |
| 宿主域 $h^{+} \rightarrow h$ | 8 \times 10^{-9} | ||
| 细菌 | |||
| Escherichia coli | 乳糖发酵 $lac^{-} \rightarrow lac^{+}$ | 2 \times 10^{-7} | 每次分裂的突变细胞频率 |
| 噬菌体 T1 敏感性 $TI^{6} \rightarrow TI^{r}$ | 2 \times 10^{-8} | ||
| 组氨酸需要型 $his^{+} \rightarrow his^{-}$ | 2 \times 10^{-6} | ||
| $his^{-} \rightarrow his^{+}$ | 4 \times 10^{-8} | ||
| 藻类 | |||
| Chlamydomonais reinhardtii | 链霉素敏感型 $str^{3} \rightarrow str^{r}$ | 1 \times 10^{-6} | 每次分裂的突变细胞频率 |
| 真菌 | |||
| Neurospora crassa | 肌醇需要型 $inos^{-} \rightarrow inos^{+}$ | 8 \times 10^{-8} | 每个无性孢子的突变频率 |
| 腺嘌呤需要型 $ade^{-} \rightarrow ade^{+}$ | 4 \times 10^{-8} | ||
| 玉米 | |||
| Zea mays | 皱缩种子 $Sh \rightarrow sh$ | 1 \times 10^{-6} | 每个配子的突变频率 |
| 非紫色糊粉层 $Pr \rightarrow pr$ | 1 \times 10^{-5} | ||
| 无色糊粉层 $R^{r} \rightarrow r^{r}$ | 5 \times 10^{-4} | ||
| 果蝇 | |||
| Drosophila melanogaster | 黄体 $Y \rightarrow y$ (雄蝇) | 1 \times 10^{-4} | 每个配子的突变频率 |
| $Y \rightarrow y$ (雌蝇)白眼 $W \rightarrow w$ | 1 \times 10^{-5} 4 \times 10^{-5} | ||
| 褐眼 $Bw \rightarrow bw$ | 3 \times 10^{-5} | ||
| 黑檀体 $E \rightarrow e$ | 2 \times 10^{-5} | ||
| 小鼠 | |||
| Mus musculus | 非鼠色 $a^{+} \rightarrow a$ | 3 \times 10^{-5} | 每个配子的突变频率 |
| 白化 $c^{+} \rightarrow c$ | 1 \times 10^{-5} | ||
| 人 | |||
| Homo sapiens | 甲型血友病 $h^{+} \rightarrow h$ | 3 \times 10^{-5} | 每个配子的突变频率 |
| 白化病 $a^{+} \rightarrow a$ | 3 \times 10^{-5} | ||
| 甲膑综合征 | 2 \times 10^{-6} | ||
| 亨廷顿舞蹈病 | 5 \times 10^{-6} | ||
| 软骨发育不全 | 4 \times 10^{-5} | ||
| 大肠多息肉 | 2 \times 10^{-5} | ||
| 进行性假肥大性肌营养不良 | 1 \times 10^{-4} | ||
玉米和小鼠的突变率与果蝇和人属于同一范围,但微生物的突变率明显较低,或许跟生活史较短有关。像细菌这类单细胞生物中,突变率是以细胞分裂为基础来计算的,而在像果蝇和小鼠这样的多细胞生物中,每一世代时间(generation time)包括很多次连续的细胞分裂,而在每一次细胞分裂中都可发生突变,突变率自然就要高些。
三、突变的性质
突变是可逆的。基因 A 可以突变为基因 a,基因 a 又可突变成原来的状态,A。通常将任何偏离野生型等位基因的突变(如 $+ \rightarrow a$ )叫作正向突变(forward mutation),从突变类型向野生型类型的变化(如 $a \rightarrow +$ )叫作回复突变(rescue mutation)。正突变和回复突变的频率一般不同。例如大肠杆菌中,野生型 $(his^{+})$ 突变为组氨酸缺陷型(histidine requirement, $his^{-}$ )的正突变率是 2 \times 10^{-6} ,而由组氨酸缺陷型突变为野生型的回复突变率是 4 \times 10^{-8} 。
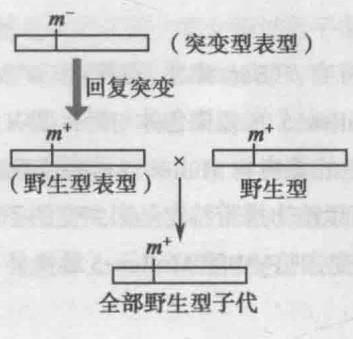
在鉴定回复突变时,应该注意区分以下两种类型:①真的回复突变,突变发生在同一基因座,跟正突变的位置一样;②抑制因子突变(suppressor mutation),突变发生在另一基因座上,但是掩盖了原来突变型的表型效应。在微生物中如果要鉴定抑制因子突变,通常可以用回复品系(revertant stock)与野生型杂交,观察子裔中有无突变型重新出现(图11-1)。如果有突变型出现,这就意味着,抑制因子和原来突变已经相互分开,突变型重新出现。如果这种杂交的后代中没有突变型出现,则证明回复突变与抑制作用无关。
根据回复突变的出现,常常可以把点突变与较大的突变,例如缺失等,区分开来。因为缺失包括遗传物质的丧失,一个回复突变恰好补全了失去的全部遗传物质几乎是不可能的。相反的,由微小的化学改变引起的点突变,没有遗传物质的明显获得或缺失,是比较容易回复的,所以回复突变可以排除缺失或重复等。
图 11-1 回复突变出现的两种机理以及在微生物中常用的区别方法
(a)突变基因座本身发生回复突变, $m^{-} \rightarrow m^{+}$ ,结果出现野生型表型。与野生型 $m^{+}$ 菌株杂交,子代全为 $m^{+}$ ,都是野生型(除非极偶然地出现新突变 $m^{-}$ )。(b)突变型表型改变是由一个抑制因子基因座(su)的突变引起。当被抑制的 $m^{-}su^{-}$ 菌株跟野生型 $m^{+}su^{+}$ 杂交,某些子裔由于重组将会出现突变型 $m^{+}su^{+}$ ,而且它们的出现频率比基因 $m$ 的突变率高得多。
(a)
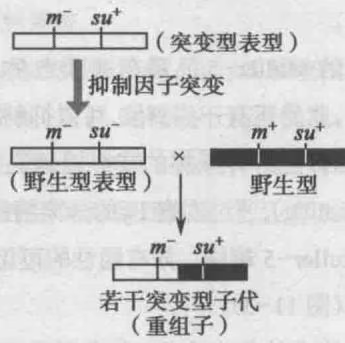
(b)
突变是多向的。一个基因可以向不同的方向发生突变,换句话说,它可以突变为一个以上的等位基因。例如基因 A 可以突变为等位基因 $a_{1}, a_{2}, a_{3}$ ……因而,在这个基因座上,群体中某个体的基因型可以是 AA,也可以是 $Aa_{1}, Aa_{2}, a_{1}a_{2}$ ……任意组合。
一个基因座上可以有两个以上的基因状态存在,叫作复等位基因,这在前面已介绍过。例如在小鼠中,影响毛色的复等位基因有 $A^{+}$ (鼠色), $A^{Y}$ (黄色),a(黑色)……在家蚕中,影响幼虫皮斑的复等位基因有p(白蚕), $+^{P}$ (普通斑), $p^{S}$ (黑缟)等16个。因为有复等位基因的存在,所以一个基因的突变可以是多方向的。例如黑腹果蝇的野生型红眼基因 $(w^{+})$ 可以突变为曙红眼基因 $(w^{e})$ ,曙红眼
图 11-2 突变的多方向性
黑腹果蝇中, $w^{e}$ 可以突变为 w 基因座上的其他等位基因,这些等位基因一般又可回复突变为 $w^{e}$ 。
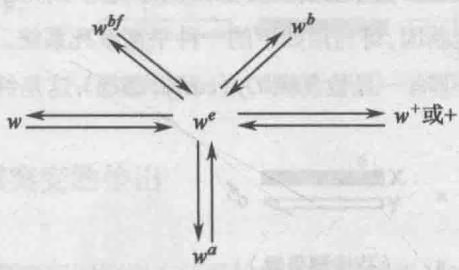
基因又可回复突变为野生型基因,或突变为w座位上的其他等位基因,如杏色眼基因 $(w^{a})$ 、浅黄眼基因 $(w^{bf})$ 等。这说明突变的多方向性(图11-2)。
第二节 突变的检出
从孟德尔的试验开始,要知道一个基因的存在,通常要依靠这个基因座上的不同等位基因所产生的表型改变,然后利用性状观察进行检验。如果某一基因座的所有等位基因在表型效应上是相似的,那么这样的基因因为在作用上缺乏独特的标志,始终作为正常表型的一部分,没有办法把它检查出来。换句话说,如果等位基因没有差异,就不能用孟德尔遗传实验方法检查出来;只有等位基因存在差异时,我们才可以推论有某一特定基因存在。所以这个时期查看基因突变,主要就是检出能产生新的表型效应的不同等位基因。
一、果蝇突变的检出
虽然摩尔根等已在果蝇中找到几百种突变型,并应用在遗传学研究上,但是定量地测定新突变,还有赖于摩尔根的学生马勒所发展的几种独创性的技术。
我们现在介绍如何用马勒发展的 Muller-5 技术来检出果蝇 X 染色体上的隐性突变,特别是致死突变。
果蝇的 Muller-5 品系在 X 染色体上带有 B(Bar, 棒眼, 显性) 和 $w^{a}$ (apricot, 杏色眼, 隐性) 标记基因, 此外还有一些倒位, 可以抑制 Muller-5 的 X 染色体与野生型 X 染色体的重组。
实验时,把野外采集的或经过诱变处理的雄蝇与Muller-5雌蝇交配,得到 $\mathbf{F}_1$ 后,做单对交配(pair mating),通过观察 $\mathbf{F}_2$ 的分离情况可以检出携带特定基因突变的子裔。如有致死突变, $\mathbf{F}_2$ 中只有Muller-5雄蝇。如有隐性的可见突变,则 $\mathbf{F}_2$ 中除Muller-5雄蝇外,还会出现具有可见突变的雄蝇(图11-3)。
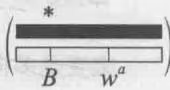
这个技术的优点在于:①有无致死突变可以根据 $F_{2}$ 中有无野生型雄蝇(即没有棒眼且红眼)进行简单客观地判断。②如有致死基因,致死基因(*)存在于 $F_{2}$ 杂合子雌蝇( arrayc|c:c & * &
& B & w^a array )中,可供进一步研究。③可研究致死基因在杂合子中的作用。④也可检出可见突变,但同时具有致死作用时,则无法检出。
这个技术的缺点有:①只能检出完全致死(100%致死)的隐性基因,而且这种致死作用要发生在成蛹期以前。②有时Y染色体上有些正常作用的基因,可降低X致死突变的作用。但我们要分析的主要是 $F_{2}$ 的雄蝇的致死情况,所以有时结果受到影响,不能正确地估计隐性致死突变率。
除了 X 连锁隐性突变以外, 常染色体上的突变基因也可利用相似的方法进行检验。例如要检出果蝇的第二染色体上的突变基因, 可利用如下的一种平衡致死系统。
该品系中,一条第2染色体上有一显性基因Cy(curly,翻翅),这是纯合致死的,同时还有一
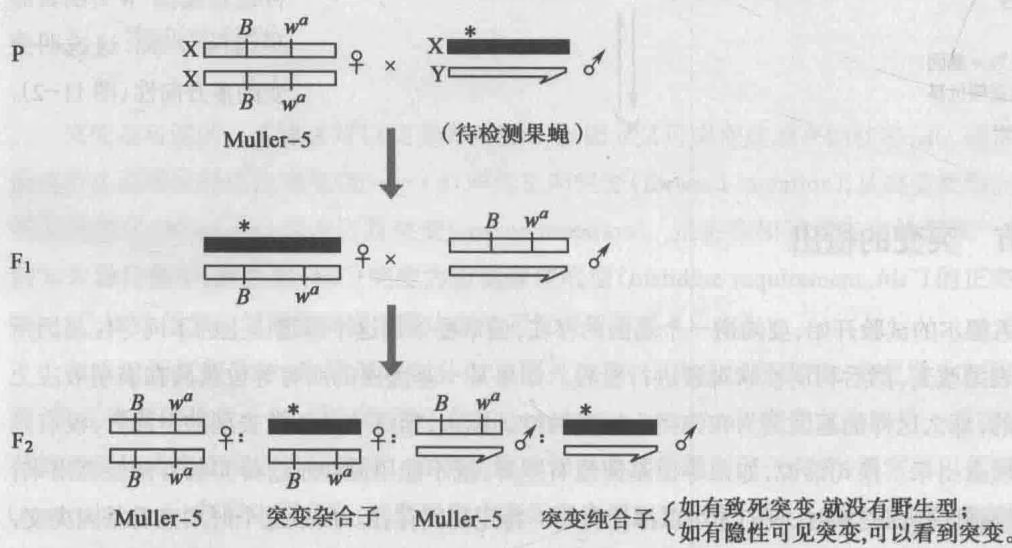
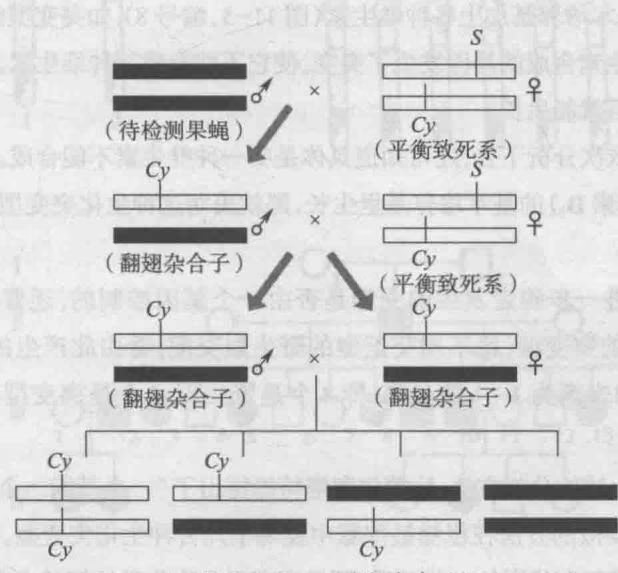
野外采集的或经过诱变处理的野生型雄蝇(待检测的X染色体用黑线表示,突变用*表示),跟Muller-5雌蝇交配。这些雌蝇的X染色体是纯合的,带有显性棒眼基因(B)和隐性杏色眼基因( $w^{a}$ ),以及一些倒位,可以抑制 $F_{1}$ 杂合雌蝇的两X间的重组。 $F_{1}$ 雌蝇与 $F_{1}$ 雄蝇做单对交配。每一 $F_{1}$ 雌蝇携带一个待测定的X染色体。 $F_{2}$ 中4种果蝇可以通过表型加以区分。如果待测定的X染色体上没有隐性致死突变, $F_{2}$ 将出现1:1:1:1的表型比例。如果待测定的X染色体上带有隐性致死基因,那么 $F_{2}$ 中没有野生型雄蝇,雌蝇的数目为雄蝇的两倍。如待测定的X染色体上有一隐性的可见突变,那么 $F_{2}$ 雄蝇中除了Muller-5品系还可以看到突变体。
个大倒位可抑制整条第2染色体的重组。另一条第2染色体上有另一显性基因 S(\text{star}, \text{星状眼}) ,也是纯合致死的。这就是我们在前一章介绍过的平衡致死系统。
现在把该系统的雌蝇与要检验的雄蝇交配,在 $F_{1}$ 中选取翻翅雄蝇,再与该系统的雌蝇单对交配,分别饲养(图11-4)。在 $F_{2}$ 中选取翻翅个体相互交配,在 $F_{3}$ 时有以下几种情况:①如最初第2染色体上不带有致死基因,则有33%左右的野生型;②如最初第2染色体上带有致死基因,则只有翻翅果蝇;③如最初第2染色体上含有隐性可见突变,则除翻翅果蝇外,还有33%左右的突变型;④如最初第2染色体上含有半致死突变,则野生型很少。
图 11-4 果蝇第 2 染色体的隐性致死突变的检验
在 $F_{1}$ 选翻翅雄蝇 $(Cy/+ )$ ,与平衡致死系统的雌蝇单对交配,得到很多 $F_{2}$ 。在 $F_{2}$ 中选翻翅个体 $(Cy/+ )$ ,这些个体都带有要测定的同一第 2 染色体,进行相互杂交。如果待测定的第 2 染色体上没有隐性致死基因, $F_{3}$ 将出现 1 野生型纯合子 $(+/+) : 2$ 翻翅杂合子 $(Cy/+ )$ 。如果待测定的第 2 染色体含有隐性致死突变, $F_{3}$ 中只有翻翅杂合子 $(Cy/+ )$ 。
$$
F _ {1}
$$
$$
\mathrm{F} _ {3}
$$
(纯合致死)(翻翅杂合子)(翻翅杂合子)(?)
二、粗糙链孢霉突变的检出
粗糙链孢霉中,营养突变的筛选方法是比德尔和塔特姆(1945)最初发展出来的。该方法的基本原理是这样的:野生型菌株能合成一系列化合物,所以能在含有糖、某些无机酸和盐类、一种氮源和一种维生素——生物素(biotin)的基本培养基上生长,但大多数缺陷型菌株不能合成这种或那种化合物,因此不能在基本培养基上生长,但能生长在完全培养基上。所谓完全培养基,是在基本培养基中再添加酵母和麦芽抽提物,以及水解酪蛋白等,这种培养基含有各种氨基酸和维生素等。要检出营养突变时,可把粗糙链孢霉菌株分别接种在完全培养基和基本培养基上。如果在完全培养基上能够生长,而在基本培养基上不能生长,可进一步在基本培养基上添加单一维生素或氨基酸,如果在添加某一营养物后即可生长,就知道这个菌株不能合成该营养物,所以是该营养物的缺陷型。
具体做法如下:①培养野生型粗糙链孢霉,用X线或紫外线等照射分生孢子,或用化学药剂处理,引起突变。②把这些处理过的分生孢子与相对交配型的野生型粗糙链孢霉交配,由此长出子囊孢子。③从子囊中取出子囊孢子,分别培养在完全培养基上。粗糙链孢霉的突变型一般能在完全培养基中生长和发育。④从完全培养基上生长起来的粗糙链孢霉又形成分生孢子。取出一部分分生孢子培养在基本培养基里,观察它们的生长,如生长正常,表示没有发生突变;如果不能生长,表示已发生了突变(图11-5)。
接着要分析发生了什么突变。把突变型的分生孢子从完全培养基里取出来,分别培养在不同的培养基上:
(1) 完全培养基(图 11-5, 编号 11), 突变型一般能在这里生长。
(2) 基本培养基(图 11-5, 编号 10), 突变型不能在这里生长。
(3) 基本培养基加上各种氨基酸(图 11-5, 编号 9), 如突变型还是不能在这里生长, 表示加了氨基酸也没有用, 因此可推测不是控制氨基酸合成的基因发生突变, 突变菌株是能合成各种氨基酸的。
(4) 基本培养基加上各种维生素(图 11-5, 编号 8), 如突变型能在这里生长, 表明突变型是控制某种维生素合成的基因发生了突变, 使它不能合成某种维生素, 所以在基本培养基中添加了这种维生素后就能生长。
这样依次分析下去,还可知道具体是哪一种维生素不能合成。例如,如果发现它只能在含有泛酸(维生素 $B_{5}$ )的基本培养基里生长,那就表明这种生化突变型是控制泛酸合成的基因发生了突变。
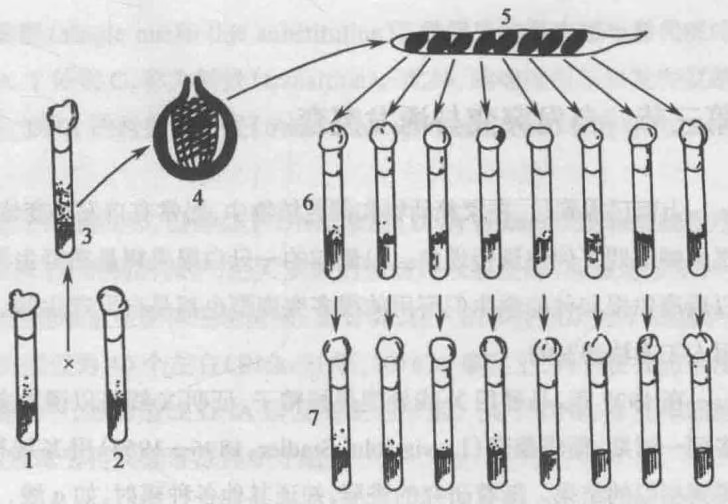
为了进一步确定发生的变异是否由一个基因控制的,还要做如下工作:把经过上述方法检查出来的突变型,跟不同交配型的野生型交配,看由此产生的子囊孢子表现出什么样的分离现象,如表现为1∶1的分离,即4个是野生型,4个是突变型,那就表明是一个基因的突变(图11-6)。
利用上述的分析方法,比德尔和塔特姆提出了“一个基因一个酶”(见表5-5)。随后,生物学家们利用类似的方法在粗糙链孢霉中发现了几百种生化突变型。对这些生化突变型的研究,不仅阐明了基因和代谢的一些关系,而且丰富了生物化学的相关内容。
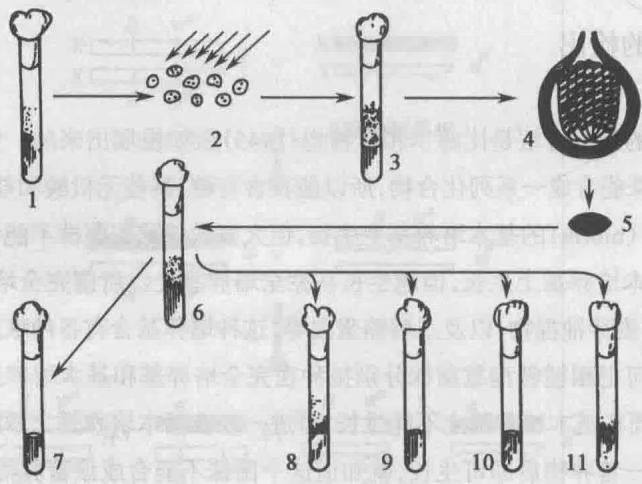
- 培养野生型菌株。2. X 线或紫外线照射分生孢子。3. 照射过的分生孢子跟野生型交配。4. 子囊壳,内含许多成熟的子囊。5. 子囊孢子。6. 子囊孢子生长在完全培养基里。7. 基本培养基,在 6 中的分生孢子不能在这里生长,这表明突变发生了。然后从 6 中取出分生孢子,分别培养在 4 种培养基 (8~11) 里。8. 基本培养基加维生素。9. 基本培养基加氨基酸。10. 基本培养基。11. 完全培养基。照例,突变型不能生长在基本培养基,能生长在完全培养基。又发现它能生长在 8,不能生长在 9,这表示它需要维生素。
三、人突变的检出
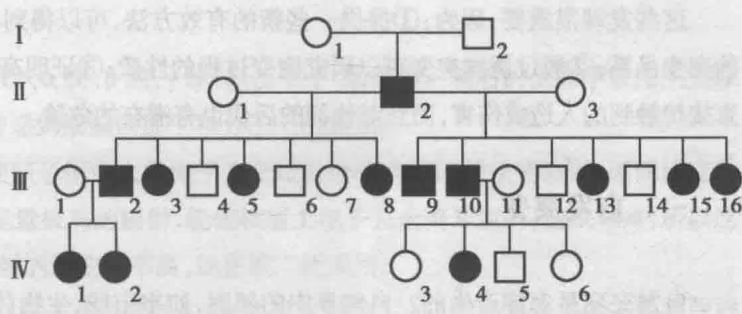
在人中,上述方法均不适用,突变的检出得依靠家系分析和出生调查。一般来说,常染色体隐性突变难以检出,因为一个隐性性状的出现,很可能是由于两个杂合个体的婚配,而不是由于隐性突变的缘故。相反,显性突变的起源就比较容易检出,只要遗传方式规则,一个家系中,如果一个人有一显性突变性状,而他(或她)的父母是正常的,这就表明患者出现了一个新的突变(图11-7)。
图11-6 确定粗糙链孢霉生化突变型的方法
- 野生型菌株。2. 突变型菌株,这里是不能合成泛酸的突变型。3. 野生型和突变型杂交的后代。4. 子囊壳,内含许多成熟的子囊。5. 一个子囊,含有8粒子囊孢子。6. 让这些子囊孢子分别生长在含有泛酸培养基的8个试管里,它们都能正常生长。7. 如果让它们生长在8个都不含有泛酸培养基的试管里,结果是一半能够生长,一半不能生长,表明突变型是一个基因突变,因为突变型和野生型杂交,产生1:1的分离。
从这家系来看,这个性状的遗传方式规则,家系中出现的第一个男性患者(Ⅱ-2)的父母正常,表明是一个新产生的突变。
图 11-7 一个上睑下垂的家系,表现为显性遗传(刘祖洞等,1964)
如果显性性状的遗传方式不规则,例如双亲之一可能带有这个基因,但表型正常,突变性状没有表达出来,那显性性状的起源又将难以确定。
因为男性只有一个 X 染色体, 所以 X 连锁隐性突变的起源有时也可从家系分析中检出。如果一个女性的一条 X 染色体上有一基因突变, 她的半数男孩将遗传这个性状。然而 X 连锁性状的检出, 也可发生误差, 因为我们难以确定, 杂合子女性所带有的突变基因是新产生的, 还是从她的祖先传递下来的。所以人类中突变的检出, 最可靠的还是限于显性基因。关于人的显性基因的突变率的计算, 我们已在“突变率”一项中说明过。
随着生化技术的发展,研究者进一步利用各种蛋白质或酶的微小变异筛选人类突变。根据蛋白质在电场中的迁移率不同,可把某一蛋白质的微小差异检查出来,例如人的快速泳动和慢速泳动的葡糖-6-磷酸脱氢酶(glucose-6-phosphate dehydrogenase)等。这些微小差异都是遗传的,可在家系中一代代追寻。虽然这种变异通常并不产生形态上或生理上的效应,但是这种变异的存在,表明蛋白质中氨基酸排列顺序可以由突变而改变。但是,这个技术有一个限制,因为并不是所有氨基酸改变都可由电泳检出,所以单纯利用该技术会导致某一蛋白质的突变率可能被低估。但随着生化和分子生物学技术的不断进步,研究者对突变的原因、性质、种类、频率等有了更多的了解。由于DNA测序技术的快速发展,大量人突变检出可从基因水平直接开展,但筛选得到的DNA变异是否改变了表型效应,以及如何改变了表型效应,仍需要深入的遗传分析。
第三节 自发突变与诱发突变
上面已提到过,在家养动物和园艺植物中,时常有自发突变体出现。在1910年,摩尔根用白眼果蝇证明了伴性遗传现象。但最初的一只白眼果蝇是在野生型果蝇的培养瓶中自发出现的,以后摩尔根和他的学生们所用的很多突变型也都是自发产生的。也就是说,这些突变型并不是用人工方法诱发的。
在 1927 年, 马勒用 X 线处理果蝇精子, 证明 X 线可以诱发突变, 显著地提高突变率。差不多同一时期, 斯塔德勒 (Lewis John Stadler, 1896—1954) 用 X 线和 γ 线处理大麦和玉米种子, 也得到相似的结果。随着研究的进展, 知道其他各种辐射, 如 α 线、β 线、中子、质子及紫外线等都有诱变作用。
这些发现很重要,因为:①提供一些新的有效方法,可以得到很多遗传学分析和育种上有用的突变品系;②通过诱发突变可以研究突变过程的性质;③证明高能辐射和许多化学品不仅能对直接接触到的人造成伤害,而且对他们的后代也有潜在的危险。
一、自发突变
自发突变是怎样产生的?自然界中的辐射,如宇宙线、生物体内的放射性碳和钾等,可能是一种原因,但自然界中的电离辐射强度不足以说明自发突变的全部,可能只能说明其中的极小一部分。
温度的极端变化是另一种诱变因素。例如有人认为极端温度是黄鹤菜(Crepis)自发突变的重要因素。用极高的温度(例如40℃)或极低温度(例如0℃)处理生物材料,可增加突变率,但总的看来,温度在自发突变中的重要性还比不上自然辐射。
自从知道化学药品可以诱发突变后,人们不久就意识到周围环境中各种化学物质的潜在诱变性。不过自发突变不能单单归因于外界因素,也应考虑到体内或细胞内某些生理、生化过程所产生的物质的作用。支持这一论点的证据是:①植物的种子贮藏久了,突变率常常增加。例如在正常情况下,金鱼草的突变率大约是1%(包括所有的基因,如果每个基因的突变率是10万中1个,那么如果一个配子中共有1000个基因的话,即可得到1%)。但种子贮藏6~9年后,突变率就从1%增加到1.6%~5.3%,贮藏10年后可达14.3%。②从陈种子中可提取一些诱变物质。例如从烟草的陈种子中压出油来,用这种油处理同一烟草品种的新鲜种子。从这些种子长出来的幼苗,突变种类跟自发突变相似,但突变频率增加。③把番茄种在很干燥的条件下,提高番茄细胞的渗透压,以后从它们的 $F_{2}$ 和 $F_{3}$ 中可以分离出大量突变体。
现代生物学家逐渐揭示了自发突变的机制——在细胞自身正常的代谢过程中,DNA一直承受着内源物质的持续攻击(Lindahl,1972)。以人为例,每个体细胞的DNA每天约产生7万个损伤位点,主要来自于代谢过程产生的活性氧化物(reactive oxygen substances,ROS)对碱基造成的氧化损伤,以及碱基水解、碱基烷化等。DNA的复制错误也是自发损伤的重要来源之一。仍以人为例,体细胞每分裂一次,就有 6\times 10^{9} 个核苷酸发生复制。DNA复制的过程中,DNA聚合酶的错误配对会导致单核苷酸替换(single nucleotide substitution)。最常见的是由嘌呤替代嘌呤以及嘧啶替代嘧啶,如G替代A,T替代C,称为转换(transition)。此外,胞嘧啶由于自发去氨基化(deamination)可变成尿嘧啶。DNA的跨损伤合成(translesion synthesis, TLS)也会导致DNA在复制过程中产生自发突变。
尽管以上多种损伤威胁存在于细胞内部,但得益于 DNA 修复 (DNA repair)机制和细胞程序性死亡(programmed cell death, PCD)机制的保护,绝大多数的损伤可以被及时、准确地修复,一些损伤严重、无法修复的突变细胞能够被生物体主动清除。据计算,在人的多种组织的干细胞中,每年每个细胞持续积累的新发突变仅为 40 个左右(Blokzijl 等,2016)。事实上,只有在损伤未修复,或在修复时引入了错误的情况下,才会造成 DNA 自发突变的积累。关于 DNA 修复和细胞程序性死亡的机理,我们留到后续章节再向读者做详细介绍。
二、辐射和紫外线照射诱变
生物体接触的辐射线有 X 线、 $\alpha$ 线、 $\beta$ 线、 $\gamma$ 线,以及中子、质子等。辐射的生物学效应主要取决于它们所含的能量,以及能传递到细胞内原子和分子上的能量。
辐射所含的能量愈大,可使原子轨道上的电子变化以及分子共振态的改变愈强,因而诱变的效率更高。像 X 线、γ 线等是能量极高的辐射,能使轨道上电子完全离开原子,造成电离,所以这些辐射叫作电离辐射。电离辐射的诱变效率高,现在被广泛采用。
辐射剂量的单位用 r(roentgen, 伦琴) 表示。1 r 的照射可使 $1 , cm^{3}$ 的标准状态的干燥空气产生一静电单位 (esu) 的电离量。至于 1 r 的照射可以引起多少突变,随生物种类、照射器官和处理时间而有差异。现在选择几种代表性的生物,来看一看 1 r 的诱变率是多少。从表 11-2 看来,1 r 的诱变率大都在一亿分之一的范围内。
表 11-2 辐射剂量为 $1\mathrm{r}$ 时的诱变率
| 生物种类 | 研究的基因座 | 照射对象 | 突变率 |
| 小鼠 | 常染色体隐性可见突变,7个基因座的平均 | 精原细胞精母细胞 | 2.6 \times 10^{-7} |
| 黑腹果蝇 | 常染色体隐性可见突变,9个基因座的平均 | 卵母细胞卵原细胞 | 1.4 \times 10^{-8} |
| 常染色体隐性可见突变,9个基因座的平均 | 成熟精子 | 6 \times 10^{-8} | |
| 大肠杆菌 | 生化突变,30种的平均 | 2.7 \times 10^{-10} |
诱发突变的种类跟自发突变很相似,这不仅在引起基因突变和染色体畸变这两大类上是这样,而且在引起这两大类的细分条目上也是如此。因此诱发突变并不产生特别的突变型,只不过增加突变的频率而已。一般地说,辐射剂量低时,诱发突变率是自发突变率的几十倍;辐射剂量高时,诱变率可达自发突变率的几百倍以上,所以辐射诱变在增加突变率上有很大作用。
电离辐射引起遗传损伤的途径,大部分还未了解,但是它们可能以两种方式改变染色体的结构:①直接方式,通过量子跃迁释放的能量击中染色体,好像子弹击中靶子一样;②间接方式,通过电离化(ionization)使细胞内发生化学变化,转而使染色体在复制时产生异常。一般分裂中的细胞比不分裂细胞对辐射敏感。用 $\gamma$ 线来治疗肿瘤也是同样的理由,迅速分裂中的肿瘤细胞比不分裂的周围细胞对射线敏感得多。
电离辐射的遗传学效应在许多生物中都有研究,并得出两个重要结论:
第一,电离辐射可诱发基因突变和染色体断裂,它们的频率跟辐射剂量成正比。例如用2000 r的剂量处理果蝇精子,大约产生6%的X连锁隐性致死突变,而剂量为4000 r时,频率大约增至12%(图11-8)。在相当大的一个剂量范围内,辐射剂量和突变率之间都存在线性关系。但是用高剂量辐射诱发X连锁隐性致死突变时,得到的突变率比预期低,这可能是因为在一个染色体上诱发了一个以上的致死突变。用Muller-5技术测定的,是带有一个或一个以上的隐性致死突变的X染色体频率,而不是测定隐性致死突变的实际频率。而且还应当注意到,虽然染色体断裂的频率与照射的剂量成正比,但是像倒位、易位和缺失等染色体结构变异就与辐射剂量不一定是线性关系了。
第二,辐射效应是累积的。处理果蝇精子,诱发的突变数跟接受的照射量成正比,而跟照射的方式无关。低强度长期照射(慢性照射)与高强度短期照射(急性照射)诱发的突变数一样;连续照射与间歇数小时的分次照射,产生的突变数也一样。但在其他生物中,并不存在这样确切的关系。例如处理小鼠精原细胞时,慢性照射产生的突变率比同剂量的急性照射少。可以确定的是,一个细胞接受的辐射剂量即使只有很小的增加,该细胞发生突变的概率也会增加。
紫外线照射也可诱发突变,但不及电离辐射有效。紫外线的最有效波长是270 nm,这个波长相当于核酸的吸收峰。紫外线也是电磁辐射,跟X线一样,但穿透性很弱。例如紫外线照射约有30%可以穿透过玉米花粉壁,但只有8%可以穿透过鸡蛋的卵黄膜。这样低的穿透性很难保证实验群体中每一细胞都接受同样的辐射量,所以紫外线很少用作高等生物的诱变剂,而多用在微生物、生殖细胞、花粉粒以及体外培养细胞等的诱变中。
三、化学诱变
最早知道的化学诱变剂是秋水仙碱,可以诱发多倍体。1943年奥尔巴赫(Charlotte Auerbach, 1899—1994)和罗布森(John Michael Robson, 1900—1982)用果蝇做实验,发现芥子气(二氯二乙硫醚)可以诱发突变。他们的发现不是完全偶然的,因为已知芥子气跟X线一样,可以抑制细胞分裂,引起炎症,所以他们猜想,芥子气很可能也有诱变效应。不久又发现,芥子气
和氮芥子气可引起染色体断裂。
化学诱变的发现开拓了人工诱变的新途径。化学诱变剂的应用,可大大提高突变率,而且处理比较方便:只要把化学诱变剂添加到培养基中,在上面培养孢子或细菌,或者把诱变剂配成溶液,把种子、芽或休眠的插条等浸渍在溶液中即可。
随着科学实验的进展,化学诱变剂的名单不断延长。大量化学品,其中很多是致癌剂(carcinogen),可以诱发突变。在这些化合物中,有的广泛地用于工业加工过程中,而另一些普遍地用作杀虫剂、杀菌剂和食物添加剂等(表11-3),所以科学严格地鉴定可以诱变的化学品并采取防护措施是一项非常迫切的科学工作。有些化学诱变剂是高度有毒的,例如氮芥子气,可以在它们产生明显的遗传损害以前,就把它们鉴别出来。可是另一些化合物并不那么有毒,却是诱变剂,所以往往在它们造成严重遗传损害之前未能被检查出来。我们最关心的是各种化学品对人类的潜在遗传损害,但是因为不能用人做实验,所以只有根据其他生物的诱变实验的结果来推断。如发现一种化合物在细菌、果蝇或小鼠中具有诱变作用,我们就把它看作是人的潜在诱变剂,不用它,或者采取防护措施,以免危及人体。
表 11-3 一些化学诱变剂和它们的作用(主要根据 Smith-Keary, 1975)
| 化学诱变剂 | 主要用途 | 有害效应 |
|---|---|---|
| 乙烯亚胺(ethylenimine)及其衍生物 | 纺织工业(染色,防皱防水);农业(杀虫剂和土壤团粒结构促进剂);石油工业 | 毒性和致癌剂;在多种生物中诱发突变,诱发人细胞的染色体畸变 |
| 三乙撑硫代磷酰胺(thiotepa) | 纺织工业(染色,防火防水) | 诱发小鼠突变和人细胞的染色体畸变 |
| 芥子气(mustard gas) | 应用于塑料工业 | 各种生物的畸胎剂、致癌剂和诱变剂 |
| 亚硝胺(nitrosamine) | 石油工业,线虫防治,火箭燃料,增塑剂;存在于很多食品和烟草中 | 在果蝇中有毒、致癌和诱变,但在细菌中不是,亚硝胺可能要由酶作用后才有活性 |
| 乙二胺四乙酸(ethylenediamine tetraacetic acid,EDTA) | 促进色香的保持,广泛应用于食品工业 | 在高等生物中引起染色体畸变 |
| 克菌丹(captan) | 农业和园艺上的杀真菌剂 | 有毒,引起畸胎;大肠杆菌诱变剂 |
| 链霉黑素(streptonigrin) | 抗生素,癌化疗剂 | 致癌和诱变;引起高等生物细胞的染色体畸变 |
| AF-II(呋喃糠酰胺,furylfuramide) | 食物添加剂,作为豆腐、火腿、香肠等保存剂 | 在实验动物中有致癌、诱变作用,能引起染色体畸变,但未发现有致畸作用 |
自发突变和诱发突变有一个共通的特征,就是随机性。所谓随机性,就是说,突变可以发生于不同发育时期的各种细胞,可以发生于细胞内的不同染色体,可以发生于染色体上的不同基因座,而且同一基因座上的基因又可突变成各种不同的等位基因。但是某些化学诱变剂的诱变作用具有一定的特点,例如生物碱咖啡因可以诱发染色体断裂和重组,但并不显著提高可见突变的发生率。又如一些核苷酸类似物,如脱氧尿核苷处理细胞时,会使细胞合成 DNA 时随机地掺入这种类似物,以代替正常的核苷酸,结果造成染色体畸变,而且断裂的地方有集中于染色体的某些区段的趋势。但即使在这种情况下,仍然不能说突变是不随机的。到现在为止,还没有发现哪个诱变因素能使生物定向地产生更适应于该因素的一些突变。
四、诱变在育种上的应用
物理因素和化学因素可以诱发突变,使突变率大大提高,这样变异的来源就大为增多。通过人工选择再加上育种上的一些措施,可以培育出生产上需要的各种优良品种。
在微生物选种中,现在已广泛应用诱变因素来培育优良菌种。例如青霉菌的产量最初是很低的,生产成本也很高。后来交替地用 X 线和紫外线照射,以及用芥子气和乙烯亚胺处理,再配合选择,结果得到的菌种,不仅产量大大地提高了,而且混在青霉素制品中的一种黄色素也不再分泌了。人工诱变已经广泛地应用在各种抗生素菌种和其他工业微生物的育种上,使产品质量继续提高,生产成本不断下降。
在植物方面,应用诱变育种,也已培育出许多优良品种。这个方法特别有利于改进高产品种的个别不良性状。例如用 $\gamma$ 线处理籼稻干种子,选出提前 15 天成熟的新品种,丰产性状仍旧保存下来。又如,一般米粒的蛋白质含量不高,而且所含的蛋白质较多地分布在米粒的外层,在碾成白米时,多已丧失。现在用诱变方法,得到新的水稻品种,不仅提高了米粒中蛋白质的含量,而且蛋白质分布在整个米粒中,所以碾成白米后,米粒中蛋白质含量提高很多。还有,用 $\gamma$ 线和其他诱变剂处理大豆,培育出一个新品种,该品种具有改变了的酶系,在光合过程中消耗有机碳很少,被称为“非光呼吸作物”。光呼吸虽为植物正常生活所必需,但它的消耗过大,几乎用去了合成有机碳的一半,所以育成的非(或低)光呼吸作物可在同样的施肥和管理条件下,提高产量 50%。诸如此类的例子是很多的。我国利用诱变育种的方法已先后育出了一百种以上的水稻、小麦、高粱、玉米、大豆等新品种,而且有些品种已大面积推广种植,在粮食增产上起了很大的作用。
在家蚕中,斯特伦尼科夫(Vladimir Strunnikov,1914—2005)利用诱变技术研究出“性连锁平衡致死系”,使孵出来的都是雄蚕。部分育种经过如下:应用电离辐射,得到几个Z染色体上具有隐性致死基因的品系,从中选出Z染色体左臂上带有隐性致死基因 $l_{1}$ 或 $l_{2}$ 的两个杂合子。这两品系虽各有一个致死基因,但不降低生活力。 $l_{1}$ 与 $l_{2}$ 的基因座靠近,重组值很低。另外又由辐射诱变得到ZW易位的雌蚕,Z染色体的一个片段易位到W染色体,该易位片段上带有与 $l_{1}$ 和 $l_{2}$ 相对应的正常等位基因(图11-9)。
把ZW易位的雌蚕与一条Z染色体上带有致死基因 $l_{1}$ (或 $l_{2}$ )的雄蚕交配,得到的杂种中,雌蚕具有从母本来的ZW易位染色体和从父本来的带有 $l_{1}$ (或 $l_{2}$ )的Z染色体。雌蚕由于有ZW易位,除了一个正常Z染色体外,还有一个由于易位而获得的Z染色体片段,所以Z染色体部分重复,但它们仍是可育的。Z染色体部分重复的杂种雌蚕再与一条Z染色体上带有致死基因 $l_{2}$ (或 $l_{1})$ 的雄蚕杂交,所得的杂合子中,雄蚕的两条性染色体ZZ分别具有 $l_{1}$ 和 $l_{2}$ 致死基因,这样就得到了平衡致死系:雌蚕带有ZW易位和一个标记有 $l_{1}$ (或 $l_{2}$ )的正常Z染色体,而雄蚕是致死基因 $l_{1}$ 和 $l_{2}$ 的杂合子。这种平衡系能真实遗传(图11-9a)。将该系统的雄蚕与正常雌蚕杂交时,下代只有雄蚕(图11-9b),因为雌蚕的W上没有 $l_{1}$ 或 $l_{2}$ 的等位显性基因,所以雌蚕全部死亡。
根据实验,可能仍有少数雌蚕活下来,这是由于父本雄蚕 $(l_{1}+/+l_{2})$ 的两致死基因间发生重组,形成不具有致死基因的雄配子(++),如果这种雄配子与带有W的雌配子结合,就有可能出生有生活力的雌蚕(图11-10)。
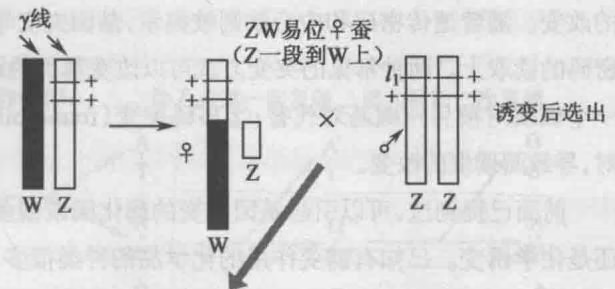
(a) 平衡致死系的雄蚕对两个不同致死基因 $(l_{1}, l_{2})$ 都处于杂合态,从而使具有不同致死基因的个体不致死亡,同时由于两致死基因间的平衡效应,使这品系可以自我保持下去,子代的雄蚕像父本,雌蚕像母本。(b) 平衡致死系雄蚕与正常雌蚕杂交时,由于致死基因 $l_{1}, l_{2}$ 位于Z染色体上,所以雌蚕(ZW)全部死亡,活下来的都是雄蚕(ZZ),可供生产用。
(a)
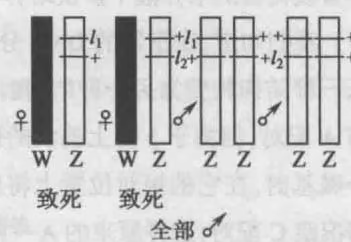
(b)
图11-10 父本雄蚕中两致死基因发生重组,可形成不带致死基因的雄配子
1 | \begin{array}{r} {\text { 父本 } \xrightarrow [ + ]{l _ {1}} \xrightarrow [ l _ {2} ]{+} \left\{ \begin{array}{l l} {\text { 未交换 }} & {\xrightarrow [ + ]{l _ {1}} \xrightarrow [ + ]{+} \xrightarrow [ - ]{l _ {2}}} \\ {\text { 交换 }} & {\xrightarrow [ - ]{l _ {1}} \xrightarrow [ - ]{l _ {2}}} \end{array} \right.} \end{array} |
ZW 易位的平衡致死系已用于蚕种生产,提供全是雄蚕的杂交种。但鉴于平衡致死系雌蚕有较大片段的重复,不可避免地会影响其生活力,所以还应继续选育,增加雌蚕强健度。不过不论怎样,斯特伦尼科夫的实验构思是巧妙的,他所得到的性连锁平衡致死系如经过实质性的改进,有可能在蚕丝业生产上发挥其应有作用。
第四节 突变的分子基础与遗传效应
沃森和克里克关于 DNA 的结构和复制的模型确立后, 分子生物学家清楚地认识到基因突变是由子 DNA 分子中核苷酸顺序的改变造成的。基因突变引起基因作用改变, 最后导致个体表型的改变。随着遗传密码和中心法则被揭示,基因突变导致基因作用改变的原因自然落到了遗传密码的读取上。两种常见的突变方式可以改变基因的遗传信息:①碱基替换(base substitution),一个碱基对被另一碱基对代替;②移码突变(frameshift mutation),增加或减少一个或几个碱基对,导致阅读框的改变。
前面已提到过,可以引起基因突变的理化因素很多。不过在诱变机理方面了解比较清楚的还是化学诱变。已知有诱变作用的化学品的种类很多,而且这张单子还在不断延长。我们现在就以几类不同的化学物质为例,分别说明碱基替换和移码突变这两种基因突变方式。
一、碱基类似物的诱发突变
一些化合物的分子结构很像天然化合物,可以在某个化学反应中取代天然化合物。碱基类似物(base analogue)是这类化合物中最早受到注意的,因为一些碱基类似物可以在 DNA 复制中代替天然碱基,引起配对错误,使得一碱基对被另一不同碱基对所代替。
例如 5-溴尿嘧啶(5-bromouracil, BU)是一种碱基类似物, 它跟胸腺嘧啶有类似的结构。把大肠杆菌培养在含有BU的培养液中, 菌体DNA中的一部分胸腺嘧啶便为BU所取代。一般, DNA中含有的BU愈多, 则群体中发生突变的细菌也愈多, 而且将已经发生了突变的细菌换到不含溴化物的培养液中多次培养, 仍旧保持突变的性状。那么该怎样解释这些现象呢?
我们知道,在正常的 DNA 分子中,T 和 A 处在相对的位置上。BU 像所有天然碱基一样,能从一种结构转变为另一种结构。通常 BU 在 DNA 分子中以酮式状态存在,这时它和 T 一样,能与 A 配对;但由于 5 位上的溴的影响,BU 有时以烯醇式状态存在于 DNA 中,当 DNA 复制到这个碱基时,在它的相对位置上将出现一个 G(图 11-11)。而在下一次 DNA 复制时,G 又按一般情况跟 C 配对,这样原来的 A—T 碱基对就转变为 G—C 碱基对(图 11-12)。
因为 BU 的烯醇式可以跟 G 配对, 所以它有时掺入到 DNA 中取代 C 的位置, 也可引起碱基对的改变, 由 G—C 碱基对改变为 A—T 碱基对。这过程完全是上述过程的回复。因为 BU 的烯醇式是比较不常见的异构体, 所以由 G—C 变为 A—T 要比 A—T 变为 G—C 少得多。尽管这样, 由 BU 诱发的突变也可由 BU 来回复。
前面已介绍过转换, 即嘌呤由嘌呤代替, 嘧啶由嘧啶代替; 而嘌呤为嘧啶代替, 嘧啶为嘌呤代替, 叫作颠换(transversion) (图 11-13)。BU 引起的碱基替换是转换。
另一碱基类似物——2-氨基嘌呤(2-aminopurine)对T4噬菌体和大肠杆菌等也是诱变剂,它的诱变作用也是引起碱基对的转换。
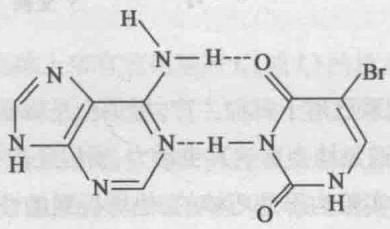
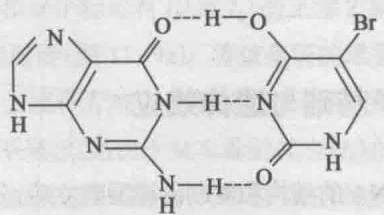
G BU烯醇式
图11-11 BU的碱基配对方式
BU 以酮式存在时,与 A 配对;以烯醇式存在时,则与 G 配对。
(a) 诱发 A—T 转换为 G—C。复制时,碱基类似物的常见异构体(酮式)代替天然碱基(胸腺嘧啶),掺入 DNA。掺入后第一次复制时,该类似物以烯醇式存在,跟一不同的天然碱基(鸟嘌呤)配对,从而在下一次复制时,导致碱基对的替换(复制误差,error of replication)。(b) 诱发 G—C 转换为 A—T。复制时,出现配对错误,碱基类似物的稀有异构体(烯醇式)掺入 DNA。在掺入后第一次复制时,类似物又回复酮式结构,这时配对正常,从而导致下一次复制时出现碱基对替换(掺入误差,error of incorporation)。
(a)
(b)
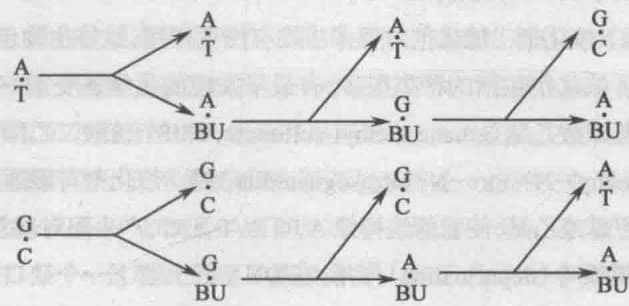
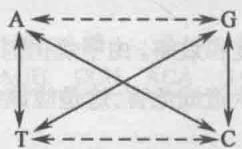
(a)
图11-13 碱基替换的几种可能形式
(a) 碱基的转换(虚线)和颠换(实线)。(b) 一段 DNA 双链中, 碱基对替换的例子。
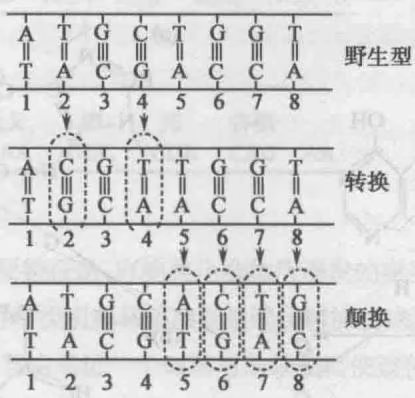
(b)
二、改变 DNA 化学结构的诱变剂
碱基类似物是诱变剂,因为它们取代复制中 DNA 的一个正常碱基;其他诱变剂,如亚硝酸、烷化剂(alkylating agent),它们的作用是改变核酸中的核苷酸化学组成,所以它们的作用与 DNA 的复制无关。
(1) 亚硝酸( $\mathrm{HNO}_{2}$ ) 这是一种很有效的诱变剂, 已知可以引起很多生物的突变, 如烟草花叶病病毒, T2、T4 噬菌体, 大肠杆菌等。
已知亚硝酸有氧化脱氨作用,能使 A 脱去氨基,成为次黄嘌呤(H),使 C 脱去氨基,成为 U (图 11-14),使 G 脱去氨基,成为黄嘌呤(X)。A 脱氨后生成的 H 跟 C 配对,C 脱氨后生成的 U 跟 A 配对。在下一次 DNA 复制时,C 又按一般情况跟 G 配对,A 也按通常情况跟 T 配对,这样前者就由原来的 A—T 转换为 G—C,后者由原来的 G—C 转换为 A—T,使 DNA 分子中核苷酸排列顺序发生变化。但 G 脱氨后生成的 X 仍和 G 一样,与 C 配对,因此 G 脱氨没有诱变作用。
用亚硝酸处理大肠杆菌的碱性磷酸酶缺陷株,能够得到生产这种酶的回复株。分析回复株中碱性磷酸酶的氨基酸顺序,并参照遗传密码,知道亚硝酸使这个缺陷型回复为原养型的机制主要是由于A—T转换为G—C。
(2) 烷化剂 烷化剂对很多生物有诱变作用, 这些生物包括噬菌体、细菌、链孢霉、蚕豆和果蝇等。烷化剂包括的种类很多, 有最早发现的化学诱变剂——芥子气, 还有在工业上广泛应用的甲基磺酸乙酯 (ethane methyl sulfonate, EMS)、硫酸二乙酯 (ethylethane sulfonate) 和亚硝基胍 (N-methyl-N-nitro-N-nitrosoguanidine) 等。烷化剂可能通过几种不同途径, 引起突变: ①给 G 添加甲基或乙基, 使它的结构像 A, 可跟 T 配对, 产生配对误差 (图 11-15); ②烷化的 G 脱掉嘌呤造成脱嘌呤 (depurination) 作用, 在 DNA 链上留下一个缺口, 影响 DNA 的复制, 或使核苷酸顺序缩短, 引起移码突变; ③同一 DNA 分子或不同 DNA 分子间的两链间形成交联 (cross-linkage), 使一个或几个核苷酸丢失或被切除。
很多烷化剂不仅有毒,而且可以诱变和致癌。由于烷化剂在工业上应用广泛,如果使用不当,可造成环境污染,会对使用者和附近群众造成危害,这是应该多多注意的。
7-乙基鸟嘌呤(mG) T
(a)
(a)
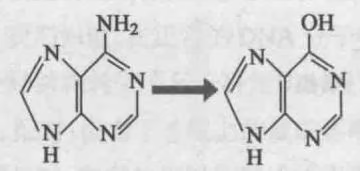
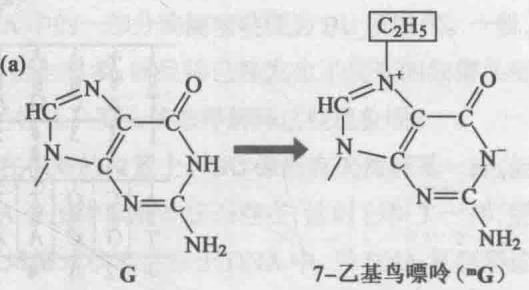
(b)
(b)
(c)
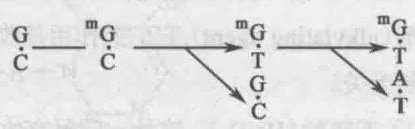
(a) 亚硝酸使 A 脱去氨基, 成为 H, 使 A—T 转换为 G—C。(b) 亚硝酸使 C 脱去氨基, 成为 U, 使 G—C 转换为 A—T。
(a) G 的烷化。(b) ${}^{m}$ G 与 T 配对。(c) 配对行为改变, G—C 转换为 A—T( ${}^{m}$ G 表示 7-乙基鸟嘌呤)。
三、结合到 DNA 分子上的诱变剂
吖啶类是另一类重要的诱变剂,因为这类药物能使在细胞内生长的病毒出现移码突变。所谓移码突变,就是由于DNA分子的某一位置上缺失或插入一对或几对(非3倍数)核苷酸而造成遗传密码的移位。由于遗传密码以3个核苷酸为一组而且是连续的,所以在缺失或插入核苷酸之后的密码都成为错误密码,都将翻译为不正常的氨基酸,甚至提早终止。这种突变型称为移码突变型。例如一个正常基因的密码子是……UUU AAA UUU……当增加一个A时,就使编码顺序改变,成为……AUU UAA AUU U……这样就引起了基因突变。相反,失去一个核苷酸对,也将引起同样的遗传后果(图11-16)。
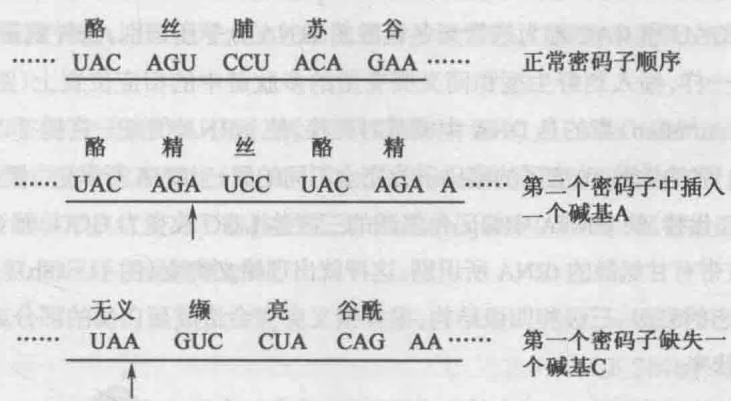
吖啶类诱发突变的一个重要特征是,吖啶类化合物所诱发的突变型能用吖啶类回复,但不能由碱基类似物回复。这是因为吖啶类引起移码突变是通过增加或减少一个或几个碱基对实现的,所以增加一个碱基对的突变型可由邻近一个碱基对的缺失而使遗传密码又回复原来阅读框,出现回复突变,这自然不能由碱基对替换来实现。
吖啶类化合物包括原黄素(proflavine)、吖黄素(acriflavine)和吖啶黄(acridine yellow),是较为扁平的分子,能够与DNA结合,插入邻近碱基对间,使它们分开。吖啶类的诱变作用跟遗传重组有关,并且认为插入的吖啶分子使DNA双链歪斜,导致遗传交换时排列出现参差,结果出现不等交换,产生的两个重组分子,一个碱基对增加,一个碱基对减少(图11-17)。
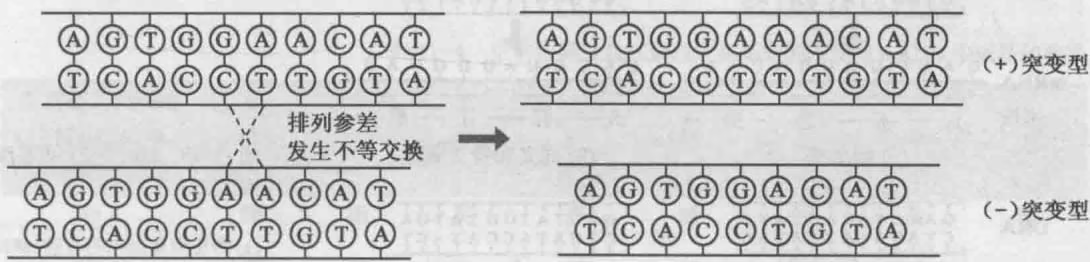
一般认为,吖啶分子插入邻接的两碱基对间,使 DNA 分子歪斜,因而在遗传重组时排列参差。交换发生在非同源碱基对间,形成的重组分子,一个碱基对增加,一个减少,即不等交换。
四、基因突变与氨基酸顺序
蛋白质合成时,双链 DNA 上的遗传信息先传递给单链 mRNA,然后以 mRNA 为模板,合成多肽。mRNA 上的核苷酸以 3 个为一组,作为一个密码子,被一个特定的 tRNA 分子识别,并由它把正确的氨基酸接到延伸中的多肽链上。所以 DNA 分子的核苷酸顺序的改变,不论是起因于碱基替换,还是起因于移码突变,都有可能使该基因决定的多肽的氨基酸顺序发生改变。
不同碱基替换对多肽中氨基酸顺序的影响不同,可以是同义的,可以是错义的,也可以是无义的。同义突变(synonymous mutation)指不改变氨基酸序列的碱基替换,一般不易认出。因为虽然 DNA 组成变了,某一密码子不同了,但在多肽链中仍插入同一氨基酸。例如天冬氨酸由三联体 GAU 或 GAC 编码,DNA 中一个碱基对的替换,使 mRNA 密码子由 GAU 变为 GAC,因为密码子 GAU 和 GAC 都为携带天冬氨酸的 tRNA 分子所识别,这种氨基酸就像没有发生过碱基替换时一样,插入到野生型和同义突变型的多肽链中的相应位置上(图 11-18b)。错义突变(missense mutation)指的是 DNA 中碱基对替换,使 mRNA 的某一密码子改变,由它所编码的氨基酸不同。那就是说,改变了的密码子为完全不同的另一 tRNA 所识别。例如 DNA 中碱基对 T—A 被 G—C 代替,使 mRNA 中编码色氨酸的三联体 UGG 改变为 GGG,而 GGG 是甘氨酸的密码子,因而被带有甘氨酸的 tRNA 所识别,这样就出现错义突变(图 11-18b)。因为多肽链中氨基酸顺序决定它的二级、三级和四级结构,很多错义突变会造成蛋白质的部分或完全失活,从而表现出突变性状来。
碱基替换改变了 mRNA 上的一个密码子, 成为 3 个终止密码子 UAG、UAA 和 UGA 中的任意一个时, 就出现无义突变 (nonsense mutation)。如无义突变出现在基因中间, 翻译进行到终止密码子, 肽链的延长停止, 只能产生截断的多肽, 往往没有活性 (图 11-18c)。
移码突变时,DNA 分子中添加或减少一个(或几个)碱基对,它们的效应是使密码子读框改变,从添加或减少一个碱基对的那个密码子开始,一直到信息的末尾都出现误读,产生的多肽可能会有错乱的氨基酸顺序;或者在误读中出现无义密码子,多肽延伸提早停止,只形成无活性的多肽片段(图 11-18d)。这些突变往往会使合成的酶或蛋白质的活性降低,或完全失活,结果突
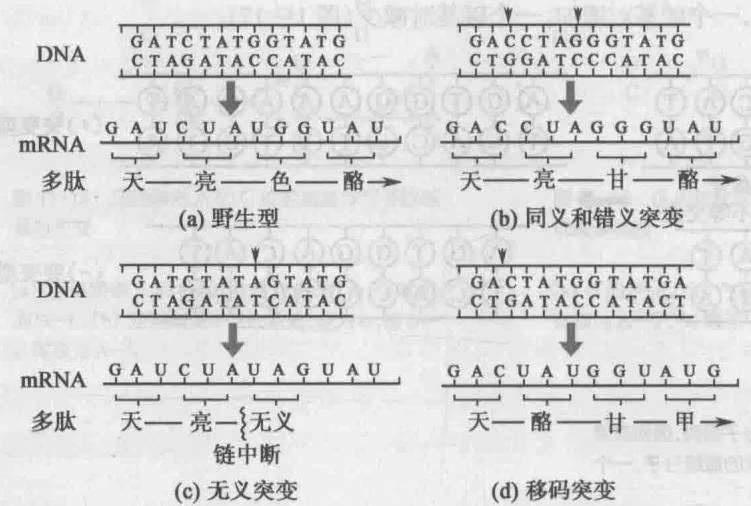
(a) 野生型基因和相应的 mRNA 的一小段核苷酸顺序,以及被这一小段所决定的多肽的氨基酸顺序。(b) 天冬氨酸密码子发生一个同义突变,色氨酸密码子出现一个错义突变。(c) 色氨酸密码子发生一个无义突变。(d) 天冬氨酸密码子发生一个移码突变。DNA 链上的小箭头指出突变发生的地方。
变体不能存活,或显示出突变性状来。
五、基因突变与血红蛋白病
上面已简单地说明碱基替换或碱基增减可能是突变的原因,我们现在以血红蛋白病为例,说明这是由于血红蛋白基因中 DNA 碱基发生变化,引起 mRNA 中碱基的相应更改,导致血红蛋白分子中珠蛋白的结构发生变异而导致的疾病。
(1) 错义突变 镰状细胞贫血主要发生在非洲,我国新疆地区也有发生。这是由一对突变基因 HBB 控制的,我们在前面已谈到过,纯合子 $HBB^{S}HBB^{S}$ 的红细胞在缺氧时,都成为镰刀形,他们的红细胞中有一种不正常的血红蛋白,叫作血红蛋白 S(Hb S)。杂合子 $HBB^{A}HBB^{S}$ 的红细胞在缺氧时,一部分成为镰刀形,他们的红细胞中有 40% 左右的异常血红蛋白 Hb S,还有 60% 左右是正常的成人血红蛋白 Hb A。而正常人的红细胞不会呈镰刀形,红细胞中的蛋白质都是正常的,都是 Hb A。
Hb A 和 Hb S 在电场中迁移率不同, 所以不同基因型的人 $(HBB^{A}HBB^{A}, HBB^{A}HBB^{S}, HBB^{S}HBB^{S})$ 可以通过蛋白质电泳来鉴定(图 11-19)。Hb S 是最早发现的异常血红蛋白, 以后由于实验技术的进展, 新的异常血红蛋白不断被发现, 如 Hb Siriraj、Hb Luhe 等, 现在报道的异常血红蛋白已达数百种之多, 而且还在继续增加中。
图 11-19 血红蛋白的电泳图(引自 Pauling 等, 1949)
血红蛋白在 pH 6.9 的磷酸缓冲液中的电泳情况。正常血红蛋白向一极泳动,镰状细胞贫血患者的血红蛋白向另一极泳动,而杂合个体的血红蛋白正像两者的混合。
分析 Hb A、Hb S、Hb Siriraj 和 Hb Luhe 的氨基酸组成, 发现这些血红蛋白 $\beta$ 链上有一个氨基酸的不同。现在把 $\beta$ 链氨基端作为起点, 将有关氨基酸列出来, 看哪个氨基酸被替换了。
从表 11-4 可以看到,从 N 端算起,在 $\beta$ 链的第 6 位上,Hb A 含有的氨基酸是谷氨酸,Hb S 含有的氨基酸是缬氨酸,可见只要有一个氨基酸的替换,就可使血红蛋白的性质改变,能够引起溶血性贫血这样严重的疾病。Hb Siriaj 和 Hb Luhe 则分别在第 7、8 位上发生了氨基酸替换。
表 11-4 正常和异常血红蛋白中氨基酸的改变与 mRNA 中碱基的替换
| β链氨基酸顺序 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 正常的氨基酸 | 缬 | 组 | 亮 | 苏 | 脯 | 谷 | 谷 | 赖 |
| 正常的密码子 | GUA | CAU | CUU | ACU | CCU | GAA | GAA | AAA |
| Hb A | 缬 | 组 | 亮 | 苏 | 脯 | 谷 | 谷 | 赖 |
| Hb S | 缬 | 组 | 亮 | 苏 | 脯 | GUA 绒 | 谷 | 赖 |
| Hb Siriraj | 缬 | 组 | 亮 | 苏 | 脯 | 谷 | AAA 赖 | 赖 |
| Hb Luhe | 缬 | 组 | 亮 | 苏 | 脯 | 谷 | 谷 | CAA 谷胺 |
(2) 终止密码子突变 终止密码子(UAA、UGA、UAG)的一个碱基被取代,使突变后的密码子能编码某一氨基酸,这实际上也是碱基替换的一种,只不过替换的碱基是终止密码子中的碱基而已。
因为 Hb A α 链有 141 个氨基酸, β 链有 146 个氨基酸, 所以 α 链的终止密码子在 142 位, β 链的终止密码子在 147 位。当终止密码子发生突变时, 肽链合成将向 C 端延伸, 直到遇到另一终止密码子为止。例如异常血红蛋白 Hb Constant Spring, α 链 142 位的 UAA 变为 CAA, 终止密码子变为谷氨酰胺, 肽链一直延伸到 173 位另一终止密码子为止, 所以 Hb Constant Spring 的 α 链有 172 个氨基酸(图 11-20)。
(3) 无义突变 血红蛋白病中,也有正常终止密码子前的某个碱基发生无义突变,成为新的终止密码子,因而使肽链缩短的情况。例如异常血红蛋白 Hb McKees-Rock 的 $\beta$ 链只有 144 个氨基酸,这是由于 $\beta$ 链 145 位的密码子 UAU 变为 UAA,成为另一终止密码子,所以肽链合成到 144 位氨基酸时提前终止,使 $\beta$ 链 C 端少了两个氨基酸。
(4) 移码突变 如果在正常密码子中插入或缺失 1~2 个碱基, 那么其后面的碱基便依次推后或移前, 结果三联体密码子的碱基成分便发生变化, 由此决定的氨基酸也发生改变, 而且肽链的合成也将不在原来的位置终止, 而在移码后出现的新的终止密码子处终止, 以致合成的肽链延长或缩短。例如异常血红蛋白 Hb Wayne 是 $\alpha$ 链 138 位 UCC 缺失一个 C, 使 $\alpha$ 链的合成不在原来应该终止的地方停止, 而一直到 146 位合成精氨酸后才终止, 从而使 $\alpha$ 链延长 (图 11-20)。
上述镰状细胞贫血的出现以及其他血红蛋白病的产生,不论是由于碱基替换,还是碱基的增减,都清楚地表明,血红蛋白基因的碱基改变,引起 mRNA 碱基顺序的改变,从而导致血红蛋白中珠蛋白氨基酸排列的改变。
在这一节结束的时候还要再说明一点, 因为是 $\alpha-$ 珠蛋白基因决定 $\alpha$ 肽链, $\beta-$ 珠蛋白基因决定 $\beta$ 肽链, 而不是决定整个血红蛋白, 这就是为什么学者们要把 “一个基因一个酶” 假说改为 “一个基因一条多肽” 假说的道理。感兴趣的读者可结合后续基因表达调控章节, 进一步思考 “一个基因一条多肽” 的表达是否就完全精准了呢?
Hb Constant Spring, 终止密码子的一个碱基替换导致肽链延长; Hb Wayne, 缺失一个碱基导致移码突变后肽链延长。
解释下列名词: 基因突变, 自发突变, 诱发突变, 可见突变, 生化突变, 致死突变, 回复突变, 突变率, 碱基替换(转换和颠换), 移码突变, 无义突变, 错义突变, 同义突变。
从改变遗传信息的角度,基因突变可以分为哪几类?请分别描述它们的突变特点及遗传信息的变化。
进行 Muller-5 测验时, 要检验的雄蝇与 Muller-5 雌蝇交配得到 $F_{1}$ 后, 一定要做单对交配, 观察 $F_{2}$ 的分离情况。为什么一定要做单对交配?
为什么多倍体可以阻止基因突变的显现?同源多倍体和异源多倍体在这方面有什么不同?
5. 在鸽子中,有一伴性的复等位基因系列,包括
$$
B ^ {A} = \mathrm{灰红色} \qquad B = \mathrm{野生型(蓝)} \qquad b = \mathrm{巧克力色}
$$
显性可以认为是完全的,次序从左到右。我们已经知道鸟类的性决定是:♂ZZ,♀ZW。
基因型 $B^{A}b$ 的雄鸽是灰红色的, 可是有时在它们的某些羽毛上出现巧克力斑点。请对这现象提出两个说明, 一个从染色体方面, 一个从基因方面。
如果在遗传型 $B^{A}(-)$ 的雌鸽中出现斑点,这斑点往往是巧克力色,但在这类鸽子中有时也可看到蓝色斑点。这个事实对你的上述两个解释中哪一个有利?
在一牛群中, 外貌正常的双亲生产一头矮生的雄犊。这种矮生究竟是由于突变的直接结果, 是由于隐性矮生基因的“携带者”的偶尔交配后发生的分离, 还是由于非遗传(环境)的影响? 你怎样决定?
一野生型的雄果蝇与一个白眼基因纯合的雌果蝇杂交,子代中发现有一只雌果蝇具有白眼表型。你怎样决定这个结果是由于一个点突变引起的,还是由于缺失造成的?
用 4000 r 的 X 线照射, 使处理过的果蝇配子中有 12% 发生了性连锁隐性致死突变。假定在没有照射过的果蝇配子中, 几乎没有可检出的突变发生, 又假定突变率与剂量之间有严格的线性关系, 请问, 用下列剂量进行照射时, 预期发生的致死突变率各为多少?
$$
(1) 1 0 0 0 \mathrm{r}; (2) 2 0 0 0 \mathrm{r}; (3) 5 0 0 0 \mathrm{r}; (4) 6 0 0 0 \mathrm{r} 。
$$
原子弹在日本长崎和广岛爆炸后, 最初的一个遗传学研究是调查受到过辐射的个体, 了解他们的子女性比情况。为什么?
在辐射的剂量效应中,一般认为易位的出现需要两个独立的断裂。所以易位的频率大致上与剂量的平方成比例。可是在多数实验中,易位的出现往往与剂量的3/2次方成比例。这可能是由于某些断裂重新愈合的结果。
现在有一实验,对果蝇的精子进行照射,在每100个存活的子代中,发现易位的数目如下:
| 照射剂量 | 500 r | 1 000 r | 2 000 r |
|---|---|---|---|
| 未成熟精子 | 8 | 27 | 70 |
| 成熟精子 | 1 | 7 | 13 |
根据公式 $y = kD^2$ ,计算剂量 $D = 0.5\mathrm{kr} (= 500\mathrm{r})$ 时的 $k$ 值,然后利用这个 $k$ 值计算 $D = 1\mathrm{kr}$ 和 $D = 2\mathrm{kr}$ 时的 $y$ 值。把这些预期值与用公式 $y = kD^{3/2}$ 所得的数值相比较。你得出什么样的结论?
- 在大肠杆菌的色氨酸合成酶的蛋白质 A 的某一位点(位置 223)上观察到下列氨基酸的替换:
问:①假定每个氨基酸的替换只是由一个核苷酸的改变引起的。利用遗传密码表,指出什么密码子适合这系列的变化?②你预期哪两个突变结合能重组形成野生型(Gly)?③哪两个突变结合不能重组形成野生型?④上述氨基酸的改变中,哪一个表示碱基转换?哪一个是碱基颠换?
- 某研究小组利用 Southern 印迹的方法对不同的囊性纤维化患者家系进行了研究。研究者针对 CFTR 基因突变特点设计了两种杂交探针,其中野生型探针 oligo-N 能够和野生型 CFTR 编码基因特异性结合; $\Delta F508$ 突变型探针 oligo- $\Delta F$ 能够与造成 CFTR 的 508 位苯丙氨酸缺失的突变等位基因特异性结合,结果如下图所示。我们用 C 表示野生型 CFTR 编码基因,c 表示造成 CFTR 的 508 位苯丙氨酸缺失的突变等位基因。请问:
(1) 请写出家系 A 中父母和儿子的基因型。
(2) 请尝试解释 CFTR 的 508 位苯丙氨酸缺失突变导致囊性纤维化的遗传机制。
(3) 在家系 B 中, 全部个体的 DNA 都仅与野生型探针有杂交条带, 提示他们均不携带 c, 如何解释子女患病的原因?
(4) 如何解释家系 C 中子女患病的原因?
- 某同学在获得了一只携带点突变的杂合小鼠和一只携带 20 bp 缺失的杂合小鼠,为了实验需要,它将突变体分别与野生型小鼠杂交,得到了 $F_{1}$ 。为了确认子代的基因型,需要剪尾巴抽提基因组 DNA,做基因型分析。请你帮他设计不同的分子生物学实验方法分别鉴定点突变和缺失突变(结合第五章的相关知识)。
数字课程学习

在线自测 习题答案
第十二章 重组、转座与 DNA 损伤修复
我们在本书的多个章节都提到了重组现象,比如减数分裂中非姐妹染色单体的重组交换,细菌接合和转导中的同源重组等,但我们对重组的分子机制还了解甚少。我们将在这一章中简要介绍重组的分子机制,以及与 DNA 重组相关的一种特殊的 DNA 行为——转座。此外,基因突变的修复机制也与重组有关,我们在此章一并介绍。
另一方面,本章和前两章介绍的遗传物质的改变密切相关。减数分裂中的重组交换是真核细胞有性生殖过程中增加变异的重要手段:发生在单个基因内部的重组交换也可以产生基因突变,发生在不同基因之间的重组交换可以在子代中产生新组合,增加群体的遗传变异。使基因位置发生变化的转座也是一种有效的诱发突变方法,曾被大量用于模式生物的基因功能研究中。一些错误倾向性的DNA修复手段会直接产生基因突变。
第一节 重组的分子基础
重组或交换是遗传学的基本现象。一方面,它是遗传分析的主要手段,在遗传学研究中应用广泛;另一方面,动、植物育种工作者应用遗传重组,培育出优良的品种。在自然界中,遗传重组形成各种基因组合,通过自然选择,把能产生有利性状的基因组合选留下来,使生物不断地向前发展。
关于重组的机制研究还在继续。现在我们先评价有关基因重组的两个学说,然后再从分子水平对重组现象加以阐述。
一、基因重组的可能机制
关于基因重组的假设很多,但有两个模型受到广泛注意,一个是断裂愈合模型(breakage joining model),另一个是模写选择模型(copy-choice model)。
(1) 染色体断裂愈合模型 这个模型是达林顿(Cyril Dean Darlington, 1903—1981)(1937)提出来的。他观察到,减数分裂前期I时,一对同源染色体相互吸引,进行联会,而当每一染色体分成两个单体时,两对染色单体又互相排斥。他根据这些现象,提出设想,认为在联会时,两同源染色体互相缠绕,形成相关螺旋,这时染色体内扭力和染色体间扭力保持平衡。但当染色体分成染色单体时,同源染色体间的引力被斥力代替,这时平衡受到破坏,只有当两个非姐妹染色单体在同一点上同时断裂时,平衡才得以恢复。染色单体断裂后,断裂端环绕未断裂的染色单体旋转,螺旋部分松开,在这一过程中,一条染色单体的断裂端跟另一非姐妹染色单体的相应断裂端接触,互相愈合,形成重组的染色单体(图12-1)。根据这个断裂愈合模型,重组始终是交互的,而且每发生一次断裂愈合,在所形成的4条染色单体中,必然两条是亲代类型,两条是重组类型。
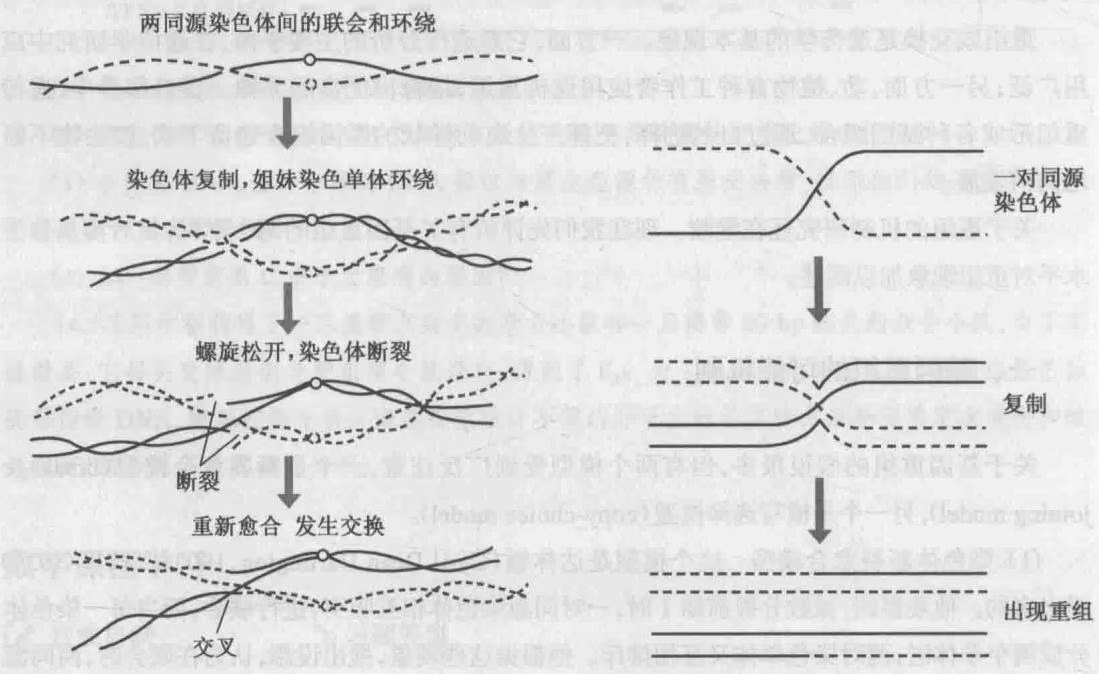
图12-2 模写选择模型示意图
达林顿的模型能解释某些观察到的现象,但是重组并非始终是交互的,在一个减数分裂的4个产物中,不一定总是2:2分离的,所以这个模型是不完全的。
(2) 模写选择模型 这一模型是贝林(John Belling, 1866—1933)(1931)提出来的,之后为了说明细菌的重组,又得到了重视。这个模型认为,重组是复制的直接结果。复制时以每一亲本染色体为模板,形成一条子染色体。在复制过程中,子染色体可以调换模板,本来是以某一亲本染色体为模板,转而以另一亲本染色体为模板,所以形成的子染色体一部分以父本染色体为模板,一部分以母本染色体为模板。复制产生的4条染色体中,两条是重组类型染色体,两条是亲代类型染色体(图12-2)。
这个模型虽能说明细菌和病毒的重组现象,但是这个模型也是不完全的。因为根据这个模型,每对姐妹染色单体中,只有一条染色单体可以参与交换,而另外一条染色单体应该保持亲本原型,而我们从真菌的四分子分析知道,三线或四线双交换也同样存在。还有,这个模型需要DNA的保留复制,而我们已清楚地知道,DNA是半保留复制的。如果每一染色单体相当于一个DNA分子的话,那么这个模型要求重组染色体全是新DNA,而亲本型染色体全是旧DNA,这显然又跟事实不相符合。
利用四分子分析可以清楚地了解重组现象,因为减数分裂的产物可以分离出来加以分析。从这些分析知道,虽然重组是一个非常精确的过程,但有时也会出现不规则情况,产生异常分离,所以任何重组模型不仅需要说明正常的重组过程,还必须考虑到这些不规则现象,因此我们在讨论重组的分子基础以前,先说明一下重组模型还应当兼顾到的基因转变(gene conversion)现象。
二、基因转变
重组通常是交互的。例如在一个杂合子中,如果一染色体把基因 $A$ 交给它的同源染色体,则它的同源染色体必定把基因 $a$ 交还给它。所以在真菌中,一个座位上的两等位基因分离时,应该呈现2:2分离。可是林德格伦(Carl Clarence Lindegren,1896—1987)在酿酒酵母(Saccharomyces cerevisiae)中发现,有的子囊含有 $(3A + 1a)$ 或 $(1A + 3a)$ 的子囊孢子,而不是预期的 $(2A + 2a)$ 。以后研究者在粗糙链孢霉中也发现这个现象(Mitchell,1955),揭示了这个问题的重要意义,并进行了详细的分析。
链孢霉的杂交实验中所用的基因参与吡哆醇(pyridoxine,维生素 $B_{6}$ )的合成。有一突变基因在某一位点上发生了突变,相应的突变株要在培养基中添加吡哆醇后才能生长,但对酸度是敏感的,改变酸度后,就不再是吡哆醇依赖型的了。该突变基因记作pdxp。在一邻近的位点上,也有一突变基因,也是吡哆醇依赖型突变,但对酸度不敏感。该突变基因记作pdx。这两个突变位点非常接近,可能属于同一顺反子。
将两个吡哆醇突变株杂交: + pdxp \times pdx + ,取得子囊后,将585个子囊中的孢子依次分离出来,进行培养和鉴定。实验结果发现4个子囊中出现了野生型的孢子对,好像发生突变的两位点间有了重组(表12-1),可是跟预期不符的是,没有发现重组后应该同时出现的双突变(pdx pdxp)孢子对(图12-3)。实验分析方法是灵敏的,因此如果有双突变型的话,是能够检出的。还有这些情况也不能用突变来说明,因为它们的实际频率比这些位点的正常突变率高得多。
(a)
表 12-1 粗糙链孢霉的两突变株杂交 \left( {+p{dx} \times {pd}{xp} + }\right) 后出现野生型孢子对的子囊类型
| 孢子对 | 子囊 | |||
| 1 | 2 | 3 | 4 | |
| 第一对 | + pdxp | pdx + | ++ | pdx + |
| 第二对 | ++ | pdx + | + pdxp | + pdxp |
| 第三对 | + pdxp | ++ | pdx + | ++ |
| 第四对 | pdx + | + pdxp | pdx + | pdx + |
注:每一子囊内的4个孢子对(8个孢子)中,只有一个孢子对是完全野生型,但没有相对应的双突变型。
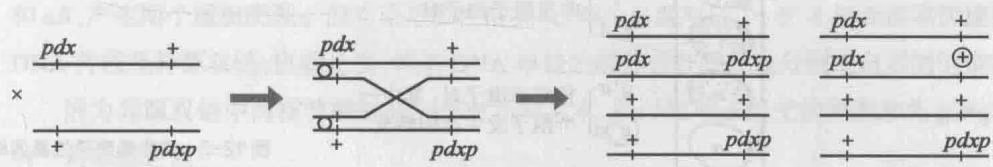
(b)
图 12-3 粗糙链孢霉的基因转变
两吡哆醇依赖型的突变株杂交时,由于重组,出现完全野生型的孢子对和双突变型孢子对(a)。发生基因转变后,pdx 位点出现异常的 3:1 分离,但紧密连锁的 pdx 位点却显示正常的 2:2 分离 (b)。基因的外面加一圆圈,表示发生了转变。
(a)
上面这些不寻常的情况,好像是一个基因转变为另一等位基因,所以称为基因转变。例如图12-3中,pdxp转变为野生型(+)。基因转变往往伴有转换区外基因的重组,但区外基因的重组是正常的交互方式,所以虽然pdxp位点出现异常的3:1(或6:2)分离。但邻接的pdx位点仍显示正常的2:2分离。
在粪生粪壳菌(Sordaria fimicola)中也发现了基因转变(Olive,1967)。粪壳菌的g基因座上, $g^{-}(g)$ 决定子囊孢子灰色,而 $g^{+}(+)$ 决定子囊孢子黑色。在 g^{+}\times g^{-} 杂交中,他们分析了200 000子囊,发现有0.06%是5:3分离,0.05%是6:2分离,还有0.008%是3:1:1:3或异常的4:4分离(图12-4)。在异常的4:4子囊中,虽然也有4个 $g^{+}$ 和4个 $g^{-}$ ,但是排列方式特殊,一个孢子对中的两个孢子有着不同的基因型,而我们知道,每一孢子对都是一次有丝分裂的产物,它们应有同样的基因型。此外,虽然g/+这对等位基因表现不寻常的分离,但是邻近的基因A/a呈现正常的分离(图12-5),与粗糙链孢霉的情况一样。
4:4
6:2
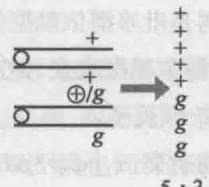
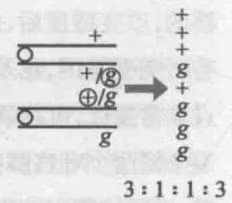
转变的基因外面加一圆圈。(a) 正常分离。(b) 染色单体转变。(c)、(d) 半染色单体转变。
在 6:2(或 2:6) 子囊中(图 12-4b),减数分裂的 4 个产物中,有一个产物发生基因转变,所以是染色单体转变(chromatid conversion)。而在 5:3(或 3:5) 或 3:1:1:3 的子囊中(图 12-4c 和图 12-4d),减数分裂的 4 个产物中,有一个或两个产物的一半出现基因转变,所以是半染色单体转变(half-chromatid conversion)。一个染色单体相当于一个 DNA 分子,转变可以影响一个 DNA 分子的双链,也可仅仅影响其中的一条链。
在 5:3 和 3:1:1:3 的分离中, 基因转变只影响半染色单体, 所以分离一定发生在减数分裂后的有丝分裂中, 所以叫作减数后分离 (post-meiotic segregation)。
1 | g ^ {+} A \times g ^ {-} a |
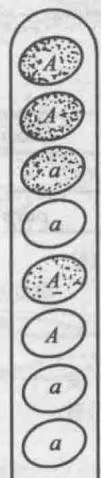
$$
\left. \begin{array}{c} g ^ {+} A \ g ^ {+} A \end{array} \right}
$$


重组子孢子对, 其中一个孢子发生基因转变
$g^{-}a$ 非重组子孢子对 $g^{-}a$
图 12-5 粪生粪壳菌的基因转变造成异常 4:4 分离
一个子囊, $g^{+}$ (图中加点)和 $g^{-}$ (图中未加点)显示3:1:1:3分离(或异常的4:4分离),但A/a显示正常的4:4分离。转变的基因用外面加圆圈来标明。在这个例子中,g基因座发生基因转换,而旁侧的A基因座发生同源重组。
粪生粪壳菌的基因转变现象还有两个值得注意的特点:①显示5:3和6:2分离的子囊中,大约有30%也在g座位的两侧发生重组;②有基因转变的子囊中,基因转变和遗传重组都发生在同样两条染色单体的子囊比例竟高达90%(见图12-5)。换句话说,基因转变跟遗传重组是有关的。
基因转变在子囊菌 Ascobolus immersus 和果蝇中也有发现。如果有合适的检出方法,也有可能在其他生物中观察到。
三、遗传重组的分子基础
断裂愈合学说认为,遗传重组时,两染色单体在相同的点上断裂,然后以新的组合连接起来。如果染色单体不是在相应的点上断裂和愈合,那么形成的染色体将有重复和缺失,即发生我们前面所讲述的非同源末端连接。
四分子分析的结果使我们对重组现象有了进一步的认识。重组不仅有正常的交互方式,而且偶尔也有不规则的非交互方式,例如基因转变。基因转变往往与正常互换有关,两者有相当多的机会影响到相同的两条非姐妹染色单体。还有,有的子囊出现减数后分离,表明重组可以影响染色单体,也可影响半染色单体。
为了解释上面这些现象,一些学者提出了不同的重组模型,其中霍利迪(Robin Holliday,1932—2014)(1946)提出的一个重组模型受到多数学者的支持,以后又经过一些学者和霍利迪本人的修改,叫作异源双链或杂种DNA模型(heteroduplex or hybrid DNA model),适用于原核生物和真核生物。
根据这个模型,重组过程是这样的(图 12-6):一对同源染色体有4条染色单体,每一染色单体是一条DNA双链,所以有4条DNA双链。在晚偶线期和早粗线期染色体配对时,内切核酸酶识别同源DNA分子上的相应断裂点,在断裂点的地方把磷酸二酯键切断,使两个非姐妹DNA分子各有一条链断裂。两断裂链从断裂点脱开,螺旋局部放松,然后在连接酶的作用下,断裂点以交替方式跟另一断裂点相互联结,形成一个交联桥(crossbridge),该结构又称为Holliday中间体(Holliday intermediate)。交联桥不是静态的,可向左右移动,移动后留下较大片段的异源双链。随后这交联桥的两臂环绕另外两臂旋转成为十字形,并在交联部分断开,消除交联体,恢复为两个线性DNA分子。断开方向或沿东西轴进行,或沿南北方向进行。如沿东西方向切断,则产生的两个异源双链的两侧基因为AB和ab,仍保持亲代类型;如沿南北方向切断,则两侧基因为Ab和aB,产生两个重组类型。但不论是哪种情况,在两个异源双链中,在A与B两基因座间都有一DNA片段是异源双链,也就是说,两条DNA单链的部分核苷酸片段分别来自不同的亲本。
因为异源双链中两核苷酸链分别来自不同亲本,所以如用于杂交的两亲本为 g^{+} \times g^{-} ,且两者有一对碱基之差:
1 | g ^ {+} (+) \frac {\mathrm{ACAGT}}{\mathrm{TGTAA}}, g ^ {-} (g) \text {是} \frac {\mathrm{ACATT}}{\mathrm{TGTAA}} |
则异源双链 DNA 区域应为
$$
\frac {\mathrm{ACAGT}}{\mathrm{TGTAA}}
$$
(b)
(d)
(a)
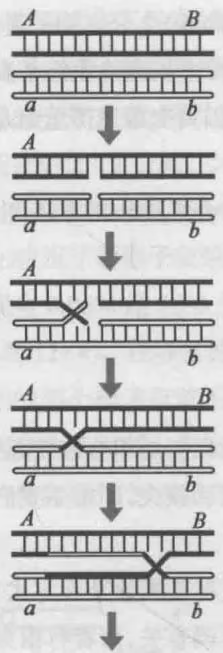
(e)
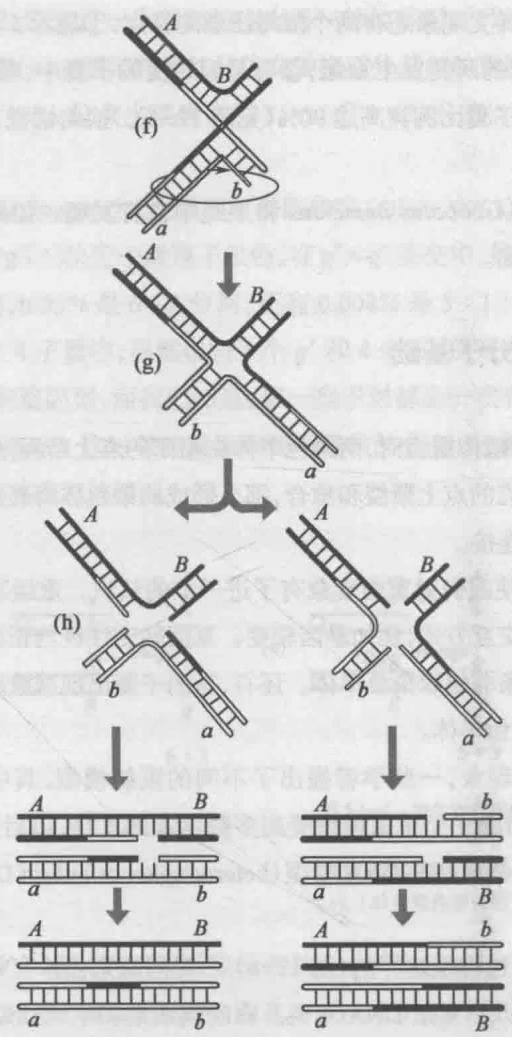
(i)
(j)
图 12-6 遗传重组的 Holliday 模型(仿山口彦之,1979)
(a) 两条 DNA 双链, 相当于减数分裂时两条染色单体, 为简略计, 图中只画出两条染色单体, 另两条未画出。(b) 内切核酸酶识别每一 DNA 分子的相应断裂点, 在每一分子的一条链的相同位点上造成切口, 这两条链的极性相同。(c) 单链的游离端交换位置。(d) 单链连接, 形成一个交联桥。(e) 交联桥的位置移动, 形成较大区段的异源双链区。(f) ~ (g) 交联桥的两臂沿箭头方向旋转, 呈现中空的十字构型。(h) 十字构型的两条单链保持完整, 另外两条单链出现断裂。左侧的交联桥沿东西方向切断, 右侧的交联桥沿南北方向切断。(i) ~ (j) DNA 修补合成。在 A 与 B 两基因座间的中间部分有一较大的异源双链 DNA 区域。至于两侧的标记基因可以不出现重组, 仍保持亲代组合(左图); 也可发生交换, 出现重组类型(右图)。
其中的错配碱基对是 G—A, 那么这样的错配部分如何修补, 造成的结果又是如何呢?
异源 DNA 是不稳定的, 不配对的核苷酸在 DNA 分子中造成歪斜, 不配对的一小段由外切核酸酶切除, 留下单链缺口。然后在 DNA 多聚酶的作用下, 合成具有互补碱基的片段, 填补缺口, 再由连接酶把新合成的短链以共价键连接上去, 成为连续的核苷酸链, 完成修复过程。但是在修复时, 由于切除的不配对碱基片段不同, 可以有两种修复结果。例如错配的碱基对 G—A 的修复, 如果切去 A 所在片段, 则在染色单体中形成一个野生型基因 (+); 如果切去的是 G 所在片段, 就会在染色单体中形成一个突变型基因 (g) (图 12-7)。如果错配的核苷酸没有得到校正, 杂种 DNA (杂种染色单体) 留到下一次复制时, 将产生两个不同的子染色单体, 这样就出现半染色单体转变, 一个孢子对中的两个孢子不同 (图 12-8)。
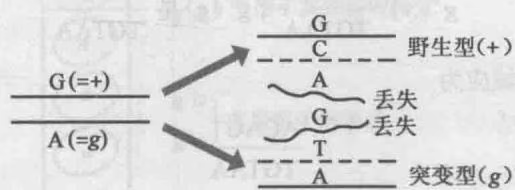
不配对的碱基对由外切核酸酶切除,新合成的互补短链(虚线部分)在连接酶的作用下连接上去。由于切去的不配对片段的不同,校正后或出现野生型,或出现突变型。
图 12-8 用遗传重组的异源 DNA 模型说明基因转变的起源
4 条染色单体全部画出,中间两条单体各有杂种 DNA 片段。校正的片段用粗线标出。① 杂种分子校正,子囊孢子分离正常 (4:4)。② 两个杂种分子都校正为 +,子囊孢子出现 6:2 分离。③ 两个杂种分子都未校正,子囊孢子出现 3:1:1:3 分离。④ 一个杂种分子校正为 +,子囊孢子出现 5:3 分离。
1 | \begin{array}{c c c} \text {正常分离} \\ \text {6:2分离} \\ \text {3:1:1:3分离} \\ \text {5:3分离} \end{array} |
这个杂种 DNA 模型清楚地说明重组是一个酶促过程,不仅 DNA 聚合酶是合成新的互补链所必需的,而且内切核酸酶、外切核酸酶和连接酶等也是 DNA 链的切割、断链的切除和愈合所必需的。
可见,杂种 DNA 模型不仅说明了遗传重组的过程,同时也解释了基因转变的现象,是比较完善的模型。在霍利迪提出此模型后不久,其他学者也提供了许多有力的实验证据。第一个重要证据来自 20 世纪 70 年代初,分子生物学家利用噬菌体和质粒 DNA 在电镜下观察到了交叉成十
图 12-9 Holliday 模型中的十字构型中间体的电镜照片(引自 Potter 等, 1979)
字构型的 Holliday 中间体(图 12-9),并在真核生物细胞中利用质粒 DNA 构建出了 Holliday 模型。随后,Holliday 模型中涉及的多种酶分子从细胞中分离得到,包括第一个重组酶 RecA,它可
以促进 DNA 单链之间的交换,调节重组事件的起始,以及其他多种特异性识别 Holliday 结构的解旋酶、拓扑异构酶等。
随着分子生物学和遗传学的不断发展,更多的实验证据进一步提示,除了 Holliday 模型之外,染色体的同源重组可能也涉及其他分子机制。比如说,在酿酒酵母中发现,染色体重组不是由两条异源的 DNA 单链断裂(single-strand break, SSB) 而是 DNA 双链断裂(double-strand break, DSB) 起始的(Szostak, 1983),据此提出了双链断裂模型:DNA 双链在断裂口扩大成缺口,然后入侵到另一条非姐妹染色单体的断裂端,修复补平,形成杂合双链。除了 DSB,发生在重复 DNA 中的单链复性(single-strand annealing) 以及合成依赖型的单链复性也被认为是促进染色体同源重组的起始事件,但更精确的重组机制还有待这一研究领域的更多进展。
第二节 转座与转座因子
前面我们介绍了 DNA 重组的机理,它可以很好地解释减数分裂中同源染色体是如何发生交换的。在这一节中,我们将专门介绍和 DNA 重组密切相关的另一个重要的遗传学现象——转座(transposition)。我们把细胞中能改变自身位置的一段 DNA 序列叫作转座遗传因子,或简称转座因子或转座元件(transposable element,TE)。所谓转座,简单地说,就是 DNA 序列从基因组的一个位置跳跃到另一个位置的现象。
最早发现转座因子并提出基因在染色体上的位置不是固定不变的科学家是美国遗传学家麦克林托克(Barbara McClintock, 1902—1992), 她早在 1950 年就通过玉米籽粒色斑的不稳定性遗传的研究提出了控制生物性状的遗传因子在染色体上是“可动”的, 能够从染色体的一个位置跳跃到另一个位置, 或者从一个染色体跳跃到另一个染色体上。玉米中控制籽粒色斑的遗传因子被称作激活 - 解离系统 (activator-dissociation system, Ac-Ds system), 我们将在下文详细介绍其中的具体机制。
为了较好地了解转座因子的性质和转座的遗传学效应,我们先从简单的原核生物中的转座因子入手,再讨论较为复杂的真核生物中的转座因子。
一、原核生物中的转座因子
麦克林托克在 1950 年提出遗传因子可以转座的概念,这是超越时代的,当时遗传学家都报以怀疑的眼光。直到 20 世纪 60 年代初期,在大肠杆菌中发现了转座因子,此后陆续在酵母菌、果蝇以及哺乳动物中发现有转座因子的存在,生物学家们才对玉米的转座因子的分子机制有了进一步的认识。为便于在分子水平上阐明转座的机理,先以细菌的转座因子为例来加以叙述。
(1) 插入序列(insertion sequence, IS) IS 是最简单的转座因子, 最初是从大肠杆菌的 lac 突变体中发现的, 这些突变体的基因内部或附近区域出现了一段自发插入的序列, 破坏了 lac 基因的正常结构和相应的功能, 因此被称为插入序列。这种突变体的回复突变率很高, 进一步研究发现, 原来是由 IS 的切除而引起的。
后来的研究发现,IS 是细菌染色体和质粒的正常组成部分,例如,大肠杆菌的染色体上有多种常见的 IS,且每种 IS 的拷贝数不等。正如我们在第八章介绍的,大肠杆菌的 F 因子上也有 IS。IS 的结构非常紧凑,如图 12-10a 所示,IS 的两端是短的反向重复 (inverted repeat, IR) 序列,它们一般相同或近乎相同,长度范围从几个 bp 到几十 bp 不等。IS 的反向重复序列对它的转座能力是必需的。此外,绝大多数 IS 内部编码一个转座酶 (transposase),它是结合 IS 的末端并切割 DNA 的关键酶,也是转座所必需的。最后,IS 成功插入到基因组的另一个位置时,会在插入靶位点上生成新的正向重复 (direct repeat, DR) 序列 (图 12-12b)。插入片段还可以从插入位点再切除,如果切除精确,可使 IS 诱发的突变回复为野生型;不精确切除可使插入位置附近的宿主基因发生缺失,造成突变表型。
(2) 复合转座子(composite transponson, Tn) 复合转座子是细菌中的另一种转座因子。20世纪30年代, 日本东京有一次痢疾流行。从患者排泄物分离到的痢疾菌(Shigella dysenteriae)竟同时具有多重耐性, 对青霉素、四环素、链霉素、氯霉素和磺胺等都有抗性, 而且这些抗性能以紧密连锁的方式一起遗传, 甚至还可传递给其他肠道菌。这种现象很快引起遗传学家的注意, 他们发现带有这些抗性的载体是一种质粒, 很像大肠杆菌中的F因子, 也是一种能独立复制的环状DNA分子。因为这种质粒能够传递抗性基因, 所以称为R质粒(R代表抗性)。
把 R 质粒的环状双链 DNA 分子加热变性, 然后慢慢复性, 在电镜下观察, 发现复性后的质粒是哑铃状: 两端各有一个单链环, 一大一小; 中间是一条双链的柄, 也由两个反向重复顺序形成 (图 12-11)。以后的研究发现, 这两个反向重复序列事实上是一对逆向排列的 IS。因此整个质粒可以分为两部分: 一部分是两个 IS 以及其中间带有的若干基因, 如抗性基因 $str^r$ 等, 这部分合起来就是 Tn; 而质粒的其余部分带有抗性转移功能基因 (resistance-transfer functional gene, RTF gene),
(b)
图 12-10 IS 结构示意图(a)和由于 IS 插入形成的靶位点的正向重复(b)
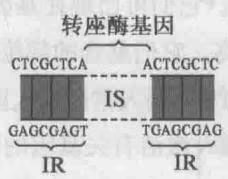
(a)
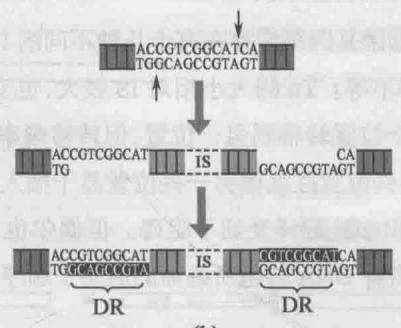
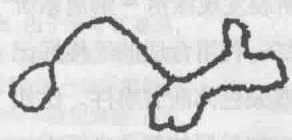
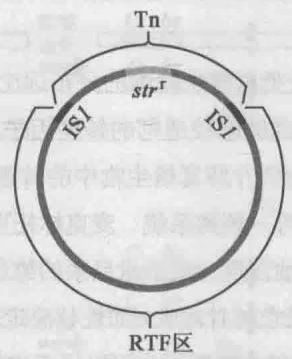
复合转座子包括IS和抗性基因两部分。
所以称为RTF区,如图12-12所示。
Tn 比 IS 复杂一些, 图 12-13 给出了一个典型的 Tn 的结构: 它的内部除了含有转座酶编码基因, 还带有同转座无关的一些结构基因, 如抗药基因; Tn 的两端是两个 IS, 构成了 “左臂” 和 “右臂”。两个臂可以是正向重复, 也可以是反向重复。位于两端的 IS 可以作为 Tn 的一部分随同转座, 也可以单独作为 IS 而转座。转座子插入宿主的靶序列后, 也造成靶序列的正向重复序列。Tn 内部所携带的抗药基因可以随着 Tn 的转座而在基因组中快速传播, 这是上述痢疾流行的原因, 也是自然界中细菌产生抗药性的主要原因之一。表 12-2 列举了一些常见的 Tn 及其组成情况。
Tn
| IR | 转座酶编码基因 | IR | 结构基因 | IR | 转座酶编码基因 | IR | |
| IS | IS | ||||||
图12-13 Tn的一般结构示意图
表 12-2 一些常见 Tn 的结构组成
| 转座子 | 长度 /bp | 结构基因 | 末端 IS | 末端取向 |
|---|---|---|---|---|
| Tn903 | 3 100 | $Kan^r$ | IS903 | 反向 |
| Tn9 | 2 500 | $Cam^r$ | IS1 | 正向 |
| Tn10 | 9 300 | $Tet^r$ | IS10R, IS10L | 反向 |
| Tn5 | 5 700 | $Kan^r$ | IS50R, IS50L | 反向 |
不同细菌基因组内存在有十几种不同的 IS, 各具有特定的碱基顺序, 其大小因 IS 而异, 几十到几千 bp 不等。Tn 的大小相对 IS 较大, 也变化较大。它们可出现在基因组的不同位置, 并且可以从一个位置转移到另一位置, 但转移频率一般不高。它们整合的部位并不具有严格的顺序特征, 但某些位置往往比另一些位置易于插入。IS 或 Tn 的插入常使插入区的基因失活, 因为正常的转录和 (或) 翻译受到了阻碍。但偶尔也可由于插入激活有关基因的转录, 因为 Tn 也可能带有它们自身 DNA 转录所必需的启动子顺序。
二、真核生物中的转座因子
转座因子在各类真核生物中的分布远比遗传学家原先预料的广泛,表12-3列举了几种模式生物中较常见、研究得也较透彻的转座因子。在下文中,我们将以玉米中的激活-解离系统、果蝇中的 $P$ 因子等为例介绍真核生物中的转座因子的结构和行为特征。
(1) 玉米的激活 - 解离系统 麦克林托克是通过研究玉米染色体的断裂发现激活 - 解离系统 (Ac-Ds 系统) 的。她发现一些玉米品系的染色体不稳定, 常发生断裂和丢失, 利用合适的遗传标记 (位于发生丢失的染色体片段上), 如性状决定基因, 可以很好地 “追踪” 这些染色体断裂事件。比如说第 9 号染色体短臂的断裂丢失可以用玉米籽粒三倍体胚乳的最外层——糊粉层的颜色来标识。
在了解麦克林托克的工作之前,我们先要介绍一下玉米的第9号染色体上与糊粉层颜色相关的基因组成,如图12-14所示,在这条染色体的短臂上,有3对与籽粒颜色有关的等位基因。
(b)
表 12-3 几类生物中常见的转座因子
| 生物 | 转座因子 | 机能 |
| 细菌 | 插入顺序(IS) | — |
| 转座子(Tn) | 抗性 | |
| 酵母 | Ty 因子 | 引起突变 |
| 玉米 | 调控因子(Ac-Ds 系统) | 籽粒色泽变化 |
| 果蝇 | P 因子 | 杂交败育 |
| 哺乳类 | 前病毒,反转录转座子 | 致癌作用等 |
C 基因座上有两种等位形式, $C^{l}$ 和 C, 前者是一个显性抑制子, 即单拷贝的 $C^{l}$ 可以发挥显性抑制作用, 抑制糊粉层颜色的发生。而 C 是一个隐性基因, 只有在纯合时才能促进糊粉层颜色的发生。Bz 基因座上也有两种等位形式, Bz 和 bz, 前者是一个显性基因, 在没有 $C^{l}$ 的前提条件下, 单拷贝 Bz 就可以促进糊粉层发育为紫色, 而 bzbz 纯合子则能促进糊粉层发育为褐色。最后一个重要的基因是 Ds, 它是染色体发生断裂的位点所在。
图 12-14 玉米第 9 号染色体上与糊粉层颜色有关的基因组成
图 12-15 Ac-Ds 系统控制玉米籽粒颜色的机制
$C^{i}$ 显性抑制基因,抑制糊粉层的颜色发生; $C^{i}$ 的隐性等位基因 C,纯合时可以促进糊粉层的颜色发生;Bz 显性基因,促进糊粉层发育成紫色;Bz 的隐性等位基因 bz,纯合时促进糊粉层发育成褐色;Ds 解离因子,染色体断裂位点。
(a) $F_{1}$ 三倍体细胞中没有发生断裂,由于存在一个 $C^{i}$ 基因拷贝,发挥显性抑制作用,玉米籽粒为无色。(b) $F_{1}$ 三倍体细胞在 Ds 处发生断裂(在 Ac 存在的条件下),丢失了 $C^{i}$ 基因和 Bz 基因,C 基因座的抑制作用消失,bzbz 纯合子促进糊粉层发育为褐色,无色的玉米籽粒上出现了褐色斑点或条纹。(c) 在一种突变品系中,Ds 在 Ac 的作用下插入到 Bz 基因的内部,造成了 Bz 基因的沉默,由于没有 $C^{i}$ 基因,玉米籽粒表现为全褐色。但是,在籽粒的发育过程中,一些子细胞的 Ds 在 Ac 的作用下继续转座,可从 Bz 基因的内部精确解离出来,Bz 基因发生回复突变,促进糊粉层发育成紫色,褐色籽粒上出现紫色斑点或条纹。
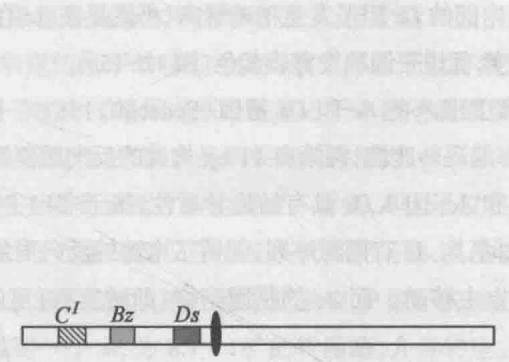
麦克林托克选择了这样一组杂交实验(图12-15),她将CCbzbz__的母本(不含Ds)与 $C^{l}C^{l}BzBzDsDs$ 的父本进行杂交,得到 $F_{1}$ ,观察 $F_{1}$ 的籽粒颜色。在杂合子 $C^{l}CCBzbzbzDs$
(c)
中,由于有一个 $C^l$ 基因的作用,籽粒糊粉层应发育为无色(图12-15a)。事实上,大多数籽粒的确如此,但是,她同时还发现了一些籽粒在无色背景上出现了褐色斑点或条纹,她推断这些褐色斑点所对应的细胞中,染色体在 $Ds$ 基因处发生了断裂,丢失了 $C^l$ 和 $Bz$ 基因,丢失后的三倍体细胞的基因型为 $_CC_bzbz$ ,因此发育为褐色(图12-15b)。而褐色色斑的大小则取决于这一断裂丢失事件发生的时期:如果在胚乳发育早期就发生了染色体的断裂丢失,那么这个变异细胞的所有子细胞都携带发生丢失的第9染色体,褐色色斑的面积就会较大,而如果在胚乳发育晚期才发生染色体的断裂丢失,那么发生丢失的子细胞群较小,褐色色斑也较小。
麦克林托克随后又发现单独的 $Ds$ 并不能直接诱导染色体断裂,而是需要另一个因子的帮助,即 $Ac$ ,意为激活因子, $Ac$ 位于另一条染色体上,存在于某些玉米品系中,只有在 $Ac$ 存在的前提条件下, $Ds$ 才能发生断裂。两者共同构成了一个控制籽粒颜色的系统,因此被称为控制因子。不仅如此,更深入的研究工作让她继续认识到 $Ds$ 不仅能诱导染色体断裂,而是能够从染色体的一个位置上切离,转移到另一个位置。在一种特殊的玉米品系(基因型 $CCCBzbzbzDs_$ )中, $Ds$ 因子直接插入到了 $Bz$ 基因的内部(当然是在 $Ac$ 存在的条件下实现的),造成了该基因的插入失活,由于这一突变发生在配子时期,因此籽粒发育成全褐色。但是,在一些褐色籽粒上出现了紫色花斑,其原因是位于 $Bz$ 基因内部的 $Ds$ 因子发生精确解离(仍然是在 $Ac$ 存在的条件下),从中跳跃出来,造成 $Bz$ 基因的回复突变,促进子细胞发育成紫色(图12-15c)。
1983 年, 研究者成功克隆了玉米的 Ac 和 Ds 基因 (Federoff, 1983)。测序结果表明, Ac 长 4563 bp, 含有 5 个外显子, 内部编码转座酶, 两端有 11 bp 构成的反向重复序列, 是一种能够自主移动的调节因子 (图 12-16)。和 Ac 不同, Ds 具有结构异质性, 属于非自主移动的受体因子。不同的 Ds 长度在 0.5~4.0 kb 之间, 与 Ac 有同源序列, 保留了末端的反向重复序列, 但缺失了转座酶的部分编码序列, 因此不能自主移动。而 Ac 的基因产物 (即转座酶) 可以扩散到 Ds 元件上, 与其结合并帮助其发生转座。
(2) 果蝇的 $P$ 因子 果蝇的基因组中也含有多种转座元件, 但其中, 还数对 $P$ 因子的研究最为广泛, 利用改造后的 $P$ 因子对果蝇基因组进行诱变分析的反向遗传学研究也得到了广泛的应用, 并取得了理想的研究成果。
P 因子的发现源于一个特殊的杂交现象。20 世纪 70 年代,遗传学家发现一些不同品系的黑腹果蝇的杂交后代出现了异常的性状(Kidwell,1977),比如频繁突变,染色体断裂,更重要的是不育。我们把这种现象称作杂种不育(hybrid dysgenesis)。根据杂交后是否产生不育后代,遗传学家把果蝇品系分为了两大类,P 品系和 M 品系。杂交实验显示只有 M 品系的雌蝇和 P 品系的雄蝇杂交才会得到杂种不育的后代,其他杂交条件得到的后代都是表型正常的。通过对不同突变品系的进一步研究和分子杂交实验,遗传学家随后发现造成这一特殊表型效应的“罪魁祸首”是一个具有转座活性的转座因子,P 因子。
图 12-17 给出了 P 因子的结构示意图。P 因子全长 2907 bp,末端含有 31 bp 大小的反向重复序列,内部含有一个转座酶的编码基因,由 4 个外显子 $(0,1,2,3)$ 和 3 个内含子组成。P 因子编码的转座酶能够结合到 P 因子的末端,介导其在基因组中的转座。黑腹果蝇的基因组中除了有拷贝数不定的完整 P 因子,往往还有许多不完整的 P 因子,它们保留了末端的反向重复序列,但内部的转座酶编码基因含有大段缺失,不具有编码功能。但在完整 P 因子存在的条件下,不完整的 P 因子也能在基因组中发生转座。
携带完整 P 因子的果蝇即为 P 品系,不携带完整 P 因子的即为 M 品系。M 品系的雌蝇和 P 品系的雄蝇杂交的 $F_{1}$ 果蝇出现杂种不育的原因是,P 因子在发育中的生殖细胞系中发生转座,染色体出现断裂和重排,导致大量生殖细胞无法发育成熟,因此出现不育性状。
通过前面几种转座因子的学习,我们不难发现,转座对基因组的影响要比单个的基因突变或移码突变严重得多,转座往往给基因组带来明显的有害变异,甚至大段染色体的重排,因此,转座因子不容易通过自然选择而被固定在基因组中。但是,让遗传学家感到非常意外的是,在1950年前野外捕获的黑腹果蝇基本不携带P因子,但此后P因子成功侵入黑腹果蝇基因组(从Drosophila willistoni果蝇的水平转移),并仅用数十年时间就扩散到了全部的黑腹果蝇品系中。深入的研究揭示,P因子成功入侵果蝇基因组是由于P因子能够自行负调控其转座能力,严格控制其在基因组的数目和稳定性,保证P品系果蝇的存活力。
P 因子的转座活性主要受到两方面的调控。首先,P 因子仅在生殖细胞中转座,在体细胞中不能转座。杂种不育的子代果蝇仅仅在生殖系统出现问题,其他器官正常。造成这种差别的原因是细胞特异性 mRNA 加工方式。在生殖细胞系中,P 因子的转座酶编码基因的成熟 mRNA 含有 4 个外显子,能够编码一个 $M_{r}$ 为 8.7 \times 10^{4} 的转座酶,介导转座。但是,在体细胞中,某种特殊蛋白质结合到转座酶编码基因的 2 号外显子上,抑制了 2—3 外显子之间的内含子的剪切,成熟的 mRNA 中保留了这一内含子,最终造成移码突变,终止密码子提前,得到了一条 $M_{r}$ 为 6.6 \times 10^{4} 的截断肽段,不具有转座活性(图 12-18)。
其次,在P品系果蝇的生殖细胞中, $P$ 因子也不发生转座,因此P品系自交后代完全正常。尽管M品系的雌性和P品系的雄蝇得到杂种不育的子代,但是P品系的雌果蝇和M品系的雄果蝇的杂种 $\mathbf{F}_1$ 完全正常,这说明 $P$ 因子的转座活性还受到母系遗传机制的调控。 $P$ 因子能够转座和卵细胞的细胞质类型有关,P品系的细胞型(cytotype)抑制 $P$ 因子转座,而M品系的细胞型允许 $P$ 因子转座。近年来的研究提示P品系雌蝇可能通过表达一种非编码RNA——piRNA
图 12-17 黑腹果蝇中完整 P 因子和不完整 P 因子的结构示意图
空白框表示外显子,斜线框表示内含子,箭头表示末端重复序列。
$M_{r}$ 8.7×10 $^{4}$ 转座酶(生殖细胞)
$M_{r}$ 6.6×10 $^{4}$ 截断蛋白(体细胞)
图 12-18 生殖细胞和体细胞中 P 因子的 mRNA 加工方式
(PIWI-interacting RNA) 并积累在卵细胞中,传递给子代果蝇,发挥抑制 P 因子转座的作用。关于 piRNA 的作用和机制,我们留到后续章节再和读者介绍。
视频14 $P$ 因子转座元件
三、反转录转座和反转录转座子
前面介绍的 IS、Tn、Ac-Ds、P 因子等转座因子进行转座的中间体都是 DNA,也称为 DNA 转座子 (DNA transponson)。真核生物中还有另一类转座因子,它们的转座中间体是 RNA,需要将 RNA 反转录成 DNA 再插入到基因组中实现转座。我们把这种转座称为反转录转座 (retrotransposition)。反转录转座出现在能自由感染宿主细胞的反转录病毒 (retrovirus) 和真核基因组中的反转录转座子 (retrotransponson) 中。
反转录病毒的基因组是单链 RNA, 5’ 和 3’ 端各有一个短的重复序列 R, 分别和 5’ 特异序列 U5 和 3’ 特异序列 U3 连接。基因组的内部是 3 个重要的蛋白质编码基因, 分别为: gag, 编码病毒的核心蛋白; pol, 编码反转录酶; env, 编码包膜蛋白。这些基因的产物是病毒感染宿主和复制所必需的。当病毒 RNA 基因组经反转录酶催化反转录成双链 DNA 时, 病毒 DNA 的末端形成了长末端重复 (long terminal repeat, LTR), LTR 由 U3-R-U5 3 个序列串联而成, 是反转录病毒 DNA 的特有结构, 也是反转录病毒整合到宿主基因组所必需的元件 (图 12-19)。当病毒感染宿主细胞后, 反转录病毒将自身的基因组释放到细胞中, 利用反转录酶以 RNA 基因组为模板合成 DNA, 再以 DNA 为中间体整合到宿主基因组中, 成为前病毒 (provirus), 随同宿主基因组一起复制、转录和翻译, 并在一定条件下重新组装, 裂解宿主细胞, 释放新病毒, 进入下一轮感染。
在真核生物基因组中的反转录转座子可以分为两个基本类型: LTR 反转录转座子 (LTR retrotranponson) 和非 LTR 反转录转座子 (non-LTR retrotransposon)。LTR 反转录转座子结构和反转录病毒非常相似, 因此又被称为反转录病毒类似元件 (retrovirus-like element), 两端含有正向重复的 LTR, 内部是反转录酶编码基因, 能够自主进行转座。它们的转座机制也和反转录病毒类似, 依赖于 RNA 作为中间体, 但是不能像病毒那样裂解细胞并在细胞间进行传播。酿酒酵母中的 Ty1 转座因子是反转录转座子的代表。Ty1 全长约 5.9 kb, 两侧的 LTR 序列长约 340 bp, 内部含有两个蛋白质编码基因 TyA 和 TyB, 分别与反转录病毒的 gag 和 pol 基因同源, 是介导 Ty1 反转录转座所必需的 (图 12-20)。发生转座时, 首先以 Ty1 的基因组 DNA 为模板, 转录产生 RNA 链进入细胞质, 再在 TyB 编码的反转录酶的作用下反转录合成双链 DNA, 新合成的 DNA 拷贝重新入核, 插入到基因组的新位置上, 形成一个新的 Ty1 拷贝。可见 Ty1 的反转录转座可以增加 Ty1 的拷贝数, 多数酵母菌的基因组中都含有约 35 个 Ty1 序列。除了酵母的 Ty1, 果蝇中的 copia、gypsy, 人类中的 HERV (human endogenous retroviruses) 都属于 LTR 反转录转座子。
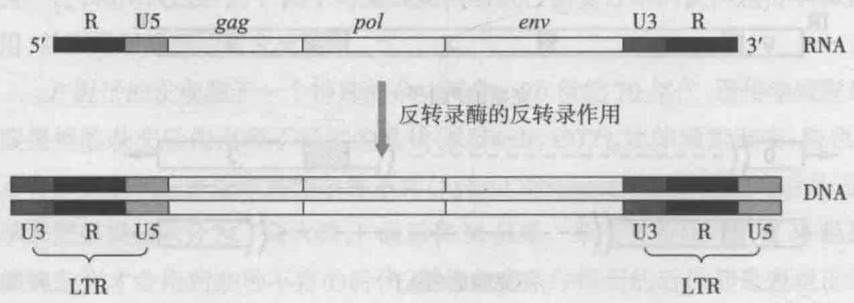
图12-20 Ty1的结构与反转录转座的基本过程
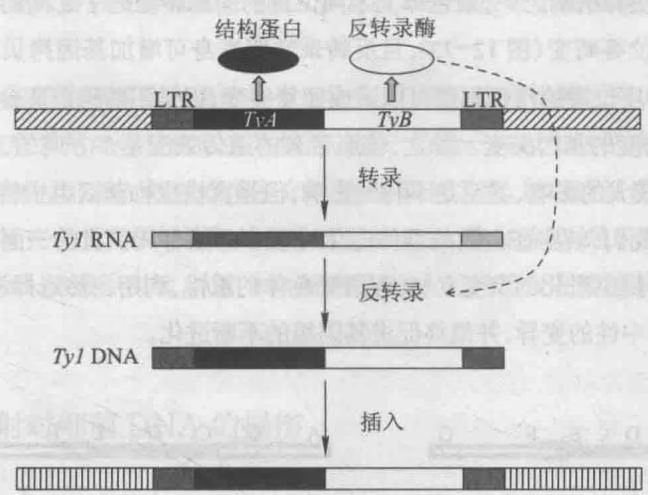
非 LTR 反转录转座子是两端不具有 LTR 元件的反转录转座子,但通常在它的一端有一个特征性的串联排列的 A-T 碱基对,提示了他们是由转录产物的 poly(A) 尾反转录而来。在真核生物基因组中,非 LTR 反转录转座子的分布更为广泛,数量也更多,也被称为反转座子(retroposon)。例如,果蝇中的 HeT-A 和 TART(telomere-associated retrotransposon),人类中的 LINE、SINE 等都属于非 LTR 反转录转座子,我们将在基因组一章向读者详细介绍它们。
我们将本书介绍的各种类型的转座因子的分类总结成图 12-21。随着基因组技术的不断发
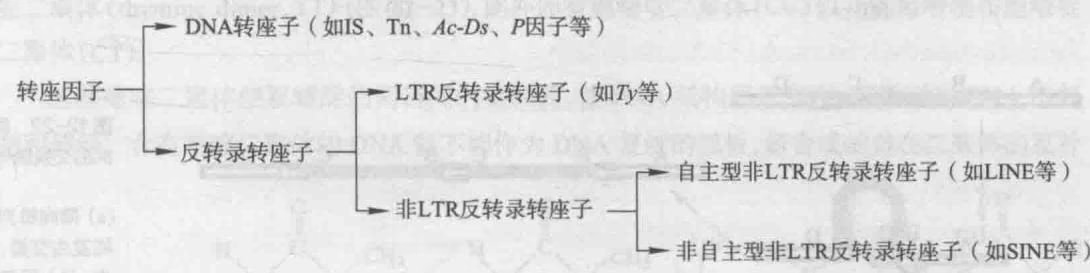
转座因子首先可按照转座机制分为以 DNA 为中间体的 DNA 转座子和以 RNA 为中间体的反转录转座子。后者根据两端序列的特征分为 LTR 反转录转座子和非 LTR 反转录转座子。非 LTR 反转录转座子又可根据能否自主转座分为自主型和非自主型。
展,遗传学家们发现了转座因子在真核生物基因组中的重要地位:全部转座因子在哺乳动物基因组中占比约50%,在一些植物基因组中甚至可以达到90%。毫无疑问,转座是遗传物质的一个非常重要且特殊的属性。
四、转座的遗传效应和进化意义
通过对多种转座因子的学习,我们看到,由转座带来的遗传效应非常广泛和复杂。最常见的效应包括:①插入突变,各种转座元件插入染色体的编码区会导致原基因编码的多肽链提前终止或延长,读框位移,等等,造成基因功能的破坏,插入调控区会导致邻近基因的表达异常;②获得新基因,以Tn为代表的转座元件能够将新的结构基因通过转座传递到受体细胞中;③转座也是诱导染色体结构变异机制之一,染色体上不同位置的同源转座因子之间的交换会诱导染色体发生缺失、重复、倒位等畸变(图12-22),且反转录转座本身可增加基因拷贝,造成重复;④切离突变,转座序列从转座位置的精确解离可以造成回复突变,但是不精确解离会带走部分基因组原有序列,造成不同程度的基因突变。总之,转座带来的遗传效应是多方向的,尽管多数效应会对单个宿主细胞造成较大的影响,甚至是不利的影响,但是真核生物基因组中转座元件的广泛分布这一基本事实提示我们,转座在生物的群体进化过程中必然有其积极的一面。通过转座事件促进基因的水平交流,提供进化的突变素材,促进染色体的重排,利用自然选择淘汰不利的变异,选择有利的变异,保留中性的变异,并最终促进基因组的不断进化。
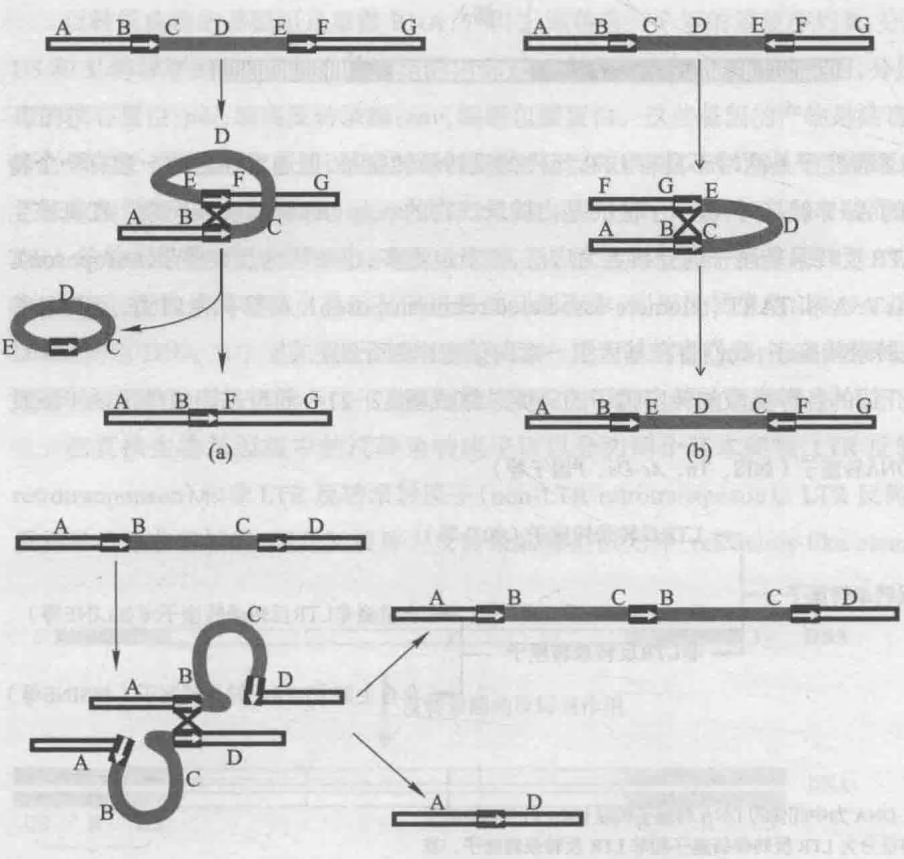
(c)
图 12-22 同源转座因子之间的交换诱导染色体畸变
(a) 同向排列的转座因子之间发生交换, 造成染色体缺失。(b) 反向排列的转座因子之间发生交换, 造成染色体倒位。(c) 同向排列的转座因子之间发生不等交换, 造成一条染色体缺失, 一条重复。
第三节 DNA 损伤的修复
在生命进化的过程中,遗传信息的载体——DNA 不仅通过半保留复制实现遗传物质的准确复制,还进化出了一系列重要的 DNA 修复机制,来保证遗传信息的稳定性。DNA 是生命世界里唯一拥有修复机制(而不是采用替换、淘汰或降解)的生物大分子,DNA 修复对于物种的遗传变异具有无可替代的作用。
我们在基因突变一章中和读者详细介绍了各式各样的基因突变类型及它们的遗传效应,已了解到细胞几乎无时无刻不暴露在各种内部(复制错误、氧自由基等)或外部(射线、化学药物等)的诱变因素之下,但是绝大多数变异都会在DNA修复机制的监控之下被发现和纠正,从而保证物种得以稳定地延续。
DNA 修复机制存在于从细菌到人类的各个生物体内,但在不同物种之间、不同 DNA 损伤、不同细胞时相下,细胞所采用的修复机制互不相同。这一节我们先以大肠杆菌受到紫外线损伤后产生的嘧啶二聚体为例从 DNA 修复的角度介绍 DNA 损伤类型,然后详细说明大肠杆菌的常用 DNA 修复途径,再补充说明真核细胞其他几种重要的 DNA 修复途径,最后列举和 DNA 损伤修复缺陷相关的代表性人类遗传疾病,从多个角度说明 DNA 损伤修复在维持基因组稳定性和生命健康中的重要地位。
一、紫外线照射对细菌 DNA 的损伤
紫外线(ultraviolet light, UV)是一种有效的杀菌剂。用紫外线照射细菌,并把细菌培养在黑暗中,那么被杀死的细菌数目与照射剂量成正比。如果细菌接触可见光,大部分细菌就能活下来,这是光能修复损伤的证据。
紫外线主要作用于DNA,因为用波长260 nm的紫外线照射细菌时,杀菌率和诱变率都最强,而这个波长正是DNA的吸收峰。紫外线照射对DNA发生了什么作用呢?分析紫外线照射后的DNA,发现有几个变化,其中最明显的变化是,同一链上的两个相邻嘧啶核苷酸共价连接,形成环丁烷嘧啶二聚体(cyclobutane pyrimidine dimer,CPD)。嘧啶二聚体中,最常见的是胸腺嘧啶二聚体(thymine dimer, $\widehat{TT}$ )(图12-23),此外还有胞嘧啶二聚体( $\widehat{CC}$ )以及胸腺嘧啶和胞嘧啶二聚体( $\widehat{CT}$ )。
这些嘧啶二聚体使双螺旋的两链间的键减弱,使 DNA 结构局部变形,严重影响 DNA 的复制和转录。含有嘧啶二聚体的 DNA 链不能作为 DNA 复制的模板,新合成的链在二聚体的互补
图 12-23 胸腺嘧啶和胸腺嘧啶二聚体
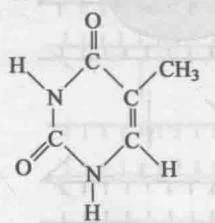
胸腺嘧啶
胸腺嘧啶
胸腺嘧啶二聚体
位置和两旁留下了缺口。
我们将包括碱基二聚体在内的常见 DNA 损伤整理在图 12-24 中,从损伤导致的 DNA 的结构变化的角度,常见的损伤类型包括:①单碱基的修饰,如碱基的烷基化、去氨基化、氧化等;② DNA 交联,包括单链内交联(如 CPD)和链间交联(interstrand crosslink, ICL),即两条 DNA 单链的碱基之间通过共价键形成交联;③复制错误或碱基类似物插入导致的错配等;④ DNA 断裂,包括单链断裂和双链断裂。这些损伤可能通过自发突变产生,也可能来自于外部因素,细胞通常根据损伤的结构特点,而不是诱发原因来选择合适的 DNA 修饰途径。
当细胞内 DNA 产生了这些损伤, 细胞就会启动 DNA 损伤响应 (DNA damage response, DDR), 它通常包括①特异性 DNA 损伤的感知; ②损伤信号的传递; ③促进修复这 3 个基本环节。
二、光复活
细菌经紫外线照射后,再放在波长310~440 nm的可见光下,存活率大大提高,并且突变频率降低了。这是一种DNA光修复酶(photolyase)介导的光复活(photoreactivation)修复。在暗处,DNA光修复酶能识别紫外线照射所形成的嘧啶二聚体,如TT,并和它结合,形成酶-DNA复合物,但不能解开二聚体。但照以可见光时,酶利用可见光(300~500 nm)提供的能量,使二聚体解开成为单体,然后酶从复合物中释放出来,修复过程完成(图12-25)。
三、切除修复
切除修复包括两种主要类型: 碱基切除修复(base excision repair, BER)和核苷酸切除修复(nucleotide excision repair, NER)。碱基切除修复主要负责单碱基修饰的化学修复, 如氧化、脱氨基化和烷基化; 核苷酸切除修复主要负责涉及两个及以上核苷酸的损伤修复, 比如紫外线诱发的嘧啶二聚体等。尽管两者的适用场合不同, 但都包括3个基本步骤: ①复合物识别、结合并切除DNA中受损的碱基; ②DNA聚合酶利用未损坏的DNA互补链作为模板填补切除后留下的缺口; ③DNA连接酶封闭DNA聚
工代表嘧啶二聚体
合酶留下的切口(nick),完成修复过程。由于切除修复过程不依赖可见光,因此也被称为暗复活,它们在大肠杆菌和人类中均以非常相似的机制发生。我们以大肠杆菌为例进行简要说明。
在碱基切除修复途径中(图 12-26a),首先由 DNA 糖基化酶(glycosylase)负责识别单碱基的异常化学修饰,糖基化酶进一步水解异常碱基与脱氧核糖之间的糖苷键,受损碱基脱落,留下缺少碱基的 AP 位点(apurinic or apyrimidinic sites, AP sites)。AP 位点随后被 AP 内切核酸酶(apurinic-apyrimidinic endonuclease)识别,它和磷酸二酯酶(phosphodiesterase)一起发挥作用,切除损伤位点及其邻近的糖-磷酸骨架,产生单链的 DNA 缺口。接下来,DNA 聚合酶 I 以未受损的 DNA 链为模板,以碱基互补配对原则,补充缺失的核苷酸;DNA 连接酶最后将新合成链
(a) 碱基切除修复。(b) 核苷酸切除修复。
(a)
(b)
与主链连接起来,完成切口的封闭。
再看核苷酸切除修复途径(图 12-26b),损伤涉及多个碱基,参与损伤识别的是3个重要的核酸切除酶(excinuclease)UvrA、UvrB和UvrC。两分子UvrA和一分子UvrB构成三聚体蛋白首先识别并结合DNA损伤,并利用ATP能量在受损部位弯曲DNA。随后,UvrA从DNA上解离。UvrC结合到UvrB-DNA复合体上,并在受损核苷酸3’端第4或5个磷酸二酯键,5’端第8个磷酸二酯键上进行切割,产生两个切口。DNA解旋酶UvrD进一步释放出切除的12~13碱基长的寡核苷酸(12-13-mer)。随后的步骤和碱基切除修复相似,DNA聚合酶I填补缺口,DNA连接酶封闭切口。人类中的核苷酸切除修复与大肠杆菌的类似,但又进一步根据损伤发生的时期分为转录偶联核苷酸切除修复(transcription-coupled nucleotide excision repair, TC-NER)和非转录偶联的全基因组核苷酸切除修复(global genomic nucleotide excision repair, GG-NER)途径,这两条途径涉及不同的识别复合物。此外,损伤位点切除的寡核苷酸的长度也有所不同,为24~32个。
四、错配修复
错配修复(mismatch repair, MMR)是对 DNA 复制过程中产生的错误配对进行特异性修复的途径。在 DNA 复制过程中,DNA 聚合酶通过其 $3’\rightarrow5’$ 外切核酸酶活性发挥其校对(proofreading)功能,及时纠正复制中的错误。错配修复发生在 DNA 复制后,可以校正那些未被校对作用发现的错误碱基对,因此,它是 DNA 精确复制的另一重要保证。
错配损伤和其他 DNA 损伤有所不同,因为发生错误配对的碱基(例如 T-A 换成了 T-C)仍然是正常的碱基(没有异常的修饰等)。那么该如何发现其中的错误呢?答案是可以同时读取模板链和合成链的信息。例如在大肠杆菌中,修复机制是利用两条链上 DNA 甲基化模式的差别来区分谁是模板链(已甲基化),谁是新合成链(还未甲基化)。
我们结合图 12-27 向读者介绍大肠杆菌的错配修复途径。第一阶段,错配损伤的识别依赖于 MutH、MutL 和 MutS 等蛋白质。MutS 蛋白首先与损伤结合以启动修复过程,MutL 蛋白随后加入复合物,介导后续的蛋白质互作和新、旧链的区分。MutH 进一步结合上去,它具有内切核酸酶活性,可在错配位点的 5’ 或 3’ 端切割未甲基化的 DNA 链,即新合成的链。切口位置可能距离损伤位点较远(几百 bp 甚至更远)。随后 MutS、MutL、UvrD 以及含有外切核酸酶活性的 DNA 聚合酶共同发挥作用,从切口处切除包含错配位点的核苷酸链。最后由 DNA 聚合酶Ⅲ填补大缺口,DNA 连接酶进行缝合。
错配修复同样在包括人在内的其他物种中发挥重要作用,但不同物种识别新旧 DNA 链的机制不同,参与修复的蛋白质组成也有一定的差异。此外,在人中,错配修复对于维持含有 DNA 微卫星序列 (microsatellite) 的基因组区域的稳定性尤为重要,DNA 聚合酶在复制这些短重复序列时容易因为滑动错误 (slippage error) 导致插入或缺失,而错配修复可以予以纠正。
五、同源重组修复
同源重组不仅促进了减数分裂过程中遗传物质的变异,也在 DNA 损伤修复中发挥重要的作用。同源重组负责修复的是 DNA 的双链断裂损伤。由于同源重组修复需要利用有丝分裂中正常的姐妹染色体作为模板纠正损伤 DNA,所以它发生在 DNA 复制过程中或复制后,即 S 期和 G₂ 期。同源重组修复的基本步骤和前面介绍的同源染色体重组非常相似。在大肠杆菌中(图 12-28),这一过程涉及 20 多个基因产物和 DNA 的协作,大致的途径包括:① RecBCD 复合物(含解旋酶和外切酶活性)共同识别和作用于损伤位点,加工断点形成 3’ 突出端;② 重组酶 RecA 和其他 DNA 单链结合蛋白(single strand DNA binding protein, SSB)组装到切割后形成的单链 DNA上,促进损伤链入侵姐妹染色单体进行同源配对,并促进 DNA 链的交换;③ RuvAB 和 RecG 等蛋白质协作,促进异源双链 DNA 的延伸;④ 异源双链 DNA 被 RuvC 切断,Holliday 中间体分离,DNA 连接酶缝合切口。由于利用了同源的姐妹染色体,同源重组修复也是一种无错的修复过程。
六、其他 DNA 修复途径
以上介绍的损伤修复途径是大肠杆菌中常见的类型,除此之外,还有一些其他重要的修复途径在真核细胞以及高等哺乳动物细胞中发挥重要作用。例如我们前面介绍过的可诱导染色体结构变异产生的非同源末端连接,它就是针对 DNA 双链断裂的一种错误倾向性的修复方式。这种修复方式往往发生在没有姐妹染色体作为模板的 $G_{1}$ 期,通过直接将 DNA 双链断裂的缺口重新连接进行修复,因此会在修复过程中引入突变。此外还有错误倾向性的跨损伤合成(translesion synthesis, TLS)修复,以及链间交联损伤修复(interstrand crosslink repair, ICL repair)等,我们在此暂不向读者逐一介绍。
七、DNA 损伤修复缺陷与人类疾病
DNA 持续暴露在内源和外源损伤诱变剂的伤害之下,如果没有有效的修复机制,DNA 损伤必然快速积累,这自然会带来严重的疾病。由 DNA 修复基因缺陷引起的人类遗传疾病的种类有数十种之多。例如,着色性干皮病(xeroderma pigmentosum)是一类常染色体隐性遗传疾病,患者对阳光极度敏感,皮肤癌的发病率非常高。对患者的皮肤成纤维细胞进行分析发现,这类细胞在 DNA 损伤后修复能力大大降低。遗传分析揭示了多个基因,如 XPA、XPB、XPC、XPD、XPE、XPF、XPG、XPV 等的缺陷可导致疾病的发生,而这些基因正是人细胞核酸切除修复途径的关键蛋白质,它们编码的多肽具有核酸切除酶的活性。又如,遗传性非息肉性结肠癌(hereditary nonpolyposis colon cancer)是由 DNA 错配修复途径的遗传缺陷所导致的,临床发现参与该途径的蛋白质(如 MSH2、MLH1 等)编码基因突变可引起该疾病发生。范可尼贫血(Fanconi anemia)则是由负责交联损伤修复的基因缺陷所导致的,已知 20 多个该修复通路基因的突变可以导致该综合征的发生,临床表型包括儿童时期出现进行性的骨髓衰竭,发育不良,急性髓性白血病等。不难看出,DNA 损伤修复的缺陷与多种肿瘤相关,这进一步提示了 DNA 修复系统在保护细胞免受环境中致癌物质的诱变作用方面具有重要的作用,对于 DNA 损伤和修复途径的研究无疑将有助于人们更好地维护健康和抵御疾病。
修复过程在生物体内是普遍存在的,也是正常的生理过程。在漫长的进化过程中,选择有利于修复过程的多样化和完善化,但遗传信息的传递过程仍然不可能是完美无缺的。事实上,DNA顺序的改变时时以低频率发生着,为进化过程中自然选择提供新的原材料,使各类生物能在选择作用下不断地向前发展。
习题
什么是染色体断裂愈合模型和模写选择模型?
什么是基因转变?什么是杂种 DNA 模型?
转座因子和反转录转座子进行转座的机制有何不同?
转座能带来哪些遗传学效应,试结合具体的转座因子加以解释。
紫外线诱变的作用机制如何?它引起的 DNA 损伤的修复途径是什么?
简述电离辐射引起的 DNA 的损伤及其修复。
就某一顺反子来说, 正向突变率往往比回复突变率至少高一个数量级。如何解释?
M 品系的雌蝇和 P 品系的雄蝇杂交的 $F_{1}$ 果蝇出现杂种不育的表型。研究发现造成这一突变表型的原因是 P 因子在发育中的生殖细胞系中发生转座,染色体出现断裂和重排,导致大量生殖细胞无法发育成熟,因此出现不育性状。请问:
(1) 为什么雄 P 和雌 M 的后代只有不育的问题, 而其他生理结构和功能正常?
(2) 为什么只有雄 P 和雌 M 的后代不育?
常见的 DNA 损伤有哪些类型?
简述大肠杆菌同源重组修复的基本过程,为什么这条修复途径只能发生在细胞周期的 S 期和 $G_{2}$ 期?
数字课程学习

在线自测
习题答案
第十三章 细胞质和遗传
本书前面所讲的性状,都是由核内基因控制的,不过它们的表现通常是要通过细胞质的。例如,花冠的颜色是由染色体上基因所控制的,但花冠的颜色是色素合成的结果,而色素是在细胞质中合成的。但遗传学家发现,细胞质对遗传的贡献还体现在其他很多方面。例如,积累在卵细胞细胞质中的基因产物可影响胚胎发育;某些性状的遗传是通过细胞质中的遗传物质的。此外还认识到,细胞质与细胞核有着相互依存的关系,某些性状的遗传,不仅需要核基因的存在,而且还与细胞质因素有关,所以细胞质在遗传中的作用不容忽视。
第一节 母性影响
通常,正交 \varphi AA \times \delta aa 和反交 \varphi aa \times \delta AA ,子代的表型是一样的。这是因为两亲本在核基因的贡献上是相等的,子代的基因型都是 $Aa$ ,所以在同一环境下,表型也是一样的。可是有时候两种交配的结果并不相同。例如前面介绍的伴性遗传,这是由于性染色体组成在两性中不同而导致的。但遗传学家发现还有一些正、反交不同的情况,子代的表型受到母本基因型的影响,与母本的表型有关,这种现象叫作母性影响(maternal effect)。母性影响有两种,一种是短暂的,仅影响子代个体的幼龄期;一种是持久的,影响子代个体的终生。我们现在分别用例子来说明。
一、短暂的母性影响
在麦粉蛾 E. phestia 中, 野生型的幼虫皮肤是有色的, 成虫复眼是深褐色的。这种色素是由一种叫作犬尿素的物质形成的, 由一对基因控制。突变型个体缺乏犬尿素, 幼虫不着色, 成虫复眼红色。有色的个体 (AA) 与无色的个体 (aa) 杂交, 不论哪个亲本是有色的, $F_{1}$ 都是有色的。 $F_{1}$ 个体 (Aa) 与无色个体 (aa) 测交, 这时有色亲本的性别就会影响后代的表型。如果 Aa 是雄蛾, 后代中半数的幼虫是着色的, 成虫时复眼深褐色, 这与一般测交没有什么不同 (图 13-1a)。可是如果 Aa 是雌蛾, 所有的幼虫都是有色的, 但到成虫时, 半数是褐眼, 半数是红眼, 这些结果显然和一般的测交不同, 也与伴性遗传的方式不相符合 (图 13-1b)。
如何来解释这样的结果呢?原来精子的细胞质组分很少,而卵里含有大量的细胞质,当 $Aa$ 母蛾形成卵子时,不论 $A$ 卵或 $a$ 卵,细胞质中都含足量的犬尿素,所以它们的后代中, $aa$ 幼虫的
左旋
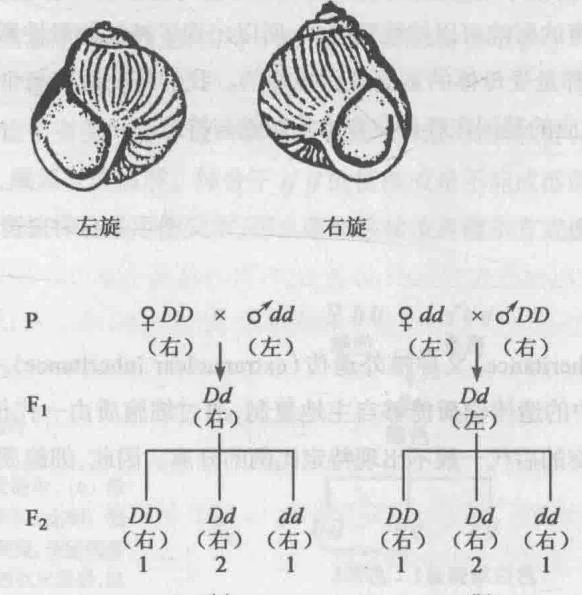
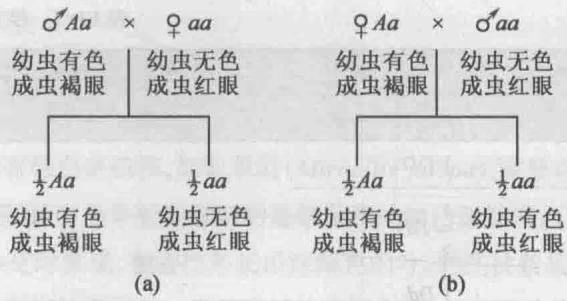
皮肤也是有色的。不过这种母性影响是暂时的,因为这样的 aa 个体缺乏 A 基因,不能自己制造色素,所以随着个体的发育,色素逐渐消耗,到成虫时复眼已变为红色了。
二、持久的母性影响
椎实螺(Limnaea)外壳的螺旋方向,受母本的基因型控制,终生不变,看来很像细胞质遗传,其实还是受母性影响。
椎实螺是雌雄同体的,繁殖时一般进行异体受精。两个个体相互交换精子,同时又各自产生卵子。但是如果把它们一个一个地分开来饲养,它们就进行自体受精。
椎实螺外壳的旋转方向可以是右旋的,也可以是左旋的。如果拿一个螺壳,使螺壳的开口朝着你自己,椎尖朝上,那么开口在右边的,螺壳就是右旋的,开口在左边的,螺壳就是左旋的(图 13-2)。
椎实螺外壳的右旋和左旋,是由一对基因控制,右旋(D)对左旋(d)是显性。右旋雌螺与左旋雄螺交配时, $F_{1}$ 全为右旋, $F_{2}$ 也全为右旋(图13-3a)。但 $F_{2}$ 中有3/4雌体,其 $F_{3}$ 全为右旋;另外1/4雌体,其 $F_{3}$ 全为左旋(表13-1)。这里, $F_{2}$ 之所以全为右旋,是因为母本的基因型是Dd。在反交情况下,即亲代是左旋雌螺与右旋雄螺交配,则 $F_{1}$ 全为左旋,并不因为左旋基因是显性,而是因为它们的表型取决于母本基因型。 $F_{2}$ 则和正交一样,全是右旋,因为 $F_{1}$ 母本的基因型是Dd,而左旋(d)是隐性(图13-3b)。 $F_{3}$ 也一样,表现为3:1分离(表13-1)。
图13-2 椎实螺的外壳
图13-3 椎实螺外壳旋向的遗传
(a)
(b)
表 13-1 椎实螺外壳旋转方向的遗传
| $F_2$ | $F_3$ | ||
| 基因型 | 表型 | 比例 | |
| 1 DD | 1 DD | ||
| 2 Dd | \frac{1}{2} \text{DD} | 右旋 | 3 |
| 1 Dd | |||
| \frac{1}{2} \text{dd} | |||
| 1 dd | 1 dd | 左旋 | 1 |
这种遗传现象,初看很使人费解,但仔细分析起来,也很简单。原来螺类的受精卵是螺旋式卵裂,成体外壳的旋向取决于最初两次卵裂中纺锤体的方向(图13-4)。而纺锤体的方向取决于卵细胞质的特性,归根结底取决于母体染色体上的基因型。子代的基因型不能对之再作更改,而只能
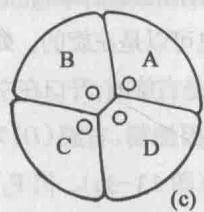
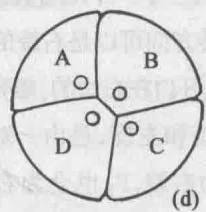
(a)、(b)第一次卵裂时;(c)、(d)第二次卵裂时。(a)、(c)左旋螺;(b)、(d)右旋螺。
反映于其所产生的卵细胞,即决定下一代的表型。所以就出现这样的现象,即母本基因型控制子代的表型。需要强调的是,尽管母性影响依赖于母本基因的作用,但这些基因仍以经典方式传递,它的特点只不过是父本的显性基因延迟一代表现和分离而已。
从上面这两例看来,卵细胞质的特性的确可以影响胚胎发育,尤其是早期发育,所以出现了短暂的母性影响,但有些早期发育的影响可以持续到成体,所以出现了持续的母性影响。不过不论哪一种情况,卵细胞质的特性都是受母体的基因型所控制的。我们将在遗传与个体发育一章继续向读者介绍能够发挥母体效应的基因在胚胎发育中的功能与特点。
第二节 细胞质遗传
细胞质遗传(cytoplasmic inheritance)又称核外遗传(extranuclear inheritance),是由细胞质中的遗传物质决定的。细胞质中的遗传物质能够自主地复制,通过细胞质由一代传至下一代。细胞质遗传是非孟德尔式的,杂交的后代一般不出现特定比例的分离。因此,细胞质遗传与母体效应完全不同。
一、高等植物叶绿体的遗传
有几种高等植物有绿白斑植株,如紫茉莉(Mirabilis jalapa)、藏报春(Primula sinensis)、假荆芥(Nepeta cataria)等,其中最早被注意到的是紫茉莉的绿白斑植株。1909年,科伦斯利用紫茉莉绿白斑枝条进行杂交时发现,有些枝条长出深绿色的叶,有些枝条长出白色或极淡绿色的叶,有些枝条则长出绿白相间的花斑叶。用显微镜检查绿色叶,或花斑叶的绿色部分,细胞中含有正常的叶绿体,而检查白色叶或花斑叶的白色部分,细胞中缺乏正常的叶绿体,是一些败育的无色颗粒。用不同枝条上的花相互授粉时,后代的叶绿体种类完全取决于种子产生于哪一种枝条上,而与花粉来自哪一种枝条完全无关。来自深绿色枝条的种子必长成深绿幼苗,其中所含有的叶绿体是正常的;来自淡绿枝条的种子必长成淡绿幼苗,其中所含的叶绿体大多是败育的;来自绿白斑枝条的种子则长成3种幼苗:具有正常叶绿体的深绿幼苗、具有败育叶绿体的淡绿幼苗,以及正常和败育叶绿体都有的绿白斑幼苗,其比例在每朵花中不同(表13-2)。
表 13-2 紫茉莉的绿白斑植株的细胞质遗传
| 父本枝条 | 母本枝条 | 子代 |
|---|---|---|
| 深绿 | 深绿淡绿绿白斑 | 深绿淡绿绿白斑 |
| 淡绿 | 深绿淡绿绿白斑 | 深绿淡绿绿白斑 |
| 绿白斑 | 深绿淡绿绿白斑 | 深绿淡绿绿白斑 |
叶绿体储存在细胞质中。就细胞质来说,雌、雄两性配子的贡献不同。胚珠中的雌配子含有细胞质,而花粉管中的雄配子很少含有细胞质,而且通常不含有包括叶绿体在内的质体(plastid)。叶绿体的遗传属于细胞质遗传,种子后代的叶绿体种类取决于种子产生于哪一种枝条上,而与花粉来自哪一种枝条无关。
高等植物中有关叶绿体遗传的另一例是玉米的埃型条斑(striped iojap trait),相关的基因称作iojap(ij),属第7连锁群。纯合子ij ij的植株或是不能成活的白化苗,或是有特征性的白色条斑。如果条斑植株总是用作父本,那么条斑性状按孟德尔方式遗传(图13-5a)。然而如果把条斑
图 13-5 玉米的埃型条斑的遗传
(a) 母本正常时, 显示孟德尔式遗传。(b) 母本是条斑时, 看不到典型的孟德尔式比例。很可能基因型 ijij 引起叶绿体的突变, 使呈现条斑或白色性状。一旦埃型条斑性状出现后, 就通过细胞质遗传。
(a)
(b)
植株用作母本,那么不论父本的基因型是什么,叶绿体的特征将持续下去,子代没有典型的孟德尔比例,它们的表型可以是绿的、白的或条斑的,看不到核基因和质体表型间的对应关系(图13-5b)。所以埃型条斑性状一旦在纯合子ij ij植株出现后,就显示典型的细胞质遗传,一直持续下去,即使有正常核基因Ij的存在也不再有“矫正”作用了。
二、叶绿体遗传的分子基础
紫茉莉的绿白斑和玉米的埃型条斑都是有关于叶绿体的色泽和分化。叶绿体来自细胞质中称为前质体(proplastid)的颗粒,能独立复制。胞质分裂时叶绿体随机分配到子细胞中。大多数植物的雄配子中前质体很少或者没有,所以叶绿体性状大都由结种子的亲本传下去,如紫茉莉,这种遗传方式称为母系遗传(maternal inheritance)。但是,也有一些植物的叶绿体遗传受到双亲叶绿体DNA的影响,如天竺葵(Pelargonium zonale)。将天竺葵的绿色、白色植株作亲本,正、反交的结果相同, $F_{1}$ 出现绿色、花斑和白色3种性状,但不符合孟德尔分离比。我们把这种遗传方式称为双系遗传(biparental inheritance)。尽管双系遗传中双亲的遗传物质对后代均有贡献,但它仍属于非孟德尔遗传,因为双亲的贡献是随机的,后代中不会有可预期的分离比。
叶绿体 DNA(chloroplast DNA, cpDNA) 是共价闭合的 DNA 分子。分离单细胞藻类的叶绿体 DNA 比较容易,因为它们的 G/C 含量比核 DNA 低。例如衣藻(Chlamydomonas reinhardtii) 叶绿体 DNA 的 G/C 含量为 36%,而核 DNA 的 G/C 含量为 64%,两者相差较大。但在高等植物中,两者的 G/C 含量比较接近,分离不免困难些(表 13-3)。
表 13-3 几种植物叶绿体 DNA 的某些特性
| 植物 | 叶绿体基因组大小 | G/C含量/% | ||
| μm | kb | 叶绿体基因组 | 核基因组 | |
| 眼虫 Euglena gracilis | 40 | 150 | 25 | 48 |
| 衣藻 Chlamydomonas reinhaidtii | 62 | 190 | 36 | 64 |
| 绿藻 Chlorella ellipsoidea | - | 175 | 36 | 56 |
| 伞藻 Acetabularia | 200 | 2000 | - | - |
| 莴苣 Lactuca sativa | 43 | 150 | 38 | 38 |
叶绿体 DNA 与细菌 DNA 相似, 是裸露的 DNA。每一叶绿体内的叶绿体 DNA 分子数难以测定, 据估计, 高等植物中每个叶绿体内含有 30~60 拷贝, 而某些藻类中每个叶绿体 DNA 可有 100 拷贝左右。植物叶绿体基因组的大小差异也很大: 高等植物的叶绿体 DNA 为 120~160 kb, 而藻类的叶绿体 DNA 变化范围较大, 多数为 85~292 kb, 少数藻类, 如伞藻的叶绿体 DNA 高达 2000 kb。在这类 DNA 中, 大约有 15% 与核 DNA 在质量和碱基成分上相似, 两者可以形成杂种分子; 其余的叶绿体 DNA 和核 DNA 不同, 当变性为单链后, 再缓慢冷却时, 两者间不会形成双链结构。叶绿体 DNA 能够自我复制, 其复制速率和核 DNA 的复制速率不同。叶绿体中含有合成蛋白质需要的核糖体、RNA 和酶。而且叶绿体 DNA 的复制也是半保留性的, 它们的 RNA 的合成也可被 DNA 酶和放线菌素 D 所抑制, 这些都与核 DNA 一样。
这样看来,叶绿体本身具有遗传的特性。第一,叶绿体 DNA 能按原样复制,而且不论是正常的,还是异常的,均可由上一代传给下一代,与核基因无关。第二,叶绿体 DNA 可以突变,且突变后仍是稳定的。
不过虽然叶绿体本身含有 DNA, 具有自我复制和传递的遗传特性, 但叶绿体也受到核基因的影响, 我们在前面已提到过, 许多核基因影响叶绿体的形成, 叶绿体属于半自主型细胞器。
三、真菌类线粒体的遗传
线粒体是细胞代谢中心之一,是合成呼吸酶和其他酶系的场所。呼吸酶的缺少会影响细胞的生长,所以某些“生长迟缓”的突变,例如酵母菌的“小菌落”(petite colony)就与线粒体有着密切的关系。埃弗吕西(Boris Ephrussi, 1901—1979)最先利用酵母线粒体突变体研究线粒体遗传规律(1953)。
酵母菌有性生殖时,两个交配型不同的单倍体细胞互相结合,形成二倍体合子。二倍体合子经过减数分裂,形成4个单倍体子囊孢子,这4个孢子不像粗糙链孢霉那样有规则地排列,但它们代表减数分裂的4个产物,可以一个个地分离开来,分别培养,进行遗传学分析。无性繁殖时,酵母菌利用出芽生殖的方法增殖,在合适条件下,不论单倍体细胞或双倍体细胞,都可用出芽生殖继续繁衍下去(图13-6)。
从一个酵母菌开始,让它以无性的方式增殖,长成一个培养物。按理,这个培养物应该是均一的,可是取一点儿菌样,涂布在固体培养基上,让每一个酵母菌长成一个菌落,其中有一小部分菌落(1%~2%)会比其他菌落小得多,是所谓的“小菌落”。原来小菌落酵母菌缺少细胞色素a和 b 以及细胞色素 c 氧化酶, 所以在通气情况下, 这些“小菌落”细胞比正常细胞长得慢, 就长成了小菌落。小菌落很稳定, 不能回复到正常的大菌落 (grande colony)。
α 和 a 代表不同的交配型。
小菌落还可用化学诱变法得到, 只要把正常酵母菌长在吖啶黄的稀溶液中, 长出来的酵母菌就全是小菌落的, 诱变率是 100%, 这自然是在通气条件下的结果。在不通气的培养中, 连正常酵母菌也不产生细胞色素氧化酶, 所以是不能诱发出这种小菌落突变的。
把小菌落酵母菌跟正常的酵母菌交配,只产生正常的二倍体合子,它们的单倍体后代也是正常的,也就是说,“小菌落”的性状消失了,完全表现为细胞质遗传。可是染色体上的基因,例如交配型基因 $\alpha$ 和 $a$ 还是跟预期一样分离,子囊中4个孢子出现 $1:1$ 的比例,其中两个是 $\alpha$ ,另外两个是 $a$ ,可见“小菌落”性状与核基因没有直接关系(图13-7)。
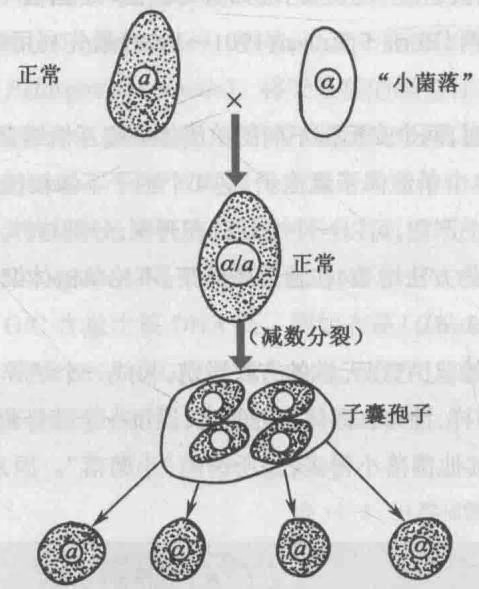
二倍体合子是正常的,它们的子囊孢子后代也是正常的,表现为细胞质遗传。但是一对交配型基因 $\alpha /a$ 的分离比为 $1:1$ ,是由核基因决定的。图中有小点的细胞表示细胞质正常,形成正常的大菌落,没有小点的细胞表示细胞质不正常,形成小菌落。
再举一例,粗糙链孢霉的“缓慢生长”(poky, po)突变型,生长迟缓,呼吸贫弱,这种性状跟酵母菌的小菌落一样,也是细胞质遗传的。但是因为链孢霉会产生大小不等和细胞质含量不同的单倍体核(也可称作配子),所以突变型(po)与野生型(+)杂交时,除了跟酵母菌的细胞质遗传一样,杂交后代不出现一定比例的分离,表现为非孟德尔式遗传以外,还像高等植物一样,显示母系遗传的现象。如果突变型 po 的单倍体核(♂)和野生型的受精丝中的单倍体核(♀)相结合,得到的后代全是野生型;如果野生型的单倍体核(♂)和突变型 po 的受精丝中的单倍体核(♀)相结合,后代全是突变型(图 13-8)。
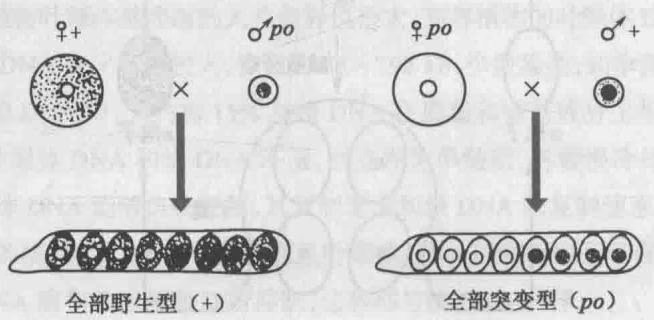
不同交配型用黑白小圈表示,因为交配型由核基因控制,所以显示孟德尔式分离比4:4。野生型(+)细胞质中有小黑点,突变型(po)细胞质中没有小黑点,杂交后代未出现分离,显示母系遗传。
四、线粒体遗传的分子基础
酵母菌的小菌落细胞内缺少细胞色素 a 和 b,还缺少细胞色素 c 氧化酶,不能进行有氧呼吸;粗糙链孢霉的缓慢生长细胞也缺少细胞色素 c 氧化酶等。在正常培养条件下,由于缺少正常氧化作用所需的呼吸酶,所以突变体生长缓慢。已知线粒体是细胞的呼吸代谢中心,而且上述有关酶系也存在于线粒体中,所以可以推测,有关的基因也存在于线粒体 DNA 中。我们将在基因组一章详细介绍线粒体 DNA 的组成。
根据 CsCl 密度梯度离心, 发现小菌落突变型的线粒体 DNA 与大菌落的线粒体 DNA 显著不同, 有时甚至测不出小菌落突变型有线粒体 DNA 的存在。这表明, 小菌落突变体中线粒体 DNA 大部分丢失或严重缺失。根据小菌落 DNA 受损的情况, 线粒体 DNA 完全缺失的称为 $p^{0}$ 小菌落, 线粒体 DNA 部分缺失或变异, 称为 $p^{-}$ , 而野生型大菌落称为 $p^{+}$ 。用限制酶和分子杂交分析 $p^{-}$ 突变型的线粒体 DNA, 结果发现除了有一些片段多次重复以外, 还有大片段缺失。
$p^{-}$ 或 $p^{0}$ 小菌落细胞不能执行线粒体的转录和翻译工作。因为线粒体有自己的蛋白质合成装置,线粒体自身合成的蛋白质对各种呼吸酶整合到线粒体内膜上是必不可缺的。因此,各种细胞质遗传的小菌落表型几乎相同,尽管线粒体 DNA 的变异和损害性质可以很不相同。
根据 CsCl 梯度密度离心和限制酶分析粗糙链孢霉的缓慢生长突变型和野生型, 发现它们的线粒体 DNA 并没有明显的差异。缓慢生长突变的表型效应与小菌落不同, 缓慢生长突变是可逆的, 在原培养基上继续培养, 生长速率可逐渐恢复, 接近野生型。不过, 缓慢生长突变对呼吸酶的影响也是多方面的, 可见其中线粒体的蛋白质合成也出现了障碍。曾有研究表明, 缓慢生长突变型的营养菌丝缺乏线粒体核糖体小亚基, 这使线粒体的蛋白质合成速率大大降低, 从而影响呼吸代谢, 使菌丝生长降低。当菌丝生长接近稳定相 (stationary phase) 时, 线粒体核糖体的大、小亚基数目趋向平衡, 菌丝生长率增加。
从上面的说明看来,小菌落和缓慢生长的性状的决定都与线粒体中的 DNA 有关。不过需要强调,线粒体本身也受核基因的控制,也属于半自主型细胞器,线粒体遗传同样是相当复杂的。
现在知道,线粒体 DNA (mitochondrial DNA, mtDNA) 是裸露的双链分子。每一细胞内有多个线粒体,例如单倍体酵母菌细胞可以含有 1~45 个线粒体,每一线粒体又含有 50~150 个线粒体 DNA 分子。尽管每一细胞中线粒体 DNA 分子的拷贝数很多,但是,生殖细胞中线粒体的复制是选择性的,只有少数进行复制。在动物中,精子中虽然带有少量线粒体 DNA,但进入卵细胞质中随即被扩散稀释和特异性降解。因此,动物子裔的线粒体 DNA 与母本一致,有关的线粒体性状表现为母系遗传。
五、人类线粒体遗传与机制
人类的线粒体遗传和其他动物一样,遵循母系遗传(Wallace,1980)。1988年华莱士(Douglas Cecil Wallace,1946—)利用Leber遗传性视神经萎缩病(Leber’s hereditary optic neuropathy,
LHON)的研究首次提出了线粒体 DNA 突变可引起人类遗传疾病。我们先举一个线粒体疾病家系的例子,再和读者介绍人类线粒体遗传的一些特点。
线粒体 DNA 突变可导致遗传性心肌病。在一个线粒体心肌病家系(图 13-9)中,我们发现该病遵循母系遗传的规律:女性患者可以将疾病传递给后代,而男性患者的后代通常是健康的。另一方面,在女性患者的子女中,患者的临床表现差异很大,心肌病的发病程度从轻度到严重不等。
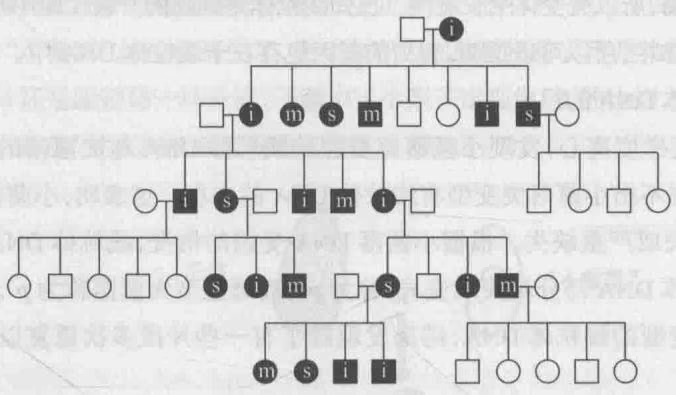
患者发病程度不等,m 表示轻度,i 表示中度,s 表示严重。
前面已经介绍过动物线粒体遗传遵循母系遗传的主要原因,人类线粒体遗传的机制是相似的。成熟卵细胞拥有数十万拷贝的线粒体 DNA,而精子中只有几百拷贝。受精时,精子的线粒体 DNA 进入卵母细胞后不仅被快速稀释,而且会被卵母细胞内的核酸酶消化。因此,精子的线粒体 DNA 对子代表型无明显作用,子代个体中由线粒体 DNA 所决定的疾病/性状只取决于卵细胞的线粒体 DNA,因此表现为母系遗传。但除了母系遗传,人类线粒体 DNA 遗传还具有表型不规律分离、阈值效应和遗传瓶颈等特点。
在一个合子内携带不同类型的细胞器(如野生型和突变型)的现象被称为异质性(heteroplasmy),如果合子只含有一种类型(全部野生型或突变型)的细胞器则称为同质性(homoplasmy)。一个同质性的受精卵,在它发育的过程中只会产生同样类型的子细胞,细胞器组成没有变化(图13-10a)。但在一个异质性的受精卵的发育过程中,由于胞质分裂的随机性,细
(a) 同质性细胞
(b) 异质性细胞
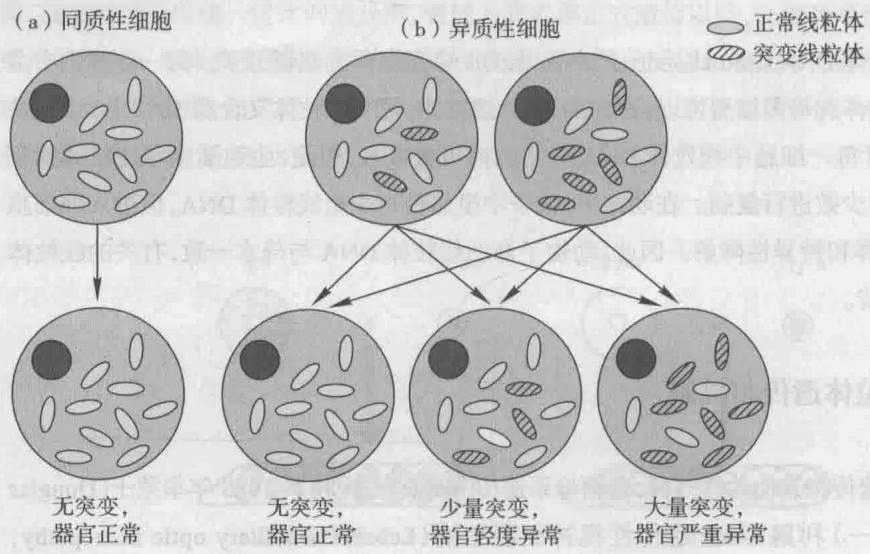
(a) 同质性细胞的子代细胞表型不发生分离。(b) 异质性细胞的子代细胞表型发生分离。
胞器在子细胞中随机分配,就会产生不同类型的子细胞(图 13-10b):有的细胞中突变线粒体多一些,对应的器官就可能会产生病变;而有的细胞中突变线粒体少一些,甚至没有,对应的器官就可能轻度异常或完全正常。这就是线粒体遗传的表型不规律分离,它会导致同一个体的不同器官的表型不同(以及不同个体受累器官不同)等现象。
临床上发现眼、耳、脑、心、肌肉等是常见的线粒体疾病受累器官,这其中的原因与线粒体DNA的功能直接相关。线粒体是有氧呼吸的场所,我们将在基因组一章介绍,线粒体DNA上的基因除了参与自身的蛋白质翻译以外,全部编码呼吸链相关蛋白。因此绝大多数线粒体DNA突变造成的是呼吸链受损,细胞供能不足。当某组织细胞中突变线粒体的有氧呼吸供能无法达到维持该组织细胞正常生理功能的阈值时,就会表现出疾病,这被称为阈值效应。显然,阈值水平与组织细胞的能量需求密切相关,眼、耳、脑、心、肌肉等都是有氧呼吸活跃的高耗能组织,所以它们对线粒体DNA突变更加敏感。
从我们所列举的心肌病家系中可以看到,线粒体遗传疾病的另一个重要特点是同一患者的后代表型严重程度相差悬殊,可以是重度、中度、轻度甚至正常,这其中的机制涉及另一个重要的线粒体遗传特点——线粒体遗传瓶颈(mitochondrial genetic bottleneck)。研究者们认为在雌性胚胎的原始生殖细胞发育过程中,线粒体数目会发生大幅减少,最终只有少量的线粒体DNA经复制后积累在成熟的卵母细胞中(Chinnery等,2008)。尽管今天我们仍然不清楚这一过程的具体机制和准确的发生时间,但可以确定的是,如果一个雌性胚胎细胞是异质性的,那么在它的原始生殖细胞发育的过程中,成熟卵细胞之间突变型线粒体DNA的比例会显著不同,受精后得到的个体自然就会出现不同程度的表型了(图13-11)。
可见,人类的线粒体遗传完全不同于核基因组的遗传:一方面后代的表型取决于母亲,另一方面后代表型的变异程度很大,这与人类线粒体 DNA 的遗传特点是密不可分的。有趣的是,近年来遗传学家通过大量的线粒体 DNA 测序发现人类的线粒体 DNA 有时也会遵循双系遗传,在多个没有亲缘关系的大家系中发现,父源线粒体 DNA 能和母源线粒体 DNA 一起遗传给子代(Huang 等,2018)。或许在不久的将来,我们还要重新审视人类线粒体遗传的机制。
图 13-11 线粒体遗传瓶颈
携带正常和突变线粒体的异质性原始生殖细胞在发育成卵细胞的过程中经历线粒体遗传瓶颈,形成不同的卵细胞,受精后发育形成的子代个体的表型差异显著。
六、草履虫放毒型的遗传
上面讲过的绿白斑的遗传跟叶绿体有关,小菌落的遗传跟线粒体有关。叶绿体和线粒体都是细胞质的构成要素,是细胞进行正常机能所不可缺少的。我们现在介绍草履虫(Paramecium aurelia)放毒型的遗传。放毒型的遗传与另外一种颗粒有关,这种颗粒不是细胞质的构成要素,因为并不是所有草履虫都具有这种颗粒。
(1) 草履虫的生殖方式 草履虫有一个大核和两个小核。大核主要管营养, 是多倍性的; 小核主要与遗传有关, 是二倍性的。
草履虫有两种基本的生殖方式:①无性生殖,即由一个个体通过细胞分裂成为两个个体,基因型仍旧跟原来的个体一样。②有性生殖,即接合生殖,两个个体接合,相互交换小核。在这个过程中,大核消失,小核经过减数分裂后,相互交换。如接合中的两个个体,一个是AA,一个是aa,则最后形成的4个个体都是Aa(图13-12)。此外,还有一种有性生殖方式,是自体受精,即一个体的两个小核经过减数分裂,留下1个小核,这个小核分裂一次,又相互合并,以后再分裂发育成大核和小核。通过自体受精后,不论个体原来的基因型怎样,最后产生的两个个体都是纯合子(图13-13)。
(2) 草履虫的放毒遗传与卡巴粒 索恩本 (Tracy Morton Sonneborn, 1905—1981) 发现有一
图13-13 草履虫的自体受精
图13-14 草履虫的放毒型和敏感型
(a) 放毒型, 核内有 K 基因, 细胞质中有卡巴粒, 外面培养液中有草履虫素。(b) 敏感型, 核内有 kk 基因, 细胞质中没有卡巴粒。
个品系的草履虫能够产生一种物质,叫作草履虫素。这种物质对自己无害,但对不同品系的草履虫却是毒素,作用的时间一长,能够杀死它们。这种能产生草履虫素的个体叫作放毒型,而受害的个体就称为敏感型。
实验发现,草履虫的放毒型需要两种因子同时存在(图 13-14):①细胞质
因子,叫作卡巴粒(kappa particle, $\kappa$ );②核基因K,这是一个显性基因,参与调节卡巴粒的增殖,k是隐性等位基因。也就是说,KK且有卡巴粒是放毒型,kk且没有卡巴粒是敏感型。
如把放毒型与敏感型交配(即接合),由于交换了小核,它们双方的基因型都成为 Kk,但其中一个有卡巴粒,能够产生草履素,是放毒型,另一个没有卡巴粒,不能产生草履虫素,仍然是敏感型。
这两个个体以后各自形成一个系统,如果使它们自体受精,那么都产生1/2的KK和1/2的kk。但原来是放毒型的,后代中有一半是放毒型,还有一半起初是放毒型,经过几代以后,由于没有K基因,卡巴粒不能增殖,就成为敏感型。原来是敏感型的,虽然后代中有一半是KK,一半是kk,但因为没有卡巴粒,所以都是敏感型(图13-15a)。
如使放毒型与敏感型接合的时间延长,除交换小核外,细胞质也有交换,这样它们双方都是基因型 $Kk$ ,都有卡巴粒,所以都是放毒型。但在自体受精后,有一半的基因型是 $KK$ ,细胞质中又有卡巴粒,所以是放毒型;另一半的基因型是 $kk$ ,虽然起始是放毒型,但经过几次分裂后,卡巴粒的数量逐渐降低;以至消失,所以最终成为敏感型(图13-15b)。
从以上实验可以知道,有卡巴粒的草履虫是放毒型,没有卡巴粒的草履虫是敏感型,可见草
图 13-15 草履虫放毒型和敏感型的接合
(a) 接合时间短, 没有交换细胞质。
- 接合;2. 交换小核后,基因型都成为 Kk;3. 后代中一半 KK,一半 kk。但只有放毒型的后代 KK 仍是放毒型。(b) 接合时间较长,交换了细胞质。
- 接合,也交换了细胞质;
- 两个草履虫都有卡巴粒;
- 后代中一半 KK,一半 kk。KK 都是放毒型,kk 是敏感型。点代表卡巴粒,有点的个体是放毒型,无点的个体是敏感型。
(a)
(b)
履虫素是卡巴粒产生的,但细胞质中卡巴粒的增殖又依赖核基因 K 的存在。如果单有核基因 K 存在,而细胞质中没有卡巴粒,也不能产生卡巴粒,因此仍然是敏感型。
(3) 卡巴粒的属性与起源 草履虫的细胞质中如果没有卡巴粒, 可以用微注射法导入, 而且草履虫细胞本身有时也可摄入卡巴粒。反之, 含有卡巴粒的草履虫在有利于迅速增殖的培养液中培养, 可使卡巴粒丢失, 可见卡巴粒的最高复制速度还抵不过宿主细胞的分裂速率, 以致细胞质中卡巴粒逐渐减少, 最终丢失。卡巴粒还可被物理或化学因素消除, 如 X 线、紫外线、高温、低温、氮芥气以及可以抑制蛋白质合成的抗生素 (如链霉素) 等。从这些实验得到启发, 研究者对草履虫细胞质进行深入观察, 终于在放毒型品系中发现了卡巴粒。
卡巴粒的直径大约为 $0.2 \mu m$ ,相当于一个小型细菌的大小,推测可能是退化的细菌,现在已演化为内共生体(endosymbiont)了。研究证实,卡巴粒含有 DNA、RNA、蛋白质、酸类和酯类等,其组成与比例酷似细菌。卡巴粒的 rRNA 已被分离出来,能和大肠杆菌 DNA 杂交,但不能与草履虫 DNA 杂交。还有卡巴粒 DNA 的碱基成分也与宿主的核 DNA 和线粒体 DNA 不同。
草履虫的卡巴粒不是都有放毒能力。卡巴粒可突变为非放毒型 $\pi$ 粒。 $\pi$ 粒在形态和功能上不同于野生型卡巴粒,不能形成明亮的R体(R-body)。据研究,R体跟病毒状颗粒有关。病毒状颗粒的DNA含量类似于T偶数噬菌体,所以可能是一种噬菌体,而R体或许就是这种噬菌体所编码的毒素蛋白质。由此看来,卡巴粒之所以能赋予它们的宿主以放毒能力,实际上是由于它们颗粒中带有噬菌体,该噬菌体编码一种放毒型毒素蛋白质(killer toxin protein),这种蛋白质成为折光率强的R体,释放到培养液中,称为草履虫素,可以导致敏感型草履虫死亡。这些关系总结在图13-16中。自从卡巴粒被发现后,在草履虫中又找到了其他粒子,如 $\gamma, \delta, \lambda$ 和 $\mu$ 等。所有这些粒子都含有DNA,都遵循细胞质遗传。
第三节 核质互作与禾谷类作物的雄性不育
细胞质在遗传中的重要作用,不单在于细胞质内具有类似核基因的细胞质基因,也不单在于细胞质基因与核基因之间的相互依存关系,还在于细胞核和细胞质之间密切的相互作用。细胞质内合成的某些蛋白质受到核基因的调控,核基因复制所必需的能量、单核苷酸、氨基酸和特殊
的酶又是由细胞质所供应。
玉米、高粱和水稻等禾谷类作物的雄性不育(male sterility)是细胞质中遗传物质与核基因相互作用的一个重要例子。
例如,玉米中有一种称为雄性不育的变异,这种植株在长出雄穗的时候,花药自然地不显出来,因此整个植株不能开花散粉。但它的雌穗的发育却是正常的,只要授上另一植株的花粉,照样可以结种子。这种特性有时是受细胞质控制的。如把雄性不育植株(♀)与雄性正常植株(♂)杂交, $F_{1}$ 与母本相同,也表现雄性不育,而且再用雄性正常的植株和它杂交,仍然表现雄性不育。这样的杂交,不论再重复多少次,后代植株的雄花仍然是不育的。这表明,雄性不育的特性是在细胞质内,是由细胞质基因控制的,遵循母系遗传。
用细胞质传递的雄性不育植株进行许多不同杂交试验,有时发现少数父本具有恢复雄性不育的作用,而且证明这种恢复作用大都由染色体上一个显性基因 Rf 控制, $F_{1}$ 植株都能散发花粉, $F_{2}$ 则分离为 3:1。如以(S)代表雄性不育的细胞质基因,(N)代表正常的细胞质基因,那么这个分离现象可用图 13-17 说明。
图13-17 玉米雄性不育的遗传
Rf基因的存在可使雄性不育
恢复为正常可育性状这一现象证明,雄性不育的性状受细胞质基因的控制,也受核基因的控制,是两者共同作用的结果。不过,以后也发现还有其他基因参与育性恢复,而且水分、土壤肥力以及日照长度等条件对雄性不育的性状也都有影响,雄性育性性状决定是相当复杂的。
雄性不育的性状在制造杂交种时很有用处。制造杂种的程序大致是这样的:先把雄性不育系(S)rfrf和正常自交系(N)rfrf杂交,得到的下代还是雄性不育的,再用正常自交系作父本和它杂交。因为这次杂交还是用同一亲本,所以叫作回交。回交后代还是表现雄性不育,这样连续回交四五次,最后得到雄性不育自交系。该自交系的外形跟父本自交系一样,不会露出花药散粉。正常自交系自交,既能使母本结籽,又能保持原有自交系的性状,所以也叫作保持系。另外再要有一种恢复育性能力的自交系(或品系)(N)RfRf,将它的花粉授予不育系后,能使不育系的后代恢复正常,开花结籽,所以叫作恢复系。
有了合适的不育系、保持系和恢复系之后,在制造玉米单交种或高粱、水稻的杂交种时,一般还需建立两个隔离区。一区是繁殖不育系和保持系的隔离区,在区内交替地种植不育系和保持系。不育系缺乏花粉,花粉是从保持系来的,从不育系植株收获的种子仍旧是不育系。保持系植株依靠本系花粉结实,所以从保持系植株收获的种子仍旧是保持系。这样在这一隔离区内同时繁殖了不育系和保持系(图13-18)。另外一区是杂种制种隔离区,在这一区里交替地种植不育系和恢复系。不育系植株没有花粉,花粉是从恢复系植株来的,所以从不育系植株收获的种子就是杂交种子,可供大田生产用。恢复系植株依靠本系花粉结实,所以从恢复系植株收获的种子仍旧是恢复系。这样在这一隔离区内制出了大量杂交种,同时也繁殖了恢复系(图13-19)。这就是用两个隔离区同时繁殖三系的制作杂交种的方法,简称为“二区三系”制种法。
图 13-19 制造杂交种, 同时繁殖恢复系
作物的雄性不育特性最早被应用到玉米和高粱等的杂交制种上。从20世纪60年代开始,核质互作和杂种优势理论又进一步促进了水稻遗传育种的飞跃。以袁隆平(1930—)为代表的中国水稻育种学家们对水稻的雄性不育性状进行了广泛研究,1973年籼型三系杂交水稻成功配制,极大地提高了水稻产量。中国成为世界上第一个成功培育杂交水稻并大面积应用于生产的国家。同年,石明松(1938—1989)在水稻田间发现了一株天然雄性不育株,该不育系在长日照的高温条件下表现为雄性不育,可以作为不育系用于杂交水稻制种;而在短日照低温条件下可育,可以用于不育系的繁种,后被称为光周期敏感核不育(photoperiod-sensitive genic male sterile, PGMS)系。利用这个特殊品系,中国水稻育种学家们又成功开创了“二系”杂交水稻育种技术,两系杂交稻可以进一步增加亲本的遗传差异,杂交种的产量进一步提升。
袁隆平最早在海南三亚发现的花粉败育野生稻 CMS-WA (wild abortive cytoplasmic male sterility) 是由细胞质基因和核基因互作导致花粉败育的类型, 属于孢子体雄性不育。通过回交的方法可以保留不育系细胞质基因组而交换核基因组, 从而达到繁殖的目的。近年来, 遗传学家利用分子生物学手段揭示了核质互作与不育系的部分机制 (Luo, 2013)。细胞质中决定雄性不育的基因是水稻线粒体基因 WA352, 它编码的蛋白质可以在花粉母细胞期的花药绒毡层中优先累积, 并通过与水稻核基因组编码的线粒体蛋白 COX11 相互作用, 抑制 COX11 在过氧化物代谢中的功能, 诱导绒毡层细胞提前发生细胞程序性死亡, 最终导致花粉败育。在恢复系中, 核基因组编码的育性恢复基因 (restorer of fertility, Rf) 编码 PPR (pentatricopeptide repeat protein) 蛋白, 这是一类参与 mRNA 转录后加工的调控蛋白。研究发现 PPR 蛋白通过降低 WA352 的表达水平抑制了它的作用, 从而逆转雄性不育的表型。
除了水稻,通过雄性不育品系进行杂交制种的已被推广到甜菜、洋葱、小麦、大麦等作物,对提高我国粮食产量发挥了巨大作用。可见,尽管细胞质中的遗传物质在数量上远不及细胞核,但它们的作用同样不容小觑。
习题
母性影响和细胞质遗传有什么不同?
细胞质基因和核基因有什么相同和不同的地方?
在玉米中, 利用细胞质雄性不育和育性恢复基因, 制造双交种, 有一种方式是这样的: 先把雄性不育自交系 A $[(S)rfrf]$ 与雄性可育自交系 B $[(N)rfrf]$ 杂交, 得单交种 AB。把雄性不育自交系 C $[(S)rfrf]$ 与雄性可育自交系 D $[(N)RfRf]$ 杂交, 得单交种 CD。然后再把两个单交种杂交, 得双交种 ABCD, 问双交种的基因型和表型有哪几种, 它们的比例怎样?
“遗传上分离的”小菌落酵母菌在表型上跟我们讲过的“细胞质”小菌落酵母菌相似。当一个遗传上分离的小菌落酵母菌与一个正常酵母菌杂交,二倍体细胞是正常的,以后形成子囊孢子时,每个子囊中两个孢子是正常的,两个孢子产生小菌落酵母菌。用图说明这些结果,并注明相应的基因型。
“遗传上分离的”小菌落酵母菌与“细胞质”小菌落酵母菌杂交,形成的二倍体是正常的。这些二倍体细胞形成的子囊,正常细胞与突变细胞各有两个。解释这些结果,作图概括你的说明。
一个雄性不育植株,用对育性恢复基因 Rf 是纯合的花粉授粉, $F_{1}$ 的基因型怎样,表型怎样?
上题的 $F_{1}$ 植株作为母本,用一正常植株 (rfrf) 的花粉测交,测交的结果应该怎样?写出基因型和表型,注明细胞质种类。
举一个经典的孟德尔式遗传的例子, 正交和反交的结果是不同的。
一个基因型为 $Dd$ 的椎实螺自交, 子代的基因型和表型怎样? 如子代个体自交, 它们的下一代表型又怎样?
上题中开始做实验所用的杂合子椎实螺的表型是怎样的?请说明。
正、反交在 $F_{1}$ 往往得出不同的结果,这可以由伴性遗传、细胞质遗传或母性影响来解释。怎样用实验方法来区分这 3 种遗传机制?
根据现有科学事实, 怎样正确理解在遗传中细胞核与细胞质之间的关系。
衣藻的一个链霉素抗性品系, 在细胞核和细胞质中都有抗性因子。它与链霉素敏感品系杂交, 如果抗性品系是“+”亲本, 敏感品系是“-”亲本, 预期的结果是什么? 如果做的是反交, 结果又如何?
人群中,遗传性心肌病的表现从轻度到严重型不等。图 13-9 给出了一个家系中心肌病的发病情况及患病程度。请问:
(1) 该家系具有哪些线粒体遗传的特征?
(2) 该如何解释该家系中心肌病患者的发病程度的不同?
- 2002 年,丹麦学者报道了一例严重运动耐受能力低下的临床患者(Schwartz,2002),患者肌肉细胞线粒体 DNA 的 ND2 基因发生 2 bp 的缺失,造成移码突变。ND2 是呼吸链复合物 I 的蛋白质编码基因,突变造成了 ND2 的功能丢失。请问:
(1) 研究者发现患者仅有肌肉问题, 心、肺及其他器官均正常。怎样理解造成这些差别的原因?
(2) 通过线粒体 DNA 的多态性位点分析, 研究者还发现突变线粒体 DNA 来自他的父亲, 而不是母亲。但患者的父亲、患者的妹妹都没有疾病。怎样理解其中的原因?
数字课程学习
在线自测 习题答案
第十四章 基因组
从单一基因研究到全基因组研究是20世纪末生命科学发展史上里程碑式的一个飞跃。2000年,人类基因组草图发表;2010年,一千余种物种(含一百余种真核生物)全基因组序列发表;2020年,近六百种真核生物基因组完成注释。几乎没有哪个生物学分支学科能够像基因组学这般快速积累和发展。虽然全基因组测序在酝酿阶段饱受争议,但时至今日,基因组研究所带来的成就已经深刻地改变了现代遗传学和生物学的思维模式,渗透到了医学、农业、工业等领域,并将继续对自然科学和人类社会的发展产生深远的影响。
第一节 基因组概述
1986年,遗传学家罗德里克(Thomas Roderick, 1930—2013)首次提出了基因组学(genomics)的概念,并创办了同名期刊。基因组学是一门对某一物种的所有基因进行基因组作图、核苷酸序列测定和基因功能分析的分支学科。那什么是基因组?基因组又具有哪些性质和特点?
一、基因组
基因组(genome)一词最早指的是一套具有完整遗传信息的基因拷贝或者一套完整的染色体。现在,基因组更准确的定义是一个细胞中所有遗传物质的总和,包括基因序列和基因间序列。每种生物都携带特定的基因组序列,其中包含了构成和维持该生物体生命形式与生命活动所需的全部遗传信息。
一种生物的单倍体基因组的 DNA 总量称为 C 值(C-value)。每种生物都具有其特定的 C 值。如图 14-1, 一些两栖类、鱼类、植物和原生动物的 C 值较大, 细菌的较小。即使在同一纲或目中, 不同属或种生物的 C 值差别也很大。哺乳动物的 C 值和爬行类、软体动物相近。因此, 生物的 C 值并不与生物复杂程度(或生物在进化上所处地位)相关, 这一现象被称作 C 值悖论(C-value paradox)。如果不看全基因组的大小, 单看基因的数目, 基因组中全部基因的数目与物种的复杂程度同样没有明显的相关性, 这被称为 G 值悖论。比如, 拟南芥的基因数是果蝇的近两倍。因此, 简单地用基因组大小、基因数目的多少来评价生物的基因组显然是不合理的, 生物的基因组需要从基因组的组成结构、序列特征甚至基因功能等多方面进行研究。在下文中,我们将结合几种模式生物,分别介绍病毒、原核生物和真核生物基因组的结构和功能特点。
单倍体基因组的核苷酸对数
图14-1 不同生物基因组大小
二、病毒基因组
病毒是最简单的生命体,病毒基因组包括 DNA 基因组和 RNA 基因组,这取决于病毒采用哪种核酸作为遗传物质。以乙型肝炎病毒(hepatitis B virus, HBV)为例,它的基因组结构非常简单(图 14-2)。HBV 含有不完全双链 DNA 分子,基因组大小为 3.2 kb,含有 4 个基因,分别编码衣壳蛋白 S、DNA 多聚酶 P、核心蛋白 C 和未知功能蛋白 X。在 HBV 基因组内,S 基因完全重叠于 P 基因中,X 基因与 P 基因、C 基因,C 基因与 P 基因都有重叠。HBV 的这些特点代表了病毒基因组的许多一般特征,归纳如下:
(1)病毒基因组的大小从几kb到几百kb不等,和病毒类型有关。一般来说,基因组较大、遗传信息较多的病毒对宿主的依赖性较小。
(2) 病毒基因组形式多样, 有双链核酸分子(如大多数动物病毒), 也有单链核酸分子(如噬菌体、反转录病毒等); 有闭环分子(如噬菌体、乳头瘤病毒等), 也有线性分子(如腺病毒、流感病毒等)。一些病毒基因组的核酸链甚至是断裂的, 如流感病毒的基因组由8条独立的RNA链构成。
内圈的灰色和黑色实线是基因组 DNA, 外圈的空心弧线对应 4 个基因的开放阅读框 (ORF)。
(3) 病毒基因组通过多种方法在较小的基因组容量内提高携带遗传信息的效率,比如基因组内非编码序列所占的比例极少,含有大量的重叠基因(即两个基因共享部分甚至某一基因的全部核苷酸序列)。
(4) 从基因表达上看, 病毒基因组内存在操纵子结构 (详见基因表达调控一章), 功能相关基因聚集分布, 在同一调节区域的调控下一起转录。此外, 一些病毒的某些基因也存在内含子序列。
三、原核生物基因组
原核生物包括蓝细菌、细菌、古菌、放线菌、立克次氏体、螺旋体、支原体和衣原体等。相对病毒基因组,原核生物的基因组略大,一般为几个Mb大小。在已完成全基因组测序的生物中,原核生物的种类最多。
大肠杆菌的基因组是较早开始研究的原核生物基因组。我们先以大肠杆菌 K-12 菌株为例介绍细菌基因组的组成,再归纳以细菌为代表的原核生物基因组的一般特点。如图 14-3,在大肠杆菌 K-12 全长 4.6 Mb 的基因组中,87.8% 的序列是蛋白质编码基因,0.8% 负责编码 RNA 产物,0.7% 是非编码重复序列,余下 10.7% 的序列负责基因表达调控和其他未知功能。两条 DNA 链都能作为模板进行基因转录,基因间的平均间隔大小仅为 118 bp。大肠杆菌基因的组织顺序和染色体复制的方向有关;存在大量操纵子结构,功能相关基因通常一起转录。在大肠杆菌基因组编码的 4288 个蛋白质中,包括了氨基酸、核酸合成代谢所需酶类,碳氮化合物分解代谢所需酶类以及结构组成蛋白等。
对比分析其他细菌基因组和大肠杆菌基因组进一步发现,原核生物的基因组在基因组组成结构和基因类型上都具有很大的相似性,它们具有以下一般特征:
的全基因组图谱(引自
Blattner 等,1997)
① 基因组通常仅由一条闭合的环状双链 DNA 分子组成,DNA 分子以超螺旋的组织方式集中在一个较为致密的区域,即类核(nucleoid)。但是也有一些细菌的基因组是线性分子,如链霉菌等。
② 大多数基因为单拷贝基因,少数基因(如 rRNA 基因)为多拷贝。
③ 两条 DNA 链上都有编码基因,非编码序列的比例很低。含有一些重复序列,也含有一些特殊的 DNA 结构元件,如复制起始区、转录终止子等。
④ 具有操纵子结构, 数个功能相关的结构基因串联在一起, 在同一调节区的控制下一起转录。
⑤ 与病毒基因组相比,细菌基因组中重叠基因较少。
⑥ 质粒是细菌染色体外共价闭合的环状 DNA 分子, 大小在 1~200 kb 不等, 可以独立复制, 但不是细菌生存所必需的。
近年来,人们对古菌的基因组研究也逐渐升温,这一点从已完成的古菌基因组测序的数目中可见一斑。由于古菌的细胞膜、细胞壁、代谢途径、翻译机制等均和普通细菌不同,因此古菌也被定义为原核生物和真核生物以外的“第三生物界”,即三域学说。1996年詹氏甲烷球菌(Methanococcus jannaschii)全基因组序列的发表第一次在基因组水平证明了三域学说的合理性:该古菌中未知功能的基因比例远大于一般细菌,此外,转录、翻译和复制相关基因类型与真核生物更加类似。随着更多的古菌的测序完成,研究者不断提出支持和反对的各项证据,三域学说的争论仍在继续,但基因组学无疑在生物进化分析中彰显了独特的作用。
四、真核生物的线粒体基因组和叶绿体基因组
大多数真核生物具有复杂的多细胞、多器官结构,与之相对应的是,真核生物基因组的组成比病毒和细菌要复杂得多,对它们的研究也相对困难和复杂。我们在前面介绍过,真核生物细胞内的线粒体和叶绿体都含有独特的细胞器 DNA,它们同样是维持真核细胞生存必不可少的条件,因此真核生物基因组包括核基因组和细胞器基因组。我们先介绍细胞器基因组。
除了少数低等真核生物的线粒体基因组为线性,大多数生物的线粒体基因组为环形 DNA 分子。线粒体的基因组通常有多个拷贝,但不同细胞类型所含拷贝数不同。线粒体基因组的大小同样和生物的复杂程度无关,动物细胞的线粒体基因组最小,不到 20 kb,低等真核生物次之,而显花植物的线粒体基因组最大,从几百到几千 kb 不等。线粒体基因组结构疏松,含有大量内含子序列。线粒体基因组主要负责编码一些 rRNA、tRNA 和部分呼吸链组分蛋白质等。但是,线粒体的结构和生命活动还需要核基因组的参与和调控。以人的线粒体基因组为例(图 14-4),全长 16 569 bp 的序列共编码呼吸链相关的 13 个蛋白质分子、22 个 tRNA 分子和 2 个 rRNA 分子。基因的组织效率非常高,基因间的非编码序列非常少,没有内含子,而且还存在重叠基因。
植物细胞的叶绿体基因组是闭环 DNA 分子, 大小从几十到几千 kb 不等, 但多数为几百 kb 大小。一个叶绿体内含有多个叶绿体 DNA 拷贝, 不同物种中叶绿体 DNA 的拷贝数不同。叶绿体基因组比线粒体基因组大, 含有内含子序列较多, 编码基因数也较多, 包括 tRNA 基因、rRNA 基因、RNA 聚合酶基因、核糖体蛋白质编码基因、光合作用相关蛋白质组分的编码基因, 等等。叶绿体基因组的一个特点是: 含有两段 10~76 kb 大小的反向重复区 (IR 区), IR 区内部含有rRNA 编码基因, IR 区将环状 DNA 分子分隔成大单拷贝区(LSC 区)和小单拷贝区(SSC 区)。1986 年第一个叶绿体 DNA——烟草(Nicotiana tabacum)叶绿体 DNA 全序列发表, 该 DNA 分子全长 155 844 bp, 编码大约 150 个基因。大多数植物的叶绿体携带的基因的种类相似, 但它们在不同生物的叶绿体 DNA 链上的组织和排列方式不同。
线粒体、叶绿体基因组的遗传密码与核基因组略有不同,且线粒体、叶绿体 tRNA 的简并性较强,这使得线粒体、叶绿体的编码方法更简单,也使得这些细胞器自身的翻译系统更简单。线粒体 DNA 和叶绿体 DNA 的另一个重要特点是,它们的遗传方式属于非孟德尔遗传,即亲代的线粒体 DNA 和叶绿体 DNA 并非均等地分配给子代细胞。关于这个部分我们已在细胞质和遗传一章中作过详细介绍。
五、模式真核生物核基因组测序的完成情况
1996 年通过国际合作,第一个真核生物的全基因组测序完成,即酿酒酵母,它是最简单的单细胞真核生物。酿酒酵母的基因组大小为 12 Mb,共 16 组染色体,含有 5 885 个蛋白质编码基因和大约 455 个 RNA 编码基因。酵母基因组不同于病毒、原核生物基因组的一个重要特点是:基因组内存在大量冗余序列,包括重复序列和多拷贝基因。1999 年,第一个多细胞生物,秀丽隐杆线虫(Caenorhabditis elegans)的全基因组测序完成,在 97 Mb 的基因组中,含有 6 对染色体,编码 19 099 个基因,基因在染色体上的密度更低,重复序列的比例也更高。相比简单的单细胞生物酵母,线虫的基因组编码大量独特的细胞间信号转导蛋白,这也是多细胞生物基因组的一大特点。线虫在 20 世纪 60 年代才被选为模式生物,但其后,它在研究信号转导,尤其是器官发育和程序性死亡通路中发挥了重要的作用,在线虫中鉴定出的许多关键基因都在人基因组中找到了同源基因。
另外几种模式真核生物的基因组测序也在随后几年内陆续完成,如2000年完成了黑腹果蝇(120 Mb)以及拟南芥(Arabidopsis thaliana)(125 Mb)基因组的测序,2002年完成了小鼠(Musmusculus) (2.5 Gb) 基因组的测序。模式生物的全基因组信息极大地推动了基于模式生物的人类疾病研究、生物进化研究和其他基础研究等。
第二节 真核生物基因组的结构和组成特点
真核生物基因组的结构和组织特点比病毒、原核生物复杂得多,真核生物的基因组的研究也更有利于认识人类自身。在下文中,我们将从几个方面描述真核生物基因组的特点。
一、真核生物染色体包装方式
独特的染色体包装方式是真核生物基因组的第一个重要特征。上文已经提到了许多病毒、原核生物及真核生物细胞器的基因组 DNA/RNA,它们大多是较为“裸露”的分子,不被蛋白质分子包装或被简单包装。但是,在真核生物细胞中,基因组 DNA 并非“裸露”。以人的基因组为例,人类染色体的实际长度为几微米(μm),但如果按照每圈 DNA 螺旋含 10.5 bp,约 3.4 nm 计算,每条染色体上携带的 DNA 的总长平均可达几个厘米。因此,必然存在一种高度有效的包装系统将如此长的 DNA 分子压缩了上千倍,从而将全部基因组 DNA 顺利包装进入狭小的细胞核中。
1974年,罗杰·科恩伯格(Roger David Kornberg, 1947—)和托马斯(Jean Thomas, 1942—)通过核酸酶保护实验结合电镜观察,提出了染色质结构的“念珠”(beads on a string)模型(图14-5)。他们先用小球菌核酸酶轻度消化染色质,离心分离消化程度不同的产物分子后进行电泳检测和电镜观察,结果发现平均每200 bp的核苷酸对应电镜下的一个“念珠”单位,400 bp的消化产物就是两个相连的“念珠”,以此类推,这个“念珠”样小体被称为核小体(nucleosome)。核小体模型在随后的研究中得到了公认和补充。
核小体是真核生物染色质的基本结构单位,在真核生物中高度保守:4种组蛋白H2A、H2B、H3和H4各两个分子构成一个桶状的八聚体,147 bp的DNA片段以左手螺旋方向盘绕八聚体1.65圈,构成直径为11 nm的核小体核心结构。相邻核小体之间还有一段连接DNA(10~80 bp,长度与种属、组织类型有关)、H1组蛋白(连接组蛋白)以及其他非组蛋白的DNA结合蛋白。因此,一个完整的核小体单位包含了约200 bp的DNA片段。
核小体的装配是 DNA 包装的第一步, 随后 DNA 以核小体作为基本结构进一步螺旋化, 6 个
核小体核心颗粒
核小体通过连接组蛋白形成直径为 30 nm 左右的中空螺线管(solenoid),又称 30 nm 染色质纤维(30 nm fiber)。螺线管再次螺旋化形成超螺线管(supersolenoid),最后再压缩成为染色质。这样,DNA 总共经过四级包装,被压缩了 7 000~8 000 倍后形成了染色质结构(图 14-6)。近年来的机制研究揭示,真核 DNA 的压缩程度受到时空特异性调节,DNA 复制、转录和修复等事件都依赖染色质结构的动态变化。
二、割裂基因
真核生物基因的编码序列在染色体上不是连续排列的,而是被内含子间隔开,因
此真核生物的基因被称为“割裂基因”,这是真核生物基因组的另一特点。内含子在基因转录后不久被切除,不存在于成熟的 mRNA 序列中。我们已在遗传的分子基础一章介绍过割裂基因的结构,现在我们介绍一下遗传学家是如何发现这一现象的。
尚邦(Pierre Chambon,1931—)最早看到了“割裂基因”现象,在比较鸡的输卵管细胞和红细胞的基因组差异时,他提取了两种细胞的基因组DNA,酶切后进行电泳,用卵清蛋白的mRNA来制备cDNA探针,分别和两种基因组DNA进行Southern印迹,结果两种组织中的DNA出现了完全相同的多条杂交带。实验表明,虽然两种细胞的基因表达不同,但它们的基因组DNA是相同的。但令尚邦不解的是,卵清蛋白的cDNA序列内部并没有他所使用的限制性内切酶的酶切位点,为什么会在杂交中出现多条阳性条带。随后,夏普和罗伯茨利用腺病毒外壳蛋白六聚体基因(Hexon gene)进行杂交实验,发现该基因的DNA单链和mRNA链不能完全互补,在DNA-mRNA杂合链中出现了因不能互补配对而拱出的泡状结构(图14-7)。他们据此提出了割裂基因的概念,认为基因的编码序列在DNA上是不连续的。尚邦随后才意识到,原来在卵清蛋白基因的割裂区中含有酶切位点,可以将整个卵清蛋白基因切割成多条片段。1978年吉尔伯特提出了内含子和外显子两个名词,内含子是指在成熟的mRNA中不出现的DNA序列,而外显子是指在成熟的mRNA中出现的DNA序列(见图5-26)。
从初始 mRNA 中去除内含子的过程叫作 RNA 剪接 (RNA splicing)。剪接位点的选择, 即内含子的边界, 有一个共同的特征: 5’ 端通常以 GT 开始, 3’ 端通常以 AG 结束, 这被称为 GT/AG规则。相比原核生物,真核生物的RNA剪接似乎做了“减法”——内含子浪费了遗传信息的储存空间;但当遗传学家进一步追踪RNA剪接的过程时,他们发现真核生物其实做了一个非常巧妙的“加法”——采用可变剪接(alternative splicing)的方式增加基因表达的多样性。所谓可变剪接,简单地说,就是mRNA前体的不同剪接方式。通过可变剪接,一个mRNA前体在不同的剪接方式(选择不同的剪接位点组合)下,可以产生不同的mRNA剪接变异体(splicing variant)。利用基因组数据和表达序列标签(expressed sequence tag, EST)数据进行计算机分析后推测,在人的基因组中 $35% \sim 60%$ 的基因具有可变剪接形式。考虑到现有的EST文库中的序列还不能覆盖不同组织细胞的全部mRNA,实际可变剪接的频率可能比预测的更高。如图14-8,人的原肌球蛋白编码基因在横纹肌、平滑肌、成纤维细胞及脑细胞中的mRNA剪接方式各不相同,在成纤维细胞中就有两种方式。可见,可变剪接是真核生物细胞调节基因表达和增加遗传信息多样性的重要机制。
(a) Hexon 基因结构示意图。
(b) Hexon 基因 DNA-mRNA 杂合链。
尽管内含子在初始 mRNA 加工过程中会被剪接掉,但是这并不意味着内含子是基因组序列中的多余组分。首先,内含子的存在提高了一个基因中遗传信息的存储量,一方面可变剪接使得单独一个基因可以编码多种蛋白质,另一方面有些基因的内含子本身也可以编码其他蛋白质。例如,人的 I 型神经纤维瘤 NF1 基因的第 26 个内含子中包含了 3 个独立转译的基因序列。其次,从进化角度看,内含子序列的突变压力相对较小,对突变的容忍度高,有利于基因组的进化。但
α-原肌球蛋白编码基因
在横纹肌细胞、平滑肌细胞、成纤维细胞和脑细胞中原肌球蛋白的编码基因利用了不同的内含子剪接方式。在成纤维细胞中存在两种不同的剪接方式。
是,不是所有内含子序列的突变都是中立的,内含子中也存在重要的基因表达调控序列,在这些位点上的突变会影响正常的基因表达,甚至引起疾病。例如,凝血因子Ⅷ第22个内含子的倒位突变可引起凝血因子Ⅷ严重缺乏,这是临床上部分重症甲型血友病的发病机制。
三、基因家族与基因超家族
基因家族(gene family)是真核生物基因组中基因组成的一个特点。每个基因家族包括多个基因成员,它们在序列上具有高度的相似性但不完全相同。基因家族的不同成员很可能是由同一个祖先基因经过复制和后续突变而形成的。基因家族的成员在染色体上的分布分为两种:一种是散在分布于各条染色体上,这是大多数基因家族的分布方式;另一种是集中分布在一条染色体的某一个特定位置,形成“基因簇”(gene cluster),如人的rRNA、tRNA和组蛋白基因等。
真核生物基因组中,很多表达活跃的基因都属于特定的基因家族。有时候,基因家族的不同成员可以在不同时间、不同组织进行表达。例如,人的同源异形基因家族(homeobox gene family)由38个Hox基因及214个孤独同源异形基因(orphan homeobox gene)构成,不同成员在个体发育的特定时期表达,调节胚胎体节定位及器官发育。另外一种常见的情况是,基因家族的多个成员编码功能相同或相近的蛋白质,满足某个特定时期机体对该蛋白质的需求。比如人的4种组蛋白分子,共有60个编码基因,分布在7条染色体上,序列高度保守,尤其在6号染色体短臂有两个集中的基因簇(图14-9),每个基因簇都含有串联排列的多拷贝组蛋白基因,可以在短时间内迅速表达出大量组蛋白,供染色质复制使用。
从广义上讲,一些非编码序列在基因组中也存在大量序列相似的拷贝,也可以称作基因家族。比如说下文将要提到的 Alu 序列和 LINE-1 序列,它们在基因组中有很多截短和突变的拷贝,也构成“基因家族”。有时候,基因家族还含有突变后不具有编码功能的假基因(pseudogene),如人的 $\alpha-$ 珠蛋白基因簇内含有 3 个假基因, $\beta-$ 珠蛋白的基因簇内也含有 1 个假基因。它们在进化中由复制产生,又在后来的突变中丧失了编码正常蛋白质的活性而成为了假基因(图 14-10)。还有一些基因的重复拷贝只保留了有限的基因序列,例如仅一个外显子,这样的 DNA 序列被称为基因片段(gene fragment)。
图 14-9 人的组蛋白编码基因在染色体上的分布
α-珠蛋白基因簇包括 $\zeta_{2}$ 、 $\psi_{\zeta_{1}}$ 、 $\psi_{\alpha_{2}}$ 、 $\psi_{\alpha_{1}}$ 、 $\alpha_{2}$ 、 $\alpha_{1}$ 和 \theta7 个基因,其中 $\zeta_{2}$ 在胎儿时期表达, $\alpha_{1}$ 及 $\alpha_{2}$ 在成年时期表达, $\psi_{\zeta_{1}}$ 、 $\psi_{\alpha_{2}}$ 、 $\psi_{\alpha_{1}}$ 为假基因。β-珠蛋白基因簇包括 $\varepsilon$ 、 $G_{\gamma}$ 、 $A_{\gamma}$ 、 $\psi_{\beta}$ 、δ 和 β6 个基因,其中 ε 在胚期表达, $G_{\gamma}$ 、 $A_{\gamma}$ 在胎儿期表达,β 和 δ 在成年时表达, $\psi_{\beta}$ 为假基因。
假基因又称拟基因,指的是基因组中与有功能的基因相似,失去编码功能的 DNA 序列。1977 年,研究者在非洲爪蟾 DNA 中克隆了第一个假基因(Jacq,1977)。爪蟾的 5S rRNA 基因约有 500 个拷贝,串联重复排列在染色体上。在每个重复单位中含有一个 5S rRNA 基因和一个携带了 9 个突变的不转录的 5S rRNA 假基因,每个重复单位间被不转录的间隔序列隔开,间隔序列的长度变化不定。在人的核基因组中,约 10% 的基因有拷贝数不同的假基因,全部假基因及基因片段约两万个或更多,几乎与基因的数量相当。近年来的研究发现,不少假基因也具有“真功能”,尤其是在基因表达调控方面。
根据形成方式的不同, 假基因可以分为两种类型: 常规假基因 (conventional/classical pseudogene) 和加工后假基因 (processed pseudogene)。常规假基因是在基因组进化过程中, 功能基因复制后发生突变产生的失活产物, 如上文介绍的人的 $\alpha$ -珠蛋白和 $\beta$ -珠蛋白的假基因, 序列和正常基因几乎完全一致, 但因为突变或缺少启动子不能正常表达或者表达的蛋白产物没有活性 (图 14-11)。加工后假基因是由来自功能基因的 RNA 转录产物反转录成 DNA 后重新随机地插入基因组中形成的。如图 14-12, mRNA 反转录为 cDNA 后再次插入基因组, 形成一个新的基因拷贝, 这个基因拷贝通常不含有启动子序列和内含子, 而保留了 poly(A) 尾巴。新的基因拷贝由于没有启动子, 不能正常转录和表达而成为假基因。如人基因组中一些 tRNA 和 rRNA 的基因拷贝就属于这类假基因。
不同的基因家族中,成员之间在碱基序列和氨基酸序列上的相似性有一定的差异:有的家族成员在编码区碱基序列完全相同,如人的组蛋白基因;有的家族成员只共享独特的蛋白质结构域甚至是蛋白质基序,如同源异形框基因家族。某些基因之间虽然既没有碱基序列的相似性,也没有同源的蛋白质功能域或者基序,但是它们在功能上具有一定的相似性,如免疫球蛋白编码基因,我们可将这类基因定义为基因超家族(gene superfamily)。
四、真核生物基因组中的非编码序列
从基因组的组成上看,蛋白质 / RNA 编码基因所占的比例非常小,含有大量非编码序列是真核生物核基因组的另一个重要特点。前面讲过,大肠杆菌的非编码序列占 12%,而酿酒酵母的占利用 NCBI 的 blast 软件比较 HBAP1 全长序列与 HBA2 全长序列,同源性达到 72%,但 HBAP1 在起始密码子、剪接位点等关键位点均存在点突变,在外显子序列内部还有多碱基缺失,不能正常表达而成为假基因。
| 起始密码子突变 | |
| HBA2 | CACAGACTCAGAGAGAACCCACCATGGTGCTGTCTCCTGCCGACAAGACCAACGTCAAGG |
| HBAP1 | CACAGACTCAGAAATAAGCTGCCGTGGTGCTGTCTCCTGAGGACAAGGCTAACACCAAGG |
| HBA2 | CCGCCTGGGGTAAGGTCGGCGCGCACGCTGGCGAGTATGGTGCGGAGGCCCTGGAGAGGT |
| HBAP1 | CGGTCTGGGAGAAAGTTGGCAACCACACTGCTGGCTATGCCACGGAGGCCCTGGAGAGGC |
| HBA2 | GAGGCTCC--CTC-CCCTGCTCCGACCCGGGCTCCT-CGCCCCGCCC--GGACCCACAGG |
| HBAP1 | AAGAACCCCTCCTCTCCCTGCTCACACCTTGGGTCCAACGCCCCACTCCAGGGCTCCACTGG |
| HBA2 | CCACCCTCAACCGTCCTGGCCCCGGACCCAAACCCCA-CCCCTCACTCT--GCTTCTCCC |
| HBAP1 | CCACCCCTAACTATTCTTACCCTGGACCCAGCCCCCAGCCCCTCACTCTTTGCTTCCCCC |
| HBA2 | CGCAGGATGTTCCTGTCCTTCCCCACCACCAAGACCTACTTCCCGCACTTCGACCTGAGC |
| HBAP1 | TGAAGCATGTTCCTGACCTTCCTCTC——ACTTGGCCCTGAGT |
图14-11 $\alpha$ -珠蛋白基因簇中的HBA2与常规假基因HBAP1的部分序列比对结果
30%, 线虫达到 75%, 果蝇是 80%, 小鼠和人的非编码序列的比例分别高达 95% 和 98%。真核生物中这些大量的非编码序列一度被归为“垃圾 DNA”(junk DNA)。但是, 随着功能基因组学的发展, 许多“垃圾 DNA”被重新验明真身, 它们是基因组中未被发掘的重要宝藏。“垃圾 DNA”包括基因间的非编码序列和基因内部的非编码序列。基因内部的非编码序列主要包括上文介绍的内含子序列。基因间的非编码序列所占的比例更大, 除了上文提到的假基因和基因片段, 还包括大量的非编码重复序列。
与原核生物基因组不同,真核生物基因组中出现了大量的重复序列。我们在“遗传的分子基础”一章介绍了 DNA 的变性和复性。对于一个完整的基因组而言,DNA 的复性速率与基因组中碱基序列的复杂情况和重复程度有关。顺序单调、重复程度高的 DNA 片段,例如序列为 ATATAT 的高度重复序列 (highly repetitive sequence),与顺序变化大、重复程度低的 DNA 片段,例如单拷贝的结构基因相比,前者的复性速率要明显高于后者。此外、复性速率也受到反应液中 DNA 初始浓度的影响:浓度越高,互补链碰撞机会越多,复性速率越快。因此,以未复性的单链百分数为纵轴,初始浓度 (C_{0}) \times 时间 $(t)$ 为横轴,做成 $C_{0}t$ 复性曲线,可以用来估计重复序列和单拷贝序列的相对比例。
图 14-13 比较了原核生物(大肠杆菌)和真核生物(小牛)的 $C_0t$ 复性曲线。大肠杆菌 DNA 中没有重复顺序, 反应曲线也是单调的。起始阶段全都是单链, 到最后阶段都成为双链。但小牛 DNA 的复性曲线分为两部分: 前面一段曲线的复性速率高, 代表了序列短、重复程度高的序列, 约占基因组的 $40%$ ; 后一段曲线的复性速率低, 代表了较为复杂的单一序列, 占 $60%$ 。
如果对人的基因组 DNA 进行复性分析, 可以发现人的基因组中含有 3 种不同重复程度的重复序列, 即高度重复序列、中度重复序列和单一序列。有时也把重复次数在 10 次以内的序列称为低度重复序列, 包括一些多拷贝的功能基因, 如珠蛋白编码基因。单一序列和低度重复序列的复性速率非常慢, 这部分 DNA 约占基因组的 60%。高度重复序列的复性速率最快, 占基因组的 10%, 它们在基因组中的重复次数可以达到 10 万以上。中度重复序列的复性速率次之, 占基因组的 30%, 这些序列的重复次数从十几次到几千次不等。重复序列还可以根据其在染色体上的排列方式进行分类, 包括串联重复序列 (tandemly repeated sequence) 和散在重复序列 (interspread repetitive sequence) 两种。
卫星 DNA (satellite DNA) 是典型的串联重复序列。在用密度梯度离心法分离真核细胞基因组 DNA 时,含有串联重复序列的 DNA 片段会形成“卫星”带。这是因为含有大量短串联重复序列的 GC 含量和密度有别于整个基因组的水平。卫星 DNA 一般不可转录,构成了染色质中包装程度较高的异染色质区域。
散在重复序列又可以分为长散在重复序列(long interspersed nuclear element, LINE)和短散在重复序列(short interspersed nuclear element, SINE)。短散在重复序列的重复单位小于500 bp,拷贝数大于10万。最有代表性的短散在重复序列是灵长类特有的Alu元件(Alu elements)。Alu在人基因组中拷贝数超过100万,占全基因组的11%左右,染色体上平均每隔4 kb左右就有一个 Alu 序列。Alu 以不同密度分散在人的染色体的各个位置,可以在基因的内含子中,也可以在基因间的序列中。研究显示,Alu 在基因组进化、基因表达调控和疾病发生中扮演了重要作用。图 14-14 给出了人 Alu 的结构组成:两侧是一段 6~18 bp 的正向重复序列,中间由两个 130 bp 的串联重复顺序组成,在第二个重复单元中有 32 bp 无关碱基的插入。Alu 元件正是因为序列内部含有一个限制性内切酶 Alu I 的位点而得名。研究认为,Alu 序列是 7SL RNA 基因(信号识别蛋白 SRP 的组分之一)的加工后假基因(见下文),在进化过程中由偶然的 7SL RNA 基因反转座产生。基因组中除了完整的 Alu,还有大量截短和缺失的突变体。由于 7SL RNA 基因受 RNA 聚合酶Ⅲ的转录调控,启动子序列位于转录起始位点的下游,因此转座后形成的重复拷贝仍然可以被转录激活,而且体外实验中 Alu 序列具有独立转录活性,这在一定程度上提示了 Alu 序列在基因组中广泛存在的原因。
图14-14 人Alu序列重复单元的结构示意图
长散在重复序列的重复单位大于 1 kb,在基因组中有 $10^{4} \sim 10^{5}$ 个拷贝。和短散在重复序列 Alu 不同,长散在重复序列普遍存在于脊椎动物基因组中。其中,LINE-1(L1) 家族是哺乳类(包括人)基因组中最主要的长散在重复序列。人的 L1 序列全长 6.1 kb(图 14-15),两侧同样有正向重复序列,内部含有两个开放阅读框 ORF1 和 ORF2。ORF1 编码一个相对分子质量约 4 \times 10^{4} 的蛋白,而 ORF2 编码蛋白的内部含有反转录酶结构域和内切核酸酶结构域。此外,5’ UTR 含有一段内部启动子序列,而 3’ UTR 含有 poly(A/T) 序列。人基因组内 L1 的拷贝数达到 1 \times 10^{5} \sim 5 \times 10^{5} ,但全长重复序列很少,通常缺失 5’ UTR 序列。
在基因组进化过程中,一般认为串联重复序列是由原始序列的复制和滑移产生的,而转座则是形成散在重复序列的重要机制之一。长散在重复序列和短散在重复序列都属于真核细胞基因组的非 LTR 反转录转座子。除此之外,真核生物基因组中可转座的元件还包括 DNA 转座子和 LTR 反转录转座子两类。
DNA 转座子在原核生物基因组中较为常见,比如大肠杆菌的 IS 等。真核生物中 DNA 转座子较为少见,如玉米的 Ac/Ds 元件等,这些内容我们已在前面进行了详细介绍。在高等真核生物中也有 DNA 转座子,如知名的 mariner。mariner 转座子最早是从毛里求斯果蝇 (Drosophila mauritiana) 中发现的,具有长度为 28 bp 的末端反向重复序列,可以特异性地和目标位点结合。随后在许多其他物种(包括人)中都发现了 mariner 类似元件(mariner like element)。
反转录转座子的出现,是真核生物基因组区别于原核生物的又一特点。脊椎动物以外的真核生物的反转录转座子主要是 LTR 反转录转座子,包括 Ty3/gypsy 家族和 Ty1/copia 家族。脊椎动物中非 LTR 反转录转座子占主要地位,例如人类基因组中长散在重复序列和短散在重复序列占基因组的 34%。脊椎动物中 LTR 反转录转座子主要是内源性反转录病毒(endogenous retrovirus, ERV)和它的截短形式——反转录病毒类似元件,它们是病毒整合进入脊椎动物染色体后遗留的痕迹,有一些仍有活性,但大部分已经退变。
第三节 人类基因组计划和人类基因组
人类基因组计划(Human Genome Project, HGP)是科学史上和曼哈顿原子弹计划、阿波罗登月计划相媲美的第三大科学计划,其意义之深远不言而喻。我们在此简要和读者介绍一下HGP的研究内容、研究成果以及这项计划对遗传学的影响。
一、人类基因组计划
HGP 酝酿于 20 世纪 80 年代中期,1984 年在美国犹他州盐湖城阿尔他举行的“环境诱变物和致癌物防护”的国际会议揭开了全基因组研究的序幕。当时,与会科学家们第一次提出了“能否从全基因组筛查中获得环境因素或致癌物诱变的人群携带的全部基因突变”的疑问。随后,基因组测序计划得到了广泛的关注和讨论,因研究病毒癌基因而获得 1986 年生物学家杜尔贝科(Renato Dulbecco,1914—2012)在当年的 Science 杂志上发表了题为《癌症研究的转折点:测定人类基因组序列》的论文。他在论文中提出:相比“零敲碎打”地寻找肿瘤相关基因,全基因组测序可以获得人类全部表达基因的信息、功能和表达谱等,从而将与肿瘤发生相关的基因都找出来。这篇论文轰动一时,引发了一系列深入的讨论。有大批学者支持,也有学者反对。反对者的观点主要集中在两方面:一是全基因组测序将消耗无比巨大的人力财力;二是基因组中编码基因所占的比例很小,是否有必要做全部测序。
在一片质疑声中,1988年美国国会最终批准拨出专款资助能源部和国立卫生研究院同时负责实施HGP,由发现DNA双螺旋的沃森担任HGP第一任首席科学家,同年成立国际人类基因组组织(Human Genome Organization, HUGO)。1990年10月由美国国会批准正式启动HGP,随后,该计划发展成一个由多国政府支持的国际项目,先后有法国、英国、意大利、德国、日本宣布加入,中国于1998年申请参加人类基因组3号染色体端部约 $1%$ 基因组的测序。
HGP 的总体规划是: 拟在 15 年内至少投资 30 亿美元, 进行全人类基因组的测序分析; 完成包括遗传图谱、基因图谱、物理图谱和序列图谱在内的 4 幅人类基因组图谱的绘制, 同时完成 5 种模式生物——大肠杆菌、酵母、线虫、果蝇和小鼠的全基因组测序。最终目标就是确定人类基因组所携带的全部遗传信息, 同时确定、记录和阐明人类基因组的全部 DNA 序列。HGP 具体的执行进度表如图 14-16。
1998年5月,由文特尔(John Craig Venter, 1946—)领导的Celera Genomics公司在华盛顿成立,以私营生物公司的身份挑战HUGO,拟在3年内完成人类基因组的全部测序工作,同时宣称由他们获得的数据将不会免费开放。在这件略带戏剧性的事件影响下,人类基因组测序在“公”与“私”之间展开了激烈的竞争。
| 1984 | 1990 | 1991 | 1992 | 1993 | 1994 | 1995 | 1996 | 1997 | 1998 | 1999 | 2000 | 2001 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| |—/| | | | | | | | | | | | | | | | | | | | | | | | | |
细菌基因组测序
从上至下依次是各类简单的模式生物、小鼠和人的基因组测序进度。
最终,通过长时间的竞争与和谈,2001年2月12日,HUGO和Celera Genomics公司分别在Nature和Science杂志上同时公布了人类基因组草图,又称工作框架图(working draft),及其初步分析结果,比HGP原计划提前了2年。基因组草图覆盖了基因组90%的序列,单碱基错误率低于1%。2003年,覆盖度达99%、单碱基错误率在0.001%的精图完成。同时,单条染色体的完全测序也在逐个完成。2006年1月,最后一条人类染色体——1号染色体的全部测序完成,标志着基因组99.99%的序列实现完全测序。如今,全世界的研究者都可以登录在线生物学数据库进行人类基因组数据的实时搜索并免费获取任意序列。常用的基因组检索数据库包括美国国立生物技术信息中心(National Center for Biotechnology Information,NCBI)的Genbank,美国加利福尼亚大学圣克鲁兹分校的基因组浏览器和欧洲生物信息研究所(European Molecular Biology Laboratory-the European Bioinformatics Institute,EMBL-EBI)和桑格研究所(Wellcome Trust Sanger Institute)共同开发的Ensembl等。研究者们将人类基因组计划(及其后续计划)得到的基因组序列定义为参考基因组(reference genome),因为这个基因组信息并非来自于某个特定的人,而是不同人(不同种族、不同性别等)基因组DNA序列的集合。参考基因组是科学家将混合样本进行整理和校准的结果,用来代表智人这个物种的基因组标准。随着测序研究的深入和基因组样本量的增加,参考基因组序列一直处于不断完善之中,目前国际发布的最新参考基因组版本是GRCh38/hg38(genome reference consortium human build 38/human genome build 38),研究者可以根据自身研究的需要选择合适版本的基因组序列。
二、人类基因组的组成和特点
基因组计划完成之后,人类第一次翻开了编码人类生命的“天书”。在这本长达30亿个碱基的“天书”中,GC比例为41%,低于AT的59%。19号染色体上GC比例最高,达49%;4号和13号染色体上最低,为38%。GC比例和染色体上的基因数目之间存在一定的相关性。
人类基因组序列可以分为重复序列和单一序列,重复序列的比例略高于单一序列(图 14-17)。重复序列中散在分布的转座序列占主要地位(表 14-1):长散在重复序列和短散在重复序列分别占基因组全部序列的 21% 和 13%,两者都属于反转录转座子,LTR 反转录转座子占 8%,还有 DNA 转座子占 3%(图 14-18)。汇总起来,人类基因组中 45% 左右的序列来自于转座元件,这一比例远高于绝大多数真核生物。大部分转座元件在人类基因组中的转座活性已大大下降,比如 DNA 转座子已经完全丧失了转座活性,但是还有一些转座元件仍具有一定的转座活性,能
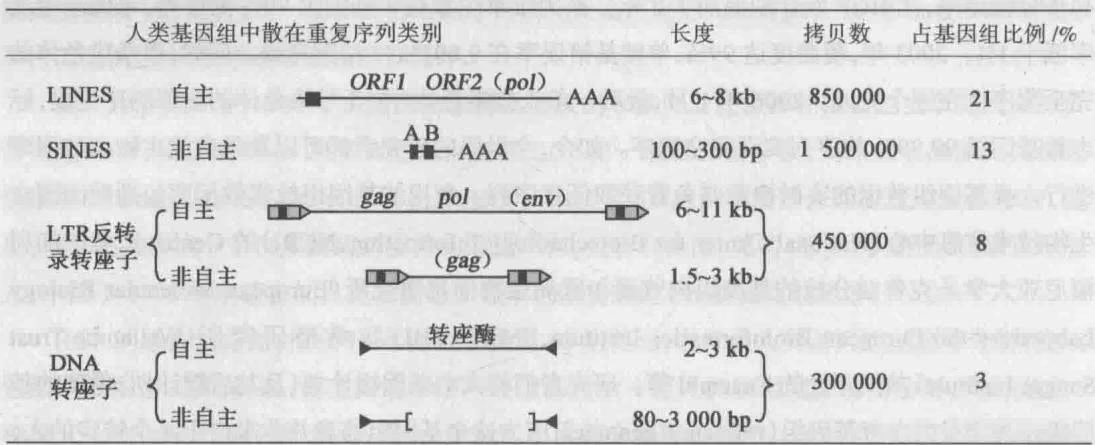
LINEs 具有自主转座活性, SINEs 是非自主元件; LTR 反转录转座子包括编码转座酶的自主型元件 ERV 和非自主元件 TRVL; DNA 转座子也包括编码转座酶的自主型和非自主型元件。
够引起基因重排。我们现在对人类基因组中的转座元件的认识还较少,它们的功能角色还有待更深入系统的研究工作。在基因组的剩余部分中,区段重复(segmental duplication),又称为低拷贝重复(low-copy repeats, LCR),占基因组的3%,卫星DNA等简单序列重复占5%。在2001年HUGO公布的人类基因组草图中,详细列举了人类基因组中发现的散在重复序列和卫星DNA的种类、大小、比例或定位(表14-1、表14-2)。
表 14-1 人类基因组中已发现的散在重复序列 $^{*}$
| 拷贝数 /×1 000 | 总碱基数 /Mb | 占基因组比例 /% | 家族数目 | |
|---|---|---|---|---|
| SINEs | 1 558 | 359.6 | 13.14 | |
| Alu | 1 090 | 290.1 | 10.60 | 1(-20) |
| MIR | 393 | 60.1 | 2.20 | 1(1) |
| MIR3 | 75 | 9.3 | 0.34 | 1(1) |
| LINEs | 868 | 558.8 | 20.42 | |
| LINE1 | 516 | 462.1 | 16.89 | 1(-55) |
| LINE2 | 315 | 88.2 | 3.22 | 1(2) |
| LINE3 | 37 | 8.4 | 0.31 | 1(2) |
| LTR 元件 | 443 | 227.0 | 8.29 | |
| ERV-I型 | 112 | 79.2 | 2.89 | 72(132) |
| ERV(K)-II型 | 8 | 8.5 | 0.31 | 10(20) |
| ERV(L)-III型 | 83 | 39.5 | 1.44 | 21(42) |
| MaLR | 240 | 99.8 | 3.65 | 1(31) |
| DNA 转座元件 | 294 | 77.6 | 2.84 | |
| hAT类 | ||||
| MER1-Charlie | 182 | 38.1 | 1.39 | 25(50) |
| Zaphod | 13 | 4.3 | 0.16 | 4(10) |
| Tc-1类 | ||||
| MER2-Tigger | 57 | 28.0 | 1.02 | 12(28) |
| Tc2 | 4 | 0.9 | 0.03 | 1(5) |
| mariner | 14 | 2.6 | 0.10 | 4(5) |
| PiggyBac-like | 2 | 0.5 | 0.02 | 10(20) |
| 未分类 | 22 | 3.2 | 0.12 | 7(7) |
| 未分类 | 3 | 3.8 | 0.14 | 3(4) |
| 合计 | 1226.8 | 44.83 |
* 引自 International Human Genome Sequencing Consortium, 2001。
表 14-2 人类基因组中的卫星 DNA $^{4}$
| 类别 | 重复序列大小 | 主要染色体定位 |
|---|---|---|
| 大卫星 DNA | 几 kb | 特定染色体上的多个位置 |
| RS447 | 4.7 kb | 4p15,有 50 ~ 70 拷贝,8p 远端还有一些 |
| 未命名 | 2.5 kb | 4q31 和 19q13,约 400 拷贝 |
| 未命名 | 3.0 kb | X 染色体上,约 50 拷贝 |
| 卫星 DNA | 5 ~ 171 bp | 主要在着丝粒位置 |
| α(alphoid DNA) | 171 bp | 全部染色体的着丝粒异染色质区 |
| β(Sau3 A 家族) | 68 bp | 1、9、13、14、15、21、22 和 Y 染色体的着丝粒异染色质区 |
| Satellite1(富含 AT) | 25 ~ 48 bp | 大多数染色体的着丝粒异染色质区,其他异染色质区 |
| Satellite2 和 3 | 5 bp | 全部染色体 |
| 小卫星 DNA | 6 ~ 64 bp | 所有染色体的端粒和近端粒位置 |
| 端粒家族 | 6 bp | 所有端粒 |
| 高度可变家族 | 9 ~ 64 bp | 全部染色体,常在近端粒区 |
| 微卫星 DNA | 1 ~ 4 bp | 全部染色体上散在分布 |
* 引自 International Human Genome Sequencing Consortium, 2001。
在人类基因组的单一序列中,基因的内含子序列所占比例较大,而具有蛋白质编码功能的基因序列仅占1.5%左右。换言之,98.5%的基因组序列是非编码的,这一比例远远超过了生物学家们最初的设想。不仅如此,基因的数目也完全不在学者们的预料之中。在HGP计划之初,生物学家估算人类基因组的蛋白质编码基因个数约为100 000。2001年,在HUGO和Celera Genomics公布的人类基因组草图中,这一数字被预测在30 000~40 000。到了2004年的基因组精图,研究者们认为仅有20 000~25 000。近年来,随着基因组序列功能注释工作的推进,这一数字被进一步精确到19 000~21 000。人类基因组的基因个数与小鼠、拟南芥等都非常接近,再次说明生物的复杂性并不是依靠基因的数量来实现的。
人类基因组的蛋白质编码基因多为割裂基因,平均外显子个数约为8.8个,外显子的平均长度约为145 bp,而内含子平均长度达到了3 365 bp,远高于外显子。基因全长平均约为27 kb,其中编码序列平均约1340 bp,3’ UTR和5’ UTR的平均大小则分别为300 bp和770 bp。不同基因之间差异极大,而且基因和或外显子的长度与基因编码产物的长度之间并无明显关联,这是因为各个基因外显子序列和编码序列的比例互不相同。和其他物种基因组相比,人类基因组中基因在染色体上分布密度极低,大约每145 kb分布一个基因,与之一致的是人类基因组中罕见重叠基因。不同染色体上基因分布不均匀,其中19号染色体上基因密度最高,而13号和Y染色体所含基因最少。在全部蛋白质编码基因的产物中,主要类型包括酶、核酸酶、信号转导分子、受体分子等(图14-19)。绝大多数人类基因组的蛋白质编码基因产物与其他物种中的蛋白质存在一定程度的同源性,这也为基因组进化提供了重要证据。
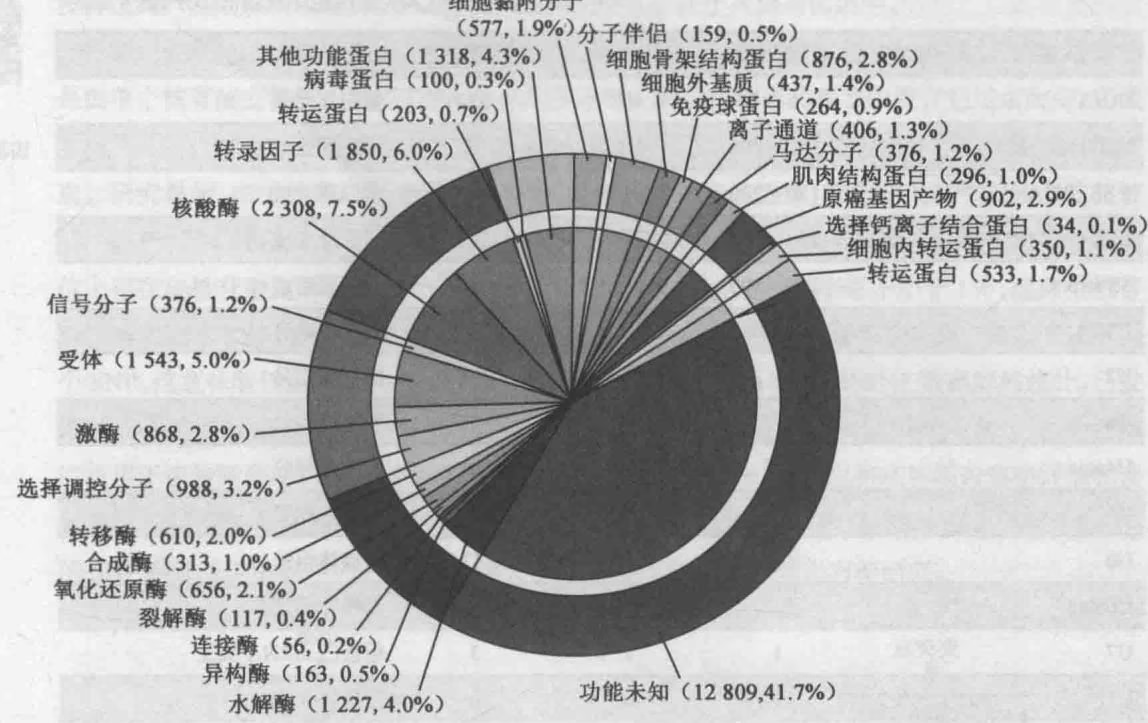
能分类(引自 Venter 等,2001)
多种多样的 ncRNA 基因的发现是人类基因组计划的一项重要收获。mRNA 是可以翻译成为蛋白质的一类 RNA 分子,而 ncRNA 就是指没有蛋白质编码功能的 RNA 分子的统称。在 2001 年 HUGO 公布人类基因组草图时,研究者们就发现 ncRNA 基因广泛存在于人类基因组中(表 14-3),功能分析强烈提示它们也同样是维持细胞生命活动不可或缺的组分。例如,蛋白质翻译中负责转运氨基酸的转运 RNA(transfer RNA, tRNA)和负责组装核糖体的 4 种核糖体 RNA(ribosomal RNA, rRNA)都是蛋白质翻译的核心调控分子。此外,U1、U2、U4、U5、U6 等 RNA 分子是参与 mRNA 剪接(mRNA splicing)的一类小核 RNA(small nuclear RNA, snRNA,又称为 U-RNA),它们先与蛋白质构成核糖核蛋白(small nuclear ribonucleoproteins, snRNPs),再与其他蛋白质进一步组装成剪接复合体(spliceosome),执行 mRNA 的剪接。两种小核仁 RNA(small nucleolar RNA, snoRNA)是 rRNA 合成后加工和碱基修饰的关键调控分子。人类基因组中其他一些特殊功能的低丰度 ncRNA 包括:X 染色体上的 Xist RNA 基因表达的 17 kb 大小的 ncRNA 是人类基因组中代表性的长非编码 RNA(long non-coding RNA, lncRNA),负责介导 X 染色体的随机失活;3 号染色体长臂的端粒 RNA(telomerase RNA)基因是染色体端粒延伸的必要组成。随着基因组序列功能研究的深入,人类基因组中发现了越来越多的 ncRNA,其数量与蛋白质编码基因旗鼓相当。这些 ncRNA 从不同层次参与了基因表达调控,我们将在基因表达调控一章和读者详细介绍其中的一些类型。
表 14-3 人类基因组中发现的部分 RNA 基因
| RNA基因(或基因家族) | 预测数目 | 已发现数目 | 相关基因数 | 功能 |
|---|---|---|---|---|
| tRNA | 1310 | 497 | 324 | 蛋白质合成 |
| SSU(18S)rRNA | 150~200 | 0 | 40 | 蛋白质合成 |
| 5.8S rRNA | 150~200 | 1 | 11 | 蛋白质合成 |
| LSU(28S)rRNA | 150~200 | 0 | 181 | 蛋白质合成 |
| 5S rRNA | 200~300 | 4 | 520 | 蛋白质合成 |
| U1 | ~30 | 16 | 134 | 剪接体组分 |
| U2 | 10~20 | 6 | 94 | 剪接体组分 |
| U4 | ? ? | 4 | 87 | 剪接体组分 |
| U4atac | ? ? | 1 | 20 | 剪接体组分 |
| U5 | ? ? | 1 | 31 | 剪接体组分 |
| U6 | ? ? | 44 | 1135 | 剪接体组分 |
| U6atac | ? ? | 4 | 32 | 剪接体组分 |
| U7 | 1 | 1 | 3 | 组蛋白mRNA加工 |
| U11 | 1 | 0 | 6 | 剪接体组分 |
| U12 | 1 | 1 | 0 | 剪接体组分 |
| SRP(7SL)RNA | 4 | 3 | 773 | 信号识别颗粒组分 |
| RNAse P | 1 | 1 | 2 | tRNA加工 |
| RNAse MRP | 1 | 1 | 6 | rRNA加工 |
| 端粒RNA | 1 | 1 | 4 | 端粒模板 |
| hY1 | 1 | 1 | 353 | Ro RNP(核糖核蛋白)组分 |
| hY3 | 1 | 25 | 414 | Ro RNP(核糖核蛋白)组分 |
| hY4 | 1 | 3 | 115 | Ro RNP(核糖核蛋白)组分 |
| hY5(4.5S RNA) | 1 | 1 | 9 | Ro RNP(核糖核蛋白)组分 |
| 穹窿体RNA | 3 | 3 | 1 | M_r 1.3 \times 10^4 穹窿体RNP组分 |
| 7SK | 1 | 1 | 330 | 未知 |
| H19 | 1 | 1 | 2 | 未知 |
| Xist | 1 | 1 | 0 | 起始X染色体失活 |
| 已知C/D snoRNAs | 81 | 69 | 558 | rRNA前体加工或rRNA位点特异甲基比 |
| 已知H/ACA snoRNAs | 16 | 15 | 87 | rRNA前体加工或rRNA位点特异假尿苷酸化 |
* 引自 International Human Genome Sequencing Consortium, 2001。
三、人类基因组常见的遗传变异
我们在前面介绍的都是人类基因组的共同特征,当研究者对比不同人的基因组或对比任意个人基因组与参考基因组后,他们发现人与人之间还存在多种类型的遗传变异位点,这些变异并
视频 16
人类核基因
组组成
第一类重要的遗传多态性是单核苷酸多态性(single nucleotide polymorphism, SNP), 它指的是由单个核苷酸变异所引起的 DNA 序列的多态性。我们在前面的章节中曾介绍过点突变, 它通常指的是可以导致疾病发生的单核苷酸变异, 例如珠蛋白编码基因的点突变可导致镰状细胞贫血。研究显示, 由于这类点突变对个体有害, 经过长期的自然选择, 它们在人群中的频率往往较低。因此, 我们可以用等位基因频率来简单区分有害的突变和中性的多态——如果一个基因座位上存在单核苷酸变异, 且其中任何一种核苷酸类型在群体中的频率都不小于 $1%$ , 这种单核苷酸变异就属于 SNP, 反之, 则为突变(图 14-20)。人类基因组中平均每 1200 个核苷酸中就有一个 SNP, 这意味着任意两个人之间存在 $0.1%$ 左右的序列差异。根据 dbSNP 数据库的统计, 已发现的人类基因组 SNP 已达数亿个。因此, SNP 是人类遗传多态性的重要组成部分, 这也是它被广泛用于遗传图谱绘制、连锁分析和关联分析的重要原因之一, 我们也将在后续内容中详细和读者介绍 SNP 在这些研究方法中的应用。另一方面, 尽管 SNP 数量多、分布广, 但是仅有不到 $1%$ 的 SNP 落在基因编码序列之中, 其余绝大多数基因外 SNP 的功能仍有待研究。
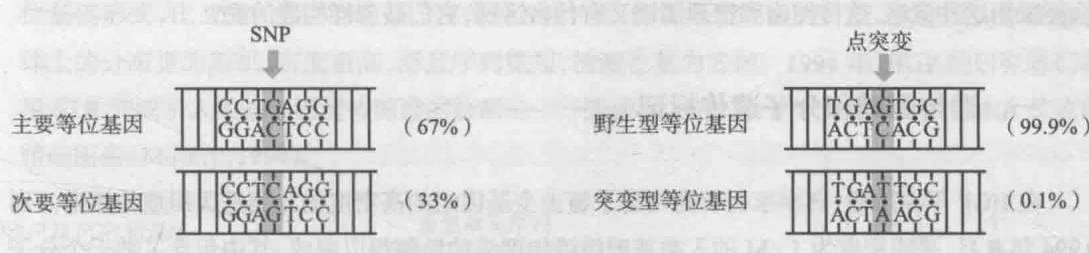
序列右侧的括号中给出了假想的等位基因频率。SNP一般只有两种不同的碱基组成,频率高的被称为主要等位基因(major allele),频率低的被称为次要等位基因(minor allele)。出现频率低于1%,且会导致疾病/性状产生的等位基因被称为突变型等位基因,频率接近100%的被称为野生型等位基因。
第二类常见的人类基因组遗传多态性是拷贝数变异(copy number variation, CNV), 它指的是长度在 100 bp 以上的基因组片段的拷贝数目的变化(相比于参考基因组), 属于亚显微水平的结构变异。根据 DGV 数据库的统计, 已发现的人类基因组 CNV 超过 55 万个(长度在 100 bp~几个 Mb), 覆盖了近 80% 的人类基因组(图 14-21)。CNV 虽然在数量上不及 SNP, 但是涉及的基
(a) CNV 示意图。(b) 人类基因组 CNV 图谱 22 条常染色体和性染色体排列成圈, 内圈的射线表示染色体该处 CNV 的密度(引自 Conrad 等, 2010)。
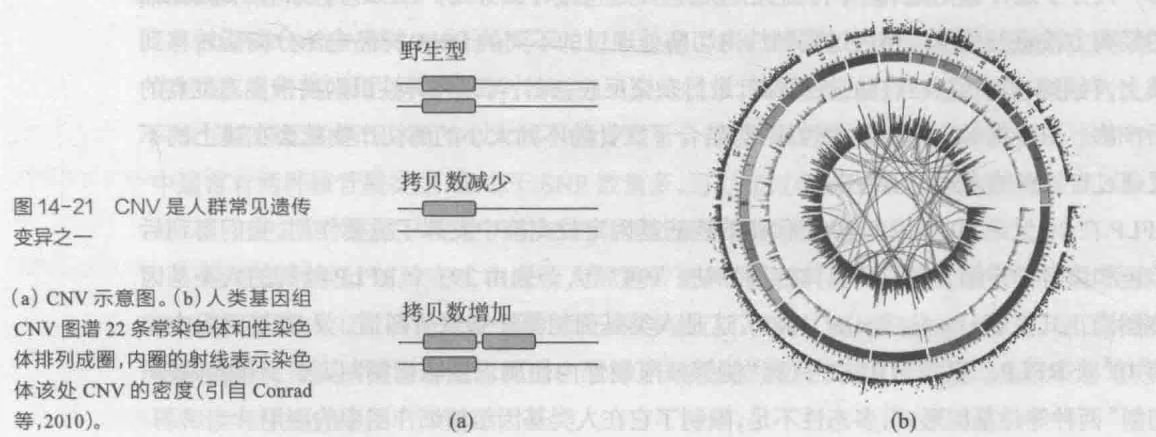
因组范围更广,且新发突变频率更高,强烈提示了它和 SNP 在人群遗传差异中同样重要的贡献。
除了以上两种,基因组中的遗传多态性还包括短插入/缺失(small-scale insertion and deletion, InDel),它指的是大小介于SNP和SNV之间的碱基插入或缺失,在基因组中也广泛分布。此外,在前面介绍的串联重复序列中,也有部分序列在人群中存在多态现象,其中的具体类型我们留到下一节再和读者们详细介绍。人类基因组中存在的大量常见的遗传变异揭示了人群差异的遗传基础,它也是当下基因组学研究的热点领域之一。
第四节 基因组作图和测序
人类基因组和小鼠基因组都非常庞大,从 HGP 执行进度表中我们看到,对这两个基因组的测序是采用先作图再测序的方法(见图 14-16)。首先完成的是遗传图谱,然后是物理图谱,再是 cDNA 的测序(因为人们对编码基因的认识要求更加迫切),最后才是基因组的序列测定。为什么要采用这种策略,遗传图谱和物理图谱又有什么区别,它们是怎样构建的呢?
一、遗传图谱和分子遗传标记
在 HGP 早期阶段,科学家们首先构建了覆盖全基因组的高密度的人类基因组遗传图谱。到 1994 年 9 月,平均密度为 1 cM 的人类基因组遗传图谱的绘制得以完成,其中包含了数千个分子遗传标记。遗传图谱之所以被放在 HGP 的首要位置,主要是基于两方面考虑,一是构建高密度遗传图谱可以为后续的序列拼装提供支架,二是覆盖全基因组的遗传图谱可以为遗传疾病的致病基因定位提供连锁分析的工具(详见遗传分析策略与方法一章)。
我们在前面的章节中已经介绍了连锁分析和遗传作图的方法。在模式动物中,我们可以采用相对性状来进行连锁分析,人为设计的杂交实验并分析不同表型后代的比例,计算基因间的遗传距离,并据此绘制遗传图谱。但是,对于人类而言,我们不能采用指定婚配的方法,可供追踪的家系的数目和大小亦非常有限。此外,多数人类性状是多基因决定的复杂性状,基于相对性状的遗传作图在人类基因组中的应用非常局限。但是,随着遗传学的发展,研究者们很快开发出了一系列新颖的分子水平的遗传标记,并顺利完成了人类基因组的遗传图谱绘制。
第一代分子遗传标记是 RFLP, 我们已经在前面进行过详细介绍。RFLP 可以利用 Southern 印迹的经典方法进行检测。将经过限制性内切酶处理过的不同的 DNA 样品电泳分离后转移到尼龙膜上, 利用和多态位点互补的核酸探针进行杂交反应, 探针可以特异性识别携带多态位点的酶切后产物。由于探针上携带放射性标记, 结合了探针的不同大小的酶切产物就会在膜上的不同位置通过自显影的方式显现出来。
RFLP 在 20 世纪 80 年代末 90 年代初的疾病基因定位克隆中发挥了重要作用, 我们留到后续章节再和读者们详细介绍它的具体应用方法。1987 年, 一张由 393 个 RFLP 绘制的人类基因组遗传图谱正式发表 (Donis-Keller, 1987), 这是人类基因组第一张遗传图谱。人类基因组中实际约有 $10^{5}$ 个 RFLP。但由于 RFLP 只有“能够被限制性内切酶识别和切割”以及“不能够被识别和切割”两种等位基因形式, 多态性不足, 限制了它在人类基因组精细作图中的应用。
第二代分子遗传标记被称为简单序列长度多态性(single sequence length polymorphism, SSLP), 这种标记实际上是一种串联重复 DNA 序列, 和我们在前面介绍过的卫星 DNA 的属性是一致的。但 SSLP 又是一类特殊的串联重复序列: 它们的单位序列的串联重复次数在人群中存在普遍差异(图 14-22a), 即不同个体在相同 SSLP 的基因座上往往携带了不同长度的等位基因形式(由于不同重复次数造成), 从而形成了遗传多态现象, 因此得名。人类基因组的遗传作图主要利用了两类 SSLP。第一类是小卫星 DNA (minisatellite DNA), 重复单位长度一般为 6~64 bp, 总长为 0.1~20 kb(均小于卫星 DNA)。小卫星 DNA 在所有染色体上都有分布, 但近端粒区域密度更高, 也被称为数目变异串联重复(variable number of tandem repeat, VNTR)。另一类 SSLP 是微卫星 DNA (microsatellite DNA), 顾名思义, 微卫星 DNA 长度更小, 它的重复单位仅为 1~4 bp, 总长通常不到 100 bp, 也被称为简单重复序列(simple tandem repeat, STR)。
SSLP 可以通过 PCR 进行检测(图 14-22b),也可以采用 Southern 印迹方法。和 RFLP 一样,SSLP 的多态性也体现在 DNA 序列的长度差异上。但 SSLP 相比 RFLP 增加了很多优点:首先,SSLP 在基因组的分布数量更大,范围和密度都有所增加;其次,SSLP 有不同重复次数的多种等位基因形式,比 RFLP 的二态性好。在两种 SSLP 中,STR 的使用更为广泛,这是因为它在染色体上的分布更为随机,密度更高,而且序列更短,检测也更为方便。1994 年,HGP 的研究者们利用 STR 完成了人类基因组遗传图谱的绘制——一张含有 3627 个 STR 和其他已知 DNA 位点的精细图谱(Murray, 1994)。
图 14-22 SSLP 及 PCR 检测结果示意图
(a) 一个假想的 SSLP 位点, 灰色方框代表该 SSLP 的基本重复单位, 3 个个体分别携带 6/8、5/7 和 7/9 个重复拷贝, 互不相同。(b) 在 SSLP 的侧翼序列上设计引物进行 PCR 扩增, 产物经电泳分离, 可以看到每个个体 PCR 产物的带形互不相同, 这是由于该 SSLP 的长度差异造成的。
(a)
(b)
我们已在人类基因组常见遗传变异中介绍过 SNP, 它在人类基因组中大约每 1200 个核苷酸中就有一个 SNP。遗传学家基于 SNP 的特征, 将 SNP 开发为第三代分子遗传标记, 由于 SNP 的数量和分布远超 SSLP 和 RFLP, 它是当下使用最广泛的分子遗传标记。
SNP 和 RFLP 和 SSLP 标记不同, 它不再是 DNA 片段的长度变化, 而是直接以序列变异作为标记。因此, 常用的 SNP 检测方法是分子杂交技术。根据多态位点邻近的核苷酸序列设计探针, 只有完全匹配的基因序列可以和探针稳定结合。尽管 SNP 通常也是二态的, 即一个 SNP 在人群中通常有两种核苷酸类型, 但由于 SNP 数量多, 可以通过单倍型组合增加多态性(图 14-23)。此外, 芯片杂交技术的成熟促进了 SNP 自动化批量检测和快速数据分析。
随着基因组计划的完成和后续人群遗传差异的研究(详见下文),目前在公共数据库中的SNP数目已达数亿。利用SNP遗传标记,科学家们不仅有了更精细的遗传图谱,更在肿瘤、衰老、糖尿病等复杂疾病的易感基因筛选中取得了一系列的成果,我们留到遗传分析策略与方法一章再和读者详细介绍。
| SNP1 | SNP2 | SNP3 | SNP4 | |||
|---|---|---|---|---|---|---|
| 个体1 | …… | TACAGGATC…… | TTCGGGCCA…… | AATCCATGC…… | AAGCTCGGA……→ | 单倍型1 GGCT |
| 个体2 | …… | TACAAGATC…… | TTCGAGCCA…… | AATCCATGC…… | AAGCTCGGA……→ | 单倍型2 AACT |
| 个体3 | …… | TACAGGATC…… | TTCGAGCCA…… | AATCTATGC…… | AAGCTCGGA……→ | 单倍型3 GATT |
| 个体4 | …… | TACAGGATC…… | TTCGAGCCA…… | AATCCATGC…… | AAGCCCGGA……→ | 单倍型4 GACC |
图14-23 单条染色体上连续多个SNP构成
的单倍型在人群中呈现出良好的多态性
二、物理图谱
在基因组计划执行期间,分子遗传标记构建的遗传图谱的应用仍然有部分局限:一方面,分子标记的数量(这一阶段主要还是 RFLP 和 SSLP)仍不足以覆盖庞大的人类基因组,另一方面,重组热点的存在影响了遗传作图的精确度,对酿酒酵母的全基因组测序后发现一些遗传标记的位置甚至出现了颠倒。因此,在遗传作图之外,需要另一种作图方式进行检验、校正和补充,即物理作图(physical mapping)。物理作图指的是采用分子生物学技术直接将 DNA 分子标记、基因或克隆标定在基因组实际位置的作图方法。与使用重组率计算距离的遗传图谱不同,物理作图反映的是目标 DNA 分子在染色体上的真实位置,用碱基对计算分子标记之间的距离。
常见的物理作图方法包括:①限制酶作图,即利用不同限制性内切酶的酶切片段的大小来计算酶切位点之间的物理距离;②克隆作图,将目的基因组(片段)随机打断后分别构建到克隆载体中,根据各克隆中外源DNA片段之间的重叠顺序构建重叠群(contig);③荧光标记原位杂交,利用荧光标记探针结合到染色体上后,相对于染色体两端的位置进行作图;④序列标签位点(sequence tagged site,STS)作图,利用不同STS标记在一条染色体的随机断裂片段中的分离频率,计算STS标记之间的相对距离(图14-24)。
其中,STS作图是最常用的一种物理作图方法。STS来源广泛,只要是一段在基因组内序列已知、位置唯一的DNA序列即可,包括上文提到的RFLP、SSLP,已知基因序列或表达序列标签,还有基因组内的一些随机小片段都可以作为STS标记。1998年,HGP完成了一幅由41664个STS标记构成的基因组物理图谱(Deloukas,1998)。
着丝粒左侧的两个 STS 标记相距较近,同时出现在全部 6 条断裂片段中,即发生分离的概率低。而着丝粒右侧的两个 STS 标记相距较远,仅在两个断裂片段中同时出现,发生分离的概率较高。
三、基因测序与测序策略
我们在前面的章节中已经介绍过桑格发明的链终止测序法(图 5-46)。传统的 Sanger 测序方法一次可以读取 500 bp 左右的 DNA 序列。随着基因组计划的推进,DNA 测序的技术也在不断革新,利用荧光探头替代肉眼读序,并利用毛细管电泳替代聚丙烯酰胺电泳后,传统测序速度得到了极大的提高,推动了 HGP 的完成。下面和读者简单介绍一下基因组的测序策略。我们先来说明一个重要概念——鸟枪法测序(shotgun sequencing):它指的是直接从单个测序反应中得到一系列短序列,然后通过检测重叠区推导出完整序列的方法。鸟枪法得名于在测序之前需要将待测的长片段 DNA 随机打断成一系列短序列,这样操作的主要原因是 Sanger 测序的一次反应通常仅能读取 500 bp 左右的遗传信息。鸟枪法测序的基本流程如图 14-25,首将目标 DNA 随机断裂为 2 kb 大小,建立克隆文库;然后进行高效、大规模的双向末端测序;再通过构建重叠群进行序列拼装;最后针对剩余未被测到的缺口(gap)进行针对性的填补。
鸟枪法测序存在一个非常重要的问题,由于断裂是随机的,不能保证待测 DNA 的各个位置都被均匀打断,而且挑选短片段进行测序也是随机的,因此理论上缺口是不可避免的。为了解决这一问题,研究者增加了测序深度 (sequencing depth)。所谓测序深度,指的是实际短片段测序得到的碱基总量与待测 DNA(基因组)大小的比值。例如,某物种基因组大小为 5 Mb,实际测得了 1 万个平均长度为 500 bp 的短片段序列信息,则测序深度为 \frac{10\ 000 \times 500}{5\ 000\ 000} = 1 ; 如果实际测得 5 万个短片段序列信息,测序深度为 \frac{50\ 000 \times 500}{5\ 000\ 000} = 5 ; 以此类推。不难想象,较低的测序深度会导致测序质量不佳,其中的原因包括:①重叠区短,拼装过程中不同重叠区之间的空缺数量多且长度长;②错误率高,一些序列只被单个测序反应测得,缺少重复来检验准确性。反之,较高的测序深度可以有效减少空缺,提高准确率。但也请读者们注意,过高的测序深度也会带来测序工作量剧增,重复测序花费大量投入但质量提升幅度有限的问题。那该如何选取合适的测序深度呢?
图 14-25 鸟枪法测序的一般步骤(a)和示意图(b)
(a)
(b)
基因组学研究者发现,通过提高测序深度降低基因组中特定碱基未被读取到的概率近似于泊松分布:
$$
P = e ^ {- m}
$$
式中, $P$ 表示基因组中某一碱基未被任何短片段测序读取到的概率, $e$ 为自然底数, $m$ 表示测序深度。根据方程,当 $m = 1, P = e^{-1} = 0.368$ 。这说明当测序深度为 1 时,待测基因组中任意一个碱基未被测到的概率约为 $36.8%$ ,这显然是实际基因组研究中不能接受的。进一步代入不同的 $m$ 可以发现,当 $m = 5, P$ 降低到了 $0.67%$ ,这是一个较为理想的概率,它意味着基因组中每个碱基未被测得的概率不到 $1%$ 。换句话说,基因组中 $99%$ 的核苷酸序列都至少被一次短片段测序反应所读到,我们也称为测序的覆盖率(coverage ratio)达到 $99%$ 。在 2001 年 HUGO 和 Celera Genomics 发布的基因组草图中,两个研究团队也正是采用了 $4 \sim 5$ 左右的测序深度,覆盖率约 $90%$ 。
了解了鸟枪法测序之后,接下来再和读者介绍详细测序策略。HUGO 制定的全基因组测序策略包括作图一测序一组装 3 个阶段(图 14-26)。首先,制作较高密度的遗传图谱和物理图谱,再进行 DNA 测序。到 1995 年,两种图谱联合使用后可以达到平均每 100 kb 一个标记,随后才开始了真正的基因组 DNA 测序阶段。第二阶段,将基因组打断成 100~200 kb 的片段后,构建到约 30 万个细菌人工染色体(bacterial artificial chromosome, BAC)克隆文库中,并且利用联合图谱将 BAC 克隆定位到基因组的确切位置上。最后阶段,分别对每个 BAC 克隆构建亚克隆,进行鸟枪法测序和拼接,最后再完成全基因组组装,缺口填补等(图 14-27)。公共测序领域的这一测序方案被称作层次鸟枪法测序(hierarchical shotgun sequencing),又称为逐个克隆法(clone-by-clone sequencing)。
图14-27 层次鸟枪法测序策略示意图(引自International Human Genome Sequencing Consortium, 2001)
另一方面,私人测序领域 Celera Genomics 采用的是全基因组鸟枪法测序 (whole-genome shotgun sequencing),即不经过 BAC 克隆群的构建,直接将全基因组随机断裂成 2 kb 的片段,构建到克隆中进行大规模的测序和拼接,再利用遗传图谱和物理图谱以及超级计算机进行计算和组装。相比层次鸟枪法,全基因组鸟枪法测序的速度更快,因为它不需要构建大量的 BAC 克隆。但是,由于人的基因组较大,且重复序列多,全基因组鸟枪法测序需要更多的测序反应和更庞大的计算量来保证测序和拼装质量。尽管 HUGO 和 Celera Genomics 采用了不同的测序策略,但两者公布的数据结果高度一致,这也很好地证明了基因组计划所获得的数据的可靠性。
在 HGP 完成之后,新的测序技术仍然层出不穷,测序速度和规模不断创新高,成为“后基因组时代”的重要技术平台。2005 年,罗氏公司开发的 454 测序系统开始商业化运行,代表了第二代测序技术 (next-generation sequencing, NGS) 的成熟。随着 Illumina 等公司大力推广和发展第二代测序技术,生命科学研究进入了高通量测序 (high-throughput sequencing) 的新时代。我们简要和读者们介绍一下第二代测序技术。Sanger 测序经过发展之后,它的基本过程仍然包括 DNA 扩增和序列读取两部分,由于这两步必须顺次完成,因此限制了 Sanger 测序效率的进一步提升。而第二代测序技术的核心是“边合成边测序”,即在 DNA 的复制过程中,在添加核苷酸(携带特定标记)的同时,就读取添加上去的碱基信息,因此,DNA 扩增和序列读取同时完成。这样的技术突破使得第二代测序表现出并行量更大、操作更简易、费用更低廉等多个优势,快速成为了流行的高通量测序手段,被广泛运用到生命科学研究的各领域。但是,第二代测序技术也具有读长短等缺点。近年来,PacBio 推出的 SMRT (single-molecule real time sequencing) 和 Nanopore 推出的 MinION 能够在单分子水平进行长片段 DNA 的测序,使得测序技术有了进一步的发展,也被称为第三代测序技术 (third-generation sequencing, TGS)。
第五节 后基因组时代
在人类基因组计划之后,迎面而来的是不断膨胀的数据量,生物学家面临着更多的问题和挑战。HGP带给了我们30亿个碱基对序列的信息,但其中仅有1.5%的编码序列,以及不容忽视的人与人之间的遗传差异。但是,30个碱基携带的具体信息是什么,尤其是98%的非编码序列在基因组中扮演怎样的角色?这些基因之间如何相互作用和通讯,指导生命体的新陈代谢?遗传差异如何造成个体差异?个性化医疗和教育是否具有理论基础和实际操作可能性?
在后基因组时代,各国科学家继续通力合作,开发了许多新技术,推动了多项新组学计划的发展。例如,功能基因组学的研究内容包括基因组的多样性和进化规律、基因组的表达及其调控、模式生物体基因组研究等,又可以分为转录组、蛋白质组等领域。而比较基因组学是通过对比模式生物的基因组结构和功能,建立新的研究技术和方法,加速人类基因组自身的研究。疾病基因组学旨在从全基因组角度分析和筛查疾病相关基因等。我们在此和读者们介绍几个代表性研究计划。
“单倍型图谱计划”(Haplotype Map Project)由国际单倍型联合会于2002年10月正式启动,2005年10月一份包括了269份不同人基因组样本的单倍型图谱发表。这一计划完成了人类基因组中900万个SNP的基因分型和图谱绘制,构建了人类DNA序列中多态位点的常见遗传模式,推动了人群遗传变异和复杂疾病遗传因素的相关研究工作。
在单倍型图谱计划的推动下,英国 Sanger 研究所、中国深圳华大基因研究院、美国国立人类基因组研究所于 2008 年又发起和承担了“千人基因组计划”(1000 Genome Project)。此计划的目标是在单倍型图谱计划的成功经验基础上,完成来自全球 27 个族群的 2500 人的全部基因组的测序;重点检测人群中的遗传变异,包括 CNV、SNP、InDel 及其他结构变异等;旨在建成开放、公共的人类基因组参照数据库,为性状、疾病的遗传分析提供详细的基因数据,为个性化医疗提供遗传信息参照,促进人类基因组研究的进一步发展。2010 年 10 月,此项目第一阶段的成果发表,通过对 179 个个体的低覆盖度测序以及其他测序工作,发现了人群中更多新的遗传变异,为后续章节我们将介绍的复杂疾病易感基因筛选提供了重要的数据参照。
2003年9月,美国国立人类基因组研究所提出了一项“DNA元件的百科全书计划”(Encyclopedia of DNA Elements Project, ENCODE Project)。这一计划旨在找出人类基因组序列中所有的结构和功能元件,形成一个完整的人类基因组的“元件目录”,计划分为示范期、技术发展期和产出期三个阶段。2007年6月,示范期的研究成果发表,研究人员按一定标准选择了占人类基因组中所有结构和功能元件序列的 $1%$ 左右的代表性DNA片段,它们分布在不同染色体上,对这些片段进行了功能注释,包括寻找和研究蛋白质编码序列、非编码序列、转录调控元件、其他调节染色体结构和动态活动的功能序列,等等。在技术发展期,ENCODE计划开发的主要研究手段包括(图14-28):利用染色质构象捕获碳拷贝(chromosome conformation capture carbon copy, 5C)、高通量染色质构象捕获(Hi-C)等技术分析存在DNA-DNA相互作用的关键位点;利用DNA酶I超敏感位点测序(DNase I hypersensitive sites sequencing, DNase-seq)、甲醛辅助分离调控元件测序(formaldehyde-assisted isolation of regulatory elements sequencing, FAIRE-seq)、染色质免疫沉淀测序(chromatin immunoprecipitation sequencing, ChIP-seq)和全基因组亚硫酸氢盐测序(whole genome bisulfite sequencing, WGBS)等进行DNA调控元件的分析,具体包括远端/邻近基因表达调控位点、DNA修饰位点和组蛋白修饰位点的鉴定;利用生物信息学预测、反转录PCR(reverse transcriptase polymerase chain reaction, RT-PCR)、RNA测序(RNA sequencing, RNA-seq)、RNA免疫沉淀结合高通量测序(RNA immunoprecipitation sequencing, RIP-seq)等进行RNA转录产物的鉴定与功能分析。篇幅所限,我们在此不能向读者们逐一介绍这些技术方法,但正是科学与技术的相互促进才有了当下基因组学日新月异的发展。
截至 2020 年 3 月, ENCODE 计划在人类基因组中鉴定到蛋白质编码基因 19957 个, 长度超过 200 nt 的 lncRNA 基因 17 952 个, 长度小于 200 nt 的小非编码 RNA (small non-coding RNA, sncRNA) 基因 7 576 个, 假基因 14 768 个, 全部转录产物共计超过 22 万种, 涉及了 80% 以上的人类基因组序列。此外, 基因组中还有数百万个转录调控蛋白结合的 DNA 位点。这些数字所描绘的基因组蓝图和研究者们在 HGP 酝酿时期的想象大相径庭, 它强烈提示了基因组的复杂性——DNA 序列参与生命活动的角色是多种多样的, 可以是蛋白质编码序列, 也可以是 RNA 编码序列, 甚至是 DNA 本身。基因组中遗传信息的存储和表达是一个多元协作、高度有序的复杂的动态过程。那么, 遗传信息表达的过程具体包括哪些基本内容, 它们又是如何发挥作用的呢? 我们将在下一章向读者们进行详细的介绍。
基因组计划改变了我们对生命世界的认识视角,推动了日新月异的生物信息与技术发展,与此同时,基因组计划留给我们更多的疑问和挑战,生命的天书等待我们去仔细阅读。
习题
请解释以下名词:割裂基因、重叠基因、基因家族、假基因、卫星 DNA、散在重复序列。
什么是分子遗传标记?常见的分子遗传标记有哪些?请举例说明它们各自的优点和缺点。
下图是一张限制性酶切作图得到的结果,请根据酶切结果将 EcoR I 和 BamH I 的酶切位点标记到这段 4.9 kb 的 DNA 上。请问结果有几种可能性?你能设计实验进行改进以得到唯一的结果吗?
人类基因组的编码基因数目不到3万,远远小于我们所预期的,比线虫略多一些,比拟南芥还少一些。你如何理解这个数值和人的复杂性之间的关系。
什么叫非编码 RNA, 人类基因组中有哪些类型的非编码 RNA? 试举例介绍它们的功能。
微卫星是常用的分子遗传标记,在人类基因组中分布广泛,且具有较高的多态性。请问: (1) 什么是微卫星,它为什么具有较高的多态性? (2) 设计至少两种基因分型的实验方法对微卫星多态进行鉴定,写出简要的实验方案。
人类基因组中有哪些类型的转座序列?请简述它们的类别和特点。
重复序列在人类基因组中的比重非常高,请从基因组结构、功能以及进化3个角度分别举例说明重复序列的功能和意义。
人类的珠蛋白基因家族含有两个基因簇, 其中, $\alpha-$ 珠蛋白基因簇位于 16 号染色体, $\beta-$ 珠蛋白基因簇位于 11 号染色体。如图 14-10 所示, 两个基因簇内均含有多个序列相似但功能有所不同的基因家族成员以及一些无功能的假基因, 请问:
(1) 什么是基因家族?人类基因组中出现多拷贝的珠蛋白基因家族有何意义?
(2) 什么是假基因?珠蛋白基因簇内的假基因与有功能的珠蛋白基因序列高度相似,但却丧失了正常基因功能,请问其中的机制?
有一段长度为 $10000\mathrm{bp}$ 的DNA序列,我们要对它进行鸟枪法测序。为了完成这个任务,先将这段DNA序列扩增后随机打断,然后对这些片段进行测序。一般需要约100个测序反应(已知每个测序反应能够完成 $500\mathrm{bp}$ 的测序)才能完成最后的测序,即实际测序得到的碱基总量与这段序列的大小的比值为5,这个比值被称为什么?为什么在实际操作中要进行如此多的测序反应,谈谈你的理解。
全基因组鸟枪法测序和层次鸟枪法测序的优劣各是什么?
写出以下几个国际性研究计划的主要研究目标和研究手段:
| 计划名称 | 主要研究目标 | 基本研究手段 |
|---|---|---|
| 人类基因组计划 | ||
| 国际单倍型图谱计划 | ||
| ENCODE 计划 |
2010年5月20日,文特尔领导的实验室向世界宣布首例人造生命诞生,这是一种完全由人造基因控制的单细胞细菌Synthia。这个人造生命的诞生显然得益于基因组研究的发展。你对基因组研究的发展方向有怎样的看法?
在基因组的发展和应用过程中, 是否也会出现一些问题, 甚至是弊端, 我们该如何对待?
数字课程学习
在线自测
习题答案
第十五章 基因表达与基因 表达调控
我们在前面已经介绍了基因的基本结构和属性、基因组的组成和特点,也介绍了基因和性状表型之间的联系。那么,储存在细胞内部的基因组是如何实现它所携带的遗传信息的呢?蛋白质(和 ncRNA)是生命活动的执行者,DNA 是如何指导蛋白质合成的?换句话说,基因表达的过程是怎样进行的?这个过程又受到怎样的严格调控,才能保证基因的时空特异性表达?
第一节 从 DNA 到蛋白质
在介绍基因表达的过程和调控机制之前,我们先简单叙述一下蛋白质编码基因的遗传信息是如何从 DNA 流向 mRNA,再体现在蛋白质分子上的,以及蛋白质分子又有哪些特殊结构和功能可以执行不同的生命活动。
一、中心法则
遗传信息的传递遵循中心法则(central dogma)的规定,中心法则把 DNA、RNA 和蛋白质的关系概括为下列 3 点:
① DNA 链中的核苷酸序列储存了生物体的遗传信息。
② DNA 复制是遗传信息从亲代向子代传递的基础。
③ 遗传信息从 DNA 通过 mRNA 传递给蛋白质是生物体实现表型的基础。具体地说,从携带遗传信息的 DNA 到体现生命活动的蛋白质需要经过两个阶段:转录(transcription)和翻译(translation)。首先,以 DNA 为模板,根据碱基互补配对原则,合成 mRNA,把 DNA 上所带的遗传信息准确传给 mRNA 的过程称为转录。转录后形成的 mRNA,在核糖体内,以 3 个核苷酸决定一个氨基酸的方式,顺序合成多肽链的过程称为翻译。
中心法则的要点是:遗传信息在亲代和子代之间的传递是由 DNA 传向 DNA, 在当代生命体中是由 DNA 传向 mRNA, 最后指导蛋白质的合成, 决定特定性状(图 15-1a)。
随着分子生物学的发展,中心法则已有了新的发展。首先,RNA 也可以通过复制实现从 RNA 到 RNA 的遗传信息传递。RNA 病毒,如脊髓灰质炎病毒、流行性感冒病毒、冠状病毒,以及大多数单链 RNA 噬菌体等,在感染宿主细胞后,它们的 RNA 都能在宿主细胞内进行复制。
图15-1 中心法则的发展
(a) 经典中心法则。(b) 中心法则的发展(引自 Wahlestedt, 2013)。
这种复制以病毒的 RNA 为模板,而不是通过 DNA。用放线菌素 D 处理宿主细胞后,以 DNA 为模板的 RNA 合成受到了显著抑制,但是 RNA 病毒的产生并未受到影响,表明这些病毒 RNA 的复制是不通过 DNA 的。其次,某些引起肿瘤的单链 RNA 病毒,如劳斯肉瘤病毒(Rous sarcoma virus, RSV)和劳舍尔小鼠白血病病毒(Rauscher mouse leukemia virus)等能以病毒 RNA 为模板,反向合成 DNA,然后以这段病毒 DNA 为模板,互补合成 RNA。这类病毒属于反转录病毒。它们的生活史我们在反转录转座一节中已经进行了详细介绍。
近年来,随着基因组学和 ncRNA 功能研究工作的深入,中心法则又有了新的修改和补充。正如我们在上一章介绍的那样,基因组中仅有 1.5% 的遗传信息从基因组 DNA 流向了蛋白质,但有 80% 以上的基因组 DNA 有转录产物,这其中除了 mRNA 外,还包括各式各样的 ncRNA。这些 ncRNA 既可以在 DNA 水平调节染色质结构和转录活性,也可以在转录和翻译水平参与调节 mRNA 的合成、加工和翻译(图 15-1b)。
鉴于生物的多样性,随着科学实验的进展,如果对中心法则还有进一步的修改和补充,那也是可以想象的。
二、性状与蛋白质
遗传分析中的性状在形式上千变万化,但本质上都与蛋白质有关。一个细胞内部含有成千上万种不同的蛋白质分子,这些蛋白质各有一定的序列和结构,在细胞内外执行不同的功能,控制一系列错综复杂的代谢变化,最后显示为各式各样的形态特征和生理性状。
蛋白质的种类很多,我们在这里介绍几类具有特定功能的蛋白质。
(1) 酶 (enzyme) 细胞每进行一项工作, 都涉及一系列错综复杂的生化反应。这些反应几乎没有一个是自发的, 反应底物只有在酶的催化作用下才能快速转换成为反应产物。不同的生化反应所需的酶不同。如果细胞内缺少了某一种酶, 相应的生化反应则不能进行。例如, 尿黑酸尿症患者的体内缺少尿黑酸氧化酶,因此不能把尿黑酸转变为乙酰乙酸,前者直接通过尿液排出来,暴露在空气中被氧化成黑色素。
(2) 转运蛋白(transport protein) 在细胞膜上和膜内有一类特殊的蛋白质,在它们的作用下,细胞能够将代谢所需的原料运入胞内特定位置,将代谢废物运至胞外。这类蛋白质被称为转运蛋白,它们负责识别和结合特定物质,帮助它们在细胞内/间运输。血红蛋白就是一种重要的转运蛋白。血红蛋白存在于脊椎动物的血液中,是氧分子的转运蛋白。当静脉血通过肺的时候,血液中的血红蛋白可以和氧气结合,成为富含氧的动脉血流入心脏,随着血液从心脏进一步流向身体其余部分,血红蛋白释放其结合的氧分子,维持各组织细胞的呼吸。当血红蛋白出现功能异常时,会导致血液的携氧能力下降,临床上表现为不同程度的贫血。
(3) 作为结构单位的蛋白质 细胞膜以及细胞内的所有细胞器(如细胞核、核糖体、线粒体、叶绿体等)的组装都离不开蛋白质分子。大量的结构蛋白质以特定方式组合配搭在一起, 形成特定的细胞器形状, 执行特定的功能。
(4) 激素(hormone) 在昆虫和高等动物中, 身体的一部分可以产生一种或多种特定蛋白质, 释放到血液中, 通过循环系统, 调节其他细胞的活动, 它们叫作激素。激素的作用具有专一性, 这与它们特定的组成和结构有关。例如男性的脑垂体前叶产生的促性腺激素(gonadotropic hormone, GSH), 它可以刺激睾丸的间质细胞, 促进睾酮(testosterone)分泌, 维持精子生成。
(5) 抗体 (antibody) 脊椎动物中, 当体内出现外来蛋白质、多糖或核酸时, 免疫器官淋巴结和脾会被诱导产生一种特定的蛋白质——抗体以抵抗外来物质的入侵。抗体具有独特的结构, 可以特异性识别外来分子。抗体是脊椎动物防御机制的重要组成部分, 可以有效防止细菌、病毒等的侵入。在患无 $\gamma-$ 球蛋白血症 ( $\gamma-$ globulinemia) 的婴儿的血浆中基本没有 $\gamma-$ 球蛋白, 因此不能形成某些抗体。在出生半年后, 随着从母体带来的抗体逐渐消失殆尽, 患病婴儿会频繁发生细菌性感染。
(6) 受体 (receptor) 受体是位于细胞膜或细胞内的大分子蛋白质, 能选择性地与相应配体 (ligand) 相结合, 激活特定的分子信号转导途径, 诱导特定的生理效应。例如有一种 X 连锁隐性遗传病——睾丸女性化综合征 (testicular feminization syndrome), 患者表现为女性体态, 但性染色体是 XY, 有睾丸发育, 也能正常分泌雄激素。进一步研究发现, 发病原因是由于患者靶组织细胞中的睾酮受体 (testosterone receptor) 异常, 对雄激素部分地或完全不敏感, 影响了睾丸成熟和精子发生, 所以尽管患者体内有正常水平的雄激素, “他” 也不具有生育能力。睾酮受体编码基因在 X 染色体长臂, 基因突变导致了疾病的发生。
从上面的例子中我们不难看出,很多遗传性状都直接或间接地与蛋白质的性质与功能有关。只有了解蛋白质的合成过程,才能更好地认识基因与遗传性状之间的关系。
三、蛋白质的结构和组成
构成蛋白质的最小单位是氨基酸(amino acid)。构成蛋白质的天然氨基酸有20种,它们有一个共通的结构:中央是碳原子,分别与一个氨基( $-NH_{2}$ ),一个羧基( $-COOH$ ),一个H原子和一个可变基团(R)相连(图15-2)。由于R基不同,不同氨基酸的结构和性质均不相同。
如图 15-3 所示, 我们可以将 20 种氨基酸分为非极性氨基酸(疏水氨基酸, 8 种)和极性氨基酸(12种)。其中,非极性氨基酸8种,包括丙氨酸(Alanine,A)、缬氨酸(Valine,V)、亮氨酸(Leucine,L)、异亮氨酸(Ileucine,I)、脯氨酸(Proline,P)、苯丙氨酸(Phenylalanine,F)、色氨酸(Tryptophan,W)和甲硫氨
图 15-2 氨基酸的结构通式
酸(Methionine, M)。极性氨基酸又可以分为极性不带电氨基酸7种,包括甘氨酸(Glycine, G)、丝氨酸(Serine, S)、苏氨酸(Threonine, T)、半胱氨酸(Cysteine, C)、酪氨酸(Tyrosine, Y)、天冬酰胺(Asparagine, N)和谷氨酰胺(Glutamine, Q);极性带正电氨基酸3种,包括组氨酸(Histidine, H)、赖氨酸(Lysine, K)和精氨酸(Arginine, R);极性带负电氨基酸两种,包括天冬氨酸(Aspartic
acid, D) 和谷氨酸 (Glutamic acid, E)。
氨基酸和氨基酸之间通过肽键(peptide bond)连接,即一个氨基酸的羧基与另一个氨基酸的氨基通过缩合反应除去一分子水,形成酰胺键。两个或两个以上的氨基酸通过肽键共价连接形成的聚合物称为肽(peptide),由两个、三个或四个氨基酸组成的肽分别被称为二肽、三肽和四肽等。构成蛋白质的肽长短不一,一般称10个以下氨基酸组成的肽为寡肽(oligopeptide),10个以上氨基酸组成的肽为多肽(polypeptide)。尽管所有蛋白质都是由20种氨基酸构成的,但是由于20种氨基酸可以以各种顺序连接起来,且每一种氨基酸在多肽链中可以重复出现,因此这些氨基酸能够构成的蛋白质的数目是惊人的。
蛋白质的结构是蛋白质的重要特征(图 15-4),我们将氨基酸在多肽链中的排列顺序称为蛋白质的一级结构(primary structure)。由于邻近氨基酸之间的相互作用(吸引或排斥),使得肽链倾向以一定方式卷曲起来,这叫作蛋白质的二级结构(secondary structure)。典型的二级结构包括α螺旋(α-helix)和β折叠(β-sheet)。二级结构之间又倾向以一定方式相互靠拢,发生进一步折叠,这叫作蛋白质的三级结构(tertiary structure),结果一条多肽链出现的形状可以是纤维状的,也可以是球状的。每一条折叠后的多肽又可和其他的相同的或不同的多肽链进一步联系起来,例如血红蛋白分子就是由4条多肽链组成的,这是蛋白质的四级结构(quaternary structure)。显而易见,蛋白质的一级结构决定了它的全部高级结构,也决定了它的物化性质和生物学活性。每一种蛋白质都有着与其他蛋白质不同的序列和结构,因此细胞内的蛋白质具备各种各样的生物学活性,可以执行不同的生物学功能。
第二节 原核生物的基因转录与翻译
为了了解从基因到蛋白质的途径,我们先以研究得较为清晰的原核生物基因表达为例进行介绍。
一、RNA 转录和 RNA 聚合酶
以 DNA 为模板转录出 mRNA 的过程需要一种依赖 DNA 的 RNA 聚合酶 (RNA polymerase)。我们以大肠杆菌为例,详细介绍这种 RNA 聚合酶如何利用 DNA 进行基因表达。大肠杆菌的 RNA 聚合酶又称全酶 (holoenzyme),包括 6 个多肽,其中 5 个多肽 ( $\alpha\alpha\beta\beta’\omega$ ) 构成核心酶 (core enzyme),第 6 个多肽是 $\sigma$ 因子 (sigma factor)。核心酶和 $\sigma$ 因子构成全酶 (图 15-5a)。
DNA 转录中, 由 RNA 聚合酶催化的 RNA 合成也是从 5’ 到 3’ 进行。作为模板的 DNA 链与合成的 RNA 链方向是相反的, 即转录时 DNA 链是从 3’ 到 5’ 读取的。RNA 聚合酶沿 DNA 双链移动时, DNA 双链被解开, 游离的核苷三磷酸通过碱基互补配对与 DNA 模板链结合, 并在相邻排列的核糖核苷酸间形成 3’, 5’-磷酸二酯键, 这样核糖核苷酸就一个接着一个连接起来 (图 15-5b)。
和 DNA 复制不同, DNA 转录不是沿 DNA 分子全长进行的, 是以包括一个或几个基因的 DNA 区段为单位进行合成的。任何一个基因转录合成时作为模板的仅是 DNA 双链中的一条,
(a)
图 15-5 大肠杆菌的 RNA 聚合酶及 mRNA 的合成
(a) 大肠杆菌中 RNA 聚合酶的结构示意图, 包括核心酶复合物和 $\sigma$ 因子。+1 代表转录起始位点。(b) RNA 聚合酶沿 DNA 双螺旋移动, 使它的螺旋解开。双链中的一条单链作为模板, 以碱基互补方式从 5’ 到 3’ 合成 mRNA, 形成一段 DNA-RNA 杂合链, 随后 mRNA 与模板 DNA 分开。RNA 和 DNA 分开后, 两条 DNA 链重新形成双螺旋, mRNA 单链被释放出来。
(b)
但原核细胞基因组 DNA 两条链都编码大量基因。因此,DNA 转录需要一种机制保证在准确的 DNA 链和区段进行 DNA 转录。
二、 $\sigma$ 因子与启动子
在大肠杆菌的 DNA 转录酶中, $\sigma$ 因子作为一个特殊的组分,负责识别待表达的基因序列,指导全酶在正确位置上进行组装,起始 DNA 转录。研究证明, $\sigma$ 因子只与转录起始有关,在 RNA 链合成了 8~9 个碱基后, $\sigma$ 因子从全酶中释放出来,参与下一个转录起始。
那么 $\sigma$ 因子是如何正确启动特定基因的转录的呢?原来 $\sigma$ 因子所识别的信息就储存在基因序列的内部,我们把这一段和转录调控识别相关的特定 DNA 区域称作启动子(promoter),它通常在基因转录起始位点的 $5’$ 上游。以大肠杆菌的 $\sigma^{70}$ 因子(相对分子质量为 7.0 \times 10^{4} 的 $\sigma$ 因子)为例,在转录起始位点之前 10 个(-10 区)和 35 个(-35 区)核苷酸的位置是 $\sigma^{70}$ 因子的关键识别位点。它们在不同的原核基因中具有高度保守的序列,-10 区被称为 Pribnow 框(Pribnow box),保守序列为 TATAAT;-35 区被称为 Sextama 框(Sextama box),保守序列为 TTGACA。-10 区和 -35 区之间的间隔碱基数目也较保守,长度均在 15~20 个核苷酸对。此外,启动子其他一些位置上的核苷酸也具有一定的保守性(图 15-6)。
| 上游元件 | -35区 | 间隔 | -10区 | 间隔 | RNA转录区 | ||
| 保守序列 | +1 | ||||||
| NNAAAATT-T | AA-T | TTTTTNNAAAAANNN | N | TTGACA | $N_{17}$ | TATAAT | |
图 15-6 大肠杆菌 $\sigma^{70}$ 因子识别的保守序列
转录起始位点标记为+1,N表示任意核苷酸。
大肠杆菌中仅有一种 RNA 聚合酶,但是有多种不同的 $\sigma$ 因子(表 15-1),它们负责在不同环境条件下控制不同基因的表达,是大肠杆菌基因表达调控的重要手段。这些 $\sigma$ 因子在特定环境的刺激下,识别特定的启动子序列,启动不同基因的转录表达。其他原核生物中,也有多种 $\sigma$ 因子调控不同生活环境或生命周期中基因表达的现象。
表 15-1 大肠杆菌不同 $\sigma$ 因子的功能
| 因子名称 | 基因名称 | 功能 |
|---|---|---|
| $\sigma^{70}$ | RpoD | 负责在一般条件下绝大多数基因的转录 |
| $\sigma^{54}$ | RpoN | 环境中缺乏氮源时负责基因转录 |
| $\sigma^{38}$ | RpoS | 大肠杆菌生长平台期或饥饿条件下负责基因转录 |
| $\sigma^{32}$ | RpoH | 热休克因子,在热激条件下负责基因转录 |
| $\sigma^{28}$ | RpoF | 鞭毛 $\sigma$ 因子 |
| $\sigma^{24}$ | RpoE | 周质空间的热压力 $\sigma$ 因子 |
| $\sigma^{19}$ | FecI | 柠檬酸铁 $\sigma$ 因子,负责离子运输中 $fec$ 基因的转录 |
三、转录终止
当 RNA 合成开始后, $\sigma$ 因子被释放, RNA 链的延伸由核心酶催化。当 RNA 转录到终止子 (terminator), 合成停止。这个终止子具备两个结构特征(图 15-7): 一是包含一段富含 GC 的序列, 相应的 RNA 转录产物会在内部发生配对, 形成发夹结构(hairpin), 阻碍 RNA 聚合酶在 DNA 模板上的前进; 二是在 GC 序列下游有串联排列的 AT 碱基对, 在 mRNA 链上对应一串 U。由于 AU 对之间的结合力较弱, 所以利于 RNA 分子从模板链上解离下来。
可见转录产物内部配对形成的发夹结构以及其下游的串联 AU 碱基对。
四、信使RNA与密码子
在转录中,DNA 的一条链作为模板合成了一条 RNA 链,这条 RNA 链被称为基因的初级转录物。在翻译中,在核糖体中被当作模板翻译出相应多肽链的 RNA 分子被称为信使 RNA (messenger RNA,mRNA),因为它能够准确传达 DNA 上的遗传信息。在原核细胞中,初级转录物就是 mRNA。但是,在真核生物中,初级转录物只是 mRNA 的前体(precursor mRNA,pre-mRNA),必须经过特定的加工和修饰才能成为成熟的 mRNA 进行翻译。真核细胞基因转录物的加工过程我们会在下一节进行详细介绍。
由于 mRNA 是由 DNA 的一条链转录的, 所以 mRNA 与这条 DNA 链的碱基完全顺序互补, 而跟双链中的另一条 DNA 链完全相同, 只不过 DNA 中的胸腺嘧啶在 RNA 中被替换为尿嘧啶。我们把作为 mRNA 模板的这条 DNA 链称作模板链(template strand), 它与 mRNA 互补。mRNA 链也被称作有义链(sense strand), 与 mRNA 互补的 RNA 链则被称作反义 RNA (antisense RNA)。反义 RNA 可以和 mRNA 配对, 从而抑制 mRNA 的翻译。由于反义 RNA 的这一特殊调控作用, 反义 RNA 技术已经广泛应用于分子生物学实验。
由于模板 DNA 链的核苷酸序列与 mRNA 的核苷酸序列是互补的, 所以 DNA 所储存的遗传信息可以正确无误地传递给 mRNA。但是 RNA 只有 4 种不同的碱基, 而氨基酸有 20 种, 生物该如何将 4 种 RNA 的遗传信息翻译成 20 种氨基酸呢? 1966 年, 尼伦伯格等人发现, mRNA 的 3 个碱基可以决定一个氨基酸, 即 RNA 上的三联体 (triplet) 核苷酸组成一个密码子 (codon), 负责编码不同的氨基酸。如图 15-8 所示, 三联体核苷酸的各种可能组合数有 $4^{3} = 64$ 个, 而氨基酸只有 20 种, 所以一种氨基酸对应的密码子不只 1 种。除了甲硫氨酸 (AUG) 和色氨酸 (UGG) 只有 1 种密码子外, 大多数氨基酸都有两种以上的密码子, 如天冬氨酸和天冬酰胺各有两种密码子, 而精氨酸和亮氨酸各有 6 种密码子。一种氨基酸有两种以上的密码子的情况, 叫作兼并 (degeneracy)。mRNA 序列从起始密码子 (start codon) AUG (或 GUG) 开始合成氨基酸, 但合成起始后, 多肽链的第一个氨基酸可以是任意一种氨基酸。位于 mRNA 内部的 AUG 被翻译为甲硫氨酸。UAA、UAG 和 UGA 3 个密码子属于无义密码子 (nonsense codon), 即这些密码子没有相对应的氨基酸, 遇到这些密码子时肽链合成停止, 蛋白质合成终止。
第二位字母
| U | C | A | G | ||
|---|---|---|---|---|---|
| U | UUUUUCUUAUG | UCUUCCUCAUCG | UAUUACUAA UAG | UGUUGCUGA UGG | UCAG |
| C | CUUCUCCUACUG | CCUCCCCCACCG | CAUCACCAA CAG | CGUCGCCGA CGG | UCAG |
| A | AUUAUC AUA AUG | ACUACCACAACG | AAUAACAAAAAG | AGUAGCAGA AGG | UCAG |
| G | GUUGUC GUA GUG | GCU GCCGCA GCG | GAUGACGAA GAG | GGUGGCGGA GGG | UCAG |
图15-8 密码子表
遗传密码在生物界中几乎是普遍通用的。如将兔的血红蛋白的 mRNA 加到大肠杆菌的酶和其他必要因素中,也可以得到兔的血红蛋白。又如兔乳头瘤病毒中含有合成精氨酸酶的基因,将这种病毒注射到人体中,可以促进精氨酸酶的合成,从而有可能用来治疗由于缺失精氨酸酶引起的高精氨酸血症(hyperargininemia)。但是,真核生物和原核生物在密码子使用上稍有不同,例如真核生物几乎均采用 AUG 作为起始密码子,但原核生物的起始密码子还可以是 GUG 和 UUG。此外,核外 DNA(包括叶绿体 DNA 和线粒体 DNA)的密码子使用也和核基因组有所不同,不同生物核外 DNA 的密码子也不完全相同。这些事实很好地证明了生命世界的同一性和多样性是并存的。
五、转运RNA与反密码子
在 mRNA 翻译成多肽链的过程中, 核糖体从 mRNA 的 5’ 端向 3’ 端移动, 在转运 RNA (transfer
RNA, tRNA) 的作用下, 认读 mRNA 上的密码子, 选择相应的氨基酸, 并将其添加到延长中的肽链中 (图 15-9)。
核糖体以 mRNA 分子为蓝图, 利用 tRNA 把蛋白质的原料——20 种氨基酸一个个地排列起来。tRNA 也是单链 RNA 分子, 只有 73~90 个核苷酸长。除了 4 种普通碱基 (A、U、C 和 G) 以外, tRNA 中还含有相当数目的稀有碱基, 它们是经过特定酶的加工后形成的。
每种氨基酸各有一种或一种以上的 tRNA。现在已知的 tRNA 种类在 60 种以上, 每一种生物的 tRNA 至少在 40 种以上, 原核生物的 tRNA 和真核生物的 tRNA 结构相似。tRNA 分子有稳定的二级结构, 即三叶草结构 (clover-leaf structure), 其中包括 4 个重要组成部分 (图 15-10), 它们的名称和功能如下:
(1) 反密码子环 环中有3个碱基形成反密码子(anticodon)。在核糖体上进行蛋白质合成时, 反密码子与mRNA上相应的三联体密码子配对。例如, 在苯丙氨酸 tRNA (tRNA $^{Phe}$ ) 中, 苯丙氨酸的密码子是5’-UUC-3’(5’端是密码子的第一位, 3’端是第三位), 而 tRNA $^{Phe}$ 中的反密码子是3’-AAG-5’, 符合碱基配对关系。
(2) 氨基酸臂 所有 tRNA 的 3’ 端都以 CCA-OH 结尾。这 3 个核苷酸并非由模板 DNA 转录而来, 而是在特殊酶的作用下添加到 tRNA 中的。3’ 端 A 残基上的羟基可以在酶催化下与氨基酸形成酯键, 这样氨基酸可以接在 tRNA 的 3’ 端, 这也是氨基酸臂的得名原因。
(3) 双氢尿苷环 因为环内含有双氢尿嘧啶核苷或双氢尿苷而得名。此环与识别特定氨酰-tRNA合成酶(见下文)有关。
(4) TψC 环 因环内含有假尿嘧啶核苷(ψ)而得名。此环可能参与 tRNA 与核糖体的结合。
图15-9 多肽的合成
图 15-10 酿酒酵母丙氨酸 tRNA 分子的核苷酸顺序图(a)及其结构示意图(b)
在 tRNA 分子的环间或臂内存在许多 G-C 碱基对,使得 tRNA 分子能以发夹方式折叠起来。此外,某些 tRNA 还有一额外环含有 2~13 个不配对碱基,位于反密码子环和 TψC 环之间,作用不明。
由于 tRNA 的反密码子按一定规则与 mRNA 密码子相配对, 因此 tRNA 能够把特定密码子转译为特定的氨基酸。但是, 在同一氨基酸配对的 tRNA 中, 反密码子可以是不同的。例如丝氨酸的 tRNA I 型的反密码子是 3’-AGU-5’, III 型的反密码子是 3’-UCG-5’, 因此前者与 5’-UCA-3’ 配对, 后者与 5’-AGC-3’ 配对, 从密码子表可以知道这些密码子都是控制丝氨酸合成的。因此, 通过 tRNA 的媒介, 完全不同的密码子可以编码同一氨基酸。此外, 相同的反密码子可以识别不同的密码子, 例如丝氨酸的 tRNA I 型的反密码子是 3’-AGU-5’, 它不仅与密码子 UCA 配对, 而且也与 UCU、UCC 和 UCG 配对, III 型的反密码子是 3’-UCG-5’, 除与密码子 AGC 配对外, 也与 AGU 配对, 这样通过两种 tRNA 可以把 6 种不同的密码子都翻译为丝氨酸。克里克认识到这种情况后于 1966 年提出了“摆动假说”(wobble hypothesis), 认为 tRNA 反密码子的 5’ 端碱基并不一定与密码子的 3’ 端碱基严格互补, 而是可以摆动的, 具体的配对情况见表 15-2。
表 15-2 反密码子 / 密码子配对的摆动原则
| 反密码子5'端碱基 | 密码子3'端碱基 |
|---|---|
| U | A或G |
| C | G |
| A | U |
| G | C或U |
| I* | A、C或U |
$^{*}$ I 代表肌苷 (inosine), 常出现在反密码子 5’ 端, 是脱氨的腺嘌呤衍生物。
tRNA 要把氨基酸转运到核糖体并添加到合成的肽链中, 必须与相应的氨基酸分子结合, 形成氨酰 tRNA (aminoacyl-tRNA), 这个结合是在一组叫作氨酰 tRNA 合成酶 (aminoacyl-tRNA synthetase) 的催化下进行的。不同的氨基酸和它相应的 tRNA 的结合是由不同的酶来催化的, 所以有多少种氨基酸, 就有多少种氨酰 tRNA 合成酶。
氨酰 tRNA 的合成分两步。第一步, 氨基酸分子的羧基(—COOH)首先与 ATP 反应, 形成氨酰 AMP 和焦磷酸, 这样氨基酸被激活了。第二步, 氨酰 AMP 和相应的 tRNA 的 3’ 端的腺苷基 (adenyl residue) 反应, 形成氨酰 tRNA 和 AMP。这样, 氨基酸就由一个高能键与它相应的 tRNA 共价连接起来(图 15-11)。
六、核糖体与核糖体 RNA
核糖体是蛋白质合成的场所,核糖体内含有多种核糖体 RNA (ribosomal RNA, rRNA),它们和核糖体蛋白质一起组成核糖体,参与蛋白质的合成。核糖体 RNA 是细胞内丰度最高的 RNA 分子,大肠杆菌的 rRNA 占细胞中 RNA 总量的 82%~83%。在核糖体中,rRNA 占 37%,其余部分是蛋白质。在电镜下观察,核糖体呈微小的悬滴状,直径大约是 20 nm。每一核糖体由大、小两亚基组成。原核细胞的核糖体的大亚基有一个 5S rRNA 分子与一个 23S rRNA 分子,还含有大约 31 种核糖体蛋白质,而小亚基含有一个 16S rRNA 分子和大约 21 种蛋白质(图 15-12a)。而真核细胞的核糖体的大亚基含有 5.8S、5S 和 28S 3 种 rRNA 分子,小亚基仅具有一个 18S rRNA 分子,大、小亚基还结合有多种核糖体蛋白质(图 15-12b)。
(a) 原核生物细胞核糖体。(b) 真核生物细胞核糖体。核糖体由大亚基和小亚基组成。每一亚基都含有特定的 rRNA 和一定数目与种类的蛋白质。
在蛋白质合成时,核糖体沿 mRNA 链运行,方向是从 5’ 到 3’。核糖体运行时,氨基酸相继地加到延长中的多肽链上。换句话说,核糖体逐个认读 mRNA 上的遗传密码,选择相应的氨基酸,加到延长的肽链中。合成完成后,核糖体从 mRNA 链上解离,进入下一次循环再利用。事实上,多肽链合成时,一条 mRNA 链上并不是只有一个核糖体,而是若干核糖体先后结合到 mRNA 链上,同时翻译 mRNA。若干核糖体由一个 mRNA 分子串在一起,称为多核糖体(polyribosomes)或多体(polysomes)(图 15-13)。
(a) 原核生物细胞核糖体。
(b) 真核生物细胞核糖体。核糖体由大亚基和小亚基组成。每一亚基都含有特定的 rRNA 和一定数目与种类的蛋白质。
(a) 多核糖体示意图。(b) 大肠杆菌中一条正在翻译中的 mRNA 链的电镜照片, mRNA 表面结合了大量核糖体, 形成了多核糖体。
图15-13 多核糖体
七、蛋白质的生物合成
蛋白质合成是一个极其复杂而又十分协调的连续过程,需要氨基酸、mRNA、tRNA 和核糖体等多个组分互相协调才能产生特定的多肽。我们以原核细胞为例,简单介绍这一生物学过程的
基本步骤,不同生物的蛋白质合成过程基本相似。
大肠杆菌的蛋白质翻译起始需要核糖体、特异性起始 tRNA、mRNA 以及 3 个翻译起始因子 (initiation factor, IF) ——IF-1、IF-2 和 IF-3 (图 15-14)。首先,IF-3、mRNA 和 30S 核糖体亚基形成复合物。30S 核糖体亚基与 mRNA 的结合依赖于 mRNA 链中特有的 Shine-Dalgarno 序列,它是原核生物 mRNA 中的一段富含嘌呤的保守序列,多为 AGGAGG,位于起始密码子上游约 7 个核苷酸处,能够同 16S rRNA 3’ 端的序列互补结合。随后,IF-2 和特异性识别起始密码子的甲酰甲硫氨酰 tRNA (fMet-tRNA $^{fMet}$ , f 表示甲硫氨酸的氨基被甲酰化,只有 fMet-tRNA $^{fMet}$ 能和 IF-2 结合,而不被甲酰化的甲硫氨酰 tRNA 能够在肽链延伸中添加甲硫氨酸) 形成复合物。接着,甲酰甲硫氨酰 tRNA 与 mRNA 的起始密码子结合,两个复合物连同 IF-1 以及 GTP 分子共同构成 30S 起始复合物。最后,利用 GTP 分子水解释放的能量,50S 核糖体亚基结合到复合物中,起始因子被释放,形成完整的 70S 核糖体。
根据上述的合成程序,多肽的第一个氨基酸应该是甲酰甲硫氨酸,可实际上在蛋白质中没有甲酰甲硫氨酸,原来蛋白质合成虽然从甲酰甲硫氨酸开始,但在合成蛋白质过程中或合成以后,甲酰基或者甲酰甲硫氨酸会被分解,或者前端几个氨基酸都会被分解,所以一般多肽氨基端的第一个氨基酸可以是甲硫氨酸,也可以是其他氨基酸。
完整的核糖体有3个tRNA结合位点(图15-15)。一个叫作氨酰位(aminoacyl site, “A”), 是进入核糖体的tRNA结合的地方。在“A”位置上,tRNA的反密码子可以跟30S亚基上的mRNA密码子配对,而tRNA所带的氨基酸可以在50S亚基上形成肽键。另一位置叫作肽酰位(peptidyl site, “P”),当tRNA分子所携带的氨基酸形成肽键后,该tRNA就从A位移动到P位。还有一个位点叫作出口位(exit site, “E”),这个位置在P位的另一侧,是无氨基酸负载的tRNA结合的位置。
蛋白质翻译起始后的延伸过程,每个氨基酸通过3个步骤加入到延伸中的肽链中(图15-16):①带
其中,EF-G 是延伸因子 G,它参与了 tRNA 从 A 位到 P 位、从 P 位到 E 位、核糖体向 mRNA 3’ 端移动 3 个核苷酸的位移步骤,这个过程同样还需要 GTP 分子水解供能。
有某一氨基酸的 tRNA 分子首先进入 70S 核糖体的 A 位;②在肽基转移酶(peptidyl transferase)的作用下,该 tRNA 所带的氨基酸跟 P 位上 tRNA 所带的氨基酸形成肽键;③核糖体沿着 mRNA 移动,下一个密码子进入 A 位,而原先位于 P 和 A 位的 tRNA 分别转移到 E 和 P 位。在翻译延伸的过程中,tRNA 结合到 A 位,肽键形成,tRNA 的移位等都需要有若干延伸因子(elongation factor, EF)的协助以及 GTP 作为能源。
当翻译过程进行到终止密码子——UAA、UAG或UGA时,没有tRNA具有和这3个密码子相对应的反密码子,肽链的延伸终止。事实上,终止密码子可以被释放因子(release factor, RF)识别,产生3种效应:多肽链与P位置上的tRNA分子分开;tRNA分子从核糖体释放;核糖体解离为两个亚基,进入下一轮合成。
核糖体的结构极为复杂,蛋白质合成中的更多机制更有待于深入研究。但是蛋白质生物合成中的信息转移、编码、翻译过程等在研究过的生物中大致都是相同的。这也是科学家利用转基因技术成功改造宿主细胞的重要理论前提。例如,来自土壤微生物苏云金杆菌(Bacillus thuringiensis)的Bt基因可以编码一种Bt蛋白,特异性消灭鳞翅目昆虫。将Bt基因通过基因工程技术导入玉米中获得的转基因玉米同样可以自主合成Bt蛋白,有效抵御虫害,提高了玉米产量。显然,翻译装置的机能在不同门类的生物中是高度相似或相同的。这种相似或相同也反映了它们在地球上的共同起源。
第三节 原核生物的基因表达调控
生物的环境经常变动,自然选择有利于适应性强的生物的生存和繁衍。基因表达的调控能使生物在利用自然资源和应付生活环境方面有很大的灵活性,从而使生物可以更好地保存自己,繁衍种群。原核生物也有很强的环境适应能力,当环境发生改变时,它们可以通过改变不同类群的基因表达来应对环境的变化。
原核生物基因表达的调控主要体现在转录水平,有正、负两种调控形式。负调控下,阻遏物(repressor)与DNA结合,转录被抑制;阻遏物缺乏时,转录开启。正调控时,诱导物(inducer)与DNA结合,促进转录;诱导物缺乏时,转录中断。基因不同,环境因素不同,调控的具体方式也不同。
一、操纵子模型
法国分子生物学家雅各布和莫诺于 1961 提出的操纵子学说 (operon theory) 说明了大肠杆菌在环境因素的调控下, 如何在转录水平改变结构基因的表达。
他们提出,根据基因在决定蛋白质合成中的不同作用,可以将基因分为两大类:①结构基因(structural gene),它们决定蛋白质的氨基酸顺序;②调节基因(regulator gene),它们控制在某一细胞的内环境下合成特定蛋白质的速率。他们又认为,与某一代谢途径密切相关的多个蛋白质的结构基因常常位于染色体的邻接位置上。这些基因能否被转录是由位于邻接于结构基因一端的操纵基因(operator)的状态而定。包括结构基因、操纵基因以及结构基因的启动子在内的整个连续的DNA结构单元称为操纵子(operon)(图15-17)。此外,操纵基因的状态由调节基因的产物——阻遏物 / 诱导物控制, 这些基因产物通过识别和结合操纵基因动态调控结构基因的转录活性。
二、大肠杆菌乳糖操纵子
大肠杆菌能利用乳糖作为唯一碳源,乳糖能够进入细菌细胞,并能被分解为葡萄糖和半乳糖。能够执行这些功能的酶是由乳糖操纵子(lactose operon)中的3个结构基因(lac Z, lac Y, lac A)编码的:lac Z编码β-半乳糖苷酶(β-galactosidase),催化乳糖水解为葡萄糖和半乳糖;lac Y编码β-半乳糖苷透性酶(β-galactoside permease),这是一种膜结合蛋白,促进乳糖进入细胞,加速乳糖的利用率;lac A编码β-半乳糖苷乙酰基转移酶(β-galactoside transacetylase),能够将乙酰基转移到β-半乳糖苷上,功能暂时还存在争议。大肠杆菌虽然能利用乳糖,但它们只在培养基中缺乏其他碳源且有乳糖存在的条件下才转录这3种酶进行乳糖代谢。培养基中的乳糖发挥了诱导物的作用,这些在诱导物作用下产生的酶也被称为诱导酶。下面介绍大肠杆菌是如何利用乳糖操纵子产生诱导酶的。
乳糖操纵子的调节基因(lac I)编码一个360个氨基酸的多肽,4条多肽形成一个有活性的四聚体阻遏蛋白,能够结合到操纵基因(lac O)上,发挥抑制活性。培养基中没有乳糖时,阻遏蛋白与操纵基因结合,阻断RNA聚合酶在基因上的移动,无法转录下游的结构基因(图15-18a)。当培养基有乳糖且为唯一碳源时,乳糖进入细胞后的代谢产物异乳糖能够与阻遏蛋白结合,发挥
(b)
(a) 无诱导物, 阻遏蛋白结合操纵基因, 抑制RNA转录。(b) 诱导物结合到阻遏蛋白上, 阻遏蛋白无法继续和操纵基因结合, RNA转录开启。
诱导物的作用,使阻遏蛋白的构型改变,失去与操纵基因结合的能力,RNA聚合酶能够从启动子向下游移动,开始结构基因的转录。大肠杆菌的转录和翻译是耦联的,结构基因产物随即作用于乳糖,促进乳糖的代谢(图15-18b)。当环境中的乳糖被分解完后,阻遏蛋白又能继续发挥作用,抑制操纵基因,关闭结构基因的转录。
三、大肠杆菌色氨酸操纵子
大肠杆菌的乳糖操纵子属于诱导操纵子,即单独的阻遏物有活性,直接结合并抑制操纵子的转录。大肠杆菌的色氨酸操纵子控制色氨酸合成酶的转录,属于抑制操纵子,即单独的阻遏物没有活性,只有与共抑制物结合,才形成有活性的复合物,抑制操纵基因。实验发现,当环境中存在大量色氨酸时,该操纵子控制的基因表达被关闭,而当环境中的色氨酸缺乏时,基因表达可重新开启。色氨酸操纵子的结构如图15-19所示,操纵基因trp O位于启动子trp P的内部,下游是5个色氨酸生物合成途径所需酶的编码基因,分别是trp E, trp D, trp C, trp B和trp A。缺乏色氨酸时,调节基因(trp R)编码的阻遏蛋白没有活性,不能与trp O结合,RNA聚合酶结合到trp P上起始基因转录,为合成色氨酸做准备(图15-19a)。环境中存在色氨酸时,色氨酸分子与trp R编码的阻遏蛋白结合,成为有活性的阻遏物,结合到trp O上抑制RNA聚合酶转录起始(图15-19b)。
(b)
图15-19 色氨酸操纵子模型
(a) 色氨酸不存在时, 阻遏蛋白无活性, 操纵子开启。(b) 存在色氨酸时, 阻遏蛋白与之结合后结合到操纵基因上, 关闭操纵子。
视频17操纵子与代谢抑制
四、大肠杆菌代谢抑制
再和读者介绍另一个有趣且重要的现象,如果在培养基中同时加入葡萄糖和乳糖两种碳源,大肠杆菌将优先利用葡萄糖而非乳糖。只有当葡萄糖耗尽时,大肠杆菌才会开启乳糖操纵子,促进乳糖代谢相关酶的合成。微生物遗传学家发现,葡萄糖能够抑制乳糖操纵子及代谢其他碳源的操纵子,这一现象被称为代谢抑制(catabolite repression)。宏观上讲,这是生物适应性的一种表现,因为葡萄糖是更高效的能量来源。但在微观的分子机制上,该如何解释呢?
研究发现,乳糖操纵子中的启动子上有两个蛋白质结合位点:一个是RNA聚合酶的结合位点(lac P);另一个是CAP-cAMP,即降解物激活蛋白(catabolite activator protein,CAP)和环腺苷酸(cyclic AMP,cAMP)构成的复合物的结合位点(lac C),而CAP-cAMP与启动子的结合又是RNA聚合酶开启乳糖操纵子中结构基因转录所必需的(图15-20)。
视频18乳糖操纵子遗传分析
葡萄糖的代谢产物能够对细胞中的 cAMP 产生很大影响。当葡萄糖浓度高时,细胞内 cAMP 含量降低;葡萄糖浓度低时,细胞内 cAMP 含量升高。当培养基中不含葡萄糖时,cAMP 浓度增加,并能够与细胞内的 CAP 形成复合体。CAP 是一个二聚体,每一亚基含有 209 个氨基酸残基。当细胞内葡萄糖含量低时,高水平的 cAMP 与 CAP 形成的复合体可特异地结合到乳糖操纵子的启动子上,促进 RNA 聚合酶与启动子的结合,开启转录。当培养基中同时含有乳糖和葡萄糖时,细胞内的 cAMP 水平降低,CAP 不能结合启动子,RNA 聚合酶无法起始转录。
因此,在大肠杆菌乳糖代谢这个例子中,除了阻遏物和操纵子的负调控外,还有 CAP-cAMP 的正调控,两者共同调节乳糖代谢基因的转录表达,使得大肠杆菌更好地适应环境变化。
虚框部分是一个不完美的回文序列, 黑点是回文序列的中心, 位CAP-cAMP 结合位点中。以转录起始位点为 +1, 底部数字标示了苷酸的位置。
五、大肠杆菌色氨酸衰减作用
在大肠杆菌色氨酸调节基因 trp R 缺失突变体中, 色氨酸存在时色氨酸操纵子的转录水平是没有色氨酸时的 1/10。这一现象提示, 除了阻遏蛋白对操纵子的负调控之外, 还有另一种调控作用可以根据环境中色氨酸水平调节色氨酸的合成速率。研究者发现, 这种抑制作用就是衰减作用 (attenuation), 执行这一调控作用的基因序列被称为衰减子 (attenuator)。在色氨酸操纵子第一个结构基因 trp E 的上游、启动子的下游有一段 162 bp 的调控序列, 编码色氨酸 mRNA 的引导序列 (leader sequence), 被称为 trp L 调节区 (图 15-21a), 能够控制色氨酸操纵子的衰减调控。
色氨酸衰减子位于 trp L 的 114~141 位, 它与前文所述的原核生物基因的转录终止子基本相同,在一段富含 G/C 的回文序列下游连接了一串 A/U 碱基对。G/C 区的 mRNA 产物倾向于形成发夹结构,可诱导结合其上的 RNA 聚合酶的构型改变,在下游的 A/U 位置终止转录,下游色氨酸操纵子结构基因的转录也就随之提前终止。接下来介绍衰减作用如何响应外界环境变化。
(a) trp L 的序列特征。(b) 色氨酸存在和不存在时 trp L 转录产物的二级结构。
首先,trp L 内部总共存在 4 段可以通过碱基配对形成发夹结构的碱基序列,分别位于 60~70(1 区)、75~85(2 区)、110~121(3 区)、126~134(4 区)区段。这 4 段序列可以有两种配对选择:①1区和2区,3区和4区分别配对;②2区和3区配对,1区和4区保持单链。事实上,3区和4区就是衰减子的回文序列,因此当它们配对时,转录提前终止。
其次,在 trp L 的 27~71 位还含有一个 14 肽的编码序列,内部有两个连续的色氨酸密码子,它的下游就是 1 区序列。在缺乏色氨酸时,Trp-tRNA $^{trp}$ 不足,核糖体停止在 mRNA 链上,占据了 1 区位置,2 区和 3 区配对,无转录终止信号,转录继续进行(图 15-21b,左图)。而在色氨酸存在条件下,Trp-tRNA $^{trp}$ 也丰富,翻译能够顺利进行,核糖体不会占据 1 区位置,1 区和 2 区、3 区和 4 区能够配对,形成终止信号,中断下游结构基因的转录(图 15-21b,右图)。需要说明的是,原核生物基因的转录和翻译是耦联的,即在转录的同时翻译也在进行,这同样是衰减作用得以实现的前提。
衰减作用并不仅仅出现在色氨酸的转录调控中,其他操纵子(苯丙氨酸、苏氨酸、亮氨酸、异亮氨酸、组氨酸)的转录也涉及了衰减作用的调控。它们的结构基因上游通常也存在一段引导序列,编码一条短肽,内部含有连续的编码氨基酸的密码子,比如苯丙氨酸和组氨酸合成基因的引导序列中分别含有7个连续的苯丙氨酸、组氨酸密码子。衰减作用的调控比阻遏物/诱导物-操纵基因的调控更为精细,在原核生物中,两者往往协同作用,共同调节基因表达。
第四节 真核生物的基因转录与翻译
了解了原核生物的基因转录过程与调控方式,我们接下来介绍较为复杂的真核生物的基因转录与翻译的一些特点。
一、基因转录起始
大肠杆菌中只有一种 RNA 聚合酶催化基因转录。但在高等真核生物中,不同类型的 RNA 是由不同 RNA 聚合酶催化转录的。真核细胞含有多种不同的 RNA 聚合酶,除了线粒体和叶绿体内含有细胞器特异性 RNA 聚合酶外,细胞核内的其他 3 种 RNA 聚合酶也各有分工(表 15-3)。其中,RNA 聚合酶 II(RNA polymerase II,RNAP II)负责全部蛋白质编码基因的转录。真核生物的 RNA 聚合酶 II 与原核生物的 RNA 聚合酶同源性很高,由 12 个亚基(RNA polymerase II subunits,RPB1~RPB12)组成(图 15-22)。
表 15-3 真核细胞核内的 3 种 RNA 聚合酶
| RNA 聚合酶 | 转录基因 |
|---|---|
| RNA 聚合酶I | 5.8S、18S、28S rRNA 基因 |
| RNA 聚合酶II | 所有蛋白质的编码基因、小核仁 RNA 基因、部分小核 RNA 基因、微小 RNA、小干扰 RNA |
| RNA 聚合酶III | tRNA 基因、5S rRNA 基因、部分小核 RNA 基因、其他小 RNA 编码基因 |
RNA 聚合酶Ⅱ与基因的启动子序列结合。真核生物基因的启动子也具有高度的保守性
(图 15-23), 大多数蛋白编码基因的启动子的 -30 区含有 TATA 框(TATA box)。其他保守元件还包括: 位于 -35 区的 BRE(TF II B recognition element)、位于转录起始位点的 INR(initiator) 和位于 +30 区的 DPE(downstream promoter element)。真核 RNA 聚合酶 II 识别的启动子一般至少含有两种上述 DNA 元件。
| -35-30 | +30 | |
| BRETATA | INR | DPE |
| 启动子元件 | 保守序列 | 相结合的普遍转录因子 |
| BRE | G/CG/C G/AC G CC | TF IIB |
| TATA | TATAA/T AAT | TBP |
| INR | C/T C/T A N T/A C/T C/T | TFIID |
| DPE | A/G G A/T C G T G | TFIID |
图 15-23 真核生物基因启动子保守元件的位置及序列特征
尽管真核生物 RNA 聚合酶的亚基数量比原核的增加了很多,但真核生物 RNA 聚合酶不能独立起始转录,需要大量转录因子的协助。聚合酶Ⅱ依赖的转录因子(transcription factor for polymerase Ⅱ)包括 TFⅡA,B,D,E,F,H 等,这些转录因子负责识别和结合核心启动子,与 RNA 聚合酶一起调控基因的基础表达,被称为普遍转录因子(general transcriptional factor,GTF)。GTF 的功能包括帮助 RNA 聚合酶的正确定位,解开 DNA 双螺旋,在转录起始后释放 RNA 聚合酶,使它能够沿着 DNA 链延伸等。图 15-24 描绘了在普遍转录因子的协助下,RNA 聚合酶Ⅱ识别并结合启动子,组装成转录起始前复合物(pre-initiation complex,PIC)的过程。
TATA 框结合蛋白(TATA-box binding protein, TBP)是真核细胞3种RNA聚合酶都需要的普遍转录因子,负责识别和结合核心启动子序列。在含或不含TATA框的基因的转录起始中都需要TBP的参与。在RNA聚合酶Ⅱ参与的转录起始复合物中,TBP是TFIID的组分之一。一方面,TBP识别TATA框位点,另一方面,TBP亚基和DNA结合后,可以使DNA链发生80°弯折,暴露出其他蛋白质结合位点(图15-25)。TBP还有多个互作蛋白,它们负责识别和结合其他核心启动子序列等。在不同物种中,TBP的TATA框识别功能域在序列上高度保守。
图 15-24 RNA 聚合酶Ⅱ转录起始前复合物的形成
(a) 普遍转录因子 TFⅡD 首先利用 TBP 亚基与启动子的 TATA 框结合。(b) TFⅡA 结合到 TFⅡD 上, 稳定 TFⅡD 和启动子的结合, 阻止其他抑制分子的结合; TFⅡB 和启动子结合, 增强对启动子的识别。(c) TFⅡE、TFⅡH 及已结合了其他转录因子的 RNA 聚合酶 II 一起结合到 TFⅡD-TFⅡA-TFⅡB 复合物上。(d) 全部因子装配完成, 在核苷酸和能量存在的条件下, 可以起始转录。其中, TFⅡE 促进启动子序列的双链打开; TFⅡF 类似原核细胞的 σ 因子, 保证聚合酶和启动子的特异性结合; TFⅡH 具有激酶活性和解旋活性, 提供能量并促进 DNA 解旋。
图 15-25 TBP 结合 TATA 框后 DNA 发生弯折
二、mRNA 的转录后加工
原核细胞的基因转录和翻译耦联,RNA转录后基本不需要加工即可直接进行翻译。但在真核生物中,基因转录和翻译分别在不同的场所进行(图15-26)。真核细胞核内,经RNA聚合酶转录得到的初级转录物需要经过一系列的加工过程才能转变为成熟的RNA分子,这一过程被称为转录后加工(post-transcriptional processing)。初级转录物只有经过正确加工后才能形成成熟的mRNA,并从核内转移到细胞质进行蛋白质的合成。
图 15-26 基因转录和翻译的时空关系
(a) 原核细胞中转录和翻译耦联。(b) 在真核细胞中, 转录在细胞核内发生, 经加工后成熟的 mRNA 出核后在细胞质中进行翻译。
真核基因初级转录物一般需要经过以下加工过程:
(1) 在 mRNA 的 5’ 端加上一个 7-甲基鸟苷 (7-methylguanositie) 作为帽子。这一鸟苷通过三磷酸键 (triphosphate bond) 连接到第一个核苷酸上。所有真核类的 mRNA 都有这帽子。mRNA 的加帽可以促进核糖体识别 mRNA,从而可以延长 mRNA 的寿命。
(2) 在 mRNA 前体的 3’ 端加上一条具有 150~200 个腺苷酸的序列, 称为多聚腺苷酸 poly(A)。真核细胞中, 负责转录终止的蛋白质首先识别和结合转录终止保守序列 AAUAAA (下游还有一些 GU 或富含 U 的特征序列), 招募其他蛋白质一起完成初级 RNA 转录物的切割。随后在 poly(A) 聚合酶 (polyadenylate polymerase) 的作用下进行 poly(A) 加尾, 随着 poly(A) 尾的延伸, 一些结合蛋白也结合到 poly(A) 上。这条 poly(A) 尾对 mRNA 的稳定性有一定维持作用, 促进最后一个内含子的剪接, 而且可能对 mRNA 进入细胞质并结合到核糖体上有帮助。
(3) 初级 RNA 转录物中的内含子序列被特异剪切, 留下的外显子序列首尾连接起来, 这个过程称为 RNA 剪接 (RNA splicing)。mRNA 剪接过程较为复杂, 简单地说, 首先内含子近 3’ 端的一个腺嘌呤核苷酸 (A) 利用 2’ 羟基与内含子 5’ 端的核苷酸的磷酸基团反应形成磷酸二酯键, 整个内含子序列形成一个“套马索” (lariat) 结构。随后, 前一外显子 3’ 端核苷酸暴露的羟基与下一个外显子 5’ 端核苷酸的磷酸反应; 最后, 两个相邻外显子之间形成磷酸二酯键, 成“套马索”状的内含子从初级 RNA 转录物上完全解离出来, 完成剪接过程 (图 15-27)。内含子的剪接依赖于由核糖核蛋白与其他一百余种蛋白质构成的剪接复合体。除了 mRNA, tRNA 和 rRNA 也都有特定的剪接方式。
(4) RNA 编辑(RNA editing)不是对初级 mRNA 转录物的修饰,而是直接对初级 mRNA 转
录物的遗传信息进行修改。RNA 编辑最早是在锥虫线粒体基因中发现的。锥虫的线粒体基因组编码一类特殊的引导 RNA (guide RNA, gRNA), 长 55~70nt, 3’ 端具有 poly(U) 尾, 可以与初始 mRNA 不完全互补, 然后在 mRNA 序列中不配对的地方相应地插入了一些 gRNA 特有的 U, 完成信息编辑。哺乳动物中也有 RNA 编辑, 但很少见, 进化意义尚不清楚。如小肠中载脂蛋白 B 的 mRNA 在成熟前有一个 C 到 U 的编辑, 提前终止了可读框, 但肝中没有这一编辑过程 (图 15-28)。可见, RNA 编辑也参与了组织特异性表达调控。
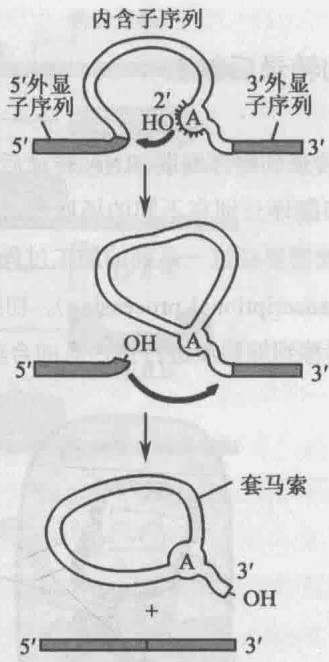
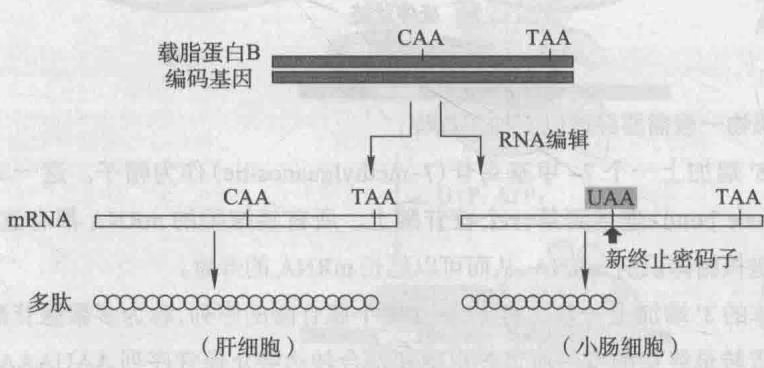
三、蛋白质翻译与修饰
真核细胞内转录产生的初级转录物在核内经过上述加工程序后, 最后成为成熟的 mRNA。但在这些 mRNA 进入翻译之前, 还必须出核, 并在蛋白质翻译场所正确定位, 因为真核生物细胞内的转录和翻译不是耦联的。在成熟 mRNA 出核的过程中, 一些出核因子参与其中, 此外, 5’ 帽和 poly(A) 尾对出核和定位也有重要作用。出核后的 mRNA 可以利用细胞骨架进行运输, 或者在细胞质内随机扩散, 或者与特定的细胞质蛋白质结合。真核细胞的大多数 mRNA 的半衰期在 30 min 左右, 细胞内不需要的 mRNA 通过降解及时被清除, 这个途径有利于精确调控细胞内的生化反应。换句话说, 真核细胞内的 mRNA 在翻译和降解之间保持着动态平衡, 这个平衡机制可以精确调控细胞内的基因表达。
真核生物的蛋白质翻译以加工成熟的 mRNA 为模板,从起始密码子(AUG)开始,到终止密码子(UAA、UAG、UGA)结束,和这段 mRNA 序列相对应的 DNA 序列是编码序列。从 mRNA 链的转录起始位点到编码区的 5’ 端的序列被称为 5’ 非翻译区(5’ untranslated region,5’ UTR),而从编码区的 3’ 端到转录终止位点的序列被称为 3’ 非翻译区 (3’ untranslated region, 3’ UTR), 这些 mRNA 序列均不会被翻译成氨基酸 (图 15-29)。
Genomic Sequence: NC_000016.10 Chromosome 16 Reference GRCh38.p13 Primary Assembly
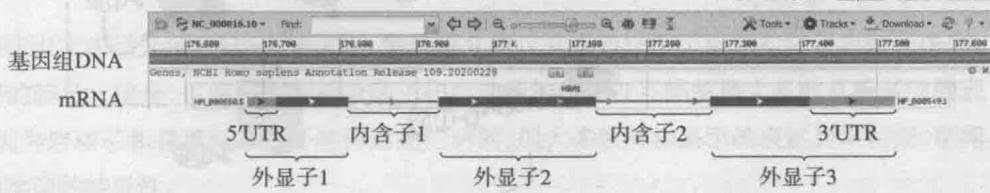
在 mRNA 链中, 箭头代表转录方向, 方框代表外显子, 细线代表内含子, 深色方框代表氨基酸编码区域, 浅色方框代表非翻译区。
真核细胞的翻译过程和原核细胞大致类似,但也有一些差别。例如,真核 mRNA 链中没有 Shine-Dalgarno 序列,核糖体通过 5’ 帽识别 mRNA,起始 mRNA 翻译;真核基因的起始密码子不全是甲酰甲硫氨酸,未被甲酰化的甲硫氨酸也可以用作起始密码子,但真核细胞仍有特异性的起始 tRNA;真核基因的翻译过程需要更多的蛋白质因子的参与,比如翻译的起始至少需要 10 个蛋白质才能完成。
真核基因表达区别于原核基因的另一个重要特点是,真核基因还存在翻译后的蛋白质修饰,即翻译产生的蛋白质多肽一般还需要经过多种加工才能成为有功能的蛋白质,这些加工包括:①蛋白质折叠形成正确的构象;②在氨基酸上进行共价修饰,包括磷酸化、糖基化、乙酰化和甲基化等;③多亚基复合物的组装,如形成二聚体、多聚体等。
四、蛋白质降解
如果翻译产生的蛋白质不再需要,或者由于某种原因形成了异常蛋白质、错误折叠的蛋白质等,那么真核细胞会立即主动清除这些蛋白质。真核细胞快速降解蛋白质的重要机制之一为泛素-蛋白酶体途径(ubiquitin-proteasome pathway)。
泛素(ubiquitin, Ub)是一个含有76个氨基酸的小分子蛋白质,在真核生物中广泛表达(因此得名),高度保守。泛素通过与蛋白质底物的赖氨酸残基连接,形成多聚泛素链,指导标记蛋白质被蛋白酶体识别并发生降解。这个过程涉及3个重要的蛋白质:泛素激活酶(ubiquitin-activating enzyme, E1)、泛素结合酶(ubiquitin-conjugating enzyme, E2)和泛素连接酶(ubiquitin ligase, E3)。首先,在ATP供能的条件下,E1与Ub结合;随后,E1将Ub转移到E2分子上;同时,E3识别并结合底物蛋白质,并通过与E2的相互作用将Ub转移到底物蛋白质上,更多的Ub分子进一步添加到该蛋白质上,形成一条多聚泛素链;最后,这个多泛素化的蛋白质被26S蛋白酶体(proteasome)识别,被迅速降解(图15-30)。
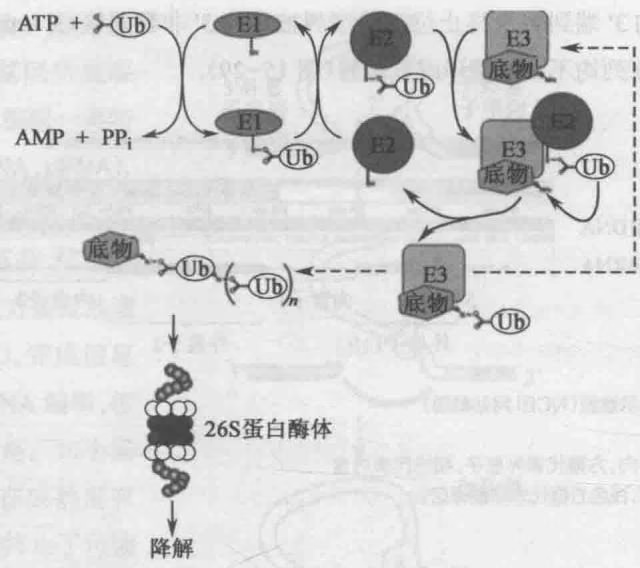
第五节 真核生物的基因表达调控
和原核生物相比,真核生物的基因表达过程及其调控机制也复杂得多。这种复杂的基因表达调控是真核生物实现更加高级的生命形式、进行更加复杂的生命活动的遗传基础。真核细胞的转录在核内进行,翻译在细胞质进行。根据时空上的差别,我们可以将真核生物基因的表达调控分为转录水平和翻译水平,进一步又可分为前、中、后水平(图15-31)。在每个水平,真核细胞都有相应的调控机制,精确控制基因表达。例如,转录起始阶段很多组织特异性DNA调控文件与蛋白质因子相互作用,负责组织特异性基因转录的起始;在转录后加工阶段,可变剪接的调控方式大幅增加基因表达的多样性,可在特定的发育阶段和特定的细胞类型中表达相应的剪接变异体;在翻译后加工阶段,蛋白质激酶和磷酸酯酶对信号蛋白的磷酸化和去磷酸化修饰可以精确调节信号途径的开启和关闭等。在下文中,我们将主要和读者介绍一些真核基因转录起始前复合物中的表达调控元件,再来重点说明可变剪接的生物学意义。
一、顺式调控元件
我们在上文中已介绍,真核细胞 RNA 聚合酶Ⅱ通过普遍转录因子识别和结合启动子序列,起始基因的转录。但是,仅仅是普遍转录因子和启动子的参与并不能解释大多数真核基因的表达特点,因为启动子和普遍转录因子的作用是广谱的,但大多数真核基因的表达具有时间、空间以及细胞类型的特异性。
原来,除了 RNA 聚合酶、启动子和普遍转录因子,真核生物的基因表达还受到大量其他元件的调节,这些元件是实现真核生物时空特异性基因表达的分子基础。根据作用方式的不同,可以将这类元件分为顺式调控元件(cis-regulatory element,又称顺式作用元件,cis-acting element)和反式调控元件(trans-regulatory element,又称反式作用元件,trans-acting element)。顺式调控指的是该元件只能够调节自身所在染色体上邻近结构基因的表达,如启动子,它们一般与结构基因串联排列在同一条染色体上,距离也较近,大多数为 DNA 元件。反式调控指的是该元件能够调节不同染色体上结构基因的表达,包括各种转录因子的编码基因,它们或者与结构基因不在一条染色体上,或者距离遥远。通常,顺式调控元件不编码任何蛋白质,仅提供一个 DNA 位点,而反式调控元件编码转录因子,能够识别顺式调控元件并与之结合,共同调控基因转录。ncRNA 的调控方式较为复杂,顺式和反式均有,我们留到后面再做详细介绍。
我们先介绍顺式调控元件。除了启动子,常见的顺式调控元件还包括:增强子(enhancer)、沉默子(silencer)、绝缘子(insulator)、基因座控制区(locus control region, LCR)和基质结合区(matrix attachment region, MAR)等。
(1) 增强子 这是一种远端调控元件, 可以通过调控启动子区域 DNA 转录起始前复合物的组装来提高基因转录效率。增强子和被调控基因之间的距离通常较远, 可相隔数千 bp。尽管和基因之间相距甚远, 但是增强子能够被转录激活因子(transcription activator)结合, 利用染色质弯折形成的回环(loop)作用于转录起始前复合物, 从而实现转录调控(图 15-32)。
研究者在 SV40 病毒基因组中发现了第一个增强子 (Benerji, 1981), 长度为 140 bp, 它能够显著提高下游融合基因的表达水平。序列分析发现, 该增强子由两个串联的 72 bp 的重复序列
图15-32 增强子作用方式
增强子结合转录激活因子,通过 DNA 弯折与转录起始前复合物结合,激活转录。
组成,具有核心序列,改变序列方向或者增强子与基因的相对位置,增强子的转录激活活性不受影响。这些性质代表了增强子的通性:具有一定的核心序列,作用与方向和位置无关。
增强子的转录激活作用通常具有组织器官和发育阶段的特异性。真核细胞的许多基因能够在多种组织中表达,但研究发现,多组织表达往往依赖的是多种组织特异性增强子,而非一种广谱调控元件。例如,某一基因能够同时在小鼠的脑部和四肢表达,仔细分析该基因的上游调控区,发现了多个不同的增强子(图15-33a)。当其中一个增强子1(脑特异增强子)通过DNA弯折和转录起始复合物发生作用,促进基因表达时,我们看到该基因在小鼠的脑部有了特异表达(图15-33b);当另一个增强子2(四肢特异增强子)通过作用于起始复合物发挥转录激活作用时,我们看到该基因在小鼠的四肢有了特异表达(图15-33c)。
又如, 黑腹果蝇的 yellow 基因负责体表的色素合成, 包括翅、四肢、幼虫、刚毛等。野生型的果蝇呈黑棕色, 大多数 yellow 基因突变型的果蝇呈黄褐色。研究发现, 有一些突变体果蝇仅在部分器官出现黄褐色变异, 其他器官颜色正常即表现出嵌合 (mosaic)。序列分析发现, 原来突变发生在 yellow 基因不同的增强子中。在 yellow 基因上游和内部有多个增强子, 分别负责激活 yellow 基因在不同组织细胞中的表达。
(2) 沉默子 和增强子相反, 这是一种基因转录的负调控元件。但它和增强子的调控方式很类似——参与时空特异性基因的表达调控, 不受方向和位置的限制。
单倍体酿酒酵母有 a 和 $\alpha$ 两种交配型,由染色体上 MAT 基因座中的基因控制:当该基因座是 MATa 时,交配型是 a;当该基因座是 MATa 时,交配型为 $\alpha$ 。而与交配型有关的遗传信息也存在于 MAT 基因座左右两侧的 HMLa 和 HMRa 基因座中(图 15-34)。虽然这两个基因座分别含有 $\alpha$ 和 a 基因的完整拷贝及它们各自的启动子,但通常不被转录。研究发现,HMLa 和 HMRa 基因座旁侧存在酵母交配型基因座沉默子(mating-type locus silencer),造成了该位置 $\alpha$ 和 a 基因的沉默。只有当这些基因插入到 MAT 基因座时,才能解除沉默子的作用,发生转录并决定酵母的交配型。
(3) 绝缘子 绝缘子本身对基因的表达既没有正效应, 也没有负效应, 其作用只是不让远端调控元件对基因的活化效应或失活效应发生作用。如图 15-35 所示, 如果绝缘子处在基因 A 的
(a) 某一基因可在小鼠脑及四肢表达。(b) 当增强子1作用于RNA聚合酶Ⅱ时, 基因在脑中特异表达。(c) 当增强子2作用于RNA聚合酶Ⅱ时, 基因在四肢特异表达。
图 15-34 酵母交配型的分子基础
当 HMLα 基因座内的基因插入到 MAT 位置成为 MATα 时,酵母交配型为 α;当 HMRα 基因座内的基因插入到 MAT 位置成为 MATα 时,酵母交配型为 a。
启动子和增强子之间,它可以中断启动子和增强子之间的通讯,抑制增强子的转录激活作用;如果绝缘子处在表达活跃的基因 B 和表达沉默的异染色质(或沉默子)之间,它可以保护表达活跃基因不受到异染色质的干扰。
绝缘子的特殊作用保证了许多远程的调控元件不会干扰无关基因的表达。绝缘子将染色体划分为了空间上相互独立的区域,也在功能上把染色体划分为表达上相互独立的区域。
上述介绍的增强子、沉默子与绝缘子都属于远端转录调控元件,它们的作用机制相似,但调控性质不同。图15-36展示了这些调控元件在基因组DNA上的分布特点。绝缘子负责在基因组DNA上划分独立的表达调控区域,增强子和沉默子负责激活或沉默所在调控区域的基因表
TF: 转录因子; S: 沉默子; I1、I2: 绝缘子; E1、E2: 增强子; P1、P2: 启动子。沉默子 S 起始异染色质 (heterochromatin) 的包装, 从 S 所在 DNA 位置向两侧扩散, 包围了启动子 P2 (及其下游的基因) 的 DNA 区域。异染色质结合蛋白如 HP1 (heterochromatin protein 1) 等进一步结合到这一区域, 促进染色质的浓缩, 完全关闭该区域内的基因表达。绝缘子 I1 有效隔离了异染色质区域的作用, 保护了 I1 另一侧常染色质 (euchromatin) 区的表达活性。增强子 E1 有效激活了启动子 P1 (及其下游的基因)。另一个绝缘子 I2 则阻断了增强子 E2 对 P1 的潜在调控作用。
达。这些不同的远端 DNA 调控元件在基因组的表达调控中高度协作,共同保障各个基因能够得到独立的、时空特异性的表达调控。
近年来,一些深入的研究工作发现增强子等 DNA 调控元件有时也会通过 DNA-DNA 相互作用的方式调控另一条染色体(同源或非同源)上的基因表达,即发挥反式调控的作用。这是基因表达调控复杂性的又一体现。
(4) 基因座控制区(LCR) LCR 位于基因(尤其是基因簇)的上游,通常由 DNA 酶超敏感位点(DNase-hypersensitive site)组成,它的特点是可以同时调控下游一个基因簇内全部基因的表达,兼有增强子和绝缘子的活性。
我们以人的 $\beta-$ 珠蛋白基因簇为例说明 LCR 是如何调控基因表达的。人的 $\beta-$ 珠蛋白以基因簇的形式排列,在整个基因簇的上游,有 3 个 DNA 酶超敏感位点,构成了基因座调控区(图 15-37a)。在发育不同阶段, $\beta-$ 珠蛋白基因簇中的不同基因进行选择性表达(图 15-37b):在胚胎早期,主要表达 $\varepsilon-$ 珠蛋白。随着胚胎的发育, $\varepsilon-$ 珠蛋白不断减少, $\gamma-$ 珠蛋白表达上升。待到胎儿出生时, $\gamma-$ 珠蛋白又出现下降, $\beta-$ 珠蛋白逐渐取而代之,并一直维持到最后。突显这一复杂时空特异性调控的正是基因簇上游的 LCR,在胚胎发育早期,LCR 特异性转录激活 $\varepsilon$ 基因,对 $G_{\gamma}, A_{\gamma}, \beta$ 基因的作用很弱;到了胚胎发育中后期,LCR 对 $\varepsilon$ 基因的激活作用被屏蔽,激活 $G_{\gamma}, A_{\gamma}$ 基因表达,对 $\beta$ 基因的作用仍然很弱;直至胎儿出生后,LCR 对 $G_{\gamma}, A_{\gamma}$ 基因的激活作用也被屏蔽, $\beta$ 基因的表达被激活(图 15-37c)。
由珠蛋白合成不足引起的贫血症被称为地中海贫血症。在一些地中海贫血症患儿中发现,红细胞前体细胞内珠蛋白编码基因和邻近的调控序列都没有突变,而是远端的 LCR 发生了部分或全部的丢失,结果造成了珠蛋白的表达沉默,引起贫血症。
关于 LCR 是如何调控基因表达的分子机制还不是很清楚,一种解释是 LCR 通过调节染色质的结构控制基因(簇)的表达。在转录开始前,LCR 招募染色质修饰蛋白进行染色质的去包装化,使转录因子能够更容易地进入该调控区,从而启动转录。
(a)
(c)
(b)
(a) $\beta-$ 珠蛋白基因簇及上游的 LCR, LCR 由 3 个 DNA 酶超敏感位点组成。(b) $\beta-$ 珠蛋白在发育不同阶段的表达情况。(c) 发育不同时期 LCR 特异性调控 $\beta-$ 珠蛋白基因家族成员的表达。
(5) 基质结合区(MAR) 也称为基质附着区, 是与核基质或核骨架特异结合的 DNA 调控序列, 长度一般为 30~1 000 bp, 有的更长, 富含 AT, 也具有特定的保守序列
(介导与核基质相互作用的关键位点)。不同 MAR 与核基质的亲和力不同。MAR 通过与核基质结合,能使染色质形成独立的疏松环状结构,以利于转录的发生(图 15-38)。同时,MAR 上通常含有多种转录调控蛋白的结合位点,与这些因子结合后,也能发挥调控基因表达的作用。
二、反式调控元件
参与真核细胞基因转录起始的反式调控元件主要包括上文已经介绍的普遍转录因子、特异转录因子(specific transcriptional factor)和中介子(mediator)。这些蛋白质因子一般通过识别并结合特定的顺式调控元件,再与RNA聚合酶和普遍转录因子共同组装成基因转录起始前复合物,调节基因的表达水平。
(1) 特异转录因子 特异转录因子和普遍转录因子最主要的区别在于它们不是所有 RNA 聚合酶Ⅱ转录起始复合物的必要组分。特异转录因子根据不同的作用效果, 可以分为激活型转录因子和抑制型转录因子。激活因子是增强子的结合蛋白, 抑制因子多是沉默子的结合蛋白。
转录因子通常含有两个重要的结构域:一个是 DNA 结合域(DNA binding domain, DBD),负责与 DNA 调控元件结合;另一个是转录激活域(activation domain, AD),负责与基础转录起始前复合物中的其他蛋白质相互作用,调节复合物的转录活性(图 15-39)。值得一提的是,基因工程领域开发的酵母双杂交实验系统正是利用了转录因子独立的双功能结构域,已被广泛应用于蛋白质相互作用的筛选与鉴定。基本的实验原理如图 15-40 所示,将转录因子的 DBD、AD 拆开后分别与两个待检测蛋白融合,当这两个待检测蛋白之间存在相互作用关系时,可以将 DBD 和 AD 拉近,成为完整的转录因子,发挥转录激活作用,启动下游报告基因的表达。反之,如果蛋白质之间没有互作关系,报告基因不能表达。
DBD 有几种常见结构。①螺旋 - 转角 - 螺旋 (helix-turn-helix, HTH), 这是最简单也最常见的 DNA 结合域 (图 15-41a)。靠近 C 端的螺旋负责与 DNA 螺旋的大沟结合, 不同 HTH 结构域在这个螺旋中的氨基酸组成不同, 决定了它们能够特异性地识别不同的 DNA 序列。很多 HTH 类型的转录因子可以以同源二聚体的形式发挥作用。②锌指 (zinc finger), 它最大的特点就是利
图15-39 特异转录因子的作用方式
特异转录因子利用其 DBD 与顺式元件结合, 利用其 AD 与转录起始前复合物结合, 调节后者的转录活性。
(b)
(d)
将转录因子 GAL4 的 DBD 结构域与诱饵蛋白连接, GAL4 的 AD 结构域与候选互作蛋白连接, 与报告基因共同导入细胞内, 观察报告基因的表达情况。
用 Zn 原子作为结构组分, 维持结构稳定。这类结构可分为两类, 第一类多在真核 rRNA 基因转录中发现, 包含一个 $\alpha$ 螺旋和一个 $\beta$ 折叠, Zn 原子衔接这两个结构域, $\alpha$ 螺旋负责识别和结合 DNA 螺旋的大沟(图 15-41b); 第二类多在受体蛋白家族中发现, 包含两个类似于 HTH 的结构域, Zn 原子衔接两个螺旋, 通常这类蛋白以二聚体的形式发挥作用, 两侧的两个螺旋分别插入 DNA 螺旋的大沟中(图 15-41c)。③亮氨酸拉链(leucine zipper), 因形状而得名。亮氨酸拉链结构含有一个 $\alpha$ 螺旋, 通常以二聚体的形式发挥作用(图 15-41d)。两个螺旋利用内部的疏水基团相互作用(主要是亮氨酸), 分开的一端负责和 DNA 螺旋的大沟结合。亮氨酸拉链可以形成同源二聚体或异源二聚体, 同源二聚体识别两段相同的 DNA 调控元件, 而异源二聚体可以和两段不同的 DNA 调控元件结合。
尽管 DBD 有常见的结构,但是,核苷酸序列和 DBD 的氨基酸序列之间的结合关系并不是一一对应的。相同的氨基酸残基可以和不同的碱基结合,反之亦然。核苷酸-氨基酸的对应关系与特定的蛋白质构象、邻近的氨基酸组成、核苷酸构象等都有关系。
此外,特异转录因子的 AD 也有一些特点,比如富含 Glu 和 Asp 等酸性氨基酸,或者富含 Pro 等,这些特殊的氨基酸组成能够促进蛋白质-蛋白质相互作用。
(2) 中介子 有时候, 特异性转录因子不能直接和转录起始前复合物的蛋白质组分直接结合,这就需要另一类蛋白质因子的协助,即中介子。中介子能够介导特异性转录因子与转录起始前复合物之间的相互作用(图 15-42)。中介子具有多种生物学活性,如接头蛋白活性,介导特异转录因子和转录起始前复合物的结合,招募普遍转录因子和RNA聚合酶结合到染色质上,以及染色质修饰等。
(a)
(c)
(a) 螺旋-转角-螺旋。(b)、(c) 锌指。(d) 亮氨酸拉链。
视频 19
真核基因转录起始复合物
三、管家基因与奢侈基因
如果利用高通量组学手段对多细胞真核生物的各个细胞类型进行基因组序列的分析, 只会发现少量体细胞变异带来的差异; 但如果进行全基因组基因表达产物的分析, 结果就会大相径庭, 任何两种细胞之间的表达差异都非常巨大。研究者将在不同组织细胞之间, 不同发育阶段之间没有表达差异的基因称为管家基因(housekeeping gene), 它们的基因产物主要负责维持细胞的基本生命活动, 故在机体的所有细胞类型中都恒定表达, 如细胞骨架基因 ACTB(actin beta)、代谢基因 GAPDH(glyceraldehyde-3-phosphate dehydrogenase) 等。而在不同组织细胞之间、不同发育阶段之间存在表达差异的基因则被称为组织特异性基因(tissue-specific gene)或奢侈基因(luxury gene)。这类基因不仅在特定细胞类型、特定发育阶段中独特性表达, 而且它们的基因产物往往决定了特定细胞类型的生物学特征和功能, 例如红细胞的 HBA1(hemoglobin subunit alpha 1) 特异性表达 α-珠蛋白, 胰岛 β 细胞的 INS(insulin) 特异性表达胰岛素等。研究发现, 在高等生物中, 奢侈基因的数目多于管家基因的数目, 这也从另一个侧面说明了真核基因表达调控的重要性。
我们在上文中以基因表达起始前复合物为对象,重点介绍了真核基因表达调控的一个主要层次——转录水平的调控。在这一调控层次中,不难发现,不同转录起始前复合物可以分别负责管家基因和奢侈基因的表达。由普遍转录因子、RNA聚合酶和启动子组成的转录起始复合物中,各个调控元件/因子都没有组织特异性,在不同细胞中的表达调控效果是相近的,它们负责的是管家基因的表达。而由DNA远端调控元件、组织特异性转录因子、和/或共激活/抑制因子、中介子等共同参与的转录起始前复合物负责调节奢侈基因的表达,因为增强子、特异性转录因子等转录调控元件/因子都具有组织特异性。
四、可变剪接
我们在前面已经介绍过,真核基因的可变剪接可以大大增加遗传信息的多样性。事实上,从表达调控的角度看,可变剪接也是真核基因时空特异表达的重要调节机制之一。基因的不同剪接变异体在可变剪接机制的调控下,在特定细胞、特定发育时期表达,参与决定细胞的功能和命运。例如,前面介绍的黑腹果蝇的 $P$ 因子在体细胞和生殖细胞中转座活性的差异正是由于可变剪接得到的产物不同而造成的(见图12-18)。此外,果蝇的性别决定(见图6-24)也是一个很好的例子。
我们已经知道,果蝇的性别是由早期胚胎的性指数所决定的,即 X 染色体的数目与常染色体组数的比例(见图 6-24),研究发现这一比例决定了果蝇性别发育“开关”——SXL 蛋白的积累程度。充足的 SXL 蛋白可以促进雌性性别分化,缺乏 SXL 蛋白则促进雄性性别发育。SXL 蛋白的表达受到可变剪接的调控。
SXL 蛋白由 Sxl 基因编码。在 Sxl 基因的上游有两个启动子—— $P_{E}$ 和 $P_{M}:P_{E}$ 是一个“早期”启动子,即它在胚胎发育早期就能启动基因转录,而 $P_{M}$ 属于“晚期”启动子,它在胚胎发育稍晚的阶段才发挥作用。 $P_{E}$ 启动子的活性受到性指数的影响(性指数可影响和 $P_{E}$ 结合的转录因子的丰度)。在 XX 胚胎中,Sxl 基因首先从 $P_{E}$ 启动子开始表达,而 XY 胚胎不能从 $P_{E}$ 启动子开始表达 Sxl 基因。 $P_{M}$ 启动子的活性在两种胚胎中没有差异,都可以表达。
如图 15-43 所示, 在 XX 胚胎发育早期, Sxl 基因首先从 $P_{E}$ 转录表达, 得到的成熟 mRNA 链经翻译后可得到正常的 SXL 蛋白。到发育后期, Sxl 从 $P_{M}$ 转录。在前期生产的 SXL 蛋白的剪接调控下, 去除 3 号外显子, 成熟 mRNA 继续翻译成 SXL 蛋白, 该蛋白质进一步参与自身 mRNA 链的剪接加工, 这种正反馈最终积累了大量 SXL 蛋白。但在 XY 胚胎中, Sxl 基因仅从 $P_{M}$ 转录表达, 成熟 mRNA 链中保留了第 3 号外显子, 由于第 3 号外显子中提前出现了一个终止密码子, 该 mRNA 经翻译后得到的是一条截短的异常多肽, 不具有 SXL 蛋白的活性, 更无法启动积累 SXL 蛋白的正反馈过程。
作为一种剪接调控因子,SXL蛋白不仅可以影响自身的表达,还可以影响性别决定途径下游tra基因的剪接(图15-44):在XX胚胎中,细胞中积累的SXL蛋白也能调控tra基因的剪接,得到的mRNA可以翻译成有功能的TRA蛋白。TRA蛋白也是可变剪接的调控因子,以正反馈的形式控制自身的表达。而在XY胚胎中,没有SXL蛋白,tra基因在其他剪接因子的作用下得到不同的剪接变异体,该mRNA序列中也提前出现了终止密码子,无法翻译出有功能的TRA蛋白。
在 XX 胚胎中, 积累的 TRA 蛋白随后和组成型表达的 TRA2 蛋白一起, 进一步调控下游 dsx 基因的可变剪接过程, 得到的剪接变异体的翻译产物可以决定雌性性别分化。而在 XY 胚胎中, 由于没有 TRA 蛋白, dsx 基因转录得到了另一种剪接变异体, 其翻译产物可以决定雄性性别分化。可见,在果蝇胚胎的性别决定过程中,基因的可变剪接方式发挥了关键性的调控作用。可变剪接在调控基因表达、细胞命运方面还有很多例子,在此就不一一介绍了。图15-45给出了几种常见的可变剪接方式,虽然现在对真核基因mRNA剪接的分子机制还不完全清楚,但毫无疑问的是,可变剪接是真核基因表达的重要调控手段之一。
关基因的剪接方式和调控途径
图 15-45 常见的可变剪接方式(引自 Cartegni 等,2002)
第六节 表观遗传调控
我们在上一节介绍了基因表达受到各式各样的 DNA 调控元件和蛋白质因子的精确调控, 因此, 基因组中除了蕴藏着大量性状决定基因, 更包含了大量的发挥表达调控作用的 DNA 元件和调节蛋白编码基因, 这与近年来功能基因组学的发现是一致的。调控基因的突变也会导致性状的改变, 例如前面介绍的黑腹果蝇 yellow 基因增强子突变等。但是, 有时候即使没有基因序列的改变,基因表达的过程也会受到影响,这就是近年来表观遗传学(epigenetics)所关注的研究内容。所谓表观遗传,指的是在DNA序列不改变的情况下,基因功能发生的可遗传的变异,最终可导致表型变化(Riggs等,1996)。近年来,遗传学家进一步更新了表观遗传的定义——不依赖于DNA序列变化,由染色体结合的、可遗传的变异引起的基因表达变化(Deans和Maggert,2015),而表观遗传学就是研究表观遗传的现象与机制。影响表观遗传变化的内源因素包括DNA甲基化,组蛋白修饰,染色质重塑和非编码RNA等。
下面我们将分别介绍几种表观遗传机制是如何调控基因表达的。
一、染色质结构与组蛋白修饰
我们已经介绍了真核生物的基因组结构,知道真核生物基因被大量的蛋白质所包裹,压缩成独特的染色质结构。基因表达同样需要大量蛋白质的参与,比如 RNA 聚合酶必须与启动子序列结合才能启动转录,而在后续的转录和加工过程中,同样需要不同蛋白质的动态结合和解离。
如果仔细观察染色质的精细结构,会发现不同位置上 DNA 的包装程度并不完全相同。染色体末端端粒和中部着丝粒区域的包装程度很高,属于异染色质区,能够被核染料染成深色。这一区域由于包装程度过高,基因表达所需的蛋白质无法结合 DNA 链,因此几乎没有基因表达活性。而染色质的其他区域则属于常染色质区,染色较浅,染色质结构较疏松,基因表达所需的蛋白质能够相对容易地进出,以便控制基因表达。研究发现当基因在基因组中位置发生改变,如从常染色质区转移到异染色质区时,基因表达水平也会随之发生变化。例如,果蝇的白眼基因 white 负责复眼的颜色,野生型果蝇的复眼颜色是红色的。有一类突变体果蝇,它的复眼颜色有红有白,相间分布呈斑点状。遗传分析发现,这类果蝇的 X 染色体出现了染色体片段的倒位,导致 white 基因转移到了异染色质邻近区域,尽管 white 基因的内部(包括调控序列)没有发生任何突变,但是由于邻近异染色质的影响,white 基因被关闭表达,表现为白眼。红色小眼细胞则来自于发育早期异染色质的扩散范围较小的母细胞,这些细胞内 white 基因未被关闭,正常表达,因此表现为红眼(图 15-46)。
又如,在显微镜下观察果蝇的唾腺染色体,在局部位置上能看到一些螺旋化程度较低、发生膨胀的区域,杂交实验证明这些区域正是转录活跃的区域,膨胀的染色体结构可以更好地向转录所需蛋白质分子“开放”,利于转录的进行(图15-47)。在发育的不同阶段,疏松区出现和消退的位置处于动态变化之中,这是基因时间特异性表达调控的又一证据。
核小体的装配是染色体包装的第一步,因此参与核小体装配的组蛋白是决定染色质包装
图 15-47 果蝇唾腺染色体上的动态膨胀区(引自 Novikov,2009)
(a) 经热刺激后的唾腺染色体的一个区段上出现了膨胀的疏松结构。(b) 未受刺激的相同区段的唾腺染色体的对照。
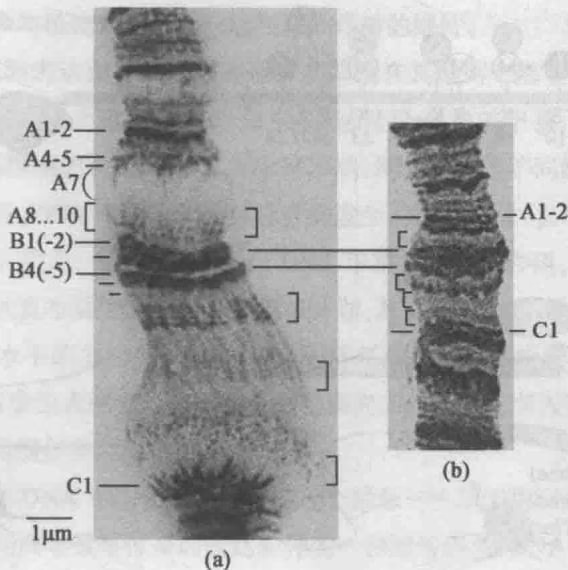
程度的重要因素之一。组蛋白的修饰主要发生在肽链的N端和C端,修饰类型包括乙酰化(acetylation)、甲基化(methylation)、磷酸化(phosphorylation)和泛素化(ubiquitination)等,修饰位点以赖氨酸(K)居多,还有精氨酸(R)、丝氨酸(S)和苏氨酸(T)等(图15-48a)。组蛋白上不同氨基酸位点的不同化学基团的修饰共同参与了染色质构象的动态调节,从而与DNA的转录、包装、修复、复制等活动相适应(图15-48b)。例如,H3的N端K4和K36的甲基化能够招募转录相关蛋白,促进基因表达;而H3的N端K9和K27的甲基化会促进DNA包装蛋白的结合,压缩染色质结构,抑制基因表达。此外,乙酰基带负电,可以中和组蛋白尾端的正电性,从而削弱组蛋白与DNA链的结合强度,疏松染色质,较高的组蛋白乙酰化水平可以促进转录。
视频 20
DNA 甲基化
和基因组
印记
二、DNA 甲基化与基因组印记
DNA 甲基化是表观遗传的第二项重要研究内容, 它指的是 DNA 序列中的胞嘧啶脱氧核糖核苷酸的胞嘧啶(C)能够被甲基化修饰, 形成 5-甲基胞嘧啶脱氧核糖核苷酸(5mC)(图 15-49a)。在哺乳动物细胞的基因组中, DNA 甲基化主要发生在 CpG 二核苷酸中的胞嘧啶上(p 表示两个核苷酸分子之间的磷酸二酯键)。负责催化 DNA 甲基修饰的是 DNA 甲基转移酶(DNA methyltransferase, DNMT)家族的成员, 它们能够维持基因组已有的 DNA 甲基化标记并建立新的 DNA 甲基化标记。
研究者对基因组序列进行深入分析发现,哺乳动物基因组中 CpG 二核苷酸的分布显著不均匀(图 15-49b): 在超过 98% 的基因组序列中,CpG 的密度极低(平均每 100 bp 中只有一个 CpG),且大多被甲基化修饰。但在其余不到 2% 的区域内,CpG 呈高密度分布(平均每 10 bp 至少一个 CpG)且没有甲基化修饰,这些成簇分布的 CpG 被命名为 CpG 岛,即哺乳动物基因组中长度为 0.3 ~ 3 kb,富含 CpG 二核苷酸成分(GC 含量 > 50%)的 DNA 序列。CpG 岛通常位于编码基因启动子内部或者邻近启动子的位置,它的甲基化修饰水平与下游编码基因的表达效率密切相关:甲基化 CpG 岛抑制基因表达,去甲基化 CpG 岛增强基因表达。这其中的基本机制是甲基化的 CpG 岛干扰了转录因子与 DNA 的正常结合,招募染色质修饰蛋白,改变染色质的包装(a) 组蛋白 H3 上化学修饰的常见位点与修饰类型; M, 甲基化; A, 乙酰化; P, 磷酸化。(b) 哺乳动物基因组不同 DNA 区域上组蛋白的修饰特点: 在活跃的启动子 DNA 区域, 组蛋白具有标志性的 H3K4me2、H3K4me3 以及高乙酰化水平, 下游发生转录的基因序列被富含 H3K36me3 和 H3K79me2 标记的组蛋白所包装。增强子序列结合的组蛋白的特征则是高水平的 H3K4me1、H3K4me2 和 H3K27ac。而表达沉默的基因通常处在发生了 H3K9me2 和 / 或 H3K9me3 或 H3K27me3 修饰的组蛋白的包装之中(引自 Zhou 等, 2011)。
(a) 胞嘧啶与甲基化胞嘧啶。(b) 哺乳动物基因组中 CpG 的分布特点。
程度。研究发现,一类含有甲基化 CpG 结合功能域(methyl-CpG binding domain, MBD)的蛋白质,如 MeCP2(methyl-CpG binding protein 2)负责识别并特异性结合甲基化的 CpG 岛,竞争性阻止了转录因子与启动子靶序列的结合,招募组蛋白去修饰蛋白压缩染色质,从而抑制该区域内基因的转录活性。1999 年遗传学家发现,一类儿童时期发病的遗传性神经系统疾病——雷特综合征(Rett syndrome)正是由 MeCP2 基因缺陷所导致的(Amir 等, 1999),这充分说明了表观遗传调节蛋白对于正常生命活动的重要性。而在植物细胞中,胞嘧啶甲基化可以发生在更多的位置,除了 CpG 二核苷酸,还有 CHG 和 CHH(其中 H 指的是 A, C, T 3 种碱基类型的任意一种)三核苷酸,这两种修饰形式主要参与植物转座子的沉默和异染色质的维持。
DNA 甲基化在基因表达调控中的重要地位还体现在其他两个重要方面:首先,以人基因组为例,约60%的编码基因的上游含有CpG岛,可以通过CpG岛的甲基化水平调节基因表达;其次,不仅基因组中不同区域的CpG岛甲基化水平不同,同一个体的不同组织细胞之间,或同一组织细胞的不同发育阶段,DNA甲基化修饰状态亦会发生动态的变化,参与个体发育、组织分化过程中的基因表达调控。因此,为了更好地认识DNA甲基化的潜在作用,人类表观基因组协作组织于2003年10月正式宣布实施人类表观基因组计划,其目标是确认、分类和解释人类主要组织中所有基因在基因组水平的DNA甲基化模式,包括在基因组水平绘制不同组织类型和疾病状态下的DNA甲基化可变位点图谱。这项系统性的研究工作有望为深入认识人类基因组中DNA甲基化修饰的调控作用提供关键数据。
下面和读者介绍与 DNA 甲基化密切相关的一个概念——基因组印记(genomic imprinting),指的是因亲本来源不同而导致等位基因表达差异的一种遗传现象,DNA 甲基化正是基因组印记最重要的方式之一。为了解释印记对基因表达的影响,我们用图 15-50 来进行说明。假设某一基因座受到印记的影响,现将该基因座上杂合(Aa, 假设 A 对 a 显性完全)的一对小鼠进行自交。在两只亲本小鼠的体细胞中,由于印记的影响,a 等位基因被甲基化修饰,不能表达,而 A 等位基因不受甲基化修饰,可以正常表达,因此亲本小鼠的表型是野生型。而且,在这两只亲代小鼠的整个生命周期中,这种印记的方式不会发生改变,小鼠自始至终表现为野生型。但是,在生殖细胞发育的过程中,亲代原有的所有印记被去除,随后根据配子的亲本来源不同,基因被重新印记:所有雌配子中该基因座不被甲基化修饰,基因型有两种(去甲基化的A和a);所有的雄配子中,该基因座都被甲基化修饰,基因型也有两种(甲基化的A和a)。雌、雄配子结合,得到的 $F_{1}$ 小鼠可能有如下情况:当雌配子的去甲基化A和雄配子的甲基化a结合得到Aa型杂合子,由于A未被甲基化,所以表现为野生型;但当雌配子的去甲基化a和雄配子的甲基化A结合时,尽管也得到Aa型杂合子,但是由于A被甲基化,表现为突变型。当然,还会有AA和aa型组合,其中各有一个基因被甲基化,但并不影响它们的表型,分别为野生型和突变型。从这个例子中,我们看到,基因组印记不仅影响了基因表达,而且改变了孟德尔遗传的性状分离比(Aa杂合子的自交 $F_{1}$ 性状分离比为野生型:突变型=1:1)。
a; □ A; 甲基。
每个印记基因的印记均是在亲代生殖细胞形成的过程中建立的,并能在个体发育过程中维持不变,直至自身的生殖细胞形成时才被抹去,并根据亲本来源的不同重新建立新印记。印记这一术语本身的含义就是“记住”亲本来源的意思。我们看到,印记的存在使得基因组在一些基因座上成为了功能上的“单倍体”,在遗传过程中表现出了特殊的效应。尽管基因组中印记的基因只占个体基因组中的少数,但它们在个体发育和疾病发生中发挥了重要的作用。
我们先举一个个体发育的案例。小鼠的Igf2(insulin-like growth factor 2)基因和Igf2r(insulin-like growth factor 2 receptor)基因都是印记基因,两者共同调控胚胎的正常发育。Igf2父源性表达,Igf2r母源性表达,这种与亲本来源相关的特殊表达模式正是由DNA甲基化与基因组印记造成的。以Igf2基因为例(图15-51),在母源染色体上,Igf2基因邻近的绝缘子序列未被甲基化,因此可以结合特定的转录因子CTCF发挥绝缘子的作用,屏蔽了另一侧增强子对Igf2基因的转录激活作用,Igf2表达沉默。在父源染色体上,绝缘子序列被甲基化修饰,无法结合转录因子,丧失绝缘子的屏蔽作用,左侧的增强子转录激活Igf2基因的表达。
实验发现,由于印记的存在,亲本来源不同的突变等位基因诱导的小鼠表型也不同。如果小鼠缺失了父源 Igf2 基因而母源 Igf2 基因正常,会导致胚胎过小,但反过来,如果小鼠缺失了母源 Igf2 基因而父源 Igf2 正常,小鼠没有任何明显表型。仔细思考,这种表型的差异也是由于基因表达调控的不同造成的。除了 Igf2,Igf2r 的突变效应也是类似的。母源 Igf2r 基因缺失会造成胚胎过大,但父源 Igf2r 基因缺失没有明显表型,这是因为在印记的影响下,Igf2r 基因母源性表达。更加有趣的是,同时缺失父源 Igf2 基因和母源 Igf2r 基因的结果是胚胎发育回复正常,这提示了两基因产物之间存在相互拮抗的关系,而这种拮抗关系也是胚胎正常发育所必需的。
再举一个人类遗传病的例子。在人群中发现两类罕见的染色体缺失造成的疾病,患者同样是15q11-13区域的缺失,但表型有两种,临床上分别命名为普拉德-威利综合征(prader-willi syndrome)和安格尔曼综合征(angelman syndrome),前者的主要症状是神经发育迟缓、肥胖、肌张力低、手足小、性功能低下等,后者的主要症状包括严重运动障碍、神经发育迟缓、共济失调,以一逗就笑的特殊面容为特征。对病人进行遗传分析发现(图15-52),有且仅有缺失母源15q11-13区域可导致安格尔曼综合征,有且仅有缺失父源性15q11-13区域可导致普拉德-威利综合征,充分证明了这个染色体缺失区域存在多个受到基因组印记调控的基因,且它们存在不同的表达模式,如UBE3A基因遵循母源特异性表达,母源的UBE3A基因突变也会导致安格尔曼综合征。
除了染色体缺失、单亲二体型(uniparental disomy,即两条同源染色体或它们的部分片段仅来源于双亲中的一方)、印记缺陷,以及15q11-13内关键基因(如UBE3A)的突变也是普拉德-威利综合征和安格尔曼综合征的发病原因。
三、RNA干扰
RNA 干扰(RNA interference, RNAi)最早是在植物中观察到的。1990 年,一些研究人员向矮牵牛(Petunia hybrida)中转入紫色色素合成酶基因,希望能够让花朵更鲜艳,结果却使得矮牵牛花出现了褪色,花瓣几乎变成了白色(图 15-53)。进一步研究发现,细胞内部该基因 mRNA 降解速率大大提高,但机制不明,这一现象在当时被称为共抑制(cosuppression)。
1998 年, 法尔和梅洛等人首次将正义链 RNA 和反义链 RNA 混合注入线虫中, 发现只需要几个分子的双链 RNA 就能够完全阻断一个细胞内同源基因的表达, 并据此提出了双链 RNA 的 RNA 干扰作用。所谓 RNA 干扰, 指的是与靶基因序列同源的双链 RNA 所诱导一种序列特异性的转录后基因沉默现象。1999 年, 研究者进一步发现由双链 RNA 产生的小干扰 RNA (smallinterfering RNA, siRNA) 才是引起序列特异性 RNA 干扰的关键分子 (Hamilton 和 Baulcombe, 1999)。图 15-54 给出了 RNA 干扰的分子途径。
图 15-53 矮牵牛花中导入外源色素合成酶基因的结果(引自 Napoli 等, 1990)
(a) 野生型。(b) 转基因品种之一。
(a)
(b)
首先, 双链 RNA (double-stranded RNA, dsRNA) 经过核酸酶 Dicer 的加工后成为 siRNA。Dicer 属于 RNase III 家族, 能够特异识别和结合 dsRNA 并对其进行切割, 形成有功能的 siRNA。所有的 siRNA 具有一些共同特征: 全长 20~24 个核苷酸 (nt), 3’ 端具有 2 nt 突出的黏性末端和羟基, 5’ 端含有磷酸, 且 siRNA 的序列与靶基因之间具有高度同源性。siRNA 可以从 dsRNA 加工而来, 或者人工合成后直接导入细胞。siRNA 随后被组装到 AGO (Argonautes) 蛋白中形成 RNA 诱导的沉默复合体 (RNA-induced silencing complex, RISC), AGO 家族蛋白是一类内切核酸酶, 可以对靶序列进行切割。在 RISC 复合物中, siRNA 的双链发生解旋, 其中一条链被剔除或切割降解, 我们称为伴随链 (passenger strand), 而另一条链被保留下来, 被称为指导链 (guide strand)。接下来, RISC 中的指导链通过碱基互补配对的方式引导 AGO 蛋白识别靶 RNA, 并对其进行沉默抑制。部分 RNA 干扰作用有级联放大效应, 因此只需要少量 siRNA 分子就可以显著抑制靶基因的表达。
RNA 干扰现象在多种生物中存在, 是生物抵抗外源病毒, 抑制内源转座序列的重要机制。由于 RNA 干扰作用的特异性较好、效率高, 相应的实验技术已广为遗传学工作者使用, siRNA 药物研发也在近年来取得了突破性进展。
微 RNA (miRNA) 是能够引起基因转录后沉默的第二类重要 RNA 分子, 普遍存在于植物、线虫、果蝇、哺乳动物等多种真核生物的基因组中, 通过转录后基因沉默的机制调控动、植物生长发育和环境应答。
第一个 miRNA 分子 lin-4 是在线虫中发现的。lin-4 以不完全互补的方式与其靶 mRNA (lin-14) 的 3’ 非翻译区的特定区域相互作用,通过诱导 lin-14 mRNA 降解以及抑制蛋白质翻译,最终导致细胞内 lin-14 蛋白质的减少(图 15-53)。2000 年,又发现了第二个线虫 miRNA 分子 let-7。随后在多个物种中发现了 let-7 的同源基因以及更多的保守的或物种特异性的 miRNA,miRNA 才作为一种重要的表达调控机制引起了研究者的广泛关注。
与 siRNA 不同, miRNA 全部由基因组内源 DNA 编码产生, 基因组中蛋白质编码基因的内含子区、非翻译区、基因与基因间的间隔序列都可以产生 miRNA。以动物细胞为例, 从基因组中被 RNA 聚合酶 II 转录产生的 miRNA 基因产物被称为初级 miRNA (primary miRNA, primiRNA), 初级 miRNA 经过核酸酶 Drosha 的加工形成 miRNA 前体 (precursor miRNA, premiRNA)。miRNA 前体约含 70 nt, 呈茎环结构, 内部序列不完全互补配对。miRNA 前体随后在 Exportin-5 蛋白的协助下出核, 并在核酸酶 Dicer 的继续加工下形成成熟的 miRNA: 长约 22 nt, 3’ 端有 2 nt 突出, 类似 siRNA, 但内部序列不完全互补配对。
视频21 ncRNA介导的基因沉默
在细胞质中,成熟的 miRNA 在解旋酶的作用下打开双链,其中一条链被包装到 RISC 复合物中。miRNA 对基因表达调控的方式主要取决于它与靶 mRNA 的 3’ 非翻译区的匹配程度(图 15-55):如果 miRNA 与靶 mRNA 的互补配对序列较长,结合紧密,那么 miRNA 可以直接切割靶 RNA;如果 miRNA 与靶 mRNA 的互补配对碱基数较少(7~8个),结合松散,那 miRNA 可在接头蛋白 TNRC6(trinucleotide repeat containing adaptor 6)家族成员等的帮助下,缩短 mRNA 链的 poly(A)尾巴,降低 mRNA 稳定性,并抑制 mRNA 的翻译效率等。研究者们发现 miRNA 在不同物种中采用的主要途径有所不同,植物细胞中常见靶 mRNA 切割,而动物细胞中常见 mRNA 去 poly(A)尾巴和翻译抑制。迄今,人类基因组已发现 1800 余条 miRNA 编码基因,由于 miRNA 能够结合并调控不同的靶 mRNA,人类 miRNA 参与调节了基因组中的绝大多数 mRNA,与生长发育、环境应答、疾病发生等各种生命活动都密切相关。
除了 siRNA 和 miRNA, 能够发挥 RNAi 作用的还有第三类重要的 ncRNA——piRNA。我们曾在果蝇的转座元件 P 因子中提到过这类特殊的 RNA 分子, 它抑制了 P 品系果蝇的 P 因子在生殖细胞中的转座, 维持了 P 品系的稳定遗传。
2001年,研究者最早在果蝇中观察到一种较长的“siRNA”分子,可以调节雄性果蝇的生育力(Aravin, 2001),进一步研究发现这是一类全新的ncRNA,长度为 $21 \sim 35$ nt,特异性地与另一类AGO蛋白——PIWI蛋白质结合,因此被命名为piRNA。迄今,研究者在绝大多数动物中发现了活跃的piRNA及与其结合的PIWI蛋白质,它们在生殖细胞而非体细胞中发挥重要的调控作用:piRNA通过指导PIWI蛋白质特异性切割靶RNA,促进DNA甲基化和异染色质的包装。这条基因表达调控途径是动物细胞在演化过程中形成的一种序列特异性的抵抗外源病毒和内源转座元件的分子免疫机制,它有效保护了宿主基因组的稳定性。
四、lncRNA 与基因表达调控
上文介绍的具有 RNAi 作用的 ncRNA 分子都是长度较小的 ncRNA, 它们和其他长度小于 200 nt 的 ncRNA 一起, 可称为 sncRNA。而长度大于 200 nt 的 ncRNA 被定义为 lncRNA, 在结构和功能上更具有多样性, 在基因表达调控的多个层次都扮演了重要的角色。在高等生物基因组中,lncRNA 也主要由 RNA 聚合酶Ⅱ转录产生,含有 7-甲基鸟苷帽子和 poly(A) 尾巴,lncRNA 转录产物的种类接近甚至超过了 mRNA,逐渐成为 ncRNA 领域的另一研究热点。
第一个被发现的 lncRNA 是介导哺乳动物细胞 X 染色体随机失活的 Xist RNA。我们先和读者说明剂量补偿效应 (dosage compensation effect) 这一概念, 它指的是在 XY 性别决定类型的生物中, 性连锁基因在两种性别中有相等或近乎相等的有效剂量的遗传效应。即在雌性、雄性细胞里, X 染色体的编码产物在数量上相等或近乎相等。不同生物采用不同的剂量补偿策略: 果蝇通过增加雄蝇 X 染色体的转录活性实现补偿; 线虫通过降低雌雄同体个体的 X 染色体的转录活性实现补偿; 而哺乳动物则利用 X 染色体随机失活, 即雌性哺乳动物在胚胎发育早期, 细胞中的两条 X 染色体之一独立且随机地失去活性, 又称为莱昂作用 (lyonization)。失活的 X 染色体保持高度压缩的形式, 被称作巴氏小体 (Barr body) (图 15-56a), 在一些组织细胞中可见。观察巴氏小体也是常用的一种判断哺乳动物性别的简易方法。X 染色体失活的典型案例是玳瑁猫, 即三色猫。猫毛的白斑是由于皮斑基因 S/s 的作用, 纯合子 SS 的白斑分布范围广, 而杂合子 Ss 的白斑仅限于腹部和四肢。而猫毛的黑色与黄色是由X染色体连锁的另一对等位基因O/o决定的。O基因的表型是黄色,o的表型是黑色。一只Oo杂合雌猫,由于X染色体随机失活,体细胞中只有一条X染色体处于活性状态:有些细胞中,带有O基因的X保留了活性,细胞表现为黄色皮斑;另一些细胞中,带有o基因的X保留活性并表现为黑色皮斑。这就是三色猫的形成原因。
尽管人们在20世纪60年代就观察到了哺乳动物细胞的X染色体随机失活现象,但直至近年来遗传学家才逐渐揭示了其中的分子机制(图15-56b)。X染色体随机失活由X失活中心(X-inactivation center, Xic)调控,定位于Xq13,其中包含了lncRNA编码基因Xist。在发生失活的X染色体上,Xist基因转录活跃,Xist RNA包裹在X染色体上,并从Xic向染色体两端扩展,进一步招募组蛋白修饰蛋白诱发组蛋白修饰如H3K27me3等,关闭基因表达,促进染色质包装成浓缩态的异染色质,最终造成X染色体的失活。而在没有失活的另一条X染色体上,Xist基因的转录被阻断因子关闭,从而逃避了失活。
(a) XX 细胞中的巴氏小体。(b) Xist RNA 介导 X 染色体随机失活的基本过程。
随着 lncRNA 研究的深入,研究者发现 lncRNA 编码基因在高等生物基因组中广泛分布:有的位于编码基因之间的间隔序列中,有的位于内含子序列中,有的部分序列与外显子序列重叠,还有的分布在编码基因的反义链上等。与多样性分布特点相一致的是,lncRNA 的功能也呈现复杂多样的特点:lncRNA 几乎参与了基因表达各个层次的调控,能与基因组 DNA、mRNA、多肽发生相互作用,既可以直接在其转录位置附近发挥顺式调控作用,也可以反式作用于距离很远的基因。已有研究揭示 lncRNA 的分子机制主要分为 4 类(图 15-57):①充当诱饵(decoy)分子吸附 DNA 结合蛋白如转录因子,阻遏其对靶基因的调控作用;②充当支架(scaffold),促进多个蛋白质分子形成复合物,调控基因表达;③通过 RNA-DNA/蛋白质相互作用充当引导分子,将特定表达调控蛋白招募到基因组 DNA 的转录区域;④和增强子类似,利用染色质回环发挥引导作用,调节转录起始。
当下,ncRNA 及其所参与的基因表达调控无疑是生命科学领域最为活跃的研究热点之一,它
(1) 诱饵
(4) 增强子
重新阐述了生物学关键的基本概念(比如什么是基因)和基本规律(比如中心法则的遗传信息流动),引领了生命科学各个领域的发展。鉴于 ncRNA 在本书中多次出现,我们利用图 15-58 和读者们简单梳理一下本书中介绍到的主要 ncRNA 类型。和蛋白质编码基因一样,ncRNA 的表达也分为广谱表达和特异性表达。负责蛋白质翻译、RNA 加工的 rRNA、tRNA、snRNA 和 snoRNA 对于细胞正常生命活动是必需的,它们在各个细胞中广谱表达,可称为管家 ncRNA(housekeeping ncRNA)。而在这一节介绍的参与基因表达调控的一系列 ncRNA,它们自身的表达和功能也是相互适应的,具有时空和细胞类型的特异性,可称为调控 ncRNA(regulatory ncRNA)。调控 ncRNA 再根据大小分为 sncRNA 和 lncRNA。长度小于 200 nt 的 sncRNA 主要包括 siRNA、miRNA 和 piRNA,它们都是具有 RNAi 作用的小 RNA,参与转录后基因表达调控。而序列较长的 lncRNA 在 RNA 结构、基因组分布和调节功能等各个方面都更加多种多样,还有待系统深入的研究。随着高通量测序技术的飞速发展,ncRNA 的调控网络会逐渐清晰,新的 ncRNA 类型、新的功能、新的机制也会源源不断地进入我们的视线,帮助我们更好地认识遗传变异的奥秘。
习题
根据中心法则的内容,你能否大胆猜测:在生命早期,是先有 DNA,还是 RNA,又或是先有蛋白质?谈谈你的理由。
在 E. coli 中有如下一个基因序列(从转录起始位点开始,上游启动子序列未给出):
5’-GAGCAATATG TCAGAACTGC CATGCTTCAT ATGAATAGAC CTCTAGGATA A-3’
1 10 20 30 40 50
假如这是有义链的序列,请写出该基因的 mRNA 序列,并给出相应的多肽序列。
上题中, 如果所给序列分别发生了以下突变: ①第8位的A丢失; ②第28位的C之后添加了一个G; ③32位的T突变为A; 那么该基因将翻译成怎样的多肽序列?
请解释下列名词: $\sigma$ 因子、RNA 聚合酶、密码子、反密码子、操纵子、衰减子、普遍转录因子、特异转录因子、增强子、沉默子、绝缘子、基因座控制区、中介子、泛素、基因组印记、RNA 干扰。
通过本章的学习,你能否总结一下,原核基因表达和真核基因表达的异同点有哪些?
在分析转录因子的 DNA 结合域时, 我们发现绝大多数的 DNA 结合域都与 DNA 螺旋的大沟相互结合。请从 DNA 双螺旋的化学结构特征思考产生这种规律的原因。
请分析下列 E. coli 突变体中乳糖操纵子的表达情况:
| 基因型 | +葡萄糖+乳糖 | +葡萄糖-乳糖 | -葡萄糖+乳糖 | -葡萄糖-乳糖 |
|---|---|---|---|---|
| 野生型 | 关闭 | 关闭 | 开启 | 关闭 |
| lac $P^{-}$ (启动子突变,不能与RNA聚合酶结合) | ||||
| lac $O^{C}$ (操纵基因突变,不能与阻遏蛋白结合) | ||||
| lac $I^{-}$ (阻遏蛋白编码基因突变,无蛋白产物) | ||||
| lac $I^{S}$ (阻遏蛋白编码基因突变,产物不能被诱导物结合) | ||||
| $CAP^{C}$ (CAP蛋白编码基因突变,不依赖cAMP也能与启动子结合) |
- 大肠杆菌的色氨酸操纵子的结构如图 15-19 所示。其中,调节基因 trp R 编码阻遏蛋白,启动子基因 trp P 是 RNA 聚合酶的结合位点,操纵基因 trp O 可以与有活性的阻遏蛋白结合,关闭下游基因表达。结构基因 Trp E, D, C, B, A 依次编码和色氨酸合成有关的多肽。研究发现:① 当环境中缺乏色氨酸时,trp R 编码的阻遏物没有活性,不能与操纵基因结合;② 当环境中存在色氨酸时,trp R 编码的阻遏物与色氨酸结合,形成有活性的阻遏物,与操纵基因结合。请问:
(1)当环境中无色氨酸时,色氨酸合成相关的结构基因的转录状态是?当环境中添加色氨酸时,色氨酸合成相关的结构基因的转录状态是?
(2) 当 trp P 发生突变, 不能与 RNA 聚合酶结合, 该操纵子对环境中色氨酸的应答情况会发生怎样的变化?
(3) 当 trp O 发生突变, 不能与阻遏物结合, 该操纵子对环境中色氨酸的应答情况会发生怎样的变化?
(4) 研究发现, 在 trp R 缺失突变体中, 环境中存在色氨酸时, 色氨酸结构基因的转录水平是没有色氨酸时的 1/10 左右。造成这一现象的可能机制是?
果蝇 yellow 基因负责体表多处的色素合成, 包括翅、四肢、幼虫、刚毛等。野生型呈黑棕色, 突变型呈黄褐色。某同学发现了少数特殊的突变体果蝇, 它们仅在部分器官出现黄褐色变异, 其他器官正常。请分析可能的遗传机制, 并尝试设计实验进行证明。
试举例说明调控真核基因时空特异性表达的机制有哪些。
Igf2 基因隐性纯合突变(功能丧失型突变)雄鼠和野生型雌鼠杂交得到的 $F_{1}$ 发育出现障碍, 胚胎偏小, 但是 Igf2 隐性纯合突变的雌鼠和野生型雄鼠杂交得到的 $F_{1}$ 发育正常。请从遗传学角度对这一现象进行解释。
siRNA 和 miRNA 介导的转录后基因沉默有很多相似的地方,但也有显著不同,试对比分析二者的异同。
20世纪90年代初,一些植物研究人员通过向矮牵牛中转入紫色色素合成酶基因的方法进行花卉改良,希望转基因花朵更鲜艳,结果发现矮牵牛花出现了褪色,花瓣几近变成了白色。进一步研究发现细胞内部该基因mRNA降解速率大大提高,但机制不明,这一现象在当时被称为共抑制现象(co-suppression of gene expression)。请问这实际上是一种什么遗传机制?并简述它的作用过程与特点。
两个科学小组共同开展某一疾病的发病机制研究,通过对正常个体的细胞和患者细胞进行遗传分析他们获得了如下发现:
(1) 小组 A 发现在疾病致病基因的启动子区域的 CpG 岛出现超甲基化。请问什么是 CpG 岛?CpG 岛的超甲基化对疾病致病基因的表达会产生什么影响,并简述原因。
(2) 小组 B 发现患者细胞内一些靶向疾病致病基因的 miRNA 的表达被抑制。请问什么是 miRNA?miRNA 受到抑制会致病基因的表达产生什么影响,并简述原因。
- 研究者最先在线虫发育的基因表达调控中发现了第一个微RNA——lin-4。已知lin-4能调节早期发育调控基因lin-14。lin-14的蛋白质浓度是调节时序性发育的机制所在。在lin-14的功能缺失型突变(隐性突变)中,幼虫的部分发育阶段被跳过,产生早熟个体,而在lin-14的功能获得型突变(显性突变)中,早期幼虫的发育阶段被不断重复,造成了个体发育的延迟。请问:
(1) 已知微小 RNA 是非编码 RNA 的重要组成, 请问什么是非编码 RNA?
(2) 请再举两个非编码 RNA 的例子?(tRNA、rRNA 除外)
(3) 已知微小 RNA lin-4 可与发育调控基因 lin-14 的 mRNA 的 3’ 非翻译区不完全互补配对,请问微小 RNA lin-4 会如何影响靶基因 lin-14 的表达。
(4) 请推测 lin-4 基因的功能丧失型突变和功能获得型突变的表型效应,并简要给出理由。
- 研究者在随机诱变拟南芥时发现了一个叶形态的突变株, 进一步研究发现直接控制这一性状的结构基因 L 的编码区序列没有碱基序列的变化, 但是 L 基因的表达水平显著改变, 请列出不通过改变编码区碱基序列影响基因表达水平的 3 种可能因素, 并尝试详细说明这些因素的调控机制。
数字课程学习

在线自测 习题答案
第十六章 遗传分析策略 与方法
我们在前面的章节中介绍了一系列遗传学基本知识和理论,以及它们的发现历史和研究过程。细心的读者可能会发现,遗传学家在分析问题、解决问题的过程中采用了很多规律性的科学方法,而其中一些具有鲜明的遗传学特色,我们将它们称为遗传分析(genetic analysis)的策略与方法。在这一章,我们先简要介绍两种重要的模式生物遗传分析策略,再以人类遗传病/性状为研究对象,介绍单基因疾病/性状和复杂疾病/性状的不同遗传分析方法。
第一节 正向遗传学与反向遗传学
遗传学发展的早期,孟德尔利用豌豆揭示了遗传因子的分离和自由组合定律,而摩尔根利用果蝇揭示了基因在染色体上。二者的开创性工作有很多共同点:首先,都利用了模式生物来揭示生命的一般规律;其次,都从模式生物的表型变异入手,确切地说,是从一对相对性状入手。孟德尔研究的是红花与白花豌豆,摩尔根研究的是红眼与白眼果蝇。孟德尔假设不同的遗传因子决定了红花与白花的表型,摩尔根进一步证明存在于X染色体上white基因的突变与否决定了白眼或红眼,以此类推。总结这些研究方法的基本特征,不难看出,遗传学家们都是从具有相对性状的模式生物出发,利用它们的表型差异寻找其中的遗传机制。这就是正向遗传学(forward genetics)的思想雏形。
但是天然的相对性状并不容易获得,后来,遗传学家充分利用诱发突变这一技术,获得了很多突变品系,使得正向遗传学研究策略有了快速发展。当下的正向遗传学研究策略可以归纳为如图16-1:首先,选择合适的科学问题,例如我们想研究粗糙链孢霉某物质合成途径的遗传机制;接下来,对链孢霉进行随机诱变(如辐射等);第三步是关键步骤——目标表型的筛选,即仔细观察诱变后的哪些菌株符合目标表型,例如可用添加了各种氨基酸的选择性培养基检验哪些突变株不能合成某种氨基酸;最后,从这些突变菌株中确定突变基因的染色体位置以及它们的突变信息,进一步研究该基因的功能。基于这样一个基本研究步骤的遗传分析策略被称为正向遗传学,即通过生物个体或细胞的基因组的自发突变或人工诱变,首先寻找相关的表型或性状改变,然后从这些特定性状变化的个体或细胞中找到对应的突变基因,并揭示其功能的研究方法。简言之,正向遗传学是从表型出发,然后再根据具有特定表型的生物品系去鉴定基因型的一种策略。
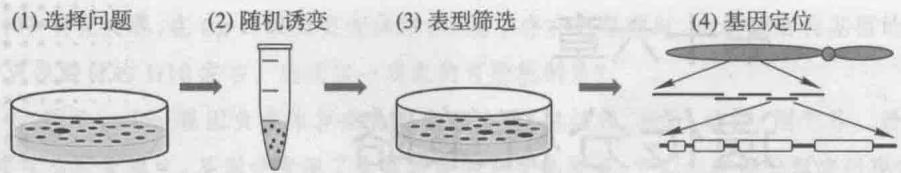
一、海德堡筛选
和读者介绍一个正向遗传学的经典研究案例:1979—1980年,福尔哈德和威绍斯在位于海德堡的欧洲分子生物学实验室,利用正向遗传分析策略对果蝇早期胚胎发育的遗传机制进行了全面分析(Nüsslein-Volhard 和 Wieschaus, 1980)。这项工作是第一次在多细胞真核生物上开展的诱变工作,打破了从单基因(突变)的角度去研究果蝇的研究思路。作为一次非常成功的大规模随机诱变筛选的代表性遗传分析工作,它被大家称为海德堡筛选(Heidelberg screening)。
福尔哈德和威绍斯选择了一个非常特殊的科学问题,即果蝇早期胚胎发育的遗传机制(其中的具体原因我们留到“遗传与个体发育”这一章再做介绍)。在确定了这个科学问题之后,他们首先利用EMS对果蝇进行随机诱变,我们在基因突变一章已介绍过EMS是一种带有活泼烷基的烷化剂,可造成碱基对的配对改变,实现基因诱变。具体诱变方案是给雄蝇喂食EMS,浓度为25 mmol/L,这个浓度可以使得每1 000个诱变精子中,任意一个基因均有一个突变(Lewis & Bacher, 1968)。研究的下一步是突变品系的培育,将诱变雄蝇与雌蝇交配得到 $F_{1}$ 。在随机诱变的作用下,各个 $F_{1}$ 果蝇在基因组某些位置携带不同的单拷贝基因突变(非致死的),将 $F_{1}$ 和野生型果蝇做单对杂交,可以得到携带相同突变的 $F_{2}$ 果蝇, $F_{2}$ 自交就能够在 $F_{3}$ 中得到各突变品系的杂合子和纯合子(图16-2)。
接下来是表型筛选, 观察 $F_{3}$ 的早期胚胎发育过程, 选择其中出现胚胎发育异常的个体, 对不同表型变化进行分类整理。在当时的筛选工作中, 他们发现有的胚胎丧失了体节的极性, 有的缺失了全部奇数或全部偶数的体节, 还有的丧失了连续好几个体节, 躯干上出现了大段缺失。最后福尔哈德和威绍斯一共收集了 600 个左右的突变体, 对这些突变体进行基因定位, 发现了约 120 个基因的不同突变, 这些基因也因此被证明是控制果蝇早期胚胎发育的主要基因。这项工作的影响力之大, 以至于在这之后的近十年中, 世界各地的果蝇实验室都在围绕他们发现的突变体和基因开展果蝇研究。更为重要的是, 调节果蝇胚胎发育的很多基因在演化中是非常保守的, 它们
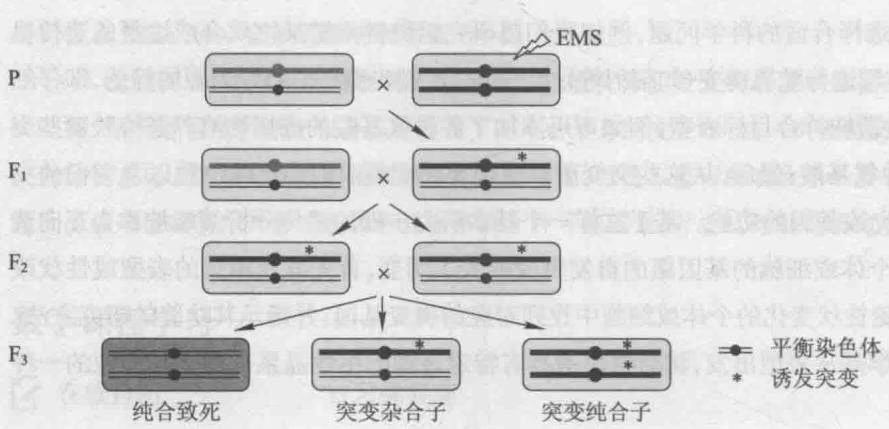
对亲代雄果蝇进行 EMS 诱变后,与携带平衡染色体的雌性果蝇交配。通过平衡染色体上的显性性状标记挑选出携带平衡染色体的 $F_{1}$ ,它的另一条染色体是随机诱变的染色体。将每只 $F_{1}$ 和携带平衡染色体的雌蝇进行交配得到携带相同突变的 $F_{2}$ 雌、雄果蝇,再自交得到 $F_{3}$ ,由于平衡染色体纯合致死,因此 $F_{3}$ 中,突变杂合子占 2/3,突变纯合子占 1/3。
也存在于人类基因组中,这些果蝇突变体为人类疾病/性状的机制研究提供了重要基础。关于这些基因如何调节果蝇胚胎发育,我们留到“遗传与个体发育”这一章再和读者们进行详细介绍。
二、正向遗传学的优点与局限
海德堡筛选这一经典案例是典型的从表型到基因型的正向遗传学研究方法。这种研究方法的优点显而易见:首先,随机诱变没有主观偏向性,基因组的任意基因都有被诱变的可能性。其次,相比于传统的一对一对相对性状的观察研究,正向遗传学可以在一次表型筛选中得到大量不同类型的突变体,易于在短时间内获得大量遗传研究素材。但在研究工作中,福尔哈德和威绍斯也发现这样的遗传学筛选可能会遗漏一些特殊类型的基因。第一类是我们曾在细胞质遗传中介绍的母体效应基因,这是一类由母体表达,积累在卵细胞质中指导胚胎发育的基因,因此,它的表型效应会延迟一代产生。另一类在筛选中无法获得的基因突变是纯合致死突变,但可以从后代的比例中发现端倪。遗传学家们设计了一系列方法来解决这些问题,例如母体效应基因的正、反交结果不同,有且仅有雌性纯合果蝇的后代会出现发育异常的表型(图16-3)。
但除此之外,正向遗传分析方法还存在一些固有缺点。例如,从理论上讲,随机诱变不可能诱变基因组的全部基因,诱变规模越大,只能越接近全部基因组。如果想研究小鼠等哺乳动物,由于它们的基因组庞大,随机诱变的研究成本将大幅上升。还有,在功能上存在冗余或多效的基因也不容易被筛选出。再次,遗传突变通常是不可逆、不可控的,活性无法按照研究者的愿望进行转换等。解决这些问题,就需要遗传学家开发新的遗传分析策略。
(a)
(b)
(c)
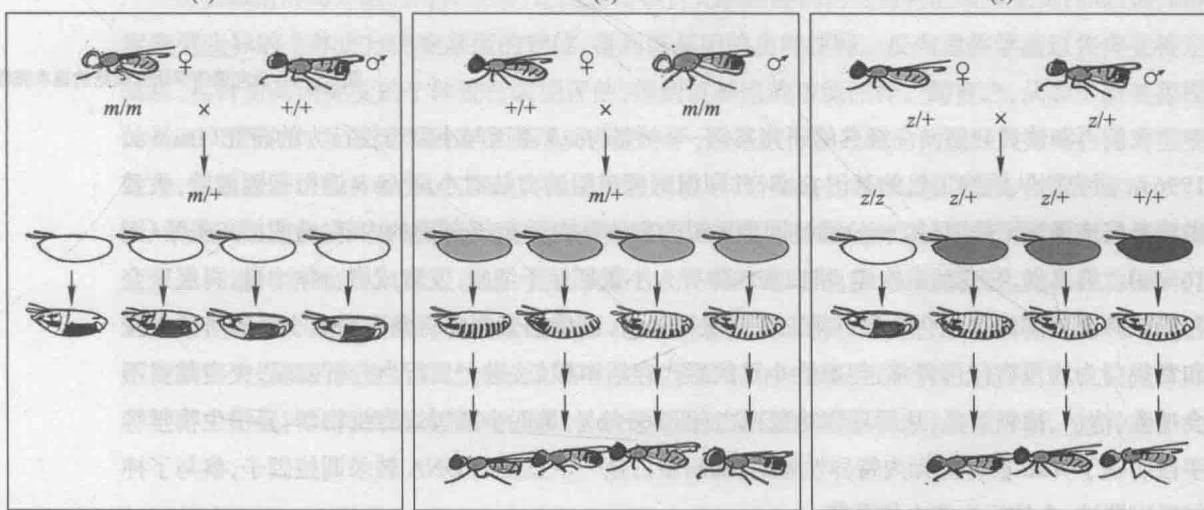
m 代表隐性突变的母体效应基因,z 代表隐性突变的合子基因,+ 代表两者相应的野生型等位基因。(a) 和 (b) 母体效应基因纯合突变果蝇与野生型果蝇的正、反交;(c) 合子基因突变杂合子自交。
三、反向遗传学
在 20 世纪 90 年代,随着分子生物学的发展,尤其是转基因技术和基因敲除技术的发展,遗传学家针对正向遗传学中不易解决的一些问题,设计了另一种从基因型到表型的遗传分析手段,由于恰好和正向遗传学的方向相反,我们称之为反向遗传学(reverse genetics)。它指的是,首先在生物个体或细胞内改变某个特定的基因或蛋白质,然后再去寻找有关的表型变化,从而揭示该基因或蛋白质功能的研究方法。
反向遗传学的基本步骤如图 16-4 所示, 第一步与正向遗传学相同, 也是先选择问题, 例如我们对植物叶子的不同形态感兴趣。第二步是选择想要研究的基因, 这一步是反向遗传学的重点步骤。研究者可以通过文献或基因数据库检索的方式尽可能地去寻找线索和目标, 最终锁定某个特定基因。第三步是针对目的基因进行突变或过量表达等, 突变可破坏内源性基因的生物学功能, 过量表达可以增加大量外源性基因的作用。最后是表型分析, 在对模式生物进行基因突变或过量表达之后, 观察叶子的形态是否出现了预期的表型变化。如果是, 可以获得该基因与叶子形态之间的生物学功能联系。
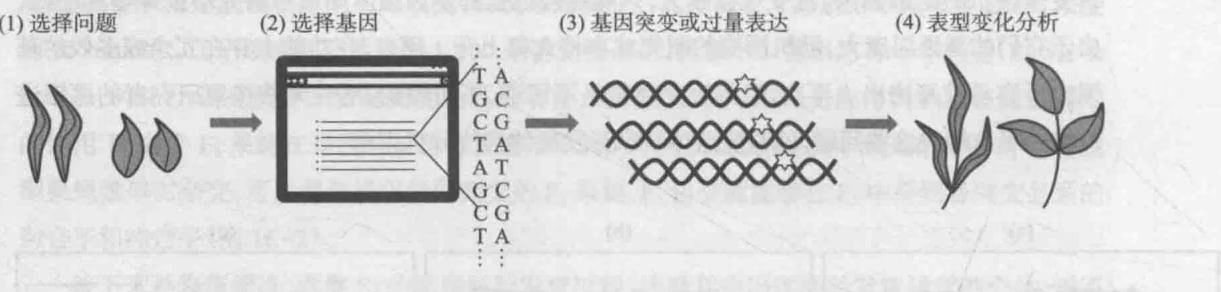
我们再和读者介绍一个经典的研究案例——小鼠fosB基因与小鼠母性行为的研究(Brown,1996)。研究团队挑选了目的基因fosB,并利用同源重组的方法对小鼠fosB进行基因敲除:大致做法是将选择标记基因(如neo)通过同源重组的方法替换到fosB基因的内部,造成插入失活(图16-5a)。第二步,突变品系构建,将突变载体导入小鼠胚胎干细胞,发育成嵌合体小鼠,再经杂交和标记筛选得到突变纯合小鼠。第三步是表型分析,系统的表型分析发现突变小鼠的个体发育和常规行为均没有任何异常,但雌性小鼠的后代存活率极低,进一步行为分析发现,突变雌鼠不会哺乳、清洁、招领幼鼠,从而导致幼鼠死亡(图16-5b)。第四步通过发育生物学、分子生物学等手段明确了fosB在神经元内特异性表达,编码蛋白是一个重要的DNA转录调控因子,参与了神经元可塑性、个体行为能力的调节。
结合 fosB 这个案例可以看出, 反向遗传学的最大特点是直接针对特定基因或基因家族开展遗传研究。20 世纪末, 随着体外和体内 DNA 操作技术的不断发展, 按照研究者的意愿对内源或外源 DNA 进行加工、突变、表达或编辑的技术日趋成熟。因此, 通过反向遗传学的手段对模式生物的所有已知基因进行逐个研究成为理论上可行的事情, 尤其是那些在正向遗传学方法中不易被诱变的基因可以通过反向遗传学方法进行有效的补充。
但反向遗传学研究也存在缺点。由于目的基因的信息全部来自资料检索与科学假设,因此
图 16-5 fosB 基因敲除小鼠的构建和表型
(a) 利用同源重组方法将选择标记基因 neo 与 fosB 基因的 2 号外显子(E2)进行替换。(b) 野生型母鼠在喂养幼崽(上), 突变型母鼠与死亡的幼崽(下)。
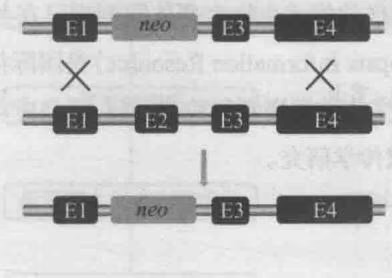
(a)
(b)
表型分析具有盲目性。事实上,在fosB研究最初,研究者观察了成年小鼠的各种行为能力,结果是无一异常,几乎要终止fosB的课题研究。直至最后,他们在偶然间发现雌性突变小鼠尽管产仔率正常但后代的存活率明显偏低,进一步仔细观察了哺乳、清洁、招领幼鼠的“母性”行为才发现了显著的表型变化。当下,表型筛选的风险不可控仍然是反向遗传学研究的难点之一。其次,在一般情况下,研究者只会按照实验条件和目的选择一种基因的突变策略,或者敲除或者过量表达等,也就是说一次只能制造一种显性或隐性突变,而不同的突变带来的表型效应可能不同,这也在一定程度上增加了研究的风险。第三,对模式生物全基因进行逐个诱变再进行全套的表型评估的研究成本非常高,且数据积累慢。
四、反向遗传学的改进
简要总结前面介绍的两种策略: 正向遗传学首先观察随机诱变得到的表型变化, 然后选择特定表型变异的个体进行突变基因的定位, 得到该基因的功能注释。反向遗传学通过先突变特定基因, 再针对基因突变的个体进行表型评估, 得到该基因的功能注释。简言之, 从表型到基因型的是正向遗传学, 从基因型到表型的是反向遗传学, 这是遗传学分析的两种经典策略。更为重要的是, 这两种方法各有利弊, 在解决实际问题的过程中, 需要综合考虑, 选择最为合适的方法。
近年来,随着模式生物全基因组随机诱变和基因定位技术的逐渐发展和完善,反向遗传学综合了正向遗传学的优点,通过改进,提高表型分析的效率和准确性,促进模式生物基因功能研究的数据积累。一些代表性的改进策略如图16-6所示,首先在模式生物(如拟南芥)中,利用随机诱变获得大规模的突变品系,然后先对各个突变品系中的突变基因进行准确定位,建立突变体库并进行生物保种。再根据研究者兴趣或目的选择特定基因的突变体进行表型分析。这种基于大
规模建库的反向遗传学改进方法非常有利于开展合作性研究,联合不同的研究团队对模式生物的基因组序列进行功能注释。今天,这样的模式生物突变体数据库已在各国研究者们的共同努力下不断发展,例如 TAIR(The Arabidopsis Information Resource)是国际拟南芥基因组数据库和拟南芥基因组注释系统,具有丰富的突变体数据资源和种子资源,研究者可以根据自己的意愿选择特定基因的特定突变直接开展反向遗传学研究。
视频 22
正向遗传学
与反向遗传
学
第二节 人类单基因性状的基因克隆
正向遗传学和反向遗传学研究策略在模式生物中得到了非常广泛的应用,也取得了丰富的成果。很多人类基因都在模式生物中存在相似的同源基因,随着模式生物遗传分析工作的不断积累,我们也将更好地了解人类生命与健康的遗传机制。与此同时,早期的人类遗传学家,尤其是医学遗传学家对人类性状的遗传分析也进行了不断的探索。20世纪初,加洛德提出了“一个突变基因一种代谢障碍”,揭示了人类单基因变异和性状变化之间的对应关系。认识疾病的遗传机制对人类健康的重要性不言而喻,遗传学家们先对简单的单基因疾病/性状进行了尝试。
一、功能克隆
对人类疾病 / 性状的遗传研究,首先需要做的是鉴定该疾病 / 性状的决定基因,完成基因克隆,并在此基础上了解致病性的变异信息。在 20 世纪 80 年代之前,遗传学家们常采用的疾病基因克隆的方法是功能克隆(functional cloning),这类研究手段是从疾病本身出发,首先收集患者的突变蛋白产物及其功能的信息,然后再对基因进行定位。从研究思路上,它类似正向遗传学的策略,先找表型(蛋白质)的线索,再找基因。
我们仍以镰状细胞贫血为例。本书已多次提到这一疾病,这是一种常染色体隐性遗传病,患者严重贫血,发育不良,关节、腹部和肌肉疼痛,多在幼年期死亡。那研究者是如何利用功能克隆的方法实现基因克隆的呢?
首先,由于在显微镜下可以发现患者的红细胞呈镰刀状,且对其中提取的血红蛋白进行电泳后发现迁移率改变(见图11-19),研究者很早就锁定突变蛋白为血红蛋白,并利用患者的血红蛋白开展功能克隆(图16-7)。研究者首先从血液样本中纯化得到正常人和患者的血红蛋白。这是功能克隆的关键步骤,由于血液样本容易获得,而且血红蛋白是红细胞的主要表达蛋白,分离很容易取得成功。接下来,利用氨基酸测序方法获得正常的血红蛋白和患者的血红蛋白的氨基酸序列,发现二者的β链之间存在一个氨基酸的差异,推断蛋白质突变发生在β链。利用正常血红蛋白的氨基酸序列反推可能的核苷酸序列,合成混合的DNA探针(根据密码子的简并性,将所有可能的DNA序列都合成并混合)。第三步,利用携带人基因组cDNA的大肠杆菌表达文库进行杂交实验,筛选能够与DNA探针结合的阳性克隆。由于表达文库中包含已知的人类蛋白质编码基因,能够与探针结合的克隆所携带的就是人类基因组中的血红蛋白β链编码基因HBB。最后,将克隆扩大化培养之后,提取其中的DNA,测定插入的外源序列,成功获得HBB基因的序列信息。
功能克隆在20世纪80年代之前解决了相当一部分疾病基因的克隆问题,它的优点是直接,基因和表型之间的功能联系较为明确,因为研究者是从突变蛋白入手的。但是,它的缺点也显而易见,因为遗传学家和临床医生都对遗传病的基因产物所知甚少,而且更重要的是,由于人体标本取材困难、蛋白质纯化技术水平有限,能够从人体内分离和纯化的蛋白质种类少,实验操作难度大,周期长。例如,很多研究者想从亨廷顿舞蹈病患者的脑组织中获得突变蛋白进行功能克隆,但遗憾的是,他们花费了几十年时间毫无所获。
但研究者们对人类疾病的探索并没有停止,随着遗传学的发展,尤其是连锁分析技术的推广,新的基因定位和克隆方法应运而生。
二、家系连锁分析
利用连锁分析可以对单基因遗传病的致病基因进行染色体大致位置的判断,这是遗传学家在人类医学遗传学中的一个重要发现。要理解其中的具体方法,我们先结合案例回顾一下前面连锁与交换的知识。
甲膑综合征(nail-patella syndrome)是一种常染色体显性遗传病,主要临床表现为指甲和髌骨发育不良。研究者很早就发现了甲膑综合征和ABO血型之间的特殊联系(Renwick & Lawler,1955)。在一个代表性甲膑综合征家系(图16-8)中,AB血型的患病父亲(Ⅱ-1)生育了
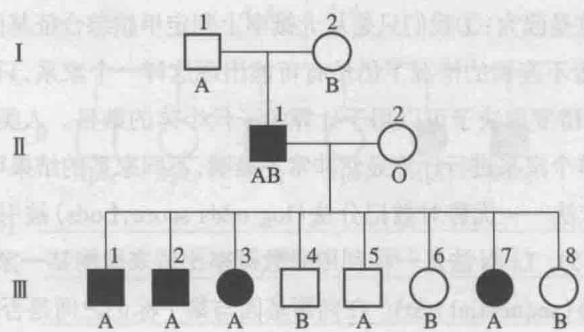
8个子女,其中所有的患病个体都是A血型,而B血型个体都是正常表型。那么是什么原因造成A血型和甲膑综合征之间出现了关联呢?值得注意的是,A血型显然不是造成甲膑综合征的直接原因,因为人群中A血型个体千千万万,他们中的绝大多数都没有患病,也就是说ABO血型和甲膑综合征之间不存在因果关系。那么是什么原因造成关联呢?遗传学家给出了正确答案——连锁,即ABO血型决定基因和甲膑综合征的致病基因在一条染色体上,它们是连锁的。家系中母亲(Ⅱ-2)是双隐性(npa i/npa i)个体,对子女的两种相关表型均没有贡献。父亲(Ⅱ-1)的基因型最可能的情况是Npa I $^{A}$ /npa I $^{B}$ ,即一条染色体同时携带了突变型的致病基因Npa和I $^{A}$ ,它们倾向于同时传递给子女,所以多数A血型的个体患病;而另一条染色体同时携带了野生型基因npa和I $^{B}$ ,所以多数B血型的个体正常。由于这个家系的婚配情况相当于测交,可以根据两基因之间的重组关系粗略计算致病基因和血型基因之间的遗传距离:全部测交子女中,只有一个男性个体(Ⅲ-5)例外,他是A血型个体,但表型正常,为重组体。那么根据重组率计算公式,可以得到重组率是12.5%(表16-1)。
表 16-1 甲膑综合征和 ABO 血型的连锁遗传
| II-1的配子II-2的配子 | Npa $I^{A}$ | Npa $I^{B}$ | npa $I^{A}$ | npa $I^{B}$ |
| npa i | Npa $I^{A}$ npa i | Npa $I^{B}$ npa i | npa $I^{A}$ npa i | npa $I^{B}$ npa i |
| 4亲组合 | 0+1重组合 | 3亲组合 |
通过这个案例可以看到,利用连锁关系可以进行未知疾病基因的定位:根据计算结果,甲胰综合征基因和 ABO 血型基因位于同一条染色体上(9 号染色体),而且两者之间相距约 12.5 cM,这就是一个粗略的基因定位过程。利用家系对人类单基因遗传病进行基因定位主要解决两个问题:①研究中的标记和致病基因是否存在连锁关系?②如果是,它们之间的重组率是多少?即致病基因和已知的标记之间相隔多少遗传距离?随着三代人类分子遗传标记的开发,遗传学家建立了利用分子遗传标记来实施精准基因定位的遗传分析方法。
三、优势对数记分法
在上述案例中,我们计算出了甲膑综合征基因和 ABO 血型基因之间的遗传距离,但 12.5 cM 这个数值还不够准确。这是因为:①我们只是从大概率上判定甲膑综合征基因和 ABO 血型基因更倾向于连锁,但是,两者不连锁的情况下仍然有可能出现这样一个家系,只是这种概率很低而已;②遗传学距离的计算精度取决于可以用于计算的子代个体的数目。人类家系与模式生物相比,个体数非常有限,用单个家系进行计算显然非常不准确,不同家系的结果可能相差甚远。
1955 年, 一种数学方法——优势对数记分法 (log odds score, Lods) 被引入了基于家系的人类连锁分析 (Morton, 1955)。Lods 法是一种利用对数概率比值来检测某一家系中有关遗传性状特定分布情况的序贯试验 (sequential test)。在判断基因与某个标记之间是否连锁时, Lods 值 (常用 Z 表示) 将在连锁情况下观察到实验数据的似然性与纯属偶然观察到相同数据的似然性进行比较, 计算公式如下:
1 | Z = \lg \frac {\text {两基因座连锁且相距} \theta \text {值所获得观察数据的似然性}}{\text {两基因座不连锁但获得观察数据的似然性}} |
实际操作中,首先选择合适的家系,要求是该家系中有杂合亲本和多个子代,可以观察杂合的性状/疾病和遗传标记在子代中的连锁互换情况。然后选择合适的Z公式,将0~0.5范围内的不同θ值代入,计算不同重组值下的Z值。最后,比较分析全部Z值,取Z值最大的一组数值作为θ和Z的估算值。根据最高Z值对连锁情况进行估计:Z>1时支持连锁,Z<-2时否定连锁,Z>3时肯定连锁,Z介于-2和3之间时需要增加家系材料来帮助判断。利用不具有亲缘关系的家系研究所获得的连锁数据可以综合起来计算Z值。因为不同家系中的连锁似然性是独立的,可以用这些数据的乘积来计算似然性。由于似然性取对数后得到Z值,因此不同家系的Z值可以相加得到总Z值,如果满足总Z>3仍然可以肯定连锁。最后,在肯定连锁的条件下,产生最高Lods值的θ值是最可能的重组率。
当下,研究者可以使用软件程序来选择合适的公式并计算 Z 值,我们在这里仅举一简单的家系模型来帮助读者们理解 Z 的基本计算方法。图 16-9 所示的是一个常染色体显性遗传病的家系,携带 $A_{1}A_{2}$ 遗传标记的母亲是个正常个体,而携带 $A_{3}A_{4}$ 遗传标记的父亲是个患病个体,他们婚配后生育了 6 个孩子,患病情况和遗传标记的携带情况如图所示。观察家系发现,3 个患病孩子都携带了从父亲那里继承的 $A_{3}$ 标记,而不携带 $A_{4}$ 标记,而在 3 个正常孩子中,有两个携带了父亲的 $A_{4}$ 标记,还有一个携带了 $A_{3}$ 标记。因此,我们可以作如下分析:如果 $A_{3}$ 标记和致病基因连锁,那么 6 个孩子中,有 5 个非重组个体和一个重组个体(Ⅱ-4);如果 $A_{4}$ 标记和致病基因连锁,那么 6 个孩子中,有 5 个重组个体和一个非重组个体。如果遗传率为 \theta ,那么在连锁的条件下,出现这一家系的概率是: \frac{1}{2}\left[\left(\frac{1-\theta}{2}\right)^{5}\left(\frac{\theta}{2}\right)^{1}+\left(\frac{1-\theta}{2}\right)^{1}\left(\frac{\theta}{2}\right)^{5}\right] ;而如果遗传标记和致病基因之间完全自由组合,那么出现这一家系的概率是 $\left(\frac{1}{4}\right)^{6}$ 。因此,Z 等于这两者比值的对数值。将不同的 \theta 值代入,得到 Z 值表。由于当 \theta 取 0.2 时出现 Z 最大值 0.323,因此不能够支持连锁,还需要更多的家系材料才能做进一步判断。
Lods 法通常需要两代或两代以上的家系,并且需要参考家系的婚配方式、疾病的遗传模式、外显率等条件进行准确分析和计算,因此它是一种以家系为基础的参数统计方法。20 世纪 70
(a)
(a) 一个假象的常染色体显性遗传病家系。(b) 根据该家系计算的 Z 值表。
(b)
| θ | 0 | 0.05 | 0.1 | 0.2 | 0.3 | 0.4 | 0.5 |
|---|---|---|---|---|---|---|---|
| Z | -∞ | 0.093 | 0.276 | 0.323 | 0.222 | 0.076 | 0 |
年代末到 90 年代初, Lods 法被广泛应用到了人类基因定位中, 包括囊性纤维化、亨廷顿舞蹈病在内的许多人类单基因疾病就是用这种方法进行粗定位的。
四、定位克隆
在遗传学家可以利用连锁分析和分子遗传检测技术将很多单基因疾病的致病基因在染色体上进行精确定位之后,定位克隆(positional cloning)技术应运而生。定位克隆指的是在没有任何疾病基因的功能信息的条件下,首先将遗传病的致病基因定位到染色体的特定位置上并获得基因序列,然后再对基因突变和疾病之间的联系进行分析的研究方法。上面讲述的家系连锁分析是定位克隆中的核心技术。
从研究思路上,定位克隆类似反向遗传学策略,先找基因,再研究基因和表型之间的功能联系。我们举个具体的案例介绍定位克隆的基本过程。在孟德尔遗传病中曾介绍过囊性纤维化,这是北欧和北美白人中最常见的致死性孟德尔疾病之一,发病率达到1/3 000左右。遗传学家很早就开始了寻找囊性纤维化基因的功能克隆,但是,由于无法获得突变蛋白,数十年没有进展。直至20世纪80年代,以徐立之(Tsui Lap-chee,1950—)为代表的遗传学家利用定位克隆的思路成功解决了这一难题。首先,研究者利用丰富的家系材料,对各个家系成员的全部分子遗传标记进行逐个分型,成功利用连锁分析方法将致病基因CFTR定位到7号染色体7q21-7q31之间(Tsui,1985),图16-10中所示的就是两个遗传标记A和B在两个代表性家系的连锁分析过程。为进一步缩小范围,他们在7号染色体上寻找了密度更高的遗传标记,再次进行连锁分析,进一步将CFTR的候选区域缩小到了7号染色体长臂上met基因与D7S8遗传标记之间大约1.6 Mb的区域(Tsui,1985)。
(a) 1号染色体上的遗传标记 $A$ 有1和2两种等位基因形式。在第一个家系中, $1/2$ 杂合子双亲生育了5个孩子,其中2个患者分别为 $1/1, 2/2$ ,基因型完全不同。第二个家系中, $1/2$ 杂合子双亲生育4个子女,3个患者分别是 $1/1, 1/2, 2/2$ ,也无规律可言。推论:CFTR和 $A$ 标记没有连锁关系。(b) 7号染色体上的遗传标记 $B$ 有3和4两种等位基因形式。在第一个家系中,双亲为 $3/4$ 杂合子,患病子女都是 $3/3$ ,正常子女都是 $4/4$ ;在第二个家系中, $3/4$ 杂合型的双亲有4个 $\mathrm{F}{1}$ 和2个 $\mathrm{F}{2}$ ,全部患病子代的基因型都是 $3/3$ ,正常个体的基因型是 $3/4$ 或 $4/4$ 。推论:7号染色体的遗传标记B与CFTR之间可能存在连锁关系。
这一候选区域内共有4个蛋白质编码基因,研究团队利用Northern印迹分别检测了它们在不同组织器官中的mRNA表达谱,结果发现有且仅有一个基因的mRNA表达谱与囊性纤维化患者的常见受累器官高度一致,即在胰腺、鼻息肉、肺、结肠、汗腺、肝等组织高表达(图16-11a),据此推断该基因为候选基因,最终成功克隆该基因,进行功能域的分析,发现它编码一个跨膜蛋白(图16-11b),负责物质运输,因此将该基因定义为CFTR,即囊性纤维化跨膜传导调节蛋白质编码基因(Riordan,1989)。最后,对比患者和正常人的CFTR基因,发现在患者中,常见的CFTR突变是3个碱基的缺失,这种缺失导致第508位的一个氨基酸发生丢失,但是由于这个氨基酸位于重要的跨膜结构域内,因此导致了蛋白质的转运功能产生缺陷。
囊性纤维化是人类历史上第一个通过定位克隆策略成功完成基因克隆的疾病。从这个案例中,我们可以简单总结一下定位克隆的技术路线(图16-12)。首先是收集大量的家系材料,分析疾病的遗传特征。然后,利用覆盖度尽可能广的多态性遗传标记对疾病基因进行染色体初步定位,锁定染色体编号和大致位置区域。再次,在候选区域中使用高密度的遗传标记进行精细定位,缩小候选区域的范围。在这两步中,需要对家系中的成员进行遗传标记的基因分型(常采用PCR技术或芯片技术等),利用家系连锁分析等方法分析遗传标记和疾病之间的连锁关系。接下来,利用基因组的图谱信息和序列信息,在最终的候选区域中寻找编码基因并根据功能进行筛选,确定基因。最后,利用家系中的患者和正常个体进行靶基因测序,找到关键的基因突变,最终获得基因序列和突变信息。
随着囊性纤维化基因的定位克隆大获成功,定位克隆技术迅速发展起来,1990年完成了肾母细胞瘤、I型神经纤维瘤、无脉络膜病的定位克隆;1991年完成了脆性X染色体、家族性结肠息肉、Kallmann综合征的定位克隆;1992年,1993年,逐年增加。值得一提的是,定位克隆在1995年后几乎完全替代了功能克隆的地位。这个历史时期恰恰是人类基因组计划刚开始推进的阶段,公共测序领域正在如火如荼地开展遗传图谱和物理图谱的绘制。事实上,当时先推进图谱绘制的目的不仅仅是为了方便后续的基因组序列拼装,另一个具有重大意义的目的是服务于人类单基因疾病基因的定位克隆,这是人类基因组计划和遗传分析方法对全人类的健康做出的巨大贡献。
视频23定位克隆
第三节 复杂疾病易感基因的筛选
尽管连锁分析能帮助解决遵循孟德尔遗传的单基因疾病的基因定位,但是大多数人类疾病并不是单一基因作用的结果,而是多基因和环境因素之间复杂相互作用的结果。我们把这类疾病定义为复杂疾病/性状(complex disease/trait)。复杂疾病的基因定位不同于单基因疾病,不同疾病不同遗传材料应采用不同的研究方法。我们在这里向读者们介绍21世纪初在国际上掀起研究浪潮的一种复杂疾病遗传分析方法——全基因组关联分析(genome-wide association study, GWAS),重点说明它的关键原理和基本方法。
一、复杂疾病
复杂疾病 / 性状是相对于单基因疾病 / 性状而言的, 它的遗传方式属于非孟德尔遗传, 符合我们在前述章节介绍的数量性状的遗传特点, 受到很多基因以及环境因素的影响, 也称为多因素遗传 (multifactorial inheritance)。复杂疾病 / 性状遗传模式的很多特点决定了我们无法按照定位克隆的思路对它进行遗传机制的研究。首先, 复杂疾病受到很多基因的共同影响, 且每个基因的作用微弱。其次, 每个基因的外显率低, 即拥有特定基因型的个体也可能不表现出预期性状。再次, 环境因素对复杂疾病的影响较大; 例如, 遗传因素对原发性高血压的影响占 $30% \sim 50%$ , 其余部分则是环境因素的作用结果。最后, 尽管复杂疾病的群体发病率高, 但群体中的每个个体的发病机制往往互不相同, 不同基因座位的非等位基因组合可以产生相似的疾病表型, 即遗传异质性 (genetic heterogeneity) 高。与此同时, 一些复杂疾病在临床上还存在表型异质性 (phenotypic heterogeneity), 相同疾病的患者的临床表现并不相同, 这与疾病的发生机理、临床诊断方法和水平等都有关系。
典型的复杂疾病/性状包括我们熟悉的身高、肤色、糖尿病、原发性高血压、心血管疾病、精神疾病、肥胖等。由于复杂疾病在人群中的发病率较高,因此也被称为常见疾病(common disease)。这些疾病/性状有遗传倾向,患者亲属的发病率要高于无关群体的发病率;但单基因的作用非常微小,发病风险受到多基因和环境的综合影响,患者所在家系中观察不到明显的孟德尔分离比例。由于影响复杂疾病的每一对等位基因的作用通常都是微效的,单独的这些基因并不能直接导致疾病的发生,而是赋予个体疾病的易感性,因此我们将这些基因称为复杂疾病的易感基因(susceptibility gene)。复杂疾病/性状的遗传分析就是要寻找和定位这些易感基因,并评估它们的风险等位基因形式。
二、关联分析
在介绍如何进行复杂疾病易感基因筛选之前,我们先说明一种新的遗传分析方法——关联分析(association analysis)。关联分析其实是一种数学方法,在复杂疾病/性状的遗传分析中,关联分析特指的是评判特定的分子遗传标记或特定环境暴露因素等,是否伴随着某疾病/性状表型一起出现的统计分析手段。例如,某地区调查研究显示,在重度吸烟的男性中,肺癌的发病率约每10万人中49人,但在不吸烟的男性中,发病率仅为每10万人3人。这些数据提示,吸烟这一环境因素伴随肺癌出现,可以描述为吸烟与肺癌存在关联(也请读者特别留意,即使是在重度吸烟的男性中,每10万人中的99 951人未罹患肺癌,吸烟和肺癌之间不能描述为因果关系)。
关联分析是基于群体数据的一种统计学分析,根据数学计算的显著性程度来评判有无关联。如果存在关联,它表示分子遗传标记的等位基因类型与疾病/性状表型是共发生的,即没有统计学上的随机独立性。但特别强调的是,存在关联并不意味着存在因果关系(例如上述的肺癌和甲膑综合征),关联也并非一种特殊的遗传学现象。
在复杂疾病 / 性状的关联分析中, 统计计算本身可能存在分析错误造成关联的假象, 需要校正和检验, 除此之外, 多个常见的生物学原因会导致分子遗传标记和疾病 / 性状表型关联。例如, 真正的直接原因, 即分子遗传标记恰好是落在该复杂疾病的易感基因内部, 可以增加患者的发病风险; 又如, 祖先基因突变和自然选择, 患有复杂疾病的祖先们在染色体其他位置恰好携带了某个分子遗传标记, 且在自然选择中被保留了下来; 再如, 群体分层, 某种疾病 / 性状和某分子遗传标记均常见于某个人群的亚群中, 比如不同种族、不同民族等。
除了上述原因,另一类造成分子遗传标记与疾病/性状关联的重要生物学因素是连锁不平衡(linkage disequilibrium, LD),又称等位基因关联(allelic association),它指的是人群中不同基因座上的非等位基因位点之间存在的非随机关联现象。假设两个基因座位分别有等位基因A、a和B、b,那么,在群体中可能有4种类型的非等位基因组合,即AB、ab、Ab和aB。如果两个等位基因(如A和B)同时出现的概率 $(P_{AB})$ 等于两个等位基因单独出现概率的乘积 (P_{A}\times P_{B}) ,即 P_{AB}-P_{A}\times P_{B}=0 ,则说明两个非等位基因的出现是独立的,相互没有关联,我们称之为连锁平衡。相反,如果发现某两个非等位基因出现了 |P_{AB}-P_{A}\times P_{B}|>0 ,那就意味着两个非等位基因之间存在一定的关联,倾向于共同出现 (P_{AB}-P_{A}\times P_{B}>0) 或者互斥出现 (P_{AB}-P_{A}\times P_{B}<0) ,我们称之为连锁不平衡。复杂疾病关联分析的真正目标就是要找到与疾病/性状易感基因之间存在连锁不平衡的分子遗传标记,只要找到了这些标记,就能帮助遗传学家定位疾病/性状易感基因。
但是,为什么遗传学家认为可以通过连锁不平衡造成的关联来寻找复杂疾病易感基因呢?为了回答这个问题,我们需要重新审视一下什么是人群。人群指的是没有血缘关系(亲缘关系)
的人的集合,是与家系相对的概念。但是,如果将人类历史上溯百年、千年甚至万年,原先没有血缘关系的人也会拥有或近或远的共同祖先。随着世代繁衍,一次次的减数分裂把祖先染色体上位置较远的连锁基因不断交换出去(也可能再次交换进来),非等位基因间的组合关系发生了很多变化(图16-13a)。但在遗传距离足够小的区间内,由于重组事件的发生概率低,紧密连锁的非等位基因之间仍然保留了祖先染色体的原始单倍型组成(如图16-13b中遗传标记4与易感基因)。这就是我们能够在“没有血缘关系”的人群中观察到非等位基因之间的连锁不平衡的原因,存在连锁不平衡的非等位基因在人群的遗传过程中不是相互独立,而是共分离的。
可见,若某一遗传标记与疾病/性状易感基因距离较远,则它们在向子代传递时容易发生分离,若干世代积累之后,在新的人群中观察这个遗传标记和疾病/性状,会发现两者相互独立;反之,若某一遗传标记与易感基因距离较近,在向子代传递时不容易发生分离,若干世代积累之后,在新的人群中,由于遗传标记和易感基因之间存在连锁不平衡,遗传标记往往会伴随着疾病/性状共同出现,即发生关联。这就意味着,如果找到了和疾病/性状关联的分子遗传标记,就很可能在该分子遗传标记所在的连锁不平衡区域内发现疾病/性状的易感基因。
(a)
(b)
图16-13 连锁不平衡的形成原因
(a) 祖先染色体通过反复重组可以将位置较远的等位基因交换出去。(b) △表示复杂疾病/性状的某易感基因所在位置,▲表示染色体上的7个遗传标记。其中,遗传标记4和易感基因的位置足够近,两者在现代人类染色体中保留了祖先染色体的原始单倍型组成。
三、关联分析中的遗传标记
由于连锁不平衡的出现需要足够低的重组概率,因此想要发现能与疾病/性状存在关联的遗传标记,就需要遗传标记在染色体上的密度、覆盖度都足够高,位置准确,而且多态性足够好。怎样的标记才能满足这些要求呢?联系我们在连锁分析和基因组计划中介绍的内容,不难想到,在基因组中广泛分布的SNP是遗传学家的不二选择。一方面,SNP是人群遗传差异的主要来源之一,数量大、分布广。另一方面,以寡核苷酸杂交为基础的DNA芯片技术易于实现自动化批量检测,且可用计算机分析结果。
1997年,时任人类基因组计划首席执行官的美国遗传学家科林斯提出了“常见疾病,常见变异”(common disease, common variant, CD-CV)的假说,认为人群中常见疾病的易患性和抗药性是由于人群中基因组某些基因座的常见变异引起的,其中编码区和调控区的SNP对疾病尤为重要。这也是在人类基因组计划之后,国际遗传学家合力推进以SNP的基因分型和图谱绘制为重心的人类单倍型图谱计划和千人基因组计划的重要原因。因此,采用SNP作为关联分析的遗传标记,不仅容易发现连锁不平衡信号,而且也可能发现直接参与调节疾病易感性的SNP。
当上述的关联分析理论和相应的统计分析方法、人群遗传变异数据和 SNP 分型技术都发展成熟之后,利用关联分析筛选复杂疾病 / 性状的遗传易感因素的研究项目如雨后春笋般地出现在全球各个研究机构,推动了人类遗传学的发展。
四、关联分析的基本方法
我们再向读者们介绍几种常见的利用关联分析筛选 / 鉴定复杂疾病 / 性状易感基因的具体实验方法(图 16-14),以便大家对关联分析有更直观的认识。
第一种称为病例对照研究(case control study)(图 16-14a),研究者通过直接比较患者群体和正常群体两组群体中某遗传标记等位基因型频率的差异,经统计分析是否具有显著差异。如果有,则认为此位点同疾病相关联;反之,否定该位点。
我们以2型糖尿病为例,研究者已经通过关联分析等方法已发现数十个2型糖尿病的易感基因,其中TCF7L2基因内部的SNP——rs7903146(T/C),被证明是2型糖尿病最为重要的风险因子之一(Grant,2006;The Wellcome Trust Case Control Consortium,2007)。如表16-2所示,在病例组中,rs7903146位点CC纯合子、TC杂合子和TT纯合子的频率分别为 $38.5%$ 、 $48%$ 和 $13.5%$ ;而对照组中,这3个频率分别为 $47.4%$ 、 $43.8%$ 和 $8.8%$ 。首先根据基因型频率分别计算实验组和对照组的等位基因频率,结果如表16-3所示, $C$ 、 $T$ 两个等位基因类型在糖尿病人群中的等位基因频率为 $62.5%$ 和 $37.5%$ ;而它们在正常人群中的频率为 $69.3%$ 和 $30.7%$ 。由于是否2型糖尿病和等位基因类型都属于二分类变量,且数据量较大,可采用简单的卡方检验评估两者关联与否。
表 16-2 TCF7L2 基因内部 rs7903146 位点的不同基因型在糖尿病人群和正常人群中的频率(参考 Groves, 2006)
(a) 病例对照研究。(b) 队列研究。
(c) 回顾性研究。
| 基因型 | CC(n;%) | TC(n;%) | TT(n;%) |
|---|---|---|---|
| 糖尿病人群 | 771;38.5% | 960;48.0% | 270;13.5% |
| 正常人群 | 1 175;47.4% | 1 084;43.8% | 217;8.8% |
表 16-3 TCF7L2 基因内部 rs7903146 位点的不同等位基因类型在糖尿病人群和正常人群中的频率
| 等位基因 | C(n;%) | T(n;%) | 合计(n) |
|---|---|---|---|
| 糖尿病人群 | 1251;62.5% | 750;37.5% | 2001 |
| 正常人群 | 1717;69.3% | 759;30.7% | 2476 |
$\chi^{2}=\sum\frac{(O-E)^{2}}{E}=23.083$ ; 自由度为 1; P<0.001
结果显示 P 值显著, 即 TCF7L2 基因内部 rs7903146 位点的等位基因类型和 2 型糖尿病之间存在关联, 且 T 是增加风险的等位基因类型, C 是保护类型。根据这些数据, 可以进一步计算 3 种基因型之间的比值比 (odds ratio, OR) 评估关联强度, 结果显示, 杂合子 TC 相对于 CC 型的
2型糖尿病风险提升至 $\frac{\frac{960}{1084}}{\frac{771}{1175}}=1.35$ 倍,纯合子TT相对于CC提升至 $\frac{\frac{270}{217}}{\frac{771}{1175}}=1.90$ 倍。
从上述案例中可以看出,病例对照研究的优点是样本易于获得,基因分型工作量小且易于操作,而且这种方法有较高的检出效能。但这种分析方法也容易掺入混杂因素,造成虚假的联系,需要选择严格的对照组,优化统计分析方法,并选择独立的其他人群做更多的检验。
第二种常用的关联研究方法称为队列研究(cohort study)(图 16-14b)。将人群按照遗传标记频率或者是否暴露于某环境因素进行分组,追踪各组疾病发生的情况,是一种通过比较不同组之间的差异,分析遗传标记或暴露因素与疾病的关联程度的前瞻性的研究方法。这种方法和病例对照有所类似,又有所不同。队列研究是一种时序性的研究,关联的可信度更高,但是这种研究方法时间长,耗费也高。
第三种常用的关联研究方法称为回顾性研究(retrospective study)(图 16-14c)。根据研究对象在过去某个时间点的特征或暴露因素进行入选和分组,然后从已有的记录中追溯从过去到未来某个时间点或研究当下为止的这一段时间内,研究对象的疾病发生情况。回顾性研究相当于从过去某个时间点开始的前瞻性研究,但实际上是在调查过去的既定事实,是一种从“果”到“因”的研究。
这 3 种常用的关联分析方法在实验设计上截然不同,对样本的要求不同,结果的可信度也不同。在实际应用中,研究者应充分考虑人群样本的特点、疾病研究的现状,以及项目的研究目标,选择最合适的研究方法。
五、全基因组关联分析
病例对照研究、队列研究和回顾性研究是对不同人群样本设计的不同关联分析方法。关联分析还可以根据选取的分子遗传标记的不同范围,分为基于候选基因区域的关联分析与基于全基因组遗传标记的全基因组关联分析。早期的关联分析通常是基于候选基因的,这些候选基因或是来自家系连锁分析的候选基因,或是在其他实验中提示的易感基因等,对这些特定基因进行人群基因分型和关联分析可以比较快捷地筛选复杂疾病的易感因素。但是,基于候选基因的关联分析带有一定的盲目性和局限性,如果候选区域存在错误或遗漏,会直接影响关联分析的结果和数据质量。
随着单倍型计划和千人基因组计划在全基因组范围进行了 SNP 分型和图谱绘制, 全基因组关联分析的可行性不断上升, 该方法是对群体进行全基因组范围的扫描, 测定全部可能的疾病关联基因变异和单核苷酸多态性。
2005 年,第一项标志性全基因组关联分析成果——年龄相关性黄斑变性的易感基因筛选结果发表。项目共召集了 96 个病例和 50 个对照,完成了覆盖全基因组的 116 204 个 SNP 的分型,最终筛选到了位于 1 号染色体的 CFH 基因内含子的一个多态位点与疾病之间存在强关联。这项工作不仅为年龄相关性黄斑变性疾病的遗传机制研究和发病风险预测提供了重要参考,更开启了全基因组关联分析的研究热潮。截至当下,全基因组关联分析在数百种复杂疾病的研究中都取得了重要成果,研究者将这些数据中找到的易感基因标注到染色体上,便于全球研究者们查询和使用。
尽管全基因组关联分析在复杂疾病遗传分析中积累了大量数据,这种研究方法也存在一些明显的不足。首先,全基因组关联分析所应用的统计学方法有一定的假阳性,需要大样本、多人群的独立重复验证才能找到真正连锁不平衡的遗传标记。其次,作为一种统计学方法,关联分析在筛选疾病易感基因时存在一定的局限,与疾病强关联的很多遗传变异或通常只是疾病发生的“标签”,而不是疾病发生的“原因”,真正的易感基因还需要借助其他手段进一步明确其在染色体上的真正位置。此外,在确定了真正的遗传变异因素之后,阐明遗传变异与复杂疾病之间的功能联系的研究工作任重而道远。第三,“常见变异,常见疾病”只是复杂疾病的一种遗传机制。随着人类遗传疾病的研究更加深入,我们越来越清楚地认识到并不是所有复杂疾病的遗传机制都符合这条规律。全基因组关联分析研究仅能解释高频的遗传变异在复杂疾病中的潜在作用,中低频的遗传变异在人类遗传疾病中的角色和筛选方法还有待于其他的研究手段与方法去解决。
六、连锁与关联的区别与联系
结合连锁交换一章与本章的知识,不难发现,单基因遗传疾病/性状的连锁分析和复杂疾病/性状的关联分析之间有着明显区别:连锁是遗传标记和疾病/性状决定基因之间的遗传学关系;而关联是遗传标记和疾病/性状表型之间的统计学关系。连锁分析通常用于罕见突变引起的单基因遗传病的基因定位,需要丰富的家系材料;而关联分析适用于复杂疾病的易感基因筛选,需要较大的人群样本。但连锁和关联之间也有着重要内在联系:群体中的关联现象很可能是遥远的共同祖先的某个遗传标记与易感基因之间的紧密连锁造成的,随着世代的传递,只有遗传距离足够近的位点之间的连锁不平衡关系才能在群体中保存下来。本章的最后,请读者们思考:如果某一遗传标记和易感基因连锁,那么它们一定关联吗?反过来,如果假定某一遗传标记和易感基因关联,那么它们一定连锁吗?
习题
什么是正向遗传学分析策略?请简述它的分析步骤。
什么是反向遗传学分析策略?请简述它的优点和缺点。
研究者在进行果蝇遗传诱变筛选时发现了一类特殊的常染色体隐性纯合突变雌果蝇,它本身表型完全正常,但当它与野生型雄果蝇杂交时,受精卵均不能正常发育成为幼虫。请问:该基因很可能属于哪类胚胎发育相关基因(请简要给出理由)?你推测这类基因的基本特点是什么?
美国中西部草原上的草原田鼠(Microtus ochrogaster)遵循一夫一妻制,雄性和雌性的草原田鼠之间有很强的依赖关系,雄性田鼠会向家里运送食物并照顾小鼠。草原田鼠的近亲草甸田鼠(Microtus pennsylvanicus)遵循一夫多妻制,雄性仅在发情期与雌性在一起,不负责照顾妻儿。研究者推测田鼠的中枢神经系统中加压素受体基因(V1aR)的表达与田鼠的“婚姻观”存在密切联系。同时,他们发现,草原田鼠的V1aR表达水平远高于草甸田鼠,但是这个基因的编码区在两种田鼠中没有显著差异,仅在草原田鼠的V1aR基因上游多出了一段428 bp的DNA元件。请问:
(1) 如何解释两种田鼠中 VlaR 基因编码区序列没有差异, 但表达量显著不同?
(2) 请你利用反向遗传学的分析策略, 简要设计一个实验方案, 检验 V1aR 的表达水平是否与田鼠的“婚姻观”有关。
假如你在临床上收治了一位患有罕见孟德尔遗传病的患者。调研发现,有关该遗传病的研究甚少,致病基因、发病机制和防治方法均不明确。请你利用本章所学知识,设计一个定位克隆的研究方案,寻找致病基因。请简要写出你的研究策略与大致步骤。
下图给出的是一个神经母细胞瘤家系, 研究发现该家系的发病原因是由 NF1 基因的突变造成的, 且该突变基因在家系中遵循显性遗传。研究者利用连锁分析发现了一个和 NF1 基因紧密连锁的 RFLP 多态位点, 并进一步用 Southern 印迹的方法分析了家系中该 RFLP 位点的多态性, 结果如图所示。请问:
(1) I-1个体中NF1突变基因最可能位于4.7kb片段所在染色体还是3.0kb片段所在染色体上?
(2) 按照上一题的推测,该家系中的重组类型个体最可能是哪(几)个?请简述原因。
(3) 请根据此家系粗略估算 NF1 基因和该 RFLP 之间的遗传距离。
探针
为什么说定位克隆的研究方法不适用于多数复杂疾病/性状遗传机制的研究?
什么是连锁不平衡?为什么连锁不平衡的存在是进行复杂疾病关联分析的基本条件?
关联分析中的常用遗传标记是什么?研究者为什么选择这类标记用于遗传分析?
请简述连锁分析和关联分析的区别与关系。
数字课程学习
在线自测
习题答案
第十七章 遗传与个体发育
受精卵是一个细胞,从一个细胞长成一个胚胎,最后长成一个成熟的个体,这就是个体发育的简单定义。个体发育依赖于连续不断的细胞有丝分裂,在每一次的有丝分裂过程中,复制后的染色体均等地分给两个子细胞。如果不考虑体细胞中低频率的基因重组和突变,从一个受精卵长成为一个新个体,每个体细胞中的基因都是等同的,但不同组织器官之间,细胞的结构与功能均不相同。通过前面多个章节的学习,我们知道不同物种之间、同一物种的不同个体之间的差异可以用遗传差异来说明,那么同一个体中细胞与细胞之间的差异该如何解释?在个体发育的过程中,核基因组、细胞器基因组以及细胞质积累的母体基因产物是如何协同作用的?为了回答这些问题,我们将在这一章中从遗传学角度,或者说是基因的角度,重新认识个体发育。
第一节 个体发育的一般模式
个体发育的一般模式包括受精、卵裂、图式形成、形态发生、细胞分化和生长5个基本过程。不同动物的个体发育基本都包括了这些过程,但这些过程并不相互独立、严格区分,而是相互交叉或更替的,发生的时间和方式也会因物种而有所不同。我们在此仅以少量代表性模式生物为例进行简要介绍,推荐读者选择相关的书籍进行胚胎发育学的专题学习。
一、受精
进行有性生殖的生物的雌配子经过受精(fertilization)成为合子,即受精卵。但生物的个体发育早在受精卵形成前就开始了。受精以前已完成减数分裂的卵细胞的细胞质中积累了由母本基因决定的物质,不仅提供了合子发育所需的营养(如卵黄),而且还蕴藏了调控合子发育的信息(即母体效应基因产物)。令人惊叹的是,雌性动物巧妙地利用不均等的细胞分裂将大部分的细胞质组分积累到了卵细胞中,而较少地分给极体。
受精即精卵结合的过程,这一过程的机制非常复杂,以人为例,位于精子表面的抗受精素(antifertilizin)和卵细胞表面的受精素(fertilizin)的相互作用促进了精子向卵子的游动和结合。精子进入卵细胞内部,核膜消失,精核和卵核融合生成合子核,受精完成。如果不考虑同源染色体的交换和基因突变等因素,每个人理论上可以产生 2^{23}\approx8.4\times10^{6} 种不同配子类型,不同的卵细胞和精子结合后,可以产生 2^{23} \times 2^{23} \approx 7.04 \times 10^{13} 种合子。因此,同胞之间,除非是同卵双生子,否则是不会有遗传组成完全相同的两个个体的,这也是生物遗传多样性的一种体现。
二、卵裂
卵裂(cleavage)指的是卵细胞受精之后经历的快速的细胞分裂期,没有细胞体积增长的间隙,受精卵分裂成大量小细胞的过程。卵裂的速度一般很快,但在不同物种中有所不同,如斑马鱼是15 s,海胆30 s,小鼠则需要10~20 h。卵裂的结果是细胞数目增多,但体积没有生长,卵裂后形成的细胞称为囊胚细胞或卵裂球(blastomere)。
以非洲爪蟾(Xenopus laevis)为例(图17-1a),成熟的爪蟾卵在垂直方向可分为动物极区域(animal region)和植物极区域(vegetal region),前者颜色较深,构成上半球,后者富含卵黄,颜色较浅,密度较高,构成下半球。第一次卵裂是纵向的,将受精卵平均分成两半。第二次卵裂也是纵向,但和第一次成直角,将受精卵垂直分为4个体积相同的卵裂球。第三次卵裂是横向的不均等的分裂(在某些动物中是均等的,如海胆),得到8个卵裂球,植物极的4个卵裂球较大,动物极的4个较小。持续的卵裂将受精卵分为更多更小的卵裂球。并在内部形成了一个空腔——囊胚腔(blastocoel),这个时期的细胞团或胚胎也称为囊胚(blastula)(图17-1b)。
图 17-1 爪蟾卵细胞(a)和早期卵裂(b)示意图
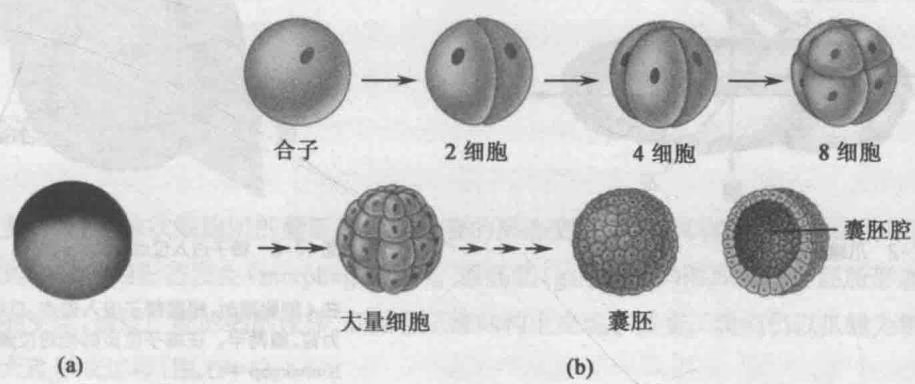
在囊胚时期,不同区域的卵裂球已发生了变化,出现了3种原始胚层(germ layer)的分化:动物极卵裂球将发育成外胚层(ectoderm),位于中间区域的发育成中胚层(mesoderm),而植物极部分将发育成内胚层(endoderm)。
需要强调的是,由于受精卵内细胞质的分布是不均一的,而卵裂也是不均等的,因此受精卵经过卵裂得到的囊胚细胞所含有的细胞质组分互不相同,这些不均匀分配的细胞质将在后续的发育过程中扮演重要的调控作用。
三、图式形成
卵裂形成的细胞团发育成为有序的结构体的过程称为图式形成(pattern formation)。图式形成包括体轴(body plan)的建立和胚层的特化。
体轴分为头尾轴(antero-posterior axis)、背腹轴(dorso-ventral axis)和中侧轴(medio-lateralaxis) (或左右轴) (图 17-2)。仍以爪蟾为例, 爪蟾精子进入卵子的位置对体轴的建立非常重要, 根据这一进入位点, 第一次卵裂将胚胎分为左、右两半, 第二次卵裂将胚胎又分为背、腹两半。体轴建立的机制相当复杂, 已知精子进入卵子的位置引发了细胞膜和细胞质之间的皮层 (cortical) 相对细胞质的旋转, 并在受精卵的相对一侧形成了 Nieuwkoop 中心, 该中心在发育过程中特化成背侧 (图 17-3)。发育遗传学的研究工作揭示, 大量母体效应基因参与了轴向的特化。例如, 在爪蟾和斑马鱼中都发现, 母体表达的 β-catenin 蛋白在 Nieuwkoop 中心积累, 参与决定背侧发育。将 β-catenin 的 mRNA 显微注射到胚胎的其他位置, 能够诱导另一个背侧的发育。
除了体轴建立,图式形成还需要细胞通过迁移完成胚层的特化。在这个阶段,细胞的命运已被决定。细胞决定(cell determination)指的是细胞被赋予特殊的“命运”,即将进入程序性的分化过程。在“决定”这一阶段,尽管细胞还没有显示出特定形态的、生理的和生化的特征,但是已经确定了分化的特定方向和实现程序。因此,细胞命运的决定是分化的前提和基础。爪蟾胚胎的8细胞期的每个细胞分离后可单独发育成相应的胚层细胞及其所对应的组织(图17-4)。但不同物种的细胞命运决定的时期有所不同,例如,豹蛙(Rana pipiens)直到原肠期晚期细胞命运决定才刚刚开始。
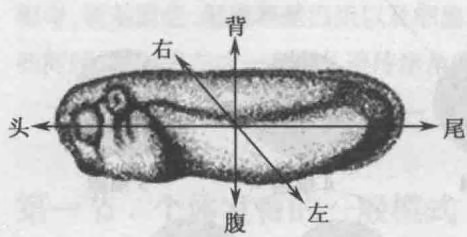
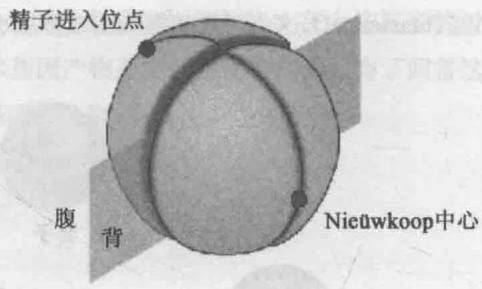
在 4 细胞期时,根据精子进入位点,爪蟾胚胎可分为背、腹两半。在精子位点的相对位置,诱导形成 Nieuwkoop 中心。
将爪蟾 8 细胞期胚胎的细胞分离后单独培养,每个细胞能发育成为特定的胚层和组织。
图式形成中细胞命运的决定同样和胚胎中不均匀分布的细胞质物质有着密切的联系。这类能够在胚胎特定位置以不同浓度决定不同细胞命运的物质被称为形态发生素(morphogen)。例如,激活蛋白(activin)属于转化生长因子- $\beta$ (transforming growth factor- $\beta$ )家族,是多种细胞表达分泌的细胞因子,在胚胎发育中发挥形态发生素的作用。将不同浓度的激活蛋白加入动物极细胞团中培养,能够诱导出不同的细胞类群(图17-5)。
图17-5 形态发生素的诱导作用
体外培养动物极细胞,加入不同浓度的激活蛋白,能够诱导出不同的细胞群。
四、形态发生
在这个发育阶段,球状细胞团的囊胚将经历显著的形态变化,成为具有细胞层分化的胚胎,这个形变的过程就称为形态发生(morphogenesis)。原肠胚(gastrula)的形成是动物胚胎形态发生中最重要的变化,通过广泛的细胞迁移,胚胎在三维结构上出现了质变。我们仍以爪蟾为例介绍原肠胚的大致形成过程(图17-6)。
原肠胚形成发生在囊胚期之后,首先是在囊胚背侧的动、植物极交界的边缘区,预定的内胚
从左至右依次为囊胚期、原肠胚早期、原肠胚期和原肠胚晚期。
层细胞出现内陷,形成裂隙状的胚孔(blastopore),位于胚孔背唇的边缘区的预定内胚层和中胚层细胞随着胚孔内陷不断内卷,这种细胞运动形成了原肠腔(archenteron,肠腔的前体)。内胚层不断推向胚胎的内部,囊胚腔显著缩小,同时,动物极的外胚层细胞向植物极迁移和外包,而中胚层细胞沿着胚孔顶壁的内表面延长。爪蟾的原肠胚形成后,形态发生还未结束,各胚层细胞还将继续通过迁移到达预定位置,为后续的分化做好准备。
五、细胞分化
上文已经提到,细胞分化与前期的图式形成密切相关。在细胞分化(cell differentiation)时期,在图式形成阶段已经特化成各个胚层的细胞向着既定的命运走上分化的道路:中胚层细胞将分化成脊索、肌肉、心脏、肾和造血组织等,外胚层细胞将形成表皮和神经系统,而内胚层细胞则形成肠和肺。在人中,胚胎细胞可以分化成为至少250种不同类型的细胞,如血细胞、肌细胞、神经细胞等等,它们在后续的发育过程中不断发展,最终形成特定的组织器官。
从遗传的角度讲,细胞分化是基因组内的遗传信息在特定发育阶段、特定组织部位、特定细胞类型中选择性表达的结果,其结果是:携带完全相同的遗传物质的细胞在形态、结构和生理功能上各不相同。
六、细胞生长和细胞凋亡
尽管胚胎早期的发育阶段几乎没有什么生长,但是到了后期,细胞生长以多种方式发生,如细胞增殖、细胞体积增大,细胞外物质的沉积,等等。此外,不同器官或者不同部分之间细胞生长速率的差异也是胚胎形态差异形成的原因。
除了细胞生长,程序性细胞死亡,又称细胞凋亡(cell apoptosis),也是发育过程中的重要细胞行为。1972年,研究者首次描述了细胞凋亡现象,并指出这是一种正常的生理过程,如同花瓣凋零(Kerr等,1972)。细胞凋亡时,细胞变成圆球状,细胞外膜鼓起形成腔泡,细胞核膜和细胞的一些内部结构破裂,核内的染色体DNA断裂成大小不等的断片,与某些细胞器等聚集,并被反折的细胞膜所包裹,形成凋亡小体(apoptotic body)。凋亡小体随后被周围的细胞吞噬,在溶酶体中消化分解。在整个过程中,细胞膜并不破裂,因此细胞内含物不渗漏出来,不会引起炎症反应,是一种“洁净”的细胞死亡方式。布伦纳(Sydney Brenner,1927—2019)、霍维茨(Robert Horvitz,1947—)和萨尔斯顿(John Sulston,1942—2018)利用模式生物秀丽隐杆线虫(Caenorhabditis elegans)的突变体发现了调控凋亡的信号途径,揭示了细胞凋亡受到一系列基因的级联调控。
在个体发育过程中,细胞凋亡的意义是使细胞保持在一定数量,处在正确位置。如线虫发育过程中,1090个体细胞中有131个细胞必会通过细胞凋亡的途径被清除,在哪个阶段哪个位置的哪一个细胞发生凋亡是固定不变的,异常的凋亡会导致胚胎发育的异常。又如,在脊椎动物神经系统的发育中,多种类型的神经元的数目是过量的,只有从靶细胞处获得足够营养因子的部分神经元能够继续存活,其余未获得营养因子的神经元将进入凋亡途径,以维持神经系统中正常的细胞数目和正确的细胞通讯。再如,蝌蚪尾巴在变态发育过程中的消失,人早期胎儿的指(趾)间组织——蹼在晚期胎儿中的消失,都是细胞凋亡的结果。可见,细胞凋亡是个体发育所必需的关键步骤。
第二节 基因在胚胎发育中的作用分析
这一节,我们以黑腹果蝇的早期胚胎发育为例,向读者介绍遗传因素如何在胚胎发育过程中发挥调控作用。在遗传分析一章,我们已介绍过福尔哈德和威绍斯成功利用遗传筛选的方法鉴定了大量参与果蝇胚胎轴向建立、体节发育的调控基因。在他们的工作基础上,遗传学家已经揭示了果蝇胚胎早期发育的形态建成依赖于母体效应基因(maternal effect gene)、裂隙基因(gap gene)、成对规则基因(pair-rule gene)、体节极性基因(segment polarity gene)和同源异形基因(homeobox gene)等的协同作用。
一、果蝇胚胎的发育过程
先简单介绍果蝇胚胎早期发育的基本过程(图 17-7a)。雌、雄果蝇的卵核和精核融合后,细胞核迅速分裂但不发生胞质分裂,形成大量核集中在一个细胞质中,成为合胞体(syncytium)。在第9次分裂结束后,细胞核移动到细胞的外周,形成合胞体囊胚层(syncytial blastoderm)。同时,15个左右的细胞停留在胚胎的后端,并发育成为极细胞(pole cell),它们会成为将来的生殖细胞。随后,细胞间隔开始发育,形成细胞性胚盘(cellular blastoderm)。果蝇的所有胚层都由胚盘外围的单层细胞发育而来。随后,原肠胚开始形成,腹面的预定中胚层首先发生内陷,形成腹面中线沟。内陷的腹面胚层或胚带(germ band)不断向后端延伸,并上升到背侧,形成构成躯干的主要区域。在受精后10 h左右,原肠胚基本形成,一系列均匀间隔的沟将胚划分成头部、胸部和腹部共14个副体节(parasegment)(图 17-7b)。这些胚胎阶段的副体节与成虫的体节(segment)交错了半个体节的位置,即每个体节实际上是由上一个副体节的后半区室与下一副体节的后半区室所构成的。
果蝇的幼虫在受精后 24 h 孵化出来,在幼虫体内已经具备了所有发育成未来的足、翅、眼等
(a)精子从卵孔进入卵细胞后,经过3 h左右的发育,形成细胞性胚盘。(b)10 h左右形成的果蝇胚胎的副体节和体节位置,区室中A表示头部,P表示尾部。
器官的成虫盘(imaginal disc)。随着幼虫觅食、生长、脱皮,幼虫经过1龄、2龄和3龄三个阶段,成为蛹,最后经过激素诱导的变态发育成为有足有翅的成虫。从果蝇成虫上更容易分辨各个体节单位,从头部至尾部分别为头部3体节(从头开始依次为Ma、Mx和Lb)、胸部3体节(T1~T3)和腹部9体节(A1~A9)(图17-7b)。每个体节都有其独特的特征,以3个胸部体节为例,第1个胸部体节仅长出腿,第2个胸部体节会长出腿和翅,第3个胸部体节则长出平衡器。可见,早期胚胎发育已经决定了果蝇发育的蓝图。
事实上,所有的物种发育都是如此,因此,早期胚胎发育的遗传学研究至关重要。
二、果蝇胚胎早期发育的关键调控基因
果蝇胚胎最早期的发育过程是由积累在卵细胞质的 mRNA 和蛋白质指导的, 这些物质在受精前由母体表达和积累, 并沿轴产生了不同浓度, 发挥形态发生素的作用, 可以激活或抑制合子基因的表达, 从而指导果蝇胚胎头尾轴、背腹轴的建立。合成这些物质的基因被称作母体效应基因。研究发现, 共有约 50 个母体效应基因参与了果蝇体轴的建立, 随后的发育都按照母体效应基因建立的基本框架进行。
母体效应基因 bicoid(bcd) 是研究得较为清楚的果蝇母体效应基因。在未受精的卵中,母体表达的 bcd 的 mRNA 定位于头端,受精后,mRNA 翻译出蛋白质,从头端向尾端扩散,沿头尾轴形成浓度梯度,这一浓度梯度为进一步的图式形成提供了重要的位置信息(图 17-8a)。观察 bcd 缺陷的雌果蝇生产的幼虫(图 17-8b),均没有头部和胸部体节,出现尾部-腹部-尾部的畸形胚胎,提示母源的 bcd 基因负责调控头胸部发育。将野生型雌果蝇卵细胞头部的细胞质吸取后原位注射到 bcd 缺陷的卵细胞的既定头部位置(注意此时没有改变母本或子代的基因型),可以部分回补子代幼虫的头部发育(图 17-8c),说明母本积累在卵细胞中的基因产物发挥了胚胎发育的调控作用。如果将野生型雌果蝇卵细胞头部的细胞质吸取后异位注射到 bcd 缺陷的卵细胞的其他部位比如中央部分,一些头部结构将会从注射位置发育出来(图 17-8d),进一步说明母本的
左侧: 果蝇实验基本方案。右侧: 子代果蝇幼虫的形态示意图。
基因产物在卵细胞中的浓度分布梯度决定了胚胎头部的建立位置。其他母体效应基因如 nanos (nos) 的 mRNA 分布在胚胎尾端,也在受精后翻译产生 Nanos 蛋白梯度,参与建立尾端模式的发生。其他母体效应基因还包括决定末端极性的 torso, trunk 等,决定背腹轴极性的 Toll, nodal 等。
裂隙基因是一些受到母体效应基因调控的合子基因,在胚胎的一定区域(沿头尾轴向,一般覆盖多个体节)内表达。这类基因如发生突变,会使胚胎体节图式出现大段空缺,因此称为裂隙基因(图17-9a),包括hunchback, krüppel, knirps, giant等。裂隙基因是在胚胎中转录表达的第一批合子基因,它们的表达受到母体效应基因的严格调控。例如,Bicoid蛋白可以结合到裂隙基因hunchback的启动子区域,激活hunchback基因的表达。被激活的hunchback转而可以继续调控其他裂隙基因的活性,如krüppel。母体效应基因和裂隙基因之间的协同作用可以将胚胎划分成独立的区域,为下一阶段的发育提供位置信息。
在裂隙基因的蛋白质产物的直接或间接调控下,成对规则基因在间隔的体节中转录表达,使得裂隙基因规划的宽阔的体节范围被进一步细分成垂直于头尾轴的7个带区。它们的突变体会每间隔一个体节就缺失一部分,因此得名。已知的成对规则基因包括even-skipped, odd-skipped, hairy, runt, fushi tarazu等。其中,even-skipped表达于奇数副体节,它的缺失突变体丢失一半的偶数副体节而fushi tarazu恰恰相反,表达于偶数副体节,缺失突变体丢失奇数体节(图17-9b)。
裂隙基因和成对规则基因共同参与了副体节的确定,尽管每个副体节看上去非常类似,但事实上,不同的表达基因的组合决定了每个副体节的特异性。
成对规则基因产物继续调控体节极性基因的转录图式。体节极性基因的突变体丧失了体节的头尾轴极性:丢失了体节的一部分结构,并被该体节的另一部分的镜像结构所替代,因此定义
左侧:野生型幼虫形态;右侧:突变型幼虫形态。阴影部分为缺失区段。
为体节极性基因(图 17-9c)。
体节极性主要具有两个作用: 在成对规则基因作用的基础上进一步确定体节的边界和极性, 以及决定体节内的细胞谱系命运。例如, engrailed 是第一个被活化的体节极性基因, 在每个副体节的前缘第一排细胞内部表达, 确定了这群细胞将特化成为幼虫体节的后部区室。表达 engrailed 的细胞的谱系命运已决定, 在后续的发育中始终停留在体节的后部。果蝇翅的成虫盘是在发育为 T2 体节的相邻副体节之间的边界上发生的, 由于 engrailed 等体节极性基因的表达确定了翅的前后部区室, 因此翅膀的前后部分的细胞谱系不同, 翅膀前后形态差别显著。但在 engrailed 突变体果蝇中, 翅前后区室的细胞边界消失, 翅的后缘出现了翅前缘的特征性短毛(图 17-10)。
野生型
engrailed突变型
图 17-10 engrailed 突变体在果蝇翅上的表型变化
在胚胎体节的划分确定之后,最后由同源异形基因决定各体节未来的发育途径,形成各体节的特征结构。美国遗传学家刘易斯(Edward Butts Lewis,1918—2004)在揭示同源异形基因的功能和性质中发挥了重要作用,并启发了福尔哈德和威绍斯的遗传筛选工作。
果蝇的同源异形基因主要分布在3号染色体上的两个区段(图17-11),一个区段是触角足复合体(antennapedia complex, ANT-C),含5个同源异形基因,包括负责头部体节特化的labial(lab)和Deformed(Dfd)基因,负责胸部体节特化的Sex combs reduced(Scr)和Antennapedia(Antp)基因,以及只在成虫的头部发育中发挥作用的proboscipdia(pb)基因。另一个区段是双胸复合体(bithorax complex, BX-C),含3个同源异形基因,包括Ultrabithorax(Ubx)、abdominal-A(abd-A)和Abdominal-B(Abd-B)基因。
同源异形基因的命名同样来源于它们独特的突变体——同源异形现象(homeosis),即某个体节或结构整体转化成了另一种结构。例如,Antp基因在正常条件下负责特化第二胸部体节,它的显性突变体可在头部体可节和胸部体节中都表达,结果头部的成虫盘被诱导成胸部的成虫盘,原来长触角的部位长出了足(图17-12a)。而Antp基因的纯合缺失突变体在胸部也不表达Antp,第2对足转变为触角(Struhl,1981)。再如,Ubx控制第三胸部体节(长有平衡器)的发育,Ubx的缺失突变体的第三胸部体节无法正常发育,转变为重复的第二胸部体节,结果平衡器转变为第二对翅膀(图17-12b)。
同源异形基因在染色体上线性排列,箭头所指的是它们在胚胎中的表达部位。
分子遗传学研究发现,同源异形基因具有高度的保守性。首先,同源异形基因在染色体上的基因排列顺序和基因在胚胎前后轴上的空间表达顺序具有共线性 (colinearity) 关系(图 17-11)。其次,同源异形基因的内部序列存在保守性,都含有一个高度保守的 180 bp 长度的同源区域,称为同源异形框(homeobox),简称同源框。这段 DNA 序列编码 60 个氨基酸的同源异形域(homeodomain),与 DNA 结合,发挥转录调控作用。再次,同源异形基因在不同物种之间高度保守。除了果蝇,脊椎动物胚胎发育早期的躯体规划也是由同源异形基因决定的。以小鼠为例,小鼠基因组中的 Hox 基因家族(Hox gene family)由 4 大类同源异形基因组成,即 Hoxa、Hoxb、Hoxc 和 Hoxd。这 4 类基因成员均含有同源异形框,通过结合 DNA 元件发挥转录因子作用;它们在染色体上成簇排列的排列顺序与果蝇 3 号染色体上同源异形基因的排列顺序一致,也与它们在小鼠胚胎发育过程中的表达图式一致(图 17-13)。研究者利用基因敲除实验揭示了小鼠 Hox 基因在胚胎发育中的关键调控作用,例如 Hoxa3 纯合突变小鼠出生后死亡,尸体解剖发现小鼠胚胎存在严重发育异常,包括颈软骨短而厚,缺失胸腺、甲状腺和甲状旁腺,心脏和血管畸形等(Chisaka 和 Capecchi,1991)。人类基因组中含有 HOXA、HOXB、HOXC 和 HOXD 4 个基因簇,基因的排列顺序和表达图式仍然高度保守。临床上发现 HOXA11、HOXA13 和 HOXD13 基因突变可导致个体出现骨骼发育异常、肢体畸形等表型。但其他人类 HOX 基因鲜见突变报道,这可能是这些 HOX 基因突变严重影响发育,导致胚胎自然流产的原因。
(a)
(b)
图 17-12 黑腹果蝇的两种同源异形突变
| a-1 | a-2 | a-3 | a-4 | a-5 | a-6 | a-7 | a-9 | a-10 | a-11 | a-13 | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| b-1 | b-2 | b-3 | b-4 | b-5 | b-6 | b-7 | b-8 | b-9 | ||||
| c-4 | c-5 | c-6 | c-8 | c-9 | c-10 | c-11 | c-12 | c-13 | ||||
| d-1 | d-3 | d-4 | d-8 | d-9 | d-10 | d-11 | d-12 | d-13 |
三、发育相关基因的调控作用
综上,在果蝇胚胎发育早期,一系列胚胎发育相关基因级联作用,相互协作,共同决定了胚胎图式和细胞命运(图17-14)。由母体表达,积累在卵细胞中的母体效应基因产物最早发挥作用,通过建立浓度梯度指导体轴的初步建立,并转录激活下游的合子基因。最先表达的合子基因是裂隙基因,它们将胚胎延体轴划分为大块区域。随后,成对规则基因被裂隙基因激活,和裂隙基因一起指导胚胎完成体节化。体节极性基因进一步促进体节内部的极性建立和细胞命运决定。最后,同源异形基因在成对规则基因和体节极性基因的基础上,指导各个体节的特征发育方向,完成后续发育的蓝图绘制。分子生物学研究进一步揭示这五类早期胚胎发育相关基因绝大多数都编码转录因子,通过转录调控实现级联效应,保证了胚胎发育准确、有序地进行。
基因的表达和作用位置用深色色块或线条表示,时间表示受精后该类基因的表达时间。
第三节 几个发育现象的遗传学分析
这一节我们就其他一些模式生物发育中的几个有趣现象,从遗传学角度来进行分析。
一、基因重排与细胞分化
前面讲过,细胞分化是基因选择性表达的结果。某些生物通过染色体 DNA 重排(DNA
不同的小写字母上标表示不同的 VSG 基因拷贝。
rearrangement)来控制基因表达。常常提到的一个例子是昏睡病的病原体——锥虫(Trypanosoma)的表面糖蛋白,还有一个众所周知的例子是哺乳动物的B淋巴细胞。
锥虫属原生动物门的单细胞真核生物,种类很多,流行于热带非洲的昏睡病是由能寄生于人体和野生/家养动物中的布氏锥虫(Trypanosoma brucei)引起的。锥虫的细胞表面覆盖了大量表面糖蛋白,每一个体约有500万至1000万分子之多,而且在同一时期,锥虫仅表达同一种表面糖蛋白变异体(variant surface glycoprotein, VSG)。这样,宿主的免疫系统仅与这种VSG接触,而不会与锥虫的任何其他蛋白质接触。在宿主对感染的锥虫及其后代所表达的VSG抗原能达到有效的免疫反应之前,个别子代锥虫会转而产生另一种新的VSG,从而使锥虫后裔成功避开宿主对其VSG的免疫反应(图17-15a)。换句话说,在感染期间,锥虫改弦易辙,转而产生新的VSG,其速率之快足以挫败宿主对感染的有效免疫应答的相继步骤的实现。
锥虫中编码不同 VSG 的基因约有 1000 个,在锥虫生活史中的每一个时期,有且仅有一个 VSG 基因表达,每隔一定阶段发生更换。某一特定 VSG 基因的表达,首先需要该基因进行复制,然后复制的拷贝转座到基因组中特定的表达部位。表达部位有活跃的转录调控元件 / 因子,能使新插入的 VSG 基因表达,所以从一个 VSG 基因的表达转换到另一 VSG 基因的表达,涉及位于表达部位的旧 VSG 基因拷贝的除去和新 VSG 基因拷贝的插入(图 17-15b)。DNA 重排在这一过程中是实现 VSG 特异表达的主要手段。
脊椎动物中抗体的产生是细胞分化中另一个较为特殊的例子。抗体产生细胞来自骨髓,随后由淋巴器官加工,成为 T 和 B 淋巴细胞(图 17-16)。这些淋巴细胞接触外来抗原后,就转变为抗体产生细胞,产生大量抗体。形成的抗体与相应抗原结合,就发生凝集或沉淀等反应。这是动物防御外来物质的复杂生理生化过程。
抗体是体液免疫应答的重要产物,属于免疫球蛋白(immunoglobulin,Ig)。免疫球蛋白又有多种类型:IgG、IgM、IgA、IgE 和 IgD,其中 IgG 是血清中含量最多的免疫球蛋白类型,不同免疫球蛋白的基本结构和化学性质相似。IgG 分子由两条重链(heavy chain,H)和两条轻链(light chain,L)组成,H 链和 H 链之间、H 链和 L 链之间均由二硫键连接,构成类似于 Y 字母的结构(图 17-17)。人和小鼠 IgG 的 L 链分为两种类型——κ 型和 λ 型,其中 λ 链还有不同的亚型。H链可分为5种类型,分别称为 $\mu, \gamma, \alpha, \delta$ 和 $\varepsilon$ 型,其中 $\alpha$ 和 $\gamma$ 也有不同的亚型。在L链和H链的近氨基端,有一段长度为 $100\sim 110$ 个氨基酸的区域在不同IgG分子之间差别甚大,被称为可变(variable,V)区。而在L链的近羧基端以及H链的其余部分,氨基酸的组成非常保守,被称为恒定(constant,C)区(图17-17)。因此,IgG分子的特异性是由V区即可变区决定的,它也是IgG与抗原结合的位点。
(b)
图 17-15 锥虫逃避宿主细胞免疫清除的机制
(a) 感染锥虫的宿主细胞内锥虫 VSG 的表达变化。(b) 锥虫基因组中 VSG 编码基因的表达调控模式。
接触抗原后,T细胞本身并不产生游离的抗体,而是协助B细胞,使它产生抗体,释放到血液中。不论有几种抗原存在,每一浆细胞通常只产生一种类型的抗体。
抗原的种类成千上万,一个个体需要产生的 IgG 在内的抗体种类很可能在 10 万以上。这样就有一个很有意义的问题:一个 IgG 肽链的 V 区和 C 区是由不同基因决定的,还是由一定数量的基因或它们的产物以各种方式组合决定的呢? 1976 年,日本生物学家利根川进揭示脊椎动物
$V_{H}$ 和 $V_{L}$ 分别代表重链和轻链的可变区, $C_{L}$ 代表轻链的恒定区,重链的恒定区有多个,分别用 $C_{H}1$ 、 $C_{H}2$ 、 $C_{H}3$ 表示。用木瓜蛋白酶处理 IgG 分子,得到两种片段,具有抗原结合活性的部分称为 Fab 片段(fragment antigen-binding),另一部分冷藏后可形成晶体,被称为 Fc 片段(fragment crystallized)。连接 Fab 和 Fc 段的区域称为铰链区(hinge region)。
利用基因重排实现抗体多样性。编码 IgG 分子 L 链和 H 链的基因分布在染色体的不同位置,如人的 L 链的 $\kappa$ 链基因位于第 2 号染色体, $\lambda$ 链基因位于第 22 号染色体,而 H 链基因位于第 14 号染色体。每条链的完整的编码基因又由不同的基因簇组成,人的 L 链基因由 V、J 和 C3 类基因簇组成,而 H 链由 L、V、D、J 和 C5 类基因簇组成。每个基因簇内都含有多个相互不同的基因拷贝,不同基因簇内的基因排列组合,就构成了上万种不同的抗体基因。以小鼠中 L 链的 $\kappa$ 链基因的组装和表达为例,小鼠的 $\kappa$ 链基因簇位于第 2 号染色体。 $\kappa$ 链基因簇包括数百个 V 基因区段、4 个 J 基因区段和一个 C 基因区段。在所有发育阶段中,J 区段都邻近 C 区段,中间仅有一内含子之隔。在胚胎细胞中,V 区段离开 J 和 C 区段的上游较远。在 B 细胞发育期间,V 和 J 间的 DNA 序列被剪切,从而 V 区段就跟 J 区段相邻接,形成了一个 V—J—内含子—C 这样的 DNA 顺序(图 17-18)。然后这段顺序转录为初级转录物,再把内含子切除,形成 mRNA 分子,最后翻译成轻链多肽。
H 链基因的组装和表达基本程序与 L 链相似, 涉及 D—J、V—DJ 两轮重排, 产物种类更加多样。由此可见, 由 L 链和 H 链组成的 IgG 分子的多样化, 主要是由于发育过程中淋巴细胞 DNA 能够以 DNA 重排的方式产生成千上万种可能的基因结构。
图 17-18 小鼠的 κ 链基因的重排与表达过程
首先随机选择 V、J 区段,由重组酶将它们之间的 DNA 除去并使之接合。图中标有 $V_{3}$ 、 $V_{4}$ 和 $J_{1}$ 的 DNA 区段已被除去,因而 $V_{1}$ 和 $J_{2}$ 就连接在一起了。接着从 $V_{2}$ 起点至 C 基因末端的整段 DNA 被转录成 RNA。最后从 $J_{2}$ 末端至 C 起点之间的序列在 RNA 加工过程中被切除,由此得到的 mRNA 再翻译成蛋白质,在本例中即为一种 κ 链。
二、发育突变体分析与基因功能预测
脊椎动物的早期发育过程在很大程度上依赖于母方提供的遗传信息。但是到了原肠胚形成时,胚胎自身(合子)的遗传信息对进一步的发育就显得重要了。
例如,在小鼠中发现一种突变,它的尾巴长度只有正常小鼠的一半。交配的结果揭示,这种突变的尾巴性状起因于显性突变基因 T,它与野生型基因(+)组成的杂合子(T/+)也同样有这性状。进一步分析知道,纯合个体 T/T 在胚胎发育的特定阶段死亡。
此后,在野外捕获的或实验室饲养的一些小鼠中,表型似乎正常,但若与 $T / +$ 小鼠交配,既有短尾小鼠后代,也有出生没有尾巴的小鼠。交配的结果可作这样的解释:外观正常的长尾小鼠实际带有隐性无尾突变基因 $t$ ,其基因型为 $+ / t$ 。当 $t$ 基因与 $T$ 基因相互作用时,即生出无尾小鼠,
这样就能完满地说明实验结果(图 17-19)。
那么 T 基因座在发育遗传学上告诉我们一些什么呢?T 基因座上各种纯合致死的等位基因会在某一特定时期阻断胚胎发育(图 17-20)。例如纯合子 $t^{12}/t^{12}$ 胚胎可发育到桑葚期,但在到达胚泡期(blastocyst stage)以前死亡。纯合子 $t^{w73}/t^{w73}$ 胚胎可发育到胚泡期,能够在子宫开始着床,可是不能完成这个过程,最后死亡(图 17-20 中未表明)。其他等位基因纯合子也可阻断胚胎的进一步发育。因为每一突变型都是在某一特定时期阻断发育,所以 T 基因座的野生型基因很可能是在出现新的细胞与细胞间的相互作用时,通过改变细胞表面的特性来控制早期胚胎发育的,使新的细胞联系能正常地、协调地进行。
图17-20 小鼠的早期胚胎发育
实线箭头表示正常胚胎发育,虚线箭头表示带有 $t$ 基因突变个体的发育从这儿开始受阻。(a)受精卵分割,形成一个细胞球,称桑葚胚。(b)发育成胚泡,出现细胞分化,形成外围的滋养外胚层。 $t^{12}$ 纯合子不能完成这一步,以未分化的桑葚胚告终。(c)胚泡植入子宫壁后,内细胞团分化出外胚层, $t^9$ 纯合子的滋养外胚层发育不良,不能很好着床,随后胚胎死亡。(d)内细胞团继续生长,胚胎进入卵圆柱体晚期。但 $t^{nr}$ 纯合子出现外胚层变性,胚胎逐渐消亡。(e)胚胎本身开始分化,卵圆柱体上出现原条,在原先存在的内、外胚层间形成中胚层。 $t^9$ 纯合子胚胎不能形成正常的中胚层,因而也没有从这胚层而来的组织。(f)出现脊索、神经管、体节,形成正常胚胎。但 $T$ 纯合子的神经管和体节异常,后肢发育不良,而 $t^{w1}$ 纯合子的胚胎很小,仅有正常胚胎的 1/4 到 3/4,神经系统异常,骨骼系统畸形以及水肿。
三、植物花器官的发育与 ABC 模型
拟南芥(Arabidopsis thaliana)也是一种良好的遗传学模式生物,属于十字花科鼠耳芥属。
拟南芥具有一系列吸引遗传学家的优点,包括植株小,易于实验室内大量种植;生长周期短,从发芽到开花4~6周;结实多,每株植物可产生数千粒种子;形态特征分明,利于表型观察等。2000年拟南芥全基因组测序完成,是第一个实现基因组全序列分析的植物。
拟南芥的生命周期主要包括:①受精卵和受精极核的形成;②胚和胚乳的发育,形成种子;③营养器官分化,形成幼苗;④生殖器官的分化,形成成熟植株。从受精卵开始的早期胚胎发育与动物细胞有很多相似之处,一些关键基因控制了拟南芥胚胎的模式建成,如 gurke 突变体的种子萌发产生的幼苗缺失了顶端部分,包括茎分生组织和子叶,monopterous 突变体幼苗缺失了中部和基部组织,包括茎和根分生组织等。
大多数动物在胚胎发育完成后,通过有丝分裂促进生长,不同细胞的生长速率是组织器官差异的主要原因之一。但是,高等植物的胚胎发育只完成了种子的形成,种子萌发后形成幼苗,需要长出根、茎、叶等器官,幼苗生长成熟之后还需要长出花朵和果实,形成下一代种子。营养器官和生殖器官的分化是植物胚胎发育完成之后的两个不可缺少的重要阶段。遗传学家利用遗传分析研究植物的器官分化,成功发现了一大批植物器官形成的调控基因,它们在合适环境因素的刺激下促进了植物的个体发育。我们以植物开花为例,向读者介绍其中的详细机制。
植物开花起始于花芽的形成,这是植物从营养生长到生殖生长的重要转折点。每种植物都在特定的季节和特定的部位长出花芽,这种习以为常的自然现象充分反映了环境和遗传两种因素对植物开花的协同调控。一方面,温度、光照时间等环境因素是诱导开花的关键外部信号。另一方面,内部因素(即基因)需要对适宜的环境信号做出准确的应答,例如花分生组织特异性基因如 Leafy (LFY) 和 APETALA1 (AP1) 等的时空特异性表达,这些基因的激活确定了花分生组织的特征。如果人为过量表达 Leafy 基因,即使环境因素不适合,茎分生组织也都转化为了花分生组织(图 17-21)。
花分生组织形成后,细胞继续分化出花器官原基,进一步发育出花。花是节间极度缩短的变态枝条,组成花的花萼、花瓣、雄蕊和雌蕊都是叶片的变态器官。这种来源相同,分化不同的器官正是我们前面介绍过的同源异形器官。以拟南芥为例,4种花器官构成了4轮同心圆结构,从外向内依次为4个萼片(sepal, Se),4个花瓣(petal, Pe),6个雄蕊(steman, St)和2个心皮(carpel, Ca)构成的雌蕊,依次被定义为1、2、3、4轮花器官(图17-22a)。
花器官发育缺陷的突变体是研究开花机制的好材料,遗传学家通过观察和分析发现了3类重要突变:第一类突变影响了第1、2轮的发育,花器官的组成突变为心皮、雄蕊、雄蕊、心皮;第二类突变影响第2、3轮的发育,花器官的组成突变为萼片、萼片、心皮、心皮;第三类突变影响第3、4轮的发育,花器官的组成突变为萼片、花瓣、花瓣、萼片。仔细分析这3类突变,不难发现:它们都属于一种花器官转变为另一种花器官的突变,即前面介绍的同源异形突变,且每次发生变异的花器官都有两轮,这些发现为遗传理论模型的提出奠定了重要基础。1991年,遗传学家提出,在正常花器官的发育过程中,4轮花器官是由3类基因(定义为A、B、C)调控,每类基因作用于同源异形突变体的作用部位,即花发育的ABC模型(Coen和Meyerowitz,1991)。这个模型的具体假设内容是:有A、B、C3类功能基因在正常花器官的发育过程中发挥作用,A类基因的表达和功能活性局限在第1和2轮,B类基因在第2、3轮,而C类基因在第3、4轮。A和B,B和C存在重合,但A和C之间存在拮抗(图17-22b)。在正常花中,第1轮花器官仅受到A基因的调控,原基发育成萼片,第2轮受A和B的双重控制,原基发育成花瓣,第3轮受B和C的控制,原基发育成雄蕊,第4轮则由单独的C控制,原基发育成心皮。
南芥在长、短光照下的开花
这一模型还可以很好地解释研究者观察到的同源异形突变(图 17-23),例如:当 A 类基因突变时,C 基因不受到抑制,可以在 4 轮花器官发挥作用,原来的萼片受到了 C 类基因调控,花瓣受到了 C 和 B 基因调控,因此突变成了心皮和雄蕊。以此类推,当 C 类基因突变时,A 基因不受到抑制,原来的雄蕊和心皮突变成花瓣和萼片。当 B 类基因突变时,仅 A 基因和 C 基因发挥作用,花瓣和雄蕊突变成萼片和心皮。
事实证明,这一模型既准确又巧妙。遗传学家陆续从拟南芥中克隆到了A、B、C这3类功能基因。不出意外的是,它们都属于基因表达调控中的组织特异性转录因子。A基因实际包含AP1和APETALA2(AP2),B基因包含APETALA3(AP3)和PISTILLATA(PI),C基因是
(a)
心皮(Ca)
(b)
图 17-22 拟南芥的四轮花器官结构(a)和 ABC 模型(b)
AGAMOUS(AG)。3类基因在氨基酸序列上存在高度相似性,除AP2外,全部基因属于MADS-box基因家族,含有保守的蛋白质结构域,识别并结合靶DNA发挥特异性转录激活作用,与同源异形框在动物发育中的调控作用如出一辙。
随着研究的深入,研究者发现如果突变 A、B、C 3 类基因,拟南芥的花器官除了叶片外仍含有心皮状结构,而不像预测的那样不含任何花组织,这提示了仍有促进心皮发育的调控基因未被发现,这就是后来定义的 D 类功能基因 SHATTERPROOF(SHP) 和 SEEDSTICK(STK)。又如,人为激活 A、B、C 3 类基因的表达,并不能使叶片转变成花器官,这又提示了还有一类基因参与从营养器官到生殖器官的转变,这就是 E 类基因,即 SEPALLATA(SEP)。新的四聚体模型可以更好地解释以拟南芥为代表的高等植物花器官形成的调控机制(图 17-24):A、B、C、D、E 5 类功能基因编码的转录因子以不同的组合方式,形成 5 类有活性的异源四聚体,结合到特定的 DNA 调控序列上,发挥组织特异性转录因子的调控作用,独立控制花萼、花瓣、雄蕊、心皮、胚珠五类花器官的发育,精确调控植物开花。
图 17-24 拟南芥花发育的四聚体模型(引自 Theißen 等, 2016)
第四节 噬菌体和原生生物的分化
前面介绍了较复杂的多细胞生物的个体发育,它们和高等生物,尤其是人类自身的发育过程更为相似。但是噬菌体、细菌和单细胞生物的某些分化现象对我们了解发育的机理也很有启发性。这些生物往往有高度特殊的结构,但体系简单,便于研究。
一、噬菌体的自发装配
烟草花叶病毒只有两种成分——遗传物质 RNA 和外壳蛋白质。这两种成分可以分开来,再在适当条件下重新组合,成为有感染性的颗粒。在这个自发装配过程中,大约有 2100 个相同的蛋白质亚基相互作用,从单一的 RNA 分子的 5’ 端开始,形成一个杆状的病毒。要建立这种简单的结构,除了 RNA 和外壳蛋白质以外,其他的信息似乎是不需要的。
我们可以利用反向遗传学方法对这类简单生物的形态建成过程进行分析,它们的基因组很小,易于操作。分析时先找到各种突变型,观察没有这些突变时,正常的发育顺序是怎样的;有突变时,哪些发育过程受到影响。一个简单的例子是,出现某一突变后,影响某一特定产物,从而使发育不能越过某一特定阶段。例如出现某个突变时,蛋白质P不能形成,使发育阶段S不能实现,这样我们可以推论,蛋白质P是阶段S发生所必需的。知道了什么基因发生突变,发育在什么地方受到阻碍,我们就可把这些实验结果贯穿起来,推导出正常的发育顺序。这种方式在研究代谢途径的生物化学方面很有价值,在分析噬菌体T4的发育途径中也很成功(图17-25)。
T4 噬菌体 DNA 利用宿主的 RNA 聚合酶合成噬菌体 mRNA。然后这种噬菌体 mRNA 在宿主核糖体上进行翻译,产生若干“早期”蛋白质。在噬菌体侵入宿主细胞 5~7 min 内,这些早期的酶导致“营养性”噬菌体 DNA 微丝(vegetative phage DNA fibril)的大量形成。在这个时候,如果在培养物中添加氯霉素等蛋白质合成抑制剂,那么噬菌体 DNA 就保持在疏松的含水的微丝状态。如果蛋白质合成不受干涉,蛋白质合成继续进行,就形成一种浓缩蛋白质,该蛋白质使营养性 DNA 微丝失去水分,压缩成为致密的多面形颗粒。
早期蛋白质合成停止后,几种“晚期”蛋白质出现。头部蛋白质分子聚合在致密的 DNA 周围,形成含有 DNA 的头部外壳。“晚期”蛋白质除了与头部外壳的形成有关以外,还与尾部的各种结构以及溶菌酶(lysozyme)有关。溶菌酶是用来裂解宿主的细胞壁的。总的说来,一个完整的噬菌体颗粒约含有 30 种不同的成分(图 17-25)。这些成分来自 3 个主要的装配线——尾部、头部和尾丝。这 3 个装配线的各自顺序以及相互之间的配合是井然有序的,通常前一步装配完成后,后一步装配才能正常进行。完成了的头和尾自发地结合在一起,然后,只有在这个时候,尾丝才添加上去。这个例子说明,在 T4 以及其他一些病毒中,基因产物能自发地装配成
从突变型推论,知道有3条装配线,汇合后形成一个成熟的噬菌体。完整的头和尾自发地结合,然后添上尾丝。图中每一号码代表一个突变基因,能够阻止进一步发育。例如突变型54,看到分开的底板、头和尾丝;突变型37出现没有尾丝的噬菌体。如果两突变型混合在一起,则能自发地装配成完整的噬菌体。
复合结构。
二、细菌的孢子形成
细菌的孢子是一种休眠结构,它们既不复制,也不显示代谢活性,可在恶劣环境下休眠几百年。然而当休眠的孢子接触到适合的环境时,可以萌发,恢复营养生长和复制。细菌的孢子形成通常是由营养物质的缺失引起,特别是碳和氮的不足容易导致孢子形成。
杆菌属(Bacilli)和梭菌属(Clostridia)的某些种形成孢子时,先出现“前孢子”(prespore或forespore)结构,把半数的DNA和一部分细胞质包含在一个特别的间隔中。在这过程中,出现明显的酶活性的变化,最后导致了成熟孢子(endospore)的形成(图17-26)。酶活性的变化,包括某些常见细菌酶的增加、另一些常见酶的减少,以及一些孢子形成时特有酶的出现。
枯草杆菌(Bacillus subtilis)在孢子形成时,RNA聚合酶中σ亚基的活性丧失。这个丧失可能使多聚酶的作用改变,它所认读的DNA模板与原来不同了。孢子形成的开始受到转录的控制,这样的看法也得到了实验的支持,因为培养中添加能抑制转录的放线菌素D后,可以阻遏孢子形成过程中某些特定阶段的出现。孢子形成时,mRNA的形成通常在有关蛋白质出现前的1 h左右,所以这类mRNA的寿命比一般的细菌mRNA(只有2~3 min)要长得多。一旦孢子形成过程开始后,形态变化和酶活性变动按严格的顺序进行,受到精密的遗传控制。
这样看来,孢子形成虽然与恶劣环境有关,但一旦开始,孢子形成过程中的形态变化以及酶活性的出现和增减都是在基因控制下进行的。
三、伞藻的再生和嫁接实验
伞藻(Acetabularia)是一类大型的海生单细胞藻类。幼龄时由假根和茎构成。假根里有一
图 17-26 孢子形成的形态变化过程(Strickberger, 1976)
从孢子形成开始到最后形成,需6~8 h。形成的孢子外面包有蛋白质,通常的营养细胞是没有这种物质的。细菌细胞崩解后,孢子被释放出来。
个相当大的细胞核,茎很长,可达7 cm。茎中含有叶绿体,到成熟的时期,茎的前端形成一个复杂的伞形结构,这是子实体。当子实体快完全形成时,假根中的核“崩解”,形成很多子核,子核分布在茎和子实体中,在子实体中形成孢囊。孢囊萌发,释放出许多有鞭毛的配子,配子结合,形成合子,又分化为假根和茎(图17-27)。
把伞藻的茎切取3段,断片都没有核,都能再生,上段的再生最完全,中段次之,下段最小(图17-28)。这表明细胞质中有一种发育所需的物质,这种物质在藻体的上部最多,向下逐渐减少。研究发现,这种发育必需的物质就是mRNA,发育所需的酶系和其他蛋白质就是根据它们所携带的信息合成的。这种mRNA在核中形成后,迅速地向藻体的上方移行,所以上方的mRNA最多,再生也最完全。
在伞藻的种间进行嫁接实验,也得到跟上述论点一致的结果。伞藻 Acetabularia mediterranea(A.m) 和 A. crenulata(A.c) 的子实体形状不同。如果把 A.c 的子实体和有核的假根切去,单取中间的茎嫁接到 A.m 的含核假根上,几个月以后,茎的端部长出一个伞形子实体来。这子实体既不像 A.m,也不像 A.c,而是在两者之间。把这形状在两者之间的子实体切去,第二次长出来的子实体就像 A.m 了。反过来,把 A.m 的茎嫁接在 A.c 的含核假根上,最后长出来的子实体也像 A.c 的子实体(图 17-29)。根据这个实验,我们可以推论说,在控制单细胞生物的发育方面,基因仍起主导作用。基因产物储存在茎中,所以在第一次再生中,长出来的子实体在两个种之间。随后,原先储存的基因产物逐渐消失,第二次长出来的子实体就像假根所属的那个种了。当然在这里我们还应注意到,因为假根里还含有一些其他细胞质组分,它们也有可能在子实体的再生上起着一定的作用。
a, 下部断片和它的再生体; b, 中部断片和它的再生体; c, 上部断片和它的再生体; n, 核。
图 17-29 伞藻的种间嫁接实验
把 A.c 的茎嫁接在 A.m 的含核假根上, 结果长出来的子实体像 A.m, 反过来也一样。图中 M 代表 A.m 的核, C 代表 A.c 的核。
习题
个体发育的一般模式包括哪些基本过程?什么是图式形成?
为了解果蝇发育过程中的基因的调控作用,某研究小组通过 EMS 诱发突变的方法获得了一些突变体果蝇胚胎(见下图)。结合本章所学知识,请分析造成这些突变体的基因类型是什么,并给出你的理由。
野生型
突变体1
突变体2
突变体3
3. 上题中的研究小组还想利用这种遗传分析的方法寻找母体效应基因的突变体,在设计这个实验时,应该注意些什么?
4. 研究者借鉴海德堡筛选的遗传分析方法又发现了一类特殊的常染色体隐性突变纯合雌果蝇,它本身表型完全正常,但当它与野生型雄蝇杂交后,受精卵均不能正常发育成为幼虫。请问该基因很可能属于哪类胚胎发育相关基因,请简要给出理由。
- 在个体发育过程中,细胞凋亡是在多基因的严格调控下有序进行的。研究者最初以线虫为模式生物研究细胞凋亡的调控途径,它们发现基因 ced-9,ced-3 和 egl-1 是线虫细胞凋亡信号转导途径的关键基因。这些基因的功能丧失型突变 (lof) 的表型结果如下表,请问:
| 突变基因数 | 突变基因 | 细胞凋亡水平 |
| 0 | 无突变,野生型 | 正常 |
| 1 | ced-9(lof) | 过度激活 |
| ced-3(lof) | 异常下降 | |
| egl-1(lof) | 异常下降 | |
| 2 | ced-9(lof);ced-3(lof) | 异常下降 |
| ced-9(lof);egl-1(lof) | 过度激活 |
(1) 根据单基因突变的表型结果,请判断 ced-9, ced-3 和 egl-1 对细胞凋亡途径是促进作用还是抑制作用。
(2) 根据双基因突变的表型结果,请判断 ced-9 和 ced-3、ced-9 和 egl-1 之间的遗传上位关系,并简述理由。
(3) 请根据(1)和(2)的分析结果,画出 ced-9, ced-3 和 egl-1 构成的信号转导途径(可以用“→”表示促进作用,用“—”表示抑制作用)。
(4) 研究者后来又发现了一个 ced-4 基因。但是, 单独的 ced-4 的 lof 的表型与 ced-4 一样; ced-4(lof) 与 ced-9(lof) 双突变的表型也和 ced-3(lof) 与 ced-9(lof) 一样, 无法进一步确定 ced-4 和 ced-3 的上下游关系。请你简单设计一个突变实验解决这一问题。
在单细胞藻类——伞藻中, 如把细胞中的核除去, 然后反将子实体切除, 将立即再生一个子实体。不过如在切除老的子实体时, 也把邻近的一部分茎切去, 无核的细胞就不能再生一个新的子实体。假定有一种“子实体形成物质”与再生有关, 你能说明完整细胞中这种物质的性质、来源、分布和对性状的影响吗?
在少数情况下, 母鸡的卵巢失去了作用(可能由于局部感染的结果), 发育为睾丸, 这样“性转换”后的母鸡甚至成为雏鸡的父亲。在这种情况下, 染色体结构没有变化。这样看来, 性腺发育所采取的途径以及性细胞分化为精子或卵, 主要是由于细胞组成本身的作用, 还是由于发育过程中提供给这些细胞的环境的作用呢?
什么是同源异形突变?同源异形基因的保守性体现在哪些方面?
某一研究小组从拟南芥中发现了一个花发育的突变体,在进行表型和遗传分析时发现,该突变体的表型为心皮、雄蕊、雄蕊、心皮(从外到内),请问是哪种类型的基因突变造成了该突变体的产生,为什么?造成该表型变异的遗传机制是什么?
数字课程学习
在线自测 习题答案
第十八章 遗传与肿瘤
上一章我们介绍了受精卵发育过程中遗传物质如何指导胚胎的形成和个体的发育。当个体发育全部完成,进入成年,又慢慢走向衰老时,绝大多数体细胞经历了大量分裂,出现突变的概率逐渐上升。它们中的一些,在积累了一定的变异之后,可能会丧失有丝分裂的有序调控,并成功逃避机体的免疫监视和清除,这群快速分裂的细胞可能会逐渐发展成为原位生长的细胞克隆群,甚至进一步发展成人人谈之色变的癌症(cancer)。
根据世界卫生组织的统计数据,全球癌症发病率和死亡率仍在逐年攀升,2018年全球新增癌症患者1810万例(男性950万,女性860万),癌症死亡人数达960万(男性540万,女性420万),对全球健康造成重大威胁。除了老龄化,遗传变异、行为和饮食相关的环境因素等都是癌症的重要诱因。认识癌症发生发展的过程,寻找和控制诱发癌症的风险因素具有重要的研究意义。在这一章,我们将从遗传变异的角度,向读者们重点介绍遗传变异在肿瘤发生发展以及肿瘤治疗中的作用。
第一节 肿瘤的特征
肿瘤(tumor)指的是脱离了接触抑制,锚定依赖,失去生长控制的细胞群。肿瘤通常指良性的赘生物(neoplasm),未发生侵袭(invasion)和转移(metastasis),是原位(in situ)的。一旦发生侵袭和转移,肿瘤的恶性程度就大大提高了,被称为恶性肿瘤(malignant tumor)或癌症(图18-1)。
根据发生变异的体细胞来源不同,肿瘤还可以分为以下几种类型:①来自于上皮组织的肿瘤,通常被称为癌(carcinoma),如腺上皮细胞起源的腺癌(adenocarcinoma)、子宫鳞状上皮起源的宫颈癌(cervical carcinoma);②来自于间充质的肿瘤多称为肉瘤(sarcoma),如肌细胞起源的平滑肌肉瘤(leiomyosarcoma)、骨细胞起源的骨肉瘤(osteosarcoma);③来自于造血系统的肿瘤常被统称为白血病(leukemia),又可分为骨髓浆细胞起源的髓细胞白血病(myelocytic leukaemia)、B细胞和T细胞等淋巴细胞起源的淋巴瘤(lymphoma)等;④来自于神经系统的肿瘤,如视网膜细胞起源的视网膜母细胞瘤(retinoblastoma)、星形胶质细胞起源的星形细胞瘤(astrocytoma)等。
一、肿瘤的遗传性
肿瘤是源于遗传变异的疾病,但绝大多数肿瘤源于体细胞的遗传变异,因此是非遗传性的,呈现散发性,这一点可以从临床上90%以上的肿瘤没有明确的家族史中得到证实。但其余的少数肿瘤也会起源于生殖细胞中发生的基因变异,具有可遗传性。遗传性肿瘤有家族性发病倾向,发病时间较早,发病部位多,且在对称性器官中往往是双侧发病。这类肿瘤在临床上所占的比例较低,且以儿童肿瘤居多。如视网膜母细胞瘤是一种儿童眼内恶性肿瘤,患者眼底有灰白肿块,易扩散。遗传性视网膜母细胞瘤占全部的35%~45%,多为双眼发病,且在两岁前即被检出,有家族史。又如,肾母细胞瘤是发病率最高的儿童腹部肿瘤,属于恶性实体瘤,有家族性和散发性之分。家族性肾母细胞瘤多发于出生后3年内,且为双侧肾发病。家族性腺瘤样息肉症(familial adenomatous polyposis, FAP)也是具有一定遗传倾向的肿瘤类型,这是一种青少年时期在结肠和直肠上形成的多发性良性息肉,但其中一些会随年龄增长发生恶变,发展为结肠癌。
二、肿瘤的细胞学特征
早在公元前3000年,人类就留下了肿瘤的记录,但直至20世纪末,随着病理学和分子细胞生物学的发展,人们才掌握了肿瘤的各项细胞学特征。脱离正常的生长控制是肿瘤细胞的首要特征。以宫颈癌为例(图18-2),在正常子宫颈中,仅有基底层的单层细胞处于快速增殖状态(用于补充上皮细胞的损耗), 宫颈上皮细胞呈现高度分化的形态特征。但在原位宫颈癌中, 整个上皮组织出现异常的去分化, 这是由于变异的细胞快速增殖, 脱离生长控制, 占据了整个上皮组织所导致的。进一步对这些变异细胞进行形态学观察, 还会发现它们的细胞形态也产生了变化: 细胞核和核仁变大, 胞质变小, 核形态也不规则。但此时的肿瘤细胞仍然是原位的, 一旦进一步获得了侵袭能力, 能够突破基底层细胞外的层纤维基质向结缔组织浸润性生长, 肿瘤细胞就发展成为恶性肿瘤。如果浸润到结缔组织中的肿瘤细胞进一步浸润到血液或淋巴管, 随体液在体内循环, 并在另一组织处着床, 再浸润到相应的实质组织中, 就可以通过快速增殖形成转移灶, 这个过程被称为转移 (图 18-3)。侵袭和转移是恶性肿瘤最危险的特征。
上方图片为实际病理照片, 下方图片为示意图。
全面的肿瘤细胞生物学特征可以总结成图18-4,除了生长失控,多数肿瘤细胞还会出现永生化和抵御细胞死亡信号、细胞能量代谢失调、基因组不稳定和突变积累等基本特征。当一些类型的肿瘤生长体积较大时,血管网络也会浸润到肿瘤组织内部,帮助肿瘤细胞进行新陈代谢,促进肿瘤的生长、侵袭和转移,这一特征被称为肿瘤血管新生(tumor angiogenesis)。此外,当下的肿瘤研究认为肿瘤不仅仅是一团快速增殖的细胞克隆,而是由各种类型细胞构成的肿瘤微环境(tumor microenvironment)与肿瘤细胞相互作用的一种复杂组织。肿瘤微环境中的各类细胞在肿瘤发生发展的过程中扮演了重要的调控作用,并会随着肿瘤进展而不断发展变化,例如免疫炎症细胞参与调节肿瘤细胞逃避机体的免疫清除,血管内皮细胞和周细胞参与调节肿瘤的血管新生等。
三、肿瘤的流行情况及主要病因
利用流行病学(epidemiology)对比不同人群的肿瘤发病率和死亡率,可以获得人类肿瘤的流行情况以及诱发肿瘤的关联因素。根据国际癌症研究机构(International Agency for Researchon Cancer, IARC) 的全球癌症研究报告, 2018 年, 全球癌症发病率最高的癌症是肺癌和乳腺癌, 两者分别占全部癌症的 11.6%, 随后是结肠癌、前列腺癌和胃癌; 死亡率最高的仍是肺癌, 占全部癌症死亡的 18.4%, 结肠癌、胃癌、肝癌和乳腺癌紧随其后。不同类型的癌症的发病率和死亡率与地域、性别、年龄、国家发展程度等都存在密切关系。例如, 在女性中, 发病率最高的依次是乳腺癌、结肠癌、肺癌、宫颈癌和甲状腺癌; 而在男性中, 发病率最高的是肺癌、前列腺癌、结肠癌、胃癌和肝癌, 这一差异与两性差异密切相关。又如, 欧美的前列腺癌发病率远高于亚洲, 而亚洲的胃癌和肝癌发病率高于欧美, 尽管存在人种差异, 但如果进一步结合不同地域的不同人种来看, 这些癌症类型的发生更多地与饮食习惯、病毒和细菌感染等存在紧密联系。
癌症病因分析发现,大约三分之一的癌症源自5种与生活方式密切相关的危险因素:高体重指数、水果和蔬菜摄入不足、缺乏运动、吸烟以及饮酒。其中,吸烟是影响最为严重的危险因素,80%的肺癌与吸烟有关,包括主动吸烟和与吸烟者生活在一起的被动吸烟的亲属等。除了肺癌,吸烟还会提高口腔癌、膀胱癌和肾癌等的发病风险。研究者已从烟草中提取出数十种可能的致癌物,包括苯并芘、二甲基亚硝胺等,它们是影响癌症发生的主要物质成分。控制烟草是重要且有效的癌症防控措施之一。
第二节 肿瘤发生是一系列基因连续变异的累积结果
流行病学的分析很早就揭示了肿瘤发生率和年龄正相关。随着年龄的增加,肿瘤发生的概率在增加,且增加的幅度随着年龄的增加不断增大,这是因为体细胞中的遗传变异需要时间的积累。随着年龄的增加,个体在各种致癌物中的暴露时间不断积累,遗传变异就逐渐增加,才使得肿瘤发生的可能性提升。更直接的证据来自在化工厂直接接触致癌物的工人,研究发现,致癌物接触时间较长的工人与接触时间较短的工人相比,肿瘤发病率高,发病时间早,且随着年龄的增加肿瘤发生率逐年增加。
1990年,临床外科医生从手术中获得了不同进展时期家族性腺瘤样息肉病患者的结肠标本,进行测序分析后发现随着结肠组织细胞的不断去分化,细胞内的基因突变不断累积(图18-5),据此提出了结肠癌的多步骤发生模型(Fearon和Vogelstein,1990)。随着研究的深入,现在认为一个正常上皮细胞突变成为癌细胞可能需要累积6~7个突变,但这一数字在不同肿瘤类型,甚至同一肿瘤类型的不同个体中都有所差别。普遍适用的规律是:只有连续的突变累积才能使变异中的正常细胞逃脱机体的各种防御机制,实现快速增殖甚至侵袭转移(图18-6)。
到底哪些基因的遗传变异会导致正常细胞发生转化呢?为了回答这一问题,在过去数十年中,研究者利用反向遗传学的思路,通过构建转基因小鼠或基因敲除小鼠等动物模型发现了一系列肿瘤相关基因,我们将在下文结合具体基因进行详细介绍。
此外,20世纪80年代初,研究者还发现人源肿瘤细胞可以在免疫缺陷小鼠体内生长,这一性质有利于在体内条件下对肿瘤细胞生长进行实验操作和观察。裸鼠(nude mice)是当下肿瘤研究中常用的一种免疫缺陷小鼠品系,它因为缺少胸腺而丧失了细胞免疫能力,同时由于出现少毛的表型而被称为裸鼠。另一品系是重症联合免疫缺陷(severe combined immunodeficiency, SCID)鼠,它缺少B淋巴细胞和T淋巴细胞,还可以接受人类骨髓干细胞的移植。研究发现,正常细胞(如小鼠成纤维细胞)在这些免疫缺陷小鼠的皮下不能形成肿瘤,但当正常细胞发生癌变,就能在裸鼠皮下形成瘤块。根据这一特点,我们可以利用免疫缺陷小鼠来判定某一基因的特定突变类型能否引起正常细胞转化为恶性表型,也就可以判定该基因是否属于肿瘤相关基因了。这一实验方案的一般步骤是首先制备目的DNA(如特定基因的突变形式)的重组质粒,然后将其导入正常细胞(如常用的小鼠成纤维细胞),再将细胞扩大培养后接种到免疫缺陷小鼠皮下,最后观察小鼠体内肿瘤细胞的生长情况(图18-7)。正常的小鼠成纤维细胞是无法在小鼠皮下形成实体肿瘤的,如果导入目的 DNA 的成纤维细胞能够在皮下形成肿瘤,则提示该 DNA 具备了转化正常细胞的能力。
一、癌基因
癌基因(oncogene)指的是正常情况下促进细胞增殖,但在肿瘤细胞中因功能获得性突变产生过度或不恰当的活跃形式,促使肿瘤细胞获得无限生长推动力的一类肿瘤相关基因。在正常细胞中存在不含有突变形式的癌基因,其产物负责调控细胞的正常增殖,可以称为原癌基因(proto-oncogene),以有别于肿瘤细胞中发生变异的癌基因。由于原癌基因的产物对于正常细胞增殖非常重要,原癌基因在演化过程中呈现高度的序列保守,从酵母到人中都普遍存在。研究揭示,原癌基因受到严格精细的控制,负责调控细胞的生长、分裂和分化等。1976年,美国生物学家毕晓普(John Michael Bishop,1936—)和瓦尔默斯(Harold Eliot Varmus,1939—)同时发现人类细胞中含有未被激活的原癌基因,它们通过变异促进癌症发生。
RAS 是最早发现的癌基因之一, 因从大鼠肉瘤 (rat sarcoma) 中鉴定得到而得名。它编码一种和 GTP 结合的细胞信号转导分子 Ras, 位于细胞膜的细胞质一侧, 负责将细胞外信号传入胞内, 在细胞增殖和细胞骨架调控中扮演重要作用 (图 18-8a)。人类基因组中含有 3 个 RAS 基因
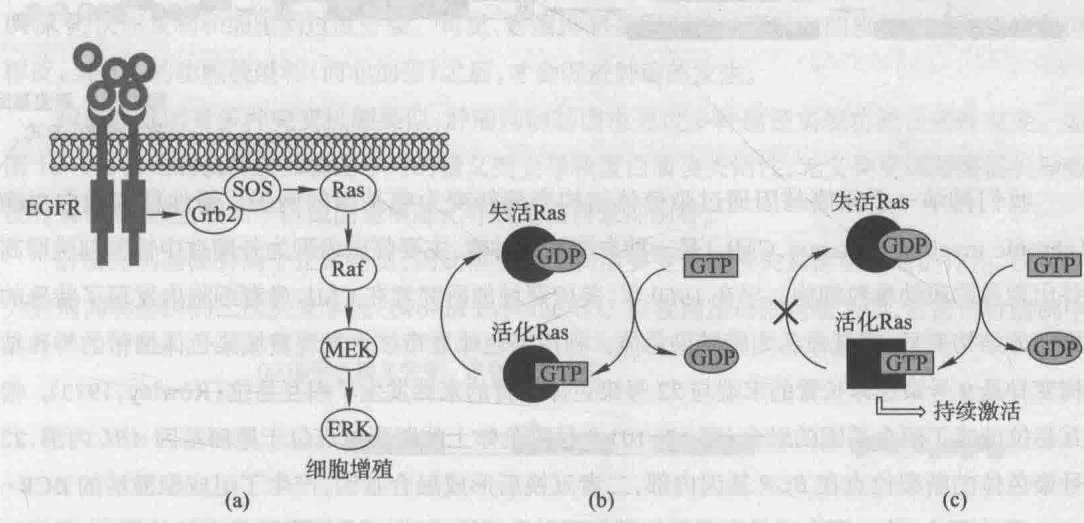
(a) 癌基因 RAS 介导的信号转导通路。在细胞膜上的受体蛋白如表皮生长因子受体(epidermal growth factor receptor, EGFR)受到外界的细胞因子刺激后发生活化,通过 GTP 交换蛋白 SOS(son of sevenless)和中间接头蛋白 Grb2(growth factor receptor bound protein 2)等促进细胞膜内侧的 Ras 蛋白与 GTP 结合,活化后的 Ras 能够进一步激活下游的多个效应分子,如 MAP 激酶(mitogen-activated protein kinase)级联成员 Raf、MEK 和 ERK 等,促进细胞增殖。(b) 野生型 Ras 结合 GTP 时具有活性,结合 GDP 时丧失活性。(c) 突变型 Ras 始终与 GTP 结合,组成型激活,不断刺激下游的效应分子,促进细胞过度增殖。
家族成员, 即 KRAS、NRAS 和 HRAS。在人类所有癌症中, RAS 的突变率约为 40%, 在胰腺癌和膀胱癌中更高。在 RAS 突变的癌细胞中, 可以检测到异常活跃的 Ras 蛋白质产物。将 RAS 基因导入成纤维细胞, 也可以成功诱导细胞转化和裸鼠成瘤。这些现象都充分证明 RAS 是一个癌基因。如图 18-8b 所示, 正常的 Ras 蛋白质产物在细胞分裂的信号转导中通过动态结合 GDP 或 GTP 发挥信号转导中的开关作用: 与 GTP 结合具有活性, 而当 GTP 发生水解转变为 GDP 时失去活性。但在 RAS 基因发生组成型突变后, Ras 突变蛋白可以在不需要信号刺激的情况下与 GTP 牢固结合 (例如, 突变破坏 Ras 的 GTP 酶活性), 持久地处于激活状态, 促进细胞的异常增殖。
从 RAS 的例子中不难看出, 原癌基因到癌基因的变异过程增加了原有的活性, 属于功能获得性突变。也因此, 原癌基因只需要单拷贝的突变就可以成为有功能的癌基因。原癌基因的功能获得性突变可以通过多种方式实现, 除了 RAS 基因通常通过编码序列的点突变实现组成型激活, 其他变异方式还包括调节序列的变异提高基因表达水平, 以及染色体结构变化诱导产生融合蛋白等(图 18-9)。
(a) 编码区错义突变,产物活性上升

(b)调控区突变,基因转录水平增加
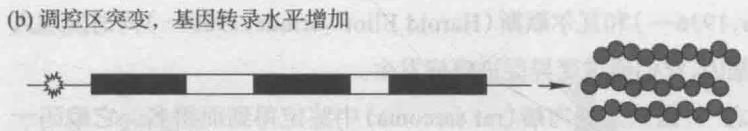
(c) 染色体结构变异,改变基因结构和产物性质

我们再举一个原癌基因通过染色体结构变异转变为癌基因的例子。慢性粒细胞白血病(chronic myeloid leukemia, CML)是一种血液系统肿瘤,主要临床表现为外周血中性粒细胞增高并出现各阶段幼稚粒细胞。早在1960年,美国费城的研究者在CML患者细胞内发现了特殊的染色体结构变异,将其命名为费城染色体。利用染色体显带技术发现费城染色体携带的特殊结构变异是9号染色体长臂的末端与22号染色体长臂的末端发生了相互易位(Rowley, 1973)。相互易位造成了两个基因的融合(图18-10),9号染色体上的断裂位点位于原癌基因ABL内部,22号染色体的断裂位点在BCR基因内部,二者互换后形成融合基因,产生了组成型激活的BCR-ABL融合蛋白,这一蛋白质具有很强的酪氨酸激酶活性,可以活化下游的肿瘤相关蛋白,刺激细胞的快速分裂与增殖,从而诱导了肿瘤发生(Groffen, 1984)。
二、肿瘤抑制基因
肿瘤抑制基因(tumor suppressor gene)是另一类在肿瘤发生发展中扮演重要角色的基因。
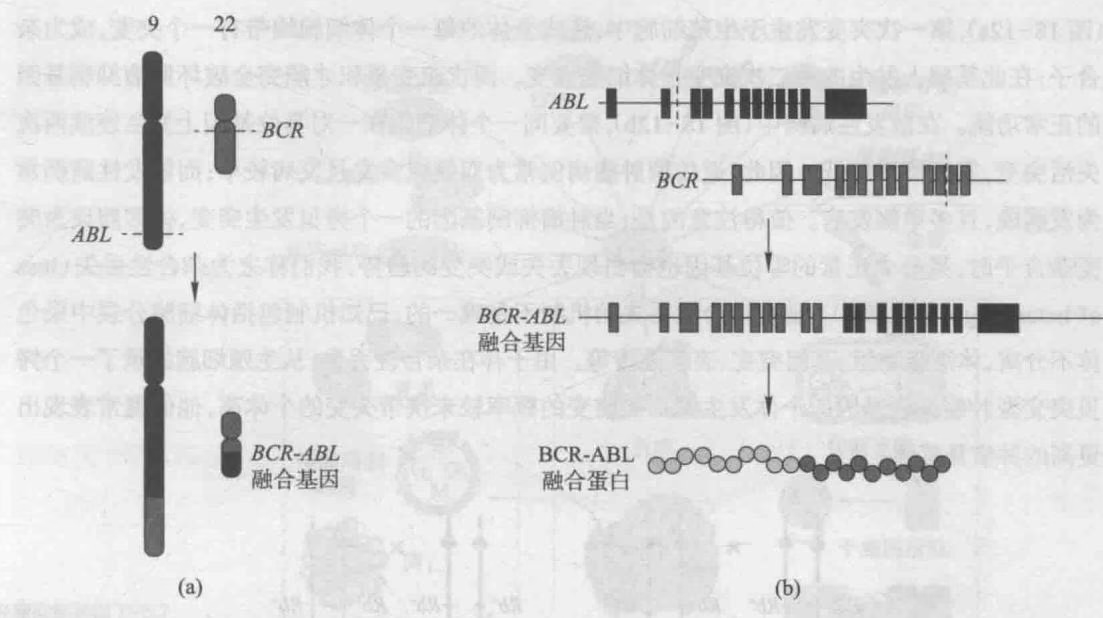
(a) 染色体相互易位示意图。(b) ABL 和 BCR 基因的断裂位点以及融合基因和融合蛋白产物示意图。
它们在正常情况下是负责监控细胞准确复制、正常分裂和生长、程序性死亡的基因,因为功能丧失性突变失去了正常功能,使异常细胞逃避修复和清除,发展为肿瘤。Rb基因是第一个被克隆的肿瘤抑制基因,最早在视网膜母细胞瘤中发现(Knudson,1971),并因此得名。Rb基因编码的蛋白质产物能够与特定的转录因子E2F结合,将细胞周期阻断在 $\mathbf{G}_1$ 期,在环境条件不适宜的情况下抑制DNA的复制。在肿瘤细胞中发现,Rb蛋白质产物失去活性,E2F因子被释放,诱导DNA的快速复制和细胞的过度分裂。可见,肿瘤抑制基因促进肿瘤发生的机制恰好和原癌基因相反,当它们的功能被限制(而非加强)之后,才会促进肿瘤的发生。
和原癌基因有多种突变机制类似,肿瘤抑制基因也通过多种途径实现功能丧失性突变。如图18-11,常见的机制包括编码序列的错义突变导致蛋白质丧失活性,无义突变或基因丢失导致没有蛋白质表达,启动子区域的超甲基化导致基因转录抑制等。
肿瘤抑制基因有两个正常拷贝,因此需要两次失活突变才能丧失其抑制肿瘤的作用,这被称为肿瘤抑制基因的二次突变学说(two-hit hypothesis)。以视网膜母细胞瘤为例,在遗传性病例中
(a) 编码区错义突变,产物失去活性
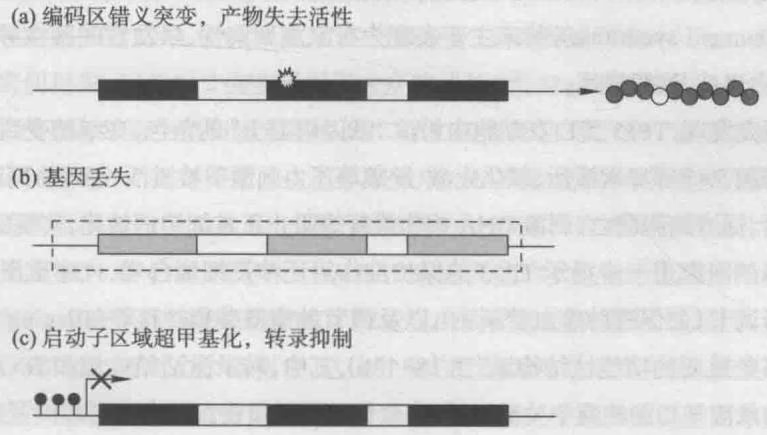
(c) 启动子区域超甲基化,转录抑制
图18-11 肿瘤抑制基因发生功能丧失性突变的常见机制
(图 18-12a), 第一次突变发生于生殖细胞中, 造成个体的每一个体细胞均带有一个突变, 成为杂合子; 在此基础上发生的第二次突变是体细胞突变。两次突变累积才能完全破坏肿瘤抑制基因的正常功能。在散发性病例中 (图 18-12b), 需要同一个体细胞在一对等位基因上发生连续两次失活突变, 发生概率较低。因此, 遗传型肿瘤病例常为双侧或多发且发病较早; 而散发性病例常为发病晚, 且多单侧发病。值得注意的是, 当肿瘤抑制基因的一个拷贝发生突变, 体细胞成为突变杂合子时, 另一个正常的等位基因也会出现丢失或突变的趋势, 我们称之为杂合性丢失 (loss of heterozygosity, LOH)。造成杂合性丢失的机制不是唯一的, 已知机制包括体细胞分裂中染色体不分离、体细胞重组、基因突变、表观遗传等。由于存在杂合性丢失, 从生殖细胞继承了一个拷贝突变型肿瘤抑制基因的个体发生第二次突变的概率较未携带突变的个体高, 他们通常表现出更高的肿瘤易感性。
(a)
(b)
图 18-12 遗传性视网膜母细胞瘤(a)与散发性视网膜母细胞瘤(b)的突变过程
除了 $Rb$ 基因, 还有很多肿瘤抑制基因在肿瘤细胞中突变频率高, 且和家族性肿瘤关系密切。例如研究最为广泛的 TP53 基因, 它编码由 393 个氨基酸组成的相对分子质量为 53 \times 10^{3} 的核内磷酸化蛋白, 因此得名。从 1979 年首次报道 TP53 与肿瘤相关至今, 全球研究者已花费了 40 余年的时间对 TP53 进行功能研究, 发现 TP53 几乎参与了肿瘤发生的各个途径, 临床上超过 $50%$ 的肿瘤细胞携带 TP53 突变。此外, 发生在生殖细胞的 TP53 突变会导致利-弗劳梅尼综合征 (Li-Fraumeni syndrome), 临床主要表现为有家族聚集性、早发性的恶性肿瘤, 如软组织肉瘤、骨肉瘤、白血病、胰腺癌等。
研究发现, TP53 蛋白在细胞内扮演“基因组卫士”的角色, 在细胞受到 DNA 损伤药物刺激、原癌基因 RAS 等异常激活、氧化应激、缺氧等压力刺激下被激活, 通过协同诱导细胞衰老、细胞周期阻滞、促进细胞凋亡、刺激 DNA 损伤修复等阻止正常细胞的转化, 实现保护作用 (图 18-13a)。近年来的研究进一步揭示 TP53 的保护性作用还涉及细胞自噬、代谢重塑、干性调节、肿瘤微环境信号调节 (如促进肿瘤血管新生), 以及调节肿瘤侵袭和转移等 (Bieging 等, 2014)。TP53 蛋白包含多个重要的功能性结构域 (图 18-13b), 其中, 转录激活结构域和 DNA 结合结构域是 TP53 发挥转录因子功能的两个关键区域, 寡聚化结构域负责调节自身形成同源四聚体, 自主调节结构
图 18-13 肿瘤抑制基因 TP53
(a) TP53 参与肿瘤发生发展的基本途径(引自 Bieging 等,2014)。
(b) TP53 的结构: TA, 转录激活结构域; PR, 脯氨酸富集结构域, 参与蛋白质相互作用; DBD, DNA 结合结构域; Tet, 寡聚化结构域; Reg, 自主调节结构域, 含有较多碱性氨基酸, 能够封闭 DNA 结合结构域的功能。
域位于 C 端, 含有较多碱性氨基酸, 能够封闭 DNA 结合结构域的功能。TP53 在肿瘤中的调节功能与它的结构密切相关: 一方面, TP53 通过蛋白质互作 (如 E3 连接酶 MDM2 等) 与氨基酸修饰 (如 S46 的磷酸化、K164 的乙酰化等) 动态调节其自身活性, 另一方面, TP53 利用其转录因子活性转录调节一系列靶基因, 如凋亡相关基因 Fas、Bax, 衰老相关基因 Cdkn1a 等。临床上已发现的 TP53 突变类型超过上千种, 但绝大多数突变位点都集中分布在 DNA 结合结构域内, 这和 TP53 的生物学功能是完全一致的。
以 BRCA1(breast cancer 1) 和 BRCA2(breast cancer 2) 为代表的一些 DNA 损伤修复基因也是肿瘤抑制基因的重要成员。它们在哺乳动物中高度保守,通过修复 DNA 损伤维持基因组稳定性,一旦发生突变,会导致更多的 DNA 损伤积累,产生更多变异,从而促进肿瘤的发生。近年来,因为与家族性乳腺癌密切相关,BRCA1/2 突变吸引了大众的关注(图 18-14)。遗传分析发现,大量早发性乳腺癌家族中的患者带有生殖细胞来源的 BRCA1/2 有害突变,患者的一次 BRCA1/2 突变发生在生殖细胞中,另一次 BRCA1/2 突变发生在体细胞中。临床数据显示,普通女性在 80 岁之前患乳腺癌和卵巢癌的概率大约为 12% 和 1.3%,但携带一个 BRCA1 有害突变的女性罹患乳腺癌的概率会分别上升至 72% 和 44%,携带一个 BRCA2 有害突变的女性罹患乳腺癌的概率会分别上升至 69% 和 17%。与此同时,携带 BRCA1/2 突变也会大幅增加胰腺癌、膀胱癌、结肠癌等的发病风险。需要强调的是,对每个个体而言,这些肿瘤的发病风险还受到年龄、家族成员发病情况及 BRCA1/2 突变位点和突变形式的影响。由于 BRCA1/2 突变在家族性乳腺癌中的致病
该家族中多位女性和男性在60岁之前罹患癌症,癌症类型包括乳腺癌、卵巢癌和膀胱癌。遗传模式呈现常染色体显性遗传的特征(不完全外显)。括号内数字为癌症确诊时年龄,IV-1和IV-2年龄都还小于30岁。
贡献高,研究者在20世纪90年代利用我们在前述章节介绍的家系连锁分析法,以上百个乳腺癌家系为遗传分析材料,成功定位了BRCA1/2基因。
三、病毒感染与肿瘤
原癌基因和肿瘤抑制基因都是人类基因组中的基因,但还有约 $5%$ 的人类肿瘤是由外源的病毒感染引起的,例如我们在基因组章节介绍的乙肝病毒可以诱发肝癌,且乙肝病毒的慢性感染是肝细胞癌最主要的危险因素。人类对肿瘤的认识最早也开始于致癌病毒的研究,早在1911年,病毒学家劳斯(Francis Peyton Rous,1879—1970)就报道了病毒感染可以诱发家鸡形成肿瘤,这一病毒随后也被命名为劳斯肉瘤病毒(Rous sarcoma virus,RSV)。到了50年代,意大利病毒学家杜尔贝科(Renato Dulbecco,1914—2012)进一步揭示致癌病毒感染宿主细胞后,能够整合到人类基因组中,跟随宿主细胞一起转录和复制。
能够致癌的病毒可以分为 DNA 病毒和 RNA 病毒两大类,但两者采用的主要机制不同。DNA 病毒常利用自身的蛋白质产物抑制宿主肿瘤抑制基因产物的活性,而 RNA 病毒多数通过激活宿主细胞内原癌基因发挥作用。
人乳头瘤病毒(human papilloma virus, HPV)是一种典型的可诱发肿瘤的DNA病毒。HPV有100多种,只有部分和恶性肿瘤密切相关,被称为高危型HPV。1983年,德国病毒学家豪森(Harald zur Hausen, 1936—)首次揭示宫颈癌的发生与高危型HPV感染密切相关。现在发现,临床上 $70%$ 的宫颈癌是由高危型HPV16和HPV18感染造成的。今天全世界范围内使用最为广泛、时间最长的人类细胞株HeLa就是一株携带HPV18的宫颈癌细胞,它于1952年被分离和培养,如今遍布全世界的肿瘤研究实验室。值得指出的是,尽管有性生活的妇女都有较高的可能性感染HPV,但机体正常的免疫系统可在数月内清除绝大多数HPV,只有长期且持续的高危型HPV感染会导致宫颈癌的发生。
当高危型 HPV 长期感染人后,病毒基因组会整合到人类染色体上,利用宿主细胞表达自身的病毒基因(图 18-15)。高危型 HPV 的早期基因编码的 E6 蛋白能够与宿主细胞的 TP53 蛋白结合,诱导 TP53 的泛素化降解,抑制细胞凋亡。与此同时,另一早期基因编码的 E7 蛋白能够与 Rb 蛋白结合,促进细胞复制与分裂,最终使得这些肿瘤抑制基因的产物同时失去了活性,造成恶性转化。
除了 HPV, 其他 DNA 病毒致癌的机制也是类似的。例如, 腺病毒 (adenovirus) 通过编码不同蛋白质(E1A、E1B)分别抑制宿主细胞内的TP53和Rb蛋白活性,猿猴空泡病毒40(simian vacuolating virus 40,SV40)编码的大T抗原(T antigen)也能利用不同的结构域分别识别和抑制TP53和Rb的活性。
图 18-15 正常宫颈组织及不同程度的宫颈上皮内瘤样病变的示意
图(引自 Woodman 等,2007)
与 DNA 病毒不同, RNA 病毒多数通过激活宿主细胞内原癌基因发挥作用。1970 年, 杜尔贝科的两位学生, 美国生物学家巴尔的摩 (David Baltimore, 1938—) 和遗传学家特明 (Howard Martin Temin, 1934—1994) 进一步发现一些 RNA 病毒感染人类细胞后, 能够利用自身的反转录酶将 RNA 遗传物质转变为 DNA 后整合到宿主基因组中, 这类病毒被称为反转录病毒。他们的工作在当时不仅改变了人们对中心法则的认识, 也揭示了另一类致癌病毒的关键机制。
根据致癌机制的不同,RNA病毒进一步分为慢性肿瘤病毒和急性肿瘤病毒。慢性肿瘤病毒通过将病毒基因整合到细胞内正常原癌基因附近,利用病毒基因组末端LTR中的强启动子作用于细胞癌基因,诱发癌变,如小鼠乳腺肿瘤病毒(mouse mammary tumor virus,MMTV)可以诱导小鼠乳腺肿瘤。在这些肿瘤细胞中发现,MMTV的插入位点通常在成纤维细胞生长因子编码基因附近,病毒基因的插入导致生长因子的上调表达,从而促进了肿瘤的发生。通常这类病毒需要感染较长时间后才启动肿瘤发生,所以被称为慢性肿瘤病毒。
急性肿瘤病毒的基因组中带有病毒癌基因,即能够使正常宿主细胞发生恶性转化的病毒基因组中的基因。这类RNA病毒感染人细胞后,病毒癌基因在宿主基因组中表达并发挥转化作用,致癌时间较短。如RSV病毒携带一个病毒癌基因v-src,能够编码有活性的酪氨酸激酶,刺激宿主细胞的快速增殖,造成转化。毕晓普和瓦尔默斯在研究中发现脊椎动物细胞基因组中有和v-src高度同源的原癌基因c-src,正如上文所介绍的那样,这些原癌基因存在于脊椎动物自身的基因组中,在变异后促进细胞癌变。对比c-src和v-src,前者是典型的真核基因,具有外显子和内含子,而后者没有内含子序列,再考虑到c-src在酵母到人中都有同源序列,具有重要的生长调控作用,研究者们认为病毒癌基因事实上起源于动物的基因组,是在病毒和动物的长期共同演化过程中形成的。为了区分存在同源性的动物细胞内的原癌基因和病毒中的癌基因,我们也可以把细胞内的原癌基因称为细胞癌基因(c-oncogene),病毒中的同源基因称为病毒癌基因(v-oncogene)。我们利用表18-1总结了一些常见的病毒与癌症的关系,可以看到不同病毒影响宿主细胞的方式各有不同。
表 18-1 几种常见致癌病毒以及它们诱发癌症的主要机制
| 病毒 | 与癌症诱发有关的基因 | 诱发癌症的主要机制 |
| RNA 病毒 | ||
| 劳斯肉瘤病毒 | v-src | 活跃的酪氨酸激酶,刺激细胞增殖 |
| 大鼠肉瘤病毒 | v-ras | 活跃的 GTP 酶,刺激细胞增殖 |
| 猿肉瘤病毒 | v-sis | 活跃的生长因子,刺激细胞增殖 |
| 小鼠乳腺肿瘤病毒 | 无 | 插入突变 |
| 莫洛尼鼠白血病病毒 | 无 | 插入突变 |
| 猫白血病病毒 | 无 | 插入突变 |
| DNA 病毒 | ||
| 人乳头瘤病毒 | E6、E7 | 结合和抑制 TP53 与 Rb |
| 腺病毒 | E1A、E1B | 结合和抑制 TP53 与 Rb |
| 猿猴空泡病毒 40 | SV40gp6(large T antigen) | 结合和抑制 TP53 与 Rb |
| 乙肝病毒 | HBX | 结合和抑制 TP53 |
四、表观遗传与肿瘤
近年来,随着表观遗传学研究不断深入,很多表观调控手段也与肿瘤的发生密不可分。例如,我们在上文提到过,启动子区域的超甲基化是肿瘤抑制基因失活的一种常见途径,这一失活方式不依赖于基因组的遗传变异,而与基因的表观调控有关。除此之外,在肿瘤细胞中,着丝粒区域异染色质的甲基化水平偏低,造成了有丝分裂重组事件的增加,诱发体细胞基因组的不稳定,这也是甲基化调控手段影响肿瘤发生的重要方式之一。
ncRNA 中的 miRNA 与肿瘤的功能与联系也是当下的一个研究热点。一方面,由于人类基因中绝大多数蛋白质编码基因都受到 miRNA 的转录后表达调控,那些靶向原癌基因和肿瘤抑制基因的 miRNA 也很可能参与了肿瘤发生发展的调控(图 18-16a)。另一方面,研究显示,在多种肿瘤细胞中出现 miRNA 编码基因的遗传变异或表达和加工的异常,涉及肿瘤的发生、发展和转移等各个过程。那些在正常细胞中靶向调节肿瘤抑制基因,在肿瘤细胞中表达量异常上升的 miRNA 很可能是促进肿瘤发生的致癌性 miRNA(oncogenic miRNA)。例如在慢性淋巴细胞白血病、淋巴瘤、肺癌、乳腺癌和结肠癌中都检测到异常高表达的 miR-155, miR-155 的转基因小鼠出现了前 B 细胞的异常增殖,进而发展为白血病。类似作用的 miRNA 编码基因还包括 miR-21、miR-17-92 等。相反,在正常细胞中靶向调节原癌基因,在肿瘤细胞中表达量异常下降的 miRNA 通常是肿瘤抑制性 miRNA(tumor suppressor miRNA),如 let-7 基因家族、miR-15a 和 miR-34 基因家族等。研究者已在包括肺癌、结肠癌、胃癌、卵巢癌、乳腺癌等肿瘤细胞中报道了 let-7 基因家族发生转录抑制、基因丢失或点突变等基因失活的现象。在正常细胞中,let-7 家族能够靶向抑(a) 肿瘤细胞中异常表达的两种类型的肿瘤相关 miRNAs。(b) TP53 基因与 miRNA 的相互调控关系: TP53 的 mRNA 受到致癌性 miRNAs 的转录后调控, 与此同时, TP53 蛋白质可以转录调节肿瘤抑制性 miRNAs 共同执行肿瘤抑制功能。
制多个关键原癌基因如 KRAS、MYC 等的表达。
正如我们在表达调控这一章所介绍的,miRNA 的表达调控具有细胞类型的特异性,且 miRNA 能够松散地结合靶 mRNA,因此一条 miRNA 可以调控不同的靶 mRNA,且一条 mRNA 可能受到多条 miRNA 的调控,因此在肿瘤发生发展的过程中,miRNA 可以通过调节不同的靶基因影响肿瘤的进程。与此同时,不同的 miRNA 还可能相互协作,共同调节肿瘤细胞内的信号网络。
在肿瘤的研究过程中,我们还发现,蛋白质编码基因和 miRNA 之间也可以通过相互作用,共同影响肿瘤发生发展,代表性的案例就是 TP53(图 18-16b)。一方面,TP53 自身受到多个 miRNA 的转录后调控,这些靶向 TP53 的 miRNA 扮演的是促进肿瘤发生的角色,另一方面,TP53 编码的转录激活因子,又可以转录调控大量 miRNA 共同发挥肿瘤抑制的作用。
综上,肿瘤的发生发展是不同遗传因素相互作用、遗传因素和环境因素相互作用的异常复杂的过程。从20世纪初揭示第一个致癌病毒到今天,尽管我们还未能了解肿瘤发生发展的全貌,但已有的研究已经为制定科学的肿瘤预防、诊断和治疗策略提供了大量的理论基础,这些成果无疑是鼓舞人心的。
2006年,美国国家癌症研究所和NHGRI联合启动了癌症基因组图谱,即TCGA计划。项目旨在将基因组测序,转录组测序、甲基化等表观组学测序数据加以整合,并结合临床影像数据等,绘制多维度、多癌种的基因组图谱。2018年,项目汇总发表了12年研究取得的数十项代表性成果——包含11000份样本,涉及33种最常见肿瘤类型的“泛癌症图谱(Pan-Cancer Atlas)”,数据量达到 $2.5\mathrm{Pb}$ 。现今,TCGA的全部数据对全球所有的医生和研究人员免费公开,作为迄今为止最大最全最系统的癌症数据库,它必将开启肿瘤研究的新时代。
第三节 利用肿瘤遗传变异特征改进肿瘤治疗策略
尽管肿瘤是人类健康的首要危险,但目前临床上三成左右的肿瘤是可以治愈的。理想的肿瘤治疗方案应该能去除所有的癌细胞,同时又不影响正常细胞,但在实际过程中很难达到这一理想状态。临床上常用的传统肿瘤治疗策略包括手术、化疗(chemotherapy)和放疗(radiation therapy)。
手术切除可以有效减少或消除肿瘤负荷,但它通常适用于未发生侵袭和转移的良性肿瘤,并会辅以化疗和放疗的治疗手段以进一步杀死可能残留的癌细胞,巩固治疗效果。显然,如果能提高癌症筛查手段,在肿瘤很小的时候就检测到肿瘤,那么患者被治愈的可能性就很大。例如,女性的宫颈涂片检查对于发现早期宫颈癌具有重要帮助,胸部CT检查是早期肺癌的有效筛查方法,还有血清癌胚抗原的检测是一种广谱性的筛查方法。当下,很多研究者致力于根据肿瘤遗传变异的特点开发特异性的肿瘤标记物,其目的就是提高早期肿瘤筛查的灵敏性、准确性和安全性。
化疗指的是使用化学药物抑制肿瘤生长。化疗既是晚期肿瘤的主要治疗手段,也是手术治疗前后的辅助手段。绝大多数化疗药物的作用是杀死快速分裂的细胞,因此它的缺点显而易见,即不能区分恶性的肿瘤细胞和正常快速分裂的细胞,如骨髓细胞、肝细胞和肠胃表皮细胞等。这也是化疗常见副作用的产生机制。化疗药物的效果与它的使用剂量密切相关:如果产生治疗效果需要的剂量和产生不可逆副作用的剂量的比值越大,说明药物特异性和安全性越好。反之,如果比值很低,说明药物的特异性差,且安全性不足。和化疗的原理类似,放疗是利用射线来抑制和消灭肿瘤细胞,放疗的射线剂量也与治疗效果密切相关。
一、靶向治疗
靶向治疗(targeted therapy)是一种新颖的化疗方法,本质上也是利用化学药物抑制肿瘤生长,但靶向治疗以肿瘤发生和发展过程中的特异性调节因子为靶标,通过干预这些因子的活性实现抑制肿瘤生长和扩散的治疗目标,也称为分子靶向治疗。相对传统手段,靶向治疗的主要优点包括特异性好,效果明显且对正常细胞造成的副作用小。靶向治疗的发展得益于我们在上一节介绍的肿瘤相关遗传变异的研究积累,肿瘤细胞中特定的变异基因的蛋白质产物正是靶向治疗的理想靶点,例如肿瘤细胞内部持续激活的细胞生长信号通路,凋亡途径以及免疫系统等。
靶向治疗可以采用的药物形式主要包括小分子药物和单克隆抗体。前者的筛选方法是首先设计和合成小分子化合物库,再针对靶标分子进行高通量的初步筛选,获得候选分子后进行进一步的化学修饰,以提高药物的治疗效果、稳定性和安全性。而抗体药物的筛选方法通常需先制备靶标分子,免疫动物制备特异性抗体,再利用基因工程手段进行人源化改造,防止抗体因被识别为异源蛋白而被免疫系统清除。
第一个临床使用的肿瘤靶向治疗药物是格列卫(Gleevec),即甲磺酸伊马替尼(imatinib mesylate)。2001年5月,美国食品与药物监督管理局批准格列卫治疗BCR-ABL融合蛋白阳性的CML患者。我们在上一节已经介绍了染色体相互易位产生的组成型激活的BCR-ABL融合蛋白是部分CML患者的发病原因,由于患者体内只有肿瘤细胞携带这种特殊的融合蛋白,正常细胞没有,因此,BCR-ABL融合蛋白是一个非常理想的治疗靶标。在20世纪80年代末,研究者从成千上万个化合物中筛选到了一个具有蛋白质激酶抑制活性的分子,经过一系列的改造之后,他们惊喜地发现格列卫结合和抑制BCR-ABL融合蛋白的活性很高,且可以口服给药(图18-17)。
图 18-17 格列卫抑制肿瘤的主要机制
(a) BCR-ABL 蛋白具有激酶活性,结合 ATP 后磷酸化底物蛋白,促进 CML。(b) 格列卫通过竞争结合 BCR-ABL 的 ATP 结合位点抑制其激酶活性。
动物和临床实验进一步揭示它的肿瘤抑制效果显著,尤其是患者的5年生存率可达80%~90%,格列卫快速通过了审批并上市。格列卫既是第一个也是非常成功的肿瘤靶向药物,主要原因正是费城染色体阳性的CML患者遗传致病机制的发现。
另一个非常成功的肿瘤靶向治疗药物是易瑞沙(Iressa),即吉非替尼(Gefitinib),这是一种靶向EGFR的抑制剂,也是首个批准上市的EGFR靶向治疗小分子药物。EGFR是位于细胞膜上的一种酪氨酸激酶受体,在多种上皮细胞来源的实体瘤中高表达,与肿瘤发生及发展有着密切联系。易瑞沙能够竞争ATP结合到EGFR胞内的激酶结构域上,阻断EGFR的自磷酸化,从而阻断EGFR活化及信号转导通路。动物实验发现,易瑞沙能广泛抑制异种移植于裸鼠皮下的多种人类肿瘤细胞的生长,并提高化疗、放疗及激素治疗的抗肿瘤活性。临床实验进一步证明易瑞沙对局部晚期或转移性非小细胞肺癌具有明显的抗肿瘤效果,可改善疾病相关的临床症状。2003年5月美国食品与药物监督管理局批准易瑞沙用于治疗晚期非小细胞肺癌。但是,和BCR-ABL只存在于CML患者的肿瘤细胞中不同,EGFR同样存在于一些人体的正常细胞之中,因此抑制EGFR的药物也会造成一些明显的副作用,主要表现为皮疹、腹泻和食欲下降。
易瑞沙的临床实验还发现一些有趣的现象,首先,部分非小细胞肺癌患者对易瑞沙尤为敏感,治疗效果更为显著。研究发现这些患者均携带了EGFR的基因突变,且突变集中影响了EGFR蛋白酪氨酸激酶域的ATP结合位点,主要类型包括L858R错义突变和19号外显子缺失突变这两种类型。由于EGFR突变会导致细胞内的抗凋亡途径被激活,促进了肿瘤的发生发展;当易瑞沙竞争结合EGFR后,可以关闭这一抗凋亡途径,促进肿瘤细胞走向凋亡,从而抑制肿瘤生长。其次,针对不同人群的临床实验发现易瑞沙对东亚地区非吸烟的女性非小细胞肺腺癌的患者效果较其他人群明显。其原因也是这个群体携带EGFR突变的频率在不同人群中最高(约 $50%$ ),但高突变率的具体原因尚不知晓。易瑞沙的临床实验结果充分说明了靶向治疗药物的“靶向性”,即只有患者肿瘤细胞携带特定的“靶标”,这些药物才能发挥特定的疗效。这也是为什么肿瘤科医生如果要考虑给肺癌患者选用易瑞沙,将会首先进行患者EGFR突变检测的原因。
除了小分子靶向治疗药物,单克隆抗体也在肿瘤靶向治疗中发挥了积极作用。研究发现,抗体类的靶向治疗药物可能通过以下三种不同的机制抑制肿瘤发生和发展:①抗体与肿瘤细胞表面抗原结合后直接诱导肿瘤细胞死亡;②抗体刺激多条免疫途径(如巨噬细胞吞噬,激活抗体依赖的细胞毒作用,补体途径等)的活化,介导肿瘤细胞死亡;③抗体与肿瘤微环境中的抗原结合,清除肿瘤血管和间质组织细胞,间接抑制肿瘤细胞的生长。
赫赛汀(Herceptin),即曲妥珠单抗(Trastuzumab),是另一类表皮细胞生长因子受体家族成员 HER-2 (human epidermal growth factor receptor 2) 的特异性抗体, 也是第一个被美国食品与药物监督管理局批准上市的抗体类靶向药物, 被首先用于 HER-2 高表达的乳腺癌患者或者 HER-2 阳性的胃癌患者。赫赛汀能够与细胞表面的 HER-2 结合, 干扰 HER-2 的自磷酸化, 抑制 HER-2 受体向细胞内传导信号, 从而抑制肿瘤生长。临床上有 15%~25% 的乳腺癌患者存在 HER-2 基因扩增或 HER-2 蛋白表达过高的现象, 造成 HER-2 功能亢进。临床实验显示 HER-2 突变阳性患者对赫赛汀治疗具有良好的应答。
尽管靶向治疗已经有效延长了很多晚期癌症患者的存活时间,但它也面临着很多问题,例如治疗费用昂贵、研发周期长等,其中,药物耐受是一个临床上迫切需要解决的问题。靶向药物的药物耐受分为原发耐药(intrinsic resistance)和继发耐药(acquired resistance)。原发耐药指的是患者肿瘤发生的分子机理和药物的靶标分子无关。在肿瘤发生发展的过程中,遗传变异的积累过程千差万别,肿瘤患者的遗传差异巨大,即遗传异质性高。由于靶向药物的靶标分子通常是单一的,存在遗传差异的肿瘤患者对靶向药物的敏感性必然不同。例如,易瑞沙只适用于拥有EGFR特定突变的肺癌患者,对没有EGFR突变的患者治疗效果有限。因此,原发耐药的问题可以通过遗传学研究揭示药物的确切靶标,再通过对患者进行遗传测试得到解决。
继发耐药,又称为逃逸性耐药、适应性耐药,是肿瘤临床治疗面临的主要挑战。继发耐药产生的主要原因可能包括以下两种,一是肿瘤发展后期,肿瘤细胞还会产生新的遗传变异,由于靶向药物作用单一,从而失去效应;二是肿瘤细胞在靶向药物的作用压力下,利用抵抗靶向药物的补偿途径拮抗药物的作用。例如,易瑞沙的长期临床试验结果发现,携带EGFR突变的患者在长期使用后,部分出现了药物耐受,对耐受群体进行进一步的遗传测试发现他们产生了新的遗传变异,包括点突变、基因扩增等,涉及多个肿瘤相关基因。但吸引研究者的是,这其中又有 $50%$ 的新突变都是一个相同的EGFR新发突变,即T790M(图18-18)。这一耐药机制的发现促进了新一轮靶向药物的研发,2013年3月到2015年11月,针对EGFR的T790M突变的第三代靶向药物泰瑞莎(Tagrisso),即奥希替尼(Osimertinib),从实验到上市仅仅花费了两年半的时间,又成功延长了很多患者的生存时间。
当下,靶向治疗的继发耐药仍然面临巨大挑战,一方面,针对耐药性的新靶向药物的研发需要大量时间,另一方面,即使是泰瑞沙这类新型靶向药物,耐药性问题依然没有从根本上得以解决。近年来,研究者已发现部分肺癌患者对泰瑞沙也产生了耐药性,他们的肿瘤细胞内部又出现了EGFR的C797S新发突变。为进一步解决这些耐药问题,正在研究和尝试联合治疗的方法,例如化疗联合靶向治疗,多重靶向药物联合或者靶向治疗联合下文介绍的免疫治疗等。
二、免疫治疗
我们已经介绍过癌症细胞的特点,除了异常增殖、侵袭和转移之外,癌症细胞还能够躲避机体的免疫系统,逃避免疫清除。早在100年前,就有学者尝试利用免疫系统来治疗肿瘤。在传统的肿瘤化疗中,干扰素、白介素2等细胞因子的使用也是旨在通过提高肿瘤患者的免疫系统实现肿瘤抑制。此外,上文介绍的靶向治疗中的一些抗体类药物(如赫赛汀等)也有一定的免疫系统激活作用。但在临床上,这些药物适用的肿瘤类型很少,治疗效果也较为有限。
近年来,一些新颖的癌症免疫治疗方法的临床实践取得了意想不到的效果,引起了全球研究者和临床医生的关注。2013年,Science杂志将癌症的免疫治疗(immunotherapy)评选为年度突破性研究进展之首,代表肿瘤的免疫治疗进入了一个全新的时代。癌症的免疫治疗指的是以正常免疫细胞(而非癌症细胞)为靶点,通过调控人体自身的免疫系统来治疗癌症的策略。从理论上讲,癌症的免疫治疗具有一些明显的优点:①相比于化疗常会出现免疫系统被破坏的情况,免疫治疗的目标是增强或修复个体的免疫系统;②免疫治疗的靶标是免疫系统,而非肿瘤细胞,所以无需针对特定肿瘤类型,理论上可对多种肿瘤有效;③由于免疫系统被修复或增强,可以抑制癌细胞的进一步变异,降低药物耐受的风险。
我们先简要介绍一种免疫细胞治疗方法,嵌合抗原受体T细胞免疫疗法(chimeric antigen receptor T-cell immunotherapy, CAR-T immunotherapy)。CAR-T免疫疗法是近年来发展起来的一种通过基因工程改造免疫细胞,从而增强免疫系统,实现抑制肿瘤生长的细胞治疗方法,目前主要应用于血液系统的肿瘤。美国食品与药物监督管理局于2017年8月通过了第一个CAR-T疗法Kymriah用于治疗复发或难治性儿童和年轻成人B细胞急性淋巴细胞白血病。CAR-T免疫疗法的核心技术是利用基因工程手段向患者的T细胞内导入能够识别肿瘤抗原的基因及T细胞活化基因形成CAR-T,赋予T细胞更强的识别肿瘤抗原并迅速活化杀伤肿瘤细胞的能力。CAR-T的治疗方法成功挽救了一些其他治疗手段全部宣告失败的白血病儿童。但另一方面,由于T细胞被过度激活,一些患者经历了严重的细胞因子风暴,直接威胁到生命安危。这提示,单纯提高免疫反应的强度不一定能够实现肿瘤抑制,且可能带来严重的毒副作用。揭示肿瘤细胞免疫逃逸的遗传机制,针对肿瘤发生发展过程中的免疫缺陷选择特异性的靶标分子设计干预药物,是癌症免疫治疗的新出路。
在20世纪末,美国免疫学家艾利森(James Patrick Allison, 1948—)和日本免疫学家本庶佑(Tasuku Honjo, 1942—)先后发现了免疫系统中的重要负调控分子,位于T细胞表面的细胞毒性T淋巴细胞相关蛋白4(cytotoxic T lymphocyte antigen 4, CTLA-4)和程序性细胞死亡受体1(programmed cell death1, PD-1),它们被称为免疫检查点(immune checkpoint)(图18-19)。这是一类在免疫系统中能够调节免疫反应的分子,动态控制机体的免疫系统活性。正常情况下,机体的免疫检查点处于抑制状态,防止免疫系统攻击自身组织。但当机体受到病原体感染或体细胞发生有害变异时,免疫检查点会被激活,启动免疫反应,及时清除各种病原体或变异细胞,以维持机体健康。但是,在肿瘤细胞中,这些免疫检查点被抑制,肿瘤细胞得以逃避免疫监视和清除。
以 PD-1 为例, 在正常组织中, T 细胞表面的 PD-1 通过与抗原呈递细胞表面表达的配体 PD-L1 或 PD-L2 结合, 抑制 T 细胞的增殖和活化, 保护免疫系统攻击自体, 引发免疫系统疾病。
抗原呈递细胞表面表达的 MHC 和 B7 分子在正常条件下分别与 T 细胞表面的 TCR 和 CD28 分子结合,活化 T 细胞,调节免疫反应。与此同时,抗原呈递细胞表面还表达 PD-L1,可以与 T 细胞表面的 PD-1 结合,抑制 T 细胞活化。此外,T 细胞表面的 CTLA-4 可以和 CD28 竞争结合 B7,抑制 T 细胞活化。PD-1/PD-L1 和 CTLA-4/B7 是肿瘤细胞最常利用的免疫检查点。
而肿瘤细胞却狡猾地利用了这一特点,通过高表达PD-L1与T细胞结合,抑制T细胞活性,实现免疫逃逸。如果能够设计药物直接靶向免疫细胞表面的免疫检查点,就有望恢复免疫系统的活性,让机体主动识别和清除肿瘤细胞。基于这一理论假设,2006年,美籍华人免疫学家陈列平(1957—)率先开展了针对PD-1/PD-L1的抗体药物的临床实验,发现利用抗体阻断PD-1和PD-L1的结合能有效解除肿瘤细胞高表达PD-L1而造成的免疫抑制,成功恢复肿瘤微环境中的T细胞活性,实现肿瘤抑制作用。这一结果为随后全球范围内的免疫治疗药物研发奠定了重要基础。当下,两个抗PD-1的抗体药物,Opdivo和Keytruda,已经成为癌症免疫治疗领域最为成功的药物,被称为“免疫检查点抑制剂”。从2014年最先在日本获批上市至今,包括Opdivo和Keytruda在内的免疫检查点抑制剂被数十个国家批准用于多种肿瘤类型的一线和二线治疗,具体包括黑色素瘤、非小细胞肺癌、肾细胞癌、头颈癌和霍奇金淋巴瘤等。最近,将Opdivo和/或Keytruda与传统的化疗药物、其他免疫治疗药物(如抗CTLA-4抗体等)联合使用的治疗方案也在临床实验中取得了积极进展。
当下,基于“免疫检查点”的免疫治疗刚刚起步却发展迅速,成功挽救了不少“提前宣告死亡”的癌症患者,给患者、家人、医生和研究者们都带去了新的希望。但与此同时,我们也应该认识到免疫治疗的临床应用时间还非常短暂,受试人群数量小,治疗的安全性和有效性都还有待更加长期和全面的评估。与此同时,目前免疫治疗适用的肿瘤类型还是较为有限的,有限的受益人数和庞大的肿瘤发病率之间亦不相适应,高昂的治疗价格也让很多普通家庭望而却步,癌症的免疫治疗仍然任重而道远。借助遗传学研究精确描述肿瘤微环境中免疫细胞的失活机制,将患者的免疫系统正常化(而不是过度或异常地增强),被认为是未来癌症免疫治疗的正确发展道路。
习题
请解释以下名词: 肿瘤转移、癌基因、肿瘤抑制基因、病毒癌基因、靶向治疗、癌症免疫治疗。
遗传变异是肿瘤发生的重要风险因素,为什么遗传变异因素诱发的肿瘤多数仍然是不可遗传的?遗传性肿瘤与散发性肿瘤相比,它有哪些特点?
请简述肿瘤的基本特征。
肿瘤的发生发展是一系列肿瘤相关基因累积突变的结果,肿瘤相关基因主要包括癌基因和肿瘤抑制基因。请从以下几个方面分别讨论癌基因和肿瘤抑制基因的差别。
| 癌基因 | 肿瘤抑制基因 | |
|---|---|---|
| 正常情况下的基因功能 | ||
| 基因突变对正常功能的影响 | ||
| 发生突变的基因拷贝数 |
什么是肿瘤抑制基因的二次突变学说?肿瘤抑制基因突变造成的肿瘤案例中,有散发性和家族性之分,请从突变发生的时间简述这两种病例的主要差异。
为了分析肿瘤相关基因与肿瘤发生之间的联系,某研究小组分析肿瘤组织中候选基因的突变情况,发现:
(1) 基因 A 参与细胞周期调控, 肿瘤细胞内的基因 A 发生了功能获得性突变。请推测基因 A 参与肿瘤发生的可能机制。
(2) 基因 B 参与调节正常细胞凋亡, 肿瘤细胞内的基因 B 发生了功能丧失性突变。请推测基因 B 参与肿瘤发生的可能机制。
(3) 基因 $C$ 也参与调节正常细胞凋亡, 但未在肿瘤细胞中检测到基因 $C$ 任何形式的突变, 而是在其 CpG 岛出现了超甲基化。请推测基因 $C$ 参与肿瘤发生的可能机制。
(4) 肿瘤细胞内发现了来自于病毒基因组的基因 D, 请推测基因 D 参与肿瘤发生的可能机制。
BRCA1/2 突变是乳腺癌的重要危险因素, 是否所有女性都有接受 BRCA1/2 检测的必要?
请简述 DNA 病毒与 RNA 病毒致癌机制的差异。
靶向治疗中原发耐药和继发耐药有什么区别?针对这两种耐药问题,你认为有哪些解决办法?
请简述 PD-1 抗体抑制肿瘤生长的机制。
数字课程学习

在线自测 习题答案
第十九章 遗传与进化
在地球上,随着自然条件的变化,生物的进化经历着由简单到复杂、由低等到高等的长期历史发展过程。现代生物都是由过去生活的生物演变而来的,每种生物都与它的生活环境相适应。这些事实已为生物学的多个分支学科的研究所证明,如古生物学、比较解剖学、胚胎学、动物地理学和植物地理学、生态学、生理学、分子生物学等。而遗传学的研究不仅提供了更多的证据,更重要的是,从遗传学角度解释了生物进化的历史过程。
这一章先从分子水平介绍蛋白质和核酸的进化,然后讲述遗传体系的进化,再介绍现代的进化理论,并用这些理论来说明新种是怎样起源的,最后讨论一下育种实践中的人工选择和远缘杂交问题。
第一节 进化概述
在生物进化的研究中,最初注意的是进化的证据,而且证据偏重在形态方面,研究方法以比较和观察为主。遗传学的兴起和发展,使进化的研究逐渐转向进化的机理方面,采用的方法主要是群体遗传学(population genetics)的方法。随着分子遗传学的发展、生化分析等研究方法的采用,在分子水平上研究生物进化成为可能。
一、蛋白质进化
蛋白质的氨基酸顺序决定了它们的立体结构及其理化性质,而氨基酸顺序是由 DNA 的核苷酸序列所编码的,所以比较各类生物的同一种蛋白质序列,可以看出生物进化过程中遗传物质的变化情况。
有一些蛋白质在不同生物中执行着同一的任务,如细胞色素 c(cytochrome c)。细胞色素 c 是一种呼吸色素,在氧化代谢中担任电子转移作用。通过不同物种的细胞色素 c 的序列比对发现:在多肽链全长中,有一些部位的氨基酸序列非常恒定,另一些部位是多变的。恒定的或保守的部位可能在功能上很重要,它们或者是一些活性位点,或者是与正确的构型有关,或者是跟邻近的膜蛋白质的结合有关。多变部位可能是一些“填充”或间隔区域,氨基酸的变换对蛋白质的功能影响较小。
细胞色素 c 氨基酸序列的分析表明(表 19-1): 黑猩猩和人的 104 个氨基酸完全一样, 差异是 0; 猕猴和人的细胞色素 c 分子有一个氨基酸不同, 从肽链的氨基端算起, 猕猴的细胞色素 c 的第 102 个氨基酸是丙氨酸, 而人的是苏氨酸; 人和酵母菌的细胞色素 c 相差较远, 104 个氨基酸中有 44 个不同, 但这两种分子的立体构型基本相似。
表 19-1 各种生物的细胞色素 c 的氨基酸组成的比较
| 生物名称 | 氨基酸差别 | 生物名称 | 氨基酸差别 |
|---|---|---|---|
| 黑猩猩 | 0 | 响尾蛇 | 14 |
| 猕猴 | 1 | 金枪鱼 | 21 |
| 袋鼠 | 10 | 天蚕蛾 | 31 |
| 豹 | 11 | 小麦 | 35 |
| 马 | 12 | 粗糙链孢霉 | 43 |
| 鸡 | 13 | 酵母菌 | 44 |
注:表中数字表示各种生物和人的细胞色素 c 不同的氨基酸数目。
从表 19-1 看来, 和人的亲缘关系愈近的生物, 细胞色素 c 的氨基酸成分也和人愈相似。正因为有这种相互关系, 所以在分子水平上研究进化的速率成为一种可能。我们从古生物学的研究上已经知道各类生物相互分歧 (divergence) 的地质年代, 可以据此作图, 横轴代表任何两类生物间分歧后经过的时间, 纵轴代表蛋白质中每个氨基酸残基的平均替换率。图 19-1 就是根据这样的设想作成的图, 图中反映了细胞色素 c 和其他几种广泛存在的蛋白质的进化速率。
图19-1 4种蛋白质的进化速率
斜线代表进化速率, 改变 1% 氨基酸顺序需要的年数注明在括号中 (斜线上的竖线代表标准误)。
从图上可以看到,图中的线条都是直线,这意味着每一种蛋白质的进化速率都是相对恒定的,但是不同蛋白质的进化速率不同。例如,纤维蛋白肽的进化比血红蛋白快,血红蛋白的进化比细胞色素c快等。这可能是因为纤维蛋白肽有较多的部位可以变异,而不影响它们的功能。组蛋白则走向另一极端,可以调整的部位很少,氨基酸序列改变的机会也少。
二、核酸进化
在分子水平上探讨进化,更直接的方法是分析遗传物质——核酸本身。DNA 分析技术的快速发展也为核酸进化分析提供了便利。
(1) DNA 量的变化 在进化过程中,生物的 DNA 含量有一定的增加趋势。如果将病毒作为最简单的一类生物的代表,那么像 $\phi X$ 174 那样的病毒的 DNA 含量只够容纳 6~8 个基因(大约 6000 个核苷酸长)。而人类基因组约有 3 \times 10^{9} 核苷酸对。生物由简单的类型进化到复杂的类型,DNA 量的增加显然很重要。因为高度进化的、结构复杂的生物需要大量的基因维持它的生命和繁衍它的种族。事实上我们发现有很多基因只存在于高等生物中,例如血红蛋白、结合珠蛋白和免疫球蛋白编码基因等。
虽然从总的趋势来看,愈是高等的生物,DNA 的含量愈高,但是我们在基因组一章已介绍过,DNA 含量不一定总是跟生物的复杂程度成正比。所以大量的 DNA 并不是形成一个复杂的生物的充分条件。
(2) DNA 质的变化 在进化过程中,核酸不仅发生量的变化,而且还发生质的变化,也就是核苷酸序列的变化。
要测定两个种间的 DNA 差异, 过去常用的一个方法是分子杂交技术。简单的操作方法是: ①从两种生物 A 和 B 中提取 DNA, 加热, 使 DNA 分子变性成为单链。②在适当温度下, 将一个种的单链 DNA 与另一个种的单链 DNA 一起温育, 使形成杂种双链 DNA A-B。为了使种间 DNA A-B 能够和种内 DNA A-A 或 B-B 区分开来, 必须把一个种的 DNA, 例如 A 的 DNA, 用放射性同位素标记, 只放少量这种 DNA 到温育混合物中。因为 A 的 DNA 所占的分量很少, 所以很少有机会能形成 A-A 双链, 从而所有标记上了的双链 DNA 都可以被认为是杂种 DNA A-B。③把这种双链 DNA 提取出来, 检验它们的同源性。如果从两种生物 A 和 B 来的 DNA 完全同源, 核苷酸顺序相同, 那么杂种 DNA A-B 变性为单链的“熔解温度” (melting temperature) 跟 A-A 或 B-B 一样。如果两个种间的 DNA 有差异, 相互间核苷酸顺序不相同, 那么这样的杂种 DNA 就比较容易打开双链, “熔解温度” 较低。研究显示两种生物的核苷酸组成有差异时, 每增加 1% 的差异, 杂种 DNA 分子对温度的稳定性降低 1.6℃。所以不同种间的 DNA 的同源程度可以通过“温度稳定性” (thermal stability) 来估计。利用这种分子杂交技术, 研究者发现两个种间的亲缘关系近, 核苷酸差异就少; 而亲缘关系疏远, 差异就大。当下, 随着 DNA 测序技术的发展、基因组研究方法的成熟, 有越来越多的分子技术可以更好地用于进化分析。
三、遗传体系的进化
最初的遗传物质是 RNA, 还是 DNA? 一个观点是, 最初的遗传物质是 RNA, 因为 RNA 是基因和蛋白质间的桥梁。在进化早期,RNA 可能既能自我复制,又能在蛋白质合成中起作用。RNA 能自我复制,现在很多 RNA 病毒还保留着这个特性。在进化中,DNA 代替了 RNA,成为遗传物质,这可能有两个好处:① DNA 比 RNA 稳定;② DNA 和 RNA 有了分工,RNA 参与蛋白质的合成,而 DNA 专门储存遗传信息。
蛋白质合成机制在进化过程中必然也在发生变化。原始的蛋白质合成机制可能不很完善,在翻译过程中容易造成差错,同一密码子常被翻译为不同的氨基酸。在离体条件下,链霉素的存在、锰离子浓度的改变等都会造成错误,说明原始生物中出现错误是可能的。由于经常会发生错误,在原始生物中,由某一核苷酸顺序形成的蛋白质只是大致上相似,而不是完全相同。正是在这种情况下,遗传密码有可能发生变化,使错误逐渐减少,蛋白质合成机制逐渐完善。
从现有的遗传密码系统中的确可以看到某些机制能够减少错误的发生。首先,同义密码子中,前两个核苷酸是相同的,不同的是第三个核苷酸。在离体实验中,也是第三个核苷酸最容易错误,这样的编码机制可以防止氨基酸替换。其次,从氨基酸的改变对酶活性的影响来看,氨基酸可以分为两类:①对酶活性影响较大的,包括酪氨酸、组氨酸、赖氨酸、谷氨酸、色氨酸等;②对酶活性影响较小的,包括苯丙氨酸、亮氨酸、异亮氨酸、缬氨酸、丙氨酸、苏氨酸等。已经知道,密码子的第一个核苷酸的错误机会仅次于第三个核苷酸,而从图15-8可以看到,第一个核苷酸的错误所造成的氨基酸改变通常都属于同一类。例如UUU是苯丙氨酸,如果错误为CUU、AUU或GUU,则出现亮氨酸、异亮氨酸或缬氨酸,错误后替换的氨基酸仍属于同一类,通常不会影响酶的功能。
原始生物含有的氨基酸种类可能没有现生生物那么多,因此原始生物的每一种氨基酸可能有更多的密码子。以后氨基酸种类逐渐增加,新增加的氨基酸占用了原有氨基酸的密码子。现生生物的密码子几乎相同,这说明在生物进化的某一阶段,遗传密码可能被固定下来了。
以上关于遗传密码的进化、虽然有事实也有猜测,而且可能猜测多于事实,但是并不妨碍我们建立一种观点,即遗传密码也像生物的其他性状一样,经历了演化过程。
遗传物质的进化,遗传密码的改善,与遗传物质的结构和传递方式一起不断进展。这种进展最明显的是染色体的演变。在高等动、植物中,同一属中的几个种,染色体数目和形态有变化,往往可以据此追溯它们的演化过程。例如菊科针垫菊属的 Chaenactis fremontii(2n=10) 和 C. stevioides(2n=10)都是从 C. glabriuscula(2n=12)演化而来的,形态上也很相似,但是更耐干旱,分布在沙漠地区。这3个种相互杂交,可以得到杂种。根据杂种的减数分裂中染色体联会的情况,知道 C. fremontii 和 C. stevioides 各有一个复合染色体,但是复合染色体的结构不同(图 19-2)。复合染色体可能是易位后形成的,易位后染色体数目减少,使这两个种获得了更高的适应性。又如小麂(Muntiacus reevesi)的染色体组成是46,XX或XY,赤麂(M. muntjak)的染色体组成是6,XX或7,XY ${1}$ Y ${2}$ 。这两个种的染色体数相差悬殊,但是可以杂交,能产生杂种。根据染色体显带结果,发现小麂染色体和赤麂染色体的横纹有一定的同源性,据此推测在进化过程中,小麂的染色体通过连续易位,演变成赤麂的染色体(施立明等,1980)。在染色体畸变一章中介绍的同源多倍体和异源多倍体也很好地说明新种的形成也可伴随着染色体组的增加。可见,在遗传体系的进化中,染色体数目可能发生变化,位于染色体上的基因的排列组合也可能随之变动。
遗传体系的变化,还包括有丝分裂和减数分裂机制的发展。有丝分裂所形成的两个子细胞中,染色体完全一样,所有基因也完全一样,所以双亲的遗传信息可以通过受精卵的连续有丝分裂正确地传递下去。而减数分裂时,非同源染色体自由组合,同时同源染色体又可相互重组交换,
2Ⅱ + 2Ⅲ(B,BC,C + E,EF,F)
图 19-2 Chaenactis glabriuscula 和衍生种的染色体结构以及种间杂种的减数分裂时配对方式 (Moore, 1976)
4Ⅱ+1Ⅲ(E,EF,F)的意思是glabriuscula与fremontii的染色体在减数分裂时形成4个二价体和1个三价体,这个三价体是由glabriuscula的E和F染色体与fremontii的EF复合染色体配对后形成的。余类推。
产生多种多样的配子,受精后形成各种组合的合子,为进化提供丰富的素材。正因为这样的缘故,有丝分裂和减数分裂的机制自从在进化过程中建立以后,就几乎被所有生物继承了下来。
四、分子进化
正如上文所说,群体遗传学研究已经充分提示亲缘关系紧密的群体有许多相同的遗传变异特点,而关系较远的群体间遗传差异较大。因此,通过比较不同群体的 DNA 序列(或者氨基酸序列等)可以推断不同群体间的亲缘关系。随着分子生物学技术的发展,进化生物学的研究者们在群体遗传学的理论基础上,利用分子生物学技术对生物间的进化关系进行研究,并建立了一个和遗传学密切相关的新的生物学分支学科,即分子进化(molecular evolution),它包括两个基本依据:①亲缘关系与遗传差异之间存在关系;②多种同源大分子的平均进化速率近似恒定。
简要来说, 分子进化是通过利用系统树 (phylogenetic tree) 描述生物类群、个体或基因序列之间的进化关系。系统树由节点和分枝组成, 节点表示每个分类学单位, 任意两个相邻的节点由分枝来联结, 表示它们之间的联系, 枝长是该分枝中的变化数。我们结合图 19-3 来和读者进行简要说明。假设从 4 个亲缘关系待定的生物样本中分离得到了基因组 DNA 片段并成功测得了一段同源 DNA 的序列, 结果显示不同序列之间的变异分为两种, 一种是多条序列共享的变异, 如
同源基因 外显子1 内含子1 外显子2
样本1 A T
样本2 G C
样本3 —|——— T A ———— G C ———
样本4 $\mathrm{C}$ A G T
(a)
(b)
图 19-3 根据 DNA 序列差异绘制的系统树可以用于分子进化分析
(a)不同生物样本中一段同源DNA序列的遗传变异信息。(b)根据(a)的变异信息绘制的系统树。
1号外显子上的插入突变,很可能是较早发生的变异,传递给了多个物种;另一种是独特的变异,即有且仅有该物种自身含有这种变异,如序列3的外显子1上的缺失突变,说明该变异发生较晚,是该类生物在较晚的进化过程中产生的。根据这样的分析,研究者可以绘制出一棵系统树(图19-3b):由于4个样本的DNA序列是同源的,所以它们拥有同一个根节点,即我们认为他们拥有共同的祖先种;其次,样本3所拥有的所有变异都是独特的,这说明它在进化过程中最早独立并单独进化,因此是最早从系统树主干上独立出来的分支,而其余3个样本都共享了一个短序列的插入,它们有一个更近一点的共同节点,而这个短序列的插入就发生在从根节点到这个节点的进化过程中。其余的节点和分支可以以此类推,最终得到一棵简易的系统树。它的分支长度和节点位置充分说明了4个生物样本之间的亲缘关系远近,从根节点到每个分支末端的线路则描绘了进化中遗传变异在各个物种中是如何顺序发生的。
我们以人类起源为例简要介绍一些代表性的分子进化工作。人类起源的早期证据来自化石记录,但是在从智人到现代人的进化途径上,学术界一直存在着“多地区起源假说”和“非洲起源假说”的争论,即人类是从存在于欧洲、亚洲和非洲的智人种群分别演化而来的,还是从非洲完成智人的演化后再迁徙到世界各地的?分子进化提供了一种新颖且有效的研究方法。1987年,研究者对来自世界不同地域的147个现代人进行了线粒体DNA的遗传变异分析(Cann等,1987),发现了134个遗传变异类型,但都起源于一个共同节点,他们据此推测20万年前非洲大陆上的一位女性是今天地球上现代人的共同祖先(图19-4)。研究者之所以选择线粒体DNA进行分子进化分析是因为当时的DNA制备技术和序列分析技术还不够成熟,相比基因组DNA,线粒体DNA更容易获得且当时序列已知,更重要的原因还包括线粒体DNA变异率高,较少重组,遵循母系遗传。在这项工作之后,一些研究者利用更大的人群样本和分辨率更高的遗传变异分析技术进行了深入研究。例如,对上万名中国男性的Y染色体进行遗传变异分析,发现他们都共享了相同的 M168G 变异, 分子进化分析发现, 该变异在 3.5 万 ~ 8.9 万年前产生于非洲, 是部分非洲人特有的遗传标记, 这一发现进一步支持了现代人的 “非洲起源假说” (Ke 等, 2001)。
图 19-4 利用线粒体 DNA 进行人类起源的分子进化分析(引自 Cann 等, 1987)
第二节 进化理论
人类在长期的生产实践中,早已注意到了生物的变异,并且认识到新类型很可能是从旧类型来的,但是因为受到当时历史条件的限制,未能作深入的观察,所以一直停留在主观经验的地步,未能上升为理论。
科学工作者总结了前人的经验,并作了系统的观察,提出了说明进化机制的理论。生物进化的流行理论,细分起来很多,也还在不断发展之中。我们主要向读者介绍两个,一个是拉马克的获得性状遗传学说,另一个是达尔文的自然选择学说。
一、拉马克的获得性状遗传学说
法国生物学家拉马克在神创论统治的时代,率先提出了生物进化思想,具有划时代的意义。拉马克的进化学说指出,包括人在内的一切物种都是由别的物种演变而来的,生物在不断地同时缓慢地变异,从低等向高等逐级进化。物种(species)不是恒定不变的类群,而是由祖先种不断进化而来。
在分析生物进化的动力时,拉马克提出了来自内、外的两种力量,并认为来自外部的环境作用更大——环境变化使生物发生适应性变化,而环境的多样性是构成生物多样性的主要原因。
他看到,在生物的个体发育中,因为环境不同,生物个体有相应的变异,而跟环境相适应。例如年幼的树木在茂密的森林中,为了争取阳光,就长得高高的;多数鸟类善于飞翔,胸肌就发达了。他在1802年提出用进废退学说(theory of use and disuse)或获得性状遗传学说(theory of the inheritance of acquired characters)。学说的主要内容包括:①生物生长的环境使生物产生某些需求;②生物改变旧的器官,或产生新的痕迹器官(rudimentary organs),以适应这些需求;③继续使用这些痕迹器官,使这些器官的体积增大,功能增进,但不用时可以退化或消失;④环境引起的性状改变是会遗传的,因此这些改变了的性状可以传递给下一代。
洞穴中的鱼常常是视盲的,这可用拉马克的学说来说明。鱼的祖先在黑暗的环境中已有很多代,鱼在黑暗中,眼没有用处,逐渐退化,终于导致视盲。长颈鹿是最高的哺乳动物,头颈特别长,但是它与人和其他哺乳动物一样,也只有7节颈椎,只是每节颈椎非常长而已。长颈鹿的长头颈也可用拉马克的学说来说明。短头颈的祖先在食物贫乏的环境里,必须伸长头颈,来吃高树上的叶子,因比头颈长得稍稍长一点,这会传给后一代。后代又在相似的环境中,同样地需要把头颈伸得长一点,来吃更高树上的叶子,又使子代个体的头颈长得长一点。这样一代一代下去,长头颈的遗传特性继续加强,头颈逐步延长,终于成为现代的长颈鹿(图19-5)。
可见,“获得性状遗传”学说在解释生物进化的机制上强调了环境作用造成的性状改变可以遗传。在20世纪初遗传学发展起来之后,这一观点受到了广泛的质疑。这是因为,环境因素造成的性状变化一般都与蛋白质有关,例如鸟类因飞翔能力发达了胸肌,但是这种性状的变化是无法影响到生殖细胞的基因序列,也就无法通过遗传的方式传递后子代个体。因此,拉马克的“获
图19-5 获得性状遗传的例子
(a) 由于“内在欲求”的驱使, 短颈祖先伸长头颈, 吃高树上的叶子, 头颈的“使用”改变了动物的遗传性。(b) 祖先的遗传性改变后, 使子代个体的头颈稍稍长些。(c) 在很多代数以后, 后代的头颈都比祖先长很多。
“得性状遗传”一度被认为是缺乏实验证据的,无法得到遗传学的支持。但是,我们在前几章介绍的表观遗传学揭示了一类特殊的遗传变异现象,它们不涉及遗传物质DNA的序列改变,但能够影响个体的性状表现,更重要的是,它们受到环境因素的影响,而且它们对性状的调控方式可以遗传给后代。表观遗传的这些性质都能很好地与“获得性状遗传”吻合。随着表观遗传学研究的不断深入,拉马克的“获得性状遗传”理论也正在经历新的发展。
二、达尔文的自然选择学说
达尔文的自然选择学说(theory of natural selection),尤其是在现代遗传学基础上发展起来的自然选择学说,能够更合理地说明生物进化的历史过程。
达尔文的自然选择学说的主要论点包括以下几个方面:
(1)生物个体之间存在变异,好比每个人的外貌都不同,都可以相互识别。我们有时不能识别野生动、植物的个体差异,那是因为我们对材料不熟悉,如果熟悉了,也可以相互区别。
(2) 生物个体的变异, 至少有一部分来自遗传上的差异。在当时, 达尔文本人和所有其他科学工作者一样, 对遗传的概念是十分模糊的, 所以对这一点不能作出严格的论证。而现代遗传学证明, 每一个性状的个体差异 (表型差异) 都由遗传差异与环境差异两方面所造成, 只不过不同性状中, 两者在表型差异中所起的作用有着不同的比重而已。达尔文未能解决遗传差异是怎样产生的问题, 但这并不影响他的整个学说, 只要从 “生物的遗传属性是会改变的” 这个假定出发, 就可建立自然选择理论。
(3) 生物体的繁育潜力一般总是大大地超过它们的繁育率,这一结论是达尔文通过广泛而详尽的观察得出来的。例如一条鲱鱼约产卵 30 万粒,一株烟草约结种子 36 万粒,而实际上能够发育成为成体的只是其中很小的一部分,许多生殖细胞得不到发育的机会,许多胚胎和幼体在未达到性成熟以前就因养料缺乏、天敌和其他不利自然条件而死亡,只有其中少数比较健壮,它们的性状跟环境比较相适应,因此存活下来,达尔文把这个过程形象化地称之为“生存斗争”。从现代遗传学来看,或许称为“生存差别”更为合适些。
(4) 个体的性状不同,个体对环境的适应能力和程度有差别,这些不同和差别至少有一部分是遗传差异造成的,因此遗传性质不同的个体,它们本身的生存机会不同,留下后代的数目有多
有少,这个事实叫作“繁育差别”。
(5) 适合能力高的个体留下较多的后代,适合能力低的个体留下较少的后代,而适合能力的差异至少一部分由遗传差异决定,这样一代一代下去,群体的遗传组成自然而然地趋向更高的环境适应能力,这个过程就叫作自然选择。但环境条件不能永久保持不变,因此生物的适应性总是相对的。生物体不断地遇到新的环境条件,自然选择不断地使群体的遗传组成作相应的变化,建立新的适应关系,这就是生物进化中最基本的过程。
(6) 地球上生物居住的环境是多种多样的, 生物适应环境的方式也是多种多样的, 所以通过多种多样的自然选择过程, 就形成了多种多样的生物世界。
(7)生物通过自然选择而得到多种新的性状,其中有些性状或性状组合特别有发展前途,是生物适应方式的关键变革。如陆生植物中维管束组织的发展、种子生殖、脊椎动物的内骨骼、体温调节机制、胎生与哺乳等,这些改变是造成生物体从低等到高等发展的主要机制。
以上几点是达尔文自然选择学说的概要,中间也有一些地方是现代遗传学对这个学说的补充说明。达尔文的这个学说基本上是正确的,但如上面所讲的,也留下一些问题没有解决,例如遗传性变异如何产生,又怎样保持,这些问题都没有得到很好的说明。但是,现代遗传学进一步发展了自然选择的理论。
最后把达尔文“通过自然选择的进化学说”的要点图解如下:
三、突变为进化提供原材料
遗传变异主要有两个来源:一个是突变,包括基因突变和染色体畸变;另一个是重组。但突变是更加基本的,因为如果没有突变,就没有不同的等位基因,那就谈不到任何重组合,所以突变是最初始的原材料。
过去有人提出不同的看法,认为突变不能成为进化的原始材料,因为突变都是有害的。现在知道,这样的论点并没有足够的证据。用 X 线处理大麦,引起许多突变,其中大部分突变降低了植株的生活力或育性,800 个突变中大约只有 1 个突变或是增强了麦秆的强度,或是提早了成熟期,或是产生其他有利的性状,可供育种时选择使用。还有,新产生的突变是否有利,要看突变体所处的环境而定。例如,对噬菌体有抗性的大肠杆菌,在没有噬菌体的培养基上,它们生长得不好,远远不如对噬菌体没有抗性的大肠杆菌;可是在有噬菌体的培养基上,只有对噬菌体有抗性的大肠杆菌才能生长,对噬菌体没有抗性的大肠杆菌是不能生活的。可见衡量突变对生物体是否有利,要跟生物体所处的环境联系起来看。再举个例子,果蝇 D. pseudoobscura 品系的自然群体中,第 2 染色体的变异体很多,研究发现它们在不同温度下生活力不同(表 19-2)。可以看到,在不同温度中,第2染色体的不同类型的生活力不同。例如在25.5℃中,标准型的生活力比变异类型A、B和C都来得好,但在21℃和16.5℃中,变异类型C的生活力就比标准型还来得好。
表 19-2 果蝇 D. pseudoobscura 第 2 染色体的各种突变类型在不同温度中的生活力
| 第2染色体的各种类型 | 25.5°C | 21°C | 16.5°C |
|---|---|---|---|
| 标准型 | 100 | 100 | 100 |
| A | 99 | 98 | 100 |
| B | 95 | 89 | 87 |
| C | 92 | 109 | 109 |
根据上面的叙述,我们可以概括出下列两点:①有少数的突变是有利的,可以作为进化的原始材料;②突变的有利与否,因所处的环境而异。
四、新基因的起源
突变可使原有基因突变产生新的等位基因类型,那么“新”的基因从哪里来的呢?这里所谓新的基因,是指非等位基因,但基因的等位和非等位的概念原本是相对的。
在前续章节曾说过,每一基因的突变方向是有一定限制的。例如家蚕的普通斑基因(P)的突变不会越出皮斑的范围,小鼠的野鼠色基因(A)的突变总是在毛色的范围以内。不过这是针对一般情况而言的。如果我们从基因的遗传效应来讲,基因的作用主要是决定蛋白质的属性,而蛋白质的属性体现在20种氨基酸的排列上。有时,一些氨基酸排列很相似的多肽,也可能具有完全不同的生理效应。例如牛和羊中的催产素(oxytocin)是一个9肽,它的氨基酸序列是:
半胱氨酸—酪氨酸—异亮氨酸—谷氨酰胺—天冬酰胺—半胱氨酸—脯氨酸—亮氨酸—谷氨酰胺
The Ground Truth image displays a single, solid horizontal line. According to Rule 2 (UNDERSCORE & LINE RULES), if the GT contains lines used for stylistic emphasis or as background elements (like ruled paper), the OCR result must ignore them. The provided OCR content is “____“, which consists of four underscores. This is incorrect because underscores are not equivalent to a solid line and are not permitted under the “Stylistic/Background Lines (Ignore)” rule. The OCR has hallucinated underscores where none should exist in the GT, violating the “Stylistic/Background Lines (Ignore)” rule. Therefore, the OCR result is inconsistent with the Ground Truth.
而牛和羊中的另一种激素——血管升压素(vasopressin)也是一个9肽,它的氨基酸序列是:
半胱氨酸—酪氨酸—苯丙氨酸—谷氨酰胺—天冬酰胺—半胱氨酸—脯氨酸—精氨酸—谷氨酰胺
这两个9肽的差异,不过是前者的异亮氨酸换成后者的苯丙氨酸,前者的亮氨酸换成后者的精氨酸,在氨基酸序列上,这两种激素很相近,但从生理作用来看完全不同。从这个例子来看,决定一种多肽类激素的基因有时可以通过变异产生决定另一激素的基因。
促黑细胞激素(melanocyte-stimulating hormone, MSH)由13个氨基酸构成,在马、牛、猪中都一样。该激素由脑下垂体的间叶所产生,可能与很多哺乳动物中皮和毛中的色素变化有关。另一种激素叫作促肾上腺皮质激素(adrenocorticotropic hormone, ACTH),由脑下垂体前叶产生,对肾上腺皮质(和其他内分泌器官)有作用。羊、牛、猪的ACTH的氨基端13个氨基酸跟MSH的氨基酸顺序完全相同。从位置25到33,3种动物的氨基酸顺序互有差异,从位置34开始,一直到羧基端,氨基酸顺序又完全相同(图19-6)。人的库欣综合征(Cushing syndrome)的特征是ACTH水平升高,患者皮肤色素加深,因为ACTH具有类似于MSH的作用,所以ACTH的水平升高,像MSH的水平升高一样,促进皮肤中色素的沉积。在这个例子中,两种蛋白质激素的氨基端13个氨基酸完全相同,它们的生化特性又相近似,所以很有可能在进化过程中,一种激素的编码基因通过部分基因重复(partial gene duplication)演变成为另一激素的基因。这也是基因起源的一种可能方式。
等位基因与非等位基因的差别取决于染色体和连锁图上的基因座是否相等。根据这个标准,若染色体发生畸变,尤其是结构变异以后,原来的等位基因就不相等了。再经过几次基因突变,原来的等位关系就不容易看出来了。事实上,人工合成异源多倍体时,两个亲本种既然可以杂交,亲缘关系不会太远,因此必然有许多基因是相同的,所以在人工合成不久的异源四倍体中,减数分裂时常有多价体出现,表明两种亲本间的某些染色体有对应关系,有对应关系的染色体上的基因自然就是等位的,但在历史较久的野生或栽培的异源多倍体中,如普通小麦、新大陆棉、胜利油菜等就没有这种现象,它们在减数分裂时,形成的都是二价体,跟正常的二倍体完全一样。这是因为原来“同源”的染色体经过多次畸变,上面的基因经过多次突变,使等位关系消失,产生了新基因,这个过程叫作多倍体的“二倍体化”。
可见,新基因的起源可以通过染色体变异改变基因所在位置,从而使新的等位基因类型变为非等位的新基因,也可以通过基因复制和进一步的变异而产生。随着基因组学研究的深入,研究者们揭示,外显子重复(exon duplication)和外显子混编(exon shuffling)也是新基因产生的重要机制。所谓外显子重复,指的是一些基因可以通过串联重复外显子产生新基因,新基因产物中特定结构域的拷贝数增加。外显子改组指的是不同基因来源的外显子可能通过染色体结构变异或转座等发生重新组合形成新基因。
我们将来自于共同祖先 DNA 序列的不同基因称为同源基因 (homologous gene), 由于来源相同, 它们的 DNA 序列具有相似性。同源基因可分为种内同源基因 (paralogous gene) 和种间同
MSH 和 ACTH 的氨基端的前 13 个氨基酸完全相同, 而 ACTH 的氨基酸顺序在猪、牛、羊中有少量差异。
源基因(orthologous gene)。种内同源基因又称为旁系同源基因,指的是在同一物种基因组内部,因为复制产生的同源基因,如人类的α珠蛋白编码基因和β珠蛋白编码基因。种间同源基因又称为直系同源基因,指的是存在于不同物种基因组中,但源自某一共同祖先DNA的同源基因,如人和小鼠的α珠蛋白编码基因。同源基因在各个物种基因组内大量存在,这一事实本身就证明了核酸的进化过程。
五、群体中的遗传平衡
所谓群体(population),又称种群。是指一群可以相互交配的个体,是一个物种在一定空间和时间分布的个体集合。因此,群体是物种的存在单位、繁殖单位和进化单位。在一个群体中,如某一个体有了一个新的变异,当它与正常个体交配时,由于显隐性关系,显性基因的作用把隐性基因的作用遮盖起来,这样是否会使隐性变异从群体中逐渐消失呢?哈代和温伯格先后独立地证明,如果一个群体符合下列条件:①群体无限大;②随机交配,即每一个体跟群体中所有其他个体的交配机会是相等的;③没有突变;④没有任何形式的自然选择;⑤没有迁移(即基因传递只发生在群体内部,不会流入或流出)。那么,群体中各基因型的比例可从一代到另一代维持不变,这就是著名的遗传平衡定律(law of genetic equilibrium),又称为哈代-温伯格定律(Hardy-Weinberg equilibrium)。根据这个定律可以知道,虽然显性基因的作用可以遮盖隐性基因的作用,但是各基因型的比例不变,所以群体中的隐性变异不会因此而逐渐消亡。
下面用个例子来说明。已知兔的脂肪有白色和淡黄色两种,这是一对相对性状,由常染色体上的基因决定,有显隐性关系。在一群体中,如有一半兔有白色脂肪,基因型是YY;另一半兔有黄色脂肪,基因型是yy,则亲代各基因型和它们的频率是:
1 | arrayc c c Y Y & Y y & y y |
各基因型的频率用小数表示,加起来的总数是1,这些数值称为群体中的基因型频率(genotype frequency)。如群体中各个体的交配是随机的,那么交配一次的结果怎样?各基因型的比率会发生变化吗?我们先计算亲代所产生的每种配子的比例,得到下面的结果:
这两个基因的频率用小数表示,加起来的总数也是1,这些数值称为群体中的等位基因频率(allele frequency)。
根据假定,群体中各个体的交配是随机的,所以交配的结果应该如表 19-3 所示。
表 19-3 配子随机结合, 得出 3 种基因型的频率
| 精子\卵子 | 0.5Y | 0.5y |
|---|---|---|
| 0.5Y | 0.25YY | 0.25Yy |
| 0.5y | 0.25Yy | 0.25yy |
把相同基因型的频率分别加起来,子代的3种基因型的频率是:
1 | arrayc c c Y Y & Y y & y y |
子代所产生的配子和它们的频率是:
1 | Y = 0. 2 5 + \frac {1}{2} \times 0. 5 0 = 0. 5 0 |
1 | y = \frac {1}{2} \times 0. 5 0 + 0. 2 5 = 0. 5 0 |
可见,子代的两种配子的频率与亲代完全一样,可以推论, $F_{2}$ 的 3 种基因型的频率仍旧是:
1 | arrayc c c Y Y & Y y & y y |
因为该群体中 3 种基因型的频率在相继的世代中保持不变,所以我们说,就这对等位基因而言,该群体已达到遗传平衡。我们还可以进一步推论,只要交配是随机的,没有其他因素的影响,群体中 3 种基因型的频率就可这样一代代保持平衡。
又如,某一群体中,最初3种基因型的频率是:
1 | arrayc c c Y Y & Y y & y y |
则它们所产生的两种配子的频率是:
1 | Y = 0. 1 0 + \frac {1}{2} \times 0. 2 0 = 0. 2 0 |
1 | y = \frac {1}{2} \times 0. 2 0 + 0. 7 0 = 0. 8 0 |
因为个体间的交配是随机的,而且又没有自然选择,那就是说每个个体都为下代贡献了同样数目的配子,所以两性个体的随机交配可以归结为两性配子的随机结合,而且各种配子的频率就是基因频率。根据这个理由,我们在计算不同基因型随机交配的结果时,只要计算各基因的随机结合的结果就可以了(表19-4)。
表 19-4 配子随机结合,得出 3 种基因型的频率
| 精子\卵子 | 0.20Y | 0.80y |
|---|---|---|
| 0.20Y | 0.04YY | 0.16Yy |
| 0.80y | 0.16Yy | 0.64yy |
根据上面配子结合的结果,把相同基因型的频率加起来,就得到下一代3种基因型的频率:
| YY | Yy | yy |
|---|---|---|
| 0.04 | 0.32 | 0.64 |
这个群体已经平衡。因为它们所产生的配子的频率是:
1 | Y = 0. 0 4 + \frac {1}{2} \times 0. 3 2 = 0. 2 0 |
1 | y = \frac {1}{2} \times 0. 3 2 + 0. 6 4 = 0. 8 0 |
这跟上一代是一样的。
现在用代数式来表示。假设群体中 3 种基因型的频率是:
1 | arrayc c c Y Y & Y y & y y |
这里 $p + q = 1$ ,这3种基因型所产生的两种配子(即两种等位基因)的频率是:
1 | Y = p ^ {2} + \frac {1}{2} \times 2 p q = p ^ {2} + p q = p (p + q) = p |
1 | y = \frac {1}{2} \times 2 p q + q ^ {2} = p q + q ^ {2} = q (p + q) = q |
根据假定,个体间的交配是随机的,所以配子间的结合也是随机的。配子间的随机结合,就得出如表 19-5 所示的结果。
表 19-5 根据配子的频率, 计算随机结合条件下各基因型的频率
| 精子\卵子 | pY | qy |
|---|---|---|
| pY | $p^{2}YY$ | pqYy |
| qy | pqYy | $q^{2}yy$ |
把相同的基因型的频率加起来,我们得到交配一代后群体中3种基因型的频率是:
1 | arrayc c c Y Y & Y y & y y |
这 3 种基因型的频率跟上一代完全一样,所以我们说,就该对基因而言,群体已经平衡了,该频率就是基因型的平衡频率。
概括上面讨论的结果:在一个大群体里,如交配是随机的,没有突变、迁移,也没有任何自然选择的影响等,那么群体中3种基因型的频率如不平衡,只要经过一代就可达到平衡,如已经平衡,则可一代代保持下去,不发生变化。
以上只是理论上的说明,现在来看自然界中的实际情况是否符合遗传平衡定律。下面以MN血型为例,加以说明。前面已讲过,人类中MN血型由一对等位基因 $L^{M}$ 和 $L^{N}$ 决定,M型和N型是纯合子,MN型是杂合子。由于 $L^{M}$ 和 $L^{N}$ 是共显性,对这个性状来讲,基因型频率和表型频率是一样的。在一项上海居民的调查中,在全部1788人,其中397人是M型,861人是MN型,530人是N型(上海中心血站,1977年)。见表19-6,因为每个M型个体带有两个 $L^{M}$ 基因,每个MN型个体带有一个 $L^{M}$ 基因和一个 $L^{N}$ 基因,每个N型个体带有两个 $L^{N}$ 基因,全部1788人共有3576个等位基因,所以
1 | L ^ {M} \text { 基因的频率 }: p = \frac {3 9 7 \times 2 + 8 6 1}{3 5 7 6} = 0. 4 6 2 8 |
1 | L ^ {N} \text { 基因的频率: } q = \frac {8 6 1 + 5 3 0 \times 2}{3 5 7 6} = 0. 5 3 7 2 |
表 19-6 MN 血型的基因型频率的计算
| 血型 | 基因型 | 人数 | $L^{M}$ | $L^{N}$ | 合计 |
|---|---|---|---|---|---|
| M | $L^{M}L^{M}$ | 397 | 794 | ||
| MN | $L^{M}L^{N}$ | 861 | 861 | 861 | |
| N | $L^{N}L^{N}$ | 530 | 1 060 | ||
| 等位基因数 | 1 655 | 1 921 | 3 576 | ||
| 等位基因频率 | p=0.462 8 | q=0.537 2 | 1.000 0 |
为了判断该群体是否达到平衡,把计算得到的等位基因频率代入基因型的平衡频率,再乘以总人数后,得到预期数,与实得数比较,进行 $\chi^2$ 检验(表19-7)。计算得 $\chi_{[1]}^{2} = 1.77, P > 0.10$ ,表明3种基因型频率符合遗传平衡定律(这里 $\chi^2$ 的自由度是1而不是2,因为在计算预期值时要应用一个基因频率 $p$ ,而这是从实得数估计出来的,因此 $\chi^2$ 的自由度减去一个)。
表 19-7 MN 血型资料和遗传平衡间的符合程度的 ${\chi }^{2}$ 检验
| $L^{M}L^{M}$ | $L^{M}L^{N}$ | $L^{N}L^{N}$ | 合计 | |
|---|---|---|---|---|
| 实得数(O) | 397 | 861 | 530 | 1788 |
| 预期频率 | $np^2$ | 2npq | $nq^2$ | n |
| 预期数(C) | 382.96 | 889.05 | 515.99 | 1788 |
| $\frac{(O-C)^2}{C}$ | 0.51 | 0.88 | 0.38 | $\chi^{2}_{[1]} = 1.77$ |
六、突变与群体的基因频率
从上面的遗传平衡定律的“适用条件”看来,符合条件的群体其实是个理想的群体。严格来讲,理想群体在自然界中是不存在的,正如气体定律中的“理想气体”是不存在的。在自然界中不可能有无限大的随机交配群体,也很难想象有绝对不受突变和自然选择影响的基因,自然界中只能有近似于这些条件的群体,但是我们可以从这个理想群体出发,单独分析不同适用条件发生变化的情况,使理论分析更接近于客观的现实群体的情况。
我们首先把突变引入,也就是说,仍旧假定一个无限大的随机交配群体,没有自然选择,但是有突变,那么基因型频率会如何变化?
例如,一群体某一基因座上有 $A$ 和 $a$ 两个等位基因类型。设 $a$ 基因的频率为 $q$ ,则 $A$ 基因的频率为 $p = 1 - q$ 。大多数基因都有一个很低的突变率,设 $A$ 突变为 $a$ 的突变率为 $u, a$ 回复突变为 $A$ 的突变率为 $v$ ,则每一代中共有 $(1 - q)u$ 的 $A$ 突变为 $a$ ,有 $qv$ 的 $a$ 突变为 $A$ 。若 $(1 - q)u > qv$ ,则 $a$ 的频率增加;若 $(1 - q)u < qv$ ,则 $A$ 的频率增加。若 $(1 - q)u = qv$ ,则基因频率 $q$ 保持不变,处于平衡状态,这与化学上的可逆反应一样的道理。在平衡时,
$$
\begin{array}{c} (1 - q) u = q v \ u - q u = q v \end{array}
$$
$$
q = \frac {u}{u + v}
$$
可见,平衡时的基因频率完全由突变率 u 和 v 决定。
举个例题,如 A 突变为 a 的突变率为 $u = 10^{-4}$ , a 突变为 A 的回复突变率为 $v = 10^{-5}$ , 那么平衡时基因 a 的频率为 q = 0.9091。不过在自然群体中, 基因频率单凭突变率决定, 自然选择完全或几乎不参与决定, 这种情况也是不多的。
七、选择与群体的基因频率
每个基因都制约着生物体的生理特性或形态结构,这些生理特性和形态特征又都或多或少地影响着个体的生活力和繁殖力,所以基因也受到自然选择的作用。
(1) 适合度和选择系数 研究者曾研究果蝇 D. funebris 中各种可见突变型的生存率, 跟野生型作比较 (Timofeeff-Ressovsky, 1934)。在培养瓶中放入野生型和某种突变型的卵, 数目相等, 然后在不同温度中饲养, 待果蝇成熟后, 统计两种表型的个体数。野生型的生存率计为 100, 计算各突变型的相对生存率, 结果如表 19-8 所示。
表 19-8 几种突变型在不同温度下的生存率
| 突变 | 15~16°C | 24~25°C | 28~30°C |
|---|---|---|---|
| eversae | 98.3 | 104.0 | 98.5 |
| 焦刚毛(singed) | / | 79.0 | / |
| 小型翅(miniature) | 91.3 | 69.0 | 63.7 |
| 截刚毛(bobbed) | 75.3 | 85.1 | 93.7 |
| 菱形眼(lozenge) | / | 73.8 | / |
结果显示,果蝇的生存率除与温度有关以外,也和群体密度(population density)等有关。从表中可以看到,有些突变如 eversae,在某些温度中,生存率不及野生型,但在另一些温度中却可超过野生型。
为了对自然选择进行定量的研究, 可以为各种基因型定出适合度 (fitness), 或适应值 (adaptive value)。适合度一般记作 W, 是指携带某一基因型的个体跟其他基因型相比时, 能够存活并留下子裔的相对能力。我们把适合度最高的基因型定为 W = 1, 这样其他基因型的 $W \leqslant 1$ 。根据表 19-8 可以计算得到, 野生型 W = 1, 而小型翅在 $25^{\circ}C$ 时 W = 0.69。
另一个相关的概念叫作选择系数(selective coefficient),一般记作 $s$ 。 $s$ 是在选择作用下降低的适合度,即 $s = 1 - W$ ,或 $W = 1 - s$ 。例如突变型小型翅的适合度是0.69,则它的选择系数就是 $1 - 0.69 = 0.31$ 。这意味着当野生型个体每留下一个子代个体时,小型翅只留下 $1 - s = 0.69$ 个子代个体。致死基因或不育基因的纯合子,它们的 $W = 0, s = 1$ 。
(2) 选择对隐性纯合子不利 现在看自然选择对一个很大的随机交配群体的影响,我们先分析隐性纯合变突个体适合度下降,选择对隐性纯合不利的情况。
假设高等生物的一个群体中某一基因座上有一对基因之差,对应了种可能的基因型:AA、Aa和 aa。选择的有效程度也与显性的程度有关。如果显性完全,杂合子 Aa 和纯合子 AA 在表型上一样,不受选择的作用。而隐性纯合子是有害的,在选择上不利,经过一代的自然选择后(表 19-9),a 的频率已经不是 q,而是
$$
\frac {q (1 - s q)}{1 - s q ^ {2}}
$$
这个数值小于 $q$ ,因为 $q < 1, s \leqslant 1, 1 - sq < 1 - sq^2$ 。因此交配一代后,基因频率 $q$ 的改变是
$$
\Delta q = \frac {- s q ^ {2} (1 - q)}{1 - s q ^ {2}}
$$
当 $s$ 很小时,分母几乎等于1,公式可以近似于
$$
\Delta q = - s q ^ {2} (1 - q)
$$
表 19-9 显性完全,选择对隐性纯合子不利时,等位基因频率的改变
| AA | Aa | aa | 合计 | 等位基因a频率 | |
| 初始频率 | $p^{2}$ | 2pq | $q^{2}$ | 1 | q |
| 适合度 | 1 | 1 | 1-s | ||
| 选择后频率 | $p^{2}$ | 2pq | $q^{2}(1-s)$ | $p^{2}+2pq+q^{2}-sq^{2}=1-sq^{2}$ | |
| 相对频率 | $\frac{p^{2}}{1-sq^{2}}$ | $\frac{2pq}{1-sq^{2}}$ | $\frac{q^{2}(1-s)}{1-sq^{2}}$ | 1 | $\frac{pq+q^{2}(1-s)}{1-sq^{2}}=\frac{q(p+q-sq)}{1-sq^{2}}$ $=\frac{q(1-sq)}{1-sq^{2}}$ |
| 等位基因a频率的改变 $\Delta q=\frac{q(1-sq)}{1-sq^{2}}-q=\frac{q-sq^{2}-q+sq^{3}}{1-sq^{2}}=\frac{-sq^{2}+sq^{3}}{1-sq^{2}}=\frac{-sq^{2}(1-q)}{1-sq^{2}}$ | |||||
从这个公式可见, $q$ 值较小时,每代等位基因频率的改变是很小的。当 $q$ 值较大, $q$ 的改变较大,而当 $q = 2/3$ 时, $\Delta q$ 达到最大,也就是说,此时自然选择最有效。
现在,我们假设群体中 a 等位基因的初始频率是 $q_{0}$ , 若进行人工选择, 每代完全淘汰 aa 隐性个体, 即 s = 1, W = 0 。经过一代后, a 等位基因的初始频率是 $q_{1}$ , 且
$$
q _ {1} = \frac {q _ {0} (1 - s q _ {0})}{1 - s q _ {0} ^ {2}} = \frac {q _ {0}}{1 + q _ {0}}
$$
如果再经过一代,则
$$
q _ {2} = \frac {q _ {1}}{1 + q _ {1}} = \frac {q _ {0}}{1 + 2 q _ {0}}
$$
以此类推, $q_{n}=\frac{q_{n-1}}{1+q_{n-1}}=\frac{q_{0}}{1+nq_{0}}$ 。公式变形后,可得 $n=\frac{1}{q_{n}}-\frac{1}{q_{0}}$ 。换句话说,利用人工选择从每代中完全淘汰aa隐性个体,或者自然条件下aa个体不能生育或者致死,要将a等位基因频率从 $q_{0}$ 降到 $q_{n}$ ,需要 $n=\frac{1}{q_{n}}-\frac{1}{q_{0}}$ 个世代。可见,当 $q_{0}$ 较大时,n值较小,但当 $q_{0}$ 很小时,n值则非常大。
各种选择系数(s)对隐性纯合子的作用,列于表19-10。可见,等位基因频率从0.99淘汰到0.10是比较快的,几乎所有选择系数都是这样。但等位基因频率的进一步降低相当缓慢,例如从0.01降低到0.001,即使在选择系数比较高时,也要经过上千代。
表 19-10 不同选择系数下,有害隐性等位基因频率从 $q_{0}$ 下降到 $q_{n}$ 所需代数
| 基因频率q的改变 | 不同s值下所需的代数 | ||||
| $q_0$ | $q_n$ | s=1(致死) | s=0.5 | s=0.1 | s=0.01 |
| 0.99 | 0.50 | 1 | 11 | 56 | 559 |
| 0.50 | 0.10 | 8 | 20 | 102 | 1020 |
| 0.10 | 0.01 | 90 | 185 | 924 | 9240 |
| 0.01 | 0.001 | 900 | 1805 | 9023 | 90231 |
| 0.001 | 0.0001 | 9000 | 18005 | 90023 | 900230 |
对频率很低的隐性个体的选择较无效的理由是,大多数隐性等位基因存在于杂合子中,自然选择对它们不起作用。例如 q = 0.01, 隐性纯合子频率 $(q^{2})$ 是 0.0001, 而杂合子频率 $(2pq)$ 接近 0.02, 两者之比是 1:200。这就是说, 在 1 万个体中, 只有 1 个个体表现隐性性状, 但是却有 200 个个体携带这个隐性基因。所以某一基因在群体中出现的频率愈低, 存在于杂合子中的机会, 相对来说就显得愈高了。
(3) 选择对显性基因不利 选择也可对显性基因不利。如果这样,选择显然更为有效,因为有显性基因的个体都要受到选择的作用。例如,如果带有显性等位基因的个体是致死的,那么一代之内它的频率就等于0。如果对显性基因的选择系数降低,它被隐性基因取代的速率就大大放慢。根据表19-11,设显性基因的频率是p,对显性基因的选择系数是s,基因频率p的改变是
$$
\Delta p = \frac {- s q (1 - p) ^ {2}}{1 - s q (2 - p)}
$$
如果 s 很小,分母 $[1-sp(2-p)]$ 接近 1,所以实际上 $\Delta p = -sp(1-p)^{2}$ ,但是 p = 1 - q,所以 $\Delta p = -s(1-q)q^{2}$ ,或者说,在选择系数 s 较小时, $\Delta p$ 与 $\Delta q$ 相同(参见表 19-9)。
表 19-11 显性完全,选择对显性个体(AA 和 Aa)不利时,等位基因频率的改变
| AA | Aa | aa | 合计 | 等位基因A频率 | |
|---|---|---|---|---|---|
| 初始频率 | $p^{2}$ | 2pq | $q^{2}$ | 1 | p |
| 适合度 | 1-s | 1-s | 1 | ||
| 选择后频率 | $p^{2}(1-s)$ | 2pq(1-s) | $q^{2}$ | 1-sp(2-p) | |
| 相对频率 | $\frac{p^{2}(1-s)}{1-sq(2-p)}$ | $\frac{2pq(1-s)}{1-sq(2-p)}$ | $\frac{q^{2}}{1-sq(2-p)}$ | 1 | $\frac{p-sp}{1-sq(2-p)}$ |
等位基因 A 频率的改变 $\Delta p = \frac{p - sp}{1 - sq(2 - p)} - p = \frac{-sp(1 - p)^{2}}{1 - sq(2 - p)}$
在这种情况下,表19-10的数值也可借用,不过要反过来解读。那就是说,如果群体中选择以0.10对隐性个体有利,那么隐性等位基因的频率由0.0001增加到0.001需要90023代;反过来,选择以0.10对显性个体不利,显性等位基因的频率从0.9999降低到0.999也要这样多的世代。不过以后有利的隐性纯合子逐渐增加,等位频率改变就要快些了。
(4) 选择对杂合子有利 有时候, 自然选择既不偏向显性纯合, 也不偏向隐性纯合, 而是对杂合子有利。例如, 在非洲的疟疾区, 携带镰状细胞贫血突变基因 $(HBB^{S})$ 的杂合子 $(HBB^{A}HBB^{S})$ 的相对生育率不仅远高于隐性患病个体, 较正常人也高。值得一提的是, 美洲的黑人人群中观察不到 $HBB^{A}HBB^{S}$ 杂合子的相对生育率较正常人高的现象。这个现象很好地说明, 适合度是基因 (基因型) 与其生存的环境共同作用的产物。某个基因型在一种环境条件下具有高适合度, 在另一种环境条件下可能表现为低适合度。现在来思考在选择对杂合子有利的情况下, 等位基因频率又将发生怎样的变化呢?
因为杂合子的适合度最高,所以可定 Aa 的适合度为 1,AA 为 1-s,aa 为 1-t,s 和 t 都取正值。经一代选择后,基因 a 频率的改变可计算如下(表 19-12)。
表 19-12 杂合子的适合度比两个纯合子都高时,经一代选择后等位基因频率的改变
| AA | Aa | aa | 合计 | 基因a频率 | |
| 初始频率 | $p^{2}$ | 2pq | $q^{2}$ | 1 | q |
| 适合度 | 1-s | 1 | 1-t | ||
| 选择后频率 | $p^{2}(1-s)$ | 2pq | $q^{2}(1-t)$ | $1-p^{2}s-q^{2}t$ | |
| 相对频率 | $\frac{p^{2}(1-s)}{1-p^{2}s-q^{2}t}$ | $\frac{2pq}{1-p^{2}s-q^{2}t}$ | $\frac{q^{2}(1-t)}{1-p^{2}s-q^{2}t}$ | 1 | $\frac{q(1-qt)}{1-p^{2}s-q^{2}t}$ |
| 等位基因a频率的改变 | $\Delta q=\frac{q(1-qt)}{1-p^{2}s-q^{2}t}-q=\frac{pq(ps-qt)}{1-p^{2}s-q^{2}t}$ | ||||
选择前基因 a 的频率是 q,经一代选择后,基因 a 频率是
$$
\frac {q (1 - q _ {t})}{1 - p ^ {2} s - q ^ {2} t}
$$
如果基因 $a$ 频率在相继世代中保持不变,则
$$
\Delta q = \frac {p q (p s - q t)}{1 - p ^ {2} s - q ^ {2} t} = 0
$$
群体取得平衡。如要 $\Delta q = 0$ ,即分子等于0,有3种可能:一是使 $p = 0$ ,另一是使 $q = 0$ ,如果这样,两个等位基因不可能同时存在于群体;另一可能是使 $ps = qt$ ,这样就可在知道两选择系数后,求等位基因频率,或在知道等位基因频率和其中一个选择系数后,求另一选择系数,即
1 | q = \frac {s}{s + t} \text {或} s = \frac {q t}{p} |
现在,我们仔细分析一下镰状细胞贫血的例子。有镰状细胞性状的杂合子 $(HBB^{A}HBB^{S})$ 对恶性疟原虫的抵抗力较强。因为杂合子细胞中有两种血红蛋白(HbA和HbS),这种组合可能影响疟原虫的营养。此外,杂合子细胞的细胞膜结构可能不利于疟原虫寄生。还有证据表明,杂合子女性的生育率也比正常女性高,可能是流产率低的缘故。
根据调查,在赤道非洲的某些群体中,婴儿时期3种基因型 $HBB^{A}HBB^{A}$ 、 $HBB^{A}HBB^{S}$ 和 $HBB^{S}HBB^{S}$ 符合遗传平衡时的频率。镰状细胞贫血患者的频率高达4%,而镰状细胞贫血患者几乎都在成年前死去,基本上不留后代,即1-t=0。这样就可根据表19-13求出正常人( $HBB^{A}HBB^{A}$ )的适合度(1-s),从而求出选择系数s。
表 19-13 镰状细胞贫血性状经选择后的等位基因频率变化
| $HBB^A HBB^A$ | $HBB^AHBB^S$ | $HBB^SHBB^S$ | 合计 | |
| 初始频率 | $0.8^2=0.64$ | 2\times0.8\times0.2=0.32 | $0.2^2=0.04$ | 1 |
| 适合度 | 1-s | 1 | 0 | |
| 选择后频率 | $0.64(1-s)$ | 0.32 | 0 | $0.96-0.64s$ |
| 相对频率 | $\frac{0.64(1-s)}{0.96-0.64s}$ | $\frac{0.32}{0.96-0.64s}$ | 0 | 1 |
| 等位基因频率 | $p=\frac{0.64(1-s)+0.16}{0.96-0.64s}$ | |||
如果想求出能使群体保持平衡时的 s 值, 从表 19-13 可以看出, 这只要使
1 | p = \frac {0 . 6 4 (1 - s)}{0 . 9 6 - 0 . 6 4 s} + \frac {1}{2} \times \frac {0 . 3 2}{0 . 9 6 - 0 . 6 4 s} = 0. 8 |
所以
1 | s = \frac {q t}{p} = \frac {0 . 2 \times 1}{0 . 8} = 0. 2 5 |
此例说明,杂合子的适合度比正常纯合子稍有增加后,就可补偿因隐性纯合子的致死而丧失的隐性基因,使群体保持多态现象。在这种情况下,突变的作用很小,因为选择系数比突变率大很多倍。
因此,当自然选择对杂合子有利时,可以出现没有等位基因频率变化的动态平衡,这种特殊情况被称为平衡选择(balancing selection)或杂合子优势(heterozygote advantage)。这种平衡选择可以将不同的等位基因以一定频率同时在群体中保留下来,不被淘汰。
以上单是从理论上来谈,我们现在举一个自然界中的实际例子,看自然选择怎样发挥作用。欧洲在产业革命以后,许多地区逐渐工业化。在工业城市的近郊,在许多不同属和不同种的鳞翅目昆虫中,黑色型个体的频率逐渐上升,这个趋势称为工业黑化,现在还在继续着。现在以椒花蛾(Biston betularia)为例(图19-7),说明如下。
在 19 世纪初叶, 在英国的曼彻斯特第一次发现有黑色型椒花蛾个体, 在这以前只有浅色型个体, 可见那时黑色型的频率是很低的。但从此以后直到今天, 黑色型频率稳定地上升, 出现于所有工业地区, 而且在这些地区黑色型都很常见, 频率常达 95% 以上。而在没有受到工业废气污染的农业地区, 则主要仍然是浅色型。杂交实验表明, 黑色型由一显性基因控制。选择因素主要是蛾体颜色是否跟它们所栖息的树皮颜色接近。在未污染地区, 树皮上大多长满地衣, 椒花蛾栖息在上面时, 浅色型极不显著, 而黑色型很明显。在某一未污染地区的树林中释放等量的浅色型和黑色型个体,观察鸟类捕食情况,结果有164只黑色型个体被捕食,而在同一时间内,只有26只浅色型个体被捕食。在污染地区,工业废气使地衣不能生长,结果树皮裸露,呈黑褐色。椒花蛾的浅色型很显著,而黑色型不明显。鸟类捕食实验中,浅色型有43只被捕食,而黑色型只有15只被捕食。由于这个关系,黑色型椒花蛾就在大工业区里得到发展,浅色型逐渐消失。
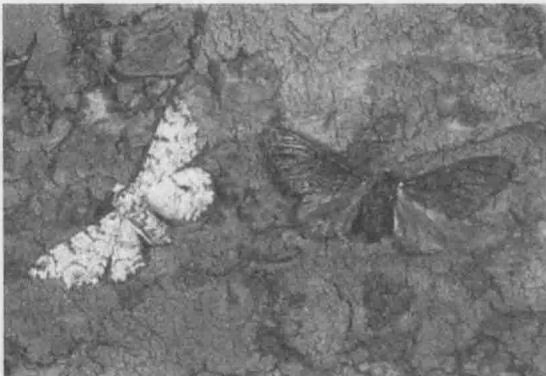
(a)
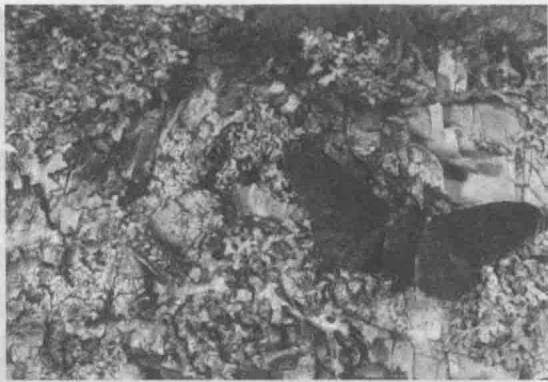
(b)
图 19-7 椒花蛾的浅色型和黑色型
(a) 浅色型和黑色型在煤灰色的没有地衣覆盖的裸露树干上。(b) 黑色型和浅色型在一正常的地衣覆盖的树干上。
八、突变和选择共同作用下的群体平衡
在前面我们讨论了等位基因频率的改变,或由于突变的结果,或由于选择的作用。但是在真实自然界,突变和选择都在起作用,所以等位基因频率往往同时受到这两个因素的影响。例如即使隐性基因在纯合态时在选择上是不利的,可是群体中始终有一定比例的隐性基因存在着,这是因为有新突变产生的缘故。也就是说,由于选择的作用,隐性纯合子减少,隐性基因的数目降低,但通过突变的作用,新的隐性突变基因进入杂合子中,补充丢失的基因数目,从而维持某一平衡点。
根据前面的推算,假设隐性纯合子在选择上不利,隐性基因 a 的频率 q 每代减少 $sq^{2}(1-q)$ , 而新产生的隐性突变基因的频率等于 $(1-q)u$ 。在平衡时, 突变所产生的隐性基因数应该与选择所淘汰的数目相等, 所以
1 | arrayr l s q ^ 2 (1 - q) & = u (1 - q) |
这就是平衡时的基因频率。实际运算时,只要测定 $s$ ,就能根据 $q$ 来估计 $u$ 。多个人类基因的自发突变率是根据这个原理来推算的。例如人类中全色盲是常染色体隐性遗传,大约8万人中有1个是纯合子。据调查,他们的平均子女数约为正常人的一半,因此取
$$
q ^ {2} = \frac {1}{8 0 0 0 0}, s = 0. 5
$$
根据公式 $u = sq^2$ ,得
1 | u = 0. 5 \times \frac {1}{8 0 0 0 0} \approx 0. 6 \times 1 0 ^ {- 5} |
椒花蛾工业黑化的例子中,在工业化以前,以及现在未污染地区,浅色型群体中也有极少量的黑色个体,很可能就是突变和选择之间的平衡所致。
九、遗传漂变
遗传平衡定律还有一个重要的前提条件是群体无限大。这是因为在大群体里,不同基因型个体所生育的后裔数可以有变动,但对基因频率不会有明显影响。可是在小群体里,这种波动会对基因频率产生相当大的影响。随机波动可以使选择上既不是有利、又不是有害的基因,即所谓中性基因(neutral gene)或近于中性的基因保存下来或淘汰掉。如果群体很小,由于机会的关系,甚至也有可能使不利的基因保留下来,而有利的基因被淘汰掉。像这样,由群体较小和偶然事件而造成的基因频率的随机波动,称为随机遗传漂变(random genetic drift),或简称遗传漂变。
遗传漂变的方向无法预测,但漂变的范围却可预言。假设有一群体,在生育年龄时群体大小为 N,那么就常染色体上某一基因座而言,共有 2N 个等位基因。假定这一基因座上的一对等位基因为 A 和 a,其等位基因频率为 p 和 $q(q=1-p)$ ,那么由孟德尔遗传的二项式分布的性质,等位基因频率改变的方差( $s^{2}$ )可用下式表示:
$$
s ^ {2} = p q / 2 N
$$
根据这个公式,可以算出各种大小不同群体的等位基因频率的标准差s(表19-14)。假定群体大小N为50,等位基因频率p为0.50,那么在N=50的子代群体中,等位基因频率变化的标准差为0.05。根据正态分布概率密度函数积分可知,约有68%的个体的等位基因频率在0.45(=0.50-0.05)与0.55(=0.50+0.05)之间。同理,约有5%的个体的等位基因频率与0.50的偏差大于0.10(即2倍标准差)。关于概率密度函数的积分方法,建议感兴趣的读者查阅生物统计学的专业书籍。
表 19-14 等位基因频率的机会偏离 $\left( {p = {0.50}}\right)$
| 标准差(s) | 群体大小(N) | |||
| 10 | 50 | 100 | 200 | |
| $\sqrt{\frac{pq}{2N}}$ | 0.11 | 0.05 | 0.04 | 0.03 |
子代群体从亲代群体接受了一个随机的基因样本,又把另一套随机产生的基因样本传给它们的下一代,这样一代代下去,样本中基因频率将随机波动着。它们可能在初始频率的附近摆动,也可更加偏离原初频率,甚至完全保留下来 $(p=1)$ 或被淘汰 $(p=0)$ 。
遗传漂变常用来说明人类种族间的差异。北美印第安人的血型分布是一个很好的例子。北美印第安人大多数是 O 型,但是 Blood 和 Blackfeet 两部落的印第安人中 A 型比较常见,而且 $I^{A}$ 频率大于 50%,不仅高于其他北美印第安人群体,而且比其他非印第安人群体也高。这是原始小群体中等位基因频率改变的结果。也许这些美洲印第安人部落的祖先从亚洲迁移过去的时候,也带去了 $I^{A}$ 基因,后来随机漂变,使该基因获得了高频率。也有可能这些印第安人最初的基因型全部是ii(O型),突变才使他们获得了 $I^{A}$ 基因。即使i基因变为 $I^{A}$ 的突变率非常低,但是一个新的等位基因一旦出现后,由于机会关系未被淘汰,而是逐渐增加,就可能出现现在Blood和Blackfeet印第安人中的高 $I^{A}$ 频率。人类群体中血清蛋白、同工酶、DNA片段的酶切位点以及其他各种生理性状的多态现象,似乎都可用小群体内的随机漂变来解释。
有些有害突变的频率在小群体中特别高,或许是因为这些小群体中为数不多的远祖携带这种突变型等位基因,以后由于随机波动而在群体中扩散开来。例如有一种先天性失明症是常染色体隐性遗传的,在东卡罗林群岛的 Pingelap 人中,有相当高的发病率。据记载,在 1780—1790 年间,一次飓风袭击了 Pingelap 岛,造成大量伤亡,岛上仅留下 9 个男人和数目不详的女人。推测起来,可能在留下来的居民中有一人或少数几人是“先天性失明”基因的携带者。到了 1970 年,Pingelap 人已增加到 1500 人,而其中先天性盲人竟有 4%~10% 之多。“先天性失明”基因在选择上显然是不利的,这种致病基因能在群体中有不寻常的高频率也很可能是遗传漂变所造成的结果。
十、选择的创造性作用
自然选择既可以改变群体中基因频率,又具有创造性作用。因为自然选择并不是对每个基因独立发生作用,而是作用于整个个体的表型上。现存的各种野生动、植物,体内所有基因必然彼此协调,并且与环境相适应。单个基因的突变虽然有可能使突变的个体形成新的适应方式,但由于原有协调关系被打破,自然选择可能选出其他基因来造成新的协调——自然选择总是保持整个个体非等位基因间的协调,这是自然选择的积极作用。
例如,亚麻田中常有一种十字花科的杂草,叫作亚麻荠(Camelina sativa subsp. crantz)这是C. sativa的一个亚种,它跟生长在亚麻田外的C. sativa的主要区别是,种子大,角果也大。杂交试验证明,这种种子大小与角果大小各由一些不同的基因差异所控制,而且角果的长、宽、厚三者也各由不同的基因所制约。
根据观察,亚麻荠所以能杂生在亚麻田内,一个重要的条件是在亚麻收割脱粒后,种子在风选时,亚麻荠的种子必须与亚麻种子吹到同一距离。正是这个选择因素,使亚麻荠种子大于C. sativa。但遗传学实验证明,使种子增大的基因有多效性,这些基因同时使角果内种子数目减少,如果角果不同时增大的话,种子减少当然是在自然选择中很不利的,但自然选择同时选择其他基因使角果增大,以维持一定数目的种子,而且在有些品系中是使角果长度增加,有些则是使角果厚度增加。自然选择还对每一花序上花的数目进行选择,使每一植株所产生的种子达到最适数目。
所以当自然选择对一个或一些基因发生作用时,往往对其他基因也发生作用,这是自然选择具有创造性作用的最重要原因,生物进化过程是不可逆的历史过程。试想,如果亚麻荠的种子传播到亚麻田外,而且能够在那里生长繁殖,它并不会退回到 C. sativa 的情况。那时由于风选风力的消除,种子可能会变小,但角果不一定同时也变小,而根、茎、叶的性状却可能产生新的变化。
十一、定向选择与不定向变异
自然选择的作用,就是利用个体中所发生的不定向变异,造成群体的遗传结构的定向变异。
如果不将个体和群体这两个水平加以区别,而认为生物的定向进化就是源自个体基因型的定向变异,这是没有根据的。
自然选择的作用,不过是使比较适应于环境的个体多留下一些可达生育年龄的个体,而使比较不适应于环境的个体少留下一些可达生育年龄的个体,这样就使群体的遗传结构发生一定方向的变化,即向更适应于环境的方向变化。
举个例子,农业生产中常常使用某种杀虫剂或抗生素,开始很有效,但后来逐渐失效了,害虫或病菌对药剂产生了抵抗力,而且这种抵抗力能够遗传,因而形成了有抵抗力的品系。这种有抵抗力品系的产生是由于选择的结果还是接触药剂后的定向变异呢?请看下面的一个实验。
把普通果蝇分成两组,第一组,把许多果蝇养在一起,让它们可以自由交配。同时用一定剂量的杀虫剂DDT喷在一片玻璃片上,把玻璃片放到果蝇的培养瓶中。果蝇群体一代一代地繁殖,每代群体都用DDT处理,药剂的剂量逐渐增加,过了十多代以后,果蝇群体的抵抗力可以比原有果蝇品系增加几百倍,忍耐得住几百倍剂量的药剂。但是这一实验本身不能判定抗性的产生是由于选择的结果,还是由于接触药剂后的定向变异。
第二组实验,不是把许多果蝇养在一起交配,而是每只瓶中只放一雌一雄,繁育一个同父同母的家系,如此繁育几十个家系。每一家系,即同父同母的兄弟姐妹,都分成两半,分养两只瓶。一只瓶中放一片有DDT的玻璃片,另一只瓶中不放玻璃片。如果某一家系,在放玻璃片的那一半中死亡率大,整个家系(两只瓶)全部淘汰不要;如果某一家系中,放玻璃片的一半死亡率低,那就把未放玻璃片的一半留下作种,仍旧放一雌一雄交配,分别繁育几十个家系。如此一代一代,每代每个家系都分两半,一半用药剂处理,以测定其抵抗力,这一半家系抵抗力测定的结果作为未受药剂处理那另一半选留的根据。如此一代代选择,十多代后,也能选出抵抗力比原来品系增加几百倍的家系,而且抵抗力增加的速度与第一组实验不相上下。
这一组实验的关键,就是只让 DDT 发挥选择作用,最后选出抵抗力很高的那个品系,其亲代、祖代以及以前所有各代,从来没有与 DDT 接触过。所以我们说,抗性的产生不是 DDT“引起”的,DDT 只起选择作用。
以后的遗传学实验证明,普通果蝇对杀虫剂 DDT 的抗性是由许多基因控制的,这些基因分布在果蝇的 X、2、3 染色体上。
对遗传学不熟悉的人有时对昆虫、细菌的“抗药性基因”感到迷惑不解,好像人类每制造一种药物,昆虫或细菌就有一大套专门的抗药性基因来对付。其实这些基因一直存在,负责调节体内各种生理生化过程,只有当我们用药物去测定它们的抗性的时候,为方便起见,我们才把它们叫作“抗药性基因”。例如,根据生物化学研究,家蝇对DDT的抗性品系,只不过是由于体内含有一种脱氯化氢酶,能使DDT转变为无毒的乙烯化合物DDE罢了(图19-8)。
图19-8 由于脱氯化氢酶的作用,DDT变为无毒的DDE
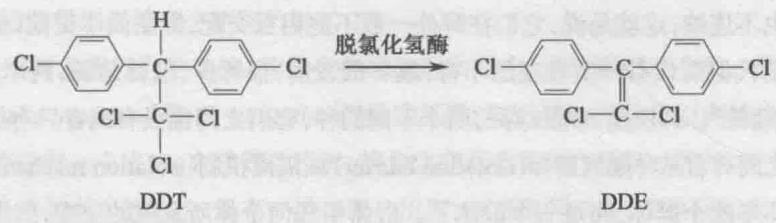
第三节 新种形成
地球上的生物多种多样,且几乎没有两个个体是完全相同的。分类学家把所有的生物分门别类,把相似的个体列入同一“种”,又把类似的种归入同一“属”,以此类推。由于不存在完全相同的个体,我们应该将怎样的个体列入同一“种”,怎样的个体必须分别归入同一“属”中的不同的“种”?在这一节,我们先要说明什么是种,然后探讨新种是怎样起源的。
一、物种的定义
分类工作者从实际出发,认为“物种”是形态上有别且遗传上固定的生物类群。当然种内是有个体变异的,但变异有个范围,这个范围本身在遗传上是“固定”的,这个范围就是种的范围。举例来说,种内变异最常见的是两性差异。鸳鸯的雌雄个体在羽毛方面的差异很大,似乎大于种间差异,但它们彼此交配但不和其他鸟交配,而且它们的后代中,雄的都像父亲,雌的都像母亲。由于这种变异范围在遗传上是“固定”的,因此属于同一个种。又如,有些生物有所谓“相”的变异:飞蝗有单生相和聚生相,两者在形态、生理、生态上很不相同,但我们知道,单生相飞蝗的后代可能是单生相飞蝗,也可能是聚生相的飞蝗,却不可能是其他昆虫,聚生相飞蝗的后代也是这样,所以这两个相的飞蝗属于同一个种。从这两个例子可以看出,种内差异有时在外部形态上非常大,但它们在遗传上是固定的,或者说是“连续”的,即可以通过有性生殖促进基因在物种内的交流。
达尔文在他的经典著作《物种起源》中指出,种间差异和种内差异从本质上讲并没有什么根本不同,这一点已为现代科学资料充分证实。在某些类群中,用来区分科或属的形态特征和生理特性,在相近类群中可以是种内变异。例如在菊科中,花托上无苞片常被认为是还阳参属(Crepis)的特征,但是在美洲的臭还阳参(C. foeliba)中,有的个体就具有花托苞片。种内变异的遗传基础是突变,包括基因突变、染色体数目和结构的变化,以及细胞质基因的变化,这是根据种内杂交实验所得出的结论。种间差异的遗传基础也不过是同样的这三类,并没有种的形成过程所专有的遗传变化。正是这个事实使达尔文提出新种由老种产生的学说,因为在老种内部就具备着产生新种的条件。
种内变异在表型和遗传上都是“连续”的。但一旦老种形成了新种,就成为“不连续”了。从“连续”到“不连续”的关键在哪里?要理解这个问题,就要回答种间“不连续”意味着什么。在自然界中,不同的种不但在形态和生理等性状上有分别,分类学家得以识别无误,而且它们在遗传上也不连续,这就是说,它们在野外一般不能相互交配,即使偶尔交配,也不产生后代,或者虽产生后代但后代有一定程度的不育,或者很衰弱,很稀少,这就是说,两个种无法通过杂交打破“不连续性”。即使是同地生存的两个不同的种,它们之间也没有或者只有很有限的基因交流,即它们之间有着某种隔离屏障(isolation barrier)或隔离机制(isolation mechanism)。如果没有隔离,那就不是两个群体,而是一个群体了。群体中任何个体所发生的突变,如果选择上有利,就可逐渐扩散到整个群体,不同个体所发生的突变在群体内部进行各种组合,一个群体始终保持遗传上的独立性。但是如果在一个群体内部出现新的隔离,把群体分为两个,则自然选择对这两个群体相对独立地发挥作用,一个群体中所发生的突变不会扩散到另一群体,两个群体将沿着不同的进化路线发展,进一步造成表型上的不连续,也就是成为分类学工作者所接受的“种”。自然界偶尔也有这样的情况:同一地区存在着两个群体,彼此之间有着隔离,甚至是很严密的隔离,而在外形上却一时不能识别。这类情况在经过仔细研究后,往往仍可发现它们在形态上的不连续。例如北美洲菊科半带草属中的 Hemizonia obconica 与 H. virgata 就是这种情况。两者之间很早就发生严密隔离,但在外部形态上还没有完全形成不连续性,因而使分类学家感到困难。种的客观存在并不依赖于人们能否识别,尤其是不依赖于用有限的研究方法能否识别。因此,种的形成问题主要归结为隔离机制的形成问题,这是种的形成中从连续到不连续的关键。至于发生隔离机制以后的形态分歧、分布区的变迁与发展等问题,则属于种内进化的范畴了。
总的来说,隔离使群体分化,促使新种的形成。
二、隔离的几种方式
在新种的形成过程中,隔离是一个重要的环节。现在我们就把隔离的几种方法加以说明如下:
(1) 地理隔离 (geographically isolation) 地理隔离是两个群体占据着不连续的分布区, 空间上的隔离阻止着两个群体间个体的交配, 因而阻止基因交流。例如, 同一种陆生螺类生活于好几个山谷, 不同种的螺类被不能超越的高山所阻隔。又如, 同一种淡水生物生活于几个海岛, 相互间有海水的阻隔。地理隔离在种的形成中起着十分重要的作用。若不是先有地理隔离, 有时就无法形成下面将要讲到的生殖隔离。但如果没有生殖隔离, 一旦再发生某种地质气候变化, 原来地理隔离的群体就有可能再度成为一个群体, 所以很多人认为地理隔离是种形成的第一步。
(2) 生殖隔离 (reproductive isolation) 种的本质在于生殖隔离。不过要注意, 这里的生殖隔离是指野外的情况。有时种间杂交在实验室或试验田里可以成功, 而且各代杂种的生活力和生育力都完全正常, 但这不能作为这两个种可合并为一个种的理由, 只要它们在野外有生殖隔离, 那就足够保证它们在自然界中成为不同的种。
生殖隔离有好几种机制,根据发生作用的时间是在杂种合子形成以前还是在杂种合子形成以后,分为两大类:一类是受精前生殖隔离,另一类是受精后生殖隔离。
① 受精前生殖隔离 受精前生殖隔离又可分为季节隔离、心理隔离和受精隔离等。
季节隔离就是两个种的生育季节不重叠。一般生物都有一定的生育季节,如动物的发情期、交配季节,植物的开花季节等。例如,菊科莴苣属的 Latuca canadensis 和 L. graminifolia,在美国东南部很大面积上同地生长,都是路边野草,人工杂交完全可育,但在自然界中,前者在夏季开花,后者在早春开花,因此得以保持两个不同的种。
心理隔离主要是指有求偶行为的动物,异性个体间缺乏引诱力,所以不相互交配。例如,两种近缘鱼类 Gasterosteus aculeatus 和 G. pungitius 都是先筑巢,然后雄鱼把雌鱼引向巢内交配,但前者巢筑在水底,巢只有一个进口,在求偶动作时,雄鱼先在雌鱼面前作纹花式游泳,然后力迫雌鱼进巢,而后者巢悬挂于水生植物上,巢有一进口和一出口,在求偶行动时,雄鱼以纹花式向巢游去,雌鱼跟着自动进巢。因为有这些生殖行为上的差异,所以虽然在实验室中可用人工授精产
生杂种,但在自然界中,很少能见到自然杂种。
受精隔离是指体内受精动物在交配受精后,体外受精动物在释放配子后,植物在花粉到达柱头以后,在一系列反应中有某种不协调,使雌雄配子不能结合。例如茄科曼陀罗(Datura)内,花粉管在异种花柱内生长速度比在同种花柱内低得多,有时甚至在异种花柱内破裂。
② 受精后生殖隔离 在 $F_{1}$ 合子形成以后起作用的种间隔离机制,使 $F_{1}$ 合子不能生存,或不能发育到性成熟阶段,或使 $F_{1}$ 杂种不育,或使 $F_{2}$ 以后各代中带有杂种基因组合的个体不能生存,或不能生育,总之是影响种间杂种后代的个体发育过程。
杂种不活可表现在个体发育的各个阶段,在不同杂交组合中表现不同。亚麻 Linum perenne♀×L. austrianum♂可得成熟的杂种胚胎,但不能穿破种皮(母体组织),因此种子不能萌发。若用人力帮助,把种皮剥掉,就能长成健壮可育的杂种植株。在反交 L. austrianum♀×L. perenne♂中,杂种胚胎不能充分成熟,但若把这胚胎从胚乳中取出,在培养液中培养,就能完成胚胎发育,以后可以萌发而长成健壮可育的植株。这说明在这个杂交体系中,杂种胚胎与杂种胚乳之间的不协调是杂种不活的原因,这种不协调跟亲本基因的表型效应有密切关系。
杂种不育或者由于性腺的形成不全,或者由于性腺内生殖细胞没有分化,或者由于减数分裂失败,这些都可使杂种个体不能生育。例如马和驴杂交,产生的骡的可育性极低,这是大家都熟悉的例子。根据细胞学的研究,知道马、驴和骡的染色体数不同,马为64,驴为62,骡为63,而且在形态上也有明显的差异。杂种在形成生殖细胞时,染色体不能正常配对,接着发生不规则的分离。这样,精子或卵的染色体组就不平衡,不能正常受精,或受精后不能正常发育,从而造成不育。以前讲过的萝卜甘蓝杂种,如不经过染色体加倍也是没有生育能力的,所以也是杂种不育的例子。
根据上面的叙述,在新种形成过程中,一般先有地理隔离,使不同群体不能相互交配,不能交流基因,这样在各个隔离的群体中可独立发生各种遗传变异。在自然选择下,这些变异逐渐累积起来,出现了生殖隔离,就完成了新种形成过程中的飞跃。
三、新种形成的两种形式
新种形成是一个量变飞跃到质变的过程。有两种不同的形式,一种是渐变式,一种是爆发式。
(1)渐变式新种形式 这是常见的一种新种形成方式,通过突变、选择和隔离等过程,从一个种先形成若干地理族或亚种,然后建立起一套生殖隔离机制,从而形成新种。从一种亲本种孕育出一个新种,需要很长很长的时间,关于这个新种形成方式的要点,我们在前面已经大致讲过,现在再以棉属内几个种为例,作一个系统的说明,以便对这个新种形成方式有一个更清晰的概念。
棉属(Gossypium)在全世界有很多种,但栽培的只有4个种:草棉(G. herbaceum)、中棉(G. arboreum)、陆地棉(G. hirsutum)和海岛棉(G. barbadense)。前两者称为旧大陆棉,染色体数目都是2n=26;后两者称为新大陆棉,染色体数目都是2n=52。每一个种又可分成许多亚种,每一亚种中又存在着许多栽培品种。在旧大陆棉的两个种里面,草棉现在主要有5个亚种。
不同亚种有一定形态差异和地理分布差别。如果两个不同亚种的群体在某地相遇,因为基因交流没有限制,两个群体能通过杂交而混成一个群体,成为两个亚种之间的中间类型。草棉的
5个亚种之中,非洲亚种是最原始的野生类型。它的种子只有极短的纤维,不能作纺织用。随着古代非洲和阿拉伯半岛之间的贸易往来,非洲亚种被带到阿拉伯,产生长纤维的突变类型,经过选育后成为槭叶亚种,分布区向东西两方向扩大,东达印度西北,西达非洲北部。以后槭叶亚种由于推广到新的地区而发展出3个一年生亚种。
中国目前种植草棉的地区已经极少了。在中国栽培稍多的“中棉”是旧大陆棉的又一个种,此种目前在世界上也有5个亚种。印度亚种是中棉中最原始的亚种,在公元前3000多年已在印度栽培,该亚种是从草棉发展来的。目前中棉中的印度亚种与草棉中的槭叶亚种在形态上的区别仍很小,比同是中棉的其他亚种之间的形态差别还小些。印度亚种向北方各个方向发展,成为中国亚种等4个亚种。
中棉由于从草棉分化出来的时间较长,受长期自然选择的作用,现在在自然界与草棉已不能有基因交流。草棉与中棉这两个不同的种的分布区在很大部分是重叠的:都在亚洲中南部和非洲。但同一种内不同亚种的分布区则互相隔绝。种与亚种在分布上的这种区别,在动物中和异花授粉植物中是最常见的。草棉与中棉进行人工杂交, $F_{1}$ 植株很健全,而且可育性还可以(这种植株在田间也有发现)。 $F_{2}$ 分离,大多数植株生活能力很差,很早就被淘汰。 $F_{2}$ 中极少数植株生活能力较强,但这些植株不是极倾向中棉,就极倾向草棉。
这是由于中棉和草棉经过长期分化,在不同的自然选择作用下各形成了一定的基因组。以后即使在同一地区生长,也只能以不同的方式来适应同一条件。杂交 $F_{1}$ 生活力不差,但到 $F_{2}$ ,基因进行各种重组合,没有一种重组合能适应当地环境,因而都淘汰了,这就可以解释为什么在自然界中棉和草棉没有基因交流,不会混杂成为一个种。
这种形式的物种形成过程,一般先有地理隔离,各自通过不同的基因突变、染色体畸变或重组,在自然选择下,形成不同的亚种,亚种一般在形态上已有一定差异。亚种再进一步分化,到有机会重新遇到时已不能有基因交流,产生了生殖隔离,那就已成为不同的种。在原则上讲,单有地理隔离和形态差异,而尚未形成遗传隔离机制的,只能称为不同的亚种。
这是物种形成的常见形式,遗传隔离机制是逐渐形成的,是通过许多微小的变化(单个突变,每一代的自然选择)的积累才逐渐完成最后的巨大质变的。
(2) 爆发式新种形式 这一种方式主要见之于植物界, 就是远缘杂种通过染色体加倍后形成新种。虽然刚形成的异源多倍体仍要通过自然选择, 使之逐渐适应当地的环境, 但异源多倍体植株可以很快得到, 所以跟前面一种新种形成方式相比较, 可以称之为爆发式新种形成。
在前面“异源多倍体”一节中,已谈过普通小麦是怎样通过种间杂交和染色体加倍后形成的。我们现在从新种形成的角度,换成棉的例子,再把异源多倍体形成新种的方式说明一下,使读者有一个更为深刻的概念。
新大陆棉有两个种,陆地棉和海岛棉。陆地棉起源于墨西哥和中美洲。我国目前栽培最多的各种改良棉,如“岱字”、“德字”、“斯字”等都是陆地棉。海岛棉原产南美洲秘鲁,本是多年生,1785年引种到美国,选出一年生类型,现在我国也有少数栽培。
陆地棉和海岛棉的染色体数都是 2n=52,两者在形态上比较接近,杂交也比较容易, $F_{1}$ 生长良好,可育性也不差,可是也是 $F_{2}$ 无法存活,这种情况跟中棉与草棉的杂交情况相近似。这两个种的分化也是通过上面讲过的渐变式的方式。
现在问题是染色体数为 52 的新大陆棉, 最初如何产生? 旧大陆棉的染色体数是 26, 是二倍体,新大陆棉是四倍体。是不是旧大陆棉的染色体数经过加倍后成为新大陆棉?事实不是那么简单。
通过染色体组分析发现,新大陆棉52条染色体中,有26条与旧大陆棉(尤其是草棉)相同。新大陆棉和草棉两者杂交,得三倍体,染色体数是39,其中从草棉来的13条与新大陆棉中13条配成13对二价体,新大陆棉中另外13条无对可配,形成单价体。我们把草棉的13条染色体作为1个染色体组,用大写字母A表示,草棉的染色体组可写作AA,新大陆棉的52条染色体中,有26条也可写作AA,因为与草棉相同;另外26条写作DD,是另一个染色体组,新大陆棉的全部染色体组是AADD。AADD中,AA可以设想是从草棉来的,DD哪里来的呢?研究者进一步发现有一种产于秘鲁的二倍体美洲野棉(G. thurberi,2n=26)就是DD,二倍体旧大陆棉AA与美洲野棉DD杂交, $\mathbf{F}{1}$ 是AD,染色体数26。这种 $\mathbf{F}{1}$ 植株高度不育,因为A的13条染色体小,D的13条染色体大,两者完全不同,减数分裂时不配对,形成26个单价体。但这种 $\mathbf{F}_{1}$ 植株染色体一加倍,成为52,即AADD,每条染色体都有一条对应的染色体,减数分裂时形成26个双价体,完全恢复可育性,自花授粉后,每个个体都是AADD,都可育,所以立即成为一个新种,与其两个亲本都不能交流基因。
这种通过杂交和染色体加倍而一次形成新种的方式,在植物界比较常见,普通小麦是异源多倍体,胜利油菜、烟草、马铃薯等也都是异源多倍体。
异源多倍体形成的整个过程是:先是一个二倍体经过长期的分化,经过许多基因突变、染色体畸变,经过极长期的自然选择,形成了一个新的染色体组(这是渐变式的物种形成过程);然后具有不同染色体组的个体相互杂交, $F_{1}$ 染色体加倍,这样就形成了异源多倍体。但刚形成的异源多倍体未必能立刻适应当地环境,仍要通过自然选择,使之逐渐适应。
物种形成的方式极为多样,单就上述两种方式而言,各类生物在细节上也有所不同,可见生物界的多样性。
第四节 育种实践中的人工选择与远缘杂交
达尔文认识到,在人类培育动植物品种的过程中,最关键的问题是人工选择。达尔文还说明了自然选择和人工选择的异同。
随着遗传学研究不断发展,现在对自然选择和人工选择的异同,比达尔文时代理解得更清楚了。这些研究对育种实践起了很大的指导作用。我们这里想就人工选择中环境条件的作用和遗传变异的作用这两个问题简单说明一下。
一、环境条件的作用
环境条件在人工选择中的作用与它在自然选择中的作用很有相似之处。在自然选择中,环境条件的作用首先在于和每个个体的基因型相互作用而决定了每个个体的表型,然后因为各种不同的表型在一定环境条件下有不同的死亡率和繁殖率,这就决定了自然选择的方向。人工选择的方向是人类的目的,或是为了获得某一器官(种子、果实、纤维等)的产量和品质,或是为了获得某一生理特性(抗病、抗寒、抗倒伏等),总之,是为了取得人类所要求的某些生产性状。所以在人工选择时,首先必须建立一定的环境条件,使某一基因型的表型效应能够充分表达,或有一最合适的表现,这样进行选择才可取得最好的效果。
例如在选育抗病品种时,育种工作者常在育种圃上进行病菌的人工感染(当然要有措施,不能让病菌传播开去)。如果不进行人工感染,很难看出哪棵植株有抗性,哪棵没有。
又如在乳牛中,要选择牛油中黄色素多的乳牛。牛油中的黄色素直接来自绿色植物,有些乳牛把植物的黄色素积累到脂肪中的能力大些,有些乳牛差些。这种积累能力的差异在很大程度上由基因型所决定,因此人工选择才有效。进行选择时必须对整个牛群都给以丰富的青饲料,这样才能使个体间的差异充分表现出来,而且这种黄色素并非遗传物质,不具有“自我复制”能力,选出来的品种要它继续保持高水平的黄色素含量,必须继续供以丰富的青饲料。
一般地说,想要选育的品种将来在什么条件下栽培或饲养,就得在什么条件下进行选择。这种做法也可以说是利用自然选择来帮助人工选择,使主要的生产性状符合人工选择的目的,而其他性状则适应当地的栽培或饲料条件。不过在任何人工选择中,自然选择也必然在起作用,所以如果人工选择一放松,自然选择就取而代之。品种退化当然有混杂、分离、变异等原因,但缺乏连续的严格的人工选择,使重要生产性状在自然选择的作用下逐渐减退,往往也是一个重要的原因。
二、遗传变异的作用
人工选择与自然选择的素材都是遗传变异。也就是说,正是由于生物群体内存在着不同的等位基因,人工选择或自然选择才能发挥作用;遗传变异愈多,则选择愈有希望。遗传变异包括突变和重组等。在稻、麦等自花授粉作物中,天然的重组是不多的,我国不少有经验的农民利用天然突变进行穗选,常得到很好的结果。例如用穗选方法选出的晚粳品种“老来青”就非常有名。现在我国各地育种机构也用某些物理因素和化学因素来提高突变率,这就是所谓辐射育种和化学诱变育种。
扩大遗传变异范围的最有效方法就是杂交。两个不同品种在许多基因座上都有不同的非等位基因,所以在杂交之后, $F_{2}$ 以后各代就有各种分离和重组可供选择。我们可以用江苏北部有名的猪种“大伦庄”猪来作为杂交育种的例子。
江苏泰兴、海安一带,人们用本地猪种“大骨头”(中型淮猪)与江苏靖江的“沙猪”杂交,想育成头像本地猪、身子像“沙猪”的新猪种。当杂交后代出现本地种性状较多的个体时,就用“沙猪”去配,如出现“沙猪”性状较多的个体时,便用本地种的猪去配,这样看猪配种,灵活运用,经过反复选择,终于育成了头像本地种“大骨头”、身体像“沙猪”的新猪种。这种猪的特征是:两耳大小适中,嘴如筒,双背,大腹,短腿,毛稀,皮薄,体躯肥圆,耐粗食,长膘快,屠宰率高,肉嫩味美,产仔多,该地人就把这个新猪种称之为“大伦庄”猪(姚德昌,未发表)。
三、远缘杂交
有时整个种内所有品种的遗传变异还不能使我们满足,仅靠选择亦是不够的,这时还可以用不同的种来杂交,这就是所谓远缘杂交。我们对于种的形成过程有了了解以后,讨论远缘杂交的实践问题就比较容易了。不过我们这里讨论的只限于植物的远缘杂交。
种的形成关键是生殖隔离的形成,但生殖隔离有各种表现。如果表现为 $F_{1}$ 的可育性大大降低,甚至完全不育,那有什么办法克服呢?前面已多次讲过,一个很有效的办法就是把它的染色体数目加倍,制备成一个异源多倍体。育种工作者把普通小麦 $(2n=42)$ 与黑麦 $(2n=14)$ 杂交,得到28条染色体的杂种。如果在杂种的幼苗期将它们的分蘖苗浸在秋水仙碱的水溶液中,经过4天左右,就能使部分杂种的染色体数加倍,成为具有56条染色体的小黑麦,兼有小麦和黑麦的全套染色体,叫作异源多倍体或双二倍体,能恢复正常结实。
如果隔离表现为 $F_{1}$ 多少有些可育性,那么可以把杂种一代与某一亲本回交,像陆地棉与海岛棉杂交,回交子代植株可育性很高,育种工作者利用这个特点,把海岛棉中抗黄萎病的基因转移到陆地棉。先将海岛棉与陆地棉杂交,然后杂种 $F_{1}$ 再与陆地棉交配,后代中选出抗性植株(用人工感染法测定),再与陆地棉交配,如此数代之后,就育成抗黄萎病的陆地棉。“爱字 1517”就是这样育成的,其中极大部分基因来自陆地棉,基本上保持陆地棉原有的基因组合,因此生长良好,只有抗黄萎病的基因来自海岛棉。这种方法的优点在于陆地棉中本来没有抗黄萎病的品种,不能依靠陆地棉不同品种的杂交而育成抗病品种,所以就从海岛棉输入所需要的基因。一旦育成抗黄萎病的“爱字 1517”之后,就可用品种间杂交育种方法育成其他抗黄萎病的陆地棉品种。
如果生殖隔离表现得更早些,例如表现为 $F_{1}$ 胚胎死亡,这常常是由于杂种胚胎与杂种胚乳不协调,我们可以把已受精而刚开始发育的种子拿出来,把其中不成熟的杂种胚胎取出,放在人工培养基上培养,得到正常健全的 $F_{1}$ 种子。例如在烟草的种间杂交(Nicotiana tabacum×N. debeyi)时,用胚珠离体授粉获得的种子在培养基上能萌发,但幼苗夭亡。为了使杂种正常成长和结实,对幼苗进行子叶培养,从子叶诱导出愈伤组织,得到了杂种。然后用秋水仙碱处理杂种生长点,使它们的染色体数加倍,成功地获得了能育的双二倍体植株(容珊、陈漱阳,1978)。
如果生殖隔离表现得更早,表现在一个种的花粉不能在另一个种的花柱上发芽,并长成花粉管,那么可用花柱嫁接法,把父本花柱接在母本子房上,让父本花粉可以在同种的花柱中长下去。这种方法在茄科植物中很成功。这样的 $F_{1}$ 种子培养成植株后,或做成多倍体,或与亲本回交,都无不可。
如果两个种的亲缘关系太远,实在无法杂交,也可尝试用原生质体融合法。这种方法的做法是,分别把两个种的幼苗组织或培养中的组织用纤维素酶和果胶酶处理,溶去细胞外壁,得到原生质体,然后使之融合成为异源多倍体。例如烟草 N. landsdorffii(2n=18) 和 N. glauca(2n=24) 用酶处理,除去细胞壁,放在硝酸钠溶液中,使细胞融合,形成杂种异源多倍体(图 19-10)。不过这两个种的亲缘关系较近,通过杂交也可得到杂种,再经过染色体加倍,同样可以得到异源多倍体。
综上,远缘杂交中用来克服生殖隔离的方法非常多。一般讲,先看原来生殖隔离如何表现,再采取相应的对策。自然界中新种形成都要通过自然选择,即使异源多倍体也不例外。同样,用远缘杂交方法来育种,也像用其他方法育种一样,还要依靠正确的人工选择,更精确些讲,是依靠人工选择和自然选择的共同作用。
Nicoliana langsdorffii
Nicoliana glauca
(c)
图 19-10 利用体细胞杂交技术,得到烟草异源多倍体
(a) 从烟草的两个种取得叶肉细胞,用酶处理,除去细胞壁。(b) 把原生质体放在 $\mathrm{NaNO}_{3}$ 溶液中,促进细胞融合,形成异源多倍体杂种。(c) 离心后,细胞接种在只有杂种细胞能长的培养基上。(d) 杂种分化出茎和叶。(e) 嫁接在亲本植株上,杂种开花结实。(f) 种子萌发,长成幼苗,最后长成成熟的异源多倍体植株。
(d)
习题
白花三叶草是自交不亲和的,所以阻止了自花受精。白花三叶草的叶子上缺乏条斑是一种隐性纯合状态 $vv$ ,大约 $16%$ 植株有这种表型。白花三叶草植株中有多少比例对这个隐性等位基因 $v$ 是杂合的? 白花三叶草植株产生的花粉中,有多少比例带有这个隐性等位基因?
参考上一题, 假使把相互交配的白花三叶草群体中所有非条斑叶的植株都淘汰 (s=1), 那么下一代有多少比例的植株将是非条斑叶的? 假使你只把非条斑叶的植株淘汰一半 (s=0.50), 那么下一代有多少比例将是非条斑叶的?
对个体生存有害的基因会受到自然选择的作用而逐渐淘汰。请问:有害的伴性隐性基因和有害的常染色体隐性基因,哪一种容易受到自然选择的作用?
人类中, 色盲男人在男性中约占 8%, 假定色盲是 X 连锁隐性遗传, 问预期色盲女人在总人口中的比例应为多少?
下图所示的是一个常染色体隐性遗传病——先天性聋哑的家系,Ⅱ-5个体是该家系的先证者。我们又已知该疾病在群体中的发病率为1/10 000,请问:
(1) 请估算群体中先天性聋哑的突变基因的等位基因频率。
(2) 如果Ⅲ-1 和群体中表型正常的一位女性随机婚配, 所生子女的患病概率是多少?
(3) 家系中, IV-1 患先天性聋哑的概率为多少?
- 下图所示的是一个常染色体隐性遗传疾病的家系图。已知群体中致病基因 $a$ 的频率为 $1%$ 。请估算系谱中第三代两种婚姻子女IV-1(III-1和III-2的子女)与IV-2(III-2和III-3的子女)的发病风险。二者发病风险的差异说明了什么?
假设在一个平衡群体中,B 血型人占 45%,O 血型人占 36%,请计算该群体中 A 血型和 AB 血型人的比例。
在一个随机交配的群体中, 如 $AA$ 个体占 $18%$ , $Aa$ 个体占 $82%$ , 且假定隐性个体全部淘汰, 结果如下表所示:
| 交配组合 | 频率 | 子代频率 | ||
| AA | Aa | aa | ||
| AA \times AA | $(0.18)^{2} = 0.03$ | 0.03 | ||
| AA \times Aa | $2(0.18)(0.82) = 0.30$ | 0.15 | 0.15 | |
| Aa \times Aa | $(0.82)^{2} = 0.67$ | 0.17 | 0.33 | 0.17 |
| 合计 | 1.00 | 0.35 | 0.48 | 0.17 |
请你再算一代,证明隐性基因型的频率将从0.17降低到大约0.09。
家养动物和栽培植物的遗传变异比相应的野生群体要丰富得多,为什么?请从下列几个方面来考虑:①交配体系,即杂交和自交所占的比例;②自然选择;③突变。
时常有人作为难题提出:“究竟鸡生蛋,还是蛋生鸡?”我们说是蛋生鸡,而不是鸡生蛋。试加说明。
证明在显性完全、选择对显性个体不利时,基因 A 频率的改变是:
$$
\Delta p = \frac {- s p (1 - p) ^ {2}}{1 - s p (2 - p)}
$$
- 证明在杂合子的适合度比两个纯合子都高时, 经一代选择后基因 a 频率的改变是:
$$
\Delta q = \frac {p q (p s - q t)}{1 - p ^ {2} s - q ^ {2} t}
$$
数字课程学习
在线自测 习题答案
参考文献
[QR Code]
索引
13 三体综合征(trisomy 13 syndrome) 254
18 三体综合征(trisomy 18 syndrome) 254
21 三体综合征(trisomy 21 syndrome) 254
3’ 非翻译区 (3’ untranslated region, 3’ UTR) 381
5’ 非翻译区 (5’ untranslated region, 5’ UTR) 380
7-甲基鸟苷(7-methylguanositie) 379
$C$ 值 $(C$ -value) 325
$C$ 值悖论( $C$ -value paradox)325
DNA 变性 (denaturation) 91
DNA 测序(DNA sequencing) 120
DNA 重排(DNA rearrangement) 434
DNA 甲基转移酶(DNA methyltransferase, DNMT) 393
DNA 结合域(DNA binding domain, DBD) 387
DNA 聚合酶 I (DNA polymerase I) 97
DNA 聚合酶Ⅲ(DNA polymerase Ⅲ) 97
DNA 酶超敏感位点(DNase-hypersensitive site) 386
DNA 损伤响应 (DNA damage response, DDR) 302
DNA 芯片(DNA chip) 118
DNA 修复(DNA repair) 271
DNA元件的百科全书计划(Encyclopedia of DNA Elements Project, ENCODE Project) 352
DNA 转座子(DNA transponson) 298
F 因子(F factor) 180
F’因子(F-prime factor) 187
G 显带(G banding) 230
Holliday 中间体(Holliday intermediate) 289
LTR 反转录转座子(LTR retrotranponson) 298
miRNA 前体 (precursor miRNA, pre-miRNA) 399
piRNA (PIWI-interacting RNA) 297
poly(A)聚合酶(polyadenylate polymerase) 379
Pribnow 框(Pribnow box) 362
RNA 编辑(RNA editing) 379
RNA 干扰(RNA interference, RNAi) 397
RNA 剪接(RNA splicing) 279,331
RNA 聚合酶(RNA polymerase) 361
RNA 聚合酶Ⅱ(RNA polymerase Ⅱ, RNAP Ⅱ) 376
RNA 引物(RNA primer) 97
RNA 诱导的沉默复合体(RNA-induced silencing complex, RISC) 398
Sextama 框(Sextama box) 362
Southern 印迹(Southern blotting) 118
TATA 框(TATA box) 377
TATA框结合蛋白(TATA-box binding protein, TBP)377
XYY 综合征(XYY syndrome) 137
X 连锁显性遗传(X-linked dominant inheritance) 31
X 连锁隐性遗传 (X-linked recessive inheritance) 31
X失活中心(X-inactivation center, Xic) 401
Y 连锁的遗传(Y-linked inheritance) 31
Y 染色体性别决定区 (sex-determining region of Y, SRY) 141
Z 连锁遗传 (Z-linked inheritance) 130
$\beta$ 地中海贫血( $\beta$ thalassemia)168
$\sigma$ 因子 (sigma factor) 361
A
癌(carcinoma) 448
癌基因(oncogene) 453
癌症(cancer) 448
安格尔曼综合征(angelman syndrome) 396
氨基酸(amino acid) 358
氨酰 tRNA (aminoacyl-tRNA) 366
氨酰 tRNA 合成酶(aminoacyl-tRNA synthetase) 366
B
巴氏小体(Barr body) 400
靶向治疗(targeted therapy) 462
摆动假说(wobble hypothesis) 366
半保留复制(semi-conservative replication) 91
半染色单体转变(half-chromatid conversion) 288
伴随链(passenger strand) 398
伴性遗传(sex-linked inheritance) 127
胞质分裂(cytokinesis) 45
比值比(odds ratio, OR) 420
编码序列(coding sequence, CDS) 101
变异(variation) 7
表达序列标签(expressed sequence tag, EST) 332
表观遗传学(epigenetics) 392
表现度(expressivity) 61
表型(phenotype) 13
表型方差(phenotypic variance, $V_{\mathrm{p}}$ ) 207
表型异质性(phenotypic heterogeneity) 416
并发率(coincidence) 156
并显性(codominance) 65
病毒癌基因(v-oncogene) 460
病例对照研究(case control study) 419
不等交换(unequal crossover) 242
不分离(nondisjunction) 131
不连续复制(discontinuous replication) 97
不完全外显(incomplete penetrance) 61
不完全显性(incomplete dominance) 63
部分不育(partial sterility) 238
部分二倍体(partial diploid) 185
C
参考基因组(reference genome) 339
操纵基因(operator) 371
操纵子(operon) 371
操纵子学说(operon theory) 371
侧体(lateral element) 47
测交(test cross) 13
测序深度(sequencing depth) 349
层次鸟枪法测序(hierarchical shotgun sequencing) 351
插入(insertion) 228
插入序列(insertion sequence, IS) 184, 292
长臂(long arm) 40
长非编码RNA(long non-coding RNA, lncRNA) 343
长末端重复(long terminal repeat, LTR) 298
长散在重复序列(long interspersed nuclear element, LINE) 336
常规假基因(conventional/classical pseudogene) 334
常见疾病(common disease) 416
常见疾病, 常见变异(common disease, common variant, CD-CV) 419
常染色体(autosome) 125
常染色体显性遗传(autosomal dominant inheritance) 31
常染色体隐性遗传(autosomal recessive inheritance) 31
超显性说(overdominance hypothesis) 220
沉默子(silencer) 383
成虫盘(imaginal disc) 430
成对规则基因(pair-rule gene) 429
重叠基因(overlapping gene) 102
重叠群(contig) 348
重复(duplication) 227
重组(recombination) 147
重组DNA技术(recombinant DNA technique) 112
重组合(recombination) 16
重组率(recombination fraction) 157
初级miRNA(primary miRNA, pri-miRNA) 399
初级性别决定(primary sex determination) 140
初级缢痕(primary constriction) 40
初级转录物(primary transcript) 101
串联重复序列(tandemly repeated sequence) 336
纯合性(homozygosity) 214
纯合子(homozygote) 13
次级性别决定(secondary sex determination) 140
次级缢痕(secondary constriction) 40
次亚带(sub-sub-band) 231
粗线期(pachytene) 47 错配修复(mismatch repair, MMR) 304
错义突变(missense mutation) 280
D
大孢子母细胞(macrosporocyte) 52
代谢抑制(catabolite repression) 374
带(band) 231
丹佛体制(Denver system) 230
单倍体(haploid) 40,245
单倍型图谱计划(Haplotype Map Project) 352
单对交配(pair mating) 266
单核苷酸多态性(single nucleotide polymorphism, SNP) 345
单核苷酸替换(single nucleotide substitution) 271
单基因病(single-gene diseases/monogenic disease) 31
单体(monosomy) 245
倒位(inversion) 227
倒位环(inversion loop) 238
等臂染色体(isochromosome) 227
等位基因(allele) 13
等位基因关联(allelic association) 417
等位基因频率(allele frequency) 479
低拷贝重复(low-copy repeats, LCR) 341
地理隔离(geographically isolation) 493
第二次分裂分离(second division segregation) 162
第二代测序技术(next-generation sequencing, NGS) 351
第三代测序技术(third-generation sequencing, TGS) 351
第一次分裂分离(first division segregation) 161
颠换(transversion) 276
凋亡小体(apoptotic body) 428
定位克隆(positional cloning) 414
短臂(short arm) 40
短插入/缺失(small-scale insertion and deletion, InDel) 346
短散在重复序列(short interspersed nuclear element, SINE) 336
断裂愈合模型(breakage joining model) 285
队列研究(cohort study) 420
多倍体(polyploid) 245
多核苷酸(polynucleotide) 87
多核糖体(polyribosomes) 368
多基因假说(multiple gene hypothesis) 199
多肽(polypeptide) 360
多线染色体(polytene chromosome) 230
多效性(pleiotropism) 60
多因素遗传(multifactorial inheritance) 416
E
恶性肿瘤(malignant tumor) 448
二倍体(diploid) 40
二次突变学说(two-hit hypothesis) 455
二分分裂(binary fission) 43
F
翻译(translation) 356
翻译起始因子(initiation factor, IF) 369
反密码子(anticodon) 365
反式调控元件(trans-regulatory element) 383
反式作用元件(trans-acting element) 383
反向遗传学(reverse genetics) 408
反向重复(inverted repeat, IR) 293
反义RNA(antisense RNA) 363
反转录(reverse transcription) 115
反转录病毒(retrovirus) 298
反转录病毒类似元件(retrovirus-like element) 298
反转录酶(reverse transcriptase) 115
反转录转座(retrotransposition) 243, 298
反转录转座子(retrotransposon) 298
反转座子(retroposon) 299
泛素(ubiquitin, Ub) 381
泛素-蛋白酶体途径(ubiquitin-proteasome pathway) 381
放射自显影技术(autoradiography) 94
非LTR反转录转座子(non-LTR retrotransposon) 298非编码 RNA (non-coding RNA, ncRNA) 106
非等位同源重组 (nonallelic homologous recombination, NAHR) 242
非亲二型 (non-parental ditype, NPD) 164
非同源末端连接 (non-homologous end joining, NHEJ) 242
非整倍体 (aneuploid) 245
非组蛋白 (non-histone) 82
分离 (segregation) 10
分离定律 (law of segregation) 14
分裂间期 (interphase) 43
分子进化 (molecular evolution) 472
分子克隆 (molecular cloning) 100
附加体 (episome) 184
复等位基因 (multiple alleles) 69
复等位现象 (multiple allelism) 68
复合转座子 (composite transponson, Tn) 293
复性 (renaturation) 91
复杂疾病 / 性状 (complex disease/trait) 416
复制叉 (replication fork) 95
复制叉停顿和模板转换 (fork stalling and template switching, FoSTeS) 243
复制起始点 (origin of replication) 96
复制子 (replicon) 96
副体节 (parasegment) 429
覆盖率 (coverage ratio) 350
G
概率(probability) 21
干涉(interference) 156
冈崎片段(Okazaki fragment) 97
高度重复序列(highly repetitive sequence) 336
高频重组(high frequency of recombination) 180
高通量测序(high-throughput sequencing) 351
睾丸决定因子(testis-determining factor, TDF) 140
割裂基因(split gene) 101
隔离机制(isolation mechanism) 492
隔离屏障(isolation barrier) 492
工作框架图(working draft)339
功能克隆(functional cloning)410
供体(donor)180
共线性(colinearity)100,433
寡肽(oligopeptide)360
关联分析(association analysis)417
管家ncRNA(housekeeping ncRNA)402
管家基因(housekeeping gene)389
光复活(photoreactivation)302
光修复酶(photolyase)302
广义遗传率(heritability in the broad sense)209
H
哈代-温伯格定律(Hardy-Weinberg equilibrium) 479
海德堡筛选(Heidelberg screening) 406
合胞体(syncytium) 429
合胞体囊胚层(syncytial blastoderm) 429
合成后期(gap 2 phase, $\mathrm{G}_2$ 期) 44
合成期(synthetic phase, S期) 44
合成前期(gap 1 phase, $\mathrm{G}_1$ 期) 44
合子(zygote) 12
合子诱导(zygotic induction) 193
合子致死(zygotic lethal) 68
核苷酸(nucleotide) 87
核苷酸切除修复(nucleotide excision repair, NER) 302
核仁形成区(nucleolar organizer) 42
核酸(nucleic acid) 87
核糖体RNA(ribosomal RNA, rRNA) 366
核外遗传(extranuclear inheritance) 310
核小体(nucleosome) 330
核型(karyotype) 230
核型分析(karyotyping) 230
亨廷顿舞蹈病(Huntington’s disease, HD) 32
后期(anaphase) 45
后随链(lagging strand) 97
互补(complementation) 109
互补DNA(complementary DNA, cDNA) 100
互补基因(complementary gene) 76
化学断裂法(chemical cleavage method) 99
环丁烷嘧啶二聚体(cyclobutane pyrimidine dimer, CPD) 301
环境方差(environmental variance, $V_{\mathrm{E}}$ ) 207
环腺苷酸(cyclic AMP, cAMP) 374
环状染色体(ring chromosome) 227
回复突变(rescue mutation) 264
回顾性研究(retrospective study) 420
混合感染(mixed infection) 190
混合遗传(blending inheritance) 11
获得性状遗传学说(theory of the inheritance of acquired characters) 474
J
基因(gene) 13
基因超家族(gene superfamily) 334
基因簇(gene cluster) 333
基因家族(gene family) 333
基因型(genotype) 13
基因型分型(genotyping) 118
基因型频率(genotype frequency) 479
基因转变(gene conversion) 161,287
基因组(genome) 325
基因组文库(genomic library) 116
基因组学(genomics) 325
基因组印记(genomic imprinting) 395
基因座(locus) 108,157
基因座控制区(locus control region, LCR) 383
基质结合区(matrix attachment region, MAR) 383
激活-解离系统(activator-dissociation system, Ac-
Ds system) 292
极细胞(pole cell) 429
剂量补偿效应(dosage compensation effect) 400
继发耐药(acquired resistance) 464
加工后假基因(processed pseudogene)334
加性方差(additive variance) 209
甲膑综合征(nail-patella syndrome) 411
甲基化(methylation) 113
假基因(pseudogene) 333
间体(mesomere) 43
兼并(degeneracy) 364
减数分裂(meiosis) 45
减数后分离(post-meiotic segregation) 288
剪接变异体(splicing variant) 332
简单序列长度多态性(single sequence length polymorphism, SSLP) 347
简单重复序列(simple tandem repeat, STR) 347
碱基对(base pair) 89
碱基类似物(base analogue) 276
碱基切除修复(base excision repair, BER) 302
碱基替换(base substitution) 276
降解物激活蛋白(catabolite activator protein,
交叉(chiasmata) 47
交互分离(alternate segregation) 236
交换(crossing over) 47
交换率(crossing over percentage) 157
交联(cross-linkage) 278
校对(proofreading) 304
接合(conjugation) 180
结构基因(structural gene) 371
姐妹染色单体(sister chromatid) 40
解链温度(melting temperature) 91
解旋酶(helicase) 98
近交(inbreeding) 214
近交系数(coefficient of inbreeding) 215
进行性假肥大性肌营养不良(Duchenne muscular
dystrophy, DMD) 138
精原细胞(spermatogonium) 48
精子形成(spermatogenesis) 49
局限性转导(restricted transduction) 195
聚合酶链式反应(polymerase chain reaction, PCR) 119
绝缘子(insulator) 383
菌落杂交(colony hybridization) 117
K
抗维生素D佝偻病(vitamin D resistant rickets) 34
抗性转移功能基因(resistance-transfer functional gene, RTF gene) 293
拷贝数变异(copy number variation, CNV) 345
颗粒遗传(particulate inheritance) 11
可变剪接(alternative splicing) 332
克兰费尔特综合征(Klinefelter syndrome) 136
克隆(clone) 116
克鲁宗综合征(Crouzon syndrome) 61
跨损伤合成(translesion synthesis, TLS) 271
L
莱昂作用(lyonization) 400
雷特综合征(Rett syndrome) 394
连接酶(ligase) 98
连锁(linkage) 145
连锁不平衡(linkage disequilibrium, LD) 417
连锁群(linkage group) 151
连锁图(linkage map) 156
联会(synapsis) 47
联会复合体(synaptonemal complex) 47
镰状细胞贫血(sickle cell anemia) 66
链终止法(chain termination method) 99
亮氨酸拉链(leucine zipper) 388
烈性噬菌体(virulent phage) 189
裂隙基因(gap gene) 429
邻近分离(adjacent segregation) 236
磷酸二酯键(phosphodiester bond) 89
卵裂(cleavage) 425
卵原细胞(oogonium) 48
螺旋-转角-螺旋(helix-turn-helix, HTH) 387
M
猫叫综合征(cri-du-chat syndrome) 234
孟德尔性状(Mendelian character) 13
孟德尔遗传疾病(Mendelian disease) 31孟买型(Bombay phenotype) 72
密码子(codon) 364
免疫检查点(immune checkpoint) 465
免疫球蛋白(immunoglobulin, Ig) 435
免疫治疗(immunotherapy) 465
模板链(template strand) 363
模写选择模型(copy-choice model) 285
末期(telophase) 45
母体效应基因(maternal effect gene) 429
母系遗传(maternal inheritance) 312
母性影响(maternal effect) 308
N
内共生体(endosymbiont) 320
内含子(intron) 101
内源性反转录病毒(endogenous retrovirus, ERV) 338
囊性纤维化(cystic fibrosis, CF) 33
拟表型(phenocopy) 62
拟常染色体区(pseudoautosomal region) 141
拟连锁(pseudolinkage) 236
拟显性(pseudodominance) 233
黏粒(cosmid) 116
鸟枪法测序(shotgun sequencing) 349
O
偶线期(zygotene) 46
P
配子(gamete) 12
配子致死(gametic lethal) 68
平衡易位携带者(balanced translocation carrier) 236
平衡致死系统(balanced lethal system) 241
普遍性转导(generalized transduction) 195
普遍转录因子(general transcriptional factor, GTF) 377
普拉德-威利综合征(prader-willi syndrome) 396
Q
启动子(promoter) 362
起始密码子(start codon) 364
起始前复合物(pre-initiation complex, PIC) 377
千人基因组计划(1000 Genome Project) 352
前病毒(provirus) 298
前导链(leading strand) 97
前期(prophase) 44
前中期(early metaphase, prometaphase) 44
嵌合抗原受体T细胞免疫疗法(chimeric antigen receptor T-cell immunotherapy, CAR-T immunotherapy) 465
嵌合体(mosaic) 255
亲代(parent generation) 10
亲二型(parental ditype, PD) 164
亲组合(parental combination) 16
侵袭(invasion) 448
区(region) 231
区段重复(segmental duplication) 341
去氨基化(deamination) 271
全基因组关联分析(genome-wide association study, GWAS) 416
全基因组鸟枪法测序(whole-genome shotgun sequencing) 351
全酶(holoenzyme) 361
全能性(totipotency) 250
缺失(deletion) 227
缺失环(deletion loop) 233
缺失作图(deletion mapping) 234
缺体(nullisomy) 245
群体(population) 479
群体遗传学(population genetics) 468
R
染色单体干涉(chromatid interference) 167
染色单体转变(chromatid conversion) 288
染色体(chromosome) 40
染色体病(chromosomal disease) 237
染色体畸变(chromosomal aberration) 227
染色中心(chromocenter) 230 人类基因组计划(Human Genome Project, HGP) 338
人类细胞遗传学命名的国际体制(International System for Chromosome Nomenclature, ISCN) 231
溶原菌(lysogenic bacteria) 192
溶原性(lysogeny) 192
熔解温度(melting temperature) 470
乳糖操纵子(lactose operon) 372
软骨发育不全(achondroplasia) 263
S
三倍体(triploid) 245
三点测交(three-point test cross) 152
三联体(triplet) 364
三体(trisomy) 245
散在重复序列(interspread repetitive sequence) 336
色差染色体(harlequin chromosome) 95
上位效应(epistasis) 78
奢侈基因(luxury gene) 389
生殖隔离(reproductive isolation) 493
适合度(fitness) 483
释放因子(release factor, RF) 371
噬菌斑(plaque) 189
噬菌斑杂交法(plaque hybridization) 117
噬菌体(bacteriophage phage) 176
受精(fertilization) 424
受体(recipient) 180
数量性状(quantitative character) 199
数量性状基因座(quantitative trait locus, QTL) 221
数目变异串联重复(variable number of tandem repeat, VNTR) 347
衰减子(attenuator) 374
衰减作用(attenuation) 374
双重感染(double infection) 190
双价体(bivalent) 47
双链RNA(double-stranded RNA, dsRNA) 398
双受精(double fertilization) 52
双脱氧法(dideoxy termination method) 99
双系遗传(biparental inheritance) 312
双线期(diplotene)47
双着丝粒桥(dicentric bridge)239
双着丝粒染色体(dicentric chromosome)227
顺反实验(cis-trans test)108
顺反子(cistron)108
顺式调控元件(cis-regulatory element)383
顺式作用元件(cis-acting element)383
四分子分析(tetrad analysis)161
四联体(tetrad)47
四线分析(4-strand analysis)161
四型(tetratype,T)165
随机遗传漂变(random genetic drift)489
随体(satellite)42
T
肽(peptide) 360
肽基转移酶(peptidyl transferase) 371
肽键(peptide bond) 360
唐氏综合征(Down syndrome) 254
特纳综合征(Turner syndrome) 137
特异转录因子(specific transcriptional factor) 387
体节(segment) 429
体节极性基因(segment polarity gene) 429
体细胞突变(somatic mutation) 262
体轴(body plan) 425
条件致死突变(conditional lethal mutation) 262
调节基因(regulator gene) 371
调控ncRNA(regulatory ncRNA) 402
同配性别(homogametic sex) 126
同义突变(synonymous mutation) 280
同源多倍体(autopolyploid) 246
同源基因(homologous gene) 478
同源染色体(homologous chromosomes) 46
同源异形基因(homeobox gene) 429
同源异形框(homeobox) 433
同源异形现象(homeosis) 432
同源异形域(homeodomain) 433
同质性(homoplasmy) 316
突变率(mutation rate) 262
图距(map distance) 153
图式形成(pattern formation) 425
退火(annealing) 91
脱嘌呤(depurination) 278
拓扑异构酶(topoisomerase) 98
W
外切核酸酶(exonuclease) 97
外显率(penetrance) 61
外显子(exon) 101
外显子混编(exon shuffling) 478
外显子重复(exon duplication) 478
烷化剂(alkylating agent) 277
微RNA(miRNA) 398
微卫星DNA(microsatellite DNA) 347
卫星DNA(satellite DNA) 336
位置效应(position effect) 107
温和噬菌体(temperate phage) 192
无义密码子(nonsense codon) 364
无义突变(nonsense mutation) 280
无着丝粒断片(acentric fragment) 239
物理作图(physical mapping) 348
X
系谱分析(pedigree analysis) 31
系统树(phylogenetic tree) 472
细胞癌基因(c-oncogene) 460
细胞程序性死亡(programmed cell death,PCD) 271
细胞凋亡(cell apoptosis) 428
细胞分化(cell differentiation) 428
细胞核(nucleus) 40
细胞决定(cell determination) 426
细胞型(cytotype) 297
细胞性胚盘(cellular blastoderm) 429
细胞质(cytoplasm) 40
细胞质遗传(cytoplasmic inheritance) 310
细线期(leptotene) 46
狭义遗传率(heritability in the narrow sense) 209
先证者(propositus) 31
显性方差(dominance variance) 209
显性上位(dominant epistasis) 79
显性说(dominance hypothesis) 220
显性性状(dominant character)10
显性致死(dominant lethal) 68
线粒体 DNA (mitochondrial DNA, mtDNA) 315
线粒体遗传瓶颈(mitochondrial genetic bottle-neck)317
限制性内切核酸酶(restriction endonuclease) 112
限制性片段(restriction fragment, RF) 167
限制性片段长度多态性(restriction fragment length
polymorphism, RFLP) 167
相互易位(reciprocal translocation) 235
镶嵌显性(mosaic dominance) 64
小孢子母细胞(microsporocyte) 51
小非编码 RNA(small non-coding RNA, sncRNA) 353
小干扰 RNA (small interfering RNA, siRNA) 397
小核 RNA (small nuclear RNA, snRNA) 343
小核仁 RNA (small nucleolar RNA, snoRNA) 343
小卫星 DNA (minisatellite DNA) 347
锌指(zinc finger) 387
新生突变(de novo mutation) 263
信使 RNA(messenger RNA, mRNA) 363
形态发生(morphogenesis) 427
形态发生素(morphogen) 427
性导(sexduction, F-duction) 187
性染色体(sex chromosome) 125
性因子(sex factor) 180
性指数(sex index) 139
胸腺嘧啶二聚体(thymine dimer) 301
修饰基因(modifier gene) 59
修饰酶(modification enzyme) 113
序列标签位点(sequence tagged site, STS) 348
选择培养基(selective media) 181
选择系数(selective coefficient) 483
血友病(hemophilia) 35
Y
亚带(sub-band) 231
亚显微水平的结构变异(submicroscopic structural
variation) 232
亚致死现象(partial lethality) 68
延伸因子(elongation factor, EF) 371
叶绿体 DNA(chloroplast DNA, cpDNA) 312
一代测序(first-generation sequencing) 120
一个基因一个酶(one gene-one enzyme) 104
一个基因一条多肽(one gene-one polypeptide) 106
一个突变基因一种代谢障碍(one mutant gene-one
metabolic block) 106
移码突变(frameshift mutation) 276
遗传(heredity) 7
遗传测试(genetic testing) 121
遗传方差(genetic variance, $V_{\mathrm{G}}$ ) 207
遗传分析(genetic analysis) 405
遗传率(heritability) 208
遗传平衡定律(law of genetic equilibrium) 479
遗传学图(genetic map) 156
遗传异质性(genetic heterogeneity) 416
异核体(heterokaryon) 257
异配性别(heterogametic sex) 126
异源多倍体(allopolyloid) 248
异源双链或杂种 DNA 模型 (heteroduplex or hybrid
DNA model) 289
异质性(heteroplasmy) 316
抑制因子突变(suppressor mutation) 264
易感基因(susceptibility gene) 417
易位(translocation) 227
引导 RNA (guide RNA, gRNA) 380
引物酶(primase) 97
隐性上位(recessive epistasis)78
隐性性状 (recessive character) 10
营养缺陷型(auxotroph) 161
永久杂种(permanent hybrid) 241
优势对数记分法(log odds score, Lods) 412有丝分裂(mitosis) 43
有丝分裂交换(mitotic crossing over) 108
有丝分裂期(mitotic phase, M 期) 43
有义链(sense strand) 363
诱导物(inducer) 371
诱发突变(induced mutation) 261
阈值模型(threshold model) 204
原癌基因(proto-oncogene) 453
原发耐药(intrinsic resistance) 464
原核生物(prokaryote) 43
原始卵泡(primordial follicle) 51
原始生殖细胞(primordial germ cell, PGC) 49
原噬菌体(prophage) 193
原养型(prototroph) 161
Z
杂合性(heterozygosity) 214
杂合性丢失(loss of heterozygosity, LOH) 456
杂合子(heterozygote) 13
杂合子优势(heterozygote advantage) 487
杂种不育(hybrid dysgenesis) 296
杂种优势(heterosis) 214
增强子(enhancer) 383
整倍体(euploid) 245
正向突变(forward mutation) 264
正向遗传学(forward genetics) 405
正向重复(direct repeat, DR) 293
指导链(guide strand) 398
质粒(plasmid) 100
质量性状(qualitative character) 199
致癌剂(carcinogen) 273
致癌性miRNA(oncogenic miRNA) 460
致死突变(lethal mutation) 262
致育因子(fertility factor) 180
中断杂交技术(interrupted mating technique) 181
中介子(mediator) 387
中期(metaphase) 45
中体(central element) 47
中心法则(central dogma)356
终变期(diakinesis)48
终止子(terminator)363
肿瘤(tumor)448
肿瘤微环境(tumor microenvironment)450
肿瘤血管新生(tumor angiogenesis)450
肿瘤抑制基因(tumor suppressor gene)454
肿瘤抑制性miRNA(tumor suppressor miRNA)460
种间同源基因(orthologous gene)478
种内同源基因(paralogous gene)478
种系突变(germline mutation)262
逐个克隆法(clone-by-clone sequencing)351
转导(transduction)193
转化(transformation)86
转换(transition)271
转录(transcription)356
转录后加工(post-transcriptional processing)379
转录激活因子(transcription activator)383
转录激活域(activation domain, AD)387
转染(transfection)116
转移(metastasis)448
转运RNA(transfer RNA, tRNA)364
转座(transposition)292
转座酶(transposase)293
转座元件(transposable element, TE)292
赘生物(neoplasm)448
着丝粒作图(centromere mapping)161
子二代(second filial generation, $\mathbf{F}_2$ )10
子三代(third filial generation, $\mathbf{F}_3$ )13
子一代(first filial generation, $\mathbf{F}_1$ )10
自发突变(spontaneous mutation)261
自交(selfing)214
自然选择学说(theory of natural selection)475
自由组合定律(law of independent assortment)19
阻遏物(repressor)371
组蛋白(histone)82
组织特异性基因(tissue-specific gene)389
| 数字课程网站 |
[General Information]
书名=遗传学 第4版
页数=512
SS号=15038676
Genetics and population analysis
BRM: a statistical method for QTL mapping based on bulked segregant analysis by deep sequencing
Likun Huang1,2,†, Weiqi Tang3,†, Suhong Bu1,2 and Weiren Wu 1,2,*
1Fujian Key Laboratory of Crop Breeding by Design,2Key Laboratory of Genetics, Breeding and Multiple Utilization of Crops, Ministry of Education, Fujian Agriculture and Forestry University, Fuzhou, Fujian 350002 and 3Institute of Oceanography, Marine Biotechnology Center, Minjiang University, Fuzhou, Fujian 350108, China
*To whom correspondence should be addressed.
†The authors wish it to be known that, in their opinion, the first two authors should be regarded as Joint First Authors Associate Editor: Russell Schwartz
Received on June 3, 2019; revised on November 2, 2019; editorial decision on November 14, 2019; accepted on November 17, 2019
Abstract
Motivation: Bulked segregant analysis by deep sequencing (BSA-seq) has been widely used for quantitative trait locus (QTL) mapping in recent years. A number of different statistical methods for BSA-seq have been proposed. However, determination of significance threshold, the key point for QTL identification, remains to be a problem that has not been well solved due to the difficulty of multiple testing correction. In addition, estimation of the confidence interval is also a problem to be solved.
Results: In this paper, we propose a new statistical method for BSA-seq, named Block Regression Mapping (BRM). BRM is robust to sequencing noise and is applicable to the case of low sequencing depth. Significance threshold can be reasonably determined by taking multiple testing correction into account. Meanwhile, the confidence interval of QTL position can also be estimated.
Availability and implementation: The R scripts of our method are open source under GPLv3 license at https://github. com/huanglikun/BRM.
Supplementary information: Supplementary data are available at Bioinformatics online.
1 Introduction
A quantitative trait locus (QTL) is defined as a genomic segment associated with the genetic variation of a quantitative trait. QTLs can be mapped with the help of molecular markers such as single nucleotide polymorphism (SNP) and insertion–deletion (InDel). There are two approaches for QTL mapping. One is individual segregant analysis (ISA), which classifies segregants according to their marker genotypes and compares trait values of different classes. The other is bulked segregant analysis (BSA), which classifies and pools segregants according to their phenotypes and compares marker allele frequencies (AFs) in different classes or pools (Michelmore et al., 1991). ISA is the common approach for QTL mapping, which is generally more precise and powerful than BSA, but BSA has the merit of being simple, quick and cheap. Since the advent of deep sequencing technologies (Mardis, 2008), a new generation of BSA approach, bulked segregant analysis by deep sequencing (BSA-seq), has been developed. BSA-seq has proven to be efficient for QTL mapping and has been applied to many different species, such as yeast (Ehrenreich et al., 2012; Granek et al., 2013; Meijnen et al., 2016), rice (Qin et al., 2018; Yang et al., 2013), cucumber (Lu et al., 2014), maize (Haase et al., 2015), chickpea (Das et al., 2015), tomato (Illa-Berenguer et al., 2015), groundnut (Pandey et al., 2017), potato (Kaminski et al., 2016), pepper (Zhang et al., 2018) and sunflower (Imerovski et al., 2019).
The principle of BSA-seq for QTL mapping is simple. A number of different statistical methods for BSA-seq have been proposed, including G0 test (Magwene et al., 2011), MULTIPOOL (Edwards and Gifford, 2012), QTL-seq (Takagi et al., 2013), EXPLoRA (Duitama et al., 2014), Hidden Markov Model (Claesen and Burzykowski, 2014), Non-homogeneous Hidden Markov Model (Ghavidel et al., 2015), smoothLOD test (Zhang et al., 2019) and so on. According to the data of citation times of these methods from Google Scholar, QTL-seq appears to have the highest impact and be the most frequently used in practical studies, especially in plants (Das et al., 2015; Illa-Berenguer et al., 2015; Lu et al., 2014; Pandey et al., 2017; Qin et al., 2018; Zhang et al., 2018). This is probably because of its simplicity and intuition, in which the difference of marker AF between two pools is directly tested using a significance threshold estimated by simulation. However, we have found that the significance threshold estimated in QTL-seq is inappropriate (see Section 4). In fact, determination of significance threshold remains to be a problem in BSA-seq due to the difficulty of multiple testing correction. In addition, how to determine the confidence interval of $\mathrm { { _ { 1 } Q T L } { ^ { \prime } s } }$ position is also a problem to be solved.
In this paper, we propose a new statistical method for $\mathrm { B S A - s e q } ,$ named Block Regression Mapping (BRM). We show that our method can reasonably estimate the significance threshold for identifying QTLs and determine the confidence interval of a $\mathrm { Q T L } ^ { \prime } \mathbf { s }$ position. In addition, we also demonstrate the coupled use of BRM with the method Pooled QTL Heritability Estimator (PQHE) (Tang et al., 2018) to estimate the heritability of a QTL after it is mapped.
2 Materials and methods
2.1 Experimental design for BSA-seq
BSA-seq is usually conducted based on a segregating population derived from a cross between two pure-line parents $( P _ { 1 }$ and $P _ { 2 } )$ such as $\mathrm { F } _ { k } ( k = 2 , 3 , 4 , \ldots ) ,$ recombinant inbred lines (RIL), doubled haploid (DH) and haploid (H). Two groups of segregants from the population are bulked, respectively, to make a pair of DNA pools. In terms of the relationship between the two pools, there can be two experimental designs: Design A, two opposite extreme pools, namely, ‘high’ pool (pool 1) versus ‘low’ pool (pool $2 ) ;$ Design B, one extreme pool (pool 1) versus one random pool (pool 2). The two DNA pools are deeply sequenced and the sequencing reads are mapped to a reference genome so that a great number of molecular markers (mainly SNP) can be identified and the counts of marker alleles in each pool can be found. Based on the data of marker allele counts, QTL mapping can be performed. Our method requires that at least one parent’s genome has been sequenced so that the parental origin of each marker allele is identifiable. The statistical principles of QTL mapping in the two designs are similar. In the following, therefore, we shall show our method based on Design A unless otherwise stated.
2.2 Basic principle of QTL mapping by BSA
Consider a marker in the genome. Suppose the AF (in terms of $P _ { 1 }$ allele) of the marker in the population, pool 1 and pool 2 are $f , f _ { 1 }$ and $f _ { 2 } ,$ respectively. If the marker is not linked with any QTL (not associated with the trait), then the two pools should both be a random sample from the population for the marker, and the AFs in the two pools are expected to be equal, or equivalently the allele frequency difference (AFD) between the two pools is expected to be zero, namely, $\mathrm { E } ( f _ { 1 } ) = \mathrm { E } ( f _ { 2 } ) = f , \mathrm { o r } \mathrm { E } ( \Delta f ) \dot { = } \mathrm { E } ( f _ { 1 } - f _ { 2 } ) =$ $\operatorname { E } ( f _ { 1 } ) - \operatorname { E } ( f _ { 2 } ) = 0 .$ , where E means mathematical expectation. By contrast, if the marker is linked with a QTL (associated with the trait), it is expected that \exists ( f _ { 1 } ) \neq \operatorname { E } ( f _ { 2 } ) , or \operatorname { E } ( \Delta f ) \neq 0 . . Hence, by testing the null hypothesis $H _ { 0 } \colon \mathrm { E } ( \Delta f ) = 0 .$ it can be inferred whether the marker is linked with a QTL or not. Generally speaking, the more closely the marker is linked with a QTL, the larger the absolute value of $\operatorname { E } ( \Delta f )$ will be. Therefore, by plotting a continuous $\Delta f$ curve based on all markers along the whole genome, it is possible to identify $\mathrm { Q T L s } ,$ which are likely to be located at the position corresponding to the top of a Df peak.
2.3 Plotting Df curve by regression
To plot the Df curve, it is necessary to find the Df of every marker in the genome at first. If the genotype of each segregant in the two pools is known, then the $f _ { 1 }$ and $f _ { 2 } ,$ , and therefore $\Delta f .$ , can be exactly calculated for every marker. Thus, the $\Delta f$ curve as well as $f _ { 1 }$ and $f _ { 2 }$ curves can be plotted by fitting these data using the local regression method LOESS (Jacoby, 2000). In LOESS analysis, the regression function, weight function and smoothing parameter (the fraction of data points in each local neighborhood) are optional. We suggest using the quadratic polynomial as regression function, the tri-cube function as weight function, and the AICc criterion to determine the suitable smoothing parameter (Hurvich et al., 1998).
In practical studies, only the pooled DNA information is available from sequencing data. As there are countless DNA molecules in each pool, the sequencing data of each pool can be taken as a random sample from the pool, in which the AF of a marker follows a binomial distribution with a mathematical expectation of $f _ { 1 }$ (pool 1) or $f _ { 2 }$ (pool 2). In principle, therefore, the $f _ { 1 }$ and $f _ { 2 }$ as well as $\Delta f$ of a marker can be estimated from the sequencing data:
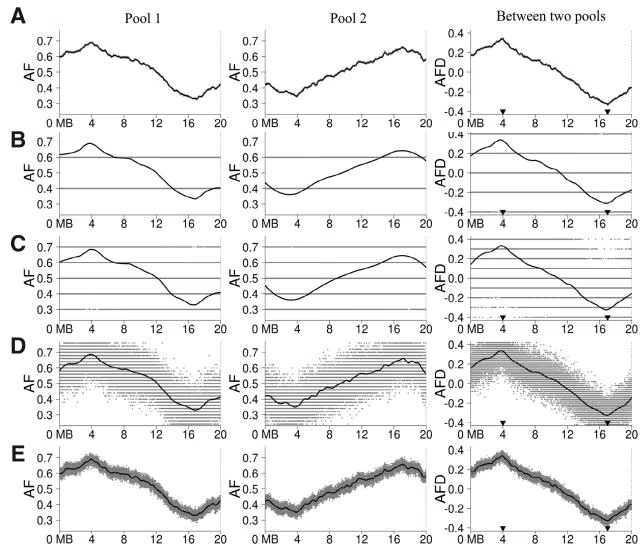
1 | \Delta \hat {f} = \hat {f} _ {1} - \hat {f} _ {2} = \frac {c _ {1 1}}{c _ {1 1} + c _ {1 2}} - \frac {c _ {2 1}}{c _ {2 1} + c _ {2 2}}\tag{1} |
where $c _ { 1 1 }$ and $c _ { 1 2 } ,$ , and $c _ { 2 1 }$ and $c _ { 2 2 }$ , represent the counts of $P _ { 1 }$ and $P _ { 2 }$ alleles of the marker in pool 1 and pool 2, respectively. In theory, $\begin{array} { r } { \mathrm { E } ( \hat { f } _ { 1 } ) = f _ { 1 } , \ \mathrm { E } ( \hat { f } _ { 2 } ) = f _ { 2 } . } \end{array}$ , and $\operatorname { E } { \Bigl ( } \Delta { \hat { f } } { \Bigr ) } = \Delta f .$ . However, as the allele counts (sequencing depths) are usually not very large, the $\mathrm { A F }$ and AFD estimates usually contain great sampling errors (sequencing noise). Nevertheless, as a pair of pair-end reads usually only spans 350 bp, the AF and AFD estimates of different markers are generally independent (except for two very closely linked markers with a distance <350 bp). Therefore, it can be expected that by smoothing the AF and AFD estimates using LOESS, sequencing noise can be effectively eliminated and $\hat { f } _ { 1 } , \hat { f } _ { 2 }$ and $\Delta \hat { f }$ curves can be plotted, which should be similar to $f _ { 1 } , f _ { 2 }$ and $\Delta f$ curves and the similarity should increase with the increase of sequencing depth (sample size). This is demonstrated by simulation study $( \mathrm { F i g . ~ 1 } ) .$ . Therefore, $\Delta \hat { f }$ curve can be approximately taken as $\Delta f$ curve for QTL identification. This enables us to develop a BSA-seq method based on the Df curve.
2.4 Block regression
In LOESS analysis, the optimal situation is that the data points of the independent variable are evenly spaced (Jacoby, 2000). In practice, however, marker density in the genome varies greatly. Simulation study results showed that severely uneven marker distribution could cause insufficient fitting in marker-sparse regions (Fig. 2A and Supplementary Fig. S1A). To solve this problem, we can divide the genome into successive small blocks of equal size. Each block is taken as a genetic unit, of which the AFs in pool 1 (denoted as $\mathbf { \Sigma } _ { - } f _ { 1 } )$ and pool $\bar { 2 } ( - f _ { 2 } )$ as well as the AFD between two pools $( \Delta - f )$ can be calculated as the arithmetic mean or weighted mean (using the relative sequencing depth as weight) of all markers in the block, namely, according to Equation (1),
1 | \begin{array}{l} \Delta \overline {{f}} = \overline {{f}} _ {1} - \overline {{f}} _ {2} = \frac {1}{m} \sum_ {i = 1} ^ {m} \hat {f} _ {1 i} - \frac {1}{m} \sum_ {i = 1} ^ {m} \hat {f} _ {2 i} \\ = \frac {1}{m} \sum_ {i = 1} ^ {m} \frac {c _ {1 1 i}}{c _ {1 1 i} + c _ {1 2 i}} - \frac {1}{m} \sum_ {i = 1} ^ {m} \frac {c _ {2 1 i}}{c _ {2 1 i} + c _ {2 2 i}} \end{array}\tag{2} |
1 | \begin{array}{l} \Delta \overline {{f}} = \overline {{f}} _ {1} - \overline {{f}} _ {2} = \sum_ {i = 1} ^ {m} w _ {1 i} \hat {f} _ {1 i} - \sum_ {i = 1} ^ {m} w _ {2 i} \hat {f} _ {2 i} \\ = \sum_ {i = 1} ^ {m} \frac {c _ {1 1 i} + c _ {1 2 i}}{\sum_ {j = 1} ^ {m} (c _ {1 1 j} + c _ {1 2 j})}. \frac {c _ {1 1 i}}{c _ {1 1 i} + c _ {1 2 i}} - \\ = \frac {\sum_ {i = 1} ^ {m} \frac {c _ {2 1 i} + c _ {2 2 i}}{\sum_ {j = 1} ^ {m} (c _ {2 1 j} + c _ {2 2 j})}. \frac {c _ {2 1 i}}{c _ {2 1 i} + c _ {2 2 i}}}{\sum_ {j = 1} ^ {m} (c _ {1 1 j} + c _ {1 2 j})}. - \frac {\sum_ {i = 1} ^ {m} c _ {2 1 i}}{\sum_ {j = 1} ^ {m} (c _ {2 1 j} + c _ {2 2 j})}. \end{array}\tag{3} |
1 | \begin{array}{c} \sigma_ {0 \Delta f} ^ {2} = \sigma_ {0 f _ {1}} ^ {2} + \sigma_ {0 f _ {2}} ^ {2} = \frac {f (1 - f)}{2 ^ {t} n _ {1}} + \frac {f (1 - f)}{2 ^ {t} n _ {2}} \\ = \frac {n _ {1} + n _ {2}}{2 ^ {t} n _ {1} n _ {2}} f (1 - f) \end{array}\tag{4} |
1 | T _ {\Delta f} = \pm u _ {\alpha / 2} \sigma_ {0 \Delta f}\tag{5} |
1 | \alpha = \frac {\alpha_ {0}}{k}\tag{6} |
1 | k = \sum_ {i = 1} ^ {c} \left(\frac {L _ {g i}}{l} + 1\right) = c + \frac {1}{l} \sum_ {i = 1} ^ {c} L _ {g i} = c + \frac {L _ {g}}{l} = c + \frac {L _ {p}}{r _ {m} l}\tag{7} |
$0 . 0 5 ~ \div ~ 6 0 0 ~ \approx ~ 0 . 0 0 0 0 8 3 , u _ { \alpha / 2 } \approx 3 . 9 4$ . The $u _ { \alpha / 2 }$ values of some species are listed in Supplementary Table S1.
Since the $f$ of every position is available from block regression, the threshold of each position in the genome can be estimated, respectively. Theoretically, however, f is expected to be $0 . 5$ according to the Mendelian Law. As r has the largest value when $f = 0 . { \bar { s } } ,$ the significance threshold in this case should be the highest or most conservative. Therefore, in general, it is appropriate to take $f = 0 . 5$ for all the positions in the genome except that there is severe segregation distortion, which can greatly reduce the significance threshold required (Fig. 4).
2.6 Confidence interval of QTL position
When a $\Delta f$ peak is significant, the H : $\operatorname { E } ( \Delta f ) = 0$ will be rejected, while the H _ { 1 } \colon \operatorname { E } ( \Delta f ) \neq 0 be accepted, suggesting that there is a QTL located in this region with the most probable position at the point of the peak top. The $\Delta f$ of the QTL is expected to approximately follow a normal distribution with mean Eð ÞDf and variance $\sigma _ { 1 \Delta f } ^ { 2 } .$ The variance can be estimated using the following formula:
1 | \sigma_ {1 \Delta f} ^ {2} = \sigma_ {1 f _ {1}} ^ {2} + \sigma_ {1 f _ {2}} ^ {2} = \frac {f _ {1} (1 - f _ {1})}{2 ^ {t} n _ {1}} + \frac {f _ {2} (1 - f _ {2})}{2 ^ {t} n _ {2}}\tag{8} |
where $t , n _ { 1 }$ and $n _ { 2 }$ are the same as in Equation (4). If we take the $\Delta f$ peak top value of the QTL as the Eð ÞDf , then we can find that at the QTL position there is 0.95 probability that $\Delta f > B = \operatorname { E } ( \Delta f )$ $1 . 6 5 \sigma _ { 1 \Delta f }$ in the case of $\mathrm { E } ( \Delta f ) > 0 , \mathrm { o r } \Delta f < B = \mathrm { E } ( \Delta f ) + 1 . 6 5 \sigma _ { 1 \Delta f }$ in the case of $\mathrm { E } ( \Delta f ) < 0$ . Plot a horizontal line of $\Delta f = B$ . It will intersect with the $\Delta f$ curve on the left and the right of the peak top $\left( \mathrm { F i g . ~ 4 } \right)$ . Thus, we can take the region between the left and the right intersecting points as the 95% confidence interval of the QTL.
3 Results
3.1 QTL mapping for yeast growth on copper sulfate In this example, we show the performance of BRM based on actua as well as sequencing-sampled AFD values of markers in yeast, and compare the results with the reported ones obtained by ISA. This will demonstrate the feasibility and efficiency of BSA-seq using BRM. The real experimental data come from the work of Bloom et al. (2015), in which 4390 segregants derived from a cross between a laboratory strain (BY) and a vineyard strain (RM) are individually genotyped for 28 220 SNPs and phenotyped for 20 quantitative traits, including the end-point Growth on a medium containing Copper Sulfate (GCS). The genotype and phenotype data are available from their Supplementary Data. A total of 32 QTLs controlling GCS are mapped by ISA. The estimated heritability ${ \overline { { ( b ^ { 2 } ) } } }$ , the proportion of phenotype variance explained by the additive effect) of each QTL varies 0.015–7.91%, with 10 QTLs being of $b ^ { 2 } > 1 % \ ( 1 . 0 7 -$ 7.91%) and the other QTLs being of h2 < 1% (0.015–0.81%).
We simulated a BSA-seq experiment based on the real genotype and phenotype data of this population. By removing segregants with missing data of GCS, the final population size was 4276. According to the GCS phenotype data, two opposite pools were made, each consisting of 300 extreme segregants. The actual AF in each pool and AFD between two pools of each SNP was calculated from the genotype data. According to the actual AF values, sequencing data (allele counts) of SNPs in each pool were generated by simulation assuming that the sequencing depth (count) of an SNP follows a Poisson distribution with the mean to be 50 and the AF of an SNP sampled by sequencing follows a binomial distribution with the expectation to be equal to its actual value.
BRM analysis based on the actual AFD values of SNPs showed that all the 10 QTLs with $b ^ { 2 } > 1 %$ and two QTLs with $b ^ { 2 } < 1 %$ (on chromosomes I and XII) were significant at the overall significance level of 0.05, and no false positives were found according to the reported ISA results (Fig. 5A and Supplementary Table S2). The estimates of QTL positions were all very close to those obtained by ISA, and the 95% confidence intervals all covered the confidence intervals estimated by ISA (Fig. 5A and Supplementary Table S2). These results indicated that 12 reported QTLs had the potential to be mapped by BSA-seq based on a pair of pools with a size of 300 segregants each from this population.
BRM analysis based on sequencing-sampled AF and AFD values was simulated for five times. The 10 QTLs with $b ^ { 2 } \geq 1 %$ were all significant in each time, and the two QTLs with $b ^ { 2 } < 1 %$ were also significant in part of the simulations. Similarly, there was no false positive according to the reported ISA results. The result of one simulation is shown in Fig. 5B and Supplementary Table S2. It is seen that the QTL positions and confidence intervals estimated by BRM based on the simulated sequencing-sampled AF and AFD values were generally very similar to those based on the actual AF and AFD values, although the confidence intervals estimated based on the simulated sequencing data were generally a little larger (Fig. 5B and Supplementary Table S2).
In addition, according to the peak AFD value of a QTL and the proportion of each pool in the population (300/4276 0.070), we also estimated the heritability $( \grave { b } ^ { 2 } )$ of each QTL using the method PQHE (Tang et al., 2018). The results showed that for most of the $\mathrm { Q T L s } ,$ the heritability estimated by BSA (based on either the actua or the sequencing-sampled AFD values) was very close to the reported estimate obtained by ISA, between which the difference was generally within the standard deviation (Supplementary Table S2). This demonstrates the reliability of pooled QTL heritabilit estimation.
3.2 QTL mapping for cold tolerance of rice seedlings
In this example, we demonstrate the application of BRM to practical BSA-seq data analysis. Yang et al. (2013) report a BSA-seq study for cold tolerance of rice seedlings. In that experiment, 430 most sensitive and 385 most tolerant individuals are selected from 10 800 $\mathrm { F } _ { 3 }$ individuals to make a pair of DNA pools, which are sequenced for an average depth of 70 and 89, respectively. The raw sequence data are available in NCBI (accession number SRP021494). With very strict screening criteria, they obtain 450 000 markers for QTL mapping. In this study, we reanalyzed the raw sequence data to identify a new set of markers, which were required to be homozygous in Nipponbare (one parent of the $\mathrm { F } _ { 3 }$ population), judged by comparing three sets of Nipponbare sequencing data in NCBI (accession numbers: DRP000489, SRP004490 and DRP003133). In total, 2 134 624 markers were obtained, including 1 921 407 (90.0%) SNPs, 211 309 (9.9%) InDels and 1908 (0.1%) others.
Yang et al. (2013) mapped six QTLs on chromosomes 1, 2, 5, 8 and 10 using the G0 test method (Magwene et al., 2011). These six major QTLs were also mapped by BRM (Fig. 6A). Meanwhile, there were several possible minor QTLs detected by BRM (Fig. 6A). In addition, to demonstrate the feasibility of BRM under low sequencing depth, we randomly extracted 10% of the sequencing data (so that the average sequencing depth of the two pools was 7 and 9, respectively) for BRM analysis. As expected, the results were basically similar to those obtained in the analysis based on the original dataset, except that three possible minor QTLs became insignificant (Fig. 6).
4 Discussion
In this paper, we demonstrate that the sampling noise from sequencing can be effectively eliminated by regression (smoothing). Therefore, for any position in the genome, the actual AF in each pool and AFD between two pools can be approximately estimated. According to this fact, we propose a new method for BSA-seq called BRM. The closeness of AF and AFD estimation by regression is satisfactory even under very low sequencing depth, although increasing sequencing depth can improve the estimates. This is a desirable property of BRM, which is especially meaningful for the species with large genome size.
The association between a marker and a trait can be tested using various statistics in BSA-seq. In BRM, we use AFD as the statistic. A merit of using AFD is that the regression estimate of AFD is expected to approximately follow a normal distribution according to the Central Limit Theorem. In addition, AFD is simple and intuitional, and its estimate can be directly used to calculate QTL heritability with the method PQHE (Tang et al., 2018), as demonstrated in the yeast example (Supplementary Table S2).
No matter which statistic is used, determination of a threshold is always a problem when multiple testing correction is required. In BRM, we propose a modified Bonferroni method for multiple testing correction. The core idea is to find the size of a genome segment equivalent to two independent loci in terms of the probability of multiple tests so that the number of effective independent multiple tests in the genome can be calculated. Interestingly, the AFD threshold has a simple form as shown in Equation (5), in which while $\sigma _ { 0 \Delta f }$ is mainly determined by the size of the two pools, $u _ { \alpha / 2 }$ is only determined by the characteristics of the genome. Therefore, $u _ { \alpha / 2 }$ is a constant for a given species (Supplementary Table S1). This is a very desirable property because it makes threshold determination simple and convenient.
The method of QTL-seq also uses AFD as the statistic for testing QTLs, where AF and AFD are termed SNP-index and DSNP-index, respectively (Takagi et al., 2013). In QTL-seq, AFD is smoothed using the sliding window method. The AFD curve obtained is similar to (though not as smooth as) that obtained by LOESS in general. The AFD threshold is determined by simulation, but it does not take multiple testing correction into account. Moreover, according to th model of simulation used, we have proved in theory that the threshold is actually for testing individual markers rather than for testing the mean (smoothed value) of multiple markers (Supplementary Text S2). Therefore, the threshold used in QTL-seq is incorrect. It can be very high when the sequencing depth is low, but may become too low when the sequencing depth is very high so that the variation from sequencing errors is greatly reduced. In the rice example, it can be calculated (Supplementary Text S2) that the average threshold at the significance level of 0.05 used in QTL-seq for the original dataset is 0.121, which is a little lower than the threshold used in BRM; while that for the reduced dataset is as high as 0.353, which only the two QTLs with the largest effects on chromosomes 1 and 8 can exceed (Fig. 6).
Apart from QTL-seq, the methods of G0 test, MULTIPOOL and EXPLoRA also have relatively high citation rates according to Google Scholar. To compare BRM with these methods, we employed them to analyze the simulated pool-sequencing data of the yeast example. The programs of MULTIPOOL and EXPLoRA were obtained from the websites https://github.com/matted/mult pool and http://bioinformatics.intec.ugent.be/kmarchal/ Supplementary_Information_Duitama_2013/, respectively, while the program of G0 test was written by ourselves. The results showed that under the average sequencing depth of 50, both G0 test and MULTIPOOL revealed obvious signals at the positions of QTLs (Supplementary Fig. S2). However, how to judge the significance of the signals was a problem. MULTIPOOL does not provide the method for estimating the LOD threshold (Edwards and Gifford, 2012). In G0 test, for estimating the G0 threshold, it is suggested to find the null distribution of G0 based on the genomic regions not harboring QTLs (Magwene et al., 2011). But how can a region harboring or not harboring QTLs be identified without being tested statistically? Therefore, this method suffers the logic fallacy of circular reasoning. In addition, although it is suggested in G0 test that multiple testing correction could be performed using false discovery rate (FDR), the concrete method for calculating FDR is not described (Magwene et al., 2011). EXPLoRA detected some QTLs under its defaulted significance level (Supplementary Fig. S2), but it also does not take multiple testing correction into account. It is noted that EXPLoRA tended to identify a single QTL (e.g. the QTL on chromosome IX) as two or more adjacent QTLs. As these single QTLs are mapped by ISA (Bloom et al., 2015), which is more powerful and has higher resolution than BSA-seq, the extra QTLs are likely to be false. In addition, the range of a QTL identified by EXPLoRA is not the confidence interval of the QTL but the region showing significant effect. That is why the more-significant QTLs had larger ranges. We also examined the case of low sequencing depth (10 on average). Similar to that of BRM, the results of MULTIPOOL and EXPLoRA were not significantly affected, but the statistic values were greatly reduced in G0 test (Supplementary Fig. S2), suggesting that G0 test is not suitable for the data of low sequencing depth. Taken together, the above comparative study demonstrates the advantages of BRM.
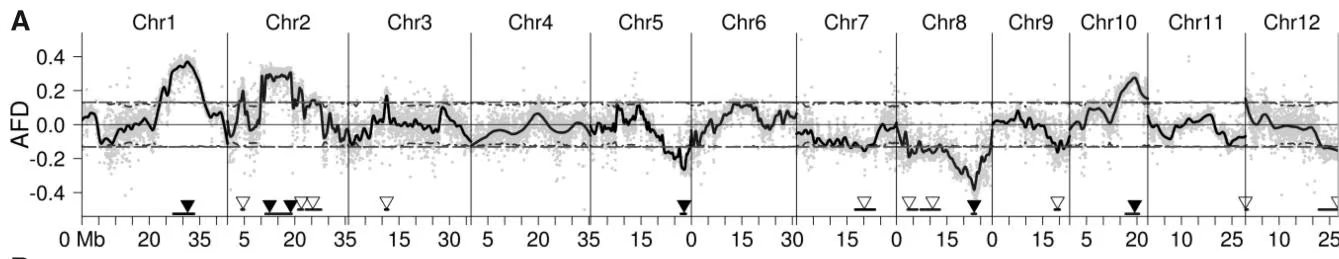
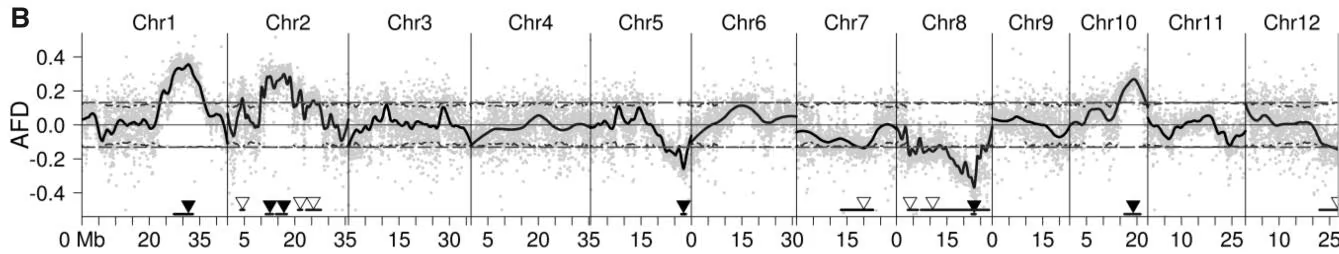
We have seen in the yeast example that QTLs with a heritability of as low as 1% can still be efficiently mapped by BRM (Supplementary Table S2), suggesting that BSA-seq can be very powerful when a large population is used. Certainly, BSA-seq is not as powerful and precise as ISA under the same condition, as seen in this example. However, the populations used for ISA are usually limited at the size of several hundreds (often around 200) due to the cost and workload of genotyping, while those for BAS-seq can be very large (e.g. several thousands) without increasing the cost and workload of genotyping. In this case, BSA-seq could be more powerful and precise than ISA. Therefore, BSA-seq should be a very promising approach for QTL mapping. Our BRM method will facilitate the implementation and application of BSA-seq.
Funding
This work was supported by the grant from the Scientific Research Foundation of Graduate School of Fujian Agriculture and Forest University (grant number YB2014004) and the International Sci-Tech Cooperation and Exchange Program of Fujian Agriculture and Forest University (grant number KXGH17014).
Conflict of Interest: none declared.
References
Bloom,J.S. et al. (2015) Genetic interactions contribute less than additive effects to quantitative trait variation in yeast. Nat. Commun., 6, 8712.
Claesen,J. and Burzykowski,T. (2014) A hidden Markov-model for gene mapping based on whole-genome next generation sequencing data. Stat. Appl. Genet. Mol. Biol., 14, 21–34.
Das,S. et al. (2015) Deploying QTL-seq for rapid delineation of a potential candidate gene underlying major trait-associated QTL in chickpea. DNA Res., 22, 193–203.
Duitama,J. et al. (2014) Improved linkage analysis of Quantitative Trait Loci using bulk segregants unveils a novel determinant of high ethanol tolerance in yeast. BMC Genomics, 15, 207.
Edwards,M.D. and Gifford,D.K. (2012) High-resolution genetic mapping with pooled sequencing. BMC Bioinformatics, 13, S8.
Ehrenreich,I.M. et al. (2012) Genetic architecture of highly complex chemica resistance traits across four yeast strains. PLoS Genet., 8, e1002570.
Ghavidel,F.Z. et al. (2015) A nonhomogeneous hidden Markov model for gene mapping based on next-generation sequencing data. J. Comput. Biol., 22, 178–188.
Granek,J.A. et al. (2013) The genetic architecture of biofilm formation in a clinical isolate of Saccharomyces cerevisiae. Genetics, 193, 587–600.
Haase,N.J. et al. (2015) Shared genomic regions between derivatives of a large segregating population of maize identified using bulked segregant analysis sequencing and traditional linkage analysis. G3, 5, 1593–1602.
Hurvich,C.M. et al. (1998) Smoothing parameter selection in nonparametric regression using an improved Akaike information criterion. J. R. Stat. Soc. Ser. B, 60, 271–293.
Illa-Berenguer,E. et al. (2015) Rapid and reliable identification of tomato fruit weight and locule number loci by QTL-seq. Theor. Appl. Genet., 128, 1329–1342.
Imerovski,I. et al. (2019) BSA-seq mapping reveals major QTL for broomrape resistance in four sunflower lines. Mol. Breeding, 39, 41.
Jacoby,W.G. (2000) Loess:: a nonparametric, graphical tool for depicting relationships between variables. Electoral Stud., 19, 577–613.
Kaminski,K.P. et al. (2016) Next generation sequencing bulk segregant analysis of potato support that differential flux into the cholesterol and stigmasterol metabolite pools is important for steroidal glycoalkaloid content. Potato Res., 59, 81–97.
Lu,H. et al. (2014) QTL-seq identifies an early flowering QTL located near Flowering Locus T in cucumber, Theor, Appl Genet, 127, 1491–1499
Magwene,P.M. et al. (2011) The statistics of bulk segregant analysis using next generation sequencing. PLoS Comput. Biol., 7, e1002255.
Mardis,E.R. (2008) Next-generation DNA sequencing methods. Annu. Rev. Genomics Hum. Genet., 9, 387–402.
Meijnen,J.-P. et al. (2016) Polygenic analysis and targeted improvement of the complex trait of high acetic acid tolerance in the yeast Saccharomyces cerevisiae. Biotechnol. Biofuels, 9, 5.
Michelmore,R.W. et al. (1991) Identification of markers linked to disease-resistance genes by bulked segregant analysis: a rapid method to
detect markers in specific genomic regions by using segregating populations. Proc. Natl. Acad. Sci. USA, 88, 9828–9832.
Pandey,M.K. et al. (2017) QTL-seq approach identified genomic regions and diagnostic markers for rust and late leaf spot resistance in groundnut (Arachis hypogaea L.). Plant Biotechnol. J., 15, 927–941.
Qin,Y. et al. (2018) QTL-Seq identified a major QTL for grain length and weight in rice using near isogenic F2 population. Rice Sci., 25, 121–131.
Takagi,H. et al. (2013) QTL-seq: rapid mapping of quantitative trait loci in rice by whole genome resequencing of DNA from two bulked populations. Plant J., 74, 174–183.
Tang,W. et al. (2018) Estimation of QTL heritability based on pooled sequencing data. Bioinformatics, 34, 978–984.
Yang,Z. et al. (2013) Mapping of quantitative trait loci underlying cold tolerance in rice seedlings via high-throughput sequencing of pooled extremes. PLoS One, 8, e68433.
Zhang,H. et al. (2019) QTG-Seq accelerates QTL fine mapping through QTL partitioning and whole-genome sequencing of bulked segregant samples. Mol. Plant, 12, 426–437.
Zhang,X. et al. (2018) Candidate genes for first flower node identified in pepper using combined SLAF-seq and BSA. PLoS One, 13, e0194071.