从测序到注释:数据如何变成基因
编者导语
本板块走完「原始数据 → 生物学结论」这条流水线:从测序原理、文库构建、 读长与覆盖度,到转录组的取样与差异表达,再到基因组注释、非编码 RNA 的识别 与蛋白质组学。合并的理由是这四段在真实项目里从不单独出现—— 你不会只做注释而不关心它来自哪次测序。 板块含 126 张图与 20 处案例,公式很少(流程性内容本来如此), 但注释与差异表达两段给出了可操作的判据。 一个必须提醒的编辑判断:真正决定结果可信度的往往不是算法而是实验设计, 生物学重复与批次效应如何处理,比换统计方法影响大得多—— 这也是本板块并入转录组部分的原因。相关方法论见 ch51。
前置:ch06。
警告
本章有 2 处原书公式或表格在 MinerU 转换中损坏,已降级为代码块保留残片。这些残片不可直接引用
(其中的系数、矩阵与表达式请回查原书对应页码)。
编者注·本板块导读
图 81 张 案例 13 处 行间公式 2 个。以下清单由正文自动扫出,均为原书内容,未新增。
图(前 8 张;其余见本板块正文)
- 图9-1 Sanger像 —— ch13
- 图9-2 ddNTP结构 —— ch13
- 图9-3 双脱氧链终止法测序原理 —— ch13
- 图9-4 自动测序仪ABI3730XL —— ch13
- 图 9-5 传统 Sanger 测序法与下一代测序技术工作原理比较 —— ch13
- 图 9-6 PacBio 测序原理图 (Eid et al., 2009) —— ch13
- 图9-7 Sanger测序的胶与峰 —— ch13
- 图9-8 测序峰图窗口 —— ch13
- ……其余 73 张见本板块正文
案例(前 6 处)
公式:本板块含 2 个行间公式,均为原书公式,未改写。若你看到代码块形式的残片,说明该处公式在 OCR 中损坏、已降级,请回查原书对应页码。
本板块由以下原始章节合并而成:ch13、ch14、ch15、ch16。
第9章 DNA测序(DNA Sequencing)
子曰:“吾,十有五,而志于学,三十而立,四十而不惑,五十而知天命,六十而耳顺,七十而从心所欲,不逾矩。”——《论语·为证》
本章主要介绍 DNA 测序的第一代 Sanger 法与下一代测序技术的基本原理,并重点介绍 Sanger 法测序的结果分析与处理方法。有关下一代测序的原理与分析流程,请参阅本书后续章节内容。
◎导学案例
弗雷德里克·桑格是一位英国生物化学家,被称为“基因测序之父”,曾因发明蛋白质与DNA测序方法,两次(1958和1980)获得诺贝尔化学奖(图9-1)。
桑格的父亲是一名医生,对他影响很大。桑格在有次谈话说过,在他小的时候,父亲总是教诲他,世界上最值得追求的事情只有两个,那就是对真理和美的追求。他相信阿尔弗德·诺贝尔在决定将奖项授予文学和科学的时候,也会有同样的想法。
从布莱恩斯滕高中(Bryanston School)毕业后,桑格追随父亲的脚步进入了剑桥大学圣约翰学院(父亲毕业于那里的医科而他却选择主修化学)。他先后获得学士学位和博士学位,随后留校任教,成为生物化学系的一名教员,同时开展生化研究。
桑格在剑桥读本科时属于中等水准的学生,他本来对剑桥的毕业考试没有抱太大的希望,在考试成绩出来后得知自己还能在剑桥继续读博士,他多少有些意外。桑格也不是一位“高产”科学家,他一生只发表过为数极少但重要的论文。他在生化年鉴上发表过一篇综述文章“Sequences, Sequences, and Sequences”,该题目概括了他一生从事的蛋白质,RNA 和 DNA 的测序研究。由此可见,对科学贡献的大小,不在量多,贵在质优。
DNA测序技术的发展极大地推动了生命科学的发展,DNA测序已经成为现代生命科学研究不可或缺的手段。自从Fredrick Sanger建立了双脱氧链终止法(dideoxy chain-termination method)的第一代DNA测序技术以来,DNA测序技术快速发展。特别是2005年以来,DNA测序技术经历了一次技术上的突破:以Illumina HiSeq PacBio RS等为代表的下一代测序(next-generation sequencing, NGS)技术的出现,使得基因组测序的通量快速增加,测序成本极大降低。NGS技术已经在生命科学、农学、医学、食品科学和环境保护等领域中得到广泛应用。DNA测序技术的发展已经远远超过了半导体信息技术进步的速度——摩尔定律(Moore’s Law)。随着DNA测序技术的快速发展,生命科学研究已经进入了组学时代,成为一门大科学(big science)。
9.1 DNA测序方法
9.1.1 第一代测序技术
第一代 DNA 测序方法是由 Frederick Sanger 等发明的双脱氧核苷酸末端终止测序法,又简称双脱氧链终止法或 Sanger 法。Sanger 法是一种基于 DNA 聚合酶合成反应的测序技术,其主要原理是利用脱氧核苷三磷酸 (dNTP) 的类似物——双脱氧核苷三磷酸 (ddNTP),取代正常的底物 dNTP(图 9-2)。因为 DNA 聚合酶不能够区分 dNTP 和 ddNTP,使 ddNTP 掺入到新合成的寡核苷酸
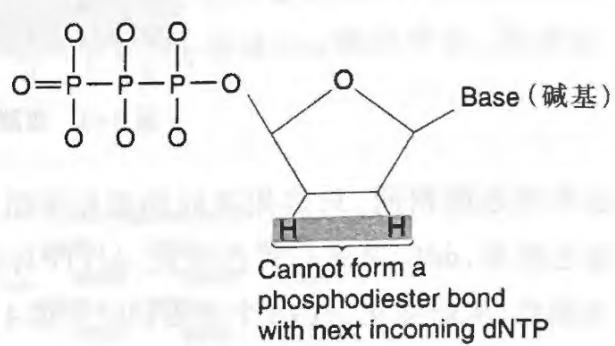
链的3’末端。而ddNTP 3’末端没有羟基(—OH),而是脱氧后的氢(—H),不能与下一个核苷酸聚合延伸,从而终止DNA链的增长。
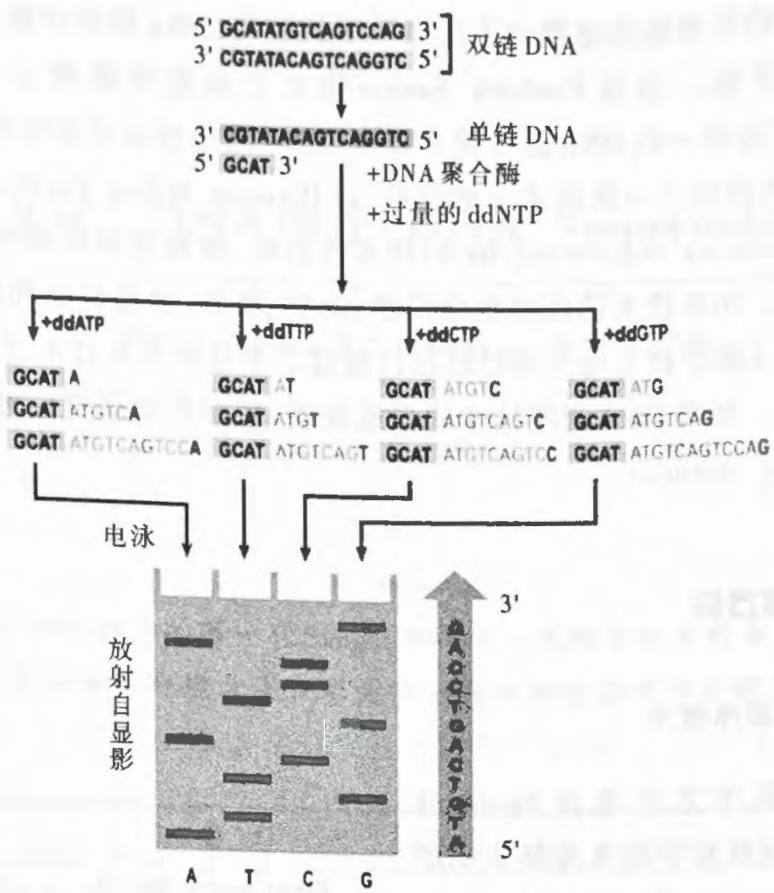
双脱氧链终止法测序过程如图9-3所示。在4个测序反应系统中加入待测的DNA模板、DNA聚合酶及DNA合成反应所需的其他成分,如4种脱氧核苷三磷酸(dNTP)、引物与缓冲液等,并且将少量的一种带有放射性同位素标记的双脱氧核苷三磷酸(ddNTP)按一定比例分别加入一个反应系统,然后进行DNA合成反应,合成与单链DNA互补的核苷酸链。合成的互补链可能在不同位置随机终止反应,产生只差一个核苷酸的DNA分子,从而能读取待测DNA分子的顺序。测序反应终止后,将四组产物全部平行地进行变性聚丙烯酰胺凝胶电泳,每组制品中的各个组分将按其链长的不同分离,从而制得相应的放射性自显影图谱。聚丙烯酰胺凝胶电泳(SDS-PAGE)可以区分长度只差一个核苷酸的DNA分子。因此,从所得电泳图谱即可直接读得DNA的碱基序列。
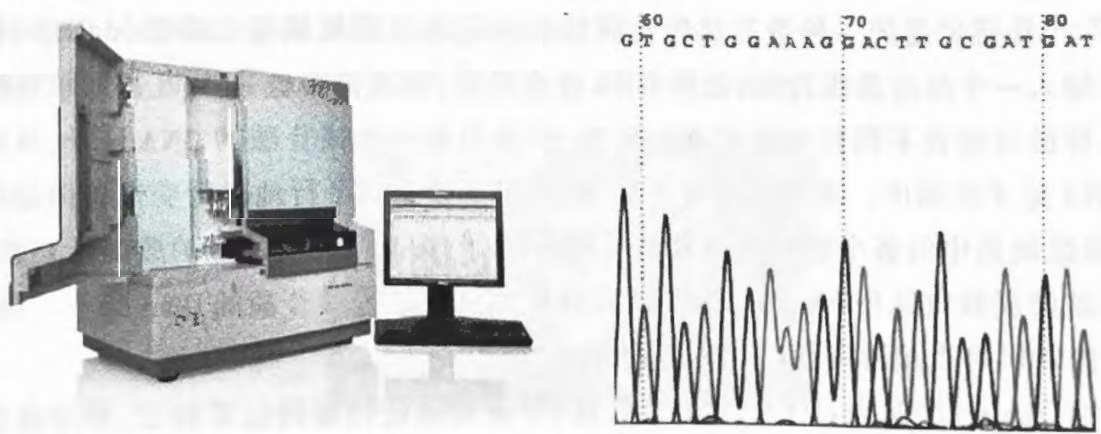
此后,Sanger法又进行了一次重要改进,用荧光标记代替同位素标记,并用成像系统自动检测,开发出荧光自动检测技术,从而大大提高了DNA测序的速度和准确性。与链终止法测序原理相同,只是用不同的荧光基团标记 ddNTP,如 ddATP 标记绿色荧光,ddCTP 标记蓝色荧光,ddGTP 标记黄色荧光,ddTTP 标记红色荧光。由于每种 ddNTP 带有各自特定的荧光颜色,从而简化为由 1 个泳道同时判读 4 种碱基。DNA 自动测序仪的应用综合使用了双脱氧链终止技术、毛细管电泳技术、四色荧光标记技术和激光聚焦荧光全自动扫描分析技术,实现了凝胶电泳、初始数据获取、碱基阅读等步骤自动化。代表性的荧光全自动测序仪为美国应用生物系统公司(Applied Biosystems Inc., ABI)的 ABI3730XL(图 9-4)。目前这种 DNA 测序仪仍被广泛使用,它拥有 96 条电泳毛细管,荧光信号被 CCD(charge coupled device)照相检测系统拍照记录下来,并通过计算机软件判读测序图谱,直接将测序信号转换成 DNA 序列。
Sanger法测序所得的DNA序列长度比较长(800~1000bp),准确性高(达99.999%),至今仍然被公认为是DNA测序的“金标准”。该方法最大的成就是被用于人类基因组计划(Human Genome Project, HGP)的测序,这项计划开始于1990年,历时13年,于2003年由美、日、德、法、英、中六国科学家共同宣布人类基因组序列图谱绘制成功。但Sanger法也存在很大的局限性,其测序成本高、通量低等缺点严重影响了其大规模使用。据估算,用Sanger法测序完成一个人类基因组(约 3\times10^{9}bp )的重测序大约需要1000万美元,而新一代测序技术只需要1000美元。
9.1.2 第二代测序技术
第二代测序技术又称为高通量测序技术或下一代测序(next-generation sequencing, NGS)技术,它一次运行可以对几十万至数亿条DNA模板进行测定。与第一代测序技术相比,极大地增加了数据产出,大大降低了测序成本,使得人们可以对各生物物种进行全基因组测序、转录组测序等研究(图9-5)。二代测序技术平台的代表性产品有Illumina公司的HiSeq2000、MiSeq平台,Life Technologies公司推出的Ion-PGM(Personal Genome Machine)等。第二代测序得到的读长相比第一代测序数据(0.8~1kb)来说都比较短,因此也被称为短序列测序法(short reads sequencing)。例如,Illumina的HiSeq与MiSeq测序平台,测序读长分别为150bp与300bp左右。
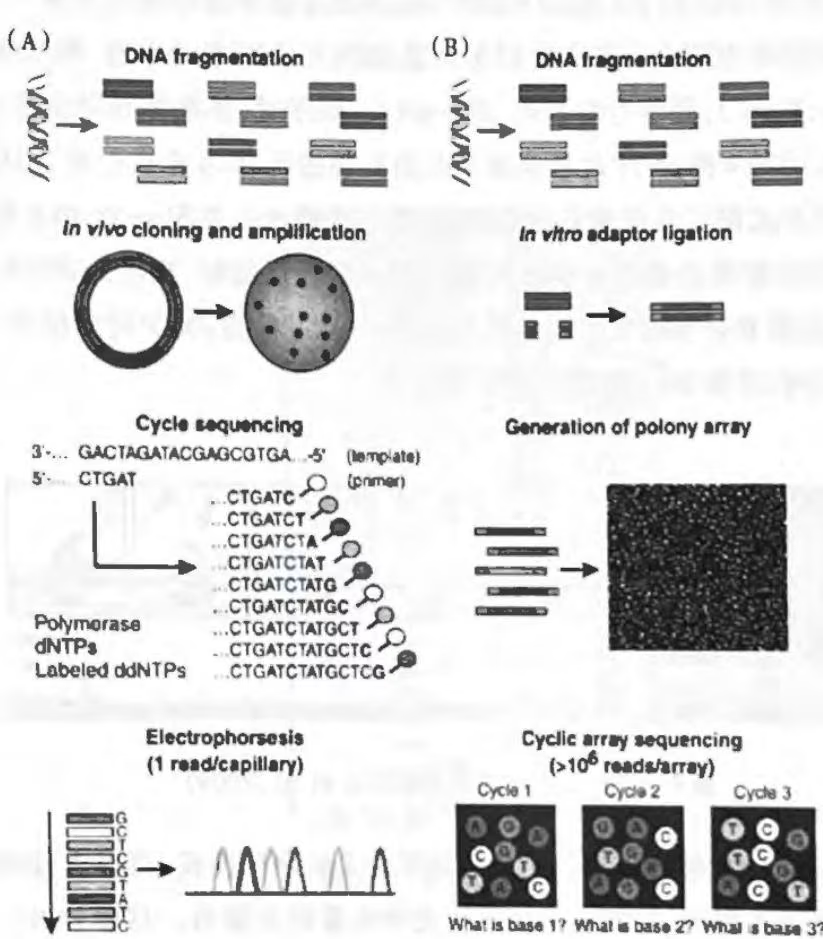
所有二代测序都采取了有别于Sanger测序法中细菌克隆培养扩增待测样本的策略,在随机片段化基因组DNA后,直接在体外连接上共同的接头序列(adapter),然后通过不同的PCR扩增法产生一簇富集的扩增子,并最终被定位在固态反应介质(如芯片、磁珠)的不同位置上。测序过程包括了一系列酶促生化反应和图像收集的自动循环。相对于Sanger测序法,下一代测序法所采用的体外构建测序文库、体外扩增测序模板及更高密度的阵列化测序更大地提高了测序的自动化和平行化,极大地降低了测序单位碱基所消耗的各种生化试剂,大大降低了测序成本。当然,第二代测序有读长较短,数据准确度不高的缺点。
以人类基因组为例,人类基因组大小为3Gb,Sanger测序法耗时13年,全世界科学家合作,花费约27亿美元,而Illumina HiSeq X-Ten高通量测序仪只需约三天时间,测序费用约为1000美元。
9.1.3 第三代测序技术
第三代测序技术是以单分子测序为目标的边合成边测序技术,其测序文库不需要PCR扩增,真正实现了对每一条DNA的单独测序。它的关键技术是荧光标记核苷酸、纳米微孔和激光共聚焦显微镜实时记录微孔荧光,常见的有Pacific Bioscience公司的SMRT技术与Oxford Nanopore Technologies公司的纳米孔单分子测序技术。Pacific BioSciences(PacBio)公司推出的单分子实时(single molecular real time,SMRT)DNA测序技术的主要特点是读长长,平均序列读长在10kb以上。它以SMRT cell为测序载体进行测序反应。SMRT cell是一张厚度为100nm的金属片,一面带有15万个直径为几十纳米的小孔,称为零模波导(zero-mode waveguide,ZMW),简称为纳米孔(图9-6A)。测序时,系统将测序文库、DNA聚合酶和带有不同荧光标记的4种dNTP放置到纳米孔的底部进行DNA合成反应。DNA聚合酶分子通过共价结合的方式固定在纳米孔的底部,通常一个纳米孔固定一个DNA聚合酶分子和一条DNA模板。当按照模板链核苷酸顺序进行DNA聚合反应时,相应的dNTP进入DNA模板链,和引物在聚合酶复合物中发生链延伸反应,同时通过检测dNTP荧光信号,获得荧光信号图像,经过计算分析获得DNA的碱基序列(图9-6B)。
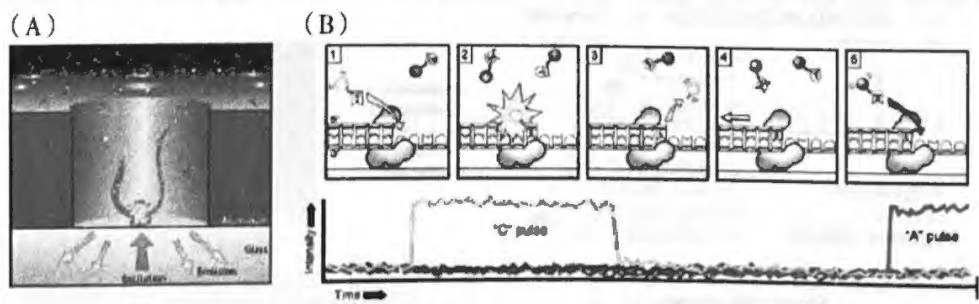
相比二代测序,它能够产生远长于二代测序技术的序列读长,可以直接测RNA序列,也可以测甲基化的DNA序列,在表观遗传学研究中有着巨大潜力。尽管如此,三代测序技术最大的缺点是单读长错误率偏高,需要重复测序纠错,以PacBio SMRT技术为例,错误率高
达 $15%$ ,且随机出错,需要进行多次测序纠错,增加了测序成本。三代测序对DNA聚合酶活性依赖度也较高。目前由于它的应用率没有二代测序普遍,其生信分析软件也不够丰富,积累较少。
9.2 碱基读取(Base Calling)
从不同测序仪上直接得到的并不是真正的碱基序列,而是测序原始信号,如胶图、峰图(荧光颜色与强度信号)、电信号等,需要先由软件转换成碱基序列,并评估碱基的质量(可信度)。将测序仪产生的原始信号转变成碱基序列的过程就称为碱基读取(base calling)。这些读取的碱基序列称为原始序列(raw data),可以存储为FASTA、FASTQ等格式。
最初 Sanger 法测序的一个模板 DNA 序列需要四个不同的测序反应,并在同一块胶上的四条泳道同时进行电泳,再经过放射自显影得到黑色的 DNA 条带胶图,后实验人员直接目视判读 DNA 序列。Sanger 法测序一次反应得到的短片段序列称为 read(读段),一般 read 长度为 800~1000bp。
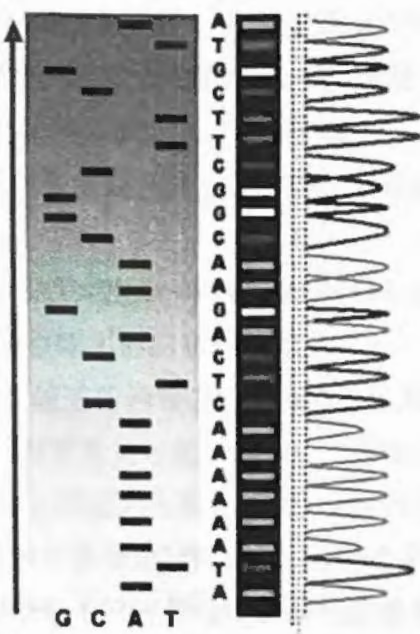
荧光标记用于测序后,测序由原来的“四个反应,四条泳道”简化为“一个反应,一个泳道”。自动化双脱氧测序的是通过计算机将原始电泳胶上的条带转化成荧光波长与强度(intensity)。这些输出数据是一个chromatogram(峰图),或常称为DNA trace。峰图里的颜色代表不同的ddNTP发射的荧光信号,而峰高度代表强度。碱基读取就是把峰图数据转换成碱基序列,如图9-7所示。
Sanger测序最常用的碱基读取程序是Phred。Phred是由美国University of Washington的
Phil Green 开发, 用于读取和评估碱基质量的工具。它采用快速傅立叶变换 (fast fourier transform) 和动态规划算法 (dynamic programming), 从测序仪的峰图文件中每个峰的信息读取对应碱基及其质量值。Phred 读取的碱基质量用 Phred Quality(Q) 来衡量。Q 值表示碱基的出错概率 (Pe) 大小, 计算公式为:
$Q = -10\lg (\mathrm{Pe})$ 。
$Q$ 值越高代表准确率越高,即错误率越低。如 $Q$ 值为20时,表示该碱基的错误率为 $10^{-2}$ (0.01),即准确率为 $99%$ 。Phred具体说明可参见其网址。
不同NGS测序平台采用不同的方法对所构建的文库进行测序,一般是通过捕获光或物理化学信号,并做相应处理来产生DNA片段的碱基序列。如Illumina与PacBio技术都是通过检测荧光标记,而纳米孔(nanopore)测序则是通过检测电场干扰。每个平台处理信号的原始数据都存储在平台特异的格式文件中,然后经过处理后再转换成通用格式FASTQ等。
9.3 Sanger测序结果分析
本实验所用测序数据来自一株细菌样品的16S rRNA基因的PCR产物的DNA测序。一般细菌16S rDNA的长度为1645bp左右,而Sanger法测序一个测序反应只能准确测定800bp左右。因此需要对样品进行两次测序反应(双向测序),然后将两个测序结果拼接成完整的PCR产物序列。
9.3.1 测序结果文件
一般测序公司以 ABI3730x 测序仪进行 Sanger 法 DNA 测序, 测序结果提供两个文档: 一个是序列文档(后缀为 .seq); 另一个是测序峰图文档(后缀 .ab1), 为碱基的测序质量信息。
本例所用的测序数据的文件名称如下:
(A) ZB10100433(yangpin1)16SS.seq——序列的文本文件, 可由记事本或 BioEdit 打开查看。
(B)ZB10100433(yangpin1)16SS.ab1——峰图文件,可由BioEdit或Chromas打开查看。注意其中的杂峰与套峰。
可从书后二维码下载此两文件。
9.3.2 查看峰图
虽然测序仪的碱基读取程序还比较精确,但总有一些不确定,如一个宽峰是一个还是两个碱基,一个很弱的峰是碱基信号还是假信号。对于这些模糊的碱基,可以通过人工检查峰图来判断其可信度。Chromas,Bioedit等是常用的峰图查看软件。
Bioedit 打开*.ab1 峰图文件, 同时打开两个窗口, 最前面是测序峰图窗口(图 9-8), 显示有规则的色谱峰及对应的 DNA 序列。注意观察其中的杂峰与套峰。
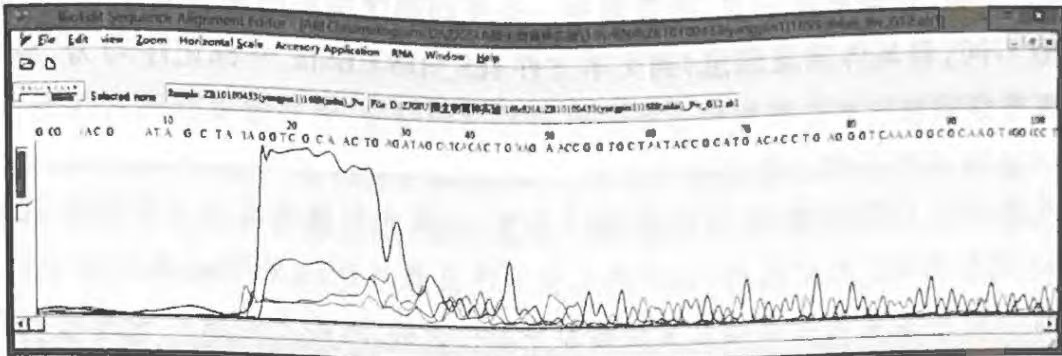
鼠标拖动窗口下面的滑块可以显示序列不同位置情况,能清楚看到整条序列的质量变化。拖动左边与左上角的放大或缩小移动块,调整显示色谱峰的不同宽度与高度,能帮助我们清楚判读峰图。
可以看到起始位置的测序峰比较高但不能区分,越到中间峰越好越规整,再到最后面,峰又变杂乱。Sanger法测序的序列(read)前50bp与800bp后的碱基通常质量比较差,一般无法判读。这是正常现象,主要是因为电泳的迁移率分辨能力有限,导致太大或太小的DNA片段分离不明显,使测序信号无法判读。
请移动鼠标到一个碱基为“N”的位置,你能确定这个未知的碱基吗?再找到一个连续重复碱基区域,如 GGG 或 AAA,你觉得这些碱基有没有问题?
(提示:可通过 BioEdit 的查找功能(Ctrl+F)定位碱基)
9.3.3 切除两端低质量碱基
如前所述,一般 Sanger 法测序序列的前端与末端碱基的质量会不好(可能是测序引物干扰、DNA 聚合酶活性降低与杂质干扰较大等原因),此两部分测序峰图通常无法判读,需要把此两部分碱基切除,留下序列中间碱基质量相对较好(峰图规则)的序列用于后续分析。
BioEdit操作方法如下:
(1)用 BioEdit 打开正向测序结果峰图文件(如 ZB10100433(yangpin1)16SS.ab1),通过移动左边与左上角的比例标尺,调整峰图的高度与宽度,使 DNA 每个碱基的峰图大小适合观察。从图 9-8 看出,前面 50 多个碱基的峰较乱,此处选择位置 55 后开始的碱基。同理,DNA 末端由于酶活力下降等原因,测序质量也逐步变差。根据峰图的形状,我们也需要切除尾部 950bp 后的碱基(约末端 100bp),因此只保留 56—950 这一段约 900bp 的高质量碱基。
(2)选择 BioEdit 显示 DNA 序列的子窗口(Window->DNA sequence from…)
(3) 然后选择 BioEdit 的 Sequence->Select positions, 在弹出窗口中输入 56 与 950, 点 OK 按钮后, 就以背景黑的显示已选择的序列。
(4) 再选 Edit->Copy(或直接按 Ctrl+C 键),复制序列到一个新的文本文件,保存为 16S_rDNA.fasta。增加序列的注释行“>16SF”(加 F 代表正向测序序列)。
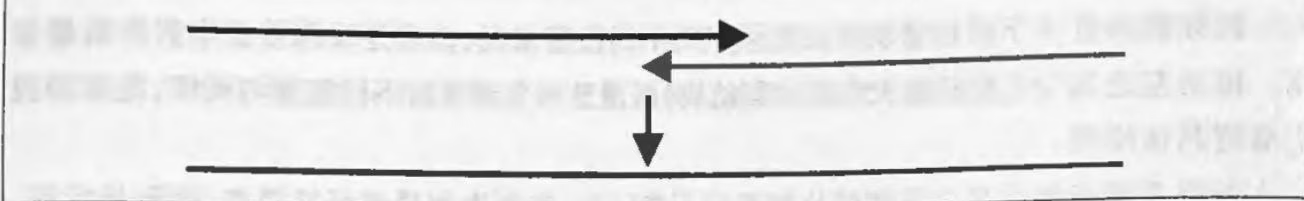
(5) 同上步骤, 根据峰图信息, 再复制另一个反向测序结果的高质量序列 (位置为 56—950, 但可能不同, 看具体质量信息) 到文本文件 16S_rDNA.fasta, 并标记序列为 “>16SR” (R 代表反向测序序列)。
一般都建议 PCR 产物, 进行双向 DNA 测序, 以最大限度地减少测序错误。测序都是从 DNA 的 5’ 端到 3’ 端进行的, 正向和反向测序是指对 DNA 的两条互补链分别测序。然后将两个测序结果利用其相互重叠的部分进行拼接, 这样才能得到完整的 PCR 产物序列。双向测序结果中重叠部分要经校读且完全一致才能认为得到了可靠 DNA 测序结果。
9.3.4 双端测序序列的合并
由于 Sanger 测序技术限制, 在测序反应良好时, 仅有 800bp 左右比较准确。对于片段比较长的 PCR 产物, 通常要求双向测序, 然后将两个测序结果利用其重叠的部分进行拼接, 使最终 DNA 序列比较准确。
(1) Bioedit 打开前面保存的 16S_rDNA.fasta。
(2)由于第二条序列是反向测序得到的DNA反向互补序列,需要先得到此DNA的反向互补序列,再与第一条测序序列进行比对:Sequence->Nuleic acid->Reverse complement。
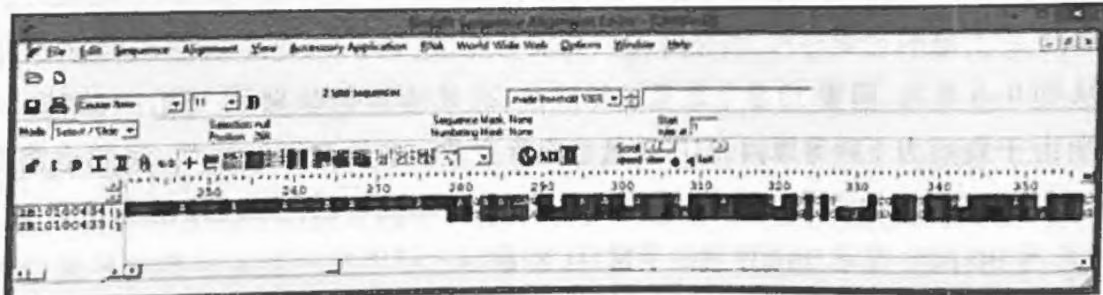
(3) 利用 BioEdit 的 alignment 功能找重叠区域: Accessory application -> ClustalW Multiple alignment, 使用默认设置, 比对结果显示 (图 9-9), 中间重叠部分的序列大部分相似。
如果重叠区不是大部分碱基相同(可能测序方向不是反向的),请试着把另一条序列反向互补,再进行序列比对。
9.3.5 碱基的校准
在上一步的比对结果窗口中,先利用BioEdit得到两条件序列合并后的一致序列:
(1) Alignment->Create consensus sequence。如果中间重叠区有少部分碱基不一致,可根据对应的峰图文件ab1的质量信息,修改碱基。修改碱基前,需要先把Bioedit的Mode设置为“Edit”与“Insert”,并选中按钮“View conservation plotting identities[…] with a dot”,以点显示相同的碱基,便于观察差异位点。
(2) 在 BioEdit 中打开正向和反向测序结果的 AB1 文件和上面比对结果放同一窗户(如图 9-10)。
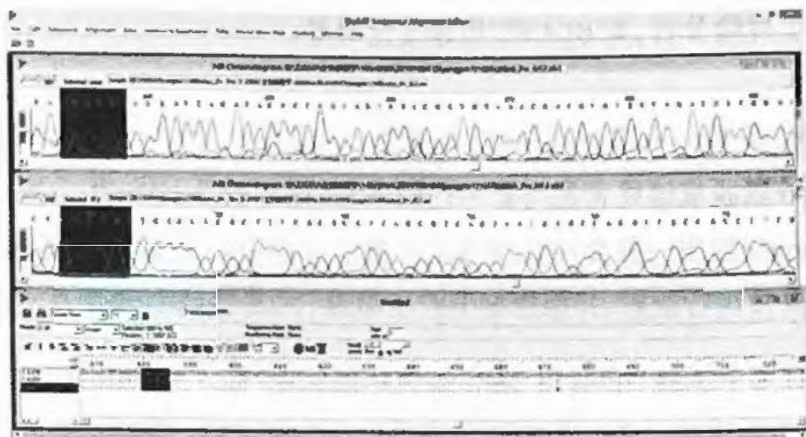
(3)定位到差异碱基的位置(图9-10黑色部分),一般可以在峰图文件中查找不一致碱基(正反链错配、缺失或误增碱基)及附近的几个序列(点击Edit->Find,或直接Ctrl+F),如查找GCAtAC。反向测序峰图的搜索,如果上一步中做了反向操作,这里需要输入序列的反向互补序列(GTaTGC),小写字母为不一致碱基。
(4)查看该碱基及附近碱基正反测序峰图形状,判断该碱基正确的序列。
(5)在序列窗口中分别改正正向16SF、反向16SR及Consensus序列中不一致的碱基。如有空位(gap)显示为“-”,需要把三条序列同一位置上的碱基与“-”都删除,才能保持后面的碱基比对结果正常(Backspace可删除光标前一个碱基)。
9.3.6 校准序列的保存
保存校正后的 consensus 序列, 即为最终测序结果的合并序列。
(1) 在 BioEdit 标题栏选择 Concensus->Edit->Copy sequences, 复制序列;
(2) 再点击 File->Alignment, 新建一个空的序列窗口;
(3) 点击 Edit->Paste sequence, 将复制的序列粘贴到窗口, 并点击“Concensus”的标题改为“16S_rDNA”;
(4) 然后保存为 16S_rDNA.fasta, 文件类型选择 FASTA 格式(图 9-11)。
16S_fDNA_1
GGGAGTGGGGGCATGCTTACCATGCAAGTCGCACGAAGGTTCGGCCTTAGTGGCGGACGGGTGAGTAACGCGTAGGTATCTATCCATGGGTGGGGGATAACACTGGGAAACCGGTGCTAATACCGCATGACACCTGAGGGTCAAAGGCGCAAGTCGCCTGTGGAGGAGCCTGCGTTTGATTAGCTAGTGGTGGGGGTAAAGACTATATGCGATGATCATAGGCTGTTGAGAGATGATCAGGCACACTGGACTGAGACACGTCCAGACTCTACGGGAGCAGCAGTGGGGGAATATGACAATGGGGGCACCTGATCCAGCAATGCCGCGTGTGTGAAGAAGGTCTTCGGATTGTAAAGCACTTTCGACGGGGACGATGATGACGGTACCCGTAGAAGAAGCCCCGGCTAACTTCGTGCCAGCAGCCGCGGTAATACGAAGGGGGCTAGCGTTGCTCGGAATGACTGGGCGTAAAGGGCGTGTAGGCGGTTTGTACAGTCAGATGTGAAATCCCCGGCTTAACATGGGAGCTGCATGTGATACGTGCAGACTAGAGTGTGAGAGAGGGTTGTGGAATTCCCAGTGTAGAGGTGAAATTCGTAGATATTGGGAAGAACACCGGTGGCGAAGGCGGCAACCTGGCTCATTACTGACGCTGAGGCGCGAAAGCGTGGGGAGCAAACAGGATTAGATACCCTGGTAGTCCACGCTGTAAACGATGTGTGCTAGATGTTGGGTGACTTAGTCATTCAGTGTCGCAGTTAACGCGTTAAGCACACCGCCTGGGGAGTACGGCCGCAAGGTTGAAACTCAAAGGAATTGACGGGGGCCCGCACAAGCGGTGGAGCATGTGGTTTAATTCGAAGCAACGCGCAGAACCTTACCAGGGCTTGAATGTAGAGGCTGCAAGCAGAGATGTTTGTTTCCCGCAAGGGACCTCTAACACAGGTGCTGCATGGCTGTCGTCAGCTCGTGTCGTGAGATGTTGGGTTAAGTCCCGCAACGAGCGCAACCCCTATCTTTAGTTGCCATCAGGTTGGGCTGGGCACTCTAGAGAGACTGCCGGTGA CAAGCCGGAGGAAGGTGGGGATGACGTCAAGTCCTCATGGCCCTTATGTCCTGGGCTACACACGTGCTACAATGGCGGTGACAGTGGGAAGCTAGGT GGTGACACCATGCTGATCTCTAAAAGCCGTCTCAGTTCGGATTGCACTCTGCAACTCGAGTGCATGAAGGTGGAATCGCTAGTAATCGCGGATCAGCATGCCGCGGTGAATACGTTCCCGGGCCTTGTACACACCGCCCGTCACACCATGGGAGTTGGTTTGACCTTAAGCCGGTGAGCGAACCGCAAGGACGCAGCCGACCACGTCCGTAACGGTGGT
图9-11 16S rDNA序列
此序列可用于后续分析,如 BLAST、构建进化树等。
习题
比较 Sanger 双脱氧链终止法与新一代测序法(如 Illumina、PacBio)测序原理的异同。
为什么 Sanger 测序一般会在开始与结尾测序反应中出现低质量碱基?对本章 Sanger 测序结果的碱基质量进行检查,并根据峰图校正碱基,尤其是两向测序序列重叠部分的碱基要求一致。
第10章 基因组学
双螺旋真是一个了不起的分子,现代人的历史大约5万年,文明大约出现在1万年前。美国的历史不过200多年。但是DNA与RNA的历史至少有几十亿年。双螺旋一直就存在,非常活跃。我们是地球上知道其存在的第一种生物。——Francis Crick
本章介绍了基因组学的基本概念、测序策略、基因组组装与注释等,并以大肠杆菌致病菌株为例说明基因组比较的分析方法。
◎导学案例
2011年5月,德国出现了由“肠出血性大肠杆菌”引发的“溶血性尿毒综合征”,迅速发生的疫情让4000多人染病,53人死亡。由于首先怀疑是一些人吃了黄瓜而致病,这一疫情又被称为“德国毒黄瓜事件”。在出现大量溶血性尿毒综合征病人后,德国和其他一些国家的研究人员马上投入到追查病原体的战斗中,并从病人体内分离到一株新的大肠杆菌O104:H4(图10-1)。仅用了一个月时间,德国研究人员和我国华大基因公司合作的基因组测序结果“产志贺毒素大肠杆菌O104:H4的开源基因组分析”就在网站上公布出来,并随后发表在NEJM网络版上。最终基因组与流行病学研究证明农场出产的豆芽是病菌源头。
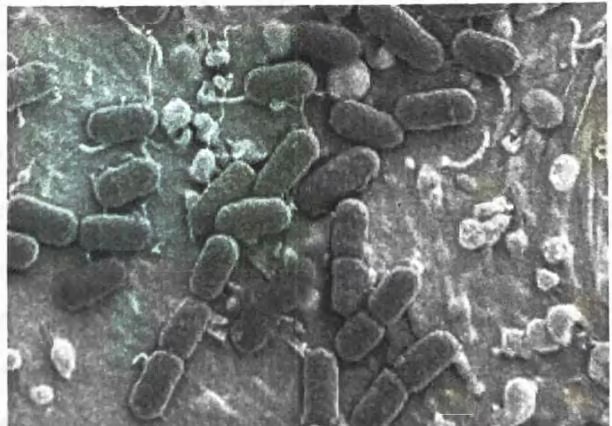
与它相似,大肠杆菌O157:H7是另一株高毒力的病原体,现在每年会导致数百次感染。人吞咽少至10个细菌细胞就可能致命。细菌感染使人致命的原因是细菌通常会从肠道扩散到肾脏,导致溶血性尿毒症综合征(hemolytic uremic syndrome)。什么使O157:H7菌株的毒力这么强?一个关键因素是它获得一种名为志贺毒素(Stx)的毒素基因,这种毒素不存在于其他大肠杆菌菌株中。Stx能结合人肾组织上的受体,但在牛肾中没有此受体,使这些动物成为细菌的无症状携带者。
病原菌的传播主要通过污染的食品与水等,主要污染肉、乳、水产品、蔬菜。因此对于这些食品最好要低温保存,并煮熟后才吃。西方国家喜欢吃沙拉等新鲜蔬菜,容易受病原菌污染。
基因组(genome)一词系由德国汉堡大学的Hans Winkles教授于1920年首创。最初是由”GENe”和”chromosome”两个词合并而成”genome”,用于表示生物的所有染色体组成上的全部基因的概念,即生物的整套染色体所含有的全部DNA序列。现在一般认为基因组指生物所具有的携带遗传信息的遗传物质的总和,包括所有的基因和基因间区域。
所谓基因组学(genomics)就是在基因组水平上研究基因结构和功能的科学。基因组学研究的内容包括基因的结构、组成、表达调控模式、基因的功能及相互作用等,是研究与解读生物基因组所蕴藏的生物全部性状的所有遗传信息的一门前沿科学。1986年,美国杰克逊实验室的遗传学家Thomas Roderick首次提出了基因组学的概念,但直到1990年“人类基因组计划(HGP)”启动才开始真正有系统地研究基因组以解码生命,而随后启动的“后基因组计划”进一步推动基因组学的发展。
一般基因组学研究可以分为三个子领域:
(1) 结构基因组学(structural genomics)是以全基因组测序为目标, 确定基因组的组织结构、基因组成及基因定位的一个分支学科。基因组的结构主要指核酸分子中不同的基因功能区域各自的分布和排列情况, 其功能是储存及表达遗传信息。
(2) 功能基因组学(functional genomics) 是以基因功能鉴定为目标, 利用结构基因组所提供的信息, 通过各种实验手段在基因组水平上全面分析基因的功能, 使得生物学研究从对单一基因或蛋白质的研究转向对多个基因或蛋白质同时进行系统的研究。
(3) 比较基因组学(comparative genomics)是指通过对多个物种已知的基因和基因组结构进行比较, 进一步理解基因的功能、表达机理及生物进化的学科。例如, 人与黑猩猩的 DNA 序列的相似度高达 $99%$ , 因此推测两者表型的差异很可能是由其基因组的调控序列差异造成的。不同种类生物储存的遗传信息量迥异, 其基因组的结构和组织形式也不同。对亲缘关系较近的基因组间相似性的研究为认识基因结构与功能等细节提供了参考, 而较远亲缘关系的基因组比较则有助于揭示生物演化的普遍性机制。
基因组学属于遗传学的一个分支,但它不同于遗传学。因为遗传学一般只研究单个基因或一组基因的性质,而基因组学是系统地研究基因组信息,试图解决生命科学的重大问题。2003年人类基因组测序成功标志着生命科学研究进入基因组学和系统生物学时代。
研究细胞、组织或整个生物体内某种分子(DNA、RNA、蛋白质、代谢物或其他分子)的所有组成内容,称之为组学(omics)。组学研究包括对基因组及基因产物(转录组和蛋白质组等)的系统生物学研究。因此,基因组学研究必然需要生物科学与其他学科的交叉合作,进而从基因组信息中挖掘生命现象的内在变化规律和相互关系。
10.1 基因组测序策略
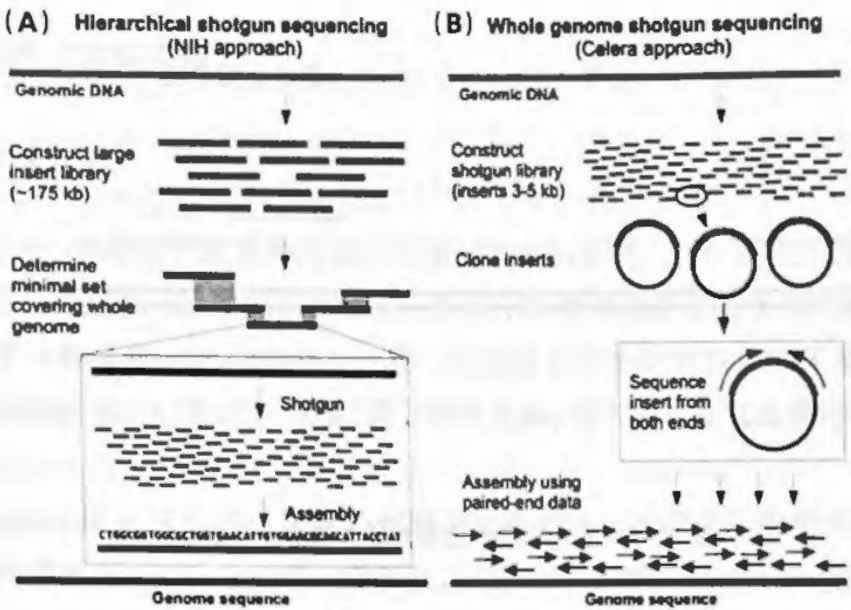
经过多年的发展,基因组测序方法已经得到长足的改进。但由于测序技术限制,DNA测序得到的序列(reads)长度远远小于整条DNA长度,还不能直接对全长DNA进行测序,需要先将基因组DNA打断成小片段进行测序。目前,基因组测序的策略主要分为两类,即逐步克隆法(clone by clone)和全基因组鸟枪法(whole genome shotgun,WGS)。逐步克隆法和全基因组鸟枪法的测序原理如图10-2所示。如果将基因组比作一幅图,基因组测序有点像拼图游戏。逐步克隆法先将整幅大拼图分成若干小图,再先拼每一个小图,然后将所有小图拼成一整幅大图;而全基因组鸟枪法则是从一开始便将大图随机打碎,再直接重新拼成一整幅大图。
10.1.1 逐步克隆法
先将全基因组序列制备大片段克隆文库,如细菌人工染色体载体(bacterial artificial chromosome, BACs)的克隆能力可达120kb,而酵母人工染色体(yeast artificial chromosome, YACs)的克隆能力可达到1Mb,并通过物理图谱上的位点进行克隆片段的筛选,尽量保证大片段克隆文库覆盖全基因组的所有碱基。之后将所筛选的大片段克隆文库里面的序列进一步打断成小片段进行质粒克隆测序。测序完成后,将测序结果先拼接成大片段,再由这些大片段组装成基因组(图10-2(A))。该方法用于人类基因组计划及一些模式生物的基因组测序。这种方法的优点是测序结果准确可靠,但由于全基因组遗传图谱和物理图谱的构建不仅非常困难,而且耗时耗力,有明显的局限性。
10.1.2 全基因组鸟枪法
全基因组鸟枪法(whole genome shotgun sequencing, WGSS)的基本原理是直接将全部基因组DNA打断成小片段后进行克隆测序,获得大量的测序序列,然后再利用高性能计算机将这些测序序列拼接起来,重新组装成一个完整的基因组(图10-2(B))。该方法省去了制作物理图谱的烦琐过程,具有经济、快速和高效的优点,但对序列拼接算法和计算机硬件要求非常高。以卡特·文特尔(Craig Venter)为首的私人测序公司采用这种方法进行人类基因组测序。全基因组鸟枪法结合二代测序技术是目前最通用的基因组测序方法。
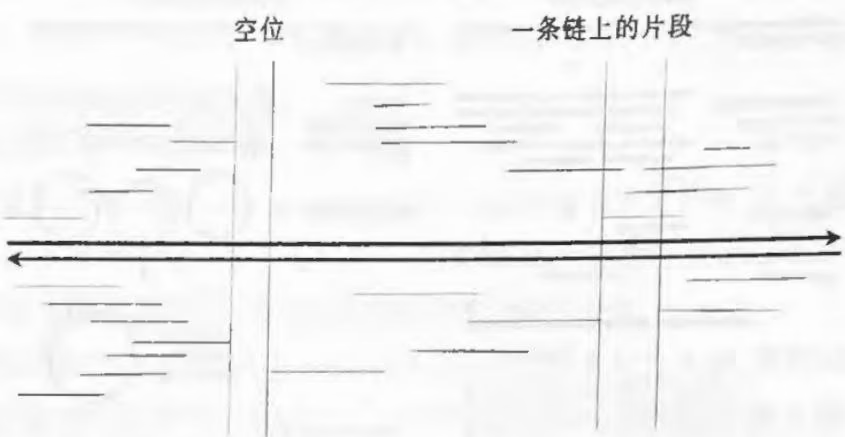
WGSS法最大的挑战在于盲目测序过程。由于没有办法预先知道测序克隆内包含什么DNA序列,可能有大量相同的DNA片段会被重复测序。且一般用于基因组测序的DNA有许多拷贝,为了保证整个基因组的每个核苷酸至少能被测到一次,必须要进行大量DNA小片段的测序,使每个碱基都有足够的覆盖度(coverage),进而拼接出完整的DNA序列(图10-3)。如果测序数据不足,有些基因组序列可能没有测到,会留下空位(gap)。
要保证所有 DNA 序列都被测到一次, 至少需要测多少数据量是鸟枪法测序最关键的问题。最早 Eric Lander 与 Michael Waterman 提出一个数学模型用于估计一个理想化的基因组的最低测序量。此模型假定基因组 DNA 被随机打断, 而且全基因组鸟枪法测序的 DNA 片段服从泊松分布。我们可以估计一个基因组中一个核苷酸没有被测序的概率 $P_{0}$ 为:
$$
P _ {0} = e ^ {- c}
$$
其中 c 是基因组覆盖度(coverage), c 的计算公式为:
1 | c = L \times N / G |
其中 L 是 DNA 测序读段的长度, 如 Sanger 法顺序长度为 1000bp 左右; N 是长度为 L 的 DNA 测序读段 (reads) 的数量; G 是基因组的长度。
通过上面两个公式,为了使一个基因组的99.99%区域被测到,我们可以估算需要测序核苷酸的最少数量。
首先,通过公式转换得到覆盖度c的计算公式:
1 | c = - P _ 0 |
然后,如果希望没有测到基因组中的任何一个核苷酸的概率只有0.01%,即
$$
P _ {0} = 1 - 0. 9 9 9 9 = 0. 0 0 0 1
$$
1 | 覆盖度 c = - 0. 0 0 0 1 = 9. 2 |
因此,为了使一条DNA序列所有核苷酸都被测序的概率为99.99%,总共需要测序的核苷酸数量为覆盖度乘以基因组的总核苷酸数量。这里我们以流感嗜血杆菌(H. influenzae Rd)基因组(其大小1830137bp)为例:
1 | \text { 总测序量 } = 9. 2 \times 1 8 3 0 1 3 7 \approx 1 6 8 3 7 2 6 0 \mathrm{nt} |
即当核苷酸测序数量为16837260nt时,H. influenzae Rd基因组的99.99%序列已经被至少测到一次。假设采用一代Sanger法测序,每个read长度为1000bp,则需要测定的read数量至少为16838个。一般全基因组鸟枪法测序要有较高的覆盖度(8×~10×)才能拼接出完整的基因组。
10.2 基因组组装与注释
10.2.1 基因组组装
在基因组学中,读段指单次测序反应所获得的短片段序列。由于当前测序技术的限制,一般测序读段的长度都低于1000bp,如Sanger法测序所得读段的长度为800bp,而二代测序平台的读段长度一般只有100~200bp。一般生物的染色体长度都在1Mb甚至100Mb以上,因此测序时需要将基因组打断成短片段,建立测序文库,测序完成后又必须将短片段测序结果拼接成染色体。
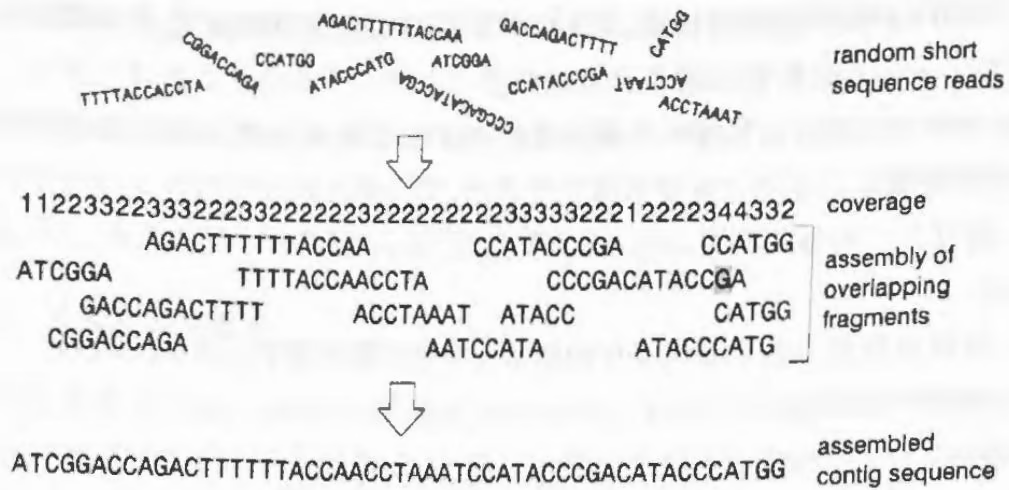
组装(assembly)指通过利用一代或二代测序所得的多个读段之间的相互重叠(overlap)关系进行短序列的延长,直至无法进一步延长,得到连续序列(continue sequences),或又称重叠群(contigs)。重叠群是指一段所有碱基都明确的DNA序列。基因组组装是一个非常困难的问题,特别对NGS测序的短序列reads,由于错误率较高(>1%),重叠序列还要考虑测序错误,如图10-4中突出显示的G核苷酸就可能是测序错误。覆盖度(coverage)显示重叠群中的每个核苷酸已被测序的频率,可作为组装质量的一个重要指标。通常较高的测序覆盖度可克服测序随机错误对组装的影响。如图10-4中与突出显示的G碱基位点匹配的序列此处大多是C碱基,可确认G碱基是测序错误。
由于染色体的重复序列及测序错误等因素,组装结果的长度往往有限,只能得到多个Contigs,此组装结果为基因组草图。如果需要拼接至完整的染色体,需要进一步建大片段文库进行测序,以确定重叠群之间的顺序并修补空缺(gaps)。更多从头测序组装方法参见本书相关章节。
10.2.2 基因组注释
基因组注释(Genome annotation)指利用生物信息学方法与工具,对基因组所有的基因和其他结构信息进行预测,并注释它们的生物学功能。准确的基因组注释对于后续的功能基因组学研究至关重要。一个完整的基因组注释需要鉴定出基因组中包含的各类生物学功能元件,如编码蛋白质的基因、非编码RNA(ncRNA)、重复序列(repeats)和假基因(pseudogene)等,并尽可能地确定基因组中所有核苷酸序列的生物学功能。
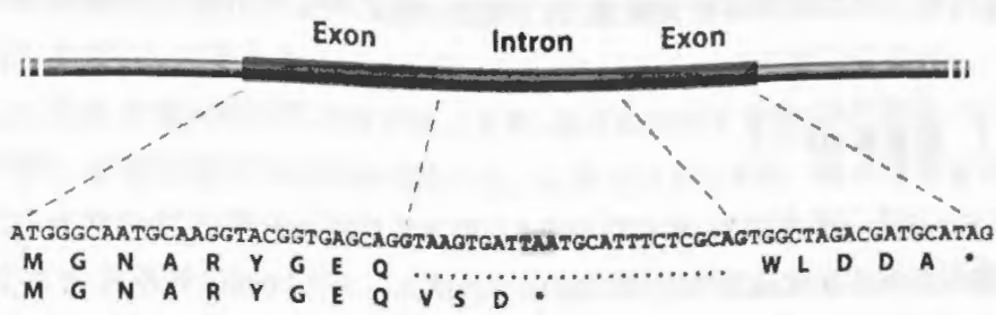
蛋白质对生物体的生命活动具有十分重要的作用。蛋白质编码基因的注释是基因组注释的最主要研究内容。蛋白质编码基因的注释一般可分为基因预测(gene prediction)与基因功能注释(functional annotation)两个方面。基因组组装完毕后即可进行基因预测与基因功能注释。基因预测指通过DNA序列的信息来确定基因结构,即根据生物体内基因的转录和翻译的信号特征来识别基因。例如编码蛋白质的基因包含由一系列的三联密码子组成的开放阅读框(ORF)。ORF以一个起始密码子(通常是ATG)开始,以一个终止密码子(TAA、TAG、TGA)结束。ORF的平均长度随物种而改变,如在E. coli中ORF的平均长度是317个密码子,而在酵母菌中的平均长度是483个密码子。大多数的ORF长度都大于50个密码子,通常寻找基因会搜寻至少100个连续的密码子串。这种ORF搜寻方法对原核生物非常有效,因为原核生物基因无内含子,基因间序列短,很少有重叠基因等。但很难用这种方法预测高等真核生物的ORF,因为高等真核生物的基因通常由外显子与内含子组成,内含子容易出现终止密码子使基因断裂(图10-5),而且基因间有大量的非编码序列等。除了起始密码子与终止密码子,真核生物基因识别往往需要其他信号,如密码子偏倚(codon bias)、转录调控区(TATA框,CpG岛)、内含子的剪切规则(GU-AG)等。密码子在特定生物体的基因中的使用频率是不同的。如酵母中精氨酸的6种密码子中,48%为AGA,因此我们预期真正的外显子是有密码子偏倚现象。而非编码区的三联核苷酸是随机排列,碱基平均分布,不会有密码子偏倚现象。基因预测软件可根据已有的生物密码子偏倚的信息预测基因序列,不同的物种有不同的密码子偏倚,所以许多基因注释程序会写明适用于哪些物种。
目前已经开发了多种基因预测方法,如 GeneMark, Glimmer, AUGUSTUS 等。Glimmer 是常用的微生物基因预测软件,它采用隐马尔科夫(Hidden Markov Model, HMM)算法从“训练”基因数据集中学习基因模型,并用于预测组装序列中的所有可能基因。Glimmer 使用简单,可以下载至本地安装运行,也可以把组装后的序列文件(如 scaffolds.fasta)上传到 NCBI 的基因预测网络服务器,自动进行基因预测。Glimmer 软件包含有一系列软件,Glimmer3 用于细菌的预测,NCBI 的 RefSeq 数据库中的细菌基因组主要是采用 Glimmer3 进行注释。GlimmerHMM 用于真核生物的预测,而 Glimmer-MG 用于宏基因组预测。软件 Glimmer 对细菌基因组的基因预测已经比较准确,但对真核生物的基因预测效果还有限。
由于原核生物的基因结构比较简单,目前基因预测算法已经可以对原核生物基因组进行方便又准确的基因预测,如另一个著名的基因预测工具Prokka,只需要10分钟就可以完成一个细菌基因组的基因注释。然而,大多数真核生物具有复杂的基因结构(如外显子-内含子结构),日前的注释算法仍很难预测每个基因的准确外显子-内含子结构。目前AUGUSTUS是公认最准确的真核基因预测软件。
基因预测得到了基因的结构信息,但是基因的生物学功能仍然未知,因此需要进行功能注释分析。基因注释过程简单说就是通过将待注释序列与数据库中已知功能的序列进行BLAST比对分析,依据序列的相似性初步判断其具有相似的功能。常用的功能注释数据库有GenBank的NR(non-redundant),Swiss-Prot,InterPro,COG(Clusters of Orthologs),GO(Gene Ontology)及KEGG等。随着生物信息技术的发展,特别是通过整合不同的计算和实验方法,研究者已经越来越能够进行比较全面而准确的基因组注释了。
10.3 模式生物基因组
模式生物是人们研究生命现象过程中长期和反复作为研究材料的物种,如酵母、果蝇、线虫、拟南芥等。模式生物的种类较多,以下简要介绍几种经典的模式生物基因组的基本概况。
10.3.1 噬菌体ΦX174
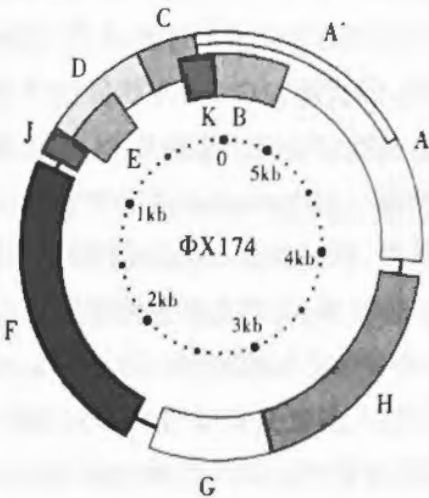
病毒(virus)是一类原始的、有生命特征的、能自我复制和专性细胞内寄生的无细胞生物。病毒基因组的大小变化很大,小的3.5kb(如噬菌体),大的560kb(如疱疹病毒)不等。病毒基因组由相对独立的多个片段组成,可以编码5~100个基因,一般比较紧凑,大多病毒有重叠基因(overlapping gene),即一段DNA序列可编码两个或两个以上的基因。噬菌体ΦX174的基因组是一条单链环状DNA分子(图10-6),其复制起点位于大约10点钟的位置。当噬菌体进入细菌细胞内就会进行DNA复制,产生大量的双链DNA(dsDNA),后再分离成单链DNA用于新噬菌体的组装。ΦX174的基因组包含11个基因,分别以字母按以下顺序命名:A-A*-B-K-C-D-E-J-F-G-H。这些基因的功能大多已经被研究清楚。如基因A与C功能为在细菌内分离双链DNA;基因B、D和J用于噬菌体的组装;基因F、G和H编码噬菌体的外壳蛋白;基因E功能为溶解宿主,释放噬菌体。
病毒一般具有较高的突变率,这是流感病毒逃避人类免疫系统的攻击,几乎每年都能引起大范围流感的主要原因。而且RNA病毒的RNA聚合酶一般缺乏校正能力,导致基因组的突变率比DNA基因组高100万~1000万倍。除了高突变率,许多病毒的复制速度也非常惊人,如一个艾滋病病毒感染的个体一天能产生10亿个病毒颗粒。病毒经常处于强大的选择压力下,如宿主的免疫反应或抗病毒药物作用等。因此,艾滋病病毒快速的突变与复制可确保有些病毒株能经受环境的选择而存活下来。
10.3.2 大肠杆菌
大肠杆菌(Escherichia coli)是肠杆菌科埃希氏菌属的一种革兰阴性菌,周身鞭毛、无芽孢。E. coli为人类和动物肠道中常见的共生菌,大部分菌株无害。自从德国的Theodor
Escherich 在 1885 年发现 E. coli 以来, 它一直被当作正常肠道菌群的组成部分。但有些血清型菌株为致病菌株, 如肠出血性大肠杆菌(EHEC)中的 O157:H7 有较强致病性。
E. coli 是微生物遗传研究的重要模式生物, 具有遗传背景清楚、操作简单、转化率高、生长快等优势。目前已经完成基因组测序的 E. coli 至少有 100 多株。最早完成基因组测序的菌株是 E. coli K-12 MG1655, 它是非致病性大肠杆菌的代表菌株。E. coli K-12 的基因组为环状双链分子 (dsDNA), 大小为 4.6Mb, 其中 87.8% 为蛋白质编码基因序列, 0.8% 为 RNA 基因序列, 0.7% 为非编码的重复序列, 其余为调控序列或功能未知的序列。E. coli K-12 基因组含有 4288 个编码基因, 其中 1853 个基因的功能已经被生物学研究确定, 其他是通过生物信息学分析注释的基因。
E. coli K-12基因组的复制起点位于3.9—3.95Mb。研究发现,大肠杆菌基因组重复序列的排布可能与DNA的复制相关。例如,多拷贝重复排列的rRNA基因(rm)位于环状染色体的中部,这个位置包含已知的DNA复制起始位点oriC,并且rrn操纵子的转录通常朝着远离复制起始位点的方向进行。
10.3.3 酿酒酵母
酿酒酵母(Saccharomyces cerevisiae)是与人类关系最为密切的一种微生物,常用于传统发酵食品,如面包、啤酒等的酿造。酿酒酵母是已知的最简单的单细胞真核生物之一。与人类细胞相似,它的细胞内有细胞核和其他特化的胞内组分。与大肠杆菌类似,酵母菌容易培养,生长周期仅为70分钟左右,同时有单倍体(haploid)和二倍体(diploid)形态,且没有致病性,因此酿酒酵母被作为模式真核生物之一。然而,现已发现一些酿酒酵母菌株(如YJM菌株)具有致病性。
酿酒酵母是第一个完成基因组测序的真核生物。1996年,国际上联合100多个实验室完成了酿酒酵母全基因组测序。酿酒酵母的基因组大小约为12Mb,由16条染色体组成。染色体长度变化较大,如染色体VI有1352kb,而染色体I仅有230kb。酿酒酵母的基因组是大肠杆菌的3.5倍,但不到人类基因组的1/10。很多酿酒酵母菌株含有一个或多个质粒。
酿酒酵母的基因组相对紧凑,基因区域占整个基因组序列的72%。与更复杂的真核生物相比,它的重复序列较少。基因预测表明酿酒酵母大约含有5885个蛋白质编码基因,在蛋白质编码基因中,有4777个是已知功能的基因,并约有1/3的酵母蛋白与人类蛋白有同源性。内含子极少,只有约0.4%的编码基因(231个基因)有内含子,而且大多为rRNA基因,并且内含子通常位于靠近rRNA基因的起始位置。然而,另一种相关的酵母菌,粟酒裂殖酵母(Schizosaccharomyces pombe)的基因中却含有较多的内含子。
酿酒酵母含有许多非编码蛋白质的RNA基因。位于染色体XII上的一段串联重复,编码了120个核糖体RNA(rRNA)基因拷贝。酿酒酵母基因组编码40个核内小RNA(snRNA),275个转运RNA基因(tRNA),其中的1/3含有内含子。
酿酒酵母的基因组是第一个被证明在演化史上经历全基因组加倍的真核生物。约在一亿五千万年前,酵母发生了一次全基因组复制。随后发生了重复DNA片段的易位(translocation), 其中的一个基因拷贝几乎全部丢失(约92%)。
10.3.4 人类基因组
人类核基因组的 DNA 大小约 3.2 \times 10^{9} bp(3Gb),分布在 24 条长度不一的染色体,最长的染色体为 250Mb,最短的为 38Mb。24 条染色体中,22 条为常染色体(autosome),2 条为性染色体,即 X 染色体与 Y 染色体。除了 21 与 22 号染色体因历史原因而例外,人类常染色体基本以大小编号。成人身体有大约 2 \times 10^{9} 个细胞,每个细胞都含有相同的基因组拷贝,只有某些特别类型的细胞(如终极分化状态的血红细胞)缺少细胞核。绝大多数细胞为二倍体,每一个细胞有 2 组常染色体,男性细胞有一个 X 和一个 Y 染色体,女性细胞则有 2 个 X 染色体,总数为 46 条染色体。二倍体细胞称为体细胞,单倍体细胞称为性细胞或配子(gamete)。单倍体细胞含有一组常染色体及一个性染色体。
据不完全估计,人类基因组有2万个左右蛋白质编码基因。跟细菌的基因不同,人类基因组的蛋白质编码基因是不连续的,被内含子分隔开的“断裂基因”。人类编码基因平均约有9个外显子,8个内含子,外显子的平均长度约135bp(一般小于800bp),内含子的平均长度为3365bp(从30个碱基到几万个碱基不等)。因此,一个基因的编码序列只有基因总长的5%左右。
早在人类基因组测序完成之前,我们就已经发现基因组上大部分区域(超过95%)是不会直接编码蛋白的。由于不知道这部分基因组有什么功能,称之为“垃圾DNA”。通过比较不同物种的基因组,我们发现人类基因组上有4%~7%部分在很多哺乳动物的基因组上都存在,这种进化保守现象表明“垃圾DNA”中有一部分可能有重要的功能。随着新的生物技术应用于非编码区的研究,我们发现“垃圾DNA”中有许多功能元件。
关键的非编码基因组元素包括:
- 非编码RNA(ncRNA):人类基因组的大部分区域(>75%)是可转录,但不能翻译成蛋白质的非编码RNA序列。ncRNA在基因组上有很多功能,比如调控基因表达(例如miRNA)和保持染色体结构稳定(例如端粒酶RNA)。
- 假基因:假基因是指曾经在古物种中行使某个功能,但现在已经没有功能的古基因,只是积累随机突变带来的遗传噪声。据Ensembl数据库的统计数据,人类基因组有13430个假基因,数目几乎接近真基因的三分之二。
- DNA重复序列:存在大量重复序列是人类基因组的最重要特征之一,人类基因组50%以上区域含有重复序列,其中60%~80%是中度与高度重复序列(小卫星DNA或微卫星DNA)。长散布重复序列(LINE)与短散布重复序列(SINE,如Alu)分别占整个基因组的21%与13%。这些重复序列可能来自DNA复制错误,也有些重复序列可能在物种进化中有重要作用。
- 反转座子(retrotransposon): 反转座子序列的两个末端含有约 700bp 的重复序列。最近的研究表明, 人类基因组上有很大的比例 (~25%) 的 DNA 是反转座子。人类基因组上有约 8% 是来自人类内源性反转录病毒 (HERV) 的反转座子 DNA。研究人员认为这些病毒反座子对于哺乳动物, 尤其是人类的基因组进化有很大的影响。
除了核基因组,人类基因组还包括线粒体基因组。线粒体是细胞中提供生理生化反应所需能量的场所。人类线粒体基因组为一环状DNA分子(mitochondrial DNA,mtDNA),长度为16568bp,每个细胞平均800个线粒体,每个线粒体含有2~10个基因组拷贝。
10.4 微生物基因组比对与可视化
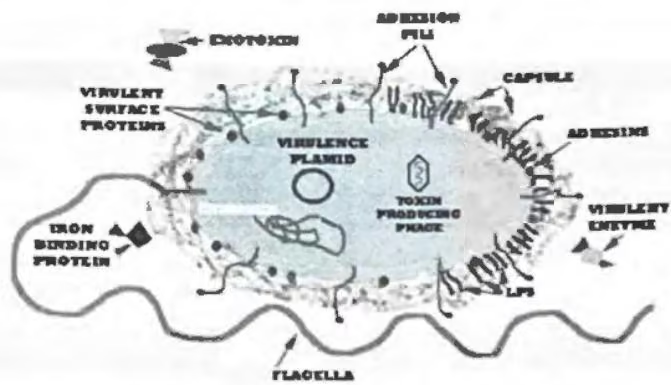
人体为细菌繁殖提供了营养丰富的环境,包括皮肤、呼吸道、消化道(口腔、大肠)、尿道和生殖道等。据估计,每个人身上的细菌数目超过自身的细胞数目。大多数情况下,这些细菌对人体是无害的。然而,有些细菌在一定条件下能够导致感染,甚至带来灾难性的后果。另外,由于大量使用抗生素导致细菌的耐药性增强,因此亟须发现细菌的毒性因子(virulence factor),以能开发相应的治疗疫苗。毒力因子(图10-7)一般包括:
- LPS(脂多糖)、荚膜:保护细菌表面。
- Ⅲ型分泌系统:细菌向真核细胞内输送毒性基因产物的效应系统。
- 黏附素(CFA、AAF、BfP、紧密素、Ipa等):黏附细胞表面。
- 外毒素(Stx、ST、LT等): 最主要毒力因子。
大多数大肠杆菌(E. coli)是人体肠道中的正常菌群,对人体无害,如菌株E. coli K12。但有些E. coli为人类致病菌,主要有肠产毒性大肠杆菌(ETEC),肠出血性大肠杆菌(EHEC),肠侵袭性大肠杆菌(EIEC),肠致病性大肠杆菌(EPEC)。EHEC的主要代表菌株是血清型O157:H7,其主要致病物质为志贺样毒素(Shiga toxins);大肠杆菌K12与大肠杆菌O157:H7在大约4.5亿年前发生分歧。测序并比较这两个基因组,发现它们共同的基因组序列有大约4.1Mb,但大肠杆菌O157:H7比大肠杆菌K12长了859000个碱基对。大肠杆菌O157:H7多出的序列,大部分是通过基因水平转移得到的。比较细菌的致病菌株与非致病菌株的基因组差异,有助于研究细菌的毒性因子。
本例对三株肠道大肠杆菌的全基因组序列进行比对,并分析致病菌株的可能致病因子。其中一株产志贺毒素的大肠杆菌O104:H4是导致2011年德国出现“肠出血性大肠杆菌”引
发的“溶血性尿毒综合征”疫情的病原菌株。
10.4.1 基因组数据
从 NCBI 的 genome 数据库下载 3 个 E. coli(E. coli K12、O157:H7、O104:H4) 的基因组 DNA 序列, 要求下载 GenBank 格式注释文件(.gbk)。
将这三个基因组数文件存放于一个目录,要求目录必须用英文名,不然Mauve不能正常读取文件,运行会报错。本章末二维码提供三个基因数据下载网址。
10.4.2 安装Mauve程序
可从Mauve官网下载并安装Mauve软件。
由于Mauve是由Java语言开发的软件,运行Mauve进行序列比对前,电脑必须先安装Java运行环境(JRE)。目前Java8是长期支持版本,为了避免可能不兼容问题,请安装此版本JAVA。
10.4.3 Mauve比对分析
(1) 启动 Mauve 程序, 从 Mauve 程序 “File” 菜单, 选择 “Align with progressiveMauve…”, 出现 “Align sequences” 窗口 (图 10-8);
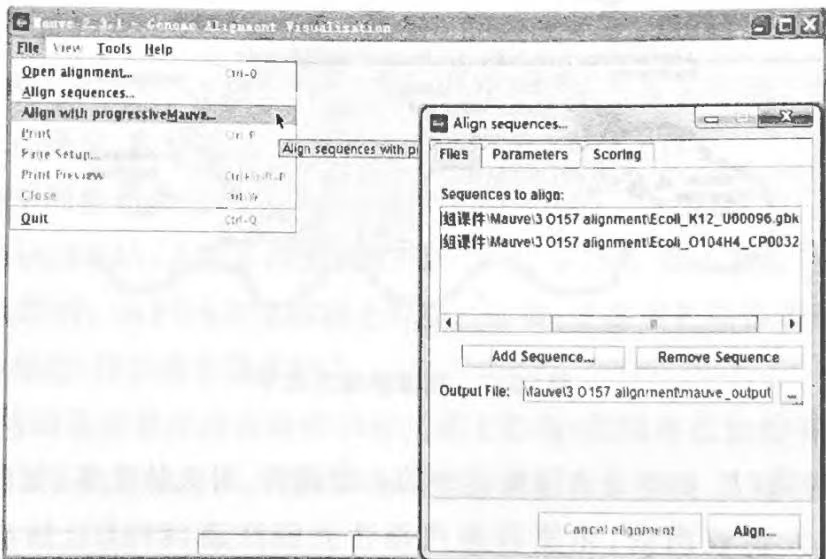
(2)再点击“Align sequences”窗口中间的按钮“Add Sequence…”,选择需要比对的基因组序列,导入序列用于比对。
重复上面步骤,添加其他需要比对的基因组序列,本实验分别添加3个大肠杆菌基因组(E. coli K12、O157:H7、O104:H4)。(注:通过按Shift键可以全部选中文件,一次导入。)
(3)最后还要指定比对输出结果文件的名称。点击“Output file”输入框右边的按键”…”,在跳出框中选择输出文件的存放文件夹,并输入一个文件名称(如 mauve_ecoli),后点“确定”
保存。
(4) 点击“Align…”按钮开始序列比对。这时程序出现一个控制台窗口“Mauve Console”,显示序列比对的过程,及程序的错误信息等。E. coli基因组的比对时间可能为20分钟左右,跟电脑的CPU性能有关。
如果程序报错,请检查下面内容:
- 输入的文件的格式是否正确,序列文件可以是FASTA格式或GenBank格式(含有基因注释信息)。
- 数据所在的文件夹是不是英文名称。因为软件 mauve 不能正确读取中文目录的内容。如果目录用了中文名,请先把目录改成英文,再选择已导入的数据,通过 remove sequence 按钮删除数据,后重新导入数据。
(5)当基因组比对结束,Mauve的可视化窗口将显示比对结果(图10-9)。结果图中彩色的区块代表与其它基因组有同源序列的区域,又称作 local colinear blocks(LCB)。末端红色竖线代表基因组(或contig)的边界。每一行的黑线代表一个菌株(菌名显示在每行的左下角),LCB可能在线条的上方或下方,代表正链或负链。每行前面的上下箭头可以上下调整基因组的排列位置。(注:为了简化图像,可以通过菜单View->Style->取消“LCB connecting lines”。)
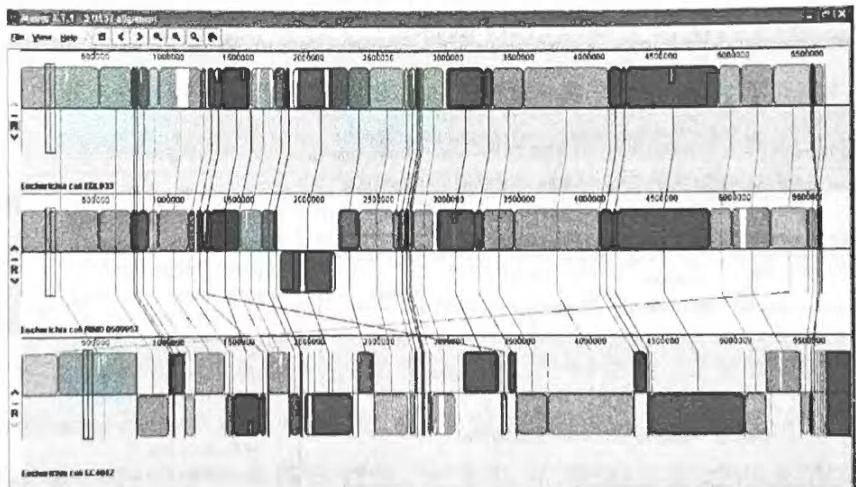
(6) Mauve 可以导出当前视图为图片: 选择菜单 Tools->Export->Export image…, 或使用快捷键 Ctrl+E, 并给要保存的文件指定一个名称。
(7)基因组比对结果的分析。基因组比对可视化结果中,白色区域代表这个序列为这个菌株中特有的序列,没有其他菌株同源的序列。通过分析这个白色区域的基因,可以确定菌株特有的基因。
首先点击 Home 图标回到基因组比对的原始视图。
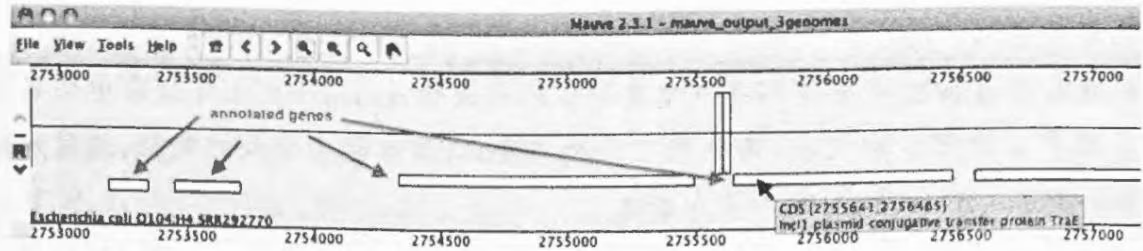
鼠标点击基因组中白色区域(没有彩色块 LCB),并双击对齐比对位置。通过工具栏中的前后箭头移动此区域到屏幕中央。后通过多次放大直到显示 LCB 下面的黑框(图 10-10),这些黑框代表预测的基因,即阅读框(ORFs)。
鼠标移动到某个 ORF 可以显示一个跳出窗口,并显示基因的信息。如图 10-10 显示此 ORF 为 IncI1 plasmid genes。利用此方法,你可以查看所有在 K12 基因组中存在,但不存在于其他菌的基因或区域。
- 现在把鼠标移动到一个 ORFs(如 iha:irgA homolog adhesion), 单击此 ORF, 并从跳出的窗口中选择 “View CDS iha …”, 就可以链接到 NCBI 网页查看这个基因的所有注释信息。通过查看这些注释说明, 判断这个基因跟毒性 (virulence) 有关。
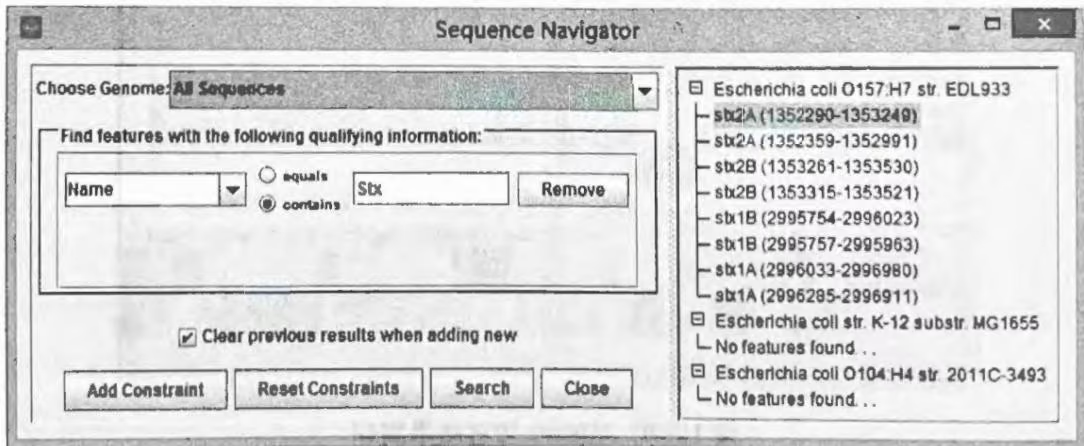
(8)寻找基因组特征。在窗口点击“home”返回,点击工具栏中的寻找基因组特征图标,在跳出的“Sequence Navigator”窗口填写要查找的基因的信息(比如名字Stx),然后点击“Search”。可以在结果中查看Stx基因是否存在于这三个基因组中,如图10-11所示,志贺样毒素(Shiga toxins)基因只存在于O157:H7菌株。
(9)查找只在部分菌株中存在的基因组区域。
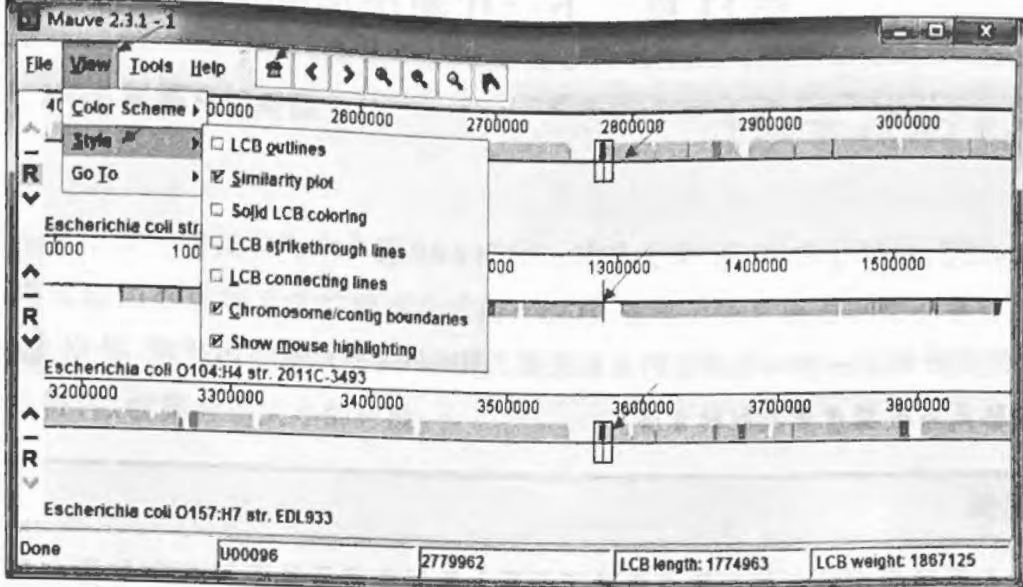
先按 “home” 按钮返回主界面,再通过菜单视图 (view) 选择 “Color Scheme” 为 “Backbone color”,而 Style 的设置如图 10-12 所示。
将模式从 LCB 切换为“Backbone color”后,不同的颜色代表只在其中两个基因组中保守的区域。从图 10-11 中可以看到 K-12 和 O157:H7 基因组存在显“红色”的区域(红色箭头
指向的黑框), 而 O104:H4 不存在此区域(红色箭头指向的一条竖线)。另外, 绿色代表只在 K-12 和 O104:H4 存在的基因组区域; 黄色代表只在 O104:H4 和 O157:H7 存在的基因组区域。
习题
全基因组鸟枪法测序中, 如果要使 H. influenzae 基因组的 99.75% 序列都被至少测序一次, 需要测多少核苷酸数据量?
由上面3个E. coli菌株基因组的Mauve比对结果,试回答以下问题:
(1) 利用三个基因组比较结果, 鉴定某个 E. coli 致病菌株独特的基因组区域 (island), 并简要描述处于这个基因组区域的基因产物 (要求显示分析区域的图片)。
(2) 同上, 鉴定两个病原 E. coli 菌株中共有, 在另一菌株中不存在的区域, 并简要描述处于这个基因组区域的基因产物 (要求显示分析区域的图片)。
(3)综上分析,你觉得哪些区域与病原菌株的致病性有关,或是可能的致病因子?
(4)选择一个可能是致病因子的序列,通过BLAST搜索此致病因子在其他细菌或古菌中的同源基因,并以表列出前5个最佳比对序列,含基因、物种名称及相似度(%)。
第11章 下一代测序基础
千里之行,始于足下。——老子
本章简要介绍下一代测序实验的基本流程及Illumina平台测序的原理,并以实例介绍了NGS数据格式与数据质量控制的方法。
◎导学案例
一个人类健康实验室的生物学家做了大量人群的高通量基因组测序与蛋白质组等组学试验。他把数据交给生物信息学家,并请他分析一下,能否找到能保证人健康一生的关键因素。生物信息学家用这些数据建立了各种数学模型,在做了大量计算工作后,终于得到了结论:若想健康一生,要具备两个关键因素:一是要有健康的父母;二是要死得早(find good parents, and die young)。
这个结论听起来很有道理,逻辑性也很强。所谓健康一生,就是一辈子不生病。那就需要有健康的父母保证有好的遗传开端,而早死就保证在任何疾病发生以前就结束生命。
然而,这个结论不用高通量测序和生物信息学分析,只要人们用常识思考也一样可以得到,所以花百万美金几年时间做实验,很可能得到一个没有什么价值的结论。
这个笑话提醒我们在大数据时代也需要有假设驱动的科学研究(hypothesis-driven research)。因为一般认为基因组大数据研究是数据驱动(data-driven)的研究,可以不用预先提出假说,先做实验,然后让数据来提假说。可是,如果预先不想好问什么问题,设计好实验,最后实验和分析只能得到很荒唐的结果。
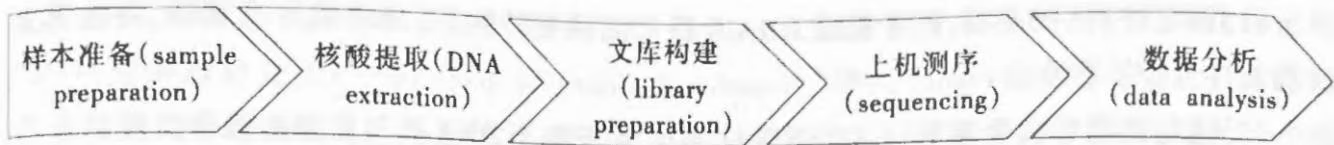
下一代测序(next generation sequencing, NGS),又名高通量测序(high-throughput sequencing, HTS),是相对于传统的桑格测序(Sanger sequencing)而言的DNA测序方法。高通量测序技术提高了测序通量(产出数据量)与测序速度,使得测序的费用与时间大幅降低,不仅为我们提供了丰富的遗传学信息,而且为个性化医疗的临床诊断打开了新的窗口。基因组DNA或转录本RNA进行NGS测序一般需要多个步骤,包括样品准备、核酸提取、文库制备、上机测序及后续数据分析等(图11-1)。下面重点介绍Illumina测序平台中的几个重要步骤。
11.1 NGS测序文库制备
下一代测序首先要提取样本中的DNA或RNA构建文库(图11-2)。DNA或RNA一般要先可用超声或酶切处理等方法打碎成小片段。注意,这些方法可能随机性不够好,如DNA末端(C碱基)处容易断裂。破碎后一般要进行片段大小选择(size selection),通过割胶回收特定长度条带,以收集合适大小的片段。
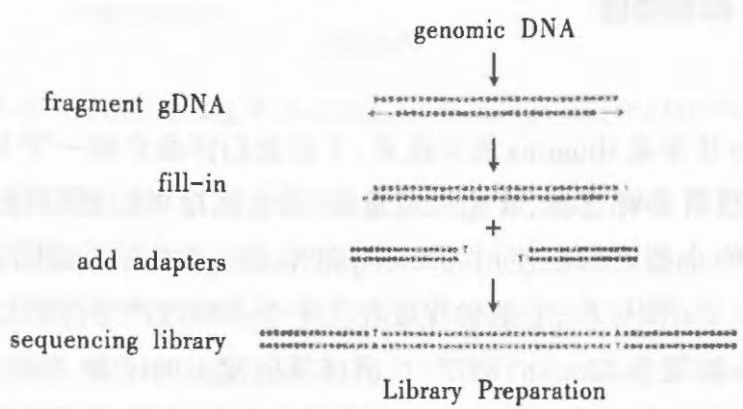
文库构建的一个关键步骤是在DNA片段的两端加接头(adapter)。如果样本是RNA还需要先反转录成cDNA再加接头。双链DNA随机打断片段末端可能不平整,需要先用klenow酶补平,再通过腺苷化在双链DNA两个3’端产生3’-dA尾,防止DNA片段自连接。然后与含有5’-dT的接头连接。接头序列由多种不同元件组成(图11-3),主要的作用如下。
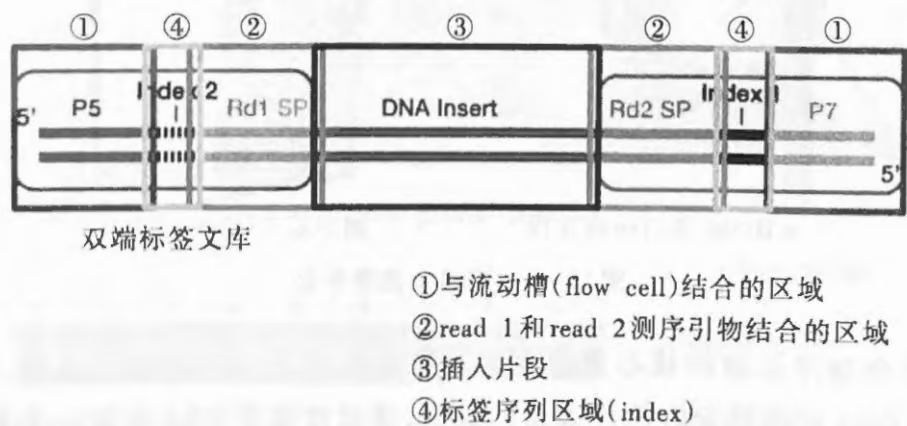
(1)锚定序列(P5/P7),用于锚定DNA片段到固体支持物上,如玻璃片或磁珠,并在其上进行测序反应。
(2)通用的测序引物序列(Rd1 SP/Rd2 SP),用于每个DNA插入片段的测序反应。
(3)标签序列(Index1/Index2),用于混合多个样本一起测序时作为区分标签(barcode)。
虽然不同的测序平台都有自己特殊的接头序列,但它们的作用相似。测序接头连接后,DNA模板可以通过接头上的PCR引物进行PCR扩增富集DNA模板量,而有些平台不需要PCR扩增富集就可以测序。
DNA 片段可以只测定一端的序列,称为单端测序(single end sequencing, SE),或从 DNA 片段两端进行测序,称两端测序(paired-end sequencing, PE)。两端测序可以使测序长度增加一倍。用于测序的 DNA 片段的大小是选择过的(经过割胶回收特定大小条带),因此两端测序序列间的距离是已知的,使后续数据分析,如比对与组装,更加可靠。
11.2 Illumina测序原理
目前常用的NGS技术是Illumina测序技术,下面我们详细介绍一下Illumina测序的基本原理。Illumina测序仪有多种选择,有超大通量的、适合测序中心使用的HiSeq2500与HiSeq X-Ten等,也有适合中小型实验室使用的MiSeq和NextSeq500等。如图11-4左边所示是一台最新的Illumina X Ten测序仪,它能够保证在几十个小时内产生几百G甚至上T的测序数据。测序芯片(flowcell)是指Illumina测序时,测序反应发生的位置,每一个flowcell上都有8条泳道,用于测序反应,可以添加试剂、洗脱等。如图11-4右边是测序芯片,图中黑色的小线条就是泳道,每一个泳道中整齐排列了无数个小区块(tile),tile是每一次测序荧光扫描的最小单位,但我们肉眼看不到。
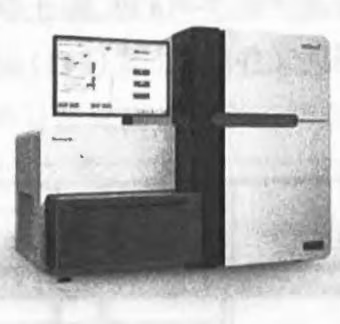
HiSeq X-Ten测序仪
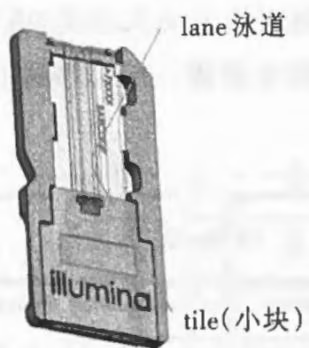
测序芯片(Flowcell)
图11-4 Illumina测序平台
Illumina平台测序原理的核心是边合成边测序(sequencing-by-synthesis, SBS),就是将打碎后建库的DNA片段锚定在测序通道内表面,通过对锚定DNA每加一个碱基进行一次“加上荧光染料—洗脱多余染料—荧光成像扫描”的循环过程,实现平行高通量的深度测序。
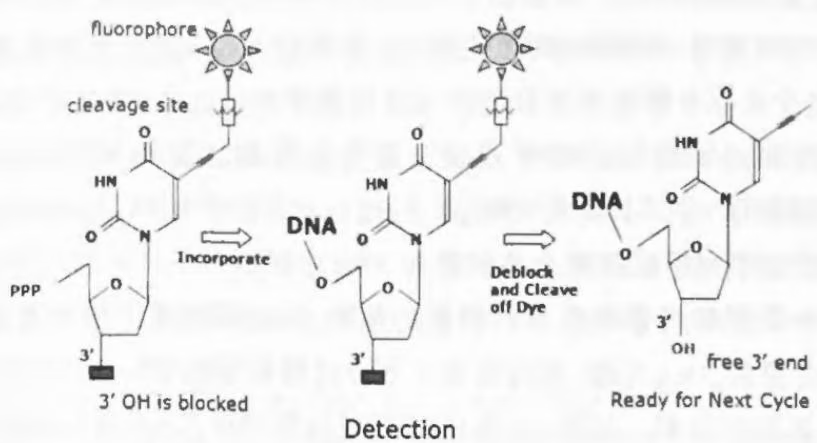
这个技术又称为可逆屏蔽终止子测序技术(图11-5),每个测序循环引入一个荧光标记的“3’-可逆屏蔽终止子(3’-blocked reversible terminator)”替代Sanger法测序的ddNTPs,其特点是羟基(3—OH)被保护碱基封闭,碱基上连接荧光基团。对于每个测序循环,延长一个碱基,加入一个可逆终止子,荧光成像后,再去除3—OH保护基团,切去碱基上的荧光基团,进入下一个测序循环。
Illumina测序的具体过程(图11-6)主要是先将片段化的DNA两侧连上接头(adapter),建立测序文库。随后将测序文库在芯片(flow cell)上扩增成簇(cluster),与固定在芯片泳道玻片壁上的寡核苷酸特异性互补结合,进行桥式(bridge)PCR,得到成百上千条相同的DNA簇。测序文库的成簇过程将放大测序荧光信号,使测序仪的光学成像系统清楚地捕捉并记录每一步合成反应的信号,从而得到高质量的序列数据。再加入4种不同荧光标记的终止型dNTP,在DNA聚合酶的催化作用下,从测序引物结合部位开始合成与测序模板互补的新DNA链。同时,由于用于测序反应的特殊核苷酸在3’端的羟基位置被化学基团屏蔽,每渗入一个此 dNTP 反应即终止。一次反应结束后,洗去未参加的 dNTP,每一个簇被激发后产生不同的激发荧光,由测序仪的光学系统拍摄成为图像并记录下来,得到一个位点的碱基序列。前一个测序循环结束后,dNTP 3’端的屏蔽基团被酶切除,3’端的羟基又被活化后,即可进入下一轮测序,如此循环 100 次左右,就完成了每个簇上 DNA 模板的 100bp 的单端测序。一个簇的图像数据就是一个 DNA 测序读长序列。单端测序常用的表示方式如“SE100”,表示单端测序,序列长度为 100bp。
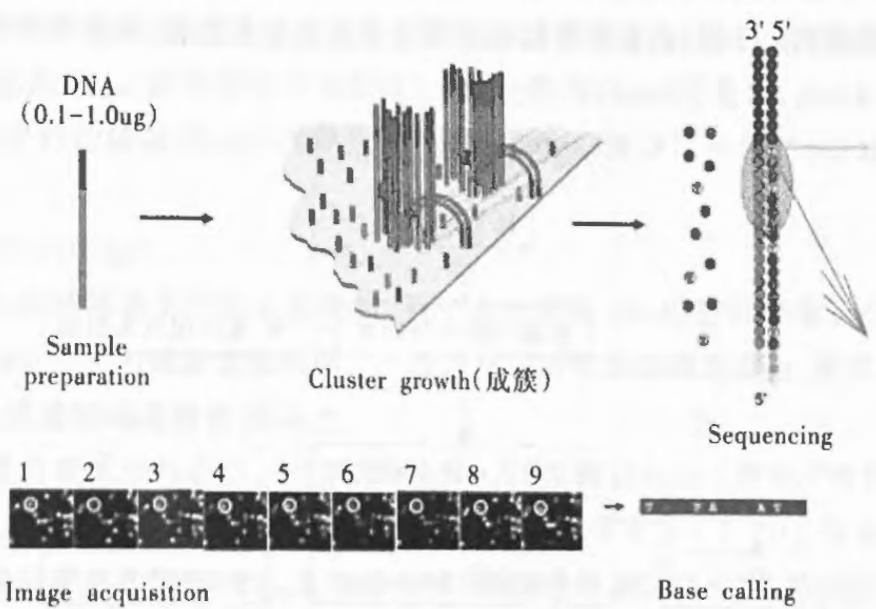
如果要进行双端测序,在单向测序完成后,系统输入缓冲液,洗掉测序过程中合成的DNA链,然后系统合成原有模板的互补链作为反向测序的模板链,以与正向测序同样的方式进行反向测序,得到的就是与正向序列成对的反向序列。双端测序常用的表示方式如“PE150”,表示双端测序,序列长度为 $150\mathrm{bp}$ 。同时对上百万个DNA簇进行边合成边测序,最后用计算机软件进行序列拼接得到全基因组的DNA序列。
各种测序平台数据的可靠性受多种因素的影响,如文库构建中的PCR富集过程不大能扩增高GC或AT含量的DNA片段,而边合成边测序过程所用的DNA聚合酶也同样不能合成高GC/AT含量的基因组序列。这种GC偏好的差异对那些极高GC/AT含量的生物(>70%)的测序更加明显。测序过程的一些其他因素都会引起数据偏差,如设备操作、图像分析、碱基读出等。
11.3 NGS数据的质量控制
一般NGS数据分析可以分为三个步骤:第一步是从测序过程产生的光或物理化学信号读取碱基(base calling),一般把碱基读取结果存放在标准的FASTQ文件;第二步是把读出的读长(read)进行质控与预处理;第三步是针对不同NGS应用的特定分析流程,如基因组组装、RNA-Seq等。而NGS分析的前两个步骤主要涉及NGS数据的质量控制,是各种NGS应用分析的共同步骤(图11-7)。本章节先介绍这两个基本分析过程,后续章节将分别讨论具体的应用。
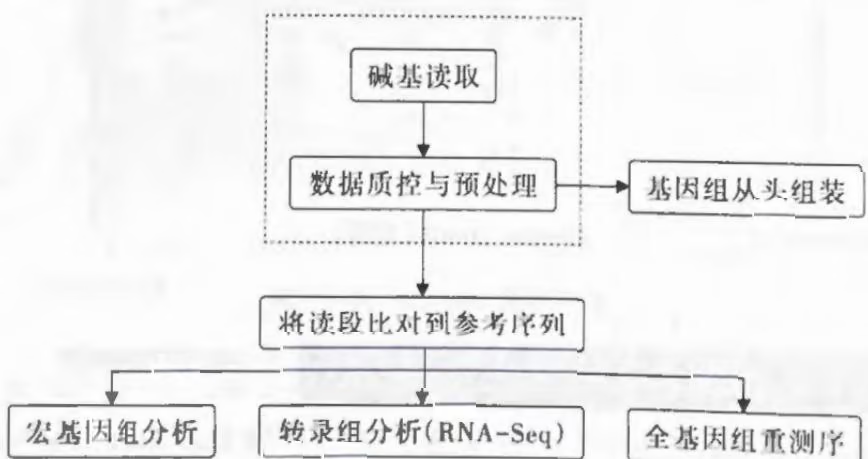
11.3.1 碱基读取与FASTQ文件
第一阶段碱基读取是从测序的荧光图像、电流或物理化学度量中提取碱基信息,一般测序平台都有自己专门的算法,如Illumina公司用其专利算法Bustard做碱基读出。碱基读出软件的执行需要多个步骤,最终产生每个测序循环的一个碱基及其对应的可信度分数。为计算碱基可信度分数,Illumina测序技术会使用控制通道(control lane)或spike control来产生一个碱基读出分数校正表。终端用户可以不用考虑碱基读出过程,而只用关注碱基读出结果的分析。
不管什么测序平台,碱基读取结果都要存储在一种 FASTQ 格式文件,文件后缀一般为 “.fastq” 或 “.fq”。Illumina 测序仪采用 bcl2fastq 软件(原名为 CASAVA)进行图像数字信息转换,产出 FASTQ 格式数据。FASTQ 格式是一种基于文本的格式,包含每个 reads 的序列及每个碱基对应的质量分数 (quality score)。图 11-8 是一个 FASTQ 的例子。
@HISEQ2000:404:C73LWACXX:2:1101:1487:1876 1:N:0:CGATGT
#4=DB?:DF?ADCFFGD>BHCEB9F3AAACEFHC>@BBFFFGD@??BF??D9B?FGDFFGDGGB@;AE>ED25;)..;;=;
图11-8 FASTQ格式
FASTQ格式中每个测序读长为4行,分别为:
- @序列 ID, 包含一个绝对名字、样本所在的 Lane、Cluster 坐标位置、Index 序列及 Read1 或 Read2 标志等信息; 其中 1:N:0:CGATGT 表示该条序列为 R1 端序列, N 表示序列没有经过 CASVA 过滤 (反之为 Y), CGATGT 为 Index 序列。
- 碱基序列,由大写字母“ACGTN”组成,N为不能识别碱基;
- +序列 ID, 与第一行@序列 ID 相同(可省略);
- 序列每个碱基的质量分数,由字符的 ASC II 编码表示。
质量分数(Q-score)是衡量碱基读取可能出错概率的指标,用于衡量核苷酸序列的可靠性。它最初是在Phred软件中定义与使用,因此也称为Phred质量值(phred quality score)。Illumina测序平台的碱基读出的质量分数与原先Sanger测序仪中的Phred分数的计算方式相似:
Illumina Q = -10 \times \lg P
其中 P 是在碱基读出中的出错概率, 基于这个方程, 1% 出错概率等于 Q-score 是 20, 而 Q30 代表 1/1000 概率的碱基读出出错。一般为保证有可靠的碱基读出, 要求 Q-score 至少要达到 20, 而高质量的碱基要在 30 以上。
由于质量值要两位数表示,不能与碱基一一对应,所以Sanger研究所将每个碱基对应的Q-score采用ASC II字符来编码,可与序列放在一起,从而开发了FASTQ格式。如图11-8中的第一个T碱基对应的编码是B,对应Q-score分值是33,而第一个N为不能判读碱基,质量值编码是#,对应Q-score分值2(非常低)。虽然历史上不同测序平台有许多不同的编码版本,如 Sanger 测序平台使用 Phred+33(33 代表 ASC II 码起始为 33) 质量值,而 Illumina 平台使用 Phred+64(e.g. Illumina 1.0, 1.3, 1.5),但最新平台(Illumina 1.8+)最终还是采用 Sanger 测序的编码方式,使用 Phred+33 质量值,取值范围为 0~41,对应 ASC II 码为 33~74。
虽然 NGS 也用其他的一些文件格式, 如 FASTA, SFF 和 QUAL 等, 但 FASTQ 已经是 NGS 数据存储的事实标准, 其他各种格式都可以通过一些软件转换成 FASTQ。一般压缩后的 FASTQ 文件的大小也会在 1G 左右, 可能含有 1 亿以上的读段。
11.3.2 数据质量检查
数据的质量检查是NGS分析的必需步骤,可以避免产生不可靠或错误的结果。
下面介绍几个判断质量好坏的常用标准(metrics):
(1) 碱基质量值 (Q-score)
碱基质量检查可以逐个位置检查读段上所有碱基的分数,一般边合成边测序平台的趋势是前面测序位置的碱基比后面测序位置的Q-score要高,末尾质量会降到20左右,如后期(later phase)的碱基质量的中位数值小于20,需要被切除再用于后续分析。一个成功的测序反应其产生的reads的碱基质量Q-score应该基本在30以上。
(2)碱基N的百分比
当测序仪碱基读取算法没法可靠地确定为任何一个碱基时就标为N。
(3)读段长度分布
有些测序平台,如 PacBio,产生不等长的读段,一般读段越长越好,有利于后期的比对与组装。
(4)每个位置上的碱基组成比例(percentage of each base across base positions)
由于测序文库是通过随机 DNA 打断来制备的, 测序后每个位置上四个碱基出现的概率应该是固定的。如果出现 AT 或 GC 严重偏离平行, 说明文库构建过程有问题, 如 rRNA 没有去干净, 或非随机 DNA 打断等。
其他质量指标,有人工序列(接头与PCR引物)或重复序列等。质量检查后,需要过滤低质量的读段,或切除低质量的碱基(Q-score低于20)及人工序列污染。
11.4 测序数据质控分析实践
拿到二代测序的原始数据之后,第一步要做的就是查看原始数据的质量。本练习分析所用数据是对一个细菌进行双端测序的结果。
11.4.1 FastQC分析数据
FastQC是目前最常用的NGS数据质量评估软件,可用于统计质量分数、GC含量、测序长度等信息。FastQC是一款Java语言编写的程序,具有友好的用户界面(图11-9),可在Windows、
Linux、MacOS系统上运行。FastQC支持的输入数据格式包括FASTQ(或压缩的fastq.gz)、SAM、BAM等,输出的结果报告包括图片和表格,并以HTML格式呈现。
(1) FastQC 安装
FastQC 是一个免安装软件, 解压后即可直接运行。
但 FastQC 运行依赖 JAVA 运行环境(JRE),要求系统已经安装合适的 JRE 版本(v1.6 以上)。JRE 安装方法扫描章末二维码阅读相关内容。
(2)FastQC使用
在 Windows 系统下运行比较方便, 双击 FastQC 目录下的 “run_fastqc.bat”, 打开 FastQC 界面, 在菜单栏选 File->Open, 打开测序数据的 FASTQ 格式文件, 则开始自动运行 (图 11-9)。
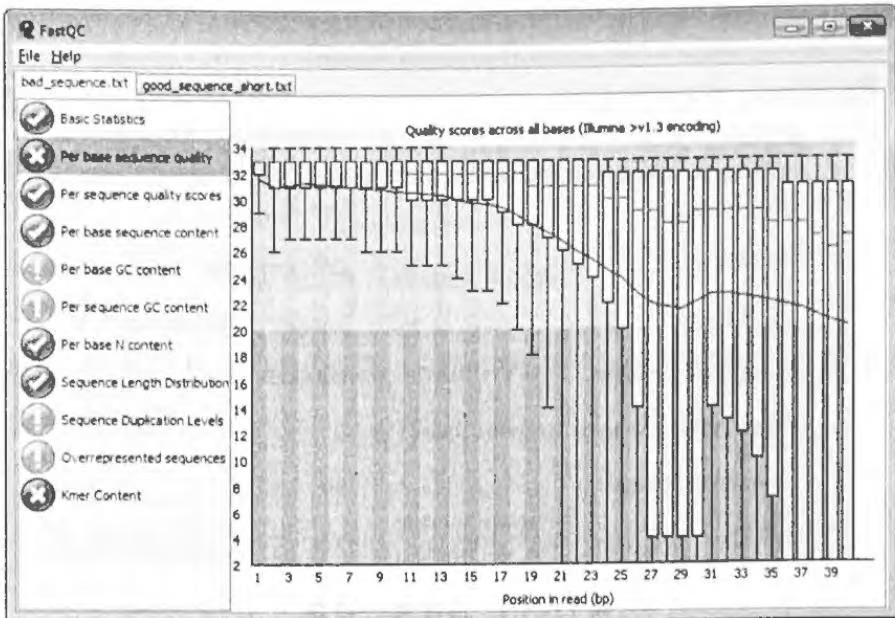
另一种是在 Linux 系统的命令行模式,需要输入相关参数,会自动生成 HTML 格式的结果报告。此种方式可一次分析多个 FASTQ 文件。
1 | \$fastqc [-o output dir] [--(no)extract] [-f fastq|bam|sam] [-c contaminant file] [-t threads] seqfile1 .. seqfileN |
这里面比较重要的选项介绍如下:
-o 用来指定输出文件的目录, fastqc 是不能新建目录的, 需要先建立一个输出目录。输出的结果是压缩文件, 默认自动解压缩, 如果加上–(no)extract 参数则不解压缩。
-f 用来指定输入文件格式, 支持多种格式, 默认会自动检测。
-c用来指定一个contaminant文件,fastqe会把overrepresented sequences去这个contaminant文件里搜索。contaminant文件的格式是“Name\tSequences”,#开头的第一行是注释。
-t 用来指定同时处理的进程个数。
程序运行完成之后会生成网页文件,如果输入的FASTQ文件名是target.fq,fastqc的输出的压缩文件将是target.fq_fastqc.zip。解压后,查看HTML格式文件的结果报告。
(3)FastQC结果解读
FastQC 结果报告基本内容有 11 个方面, 包括基本统计, 碱基含量分布统计, 质量分布统计, GC 含量, N 碱基, 插入片长度分布, adapter 接头情况, kmer 频率分布情况等。其中绿色表示通过 (PASS), 黄色表示警告 (WARN), 红色表示有问题 (FAIL)。
下面我们分别看一下各部分结果,以及 FastQC 判断各部分结果通过、警告和不合格的阈值。我们应关注结果中未通过的部分,仔细思考为什么我们的数据会得到这样的结果,可能存在哪些问题。
①Basic Statistics(基础统计信息)。Basic Statistics 的结果给出原始数据的基本信息(图 11-10),包括被分析文件的文件名、文件类型、质量值编码方式(encoding)、序列总数、标记为低质量的序列数、序列长度和 GC 含量。
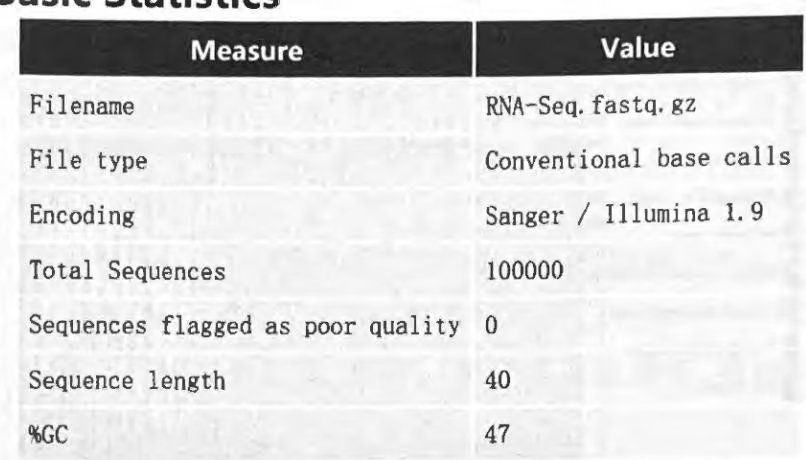
这部分结果提供了碱基质量值(Phred值)的编码方式。现在Illumina测序数据(1.9+)采用ASCⅡ值33—93编码Phred值0—60,即Phred+33;而老的Illumina系统(1.3,1.5)采用Phred+64(ASCⅡ码64—126)。如果分析较早的Illumina平台测序数据,注意需要用Phred+64编码值。
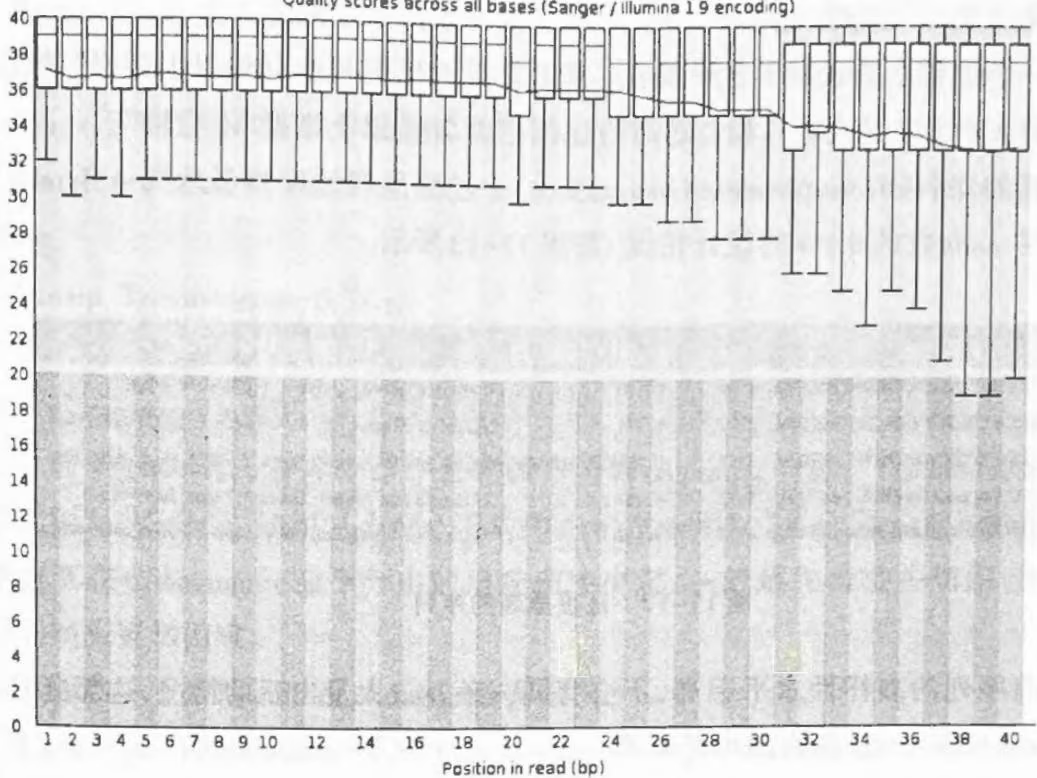
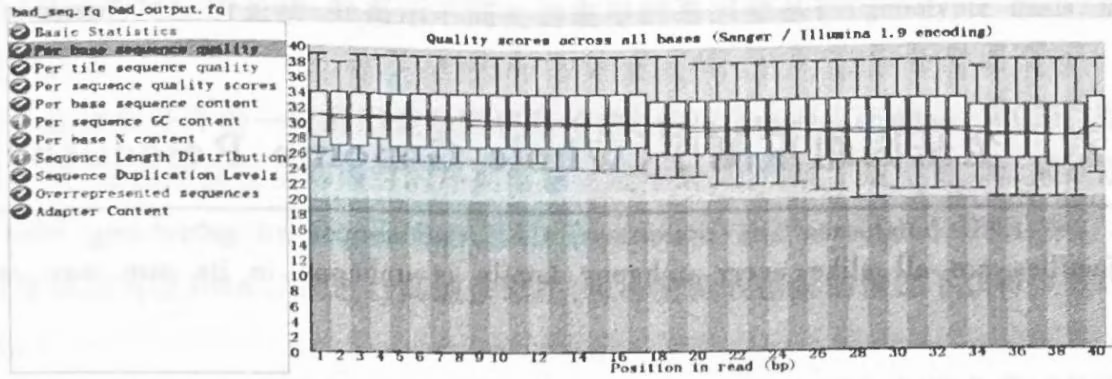
②平均碱基质量(per base sequence quality)。Per base sequence quality 显示序列每一个位置上(x轴)所有碱基的质量值范围(y轴),如图11-11所示。
图中每一位置都有一个盒状图:黄色箱子表示25%~75%的范围,即IQR(inter-quartile range),下面和上面的触须分别表示10%和90%的点。蓝线表示均值,红线表示中位数;碱基的质量值越高越好,背景颜色将图分成三部分:碱基质量很好(绿色)、碱基质量一般(黄色)以及碱基质量差(红色)。
碱基质量值随着读段的位置的增大而降低是正常现象,且通常 Paired-end 测序的反向读段的质量要比正向的差。任何一个位置的下四分位数小于 10 或者中位数小于 25,会显示“警告”;任何一个位置的下四分位数小于 5 或者中位数小于 20,会显示“不合格”。
彩图
③平均碱基组成(per base sequence content)。平均碱基组成显示每个位置上的碱基组成比例,如图11-12所示。
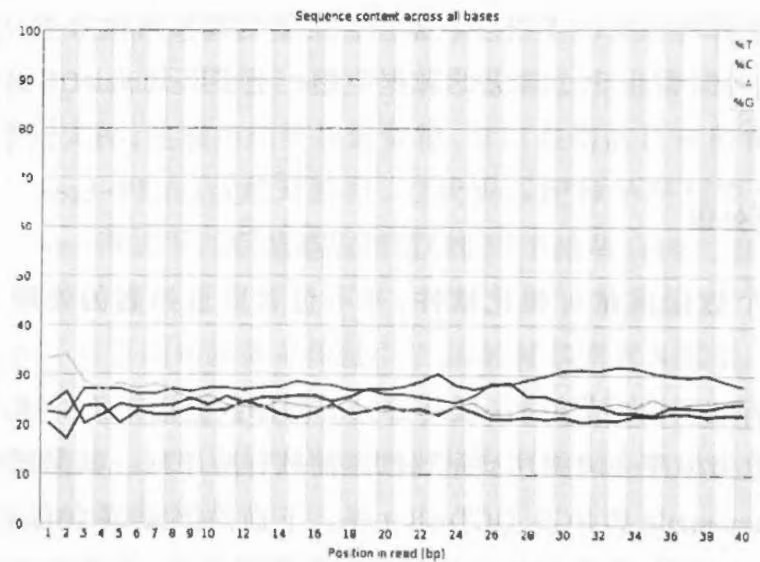
图11-12中横轴为碱基位置,纵轴为碱基组成比例。一个完全随机的文库内每个位置上4种碱基的比例应该大致相同,因此图中的四条线应该相互平行且接近;在序列开头出现碱基组成偏倚往往是建库过程造成的,比如建库时在序列开头加特异性的条码(barcode),而barcode的碱基组成不是均一的;又如酶切位点的碱基组成是固定不变的,这样会造成明显的碱基组成偏离。
在序列结尾出现的碱基组成偏离,往往是测序接头的污染造成的。
如果任何一个位置上的 A 和 T 之间或者 G 和 C 之间的比例相差 10% 以上则报“警告”,任何一个位置上的 A 和 T 之间或者 G 和 C 之间的比例相差 20% 以上则报“不合格”。
④过度呈现的序列(overrepresented sequences)。过度呈现的序列显示同一条read出现次数超过总测序reads数的0.1%的统计情况,如图11-13所示。
| Sequence | Count | Percentage | Possible Source |
|---|---|---|---|
| GATCGGAAGAGCACACGTCTGAACTCCAGTCACATCACGA | 6276 | 6.276 | TruSeq Adapter, Index 1 (100% over 40bp) |
| AATGATACGGCGACCACCGAGATCTACACTCTTTTCCCTAC | 6274 | 6.274 | Illumina Single End PCR Primer 1 (100% over 40bp) |
| CAAGCAGAAGACGGCATACGAGATCGTGATGTGACTGGAG | 6252 | 6.252000000000001 | Illumina PCR Primer Index 1 (100% over 40bp) |
| CAAGCAGAAGACGGCATACGAGATACATCGGTGACTGGAG | 6192 | 6.192 | Illumina PCR Primer Index 2 (100% over 40bp) |
| GATCGGAAGAGCGGTTCAGCAGGAATGCCGAGACCGATCT | 6142 | 6.142 | Illumina Paired End PCR Primer 2 (100% over 40bp) |
图11-13 过度呈现的序列
正常文库内序列的多样性水平很高,不会有同一条read大量出现的情况,这部分结果会把大量出现的reads列出来,并给出可能来源。
运行 FastQC 的时候可以用 -c 来指定一个文件, 这个文件里面存放可能存在的污染序列, FastQC 会在这个文件里面搜索 reads 中的 overrepresented sequences; 如果不提供这个文件, 软件会从自己的数据库中搜索并给出可能的“污染源”。
如果有任何 read 出现的比例超过总 reads 数的 0.1% 则报“警告”,超过总 reads 数的 1% 则报“不合格”。
FastQC软件官方网站也给出了很多数据质控的案例模板可供参考,包括质量好的数据与质量差的数据,这些案例包含了常见的数据类型。更多其他FastQC结果,请扫描章末二维码阅读相关内容。
11.4.2 数据预处理
FastQC 只是一个数据质量可视化软件,并不包含质量控制的处理功能,即不会改变 reads 序列本身。
为保证后续分析结果的可靠性,一般还要先对测序数据进行预处理。测序数据预处理主要以测序质量分数为标准去除测序质量比较差的核苷酸序列。数据预处理软件常用的有FASTX_Toolkit, Trimmomatic 和 NGS QCToolkit 等。下面简要介绍 Trimmomatic 用于过滤与切除低质量序列、接头序列,不需要的污染物序列等数据处理,更多内容请扫描本章后面二维码阅读相关文章。
(1) Trimmomatic 软件安装
Trimmomatic 是一个专门用于 Illumina 高通量测序数据处理的序列剪切工具。它既能用于 paired-end(PE) 测序数据,也能用于 single-end(SE) 测序数据。它处理 PE 测序数据后得到的处理后的数据还是配对的双末端形式,方便后续分析。Trimmomatic 是 Java 语言开发的程序,其运行效率比较高,可以多线程运行,在处理大规模测序数据时会比较快。
Trimmomatic 是免安装软件, 只要下载其 binary 文件, 解压缩后可以直接在 Linux 环境中运行。
Linux下可以用以下命令安装:
$wget http://www.usadellab.org/cms/uploads/supplementary/Trimmomatic/Trimmomatic-0.38.zip
$unzip Trimmomatic-0.38.zip
要运行 trimmomatic-0.38.jar, 需要电脑系统已经安装 JAVA 运行环境 (JRE)。
(2) Trimmomatic 使用
目前 Trimmomatic 有多个命令来完成不同的 trimming 功能。Trimmomatic 的处理命令与参数间用“:”来分隔,如同一个命令下有多个参数也用“:”来分隔。不同的处理命令的执行顺序由其在 trimmomatic 命令行中的出现顺序决定,一般最先做接头切除,因为使用部分匹配识别接头更加困难。
下面举一个处理 paired-end(PE) 数据的例子:
$java -jar Trimmomatic-0.38/trimmomatic-0.38.jar PE input_forward.fq input_reverse.fq output_forward_paired. fq output_forward_unpaired. fq output_reverse_paired. fq output_reverse_unpaired. fq ILLUMINACLIP: Trimmomatic-0.38 / adapters / TruSeq3-PE. fa: 2: 30: 10 LEADING:20 TRAILING:20 SLIDINGWINDOW:4:20 MINLEN:36
参数说明:
数据过滤规则:
- ILLUMINACLIP:TruSeq3-PE.fa:2:30:10 设定接头(adapter)文件,TruSeq3-PE.fa为由Trimmomatic提供的Illumina用的接头文件(在其安装目录“adapters”内),也可以改用其他用户使用的接头序列文件;注意必须要指定路径,可以是当前目录的相对路径(Trimmomatic-0.38/adapters/TruSeq3-PE.fa)或绝对路径。2代表匹配种子序列中允许的最大mismatch数;30代表在palindrome模式下匹配碱基数阈值(约50个碱基);10代表在simple模式下的匹配碱基数阈值(约17个碱基)。
- LEADING:20 从首端切除碱基质量小于20的碱基或者N碱基。
- TRAILING:20 从末端切除碱基质量小于20的碱基或者N碱基。
- SLIDINGWINDOW:4:20 从序列的5’端开始,以4个碱基为滑动窗口,将平均碱基质量小于20的窗口以后的碱基丢掉。
- MINLEN:36 保留 reads 长度最低为 36bp。
Trimmomatic 的输入/输出文件:
两个输入文件,分别为PE数据的forward reads的FASTQ文件(input_forward.fq)与reverse reads的FASTQ文件(input_reverse.fq);也可用FASTQ格式文件压缩后的fastq.gz。
Trimmomatic 运行后有四个输出文件:
①output_forward_paired.fq
②output_forward_unpaired.fq
1 | ③output_reverse_paired.fq |
1 | ④output_reverse_unpaired.fq |
其中两个是 PE 测序配对序列在处理后都保留下来的“paired”序列(output_forward_paired.fq 与 output_reverse_paired.fq),可直接用于后续 mapping 等分析;另两个是 PE 数据中配对 reads 的一个 read 被去除的“unpaired”序列,也可把它当作 single-ended 测序数据用于后续分析。
如要处理 single-ended(SE) 数据, 只要一个输入 FASTQ 文件和一个输出 FASTQ 文件, 其他参数同上。下面以前面 FastQC 查看的数据 bad_seq.fq 来进行预处理:
1 | \$gunzip bad_seq.fq.gz |
$java -jar Trimmomatic-0.38/trimmomatic-0.38.jar SE bad_seq.fq bad_output.fq ILLU-MINACLIP:testAdapter.txt:2:30:10 LEADING:20 TRAILING:20 SLIDINGWINDOW:4:15 MINLEN:30
这里 testAdapter.txt 是含有 Overrepresented sequences 序列的 FASTA 格式文件, 可能通过 fastqc 结果的 “Overrepresented sequences” 中复制得到 (先选中第一个序列, 按住 Shift 键, 再选中最后一个序列可全部复制)。而且 textAdapter.txt 要放在运行 java 的当前目录。
运行过程的输出如图 11-14 所示。
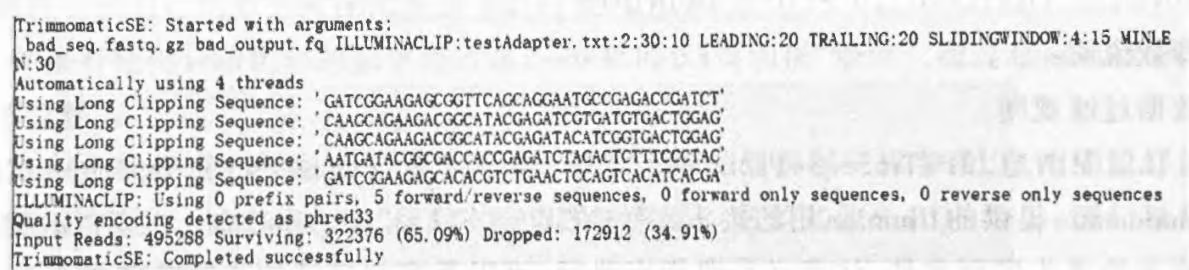
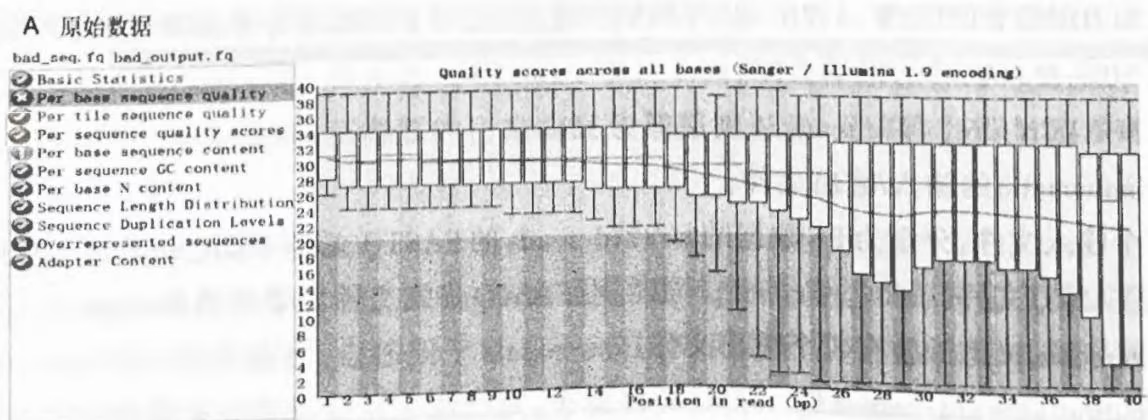
最后得到 bad_output.fq 包含已经过滤低质量及过多呈现的序列。可以通过 FastQC 查看,比较 bad_seq.fq 与 bad_output.fa 两个文件的不同。结果如图 11-15 所示,数据处理后,已经没有质量值低于 20 的数据及过多呈现的序列。
习题
- 详细描述 Illumina 测序的原理。
- 下载本章所用测序数据, 练习用 FastQC 软件分析测序 reads 的碱基质量及其他质量指标, 并用 Trimmomatic 处理。
第 12 章 全基因组重测序(Whole Genome Resequencing)
Happy families are all alike; every unhappy family is unhappy in its own way. —Leo Tolstoy
遗传变异广泛存在于生物体内,而下一代测序技术有助于精准的基因变异检测。本章主要介绍了基因变异的检测流程,重点介绍短序列比对、变异识别的算法,并以实例介绍遗传变异检测的分析方法。
◎导学案例
2013年5月,著名影星安吉丽娜·朱莉(Angelina Julie)在《纽约时报》(New York Times)上发表“My Medical Choice”一文,宣称自己已接受了预防性乳腺切除手术。《时代》杂志以封面故事报道了Julie事件。朱莉在两年后又接受了切除卵巢手术。朱莉的家族史显示:外祖母因癌症去世,姨妈因乳腺癌去世,母亲因卵巢癌去世。而基因检测显示朱莉自身携带有BRCA1基因的致病突变位点,可能有87%乳腺癌患病风险,50%的卵巢癌患病风险,而切除手术可使其乳腺癌与卵巢癌风险降低至5%以下。
BRCA1 是“breast cancer 1, early onset(乳腺癌1号基因)”的缩写。BRCA1 及 BRCA2 是最重要的两个乳腺肿瘤抑制基因,决定了绝大多数遗传性乳腺癌。它们的功能与一种对 DNA 双链断裂的修复十分重要的蛋白质 RAD51 有关。BRCA1 或 BRCA2 上的基因突变会阻碍 RAD51 的修复功能,导致更多的 DNA 修复错误,突变率的增加最终导致更大的肿瘤风险。BRCA1 及 BRCA2 基因检测对乳腺癌发病风险的预测较为准确,是个体化医疗的经典范例。
由于下一代测序技术的通量高、成本低,被普遍应用于检测一个种群中各个体的遗传变异。人类基因组中存在多种序列变异,如单核苷酸变异(single nucleotide variants, SNVs),插入缺失(insert/deletes, InDels)和结构变异(structural variants, SVs)等。最常见的变异是单个核苷酸变异,从种群概念上讲,一般把那些在种群中发生频率大于 $1%$ 的SNVs称为单核苷酸多态性(single nucleotide polymorphism, SNP)。目前国际上已有多个基因组变异研究项目,如千人基因组计划(1000 Genomes Project),致力于鉴定基因组变异,寻找与人类疾病(如癌症、糖尿病和肥胖症)关联的基因变异。目前研究基因组变异位点与疾病易感(predisposition)或药物反应的关联,并揭示不同生物表型的基因型基础(genotypic basis)是生物医药研究的热点。
基因组重测序方法一般利用全基因组鸟枪法(whole genome shotgun, WGS)对基因组进行随机打断,后测序获得全基因组的序列信息。近年来,还出现了成本更加低廉的重测序方法,如GBS (genotyping by sequencing)、RAD (restriction-site associated DNA)等方法,对特定酶切后的基因组DNA片段进行高通量测序,可在更低数据量的情况下获得全基因组的变异信息。
通过NGS数据检测遗传变异不是一件容易的事,主要挑战是如何区分真正的序列变异与假阳性。假阳性可能是由测序中PCR扩增、碱基读取、序列比对等过程产生的假象(artifacts)。因此,高质量的测序数据与特殊的变异判读(variant calling)算法是能精确检测基因组变异的基础。基因组重测序鉴定变异的一般工作流程如图12-1所示。
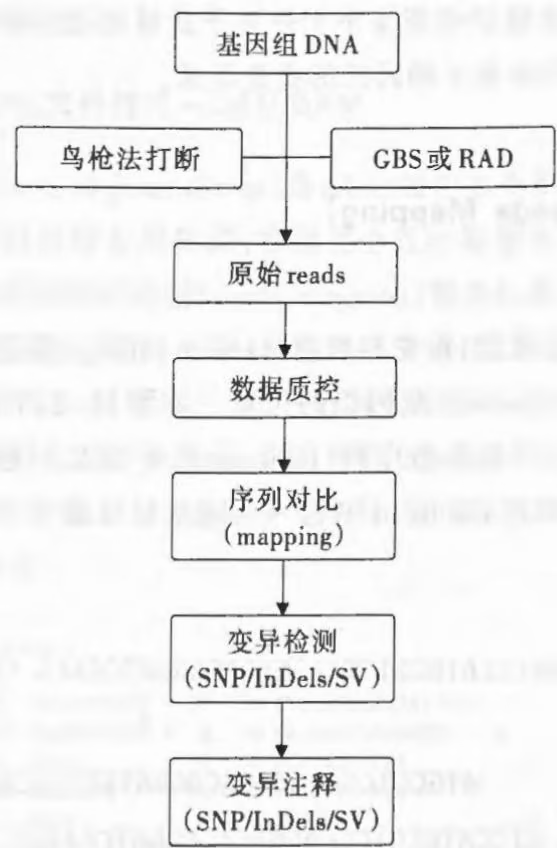
基因重测序分析开始于测序仪产生的测序数据。测序仪输出的数据通常存于FASTQ文件,包含数百万个DNA片段的原始reads,又称为原始数据(raw data)。
首先,要对测序数据进行质量控制,应用预处理软件来消除接头序列、不需要的污染物序列和低质量碱基等。常用NGS质控工具有FastQC,Trimmomatic和NGS QC Toolkit等。
再将测序 reads 比对到参考序列, 可使用比对工具(如 BWA, Bowtie2 和 Novoalign) 将这些reads与以FASTA格式提供的参考基因组进行比对,来确定每个reads在基因组的定位。比对的结果是序列比对/映射(SAM)文件及其压缩二进制格式(BAM)文件。
然后, 进行基因突变的检测。可以使用 GATK(Genome Analysis ToolKit), Samtools 及 FreeBayes 等工具。GATK 包含两个子程序 UnifiedGenotyper 或 HaplotypeCaller 都可用于检测 SNVs、InDels。SAMtools 包含一个子程序 bcftools 也可检测 SNVs 和 InDels。FreeBayes 是一种基于贝叶斯统计的方法, 可用于检测 SNVs、InDels 及 CNV 等。虽然有多种比对和变异鉴定工具可供使用, 但对 Illumina 数据的变异检测, 比对工具 BWA-MEM 和变异鉴定工具 Samtools 具有最佳性能。此步骤鉴定的突变信息保存在 Variant Call Format(VCF) 文件, 用于下游数据分析。
最后,将检测到的突变进行功能注释,以确定基因名称、编码序列、突变类型(同义突变、非同义突变及移码突变)等。常用软件ANNOVAR、SNVEff等注释基因变异对其编码蛋白质的影响。例如,如果一个SNVs被注释为一个基因的非同义突变,而且位于蛋白质的活性位点,它就很可能影响蛋白质功能。通过注释分析,可以过滤或优先选择一些变异位点用于进一步的功能研究。目前大多数研究都集中于外显子区域的基因突变(外显子测序),因为孟德尔遗传疾病中约 $85%$ 都与外显子编码区的突变有关。
12.1 短读段比对(Reads Mapping)
NGS数据经质控与预处理后,在变异判读(variant calling)前还要先把reads映射或比对到参考基因组,以确定每个reads在基因组的位置。如图12-2所示是一个简单的读段联配(read alignment)结果,第一行是参考序列(reference),下面几行是比对上的reads。Read A与D与参考序列正好完全匹配,而Read B有一个碱基G与参考序列不一样,参考序列在此处为A(用符号*标注)。
1 | \text { Reference } \text { GGATCCATGCGTCCCAGGTCACGGGATCCATG CGTCCCAGGTCACG } |
Read A ATGCGTCCCAGGTCACGGGATCCATGCGTCC
Read B ATCCATGCGTCCCAGGTCACGGGGTCCATGC
Read D CGTCCCAGGTCACGGGATCCATGCGTCCCAG
Read F CAGGTCACGGGATCCATGCGTCCCAGGTCAC
图12-2 将reads定位到基因组
与 BLAST 工具只搜索一个或几个序列在基因组的相似序列相比,同时把 NGS 上百万的短 reads 比对到基因组的算法更加复杂。由于基因突变或测序错误,reads 可能与其来源的基因组序列存在一些变异。因此序列比对算法必须要能包容这种序列差异(一般软件会默认允许两个碱基错配)。为增加比对速度与减少计算量,日前常用的比对软件BWA,Bowtie2和SOAP2等都是基于Burrows-Wheeler transform(BWT)与后缀树(suffix trees)算法的。
可以根据对速度与敏感度的要求不同来选择使用不同的比对工具。如果只要速度快,可以选 Bowtie2 或 SOAP2;如果注重敏感性,可以选择基于哈希表(hash-table-based)的工具,如 Novoalign, Stampy 等。而 BWA 试图平衡速度与敏感度,是目前最常用的 NGS 比对工具。随着 Illumina 测序 reads 长度的增加(150~300bp),原来只适用于做短 reads(50bp) 比对的工具也相应进行升级,如 BWA-MEM 可以比对长 reads。随着新的测序平台可测得更长的读段,如 PacBio 的 SMRT 可以产生 20kb 长度的 reads,目前可用的长 reads 比对软件有 BLASR, LASTZ, BWA-MEM 等。BLASR 是专门设计用来比对单分子 DNA 测序的长 reads。
另外,比对结果也与参考基因组的选择有关,与测序reads更相近的参考序列会比差得较多的参考序列有更好的比对结果。如果它们的差异太大,许多reads将被认为是错配(mismatch)而被丢弃,因此使用不同的参考序列会导致参考序列偏差(reference bias)。因为单个基因组不会包含一个种群内所有的序列变异或多态性,所以用任何一个特定的参考基因组都不可避免引入这种偏差。
12.1.1 标准 mapping 文件格式—SAM/BAM
文件格式SAM(sequence alignment/map)是tab分隔的文本格式,易读而且机器检查比较快。BAM是SAM的二进制压缩文件格式,容量更小且存取效率更高。SAM/BAM格式广泛应用于变异检测,已经是存储读段映射(reads mapping)结果的事实标准。
SAM文件格式的结构由头部分(可略)与比对部分构成。头部分提供SAM/BAM文件一些总的信息,每行由“@”开始,包括两行,每一行有两个字母组成的记录类型(tags)。如图12-3所示,第一行HD,表明这是个头部分,它有两个tags,VN代表格式版本,而SO代表排序(这里是按coordinate排序)。第二行SQ,是参考序列,它也有两个标签SN与LN,分别代表参考序列名字与参考序列长度。
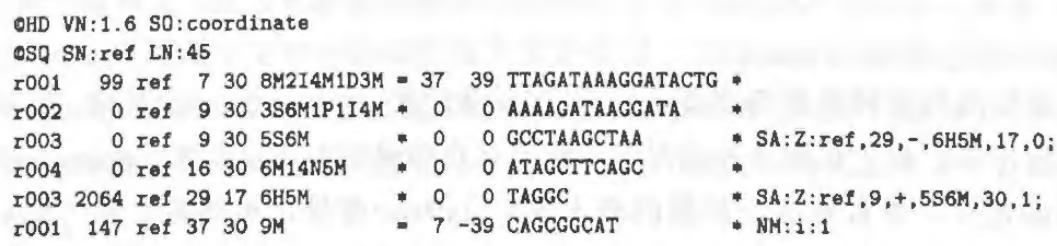
SAM 文件格式的比对部分由 11 个强制字段(mandatory fields)构成(表 12-1)。FLAG 字段采用简单的数字来跟踪 mapping 过程的 11 个标志,如是否在这个测序里有多个片段(像例子中的 r001),或比对片段 (SEQ) 是不是反向互补。为检测这些 flags 的状态或所代表的意思,需要把 16 进制数字转换成二进制。POS 字段是坐标系统,SAM 采用 1-based 坐标系统,即参考基因组的第一个碱基是 1,而不是 0。MAPQ 是比对质量分值,此值的计算方法与 Q-score 相似(MAPQ=-10lg(PMapErr))。CICAR field 详细描述 SEQ 是如何比对到参考序列的,如 r001/1 的 CIGAR 值为“8M2I4M1D3M”,说明最先 8 个碱基与参考序列相同,接下来 2 个碱基是插入序列,之后 4 个碱基相同,再后有一个碱基缺失,最后的 3 个碱基是相同的。
表 12-1 SAM/BAM 格式中字段的说明
| Col | Field | Type | Regexp/Range | Brief description |
|---|---|---|---|---|
| 1 | QNAME | String | [! -? A–]{1,254} | Query template NAME |
| 2 | FLAG | Int | $[0,2^{16}-1]$ | bitwise FLAG |
| 3 | RNAME | String | *|[:rname:^=][:rname:] | Reference sequence NAME |
| 4 | POS | Int | $[0,2^{31}-1]$ | 1-based leftmost mapping POSITION |
| 5 | MAPQ | Int | $[0,2^{8}-1]$ | MAPping Quality |
| 6 | CIGAR | String | *|([0-9]+[MIDNSHPX=])+ | CIGAR string |
| 7 | RNEXT | String | *|=|[:rname:^=][:rname:] | Reference name of the mate/next read |
| 8 | PNEXT | Int | $[0,2^{31}-1]$ | Position of the mate/next read |
| 9 | TLEN | Int | $[-2^{31}+1,2^{31}-1]$ | observed Template LENgtb |
| 10 | SEQ | String | *|[A-Za-z=。]+ | segment SEQuence |
| 11 | QUAL | String | [! –]+ | ASCII of Phred-scaled base QUALity+33 |
对SAM/BAM格式的更多说明可以参考官方文档说明。SAMtools是解读,分析与操作SAM/BAM格式文件信息的工具,可用于检测遗传变异分析等。
12.2 变异识别(Variants Calling)
一般鉴定遗传变异需要考虑多种因素,如碱基质量、比对质量、read长度、覆盖深度、单端或双端测序等。由于在测序与比对等过程中存在错误与不确定因素,variant calling也总是会有不确定性。而且鉴定小片段的插入缺失(InDels)变异比单碱基变异(SNVs)更加困难,因为reads中存在小片段InDels,会影响reads的正确比对。
变异鉴定软件一般会采用一定的统计模型或启发式(heuristics)算法减少这些不确定性(图12-4)。基于统计模型的算法会建立各种错误与偏差的统计模型,或引入其他相关的先验信息(prior information),从而显著减少误判变异的概率。而基于启发式算法的软件会考虑各种因素,如最少read长度、碱基质量和等位基因频率等。目前基于统计模型的算法比基于启发式的算法使用更广泛,如最常用的GATK,SAMtools就是基于统计模型的软件,VarScan2是最常用的基于启发式算法(heuristics-based)工具。然而统计模型一般是基于某种假设,当在某些条件下假设不成立,启发式的方法就更加可靠。如数据的测序深度(read depth)极高,或研究对象为合并的样本或受污染的样本等情况下,使用启发式的方法就更加可靠。
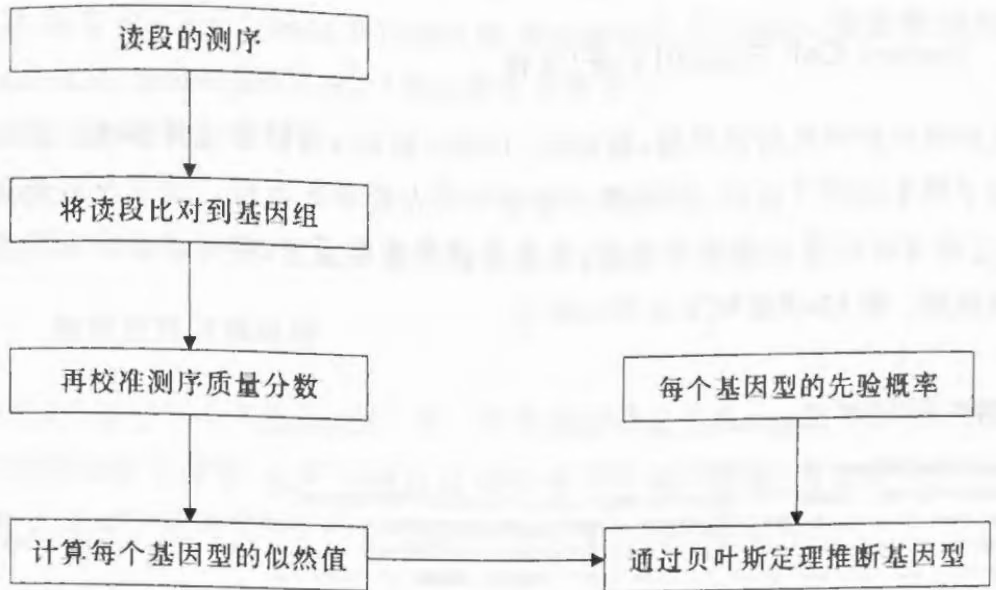
GATK有两个子程序可用于鉴定变异(variant caller):UnifiedGenotyper和HaplotypeCaller。UnifiedGenotyper采用Bayesian genotype likelihood模型来鉴定变异(SNPs和InDels)和基因型(genotypes,如A/A,A/B,或B/B)。UnifiedGenotyper运行比较快,并只单独考虑单个位点。顾名思义,HaplotypeCaller会考虑附近变异位点的关联(linkage),对单倍型(haplotypes)采用局部de novo组装和HMM似然函数来鉴定SNPs与InDel,需要更大的计算量,运行速度比较慢,但变异识别会比较准确。GATK官方建议采用HaplotypeCaller来检测变异。
SAMtools 也采用与 GATK 相同的贝叶斯模型来检测变异, 分两步。第一步用的工具是 Mpileup, 通过采集 BAM 文件中已经比对上的读段(aligned reads)信息来计算所有可能的基因型, 以及每个基因型可能真实存在的概率(似然值), 并存储在 BCF 文件中。而第二步用到的工具 BCFtools, 利用 BCF 文件中的似然值来鉴定变异。SAMtools 能够通过综合考虑覆盖度(read depth)、包含参考碱基与替代碱基的 reads 数量、参考碱基和替代碱基的平均质量分值、read 的定位质量及使用碱基比对质量(base alignment quality)等因素来评价 reads 中是否存在遗传变异。
由于不同的工具采用不同的变异识别算法,它们鉴定的变异位点往往只有部分相同。建议仔细分析每个研究的特殊条件再决定采用哪个变异鉴定软件。一般可同时采用不同的工具,并比较它们各自结果的差异,它们鉴定的共同变异位点一般比较可靠。有些工具,如GATK与Samtools,可以同时对多个样本进行变异分析,如亲子三人组、两个不同组的样品等。多样本联合检测更容易检测到那些在多个样本中存在的相同变异位点,因此采用多个样本同时检测是提高variant calling质量的有效方法。
12.2.1 Variant Call Format(VCF)文件
VCF 是存储主要序列变异类型, 如 SNPs, InDels 和 SVs 的标准文件格式。该文件格式可用于读取成千样本的百万位点, 最初被开发用于千人基因组项目。除了报告变异位点的基因组位置, 它还可以记录其他附加信息, 如变异读出的质量值, 并允许用户自定义 tags 来描述新的序列变异。图 12-5 是 VCF 文件的例子。
1 | Example VCF file |
图 12-5 VCF 格式 (from http://samtools.github.io/hts-specs/)
VCF 文件包含前面的 meta 信息、一个头部行(header line)与数据行(data lines)。meta 信息行以“##”开头,描述相关的分析信息,如物种,文件时间,组装版本,以及用户自定义数据栏中定义的简称等。
接下来的header行,以“#CHROM”开始,列出九个必需的固定列名称,分别为:检测到变异的染色体、位置(POS)、ID、参考基因组碱基信息(REF)、检测样本的碱基信息(ALT)、质量值、过滤标签、信息列(该变异位点的具体信息,如测序深度等)和样本标签格式。从第十列开始视每个样本的具体情况会不同。第五列ALT是被检测对象在该位置上的碱基序列,其中“.”表示被检测对象该位置的碱基序列与参考序列一致;QUAL栏是突变等位位点碱基(ALT)的Phred质量分数,如30代表ALT读长的错误概率是0.001。在FILTER栏,“PASS”代表这个可能位点已通过所有过滤,而“q10”代表些位点的变异判读质量低于10。数据行是VCF文件的主体,包括每个位置上变异(variant)的信息。
VCFtools 是解读, 分析与操作 VCF 文件信息的工具集。它包括两个模块: 一个通用的 Perl API 与一个 C++ 二进制可执行模块。PERL 模块可以用来做 VCF 文件检验、合并、交集或互补等通用的任务; 而 C++ 二进制可执行模块可用来计算不同的质控 (QC) 指标, 过滤特定的变异位点, 估计等位基因频率等。
12.3 全基因组重测序分析实践
本实验所用的数据来自一篇研究NGS分析方法对突变检测影响的论文,更多信息请阅读文献(Gavin Oliver,2012)。
这里使用参考基因组序列文件: chr17.fa(人类基因组序列, Hg19 版本)。
测序数据文件: Brca1Reads_0.1.fastq 和 Brca1Reads_0.2.fastq, 这些数据来自 Illumina HiSeq Paired-End reads(人的 BRCA1 基因的模拟数据)。
1 | \$mkdir resequencing |
1 | \$cd resequencing |
在进行下一步分析前,先把所有数据放到这个目录。
12.3.1 数据质控与预处理
当拿到二代测序的原始数据之后,第一步要做的就是用 fastqc 看一看原始 reads 的质量。为保证分析结果的可靠性,还要先通过过滤处理低质量的数据,才能进行下一步的分析。NGS 数据预处理的方法参见 NGS 分析基础步骤,此处不进行预处理。
12.3.2 短序列比对 (Mapping)
BWA 是 Burrows-Wheeler Aligner 的简写。它的比对敏感性与精确度都比较好。
(1) 创建基因组序列索引
第一步是创建参考序列(reference sequence)的索引文件,可以加快后面 mapping 过程。
1 | \$bwa index chr17.fa |
这步产生5个索引文件,chr17.fa.amb, chr17.fa.ann, chr17.fa.bwt, chr17.fa.pac, chr17.fa.sa。
(2) 比对 reads
通过 BWA-MEM 把测序 reads 比对到参考基因组序列。BWA-MEM 是 BWA 多种比对方法中最新最准确的程序。
1 | \$bwa mem chr17.fa Brca1Reads_0.1.fastq Brca1Reads_0.2.fastq >Brca1Reads_aligned. |
比对完后,可以查看输出的SAM格式文件:
1 | \$less -S Brca1Reads_aligned.sam |
(3)SAM->BAM转换及排序(sort)
SAM 文件是文本比较大,转换成对应的二进制格式 BAM 文件,可以节省硬盘存储空间。后续分析也大多需要用 BAM 格式文件作为输入文件。
1 | \$samtools view -b -S Brca1Reads_aligned.sam -o Brca1Reads_aligned.bam |
接下来进行排序(sort),每个read都按比对至参考基因组的坐标进行排序,这样使后续搜索变得更快,文件更小,提高处理效率。
1 | \$samtools sort BrcalReads_aligned.bam -O BrcalReads_sorted.bam |
结果会产生 Bral Reads_sorted.bam 文件。
(4)重测序的数据质量评估及去重复
得到比对 BAM 文件后,通过分析 BAM 文件可以对重测序的数据质量进行评估。常见的评估指标包括:①比对短序列比例(mapping ratio),即比对上参考基因组序列的 reads 占总 reads 的比例。②深度(depth),即基因组上被覆盖的碱基平均被多少条 reads 覆盖。③覆盖度(coverage),即基因组多少碱基被 reads 覆盖。④插入片段长度(insert size),即建库时打断片段长度,可通过 R1 与 R2 端序列比对在参考基因组上的间距来估算。
可运行samtools flagstat命令来获得短序列比对比例的信息:
$samtools flagstat Brca1Reads_sorted.bam
然后再过滤那些由 PCR 得到的重复 reads, 这些 reads 没有生物学意义, 不能用它们来计算 SNP 的测序深度。
$samtools rmdup Brca1Reads_sorted.bam Brca1Reads_sorted_rmdup.bam
最后再对得到的 BAM 文件进行索引:
$samtools index Brca1Reads_sorted_rmdup.bam
结果会产生 Brca1Reads_sorted_rmdup.bam.bai 文件。
为节省时间,本练习没有进一步进行变异分析的其他过程,如局部序列重比对(local realignments)、碱基质量分值重校正(base quality recalibration)等,这些步骤有助于提高SNP鉴定的准确性。
需要特别注意的是,通常由 Phred 程序估计的 Sanger 测序(ABI 测序仪)的质量分值是非常准确的。然而,Illumina 测序仪的质量分值代表的是一个碱基的最强荧光与次强荧光信号的比值。一些研究认为这种质量分值并不能准确反映每一个碱基发生测序错误的真实概率。特别是一个碱基在 read 中的位置(在开头、中间或末尾),即测序循环周期会对其错误概率产生很大的影响。而这并不能在由 Illumina 仪器提供的质量分值完全反映出来。另外相邻的碱基(二核苷酸)也可能会导致测序错误,特定的二核苷酸更容易出现测序错误。因此在变异检测时需要进行碱基质量分值重校正。
12.3.3 变异鉴定(Variant Calling)
比对 reads 到基因组后, 可用 Samtools 来鉴定 SNPs。在鉴定 SNPs 前, 需要创建参考基因组 (reference genome) 的索引 (index), 索引文件 (扩展名 .fai) 使程序能在参考基因组的任意位置读取比对文件中的比对信息。
$samtools faidx chr17.fa
这个命令运行后产生一个参考基因组索引文件 chr17.fa.fai。
Samtools采用一定的统计模型(Bayesian genotype likelihood)来鉴定可能变异位点。变异鉴定过程分两步,分别用到工具Mpileup与Bcftools。
$samtools mpileup -g -f chr17.fa Brca1Reads_sorted_rmdup.bam>Brcal_variants.bcf
$bcftools view -c -v Brca1_variants.bcf > Brca1_variants.vcf
鉴定的SNP信息存储文件格式为VCF(variant call format),通过查看VCF文件可以分
析鉴定的变异位点(图 12-6)。
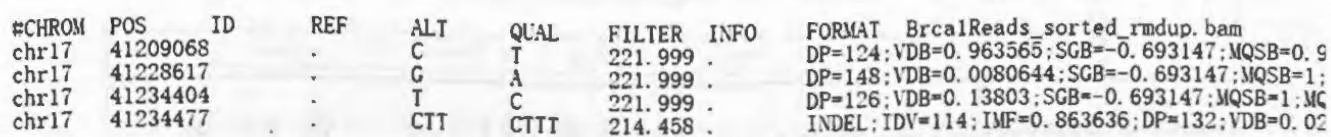
从 VCF 文件可以看到将 reads 比对到参考基因组可以检测到大量的 SNP 变异。这些 SNP 位点还可以通过 Vcftools 进一步过滤,如我们只想查看稀有的变异 (rare variants),可以选择 frequency of minor alleles (MAF) < 1% 的 SNP 位点。从全基因组测序数据鉴定变异要考虑多种因素的影响,如测序覆盖度(理想的覆盖度是在 20×~50×范围)、测序平台的错误率和比对质量分数等信息。通常在增加 SNP 筛选条件为 “QUAL < 30 || DP > 10 || FS > 60 || MQ < 40”。
当然,上述的筛选条件只是基于质量水平的过滤,如果我们想更精准地得到我们关心的突变位点信息的话,可以在质量过滤基础上做一些人群频率数据库及功能数据库的分析,如千人基因组人群频率数据库、ANNOVAR、snpEFF、clinvar等功能或者疾病数据库。
12.3.4 可视化(IGV visualization)
变异位点可视化可以比查看文本文件有更多的信息。我们用IGV来察看得到的SNP位点信息。IGV可以显示SNP的位置、基因信息及reads mapping质量等。
从IGV网站下载Windows版本文件IGV_2.3.72.zip,解压缩后,在IGV_2.3.72目录双击igv.bat运行IGV。
左上角选择基因组为人类 hg19(Human hg19)。当前人类基因组最新版本为 hg38, 但本实验用的序列是 hg19。不同的基因组版本的序列与基因注释信息都可能有差异, 不能混用。
再点菜单 File>Load from file, 选择文件 Brca1Reads_sorted_rmdup.bam, 就可以显示 BAM 文件。
同样通过菜单 File>Load from file, 导入 Brcal_variants.vcf, 这样 IGV 将显示变异位点信息。
再选择17号染色体(chr17),可以通过点击右上角放大或缩小图标,来显示底下蓝色的基因信息。IGV还可以通过键盘的左右方向键来移动显示位置,或把鼠标移到基因注释栏,按左键就可以左右拖动显示位置。通过左右移动与放大缩小操作就可以清楚地观察目标SNP信息。
由于本实验只有基因BRCA1数据,可以在数据框内输入“BRCA1”,回车就可以直接定位到BRCA1基因的位置chr17:41196312-41277500(图12-7)。以Brca1_variants.vcf栏为SNP位置参考,适当放大并移动位置观察SNP位点的信息,如是否处于基因编码区,是否有InDel。当鼠标移动到SNP位点还会自动显示SNP的详细信息,如SNP的位置(position),比对质量(mapping quality)及测序深度(depth)等。
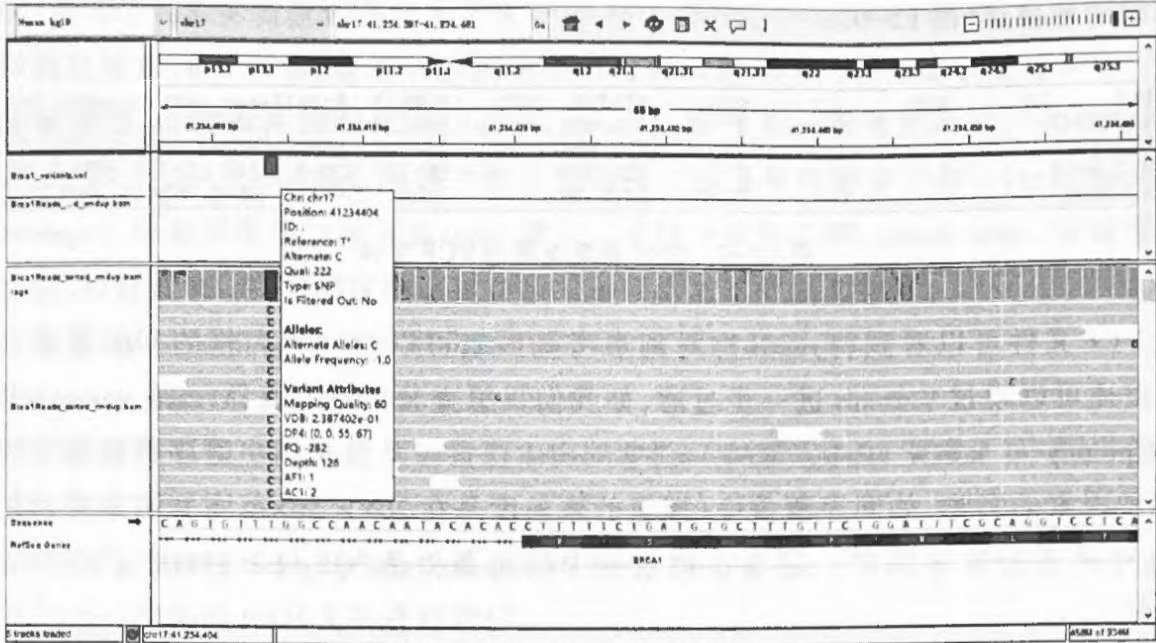
实际上,完整的基因组重测序数据量非常大,分析需要更长的时间。而此练习的数据量非常的少,只选择一个基因的数据,主要目的是让用户了解从个体基因组测序数据中检测SNVs和InDel所需的基本操作步骤。对完整变异鉴定感兴趣的读者可以再阅读相关参考文献(Garin Oliver,2012)。
习题
试述全基因组重测序分析的主要步骤。
从 SRA 数据库下载一个癌症基因组重测序课题的数据, 并利用 BWA-MEM、samtools 等工具进行 SNP 分析。
第 13 章 基因组组装 (Genome Assembly)
不积跬步,无以至千里;不积细流,无以成江海。——荀子·劝学篇
本章简单介绍下一代测序的从头组装的基本原理与组装过程,重点介绍各种组装算法,并通过酵母基因组组装实例演示NGS短片段序列的组装流程。
◎ 导学案例
酵母菌主要用于酒精与面包的制造。科学家在亚美尼亚(Armenian)洞穴中的一个古老墓地中挖掘出了一个拥有6000年历史的酒庄,配有葡萄酒压榨机、发酵器皿及饮酒杯等。这个酒庄说明当时人类已经掌握如何控制酿酒酵母生长繁殖的技术,这是人类历史上的一项重大技术创新。
然而,人类对酒精的兴趣可能更悠久。科学家还发现,笔尾树鼩(tree shrew)(图13-1)也酗酒,它饮用的“棕榈酒”是由生活在棕榈树花朵上的酵母菌自然发酵而成。树鼩是一种可能与所有灵长类动物的远古祖先类似的动物,说明酗酒基因的产生可能比亚美尼亚洞穴酒庄的历史还要早几百万年。与我们亲缘关系最近的灵长类动物黑猩猩也可能喜欢饮酒,它经常饮用天然酿造的水果花蜜。
生物体的完善基因组序列是进一步研究该物种的遗传信息与进化的基础。获得完整基因组的基因组测序方法有两种:从头测序(de novo sequencing)与全基因组重测序(whole genome resequencing)。从头测序指不依赖任何已知基因组序列信息,对某个物种的基因组进行测序,然后对测序序列进行拼接和组装,最终获得该物种的基因组序列。全基因组重测序是对基因组序列已知的物种中的个体进行基因组测序。全基因组重测序通过序列比对,可以找到大量的单核苷酸多态性位点(SNPs)、插入缺失序列(InDels)与结构变异位点(structural variations,SVs)等。下面我们简单介绍从头测序的基因组组装方法。
目前,由于测序技术对测序长度的限制,基因组测序前需要将基因组随机打断成短片段,测序完成后再将测序得到的短读段(reads)拼接成基因组序列,这个过程即为基因组组装(genome assembly)。从头测序的一般过程如图13-2所示。
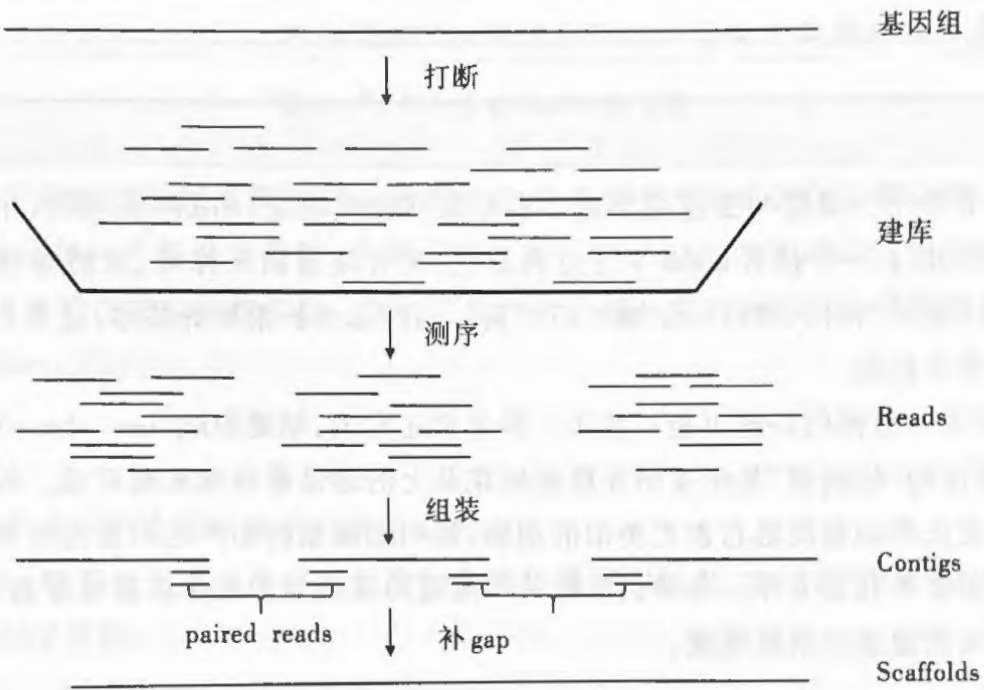
基因组组装从一代或二代测序得到的许多短读段出发,通过其相互间的重叠(overlap)关系进行短序列的延长,直至无法进一步延长。此时组装所得到的连续序列称为重叠群(contigs)。重叠群是一段所有碱基都明确的序列,骨架(Scaffold)是指顺序和方向都确定的一系列重叠群,但在重叠群之间存在未知序列(gap)。骨架的拼接主要依靠双端(paired-end)或配对(mate-pair)文库测序所得短读段之间的配对关系,或通过与参考基因组比对等方法确定重叠群之间的顺序与方向。重叠群之间的未知序列(gap)一般用多个N表示,N代表未知碱基,而N的个数代表gap的大小。
第一代 Sanger 测序的读段较长,一般可达 800bp,是基因组从头(de novo)组装的金标准,但非常昂贵与耗时,如完成人类基因组草图测序花了 30 亿美元,并用了 13 年时间。对低价与快速测序的需求促进了下一代测序技术的发展,但 NGS 的测序读段就相对小得多,一般只有 100 ~ 200bp, 并且错误率更高(Illumina 测序中通常为 0.5% ~ 1%)。短读段使后续的组装过程变得更困难, 需要更多的数据, 同样完成人类基因组测序, Sanger 测序只要大约 8× 的覆盖度, 而 NGS 却需要 100× 的覆盖度。因此, 针对 Sanger 测序的组装软件(如 Phrap 等), 已不再适合 NGS 测序的组装。针对 NGS 测序重新开发的组装软件, 如 Velvet、ABySS 和 SOAPdenovo 等, 能对海量的 NGS 数据进行从头组装, 最终得到基因组序列。
13.1 基因组组装的影响因素及测序策略
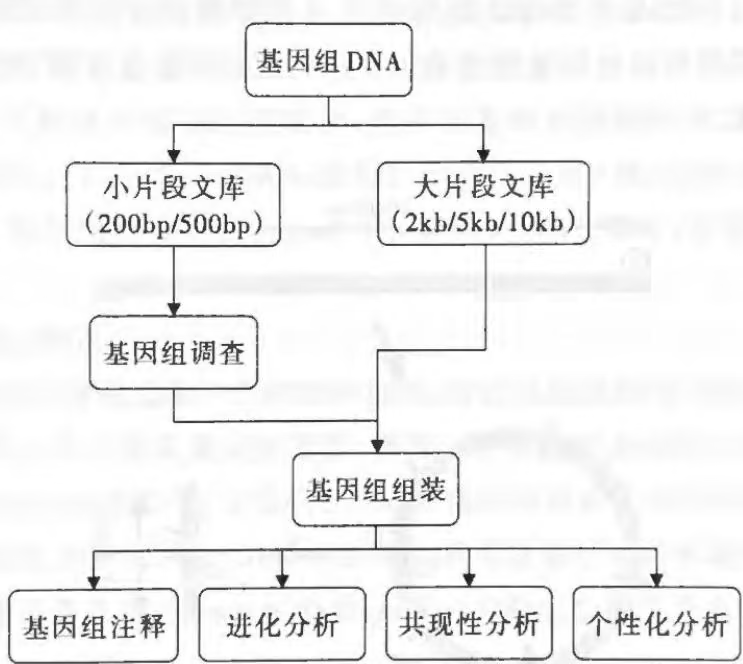
基因组从头测序是项复杂的过程,涉及大量的测序数据和计算资源消耗,下面我们列出一个基本的基因组从头测序与组装的研究流程(图13-3)。
13.1.1 影响从头组装的基因组因素
基因组大小(size)是决定组装难度的关键因素。细菌的基因组一般较小(<10Mb),NGS数据的组装一般没有问题。而人、植物等基因组数据较大(>1Gb),NGS数据的组装就变得很困难。另一个影响组装的重要因素是基因组中重复序列(repeats)的数量。有些物种,如大麦,基因组中重复序列较多,组装就变成很大的挑战,因为重复序列会造成测序reads不能定位到基因组的正确位置,组装成连续片段有困难,因此在基因组组装序列(assembly)中留下缺口(gap)。还有一个影响组装的因素是基因组的杂合度(heterozygosity)。基因组杂合度是等位基因差异性的度量参数。由于双倍体或多倍体的等位基因差异,从而使来自它们的测序短读段不能拼接在一块。其他基因组特征,如GC含量,也会影响基因组组装。一般在基因组从头测序前,要对物种进行基因组调查(survey),了解基因组的大小和杂合度等情况。基因组大小可以通过查询相关数据库,或通过流式细胞仪实验测定或通过K-mers(K-mers指长度为 $K$ 的子序列)估计等获得。估算 $K$ -mers值不仅可以估算基因组大小, 还可以检测基因组的杂合度, 杂合度越高的物种基因组组装难度越大。
13.1.2 测序策略
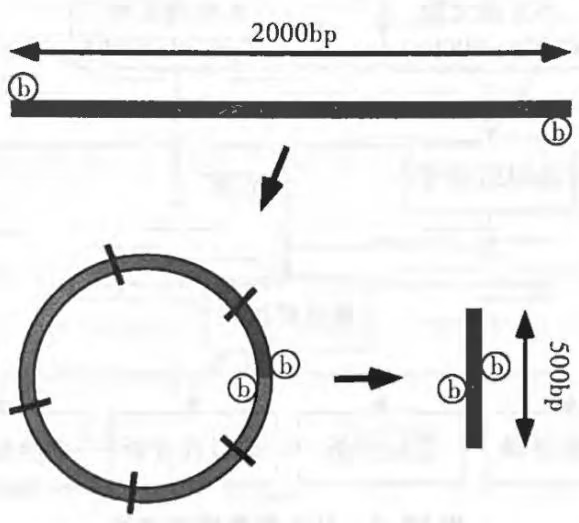
如何填补由重复序列导致的空位(gap)是测序策略要考虑的首要问题。要连接gap两边的contigs的基本方法是测出能跨过gap距离的测序读段对(read pairs)。读段对一般是通过长距离末端配对测序得到,环化配对与末端配对测序不同,它是被设计来跳过(jump)一个大片段序列的两末端(图13-4)。环化配对测序前,先将大片段DNA连接上生物素标记的接头,再通过环化使DNA片段两末端连接一块,然后随机打断,并捕获含有大片段DNA两末端的DNA片段,用于末端配对测序。为了跨过不同大小的重复区域,需要测序不同插入片段大小的测序文库(如2~40kb)。为保证组装成功,一般需要联合使用末端配对与环化配对文库。前者的测序短读段可以组装基因组非重复序列或短的重复序列;而后者可以解决中等或长范围的重复区域。
测序读段长度(read length)是组装的另一个关键因素,越长的读长将会有越好的组装结果。第三代测序技术(如Pacbio)已经能得到长的读长(long reads),最长可测序到10~50kb。而Illumina HiSeq平台快速运行模式下也可以测到250bp。如果对插入长度为450bp的文库进行双末端测序,每个读段对将会重叠,用一些软件(如工具FLASH)可以把两重叠读段,合并成一个有450bp的长读段,并能减少测序错误。这个策略可以克服由NGS短读段造成的组装困难。
测序深度(depth)是影响组装的另一个重要因素。测序深度与多种因素有关,如重复序列数量、杂合程序、读长及测序错误率等。但测序深度偏低会造成组装碎片化,对同时采用不同末端配对与环化配对文库的测序项目,一般建议短插入片段的末端配对文库与中等长度环化配对文库(3~10kb)的测序覆盖度为50×左右,而长插入片段的环化配对文库(10~40kb)的测序深度为1×~5×。另外,虽然测序深度提高有助于组装质量,但测序也不是越多越好,当深度达到一定水平(即已饱和),更高的深度无助于进一步提高组装重叠群的长度。
13.2 序列组装过程
序列组装是把随机打断测序的短读段再还原成原始序列的过程,一般可分组装重叠群,构建骨架及补洞三个步骤。
13.2.1 组装重叠群
从头组装试图基于测序 reads 的重叠来构建一个长字符串(superstrings)。最早是 Lander 与 Waterman 通过理想化的序列(无错误与无重复)对组装过程来建模。在 Lander-Waterman 模型中,如果两个短读段重叠,并且超过一定域值,就合并成一个重叠群,重复此过程直到重叠群不能被延伸。虽然这个模型比较简单,但从海量的短读段中找重叠,并把它们组装成 contigs,计算难度很大。目前基因组从头组装的方法可分成 3 类:①贪婪(Greedy)算法;②重叠一排列一生成一致序列(Overlap-Layout-Consensus, OLC)算法;③德布鲁意图(de Bruijn graph,DBG)算法。
(1) 贪婪 (Greedy) 算法
贪婪算法在组装时首先选取一个初始的读段,每次总是选取与当前序列重叠程序最高的读段,延伸当前序列。为了选取最优的读段,需要比较任意两条读段之间的重叠程度。贪婪法是基于局部序列相似的最大化,主要用于Sanger测序所得长片段序列的组装。基于贪婪法的组装软件有VCAKE、SSAKE等。OLC与DBG方法都是基于全局的设计思想,通过Lander-Waterman模型,根据重叠信息把reads组装成contigs,但是它们的实现方法不同(图13-5)。
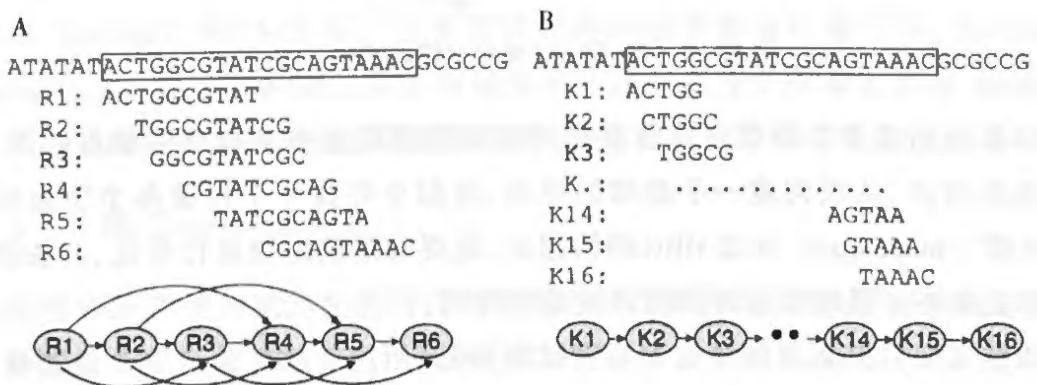
(A) OLC 算法;(B) DBG 算法
(2) Overlap-Layout-Consensus(OLC)算法
顾名思义, OLC算法可以分为3个步骤:
①对所有序列进行两两比对,找到所有测序序列之间可能的重叠信息(overlap)。
②将短读段重叠片段组合起来,并在图上做延展(laying out)。
③根据序列中每个碱基的质量值,构建一致性序列。
第一步是计算量最大的过程,随着短读段数增加会大大增加计算量。第二步创建的重叠图以节点代表短读段,每个边代表它们之间的重叠。最后一步构建一致序列等于在重叠图中找经过每个节点一次的路径,即图论中的Hamiltonian路径。目前基于OLC算法的软件有Phrap、Newbler和Celera Assembler等,主要用于较长读段的组装,如454和Sanger测序。OLC算法很少用于NGS的短读段组装,因为NGS往往有很高的测序量,如果对所有读段进行两两比对,将造成巨大的计算量。
(3)DBG(De Bruijn Graph)算法
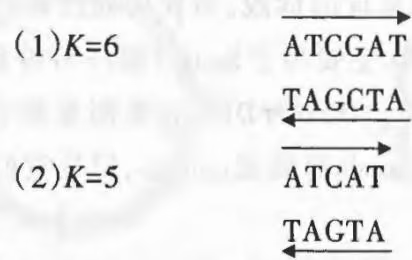
常用于短片段组装的计算方法是de Bruijn graph(德布鲁意图)算法,基于这个算法的软件有Velvet,ABySS,ALLPATHS-LG,SOAPdenovo等。这个方法不需要找所有读段之间可能的重叠,而是把读段分割成特定长度为的短片段(K-mers),将序列组装的问题转化成K-mers(de Bruijn)图的构建问题。K-mers指一个read分成K长度的所有子序列,如序列ATTACGTCGA可以分成一系列3-mers(K=3):ATT,TTA,TAC,ACG,CGT,GTC,TCG和CGA。这些K-mers被用作de Bruijn图中的节点,而连接两个节点的边(edge)代表聚合两个节点,如连接节点ATT与TTA的边是ATTA。为防止由于出现回文序列而导致序列自身拼接的问题,K值应取奇数。如图13-6所示,K值取偶数时,可能出现序列与其反向互补重合的情况,反过来完全一样,从而导致组装时序列自身组装的问题;而当K值取奇数时,刚可以避免发生这种情况。
采用DBG 算法的主要工作就是通过获得的原始数据构建一个有众多节点的图,然后用“边”来连接这些节点,从而构建一个连续的序列,类似于寻找一个连接各个节点的最短路径,称为“路径图”(roadmap)。完成DBG 的构建后,还要对图的路径进行简化,并去除去低可信路径等。组装最终步骤输出达到阈值的重叠群序列。
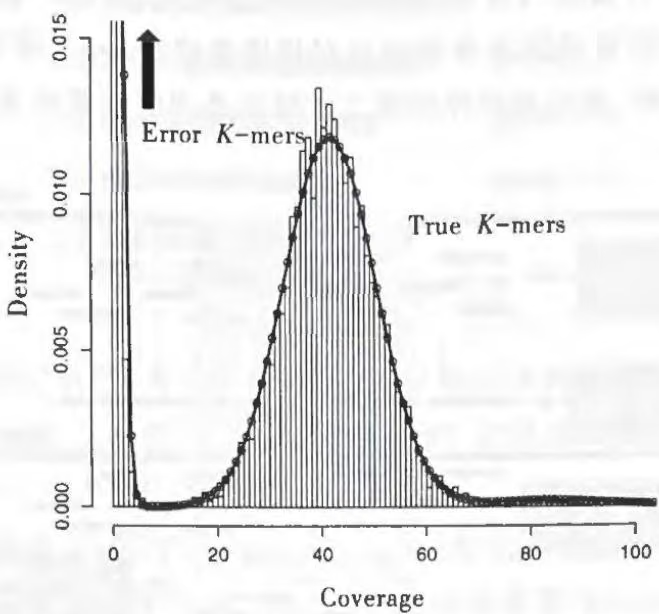
DBG算法的主要弱点是对测序错误高度敏感,因此用这类软件前必须要做测序reads纠错。一般NGS数据的QC过程并不能完全去除测序错误,因为单靠碱基的质量分数高并不能保证读段中没有测序错误。Illumina测序仪的质量分值代表的是一个碱基的最强荧光与次强荧光信号的比值,这种质量分值并不能准确反映每一个碱基发生测序错误的真实概率。现在有一些专门的纠错软件如Quake error corrector,或一些组装软件(如ALLPATHS-LG、SPAdes)中也集成了纠错模块。大多数此类软件的算法是基于K-mers过滤。在一个K-mers集合中,大多数K-mers将出现多次,而一些只出现一两次的K-mer很可能就是测序错误(图13-7)。而测序错误纠正的方法就是找到最小的碱基变异使一个短读段中所有的 $K$ -mers都更加可靠。
13.2.2 构建骨架(Scaffold)
构建骨架是对得到的重叠群(contigs)进行排序(order)与定向(orient)的过程,并能估计它们之间gap的长度(图13-2)。骨架的构建主要依靠末端配对或环化配对文库测序所得读段之间的配对关系,或通过与参考基因组比对来确定重叠群之间的顺序与方向。骨架构建软件的输入数据为组装后得到的重叠群、环化配对或PacBio三代测序的读段。首先将环化配对读段或PacBio读段比对到重叠群;再跟组装过程一样,将这些重叠群与读段组装成更长的字符串。组装所得的骨架长度受环化配对文库的插入片段大小或PacBio长读长测序读段长度的影响,不能连接大于其文库插入片段或读段长度的重复序列区域。目前专门构建骨架的工具有Bambus2,SSPACE等。许多组装软件也自带骨架构建工具,如ABySS,SGA和SOAPdenovo等。不同骨架构建工具的性能受测序数据集与分析参数影响,因此,建议不同测序项目采用不同的骨架构建工具与参数进行分析,将有助于得到最好的组装结果。
13.2.3 补洞(Gap closure)
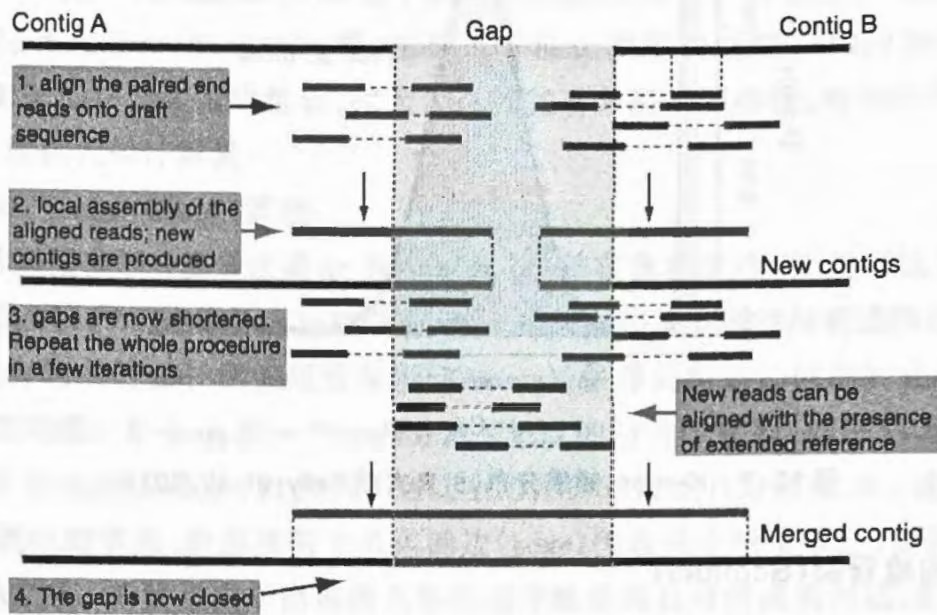
基因组组装最理想的结果是能将所有的染色体序列拼接出来,但是实际组装结果是一些大片段的重叠群或骨架,中间有许多不确定序列。产生不确定序列的原因有很多,如基因组自身的重复序列、随机测序错误、测序数据不足造成覆盖度低和组装算法限制等。因此,组装的最后一步还要补重叠群之间的不确定序列。一般可通过PCR实验补洞,先在gap两边的重叠群末端已知序列设计引物,然后PCR扩增并测序得到gap的序列。然而当有很多的不确定序列时候,这个方法很费时费力。缺口序列也可能是由于重复序列在构建重叠群的过程中被忽略。现已有一些补洞(gap filling)软件,如IMAGE、GapFiller等,可以利用可能来自gap区域的末端配对或环化配来做特定位置组装,从而逐渐补上gap区域。例如,
IMAGE 的算法(图 13-8)是首先收集比对到重叠群的读段对,并用它们组装成新重叠群来扩展 gap 区,当有新的重叠群被整入骨架,再重复这个步骤,直到整个 gap 被补上。另外也可以利用参考基因组序列进行重叠群或骨架的比对排序来修补 gap。参考序列可以是同一物种或相似物种的基因组序列,使用参考序列能大大降低基因组组装的复杂度。
13.3 组装质量的评价
基因组组装质量的评价参数主要有三个:连续性(continuity)、完整性(completeness)、准确性(accuracy)。连续性反映组装的重叠群或骨架的总数与大小分布,即组装是由少数大片段组成或由许多小片段构成。它可以通过长度的中位数或平均值表示,但常用参数是N50或N90等。为计算重叠群N50,先把所有重叠群按长度从大到小排列,然后从最大重叠群开始往后加上后一个重叠群的长度,累加得到的总长度达到所有重叠群总长度的一半时的那条重叠群长度为N50的长度(图13-9)。该值越大说明组装效果越好。例如组装得到6个重叠群,其总长度为270(70+60+50+40+30+20),则其一半为135(270×50%)。当重叠群从大到小累加到第3个重叠群时,其长度180(70+60+50)大于所有重叠群总长度的一半(135)。因此,N50值为第三个重叠群的长度(50)。
如何计算N90或N75等?
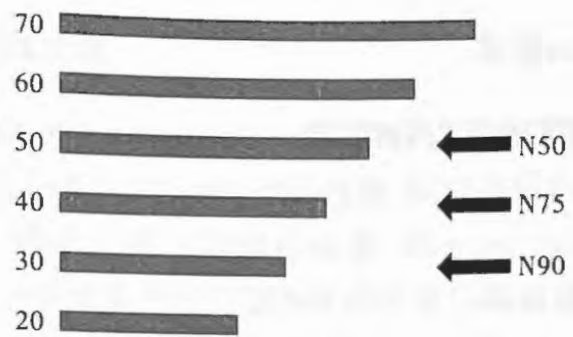
组装总长度不代表完整性,为计算完整性,将原始的读段比对(map)到组装后的重叠群或骨架序列,然后计算比对上的读段占总读段的比例,该值越大说明组装效果越好,一般需要大于90%。
为计算组装的精确性,组装序列可以比对(map)到同一个物种的高质量参考基因组序列,然后比较两个方面:碱基精度(base accuracy)与比对精度(alignment accuracy)。碱基精度评价在一个位置上是否为正确碱基,而比对精度检测一个序列被放置于正确位置与方向。如果不存在参考基因组,也可以把测序原始读段比对到组装序列上,并统计组装序列覆盖度的均一性与一致性(congruence),得到组装质量的估计值。另外,也可以使用同一个物种的基因或cDNA序列,将拼接得到的基因组序列比对(map)到基因序列上,统计基因区的覆盖度。
目前有一些工具,如 QUAST(Quality Assessment Tool for Genome Assemblies)可以评价组装质量,计算以上各种评价指标,并提供在线分析功能。国际基因组组装竞赛,根据多种指标,如组装速度、重叠群 N50、最大重叠群长度等,评估从头组装软件的效果。
NGS的短读长对组装有许多限制,加上其他因素,如测序错误、重复序列和覆盖区域不均匀等导致组装图中的不确定性(ambiguities),假阳性和路径分歧,过早终止重叠群延伸,使组装结果往往片段化。另外,由于嵌合(chimeric)连接会导致组装序列高的错误率。一般可用参考基因组,甚至亲缘关系远的物种参考,以克服这些问题。尤其当没有成对的测序读长可用时,参考基因组辅助(reference-assisted)的组装方法特别有效。随着第三代测序技术的读长增加,基因组组装的方法也将发生大的变革。
13.4 基因组组装实践
前面简介了下一代测序的从头组装的原理与方法,接下来我们将通过一个基因组组装实例,详细展示组装过程的操作步骤。这里我们选用酿酒酵母(Saccharomyces cerevisiae)基因组经Illumina Hiseq与PacBio测序的部分数据(Li et al.,2014),并选择用组装软件SPAdes进行组装。
13.4.1 Illumina reads 数据
建立工作目录,把所有数据都放在此目录:
1 | \$mkdir Assembly |
1 | \$cd Assembly |
再把测序数据复制到此目录。
1 | (1) Illumina PE(short):IDX7_1.fastq / IDX7_2.fastq |
1 | 读长(bp):2×100(2×代表两端测序读段) |
1 | reads数:1,766,886 |
1 | \$cat IDX7_1.fastq |grep "^@HWI" |wc -l |
1 | Insert size(bp):300? |
查看文件里有多少 reads,“cat”可以显示文件的内容,“wc -l”显示文件有多少行,FASTQ格式中每个read的序列信息都以@开头。
1 | (2)PacBio SE(long):pacbio_subreads_corrected.fasta |
PacBio测序仪出来的原始数据,一般会经过SMRT Analysis处理,如过滤掉SMRT系统接头等,产生FASTQ文件。
13.4.2 数据预处理
相对 NGS 的其他应用,从头组装对测序错误更敏感,因此从头组装前需要进行测序数据的质量控制,包括低质量读段过滤,以及切除读段中的低质量碱基(一般在 3’末端)、无法识别碱(N)或测序接头序列等。
Prinseq是由Perl语言编写的NGS质控程序,不需要安装,只要下载prinseq-lite.pl在本地目录就可以运行。
这里用prinseq过滤读段:
1 | \$prinseq-lite.pl -fastq IDX7_1.fastq -fastq2 IDX7_2.fastq -out_good IDX7_filtered -out_bad null -no_qual_header -min_len 50 -ns_max_n 3 -min_qual_mean 20 -trim_qual_left 20 -trim_qual_right 20 |
参数说明:
-min_qual_mean 20: 过滤掉 PE 中平均质量低于 20 的读段。
-min_len 50: 过滤掉短于 50bp 的读段。
-ns_max_n 3:未知碱基的数量。
-derep 1: 过滤重复读段。
命令过滤后产生两个配对 reads 的文件: IDX7_filtered_1.fastq, IDX7_filtered_2.fastq, 以及两个非配对 reads 的文件 IDX7_filtered_1_singletons.fastq, IDX7_filtered_1_singletons.fastq。
1 | \$spades.py --pe1-1 IDX7_filtered_1.fastq --pe1-2 IDX7_filtered_2.fastq --pe1-s IDX7_filtered_1_singletons.fastq --pe1-s IDX7_filtered_2_singletons.fastq --careful -o scer_illupe |
13.4.3 利用SPAdes组装
SPAdes(St. Petersburg genome assembler)是目前较好的基因组组装软件之一,而且使用简单。SPAdes主要用于小基因组(<100Mb)组装,如细菌或小的真核生物,但不适合大基因组测序数据的组装。该软件输入数据可以是 Illumina、IonTorrent 短 reads,或 PacBio、Sanger 长读段,也可以把一些重叠群序列作为长读段进行输入。可以同时接受多组 paired-end、mate-pairs 和 unpaired reads 数据的输入。
SPAdes 安装可从官网下载已经编译的可执行文件,或下载源码安装文件,手动进行安装:
1 | wget http://cab.spbu.ru/files/release3.12.0/SPAdes-3.12.0.tar.gz |
安装完毕后,在SPAdes-3.12.0/bin文件夹中包含一系列相关程序,如spades.py, metaspades.py(宏基因组装软件)。
使用 spades.py 软件对 Illumina 测序序列进行组装的命令如下:
–pe1-1/–pe1-2:编号为 1 的配对双末端文库(paired-end library)的左端与右端测序 reads;
–pe: 参数用于质量过滤后还是配对的读段, pe 后的数字 1 为文库的编号, 而后跟着配对读段的编号, 1 是左端 (forward), 而 2 是右端 (reverse);
–pe1-s:paired-end library 数据过滤后两端读段不能再配对的单个数据,就在同一个–pe参数后加-s标记;
1 | -o output_dir: 指定输出的文件夹; |
–careful: 通过运行 MismatchCorrector 模块进行基因组上错配 (mismatches) 和短的插入/缺失 (short InDels) 的修正, 推荐使用此参数。
命令运行结束后,在输出文件夹 scer_illupe 中产生许多文件,其中 scaffolds.fasta 是最终的组装结果,将其命名为 scer_illupe_scaffolds.fasta。
1 | \$cp scer_illupe/scaffolds.fasta scer_illupe_scaffolds.fasta |
SPAdes也可以进行不同测序平台来源数据的杂合组装。PacBio数据的平均读长比较长(~10kb),对组装后补gap、提高重复序列的组装结果比较好。–paebio参数可以加入PacBio数据(FASTQ格式)。注意,SPAdes并不能直接组装PacBio读段,仅用它们的长序列作为框
架,提高短读段组装的连续性。
$spades.py –pe1-1 IDX7_filtered_1.fastq –pe1-2 IDX7_filtered_2.fastq –pe1-s IDX7_filtered_1_singletons.fastq –pe1-s IDX7_filtered_2_singletons.fastq –careful -o scer_pacbio –pacbio subreads_corrected.fasta
这样在命令运行结束后,将文件夹 scer_pacbio 中的 scaffolds.fasta 命名为 scer_pacbio_scaffolds.fasta。
1 | \$cp scer_pacbio/scaffolds.fasta scer_pacbio_scaffolds.fasta |
想要得到一个满意的基因组,需要改变参数多次反复进行组装。数据预测处理可提高组装质量,如过滤 Illumina 与 PacBio 的低质量读段,除了去测序接头,还要过滤可能的污染序列。一般要求过滤后的有效 Illumina 读段的测序深度(depth)要达到 30×以上,才能有比较好的组装结果。尝试 SPAdes 的不同参数,如参数 -k 指定不同 K-mer 大小作索引。当仅用 PacBio 数据组装,可以用更高的重叠(overlap)域值,有助于提高 SPAdes 杂合组装的质量。
13.4.4 组装质量评价
QUAST(QUALity ASessment Tool for Genome Assemblies)是一个集成的组装结果评估软件,其中整合了MUMmer、GAGE、GeneMarkS等工具。QUAST运行速度很快,可以做有参考基因组的质量评价,也可以在没有参考基因组的情况下评估组装质量。
QUAST安装比较简单,直接下载解压就可以:
1 | wget https://downloads.sourceforge.net/project/quast/quast-5.0.0.tar.gz |
由于我们做的是从头组装(de novo assembly),就做没有参考基因组的质量评价:
$. /quast-5.0.0/quast.py scer_illupe_scaffolds.fasta scer_pacbio_scaffolds.fasta -o scer_quast 如果需要做有参考基因组的评价,只要加上参数(-r),加参考基因组的FASTA序列文件。
可以不加任何参数, 直接运行 quast.py 来察看其他的参数, 如 –glimmer, –contig-thresholds, –use-all-alignments 等。
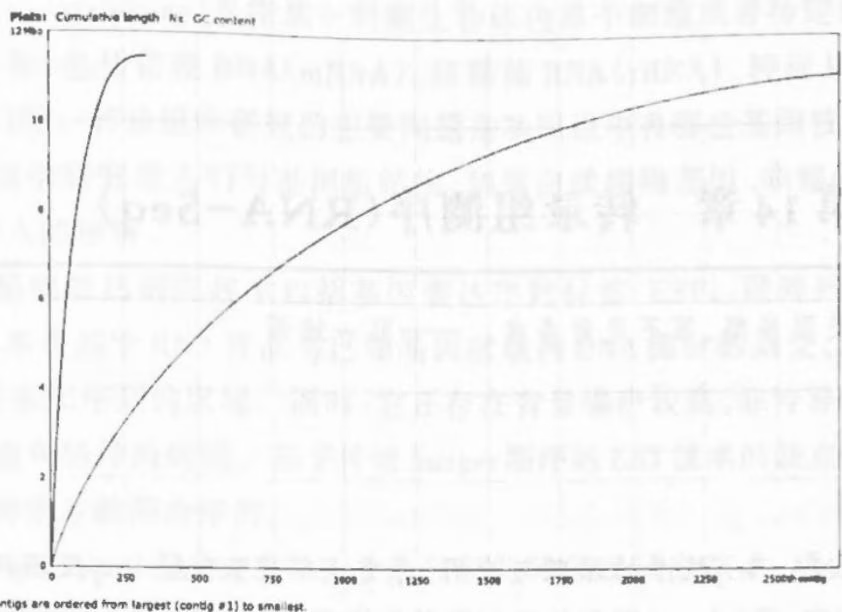
命令结果输出只要查看报告网页,阅读非常方便。在报告中有许多不同的组装质量评价结果。QUAST质量结果之一的累积长度(cumulative length),如图13-10所示,组装所得的重叠群按大到小排列后进行累加,纵坐标是重叠群的长度,而横坐标是重叠群的数量。
由图 13-10 可以看出, PacBio 杂合组装的结果相对 Illumina PE 组装的结果较好, 重叠群数量比较小, 而最长重叠群长度比较大。
习题
说明 reads, contigs, scaffolds, gaps, N50, N90 等名词的含义。
下载并安装 SPAdes 软件, 并用本书提供的数据, 用不同的参数进行基因组组装, 用 QUAST 评估组装结果。
第 14 章 转录组测序(RNA-Seq)
识不足则多虑,威不足则多怒,信不足则多言。——弘一法师
本章简要介绍 RNA-Seq 技术的原理与应用, 并重点阐述 RNA-Seq 数据的生物信息学分析方法和流程。
◎ 导学案例
微生物对营养物质的利用具有偏好性,当培养基中存在多种碳源时,微生物会先利用易于分解的碳源物质(如葡萄糖),再利用其他碳源(如半乳糖)。这种依次利用不同碳源是受碳代谢产物阻遏效应(carbon catabolite repression, CCR)的调控,严重阻碍了混合多糖的高效利用。要打破CCR效应,纠正微生物的“偏食”,就要从分子水平揭示它的作用机制。
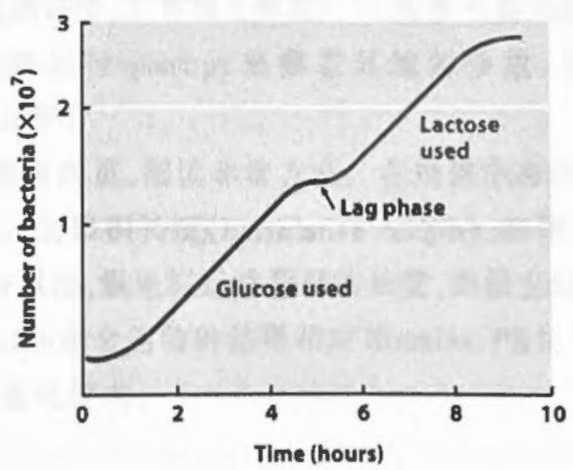
法国巴斯德研究所的著名科学家研究大肠杆菌在含有葡萄糖与乳糖的培养基中的生长现象,发现 E. coli 的生长曲线可以分为两个阶段,他称之为二次生长(diauxie)现象(图 14-1)。细菌消耗所有葡萄糖后会停止生长一段时间(约 15 分钟),当诱导出利用半乳糖的酶后又开始细胞生长分裂。Jacob 和 Monod 通过多年的努力终于揭示了 E. coli 二次生长现象的分子机制,并在 1961 提出乳糖操纵子学说(lactose operon),开创了基因表达调控机制的新领域。
转录组(transcriptome)是指某一时期生物体内单个细胞或者特定组织细胞中所有转录的RNA的总和,包括信使RNA(mRNA)、核糖体RNA(rRNA)、转运RNA(tRNA)及非编码RNA(ncRNA)等。转录组学研究的主要问题是基因组中有哪些基因被表达?其表达强度有多大?转录组学研究使人们对基因组结构,如蛋白质编码基因、非编码RNA基因和调控元件,有了更深入的理解。
传统的基因表达研究技术包括基因表达序列标签(EST)、微阵列芯片(microarray)等。Microarray技术是基于RNA样品与已知基因区域的DNA探针的杂交,依赖基因组的注释信息,不能检测未知序列的区域。同时,它还存在背景噪声较高,非特异杂交带来的无法分辨弱信号和过饱和信号的问题。基于传统Sanger测序的EST技术的缺点是其通量低、价格贵,只能检测到转录本的部分序列。
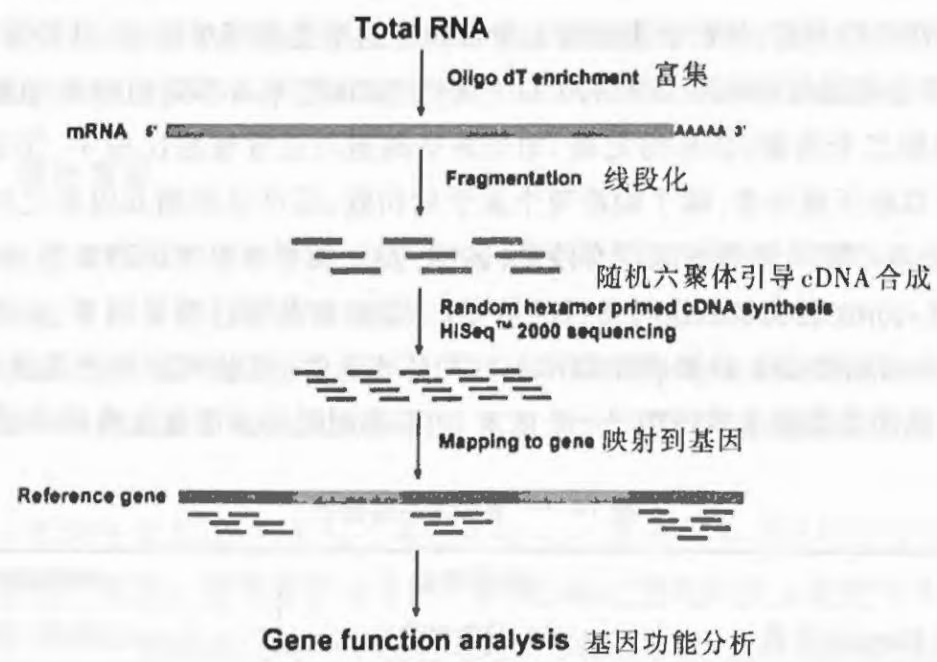
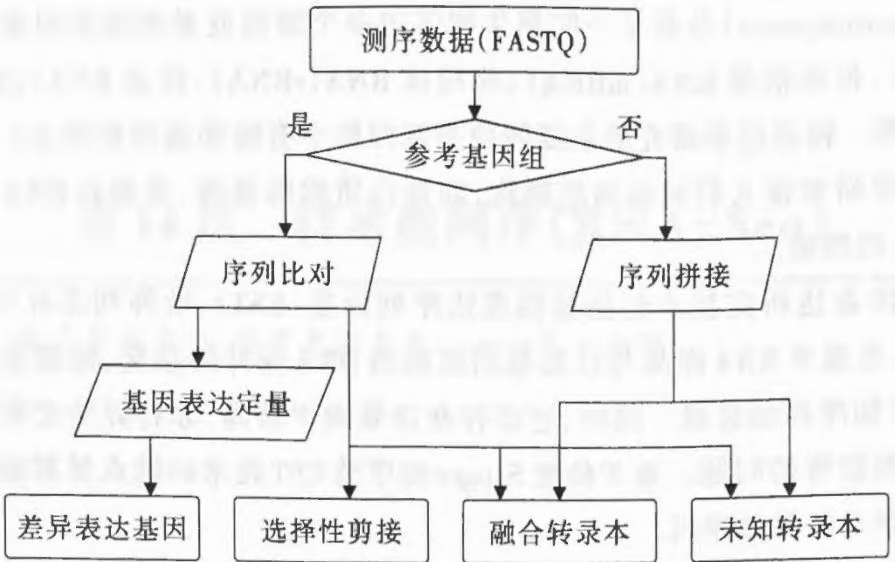
RNA-Sequencing(简称 RNA-Seq)是最新的转录组研究技术,通过将样本中提取的总RNA反转录成cDNA,后进行高通量测序并统计相关读段(reads)数,来确定样品中RNA的整体情况。对于真核生物mRNA测序(图14-2),用带有Oligo(dT)的磁珠富集mRNA,并将得到的mRNA打断成短片段,再以片断后的mRNA为模板,用六碱基随机引物(random hexamers)合成cDNA,后用于制备测序文库,构建好的文库用Illumina HiSeq 2000进行测序。对于已知基因组序列的物种,RNA-Seq方法不需要基因组注释信息,只要把样本的所有RNA测序reads比对到基因组,从而知道哪些区域表达;而且一个特定区域上总的测序reads数代表这个区域的表达活性,表达量越大,相应的测序读段数数就越多。RNA-Seq数据分析就是基于计算基因组不同区域的测序读段数数量的。由于转录本的读段数数量是离散的信号,不像microarray芯片是连续的信号,即使基因表达量相当高,RNA-Seq也不会像microarray一样有信号饱和的问题。另外,如果被测序物种没有参考基因组序列,则需要将所测短序列先拼接成转录本,再将读段数比对到转录本序列上进行分析(图14-3)。
RNA-Seq技术是发现新的转录本、选择性剪切(alternative splicing)和基因融合等转录现象的有力工具。ENCODE计划项目利用RNA-Seq研究发现,除了蛋白质编码区,人类基因组约 $75%$ 的区域可被转录。RNA-Seq也有助于发现非正常(noncanonical)的转录剪切事件,如环状RNAs。另外,因为RNA-Seq是可定量的数据,所以在系统生物学研究方面将有重要应用前景。
14.1 RNA-Seq实验设计及测序策略
14.1.1 实验设计
在 RNA-Seq 实验之前, 必须先要清楚待研究的生物学问题是什么。许多 RNA-Seq 实验是比较两个条件的转录谱, 如肿瘤细胞与正常细胞。这个是最简单设计, 只涉及一个因素(细胞类型)。单因子实验有时候也会有两个以上条件, 如比较来自不同组织的细胞特异性表达的基因。当把第二个因素(如药物处理)加到肿瘤细胞与正常细胞比较中, 实验将有 2 \times 2 组样品。在这个双因子设计中, 除了检测每个因子的功效, 还可以检测双因素之间的相互作用效果, 如药物处理可能对肿瘤细胞更有效果(表 14-1)。如果有更多的因素或条件, 总共会有 m \times n 组样品 (m 与 n 分别代表因素与条件的数量)。实验涉及超过两个因素, 如再增加时间因素, 同时在两个细胞类型上检测药物效果与时间的相关性, 实验将变得更复杂, 结果更难解释。因为任何基因变化都不能归功于一个因素, 而是基因间的多重相互作用的结果。
表 14-1 双因素实验设计
| 正常细胞 | 肿瘤细胞 | |
|---|---|---|
| 安慰剂(Placebo)对照 | 34(只为对照) | 18(单因子作用) |
| 药物处理 | 8(单因子作用) | 2(共同作用) |
任何需要统计分析的实验都需要重复与随机化。随机化指随机指定实验对象到每一个组,从而避免在实验收集过程导入非期望的偏差。为了把基因表达差异检测结果从观察的样品组外推到相应的总体,必须要有重复试验来估计组内每个基因的表达差异。重复实验数越多越好,一般要求至少有三次重复实验。然而差异表达基因也可以从没有重复的样品中观察到,但这个结果只限于这个观察的样本,因为缺少样本组内的表达差异信息,没法对一个研究总体下结论。
14.1.2 样品RNA准备
生物体的基因表达经常受一些内部因素(如组织类型、细胞组成异质性、发育阶段等)或外部因素(如各种环境胁迫等)的影响。因此,样品收集时要尽量减少无关因素的影响。如果有些影响因素不可避免,也要在每个组内都做到均衡分布。
准备 RNA-Seq 测序的样品, 要提取总 RNA 或 mRNA。由于总 RNA 中 rRNA 一般会占大多数 (约 90%), 所以在测序前先要去除 rRNA。去除 rRNAs 的方法有两种: 真核生物的 mRNA 一般有 polyA 尾, 可以通过 polyT 探针富集 mRNAs。另一个是通过去除 rRNA, 如商业核糖体 RNA 去除试剂盒 Ribo-Zero(Epicentre) 通过特殊的 RNA 探针结合 rRNA, 并由双链特异性核酸酶 (duplex-specific nuclease, DSN) 或 RNase H 来降解 rRNA-DNA 探针结合的产物。
除了 rRNA 去除,样品中 RNA 分子的降解也会导致错误的结果。RNA 完整性值(RNA integrity number, RIN)是判断 RNA 降解的常用指标。高 RIN 值代表没有或较低的降解,推荐用高质量的 RNA 样本(RIN≥8.0)来测序。由于 RNA 极易降解,提取高质量的 RNA 样本需要液氮冷冻(snap-freeze)组织样品保存。如果在田间采样,也可以用 RNA 稳定剂(如 RNAlater 等)。
其他实验因素也会影响 RNA-Seq 的结果。如基因组 DNA 的污染, 可以通过 DNaseI 处理提取后的 RNA 样本。许多 RNA 提取实验方法不能保留小 RNA, 如 microRNAs(miRNAs), Piwi-interacting RNAs(piRNAs)。如果要研究小 RNA 需要另外提取方法, 如 TRIzol 法。
14.1.3 测序策略
提取 RNA 后, 需要将 RNA 反转录成 cDNA 并连接上测序接头, 构建 RNA 测序文库。测序文库构建也会引入偏差, 此过程一般用 poly(T) 寡核苷酸结合真核 mRNA 的 3’ 端 poly(A) 尾, 造成 3’ 端偏好性。这个过程也排除了那些没有 3’ 端 poly(A) 尾结构的 mRNA 与非编码 RNA。如果需要研究这些 RNAs, 则需要通过去除 rRNA 方法或采用随机引物来进行反转录过程。
为方便后续测序读段比对,采用双端(paired-end)测序比单端测序更有益处,读段测的长度短一点也相对较好。测序时样品在测序泳道(lane)中的位置也会影响RNA-Seq结果,最好不同条件的样本都混合(multiplexed)到同一个测序通道,这样可以减少泳道与泳道间或flow cell与flow cell的差异。
RNA-Seq测序需要多少数据量是经常要考虑的问题。这个问题与许多因素有关,如基因组大小、研究目的等。一般如果要定量低丰度的转录本或检测选择性剪切变异体需要更多的测序量。通常来说,基因组越大,转录组就越复杂,需要的测序深度就越高。对于酵母这样简单的转录组,只要测定3000万条长度为35bp的读段数就足够观察到细胞中大多数(>90%)基因。而对人类基因组来说,需要有1亿条读段数(过滤后的)才能检测到80%表达的基因,而需要3亿读段数检测到80%的差异表达基因。值得注意的是,测序深度与样品重复数都能影响RNA-Seq的检测能力,两者在不同的水平起作用,前者在测序文库中随机抽取RNA片段,而后者是从不同的生物对象中抽样。有研究显示,增加样本重复数比增加测序量更有助于提高检测效果。
14.2 RNA-Seq数据分析流程
14.2.1 数据的质量控制
与基因组测序数据处理过程类似, RNA-Seq 数据分析的第一步也是质控(QC)。首先, 可用 FastQC 软件评估测序数据的质量, 如读段长度、质量值、无法识别碱基(N)的数量等。再利用预处理软件过滤低质量读段数(phred score<20)或切除测序接头(adapter)等, 从而得到有效数据(clandata)。
除了读段数数量、质量值分布等,RNA-seq还要检查其他质量指标,如总比对的reads的占百分比、rRNA读段数百分比、重复读段数比率和基因组覆盖度等。除了可用标准的NGS质控软件,RNA-Seq还有专门的软件RNA-SeQC、RSeQC等。
比对到基因组上的读段数占总测序读段数的百分比是一个重要 QC 参数, 它受许多因素影响, 如比对方法、所研究物种等, 这个数值一般要在 70%~90%。同样, 比对到 rRNA 区域的读段数的占比可以检测 rRNA 去除效率, 也受生物因素与技术因素的影响, 波动范围比较大, 从 1%~2% 到 35% 以上都有可能。下游分析前必须去除所有 rRNA 读段, 不然会影响后面的标准化。重复读段在 RNA-Seq 实验中经常发生, 有时在单次测序数据中占比可达 40%~60%, 可能由生物因素 (如少数高表达基因的读段会有很多) 或技术因素 (如 PCR 过量扩增) 造成。如何处理重复读段还没有定论, 因为它形成有生物因素, 不能简单去除重复读段。目前一般可以在建库前去除高表达基因或用末端配对读段测序可以减少重复读段数量。基因组覆盖度方面, RNA-Seq 质控软件一般会报告比对到基因内部 (intragenic) 的读段数与比对到基因间 (intergenic) 的读段数的比率。
14.2.2 读段定位到基因组(mapping)
RNA-Seq读段定位是比较复杂的问题,因为真核生物的mRNA一般是通过剪切内含子后连接外显子得到,许多读段不能直接连续比对到基因组上。目前有两种方法:一个是把当前的所有外显子注释放到一个转录本数据库,然后用RNA-Seq将读段比对到这个数据库;
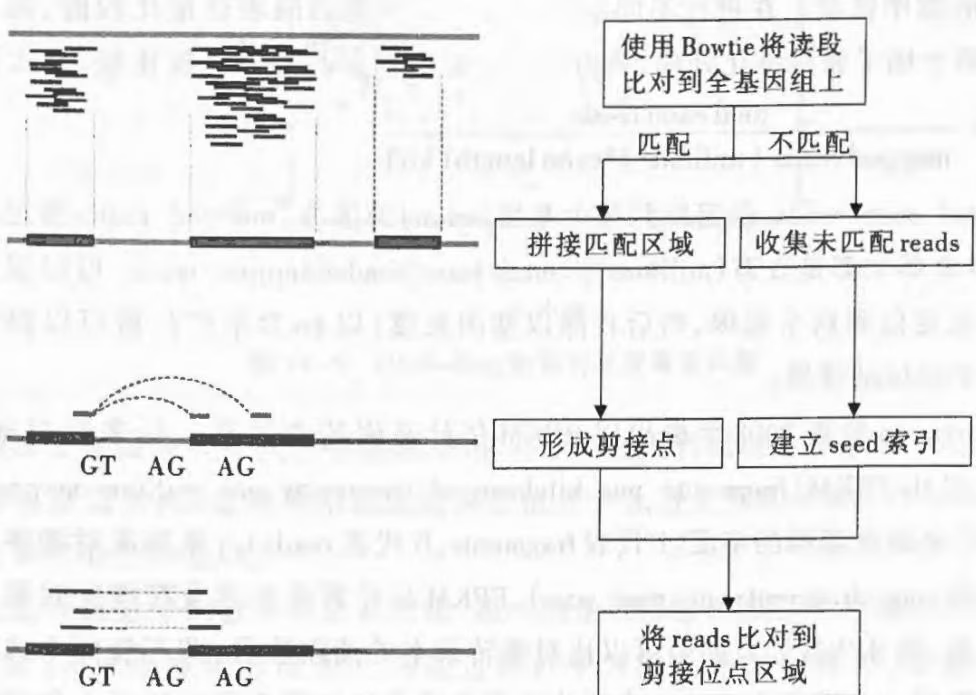
另一个是从头(ab initio)方法,不依赖基因注释,可以检测新的剪切连接点(spliance junction)。后者可以分成两类,一类是“exon-first”,即首先把读段能连续比对到基因组上(exonic reads first),然后在剩下的未定位读段中预测剪切连接点。例如Tophat就是利用这个方法(图14-4),其先调用Bowtie软件,比对到基因组,剩下的未匹配读段基于已知的内含子模式(GT-AG/GC-AG/AT-AC)进行短序列比对,比对速度较快。第二类算法采用“seed-and-extend”,先将读段分割成不同的子序列(K-mers),再进行比对过程,随后通过对可能的比对位点(hits)的延伸来定位剪切位点,如GSNAP等。
目前常用的转录组对比软件有Tophat2(图14-4)、Star、Hisat2等。
由于测序存在固有错误及基因组中存在SNP,所以所有比对软件通常都允许一定的错配。另外,基因组中一般存在重复及高度相似的片段,而且测序片段比较短,这会导致某些读段会比对到基因组多个位置上,影响最终读段的定位质量,后续分析可根据不同的研究目的,采取完全过滤或多重平均分配的方式进行处理。
如果研究的物种没有参考基因组序列,可以采用两种方法,一是利用亲缘关系相近的物种的基因组,二是从头(de novo)组装转录组,将所测短序列先组装成转录本,再将读段比对到转录本上进行分析。转录组从头组装的软件有Trinity、SOAPdenovo-Trans等,适合没有相关基因组的物种。值得强调的是,如存在序列相似度达85%以上的相关参考基因组,比对到相关参考基因组可以取得比从头组装相似或更好的分析结果,特别适合用于研究选择性剪切突变体。
14.2.3 数据标准化与定量
RNA-Seq广泛应用于估计基因或转录本(transcript)的表达量(abundance),并能比较不同样品或试验条件之间的基因表达差异。RNA-Seq估算基因表达量的基本思路是:如果一个基因转录更活跃,那么就会观察到更多的读段。基因表达定量一般有两种方法,①一种是直接统计比对到基因的读段的数目,计算每个转录本的平均读段数(estimated average read coverage,ARC)。通常情况下,只选取比对最好,而且只有唯一匹配位置的读段;②另一种是计算基因的RPKM(reads per kilobase of transcript per million mapped reads)值。要比较不同条件样品中的基因表达水平,至少需要考虑两个因素:测序深度与基因长度。如果一个样品被分成两半,其中一半的测序量是另一半的2倍,对同一个基因,在前一个样品测序数据中会有两倍的读段。同样,如果一个基因的转录本长度是另一个基因的一倍,那么长的基因会有两倍的测序读段。在进行不同条件样品和不同基因的表达量比较前,每个基因的读段数需用这两个因子做标准化处理,从而可以保证不同样品可以直接比较,公式如下:
1 | R P K M = \frac {\text { total exon reads }}{\text { mapped reads(millions)*exon length(kb)}} |
其中, total exon reads 是定位到某个基因(exon)的读段, mapped reads 指定位到基因组的总读段, 两者单位都是百万(millions)。total exon reads/mapped reads 可以视为所有读段数中有多少是定位到这个基因, 然后再除以基因长度(以 kb 为单位), 就可以得到基因单位长度内有多少定位的读段。
最初 Mortazavi 等在 2008 年提出以 RPKM 估计基因的表达量。后来针对末端 (paired-end) 测序又提出 FPKM (fragments per kilobase of transcript per million mapped reads) 比 RPKM 能更好地衡量基因的丰度 (F 代表 fragments, R 代表 reads)。末端配对测序的每个碎片会有两个读段 (one fragment=one read pair), FPKM 只计算两个读段都能比对到同一个转录本的碎片数量, 而 RPKM 计算的是可以比对到转录本的读段数量, 即不管两个末端配对是不是都能比对到同一个转录本上。一个碎片的两个读段比对到不同的转录本的情况是比较少见的, 可能是比对错误, 也可能是发生了转录本的融合之类的变异。
每一个基因有许多不同的转录本,而每一个转录本都有共同的外显子,这使我们对转录本进行表达定量分析有很大的难度。目前对转录本进行定量分析的软件有 DEseq、Cufflinks、StringTie 等。DEseq 是利用唯一能比对到每个转录本上的读段数量进行表达量的评估,而 Cufflinks 与 StringTie 是利用最大似然值模型进行表达量的评估。相对于 Cufflinks, StringTie 的分析速度更快,内存消耗也更少。
14.2.4 鉴定差异表达基因
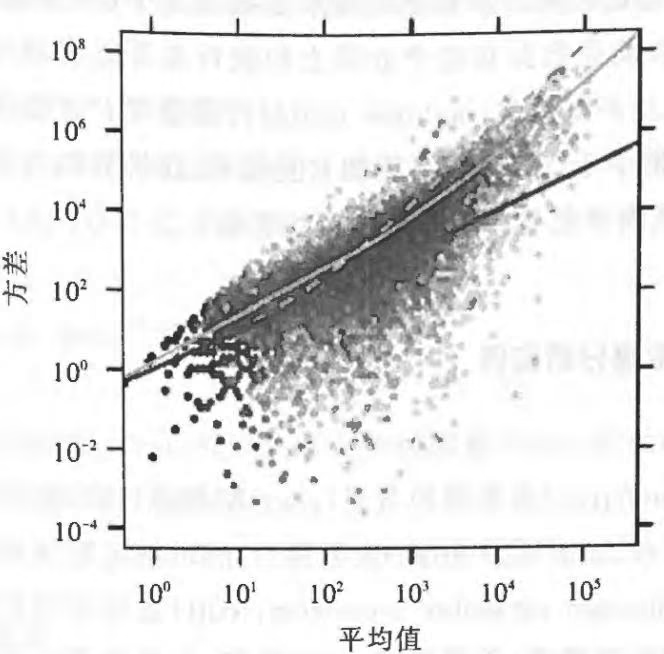
差异表达(differential expression, DE)分析是指鉴定在不同样品或条件之间, 平均表达水平发生显著变化的基因。要比较标准化后的不同组中的 RNA-Seq 基因表达量, 必须知道此数据的分布模型, 才可选择合适的统计检验方法。虽然芯片数据经转换后可以认为是正态分布, 但 RNA-Seq 数据是离散的, 即使转换后也不能认为是连续的分布。一般计数 (count) 数据, 包括 RNA-Seq 数据, 都服从泊松分布, 其特征是分布的平均值等于方差值。虽然此分布可以用来对 RNA-Seq 数据建模, 但其 RNA-Seq 数据中的方差比平均值增长更快,导致过度离散(over-dispersion)问题(图14-5)。为解决这个问题,可以应用过度离散的泊松分布或近似负二项式分布。
根据泊松分布或负二项式分布模型,判断基因表达是否在统计学水平上有差异,根据设定的差异基因筛选标准(通常采用表达差异比值大于2,校正后的P值小于等于0.05),从而筛选出满足条件的差异基因。
现有的差异表达分析软件可分两大类:第一类是以读段计数矩阵为起始文件,先进行标准化处理(如TMM标准化方法等),再通过统计学方法计算表达差异,这类代表软件有DESeq2,EdgeR等。DESeq2利用基于负二项式分布模型,采用基于广义线性模型(GLM)的检验来计算显著差异基因。第二类软件直接以FPKM、RPKM或TPM标准化后的数据进行表达差异的统计比较(如Cuffdiff采用T检验方法),代表软件为Cufflinks和Ballgown。目前差异表达基因的分析软件层出不穷,经证实采用不同的软件和方法分析得到的结果都会不同,甚至相同的软件不同的版本分析的结果也会存在差异。因此在实际应用时,都应详细记录所用的软件和版本号,对于关键性的实验可以综合分析多种方法的结果。
14.2.5 差异表达基因的功能分析
鉴定的差异表达基因还要进行功能分析从而有助于理解生物学问题。功能分析可以在不同层面进行,如基因本体(gene ontology, GO)、生物途径(pathway)和基因网络(network)。目前有许多工具可以做这种分析,如DAVID是分析差异基因的功能富集的著名软件,可以做GO标准词汇(GOterm)注释与生物途径富集分析。基因网络分析的工具有Cytoscape,可以通过利用已有的RNA-seq实验数据建立基因共表达(co-expression)基因网络,或利用STRINGS等数据库数据构建蛋白质相互作用网络等。
功能富集分析采用一种称为超几何分布(hypergeometric distribution)的概率算法。通过
Fisher精确检验,描述两个集合中是否符合同一分布的概率。在转录组数据分析中,参考数据的集合即背景数据,通常以所有的表达基因作为背景,并以不同样品间所鉴定的差异基因作为前景基因数据集。通过计算前景数据与背景数据在某个GO或者Pathway分类中的超几何分布关系,可以得到该前景数据在这个分类上的统计显著差异概率(P值)。由于多基因数据的富集分析过程涉及多重检验(multiple testing),需要对P值做校正。一般功能富集的筛选标准为校正后的P值小于0.05。校正后的P值越小,前景数据与背景数据的差异就越显著,表明所关注的前景基因可能与该功能分类密切相关。
14.3 RNA-Seq 数据分析实践
氮源可分为偏好(preferred)型氮源和贫乏(poor)型氮源。在含不同氮源的培养基中,酵母细胞的生长速率差别较大(代时从2h到6h不等)。酵母细胞对不同氮源的选择性利用主要是受氮代谢物阻遏(nitrogen catabolite repression, NCR)效应的调控。当培养基中存在较易被酵母细胞利用的偏好型氮源(谷氨酰胺、天冬酰胺、谷氨酸等),会强烈抑制酵母细胞中利用贫乏型氮源(尿素、脯氨酸等)相关基因的表达。只有当偏好型氮源被完全耗尽后,NCR敏感(NCR-sensitive)基因的表达量才会增加,酿酒酵母才能开始利用培养基中的非偏好型氮源。NCR效应是酵母细胞为了更好地适应环境中氮源变化,减少能耗,利于自身生存的一种调控机制。
本实验所用的数据为酿酒酵母在不同氮源培养基中培养后进行mRNA测序的数据(表14-2)。对照数据(Scer_urea)是酿酒酵母在尿素为唯一氮源的培养基的样品(尿素为对照氮源,不会引起NCR反应);而实验数据(Scer_arg)是在精氨酸为唯一氮源的培养条件下的表达数据(精氨酸是酵母菌的偏好性氮源,会引起NCR反应)。测序平台为Illumina HiSeq2500,对带PolyA的mRNA进行双端(paired-end)测序(2×100nt)。测序方案为非链特异性(unstranded),因此转录物的方向是不确定的,即不确定读段要比对到双链DNA的哪一条链。
表 14-2 RNA-Seq 分析的数据集
| 数据 | 文件 | 说明信息 |
|---|---|---|
| 参考基因组序列及基因信息a | genome.fa/genes.gtf | 酿酒酵母的基因组序列及基因注释文件(GTF) |
| 测序数据b | scer_arg_R1.fq/scer_arg_R2.fq | 精氨酸为氮源的样品 |
| scer_urea_R1.fq/scer_urea_R2.fq | 尿素为氮源的样品 | |
| 接头序列c | adapter.fa | Illumina测序接头序列 |
a: 参考基因组序列及 GTF 文件可从 ENSEMBL 数据库获得。
b: 一个好的 RNA-Seq 实验设计至少需要 3 个生物学重复。此练习每个样品只有一个数据,以加快程序运行速度。
c: 更多关于接头序列信息, 可查阅 https://support.illumina.com/sequencing/documentation.html。
1 | \$cat scer_arg_R1.fq |grep “^@” |wc -l 1441645 |
14.3.1 准备测序数据
将本练习所需要数据文件(见表14-2)都复制到一个目录ch16RNAseq。
$cd RNAseq
$ll -h(注:小写字母“L”,不是数字“1”)
可以看到4个FASTQ文件,PE测序会分别测定每个cDNA片段的两个末端。因此一个样品会有两个配对的FASTQ格式文件,对应左端与右端序列的测序读段,如scer_arg_R1.fq与scer_arg_R2.fq。
查看文件里有多少读段,“cat”可以显示文件的内容,“wc -l”显示文件有多少行,FASTQ格式中每个读段的序列信息都以@开头。
在进行下一步分析之前,需要对测序数据进行质控与预处理。
14.3.2 比对数据库
RNA-Seq 分析要把原始序列与基因组或转录组参考序列作比对。与 DNA 测序数据不同,将转录组测序数据比对到参考基因组上时,需要考虑基因中的内含子(intron)区域对比对过程的影响。比对软件要能够处理大片段的缺失(gap),用于跨过参考基因组中的内含子区域。目前常用的转录组比对软件有 Tophat, Star, Hisat 等。接下来我们用 Tophat 比对 reads 到酵母基因组。
(1) 安装 Tophat 软件
在 WSL 的 Ubuntu 中可以直接通过 APT 安装:
1 | \$sudo apt install tophat |
默认会安装 Tophat2 及 Bowtie2 等安装包。这里需要运行 Tophat2 命令,Tophat 无法在 WSL 环境运行。也可以从 Tophat 网站下载已编译好的软件包来使用。
(2) 构建基因组索引文件
运行 Tophat 之前,需要对参考基因组序列进行索引(index),以提高比对效率。可以用 Bowtie2 来完成:
$bowtie2-build genome.fa genome
genome.fa 是参考基因组的序列, genome 是输出的索引文件的名称。
Note
酿酒酵母的参考基因组序列及相关索引文件(Ensembl EF4 版本)可以直接到章末二维码中的网址下载。
(3) 运行 Tophat
Tophat2 是一个超快的、可执行可变剪接比对的工具,它的基本用法如下:
1 | tophat2 [options] <index_base> <read_1> <reads_2> |
本实验数据的运行命令为:
$tophat2 -p 4 –library-type fr-unstranded -G genes.gtf -o tophat_arg genome scer_arg_R1.fq scer_arg_R2.fq
-p 4 最多用4个进程。
–library-type fr-unstranded 测序文库的类型,如果读段有链特异性,比对结果将会有个XS标签。
-G genes.gtf 参考基因注释,有助于找到跨越剪切连接位点的未知序列比对。
-o tophat_arg 输出的目录。
genome 酿酒酵母的基因组索引。
大的实际数据,比对可能要花好长时间完成,但本测试数据比较小,只要差不多5分钟就会跑完。
Tophat运行完成后,检查输出目录:
1 | \$ll tophat_arg |
本例的tophat输出目录tophat_arg中有多个结果文件:
- accepted_hits.bam: BAM 格式文件保存序列比对结果。
- insertions.bed: BED 格式文件保存插入突变结果。
- deletions.bed: BED 格式文件保存缺失突变结果。
- junction.bed: BED 格式文件保存潜在 exon-exon 连接结果, 它提供了可能可变剪切体的位置信息, 以及比对到外显子的连接序列的读段数。
同样,运行另一个对照样本的数据:
$tophat2 -p 4 –library-type fr-unstranded -G genes.gtf -o tophat_uri genome scer_uri_R1.fq scer_uri_R2.fq
14.3.3 比对结果分析(Samtools与IGV)
(1) 利用 Samtools 查看 (Inspect with Samtools)
比对结果 accepted_hits.bam 文件, 是 SAM 格式文件经压缩后的二进制存储格式, 可能通过 Samtools 转换成人类可读的 SAM 格式。
1 | \$samtools view tophat_arg/accepted_hits.bam |more |
more命令查看文件,可通过按“q”键退出。
输出比对的序列数:
$samtools view tophat_arg/accepted_hits.bam |wc
输出至少有一个读段比对到基因组某位置的读段对的数量:
$samtools view tophat_arg/accepted_hits.bam |cut -f1 |sort -ulwc
可以通过Samtools自己的命令输出这些比对统计信息:
$samtools flagstat tophat_arg/accepted_hits.bam
1 | 690294+0 in total(QC-passed reads+QC-failed reads) |
有多少读段对比对到基因组,占总数的比例是多少?
(2) 利用 IGV 对比对结果进行可视化(View alignment in IGV)
首先,需要做 accepted_hits.bam 文件的索引,以加速存取,会得到一个文件 accepted_hits.bam.bai。
1 | \$samtools index tophat_arg/accepted_hits.bam |
然后就可以启动IGV, Windows下只要双击igv.bat就可运行IGV。
1 | 确保IGV左上角选中酵母基因组“SacCer3”。 |
IGV 菜单 “View->Preferences”,在标签 “Alignments” 中设置 “Visibility range threshold (kb)” 为 100kb。此参数设置 IGV 在基因组片段多长时才会显示读段与比对覆盖度 (coverage)。
现在导入.bam 文件(File->Load from File…)。
试试IGV的操作,先选择I号染色体显示测序读段,再把鼠标移动到Alignment track,并点右键,在跳出菜单中选“View as pairs”。通过右上角的Ruler放大或缩小,观察到基因的部分。鼠标移到单个读段可以看到更多有关比对的信息,其中“Pair orientation”指示测序读段是“stranded”或“unstranded”。在基因注释Track的右键菜单选择“Expanded”可以看到更多的基因剪切注释。
基因 CAR2/GAT1 是否有足够的读段覆盖?它有多少种已知的转录异构体 (transcript isoforms) 表达了?可以看到 Tophat 比对的“splice-junction-aware”方法的好处。
14.3.4 转录本组装与定量(Quantify Known Genes)
Cufflinks软件可以用于发现并定量转录本。它包括不同的程序,主程序Cufflinks可以将比对后的读段组装成转录本(transcript)。它可以在没有参考转录注释信息时,对组装的所有转录本进行表达水平定量;也可以在有参考基因注释信息时,只对已知的基因进行定量。
本练习只考虑有已知基因的表达量定量。
Cufflinks 安装可以从官网下载已经编译好的可执行文件, 解压文件后可以看到 Cufflinks 包括一系列程序, 如 Cufflinks, Cuffdiff 和 Cuffcompare 等, 可直接运行。为了方便在任意位置执行, 还需要把 Cufflinks 可执行程序的路径加入系统环境变量:
1 | export PATH=$PATH:/mnt/c/test/cufflinks-2.2.1.Linux_x86_64/ |
用以下命令运行 cufflinks:
1 | \$cufflinks -p 4 -G genes.gtf -o cufflinks_arg tophat_arg/accepted_hits.bam |
参数-G(–GTF)提供参考基因注释。(注意大写字母G只鉴定已知转录本的表达量,另一个参数-g代表鉴定除已知转录外的转录本。)
1 | \$ll cufflinks_arg |
Cufflinks 输出多个文件, transcripts.gtf 是基因注释文件。可以导入 IGV 中 (“Load from file…”), 显示在一个新的 track, 可以与参考基因注释比较, 查看是否有新的转录本。这里通过酵母的精氨酸代谢 CAR2 基因来观察 Cufflinks 对基因转录本的组装情况。
另两个输出文件 genes.fpkm_tracking 与 isoforms.fpkm_tracking 包括基因(一个基因的所有转录本合并一起)或转录本的表达量。表达量的计量单位为 FPKM。
1 | \$less -S cufflinks_arg/genes.fpkm_tracking |
genes.fpkm_tracking是基因表达量计算文件,其中第10栏是FPKM值,行按字母升序显示。为寻找样本中有最高表达量的基因:
1 | \$sort -n -k 10 cufflinks_arg/genes.fpkm_tracking |
isoforms.fpkm_tracking是转录本的表达量计算文件。Cufflinks通过复杂的算法确定一个基因的不同转录本的各自表达量。
1 | \$cat cufflinks_arg/isoforms.fpkm_tracking|grep -w "GAT1" (注意:基因名,大小写敏感!) YFL021W - - YFL021W GAT1 TSS6346 VI:95965-97498 1533 4.75909 76.9045 50.5672 103.242 OK |
哪个转录本是基因的最高表达的?此结果与前面的观察结果是否一致?(酿酒酵母可能很少有不同转录体。)
至此,我们已经看到 RNA-Seq 可以有效分辨不同剪切体,加上它又可以发现新的转录本甚至突变,相比 Microarray 有很大的优势。
14.3.5 鉴定差异表达基因
最后根据泊松分布或负二项分布模型,判断基因表达是否在统计学水平上有差异。根据设定的差异基因筛选标准(通常采取差异比值大于2倍,校正后的 $P$ 值小于等于0.001为显著性差异),鉴定差异表达基因。Cufflinks中的Cuffdiff程序可以鉴定差异表达基因。Cuffdiff鉴定差异表达基因只需要几个简单参数,一个基因注释文件(gtf),可以是前面Cufflinks组装的或已经有的注释文件。另外是待比较不同样品的 bam 文件。比较本实验用的对照样品 (Scer_urine) 与实验样品 (Scer_arginine) 测序数据的比对结果,在不同氮源下的基因表达差异。这里只用一个样本数据,对一个可靠的 RNA-seq 分析最好要有 3 个重复实验数据。
1 | \$cuffdiff -p 4 --library-type fr-unstranded -o cuffdiff_out -L urine, arg genes.gtf tophat_uri/accepted_hits.bam tophat_arg/accepted_hits.bam |
如果有重复数据,不同重复样品 bam 文件间用逗号(,)分隔,如果用空白分隔可被当成不同的独立条件数据。
1 | -L后为不同样品的名称,名称不要只用“T/N”(R会认为“True/False”)或只用数字。 |
运行结束后,Cuffdiff输出许多文件,包括基因或转录本差异表达的统计信息(gene_exp.diff与isoforms_exp.diff)。
1 | \$ll cuffdiff_out |
gene_exp.diff是文本文件可以用Excel找开查看,或可以用下面命令来查看:
1 | \$less -S cuffdiff_out/gene_exp.diff |
其中第10列是folder change(log2), 12列是 $P$ 值, 最后一列(14)是差异是否显著。下面命令可以显示显著差异表达基因, 并按基因名降序输出, 保存到文件(DE_genes.txt):
$grep yes cuffdiff_out/gene_exp.diff|cut -f1,10,12|sort -n -k 1$ $awk ‘{if($14 == “yes”)print $0}’ cuffdiff_out/gene_exp.diff>DE_genes.txt$
这两个样品的差异表达基因列表里有没有你前面看的基因或你感兴趣的基因?
14.3.6 用 CummeRbund 对差异表达基因可视化
最后可以用 R 语言的 CummeRbund 包对 Cuffdiff 结果进行可视化分析,生成差异表达基因的热图。
1 | 首先要从 Bioconductor 安装 CummeRbund 包: |
7126 genes
7126 isoforms
7070 TSS
6692 CDS
7070 promoters
7070 splicing
6692 relCDS
下一步就可以作差异表达基因的热图:
1 | > gene_diff <- diffData(genes(cuff_data)) |
1 | >myGeneIds<-gene_diff_top$gene_id #得到基因的ID |
分析结果热图如下图 14-6 所示:
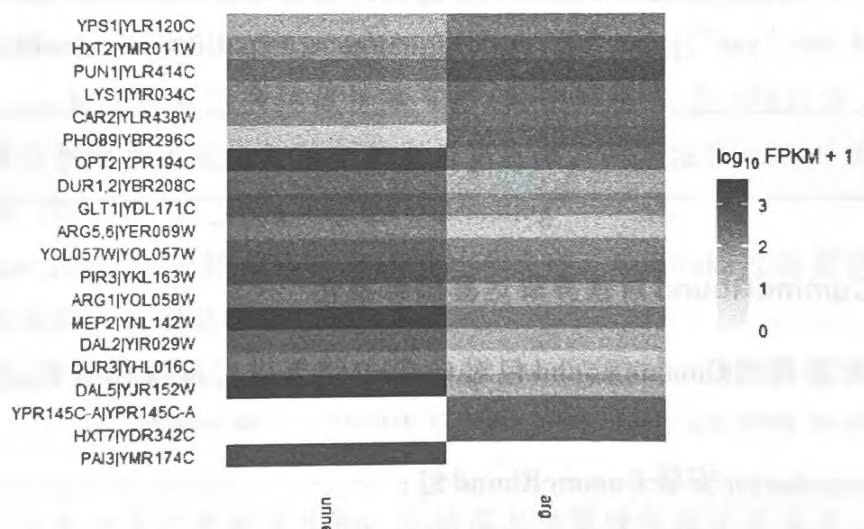
习题
简要说明 FPKM 值的概念与计算方法。
下载并安装 Tophat2、Bowtie2、CUFFLINKS 等软件,并用附件的数据进行 RNA-Seq 分析,掌握软件的常用参数,以及结果文件的格式。
尝试在 R 语言中安装 CummRbund 包,并绘制差异表达基因的热图。
第五章 基因组学
本章提要
基因组学是随着20世纪末DNA测序技术的出现和不断发展而产生的一门新兴前沿交叉生物学学科。基因组学的产生和发展引发了生命科学、医学、农业、生物技术、系统生物学等众多领域科学研究
的一场技术革命,促进了人们对复杂生命现象、生物系统等的理解。基因组学与转录组学、蛋白质组学、代谢组学等多组学分支共同构成了系统生物学的组学基础,使生命科学的相关研究进入了全面基因组时代。本章主要概述基因组学的基本概率、产生和主要研究进展;重点介绍基因组中蛋白质编码基因、RNA基因、重复序列和假基因的几种常用注释方法,并以黄瓜基因组为例说明基因组注释的整个流程。
20 世纪末 Sanger 测序技术诞生以后,科学家已有能力对单个生物的基因组进行测序,为研究单个生物的全部遗传信息奠定了基础,使生命科学相关学科从研究某个生物的单个基因或一些基因转向研究一个生物的所有基因,即基因组,由此形成了一门现代生命科学领域中的新兴前沿学科——基因组学。随着第二代和第三代高通量测序技术的快速发展,测序能力大大提高,DNA 测序成本的减少超过两个数量级,越来越多的生物已完成基因组测序。截至 2021 年 12 月,一共有 437 531 个基因组测序计划,其中 327 504 个基因组已经完成测序并向公众发布。雄心勃勃的基因组 10K 计划,更是致力于测序 10 000 个脊椎动物物种,并覆盖脊椎动物的所有属。因而,全面基因组时代的来临将给生物医学、遗传基因组学、功能基因组学及比较基因组学的研究带来新的契机。
我们知道,准确的基因组注释对于依赖基因组信息的研究工作是至关重要的。基因组注释的目标是尽可能地确定基因组中每一个核苷酸的生化和生物学功能(Brent,2008)。一个完整的注释包括在基因组中鉴定出其各类功能元件,如编码蛋白质的基因、RNA基因、重复序列和假基因等,并确定这些元件所对应的生物学功能(如果存在的话):①确定蛋白质编码基因及其外显子-内含子结构(也称为基因结构),并推断其生物学功能;②进行RNA基因的预测,并推断其功能和相互作用靶标分子;③确定基因组中重复序列的含量和分类;④进行假基因的识别和分类等。目前,人们的注意力多集中于蛋白质编码基因的注释,并已经开发了各种各样的预测方法。但即使如此,对于大多数真核生物来说,我们仍无法确定每个基因的正确的外显子-内含子结构。同时,随着基因组学相关研究的深入,RNA基因、重复序列、假基因等元件的重要性正被人们日渐重视,新的预测方法也在不断地推出。总体来说,自从分析人类基因组第一份草图以来,基因组注释的研究到目前已经有了很大的进步,特别是通过整合不同的计算和实验方法,已经能够进行比较全面而准确的基因组注释。
第一节 基因组学概述
“基因组”(genome)是指生物体的单倍体细胞中所有遗传物质的总和,包括细胞核内的DNA和各种细胞器中的DNA,是生物体内全部遗传信息的集合。基因组学(genomics)由美国科学家Thomas H. Roderick在1986年首先提出,是从整体水平研究生物体全部遗传物质的结构、组成、功能及进化的生命科学前沿学科。按其研究内容,基因组学可分为结构基因组学(structural genomics)、功能基因组学(functional genomics)和比较基因组学(comparative genomics)等。结构基因组学以研究生物全基因组DNA的序列组成和基因数目、功能和分类为目标;功能基因组学以研究全基因组水平的基因表达和调控为目标;比较基因组学则基于结构基因组学和功能基因组学信息,以研究不同物种或群体间基因组变化与进化关系为目标。
一、基因组学的产生
1977 年,Sanger 等提出链终止法测序方法(又称 Sanger 测序法),并完成噬菌体 $\Phi X174$ 全基因组测序,这是第一个被测定的基因组。DNA 测序技术的发明揭开了基因组学的神秘面纱。随着基因组测序工作的开展,迫切需要对大量基因组数据进行处理和解析,基因组学应运而生。1981 年,第一个完整的真核细胞器(人类线粒体的基因组)完成测序;1992 年,第一个真核细胞酿酒酵母Ⅲ染色体完成测序;1996 年,第一个真核生物酿酒酵母的完整基因组完成测序;2000 年,模式植物拟南芥的基因组完成测序;2001 年,人类基因组计划(HGP)人类基因组草图公布。在过去 30 年里,DNA 测序技术不断革新和发展,由以 Sanger 测序法为代表的第一代测序技术发展到了以 Illumina Solexa、Roche 454 和 ABI Solid 为代表的第二代高通量测序技术,以及以单分子测序和纳米测序为代表的第三代高通量测序技术。DNA 测序片段长度和测序通量不断提高,测序成本显著降低。高通量测序技术的诞生在基因组学研究领域具有里程碑意义,基因组学因此得到迅猛发展。

二、基因组学研究的成就
基因研究是20世纪生命科学研究的一条主线,在过去的一个世纪里,生命科学研究取得了迅猛的发展。图5-1中标注了20世纪基因组学和遗传学研究发展历程的里程碑,是
图 5-1 遗传学和基因组学研究的里程碑(Collins et al., 2003)
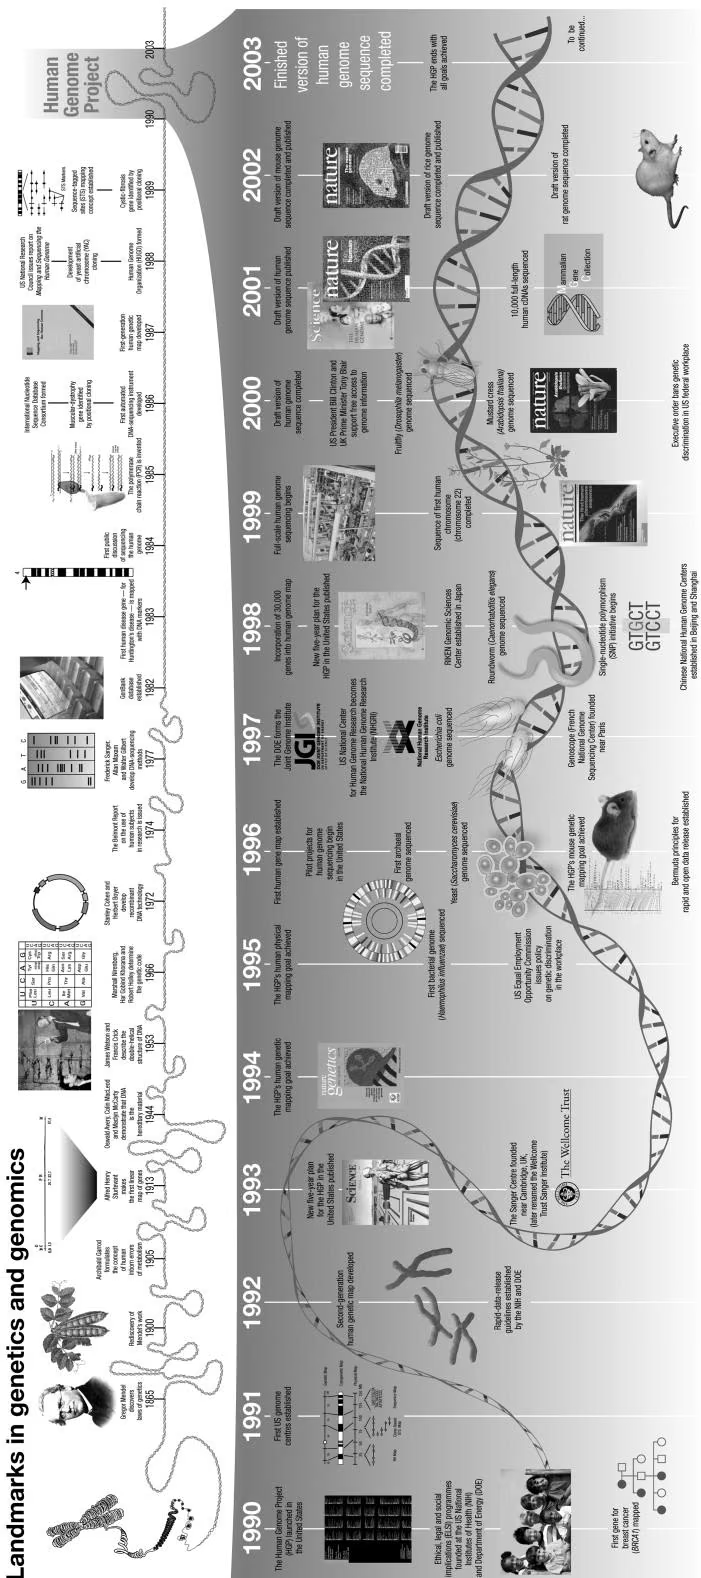
Nature 杂志为纪念 Waston 与 Crick 提出 DNA 双螺旋结构 50 周年,在 2003 年 4 月 24 日(Vol:422)刊发的基因组研究成就图谱(Collins et al.,2003)。由图 5-1 可知,20 世纪初,生命科学研究是以遗传学为代表:1900 年孟德尔遗传定律确认,1913 年 Alfred Henry Sturtevant 绘制出第一张线式基因图谱,1929 年 Phoebus Levene 提出 DNA 的化学成分和基本结构,1944 年 Oswald Avery、Colin Macleod 和 Maclyn McCarty 指出 DNA 是遗传信息的载体,直至 1953 年 Waston 与 Crick 提出 DNA 的双螺旋结构,生命科学研究走过半个世纪的辉煌。在下半个世纪,生命科学研究以分子生物学为代表:1966 年 Marshall Nirenberg、Har Gobind Khorana 和 Robert Holley 阐明了遗传密码;1972 年 Herbert Boyer 和 Stanley Cohen 提出了重组 DNA 技术,发现改造后的 DNA 分子可在体外细胞中复制;1983 年 Kary Mullis 发明了聚合酶链反应(PCR)技术;1990 年美国正式启动人类基因组计划,使生命科学研究达到了前所未有的深度和广度。
图 5-1 的下半部分是人类基因组计划的里程碑。人类基因组计划是一项规模宏大,跨国跨学科的科学探索工程,被誉为生命科学领域的“阿波罗”计划,是20世纪最重要的科技计划之一,是人类生命科学史上最伟大的工程之一,是人类第一次系统、全面地解读和研究人类的遗传物质DNA。2000年,国际人类基因组计划的科学家发布了人类基因组的“工作框架图”;2003年,国际人类基因组计划宣布绘制完成了更加精确的人类基因组序列图;2006年5月18日,英国和美国科学家宣布完成了人类1号染色体的基因测序图,已经进行了16年的人类基因组计划至此画上了圆满的句号。随着人类基因组计划的顺利完成,基因组学的广泛应用和迅猛发展拉开了序幕,随后基因组测序计划在各种生物中相继展开。例如,以拟南芥和水稻基因组计划的完成为标志,植物生物学和遗传学研究进入了基因组学时代。
人类基因组计划的重大研究成果——人类基因组序列图的完成,宣告了生命科学随着新世纪的到来进入了一个新的纪元,即后基因组时代(post-genome era)。功能基因组学成为了基因组学研究的重心,而蛋白质组学则是功能基因组学的核心。2001年2月,Nature和Science在公布人类基因组序列草图的同时,分别发表了“And now for the proteome”(Abbott, 2001)和“Proteomics in genome land”(Field, 2001)的述评与展望,对蛋白质组学研究发出了时代性呼唤。自人类基因组计划完成以来,基因组学在农业、医学、生物技术、环境、工业等许多领域都得到了应用,如基因诊断、基因治疗、新药开发、个体化医学、功能基因发掘、环境因子干预等,创造出了巨大的社会和经济价值,造福于人类。
通过全基因组测序,人们可以获得物种的全基因组序列信息,从而为该物种后续的研究和产业化应用奠定基础。近年来,我国科研工作者在动植物基因组测序方面开展了大量工作。如2013年先后完成了地山雀和藏猪的基因组测序工作,2014年发表关于金丝猴基因组的论文,2015年发表关于四倍体陆地棉基因组的论文。
国宝大熊猫受到全世界人们的喜爱,是中国的象征,它也是世界上最濒危的动物之一。我国科学家在2010年首次完成大熊猫基因组测序工作并公布大熊猫基因组数据,在2021年对大熊猫进行重测序,获得了两个高质量的大熊猫亚种基因组。通过对该基因组的分析研究,发现大熊猫生殖基因某些元素的丢失和突变,可能是大熊猫这一物种的繁殖力比其他哺乳动物低的重要原因。
狼作为家犬的野生祖先,具有复杂的系统发育和群体历史。为了研究中国南方狼的系统发育地位和群体历史,我国科学家于2019年完成了其测序工作。研究人员发现,犬科物种间的基因交流在物种形成过程中扮演了重要的作用,也揭示出古DNA的研究方法对动物博物馆
馆藏样本有显著的研究意义。
温泉蛇能够适应高海拔的生存环境,是研究变温动物环境适应性的遗传机制的重要材料。我国科学家在2018年完成了世界上生存海拔最高蛇类——温泉蛇的基因组测序工作,利用比较基因组学分析,发现多个与免疫、低氧适应和DNA修复等功能相关的基因突变位点。例如,温泉蛇EPAS1基因的突变减弱了其调节下游基因红细胞生成素表达的能力,进而导致温泉蛇血红蛋白浓度处于较低水平,是温泉蛇适应高海拔低氧条件的重要原因。这些研究结果将为人类高原病的预防和治疗提供一定的参考价值。
小麦作为全球重要的粮食作物,养活了世界上 40% 的人口。2018 年我国科学家完成了小麦 A 基因组的测序,不仅为解析小麦基因组进化和驯化提供了高质量的基因组信息,而且对进一步推动栽培小麦的遗传改良具有重要理论意义和实用价值。
玉米是一种重要的粮食作物及经典的遗传模式植物。Mo17自交系是世界上最著名的玉米杂种优势群之一,其衍生材料在我国玉米生产中得到广泛应用。鉴于Mo17基因组的重要性,2018年我国科学家完成了Mo17的基因组测序和组装工作,并从基因组学层面对玉米自交系间能够形成特别显著的杂种优势的原因进行了分析。
在我国,水稻是最重要的粮食作物,国民三分之二的口粮都是水稻。由我国科学家主导的“3000份水稻基因组计划”研究成果于2018年发布,该研究剖析了水稻核心种质资源的基因组遗传多样性,为提升水稻基因组研究和分子育种水平以及加快优质、广适、绿色、高产水稻新品种培育提供了重要资源。
大豆是最重要的油料作物,2018年,我国科学家完成国审大豆品种‘中黄13’的基因组测序。2020年,为了研究大豆基因组的多样性,研究人员对26种代表性大豆进行了基因组测序,通过基因组分析,对2898个种质进行了基因分型,将遗传变异与重要性状的候选基因联系起来,促进了大豆的进化和功能基因组学研究,并将有力推进大豆分子设计育种。
2016 年,我国科学家利用纳米孔测序技术突破复杂基因组测序,在菊属植物研究中迈出了人类认知的重要一步,完成了高等植物中全基因组测序,并克服了之前在第二代测序技术时代解决不了的高杂合、高重复基因组组装的难题,可极大推动植物基因组,尤其是药用植物基因组研究的发展,是本草基因组学研究的一项重要突破。
睡莲作为早期被子植物类群,具有重要的进化地位和基础研究价值。2019年,我国科学家完成了蓝星睡莲的基因组测序工作,公布了高质量的睡莲基因组序列,通过分析其基因组与转录组发现了早期被子植物的进化特点和特征。睡莲基因组研究成果加深了人们对多倍化的认识,是被子植物演化研究一个重要的标志性工作。
三、基因组学研究的局限
面对庞大的遗传信息,人们开始关注这些序列信息与生命活动之间的直接或间接的联系。基因的功能是什么?它们又是如何发挥这些功能的?此即后基因组计划,又称为功能基因组学研究的内容。完成基因组全长序列的测定只是完成了第一步工作——结构基因组学,接下来要完成第二步工作——功能基因组学。正如美国杜克大学的西蒙·格雷戈里博士在2006年10月公布最后一个人类染色体(1号染色体)基因测序图时所说:“我们正迈入下一阶段,那就是弄清楚基因的作用及它们是如何相互影响的。”
尽管已有多个物种的基因组被测序,但在这些基因组中通常有一半以上基因的功能是未知的。而功能基因组研究中所采用的策略,如基因芯片、基因表达分析(serial analysis of gene expression,SAGE)等,都是从细胞中 mRNA 表达的角度来考虑,其前提是细胞中 mRNA 的水平反映了蛋白质表达的水平,但事实并不完全如此。
基因→mRNA→蛋白质,三位一体,构成了遗传信息的流程图,这是传统的中心法则。但 mRNA 的表达水平不能完全反映蛋白质的表达水平,原因有 3 个方面。①基因与蛋白质之间并非一一对应关系,一个基因并不只存在一个相应的蛋白质,可能会有几个,甚至几十个。什么情况下会有什么样的蛋白质,这不仅决定于基因,还与机体所处的周围环境及机体本身的生理状态有关,并且,基因也不能直接决定蛋白质的功能。②组织中 mRNA 的表达丰度与蛋白质表达丰度的相关性并不好。在 mRNA 水平上有许多细胞调节过程是难以观察到的,因为许多调节是在蛋白质的结构域中发生的。从基因到 mRNA 再到蛋白质,存在 3 个层次的调控,即转录水平调控(transcriptional control)、翻译水平调控(translational control)和翻译后水平调控(post-translational control)。经过 3 个层次调控的蛋白质还要通过一系列的运输过程,最终到组织细胞内适当的位置才能发挥正常的生理作用。许多蛋白质还要与其他分子结合后才具有活性,基因不能完全决定这样的蛋白质后期加工、修饰及转运定位的全过程。用 mRNA 的表达水平代表蛋白质的表达水平,实际上仅考虑了转录水平调控。研究已经证明,组织中 mRNA 丰度与蛋白质丰度的相关性不高,尤其对于低丰度蛋白质来说,两者的相关性更差。更重要的是,蛋白质复杂的翻译后修饰、蛋白质的亚细胞定位或迁移、蛋白质-蛋白质相互作用等则几乎无法从 mRNA 水平来判断。③基因组是静态的,而蛋白质组是动态的,与生物系统所处的状态有关。细胞周期的特定时期、分化的不同阶段、对应的生长和营养状况、温度、应激和病理状态等所对应的蛋白质组是有差异的。
第二节 蛋白质编码基因的注释
基因组测序产生海量的 DNA 测序数据,基因组学面对的一个最基本问题是将片段化的测序原始 reads 准确地拼接成完整的基因组(基因组组装),并解密基因组中的遗传信息(基因组注释),该过程需要结合计算机、数学、生物学等交叉学科的知识和技术。从 DNA 测序技术诞生以来,片段组装一直是基因组测序工作的研究重点和热点,其主要依赖于高效的计算机软件和算法。蛋白质在生物体的生命活动中具有十分重要的功能,因此在基因组测序完成后,首先就要对蛋白质编码基因进行注释。一个基因组大部分的生物学功能,主要是通过对预测出的蛋白质编码基因的功能进行推断获得的,这就使预测蛋白质编码基因成为人们(尤其是生物信息学研究者)关注的热点问题。
一、蛋白质编码基因的注释策略
蛋白质编码基因的注释大致可分为3种策略(图5-2)。第一种是基于证据的基因注释,即根据已有的实验证据(如cDNA)、表达序列标签(EST)和蛋白质序列进行蛋白质编码基因的注释;第二种策略是从头开始的基因预测,即只根据基因组的DNA序列对蛋白质编码基因进行预测;第三种策略是重新基因预测,即通过与其他物种的基因组进行比较,从而预测一个新基因组中的蛋白质编码基因。由于不同策略具有各自的优缺点,因此,目前成功的做法是将这3种策略的预测结果进行整合,得到比较理想的注释结果。
(一)基于证据的基因注释
基于证据(evidence-based)的基因注释系统,是将已有的 cDNA 序列或者蛋白质序列与基因组进行比对,从而得到基因结构的一种注释策略。根据 cDNA 或者蛋白质序列是否由一个基因自身转录或者翻译而来,可以将序列比对分为顺式比对(cis-alignment)和反式比对(trans-alignment)两种方法。
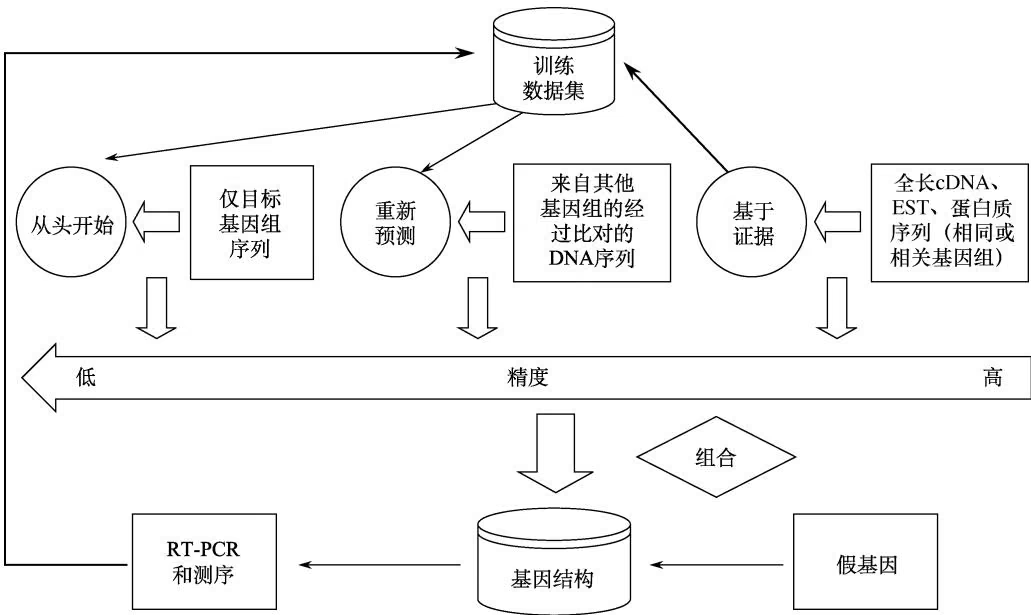
- 顺式比对 顺式比对是使用被注释基因组的 cDNA 或者蛋白质序列与基因组序列进行比对后得到的最好的比对位点,而这个位点常常被认为就是转录或者翻译形成 cDNA 或者蛋白质的基因。通常,顺式比对是使用全长 cDNA 与基因组进行比对,这也是目前基因注释的黄金标准(Brent,2008)。全长 cDNA 的克隆不仅受不同组织基因表达的特异性及表达量高低的影响,还受到转录产物长度、cDNA 文库构建及测序方法等多种因素的影响,因而真正能够覆盖完整 mRNA 的全长 cDNA 数量是十分有限的。因此,很多 cDNA 测序项目得到的大多数都是表达序列标签(expressed sequence tag,EST),也就是转录产物的片段。由于 cDNA 文库里不同的克隆可能含有同一个转录产物的不同部分,从而得到一个转录产物不同部位的 EST,所以把来自不同克隆的 EST 拼接起来可以弥补全长 cDNA 数量缺少的情况。
常用的顺式比对程序如 AAT、SIM4、Splign、BLAT、GMAP 和 Exonerate 等,不仅能将 cDNA 序列与基因组序列进行顺式比对,而且可以识别出内含子剪切位点。不过这些程序还存在着无法准确地刻画基因的非翻译区(untranslated region,UTR)部分和寻找正确的转录起始及终止密码子等缺点。通过 EST 序列试图阐明基因结构的软件有 Est2genome、PASA 和 TAP 等。其中,PASA 可以将聚类的转录产物片段(全长 cDNA 和 EST)拼接成最大比对片段,从而得到完整的或者部分的基因结构,并获得更多的可变剪切的信息。
- 反式比对 由于产生可靠的 cDNA 数据有诸多困难,一些基因组测序项目中往往不含有 cDNA 测序项目,因此缺乏相应的全长 cDNA 和 EST 等信息,这时就要采用反式比对的策略进行基因组注释(Brent,2008)。反式比对是使用 cDNA 或者蛋白质序列与基因组进行比对得到同源位点(比对所用的 cDNA 或者蛋白质并不来自这个位点,往往属于同一个基因家族)。cDNA 或者蛋白质序列可以来自本物种内同一基因家族的其他成员,也可以来自近缘物种。由于蛋白质序列相对于 cDNA 序列更加保守,因此往往是使用蛋白质序列或者翻译后的 cDNA 序列与基因组进行比对。Swiss-Prot、PIR 和 Refseq 是基因注释中常用的蛋白质比对数据库,据估计,50% 的基因可以通过与同源蛋白基因有足够的相似性来确定其基因结构。
BLAT、Exonerate 和 GeneWise 是常用的反式比对工具。GeneWise 是目前最主要的反式比对的程序,可以得到比较准确的基因结构,并且能够容忍一些测序错误,它是 Ensembl 自动基因注释系统的核心组成部分,已经完成了许多脊椎动物基因组的初始注释分析。GeneWise 预测结果相对比较保守,虽然会忽略一些真正的外显子,但是大部分预测出来的结果还是十分准确的。
单纯的基于证据的基因注释系统有两个主要的弱点:①许多数据库中的数据质量良莠不齐,会导致错误信息的不断传递;②如果数据库中不含有足够相似程度的序列,那么可能什么结果也得不到。此外,即使有较好的序列相似性比对,比对上的区域(可能的外显子)并不见得十分精确,因此,不能准确地确定其基因结构,同时在这个过程中小的外显子很容易被忽略掉。
(二)从头开始的基因预测
自基因组测序的概念被提出以来,一个明确的目标就是能够准确地进行从头开始(ab initio)的基因预测,即只依赖蕴含在 DNA 序列内部的信息来确定基因结构。这种想法来自人们希望能够用计算机模拟生物体内转录和翻译的信号识别过程,从而构建起一个体外的基因识别系统。虽然在原核生物和低等真核生物(如酵母)中确定可读框(open reading frame, ORF)相对比较容易(Brent, 2005),但是对含有大量内含子的高等真核生物来说,这个问题还远远没有解决。在高等真核生物的蛋白质编码基因预测过程中,从头开始基因预测软件虽然可以准确地预测高于 90% 的蛋白质编码碱基和 70%~75% 的外显子,但是其预测基因结构的准确性还不到 50%。这主要有两个方面的原因:①现阶段科学家对生物体转录和翻译法则的认识还有待进一步的提高;②现有的计算模型可能无法精确地模拟这个复杂的生物学过程。尽管如此,基因结构的计算模型使人们能够理解基本的生物学过程,并且可以确定出那些明显的基因组信号和特征(有显著统计学意义的),从而在未来合成生物学(见第十章)中对设计和构建新功能的基因提供一定的帮助。
从头开始的基因预测包括两个主要步骤,即蛋白质编码基因特征的识别和基因结构的生成(Brent,2007)。软件识别的蛋白质编码基因的特征大致可以分为组成特征(content sign)和信号特征(signal sign)。蛋白质编码基因的组成特征一般有:高 GC 含量、密码子组成、六联核苷酸(hexamer,6-mer)组成和碱基出现周期等,在这些信号中,六联核苷酸组成被认为是最能区分编码区和非编码区的特征。信号特征一般包括核糖体结合位点、内含子供体和受体剪接位点、内含子分支点、起始密码子和终止密码子、CpG 岛等。蛋白质编码基因特征可以通过多种方法被识别。这些特征被识别后,可以通过动态规划算法(dynamic programming)或者广义隐马尔可夫模型(generalized hidden Markov model,GHMM)来生成基因结构。广义隐马尔可夫模型既可以用于蛋白质编码基因特征的识别,还可以用于基因结构的产生,从而被许多从头开始基因预测软件所采用。1997 年发布的 Genscan 是一款里程碑式的从头预测基因软件,它整合了一系列方法用于蛋白质编码基因特征的识别,并最终使用广义隐马尔可夫模型产生基因结构,其准确性远远超过了同时代其他的从头开始基因预测软件。
(三)重新基因预测
重新(de novo)基因预测的策略是利用对照基因组(informant genome)与目标基因组的比对信息来进行基因预测(Brent,2007)。由于人们对生物体转录和翻译知识的认识有限,还不能完全仅通过基因组序列内的特征来模仿生物的转录和翻译过程,从而对蛋白质编码基因进行准确识别,因此人们考虑整合其他蛋白质编码基因的信息。随着基因组测序项目的不断进行,越来越多的基因组被测序,人们认识到可以利用自然选择所提供的蛋白质编码基因的信号来分析新的基因组。研究表明,两个或多个物种中的直系同源序列的突变频率和模式提供了宝贵的注释信息。蛋白质编码基因由于具有相对比较重要的生物学功能,因此在进化中大多数经受着负选择的作用,这就产生了两个指示编码蛋白质基因的重要信号:①由于沉默突变往往发生在密码子的第3位上,因此序列比对的空缺呈现以3为倍数的模式;②为了保证ORF编码的准确性,插入和缺失的序列长度也是3的倍数,如果有移码突变发生,这个可读框也常常被附近其他的插入和缺失修复,衡量这种现象的一个指标称为读框连贯性(reading frame consistency,RFC)。通过整合从头开始基因预测所识别的特征与基因组比对所得到的自然选择信号,可以识别出较保守的蛋白质编码基因,这就是重新基因预测的主要策略。
Twinscan、SGP2 和 SLAM 是一些利用双基因组比对信息的重新预测软件,Twinscan 和 SGP2 是第一批在性能上超越 Genscan 的程序。EXONIPHY、N-Scan 和 CONTRAST 是利用多基因组比对信息的重新预测软件。其中,CONTRAST 在人类和果蝇基因组分析过程中,通过使用多序列比对获得较大性能的提高,是目前分析人类和果蝇基因组最好的基因预测程序,并且有可能在线虫、植物和真菌基因组分析过程中也获得同样好的结果。
二、蛋白质编码基因注释的整合信息
由于注释所依赖的证据数量有限,从头预测和重新预测的结果可靠性又较低,因此将这些信息整合在一起可以得到更好的注释结果(Brent,2008)。
(一)人工整合
传统的整合方法是将已有的预测结果提交给专家手工完成,这样的人工注释在注释高质量的、已测序完毕的基因组中起着重要的作用。目前,NCBI reference sequences(RefSeq)数据库提供经过人工验证的多物种的高质量转录物,包括植物、病毒、脊椎和无脊椎动物。这些转录物和基因预测结果常常是依赖全长 cDNA 的可靠验证;同时,RefSeq 也包含使用 EST 和不完整 cDNA 比对到基因组序列上的预测结果。RefSeq 人工验证的预测结果的标识符号以 NM 开头,非人工验证的以 XM 开头。另外,目前一个最大的人工注释组是 Welcome Trust Sanger 的 HAVANA。HAVANA 整合表达序列的比对、Genscan 和 FGENESH 的基因预测结果于一体。在人类一段 30Mb 的基因组序列上通过 RT-PCR 实验,发现 HAVANA 注释几乎包括了所有的蛋白质编码基因。尽管人工注释十分精确有效,但由于其高成本的限制,目前仅用于几个核心的基因组。
(二)自动整合
自从人类基因组草图发布以后,通过计算的方法(如证据权重和动态规划算法)自动整合不同证据的注释系统开始得到发展,如Ensembl、OTTO和NCBI系统。自动整合的方法很多,最简单的是在每一个位置上选择最好的证据,这种方法需要首先构建一个从最可靠的到最不可靠的证据的等级结构。例如,Pairagon+N-Scan_EST是最简单的系统,它首先进行cDNA比对,然后用基因预测结果来填补cDNA比对;Ensemble也是基于证据等级结构,已成功应用于注释一些新的脊椎动物基因组。整合系统并不衡量所有可能的注释证据,只考虑其他程序产生的外显子-内含子的结构,包括从头预测或重新预测和基于证据预测系统产生的结构。它们从这些结构中筛选,或者组合来自不同结构的元件(如剪接位点)。整合系统通常使用待整合证据的相对可靠的概率模型,每一种证据的可靠性可以手动设置,也可以通过用已准确注释的结果进行训练。
整合系统策略所使用的原理是基于被多个程序预测出的外显子要比单个程序预测出的更加可靠这一信条。目前常见的整合系统有 GAZE、GLEAN、COMBINER、JIGSAW 和 Genomix,其中,JIGSAW 已在人类的 ENCODE 区域得到了目前最准确的整合结果。EVM 是 TIGR 开发的一套自动化基因注释系统,它通过使用一个非概率模型的权重整合证据系统(考虑了证据的类型和冗余程度)生成基因结构。通过在人类的 ENCODE 区域和水稻上对多个自动整合注释系统的预测结果进行比较,发现 EVM 与 JIGSAW 都具有相当好的特异性和敏感性。
目前人们仍不清楚,为什么整合结果总比多个预测程序预测的好。一种可能性是每一种预测程序都包含有随机错误,而两个不同程序生成相似的随机错误是比较罕见的。另一可能是,不同的程序都会预测出不同的好结果,将这些各自最好的部分整合重组在一起将在整个水平上产生出好的结果。
三、蛋白质编码基因的功能注释
预测出来的蛋白质编码基因包含着大量的未知功能信息。为了更深入全面地了解这些数据的意义,保证基因组数据的一致性和完整性,并推动对未知物种的探索,人们开发了各种生物信息学数据库。这些数据库涉及核酸和蛋白质序列、功能基因组学、蛋白质组学和生物大分子结构等方面的核心信息。生物信息学根据这些已有的证据,利用计算的方法来预测新测序物种的基因,并推测这些基因的功能。对预测的未知功能基因进行高通量功能注释主要是利用已知功能基因等信息来对新基因的功能做出推断(Brent,2008)。目前常用的主要方法是序列相似性比较法,除此之外,进化分析、亚细胞定位、结构基因组的研究与蛋白质组的研究等方法对于未知基因功能的注释也有非常重要的帮助。以上这些计算方法有效地减少了实验材料和时间的消耗,但是最可靠的功能鉴定还是通过实验方法得到的。
序列相似性分析基于“同源=功能相似”的假设。该方法将功能未知基因与数据库中的已知功能基因进行序列相似性比对,通过设立同源性指标(如 identity、E-value 等)寻找具有同源关系的已知基因,从而确定预测基因的功能。常用的数据库主要包括 NCBI 的 NT、NR(非冗余蛋白质序列数据库)、UniProt、InterPro、KEGG、KOG 等。虽然基于序列比较的最大相似法为功能预测解决了很多问题,但同时也存在着大量的错误,这些错误的根源在于相似比较没有有效地解决不同基因间进化关系所带来的问题,如趋同和趋异、重复(duplication)、基因缺失(gene loss)、水平基因转移(horizontal gene transfer, HGT)等。为了减少这类错误,可以通过选择合适或更加严格的同源性阈值(cut-off),并增加同源区长度的比例(coverage)等条件,但是这样的做法无法从根本上解决这个问题。
第三节 RNA 基因的注释
RNA 基因是指不编码蛋白质的基因,又称为非编码基因(non-coding gene, ncRNA),其编码产物为一条功能 RNA 分子(Griffiths-Jones et al., 2005)。最近几年的研究表明,ncRNA数量众多,是真核生物转录组的主要组成部分;此外,它们在高等生物的多种基因调控过程中发挥着重要作用,如 X 染色体失活、基因组印迹、转录激活过程中的染色质修饰、转录干扰及转录后基因沉默等。因此,注释 RNA 基因已成为基因组注释的一个重要组成部分。
最早发现的 RNA 基因是转运 RNA(transfer RNA,tRNA)和核糖体 RNA(ribosomal RNA,rRNA),这两类 RNA 对蛋白质合成过程至关重要。随后发现的 RNA 家族中,有一些的作用机制已比较清楚,如核内小 RNA(small nuclear RNA,snRNA)可组成剪接体(spliceosome),催化前体 mRNA 的剪接过程;小核仁 RNA(small nucleolar RNA,snoRNA)以碱基配对的方式指导 rRNA 的甲基化和假尿嘧啶化修饰;微 RNA(microRNA,miRNA)通过对特异的目标基因的转录产物进行调控,在发育过程中起到重要的作用(Meyer,2007)。虽然随着实验技术的提高和计算工具的出现,有越来越多的 RNA 类别被发现。近年来,长链非编码 RNA(lncRNA)和环状 RNA(circRNA)也渐渐走入了人们的视线。但为了结果可信,目前基因组水平上的 RNA 基因注释仍局限于寻找如上所述的几类结构已知的 RNA 基因家族的同源物。
与蛋白质编码基因的预测相比,RNA 基因的预测更为困难,原因如下所述。首先,RNA 基因缺少显著的编码结构,如起始和终止密码子、剪接位点等信息。其次,有功能的 RNA 基因的保守性更主要地体现在其二级结构上,使得 RNA 基因的预测不但依赖简单的核苷酸信息,还需要考虑 RNA 的二级结构,增加了计算复杂性。最后,与蛋白质编码基因能够通过其序列基序推断其功能相比,RNA 基因的序列信息并不足以对其功能进行推断。对于完备的 RNA 基因注释,至少要回答两个问题:①鉴定基因组中的 RNA 基因的编码区域;②推断其功能转录本,预测其功能,并寻找其相互作用伙伴。但相对于蛋白质编码基因的注释,RNA 基因的注释还处于起步阶段,对于大的基因组计划,一般只回答了第一个问题的一些子集,即预测作用机制比较清楚的 RNA 家族的同源物。
根据是否需要依赖基因组序列以外的信息,RNA 基因的预测方法分为两类,一类是基于相似性(homology-based)的预测方法,一类是从头开始的预测方法。基于相似性方法的依据是许多 RNA 基因家族在进化中序列和结构上的保守性,通过比较分析的方法可以在新测序基因组中找到这些 RNA 基因的新拷贝(Meyer,2007);从头开始的 RNA 基因预测只依赖基因组序列本身进行注释,由于 RNA 基因生物学的局限,从头开始的 RNA 基因预测是非常具有挑战性的,目前这种方法仅在一些特殊的基因组中有过一些成功应用,如富含 AT 的超嗜热菌基因组。因而,在已测序基因组的 RNA 基因注释实践中,主要依赖基于相似性的预测方法。
基于相似性的预测方法是依赖已知序列,通过比较基因组学的方法,构建 RNA 家族进化保守的序列和结构特征,进而用于新基因组中家族新成员的预测。只依赖序列相似性的比对方法适用于一些保守的 RNA 基因预测,如 rRNA 基因,使用经典的序列比对软件(如 BLAST、FASTA 等)即可以获得较好的预测结果,且具有较快的计算速度。但是,研究表明,同时考虑序列特征及二级结构的 RNA 基因预测软件(如 INFERNAL、RSEARCH 等)敏感度和特异度更高;缺点是时间复杂度更高,对计算资源的需求量更大。
目前,最全面的 RNA 家族序列和比对信息的数据库之一是 Rfam 数据库。为表征已知 RNA 基因家族的序列和结构特征,Rfam 数据库对已测序基因组中的数百万条 ncRNA 记录进行整合,获得了上千个基因家族的多序列比对结果,进一步对这些结果进行序列和结构特征的建模,获得特定 RNA 家族的协方差模型(covariance model,CM)。目前,Rfam 数据库中含有 2000 多个协方差模型,可以使用 Rfam 数据库提供的 INFERNAL 软件包对这些协方差模型与靶序列进行比对,寻找与特定模型有序列和结构相似性的区域,通过打分、排序和去除阈值以下的匹配,达到了较高的灵敏度和特异度;不足之处是计算复杂度非常高。另外,一些只针对特定类别 RNA 的预测软件,也有较好的表现。例如,tRNAscan-SE 使用 tRNA 的协方差模型进行 tRNA 的预测,已成为新测序基因组中 tRNA 预测的标准软件;Snoscan 使用真核 rRNA 的甲基化位点信息辅助 C/D box snoRNA 的预测,不但能预测 C/D box snoRNA,还能提供甲基化位点信息的注释。
第四节 重复序列的注释
重复序列(repetitive sequence,或称 repeat)在真核生物基因组中广泛存在,不同基因组中所占比例变异很大。例如,在水稻和人类基因组中,重复序列的含量分别约为 25% 和 45%,而在玉米基因组中,重复序列的含量可达 80%。对于新测序基因组来说,重复序列的含量是一个必须要回答的问题。大量重复序列的存在对基因组拼接的效果影响非常大,而且由于一些重复序列中含有编码区,对蛋白质编码基因的预测也造成了干扰,从而使对重复序列进行准确的注释和分类变得十分重要。
重复序列可简单地分为串联重复序列(tandem repeat)和散布的重复序列(dispersed repeat)两种。串联重复序列是指重复单元相邻出现的重复序列,多出现于染色体的着丝粒区和端粒区等(Saha et al., 2008)。根据重复单元的长度大小,可分为微卫星序列(microsatellite)、小卫星序列(minisatellite)和卫星序列(satellite)。散布的重复序列,大多是转座元件(transposable element, TE),是指可以通过转座(transposition)过程在基因组内不同位置间移动的 DNA 片段。根据不同的转座机制,有的转座元件进行“剪切和粘贴”(cut-and-paste),转座之后,原有位置的拷贝转移到新的基因组位置上去;有的进行“复制和粘贴”,在新的基因组位置上复制一份拷贝。这些特性决定了转座元件的进化意义。它们可以影响基因组大小,并成为基因组变异的重要来源。例如,它有生成新基因、新 miRNA 和调控序列的潜能。更重要的是,转座元件的移动可能会打断基因区域,干扰基因表达,造成基因组不同区域间的异位重组,使得基因组结构更加复杂,推动基因组进化。对真核基因组进化更深刻的理解需要关于重复序列的知识,而这又依赖于基因组测序计划中更准确的重复序列的发现和识别。
串联重复序列的结构较简单,相应地,串联重复序列的识别也相对容易。在识别串联重复序列的软件中,Tandem Repeats Finder 应用最为广泛,它可以识别重复单元达 2kb 的串联重复序列,并通过概率模型对候选序列进行评估和打分,达到较高的灵敏度和特异度。根据重复单元的长度大小,被识别出的串联重复序列可直接分类为微卫星、小卫星和卫星序列。
转座元件的识别和分类是一件具有挑战性的工作。首先,转座元件插入基因组之后,新的拷贝经历了不同的进化历程,如累积点突变和插入缺失突变,并经历不同的重组事件,使得转座元件变得片段化和分歧化,难以被目前流行的序列相似性的方法所识别。其次,转座元件有优先插入其他转座元件区域的偏好,从而形成镶嵌型结构(nested structure),这使得确定转座元件的边界变得复杂(Bergman and Quesneville,2007)。最后,在重复序列含量非常高的基因组中,预测转座元件所需的计算资源是非常可观的,时间和内存的耗费都非常大。
根据是否依赖已知 TE 的信息,TE 的鉴定方法分为两种。一种是基于相似性的方法,通过比对输入序列与已知 TE 的相似性,对输入序列进行 TE 识别;另一种是从头开始的方法,依据基因组序列内部的自身重复性,重构出转座元件的祖先序列。用相似性的方法基于先验知识,更有可能发现 “真正” 的 TE 家族,但它无法检测序列分化很大的家族成员。对于新测序基因组,那些未知 TE 及物种特异的 TE 信息需要依赖从头开始的方法,所以常使用两种方法相结合的方式进行转座元件的注释。

基于相似性的方法依赖已知 TE 的数据库,预测结果比较准确,并且可根据已知 TE 的类别为预测的转座元件分类。目前的 TE 数据库中,Repbase(https://www.girinst.org/repbase/)是比较权威的一个,它收录了多个真核物种超过 9000 条的重复序列,每一条都标注了人工检查后的注释信息,并且代表了一个重复序列家族或亚家族的一致序列(Kapitonov and Jurka,2008)。但 Repbase 比较偏重收集动物的 TE,尤其是哺乳动物;而 TIGR 植物重复序列数据库整合了 GenBank 中 12 个属的植物重复序列,数量非常大,含有超过 21 万条序列,同时附有简单的分类信息。因而,TIGR 植物重复序列数据库非常有助于植物基因组中的转座元件识别。进行已知 TE 的预测时,可直接使用 BLAST 等经典序列比对软件,但更专业的重复序列相似性比较软件是 RepeatMasker(https://www.repeatmasker.org/)。目前 Repbase+RepeatMasker 的组合被认为是重复序列注释的黄金组合。

从头开始的重复序列预测方法多种多样。按输入序列分类,有的从已拼接的基因组序列出发进行 TE 预测,如 RepeatScout 等,这类软件的优点是时间复杂度低,但会显著受到序列拼接质量的影响;有的从测序片段(read)出发,如 ReAS 和 RECON 等,虽然计算复杂度高,但较少受到拼接错误的影响。若按算法分,则类别非常多,如自身比对算法(self-comparison),PILER 和 RECON 分别使用 PALS 和 BLAST 进行自身比对,对所得 hit 划分为不同的家族,通过多序列比对获得一致序列。尤其是 PILER 软件,它针对不同类别 TE 的模式特征,设计了对应的多种算法。例如,PILER-TA 用于寻找串联重复序列,而 PILER-DF 则用于寻找散布的转座元件家族等。有些算法在牺牲了一些灵敏度的基础上获得了非常高的特异度,使得结果非常可信。例如,k-mer 扩展算法,其典型软件为 RepeatScout,它将重复序列看作一个出现次数大于 1 的长度为 k 的子字符串,然后对 k-mer 进行扩展,直到整个区域的打分低于阈值为止,获得了较高的准确度和速度。除此之外,还有一些软件只针对某一特定类别的 TE 元件,根据其生物学特征构造算法,也有很好的性能。这种方法较多地应用于寻找全长的 LTR(long terminal repeat)型反转座子,如 LTR_STUCT、LTR_FINDRE 等。比较研究表明,ReAS 和 RepeatScout 分别在测序片段水平上和已拼接基因组序列水平上获得了最佳效果,而 PILER 软件因其具有高准确度,在测序基因组的 TE 预测中经常被使用;LTR_FINDER 软件则非常适合在 LTR 反转座子含量非常高的植物基因组中应用。新测序基因组中,如果已知 TE 信息不足,又无较近缘的测序基因组时,多种软件相结合是进行 TE 注释的最佳选择。
第五节 假基因的注释
假基因是基因组中与真基因序列相似但缺乏功能的 DNA 序列。按照形成机制的不同,假基因可以分为非加工假基因(non-processed pseudogene)和加工假基因(processed pseudogene)两类。非加工假基因又称为复制型假基因(duplicated pseudogene),是通过基因组 DNA 复制或者不平衡交换产生的,多位于其同源功能基因的附近;加工假基因又称反转座假基因,来源于反转座事件,由 mRNA 反转录成 cDNA,然后整合到基因组中。后者缺少内含子,两末端有短的定向重复序列,3’ 端有多聚腺嘌呤(PolyA)尾,根据其形成机制,加工假基因也被认为是一种特殊的反转录转座子(retrotransposon)。一般而言,加工假基因与功能基因序列密切相关,在揭示基因组进化上能提供更令人信服的证据,所以是进化研究的主要对象。在已完全测序的基因组中通常都要进行假基因的鉴定,其鉴定步骤一般如下:获得去除重复序列的基因组序列和蛋白质序列;利用 BLAST( $E$ -value<1×10 $^{-4}$ )在基因组序列中搜索与蛋白质相似的序列,去除与已知基因高度重叠的序列;去除冗余和重叠的 BLAST 匹配片段;合并相邻的序列;确定假基因的母基因;对剩余的序列利用 FASTA 与基因组序列重新进行比对;与以前通过实验获得的已知假基因合并;根据两种假基因的特征对假基因进行筛选和分类。假基因的筛选通常有以下几个标准:①与编码已知蛋白质的序列高度相似;②与相似功能基因相比,覆盖其超过 70% 的编码区域。另外,功能缺失特征、PolyA 尾等也可辅助假基因的识别和分类。当然,也有些鉴定假基因的方法在进行同源搜索时使用的检测序列不是蛋白质序列而是核酸序列。
第六节 案例分析:黄瓜基因组的注释
黄瓜是一种重要的园艺作物,具有重要的经济价值,其基因组包含7对染色体,大小仅有300多Mb,由于其性别分化模式多样,黄瓜已成为植物性别决定研究的一个主要的模式植物。为了从功能基因组学和分子育种的角度揭示黄瓜主要农艺性状的遗传和分子基础,2007年3月,中国农业科学院(以下简称农科院)蔬菜花卉研究所联合国内外多家合作单位发起了国际黄瓜基因组计划(international cucumber genome initiative,ICuGI),综合使用传统的Sanger测序技术和新一代Illumina GA测序技术,拼接得到了黄瓜的全基因组序列,覆盖了整个基因组上约 $99%$ 的基因组常染色质区域和约 $96%$ 的基因区域。基于新测序的黄瓜基因组序列,我们构建了一个流程化的真核基因组注释平台。
一、蛋白质编码基因的注释
黄瓜全基因组序列的注释过程,使用 EVM 整合从头开始基因预测和基于证据的预测结果,预测了黄瓜基因组的蛋白质编码基因(注释过程如图 5-3 所示),并使用 InterPro、KEGG、KOG 和 UniProt 等数据库对预测的蛋白质编码基因的功能进行了注释。
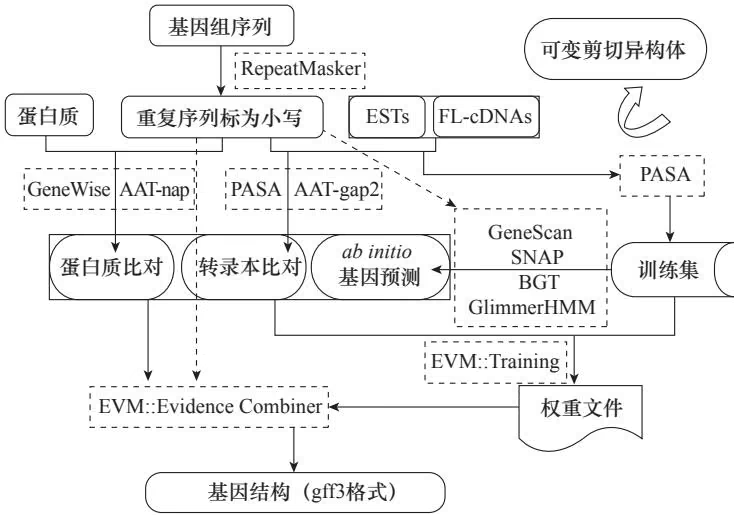
(一)基于证据的基因注释

- 转录本比对 黄瓜基因组使用的转录本数据库有:黄瓜 EST(农科院提供)和 mRNA(NCBI 下载)、甜瓜 EST(来自 MELOGEN 数据库)和 TIGR 植物转录数据库 PlantTA [目前 PlantTA 已关闭,类似数据可从 Plant GDB(http://www.plantgdb.org/prj/ESTCluster/progress.php)植物基因数据库获取]。黄瓜数据库包括 66 680 个 EST singleton、23 627 EST contig 和 260 个 mRNA;甜瓜数据库包括 10 614 个 EST singleton 和 6023 EST contig;TIGR 包含 251 个植物物种的 3 895 049 个 unigene。我们使用的 cDNA/EST 比对软件是 PASA 和 AAT-gap2。由于甜瓜和黄瓜同源性很高,我们将甜瓜和黄瓜的 EST 数据整合在一起作为 PASA 的输入。AAT-gap2 使用 TIGR 植物转录物数据作为输入进行同源比对。

- 蛋白质比对 黄瓜基因组使用了 UniProt(http://www.uniprot.org/)数据库中蛋白质数据。UniProt 是由欧洲生物信息学研究所(EBI)将两大蛋白质数据库 Swiss-Prot 和 TrEMBL 整合为一体建立的,其中 Swiss-Prot 中的蛋白质经过人工检验,质量比较高,而 TrEMBL 存放着由计算预测的结果。在黄瓜基因组的注释中使用 UniProt 13.2 版本,其中,Swiss-Prot 包含 387 331 个植物蛋白,TrEMBL 包含 515 655 个植物蛋白,因此,一共使用了 902 986 个植物蛋白。比对使用软件 AAT-nap 和 GeneWise 完成。由于 GeneWise 的运行时间相对较长,我们在用 GeneWise 进行蛋白质比对前,先使用 BLASTx( $E$ -value<1×10 $^{-4}$ )将蛋白质比对到基因组上,然后将比对上的区域前后扩展 10kb,再使用 GeneWise 对这些区域进行比对。
(二)从头开始的基因预测
基因预测训练集的构建对于从头开始基因预测及 EVM 中权重的训练都是至关重要的。目前已知的黄瓜基因很少,因此从 NCBI 下载完整的 mRNA 共 260 个。另外,使用 BLASTx 将已有的黄瓜和甜瓜的 EST 数据与 Swiss-Prot 数据库进行比对,其中满足 identity≥40%、覆盖度(匹配长度 / 蛋白质长度)=1 且 EST 长度>800bp 的 cDNA 被近似认为是全长 cDNA,这样获得了 3119 个近似的全长 cDNA。之后使用 PASA 寻找包含全长 cDNA 的最长比对片段,并产生完整的或者部分的基因结构,从中挑选具有起始密码子和终止密码子且氨基酸序列长度大于或等于 100 个氨基酸的完整基因结构作为训练集(共 1151 个)。
黄瓜基因组使用了目前 4 个比较常用的从头开始基因预测软件——BGF、GlimmerHMM、SNAP 和 GenScan。其中,BGF、GlimmerHMM 和 SNAP 程序使用 PASA 构建训练集进行参数训练,而 GenScan 则使用程序自带的拟南芥模型进行基因预测。在运行这 4 个程序前,基因组序列中的重复序列被 RepeatMasker 程序过滤掉,即将基因组中的转座元件序列用 “N” 代替。
另外,由于暂时没有与黄瓜亲缘关系较近的植物基因组可被利用,因此重新基因预测软件并没有在黄瓜基因组蛋白质编码基因的预测过程中被使用。
(三)EVM 基因预测自动整合系统
在黄瓜基因组的预测中使用 EVM 将 4 种从头开始基因预测、蛋白质和转录物的同源比对结果进行整合。EVM 在预测基因之前,根据 PASA 构建的训练集寻找生成最优基因结构模型的证据权重组合,之后根据训练得到的权重,整合多种预测结果,最终得到黄瓜基因组蛋白质编码基因的基因结构。之后对预测的基因进行一系列过滤,删除不完整的基因结构,如含有提前终止密码子的基因结构及与转座元件有显著相似的基因结构,最终得到了 25 344 个编码蛋白质的基因。
(四)基因功能注释
- 寻找同源基因 使用 BLASTp 在 UniProt 数据库(版本为 13.2)里进行数据库相似性搜索,其中满足条件 E\text{-value}<1\times10^{-6} 和 identity>35% 的基因比对被认为是黄瓜的同源基因。一共有 76.7%(19 450/25 344)的黄瓜基因在其他基因组上发现具有同源基因。其中,75.2%(19 059/25 344)与其同源基因的覆盖度超过 50%;72.4%(18 349/25 344)的覆盖度超过 70%;64.4%(16 309/25 344)的覆盖度超过 90%。由表 5-1 可得,黄瓜与杨树(Populus trichocarpa)的同源基因最多,一共有 19 150 个(75.8%),这与已测序的基因组中杨树与黄瓜具有最近的系统发育关系相一致,此外葡萄、水稻和拟南芥与黄瓜也具有较多同源基因。虽然甜瓜在系统发育上与黄瓜最接近,但是由于在 UniProt 中已知的甜瓜基因很少,所以获得的同源基因结果较少。最后,通过使用 UniProt 数据库中已有蛋白质注释为黄瓜基因的功能进行注释或提供参考。
表 5-1 UniProt 中与黄瓜同源的蛋白质的数量
| 基因组 | 基因数目 | 基因组 | 基因数目 |
|---|---|---|---|
| Populus trichocarpa | 19 150 | Vitis vinifera | 18 148 |
| Oryza sativa subsp. Indica | 17 259 | Arabidopsis thaliana | 17 919 |
| Carica papaya | 18 063 | Zea mays | 4 552 |
| Medicago truncatula | 5 750 | Cucumis sativus | 1 315 |
| Cucumis melo | 848 |
结构域和 GO 注释 使用 InterPro 数据库的 InterproScan 程序对预测基因进行结构域注释,一共有 17122 个(67.6%)基因至少含有一个结构域,其中 Pfam 结构域注释最多。由于 InterPro 的结构域提供 GO(gene ontology)注释,其中 47.6% 的基因因为含有 InterPro 结构域注释而获得 GO 注释,可用于今后的基因功能分类工作。
代谢通路注释 KEGG(Kyoto Encyclopedia of Genes and Genomes)数据库为代谢通路数据库,由日本京都大学构建并维护(Ogata et al., 1999)。KEGG由4个主要数据库组成:KEGG GENES存储基因组数据,KEGG LIGAND存储化学物质的信息,它们由KEGG PATHWAY即代谢通路联系起来,而KEGG BRITE展示了代谢通路的拓扑结构。其中,KEGG GENES和KEGG PATHWAY为主要的蛋白质功能注释数据库。KEGG PATHWAY数据库根据328条参考通路产生出69006条通路;KEGG GENE数据库包含了55种真核生物和576种细菌,以及49种古菌的2875769个基因,分为10692个KEGG直系同源组,即KO(KEGG orthology)。
首先,以黄瓜蛋白质序列为查询序列,以KEGG GENES中的所有植物和其他模式物种的蛋白质为数据库作BLASTp分析(图5-4)。进一步筛选符合条件的黄瓜蛋白:① $E$ -value< 1 \times 10^{-5} ;②比对上的KEGG GENES中的蛋白质必须拥有KO入口号;③ $\mathrm{rank} \leqslant 5$ ,即与每个黄瓜蛋白所匹配的KO入口号的个数小于或等于5。每个KO记录为一组同源基因,根据KO系统中各直系同源组所参与的代谢通路确定黄瓜蛋白的功能及其在代谢通路中的定位。我们将已预测的25344个黄瓜蛋白映射到KEGG数据库中, $40.7%$ (10327个)的蛋白质的功能被注释出来,共参与了231个代谢通路反应。
二、RNA 基因的注释
在黄瓜基因组的 RNA 基因注释中,采用 BLAST 软件进行 rRNA 基因的预测,tRNAscan-SE 软件进行 tRNA 基因的预测,Snoscan 软件用于 C/D box snoRNA 的预测,INFERNAL 软件与 Rfam 数据库(版本日期:20081104,共含 603 个协方差模型)中的 miRNA 模型、snRNA 模型和 H/ACA box snoRNA 模型进行比对,分别进行 miRNA、snRNA 和 H/ACA box snoRNA 的预测,流程如图 5-5 所示。
(一) rRNA 预测
使用 BLAST 软件预测 rRNA 基因,由于黄瓜的 rRNA 序列未知,我们从 NCBI 下载 4 条模式植物的 rRNA 序列作为库,其中,5S rRNA、5.8S rRNA 和 18S rRNA 来自拟南芥(Arabidopsis thaliana)基因组,28S rRNA 来自小麦(Triticum aestivum)基因组。将黄瓜基因组序列与植物 rRNA 基因库进行 BLASTn 比对,满足条件 E\text{-value} \leqslant 1 \times 10^{-10} 、identity $\geqslant 90%$ 且 matching length $\geqslant 100bp$ 的匹配(hits)组成了 rRNA 预测集,共得到 292 个 rRNA 基因片段,总长度达 112 966bp。
(二) tRNA 预测
tRNA 基因使用 tRNAscan-SE 软件预测,参数设为默认,共预测了 681 个 tRNA 基因和 18 个 tRNA 假基因。
(三)snoRNA 预测
对于两类 snoRNA,使用 Snoscan 软件进行 C/D box snoRNA 基因的预测,训练集使用软件自带的酵母 rRNA 序列和酵母 rRNA 甲基化位点信息,选取分值大于或等于 25 且具有甲基化位点注释信息的结果,并根据物理位置进行去冗余,最终得到 C/D box snoRNA 基因的预测集。H/ACA box snoRNA 基因的预测使用 INFERNAL 软件,将黄瓜基因组序列与 Rfam 中 83 个 H/ACA box snoRNA 相关的协方差模型进行序列和结构比对,满足条件 score≥log2(contig length)的结果组成了 H/ACA box snoRNA 基因的预测集,共预测了 157 个 C/D box snoRNA 基因和 81 个 H/ACA box snoRNA 基因。
(四)miRNA 和 snRNA 的预测
miRNA 基因和 snRNA 基因的预测方法与 H/ACA box snoRNA 的预测方法相同,即使用 INFERNAL 软件,将黄瓜基因组序列与 Rfam 数据库中该类 ncRNA 基因相关的协方差模型(miRNA 模型 46 个,snRNA 模型 10 个)进行序列和结构比对,满足条件 score≥lg2(contig length)的结果分别组成了 miRNA 基因和 snRNA 基因的预测集,得到 171 个 miRNA 基因和 192 个 snRNA 基因。
三、重复序列的注释
(一)串联重复序列的注释
黄瓜基因组中,使用 Tandem Repeats Finder 软件进行串联重复序列的预测,除 Maximum Period Size 设为 2000bp 外,其他参数默认。根据重复单元的长度对预测集进行简单分类,重复单元为 1~6bp 的称微卫星序列,重复单元为 7~100bp 的称为小卫星序列,重复单元大于 100bp 则称为卫星序列。黄瓜基因组中,共鉴定了 72 291 个串联重复序列元件,其中包括 6244 个微卫星序列、59 447 个小卫星序列及 6600 个卫星序列。串联重复序列在拼接好的黄瓜基因组序列中占 4.31%。
(二)转座元件的注释
在转座元件注释中,使用了4个各具特点的de novo预测软件,构建了一个黄瓜特异的de novo TE库,然后对其进行逐级分类,最后,整合已知TE数据库、黄瓜特异的de novo TE库和 TE 蛋白库,对全基因组序列进行了 DNA 和蛋白质水平上的 TE 注释。
- 构建黄瓜特异的 de novo TE 库 我们使用了 4 个 TE 预测软件:ReAS、RepeatScout、PILER 和 LTR_FINDER。其中,ReAS 以 Sanger 测序片段为输入序列,重构更为古老的重复序列的祖先序列;PILER 和 RepeatScout 软件使用已拼接的黄瓜基因组序列作为输入序列来预测 TE;LTR_FINDER 专门用来预测全长的 LTR 反转座子。所有预测结果中,挑选重复序列长度大于 100bp 且缺口序列 “N” 含量小于 5% 的序列,组成初步的黄瓜特异的 de novo TE 库。
由于 de novo 软件不能很好地区分 TE 序列和其他重要序列,我们对初步的 de novo TE 库进行过滤和去冗余。通过 BLASTn 比对,过滤掉与植物 rRNA 序列、黄瓜已知卫星序列或黄瓜细胞器 DNA 的同源序列(满足条件 E-value \leqslant 1 \times 10^{-10} 、identity $\geqslant 80%$ 、coverage $\geqslant 50%$ 并且 matching length $\geqslant 100bp$ 的匹配)。然后,对剩余序列进行多对多(all-versus-all)BLASTn 比对,若有满足条件( E-value \leqslant 1 \times 10^{-10} 、identity $\geqslant 80%$ 、coverage $\geqslant 80%$ 并且 matching length $\geqslant 100bp$ )的匹配,则去除两条 TE 序列中的较短一条。之后,假基因和多拷贝基因将在分类步骤中通过与 Swiss-Prot 数据库做 BLASTx 比对去除。在经过人工校正之后,在黄瓜基因组中构建了一个含有 1566 条序列的 de novo TE 库。
- 黄瓜的 de novo TE 库的分类 参照 Wicker 等(2007)的 TE 分类系统,我们对黄瓜特异的 de novo TE 库中的序列进行分类,逐级分类系统包括以下 6 个步骤:①与 Repbase 数据库进行 BLASTn 比对。②与 TE 蛋白质数据库进行 BLASTx 比对。③与 TIGR 植物重复序列数据库进行 BLASTn 比对。④与 Swiss-Prot 数据库进行 BLASTx 比对。⑤与 Repbase TEs 进行 tBLASTx 比对。⑥与 TIGR 植物重复序列数据库进行 tBLASTx 比对。
在每一个步骤中,若 de novo 序列与数据库中的已知 TE 具有满足条件(DNA 水平上为:同时满足 E-value \leqslant 1 \times 10^{-10} 、identity $\geqslant 80%$ 、coverage $\geqslant 30%$ 和 matching length $\geqslant 80bp$ ;蛋白质水平上为:同时满足 E-value \leqslant 1 \times 10^{-4} 、identity $\geqslant 30%$ 、coverage $\geqslant 30%$ 和 matching length $\geqslant 30bp$ )的匹配,则依照已知 TE 的分类信息为这条 de novo TE 序列进行注释,其余的序列进入下一步分析。由 LTR_FINDER 软件预测出的 de novo 序列若在分类完毕时仍无注释分类信息,则默认为“未分类的 LTR 型反转座子”。de novo TE 的构建和分类流程如图 5-6 所示。在构建的 1566 条序列的 de novo TE 库中,有 469 条序列被分类,其余 70% 被标记为“未分类”。
- 基因组水平上的转座元件的注释 黄瓜基因组水平上的 TE 注释包括 DNA 水平和蛋白质水平的注释结果。DNA 水平上,使用 RepeatMasker 软件,整合 Repbase、TIGR 植物重复序列数据库和构建的黄瓜特异的 de novo TE 库,作为自定义库(custom library)与黄瓜基因组序列进行比对;蛋白质水平上,使用 RepeatMasker 软件包自带的 RepeatProteinMask 程序,进行 TE 蛋白质数据库与黄瓜基因组序列的 WuBlastx 比对。最后,整合 DNA 水平和蛋白质水平的识别结果进行物理位置层面上的去冗余,比较冗余记录的权重(已知 TE>已分类的 de novo TE>未分类的 de novo TE)和局部序列比对得分,去除权重更低、得分更小的冗余记录。重复序列的整体注释流程如图 5-7 所示。整合 DNA 水平和蛋白质水平的注释,一共得到了 232 938 条转座元件,在已拼接好的黄瓜基因组序列中占 24.22%。其中,1.20% 为 DNA 转座子,11.65% 为反转座子,未分类的转座元件为 11.37%(占所有预测集的 46.95%)。LTR 型反转座子在转座元件中是含量最多的,占黄瓜基因组序列的 9.92%,其中,LTR 型反转座子的两大超家族——Copia 和 Gypsy 成为黄瓜基因组中含量最多的 TE 家族,分别占 4.37% 和 3.48%。
四、假基因的注释
参考 PseudoPipe 有关假基因的分析方法(Zhang et al., 2006),按照图 5-8 所示的流程对黄瓜基因组中的假基因进行识别和分类。
黄瓜基因组中通过同源搜索得到的片段有609个被视为功能基因,1709个基因与其对应蛋白质序列的同一性小于40%而被认为是假阳性,将这些去除后共得到9394个片段,这些片段是4403个蛋白质(占黄瓜基因组所有蛋白质的17.3%)的同源物,说明绝大多数基因是没有假基因的。而在人和小鼠等哺乳动物中,假基因几乎与基因一样多,人类基因组中目前发现28 237个假基因(35 000个基因);小鼠基因组中目前发现15 064个假基因(22 000个基因);作为植物的拟南芥假基因数目则比较少,目前发现4260个(25000个基因)(Karro et al., 2007),说明不同物种假基因数目存在很大差别。黄瓜基因组发现的这9394个假基因中,加工假基因有2871个、非加工假基因有531个、假基因片段有5992个,可以发现,加工假基因数目远远大于非加工假基因。
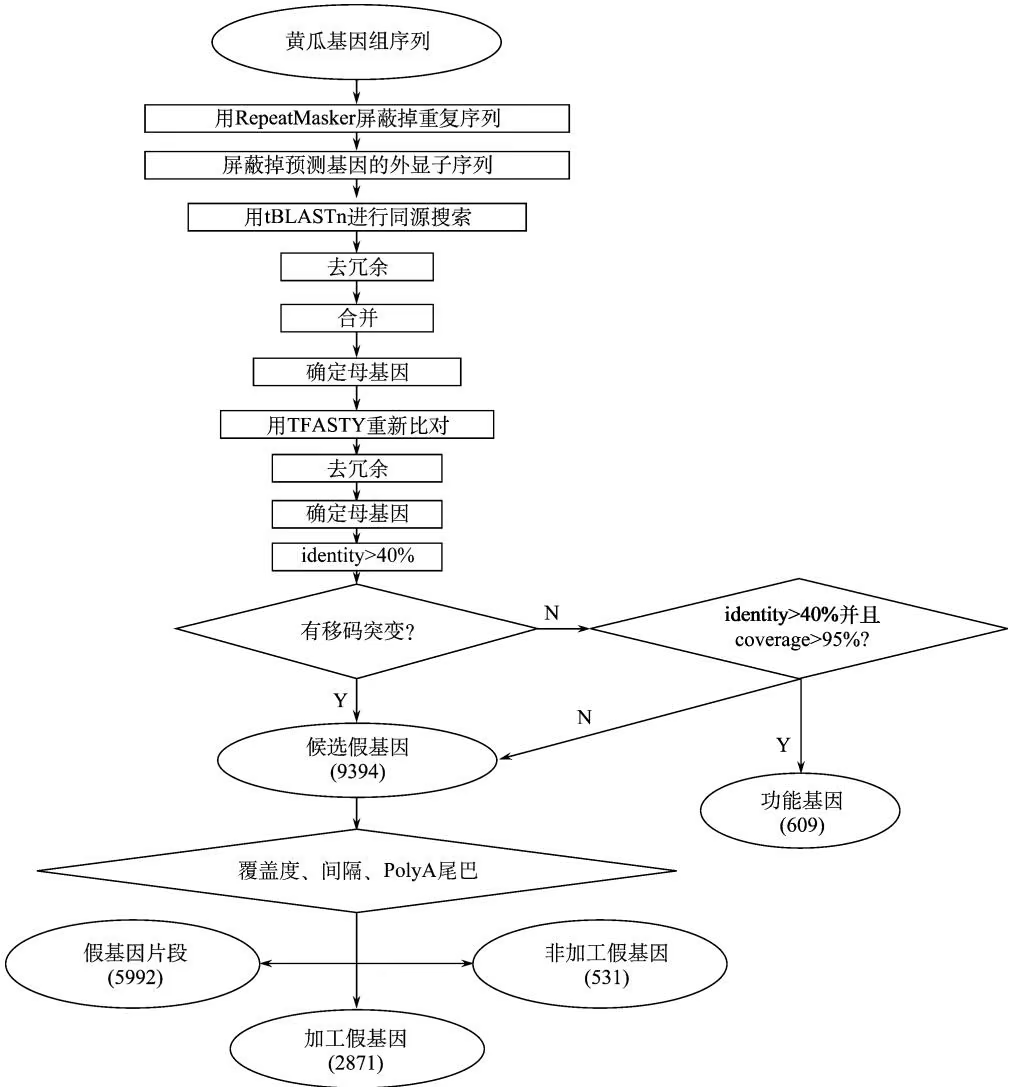

思考题
常用的编码蛋白质基因的注释方法有哪些?
如何识别假基因?
简述基因组注释的基本流程。

主要参考文献
Bergman C M, Quesneville H. 2007. Discovering and detecting transposable elements in genome sequences. Briefings in Bioinformatics, 8: 382-392
Brent M R. 2005. Genome annotation past, present, and future: how to define an ORF at each locus. Genome Research, 15 (12): 1777-1786
Brent M R. 2007. How does eukaryotic gene prediction work? Nat Biotech, 25 (8): 883-885
Brent M R. 2008. Steady progress and recent breakthroughs in the accuracy of automated genome annotation. Nat Rev Genet, 9 (1): 62-73
Collins F, Green E, Guttmacher A., et al. 2003. A vision for the future of genomics research. Nature, 422:835-847
Griffiths-Jones S, Moxon S, Marshall M, et al. 2005. Rfam: annotating non-coding RNAs in complete genomes. Nucleic Acids Research, 33: D121-D124
Kapitonov V V, Jurka J. 2008. A universal classification of eukaryotic transposable elements implemented in Repbase. Nature Reviews Genetics, 9 (5): 411-412
Karro J E, Yan Y, Zheng D, et al. 2007. Pseudogene. org: a comprehensive database and comparison platform for pseudogene annotation. Nucleic Acids Res, 35 (Database issue): D55-D60
Meyer I M. 2007. A practical guide to the art of RNA gene prediction. Briefings in Bioinformatics, 8: 396-414
Ogata H, Goto S, Sato K, et al. 1999. KEGG: Kyoto encyclopedia of genes and genomes. Nucleic Acids Res, 27 (1): 29-34
Saha S, Bridges S, Magbanua Z V, et al. 2008. Computational approaches and tools used in identification of dispersed repetitive DNA sequences. Tropical Plant Biology, 1 (1): 85-96
Wicker T, Sabot F, Hua-Van A, et al. 2007. A unified classification system for eukaryotic transposable elements. Nature Reviews Genetics, 8 (12): 973-982
Zhang Z, Carriero N, Zheng D, et al. 2006. PseudoPipe: an automated pseudogene identification pipeline. Bioinformatics, 22 (12): 1437-1439

第七章 非编码 RNA
本章提要
除 mRNA 以外,生物体内还存在许多不编码蛋白质的 RNA,直接在 RNA 水平上发挥作用,称为非编码 RNA(non-coding RNA, ncRNA)。细胞中含量最高的是 rRNA 和 tRNA 这两种常见的非编码
RNA,广义上的非编码 RNA 包括这两种研究比较透彻的 RNA,狭义上的非编码 RNA 往往不包括。本章主要以狭义非编码 RNA 进行相关论述。
第一节 非编码 RNA 概述
哺乳动物基因组的测序分析结果发现,虽然大部分 DNA 序列可以转录为 RNA,但是其中大多数并不编码蛋白质。在组成人类基因组的 30 亿个碱基对中,蛋白质编码序列仅占 1.5%,75% 的基因组序列都能够被转录成 RNA,其中非编码 RNA 占总 RNA 的 74%。这些非编码 RNA 并非垃圾 RNA。最近研究表明很多非编码 RNA 具有很重要的功能,其中突出和核心的作用是调控。2006 年度诺贝尔生理学或医学奖授予了美国科学家安德鲁·法尔和克雷格·梅洛,以表彰他们发现了 RNA 干扰(RNA interference,RNAi)现象。
一、非编码RNA的特征
非编码 RNA 按照碱基长度一般分为两类(图 7-1):第一类为短链非编码 RNA(small ncRNA,sncRNA),通称小分子 RNA,长度一般小于 200nt,包括 miRNA、piRNA、siRNA、snRNA、snoRNA 等;第二类为长链 RNA,长度一般大于 200nt,包括长链非编码 RNA(long non-coding RNA,lncRNA)等,环状 RNA(circular RNA,circRNA)也是一类特殊的长链非编码 RNA。
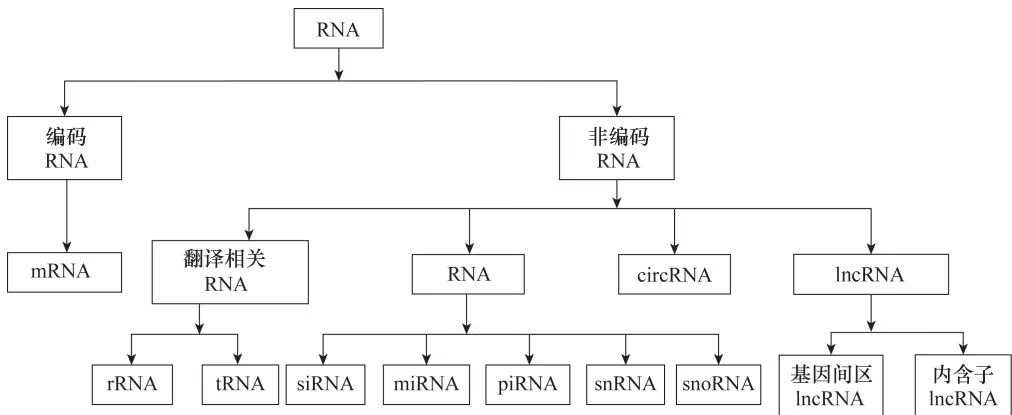
在这些非编码小 RNA 中,miRNA 主要在转录后负调控目标基因的表达,是最重要的一类调控小 RNA。目前 miRBase(release 22.1)已报道的人类 miRNA 为 2883 个,预期这类 RNA 的总数目还会增加。癌症的发展也和 miRNA 有关,这种相关性可以用于根据 miRNA 的特性分类人类癌症(Saetrom et al., 2007)。lncRNA 也是当前的研究热点,它和许多染色质重塑复合物相关,通过定位这些复合物到特定的基因位点来改变 DNA 的甲基化和组蛋白的状态,在表观遗传调控中起着重要作用(Chen and Xue, 2016)。lncRNA 不仅在转录水平,在转录后水平上也能调节蛋白质编码基因的表达,从而广泛地参与包括细胞分化、个体发育在内的重要生命过程,其异常表达与多种人类重大疾病的发生密切相关。lncRNA 存在带 PolyA 尾和不带 PolyA 尾两种形式,具有跨物种的低保守性、组织特异性表达和丰度低等特点。lncRNA 的种类远远超过编码 RNA,保守估计哺乳动物基因组序列中 4%~9% 的序列产生 lncRNA 转录本,而相应的蛋白质编码 RNA 的比例仅是 1%~5%。RNA 的调控网络可能决定我们大多数复杂的特性,并在疾病中发挥重要作用,组成了一个物种内和物种间遗传变异调控的未知世界(Mattick and Makunin, 2006)。
二、非编码RNA的识别
非编码 RNA 的大规模鉴定主要有理论预测的方法和实验的方法。理论预测主要借助计算机,从已有的非编码 RNA 中提取特征信息,然后以特征信息做全基因组搜索,比较成功的如 snoScan、snoGPS、tRNAScan、mirScan、RNAz 和 RNAmotif 等。理论预测方法简便快捷,但是最终的确定还是依赖于实验。实验的方法是构建非编码 RNA 的 cDNA 文库、克隆测序或者直接测序(直接分离纯化非编码 RNA 后测序)以及全基因组 tiling array 芯片技术。在长链非编码 RNA 的专用商业芯片推出之前,可以对已有的芯片进行探针重注释,从而识别长链非编码 RNA 的表达情况。
三、非编码 RNA 的功能预测
非编码 RNA 摆脱 “junk DNA” 的名头还不久,大部分非编码 RNA 的功能尚未被实验所证实。由于非编码 RNA 缺乏翻译产物,相对于 mRNA 又显得数量庞大,目前对非编码 RNA 的功能预测主要还是理论手段。常见方法总结如下。
1)通过互作、共表达、共定位等信息,得到与非编码 RNA 相关的一组基因及其他互作因子(miRNA 等),并进行功能富集。由于相似的特征并不直接说明功能相关,所以使用这一方法时应注意结合多种因素以增强可靠性,并注意统计检验。
2)收集尽可能全的功能注释数据与相关性数据,建立编码-非编码网络,划分功能模块,并为模块内的非编码 RNA 赋予功能。有些非编码 RNA 并没有足够进行功能富集的互作伙伴,但通过模块法可以预测其功能。
3)通过非编码 RNA 的序列,通过算法预测其与其他 RNA 或蛋白质等的结合情况,再通过所得已知因子来推测非编码 RNA 的功能。由于竞争性内源 RNA(ceRNA)是 lncRNA 的一类重要功能角色,此类方法常常用于预测 lncRNA 与 miRNA 的匹配关系并推断功能。
目前常用的非编码 RNA 功能预测平台包括 ncFANs(已整合进 noncode)、ChIPBase(https://rna.sysu.edu.cn/chipbase/)、starBase(http://starbase.sysu.edu.cn/)、LncRNADisease(http://www.cuilab.cn/lncrnadisease)、DIANA-LncBase(https://diana.e-ce.uth.gr/lncbasev3)等,此外一些较大的综合数据库也提供预测功能。lncRNA 相关常用资源见表 7-1。
表 7-1 lncRNA 相关常用资源

| 预测软件 | 特点 | 网址 |
|---|---|---|
| Noncode | 目前最全面的 lncRNA 资源。提供 17 个物种(截至 2017 年 11 月)的非编码 RNA 数据,并提供序列比对等多种功能 | http://www.noncode.org/ |
| LNCipedia | 包含人类超过 14 万条 lncRNA 的注释信息,包括二级结构、编码潜能、miRNA 结合位点等 | https://lncipedia.org/ |
| LncRNASNP2 | 收集整理了超过 14 万人类 lncRNA 和超过 11 万小鼠 lncRNA 上各数百万条的 SNP 信息,提供 lncRNA 突变功能,相关疾病、癌症样本表达等多种信息 | http://bioinfo.life.hust.edu.cn/lncRNASNP |
| CANTATAdb | 提供 10 种模式植物 lncRNA 的表达、序列比对、编码潜能等综合信息 | http://yeti.amu.edu.pl/CANTATA/ |
| HUGO-lncRNA | 提供已经官方定名的 lncRNA Symbol | http://www.genenames.org/ |
| NPInter | 收集了 22 个物种非编码 RNA 之间和非编码 RNA 与生物分子(DNA/RNA/蛋白质等)的互作关系 | http://bigdata.ibp.ac.cn/npinter4 |
| EVLncRNAs | 实验证实的 lncRNA,包含 77 个物种 1543 个 lncRNA 的信息 | https://www.sdklab-biophysics-dzu.net/EVLncRNAs2/ |
| LncATLAS | lncRNA 的亚细胞定位信息 | http://lncatlas.crg.eu/ |
| AnnoLnc | 用于注释人类 lncRNA 的 webserver,输入为 lncRNA 的 FASTA 序列 | http://annolnc.gao-lab.org/ |
四、非编码 RNA 的编码潜能
对于非编码 RNA 的认识,目前有了一些新的发现。2015 年,来自美国德克萨斯大学西南医学中心的 Eric Olson 和同事们在分析梳理肌肉特异性的长非编码 RNA 以了解它们的功能时,发现了一种在骨骼肌中特异性表达的 lncRNA。尽管这一 RNA 以往被归类为非编码 RNA,它的序列中包含的一小段却看上去好像一个编码区域。研究人员证实在体内这一 lncRNA 编码了一个包含 46 个氨基酸的微肽,他们将之命名为 myoregulin(MLN)。Myoregulin 形成了在结构上与表达于心肌和慢收缩骨骼肌中的另外两种小蛋白质 phospholamban(PLN)和 sarcolipin(SLN)相似的一种跨膜 α 螺旋。2016 年,Eric Olson 又发现了另一条 lncRNA 编码微肽的能力,新发现的微肽 DWORF 与之前发现的微肽 MLN 功能相反,可以增强 ATP 酶 SERCA 的活性。
circRNA 也属于非编码 RNA,传统上认为其并无编码能力。但最新研究表明,有些 circRNA 也可以编码并表达蛋白质或多肽。Irene Bozzoni 等发现 Circ-ZNF609(一种 circRNA)可直接翻译蛋白质,该蛋白质参与了肌肉发生过程;Sebastian Kadener 等在果蝇大脑中也发现了大量的 circRNA 翻译蛋白质或多肽。
这种编码能力被忽视的现象,一方面是由于科学家们对新种类的 RNA 了解还太少,如 circRNA 可能存在不同的翻译机制;另一方面是由于现存的预测手段都没有很好地预测出这些 RNA 的编码潜能。可读框(ORF)可能存在于任何 mRNA 序列当中,但很多 ORF 都不会翻译蛋白质。由于 ORF 越长,进行翻译的概率就越大,传统的 ORF 预测软件都会限制 ORF 的发现阈值,如 300nt(可翻译为 100aa)。这无疑使得长度小于 100aa 的微肽无法被预测出来。事实上,在这些微小的翻译产物被注意之前,标准的实验手段往往会漏过它们。电泳实验中,微肽会早早跑到凝胶底部;而质谱分析的清洗步骤会把这些分子质量不足的微肽清洗掉。
目前,通过对核糖体测序(Ribo-seq)等数据的全面分析,越来越多的非编码 RNA 被证实有编码潜能。非编码 RNA 有编码潜能的这一发现使得 mRNA 与非编码 RNA 之间的界限变得模糊,非编码 RNA 可能需要一次重新定义,而实验手段也需要一次革新。
五、非编码 RNA 的注释
基于计算方法可成功发现一些 ncRNA 基因,不过这些 ncRNA 主要集中在一级序列或二级序列已得到很好表征的 ncRNA,此后出现了用户可定制的 RNA 基序搜索程序。最近 ncRNA 基因发现程序得到进一步完善,如基于相关物种基因组序列比较分析及基于 ncRNA 的碱基组成特征或采用一些新的 RNA 序列比对和二级结构预测等方法。
NONCODE 是一个专用于非编码 RNA(不包括 tRNA 和 rRNA)的集成知识数据库(Li et al., 2017)(图 7-2)。数据来源于发表的文献、RNA-seq 数据、micro-array 数据、dbSNP 数据和 GWAS 数据,目前共收集和整合了 39 个物种(人类、小鼠、牛、大鼠、鸡、果蝇、斑马鱼、线虫、酵母、拟南芥、黑猩猩、大猩猩、马来亚猩猩、恒河猴、鸭嘴兽、猪等)ncRNA(特别是 lncRNA)的相关信息。不仅可以查询到 ncRNA 基因的定位、序列等基本信息,还可以查询表达谱、外泌体表达谱、保守信息、功能预测、疾病关联和 RNA 结构等注释信息;并提供 RNA 序列的 Blast 分析和 lncRNA 的鉴定。该数据库的网址:http://www.noncode.org/。

第二节 非编码 RNA 的分类
非编码 RNA 由于来源、性质和功能等方面的不同,在分类上可根据侧重点不同有不同的分类方法,目前较常见的分类方法如下。
一、根据 ncRNA 在细胞内的分布不同分类
- 核仁小 RNA 自从 20 世纪 60 年代末 Weinberg 等在哺乳动物中发现了第一个核仁小 RNA(small nucleolar RNA,snoRNA)U3 以来,这一领域的研究进展引起了人们的广泛关注。核仁小 RNA 是一类小分子非编码 RNA,且多富集于核仁,代谢稳定。典型的 snoRNA 具有如下主要特征:分子大小为 60~400nt;具有类似核仁提取物的性质(抗盐性);需要与特定蛋白质结合形成核仁小核糖核蛋白(ribonucleoprotein particles,snoRNP),并以此形式存在和行使功能;snoRNA 分子具有多种与蛋白质相互作用的保守序列元件(Maxwell and Fournier,1995)。
snoRNA 依据结构单元可划分为三大类:box C/D snoRNA、box H/ACA snoRNA 和 MRP RNA。其中 box C/D 和 box H/ACA 是已知 snoRNA 的主要类型,以碱基配对的方式分别指导核糖体 RNA 的甲基化和假尿嘧啶化修饰。研究发现,snoRNA 除了在核糖体 RNA 的生物合成中发挥作用之外,还能够指导 snRNA、tRNA 和 mRNA 的转录后修饰。此外,还有相当数量的 snoRNA 功能不明,被称为孤儿 snoRNA(orphan snoRNA)。在哺乳动物的孤儿 snoRNA 中,印迹 snoRNA(imprinted snoRNA)是最为特殊的一群,由基因组印迹区编码,具有明显的组织表达特异性。原核生物古菌中类 snoRNA 的鉴定表明了这些非编码 RNA 家族成员的古老起源;而哺乳动物中大量的 snoRNA 反转座子的存在更为人们探索 snoRNA 在基因组中扩增和功能进化提供了新的思路。boxC/D snoRNA 类能形成 “发夹-铰链-发夹-尾部” 状二级结构,其分子两端的 boxC、boxD 以及末端配对序列能形成保守的 “茎-内环-茎” 状二级结构,称为 “K-turn” 结构。大多数 boxC/D snoRNA 和 box H/ACA snoRNA 分别具有指导 rRNA、snRNA 或 tRNA 前体中特定核苷 2’-O- 核糖甲基化修饰与假尿嘧啶化修饰的功能;少部分 snoRNA 参与 rRNA 前体的加工剪切,与 rRNA 的正确折叠和组装相关。MRP RNA 是极为特殊的 snoRNA,在数量和功能上都迥异于其他 snoRNA。MRP RNA 只有一种分子存在于细胞中,并与 9 种蛋白质结合形成 MRP RNA 复合物,参与 5.8S rRNA 的加工和线粒体 DNA 的复制;还作为 RNase P 的 RNA 成分,参与了 tRNA 的 5’ 端成熟过程(Falaleeva and Stamn, 2013)。
- 核小 RNA 核小 RNA(small nuclear RNA,snRNA)是真核生物转录后加工过程中 RNA 剪接体(spliceosome)的主要成分,其长度在哺乳动物中为 100~300 个核苷酸。snRNA 一直存在于细胞核中,与核内蛋白质共同组成 RNA 剪接体,在 RNA 转录后加工中起重要作用。它参与真核生物细胞核中 RNA 的加工。snRNA 和许多蛋白质结合在一起成为核小核糖核蛋白(small nuclear ribonucleoproteins,snRNP),参与信使 RNA 前体(pre-mRNA)的剪接,使后者成为成熟 mRNA。snRNA 共分为 7 类,由于含 U 丰富,故编号为 U1~U7。snRNA 只存在于细胞核中,其中 U3 存在于核仁中,其他 6 种存在于非核仁区的核基质里。除 U6 由 RNA 聚合酶Ⅲ转录外,其他的都是由 RNA 聚合酶Ⅱ催化转录的,具有修饰的碱基,并在 5’ 端有一个三甲基鸟苷酸(TMG)的类似“帽”结构,3’ 端有自身抗体识别的 Sm 抗原结合的保守序列。snRNA 的特点如下:①稳定,半寿期常与核糖体相近;②含量丰富,如 U1 分子在每个核中的含量可有 $10^{6}$ 个;③普遍性,在动物、植物细胞中均含有 snRNA;④高度保守,如人和爪蟾的 U1 snRNA 有 90% 的序列相同。
通常 snRNA 不是游离存在,而是与蛋白质结合成复合物 snRNP。snRNA 不参与蛋白质合成活动,而是在 RNA 加工方面具有重要作用。U3 snRNA 与核仁内 28S rRNA 的成熟有关,而 U1 则是在核基质中与前体 mRNA 的剪接加工有关。snRNA 中的蛋白质部分具有核酸酶和连接酶活性,能把转录在内含子-外显子接点处切断,并把两个游离端连接起来(Egeland et al., 1989)。
胞质小 RNA 胞质小 RNA(small cytoplasmic RNA,scRNA)分布在细胞质,主要在蛋白质合成过程中起作用。
Cajal 小体 Cajal 小体(Cajal body,CB)是 CB 特异性小 RNA,存在于细胞核中,能与 U 族 snRNA 碱基配对,可能对 U1、U2、U4 及 U5 进行位点特异性 2’-O- 核糖甲基化,并参与假尿嘧啶形成(Cioce and Lamond,2005)。
二、根据 ncRNA 长短不同分类
根据 ncRNA 长短不同,国际通用的分类方法通常将其分为两类。常见的人类非编码 RNA 种类如表 7-2 所示。
表 7-2 人类非编码 RNA 种类(Gibb et al., 2011)
| 类型 | 亚类 | 缩略词 |
| 短链非编码 RNA | microRNA | miRNA |
| piwi interacting RNA | piRNA | |
| tiny transcription initiation RNA | tiRNA | |
| small interfering RNA | siRNA | |
| promoter-associated short RNA | PASR | |
| termini-associated short RNA | TASR | |
| antisense termini associated RNA | aTASR | |
| small nucleolar RNA | snoRNA | |
| transcription start site antisense RNA | TSSa-RNA | |
| small nuclear RNA | snRNA | |
| retrotransposon-derived RNA | RE-RNA | |
| 3-UTR-driven RNA | UaRNA | |
| x-ncRNA | x-ncRNA | |
| human Y RNA | hYRNA | |
| unsuslly small RNA | usRNA | |
| small NF90-associated RNA | snaRNA | |
| vault RNA | vtRNA | |
| 长链非编码 RNA | long or large intergenic ncRNA | lincRNA |
| transcribed ultraconserved region | T-UCR | |
| pseudogenes | None | |
| GAA-repeat containing RNA | GRC-RNA | |
| long intronic ncRNA | None | |
| antisense RNA | aRNA | |
| promoter-associated long RNA | PALR | |
| promoter upstream transcript | PROMPT | |
| stable excised intron RNA | None | |
| long stress-induced non-coding transcript | LSINCT |
短链非编码 RNA 短链非编码 RNA(small non-coding RNA,sncRNA)是一类转录本序列比较短,一般不超过 40nt 的非编码 RNA。sncRNA 分子虽小,却参与了包括细胞增殖、分化、凋亡、细胞代谢以及机体免疫在内的几乎所有生命活动的调节和控制,在生命体内扮演着至关重要的角色。短链非编码 RNA 的调节作用发生异常,则有可能导致生命体代谢活动紊乱,甚至导致疾病(如癌症)的发生。
长链非编码 RNA 长链非编码 RNA(long non-coding RNA,lncRNA)是一类转录物长度超过 200nt 的非编码 RNA 分子,它可在多层面上(表观遗传调控、转录调控及转录后调控等)调控基因的表达。lncRNA 最初被认为是 RNA 聚合酶 II 转录的副产物,是一种 “噪音”,不具有生物学功能。然而,近年来的研究表明,lncRNA 参与了 X 染色体沉默、染色体修饰和基因组修饰、转录激活、转录干扰、核内运输等过程,其调控作用正在被越来越多的人研究。
三、根据 ncRNA 的功能和表达特征分类
看家 ncRNA 看家 ncRNA [house-keeping (infrastructural) ncRNA] 表达通常比较稳定,其表达水平受体内外环境变化的影响不明显,它们具有对细胞存活至关重要的一系列功能,如 snRNA、SRP RNA 等。
调节或调控 ncRNA 调节或调控 ncRNA(regulatory ncRNA)可分为转录调控子、RNA 分布调控因子、转录后调控因子、蛋白质功能调节因子等。这类 RNA 一般在组织发育或细胞分化的特定阶段表达,或者是对外界环境的应激表达,随后调控一系列的生物过程。
兼具看家功能和调节功能的 ncRNA 这类 RNA 主要是 snoRNA,是一类广泛分布于真核生物细胞核仁的小分子非编码 RNA,具有保守的结构元件。snoRNA 主要作用为修饰 rRNA、tRNA 和 snRNA,最近研究表明 snoRNA 可形成 sdRNA。一些 sdRNA 类似于 miRNA,与 Argonaute 蛋白相关,可影响翻译过程。另外一些较长的片段,和 hnRNP 形成复合物并影响基因的表达,显示了 snoRNA 具有看家 RNA 稳定表达的特性,又具有调节 RNA 的调节作用(Falaleeva and Stamm,2013)。
第三节 microRNA
microRNA(miRNA)在细胞内具有多种重要的调节作用。每个 miRNA 可以有多个靶基因,而同一个靶基因也可以被几个 miRNA 共同调节,形成复杂的调节网络。据推测,miRNA 调节着人类三分之一的基因。最近的研究表明大约 70% 的哺乳动物 miRNA 基因是位于 TU(transcription unit)区,且其中大部分是位于内含子区(Rodriguez et al., 2004)。一些内含子 miRNA 基因的位置在不同物种中是高度保守的,其序列上也呈现出高度的同源性。miRNA 高度的保守性与其功能的重要性有着密切的关系。miRNA 与其靶基因的进化有着密切的联系,研究其进化史有助于进一步了解其作用机制和功能。
一、microRNA 的生物合成
miRNA 是一种小的内源性、长度为 21~25 个核苷酸的单链 RNA(ssRNA),由发夹状初始转录产物经过加工后形成,它的序列存在于发夹状茎环结构中的茎上。这种茎环结构通常是由 70 多个核苷酸组成的不完全的发夹结构,上面有一些凸起和环状结构。茎部形成双链 RNA,但不是严格互补,可存在错配和 GU 摆动配对。miRNA 通过与靶基因的 3’-UTR 配对,促进 mRNA 的降解或者 mRNA 翻译抑制,从而抑制靶基因的表达。在动物中,miRNA 初级转录产物为 primary miRNA(pri-miRNA)。pri-miRNA 在核内被 Drosha(2 类 RNase Ⅲ)加工为前体物 precursor miRNA(pre-miRNA),然后在 Exportin-5(EXP-5)介导下运输到细胞质,在细胞质中进一步由 Dicer 酶(RNase Ⅲ型蛋白)加工成为成熟的 miRNA 并加载到 Argonaute 蛋白生成效应物 RNA 诱导沉默复合物(RISC)[图 7-3(a)]。在植物体内 miRNA 的合成有些不同 [图 7-3(b)],植物中没有发现对应的 Drosha 及其辅酶因子(DGCR8 /Pasha)的同系物,这表明在植物细胞中没有依赖于 Drosha 的加工过程。基因研究显示,Dicer like 1(DCL-1)专一负责 miRNA 的加工。Exportin-5 同系物 HASTY(HST)介导 miRNA 从细胞核到细胞质。miRNA 在细胞核或细胞质中加载 Argonaute 家族蛋白质(AGO)(Wahid et al.,2010)。
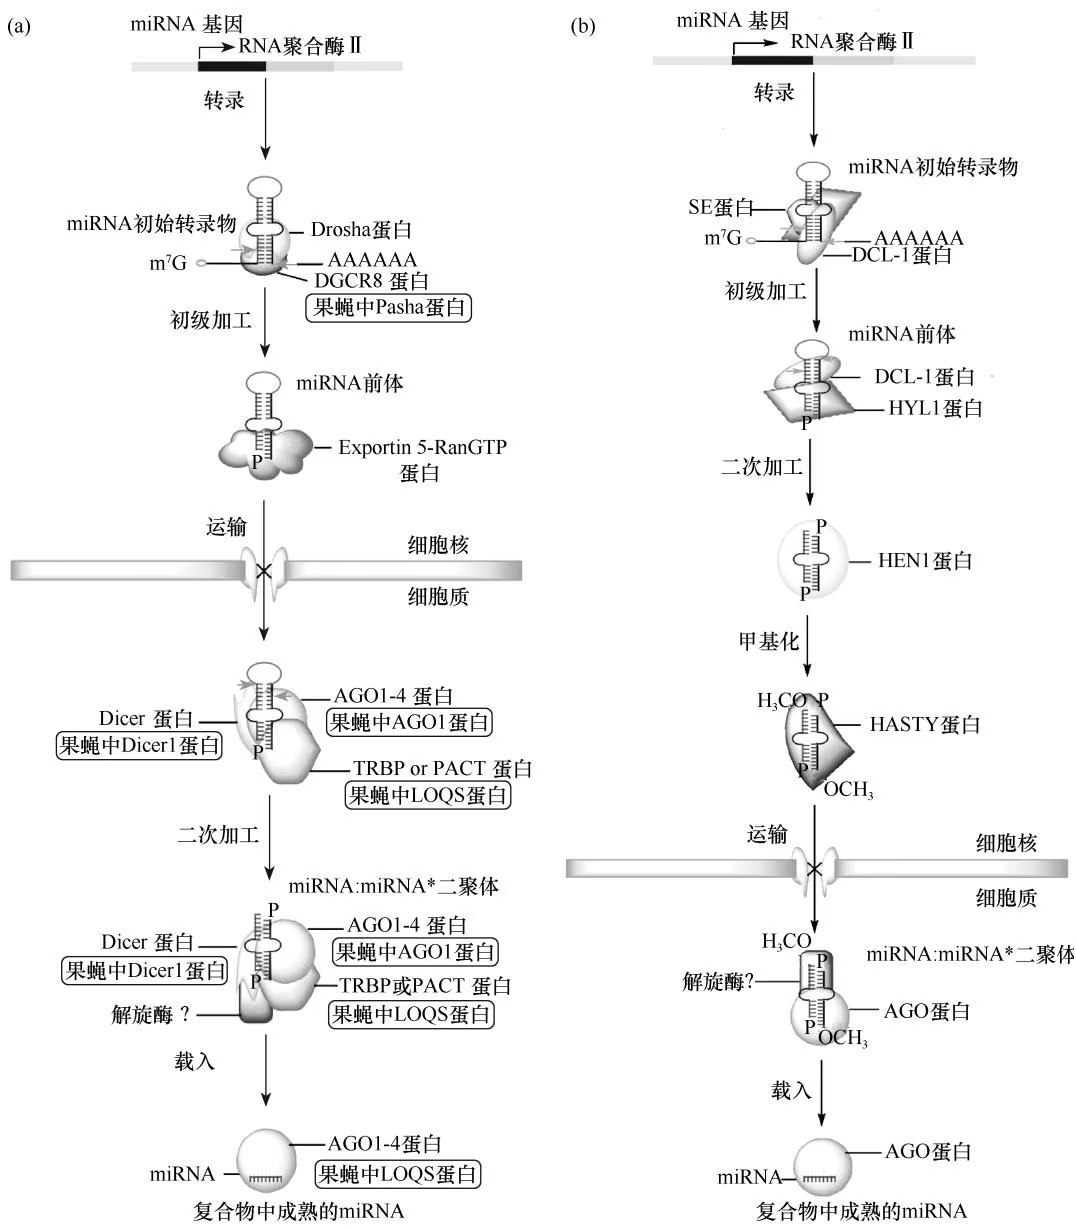
二、microRNA 的生物信息学分析方法
对目的 microRNA(miRNA)的生物信息学分析,能为其功能研究提供重要线索。miRNA 基因的常规生物信息学分析策略如下。
- 获取 miRNA 的序列信息 当前最常用的 miRNA 权威数据库是 miRBase (http://www.mirbase.org/,图 7-4),该数据库提供 miRNA 注册、序列查询、基因组定位、相关文献查询和靶基因预测等功能,目前已更新到 21.0 版,涵盖 223 物种,包含 28 645 条 miRNA 发夹前体,35 828 条成熟 miRNA。

- miRNA 新基因的预测和鉴定 生物信息学预测是利用 miRNA 在不同物种间的保守性、miRNA 前体具有的发卡结构(hairpin)、miRNA 与靶基因的互补性等特征设计算法,从而预测发现大量潜在的 miRNA。近年来,基于高通量测序数据的挖掘算法成为 miRNA 新基因鉴定的最主要的方法。一条候选的 miRNA 新基因一般需要满足以下条件。
1)前体具有典型的发卡结构:通过blast将候选miRNA新基因匹配到基因组,找到其前体大致的位置;从基因组中切割出可能的前体序列,通过RNAsharp或RNAfold软件进行二级结构折叠,需要满足发卡结构,且候选miRNA应该位于茎区。
2)能找到加工过程中 miRNA:miRNA* 二聚中间体:将高通量测序数据匹配到前体序列上,除了能找到 miRNA,还要能同时找到表达值较低的 miRNA*,两者互补,位于茎区,二聚体一般 3’ 端有 2 个碱基的突出,5’ 端有 2 个碱基的缩进。
3)在 AGO 蛋白中富集:因为 miRNA 只有载入特定的 AGO 蛋白才能发挥调控功能,候选的 miRNA 新基因在 AGO 富集的小 RNA(sRNA)高通量测序列数据的读数应该明显高于对照。
4)Dicer 或 DCL-1 酶加工依赖性:由于前体需要经过 Dicer 酶(动物)或 DCL-1(植物)加工才能生成 miRNA 成熟体。因此,在 Dicer 或 DCL-1 突变株中,miRNA 表达量应显著下降,甚至为 0。
由于高通量测序一次可以获得数以百万计的 sRNA 序列,要对每一条 sRNA 进行上述验证需要进行海量的计算。因此,基于高通量测序数据的 miRNA 挖掘算法的关键是根据一定的信息先大幅缩小候选 miRNA 的搜索范围,降低后期的计算量。例如,利用 miRNA 在不同物种间的保守性,用少数已报道的 miRNA 寻找高通量测序数据中同源的 sRNA。
基于植物 miRNA 对靶基因的切割调控特性及两者之间的高互补性,我们也建立了一种miRNA 逆向挖掘技术(Shao et al., 2013)。先通过降解组获取靶基因上的特异切割位点,然后以该位点为中心从靶基因上截取 21nt 的诱饵序列,再通过 blast,用诱饵序列从 AGO 富集的小 RNA 中钓取对应的互补候选 miRNA(图 7-5)。该方法的优点是找到 miRNA 的同时,也
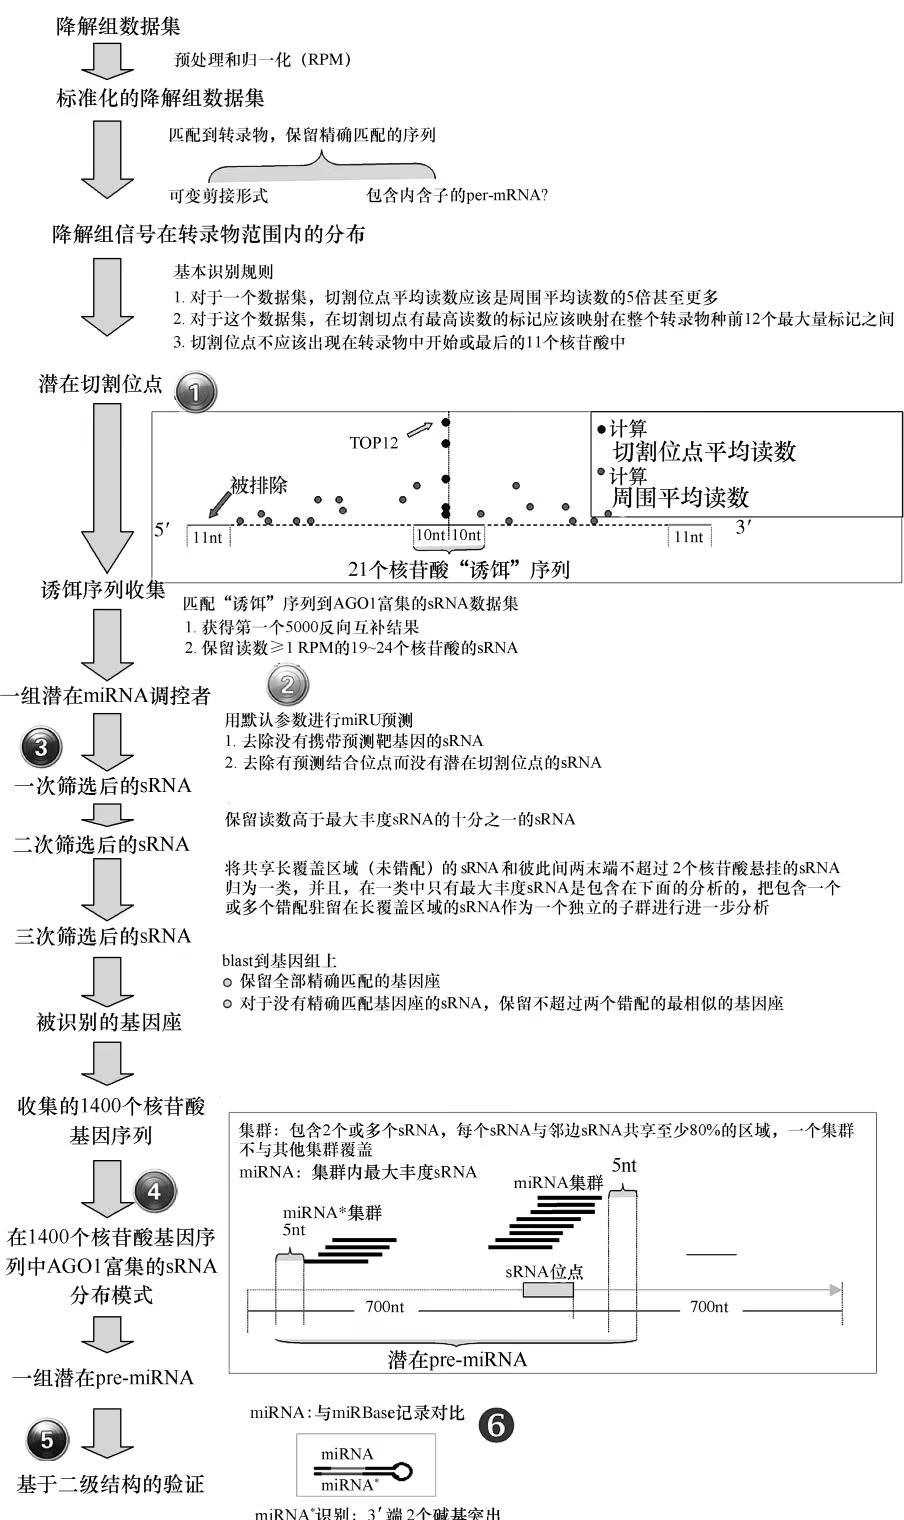
找到了它的靶基因。
由于动物 miRNA 对靶基因主要通过翻译抑制而不是切割进行调控,降解组无法发现靶基因上的切割位点,因此,该逆向挖掘技术只适合植物 miRNA 基因的大规模挖掘。但我们发现,miRNA 前体上由 Dicer(动物)/DCL-1(植物)介导产生的切割信号可被降解组测序探测到,且切割信号的位置与 miRNA(-5p)/miRNA*(-3p)的边界高度相关,可作为寻找 miRNA 新基因的标记。利用降解组对全基因组进行切割位点的扫描,并从基因组上截取包含切割位点的候选 miRNA 前体,通过发卡二级结构筛选后将 sRNA 高通量测序数据匹配到前体上,利用切割位点与 miRNA(-5p)/miRNA*(-3p)边界的高度相关性,可获得候选 miRNA。基于这一思路,我们建立了一种大规模挖掘 miRNA 新基因的新算法(Lan et al., 2016),并编写了免费共享软件 miRNA Digger(http://www.bioinfolab.cn/miRNA\_Digger/index.html)(图 7-6)。与前期建立的 miRNA 逆向挖掘技术相比,该方法不仅可用于植物,也能用于动物 miRNA 新基因的大规模挖掘。

- miRNA 靶基因的预测和鉴定 RISC 复合体在 miRNA 的指导下识别靶基因,如果 miRNA 与靶基因几乎完全互补,则切割靶基因,如果互补程度较低,则抑制靶基因翻译。由于 miRNA 与其靶基因并非完全匹配,这给确定 miRNA 靶基因带来了一定的难度。目前的 miRNA 靶基因预测的主要原理如下。
1)种子序列的互补性:miRNA 5’ 端第 2 到第 8 个核苷酸(种子序列)与靶基因 3’-UTR 的 7nt 序列完全互补配对。
2)序列保守性:miRNA 结合位点在多个物种之间如果具有保守性,则该位点更可能为 miRNA 的靶位点。
3)热动力学因素:miRNA-target 对形成的自由能越低,其可能性越大。
4)位点的可结合性:target 二级结构影响与 miRNA 的结合形成双链结构的能力。
5)UTR 碱基分布:miRNA 结合位点在 UTR 的位置和相应位置的碱基分布同样影响 miRNA 与靶基因位点的结合和 RISC 的效率。
6)miRNA 与靶基因组织分布的相关性。
相对于动物,植物 miRNA 与靶基因具有较高的互补性,一般通过切割方式进行调控。因此植物 miRNA 的靶基因预测相对简单,可靠性也较高。目前常用的预测工具是 miRU 和改进版 psRNATarget(http://www.zhaolab.org/psRNATarget/)(图 7-7)。

降解组目前已广泛应用于植物 miRNA 靶基因的大规模鉴定,其原理是植物 miRNA 主要介导靶基因的切割,且切割位点位于 miRNA 结合区域的中间(一般从 miRNA 5’ 端数过来第 10 到 11 个核苷酸之间),而降解组恰好可以检测到该特异切割峰。以拟南芥 ath-miR173-5p(UUCGCUUGCAGAGAGAAAUCAC)靶基因鉴定为例,具体如下。
1)用 psRNATarget 预测到其靶基因为 5 个,记录靶基因名称和结合位置信息(图 7-8)。
2)通过链接,提取5个靶基因序列,将归一化处理的降解组数据(TWF_summary)匹配到该序列上,保留完全匹配的降解组序列和该序列的读数,并记录该降解组序列在靶基因序列上匹配的 $5^{\prime}$ 端位置(图7-9)。
3)以靶基因位置信息为 X 轴,5’ 端匹配到该位置上降解组序列的读数为 Y 轴,做 T-plot 散点图,根据信噪比,寻找特异切割峰(图 7-10)。
从 T-plot 图中可以发现,靶基因 AT2G27400.1 在碱基位置 379 处出现特异切割峰,表明靶基因在位置 378 和 379 之间被特异切割。比较 ath-miR173-5p 在靶基因 AT2G27400.1 上预测的结合位置 367~388,该切割位点正好位于 miRNA 结合区域的中间(从 miRNA 5’ 端数过来第 10 到 11 个核苷酸之间),从而证明 ath-miR173-5p 的确可以调控靶基因 AT2G27400.1。
| 1 | Target_id:AT2G27400.1 | ||
|---|---|---|---|
| 2 | Target_Length: 930 nt | ||
| 3 | Degradome_GSM:TWF_summary | ||
| 4 | Perfect_match_Degradome_sequence | 5'_match_position | Degradome_sequence_count |
| 5 | AAAAAGCATTGGATATATTC | 554 | 0.17 |
| 6 | AAACCTAAACCCCTAAGCGG | 3 | 0.28 |
| 7 | AAACTAGAAAAAGCATTGGA | 547 | 0.56 |
| 8 | AACATATTTCAGTATATGCA | 684 | 0.34 |
| 9 | AACCAAAACATATTTCAGTA | 678 | 0.11 |
| 10 | TACAAGCGAATGAGTCATTC | 379 | 45.56 |
| 11 | AAGATATCGTGAATGATATT | 514 | 0.06 |
| 12 | AAGCATTGGATATATTCTAG | 557 | 0.4 |
| 13 | AAGCGAATGAGTCATTCATC | 382 | 0.11 |
| 14 | AATAAAAAATGGATGTTGGT | 705 | 0.28 |
| 15 | AATCTCATCTTAACTCAAAA | 84 | 0.06 |
| 16 | ACAATTTCAATATAAATGAT | 899 | 0.11 |
图 7-9 靶基因 AT2G27400.1 降解组匹配结果
我们曾统计过模式植物水稻 100 多个 miRNA 的靶基因切割信息,90% 以上都切在第 10 到第 11 之间,少数有 1 个核苷酸的偏移。如果在预测的结合位点中间未发现切割信号或切割位点偏离结合位点中间较远,则该预测的靶基因可能不是一个真实的靶基因。
动物中,miRNA 主要通过翻译抑制调控靶基因,因此,降解组无法使用,预测的靶基因需要通过实验进行验证。目前适合动物 miRNA 靶基因预测的主要软件见表 7-3。
表 7-3 常用动物 miRNA 靶基因预测软件

| 预测软件 | 特点 | 网址 |
|---|---|---|
| targetScan | 基于靶 mRNA 序列的进化保守等特征搜寻动物的 miRNA 靶基因,是预测miRNA 靶标假阳性率较低的软件 | http://www.targetscan.org/ |
| PicTar | 基于 miRNA 或 miRNA 靶标联合作用等特征搜寻动物的 miRNA 靶基因,假阳性率也较低 | http://pictar.mdc-berlin.de/ |
| Tarbase | 一个收集已被实验验证的 miRNA 靶标数据库 | http://microrna.gr/tarbase/ |
| starBase | 一个高通量实验数据 CLIP-Seq(或称为 HITS-CLIP)和 mRNA 降解组测序数据支持的 miRNA 靶标数据库,整合和构建多个流行的靶标预测软件的交集和调控关系,假阳性率也较低 | http://starbase.sysu.edu.cn/ |
第四节 IncRNA
长链非编码 RNA(lncRNA)是一类转录本长度大于 200 个核苷酸的非编码 RNA 的统称,也是目前已知最大的一类非编码 RNA,具有十分重要的功能。lncRNA 在动植物基因组中普遍存在,如在哺乳动物中超 50% 的转录本不具有蛋白质编码性。虽然 lncRNA 不编码蛋白质,但以 RNA 的形式参与多种重要生物学过程的调控,是人类基因组计划完成后,开展功能基因组学研究的热点之一。NONCODE 数据库收录了目前人类基因组中 9 万多条 lncRNA。但目前有功能报道的仅 200 条左右,人们对绝大多数 lncRNA 的功能及其和疾病的关系仍然是知之甚少。
一、lncRNA 的产生和分类
了解 lncRNA 产生和分类是进一步解析 lncRNA 功能的基础。首先,受到细胞类型和发育阶段特异的刺激,lncRNA 的产生具有细胞类型和发育阶段特异性。lncRNA 在产生过程上大体与 mRNA 类似,但也有异于 mRNA 形成的地方。例如,MALAT1 和 NEAT1 这两个 lncRNA 的 3’ 端是由 RNase P 加工,进而产生类似 tRNA 的小 RNA 产物和成熟的 lncRNA,其具有稳定的 3’ 端三重结构。根据 lncRNA 基因组上与蛋白质编码基因的位置关系,lncRNA 可以分成多种类型,如图 7-11 所示,Marko 等描绘了 lncRNA 的主要产生位置及类型,具体可以分成以下五大类:① 反义 lncRNA(antisense lncRNA),主要产生于蛋白质编码基因的反义链;② 内含子 lncRNA(intronic lncRNA),主要产生于蛋白质编码基因的内含子区域;③ 基因间区 lncRNA(intergenic lncRNA,也称 lincRNA),主要产生于两个蛋白质编码基因的中间区域;④ 分歧 lncRNA(divergent lncRNA),主要产生于蛋白质编码基因附近相反的方向;⑤ 增强子 lncRNA(enhancer lncRNA),主要产生于蛋白质编码基因的增强子区域。lncRNA 主要分布于核内和细胞质内,核内 lncRNA 占大多数,有些 lncRNA 可能同时存在于核内和细胞质内。不同类型 lncRNA 根据分布位置的不同,其发挥的作用也不同。
二、lncRNA 的功能
尽管 lncRNA 不能翻译蛋白质,但它仍然是重要的功能分子。事实上,从早期研究发现 lncRNA Xist 在 X 染色体失活中具有核心作用开始,不断涌现出大量的证据揭示 lncRNA 能够参与众多的细胞过程,如基因印记、分化和发育、抗病毒响应以及植物春化等。在已报道的 lncRNA 功能中,大部分 lncRNA 主要参与染色质修饰复合物的形成、核结构域的形成以及调控转录增强子活性,其余的 lncRNA 主要参与干扰转录机制或维持核斑点结构。目前已发现的 lncRNA 的作用机制主要涉及以下 8 种:①作为顺式(cis-)和反式(trans-)作用因子调控基因表达,并且这两种方式可以组合出现;②通过改变染色质重塑和组蛋白修饰,从而调控基因表达;③调控选择性剪接;④生成小的双链内源性干扰 RNA(siRNA);⑤调控蛋白质活性;⑥作为大分子复合物或细胞组分的支架 RNA 或组成部分;⑦改变蛋白质定位;⑧生成小的单链 ncRNA,如 miRNA。
图 7-12 是 Francesco 等整理的常见的 lncRNA 功能示意图,包含 11 种调控作用:①参与邻近基因转录的激活或抑制;②参与染色体间的互作;③参与形成核结构(如杂斑);④参与端粒区域 R-loop 结构的形成;⑤引导转录因子到特定的位置;⑥作为转录因子的“诱饵”;⑦作为染色质修饰复合物的支架;⑧作为 miRNA 的“海绵”吸附 miRNA,抑制 miRNA 的功能;⑨调控 mRNA 的降解;⑩调控 RNA 结合蛋白的细胞定位;⑪调控 DNA 结合蛋白的细胞定位。
从不断积累的 lncRNA 研究成果中可以看到 lncRNA 具有很强的异质性及功能多样性,而这取决于 lncRNA 适应不同结构和分子相互作用的能力。从其相互作用分子种类来说,lncRNA 可以和蛋白质相互作用,包括转录因子、组蛋白以及其他蛋白质等;lncRNA 可以和 RNA 相互作用,包括 mRNA、miRNA 以及其他 lncRNA 等;lncRNA 特异性地与 miRNA 结合,影响 miRNA 的表观遗传修饰作用;lncRNA 可作为竞争性内源 RNA(ceRNA)与其他具有相似 miRNA 调控模式的编码基因进行交互作用,进而互相影响彼此的表达;lncRNA 还可以和 DNA 相互作用。
因此,和 lncRNA 有关的异常有可能和疾病有关系,lncRNA 也正在成为了解疾病发生发展的新型分子,也正在成为疾病生物标志物和药物靶标的潜在分子。此外,lncRNA 的降解也与人类多种疾病(如癌症和心血管疾病等)密切相关,同时,降解的过程中也可以产生小 RNA,这些小 RNA 可能靶向其他 RNA,进而调控其功能。虽然在 lncRNA 功能方面已取得了大量的研究成果,但是仍有许多问题尚未解决。例如,是所有的还是仅仅已发现的这些 lncRNA 有功能?这些已发现的功能是否可以专门归因于 lncRNA 基因的 RNA 产物?目前主要是基于高通量实验技术(RIP-seq、ChIRP 等)获得的 lncRNA 结合蛋白、DNA 的生化和结构等特征。
三、lncRNA 在线数据库和分析软件
- LNCipedia 作为一个综合性的人类 lncRNA 数据库,包含 56 946 个基因及 127 802 个转录本的注释信息,其中整合了多个数据库及 2482 篇文献的数据,并赋予了统一的 ID。网址为 https://lncipedia.org。

- CANTATAdb 提供了 36 种植物和 3 种藻类的共计 239 631 个 lncRNA 的注释信息,是利用 RNA-Seq 数据结合生物信息学预测方法识别的。网址为 http://cantata.amu.edu.pl。

- CPC2 基于序列特征和支持向量机方法衡量 RNA 蛋白质编码潜能性的在线工具,同时提供了本地版本的下载,目前广泛应用于 lncRNA 识别。网址为 http://cpc2.gao-lab.org。

- RNAfold 利用最小自由能或配分函数预测 RNA 或 DNA 二级结构的在线工具。网址为 http://rna.tbi.univie.ac.at/cgi-bin/RNAWebSuite/RNAfold.cgi。

- RNAInter 提供了全面的 RNA 互作信息,互作类型有 “RNA-RNA” “RNA-蛋白质” “RNA-DNA” “RNA-复合物” 和 “RNA-组蛋白修饰”,包含了 154 个物种共 41 322 577 条 RNA 的互作信息,其中有 7 577 354 条 lncRNA 相关的互作信息。网址为 http://www.rna-society.org/rnainter。

- IntaRNA 能够快速而准确地预测动植物或细菌中两个 RNA 分子是否能够互作的在线工具,同时提供了本地版本的下载。网址为 http://rna.informatik.uni-freiburg.de/IntaRNA/Input.jsp。

第五节 circRNA
环状 RNA(circRNA)是区别于传统线性 RNA 的一类新型内源性 RNA,以共价键形成闭环状结构。自 20 世纪 90 年代发现第一例 circRNA 以来,人们一直将 circRNA 当成转录过程中产生的噪音。直到最近,随着新一代高通量测序技术的发展,circRNA 重回人们视野,研究者们才开始探寻其功能和作用。
与线性 RNA 不同,circRNA 并不存在 5’ 端及 3’ 端的终点,也没有 PolyA 尾。而经典的 RNA 检测方法只能分离具有 PolyA 尾结构的 RNA 分子,这也是 circRNA 在以往的研究中通常被忽略的一个原因。近年来,随着 RNA 测序(RNA-seq)技术的广泛应用和生物信息学技术的快速发展,人们发现 circRNA 广泛且多样地存在于真核细胞中。其调控的复杂性,以及在疾病发生中的重要作用越来越受到大家的重视(Jing et al., 2017)。
一、circRNA 的生物合成
研究表明,circRNA 通常由一种非经典的可变剪切方式(反向剪切,back splicing)产生。根据 Liu 等的总结,现有的 circRNA 形成过程主要有以下 4 种(图 7-13)。
1)剪接体依赖的环化途径 [图 7-13(a)]:大多数真核环状 RNA 是由选择性剪接(可变剪接)产生的。可变剪接是真核基因表达过程中的一个重要步骤,由剪接体或 I / II 型核酶驱动。反向剪切也需要剪接体,虽然具体机制仍不明确,研究者们也有了大致猜想:剪接体的 snRNP(核小核糖蛋白)对 pre-mRNA 进行相继装配之后,下游外显子的 5’ 端供体位点与上游的 3’ 端受体位点结合在一起,从而促进环状 RNA 的生成。
2)内含子配对驱动的环化途径 [图 7-13(b)]:很多 circRNA 的形成依赖于一个反向互补的基序促进环化。基序两端分别是靠近 5’ 端剪接位点的 7nt 长度的 GU 富集片段,和靠近分支位点的 11nt 长度的 C 富集片段;原转录本上的供体-受体配对可能由于 5’ 端到 3’ 端的可变剪接而变得足够靠近,从而推动环状 RNA 生成。
3)套索驱动的环化途径 [图 7-13(c)]:在经典的跳过外显子的可变剪接过程中,会生成一个套索状的副产物。这一过程在典型的线性可变剪接中常常看到,也是本类途径的特征。类似上一种途径,原本不相邻的外显子在空间上靠近,引发对其供体位点和受体位点的可变剪接,被跳过的区域进一步经过套索剪接形成由外显子组成的环状 RNA。外显子侧翼内含子中 Alu 元件的重复和反向互补序列的富集都是 2)和 3)途径的特征,可以用于分析和预测成环机制。
4)蛋白因子结合环化途径 [图 7-13(d)]:有一些 RBP(RNA 结合蛋白)可以结合内含子区特定的靶序列,使得供体-受体序列在空间上靠近,从而促进环化。在此过程中,RBP既可以固定剪接基序的位置,也可以对线性 RNA 剪接起到妨碍作用。当然,一些 RBP 与靶序列的结合也会抑制环状 RNA 的产生,如腺苷脱氨酶类蛋白。
二、circRNA的特性
circRNA 的发现补足或解释了以前很多存疑的研究。很久以前,人们就发现了数千例基因序列的 “混乱” 现象,如内含子和外显子的顺序被打乱。最开始人们以为这是剪接错误的体现,是由于癌症细胞中的剪接功能被扰乱所致。然而,在癌症样本的对照样本中,人们也发现了内含子扰乱的现象。同样,RNA-seq 的结果也常见这一现象,研究者们起初将其归于常见的基因组重排,就无视了外显子顺序的改变,或者丢弃这部分数据,将其视作实验错误。在发现 circRNA 的特性之后,人们才了解到这些实验结果并不一定是剪接的错误。此外,基因组中有一些基因是没有内含子的,这些基因也同样会生成 circRNA。一个例子就是 CDR1 基因,其编码一种小脑退化相关蛋白。miR-671 调控这个基因,但具体调控机制一直不为人所知,因为似乎 miR-671 是只能和该基因 DNA 反义链结合的。后来,人们发现 CDR1 会转录成一个环状 RNA,这才解开了调控之谜。
目前,人们已经发现了 circRNA 的许多特性。circRNA 含量丰富,在细胞中多有发现,人类细胞中的 circRNA 甚至能达到 25 000~100 000 种,数量远超线性 RNA。不同物种间的 circRNA 通常具有一定的进化保守性,但也有一些 circRNA 不保守。circRNA 由 DNA 转录而来,但一般不翻译成蛋白质。虽然不易被 RNase 降解,只要 siRNA 对应的靶序列在 circRNA 中存在但 circRNA 仍然可被该 siRNA 降解。不过当 siRNA 作用于线性 RNA 的末端时,拥有共同靶序列的 circRNA 可能并不会被沉默,这也许是空间结构上的原因。circRNA 主要在细胞质中被发现,而不出现在核糖体中。circRNA 的结构稳定,与 mRNA 相比可以持续存在较长时间。与线性 RNA 合成的速度相比,circRNA 合成速度其实非常慢。但由于封闭环状结构,使得其对核酸外切酶免疫,因此稳定性远远超过线性 RNA。某些 circRNA 的表达丰度可以超过对应的 mRNA 10 倍。随着时间的积累,细胞内 circRNA 可以达到很高的浓度,特别是神经细胞,因为没有分裂稀释,浓度更高。
三、circRNA 的分类
circRNA 分子根据其在基因组中的来源及其构成序列的不同,一般可分为 5 类:即外显子来源的环状 RNA 分子(exonic circRNA, ecircRNA)、内含子来源的环状 RNA 分子(intronic circRNA, ciRNA)、由外显子和内含子共同组成的环状 RNA 分子(exon-intron circRNA, EIciRNA)、反义链来源的环状 RNA 分子,以及基因间区来源的环状 RNA 分子。
目前报道的 circRNA 大部分是来自外显子的 ecircRNA,主要定位在细胞质中,在转录后起调控作用;而含有内含子的 ciRNA 和 EIciRNA 则定位在细胞核中,调节其亲本线性 mRNA 的转录。
四、circRNA 的主要功能
目前的研究表明,circRNA 具有 miRNA 的海绵吸附、调控亲本基因表达、翻译蛋白质、产生假基因、影响选择性剪接等功能(图 7-14)。由于 circRNA 在疾病发生的起始和发展阶段发挥重要作用,因此可以作为潜在的靶向治疗生物标志(biomarker)。
1)circRNA发挥竞争性内源RNA(ceRNA)的作用,像海绵一样吸附miRNA。2013年,两个研究团队在Nature上发文报道,CDR1基因起源的环状RNA(ciRS-7)可以结合吸附miR-7,从而降低miR-7的活性,间接上调miR-7相关靶基因的表达。由于环状RNA的稳定性,在机体内潜在对miRNA的吸附能力要强于线性mRNA和lncRNA。
2)circRNA 顺式调控亲本基因的表达。含内含子序列的环状 RNA(ciRNA、EIciRNA)一般常驻细胞核内,与 RNA 结合蛋白相互结合,调节亲本基因 mRNA 的表达。另一方面,环状 RNA 形成过程中内含子间竞争性互补配对可以与线性 RNA 之间达成一种平衡,影响 mRNA 的表达,甚至蛋白质翻译。
3)circRNA 作为模板,通过滚环扩增(rolling circle amplification)机制翻译蛋白质。绝大多数的 circRNA 属于非编码 RNA,但有些 circRNA 可以编码并表达蛋白质或多肽。
4)circRNA 产生假基因。Li Yang 等发现,一些假基因可由 circRNA 反转录转座而来,并在哺乳动物基因组中遗传,有可能通过提供增加的转录因子 CTCF 结合位点重塑了基因组结构。
5)circRNA 影响选择性剪切。circRNA 的合成可以和 pre-mRNA 剪接竞争,导致线性 mRNA 表达降低,还可通过排除特定的外显子改变加工的 mRNA 的组成。
五、circRNA 在线数据库和分析软件

- deepBase v3.0 包含了大约 15 万的 circRNA 基因(人、鼠、果蝇、线虫等),构建了最全面的 circRNA 的表达图谱。网址为 http://rna.sysu.edu.cn/deepbase3/index.html。

- circBase 收集和整合已经发布的 circRNA 数据构建的数据库。网址为 http://www.circbase.org/。

- CircNet 2.0 提供了新 circRNA 的鉴定;整合 circRNA-miRNA-mRNA 的互作网络;circRNA 亚型的表达水平;circRNA 亚型的基因组注释;circRNA 亚型的序列。网址为 http://awi.cuhk.edu.cn/\~CircNet/php/index.php。

- CircPro 提供一个 pipeline,整合 Ribo-seq 和 RNA-seq 数据来预测 circRNA 及其编码潜能。网址为 http://bis.zju.edu.cn/CircPro/。

- miARma-Seq 一个综合分析软件,可以发现任何测序物种的 mRNA、miRNA 和 circRNA,并可以区分表达量,预测 miRNA 的 mRNA 靶基因或功能分析,可在 3 种不同的操作系统中运行。网址为 https://sourceforge.net/projects/miarma/。
第六节 其他小分子 RNA
小分子 RNA(small RNA)是 20~40 个核苷酸的非编码 RNA 分子,出现在大多数真核生物中,在转录或转录后调节基因的表达,主要包括 miRNA 和 siRNA 等,本节主要讲述除 miRNA 之外的其他小分子 RNA。
一、siRNA
(一) siRNA 的生物合成
小干扰 RNA(small interfering RNA,siRNA)是一种小 RNA 分子(21~25 个核苷酸),由 Dicer(RNAase III 家族中对双链 RNA 具有特异性的酶)加工双链 RNA(dsRNA)而成。siRNA 是 RISC 的主要成员,激发与之互补的目标 mRNA 的沉默(Okamura and Lai,2008)。RNA 干扰机制中的关键分子 dsRNA 的常见来源有以下几类:细胞内源性基因的双向表达;具有反向重复结构的细胞内源性基因表达形成的发夹状 RNA(shRNA);转基因表达的 mRNA 异常聚合;转座子转录;RNA 病毒基因组或病毒感染复制过程中的中间 RNA 产物;实验方法通过质粒载体或病毒载体转染表达的 dsRNA 或 shRNA 等。
(二)siRNA 的主要功能
小干扰 RNA 为双股 RNA,在生物学上有许多不同的用途。目前已知 siRNA 主要参与 RNA 干扰(RNAi)现象,以带有专一性的方式调节基因的表达。此外,也参与一些与 RNAi 相关的反应途径,如抗病毒机制或是染色质结构的改变。其生理意义在于生物的抗御机制,调控细胞分化与胚胎发育,维持基因组的稳定,以及 RNA 水平上的调控机制(Iadevaia and Gerber,2015)。
RNA干扰在实验室中是一种强大的实验工具,利用具有同源性的双链RNA诱导序列特异的目标基因的沉寂,迅速阻断基因活性。siRNA在RNA沉寂通道中起中心作用,是对特定mRNA进行降解的指导要素。siRNA是RNAi途径中的中间产物,是RNAi发挥效应所必需的因子。siRNA的形成主要由Dicer和Rde-1(RNAi缺陷基因-1)调控完成。由于RNA病毒入侵、转座子转录、基因组中反向重复序列转录等原因,细胞中出现了dsRNA,Rde-1编码的蛋白质识别外源dsRNA,当dsRNA达到一定量的时候,Rde-1引导dsRNA与Rde-1编码的Dicer结合,形成酶-dsRNA复合体。在Dicer酶的作用下,细胞中的单链靶mRNA(与dsRNA具有同源序列)与dsRNA的正义链互换,原来dsRNA中的正义链被mRNA代替而从酶-dsRNA复合物中释放出来,然后,在ATP的参与下,细胞中存在的RISC,利用结合在其上的核酸内切酶的活性来切割dsRNA上处于原来正义链位置的靶mRNA分子中与dsRNA反义链互补的区域,形成 $21\sim 23\mathrm{nt}$ 的dsRNA小片段,这些小片段即为siRNA。RNAi干扰的关键步骤是组装RISC和合成介导特异性反应的siRNA蛋白。siRNA并入RISC中,然后与靶标基因编码区或UTR完全配对,降解靶标基因。siRNA只降解与其序列互补配对的mRNA,其调控的机制是通过互补配对而沉默相应靶位基因的表达,是一种典型的负调控机制。siRNA识别靶序列具有高度特异性,降解首先在相对于siRNA来说的中央位置发生,所以这些中央的碱基位点就显得极为重要,一旦发生错配就会严重抑制RNAi的效应,相对而言, $3^{\prime}$ 端的核苷酸序列并不要求与靶mRNA完全匹配。
(三)siRNA的应用
RNAi除可以用作基因沉默外,还可以用于基因功能分析。dsRNA介导的转录后基因沉默(post-transcriptional gene silencing,PTGS)于1988年首先在植物和线虫中进行了报道。植物上进行RNAi的实验技术包括稳定转化法递送双链DNA和瞬时表达。稳定转化的方法包括基因枪法(轰击法)、聚乙二醇法、电穿孔法及农杆菌法,原理是通过植物转基因的方法,把目的基因转入受体细胞,使之表达产生dsRNA,进而产生RNAi现象来研究基因的功能或实现相应的基因沉默。瞬时表达可分为离子轰击法递送双链RNA、农杆菌渗入法递送双链RNA及通过病毒载体递送dsRNA等,是通过递送目的dsRNA到细胞中,观察特定基因片段的作用。
二、ta-siRNA
反式作用干扰小 RNA(ta-siRNA)是由 miRNA 介导生成长度为 21 个核苷酸的小 RNA,为植物特有的内生性 sRNA。ta-siRNA 的产生需要由 miRNA 的剪切引发,之后通过 siRNA 途径形成。ta-siRNA 来自 TAS 基因的转录本,通过特异的 miRNA 引导的相位切割产生 21nt 的 ta-siRNA。miRNA 引导的切割在 ta-siRNA 的生成过程中是不可或缺的。在 ta-siRNA 产生过程中,TAS 家族基因会与特异的 miRNA 相匹配,以目前发现的拟南芥中的 TAS 基因为例,TAS1 和 TAS2 依赖于 miR173 的剪切,TAS3 依赖于 miR390 的剪切,TAS4 依赖于 miR828 的剪切(Jouannet and Maizel,2012)。
植物中绝大多数的靶基因被miRNA切割后都会降解,只有少数miRNA才可以激发ta-siRNA的合成。目前的研究提出了3种激发模型。第一种是以miRNA390-TAS3为代表的“Two-hit”模型(Michael et al., 2006)。该模型要求很苛刻,一般植物miRNA都是与AGO1结合切割靶基因,但该模型要求激发miRNA与AGO7结合,且在靶基因上有两个结合位点,并且只有下游结合位点发生切割。第二种以miRNA173-TAS1/TAS2为代表的“One-hit”模型,该模型对激发miRNA的长度有要求,必须是22nt(Chen et al., 2010)。目前发现的绝大多数激发ta-siRNA合成的miRNA或siRNA都符合这种模型。第三种模型认为除了22nt的miRNA可以激发以外,不对称的miRNA:miRNA*二聚体也可以激发ta-siRNA的合成(Pablo et al., 2012)。
当 TAS 基因的初级转录本被 miRNA 切割后,并没有降解,在 SGS3 和 RDR6 的作用下复制形成 dsRNA,之后 DCL-4 在 miRNA 剪切位点处开始以 21nt 为单位进行连续相位切割 dsRNA,形成一系列在 3’ 端具有 2 个悬挂碱基的双链 siRNA。随后,双链 ta-siRNA 中的一条链与 AGO 蛋白形成复合物,介导其他基因的切割降解。
ta-siRNA 介导的基因表达调控参与了植物生长期的转换、逆境适应、花叶等侧生器官背腹性发育等重要生物过程,是 miRNA 调控机制的重要组成部分。目前研究发现,一些蛋白质编码基因也可以生成 ta-siRNA,并且有的 ta-siRNA 也可以激发靶基因形成下一级的 ta-siRNA。
三、piRNA
与 Piwi 蛋白相作用的 RNA 称为 piRNA。piRNA 在基因组中显示出与众不同的定位类型,主要成群地分为长 20~90kb 的基因簇,其中长片段的小分子 RNA 只能来源于单链。相似的 piRNA 在人类和小鼠中均有发现,大部分基因簇出现在同一染色体位置上。虽然 piRNA 的功能仍然需要研究阐明,但是生殖细胞中的 piRNA 富集现象和 Piwi 突变导致的男性不育表明 piRNA 在配子形成的过程中起作用。
(一) piRNA 的生物合成
piRNA 的生成有两个主要途径:初级合成路径和次级 piRNA 扩增乒乓循环路径(图 7-15)。初级 piRNA 倾向于在核酸 5’ 端含有一个尿苷,而次级 piRNA 在 5’ 端有 10nt 序列和初级 piRNA 互补,并且在第 10 个核苷酸位置倾向于包含有意义的腺苷。下面以果蝇 piRNA 的生物合成为例来讲述合成路径。
piRNA 的初级合成:在果蝇卵巢,初级合成路径存在于生殖细胞和周围的体细胞,而乒乓循环只存在于生殖细胞。在果蝇卵巢体细胞的初级路径,Piwi 亚家族中仅 Piwi 表达,piRNA 前体是从 piRNA 簇转录,如 flamenco(flam)基因座的长单链经过多步完成的转录。从 piRNA 簇来的长初级转录产物,可能进入细胞质中被加工成中等长度,但是过程中很多详细步骤仍然未知。加工过程需要位于线粒体表面的 Zucchini(Zuc)核酸内切酶,常生成 5’ 端为 U 的前体 RNA。转运和随后的成熟步骤可能发生在细胞核周围,形成于线粒体表面的颗粒称为 Yb 体。在前体的加工过程中,Minotaur(Mino)和 GasZ 同时聚集于线粒体表面发挥作用。在未知的 3’→5’ 核酸外切酶作用下,前体物进一步剪切加工成成熟 piRNA 大小。DmHen1/Pimet 甲基转移酶和 2’-O-methylates 甲基酶进一步作用生成成熟 Piwi-piRNA 复合物或 Piwi-piRISC。Piwi-piRNA 复合物进入细胞核中调节目标基因,无 Piwi 蛋白的 piRNA 留在细胞质中。在果蝇生殖系细胞中初级 piRNA 也来源于如 42AB 座双链 piRNA 并加载到 Aub 和 Piwi 蛋白形成 piRISC。
piRNA 的次级合成:Aub-piRISC 复合体启动细胞质中的乒乓(ping-pong)循环和 AGO3 一起作用生成次级 piRNA。乒乓循环被认为发生在细胞核周围的一个电子致密的称为 nuage 的非膜结构。Piwi 蛋白和许多其他 piRNA 产生过程中的因子在该结构聚集。在乒乓循环路径,AGO3 和 Aub 以互补的方式在它们的剪切活性作用下切开正反转位子转录物。piRNA 以一种前馈机制产生,这样导致了转座子转录本的消减,从而沉默转座子。产生在卵巢的 piRNA 在卵中以 Aub-piRISC 的形式积累,这也导致了在卵中乒乓循环的启动并促进 piRNA 的合成(Iwasaki et al., 2015)。
(二)piRNA 的主要功能
piRNA 主要存在于哺乳动物的生殖细胞和干细胞中,通过与 Piwi 亚家族蛋白结合形成 piRNA 复合物(piRC)来调控基因沉默途径。对 Piwi 亚家族蛋白的遗传分析以及 piRNA 积累的时间特性研究发现,piRC 在配子发生过程中起着十分重要的作用,还能维持生殖系和干细胞功能,调节翻译和 mRNA 的稳定性。
四、其他常见小分子 RNA
(一) tmRNA
转移-信使 RNA(transfer-messenger RNA,tmRNA)是一类具有类似 tRNA 和 mRNA 双重功能的小分子 RNA,它在一种特殊的翻译模式-反式翻译模式过程中发挥重要作用。它是一类普遍存在于各种细菌及细胞器(如线粒体、叶绿体等)中长 260~430 个核苷酸的稳定小分子 RNA。tmRNA 主要包括 12 个螺旋结构和 4 个“假结”结构,同时还包括 1 个可译框架序列的单链 RNA 结构。tmRNA 中 H1 由 5’ 端和 3’ 端两个末端形成,与 tRNA 的氨基酸受体臂相似。H1 和 H2 的 5’ 端部分之间有一个由 10~13 个核苷酸形成的环,类似 tRNA 中的二氢尿嘧啶环,称为“D”环。H3 和 H4、H6 和 H7、H8 和 H9、H10 和 H11 之间分别形成 pK1、pK2、pK3、pK4。H4 和 H5 之间则由一段包含编码标记肽 ORF 的单链 RNA 连接。H12 由 5 个碱基对和 7 个核苷酸形成的环组成,类似 tRNA 中的 TΨC 臂和 TΨC 环,称为“T”环。tmRNA 结构按照功能进行划分可分为 tRNA 类似域(TLD)和 mRNA 类似域(MLD)。TLD 主要包括 H1、H2、H12、“D”环和“T”环,MDL 则包括 ORF 和 H5,这两部分分别具有类似 tRNA 和 mRNA 的功能。tmRNA 与基因的表达调控以及细胞周期的调控等生命过程密切相关,是细菌体内蛋白质合成中起“质量控制”的重要分子之一。识别翻译或读码有误的核糖体,也识别那些延迟停转的核糖体,介导这些有问题的核糖体的崩解。
(二) snRNA
核小 RNA(snRNA)是真核生物转录后加工过程中 RNA 剪接体的主要成分,参与 mRNA 前体的加工过程。另外,还有端粒酶 RNA(telomerase RNA),它与染色体末端的复制有关;以及反义 RNA(antisense RNA),它参与基因表达的调控及 RNA 剪接和 RNA 修饰等。

思考题
列举非编码 RNA 的种类。
思考非编码 RNA 对于生物体的意义。
使用数据库下载 lncRNA、miRNA 和基因的互作关系,并构建互作网络。
尝试对非编码 RNA 进行功能预测。

主要参考文献
Chen H M, Chen L T, Patel K, et al. 2010. 22-Nucleotide RNAs trigger secondary siRNA biogenesis in plants. Proc Natl Acad Sci USA, 107 (34): 15269-15274
Chen J, Xue Y. 2016. Emerging roles of non-coding RNAs in epigenetic regulation. Science China Life Sciences, 3: 1-9
Cioce M, Lamond A I. 2005. CAJAL BODIES: a long history of discovery. Annual Review of Cell & Developmental Biology, 21: 105-131
Egeland D B, Sturtevant A P, Schuler M A. 1989. Molecular analysis of dicot and monocot small nuclear RNA populations. Plant Cell, 1: 633-643
Falaleeva M, Stamm S. 2013. Processing of snoRNAs as a new source of regulatory non-coding RNAs: snoRNA fragments form a new class of functional RNAs. Bioessays, 35: 46-54
Gibb E A, Brown C J, Wan L L. 2011. The functional role of long non-coding RNA in human carcinomas. Molecular Cancer, 10: 38
Iadevaia V, Gerber A P. 2015. Combinatorial control of mRNA fates by RNA-binding proteins and non-coding RNAs. Biomolecules, 5: 2207-2222
Iwasaki Y W, Siomi M C, Siomi H. 2015. PIWI-interacting RNA: its biogenesis and functions. Annual Review of Biochemistry, 84: 405-433
Jing L, Tian L, Wang X, et al. 2017. Circles reshaping the RNA world: from waste to treasure. Molecular Cancer, 16 (1): 58
Jouannet V, Maizel A. 2012. Trans-Acting Small Interfering RNAs: Biogenesis, Mode of Action, and Role in Plant Development. Berlin Heidelberg: Springer
Lan Y, Chaogang S, Xinghuo Y, et al. 2016. miRNA Digger, a comprehensive pipeline for genomic-wide, novel miRNA mining. Scientific Reports, 6: 18901
Li X Y, Dechao B, Liang S, et al. 2017. Using the NONCODE database resource. Curr Protoc Bioinformatics, doi:10.1002/cpbi.25
Mattick J S, Makunin I V. 2006. Non-coding RNA. Human Molecular Genetics, 15 (1): R17-R29
Maxwell E S, Fournier M J. 1995. The small nucleolar RNAs. Annual Review of Biochemistry, 64: 897-934
Michael J A, Calvin J, Ramya R, et al. 2006. A two-hit trigger for siRNA biogenesis in plants. Cell, 127: 565-577
Okamura K, Lai E C. 2008. Endogenous small interfering RNAs in animals. Nature Reviews Molecular Cell Biology, 9: 673-678
Pablo A M, Daniel K, Detlef W. 2012. Plant secondary siRNA production determined by microRNA-duplex structure. Proc Natl Acad Sci USA, 109 (7): 2461-2466
Rodriguez A, Griffithsjones S, Ashurst J L, et al. 2004. Identification of mammalian microRNA host genes and transcription units. Genome Research, 14: 1902-1910
Saetrom P, Jr S O, Rossi J J. 2007. Epigenetics and microRNAs. Pediatric Research, 61: 24R-29R
Shao C G, Chen M, Meng Y J. 2013. A reversed framework for the identification of microRNA-target pairs in plants. Brief Bioinform, 14 (3): 293-301
Wahid F, Shehzad A, Khan T, et al. 2010. MicroRNAs: synthesis, mechanism, function, and recent clinical trials. Biochimica Et Biophysica Acta, 1803: 1231-1243
第八章 蛋白质组学
本章提要
在现代生物学研究中,科学家们从一开始就希望找到一条能够更好地阐明蛋白质序列、结构与功能之间关系的途径。分子生物学中心法则指明生命及一切生命活动过程都是由一系列的信息流所组成的,
而这个信息流的源头就是生物体的 DNA 序列。DNA 编码的蛋白质序列能够确定最终蛋白质的三维立体结构,而具有立体结构的蛋白质决定了它所行使的功能。尽管在各个基因组计划中测序项目引起了广泛的关注,但这些基因组计划的最终目的都是确定基因组是如何通过蛋白质来实现生命活动的各项功能。蛋白质组是指在一个特定样本(细胞、组织或器官)中所表达的一整套蛋白质。蛋白质组学则是对样本中的所有蛋白质进行研究,它不仅包括对表达蛋白质的大规模鉴定及定量分析,也包括对蛋白质的功能、细胞定位、修饰,以及蛋白质的相互作用进行确定。本章主要讲述如何利用生物信息学方法与理论进行蛋白质的表达、翻译后修饰、定位及蛋白质的相互作用分析。
第一节 蛋白质组学概述
“蛋白质组学”(proteomics)和“蛋白质组”(proteome)是澳大利亚科学家 Marc Wilkins 及其同事在 20 世纪 90 年代初提出的,与“基因组学”(genomics)和“基因组”(genome)相对应,意为“一个基因组、一种生物或一种细胞、组织所表达的全套蛋白质”(Wilkins et al., 1995; 1996)。
“Proteome”一词源于“PROTEin”与“genOME”的杂合,其中“-omics”是“组学”的意思,代表对生物学和生物体系运作的一种全局的研究方式,即从整体的角度来研究一个生物体、细胞或组织。
(一)蛋白质组学的产生
蛋白质是生理功能的执行者,是生命现象的直接体现者,对蛋白质结构和功能的研究将直接阐明生命在生理或病理条件下的变化机制。蛋白质本身的存在形式和活动规律,如翻译后修饰、蛋白质间相互作用及蛋白质构象等问题,仍依赖对蛋白质的研究来解决。蛋白质组学的研究可望提供精确、详细的有关细胞或组织状况的分子描述。因为诸如蛋白质合成、降解、加工、修饰的调控过程只有通过对蛋白质的直接分析才能揭示。
因此,蛋白质组学应运而生,它以细胞内全部蛋白质的存在及其活动方式为研究对象。可以说蛋白质组学研究的开展不仅是生命科学研究进入后基因组时代的里程碑,也是后基因组时代生命科学研究的核心内容之一。2001年国际权威杂志 Science 把蛋白质组学列为六大研究热点之一,其“热度”仅次于干细胞研究,名列第二,因此,蛋白质组学的发展备受关注(van Wijk, 2001)。
(二)蛋白质组学研究的新进展
从近年来已发表的蛋白质组学研究相关论文分析,蛋白质组学技术已经广泛应用于蛋白质鉴定、蛋白质翻译后修饰和蛋白质-蛋白质互作等领域,近年来主要在以下5个方面取得显著进展。
蛋白质的分离与鉴定 由于在蛋白质组学和比较蛋白质组学研究中采用了“蛮力(brute force)”的鉴定技术,极大促进了差异表达蛋白质的研究。其中双向凝胶电泳(two-dimension electrophoresis,2-DE)技术广泛地应用于可溶性蛋白质和细胞膜外表面蛋白质的分离和鉴定。一般在第一相中采用固定化pH梯度(IPG)胶条,第二相采用SDS-聚丙烯酰胺凝胶电泳(SDS-PAGE),获得分辨率达到数千点的蛋白质图谱,然后运用生物质谱技术进行蛋白质的鉴定。但对溶解性较差的细胞膜蛋白,可采用色谱技术和分步提取技术进行分离。一维电泳和二维电泳结合Western blotting技术,或是利用蛋白质芯片和抗体芯片及免疫共沉淀技术也能鉴定蛋白质。
蛋白质互作或蛋白质复合体研究 不断有新的技术应用于蛋白质-蛋白质互作或者蛋白质复合体的分析研究上。例如,在第一相中采用蓝色非变性聚丙烯酰胺凝胶(blue native PAGE)技术分离蛋白质复合体,第二相利用 SDS-PAGE 技术进一步分离复合体中的蛋白质,可进行大规模的蛋白质互作分析。对低丰度的蛋白质复合体,有效的策略是先应用转基因技术对生物体进行表位标记(epitope tagging),然后进行亲和沉淀纯化。
蛋白质翻译后修饰分析 翻译后修饰是蛋白质功能调节的重要方式,mRNA 表达产生的蛋白质要经历翻译后修饰,如磷酸化、糖基化等。对蛋白质翻译后修饰的研究对阐明蛋白质的功能具有重要作用。当前,蛋白质翻译后修饰的鉴定技术主要有标记技术、质谱技术、特定抗体技术、特定染色剂技术等。
蛋白质功能鉴定研究 蛋白质功能鉴定研究如分析蛋白酶的活性及确定酶所催化的底物,蛋白质-蛋白质互作及配基-受体的结合分析等。可以利用基因敲除或基因反义技术分析基因产物——蛋白质的功能。另外对蛋白质的亚细胞定位研究也在一定程度上有助于对蛋白质功能的了解,如 Clontech 的荧光蛋白表达系统就是分析蛋白质在亚细胞定位的一个较常用技术。
蛋白质复合体整体结构分析 应用限制性蛋白酶水解技术,结合交叉连接(cross-linking)或同位素交换技术(isotope exchange)进行蛋白质复合体的结构分析。
第二节 蛋白质的大规模分离鉴定技术
蛋白质具有多样性与易变性的特点,从而使蛋白质组学的研究技术远比基因技术复杂和困难。一方面,由于基因的拼接和翻译后的修饰,生物体中蛋白质的数目远大于基因的数目。一个细胞中的蛋白质可多达上万种,而它们的拷贝数可能相差几百倍到几十万倍。例如,人的基因组可能有25 000~40 000个编码基因,其蛋白质数量可能达十几万甚至更多。另一方面,基因是相对静态的,一种生物体仅有一个基因组;而蛋白质是动态的,随时间、空间的变化而变化。
理想的蛋白质分离方法首先要具备超高分辨率,能够将成千上万个蛋白质包括它们的修饰物同时分离,并与后续的鉴定技术有效衔接。这种理想的分离方法还应当对不同类型的蛋白质,包括酸性、碱性、疏水、亲水、相对分子质量小或大的蛋白质均能有效分离。
二维凝胶电泳是利用蛋白质的等电点和分子质量对蛋白质进行分离,是一种十分有效的手段,它在蛋白质组分离技术中起到了关键作用。
一、蛋白质二维电泳-质谱技术
(一)蛋白质二维电泳技术
二维电泳和质谱技术联用已成为近年最流行、最可靠的蛋白质分离与鉴定技术平台。最早的二维电泳(2-DE)方法是Farrell于1975年首先提出的,它是根据蛋白质的等电点和分子质量的差异,连续进行成垂直方向的两次电泳将其分离。二维电泳一次可以分离几千个蛋白质。用固定化pH梯度(immobilized pH gradient,IPG)干胶条代替两性电解质,加上与干胶条相配套的电泳仪,如PROTEAN IEF Cell、IPG-phor等进行第一向等电聚焦,不仅极大地提高了电泳的分辨率,也提高了结果的可重复性。尽管如此,2-DE技术仍存在许多不足,如膜蛋白、碱性蛋白、低丰度蛋白的分离与检测,以及重复性、规模化、自动化等问题。对2-DE技术的改进,包括对2-DE样品的前处理及2-DE后的蛋白质点检测的研究一直在进行。除二维凝胶电泳技术外,用于蛋白质组分离的技术还有亲和层析、毛细管等电聚焦、毛细管区带电泳和反向高效液相色谱等。
荧光差异凝胶电泳(difference gel electrophoresis, DIGE)技术是对2-DE在技术上的改进,结合了多重荧光分析的方法,在同一块胶上共同分离多个分别由不同荧光标记的样品,并第一次引入了内标的概念。两种样品中的蛋白质采用不同的荧光标记后混合,进行2-DE,用来检测蛋白质在两种样品中表达情况,极大地提高了结果的准确性、可靠性和可重复性。在DIGE技术中,每个蛋白质点都有它自己的内标,并且软件可全自动根据每个蛋白质点的内标对其表达量进行校准,保证所检测到的蛋白质丰度变化是真实的。DIGE技术已经在各种样品中得到应用,包括人、大鼠、小鼠、真菌、细菌等,主要用于功能蛋白质组学,如各种肿瘤研究、寻找疾病分子标志物、揭示药物作用的分子机制或毒理学研究等。
(二)质谱技术
对分离的蛋白质进行鉴定是蛋白质组研究的重要内容。蛋白质微量测序、氨基酸组成分析等传统的蛋白质鉴定技术不能满足高通量和高效率的要求,从而使生物质谱技术成为蛋白质组学的另一支撑技术。
生物质谱技术在离子化方法上主要有两种软电离技术,即基质辅助激光解吸电离(matrix-assisted laser desorption/ionization,MALDI)和电喷雾电离(electrospray ionization,ESI)。MALDI是在激光脉冲的激发下,使样品从基质晶体中挥发并离子化;ESI使分析物从溶液相中电离,适合与液相分离手段(如液相色谱和毛细管电泳)联用。MALDI适于分析简单的肽混合物,而液相色谱与ESI-MS的联用(LC-MS)适合复杂样品的分析。
软电离技术的出现拓展了质谱的应用空间,而质量分析器的改进也推动了质谱仪技术的发展。生物质谱的质量分析器主要有4种:离子阱(ion-trap,IT)、飞行时间(time of flight,TOF)、四极杆(quadrupole)和傅里叶变换离子回旋共振(Fourier transform ion cyclotron resonance,FTICR)。它们的结构和性能各不相同,每一种都有自己的长处与不足。它们可以单独使用,也可以互相组合形成功能更强大的仪器。MALDI通常与TOF质量分析器联用,分
析肽段的精确质量,而 ESI 常与离子阱或三级四极杆质谱联用,通过碰撞诱导解离(collision-induced dissociation, CID)获取肽段的碎片信息。
离子阱质谱灵敏度较高,性能稳定,具备多级质谱能力,因此被广泛应用于蛋白质组学研究,不足之处是质量精度较低。与离子阱相似,傅里叶变换离子回旋共振(FTICR)质谱也是一种可以“捕获”离子的仪器,但是其腔体内部为高真空和高磁场环境,具有高灵敏度、宽动态范围、高分辨率和质量精度(质量准确度可很容易地小于1mg/L),这使得它可以在一次分析中对数百个完整蛋白质分子进行质量测定和定量。FTICR-MS的一个重要功能是多元串联质谱,与通常的只能选一个母离子的串级质谱方式不同,FTICR-MS可以同时选择几个母离子进行解离,这无疑可以大大增加蛋白质鉴定工作的通量;但是它的缺点也很明显,如操作复杂、肽段断裂效率低、价格昂贵等,这些缺点限制了它在蛋白质组学中的广泛应用。
二、一维(二维)色谱-质谱技术
除了蛋白质双向电泳-质谱的蛋白质分类鉴定策略,一维电泳(色谱)-质谱技术、二维色谱-串联质谱技术在蛋白质组学研究中也得到广泛应用。这两种技术在某种程度上弥补了2-DE技术的一些缺陷。
(一)一维电泳(色谱)- 质谱技术(HPLC-MS)
- 一维 SDS-PAGE 电泳(色谱)-质谱技术 一维 SDS-PAGE 电泳结合 MALDI-TOF-MS 技术,或者蛋白质复合物经酶切后用 LC-MS-MS 技术进行分析均被前人的研究证明是有效的蛋白质分离与鉴定策略。前者的技术流程是先从生物样本中获得蛋白质混合物,然后采用免疫沉淀或免疫亲和的提取方法,获得某种蛋白质的复合体;再应用 SDS-PAGE 技术对蛋白质复合物进行分离、染色、胶上原位酶切后,用 MALDI-TOF-MS 分析肽质量指纹谱并鉴定蛋白质;后者是对蛋白质复合物直接进行酶切,对获得的肽混合物进行 LC-MS-MS 分析,通过测定肽片段的序列鉴定蛋白质。
研究人员采用上述方法对鼠脑中的N-甲基-D-天冬氨酸受体(N-methyl-D-aspartate receptor,NMDAR)复合物进行了分离鉴定。分别采用免疫亲和色谱、抗NMDAR R1亚基抗体免疫沉淀和NMDAR R2B C端肽与NMDAR结合蛋白PSD-95亲和结合的方法及SDS-PAGE法分离NMDAR受体的复合物,然后利用质谱技术分析肽段的分子质量并鉴定蛋白质。实验结果表明,鼠脑中NMDAR受体复合物由77个蛋白质组成,包括神经递质受体、连接物、细胞黏附蛋白、二级信使、细胞骨架蛋白和新蛋白质等。
- 一维 IEF 电泳-质谱技术 目前,采用的以 2DE-MS 为基础的蛋白质分析策略,第一维等电聚焦电泳是根据等电点的不同而分离蛋白质,第二维 SDS-PAGE 电泳是依据相对分子质量的不同再次分离蛋白质。在 SDS-PAGE 电泳中,可以通过标准分子质量标记物,获得被分离蛋白质的相对分子质量信息。但与质谱技术测定肽段分子质量的方法相比,SDS-PAGE 上检测蛋白质相对分子质量的误差大、分辨率差。更重要的是,很难获得翻译后修饰蛋白质相对分子质量变化的准确信息。如何精确测定全细胞蛋白质的相对分子质量,一直是蛋白质组技术方法研究中的难题。研究人员报道了一种采用 IPG 胶条进行等电聚焦电泳,然后采用 MALDI-TOF-MS 对胶条进行表面直接分析的方法。该方法采用窄范围的 IPG 胶条进行一向等电聚焦电泳,电泳完毕,清洗胶条并用基质溶液浸泡、室温晾干后,将胶条截成 3.5~4.0cm 长度,用双面胶固定于质谱的样品靶上并进行 MALDI-TOF-MS 分析。采用 pH5.7~6.0 的 IPG 胶条分离大肠杆菌的总蛋白质,鉴定出 250 个蛋白质;而采用传统的 2-DE 方法仅鉴定了 100个蛋白质。测定小于 50kDa 的蛋白质,相对分子质量准确度为 0.1%~0.2%,pH 准确度为 ±0.3。该方法免除了样品从 2-DE 胶向质谱鉴定过渡时的繁复操作,将一向 IEF 电泳与准确、灵敏、高分辨的相对分子质量测定技术相结合,虽然在胶上蛋白质酶切和多肽序列的直接测定方面还存在一定问题,但是仍有可能发展成为 2-DE 的替代方法之一,用于蛋白质组学的研究。
(二)二维色谱-串联质谱技术(2D-HPLC/MS)
采用液相色谱的方法分离蛋白质和多肽有诸多优点:①速度快,一般几个小时可完成全部分离过程,而2-DE的蛋白质分离一般需1~2d;②由于在溶液状态下,样品处理方便、快速,避免了2-DE从胶上回收样品的繁复操作,分析过程易于自动化和与质谱联接;③对各种蛋白质均适用,包括疏水性、酸性、碱性、分子质量大于100kDa或小于10kDa的蛋白质等。
从组织、细胞或其他生物样本获得的蛋白质混合物,用蛋白酶(通常是胰蛋白酶)裂解,得到的多肽混合物样品进行二维色谱分离。质谱分析一般采用电喷雾串联质谱,通过测定肽段序列的分子质量对蛋白质进行鉴定。二维色谱-串联质谱(2D-HPLC/MS)分析策略的流程见图8-1。
二维色谱分离蛋白质有多种组合模式,第一维色谱一般是离子交换色谱,也可用凝胶过滤色谱,第二维通常是反相色谱。由于反相色谱采用有机溶剂作流动相,避免了盐等添加剂对后续质谱分析的影响。为了提高二维色谱的分离速度和分辨能力,第二维的反相色谱分离系统一般采用较短的色谱柱和较高的流速。整个分离系统采用一根离子交换柱与两根反相色谱柱,通过多通道阀进行柱切换的模式操作。当蛋白质或多肽组分从离子交换色谱柱上洗脱并进入第一根反相色谱柱时,第二根反相色谱柱上的组分正被洗脱进入检测系统。两根反相色谱柱的轮流切换,使得被分离物可以富集在柱的顶端。适当调整柱切换速度与流速,可以达到每分钟一个循环,获得一个色谱图。为了减小死体积,采用细内径(0.127mm)的管路并
尽可能减少管路的长度。
与 2-DE/MS 技术相比,2D-HPLC/MS 方法的不足之处就是通过蛋白质直接酶切得到的肽混合物过于复杂,较难实现对细胞全部蛋白质的识别与鉴定。相信经过不断的技术改进,2D-HPLC/MS 将作为 2-DE 的补充方法,成为蛋白质组研究中一种大规模蛋白质分离与鉴定的有效策略。
三、同位素编码亲和标签技术
同位素编码亲和标签(isotope coded affinity tag,ICAT)技术是近年发展起来的一种用于蛋白质分离与鉴定的新方法。ICAT 方法的关键是 ICAT 试剂的应用。该试剂由 3 部分组成。中间部分被称为连接部分,分别连接 8 个氢原子或重氢原子,前者称为轻链试剂,后者称为重链试剂。中间部分一头连接一个巯基的特异反应基团,可与蛋白质中半胱氨酸上的巯基连接,从而实现对蛋白质的标记,另一头连接生物素,用于标记蛋白质或多肽链的亲和纯化。当采用 ICAT 技术进行蛋白质的定量分离与鉴定时,首先要对蛋白质进行标记,然后进行蛋白质酶切,对蛋白质酶切后的多肽混合物进行亲和色谱分离,混合物中仅仅被同位素标记的肽段能够被色谱柱保留,并进入质谱进行分析,其他大量肽段都不被色谱柱保留。通过比较标记重链和轻链试剂肽段在质谱图中信号的强度,可以实现对差异表达蛋白质的定量分析,采用串联质谱技术测定肽段的序列,可以检测到肽段的分子质量并鉴定出蛋白质。ICAT 的优点在于其可以对混合样品(来自正常和病变细胞或组织等)直接测试;能够快速定性和定量鉴定低丰度蛋白质,尤其是膜蛋白等疏水性蛋白质等;还可以快速找出重要功能蛋白质(疾病相关蛋白质及生物标志分子)。
ICAT 技术由于采用了一种全新的 ICAT 试剂,同时结合了液相色谱和串联质谱,不但明显弥补了双向电泳技术的不足,而且使高通量、自动化蛋白质组分析更趋简单、准确和快速,代表着蛋白质组分析技术的主要发展方向。近些年来,针对磷酸化蛋白质分析及与固相技术相结合的 ICAT 技术本身又取得了许多有意义的进展,已形成 ICAT 系列技术。
四、表面增强激光解吸离子化飞行时间质谱技术
表面增强激光解吸离子化飞行时间质谱技术(surface-enhanced laser desorption/ionization-time of flight-mass spectra,SELDI-TOF-MS)简称飞行质谱技术。2002年诺贝尔化学奖得主田中耕一(Tanaka)发明了飞行质谱技术,其诞生伊始便引起学术界的重视,迅速成为最引人注目的亮点。飞行质谱技术的基本原理是,将样品经过简单的预处理后直接滴加到表面经过特殊修饰的芯片上,利用激光脉冲辐射使芯池中的分析物解吸形成荷电离子,根据不同质荷比,这些离子在仪器场中飞行的时间长短不一,由此绘制出一张质谱图来。该图经计算机软件处理还可形成模拟谱图,同时直接显示样品中各种蛋白质的分子质量、含量等信息。比较两个样品之间的差异蛋白质,也可获得样品的蛋白质总览。SELDI技术分析的样品不需用液相色谱或气相色谱预先纯化,因此可用于分析复杂的生物样品。而且,SELDI技术可以分析疏水性蛋白质、等电点过高或过低的蛋白质及低分子质量(<25kDa)的蛋白质,还可以发现在未经处理的样品中许多被掩盖的低丰度蛋白质,增加发现生物标志物的机会。SELDI技术只需少量样品,在较短时间内就可以得到结果,且试验重复性好,适合临床诊断及大规模筛选与疾病相关生物标志物,特别是它可直接检测不经处理的尿液、血液、脑脊液、关节腔滑液、支气管洗出液、细胞裂解液和各种分泌物等,从而可检测获得样品中目标蛋白质的分子质量、等电点、糖基化位点与磷酸化位点等信息。
综合上述分析可见,不同的蛋白质分离与鉴定方法策略各具特色,但均存在一些不足之处。相信在研究人员的不断努力下,蛋白质分离与鉴定的技术将得到不断完善,从而促进蛋白质组学研究及其应用的快速发展。
五、蛋白质芯片技术
蛋白质芯片(protein microarray)技术是一种高通量的蛋白质功能分析技术。与 DNA 芯片(DNA 微阵列)的原理相类似,蛋白质芯片在固体支持物上采用了高密度的网格来固定整个蛋白质组,从而得以对特定样品中的表达蛋白进行大规模的分析。蛋白质芯片的类型包括抗原芯片、抗体芯片,以及各种各样以蛋白质、底物或核苷酸为捕获基团的芯片。它们可以用来进行蛋白质表达谱分析,研究蛋白质与蛋白质的相互作用,甚至 DNA/RNA-蛋白质及配体-蛋白质之间的相互作用。
在蛋白质芯片上,各种特定的蛋白质(如抗体)或配体被固定在固体载体上,通过“免疫杂交”来捕获样品中的蛋白质分子。然而,与 DNA 芯片相比,蛋白质芯片技术的发展还处于相对的初期阶段。在蛋白质组水平上的芯片制作、自动检测及数据分析方面的发展都远不如 DNA 芯片那样顺利。蛋白质的特点是相同的结构基序(structural motif)可以存在于多种蛋白质中,而某个蛋白质也可以含有多种不同的结构基序。这种特点一方面决定了这个蛋白质与其他蛋白质之间存在着功能差别,另一方面也表明不同蛋白质之间可能产生交叉反应。同时,蛋白质中包含了各种各样的化学成分,也很容易导致其由于性质不稳定而发生的变性。
最近,一种被称为蛋白支架(protein scaffold)的新技术被开发用以捕获目标分子。蛋白支架是抗体的类似物,但分子更小、更稳定(不易变性),并且与目标蛋白的结合更特异。它们可以在非细胞系统中制作完成并且在支架(脚手架结构)上附上两个荧光标记。这一技术利用了荧光共振能量转移(fluorescence resonance energy transfer,FRET)的原理,即两个位置很近且吸收光谱有重叠关系的荧光染料分子,当一个荧光分子被激发后,另一个会通过激发能量的转移而被激发出荧光。这种能量转移的效率依赖于两个染料分子之间的距离。如果标记蛋白的一部分参与了目标蛋白的结合,那么蛋白质的构象变化会引起两个荧光标记分离,从而阻断两个染料分子之间的激发能量转移,而这种变化就可以根据荧光值是否变化来判断。
蛋白质芯片的数据分析相对于制备来说要简单一些,我们可以采用与 DNA 芯片相类似的芯片图像分析方法及聚类算法来鉴定共调控的蛋白质。
六、通过数据库搜索鉴定蛋白质
利用质谱技术进行蛋白质的鉴定在很大程度上依赖于生物信息学的应用。例如,当我们利用质谱技术确定了肽质量指纹谱(peptide mass fingerprinting,PMF)或肽段序列时,就需要在蛋白质消化片段数据库中进行搜索,以确定其理论上所属的蛋白质。这种搜索可以完全匹配的方式或者接近完全匹配的方式进行。但实践中经常会发生蛋白酶的不完全水解,即水解产物在应该发生断裂的位点不发生断裂。另外,从基质辅助激光解吸电离质谱(MALDI-MS)中得到的肽段是带电荷的,其质量也会与理论值略有偏差。因此,为了提高数据库搜索的识别能力,搜索引擎必须在匹配肽段的分子质量方面具有一定的灵活性,以满足肽段的不完全水解及电荷修饰等各种可能的实际情况。为了达到这一目的,搜索引擎就需要用户在检索时提供尽可能详细的信息,如肽指纹的分子质量,肽段序列,完整蛋白质的分子质量、等电点,甚至序列所属的物种名等,这些对于确定蛋白质的唯一性来说都非常重要。
利用数据库匹配的方式进行肽段鉴定时都遵循一个基本假设,即被研究物种的所有蛋白质序列都是已知并存储于数据库中的。因此,这种方法只在一些进行了完全测序且基因组注释比较完善的模式生物中应用得比较好,而在非模式生物中的应用则非常有限。
ExPASy(expert protein analysis system,http://www.expasy.org)是由瑞士生物信息研究中心维护的一个整合全面的蛋白质组学信息的网络服务器,提供了众多的蛋白质序列、序列特征、结构、功能注释等方面信息与分析工具,在其蛋白质组学工具中就包含了 Mascot、ProFound 等多种与质谱数据相关的肽质量指纹数据分析工具。

第三节 蛋白质的翻译后修饰
蛋白质在翻译合成后,需要经过一些功能基团的共价修饰才能获得相应的活性、结构与功能,这个生物学过程称为蛋白质翻译后修饰(post-translational modification,PTM)。目前已知的蛋白质翻译后修饰类型超过200种,常见的类型包括磷酸化、糖基化、泛素化、乙酰化和硫酸盐化等。蛋白质的翻译后修饰通过改变分子大小、疏水性及蛋白质的整体构象等对蛋白质生物学功能的正常行使产生影响。它可以直接影响蛋白质之间的相互作用,以及蛋白质在不同的亚细胞区域的分布。
一、基于序列的蛋白质翻译后修饰预测
对于蛋白质翻译后修饰的预测能够快速地将未知蛋白质的功能限定于某个特定范围之内。例如,了解特定底物-翻译后修饰酶的关系可以揭示相应的途径(pathway)信息,而特定的翻译后修饰还可以用来确定蛋白质的亚细胞定位或行使功能的类型。因此,利用计算机辅助从蛋白质序列中预测可能的翻译后修饰情况对于蛋白质组数据的生物学注释非常必要。
发生翻译后修饰的底物蛋白质具有被特定修饰酶所识别的序列基序,这些序列基序通常只包含5个残基,倾向存在于没有固定三维结构的非球形区域(non-globular region)内,并且,区域内包含的都是一些有极性的、小的或者骨架柔韧度较大的残基,这样,蛋白质翻译后修饰位点才易于与修饰酶互相接近。但是,如果预测只考虑修饰识别序列基序的话,由于其长度过于短小,就容易在序列模式匹配中产生过多的假阳性。以蛋白质磷酸化位点的一致性特征序列[ST]-X-[RK]为例,这样短的序列基序几乎在每个蛋白质序列中都会出现很多次,如果仅根据这一序列特征,那么得到的预测结果大多数情况下都会是假阳性结果。
为了减少假阳性的出现,在预测中除了修饰位点的序列基序特征外,我们还要考虑修饰位点周边环境序列的特点,并尽可能地利用一些统计学方法来增加预测的准确性。支持向量机(support vector machine,SVM)是一种与线性或二次判别分析相类似的数据分类方法。这种方法先将所有的数据映射到一个三维甚至多维空间上,然后利用线性的或非线性的函数所形成的最佳超平面(hyperplane)将真实的信号与噪声进行区别。简而言之,支持向量机就是把这个修饰位点的预测转化成了一个分类问题(是或不是修饰位点)。以特定激酶家族磷酸化位点的预测为例,支持向量机采用了已知的激酶磷酸化位点组成特征、周边序列组成特征等作为阳性集合,将其中不发生磷酸化的丝氨酸、苏氨酸、酪氨酸残基的周边序列组成特征作为阴性集合,支持向量机模型经过充足的周围序列组成特征的训练之后,就可以用来比较准确地识别激酶中的磷酸化位点。国内外不同的研究组在蛋白质翻译后修饰位点预测方面开展了大量的研究工作,我国学者在本领域也取得了显著的成就,开发了数十个翻译后修饰相关的计算工具(http://www.biocuckoo.org/link.php)。
二、在蛋白质组学分析中鉴定翻译后修饰
翻译后修饰也可以通过实验得到的质谱指纹数据进行鉴定。在 ExPASy 蛋白质组学服务器工具页面上列出了很多根据质谱分子质量数据来确定翻译后修饰的程序,可以用来搜索序列中已知的翻译后修饰位点,并且在数据库片段匹配时根据修饰的类型将额外的质量进行整合。例如,FindMod 可利用实验确定的肽段指纹信息来比较实际测得的肽段质量与其理论值是否存在差异。如果有,FindMod 就利用一系列预先确定的规则来预测特定的修饰类型。FindMod 可用来预测 28 种不同类型的修饰,包括甲基化、磷酸化、酯化和硫化等。GlyMod 是另一种特异针对糖基化进行预测的程序,它同样是利用实验确定的肽段与理论获得肽段在质量上的差异来进行预测。
第四节 蛋白质分选
除线粒体和植物叶绿体中能合成少量蛋白质外,绝大多数的蛋白质均在细胞质基质中的核糖体上开始合成,然后运至细胞的特定部位,这一过程称蛋白质分选(protein sorting),也被称为蛋白质定向转运。
正确的亚细胞定位是蛋白质行使功能不可缺少的一部分。很多蛋白质只有被转运到特定的细胞位置才能行使其功能,因而对蛋白质运输及亚细胞定位机制的研究已经成为现代细胞生物学研究的主题。对蛋白质细胞定位的了解有助于缩小其可行使功能的范围,从而对蛋白质功能进行准确注释。
对于大多数真核生物蛋白质来说,新合成的蛋白质前体必须转运到特定的膜结合区域并经过蛋白质水解过程才能形成成熟的功能蛋白,这些特定的区域包括叶绿体、线粒体、细胞核、过氧化物酶体等。为了实现蛋白质的转运,新生的蛋白质序列中必须具备特定的肽信号,它们能够指导蛋白质向特定的区域转运。一旦蛋白质在细胞器之内转运完成,蛋白酶就会将信号序列去除,以产生成熟的蛋白质(另一个例子是发生翻译后的修饰)。即使在原核生物中,蛋白质也可以被定向转运到内膜或外膜、细胞内的周质间隙或细胞外,其蛋白质的分选机制与真核生物类似,也是依赖于信号肽的出现。
蛋白质分选信号序列的特征一致性很弱,它们一般都是在一个或多个具有正电荷的残基后面紧跟有一个疏水核区域,但是在序列长度和残基构成上的变化很大。以线粒体定向转运肽为例,它位于蛋白质的N端。典型序列基序的长度为20~80个残基,富含精氨酸等带正电荷的残基及丝氨酸、苏氨酸等带羟基的残基,但是缺少带负电荷的残基,同时具有形成两性α螺旋的倾向。当前体蛋白质被转运进入线粒体后,这些定向转运信号序列就被剪除。另一种蛋白质分选信号——叶绿体定位信号(也被称作转运肽)也是位于蛋白质的N端,长度为25~100个残基,它们经常包含很少量的负电荷残基及许多像丝氨酸那样带羟基的残基。定向转运到叶绿体的蛋白质有一个非常有趣的特性,即其转运信号是双向的。也就是说,它们由两个毗邻的信号肽组成,其中一个信号在剪切前将蛋白质定向转运到叶绿体的基质空间,而另一个信号则将剪切后的剩余部分定向转运到类囊体上。细胞核定向转运信号在长度上变化也很大(7~41个残基),与前几类信号不同,核定位信号位于蛋白质序列的内部,通常是一个或两个包含了基础残基及一致性基序的K(K/R)X(K/R)片段。核定位信号序列在蛋白质发生转运后并不会被剪除。
蛋白质亚细胞定位的计算预测方法可以粗略地分为两类。第一类方法主要利用蛋白质的氨基酸序列中的信号特征(signal),同时还需要诸如表达谱数据、系统发育图谱、数据库记录描述内容中的上下文及 GO 注释词条等额外信息。当提供了上述额外信息时,预测结果的准确性就要比单独基于序列的预测方法高很多,但这种额外数据是可遇而不可求的。因此,利用数据库内容上下文或者 GO 词条进行预测时需要相应的蛋白质已经具有一定的注释信息,而这些注释信息中经常会包含相应的亚细胞定位信息,它们或者明确地出现在 GO “细胞组分”(cellular component)相应的词条中,或者在 Swiss-Prot 数据库记录的描述行或关键词行中给予一定的提示。
还有一些方法只利用序列进行对库的同源性搜索或者查找与之共同出现(co-occurrence)的蛋白质结构域。如果查询蛋白质序列与已知亚细胞定位的蛋白质是同源的,我们就可以利用同源序列的性质进行注释转移,这样的预测结果通常比较准确,特别是当两个同源序列的相似性非常好的时候。如果利用这种方法找不到相近的同源序列,那么就需要利用一些能够对真实的蛋白质分选信号序列进行统计性学习的方法(如机器学习方法中的神经网络、隐马尔可夫模型及支持向量机等)进行预测。

的程序之一。从第二版 SingalP 开始,预测中又加入了另一种机器学习方法——隐马尔可夫模型来增加预测的准确性。其中,神经网络算法包含了两种不同的分数,一种是为识别出的信号肽打分,另一种是为蛋白酶的断裂位点进行打分;而隐马尔可夫模型则用来区分信号肽及将蛋白质插入膜中的 N 端跨膜锚定片段。由于真核生物、革兰氏阴性菌及革兰氏阳性菌的信号肽特征具有明显的差异,因此,SignalP 收集了 3 个不同物种的训练数据集。这样,在进行序列分析之前可以先选择适当的数据集以提高预测的准确性。SignalP 可以同时预测信号肽并对蛋白酶的剪切位点进行预测。第三版的 SignalP 改进了对信号肽断裂位点预测的方法,因此预测结果的准确性得到了进一步提高,对信号肽断裂位点预测的准确率达 75% 以上。
TargetP(https://services.healthtech.dtu.dk/service.php?TargetP-2.0)是进行真核生物蛋白质亚细胞定位预测的程序。它使用了神经网络方法,主要对蛋白质序列的N端是否存在下列几种前导肽进行预测:叶绿体转运肽(chloroplast transit peptide)、线粒体靶肽(mitochondrial targeting peptide)及分泌途径信号肽(secretory pathway signal peptide)。如果分析的蛋白质序列中包含了N端的前导肽,则TargetP还会对可能的前导肽断裂位点进行预测。TargetP分别利用SignalP和ChloroP两种不同的程序来对序列中的信号肽及叶绿体转运肽的断裂位点进行预测。

PSORT(http://www.psort.org/)是一个1992年就开发出来的亚细胞定位预测程序,它最先采用了决策树(decision tree)的方法进行预测,即计算一组来源于定位信号序列的参数并将之与从文献中总结的一系列定位规则进行比较。这些规则大部分关注的是现有的各种能够将蛋白质定位于特定细胞区域的序列基序,还有一部分规则主要记录了特定信号序列基序的氨基酸组成内容。PSORT能够鉴别植物、动物及酵母中不同的定位区域,分别有17种、14种及13种。1997年更新的PSORTⅡ则使用了k最近邻域法(k-nearest neighbor method)这种统计分类技术来进行预测。它同样将查询序列与一个包含了大量不同细胞定位信号肽的数据库进行比较,如果大多数最近邻(nearest neighbor)的信号肽匹配具有一个特定的细胞定位,那么这个序列就被认为是具有相同亚细胞定位的信号肽。但是,PSORT II不能够对植物蛋白的亚细胞定位进行预测,而且对动物及酵母蛋白的定位预测也只能给出12种类型。WoLF PSORT是PSORT II的扩展版本,它主要通过对蛋白质序列中的分选信号(sorting signal)、序列的氨基酸组成及诸如DNA结合基序等序列基序的分析将氨基酸序列转变成多种定位特征,然后利用简单的k近邻分类器(k-nearest neighbor classifier)对蛋白质的定位进行预测。WoLF PSORT恢复了对植物蛋白亚细胞定位的预测,对3个物种中定位预测的类型都超过10种。此外,更新于2010年的PSORTb v3.0针对细菌和古菌的序列来预测亚细胞定位情况,并分为在线版本和本地版本。

第五节 蛋白质相互作用
细胞中的大部分功能是由蛋白质来执行的,蛋白质间的相互作用是细胞实现功能的基础。细胞进行生命活动过程的实质就是蛋白质在一定时空下的相互作用,因此,描绘出蛋白质间的相互作用是蛋白质组学又一个重要的研究内容。蛋白质之间的相互作用不仅包括那些能够形成稳定复合物的强相互作用,也包括那些可能只在瞬时发生的弱相互作用,其中,参与形成复合物的蛋白质要比那些只出现瞬时相互作用的蛋白质表现出更为紧密的表达共调控性质。蛋白质-蛋白质相互作用的研究在探寻细胞信号转导途径、复杂蛋白质结构的建模及理解蛋白质在各种生物化学过程中的作用方面都是非常必要的。
一、利用实验鉴定蛋白质互作
通过实验鉴定蛋白质的相互作用主要包括遗传学方法、生物化学方法和生物物理方法,其结果可以在原子、互作双组分、互作多组分(复杂互作)及细胞水平4个方面得到表现。原子水平的实验,如X射线晶体衍射及核磁共振技术可以精确地显示互作原子或残基之间的结构关系;互作双组分实验,如酵母双杂交则只能检测出哪些蛋白质之间发生了互作,但无法描述其中细节;同样,互作多组分实验,如亲和层析-质谱能够检测出参与形成复合物的多个蛋白质组分,但也只能止步于组分鉴定阶段;而细胞水平实验,如荧光免疫则可以对蛋白质的细胞定位进行确定。
蛋白质互作研究中最经典的方法无疑是酵母双杂交(yeast two hybrid,Y2H)系统。它采用了一套必须要转录激活因子(transcription activator)才能激活的报告基因表达体系(图8-2)。由于转录因子同时具有DNA结合结构域(DNA binding domain,BD)及转录激活结构域(trans-activation domain,AD),于是,人为地将转录因子的这两个结构域分隔开来,将可能发生相互作用的两个基因的cDNA分别与其中BD的DNA及AD的DNA进行融合以产生诱饵蛋白(bait protein)及其潜在的猎物蛋白(prey protein)。当诱饵蛋白和猎物蛋白能够发生互作结合时,转录因子的两个结构域也能够结合在一起行使其功能,从而导致报告基因的表达。当然,还可能利用这一套系统在一个cDNA文库中筛选与诱饵蛋白发生互作的蛋白质,即将cDNA文库中所有的cDNA作为可能与待研究蛋白质发生互作的猎物蛋白同AD进行融合,然后利用其能否与诱饵蛋白互作导致报告基因的表达进行筛选。这种方法通常用来发现和研究目前还不太了解的蛋白质的相互作用及功能。
在检测蛋白质之间的相互作用方面,酵母双杂交系统具有非常高的灵敏度,即使是微弱的、瞬间的蛋白质相互作用也能够通过报告基因的表达敏感地检测到,但是这种方法也存在着一些局限性。首先,它不是一种直接检测蛋白质相互作用的方法,而某些蛋白质自身的转录激活功能使得AD-猎物蛋白融合基因与BD-诱饵蛋白融合基因表达产物无需特异地结合就能启动转录系统,从而产生假阳性结果(虚假的相互作用)。其次,酵母双杂交系统对相互作用的蛋白质在细胞内的定位要求非常严格,只有定位于细胞核内的相互作用蛋白才能确保报告基因的激活,而定位于细胞质内或细胞膜上的蛋白质则很难采用该技术进行分析。最后,酵母双杂交系统只能检测两个组分的互作情况,因而那些必须有多个蛋白质共同参与的相互作用利用这一方法也是检测不到的。
与酵母双杂交系统相比,遗传学方法属于小规模的蛋白质互作实验,它通过观察两个互作候选基因(X-Y)的突变体表型来进行研究。例如,抑制突变(suppressor mutation)是指Y基因的突变可以将最初X基因突变时所产生的非正常表型恢复至正常或接近正常。这是因为X基因的第一次突变引起了蛋白质X在构象上的变化,这一变化阻止了它与蛋白质Y的相互作用,从而形成了丧失功能的表型。当我们在Y基因上引入与之互补的突变,蛋白质间的相互作用便能够被重建起来,从而使突变表型得到恢复或部分恢复。在另一种被称为合成致死筛选(synthetic lethal screen)的遗传学方法中,还是上述两个可编码互作蛋白的基因(X-Y),如果分别将X基因或Y基因进行单突变,这种单突变虽然在蛋白质构象上有所变化,但仍然能够部分保持蛋白质X和Y之间的互作,不会造成个体的死亡。然而,当将这两种突变引入一个个体时,突变蛋白质X和Y之间的互作就被阻断,导致个体致死。
遗传学方法虽然可以推断蛋白质之间的互作,但却不能提供直接的证明。相反,一些通过蛋白质之间具有亲和力(特异性结合的倾向)特性的物理方法则能够为蛋白质互作提供直接的证据。通常情况下,这种亲和方法是将一种分子进行固定,利用它作为诱饵来诱捕那些与之互作的蛋白质,随后将这些蛋白质进行纯化及鉴定。
亲和层析是将诱饵分子固定于某一种载体介质,如琼脂糖柱子中。目的蛋白通过它表面上的生物功能位点,特异并可逆地结合在诱饵分子上。将蛋白质提取物加入柱子中,并利用低盐缓冲液进行洗脱,与诱饵有相互作用的蛋白质(因为结合在一起)被留在柱子中,其他的则被缓冲液洗脱,而那些结合的蛋白质可以利用高盐的缓冲液随后被洗脱下来。通过改变缓冲液的盐浓度,就可能鉴别哪些蛋白质与诱饵的结合能力较弱而哪些结合能力很强。目前一种叫作 GST-pull down 的亲和层析方法比较流行,它的诱饵蛋白是谷胱甘肽 S 转移酶(GST)的融合表达蛋白。由于此酶与其底物谷胱甘肽具有高亲和力,因此融合蛋白可以牢固地附着在谷胱甘肽包被的琼脂颗粒上,而那些与 GST 融合蛋白互作的蛋白质就会在层析柱中保留下来,无相互作用的蛋白质则被洗脱。这种方法的好处是任何一个蛋白质都可以与 GST 进行融合而作为诱饵。但是必须记住在实验中要加一组只利用 GST(无融合蛋白)的对照层析,这样才能排除那些与 GST 互作的蛋白质。通过亲和层析纯化后的蛋白质则可以继续通过凝胶电泳及质谱技术来确定相互作用的蛋白质组分。
免疫共沉淀反应是另一种亲和方法,它是利用抗体能够特异性地与蛋白质复合物中某一组分进行反应而使蛋白质复合物沉降下来。该方法在能够保存蛋白质与蛋白质相互作用的条件下制备细胞的溶解液。一种与蛋白质X特异作用的抗体被加入这种细胞溶解液中,于是,蛋白质X及与它有相互作用的任何蛋白质都被沉淀下来。免疫共沉淀法的优点是所研究的相互作用蛋白均是经翻译后修饰的天然蛋白,即可以表征生理条件下蛋白质间的相互作用。但是该方法需要针对目标蛋白制备出一定量的多克隆抗体或单克隆抗体,过程相对复杂,而且目标蛋白只有达到一定浓度才能与抗体结合形成沉淀,因而只适用于研究具有高表达量的目标蛋白。此外,亲和层析与免疫共沉淀反应存在一个共同的问题,即它们不仅可以分离与诱饵直接互作的蛋白质,同样还会分离出不直接互作的蛋白质。这时就需要交联(cross-linking)来确定直接的互作并证实蛋白质复合物的空间架构。
前面提到过的微型化的蛋白质芯片是高通量地利用亲和技术进行蛋白质互作的研究。蛋白质芯片的制备与 DNA 微阵列使用了相似的方法,即利用机械手将少量的液态样品点在玻片等固体基质的载体上。而对互作蛋白的捕获可以在很大的范围内进行(如利用表面化学反应可捕获所有相关的蛋白质),也可以在很小的范围,甚至是特异结合的范围内进行(如利用抗体)。
由于上述实验方法都不能保证消除实验中的假阳性与假阴性,那么为了从理论上弥补各种技术的缺陷,在实验中应当将多种技术方法得到的结果结合起来。
二、蛋白质互作的预测
虽然上述多种实验方法使得到的蛋白质相互作用数据得到了大规模的增加,但是这些技术方法在一定程度上都存在着偏向性或缺陷,从而导致结果中“假阴性”或“假阳性”错误的比例较高。但是在这些蛋白质相互作用数据中必然潜藏着具有生物学意义的信息,我们可以从中总结出一些调控这些相互作用的基本规则,这些规则有助于开发自动预测蛋白质相互作用的算法。
蛋白质相互作用预测的生物信息学方法总结起来可以分成4类:①基于基因组信息的方法;②基于进化关系的方法;③基于蛋白质序列的从头预测的方法;④基于蛋白质三维结构信息的方法。其中,基于基因组信息的预测方法中包括邻接基因(gene neighborhood)、基因/结构域融合事件(gene/domain fusion event)、系统发育谱(phylogenetic profile)及镜像树(mirror tree)等方法;基于进化信息的预测方法包括突变关联(correlated mutation)、保守的蛋白质相互作用及进化速率关联(correlated evolutionary-rate)等方法。
(一)根据邻接基因进行互作蛋白的预测
一般说来,基因次序在不同的原核生物基因组中的保守性很差。如果确实在不同基因组中发现了具有同样邻接关系的基因,则它们很可能属于同一个操纵子(operon)。这是因为在原核生物基因组中,功能相关的基因承受着相同的选择压力,倾向于在基因组中连在一起,构成一个操纵子。操纵子中编码的蛋白质通常是功能相关或具有物理互作关系的。这种基因之间的邻接关系在物种演化过程中具有一定的保守性,可以作为基因产物之间功能关系的指示标识。这一预测规则支持了大多数原核生物基因组的互作蛋白的预测。但对于真核基因组来说,利用基因次序进行互作蛋白的预测不如基因表达中的共调控蛋白有说服力。
(二)根据基因 / 结构域融合事件进行互作蛋白的预测
基于基因融合事件的互作蛋白预测方法的理论基础是,对于一个特定物种中包含了融合结构域 AB 的蛋白质家族来说,经常会发现它与其他物种中相互分离的两个基因 $A’$ 和 $B’$ 相对应。这类蛋白质就被称为“复合”蛋白(即融合蛋白),而它们包含的每一个结构域都被称为“成分”蛋白。这一预测主要是在具有完整基因组序列的物种中进行基因融合事件的
鉴定,因为这样才能发现不同物种中相对应的“同源”蛋白。如果一个复合蛋白特定地与另一个物种中的两个成分蛋白相似,即使这两个成分蛋白的编码基因并不一定相邻,但这两个成分蛋白很可能发生相互作用以执行与AB相同的功能(图8-3)。反过来说,如果两个祖先基因A和B编码了相互作用的蛋白质,那么在进化的过程中为了加强这种互作的有效性,在其他基因组中这两个基因很有可能融合在一起。
这一方法更进一步的解释是当两个成分蛋白作为结构域在一个蛋白质中融合时,它们必须位置非常地接近,以执行同样的功能。如果这两个结构域存在于两个不同的蛋白质中时,为了维持相同的功能,它们相互靠近及相互作用的特性也必须维持下来。因此,研究基因/蛋白质的融合事件,就可以对蛋白质-蛋白质的相互作用进行预测。这种利用基因融合事件来揭示其成分蛋白之间的功能相互关系的预测方法被称为“Rosetta stone”方法。这种预测原则被证实是相当可信的,它已经被成功地应用到从原核到真核生物中大量蛋白质互作的预测中。
研究表明,基因融合事件在代谢蛋白(metabolic protein)中尤为普遍,利用此方法进行预测的局限性在于只能够预测在进化过程中发生融合的蛋白质之间的功能关联,不能判断发生融合的蛋白质是否真正发生了物理上的直接接触。
(三)根据系统发育谱进行互作蛋白的预测
由于存在于同一信号/代谢途径或者同属于一个蛋白质复合物的蛋白质只有同时出现才能执行它们特定的功能,因此,具有功能相关性的蛋白质在进化的过程中倾向于在其他基因组中同时出现或缺失。因为当复合物中一个组分蛋白质缺失时,就会导致整个复合物不能形成。在环境的选择压力下,复合物中其他那些无功能的互作伴侣也会在进化中丢失,因为它们已经不是行使功能所必需的。根据系统发育谱的预测方法就是查找不同基因组中直系同源物共同出现及共同缺失(co-absence)的情况,即在完全测序的基因组中鉴定每一个蛋白质在每一个基因组中出现及丢失的情况,这样就得到一个系统发育谱。当比较不同蛋白质的系统发育谱时,那些具有相同或相似谱形的蛋白质很可能具有功能上的相关性(图8-4)。但是,这种根据基因共缺失或共出现的互作蛋白预测方法同样不能确定功能相关的蛋白质之间是否存在物理上的直接接触,而且其预测准确性依赖于完成测序的基因组的数量及系统发育谱构建的可靠性。
我们关注 7 个蛋白质(P1~P7)之间的相互关系,于是在大肠杆菌(EC)、酿酒酵母(SC)、流感嗜血杆菌(HI)和枯草杆菌(BS)4 个完全测序的基因组中,针对大肠杆菌的每一个蛋白质序列都构建一个系统发育谱,以表明哪一种基因组中能够编码此蛋白质的同源物。随后,将这些系统发育谱进行聚类,找到具有相同或相似谱型的蛋白质。由于 P2 与 P7、P3 与 P6 具有一致的谱型,因此它们可能具有功能上的相关性(存在于同一途径或同一个蛋白质复合物中),而用直线相连的谱型之间有一定的差异,被称为邻居(neighbor)。
镜像树是一种基于系统发育分析的更加定量化的互作蛋白预测方法。根据观察,互作蛋白的进化距离相似性水平要显著高于那些没有互作关系的蛋白质的进化距离,这表明互作蛋白受其功能约束,因而其进化过程应该保持一致。如果突变发生在其中一个蛋白质的互作表面,为了维持蛋白质的相互作用,相应的突变很有可能也发生在其互作伴侣上,结果造成两个互作蛋白具有反映相似进化历史的进化树形,即呈现共同进化的特征。通过构建和比较它们的系统发育树,如果发现拓扑结构几乎一致的发育树,这种相似的树就被称为镜像树(图8-5),具有相似树形的蛋白质是功能相关的,很可能发生了互作。为了量化地研究共进化程度,可以计算进行建树分析的两组蛋白质同源物的进化距离,并对距离矩阵的相关系数(correlation coefficient, r) 进行检查,如果 r > 0.8,即很有可能两个蛋白质之间发生了互作。当两个蛋白质家族用于构建系统发育树的进化距离矩阵出现很强的统计学相关性时,如果主要两个树型拓扑结构基本一致(形成类似的镜像),这两个蛋白质的功能相关性就能被确定下来。
(四)根据序列同源性进行互作蛋白的预测
已知的蛋白质互作图谱能够为新测序完成的基因组中蛋白质互作的预测提供必要的信息。如果某个基因组中的一对蛋白质是互作蛋白,那么它们在另一个基因组中的同源蛋白也可能发生类似的互作。这种同源蛋白对被称为互作物(interolog)。这种预测方法依赖于确定正确的直系同源蛋白并且要利用现有的互作蛋白数据库。例如,我们在新测序得到的基因组中通过系统的相似性搜索来鉴定那些已知的互作蛋白对(known interacting protein partner)可能的直系同源蛋白对,从中确定潜在的保守互作蛋白。如果互作蛋白具有已知的三维结构,则这种方法能够帮助对蛋白质的四级结构进行建模。
(五)利用多种方法进行互作蛋白的预测
前面提到的各种预测方法都需要依赖于某种特定的前提(方法上的局限性),如只能确定功能上的相关性而无法给定直接的互作证据,或者只有在完全测序基因组上才能进行分析等。这种分析前提会使预测结果出现某种程度上的偏差,而且由于分析使用的数据对象不同,很难对不同方法的表现性能进行评估。为了产生比较可信的蛋白质互作预测结果,用户一般都需要利用多种不同的方法进行预测以减少偏差和错误。
STRING(search tool for the retrieval of interacting genes/proteins,互作基因/蛋白搜索工具,http://string-db.org/)是一种综合利用了邻接基因、基因融合及系统发育谱等证据来进行蛋白质互作预测的数据库及网络服务器。最新版本的 STRING 除了计算预测外,还整合了大量实验获得的共表达数据及从文献中挖掘到的蛋白质互作信息。经过分析,

STRING 可以给出包括直接及间接的蛋白质-蛋白质相互作用的所有证据。直接互作是指蛋白质之间发生物理互作的情况,而间接相互是指那些功能相关的在同一(代谢)途径中拥有相同底物的酶类或者指在同一遗传途径中相互具有调控关系的蛋白质。STRING11.5 包含了来源于 14 094 个基因组的 6000 多万个蛋白质的相关信息。
使用 STRING 进行计算预测分析时,查询序列首先会根据 COG(cluster of orthologous group)信息进行直系同源物的分组,然后序列会在数据库中搜索已知的保守基因连锁模式(查找邻接基因)、基因融合情况及系统发育谱。STRING 利用一个权重记分系统来评估各个基因组中上述 3 种类型蛋白质相关的显著性,以及从实验中获得的互作数据和文献挖掘的信息。为了降低假阳性并增加预测的可信度,3 种计算类型的相关蛋白质还会在一个内部参考数据集中做再次的检查。STRING 的最终结果是返回一个互作蛋白(功能相关蛋白)列表,针对每一个功能相关蛋白都会提供所得到的计算预测、实验获得及文献挖掘方面的证据,以及一个简单的蛋白质互作(功能相关性)分数。根据其中参与的多个功能相关伴侣情况,STRING 还能够以交互的形式提供图形化显示的蛋白质结合互作网络及特定的详细信息。

思考题
什么是蛋白质组?什么是蛋白质组学?
二维凝胶电泳在进行蛋白质分离时有什么局限性?液相色谱技术比二维凝胶电泳有哪些优越性?
蛋白质的功能是否会随着时间、生理状态或其他条件因素发生变化?
线粒体、叶绿体及细胞核定向转运信号肽的序列特征分别是怎样的?
都有哪些实验方法能够鉴定蛋白质之间的物理互作?
理解各类蛋白质互作预测方法的思想基础。

主要参考文献
Abbott A. 2001. And now for the proteome. Nature, 409 (6822): 747
Collins F S, Green E D, Guttmacher A E, et al. 2003. A vision for the future of genomics research-a blueprint for the genomic era. Nature, (422): 835-847
Fields S. 2001. Proteomics in genomeland. Science, 291 (5507): 1221-1224
Pellegrini M, Marcotte E M, Thompson M J, et al. Assigning protein functions by comparative genome analysis: protein phylogenetic profiles. 1999. Proc Natl Acad Sci USA, 96(8):4285-4288
van Wijk K J. 2001. Challenges and prospects of plant proteomics. Plant Physiology, 126: 501-508
Wasinger V C, Cordwell S J, Cerpa-Poljak A, et al. 1995. Progress with gene-product mapping of the mollicutes: mycoplasma genitalium. Electrophoresis, 16: 1090-1094
Wilkins M R, Sanchez J C, Gooley A, et al. 1995. Progress with proteome projects: why all proteins expressed by genome should be identified and how to do it. Biotech Genet Eng Rev, 13: 19
Wilkins M R, Sanchez J C, Williams K L, et al. 1996. Current challenges and future applications for protein maps and post-translational vector maps in proteome projects. Electrophoresis, 17: 830-838