系统发育、宏基因组与系统生物学
编者导语
本板块把三个都建立在多序列比较之上的主题放在一起:系统发育(用保守位点推断 物种关系,涉及模型选择与自展支持率)、宏基因组学(从混合样本直接组装并分箱)、 以及系统生物学与合成生物学(把系统当作整体建模乃至干预)。 末尾并入了引物设计与蛋白质结构预测,因为它们是同一条链的下游工具。 板块有 152 张图与 28 个公式:树、比对与网络图占了图的大头, 而系统发育部分给出了这 19 个公式。请注意区分两件事—— 树上的分支长度是估计量而非观测值;聚类顺序不等于生物学差异。 建树算法见 ch26,多重比对的原理见 ch28。
前置:ch13。
警告
本章有 6 处原书公式或表格在 MinerU 转换中损坏,已降级为代码块保留残片。这些残片不可直接引用
(其中的系数、矩阵与表达式请回查原书对应页码)。
编者注·本板块导读
图 106 张 案例 16 处 行间公式 28 个。以下清单由正文自动扫出,均为原书内容,未新增。
图(前 8 张;其余见本板块正文)
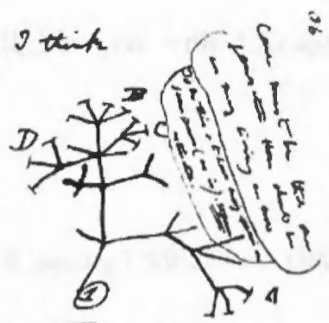
- 图6-1 达尔文手稿中的进化树 —— ch17
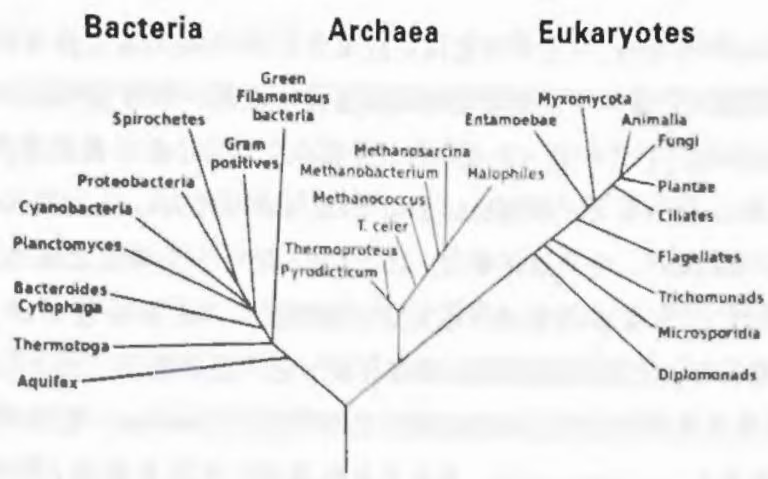
- 图 6-2 生命进化树 —— ch17
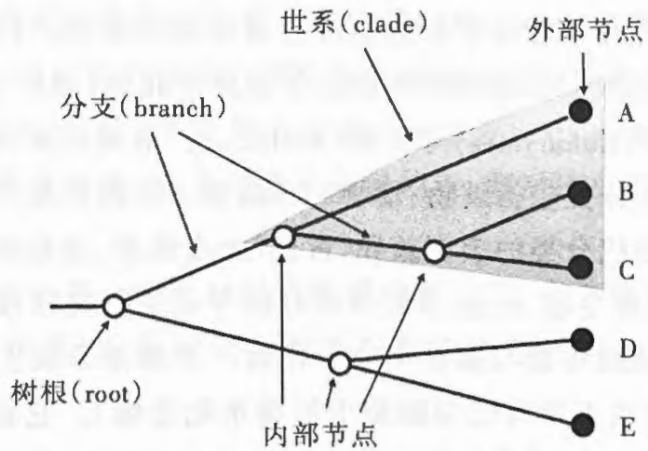
- 图6-3 系统进化树 —— ch17
- 图6-4 有根树与无根树 —— ch17
- 图6-5 基因分化 —— ch17
- 图6-6 BLAST页面 —— ch17
- 图 6-7 MEGA 序列比对结果 —— ch17
- 图6-8 MEGA建树方法菜单 —— ch17
- ……其余 98 张见本板块正文
案例(前 6 处)
- ◎ 导学案例 —— ch17
- 习题 —— ch17
- 本章简要介绍宏基因组学的基本知识与数据分析方法,并以实例介绍16S rDNA扩增子测序数据的生物 —— ch17
- ◎ 导学案例 —— ch17
- 习题 —— ch17
- ◎ 导学案例 —— ch17
- ……其余 10 处见本板块正文
公式:本板块含 28 个行间公式,均为原书公式,未改写。若你看到代码块形式的残片,说明该处公式在 OCR 中损坏、已降级,请回查原书对应页码。
本板块由以下原始章节合并而成:ch17、ch18、ch19。
第6章 系统发育树(Phylogenetic Tree)
自然界生存下来的,既不是四肢最强壮的,也不是头脑最聪明的,而是有能力适应变化的物种。——Charles Robert Darwin
本章介绍了系统进化树的基本概念、进化树的构建原理,以及替换模型的知识,并以常用软件MEGA为例,介绍系统发育树的构建方法与应用。
◎ 导学案例
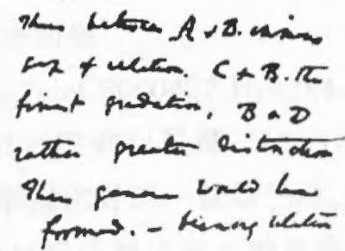
所有的生物都可以追溯到共同的祖先,生物的产生和分化就像树一样地生长、分叉,以树的形式来表示生物之间的进化关系是非常自然的事。达尔文在科研笔记中就以树表示物种的亲缘关系(图6-1)。达尔文画的树中最下面标注①的分支点代表已经灭绝(extinct)的祖先物种,其他标注A,B、C、D等末端分支点代表现存(extant)的物种。树的各个分支点代表一群生物起源的相对时间,两个分支点靠得越近,则对应的两个种群的生物进化关系越密切。
《物种起源》第四章中有一幅比较正式的进化树,它是全书的唯一配图,可见达尔文对进化树的重视程度。此后,绘制地球上所有生物的生命之树成为生物学家追求的一个梦想。
系统发育(phylogeny)是指某一个类群的形成和发展过程,是与个体发育相对而言的概念,也称系统发生。自从达尔文时代起,许多生物学家都有一个梦想,就是重建地球上所有生命的进化历史,并以进化树的形式描述这部历史。德国昆虫学家Willi Hennig在20世纪50年代提出生物分类学须寻找系统发育的分支结构,根据这种分支结构揭示的谱系关系进行分类。
早期系统发育研究中,分类学者基于形态、解剖及生理生化特征等生物表型数据,对生物体进行系统分类与命名,取得了许多有价值的生物学观念,并提出地球上所有生物有着共同祖先的观点。直到20世纪50年代,生物大分子数据才开始被应用于系统发生研究,尤其是随着蛋白质与DNA测序技术的发展,蛋白质与DNA序列具有比其他特征更丰富的进化历史信息,被广泛应用于物种进化关系研究。以生物大分子序列研究物种的亲缘关系被称为分子系统发育学(molecular phylogenetics)。根据各种生物在分子水平上的进化关系,可以建立分子进化的系统发育树(phylogenetic tree),直观显示物种间的亲缘关系。
最初分类学家 Linnaeus 把生物分成动物与植物两大类。随着越来越多生物体的发现,后来根据细胞结构特征(核膜),可把生物体分成原核生物(prokaryotes)与真核生物(eukaryotes)。再后来分类学家 Whittaker 又提出把生物体分为五界(kingdoms):细菌界(Bacteria)、原生动物界(Protists)、植物界(plants)、真菌界(fungi)和动物界(animals)。从 20 世纪 70 年代起,DNA 序列开始被用于研究物种之间的进化关系。1977 年,Carl Woese 等通过 16S 核糖体 RNA(16S rRNA)的基因序列建立了生命进化树(图 6-2),包括三个主要分支:细菌(Bacteria)、真核生物(Eukaryotes)与古菌(Archaea)。细菌分支包括传统的原核生物、线粒体和叶绿体。真核生物分支包括植物、动物和真菌等。古菌是基于 16S rDNA 序列分析发现的一个新分类。根据传统分类的表型差异,古菌(如嗜热菌、嗜盐菌等极端微生物)与细菌都没有核膜,被认为是原核生物,但把它们的核苷酸序列进行比较可看出明显差异,而且它们之间的遗传差异程度就跟细菌与真核生物一样大。古菌像原核生物一样具有细胞壁,但缺乏肽聚糖(一种普遍存在于所有已知细菌中的碳水化合物)。它们的 DNA 像真核细胞的 DNA 一样被包裹在组蛋白上。古菌也具有一些特征,如细胞壁中含有独特的假肽聚糖、细胞膜中含有独特的醚键及分枝脂链等,这些特殊的细胞结构可以帮助它们抵抗来自极端环境的压力。因此他们提出将生物界分为独立的“三域系统”(three domains of living things)。后来其他基因序列的研究,包括大核糖体RNA和保守蛋白质的基因序列,证明这是最好的进化分类方法。
6.1 分子系统发育树的基本概念
系统发育树是由一系列节点(node)和分支(branch)组成(图6-3)的,其中每个节点代表一个分类单元(物种或序列)。分支末端的节点为外部节点,对应一个实际观察到的基因、蛋白质或物种等,又称为可操作分类单元(operational taxonomic unit, OTU)。与外部节点对应,内部节点代表一个推断出的共同祖先(common ancestor),它在过去的某个时间分出两个独立的分支,现在已经不存在了。由单一祖先及其所有后裔组成的群体称为世系或支系(clade)。图6-3所示是五个物种(ABCDE)之间进化关系的系统进化树,其中实心圆圈表示外部节点,空心圆圈表示内部节点。
分支为节点之间的连线,代表物种之间的进化关系(relationship),分支长度可表示不同数据之间的分歧程度,它是关于生物进化时间或遗传距离的一种度量形式。系统发生树分支的拓扑结构(topology)不仅可表示进化事件发生的先后关系,还可表示有关序列分歧程序的信息。进化树按分支信息可为标度树(scaled tree)与非标度树(unscaled tree)。标度树又称进化分支图(phylogram)。在标度树中,分支的长度一般与分类单元之间的变化成正比,连接两个节点的分支的长度准确地表示它们之间的差异。而非标度树又称进化分支图(cladogram),只表示它们之间的亲缘关系,而没有表示它们差异的任何信息。
一般内部节点只有两个分支,因此也称为二叉节点(bifurcating),但有时也有三个或多个派生分支,即是多叉(multifurcating)。多叉节点可以有以下两个原因:①一个祖先种群同时产生了三个或更多的独立分支;②过去某时发生了两个或多个二叉分歧,但是目前可获得
的数据无法确定它们发生的先后顺序。
系统发育树结构的基本信息在计算机程序中常用一组嵌套的圆括号表示,称为Newick格式。用Newick格式表示图6-3中的树,可写成(((A,(B,C)),(D,E))。
来源同一个祖先的两个外部节点之间用逗号分隔,并用一个圆括号配对表示形成一个内部节点,Newick格式进化树最后必须以顿号结尾。
6.1.1 有根树与无根树
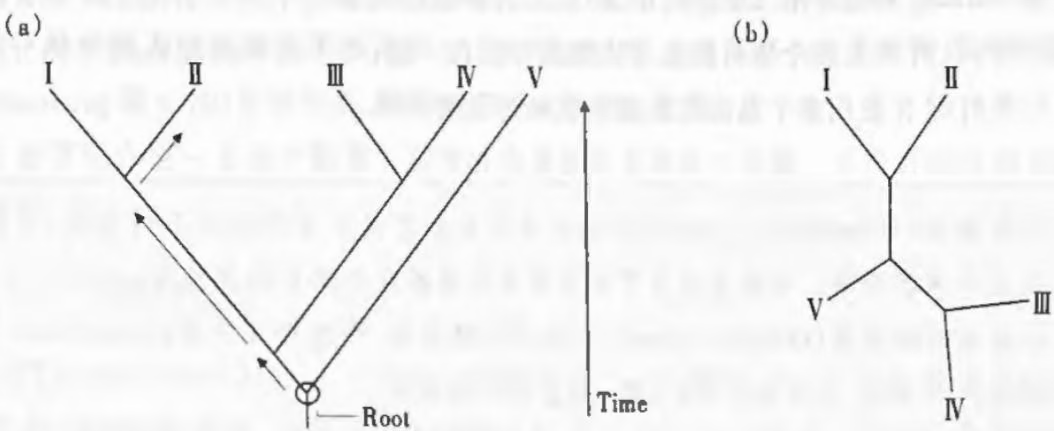
系统发育树按能否推断出共同祖先和进化方向,可分为有根树与无根树。有根树(rooted tree)的树根为一个共同祖先节点,从树根只有唯一的路径进化到其他任何节点。如图6-4中的箭头表示在有根树中从根到物种Ⅱ的唯一路径。无根树(unrooted tree)只表明了节点之间的关系,而没有关于进化发生路径的信息。但是可通过引入外部参考物种作为外类群(outgroup),来确定无根树的根节点。外部参考物种可用那些明确地已从被研究物种中分歧出来的物种,如研究人类(human)、黑猩猩(chimpanzee)与大猩猩(gorilla)时,可用狒狒(baboon)作为外类群,树的根可放在连接狒狒与人、黑猩猩和大猩猩共同祖先的分支上。
6.1.2 基因树与物种树
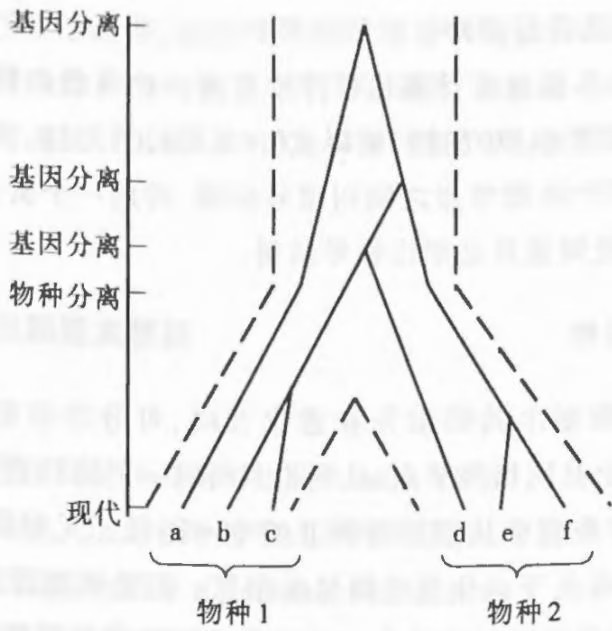
需要指出的是,基于单个同源基因差异构建的系统发育树为基因树(gene tree)。物种树(species tree)代表一个物种或种群进化历史的系统发育树。基因树经常被误当成物种树,然而基因树代表的仅仅是单个基因的进化历史,而不是其所在物种的进化历史。因为进化是发生在生物种群水平,而不是发生在个体水平上,物种形成事件(speciation event)可能在基因分化前或后发生,即不在同一个时间发生。通常基因分化先于新物种的种群分离,因为两个物种分歧的时间一般为两个物种发生生殖隔离的时间。如图6-5所示,基因的进化导致产生6个同源基因,在实线下,以字母a到f表示,而物种形成用虚线表示。相比物种内的其他基因,物种1中的一些基因可能与物种2中的一些基因更相似,如基因d是物种2中的成员,但是它与物种1中的成员更加接近。
当只考虑一个基因的时候,个体可能表现出与其他物种的成员关系更近。例如人类白细胞抗原(human leukocyte antigen, HLA)基因的多态性起源先于物种分歧,如只用HLA基因构建物种树,有些人类个体可能会与大猩猩分类在一起,而不是和其他人类个体分类在一起。所以最好综合使用多个基因的数据分析来得到物种树。
同源基因(Homologous gene)指从同一个共同祖先演化而产生的不同基因,可能具有相同或不同的功能。同源基因又可分为直系同源基因与旁系同源基因。
- 直系同源基因(Orthologs gene): 指在不同物种间, 通过物种分离(speciation)事件而产生的同源基因, 如上图中 d 与 b 或 c 为直系同源基因。
- 旁系同源基因(Paralogs gene): 指在同一个物种内, 通过基因复制(gene duplication)产生的同源基因, 如上图中 b 与 c 或 e 与 f 为旁系同源基因。
一般用于分子系统发育分析中的序列必须是直系同源基因,才能真实反映物种间的进化关系。
6.2 分子系统发育树的构建方法
对于给定数量的分类单元,有很多棵可能的系统发育树,但是只有一棵树是正确的,进化分析的目标就是要寻找这棵正确的树。用于进化分析的分子数据有两类:一是距离(distances)数据,即两个数据集之间所有两两差异,常用距离矩阵描述;二是特征(characters)数据,即分子所具有的不同状态特征。如DNA序列是由A、C、T、G四个碱基组成的离散数据。常用的基于距离构建系统发育树的方法有UPGMA(非加权分组平均法)、Neighbor-Joining(邻接法)、
Minimum Evolution(最小进化法)等。而基于特征构建系统发育树的方法以一定的进化概率模型来解释分子改变,常用的方法有 Maximum Parsimony(最大简约法)、Maximum Likelihood(最大似然法)和 Bayesian Inference(贝叶斯推断法)等。
如果确定了所有状态之间的相似性的标准,特征数据就可以转换成距离数据。例如,两个基因或蛋白质序列之间的距离值(D)可以简单通过序列比对来确定,将匹配的位点数(m)除以总的位点数(n):D=m/n。但这样的转换可能会使一些序列信息丢失,因为有些核苷酸或氨基酸的替换更容易发生,如哺乳动物的基因组中C被T替换的频率将近C被G或A替换的3倍。所以计算DNA序列的两两距离时,比对中C/T的错配的权重应该与C/G或C/A的权重不一样。
各种方法都各有优缺点。对于近缘物种序列,通常情况下使用最大简约法;而对于远缘物种序列,一般使用邻接法或最大似然法。邻接法的速度一般比较快,但对于序列相似度很低的序列,邻接法往往出现long-branch attraction(LBA)现象,会严重干扰进化树的构建。对于不同方法构建分子进化树的准确性,Hall(2005)认为贝叶斯法的准确性最好,其次是最大似然法。一般推荐用两种以上不同的方法构建进化树,如果所得到的进化树结构类似,且可信度(bootstrap值 >70 )总体较高,则得到的进化树较为可靠。
下面简要介绍一下基于距离的邻接法构建系统发育树的原理。其他方法可扫描章末二维码查看。
6.2.1 邻接法
邻接法(Neighbor Joining Method, NJ)是由N. Saitou和M. Nei于1987年提出的一种基于距离最小的建树算法,是最小进化(Minimum Evolution)法的简化。该方法首先由一棵星状树开始,即所有分类单元都从一个中心节点出发。然后,通过确定距离最近的相邻分类单元,通过循环将相邻节点合并成新的节点,使进化树分支的总长也尽可能地小,从而建立一个相应的拓扑树。在重建时将距离最小的两个终节点连接起来,在树中增加一个共同祖先节点,同时去除原来的两个终节点及其分支,并将新增加的节点作为终节点。随后,重复上一次循环。在每一次循环中,都有2个终节点被一个共同祖先节点取代。如此循环直到只有2个终节点时为止。
下面以五种灵长类动物为例,说明邻接法进行进化树构建的过程。我们感兴趣的是哪个灵长类动物与人类有最密切的亲缘关系。
1 | A Gorilla gorilla(gorilla)大猩猩 |
基于距离法的第一步是构建一个距离矩阵,反映物种间的差异。这里我们使用以下距离矩阵 (m\times m) :
| B | C | D | E | |
|---|---|---|---|---|
| A | 11 | 12 | 17 | 24 |
| B | 9 | 16 | 24 | |
| C | 16 | 24 | ||
| D | 24 |
邻接法的初始系统树为星状树(只有一个内部节点连接所有外部节点),然后循环通过连接两个邻近节点(Neighbor-joining)成一个新节点。
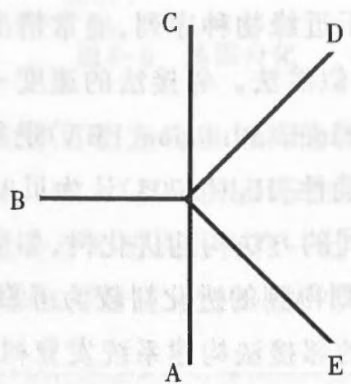
第一步 $(n = 5)$
首先,通过公式 $S_{x}=\sum_{i=1}^{n}d_{xi}$ 来计算得到 $S_{x}$ 的值,其中n是OTUs(可操作分类单元)的数量,在这里是n=5。
例如, $S_{A} = d_{AB} + d_{AC} + d_{AD} + d_{AE}$ $S_{A} = 11 + 12 + 17 + 24 = 64$ $S_B = 11 + 9 + 16 + 24 = 60$ $S_C = 12 + 9 + 16 + 24 = 61$ $S_D = 17 + 16 + 16 + 24 = 73$ $S_E = 24 + 24 + 24 + 24 = 96$
然后,我们计算 $\delta$ 矩阵,其中 $\delta_{ij}=d_{ij}-(S_{i}+S_{j})/3$ :
$$
\delta_ {A B} = 1 1 - \frac {6 4 + 6 0}{3} = - 3 0. 3
$$
$$
\delta_ {A C} = 1 2 - \frac {6 4 + 6 1}{3} = - 2 9. 7
$$
$$
\delta_ {A D} = 1 7 - \frac {6 4 + 7 3}{3} = - 2 8. 7
$$
这里要除以3是因为合并两节点ij后的距离是它们分别到其他3个节点距离之和。建立新的矩阵就为:
| B | C | D | E | |
|---|---|---|---|---|
| A | -30.3 | -29.7 | -28.7 | -29.3 |
| B | -29.4 | -28.3 | -28 | |
| C | -28.7 | -28.3 | ||
| D | -32.3 |
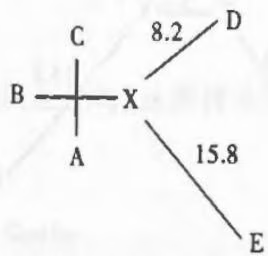
这个矩阵中的数字反映了进化树中相邻节点 $i$ 和 $j$ 所连接分支的相对总长度,一般认为此数值越小,最终树的总长度也最小,在这里最小的数值是 $\delta_{DE}$ 。因此,节点D和E是第一个被连接的相邻节点,它们被连接到新的节点X, $d_{DX}$ 和 $d_{EX}$ 通过下面公式计算:
$$
d _ {D X} = \frac {d _ {D E} + \frac {S _ {D} - S _ {E}}{n - 2}}{2} = \frac {2 4 + \frac {7 3 - 9 6}{3}}{2} = 8. 2
$$
$$
d _ {E X} = d _ {D E} - d _ {D X} = 2 4 - 8. 2 = 1 5. 8
$$
从而得到下面的树:
第二步 $(n = 4)$
下一步我们要确定下一对要连接的节点,建立一个用X替代了D和E的矩阵,因此这个矩阵有4个OTUs:A、B、C、X。我们需要计算 $d_{XA},d_{XB},d_{XC}$ :
$$
\begin{array}{l} d _ {X A} = \frac {d _ {D A} + d _ {E A} - d _ {D E}}{2} = \frac {1 7 + 2 4 - 2 4}{2} = 8. 5 \ d _ {X B} = \frac {d _ {D B} + d _ {E B} - d _ {D E}}{2} = \frac {1 6 + 2 4 - 2 4}{2} = 8 \ d _ {X C} = \frac {d _ {D C} + d _ {E C} - d _ {D E}}{2} = \frac {1 6 + 2 4 - 2 4}{2} = 8 \end{array}
$$
得到下面的矩阵:
| B | C | X | |
|---|---|---|---|
| A | 11 | 12 | 8.5 |
| B | 9 | 8 | |
| C | 8 |
与第一步计算方法一样,建立 $\delta$ 矩阵:
$$
S _ {A} = 1 1 + 1 2 + 8. 5 = 3 1. 5
$$
$$
S _ {B} = 1 1 + 9 + 8 = 2 8
$$
$$
S _ {c} = 1 2 + 9 + 8 = 2 9 \quad S _ {x} = 8. 5 + 8 + 8 = 2 4. 5
$$
| B | C | X | |
|---|---|---|---|
| A | -18.75 | -18.25 | -19.5 |
| B | -19.5 | -18.25 | |
| C | -18.75 |
这个矩阵有两个最小值,这里我们选择连接节点B和C(如果选择A和X,最后的树将会相同),B和C连接到新的节点Y:
$$
d _ {B Y} = \frac {d _ {B C} + \frac {S _ {B} - S _ {C}}{n - 2}}{2} = \frac {9 + \frac {6 0 - 6 1}{3}}{2} = 4. 2 5
$$
$$
d _ {C Y} = d _ {B C} - d _ {B Y} = 9 - 4. 2 5 = 4. 7 5
$$
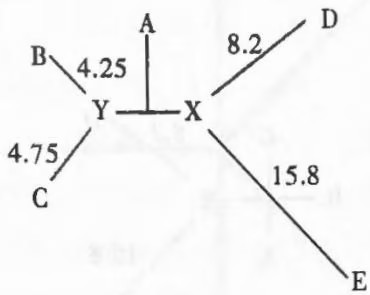
第三步 $(n = 3)$
同样,再建立一个用 Y 替代了 B 和 C 的矩阵,此矩阵只有三个 OTUs:A、Y、X。计算长度 $d_{YA}, d_{YX}$ :
$$
d _ {Y A} = \frac {d _ {B A} + d _ {C A} - d _ {B C}}{2} = \frac {1 1 + 1 2 - 9}{2} = 7
$$
$$
d _ {Y X} = \frac {d _ {B X} + d _ {C X} - d _ {B C}}{2} = \frac {8 + 8 - 9}{2} = 3. 5
$$
| Y | X | |
|---|---|---|
| A | 7 | 8.5 |
| Y | 3.5 |
同样, $\delta$ 矩阵就变为:
| Y | X | |
|---|---|---|
| A | -19 | -19 |
| Y | -19 |
在这个矩阵中所有值都相等,我们选择将A和Y连接,并建立新的节点Z。
$$
d _ {r z} = 1
$$
$$
d _ {A Z} = 6
$$
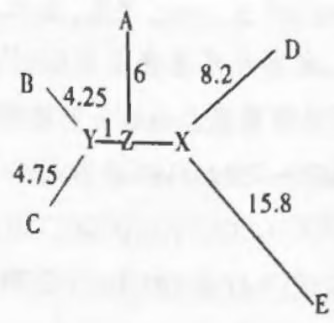
第四步 $(n = 2)$
最后的矩阵非常简单,只有:
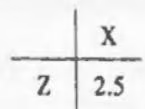
我们用长度 $d_{zx}$ 来获得最终的无根进化树,这棵树说明黑猩猩是与人类亲缘性最高的灵长类动物。
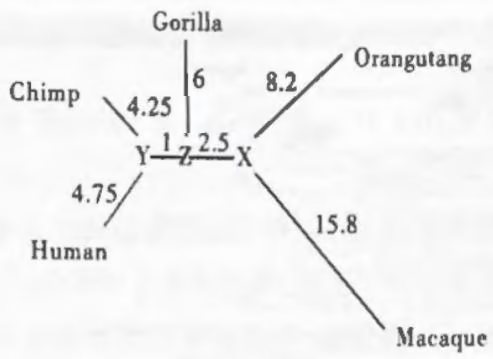
6.3 MEGA 构建进化的实训
本实验将学习构建系统演化树(phylogenetic tree)的主要方法——邻接法(Neighbor-Joining, NJ),并学习生物软件MEGA的主要使用方法。
6.3.1 基因序列的获得
(1) 打开 NCBI 网站的主页, 选择 “Protein” 数据库, 搜索 “insulin AND human[orgn]”. 选择第一个人 (Homo sapiens) 的蛋白质序列, 并以 FASTA 格式保存此人胰岛素序列到新文件 ins_seq.fasta。
1 | 如要下载胰岛素基因序列,只要在胰岛素蛋白 GenPept 格式信息页面,找到 "CDS" 注释部分,通过点击 CDS 链接获得胰岛素蛋白的编码基因序列。 |
1 | >gil386828|gb|AAA59172.1| insulin [Homo sapiens] |
(2)通过NCBI的BLAST中的BLASTP程序检索人胰岛素的相似蛋白序列(图6-6)。
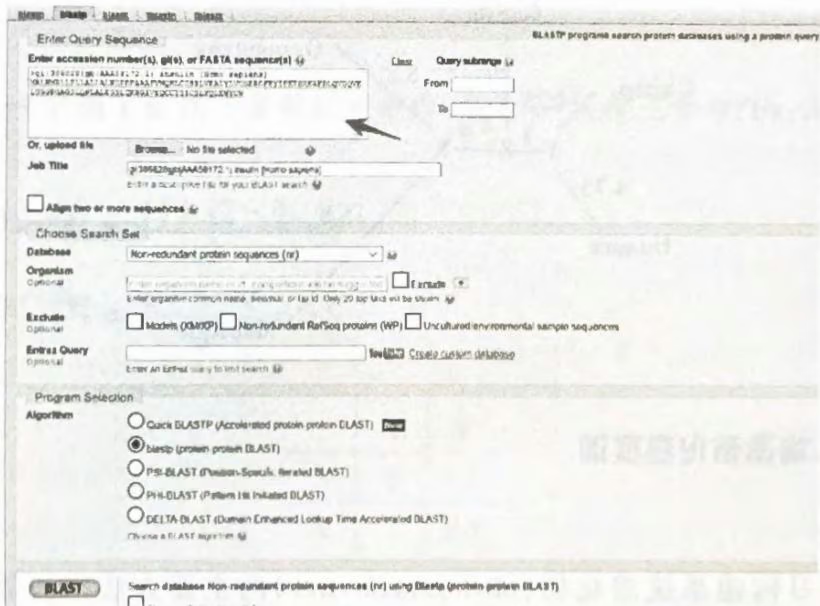
(3) BLAST 搜索结果中, 根据序列相似性的大小, 挑选至少 5 个不同物种的胰岛素蛋白序列, 点击每个序列前方的链接, 选择 FASTA 格式, 并将序列复制到 ins_seq.fasta 文件中。
注:本章末二维码中提供此文件下载地址。
6.3.2 MEGA 构建进化树—NJ 法
(1) 打开软件 MEGAX。
(2)首先导入序列,点“Data”按钮,选择“open a file/session…”,再选择已获得的ins_seq.fasta文件,在跳出的窗口中选择“Align”,即进行序列比对。
也可选择 Alignment→Alignment Explorer/CLUSTAL, 将刚才保存的 FASTA 格式序列, 直接复制粘贴进去 (Ctrl+C→Ctrl+V), 或选择“Retrieve sequences from a file”直接打开 ins_seq.fas 文件。
(3)由于MEGA软件已经集成了ClustalW,所以可直接用MEGA进行序列的比对。序列导入后,选择菜单Alignment $\rightarrow$ Align by ClustalW,在弹出的对话框中点击“OK”,选择所有序列,比对参数使用默认设置,比对结束后结果如图6-7所示。
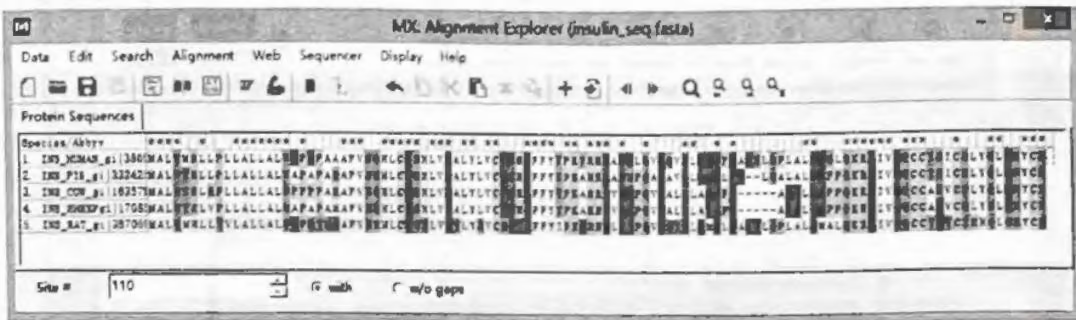
也可以选择“Align by Muscle”,Muscle 比 ClustalW 的比对速度更快,当要比对的序列越多,速度差别越大。
(4) 比对完成后, 需要人工检查序列比对情况。如果序列两端不齐, 可将序列两端切齐: 通过选择两端不齐部分 (点击序列上方的空格, 及与 Shift 键配合使用), 按 Delete 键即可去掉两端不齐序列。通过这种方式也可去除仅包括 gap 的列, 还可以再手动调整空位 (gap) 的位置使比对更合理。最后为了以后方便使用, 可以把比对后的序列先保存成 *.mas 文件 (ins_seq.mas)。
(5) 把比对后的序列保存为 MEGA 自身的 MEG 格式, 选择菜单 Data→Export Alignment →MEGA format, 保存为 insulin_seq.meg 文件, 在跳出的 “Input title of the data” 框中输入 “insulin” 再点 “OK” 按钮。
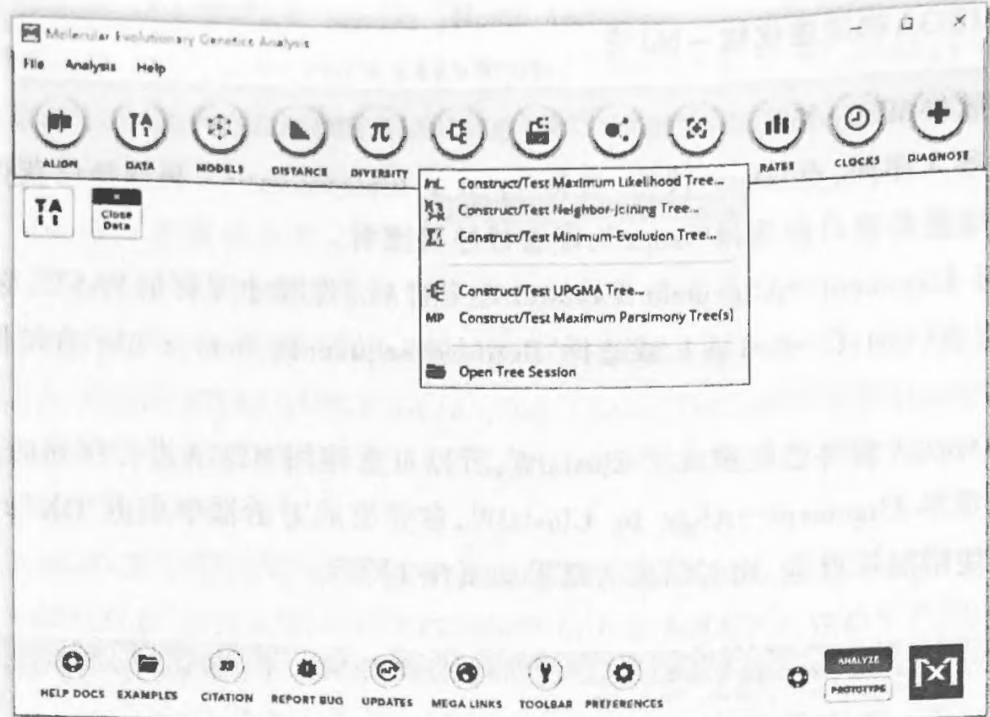
(6) 在 MEGA 主程序窗口的工具栏中, 选择“Phylogeny”按钮(图 6-8), 选择 NJ 建树方法 (Construct /Test Neighbor-Joining Tree); 在跳出窗口中选择文件“insulin_seq.meg”。并在随后跳出的“Analysis Preferences”窗口(图 6-9) 中设置参数:
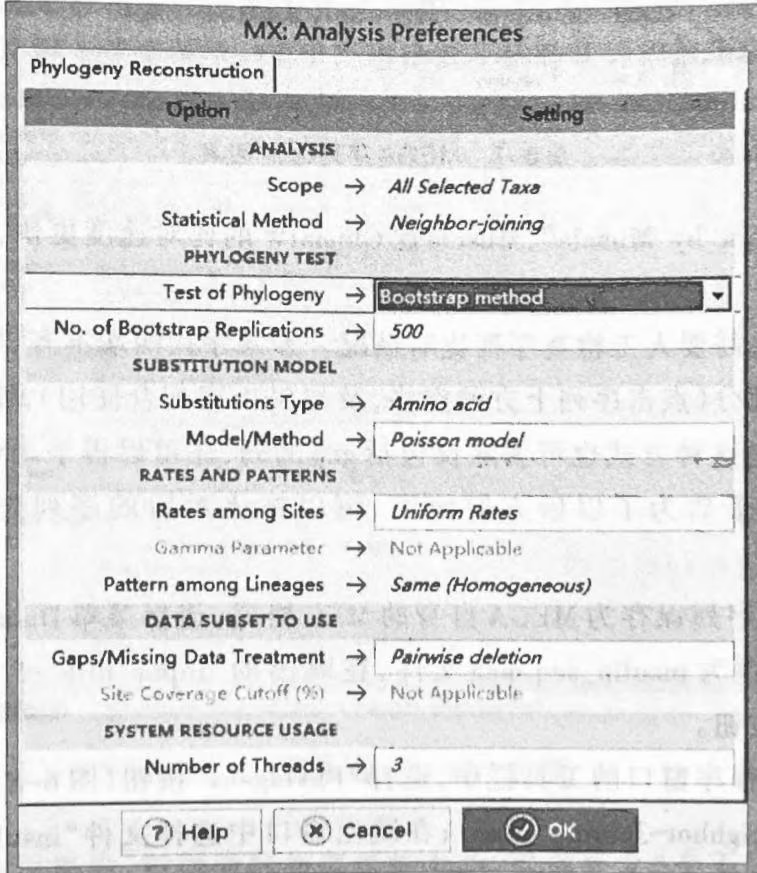
(7)可以根据序列的需要更改这里的参数,我们这里只将Bootstrap重复次数改为1000次,其他采用默认值。基于核苷酸或蛋白质序列的NJ建树,需要选择特定的模型,一般核苷酸选择“Kimura 2-parameter”模型;而蛋白质选择“Poisson Correction”(泊松修正)这一简单模型。其他复杂模型的选择需要专门软件如JmodelTest来检测分析。关于这些参数设置的更多信息,请参考MEGA的说明书。
(8)点击“OK”按钮,很快进化树就构建完成,而且还显示分支的支持率(图6-10)。一般认为Bootstrap值大于70,才认为构建的进化树较为可靠,而小于50则认为此树不可信。如图6-10所示,可设置只显示置信度大于70的树枝。
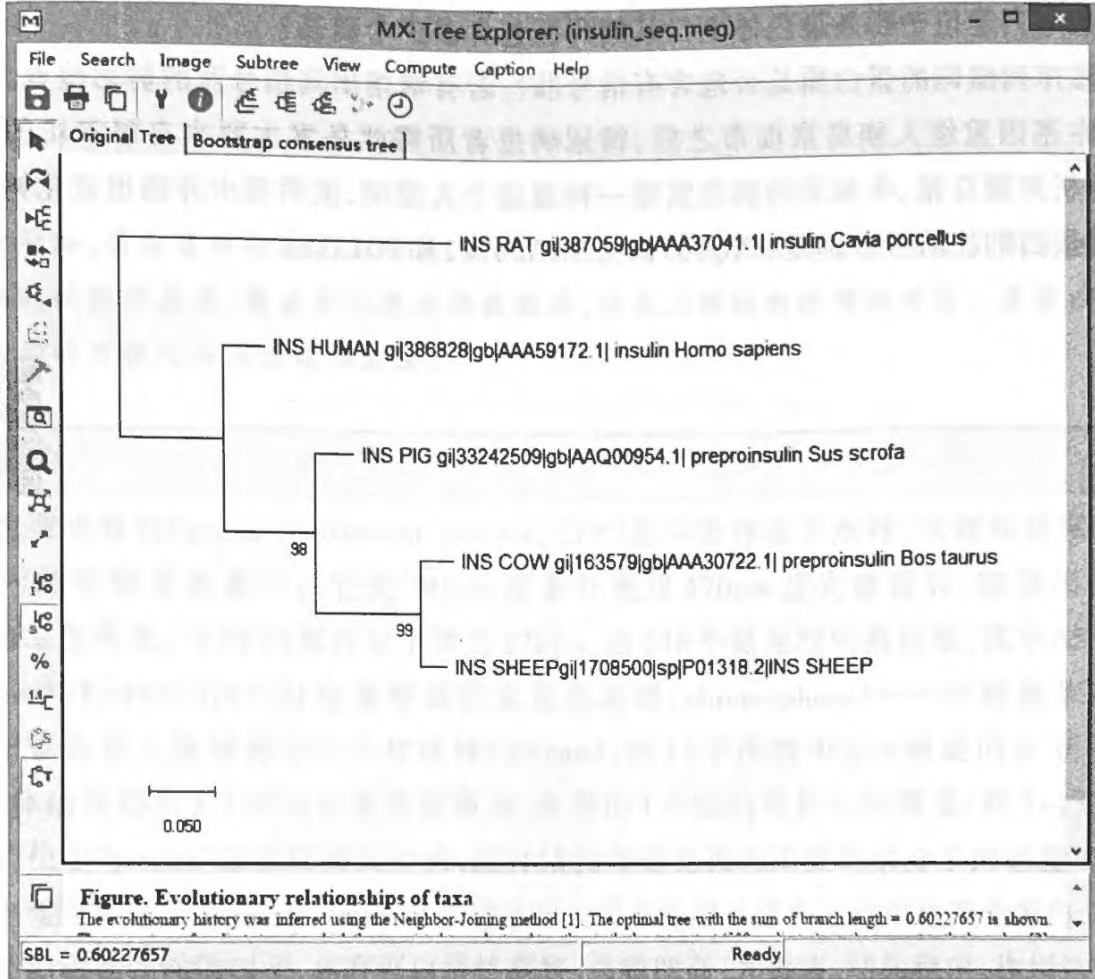
(9) Tree Explorer 提供一些调整或美化进化树的功能。要改变进化树的显示方式, 点击 View→Tree/Branch Style, 可以选择进化树的不同树形。常见的树形有传统型(tranditional): 包括长方形(rectangular)、直线形(straight)、曲线形(curved)、辐射形(radiation)和环形(circle)。
(10) 进化树的保存。MEGA 的结果保存方式比对灵活。点击菜单 Image→Save as Image file 将进化树保存为 TIFF 或 PDF 格式的图片。而点击菜单 File→Export Current Tree (Newick) 可以输出 Newick 格式的进化树(insulin_seq.nwk)。保存的 Newwick 格式树文件可以在 iTOL, Figtree 等工具中进行更复杂的调整,比如添加分类颜色、标记和条形图组合等。
习题
以胰岛素的基因序列重新用NJ法构建基因序列的进化树, 比较蛋白序列与基因序列构建进化树时的参数及结果差异。
利用在线进化树工具 phylogeny.fr 构建胰岛素的进化树,并注意其与 MEGA 分析过程与参数设置的差异。
请查询人胰岛素基因(GenBank Accession no. J00265)的相关信息并回答下列问题:
(1)该序列定位于哪条染色体上?其编码区包含多少个碱基?
(2)该序列编码的蛋白质是否包含有信号肽?若有请指出其信号肽的剪切位点。
(3)在基因重组人胰岛素面市之前,糖尿病患者所需胰岛素主要来自屠宰场的动物胰脏。请分析来源自猪、牛和羊的胰岛素哪一种最适于人使用,说明理由并画出进化树。(这三种胰岛素蛋白的注册号分别是AAQ00954、AAA30722和P01318)
第 15 章 宏基因组学(Metagenome)
得到数据之前就建立理论是个严重的错误。——阿瑟·柯南·道尔
本章简要介绍宏基因组学的基本知识与数据分析方法,并以实例介绍16S rDNA扩增子测序数据的生物信息学分析流程。
◎ 导学案例
在人体内生活着大量的微生物,这些微生物菌群及其遗传信息的总和被称为人体微生物组(human microbiome)。据估计,成人肠道中生活着大约2kg的细菌,其他部位如口腔、皮肤、呼吸道和生殖道也含有大量共生菌群。这些菌群的细胞数量大约有 $10^{13}\sim10^{14}$ 个,比人体自身的细胞数约多10倍。这些细菌所携带的基因数量更是惊人,可能多达人类自身基因的100倍。因此,科学家将人体微生物菌群所携带的全部基因称为人体“第二基因组”(second genome)。所幸的是,这些菌群中绝大多数成员都是人类的忠实朋友,其中有极个别条件致病菌,只在人体免疫力被破坏后才会致病。因此,有些学者认为绝大多数人体微生物对人类健康并没有重要作用,可能只是人体环境适合它们生存而已。
目前越来越多的人类微生物组研究表明肠道菌群失调可能与肥胖、自闭症、糖尿病、癌症和肠胃炎等疾病有密切关系。粪菌移植(fecal microbiota transplantation, FMT)作为重建肠道菌群的有效手段,已用于治疗感染性腹泻、炎症性肠病、便秘等胃肠道病症,并被认为是突破性的医学进展。
在地球的各种环境中,如土壤、海洋或人体肠道,都生活着成千上万的微生物,包含细菌、真菌、古菌和病毒等。生态环境中的微生物菌群(microbiota)具有非常丰富的组成与功能多样,并随着环境的变化而动态变化。当前我们对微生物的知识大多还是来自可培养的微生物,对微生物菌群的多样性与动态变化机制的理解还很欠缺。然而,据统计,自然界中约有99%的微生物是不能在实验室条件下进行纯化培养的不可培养微生物。类似各种“组学”的概念,我们将某一生境中全部微生物及其含有的遗传物质(DNA、RNA等)的总和称为微生物组(microbiome)。例如,人类肠道中寄生了约1000种不同的细菌,其携带的基因数量更是惊人。肠道微生物对人体健康有着至关重要的作用,比如帮助消化食物、合成维生素等,但是也有一些微生物可能会导致疾病,或影响药物在体内的代谢、药物的作用等。
microbiota: 常译为微生物群, 指生活在特定生态环境中的微生物总和, 强调微生物群系本身, 与 microflora 是近义词。如 “肠道菌群 (gut microbiota)”、“土壤菌群 (soil microbiota)”。
microbiome: 常译为微生物组, 可以理解为 microbiota+genome, 强调微生物群系和其含有的遗传信息的集合, 如“人体微生物组 (human microbiome)”。
宏基因组(metagenome)(也称微生物环境基因组,microbial environmental genome)是由Handelsman等在1998年提出的新名词,其定义为“the genomes of the total microbiota found in nature”,即生境中全部微生物遗传物质的总和。目前主要指环境样品中的细菌和真菌的基因组总和,包含了可培养的和未可培养的微生物的基因组。宏基因组学(metagenomics)是一种研究微生物群落多样性的方法,不需要借助微生物人工培养,通过同时测定一个样品中微生物群落的所有DNA序列,研究此微生物群落的物种分类与功能概况。在高通量测序出现前,宏基因组研究主要是通过DNA克隆与Sanger测序,即首先提取微生物群落的DNA,片段化后克隆至测序载体中,用Sanger法测序获得DNA序列,此过程费时费力且昂贵。随着NGS技术的发展,高通量测序已经完全代替传统低通量的Sanger法测序,成为宏基因组研究的主流方法。NGS的高敏感性可以直接检测以前观察不到的不可培养微生物物种。美国卫生研究院(NIH)在2007年启动人类微生物组计划(Human Microbiome Project,HMP),试图利用NGS方法研究人体微生物菌群的结构及动态变化,以及其与人类健康(如肥胖、自闭症、糖尿病、肠胃炎等)之间的关系。
15.1 基于NGS的两种宏基因组研究策略
宏基因组研究的目标是确定一个微生物群落的物种分类组成、相对丰度,以及其如何受环境因素的影响。一般有两种不同的测序策略:全基因组鸟枪(whole genome shotgun, WGS)宏基因组测序与靶向(targeted)宏基因组测序,或又称扩增子(amplicon)测序。
(1) WGS宏基因组测序是从一个环境或宿主样本中直接提取微生物的全部基因组DNA,并经破碎成小片段后进行测序分析。宏基因组测序避免了PCR扩增导致的偏倚,更能反映样本的真实情况,而且通过组装与基因注释可获得新物种的基因信息,有助于对微生物群落的功能进行准确的判断。
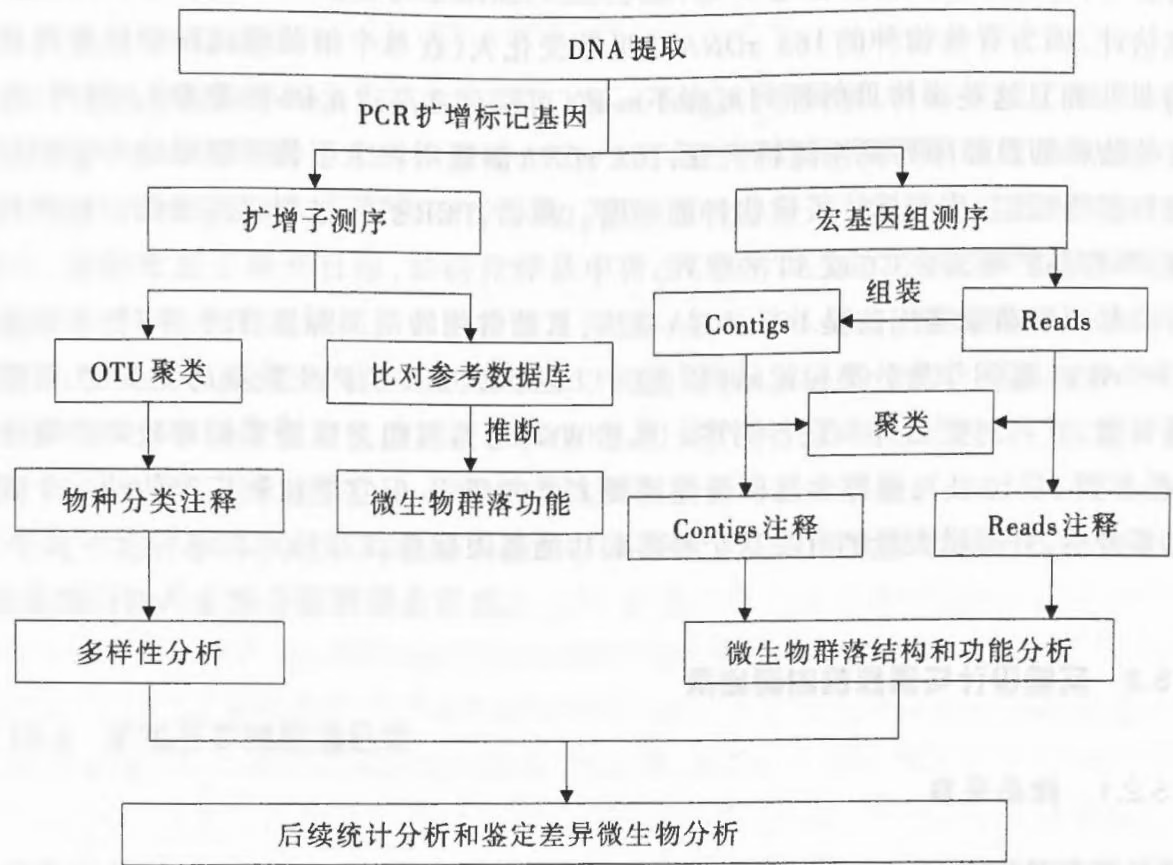
宏基因组测序不仅能获得无偏的物种组成与基因功能信息,还能通过分箱(binning)组装方法拼接出部分微生物的基因组草图。与单个物种的基因组测序相比,微生物群落的宏基因组测序数据更加复杂,每个宏基因组测序样本包括大量的未知微生物,而且这些物种的相对丰度也变化很大,因此宏基因组数据有很高的异质性(heterogeneity),分析难度较大,并且目前微生物全基因组的数据库资源不够丰富,很多宏基因组测序序列无法比对到数据库中的已知序列进行微生物群落和功能分析(图 15-1)。
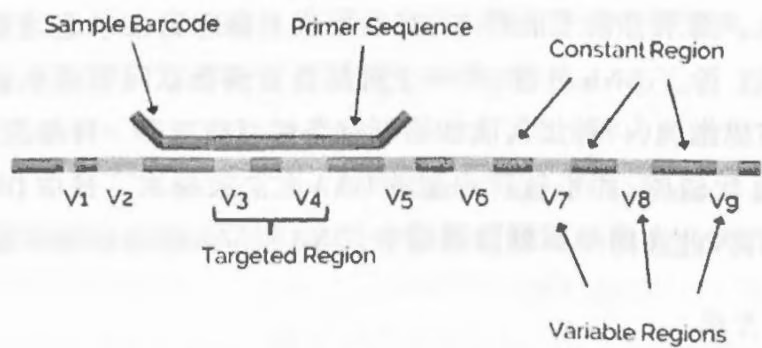
(2)靶向宏基因组测序方法利用在不同微生物中保守的标记基因 (marker gene), 如 16S rRNA 基因 (又称 16S rDNA), 经定向 PCR 扩增后再测序分析。标记基因是指在微生物中广泛存在, 序列相当保守并有分化的基因, 可以用于微生物群落结构与组成分析。16S rRNA 基因被认为是进化研究通用的生物钟 (universal clock), 进化缓慢, 进化速率大约是每 5000 万年发生 $1%$ 的碱基突变, 能反映不同物种间的亲缘关系。16S rDNA 序列长度约为 1542bp, 由 10 个高度保守区和 9 个可变区构成 (图 15-2)。保守区序列高度保守适合用于多物种的 PCR 引物设计, 不保守区的序列可在不同分类学水平上区分不同的微生物物种。其中 V3, V4, V5 区特异性较好, 数据库信息全, 是细菌多样性分析的最佳选择。
因此, 16S rDNA 常作为标志物来测量细菌不同 OTU(可操作分类单元, 描述一个物种或一组物种)的相对丰度。但要注意的是, 基于 16S rDNA 的方法只是对物种分类的相对数量做近似估计, 因为有些物种的 16S rDNA 拷贝数变化大(在单个细菌基因组中已发现最多有 15 个拷贝), 而且这些多拷贝的序列可能不一致(可能存在高达 $6.4%$ 的差异)。另外, 也可能由于有些物种的目标序列发生随机突变, 16S rDNA 的通用 PCR 引物不能结合于它们的目标位点进行扩增反应, 从而低估了该物种的丰度。最后, PCR 扩增过程容易导致一些序列扩增的偏倚, 不容易扩增富含 GC 或 AT 的序列。
标志基因细菌最常用的是16S rRNA基因,真菌常用转录间隔区(ITS)序列,而真核生物常用18S rRNA基因作为分类标记基因。这个方法大大减少所产生数据的复杂度,可获得更深的覆盖度,并可对更多样本进行测序。虽然WGS宏基因组方法需要相对较高的测序深度(每个样本要2~10Gb),进行大规模研究需要大量的费用,但它能比较正确估计一个微生物群落的多样性,并提供大量的有关这个群落的功能基因信息。
15.2 实验设计与测序的影响因素
15.2.1 样品采集
样品采集是宏基因组研究的最初实验步骤,要注意采样对象或环境的选择,尤其应注意取样环境必须要有代表性,能反映研究对象的生活习性,详细记录取样的环境与取样过程,如取样地的一般特征(温度、pH等)、地理位置和取样方法等。对于临床样本通常要记录患者的医疗史、关键临床指标、采样部位及采样条件等。这些背景数据(metadata)信息对后续宏基因组数据分析非常重要,因为宏基因组研究主要通过数据挖掘微生物组数据与背景数据的统计学关联性,从而揭示其生物学机制。
15.2.2 DNA提取
样品采集后应尽快进行 DNA 提取和测序,以避免 DNA 降解。提取的 DNA 应该能反映取样环境的所有或大多数微生物及其相对数量,并要有较高的纯度,不可包含可能影响下游文库构建的污染,如土壤样本中经常含有腐殖酸(humic acids)、多糖等污染物,会抑制测序文库构建的酶活性。而来自宿主的样本,如人肠道上分离的 DNA 经常有宿主的 DNA 污染,需要去除污染 DNA。除了 DNA 纯度,另一个挑战是如何能以同等效率提取不同微生物菌种的 DNA。如机械破碎细胞,一种细菌的细胞裂解条件可能对另一种细菌并不合适,如会造成易破碎细胞的 DNA 比较碎,而难破碎细胞的 DNA 无法被提取。提取 DNA 方法对宏基因组的结果有重要影响,因此在同一系列的研究中,DNA 提取方法应保持一致。
15.2.3 测序方法
随着 DNA 测序文库构建方法的发展, 现在只要少量 DNA 就可以构建测序文库, 如
Nextera XT protocol 只需要 1ng DNA。因此,从大多数生态环境样本中提取的 DNA 应该能用于构建测序文库。如有些条件只有很少的 DNA 样本,像古生物化石样品,可以通过 DNA 扩增来产生足够的 DNA。
测序还要考虑测序深度(depth)与读长(read length)等因素。16S扩增子测序一般采用双端250bp(PE250)测序,单个样本需要3万~5万条序列的测序深度;而宏基因组一般采用双端150bp(PE150)测序,需要测至少2000万条(20Mb)序列,数据量可达到6Gb(150×2×20Mb)。深度取决于研究目标,如研究样品中稀少(rare)微生物的组成可要比研究高丰度(abundant)微生物的组成测更多的数据量。读长一般是越长越好,现在Illumina HiSeq平台在快速运行模式下,进行两端测序的读段可以拼接得到450bp的序列。而其他测序平台,如PacBio的SMRT可以产生更长的读段(>40kb),但其产生的数据量比较少。目前一般综合利用不同测序平台的优点,Illumina的短读段可以用于调查群落的组成比例,而Pacbio的长读段有助于细菌基因组组装时骨架的组装。测序技术的发展无疑将会增加读长并降低价格,使宏基因组的研究目标更容易完成。
15.3 扩增子测序数据分析
本节以细菌 16S rRNA 基因扩增子测序(简称 16S 测序)为例,对扩增子测序的数据分析流程进行说明。扩增子测序的分析流程,包括数据预处理、OTU 聚类、物种分类注释与多样性统计等过程。
15.3.1 测序数据质控与预处理
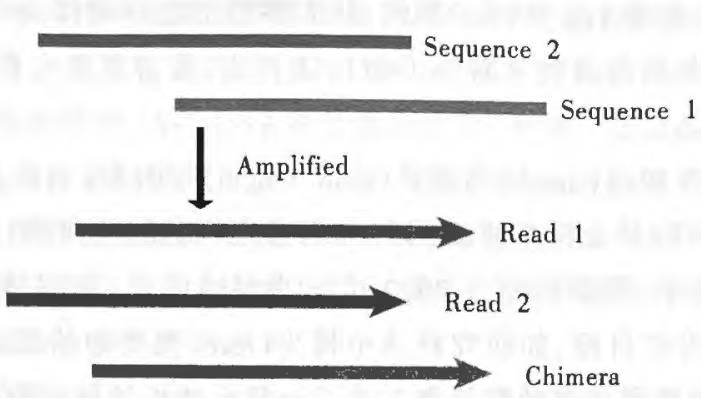
为保证数据质量和避免得到错误结果,宏基因组测序的原始数据(raw data)需要先进行预处理得到纯净序列(clean data)后,再进行下游的分析。通过常用的NGS质控工具可以过滤低质量读段,切除低质量碱基与测序接头等。对来自宿主的样本还需要用比对宿主基因组的方式去除宿主DNA的污染。通常16S测序采用混合样本测序策略,因此先要通过样本特异性的条码(barcode)将总的测序序列分解为各样本的序列,再用于数据质控处理。Illumina HiSeq或MiSeq测序获得的双端序列(paired-end reads)还要先拼接成一条序列。16S测序的PCR扩增和测序过程中都可能出现错误,产生许多背景噪声,可能导致对生物多样性的估计过高,因此需要采用一些工具(如QIIME的Denoiser)进行去噪处理。另外,16S测序中的PCR扩增过程还可能会产生嵌合体(chimera),即试管内两个不同模板DNA分子的重组产物(图15-3),需要利用一些工具(如ChimeraSlayer,UCHIME等)进行识别并删除。PCR也会产生重复读段,Picard工具有专门的去除重复读段模块,它不需要先把读段比对到参考基因组。
15.3.2 OTU聚类与物种分类注释
为了解样本中存在哪些微生物,最直接的思路就是将每条序列比对到分类数据库,这样可以获得样本中已知的物种分类信息。然而,样本中还存在大量未知物种,仅比对参考数据库无法全面了解样本的物种构成。因此,通常做法是将相似的序列聚为一类,称为可操作分类单元(operational taxonomic unit, OTU)。因为在16S扩增子测序中无法获得完整的16S rRNA基因信息,不宜直接用物种的概念,所以用OTU取代“物种”的概念进行系统发育分析和多样性分析。
尽管很多16S rRNA基因序列在同一物种中非常保守,但仍有一部分序列是会变异的,而且在扩增和测序过程难免出错,因此以 $100%$ 相似度作为聚类标准很可能将本是同一个物种的序列划分为两个不同的分类单元。实际应用中,常用 $95%$ 、 $97%$ 和 $99%$ 相似度作为某一个分类水平的阈值,将高于这个相似度的序列划分为一个OTU,例如MEGAN软件推荐种间相似度为 $99%$ ,属间相似度为 $97%$ ,科间相似度为 $95%$ 。除了利用序列相似性进行从头聚类(de novo clustering)以外,还可以通过比对参考数据库进行聚类:一种策略是保留与参考数据库匹配的序列,舍弃不匹配的序列(closed-reference);另一种是保留匹配的序列,同时将不匹配的序列再进行相似性聚类(open-reference)。最后各OTU选择一条代表序列,并比对到已知的参考数据库后就可获得各OTU的物种分类信息。不匹配序列可能是源自还没有被纳入数据库的新物种。最初的基准研究显示发现新物种需要1M条序列,所以这是每个样本16S测序的最底数据量。而且要注意,16S序列的数量并不等同于细菌细胞数量,有些细菌有多拷贝的16S基因,而且这些多拷贝的16S基因序列可能完全相同或有一些差异。
OTU 聚类构建完后,首先可对每个 OTU 进行计数,建立一个 OTU 组成丰度表,用于后续的多样性分析。同时,每个 OTU 需要选择一个代表序列来作为这个 OTU 的代表进行系统发育分析。一般可以选最长的或丰度最高的序列。选出代表序列后,比对 OTU 序列到含有物种分类信息的参考数据库,即可对测序的 OTU 序列进行物种分类鉴定与建立系统发育树。因此,OTU 分类分析最关键的因素是序列比对算法和含有物种分类信息的参考数据库。16S rRNA 基因序列参考数据库常用的有核糖体数据库 RDP(Ribosomal Database Project)、Greengenes 数据库和 SILVA 数据库等。
15.3.3 多样性分析
宏基因组研究需要以一种生态学的观点来指导分析。按照生态学的观点,多样性高的生态群落,抵抗力和稳定性都会更高更强。当得到一个群落的物种组成后,一般就是计算生态多样性。通常生态多样性的指标可分两类: $\alpha$ 多样性指数( $\alpha$ -diversity)与 $\beta$ 多样性指数( $\beta$ -diversity)。
α多样性是指一个生态环境内物种的多样性,主要是评价同一个环境内样品的多样性程度。常用的度量指标包括计算菌群多样性的香农多样性指数(Shannon diversity index)、辛普森多样性指数(Simpson diversity index)和菌群丰度的Chao1丰度估计值(Chao1 richness estimator)等。
β多样性是指不同生态系统之间的物种多样性,衡量时空尺度上物种组成的变化。Beta多样性不仅描述环境内物种的数量,还考虑这些物种的相似性以及彼此之间的亲缘关系。物种相似性越低,β多样性越高。
UniFrac距离矩阵常用于β多样性分析,其计算方法为:首先利用来自不同环境样品的OTU代表序列构建一个进化树,样品对间的距离通过计算一对样本共有的和非共有的进化树分支的长度得到,其公式为:样品对间距离=非共有的分支长度总和/共有与非共有的分支长度总和。Unifrac度量差异通过0-1距离值表示(图15-4),进化树上最早分化的树枝之间的距离为1,即差异最大,来自相同环境的样品在进化树中会较大概率集中在相同的节点下,即它们之间的树枝长度较短,相似性高。若两个群落完全相同,那么它们没有各自独立的进化过程,UniFrac值为0;若两个群落在进化树中完全分开,即它们是完全独立的两个进化过程,那么UniFrac值为1。
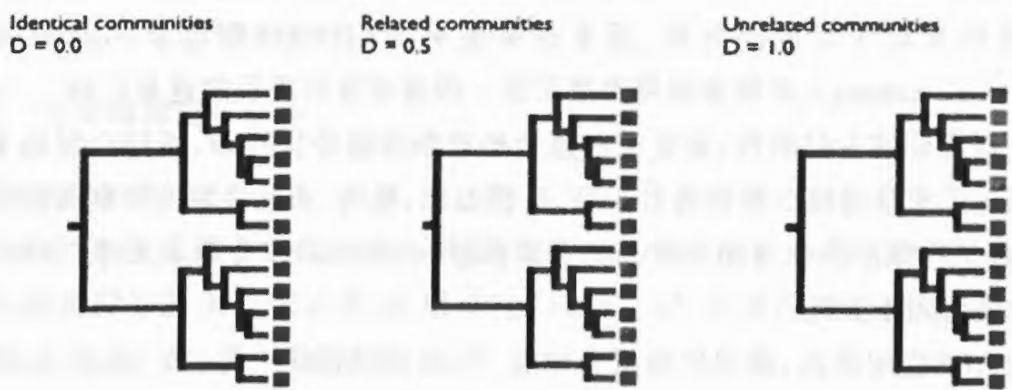
从 UniFrac 的定义可以看出它只考虑序列是否在群落中出现,而不考虑序列的丰度。若两个群落包含的物种完全相同,那么不管每个物种的丰度是否有差别,UniFrac 值都为 0,此为 Unweighted 分析(只考虑 OTU 是否在群落中出现,不考虑其丰度)。而 Weighted 分析会根据每个 OTU 的相对丰度来计算权重,可以更进一步定量地检测样品间不同谱系上的差异。
Unifrac 分析得到的距离矩阵可用于多种分析方法, 如可通过多变量统计学方法 PCoA 分析(principal coordinates analysis),直观显示不同环境样品中微生物进化上的相似性及差异性。PCoA分析是一种研究数据相似性或差异性的可视化方法。PCoA从多维OTU数据中提取出最主要元素和最大程度反映样本差异的三个坐标轴,并映射在三维空间体系中,通过可视化作图,距离越近的点表示相似度越高。
需要注意的是,如果样品间测序深度差别太大,有可能导致多样性的估算产生偏差(bias)。一般不同样品的数据要先进行标准化(normalization)处理后才能进行样品间的比较。常用的标准化方法是随机从每个样品中选择相同数目的读段,即稀疏化(rarefaction),或将每个OTU的读段数除以该样本的总测序量使OTU计数转换为相对丰度值。
15.3.4 数据分析工具与数据库
QIIME (Quantitative Insights Into Microbial Ecology, www.qiime.org) 和 Mothur (www.mothur.org) 是微生物生态学研究领域最流行的综合软件包,它们的功能与用途相似,可以实现从数据预处理、OTU 聚类到多样性分析的基本分析流程。QIIME 分析流程由美国科罗拉多大学的 Rob Knight 团队开发,包含了 PyNAST 比对、系统发育树构建、OTU 分类及主坐标分析 (PCoA) 聚类可视化等软件,并含有人类微生物组项目中用于宏基因组分析的标准化分析流程脚本。
随着高通量测序技术的发展,鸟枪法宏基因组测序的相关分析软件也越来越多。对于有较高质量宏基因组参考数据库的人类肠道微生物,可采用Kraken2进行序列的物种分类,HUMAnN2可用于基因功能定量分析。而对于缺少高质量宏基因组参考数据的研究,则可采用MEGAHIT从头组装宏基因组数据得到重叠群,并用Prokka进行基因预测。预测得到的基因集可通过BLAST比对到各种基因功能注释数据库进行生物学意义研究,如常用的碳水化合物基因数据库CAZy、抗生素抗性基因数据库CARD和毒力因子数据库VFDB等。如果涉及多个样品的宏基因组数据分析,通常还需要采用CD-HIT构建非冗余基因集(non-redundancy gene catalog),实现所有样本基于统一的参考序列进行定量和比较。
除了上面提到的专门软件,也有一些整合的宏基因组分析网站,如IMG/M和MG-RAST等。它们集成了宏基因组分析的各种工具,有预处理、聚类、功能注释及不同条件间比较等。MG-RAST直接将测序数据与相关样品的背景信息(metadata)作为输入文件,而IMG/M需要预组装的重叠群用于分析。
与其他NGS应用类似,美国生物信息中心NCBI的SRA(Sequence Read Archive)数据库也是存储各种宏基因组数据的主要官方数据库。同样,欧洲生物信息中心EBI也提供功能相似的存储数据库ENA(European Nucleotide Archive),界面相对于SRA更友好,而且可以直接下载原始FASTQ文件。这些数据库中积累大量数据,特别是目前未知物种的序列数据后,将促进宏基因组研究中发现新基因或新物种。
15.4 16S rDNA扩增子数据分析实践
16S rDNA 扩增子测序分析是微生物组领域应用最广泛的技术。16S rRNA 基因测序数据分析流程为: 先对样本测序数据进行质控与预处理, 得到样本的 OTU 聚类与物种分类信息, 再通过可视化查看样品的细菌种类, 并统计每个样品的差异菌种。
此流程所有命令都需在 WSL 的 bash 终端下运行(以下命令前面的“$”代表 bash 提示符,不需要输入)。运行 Ubuntu 之前,先在电脑 D 盘创建一个新文件夹 win16s,并将样本测序数据文件(raw_reads.zip)放在此目录下。
$cd /mnt/d/win16s/ 切换到工作目录
15.4.1 相关软件与文件
(1) 安装 VSEARCH
$sudo apt install vsearch 默认安装在/usr/local/bin/目录
(2) 安装 RDP classifier
先下载 RDP Classifier(此流程只能使用老版本 v2.2)并放在本练习文件所在的 D 盘的 win16s 目录,再解压缩文件 rdp_classifier_2.2.zip,可得到一个新的文件夹 rdp_classifier_2.2:
$unzip rdp_classifier_2.2.zip
1 | \$ls /mnt/d/win16s/rdp_classifier_2.2/ |
可见此目录下有 rdp_classifier-2.2.jar 等文件。
(3) 下载 RDP Gold 数据库 (rdp_gold.fa)
$wget -c http://drive5.com/uchime/rdp\_gold.fa
15.4.2 分析流程运行命令
(1) 准备测序数据
本实验需要把所有样本的原始测序数据(raw_reads.zip)放在一个文件夹(win16s)。一个样品的双端测序有两个读段文件,这里以“_R1”与“_R2”分别代表正向与反向测序读段(如果文件名与此不一致,需要重新命名)。
1 | \$unzip raw_reads.zip |
显示测序数据文件列表,如 SAA_R1.fastq.gz,SAA_R2.fastq.gz 等六个样本的两端测序数据的压缩文件。测序公司提供的数据一般已去除 barcode 和 primer 序列。下面先处理一个样本的数据,其他样本可用同样步骤进行分析。如果样品数量较多,也可将以下处理命令写到一个 shell 脚本,一次进行多个样品数据分析。
(2)合并双端测序序列
如果样品数量较小,可以对每个样品分别进行合并,一次合并一个样品的两端测序数据:
1 | \$vsearch --fastq_mergepairs raw_reads/SAA_R1.fastq.gz --reverse raw_reads/SAA_R2.fastq.gz --fastqout SAA.merged.fastq |
命令运行后,部分输出信息如下:
1 | # Merging reads 100% |
(3)序列质量控制
一般可先用 FastQC 检查测序读段的质量信息, 注意读段长度。本练习所用测序序列为 16S rRNA v3—v4 区片段大约为 400bp。这里将合并后长度 <380bp 的读段都过滤掉, 并去除所有含有未知碱基的序列。
1 | \$vsearch --fastq_filter SAA.merged.fastq --fastq_maxee 1.0 --fastq_minlen 380 --fastq_maxns 0 --fastaout SAA.filtered.fasta |
命令运行后,部分输出信息如下:
#33624 sequences kept (of which 0 truncated), 7616 sequences discarded.
(4)序列去重复(dereplication)
16S rDNA 测序涉及 PCR 过程产生大量重复,为简化后续分析可以先做序列去重复。注:如将 miniuniqusize 值设成大于 2,可去除低丰度序列,增加计算速度
$vsearch –derep_fulllength SAA.filtered.fasta –sizeout –minuniquesize 2 –output SAA.derep.fasta
命令运行后,部分输出信息如下:
#1371 uniques written, 7560 clusters discarded (84.6%)
(5)嵌合体检测
PCR 过程容易产生嵌合体(chimera),主要是由于 PCR 过程中模版的不完全延伸。一般可通过与参考数据库序列文件(rdp_gold.fa)比对去除嵌合体:
$vsearch –uchime_ref SAA. derep. fasta –db rdp_gold. fa –sizein –sizeout –nonchimeras SAA.nochimeras.fasta
命令运行后,部分输出信息如下:
#Found 138 (10.1%) chimeras, 1212 (88.4%) non-chimeras, and 21 (1.5%) borderline sequence in 1371 unique sequences。
[此步骤可略]如果没有参考序列,VSEARCH也可以通过从头(de novo)方法去除嵌合体:
$vsearch –uchime_denovo SAA.derep.fasta –sizein –sizeout –nonchimeras SAA.
nochimeras.fasta 注意:从头方法的命令运行较以上参考序列方法慢。
(6)OTU 聚类
OTU 是人为给某一个分类单元(科、属、种等)设置的标志。通常按照 97% 的相似性阈值将 16S rRNA 基因序列划分为不同的 OTU,选取最长的序列作为 OTU 的代表,用于在种或属水平的分类鉴定。
$vsearch –cluster_fast SAA.nochimeras.fasta –id 0.97 –centroids SAA.otus.fasta – relabel OTU_ –sizein –sizeout
以序列最小相似度97%聚类,得到121个Clusters,部分输出信息如下:
#Clusters:121 Size min 2,max 6924,avg 10.0
(7)生成 OTU 表格
OTU 聚类后, 将原始测序读段比对回 OTU 序列 (map reads back to the OTU data), 得到每个 OTU 的数量, 生成 OTU 表:
$vsearch –usearch_global SAA.nochimeras.fasta –db SAA.otus.fasta –id 0.97 –otutabout SAA.otutab.txt
命令运行后,部分输出信息如下:
#Matching unique query sequences:1212 of 1212 (100.00%)
Writing OTU table (classic) 100%
(8)物种分类注释
OTU 聚类后, 挑选出每个 OUT 簇中的代表序列(一般为最长的序列), 与 RDP、Sliva 或 GreenGenes 等数据库进行比对, 进行物种注释。这里采用 Ribosomal Database Project classifier 及其默认数据库做 OTU 物种分类注释。
$java - Xmx1g -jar rdp_classifier_2.2 / rdp_classifier-2.2.jar -q SAA.otus.fasta -o SAA_otus_tax.txt -f fixrank
得到将不同 OTU 注释为不同分类水平上的物种信息。SAA_otus_tax.txt 文件中每行为一个 OTU 的在不同分类水平的物种注释信息:
OTU_1; size=2553; - Bacteria domain 1.0 “Firmicutes” phylum 1.0 “Bacilli” class 1.0 “Lactobacillales” order 1.0 \ Streptococcaceae family 1.0 Streptococcus genus 1.0
(9)OTU物种分类数据整理
其他样本重复运行以上的分析命令得到 OTU 表, 然后就可统计所有样本的菌群在门、纲、目、科、属和种各层次上的分类结果(主要看门与属水平)。这里查看属水平上的分类结果。
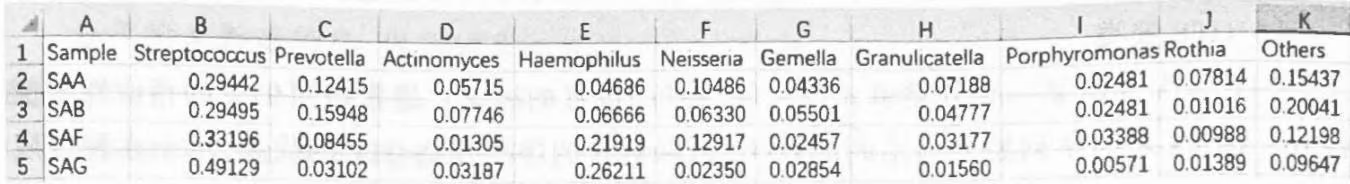
利用WPS或EXCEL打开上一步得到的各个OTU分类注释数据文件(如SAA_otus_tax.txt),整理成文件otus_tax.csv(图15-5),其中行(row)为样品名,列(column)为细菌在属水平的分类(属名)。每个样本只取丰度最高的(前9个)菌属,其他菌属都合并为“Others”。具体数据整理过程扫描书后二维码查看。
(10)菌群丰度可视化
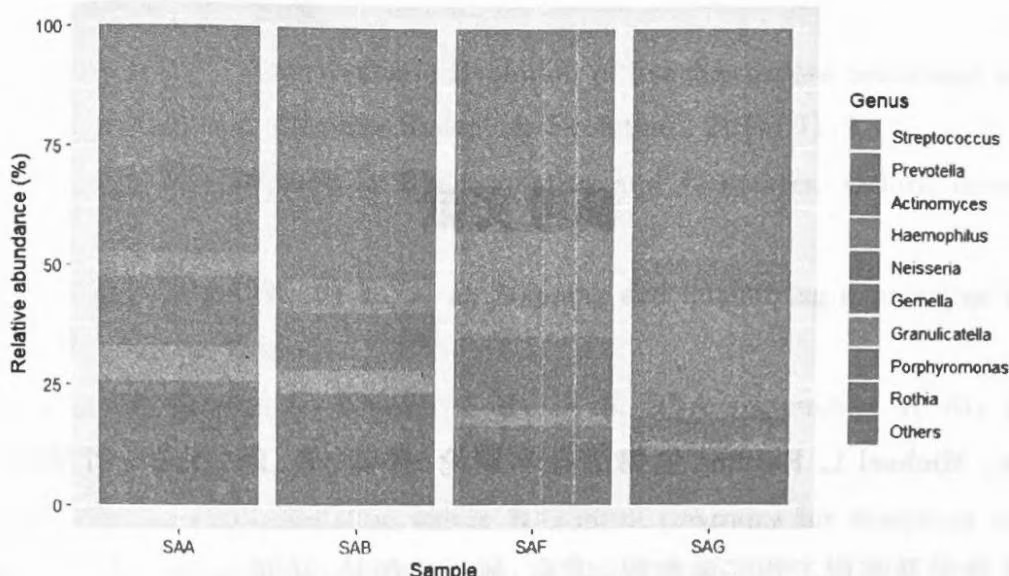
基于在属水平丰度前10的物种,采用累积柱状图进行展示,并比较不同样品间的物种差异。运行R可视化命令前,先将样本文件otus_tax.csv放到目录(D:/win16s)。
1 | #Plot relative abundance for all samples |
在属分类水平的菌株丰度分布如图15-6所示,可见链球菌属(Streptococcus)是样本中丰度最高的菌种。
习题
简述 16S rRNA 与 16S rDNA, 以及 16S rRNA 基因序列可用于微生物鉴定的原因。
利用本章 16S rDNA 测序数据, 通过在线宏基因组分析网站 MG-RAST 进行菌群分析, 并比较与上面分析结果的差异。
参考文献
Dan E. Krane, Michael L. Raymer. 生物信息学概论. 孙啸, 等, 译. 北京: 清华大学出版社, 2004.
刘箭. 分子生物学及基因工程实验教程. 北京: 科学出版社, 2008.
王举, 王兆月, 田心. 生物信息学: 基础及应用. 北京: 清华大学出版社, 2014.
吴祖建,高芳銮,沈建国.生物信息学分析实践.北京:科学出版社,2010.
杨焕明. 基因组学方法. 北京: 科学出版社, 2012.
张新宇, 高燕宁. PCR 引物设计及软件使用技巧. 生物信息学, 2004, 2(4): 15-18.
Andreas M, Francis O. Assessing an effective undergraduate module teaching applied bioinformatics to biology students[J]. Plos Computational Biology, 2018, 14(1): e1005872.
Bankevich A, Nurk S, Antipov D, et al. SPAdes: a new genome assembly algorithm and its applications to single-cell sequencing. Journal of Computational Biology, 2012, 19(5): 455-477.
Bentley D R, Balasubramanian S, Swerdlow H P, et al. Accurate whole human genome sequencing using reversible terminator chemistry. Nature, 2008, 456(7218):53–59.
Carriço J A, Rossi M, Moran-Gilad J, et al. A Primer on Microbial Bioinformatics for non-bioinformaticians. Clinical Microbiology and Infection, 2018:S1198743X17307097.
Clair C, Visick J. Exploring bioinformatics: a project-based approach. second edition. Jones & Bartlett Learning, 2015.
Gauthier J, Vincent A T, Charette SJ, et al. A brief history of bioinformatics. Brief Bioinformatics 2019, 20(6):1981-1996.
Handelsman J, Rondon M R, Brady S F, et al. Molecular biological access to the chemistry of unknown soil microbes: a new frontier for natural products—ScienceDirect. Chemistry & Biology, 1998.
Kelley D R, Schatz M C, Salzberg S L. Quake: quality-aware detection and correction of sequencing errors. Genome Biology, 2010, 11(11): R116. Edwards DJ, and Holt KE. Beginner’s guide to comparative bacterial genome analysis using next-generation sequence data. Microbial Informatics and Experimentation 2013, 3(1): 2.
Knight R, Vrbanac A, Taylor B C, et al. Best practices for analysing microbiomes. Nature
Reviews Microbiology, 2018.
Li Y, Zhang W, Zheng D, et al. Genomic Evolution of Saccharomyces cerevisiae under Chinese Rice Wine Fermentation. Genome Biology & Evolution, 2014(9):9.
Momand J, Mccurdy A. Concepts in Bioinformatics and Genomics. Oxford university press, 2016.
Mortazavi A, Williams B A, Mccue K, et al. Mapping and quantifying mammalian transcriptomes by RNA-Seq. Nature Methods, 2008.
Shendure J, Balasubramanian S, Church G M, et al. DNA sequencing at 40: past, present and future. Nature, 2017, 550(7676):345-353.
Stothard P. The sequence manipulation suite: JavaScript programs for analyzing and formatting protein and DNA sequences. Biotechniques, 2000, 28(6):1102, 1104.
Trapnell C, Roberts A, Goff L, et al. Differential gene and transcript expression analysis of RNA-seq experiments with TopHat and Cufflinks. Nature Protocols, 2012, 7:562–578.
Tsai I J, Otto T D, Berriman M. Improving draft assemblies by iterative mapping and assembly of short reads to eliminate gaps. Genome Biology, 2010, 11(4):1-9.
Wooley J C, Godzik A, Friedberg I, et al. A Primer on Metagenomics. Plos Computational Biology, 2010, 6(2): e1000667.
第7章 蛋白质结构预测
Want of care does more harm than want of knowledge.(缺乏谨慎比缺乏知识更有害)——Benjamin Franklin
众所周知,蛋白质结构决定其功能,因此研究蛋白质结构具有重要意义。本章主要介绍蛋白质结构的组织层次、蛋白质三级结构数据库,以及三维结构的预测方法。最后以实例介绍三维结构的可视化与同源建模方法。
◎ 导学案例
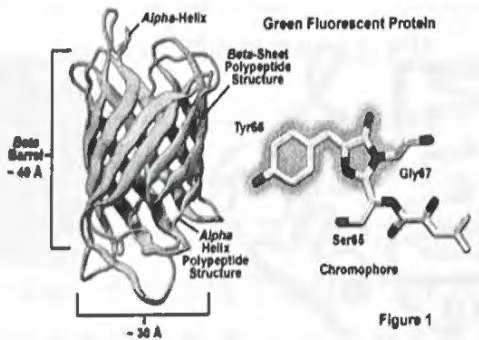
绿色荧光蛋白(green fluorescent protein, GFP)是一类存在于水母、水蛭和珊瑚等腔肠动物体内的生物发光蛋白。它受395nm近紫外光或470nm蓝光激发后,能发出波长为510nm的绿色荧光。GFP的相对分子量为27kDa,由238个氨基酸残基组成,其中65—67位残基(Ser65-Tyr66-Gly67)可自发形成荧光发色基团(chromophore)——对羟基苯咪唑啉酮。GFP蛋白质三级结构为一个柱状体(β-can),由11个围绕中心α螺旋的β折叠链组成,柱状体的顶部由3个短的转折片段覆盖,底部由1个短的转折片段覆盖(图7-1)。荧光发色基团位于“β-can”柱状结构的中央,这种结构可避免荧光团受到水分子的碰撞而失活。
GFP基因来源于Aequoria victoria(多管水母), 可在生物活体内表达绿色荧光蛋白, 检测时不需要外源底物或辅助因子, 具有可以活体观察、灵敏度高、无毒害、结构稳定、作用持久等优点。由于GFP在生命科学研究中的广泛应用, 三位发现并发展了绿色荧光蛋白的科学家——日本科学家Osamu Shimomura(下村修)、美国哥伦比亚大学的Matin Chalfie(查尔菲)以及加州大学圣地亚哥分校的Roger Y.Tsien(钱永健, 钱学森堂侄), 获得了2008年诺贝尔化学奖。
蛋白质是由氨基酸分子呈线性排列组成的,经过折叠形成具有一定空间结构的物质。相邻氨基酸残基的羧基和氨基通过“脱水缩合”方式形成肽键连接在一起。蛋白质必须折叠成特定的空间结构才能发挥其生物学功能,换言之,蛋白质的三维空间结构决定其功能。蛋白质折叠主要通过氢键、离子键、范德华力、二硫键和疏水作用实现。20世纪60年代后期,Anfinsen首先发现去折叠蛋白(变性)的蛋白质,在一定的实验条件下可以重新折叠成它的天然结构(native structure)。大多数蛋白质只有在折叠成其天然结构时才能具有完全的生物活性。
蛋白质的分子结构可划分为四个等级(图7-2),蛋白质的一级结构(primary structure)是蛋白质多肽链中氨基酸残基的排列顺序。一级结构决定了其他高级结构,由于氨基酸具有不同的侧链,当它们按照不同的序列组合时,就可形成多种空间结构的蛋白质分子。蛋白质的二级结构(secondary structure)是指多肽链中主链原子的局部空间构象,主要由分子内氢键形成的结构(图7-2中虚线表示)。
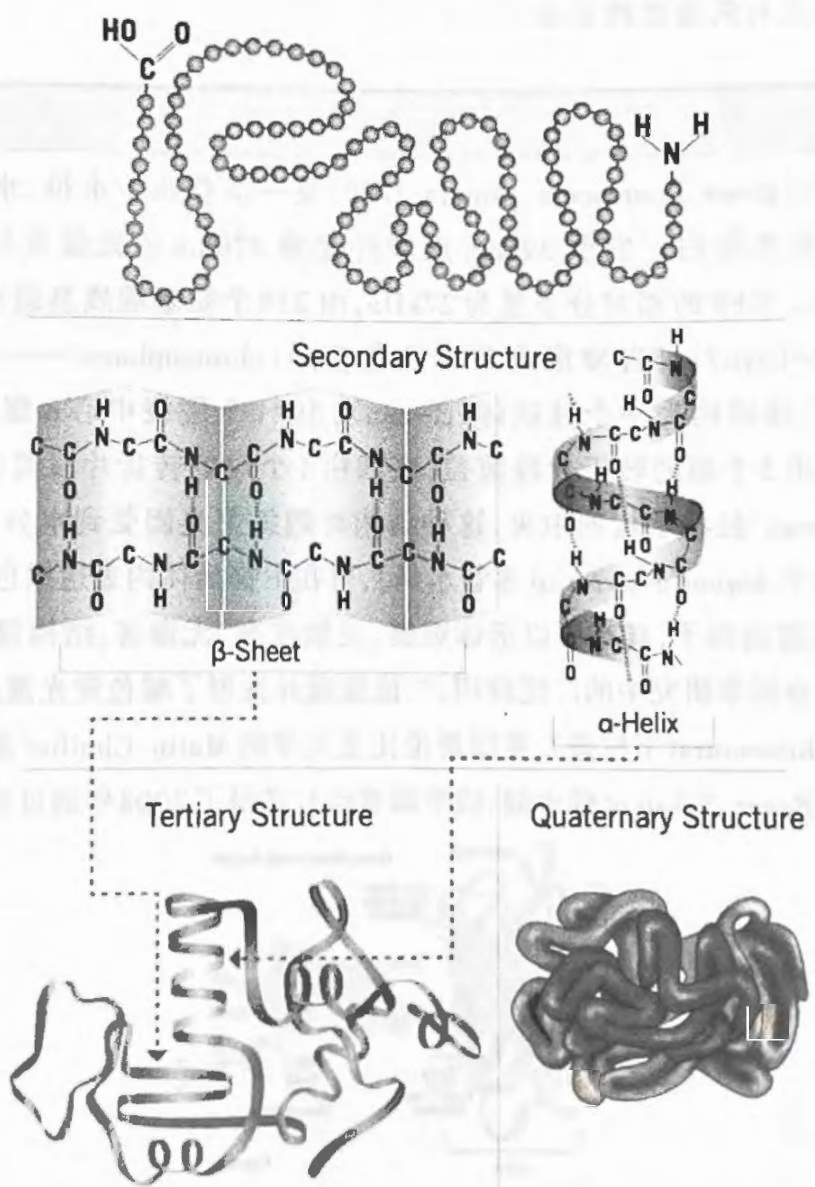
两种最常见的二级结构是 $\alpha$ 螺旋和 $\beta$ 折叠。二级结构是蛋白质翻译后立马就形成的折叠结构。蛋白质二级结构区域聚集在一起并与蛋白质别的非规则结构区域结合形成整体的三维结构,叫作蛋白质的三级结构(tertiary structure)。多肽链经过折叠后,可形成生物学功能的特定区域,如酶活中心等。有些蛋白质是由两条或更多条具有独立三级结构的多肽链组成的复合物,其多肽链间通过次级键相互组合而形成的空间结构称为四级结构(quaternary structure)。其中,每个具有独立三级结构的多肽链单位称为亚基。
现代生物学中,了解蛋白质的三维结构对理解蛋白质的功能和生物活性机理有非常重要的意义。例如,在药物设计中,大多数药物的作用靶点都是蛋白质(酶),获取精确的蛋白质三维空间结构是通过研究药物和靶标之间的相互作用来进行药物设计的基础。从Anfin-sen提出蛋白质折叠的信息隐含在蛋白质的一级结构中开始,科学家们就对蛋白质结构的预测进行了大量的研究,开发了许多能直接从氨基酸序列预测蛋白质结构的预测算法。
7.1 蛋白质三维结构的确定方法
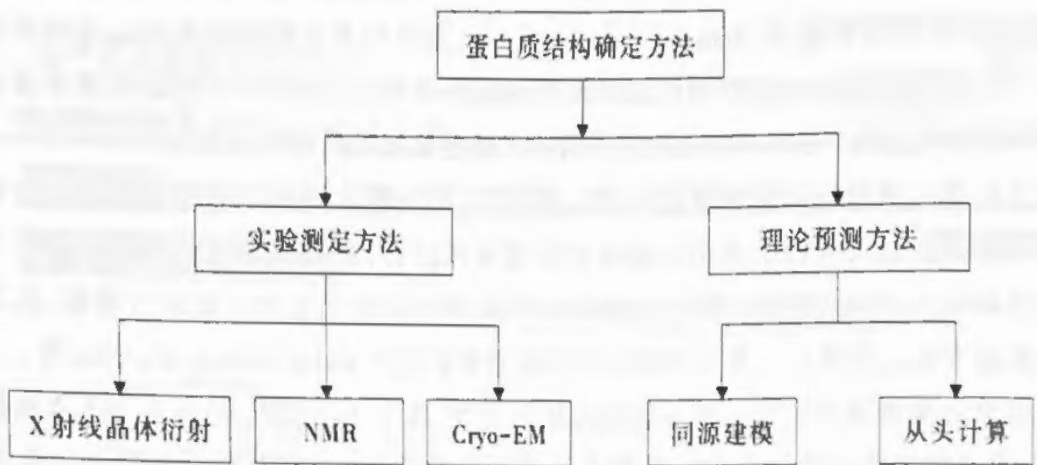
不同的蛋白质拥有不同的氨基酸序列,所有蛋白质都必须在其氨基酸序列的基础上折叠形成特定的三维结构,才能够进一步发挥其生物学功能。随着蛋白质结构测定技术的发展,许多蛋白质的结构已经被解析。蛋白质结构生物学研究蛋白质的三维结构及其生物学功能的关系。目前蛋白质三维结构确定方法可以分成实验测定方法与理论预测方法两大类(图7-3)。
7.1.1 实验测定方法
迄今为止,蛋白质结构的实验测定方法主要有X射线衍射(X-ray diffraction)、核磁共振(nuclear magnetic resonance, NMR)和冷冻电子显微镜技术(Cryo-EM)。X射线衍射法是最早用于蛋白质晶体的结构数据解析的方法之一,也是最主要的蛋白质结构测定方法。X射线衍射法利用X射线的衍射特性,对蛋白质结晶进行衍射分析,分析衍射图谱,得到蛋白质的结构信息。但有些蛋白质不易形成晶体,而且X-ray方法不能解析结构非常大的分子。
核磁共振法利用原子核的自旋(spin)特性和外加磁场来获得蛋白质中原子所发出的特殊电磁辐射,再将这些结果进行分析得到蛋白质的结构信息。NMR可用于测定溶液状态的蛋白质三维结构,是对X射线衍射技术的有力补充,但只能测定小的蛋白质(分子量小于 5\times10^{4}Da )。
冷冻电子显微镜技术通过高压快速用液氮冷冻样品,使大分子在接近生理环境的玻璃态冰中固定,从而保持其天然结构。快速冷冻技术可以捕捉到某个反应过程的中间状态,可以用于大分子复合结构及生物学功能的动态研究。冷冻电子显微镜技术可用于解析很多结构非常大的蛋白质(或蛋白质复合体),但该方法目前的分辨率不高。
7.1.2 结构预测方法
目前,通过实验方法获得蛋白质氨基酸序列要比获得其结构数据简单得多。一般认为蛋白质的三级结构是由它的一级结构决定的,因此从氨基酸序列出发预测蛋白质的三维结构是目前生物信息学领域最具有挑战性的研究方向之一。目前国际上每年都会举办一项专门对各种预测方法效果进行评估的国际竞赛活动——蛋白质结构预测评估 CASP(Critical Assessment of Protein Structure Prediction)活动,并已成为评估预测方法的金标准。
由于相似的蛋白质序列往往拥有相似的三维结构,实际上,在进化过程中,蛋白质的三级结构要比一级结构保守得多,也就是说如果两个蛋白质的氨基酸序列是相似的,那么它们的三级结构也应该是相似的。甚至两个蛋白质的氨基酸序列不太相似,它们的三级结构也可能是类似的。基于这个原理,可以通过与相似蛋白的结构进行比较来预测目标蛋白的结构,这种方法称为同源建模(homologous modeling),是迄今为止精度最高的一类结构预测方法。但同源建模依赖目标序列和已知结构蛋白的序列相似度强弱,一般认为两个蛋白质的序列至少要具有25%~30%的相似度,它们才可折叠成相似的空间结构。
对目标蛋白质进行同源建模的一般过程如下:首先要从蛋白质结构数据库中搜索一个或一组与待测蛋白质同源的并由实验测定的蛋白质结构;再将未知蛋白质与已知结构蛋白质进行序列比对,找出结构保守的主链结构片段,并对结构变化的区域进行建模;然后利用能量计算的方法进化优化。常用的蛋白质同源建模软件有 Swiss-Model, Modeller 等。
蛋白质结构预测的另外一种方法称为从头预测(ab initio)方法,这种方法不依赖任何已知结构,通过构建蛋白质折叠力场和构象搜索算法搜寻目标蛋白质的天然结构。从头预测蛋白质结构的理论依据是Anfinsen提出的蛋白质天然构象对应其自由能最低的结构这一热力学假说。然而该类方法日前还面临着诸多困难与挑战,在实际实用中,从头预测方法几乎都会在不同程度上使用已知的蛋白质结构信息。常用的蛋白质结构从头预测软件有Rosetta,QUARK等。
7.2 蛋白质三维结构数据库
一般在实验室测定蛋白质的结构后,会将数据存储于公共数据库,方便其他人查询使用。蛋白质结构数据库(Protein Data Bank, PDB)是目前最主要的收集生物大分子(包括蛋白质、核酸和糖)结构的数据库。它最初是在1971年由美国Brookhaven实验室创建,后又改由美国结构生物合作研究协会(RCSB)管理。PDB数据库中每个蛋白质或核酸都有一个PDB ID编号,是其在数据库中的唯一标识。一般在论文中需要引用某一个蛋白质结构时,就要用它的PDB ID编号。
7.2.1 PDB数据库检索
在 RCSB PDB 网站(www.rcsb.org)首页的顶部有个检索框,只要在输入框中输入查询关键词,点击 GO 按钮就会显示检索结果。PDB 数据库可检索的字段包括 PDB ID、作者、生物大分子名称与配体(ligand)等,并可使用布尔逻辑(AND,OR 和 NOT)组合进行检索。例如,用关键词“HIV-1 protease”对 HIV-1 蛋白酶的 PDB 进行搜索将返回大量结果(注意 HIV-1 是 HIV 的专有名,将返回最佳搜索结果),大部分结果是蛋白质与各种抑制剂结合的不同形式。如果只希望看到蛋白酶与天然底物相互作用,可搜索一个特定 PDB ID(“1KJF”),只查看使用肽作为底物的结构(图 7-4)。
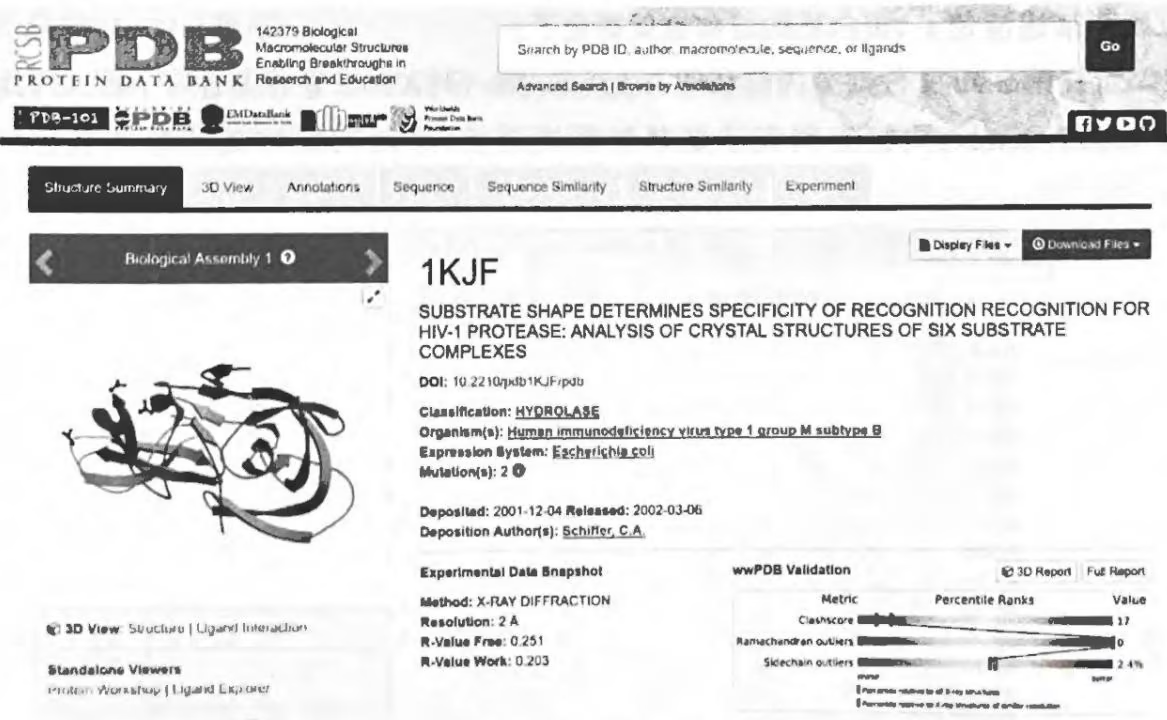
在结果页面中可以看到蛋白质结构的分类(classification),发布时间(released),测定方
法(method),分辨率(resolution)等。分辨率可说明蛋白质结构的质量,通常数值越低越好(<2Å)。在结果页面的左侧3D View,你可以看到蛋白质结构的三维图(可以旋转和绽放)。在结果页面的右侧的“Download Files”按钮可以下载文件,使用“Display Files”下拉菜单查看实际存储在PDB数据库中的多种格式文件内容。
7.2.2 PDB数据格式
蛋白质3D结构数据通常以两种特定格式的文本文件存储在PDB数据库。PDB格式文件是其标准的文件格式(文件后缀为.pdb),可以通过各种软件读取,以便结构可视化和其他处理。用文本编辑器(Notepad2)打开前面已经下载的PDB文件,或在检索结果页中使用“Display Files”下拉菜单查看实际存储在PDB数据库中的PDB格式文件内容。另一种晶体结构储存格式为mmCIF(大分子晶体结构信息文件)格式。与PDB格式相比,该格式提供了更为灵活和丰富的表现形式,但目前PDB格式文件仍是最常用的蛋白质3D结构数据存储格式。
PDB 文件就是一个文本文件,由许多行组成,每行 80 列,每行的前 6 列都是一个固定的标识符,左对齐,用空格补全 6 列。除了原子坐标信息(ATOM 开头的行),PDB 文件在文件前面部分还包括蛋白质结构相应的注释信息,如每条多肽链的氨基酸序列(SEQRES)、二级结构(HELIX,SHEET 等)的位置、注释(REMARK)和参考文献(JRNL)等。
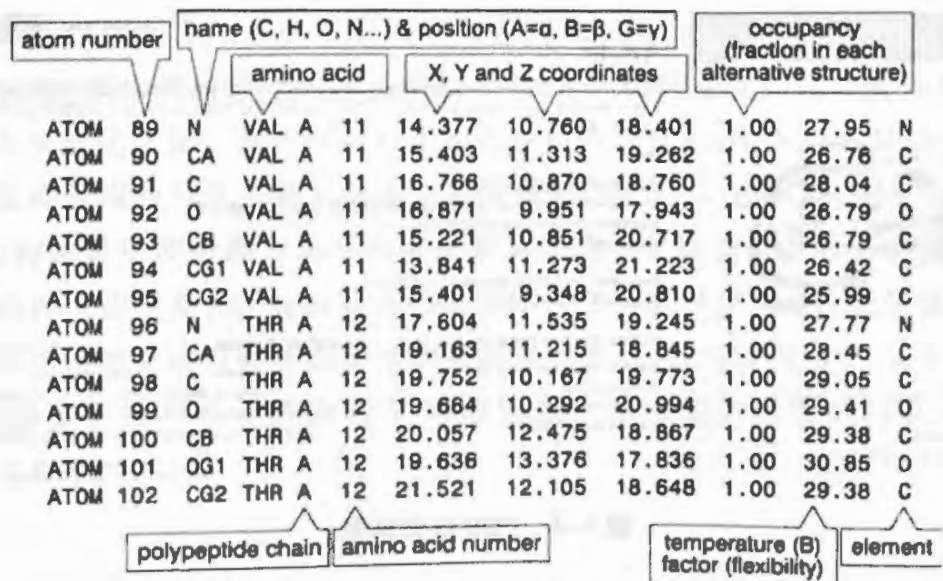
PDB文件的核心是一个原子列表和它们所属的氨基酸,以及描述它们空间位置的坐标(图7-5)。蛋白质分子由很多原子组成,可以把每一个原子看成一个点,可以通过空间坐标系中的XYZ三个坐标数字(单位为埃,0.1nm)确定一个点在空间的位置。如果把每个原子的空间位置都描述清楚了,蛋白质的结构也就确定了。
HIV 蛋白酶 PDB 文件部分内容如图 7-5 所示: 第一列 ATOM 意思是原子; 第二列代表原子序号 (atom number); 第三列表示氨基酸中的原子; 第四列表示氨基酸的名称 (aminoacid); 第五列表示氨基酸所在的肽链(A链); 第六列表示氨基酸所在肽链的序号; 第七、八、九列表示氨基酸在肽链空间结构的三维坐标(X, Y and Z coordinates); 第十列为占有率(occupancy)表示原子在位置上的“牢固”程度, 一般在0与1之间, 1表示完全稳固, 占有率小于1表示该原子可能到其他位置; 第十一列为温度因子(temperature factor)或B因子表示原子静态或动态灵活性; 第十二列也是表示氨基酸中的原子类型。
7.3 蛋白质三维结构可视化
虽然 PDB 格式文件适用于分子模拟和计算机辅助药物设计等的计算,但不适合科研人员整体观察蛋白质的三维结构。蛋白质结构可视化能够清晰地显示结构信息,有利于从原子间相互作用的层次理解生命活动过程。目前有许多程序可以基于 PDB 文件产生交互式的三维可视化,常用的软件有 RasMol、Chimer、PyMol、Swiss PDBViewer 等。蛋白质结构可视化软件主要任务是处理结构数据文件中分子坐标数据,显示其三维结构的立体图像。尽管图像的显示是二维的,但通过一些光影效果(如不同方向的光线照射、物体的阴影或材质等)可以在平面上产生立体效果。
7.3.1 利用RasMol查看蛋白质三维结构
RasMol是在Windows系统下直观可视化生物大分子3D结构的软件,提供多个模式效果图、旋转缩放功能及命令行操作功能,并可以存成普通图形文件。
(1) 获得 RasMol 程序
RasMol 是开源软件, 可以在其官方因此免费下载。下载最新的 Windows 版本 RasWin2.7.5。并以默认参数安装 RasMol 程序后(图 7-6), 运行 RasMol 程序。
(2)获得蛋白质结构数据文件
①打开网页,进入 RCSB PDB 数据库。
②在搜索框中输入GFP的PDB ID(1EMA),查寻所需蛋白GFP的PDB文件。
③在搜索结果网页中,单击列表中的下载(download files)图标,选择“PDB format”下载文件(1ema.pdb)到电脑本地文件夹。
(3)RasMol使用
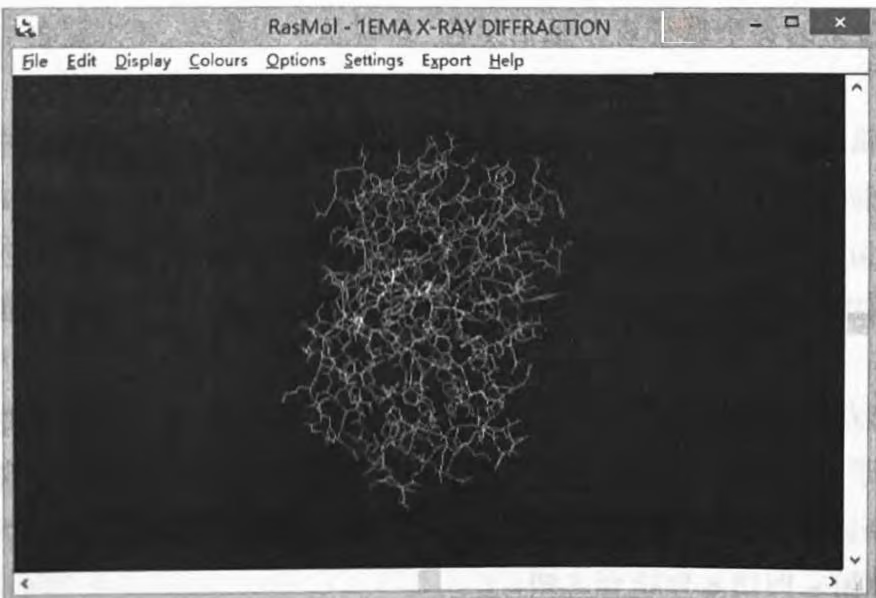
①打开 PDB 文件: 菜单 File→Open→选择“1ema.pdb”文件。打开后, 可以看到蛋白 GFP 的分子结构以“线框模型(wireframe)”显示图像。
在 RasMol 中已经打开一个 PDB 文档的情况下,要想打开另一个文件,必须先关闭前一个(点击 File→Close)。否则,新打开的分子结构会与前一个分子结构叠加显示,不便于观察与分析。
②点击菜单 file→Information, 可以看到此蛋白质的一些基本信息。
③图形窗口中鼠标操作
- 先点击蛋白质,按住鼠标左键拖动,分子绕中心旋转;
- 按住鼠标右键拖动, 分子在 $X - Y$ 平面内平移。向左向右拖动光标, 或向上向下拖动光标。
- 按住“Shift”键,鼠标左键拖动向上、向下移动,从而放大或缩小图像。
- 按住“Shift”键,鼠标右键拖动向左、向右移动,使图像以分子中心为中心在平面内顺时针、逆时针旋转。
- 按住“Ctrl”键,鼠标左键拖动向上使Z平面向远离视线方向移动,并显示Z平面以内的结构,下移向靠近视线方向移动。
④Display菜单可以直接完成生物大分子相关模型的显示与分析,点击菜单“Display”,并分别选择每个子菜单,察看显示效果。
点击 Display→Spacefill, 然后点击“Colours”菜单选择不同颜色模式:
- CPK: 蛋白质的每个原子有单独的颜色, 如碳原子为灰色, 氮为蓝色, 氧为红色, 硫为黄色。
- Shapely: 每个氨基酸都有一种颜色。
- Chain: 不同颜色显示多肽链, 可清晰反映蛋白质亚基或 DNA 双链结构。
- Temperature: 表示不同原子在分子中的热运动性(即位置的准确性), 该数值包含在 PDB 文件的一列中。红色代表原子易于振动, 而绿色与蓝色代表原子位置更加稳定不易于振动。
⑤“Options”菜单的功能是调整显示选项,点击“Options”的各个子菜单选中或取消。如Hydrogens(H原子)与Hetero atoms(异原子,非蛋白质链上的原子或分子配体)显示与否,选中状态表示命令操作时有效。最后点击“Labels”,Labels(标记)可在显示立体分子的同时,将各原子或片段相应的信息标注在上面。
X射线衍射法一般测不到H原子,所以PDB文件中没有H原子信息,H原子一般是显示
软件根据结构化学原理加入的。
⑥点击“Export”菜单,可以把图像存为BMP,GIF等格式文件,用于WORD、PPT文档等。
⑦RasMol命令行窗口的使用,在Windows任务栏中选择命令行窗口(图7-7)。
一些常用命令:
- select Lys: 选定分子中所有赖氨酸。
- select all: 选择所有的原子。
- select protein: 选择蛋白质原子。
- select hetero: 选择非蛋白质, 非 DNA 原子。
- restrict protein: 在图形窗口中去除所有的非蛋白质原子。
- restrict lys: 在图形窗口中去除所有的非 Lys 残基。
在多亚基的分子聚合物中,需要指明所选分子的链。分子链一般用大写字母或数字表示,并用一个冒号与残基符号分隔,如“Lys70:A”或“Lys70:1”。
⑧输入命令“select ligand”,回车后可以看到54个原子被选择。你可以通过输入“space-fill”显示这些原子,也可以通过Display→Spacefill显示。(注:Ligands可能是任何可以与蛋白质特异性结合的分子或离子。)
⑨放大显示选择的原子,将光标放到任意一个灰色的原子上。鼠标单击此原子,可以在命令窗口看到如下信息:
Atom: CE 582 Hetero: MSE 78 Chain: A(说明你点击的原子为第5个碳原子, 在MSE分子上)
⑩输入“color red”回车,可以看到选择的原子颜色变成红色了,后输入“color cpk”回车恢复。
⑪ 再输入“select protein”回车。点击 Display→Ball and Stick。点击 Colour→Shapely。
此时你看到 Ball and Stick 的蛋白质包含一个 spacefill 的 MSE 与 CRO 分子。
⑫点击 Export→PICT, 文件存为“Ligand.pict”。
⑬放大图像,直到MSE/CRO分子为窗口的1/4大小。鼠标点击任何一个接近MSE分子的氨基酸,可以在命令窗口看到氨基酸的信息。
⑭请查看接近 MSE 的所有氨基酸, 点击 Display→Cartoon, 此时可以看到组成蛋白质的氨基酸链。
⑮输入“select all”回车,及“select solvent”回车,可以看到溶剂分子,溶剂分子是蛋白质做晶体时的一部分。
⑯再试试下面的命令:
- select polar: 选择极性的氨基酸;
- select hydrophobic: 选择疏水氨基酸;
- select charged: 选择带电的氨基酸;
- select buried: 选择包埋的氨基酸;
- select neutral: 选择中性的氨基酸。
通过以上操作可以看出,利用“命令窗口”与“窗口菜单”都可以完成相关操作,但对“原子、残基或基团的选择”操作通过命令行窗口更方便,操作时注意切换使用。
7.4 蛋白质三维结构的同源建模
同源建模(homology modeling)是目前基于氨基酸序列预测蛋白质三维(3D)结构的最有效方法。建立一个成功的模型需要至少有一个已经通过实验测定3D结构的蛋白质(称为“模板”, 即 template), 而且该蛋白的氨基酸序列应与目标序列(target sequence)要有显著的相似性。一般认为当两个蛋白质的序列相似度高于 $35%$ 时, 它们的三维结构基本相同; 序列相似度低于 $30%$ 的蛋白质难以得到理想的结构模型。以模板作为骨架(scaffold)基础, 对目标序列进行建模, 其步骤是: 选择模板, 目标与模板的联配, 建立模型, 模型评估, 对模型进行重复优化, 直到得到一个满意的模型为止。
7.4.1 利用SWISS-MODEL进行同源建模
以下以同源建模网络服务器SWISS-MODEL为例,介绍同源建模的基本方法:
(1)SWISS-MODEL以通过ExPASy服务器的web界面访问。
(2)点击“Starting Modelling”按钮,进入该服务器的工作界面(图7-8),服务器会完全自动地为目标序列建立模型。
(3)在页面的“Target Sequence”框中输入斑马鱼Danio rerio(zebrafish)的胰岛素UniProt Accession number:O73727,或直接粘贴其蛋白质序列(可从UniProt数据库获得):
1 | > \text { sp } | O 7 3 7 2 7 | I N S _ {-} D A N R E \text { Insulin OS } = \text { Danio rerio GN } = \text { ins PE } = 2 \text { SV } = 1 |
MAVWLQAGALLVLLVVSSVSTNPGTPQHLCGSHLVDALYLVCGPTGFFYNPKRDVEPLLGLFLPPKSAQETEVADFAFKDHAELIRKRGIVEQCCHKPCSIFELQNYCN
输入序列后,页面将目标序列(target)的氨基酸序列从N端到C端以渐变颜色条显示。(4)提交前可以输入其他信息,如邮箱地址与项目名称(project title),用鼠标点击“Build Model”按钮,提交服务器进行自动建模。
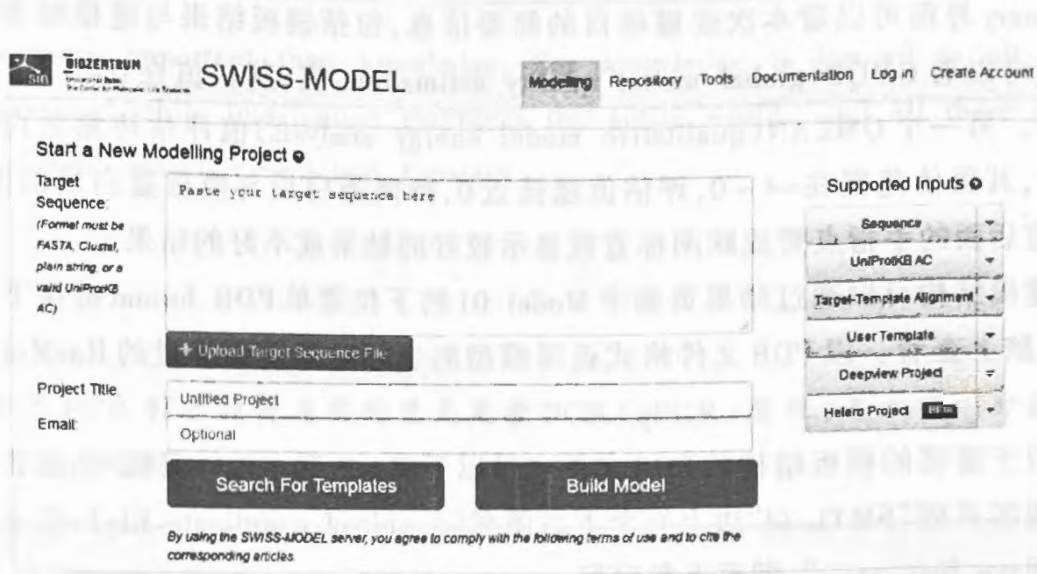
(5)如果想自己选择模板,可以点击工作界面的“Search for Template”,在返回的结果中选择合适的蛋白质作为模板,后点击右上角的“Build Models”。
(6) 同源建模完成后, SWISS-MODE 返回结果页面(图 7-9), 或通过电子邮件返回一份日志文件。
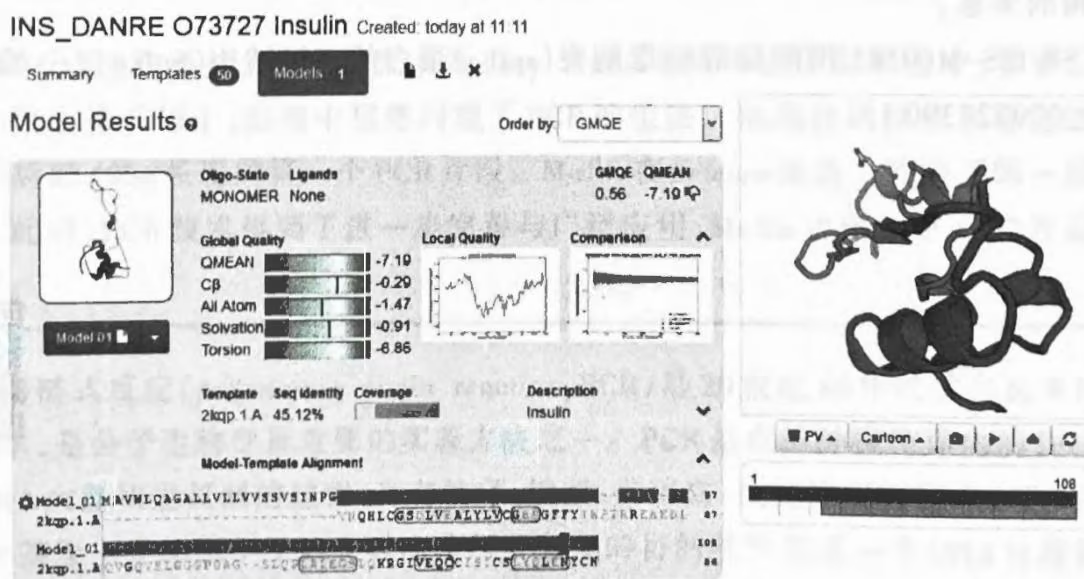
默认显示的是Models界面,建模结果包括预测的蛋白质模型的坐标、模板比对,以及模型的评价等。本例INS_DANRE蛋白是基于模板2kqp.1的A链建模的,两个序列相似度达到 $45.12%$ 。右边显示的肽段三维结构,可以旋转,放大任意位置,而且与左边的氨基酸序列是一一对应。鼠标点左下“Model-Template Alignment”的任意氨基酸,可以看到其对应的三维结构情况。点击旁边的模板(Templates)界面,可以查看数据库中已经保存的3D结构信息,及本次建模所用是哪一个模板。
Summary 界面可以看本次建模项目的简要信息,包括模板结果与建模结果。简单评价建模好坏可以看 GMQE(global model quality estimation) 值,其估值在 0~1,越接近 1,建模质量越好。另一个 QMEAN(qualitative model energy analysis) 值评估待测蛋白与模板蛋白的匹配度,其置信范围在 -4~0,评估值越接近 0,待测蛋白质与模板蛋白质的匹配度越高。QMEAN 值后面的手指点赞或踩图标直观显示较好的结果或不好的结果。
(7)建模结构可以通过结果页面中Model 01的下拉菜单PDB format链接下载PDB文件到本地电脑上查看。以PDB文件格式返回模型的坐标可用前面学过的RasMol工具查看其三维结构。
(8)用于建模的模板结构的PDB文件也可以下载pdb到本地计算机中:点击2kqp.1.A链接,在出现的页面”SMTL id”边上有个下载图标(download coordinate file),在上面按鼠标右键,再选”Save link as…”,即可下载保存。
最后要说明的是,以相同的序列采用不同的模板、建模算法或动力学优化方法都会得出不同的结果。因此,预测的结构是否真实,还需要用实验的方法进一步验证。
习题
在最新版的PDB中如何检索蛋白质三维结构和其他相关信息?
请用 RasMol 软件观察 HIV 蛋白酶的分子三维结构, 并与所学知识印证, 从而说明其功能与结构的关系。
用SWISS-MODEL预测新冠病毒刺突(spike)蛋白的三级结构(Spike蛋白的NCBI索引号为YP_009724390.1)。
第8章 PCR引物设计(PCR Primer Design)
Imagination is more important than knowledge. For knowledge is limited to all we now know and understand, while imagination embraces the entire world, and all there ever will be to know and understand…—Albert Einstein
本章简介了 PCR 引物设计与实时荧光定量 PCR(qPCR)原理,并以实例介绍 Primer Premier5 软件设计引物的方法。
◎ 导学案例
MIT生化系的Har Gobind Khorana教授根据DNA复制的原理,最早提出核酸体外扩增的设想:经DNA变性,与合适的引物杂交,用DNA聚合酶延伸引物,并不断重复该过程便可合成tRNA基因。但由于当时基因序列分析方法尚未成熟,热稳定DNA聚合酶尚未报道及引物合成的困难,这种想法似乎没有实际意义,Khorana的设想也被人们遗忘了。
中国台湾学者钱嘉韵从美国黄石公园温泉分离出的一株嗜热菌(Thermus aquaticus YT-1)中获得耐高温的DNA聚合酶(Taq酶),解决了体外扩增DNA时,高温对酶活性的影响问题。
美国 Cetus 生物科技公司的研究人员 Kary Mullis 在开车去度假的途中, 看着公路两侧驶过的公路边缘及树干, 脑海中猛然闪现了 PCR 的想法。他用放射性核素标记法看到了 10 个循环后的 49bp 长度的第一个 PCR 片段。Mullis 在 Science 杂志上发表了第一篇 PCR 学术论文。此后, PCR 技术得到了进一步完善与广泛应用, Mullis 也因此于 1993 年获得诺贝尔化学奖。
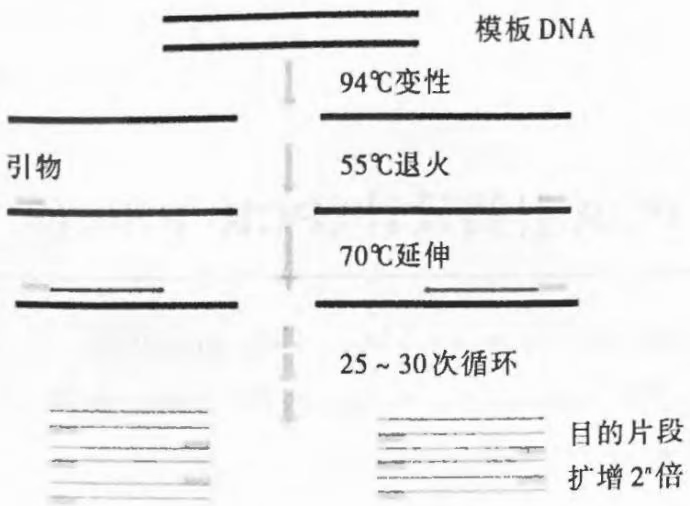
聚合酶链式反应(polymerase chain reaction, PCR)是20世纪80年代发展起来的体外核酸扩增技术,是分子生物学最重要的实验方法之一。PCR是在体外模仿体内的DNA复制条件进行DNA大量快速复制的过程,具有特异、敏感、产率高、快速简便等优点;可以从一根毛发、一滴血甚至一个细胞中于数小时内将所要研究的目的基因或某一个DNA片段扩增至十万乃至百万倍,获得足量的DNA供分析研究。PCR基本是以特定的靶DNA片段为模板,以基因片段特异性的引物为延伸起点,在耐热DNA聚合酶催化下,通过反复的高温变性、低温退火、中温引物延伸等步骤,快速特异地复制出特异目的DNA片段的过程(图8-1)。每次新合成的 DNA 片段都和母链一样可以作为下一次热循环过程中 DNA 复制的模板, 因此可以实现对特定核苷酸片段的指数级扩增。
PCR引物设计是PCR实验成功的前提,引物不仅起到引导DNA的复制起始的作用,限定了PCR的扩增区域和产物片段的大小,而且决定了PCR扩增的特异性。即PCR中DNA的合成过程均以两个引物特异结合处为起点,产物(product)为一对引物之间的DNA片段(包括引物序列)。PCR引物设计是利用计算机软件,根据输入的引物设计参数(如扩增区域、PCR产物长度、退火温度、引物GC含量等),测算出全部的候选引物,然后对每一对引物可能出现的自身发夹结构、引物间的错配、引物和模板间的错配等进行量化评分,在综合全部因素后,软件给出最佳的一对引物组合,从而有效地从模板DNA序列中扩增出目的片段。
8.1 引物设计原则
PCR 引物设计一般遵循 3 条基本原则: ①引物与模板的序列要严格互补; ②引物自身、引物与引物之间避免形成稳定的二聚体或发夹结构; ③引物不能错配在模板的非目标位点引发“非特异性”扩增。
要实现这3条原则,需要考虑如下诸多因素:
(1) 引物的长度
寡核苷酸(oligonucleotide)引物长度通常为15~25bp。因为过长会导致其延伸温度大于74℃,不适于DNA聚合酶(Taq酶)反应,而且较短的引物在靶点序列结合的效率较高。
(2)引物的 $T_{m}$ 值(解链温度)
引物的 $T_{m}$ 值一般控制在55~70℃,通常退火温度要设为比引物对中 $T_{m}$ 值比较低的引物 $T_{m}$ 值低5℃左右,但至少为45~50℃。上下游引物 $T_{m}$ 值尽量相似(差距最好不超过2℃)。引物的 $T_{m}$ 值受引物长度与GC含量影响。若引物中的G+C含量偏低,则可以使引物长度稍长,而保证一定的退火温度。
熔解温度(melting temperat, $T_{m}$ )是引物不再与模板DNA形成稳定碱基配对的温度。确切地说,如果温度正好在 $T_{m}$ ,50%的引物分子应该是不配对的。在理想状态下,退火要足够低,以保证引物和目标序列有效退火(annealing);同时还要足够高,以减少非特异性碱基对结合(non-specific base-pairing interactions)。
$T_{m}$ 值的估算有多种方法,精确估算需要考虑溶液的盐浓度及相邻碱基的配对等情况。粗略估算 $T_{m}$ 值可用公式: $T_{m}=4(G+C)+2(A+T)$ ,即每个AT配对视为2℃,而GC配对视为4℃。
(3)引物的GC含量
有效引物中 GC 含量通常为 40% ~ 60%,一对引物的 GC 含量尽量接近。如 GC 含量太高,可在 5’ 端加上一些 A 或 T,反之则加 G 或 C。
(4)引物的碱基分布
引物中四种碱基的分布最好是随机的,不存在聚嘌呤和聚嘧啶(如ACCCC或ATATAT),尤其在引物的3’端不应超过3个连续的G或C,此情况会使错误引发概率增加。引物3’端尽量不是A碱基结尾,因为错配概率A>G,C>T。
(5)引物的互补情况
引物自身不存在连续4个碱基以上的互补序列,如回文结构,发夹结构等(图8-2(A)),否则会影响到引物与模板之间的复性结合,尤其避免在3’端存在二级结构或发夹结构(图8-2(B));两条引物之间尤其是3’端应避免连续4个碱基互补,以防出现二聚体(图8-2(C)),减少PCR产物产量。
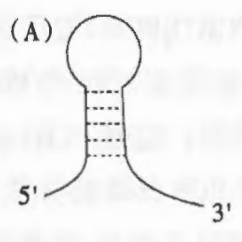
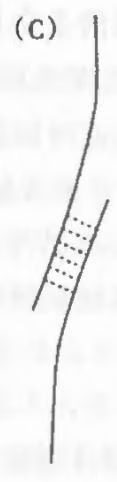
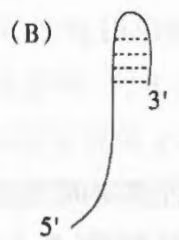
(A) 引物自身碱基配对形成发夹结构;(B) 引物 3’ 端存在二级结构;
(C)引物之间碱基配对形成二聚体
另外,设计引物之前,必须分析靶序列的性质,选择高度保守、碱基分布均匀的区域进行引物设计。如果是RT-PCR,为避免基因组的扩增,引物设计最好能跨两个外显子,片段长度以100~250bp为宜。
8.2 实时荧光定 ■ PCR 技术的原理与方法
实时荧光定量 PCR(real time fluorescence quantitative PCR, RT-FQ-PCR)是一种将 PCR 扩增和扩增产物的检测有机结合在一起的分子生物学技术。它是在 PCR 反应体系中加入能够指示 DNA 片段扩增过程的荧光染料或荧光标记的特异性探针,通过对 PCR 过程中产生的荧光信号进行检测记录,实时监测整个 PCR 进程(图 8-3),再结合相应的计算方法对所获得的荧光信号数据进行分析,计算待测样品中特定 DNA 片段的初始浓度。
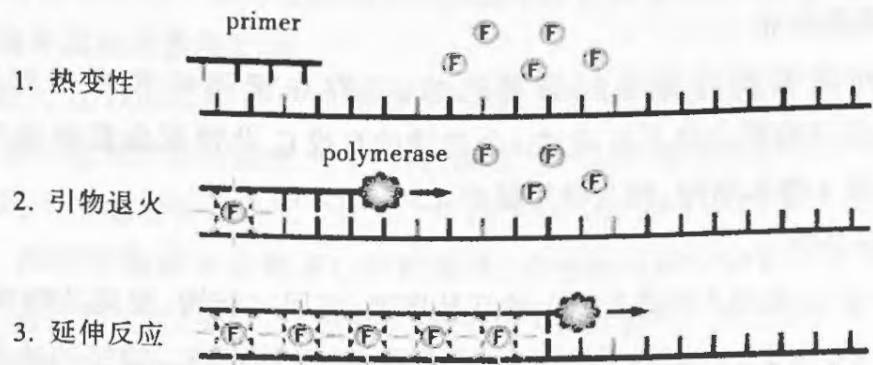
实时荧光定量 PCR 与普通 PCR 的不同之处在于它可以对基因拷贝数做到实时定量。一般实时荧光定量 PCR 技术指的是定量 PCR(qPCR) 与反转录 PCR(RT-PCR) 的组合,需先将 mRNA 反转录为 cDNA,后再作为模板进行实时荧光 PCR 分析实现定量。反转录 PCR(RT-PCR) 只是定性检测,不能进行定量检测。定量 PCR(qPCR) 也可用基因组 DNA 作为模板进行实时荧光定量 PCR 分析。荧光定量 PCR 具有特异性强、灵敏度高、重复性好、定量准确、全封闭反应、无污染等优点,现已在基础科学研究、转基因食品安全检测、医学诊断、药物研发、海关检验检疫等科研和实践领域得到广泛应用。
8.2.1 qPCR方法
近十几年来,研究人员提出并详细阐述了许多实时荧光定量PCR方法,主要是两类,一类是DNA染料法,只简单反映PCR体系中总的核酸量,是一种非特异性的检测方法;另一类是DNA探针法,将荧光素与寡聚核苷酸相连,对特异性的PCR产物进行检测。我们主要介绍第一类DNA染料法,其中最常用的是SYBR Green I,这种DNA染料吸收蓝光( $\lambda_{max}=497nm$ ),发射绿光( $\lambda_{max}=520nm$ ),对DNA双链具有高亲和力。荧光染料法简单易行,但由于荧光染料可以与任何双链DNA结合,对双链DNA没有选择性,不能区分特异性扩增和非特
异性扩增,适用于定量精度要求不高的研究。
8.2.2 qPCR扩增曲线
实时荧光定量PCR技术系在PCR反应体系中加入荧光报告基团,随着PCR反应的进行,扩增产物不断积累,导致荧光信号不断积累;同时,每经过一个热循环,定量PCR仪收集一次荧光信号,从而利用荧光信号的变化实时监测整个PCR进程,最终得到荧光强度随PCR循环数的变化曲线(图8-4)。理论上,PCR的扩增呈指数增长,在反应体系和条件完全一致的情况下,样本DNA含量与扩增产物的对数成正比,其荧光量与扩增产物量亦成正比,因此通过荧光量的检测就可以测定样本核酸量。最后根据标准曲线对未知浓度的起始DNA模板进行精确定量。
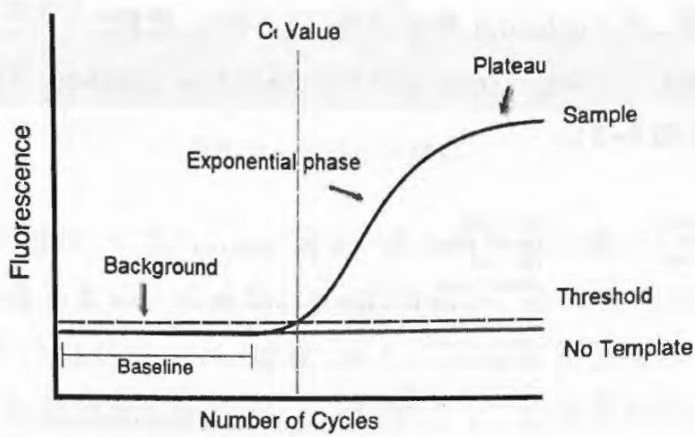
实时荧光定量PCR的扩增曲线可分为荧光背景信号、荧光信号指数扩增和荧光信号平台期3个部分。在荧光背景信号部分,PCR扩增产生的荧光信号较弱,被背景荧光信号所掩盖,无法判断产物量的变化;到达平台期后,扩增信号达到稳定,不再增加,PCR产物量与起始模板之间没有线性关系;在荧光信号指数扩增阶段,PCR扩增的产物量与起始DNA模板数呈线性关系,可以用PCR终产物的量就计算出起始模板的量。为了便于比较分析,此处引入3个基本概念(图8-4):荧光基线(baseline)、荧光阈值(threshold)和阈值循环数(threshold cycle, Ct)。基线是指PCR循环开始时,虽然荧光信号累积,但仍在仪器可检测的灵敏度下。基线通常是3~15个循环的荧光信号,即扩增曲线前面的水平部分。荧光阈值是在荧光扩增曲线上人为设定的一个值,缺省设置为3~15个循环的荧光信号标准偏差的10倍。Ct值是指在PCR循环过程中,每个反应管内的荧光信号达到设定阈值时所经历的循环次数。显然,Ct值取决于阈值,而阈值取决于基线,基线取决于实验的质量,因此Ct值是一个客观的参数。Ct值的意义在于,同一模板在不同扩增过程中终点处荧光值不恒定,可重复性差,但Ct值却极具重现性。用定量PCR原理公式可推导出,模板起始拷贝数的对数与阈值循环数(Ct值)呈线性关系,模板起始拷贝数越多,荧光信号达到阈值的循环数越少,即Ct值越小。
8.3 Primer Premier5的使用
这里我们以绿色荧光蛋白(GFP)定点突变位点的验证引物设计为例,介绍使用 Primer Premier 5 设计引物的方法。Primer Premier 5.0 是一款功能强大的 PCR 引物设计与评估软件,其下载与安装扫描本章末的二维码查看。
具体操作流程如下。
8.3.1 GFP序列查找
首先根据质粒 pGFPuv 的名称, 在 NCBI 网站查询 GFP 基因序列。
(1) 打开 NCBI 网页, 在 Nucleotide 数据库搜索 pGFPuv 质粒。
(2)选择第1个条目“Cloning vector pGFPuv, complete sequence”(GeneBank: U62636.1),找到完整质粒的基因(图8-5)。
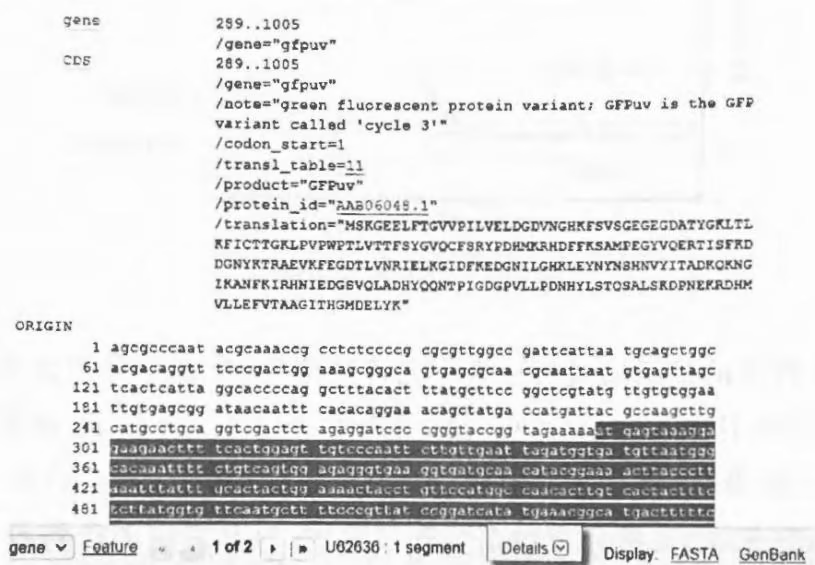
(3) 在 FEATURES 中找到 GFP 基因 (/gene=”gfpuv”), 点击前面链接 “gene” 会出现底部信息栏, 并高亮 289—1005 的 GFP 基因序列, CDS (coding sequence) 是编码蛋白序列。
(4)点击底部信息栏的FASTA链接,再点击新出现页面中的“send to”选择“Gene Features”, FASTA格式下载到指定文件(gfp_gene.fasta)。
8.3.2 引物设计与筛选
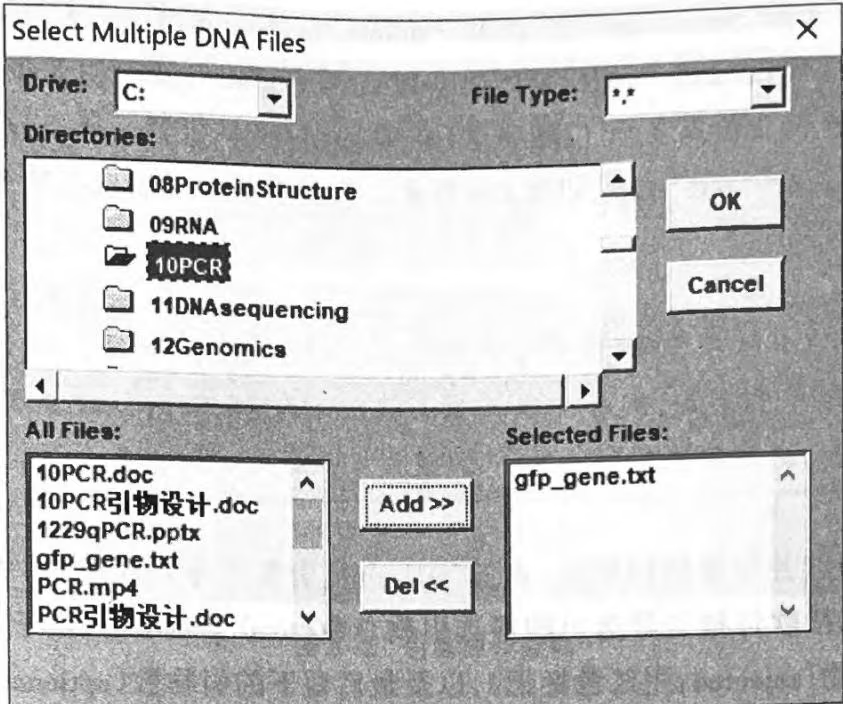
(1)序列导入:打开 Primer Premier 5.0 软件,点击 File>Open>DNA Sequence,打开输入序列对话框(GeneTank)。先选择路径(图 8-6),后鼠标选中序列文件名(gfp_gene.fasta),加入右框,选择后点“OK”按钮调入序列。
(2)在序列文件显示窗口,点击“primer”按钮,进入引物设计窗口(Primer Premier)。注:另一个按钮“Enzyme”可用于酶切位点分析;“Motif”按钮用于序列模序分析。
(3) 参数设置: 在窗口点击“Search”按钮, 进入引物参数设置窗口 (search criteria), 如图 8-7 所示。这里的主要参数有引物设计的目的 (search for) 包括 PCR 引物、测序引物和杂交探针; 引物类型 (search type) 包括正向引物 (sense primer)、反向引物 (anti-sense primer)、正反向引物 (both)、正反向成对引物 (pairs) 等。需要注意 both 与 pairs 的区别, both 设计正反向引物, 但不成对出现。如果序列有特别的要求, 可以再手动设置搜索的参数 (search parameters)。
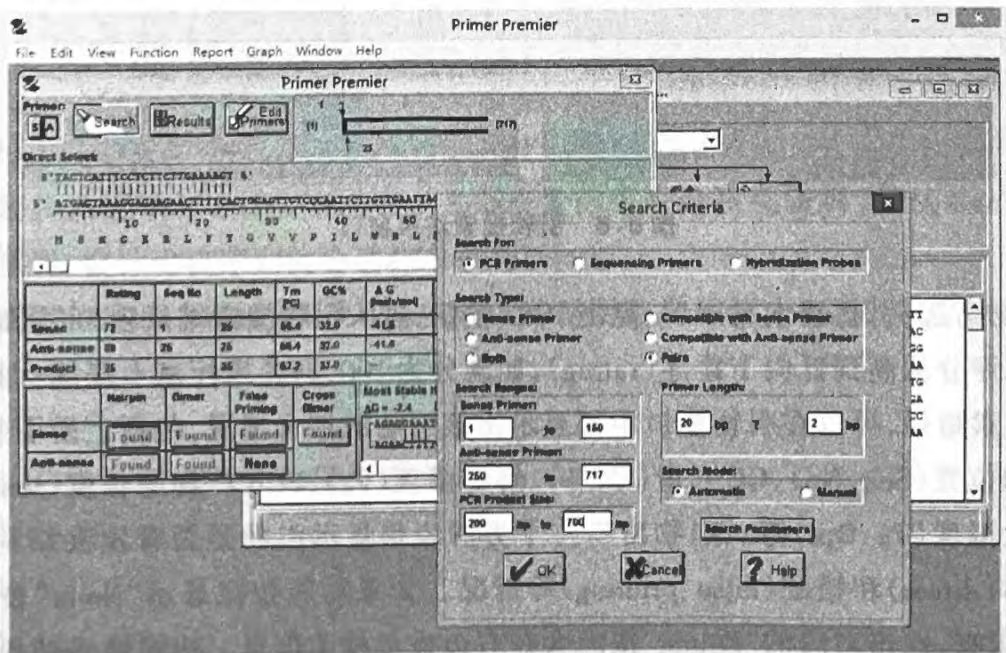
(4)这里分别选择“Search for”为“PCR Primers”和“Search Type”为“Pairs”,再分别设定PCR引物的搜索区域(search ranges)、产物长度(product size)及引物长度(primer length)。由于本例GFP定点突变位点在66位酪氨酸(在约198位碱基位置),所以设计验证突变位点引物要在突变位置前后,具体位置如图8-7所示。其他参数一般若没有特殊需要,可选择默认参数。
如果设计 qPCR 检测引物, 设置参数如下: 一般选 PCR primers 为 both, qPCR 的搜索范围是 mRNA 序列的全长, 定量 PCR 产物长度为 100~250bp; 引物长度范围为 $20 \pm 2$ ; Search parameters 中的其他参数可以不选, 使用默认设置。
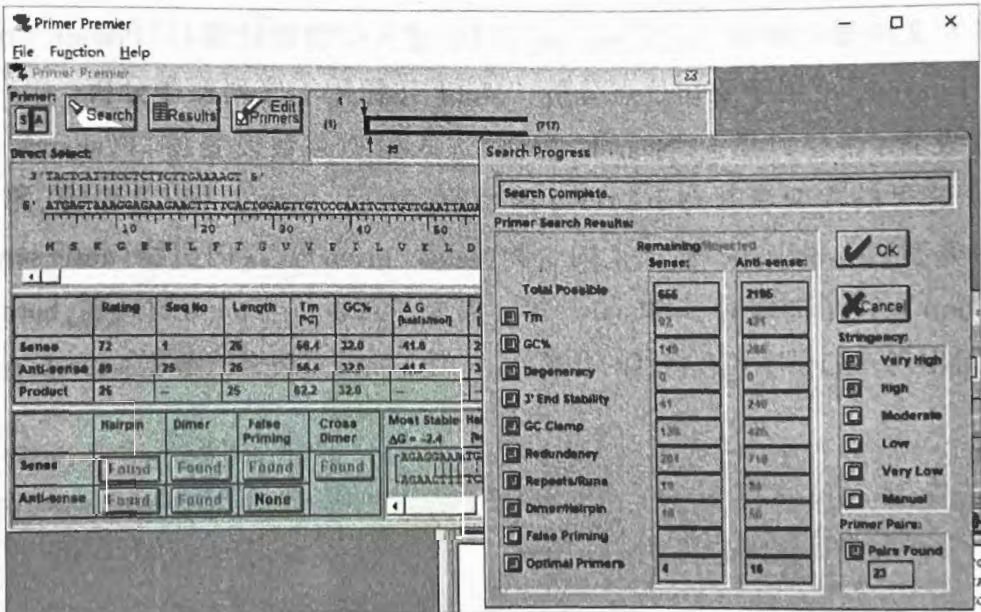
(5) 完成引物的各种参数设定后, 点击“OK”进行引物搜寻, 引物搜寻结束后, 显示结果如图 8-8 所示, 包括软件报告筛选出的候选引物总数(total possible)、由于各种参数不满足要求而去除的引物(rejected, 用红色标记), 以及最后留下的引物数(optional primers)。如果对这次结果不满意, 可点击“Cancel”按钮取消, 重新打开参数设置窗口进行调整(图 8-8)。
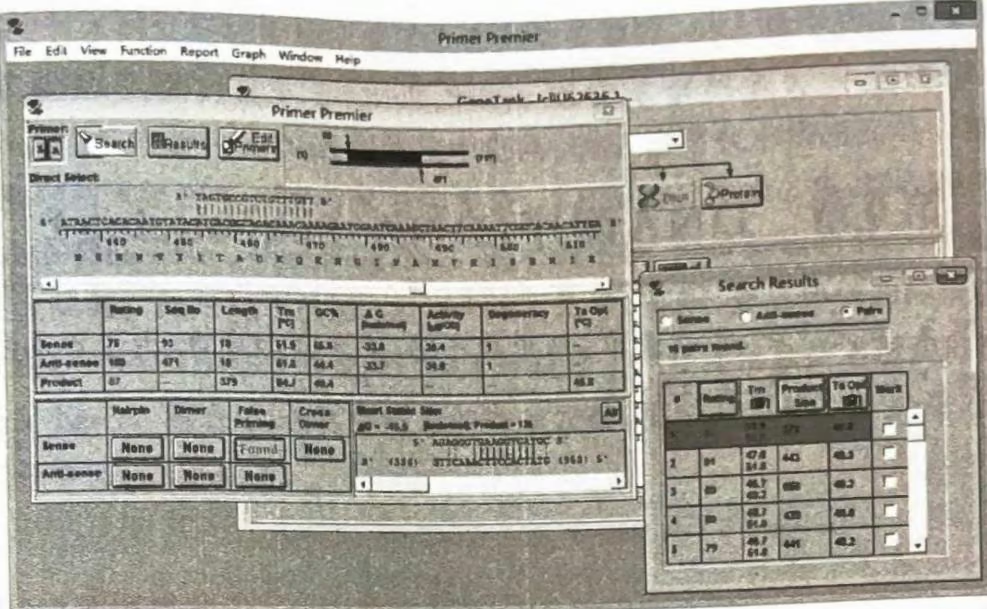
(6)引物筛选:引物搜索完毕后,点击“OK”按钮,进入引物搜索结果窗口(图8-9)。搜索结果是按照评分从高到低向下排序(rating),如满分为100,即各指标基本都能达标。点击其中任一个搜索结果,可以在引物窗口中部显示出该引物的综合情况,包括上游引物和下游引物的序列和位置(Seq No),GC含量(GC%)、解链温度( $T_{m}$ )、PCR产物的长度(length)及PCR适宜的退火温度(Ta Opt)等。引物窗口左下方的表格显示引物是否有发夹结构(hairpin),引物二聚体(dimer)和错配(false priming)等情况。如果对应按钮显示“None”表示没有,而“Found”表示有,点击对应的“Found”按钮会在右边显示相关信息。按照搜寻结果,逐条分析检查该引物对的情况,依次筛选合适的PCR引物。一般只要考虑前面评分较高的几个结果。
(7) 引物保存: 在“Search Results”窗口中选择一对合适引物, 并在“Primer Premier”窗口, 点击左上角 S(sense) 按钮选择正向引物, 然后选择菜单 Edit→Copy→Sense primer 复制正向引物序列, 后粘贴到指定文件:
gfp-f1:5’ AGAGGGTGAAGGTGATGC 3’
再点击 Edit→Copy→Anti sense primer, 同上复制反向引物序列到指定文件:
gfp-r1:5’ TTGTTTGTCTGCCGTGAT 3’
PCR引物的命名一般以F(forward)代表正向引物,R(reverse)代表反向引物,这样可以清楚看出引物序列间的配对关系。
在引物设计时,建议针对一个基因同时设计多对(1~3对)引物,从而保证可以从中挑选到PCR效果较好的一对引物,提高实验效率。
习题
实时定量 PCR 引物设计与普通 PCR 相比有哪些特点?
请查找新冠病毒 SARS-CoV-2 的 Spiker 蛋白序列的相关资料,并从 GenBank 中获取它的 DNA 序列,设计出该序列的合适 PCR 引物。
尝试用 Primer Premier 5 设计人类 HSP90 基因的定量荧光 PCR(qPCR) 引物。
第九章 系统生物学
本章提要
后基因组时代,生物综合论将成为生物学的主流研究方法。系统生物学成为生物信息学的最新前沿领域,目的是通过整合大量包括基因、蛋白质和代谢物组成成分之间的相互作用理解细胞中复杂的生物系统。
通过生物、遗传或化学的系统扰动,检测基因、蛋白质和信息通路的响应,整合这些数据最终形成描述系统结构和对扰动响应的动力学模型,以此来研究生物学系统。本章系统介绍了系统生物学的基本哲学思想、研究问题的基本方法与先进技术,以基因表达调控网络、代谢途径、信号转导通路和蛋白质相互作用网络为例介绍了系统生物学建模和系统分析的基本理论。
第一节 系统生物学基本概念
一、历史的机遇
从 1953 年 Watson 和 Crick 发现 DNA 的双螺旋结构以来,传统生物学进入了全新的分子生物学时代,使我们可以在坚实的分子基础上讨论诸如遗传、发育、疾病、进化等生命现象。生物学似乎又一次成为基于物理学基本规律的学科。今天,我们已经掌握了许多关于遗传、进化、发育及疾病等生命过程基本机制的知识,特别是我们已基本上搞清楚了诸如 DNA 复制、转录、翻译等最重要的生命过程的分子机制。
随着人类基因组计划及其他多种模式生物基因组计划的顺利进行,我们已得到越来越多的基因组序列,其他诸如蛋白质组学、转录组学、代谢组学、定位组学等计划也正如火如荼地进行。这些计划的开展并不标志我们对生物学系统的彻底理解,相反,它们催生了称为“系统生物学”的学科的形成。人们认识到,基因与蛋白质很少单独起作用,它们倾向于组成相互作用网络来行使生物学功能,特别是当我们看到这样的局面:鉴定了基因组大部分基因之后,我们仍然无法仅仅凭序列信息来推断基因的功能。对功能的研究必须分析其相互作用的网络,或者更准确地说,把基因组或蛋白质组看作一个系统来进行分析。
系统生物学是生物信息学的最新前沿领域之一,目的是通过整合大量包括基因、蛋白质和代谢物组成成分之间的相互作用理解细胞中复杂的生物系统。系统生物学的出现,是生物信息学领域的一个重大变化。系统生物学不是像过去研究分子生物学那样一次研究一个基因或蛋白质,而是研究生物学系统所有元素的行为和关系,通过系统的整合、图形显示这些数据,最终实现动力学模拟,提供扰动和监视系统的高通量技术,建立新的计算方法,达到对细胞内复杂生物过程进行系统研究的目的。
系统生物学的出现也标志着生物学的研究正在经历一场革命。如果说过去生物学研究主要以生物实验来进行,那么对于具有复杂网络的系统功能的分析,离开了理论分析和指导,几乎无法进行实验。因此,生物学尤其是分子生物学的研究方法将转变为在理论分析的指导下,将实验与理论相结合的研究过程,因而系统生物学的出现也就成为必然。
二、生物还原论与生物综合论
还原论成为 20 世纪后半叶生物学发展的主流。按照还原论的方法,为了研究生物系统某一方面的功能,只需寻找并鉴定出与此功能直接相关的基因或蛋白质即可。从某种意义上说,它是从整体机能到分子机制。
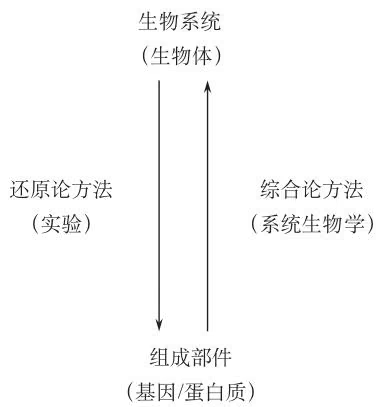
基因组计划揭开了综合论研究方法的序幕。综合论方法研究基因和各种生物大分子是怎样通过网络调控方式形成一个生物系统的。虽然还原论方法研究生物学问题取得巨大成功,但在后基因组时代我们需要综合全部生物信息重构生物体,综合论研究思路将成为生物学研究的主流。系统生物学往往是从一个简单分子模型开始,研究分子之间的非线性相互作用可以产生什么样的系统特点,通过将描述这些作用的方程参数化,最终实现对系统特点的真实估计(图9-1)。
物理学和化学中,基本粒子如何组装成物质、元素如何组成化合物的一般规律已经被发现,但在生物学研究中,我们还未能取得这种令人鼓舞的进展。实际上,我们至今还不清楚基因组上的信息是否足以建立一个完整的生物体系。在物理学基本粒子的标准模型中,包括两类基本粒子:物质组
成和作用力介质。换句话说,只有各组成部分的信息是不够的,各部分之间的相互作用信息是非常重要的(如物理学中作用力介质)。基因组包含了其组成部分的信息,但很难说它含有各部分间相互作用的信息。
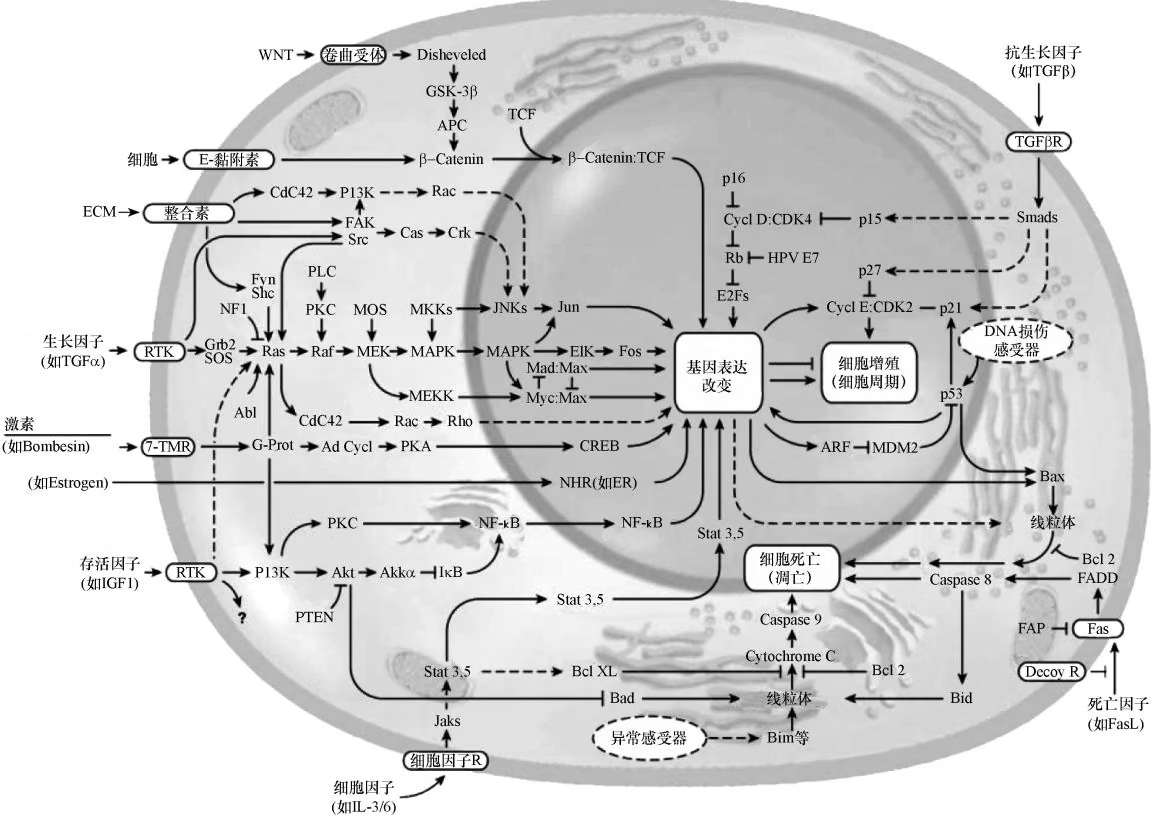
传统生物学关注的是一个一个的通路,而系统生物学则希望研究各个通路之间的相互作用,构成一个复杂的相互作用网络,从而从更高的层面上理解生命过程。通俗地说,传统生物学看到的是树木,系统生物学看到的则是森林。图 9-2 为细胞内多种信号转导通路在相互作用网络视角的示意图。
三、什么是系统生物学
人类基因组计划促使我们接受这样的观点,即生物系统包含两类信息:编码执行生物功能分子机器的基因,识别基因表达、调控相互作用的网络。这些信息遵循如下层次:DNA→mRNA→蛋白质→生物分子相互作用→通路→网络→细胞→组织→生物体→种群→生态系统。生物信息具有多层次性、信息通过复杂网络执行、鲁棒性、网络中存在枢纽节点等性质。这里要注意的是,每个层次信息都对理解生命系统的运行提供有用的视角。因此,系统生物学的重要任务就是要尽可能地获得每个层次的信息并将它们进行整合。
根据美国系统生物学研究所创始人胡德(Leroy Hood)的定义,系统生物学是研究一个生物系统中所有组成成分(基因、mRNA、蛋白质等)的构成,以及在特定条件下这些组分间的相互关系的学科(Ideker et al., 2001)。也就是说,系统生物学不同于以往的实验生物学——仅关心个别的基因和蛋白质,它要研究所有的基因、所有的蛋白质、组分间的所有相互关系。显然,系统生物学是以整体性研究为特征的一种大科学。同一时期,北野宏明也提出了系统生物学的研究目标在于从系统层次上理解生物分子行为到生物系统特征功能之间的关系,需要建立一系列的原则与方法(Kitano, 2002)。
对于多细胞生物而言,系统生物学要实现从基因到细胞、组织,甚至到个体的各个层次的整合。我们知道,系统科学的核心思想是“整体大于部分之和”;系统特性是不同组成部分、不同层次间相互作用而“涌现”的新性质;对组成部分或低层次的分析并不能真正地预测高层次的行为。如何通过研究和整合去发现与理解涌现的系统性质,是系统生物学面临的一个根本性的挑战。
系统生物学整合性的另一层含义是指研究思路和方法的整合。经典的分子生物学研究是一种垂直型的研究,即采用多种手段研究个别的基因和蛋白质。首先是在 DNA 水平上寻找特定的基因,然后通过基因突变、基因剔除等手段研究基因的功能;在基因研究的基础上,研究蛋白质的空间结构、蛋白质的修饰及蛋白质间的相互作用等。基因组学、蛋白质组学和其他各种“组学”则是水平型研究,即以单一的手段同时研究成千上万个基因或蛋白质。而系统生物学的特点,则是要把水平型研究和垂直型研究整合起来,形成一种“三维”的研究。此外,系统生物学还是典型的多学科交叉研究,它需要生命科学、信息科学、数学、计算机科学等各种学科的共同参与。
四、系统生物学基本框架
要解决生物体重构问题,首先要用计算机将有关相互作用的生物学知识计算机化,然后设计一些新实验。图 9-3 描述了系统生物学实验,在这些实验中应用了活细胞对于各种环境变化的应激反应,还融合了全基因组序列和不完全的生物学知识,所有这些都被用来揭示潜在的相互作用关系。也许在将来的某一天,利用这样一个全新水平的信息技术,我们就可以解决生物体重构问题。
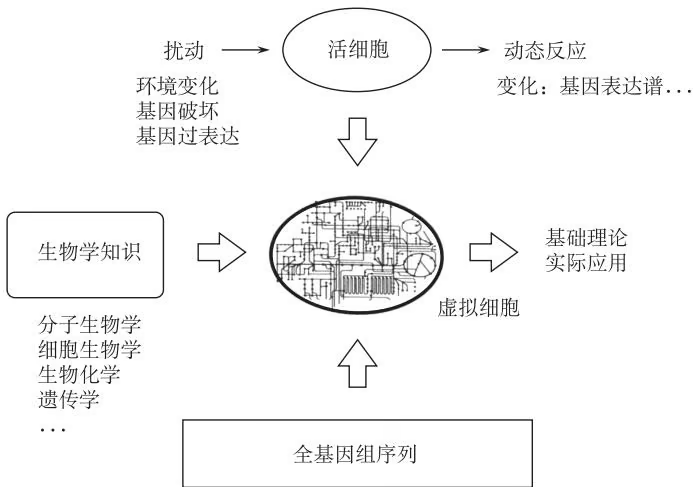
我们的最终目的是理解相应系统中观察到的整体变化的分子及其相互作用。为此,我们必须整合各种水平的整体性质的测量和生物系统的数学模型。系统生物学的基本工作框架如下。
(一)系统结构鉴定
系统结构鉴定首先是对选定的某一生物系统的所有组分进行了解和确定,描绘出该系统的结构,包括基因相互作用网络和代谢途径,以及细胞内和细胞间的作用机制,以此构造出一个初步的系统模型。多细胞有机体机构的识别不仅需要鉴定基因调控网络、代谢网络的结构,还需要在细胞水平精确理解整个生物的物理结构。这一步可以达到两个目的:描述统治系统行为的相互作用;精确预测给定扰动下系统的行为。
(二)系统行为分析
系统生物学一方面要了解生物系统的结构组成,另一方面要揭示系统的行为方式。相比之下,后一个任务更为重要。也就是说,系统生物学研究的并非一种静态的结构,而是要在人为控制的状态下,揭示出特定的生命系统在不同的条件和时间下具有什么样的动力学特征。一般是通过系统地改变被研究对象的内部组成成分(如基因突变、基因删除等)或外部生长条件(生长条件、温度、激素或药物刺激等),然后用大规模发现工具观测在这些情况下系统组分或结构所发生的相应变化(包括基因表达、蛋白质表达和相互作用、代谢途径等),并把得到的有关信息与模型进行整合。
(三)系统控制
把通过实验得到的数据与根据模型预测的情况进行比较,并对初始模型进行修订,使其预测结果与实验观察更加一致。
(四)系统设计
根据修正后的模型的预测或假设,设定和实施新的改变系统状态的实验,重复(二)和(三),不断地通过实验数据对模型进行修订和精炼。系统生物学的目标就是要得到一个理想的模型,使其理论预测能够反映出生物系统的真实性。
第二节 复杂网络及特征
对于自然界中的大量复杂系统,都可以将其抽象并用不同的网络(图)模型来描述。网络(图)由许多的节点和边组成,其中节点表示系统中不同的个体,而边则表示个体间的关系或相互作用。当两个节点之间存在相互关系或作用,则在此两节点间连一条边。若两个节点之间不存在相互关系或作用,两节点间不存在边。同时,根据边的方向性以及数值属性可以将图分为有向图、无向图、加权图等。
在构造网络时,当以一些规则的结构来近似代替真实系统中各因素之间的关系,所得为规则网络,并以二维平面上规则网格等来表示。当以一定的概率确定两个节点之间是否连边,由此生成的网络被称作随机网络。真实系统对应的网络既不是规则网络,也不是随机网络,而是具有与两者皆不同的统计特征,将具有这些与规则网络或随机网络不同统计特征的网络命名为复杂网络(complex network)。
复杂网络是在拓扑层次上,对大量真实复杂系统的抽象简化,它比规则网络和随机网络复杂得多,是研究复杂系统的结构和行为的关键。
(一)复杂网络的统计特征
在网络中,两点间的距离被定义为连接两点的最短路径所包含的边的数目,把所有节点对的距离求平均,就得到了网络的平均距离(average distance)。另外一个参数叫作集聚系数(clustering coefficient),专门用来衡量网络节点聚类的情况。例如,在朋友关系网中,你朋友的朋友很可能也是你的朋友;你的两个朋友很可能彼此也是朋友。集聚系数就是用来度量网络的这种性质的。用数学的语言来说,对于某个节点,它的集聚系数被定义为它所有相邻节点之间边的数目占可能的最大边数目的比例,网络的集聚系数 C 则是所有节点集聚系数的平均值。
研究表明,规则网络具有大的集聚系数和大的平均距离,随机网络具有小的集聚系数和小的平均距离。1998年,Watts和Strogatz通过以某个很小的概率切断规则网络中原始的边,并随机选择新的端点重新连接,构造出了一种介于规则网络和随机网络之间的网络(WS网络),它同时具有大的集聚系数和小的平均距离,因此它既不是规则网络,也不是随机网络。随后,Newman和Watts给出了一种新的网络的构造方法,在他们的网络(NW网络)中,不破坏原有的连边,并以一个很小的概率在原有规则网络上添加新的连边,从而缩短网络的平均距离。把大的集聚系数和小的平均距离两个统计特征合在一起称为小世界效应,具有这种效应的网络就是小世界网络(small-world network)。大量的研究表明,真实网络几乎都具有小世界效应。
研究还发现,大量真实网络的节点度服从幂律分布,这里某节点的度是指该节点拥有相邻节点的数目,或者说与该节点关联的边的数目。节点度服从幂律分布就是说具有某个特定度的节点数目与这个特定的度之间的关系可以用一个幂函数近似地表示。幂函数曲线是一条下降相对缓慢的曲线,这使得度很大的节点可以在网络中存在。对于随机网络和规则网络,度分布区间非常狭窄,几乎找不到偏离节点度均值较大的点,故其平均度可以看作其节点度的一个特征标度。在这个意义上,把节点度服从幂律分布的网络叫作无标度网络(scale-free network),并称这种节点度的幂律分布为网络的无标度特性。无标度网络具有普遍性,社会网络、生物网络等各类网络都具有无标度特性。
(二)网络的拓扑分析
通过计算网络上的统计指标可以得到复杂网络中更有意义的节点。基于生物大分子的互作关系或统计学上的相关性,可构建相应的复杂网络模型。根据网络中节点的相应指标可对其进行有目的的分析。对于无向无权图来说,节点的度表示和此节点有连接的节点数量,是网络研究中最基本和最广泛使用的度量标度,许多指标在计算中都要利用节点度的信息来描述网络中的高阶拓扑关系。在网络分析中可以根据节点的度筛选出中心节点(hub),以蛋白质互作网络为例,节点度较高表明该蛋白质分子能跟更多的蛋白质发生互作,因此在生物体内发挥着更重要的作用。网络分析中另一个重要的指标是介数中心性(betweenness centrality),它反映了网络中任意两点间所有最短路径中经过目标节点的路径数目占最短路径总数的百分比,刻画了目标节点连接网络中任意两点的能力,更高的介数中心性表明该节点在复杂网络中扮演着桥梁的作用,常用来寻找瓶颈节点(bottleneck)。这类节点并不一定有很高的度,因此无法通过寻找中心节点的方式找到这些瓶颈节点。
然而,越来越多的研究开始聚焦到网络中由多个节点组成的功能组件而非单独的某个节点。这种高阶的连接模式更好地反映了复杂生物网络的自组织性。大量研究表明,在生物体内发挥作用的并非单个生物大分子或者单独的某个基因,而是由多个节点共同组成的模体在发挥着生物学功能。模体被定义为复杂网络中某种异于随机网络的相互连接模式,是复杂网络中的简单功能组件。模体普遍存在于不同类型的网络中。除了保留网络局部特征的模体外,网络还具有社区结构(community)。社区结构是指网络中普遍存在的社区中节点连接紧密、社区间节点连接稀疏的现象。例如,在蛋白质互作网络中,功能类似的蛋白质可能形成一个紧密相连的“社区”。启发式的社区发现算法可以对图结构数据进行有效的聚类,并且广泛应用于蛋白质互作网络挖掘、单细胞聚类等领域。
(三)生物中的复杂网络
尽管最近才被引入,复杂网络的研究已经稳步增长。由于其良好的解释性与强大的模型表达能力,网络结构在对现实世界的建模中受到了广泛的应用。生物体的内在复杂性和系统组织性使得复杂网络为系统生物学的研究提供了一个特别有前途的框架。生物的复杂网络建模涵盖了从细胞内的分子相互作用到细胞间通讯以及生物体与物种之间的联系。随着实验和经验数据的急剧累积,建立多尺度的模型来模拟观察到的生物反应与表型是一个挑战。
在细胞水平上,将不同代谢物、蛋白质和基因之间相互作用模式中观察到的结构规律转化为观察到的表型下的组织原则是一项关键任务,可以在网络科学的背景下显著解决,它为大规模的数学和计算分析提供了框架。具体而言,模式生物代谢网络的基因组尺度重建可以表示为复杂的网络,以阐明其结构和功能之间关系的不同方面。当前生物复杂网络的研究主要集中于转录调控网络(transcription regulatory network)、蛋白质相互作用网络(protein-protein interaction,PPI)以及代谢网络(metabolic network)。
生物体的巨大复杂性更多的是由于基因表达的精细调控,而非基因含量的差异。转录网络是调控细胞基因表达的关键系统。转录因子(transcription factor, TF)响应细胞环境的变化,调节靶基因(target gene, TG)的转录,将功能蛋白相互作用与遗传基因组DNA中编码的遗传信息联系起来,从而控制基因在生物发育过程中的时空表达。这些调节因子以复合物的形式与转录起始位点附近的特定顺式元件结合,通过RNA聚合酶稳定增加或减少mRNA产生的速率。TF和TG之间的相互作用可以表示为一个有向图。当转录因子和靶基因之间发生调节相互作用时,两种类型的节点(TF 和 TG)通过有向边连接。
蛋白质之间的相互作用对于维持活细胞的分子系统正常工作至关重要。蛋白质相互作用对于细胞间的通讯、微环境变化的感知、蛋白质的运输和修饰等生物过程具有重要意义。复杂网络理论在描述复杂系统时具有普遍性和集成性,适合研究蛋白质之间的相互作用。在复杂网络分析中,每个蛋白质被表示为一个节点,蛋白质之间的物理相互作用由网络中的边表示。蛋白质研究中的一大热点是蛋白质功能的预测。在蛋白质相互作用网络中共享连接的蛋白质往往具有相似的功能。经验观察表明,70%~80%的蛋白质和与其互作蛋白质至少共享一种功能。这样,通过分析已知蛋白质的邻域,就可以推断出它们一阶邻居蛋白质的一些功能。
新陈代谢主要由基因、环境和营养决定。它由酶催化的化学反应组成,产生必需的成分,如氨基酸、糖和脂质,以及合成和利用它们来构建细胞成分所需的能量。由于化学反应被组织成代谢途径,其中一种化学物质通过酶和协同因子转化为另一种化学物质,因此这种结构可以自然地建模为一个复杂网络。通过这种方式,代谢网络是有向图和加权图,其顶点可以是代谢物、反应和酶,以及两种表示代谢物流动和催化反应的边。京都基因与基因组百科全书(KEGG)数据库就记载了大量的代谢网络信息。
随着组学技术的涌现和生物数据量的积累,生物学研究发生了重大变化。这种演变不仅意味着分析复杂度的增加,而且需要研究者在更广泛的时间和空间尺度上整合生物进程的动态。复杂网络研究为组织生物数据提供了强有力的工具,并被广泛而有效地应用于不同层次生物系统的表征和建模。
第三节 系统生物学基本技术与方法
一、测量技术
(一)全面测量
为了掌握研究的整个生物体,需要获取一组全面的数据。目前,已有方法能在 mRNA 水平进行全面测量,从而得到基因表达谱。测量蛋白质表达水平及其相互作用的方法也取得了进展(酵母双杂交、质谱等)。同时,很多干扰基因转录的方法也已发明,如使特定基因功能失效的基因敲除及对线虫特别有效的 RNA 干扰技术。此外,还有正在进行蛋白质的高精度时空定位数据的获取。
线虫是一种被充分研究的多细胞有机体。整个细胞系已被鉴定,其神经系统的拓扑结构已被完全描述,已测定了全基因组序列,采用整体原位杂交技术全面揭示其发育过程中基因表达模式的技术正在发展等。其他模式生物的类似计划也在紧锣密鼓地进行。
(二)系统生物学测量
系统生物学研究需要全面的数据,并要严格控制产生数据的质量,以供仿真、建模及系统鉴定使用。将传统的实验自动化,从而实现高质量、高通量的实验输出。系统、全面、精确的测量是系统生物学实验的基本特征。精确定量的重要性不言而喻。全面性进一步分为以下3类。①组分的全面性。诸如基因、蛋白质等成分必须得到全面测量,否则测量的有效性就值得怀疑。②时空完备性。传统生物学实验往往倾向于仅测量特定时间发生前后系统的变化,而精细时间序列和特定空间分布下获得系统行为对系统生物学则更加重要。③内容的全面性。对诸如转录水平、蛋白质相互作用强度、磷酸化、甲基化、乙酰化、定位等特征的全面测量至关重要。“系统”意味着测量所得的数据必须一致、完整。
下面以从基因表达谱推到基因调控网络进一步说明这些准则。首先需要全面测量基因表达谱。野生型表达数据难以满足要求,需要每个基因缺失突变和过表达所产生的完整数据集。许多情况下,表达水平随时间和空间的变化对建模是重要的。除了对特定时空测量数据外,还需进行固定时间、空间间隔的采样测量,这种数据对建模、系统行为分析是十分有益的。得到基因调控网络后,就需要找出网络中特定的参数,为了理解动力学特性,必须得到网络的每一参数,如结合常数、转录速率、翻译速率、化学反应速率、降解常数、扩散系数及主动运输速率等。
(三)定量的高通量测量技术
人类基因组计划不仅改进了我们系统扰动细胞的能力,也给我们提供了系统地表征细胞响应的技术,如 DNA 测序仪、微阵列技术、高通量蛋白质组学,当然还有诸如四维显微自动获取细胞系及线虫早期胚胎形成、超高分辨率荧光显微镜等许多正在发展的技术。由于这些技术可实现整体分析,因此成为生物系统性质、动力学等快速、准确分析的首选方法。
二、系统生物学实验方法
为了适应不断增长的全面、精确测量的要求,需要开发一系列新技术、新仪器,以供自动化程度高、精确度高的测量手段所需。首先,常规实验的自动化程度需要大幅度提高,否则高通量实验就是一种噩梦般的劳动。其次,需要采用尖端技术(如纳米技术、飞秒技术等)来设计下一代实验装置。有朝一日,我们也许可以测量基因和蛋白质的活动。细胞系的鉴定是分析基因表达调控网络必须完成的主要工作之一。四维显微成像系统允许我们收集恒定时间间隔的多层共焦图像,但是还需要更高的自动化程度。结合整体原位杂交和正在发展的单细胞表达谱,我们在不远的将来会实现对基因调控网络的完全鉴定。
三、系统结构的鉴定
为了理解一个生物学系统,需要首先鉴定系统的结构。有很多不同的系统结构需要测定,如发育过程中细胞之间的关系、细胞之间的接触、细胞膜、细胞内结构等。例如,为了表示基因调控网络,必须鉴定网络的所有组成部分,以及每一部分的功能、相互作用及所有相关的参数。必须用所有可能的实验数据来完成这些细微的工作。同时,已有实验的推论结果可用于预测未知基因及相互作用,这些预测结果可通过实验来验证。
(一)网络结构的鉴定
自下而上的方法 自下而上的系统生物学由分子之间的相互作用属性开始,研究这些相互作用如何导致生物体的功能行为。这些相互作用影响或作用于生物系统的过程,使生物体可以依时序发育,或者通过修复损伤或补偿耗散维持其状态;基于独立的实验数据来构建网络模型,如通过文献和一些专门的实验获取感兴趣的特定网络数据。自下而上的方法适合于大多数基因及调控网络已经得到较好理解的情况,特别适合于已经了解部分结构而只需进行完善的情形。当大多数参数已经可用,研究的主要目的就是建立一个仿真模型,用于分析参数改变时系统的动态特性。
自上而下的方法 自上而下的系统生物学由分子水平的实验数据开始,将生物系统的相关分子视为整体,在数据分析过程中,得到关于生物体分子组成及功能的新假设。
(二)参数鉴定
鉴定网络结构固然重要,网络中参数的鉴定同样重要。因为所有计算结果必须与实际实验结果一致,鉴定出来的网络必须对系统响应、行为特征进行量化分析和仿真。大多数情况下,可以基于实验数据估计参数,这些方法包括穷举搜索、遗传算法、模拟退火等。精确测量、估计参数在许多情况下是必需的,但也有无需精确估计的情况。
四、系统行为分析
一旦我们理解了系统的结构,接下来的重点就是关注系统动态行为。为了获得系统层次的理解,需要理解系统的鲁棒性、稳定性和回路功能背后的机制。仿真在系统生物学中扮演重要的角色,因为网络行为十分复杂、组分众多,直接理解网络行为几乎是不可能的,一般通过施加扰动,改变网络的参数和结构,从而分析网络动态行为,因此,建立精确的模型是必需的。仿真不仅是理解系统行为的基本工具,也是设计过程的基本工具。由于仿真是生物系统研究的可行方法,因此需要开发高度实用化、精确、用户界面友好的仿真系统。仿真器和相关软件需要大量计算,常常需要在计算机集群上运行。这些仿真系统必须能够仿真单个和多个细胞的基因表达、新陈代谢、信号转导等过程。很多情况下,仿真系统还需要能够模拟像染色体结构这样的更高层次。系统生物学仿真需要开发和整合一系列软件,如存储实验数据的数据库、细胞与组织仿真系统、参数优化软件、分叉和系统分析软件、假设生成器和实验设计专家软件及数据可视化软件,如分叉分析、代谢控制分析、敏感性分析流平衡分析、代谢控制分析等方法已用于系统动态分析。
五、系统生物学计算:数据与工具
与计算科学、数学、统计学学者合作,生物学工作者正在发展技术用于获取、存储、分析、图形化显示及模拟生物信息,未来的主要挑战是如何整合不同层次的信息。
(一)计算数据日益重要
尽管核酸、蛋白质序列数据仍然是最大、最有用的数据,但人们对其他类型的数据产生了极大兴趣,这种兴趣主要源自功能基因组学和系统生物学。例如,DIP、BIND 和 MIP 储有蛋白质-蛋白质相互作用信息,TransFac 和 SCPD 为蛋白质 -DNA 相互作用信息,KEGG 和 BioCyc 为代谢途径数据库。
这些爆炸性数据给我们提出两个挑战:①如何以适当的格式系统地储存这些信息;②如何保持数据及时更新。研究者可能收集大量基因、分子相互作用、通路等生物信息,但没有一个科学家能熟悉细胞中巨大的、复杂的相互作用信息,所以说数据对系统生物学尤为重要。
(二)整体分析日显重要
有了表达谱、分子相互作用和大量其他数据,我们的任务是发展强有力的分析和实验策略整合、分析这些数据进行生物学发现。迄今,人们的注意力主要集中在基因表达方式的分析方法。通过选择不同生物条件和时间下有明显变化的基因,基因表达数据可用于特殊生物过程中基因的识别。在这类实验中,成百上千个基因的表达水平随测试条件变化。
有相似响应的基因常常聚成功能群或者显示同样的表达方式。通过整合基因表达群与补充的整体数据,可以进行专一性或者精确的功能预测。基因表达数据可与蛋白质相互作用和蛋白质种系轮廓或基因定位信息结合,用于寻找共调控元。
(三)计算模型越来越重要
模型最初的目的是说明实验观察,研究人员往往画图表达他们的思想,这种图示有助于清楚的思考。鉴于细胞中相互作用的强度变化和复杂性高系统生物学要求更理性的模型来表达这一复杂系统。
由于高通量技术的发展,产生了大量定量的生物学数据,生物学从描述性学科逐步转向预测性学科。计算机系统用于储存、分类或压缩迅速增长的数据,我们需要把数据组合成一个网络模型,预测网络行为和实验可测结果。
(四)计算模型的类型
研究人员已提出大量细胞模型,如化学动力学模型,试图把细胞过程表达成不同的化学反应系统。网络状态用细胞中每一分子的瞬时量值(如浓度)来定义,分子借助一个或多个反应相互作用。每一个反应按照反应速率等参数,用联系反应物和补充物量值的微分方程表示,这一微分方程系统通常非常复杂,难以有解析解。然而,对于给定的初始网络状态,每一基因产物或其他分子的量可以模拟状态变化的轨迹,即网络中状态随时间变化。按此方法已模拟了包括细菌趋向性、果蝇发育模式和 $\lambda$ 噬菌体侵染大肠杆菌等生物学系统。最近有工作表明,转录、翻译和其他细胞过程也许应该用随机事件模拟更加合适。
与上述涉及化学反应系统的模型相反,另一类模型则把遗传网络模拟为分立的电路。与神经元网络非常类似,这一方法用节点和箭头(即有向线)表示网络,节点表示不同类别分子的量或水平,有向边表示一个节点对另一个节点的影响。对每个节点,我们还需要一个描述所有输入如何决定其水平的函数。一般地,点可表示为两分立态,如分子存在或缺失、基因开或关。给定所有节点的初始态,每一个节点的下一步水平直接由其函数确定。按此,所有节点的网络状态按分立的时间序列演化,下一状态由当前态计算。目前,已有一些分立电路模型的研究工作和模拟软件。对这个模型的批评主要是:模型要求即时更新节点数据,单细胞中分子相互作用并不同步,而且分子的两态表示也不足以获取网络的全部生物学行为。
(五)模型细节的选择
一个模型涉及一些关键选择,如包含哪一基因及哪一基因产物。基因可在转录、翻译水平调控,翻译后蛋白质还存在一系列修饰形式,通过可变剪接,一个基因可编码一系列不同的 mRNA。一些非遗传分子(如代谢物)可能影响网络;更进一步,一些相互作用限定于核仁、细胞膜、高尔基体及其他细胞器。所以一个完整的模型应包含分子如何实施可变剪接、修饰蛋白质产物及不同细胞器之间如何相互作用。
然而,模型的细节并不总是容易获得,解码信息是艰巨的任务。一般来说,模型参数的数量应该与可得数据的量和类型一致。例如,如果仅测量 mRNA 表达水平,那么关于蛋白质结构的详细信息可能使模型拥有太多的隐变量。
第四节 基因表达调控网络
一、基于 DBRF 方法从稳态基因表达数据推测基因网络
由于分子序列数据和大规模表达谱数据的迅速增加,迫切需要有效的计算方法从中提取数据,现已有研究人员从事大规模基因表达数据推测基因调控网络的工作。基因表达数据主要有时序和稳态两种。可以使用如信息论、遗传算法或模拟退火算法从时序表达数据建立调控网络。利用时序表达数据的一个缺点是目前采样技术不能满足在非常短的时间间隔内采样的要求。此外,已经发展了一些通过稳态数据推测调控网络的方法。
(一)基于差异表达调控识别方法推测基因调控网络
基于差异表达(difference-based regulation finding,DBRF)的调控识别从基因表达水平的差异推测可能的基因网络。首先通过野生型和突变型基因表达的差异(表9-1),推测直接和间接的基因调控关系,然后去除间接调控关系。
表 9-1 表达矩阵 M
| $x_0$ | $x_1$ | $x_2$ | $x_3$ | |
|---|---|---|---|---|
| wt | 3.750 | 3.750 | 8.939 | 0.078 |
| $a_0$ | — | 3.750 | 8.769 | 0.011 |
| $a_1$ | 3.750 | — | 8.769 | 0.086 |
| $a_2$ | 3.750 | 3.750 | — | 5.476 |
| $a_3$ | 3.750 | 3.750 | 8.939 | — |
矩阵 M 的每行表示缺失该行基因的情况下其他基因的表达水平,每列表示该基因在各种基因缺失试验下的表达水平。
确定基因调控关系的一个简单办法就是观察野生型(wt)和突变型表达水平的差异。DBRF首先要做的就是依据这种差异推测交互矩阵I体。由M可以导出矩阵I体,I体矩阵的行表示调控基因,列表示目标基因(如 $a_{0}$ 激活 $a_{2}$ 和 $a_{3}$ , $a_{2}$ 抑制 $a_{3}$ ,见表9-2)。
表 9-2 基因间相互作用的交互矩阵
| $a_{0}$ | $a_{1}$ | $a_{2}$ | $a_{3}$ | |
|---|---|---|---|---|
| $a_{0}$ | + | + | ||
| $a_{1}$ | + | |||
| $a_{2}$ | — | |||
| $a_{3}$ |
显然,如果基因 a 缺失,基因 b 的表达水平降低,基因 a 就激活基因 b 的表达,这一过程不仅推测出直接的调控关系,同时也推测出间接的调控关系。接下来,需要通过剪除上述推测冗余网络中的间接关系,从而得到精简的网络。为了剪除间接关系,对于每个基因做如下处理:①找出它们之间是否有一条以上途径;②检查这些途径的调控(激活或抑制)影响作用是否一样;③假如影响作用一样,剪除冗余途径。
(二)网络模型
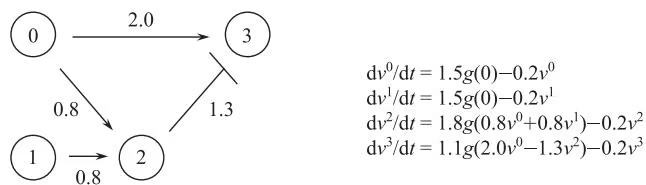
下面我们将讨论如何产生表达数据谱的网络模型。将一个基因调控网络描述为包含 N 个节点 $a_{n}$ ( $n=0,1,\cdots,N$ )、具有权重的节点间有向边、对每个节点都成立的表达函数方程 $g_{n}$ 的结构图。节点代表基因,有向边代表调控关系。有向边权重因子的正负代表作用于目标基因的激活或抑制。基因 $a_{n}$ 的表达水平由一个非线性 Sigmoidal 函数 $g_{n}$ 决定,该函数用于描述基因表达。基因表达水平可以用下面的方程表示:
$$
\frac {\mathrm{d} v ^ {a}}{\mathrm{d} t} = R _ {a} g \left(\sum_ {b} w ^ {a b} v ^ {b} + h ^ {a}\right) \lambda_ {a} v ^ {a}
$$
式中, $v^{a}$ 为基因 a 的表达水平; $R_{a}$ 为从基因 a 合成的最大速率; $g(u)$ 为一个 Sigmoidal 函数, $g(u)=(1/2)(u/\sqrt{u^{2}+1})$ ; $w^{ab}$ 为一个描述基因调控系数的连接权重矩阵; $\sum_{b}w^{ab}v^{b}$ 描述整体的激活与抑制关系; $h^{a}$ 总结了普遍的转录因子 a 上的效果; $\lambda_{a}$ 为基因 a 的产物 mRNA 降解速率。
图 9-4 给出了具有 4 个基因的小型网络模型。每一个圆圈代表一基因 $a_{n}$ ,每条边具有一权重因子。推测网络性能的评价指标是敏感性和特异性。敏感性定义为:目标网络中的边同时也在推测网络中出现的百分比。特异性定义为:推测网络中的边同时也在目标网络中出现的百分比。
二、海胆顺式基因调控网络
反式逻辑定义蛋白质相互作用因子与它们控制的基因(或网络中其他转录因子)的相互作用。相反,顺式逻辑定义通过其状态(束缚或无束缚因子)产生特殊基因表达时空模式的启动子序列之间的精确关系。这两类网络均有输入和输出,输入可能是来自信号转导途径,输出(核RNA浓度)表示许多转录后调控水平(RNA加工、RNA可变剪接、蛋白质加工和蛋白质化学修饰等)。
海胆因其发育简单(胚胎只有12种细胞)成为研究顺式(cis-)基因调控和反式(trans-)基因调控的有力模型,它们一个夏天可获得 30 \times 10^{9} 个卵子,卵子可同时受精,也可停止发育。许多转录因子容易分离、表征,其基因可用亲和染色法、传统的蛋白质化学、蛋白质微测序、DNA探针合成或文库筛选克隆。
迄今为止,海胆 endo16 基因有最完整顺式基因调控系统,这一系统用计算机或其他电路控制。大量转录因子的多种输入整合后输入 RNA 合成机。endo16 在胚胎内皮层表达,它首先出现在胚胎内皮层,然后是原肠消化道,最后在中肠密集,在前肠、后肠中消失。
长度 2.3kb 的海胆基因组包含 endo16 表达必需的全部控制元。图 9-5 显示这一区域有 34 个结合点及与其结合的 13 个转录因子。结合点落入 7 个 DNA 区域,包括 6 个功能区(调节子 A、B、DC、E、F、G)和 1 个基本启动子区。每一个区有一个或多个结合位点定义。把序列插入报告基因,再转入转基因海胆,然后测量基因表达时空表达输出。例如,这一方法显示调节子 G 是正调节器,而 F 和 DC 在相邻外胚层中响应表达抑制。A 在第 6 功能区与基本转录器之间起通讯作用,负责整合来自 G、F、E、DC 和 B 的正和负输入。
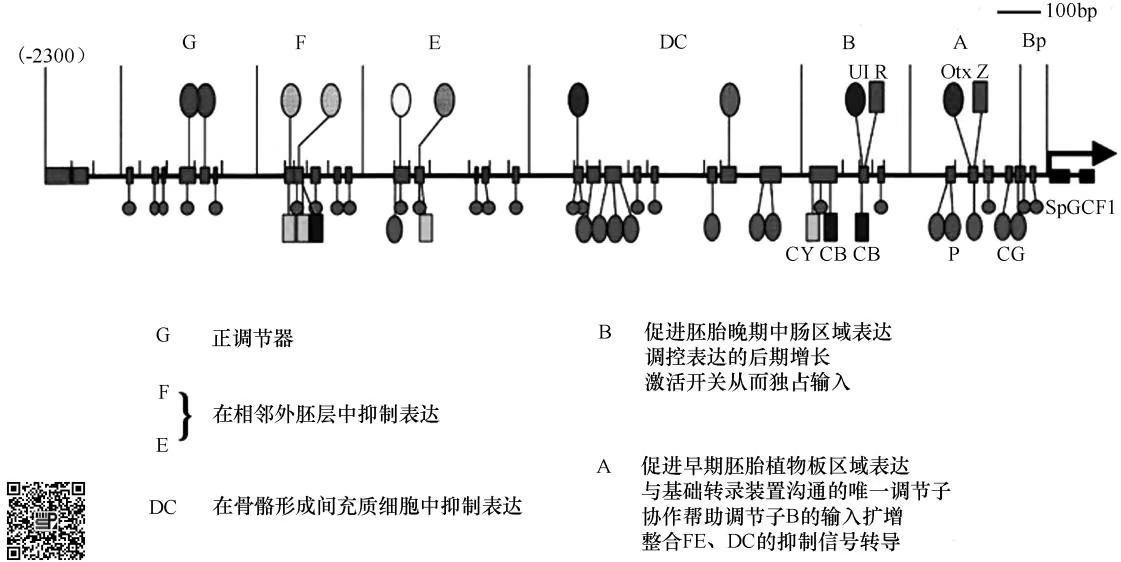
由这些研究,可构建一个描绘这些调节子,以及它们之间相互作用执行操作的模型(图 9-6)。模型清楚地表明调节子 B 通过调节子 A 作用于基因转录器,这种相互作用可以是布尔式、标量式或时间变化量。
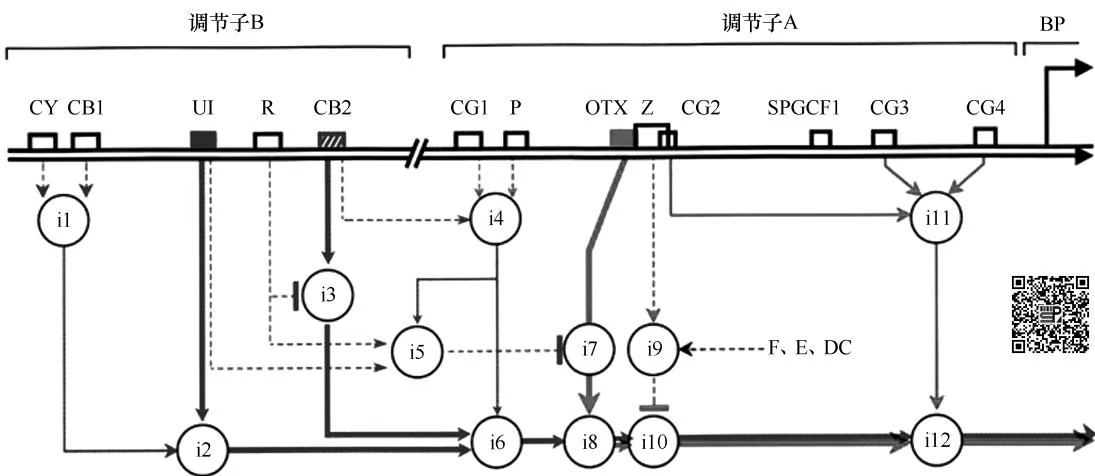
线上显示了结合位点,线下圆圈表示逻辑操作。调节子 A、B 的输出分别用红色和蓝色表示。短化线表示可由布尔式输入调节的相互作用,细实线表示标量,粗实线表示时间依赖的定量输入。箭头表示的输出产生正效应,垂直箭头表示负效应。例如,CY 和 CB1 相互作用激发调节子 B 时空控制元 UI 的输出
第五节 代谢网络
作为另一个例子,我们使用系统方法探索酵母中半乳糖的利用机制。和前面海胆发育一样,用调控网络模型预测由于定向扰动实验导致的基因表达的变化。与海胆的例子不同,其网络成分控制基因表达的顺式调控序列,现在网络由基因和反式相互作用的基因产物组成。尽管反式模型不能说明关于单个基因调控的细节,但它提供了基因如何相互作用,从而控制细胞过程的新信息。
酵母半乳糖利用系统包含至少9个基因,4个编码催化转化半乳糖为葡糖-6-磷酸的分子(GAL1、GAL5、GAL7和GAL10),第5个编码控制系统状态的转运分子。如果酵母细胞中有半乳糖,系统开启;如果缺少半乳糖,系统关闭。大量转录因子如GAL3、GAL4、GAL80和GAL6参与关/启的调控(图9-7)。
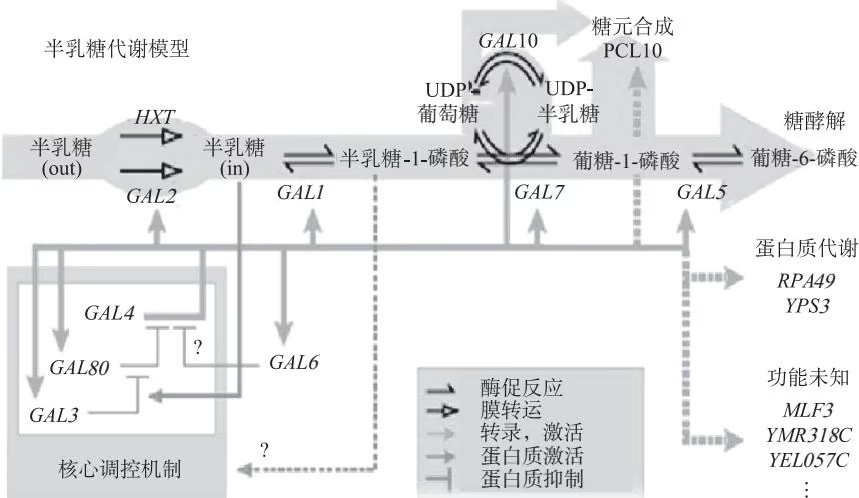
酵母通过涉及 GAL2 转运蛋白及由 GAL1、GAL7、GAL10 和 GAL5 产生的酶的一系列步骤代谢半乳糖。这些基因主要由 GAL1、GAL7 和 GAL10 组成的机制在转录水平进行调控。GAL6 通过类似于 GAL80 的方式通过抑制 GAL 酶产生另一个调控因子。点画线表示后加修正
(一)网络的遗传和环境扰动
我们希望确定半乳糖中分子相互作用是否足以说明来自对 GAL 通路扰动的基因表达的变化。为此,我们构建了 9 个遗传扰动酵母株,每一个删除一个不同基因,与野生型(无基因删除)一起,这些菌株在 2% 半乳糖有(+Gal)和无(-Gal)条件下稳定生长。在 20 种扰动(10 株 ×2 培养基)下,用全酵母基因组微阵列监视相对野生型(+Gal)mRNA 表达的变化。
997 个 mRNA 显示出在一个或多个扰动下浓度发生变化,对应的扰动基因分成 16 个不同的类,在同一类的基因中显示了相似的响应。特别是编码代谢细胞和合成通路的基因处于同一类,显示了酵母细胞中关联信息通路的网络。
(二)网络模型的构建和可视化显示
为了显示这些信息通路的性质,我们构建了一个连接其他代谢过程的半乳糖利用的分子相互作用网络。为此,关注3026个物理相互作用。这些相互作用定义了一个分子相互作用网络的模型。网络中每一个节点表示一个基因,有向线段表示第一个基因编码的蛋白质通过DNA结合能影响第二个基因的转录,无向线段表示基因编码的蛋白质有物理相互作用。
每一个扰动下的表达数据可视化加入网络。例如,图 9-8(a)显示半乳糖存在时 GAL4Δ 删除的结果,每一个节点的灰度表示其相应基因的 mRNA 表达的变化。当获取到其他信息时,也可添加进网络。图 9-8(b)说明增加蛋白质富含信息下的可视化显示,主要关注氨基酸生物合成对应的网络区。通过比较每一节点显示的 mRNA 和蛋白质表达响应,我们可以确定 mRNA 是否与蛋白质数据相关。
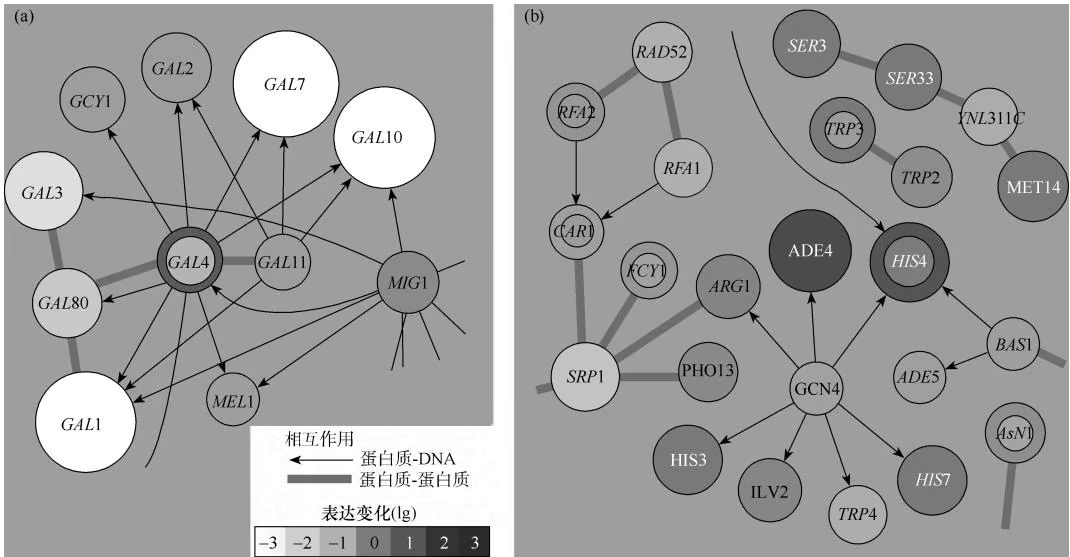

(a)半乳糖利用;(b)氨基酸生物代谢。节点表示基因,从一个节点到另一个节点的黄色有向箭头表示蛋白质-DNA相互作用,两节点之间的蓝线表示对应的蛋白质有物理相互作用。每一节点的灰度表示对应基因mRNA表达的变化,中间灰度表示无变化,暗色和亮色表示表达的增强和减弱。(b)的节点有两个不同区域,外环表示mRNA表达的变化,内环表示蛋白质表达的变化;(a)中用红色外沿圆环表示对GAL4的外部扰动
(三)观察与预测的比较
按前述系统生物学框架,我们希望确定是否观察到的20种扰动的表达变化与分子相互作用网络预测的变化一致。网络模型仅仅作粗略预测,如涉及蛋白质A与基因B的蛋白质-DNA相互作用预测A的表达变化能导致B表达的变化。如果A另外涉及蛋白质C的相互作用,那么C的表达变化也能通过A的改变引起B的表达变化。然而,网络不能说明这些相互作用是激活还是抑制;或者在多个相互作用影响一个基因的情况下,这些相互作用如何结合在一起产生全部的表达变化。类似地,网络不能指认是否蛋白质-蛋白质相互作用导致功能蛋白复合物的形成或者一个蛋白质修饰另一个,因为蛋白质-DNA或蛋白质-蛋白质相互
作用数据中没有编码这类信息。
有趣的是,我们有许多这类数据库中没有的信息可以利用。对 GAL 转录,经典遗传学和生物化学实验已确定 Gal4p 是一强转录激活子,Gal80p 与 Gal4p 结合可以抑制这一功能。我们可以通过挖掘 GAL 基因扰动对细胞中其他基因影响的文献信息来补充模型。例如,利用这类信息我们可以表明蛋白质 -DNA 相互作用是激活还是抑制;同样也可以明确是否每一个蛋白质 -蛋白质相互作用均能改变蛋白质的活性,或改变是正还是负。一旦将这类信息整合进模型,将大大增加其预测能力。图 9-9 对 20 种扰动比较了观察和预测的 GAL 基因表达响应,尽管观察的响应比预测的更加复杂,但在许多性质上二者是一致的。
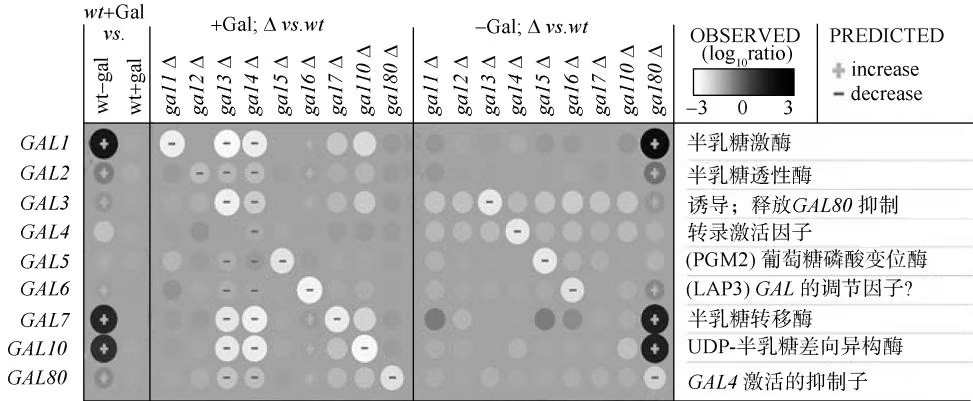
用微阵列测量20种对GAL途径扰动下生长的酵母mRNA表达谱。矩阵中每一个点表示由于特殊的干扰(列)下GAL基因(行)表达的定量变化;中等灰度表示没有变化,黑色或亮点表示增加或减少表达。矩阵的左半边显示在有半乳糖存在时与野生型相比每一删除菌株的表达变化,右半边是没有半乳糖时的类似变化情况,未注释的点表示预测物表达变化的基因
(四)通过附加扰动修正模型
用预测与观察表达响应差异可以修正模型。例如,现在模型预测 GAL 酶的扰动(即 gal1Δ、gal7Δ 或 gal10Δ)不应影响其他 GAL 基因的表达水平。尽管 gal1Δ 确实如此,但 gal7Δ 或 gal10Δ 删除明显影响 GAL1、GAL2、GAL3、GAL7、GAL10 和 GAL80 的表达水平,这是因为 gal7Δ 和 gal10Δ 删除锁定了 Gal-1-P,导致了这一通路和其他代谢水平的增加。一个假设是代谢之一对 GAL 基因表达施加控制。为了强调这一假设,我们在半乳糖 gal1gal10Δ 双删除株生长中测试表达的变化。尽管 GAL10 删除锁定了 Gal-1-P 的转换,但 GAL1 锁定了半乳糖利用通路的上一步,以致 Gal-1-P 水平大大减少。这样,如果代谢是观察到的 gal10 突变 GAL 基因表达变化的原因,这些变化应该在 gal1gal10Δ 株中消失。事实上,当我们使用微阵列检测双删除基因表达轮廓时,其确实发生,直接支持了这一修正模型。
这样,半乳糖利用的系统生物学方法给我们提供了理解通路如何调控、该通路如何与酵母细胞中其他信息通路联系的新思路。因此,这一方法可能在说明其他生物系统中的信息通路网络,最终说明多细胞生物细胞相互联系网络方面是一种强有力的方法。
第六节 信号转导途径
一、细菌化学趋向:一个鲁棒的信号转导模型
细菌的化学趋向,即细菌移向或离开化学源的过程,已经让研究者们关注了120多年。近几十年来,研究者把注意力放在阐明负责化学趋向响应的分子相互作用上,产生了大量的遗传、结构、生理和生物化学的数据。这些数据集合导致大量使用系统生物学方法模拟化学趋向网络的努力。
(一)化学趋向的行为和分子生物学
化学趋向响应的生理学相对来说较好表征。细菌在化学梯度下通过偏向随机行走、向前游动和随机再定位的变化而移动。为了游动,细菌逆时针转动其鞭毛马达。当它移动时,细菌感觉的是化学梯度的吸引或排斥,增加吸引或减少排斥导致沿确定方向的持续游动。
如图 9-10 所示,对化学趋向系统的分子生物学的细节已有些了解。已经了解的甲基接受化学趋向蛋白(MCP)共 5 个跨膜受体,有多个甲基化位点,其修饰状态控制信号转导。这个信号网络调节鞭毛马达的输出,也调节网络对改变吸引或排斥物浓度的敏感性。
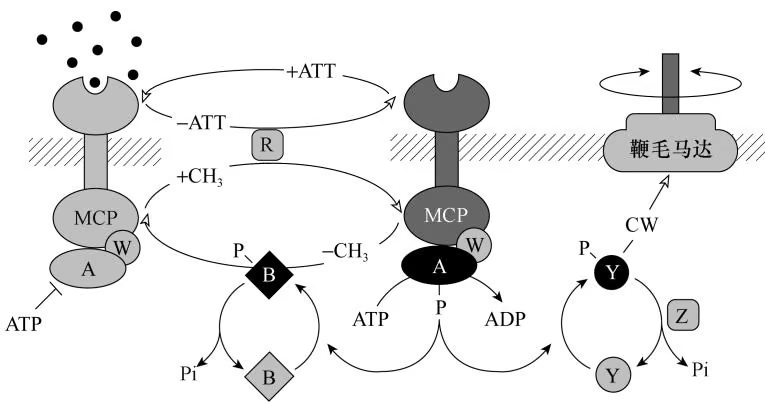
跨膜引诱物受体 MCP 与 CheW 和激酶 CheA 形成一信号复合体,CheA 能自发磷酸化并转移磷酸,从而响应调控子 CheY。磷酸 -CheY 与鞭毛马达蛋白相互作用诱导顺时针旋转。CheZ 蛋白促进 CheY 的去磷酸化。CheA 也负责转移磷酸到 CheB MCP 甲基化酶。激活的磷酸 -CheB 驱使 MCP 去甲基化,这种去甲基化作为适应机制的一部分减少了 MCP-CheW-CheA 复合物的激酶活性。CheR 是一个执行的甲基化转移酶。在增加引诱物存在的情形下,CheA 自发磷酸化被抑制,鞭毛蛋白逆时针旋转,接下来的 MCP 甲基化允许对更高引诱物浓度的适应。当在减少的引诱物中移动时,CheA 自发磷酸化被激活,这又反过来促进磷酸 -CheY 诱导翻动,然后通过 MCP 去甲基化而适应
(二)作为系统的性质模拟“鲁棒性”
已有负责化学趋向的分子相互作用响应的定量研究。例如,Spiro 等模拟在不同配体占据、磷酸化和甲基化状态之间各种化学趋向分子的转化。使用质量作用动力学方程,他们成功概括了这些分子对吸引梯度、步幅增加和饱和度的响应。按此,Spiro 等研究了定量分离成分和许多相互作用的整体产生。这个复杂的相互作用网络使得我们可以观察、模拟和预测系统的性质(即行为性质而不是研究单个系统成分)。
化学趋向网络的一个有趣的系统性质是它对不同吸引浓度适应的鲁棒性。这里,鲁棒性意指系统的输出对其输入或生物化学参数的个别选择不敏感。特别是,鲁棒适应指的是系统输出对输入变化的响应不依赖整体输入值。这样,E. coli 细胞通过改变它们的翻动频率(输出)响应对吸引浓度(系统输入)的变化。然而,由于鲁棒性适应,引诱物的均一解总是导致不同的引诱物浓度产生相同的翻动频率。
(三)细菌趋向性的完全适应和积分负反馈机制
在细菌趋向性信号转导网络中,受体复合物(由 MCP、CheA 和 CheW 组成)磷酸化响应调节子 CheY。被磷酸化的 CheY 与鞭毛马达结合产生顺时针旋转。受体复合物的活性是受甲基化调节的,被 CheR 甲基化增强其活性,被 CheB 去甲基化降低其活性。
细菌趋向性表现出完全适应性。实验表明:随诱导物剂量的持续作用,输出首先有短暂升高,接着是一段适应期,之后返回到刺激前的活性水平 $Y_{0}$ 。于是,活性的稳态水平 $Y_{ss}$ 渐近趋于 $Y_{0}$ ,并且在诱导物浓度大范围变化的情况下都能观察到这一现象。
Barkai 和 Leibler 的模拟工作显示化学适应的鲁棒性是分子信号网络结构的结果。假设简单的二态模型——MCP-CheW-CheA 蛋白复合物激活或失活,该模型可以理解实验已经观察到的多种行为。另外,该模型还可以做一系列关于适应性性质的预测。定义输入变化前后稳态输出比来描述化学趋向网络适应性精度。网络模型预测这个比值总是等于 1,表明适应性精度是一个鲁棒性量;那就是说,翻动频率仅仅受引诱物水平增加的影响,甚至会返回它的初始稳态值。事实上,可在不同幅值下改变速率常数,但仍能保持精确适应性。有意思的是,许多预测的化学趋向性质不是鲁棒的,如适应时间(输入变化和重建稳态输出之间的时间)和翻动频率(依赖酶的水平)在模型中均不是鲁棒的。
在相关的研究中,Alon 等通过在两级幅值下变化酶浓度,观察 E. coli 对饱和引诱物增加响应直接测试预测。他们观察稳态翻动频率、适应时间和适应精度。就像模型预测的一样,翻动频率和适应时间对酶活水平高度敏感,而适应精度相对保持恒定。
回到模型,对这种鲁棒行为响应的关键结构性质似乎是涉及 MCP-CheW-CheA 蛋白复合物修饰的反馈-控制环路。因为修饰速率依赖于蛋白复合物的活性,不依赖于其各种修饰形式的浓度,输入改变后系统活性倾向于返回初始稳态。
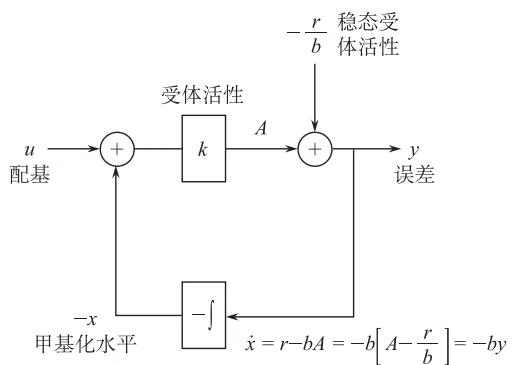
控制工程师很熟悉鲁棒性是积分负反馈的典型特征。什么是积分负反馈机制呢?现用图9-11来进行说明。带增益 $k$ 的方块表示网络获得输入,并得到输出 $A$ 。 $A$ 和期望的稳态输出之间的差值为误差 $y$ 。对 $y$ 积分并将它的负数反馈到系统中。反馈项 $x = \int y , dt$ ,因此 $\dot{x} = y$ 。稳态下, \dot{x} = 0, y \to 0 ,且与输入 $u$ 和增益 $k$ 无关。所以,只要系统是稳定的,不论输入 $u$ 和增益 $k$ 是多少,误差值都会趋于 0。变量 $x$ 表示受体的所有甲基化状态。 $x$ 的改变,即等于甲基化的速率 $r$ 减去去甲基化的速率。假设 CheB 只对被激活的受体复
合物去甲基化,利用这个假设我们将去甲基化速率写成一个关于受体活性水平 A 的函数。因此,得到如下微分方程:
$$
\dot {x} = r - b A = - b (A - r / b) = - b y
$$
我们能将趋向性信号转导网络添加到积分控制结构图中,在 CheB 只对被激活的受体复合物去甲基化的假设下,可以得到积分控制式。
(四)生物学网络的正向工程
迄今为止讨论的例子涉及构建自然发生的生物系统的力学模型。然而,前述的系统生物学框架同样可以用于按照预定模型构建合成系统,但有一个差别:前一情形,改变模型去适应生物学系统(即反向工程);而后一情形,改变生物学系统去检验模型(即正向工程),合成生物学就是正向工程。
尽管具有需要性质或特殊功能的工程化生物学系统的概念并不新鲜,但一系列正在进行的研究方案使其从概念进入实用。Elowitz 等构建了一个 E. coli 基因调控系统(图 9-12)。
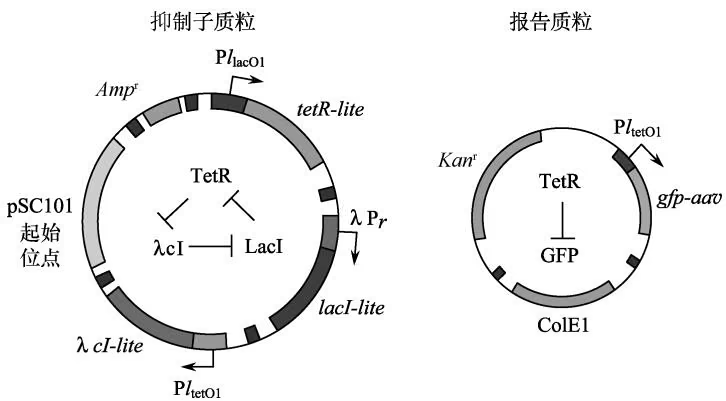
抑制子质粒编码 3 个蛋白质,每一个蛋白质与外源启动子融合,在闭合的负反馈环中一个蛋白质抑制下
一个蛋白质的转录(TetR 抑制 cI,cI 抑制 LacI,LacI 抑制 TetR)。报告质粒用于跟踪 TetR 浓度的振荡
Elowitz 等的基本网络涉及 3 个转录抑制蛋白,并将其组织成一个负反馈环路。为探究这个结构潜在的振荡行为,该小组构建描述 3 个基因的每一个多次改变蛋白质浓度的定量模型(动力学和随机)。这些模型涉及大量生物化学参数,包括翻译速率、mRNA 和蛋白质降解速率及转录速率对对应蛋白抑制子浓度的依赖。类似地,高蛋白质降解速率(相对 mRNA 降解)倾向于产生期望的谐振行为。这些模拟激励小组在 3 个抑制基因的每一个 3’ 端插入一个 C 端标签。这些标签会增加每个蛋白质的降解速率。按此,调节生物系统的参数与模型参数匹配。
为了在有机体内探索网络的行为,两个质粒被转入 E. coli 细胞:一个编码 3 个抑制蛋白,另一个包含抑制子控制下的绿色荧光蛋白(GFP)基因。通过检测荧光水平,该小组显示个别细胞的谐振周期为 150min(细胞循环周期的 3 倍)。
二、光传导中的单光子响应和钙介导反馈的重现性
下面讨论光传导中的单光子响应的鲁棒性问题。在视网膜中,杆状光感受细胞和锥状光感受细胞一起感光,再将信息传给大脑中的视皮层。视感细胞有非常特殊的几何结构。特别是感光细胞的外节片段由许多膜盘组成,这些膜盘都装载于光传导信号级联成分中。
杆状光感受细胞在感受一个单光子时产生一个固定的响应。早期,Baylor和他的同事注意到单光子响应有惊人的重现性,图9-13即为光传导途径的简略图。
将整个途径分成多个模块,单光子响应由受体激活与关闭控制。单个受体由单光子激活,被激活的受体被视紫红质激酶(RK)磷酸化,接着与抑制蛋白结合而关闭。被激活的视紫红质(R $^{}$ )激活多个G蛋白,G蛋白再刺激cGMP(环磷鸟苷)磷酸二酯酶(PDE)。被激活的PDE(PDE $^{}$ )降解第二信使cGMP,使其浓度降低,导致cGMP门控通道关闭,流量发生变化。两个由钙起作用的反馈循环值得注意。钙经过cGMP通道进入细胞,因此细胞内的钙浓度是一个关于流量J的函数。在一个循环中,用于合成cGMP的鸟苷酸环化酶(GC)受到鸟苷酸环化酶活性蛋白(GCAP)这种钙结合蛋白的调节。另一个循环中,视紫红质激酶受到该结合蛋白恢复蛋白的调节。
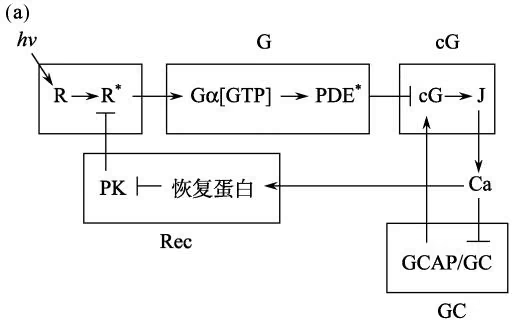
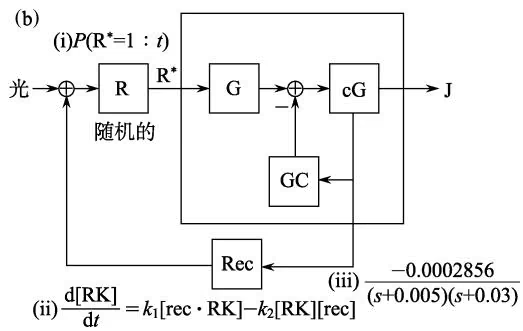
(a)路径被分成模块的示意图;(b)将路径的示意图换成数学模型
下面建立数学模型。给定时刻, $R^{}$ 的水平用一个概率函数 $P(i, t)$ 表示。许多 G 蛋白和 cGMP 磷酸二酯酶分子都由单个 $R^{}$ 激活。扩增之后,箭头指向的下一个物种的浓度能用常微分方程(ODE)表示。最后,通过线性变换函数近似某些方程。
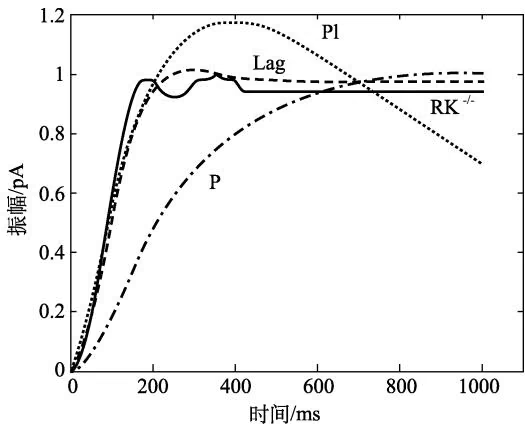
现在我们来看图 9-13 中方框(G、cG 和 GC)中的动力学。方框的输入是视紫红质分子的数量,输出是流量 J。我们的任务就是设计一个控制器,使由输入和系统成分的变化引起的输出变化最小。评价控制器的指标是鲁棒性、与实际数据的符合性和物理可行性。我们选择三种控制器,即比例控制器(P)、比例积分控制器(PI)和滞后补偿器(Lag)。比例控制器是将输出乘以一个常数再反馈到系统中;比例积分控制器是比例控制器和积分控制器的结合;滞后补偿器可看作可调的 PI 控制器。
图 9-14 中,实线表示 RK $^{-/-}$ 杆状细胞的单光子响应。采用比例控制器的系统输出呈现缓
慢上升,积分控制器的响应上升很快但最终回到零,只有滞后补偿器系统能与实际数据相符合。我们认为,钙介导的 GCAP 对 GC 的调节作用可被看作一个滞后补偿器来增强单光子响应的鲁棒性。
三、动态平衡和信号转导中的双相响应调节与正反馈及其应用
从细菌到人等各种不同的生物系统都需要保持动态平衡(保持内部环境不变的过程),并且需要对可能引起动态平衡瞬态变化的各种外部信号足够灵敏。其中,最常见的现象是信号转导途径中分子浓度维持在各自接收信号前的最优值。动态平衡还可进一步分成两类:①某个变量(如调节蛋白的浓度)可能会因为外部扰动引起瞬间的变化,但仍会维持在一定的水平,我们称该变量处于稳态,这种调节方式称为自动调节;②某个外部参数影响一个变量时,采用补偿的方式使变量最终返回稳定状态,这种调节适应称为动态平衡适应。
通常认为动态平衡适应调节的系统总是稳定的或自动调节的,所以自动调节是动态平衡系统的基本特征。下面介绍双相调节与正反馈结合的自动调节机制。其基本意思如下:第一种分子的激活促进第二种分子的激活;同时,第二种分子在活性低时会促进第一种分子激活,而在活性高时会抑制第一种分子激活(Levchenko et al., 2000)。
(一)双相调节-正反馈偶联理论
假设有两个描述系统的变量: $x(t)$ 和 $y(t)$ ,其表示为
$$
\left{ \begin{array}{l} \dot {y} = f (S, x, y) \ \dot {x} = g (x, y) \end{array} \right.
$$
式中, $\dot{x}$ 和 $\dot{y}$ 表示系统动态发展过程中 x 和 y 的变化;S 表示一个外部参数,它能影响 f 的性
质。假设 $x(t)$ 对 $y(t)$ 有促进和抑制两方面的作用(取值低时促进,取值高时抑制),而 $y(t)$ 对 $x(t)$ 只有促进作用。如果将 $x$ 固定为某个值 $x_0$ ,那么可以认为第一个等式最终发展为 $f(S, x_0, y_0) = 0$ 。如果我们现在计算与 $x_0$ 对应的所有 $y_0$ 值,就得到一个双相曲线 $y_0 = f^1(S, x_0)$ 。类似地,对所有固定的 $y^$ 值,可以得到曲线 $x^ = g^{-1}(y^)$ ,这条曲线的斜率为正。 $f^1(S_1, x_0)$ 和 $g^{-1}(y^)$ 被称为零渐变曲线,两条零渐变曲线在下降部分的交点就是系统的稳定状态(图9-15)。
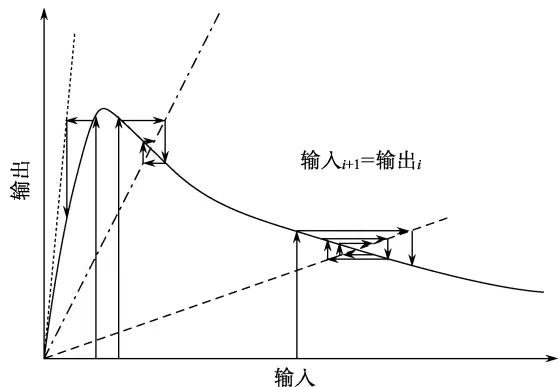
我们假定 S 的值不影响 f 的双相特性,并且只影响零渐变曲线 $f^{1}(S_{1}, x_{0})$ 的相对幅度和最大值的位置,我们还假设 $f^{1}(S_{1}, x_{0})$ 对 S 的依赖是处处单调的。
由图 9-16 可见,增加外部参数 S 使 $f^{1}$ 值增加。另外,图 9-16(a)中增加 S 使 $f^{1}$ 的最大值位置增大,图 9-16(b)中增加 S 使 $f^{1}$ 的最大值位置减小。从图 9-16(a)中可以看出,S 的增加,使系统的稳态响应从极低值逐渐变化到极高值。从图 9-16(b)可以看出,只有在足够高的 S 水平上才能产生分级的响应。而且,稳态响应作为 S 的函数,有一个明显的阈值。
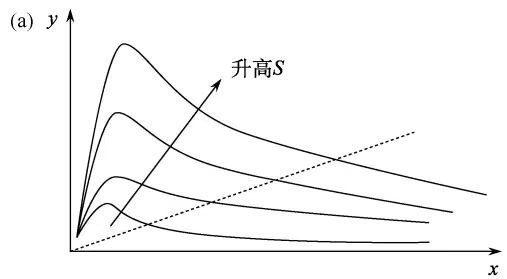
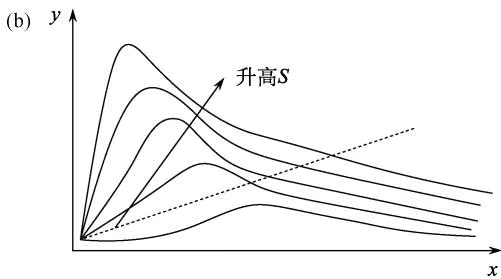
(a)在活动Ⅰ中随着零渐变群上升的方向,最大值增大;(b)在活动Ⅱ中随着零渐变群下降的方向,最大值减小。显然在活动Ⅱ中静止状态从(0,0)附近的低值变到高值的过程中有一个关于参数S的阈值函数
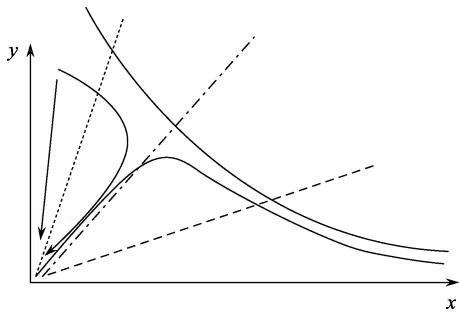
由于双相响应下降部分与简单的负反馈不易区分,我们下面讨论双相响应相对于负反馈的优越性。从图9-17中可以看出,双相响应中的稳定值不会超过一定上限,但是在负反馈机制下y的稳定值却可以任意大。此外,双相响应中对外部参数S的响应有明显的阈值,而负反馈机制则没有。还有,双相响应渐变曲线 $f^{1}(S,x_{0})$ 的上升部分的存在可能使响应外部扰动的x值呈一定峰值。
下面介绍 3 个例子,进一步说明双相调节-正反馈偶联理论在生物学中的应用。
(二)结合蛋白质的 TATA 框和转录调控
TATA 框是许多高表达真核基因启动子中主要的元件,位于转录起始位点上游 25~35bp 的区域。TATA 框的突变往往会引起转录速率的急剧下降。TATA 框是 TATA 结合蛋白(TBP)的结合位点。TBP 以单体形式与 TATA 框和其他调控因子相结合。同时,TBP 能够自己结合进行低聚,低聚体包括四聚体和八聚体。我们还不清楚 TBP 低聚反应是否会阻止它与 DNA 的结合,但是负责与 DNA 结合的 TBP 表面确实有两种低聚体形式。所以,可能是通过 TBP 低聚体与 TATA 框相结合来阻止 TBP 单体的调控作用。
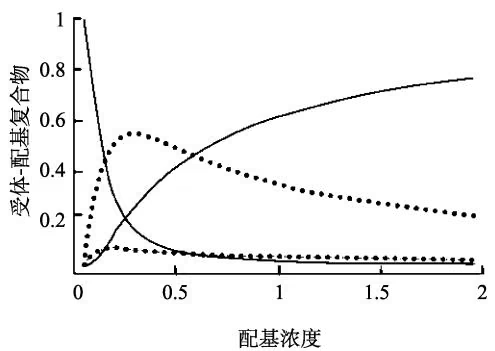
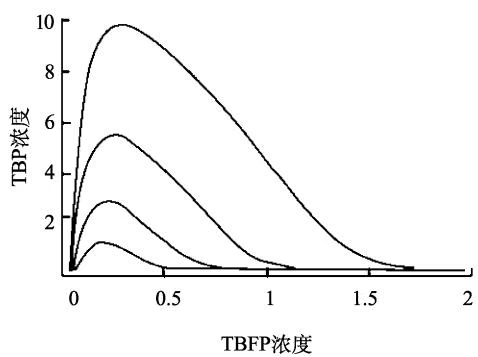
TBP 在转录起始中的重要作用表明它的表达被紧密调控。对 TBP 启动子中调控元件的研究揭示出一个 TATA 框和两个控制元件的存在,其中 TATA 框是基础转录所必需的,而两个控制元件是用于结合另一个转录元件——TBP 启动结合因子(TBFP)。两个控制元件中,一个是位于 TATA 框上游有较高亲和力的结合位点,具有激活转录的作用;另一个是位于 TATA 框和转录起始位点之间有较低亲和力的结合位点,具有抑制转录的作用。我们推测在第二个位点上的 TBFP 是起反作用的,因为它阻碍了 TBP 结合到 TATA 框上。TBP 可能对 TBFP 起正调控作用,所以呈现出 TBP 转录对 TBFP 浓度呈双相相关关系与 TBFP 转录对 TBP 浓度的正相关的结合。TBP 转录还受到包括 Ras 在内的外部信号的调控,所以 TBP 转录会受到外部参数的调节。由于 TBP 的表达需要维持在一定的水平范围,甚至在有激活信号(如 Ras)的情况下也一样,所以用双相调节-正反馈偶联解释最佳。如果使用负反馈调控,TBP 表达将无上限(图 9-18)。
(三)细胞质内 $Ca^{2+}$ 浓度的调节
由 $Ca^{2+}$ 激活的 $Ca^{2+}$ 释放是通过内质网中对三磷酸肌醇( $IP_{3}$ )和 Ryanidine 受体(RyR)敏感的 $Ca^{2+}$ 通道来调节的。 $IP_{3}R$ 的开放概率是一个关于细胞质内 $Ca^{2+}$ 浓度的双相曲线函数,在 $Ca^{2+}$ 浓度低时,通道被活化;在 $Ca^{2+}$ 浓度高时,通道被去活化。在这种情况下,当受体的4个单体中都出现高亲和力激活和低亲和力抑制的 $Ca^{2+}$ 结合位点时,双相调节产生。 $IP_{3}R$ 的开放概率受 $IP_{3}$ 的浓度和 ATP 调节。增加 $IP_{3}$ 将使最优值位置正移,并且使开放概率的最大值增大。 $IP_{3}$ 的作用在于它能变构地降低 $Ca^{2+}$ 对抑制位点的亲和力,但是保持对激活位点亲和力不变。通过降低 $Ca^{2+}$ 对激活位点的亲和力可以使最优值位置负移,从而增加 ATP 的浓度。
有报道指出,在 $IP_{3}$ 处于低浓度和高浓度水平时, $Ca^{2+}$ 是稳定的,并且以分级的方式与 $IP_{3}$ 相关,而在 $IP_{3}$ 浓度处于一个中间范围时则能导致 $Ca^{2+}$ 上下波动。图 9-19 利用反馈曲线的非单调性解释了这一行为。在反馈变为负反馈的区域中,稳定状态失稳,并且可能发生上下振动。在正反馈区域中,所有的状态均是稳定的,并且响应是分级的。
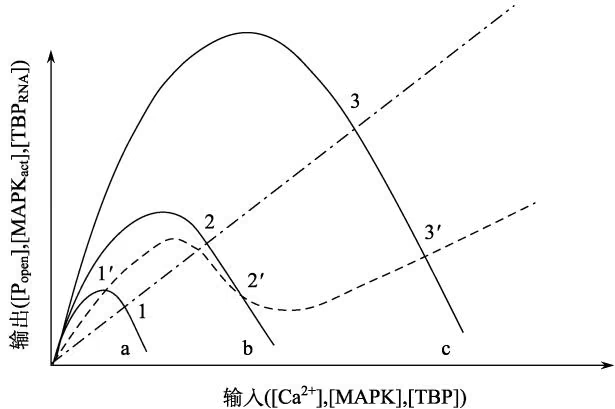
另外,易兴奋细胞在受到各种各样能瞬时增加细胞质 $Ca^{2+}$ 浓度的因子刺激后,则可频繁观察到瞬态响应峰值。峰值响应只可能当外部参数 S 为某些值时才产生。在 $Ca^{2+}$ 调控中,只有当 $IP_{3}$ 的浓度在某个范围内时,才可能产生响应峰值和振动。如果使用简单的负反馈调节,就不可能产生响应峰值。
(四)MAPK 浓度的调节
丝裂原激活的蛋白激酶(MAP 激酶,MAPK)级联是由 3 个顺序起作用的激酶组成的。级联中最后一个成分 MAPK 在酪氨酸和苏氨酸残基处双磷酸化后被级联的第二个成分 MAP 激酶激酶(MAPKK)激活。MAPKK 在苏氨酸和丝氨酸残基处双磷酸化后被级联的第一个成分 MAP 激酶激酶激酶(MAPKKK)激活。两个磷酸化反应是通过激酶和它的作用物的完全分裂而分开的。从理论上和实验上,得到 MAPKK 和 MAPK 活性的分布特性导致信号转导输出是基于这些激酶浓度的双相相关性。简单地说,在酶的底物浓度高时,由于激活酶的饱和性,没有被激活的酶底物(MAPK)不能使第二个酶作用物磷酸化。
通过以上3个例子,我们描述了两种分子相互作用之间双相调节-正反馈偶联产生普遍的自动调控和信号响应的机制。虽然负反馈调节在很长时间里被认为是维持动态平衡中自动调节的方式,但是在这里我们发现双相调节-正反馈偶联可以代替简单的负反馈,这种替代能对某些调节进行改善。尤其是双相响应最大值的存在意味着对系统的稳定状态的激活有一个上限,而简单的负反馈能使系统的响应几乎有一个实际无穷大值。所以双相调节-正反馈偶联在动态平衡中对确定和维持适当的活性值是至关重要的。双相调节-正反馈偶联的另一个优点是能产生出峰值响应或可刺激性。这个特性大量应用于 $\mathrm{Ca^{2+}}$ 调控的细胞中,其中由 $\mathrm{Ca^{2+}}$ 引起的 $\mathrm{Ca^{2+}}$ 响应对各种神经刺激或肌肉伸缩过程是重要的。
第七节 蛋白质 - 蛋白质相互作用网络
一、蛋白质相互作用网络的基本概念及性质
长期以来,人类已经积累了大量关于生物大分子的知识。随着研究的进一步深入和生物技术的发展,研究兴趣正逐渐从单个分子转向分子间的相互作用,以及由它们所形成的复杂网络。特别是近年来,大规模高通量蛋白质组技术的发展和应用,使得蛋白质相互作用数据呈指数增长。细胞系统可以看作是由基因、蛋白质和小分子之间复杂的相互作用形成的网络,后基因组时代生物学的最重要任务就是从网络水平理解细胞内的生物学过程或功能。网络生物学的目标就是通过分析生物网络的拓扑学结构和动力学特性,去认识生命现象,了解生命构建、运作和进化的原理。由于生物网络的大规模、复杂性和非线性,可以说分子网络的研究中不但充满了机遇,也充满了挑战。
网络是一个图,是节点和连接节点的边的集合。节点可以是分子、基因或蛋白质,边是分子相互作用、遗传相互作用或其他的两个元素之间的关系(图 9-20)。
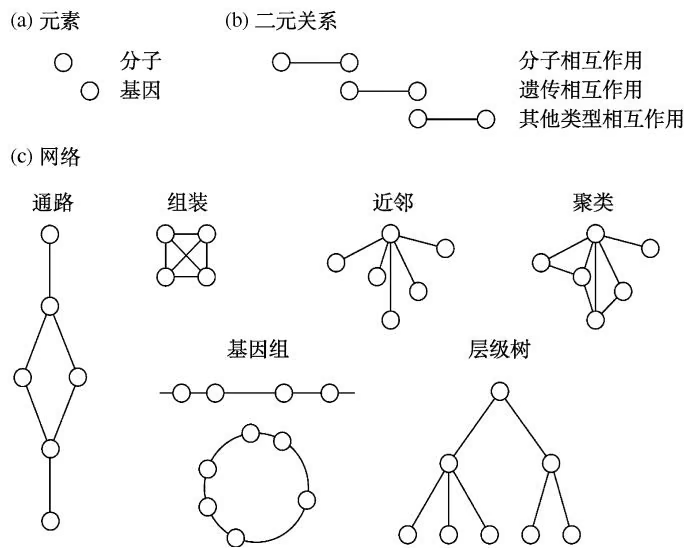
网络包括一组元素(节点)和一组二元关系(边)
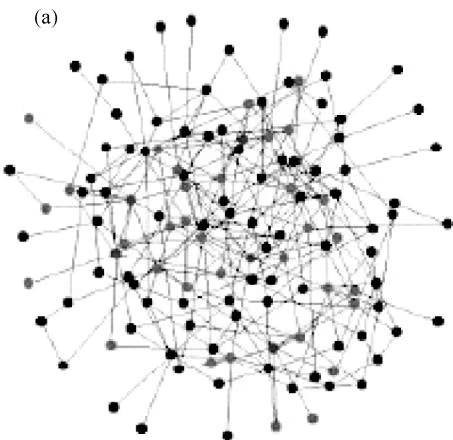
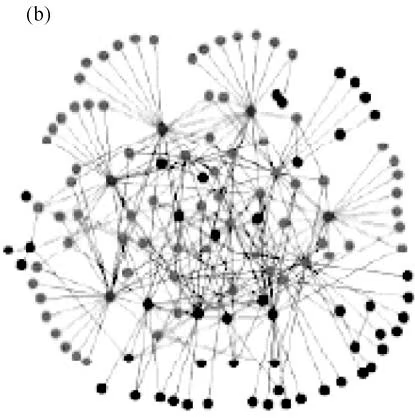
除正规网络结构外,网络从结构上还可分为随机(指数式)网络和无标度网络(图9-21)。传统的随机网络(如ER模型),尽管节点连接是随机设定的,但大部分节点的连接数目会大致相同,即节点的分布方式遵循泊松分布,有一个特征性的“平均数”。连接数目比平均数高许多或低许多的节点都极少,随着连接数的增大,其概率呈指数式迅速递减。故随机网络亦称指数网络。而无标度网络是1998年Barabasi等在研究WWW网络结构时意外发现的:WWW网络基本上是由少数高联通性的页面连接组成的, $80%$ 以上页面的连接数不到4个,而占节点总数不到1/10000的极少数节点,却和1000个以上的节点连接。网络的连接分布不见随机网络具有的“平均数”特征,而是遵循了“幂次定律”分布,即:任何节点与其他 $k$ 个节点相连接的概率正比于 $k^{-\lambda}\left[P(k) \sim k^{-\lambda}\right]$ ,于是他们把这种网络称为“无标度网络”。可见,无标度网络是不均匀的,大多数节点只有一个或两个连接,但少数节点有大量连接,从而保证系统是全部连通的。这种高联通度的节点(蛋白质)称为Hub,它作为网络中的枢纽,在生物的进化与维系相互作用网络的稳定性等方面有着不可替代的作用,这些蛋白质往往参与重要的生命活动,并发挥关键的生物学功能。分析表明,一个蛋白质参与的相互作用越多,这个蛋白质对细胞的生存也就越重要。而无标度的拓扑组织方式似乎增加了系统的稳健性,使得整个网络在部分组件出现问题或者环境改变甚至遭受外来攻击时,能够尽最大可能地保持稳定性。显然,由于绝大部分的节点只拥有少量的连接,在一般情况下被影响的节点都是这些连接度少的节点,也就是非致命的节点,即使它们出问题也不会波及太大的范围,除非扰动过大或者是度很大的节点或重要节点遭到破坏。但对Hub的袭击可能导致网络坍塌,因此,可以推测Hub进化应更慢一些。

二、蛋白质相互作用网络实例
(一)幽门螺杆菌蛋白质相互作用网络
人类胃肠道病原菌幽门螺杆菌(Helicobacter pylori)是螺杆菌的一个种类,其基因组序列早就测序完毕,大约包含1590个潜在的蛋白质或ORF。Rain等使用酵母双杂交策略从编码基因组多肽文库中筛选了261个蛋白质,共计有1200个相互作用(大约占全蛋白质组相互作用的 $46.6%$ )。他们发展了称为PIMRider的软件,可以实现图示及基于网络图的功能分析。
初步分析表明,功能相关的基因编码的蛋白质容易发生相互作用。例如,与细菌趋向性相关的几个蛋白质 CheA、CheW、CheY 及 TlpA 处于一个局部子网络中,CheA 与 CheW 和 CheY 相互作用、TlpA 与 CheW 相互作用。其他如 HypE 和 HypF、ScoA 和 ScoB、RpsR 和 RpsF、MoaE 和 MoaD、FtsA 和 FtsZ 等功能上相关的蛋白质对之间也有相互作用。
(二)酵母蛋白质相互作用网络
Uetz 等(2000)用酵母双杂交技术识别酵母(Saccharomyces cerevisiae)中由基因组序列预测的 ORF 中的蛋白质-蛋白质相互作用,发现涉及 1004 个蛋白质的 957 个相互作用。结果表明,相互作用的蛋白质往往涉及同样的生物学功能,各类功能蛋白的链接进一步形成大的细胞过程。后来该研究小组的进一步工作涉及 1548 个蛋白质的 2358 个相互作用,表明功能、亚细胞定位相近的蛋白质易聚集在一起,63% 的相互作用发生在功能相近的蛋白质之间,76% 的相互作用发生在同样的亚细胞定位之间(Schwikowski et al., 2000)。
Jeong 等(2001)利用 1870 个蛋白质、涉及 2240 个相互作用构建了酵母蛋白相互作用网络(图 9-22)。研究表明,网络属无标度网络,节点连接度服从幂律分布, $p(k) \sim k^{-\gamma}$ , $p(k)$ 为节点联系 k 个蛋白质的概率。
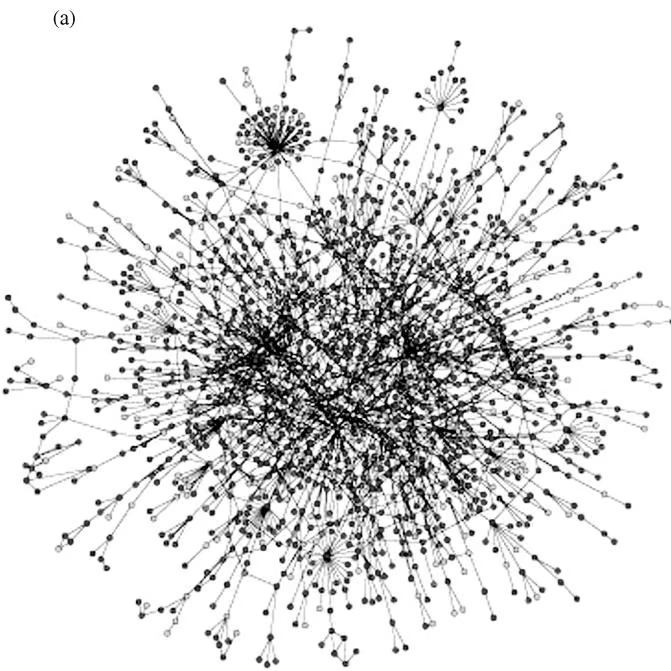
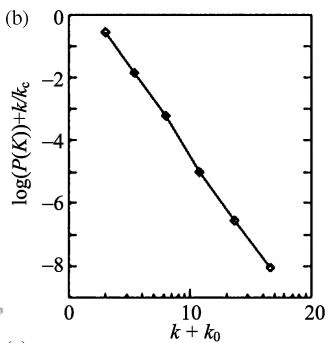
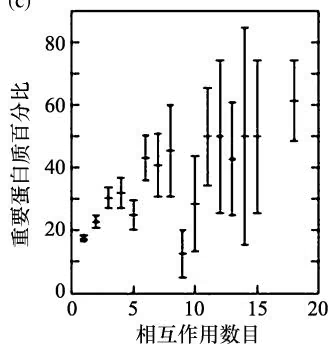
(a)酵母的蛋白质相互作用网络。节点表示酵母蛋白质,边表示蛋白质之间的相互作用;(b)酵母蛋白质相互作用网络的度分布,即蛋白质参与的相互作用数目的分布情况,横坐标为蛋白质的度,纵坐标为网络中具有该度的蛋白质的比例,该图是拟合结果;(c)酵母蛋白质的度与其功能重要性之间的关系,横坐标是蛋白质所参与的相互作用数目,纵坐标给出了具有对应度的酵母蛋白质中有多少是重要蛋白
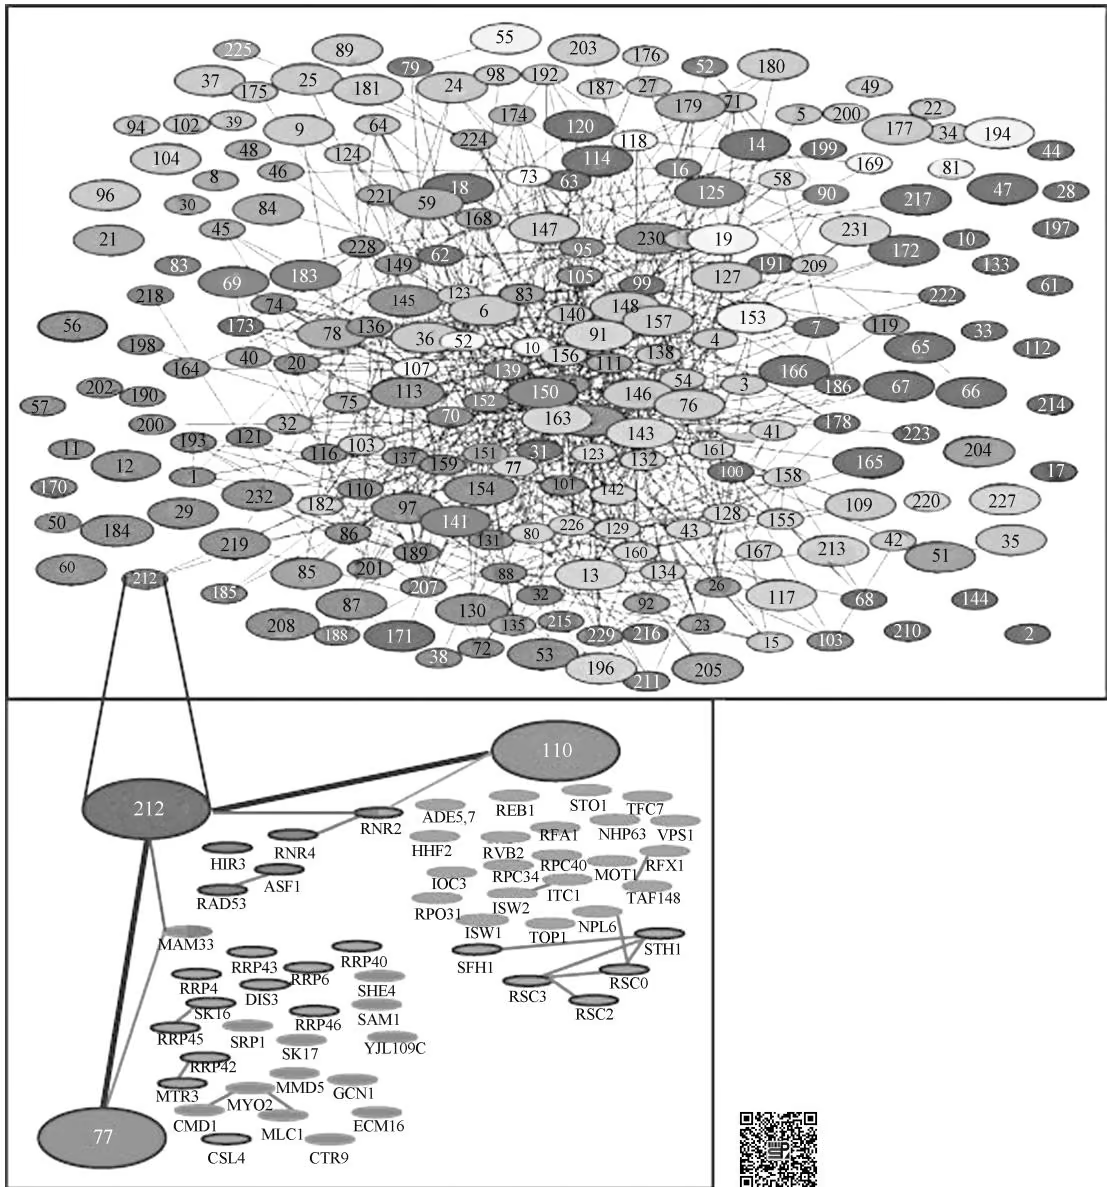
Gavin 等(2002)利用串联亲和纯化和质谱技术分析研究酿酒酵母的多蛋白复合体,共分析 1739 个基因(图 9-23),其中与人类相关的直系同源物 1143 个;纯化了 589 个蛋白质,分属 232 个不同的复合物。
研究发现了 344 种蛋白质的新功能,其中有 231 种是以前未报道过的。不同颜色表示蛋白质复合物在细胞中的作用,如细胞周期、信号转导、转录、DNA修复、染色体结构、蛋白质和RNA运输、RNA代谢、蛋白质合成和周转、细胞极性和结构及能量代谢的介导等。
Ho 等(2002)使用高通量质谱蛋白复合体识别(high-throughput mass spectrometric protein complete identification,HMS-PCI)分析研究酿酒酵母。他们选择了 725 种不同功能的蛋白质作为诱饵,其中包括 100 种蛋白激酶、36 种磷酸酶及亚基、86 种涉及 DNA 损伤的修复蛋白等,共发现 3617 种蛋白质相互作用,重点研究信号转导和 DNA 损伤修复相互作用网络。
图 9-24 是 DNA 损伤修复相关蛋白质相互作用网络,涉及细胞周期过程、转录、蛋白质降解和 DNA 修复本身等过程。网络整体上由已知和新相互作用子集构成,包括 86 个 DNA 损伤修复相关蛋白。蓝色箭头表示已知的相互作用,红色箭头表示新发现的相互作用。Ho 等的工作表明,与 DNA 损伤修复相关蛋白确实包含了许多蛋白复合体。例如,RFC(复制因子 C)
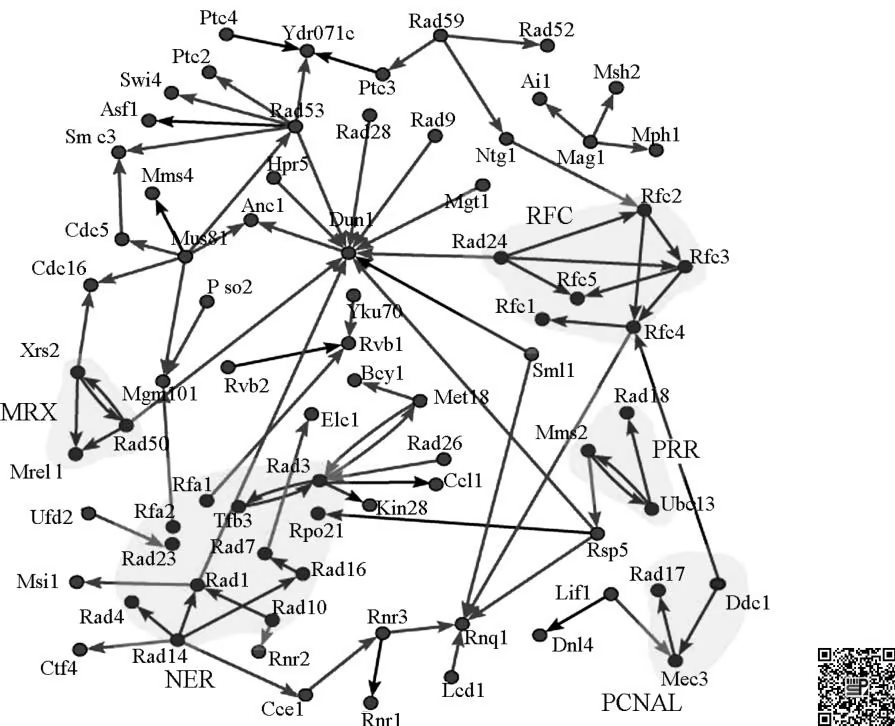
复合体由 Rfc1、Rfc2、Rfc3、Rfc4 和 Rfc5 间相互作用组成;PCNAL 复合体由 Mec3、Rad17 和 Ddc1 组成,其主要功能是传递损伤信息;PRR(后复制修复)复合体由 Mms2、Ubc13 和 Rad18 组成;MRX 复合体由 Mre11、Rad50 和 Xrs2 组成,主要负责介导同源双链修复;NERo 复合体也在已知的核酸切割修复中出现,涵盖了多个小的复合体 NEF1(Rad1-Rad10-Rad14)、NEF3/TFIIH(Rad3-TFB3-Kin28-Ccll)和 NEF4(Rad7-Rad16)。
(三)线虫蛋白质相互作用网络
秀丽隐杆线虫(Caenorhabditis elegans)是第一个进行全序列分析的多细胞生物,是研究蛋白质相互作用网络的理想模式生物,已测序列长97Mb,含有19099个编码蛋白质的基因。Li等(2004)采用高通量酵母双杂交系统技术检测4000种蛋白质的相互作用,同时用共亲和纯化试验进一步检验双杂交数据。目前,蠕虫相互作用组(WI5)含有约5500种蛋白质的相互作用,绘制成的相互作用网络如图9-25所示。
(四)果蝇蛋白质相互作用网络
黑腹果蝇(Drosophila melanogaster)是高等真核生物遗传学研究的经典材料,基因组大小为 180Mb,有 13601 个编码蛋白质的 ORF。
Giot 等(2003)用酵母双杂交系统研究果蝇的蛋白质相互作用,对 13 601 种 ORF 进行 PCR,并且对果蝇胚胎期和成蝇期的 cDNA 文库中的各种 cDNA 片段分别插入诱饵载体和猎物载体,获得庞大的克隆。随后进行双杂交测试,选出二倍体带有标记的阳性克隆,进行序列分析,得到 7048 种蛋白质,共计 20 405 种相互作用,并将其绘制出一张复杂的网络图。
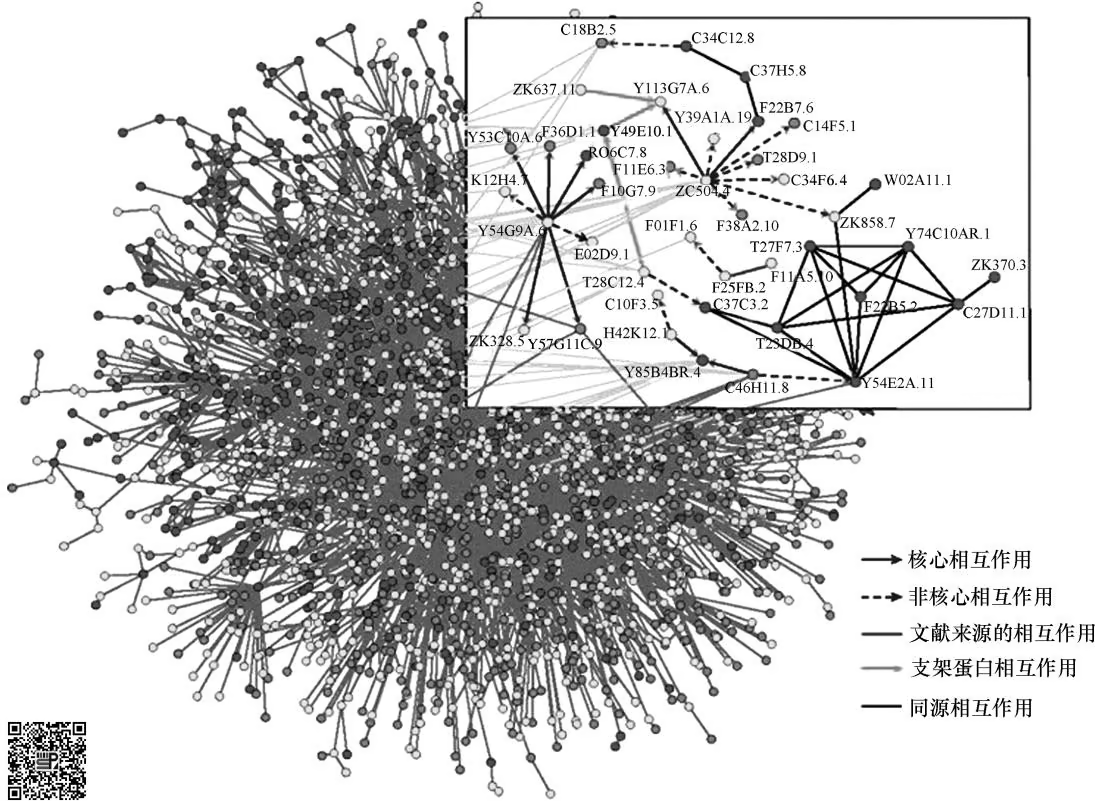
图中节点(蛋白质)按其种系发生类给以不同颜色
Uetz 和 Pankratz(2004)以酵母双杂交系统研究果蝇蛋白质相互作用,并将研究结果与其他物种(酵母、人)的蛋白质-蛋白质相互作用网络比对,发现有些蛋白质相互作用途径在进化上是十分保守的。
(五)人类蛋白质相互作用网络
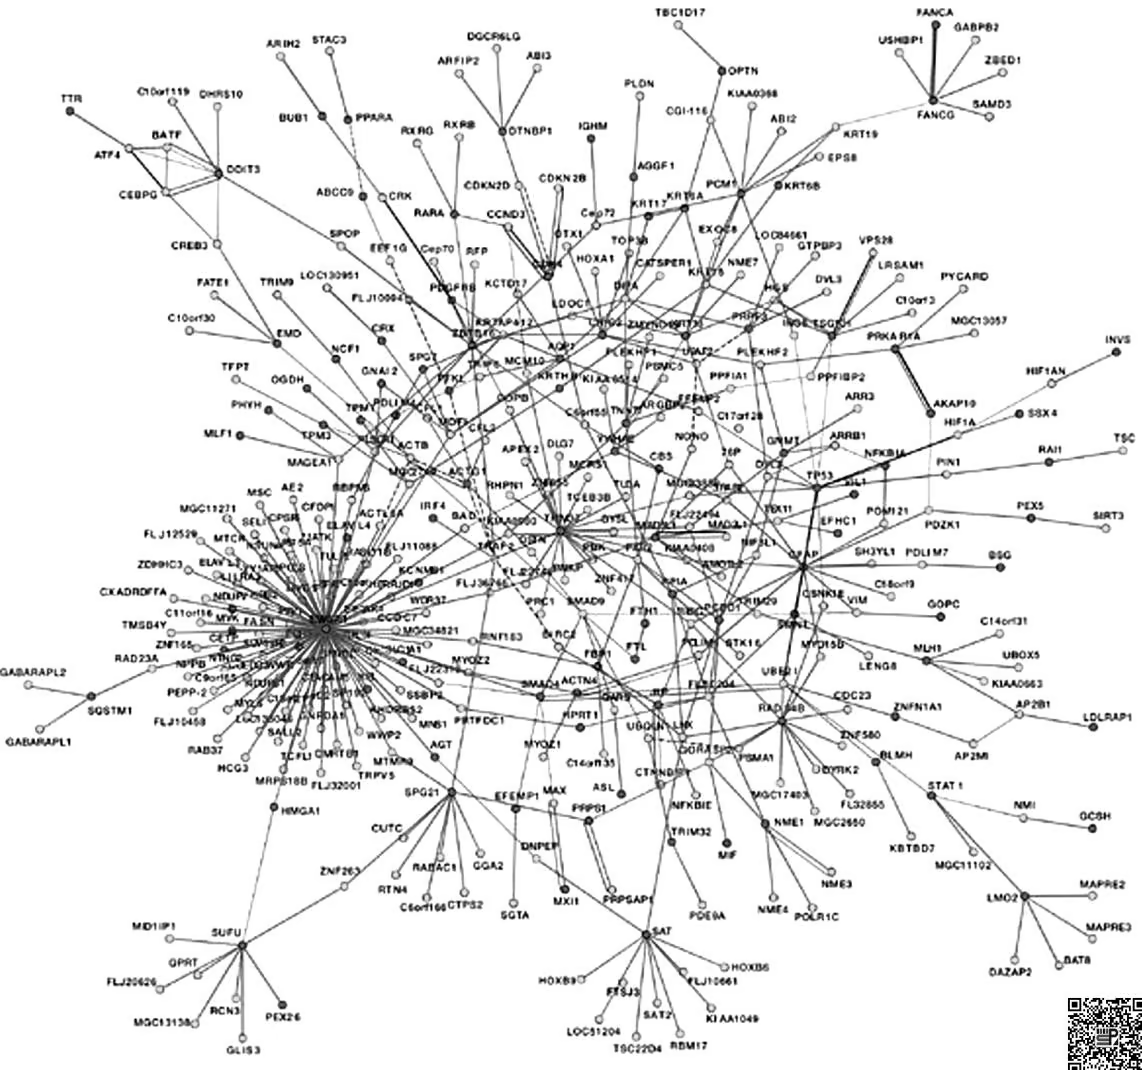
人基因组大小为 3.164 7Gb,估计含有约 2 万个基因。Raul 等(2005)借助高通量酵母双杂交系统技术从约 8100 个用 PCR 扩增出的 ORF 产物中检测到相互作用约 2800 个,绘制的蛋白质相互作用网络图见图 9-26。
三、基于相互作用网络的功能分析
有了相互作用网络之后,重要的任务就是如何在网络层面理解生物学过程及生物分子的功能。已有一些工作试图从网络的基本组成单元——网络模体、网络主题的研究等方面探讨生物学功能,以下将对这些内容做一概括性介绍。
网络模体用来描述网络中比随机网络更多出现的连接模式,是复杂网络的基本构件。可以对网络模体(motif)定义如下:“网络模体是网络中不同位置重复出现的节点组合的特殊拓扑结构”。网络模体概念可以拓展到由多种相互作用组成的整合网络,这种模体表征局部网络近邻中不同生物学相互作用的关系。同一类模体组成的更加复杂的结构称为网络主题(theme),网络主题与特定的生物学功能相关。如果把网络主题约化为一个节点而形成的简约图就是主题图(thematic map)。
(一)蛋白质相互作用网络模体分析
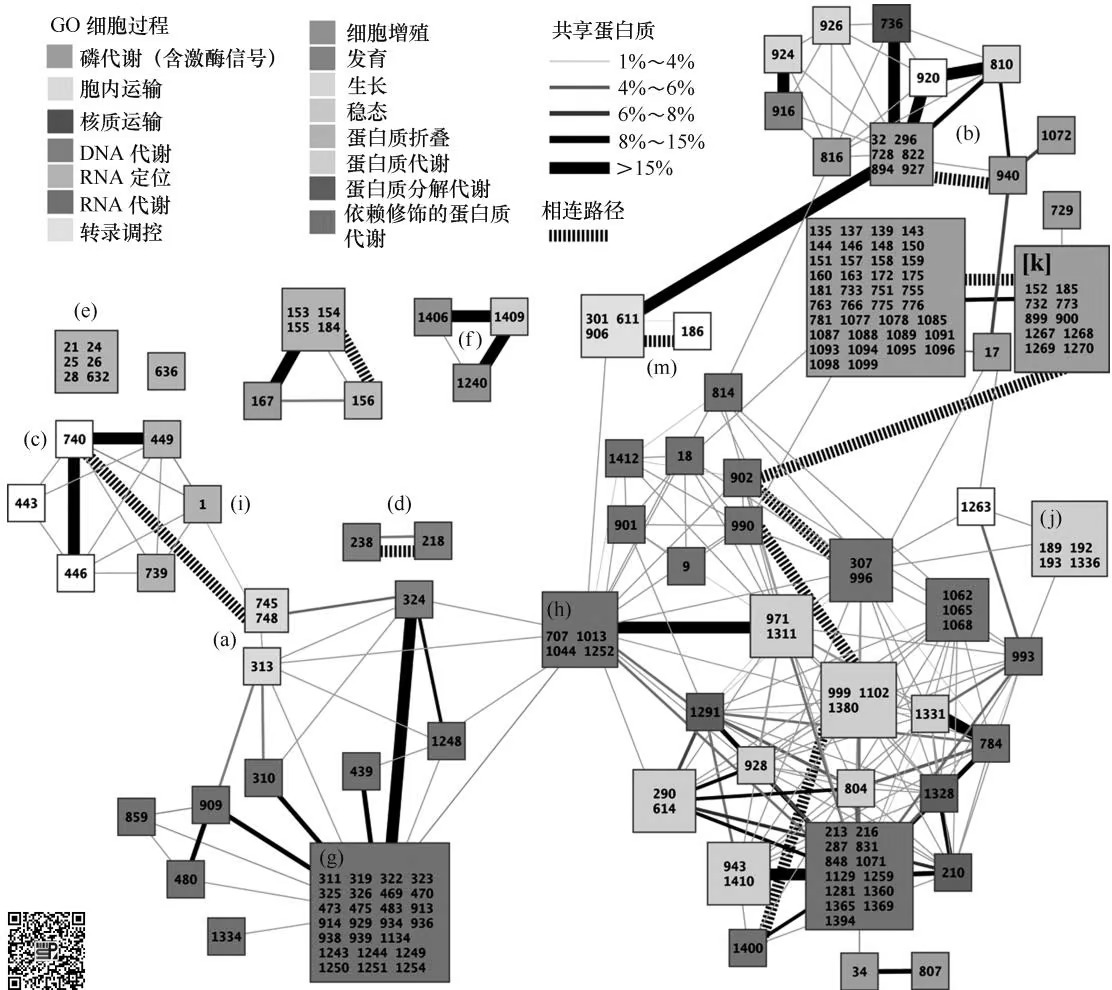
Sharan 等(2005)比较了线虫、果蝇和酵母蛋白相互作用网络,相互作用数据取自 DIP 数据库,包含酵母 4389 个蛋白质、14 319 个相互作用,线虫 2718 个蛋白质、3926 个相互作用,以及果蝇的 7038 个蛋白质、20 720 个相互作用,结果识别出跨物种保守的 183 个蛋白簇及 240 个途径,涉及蛋白质 649 个。
图 9-27 显示跨物种保守的蛋白簇和途径的整体图。由图 9-27 可以看出,网络呈明显的模块化特点,可分成 71 个不同的区域,每一区域只与特定的生物学功能相关。最大的保守簇涉及蛋白质降解(右下角)、RNA 多聚腺苷酸化和剪接(左下角),以及蛋白质磷酸化和信号转导(右上角)。其他区域涉及 DNA 合成、核-细胞质输运和蛋白质折叠。图 9-27 中也显示了不同模块之间有保守的连接。
在同一蛋白簇中蛋白质有相同或相似功能的假设下,我们可以预测新蛋白质的生物学功能。共计预测了酵母的 176 个、线虫的 1139 个和果蝇的 1294 个以前未见功能注释的蛋白质的功能。
Lee 等(2006)研究了酵母的 4738 个蛋白质、1129 个相互作用形成的网络,发现网络中大多数保守模体可分为 3 节点、4 节点,共计 8 种形式的网络 “模体”(图 9-28)。如果定义进化上完全保守的模体数占总模体数的百分比为网络模体保守分数,发现同一模体下,不同模式的进化是有差异的。
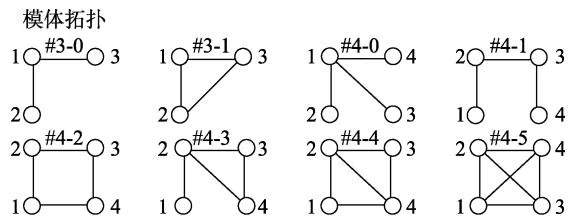
(二)整合生物网络模体、主题分析
生物学过程往往涉及诸如蛋白质相互作用、遗传相互作用、转录-调控、序列同源及表达相关等形式的多种相互作用。如果单独研究每一种网络,可能会丢掉许多涉及它们之间结合产生的过程或功能,我们有必要发展包含多种相互作用的整合生物网络,并研究它们的模体特征。
Yeger 等(2004)分析了由转录-调控和蛋白质相互作用两种类型组成的整合网络,结果显示,网络中模体大多为 2、3、4 节点模体,说明网络主要由小网络模体组成,可以把它们视为网络的基本构件。文中用黑色双向带箭头边表示蛋白质-蛋白质相互作用,用红色单向带箭头边表示转录-调控(由转录因子指向目标基因)。如果模体出现次数超过 5 次,即可被视为模体。结果发现:①可能的 2 蛋白模体共有 5 种,网络中只发现了混合-反馈环模体;②可能的 3 蛋白模体共有 100 种,网络中只发现了包括蛋白环、相互作用因子调控第 3 个基因、由转录-调控组成的向前反馈环、共调控相互作用蛋白和混合反馈环 5 种模体;③可能的 4 蛋白模体超过 4000 种,网络中发现有 63 种。
Zhang 等(2005)以酵母网络为例,考虑了 5 种类型的相互作用,定义了网络主题的概念,并明确区分了网络模体、网络主题概念上的不同(图 9-29)。蛋白质相互作用可以是直接的物理作用(简称蛋白质-蛋白质相互作用),也可以是遗传作用,还可以是合成致病或致死(SSL)。另外,2 基因可通过转录、序列同源或表达相关等方式作用。工作中使用了 3066 个 SSL 相互作用、40 438 个蛋白质序列同源关系、57 367 个关联 mRNA 表达关系、49 537 个蛋白质相互作用和 4357 个转录调控相互作用(TRI)。整合网络中包含 5831 个节点、154 759 个相互作用。正像小世界网络特征一样,它们发现大量 3 节点连接模式。
共发现的50个3节点模体,进一步分成7个子集(图9-29)。第1个模体子集是转录前馈模体,例中Swi4和其转录活化子Mcm1一起调控大量细胞循环相关基因。总结为向前反馈主题,表示有一对转录因子,其中一个调控另一个,然后共同调控目标基因。第2个模体子集是共点模体,目标基因由两个通过物理或序列同源相互作用的转录因子调控。例中Hap2、Hap3、Hap4和Hap5形成CCAAT结合因子复合物,共同调控大多涉及碳氢化合物代谢的目标基因。第3个模体子集由同一转录因子调控、由关联表达、蛋白质相互作用或序列同源联系的两个目标基因,称为调控复合物主题。实例中组蛋白八聚体Hhf1、Hhf2、Hht1、Hht2、Hta1和Htb1共同由Hir1和Hir2调控。第4个模体子集由涉及蛋白质相互作用或关联表达的4个3节点模体组成,称为蛋白质复合物主题,主要实例是ATP合成酶复合物。第5个模体子集包含由SSL或序列同源关系联系的3节点模体,称为整合SSL/同源网络近邻簇主题,实例为Myo2和有SSL或序列同源联系的大量与Myo2联系的基因。第6个模体子集描述两个节点通过SSL或序列同源联系,第3个节点通过PPI或关联表达与这两个节点联系,称为补偿复合物主题,实例为Ssn8和Cdc73由RNA聚合酶Ⅱ复合物联系。第7个模体子集中,其中两个节点由PPI或表达关联联系,第3个节点通过SSL或序列同源与这一节点联系,称为补偿蛋白和复合物/过程主题。
约有 5000 个 4 节点网络模体,图 9-30 为对应于 “补偿蛋白和复合物 / 过程” 主题的 4 节点模体。每一模体由两对节点组成,成对节点之间由 PPI 或表达关联联系,两对之间由 SSL 或序列同源联系。
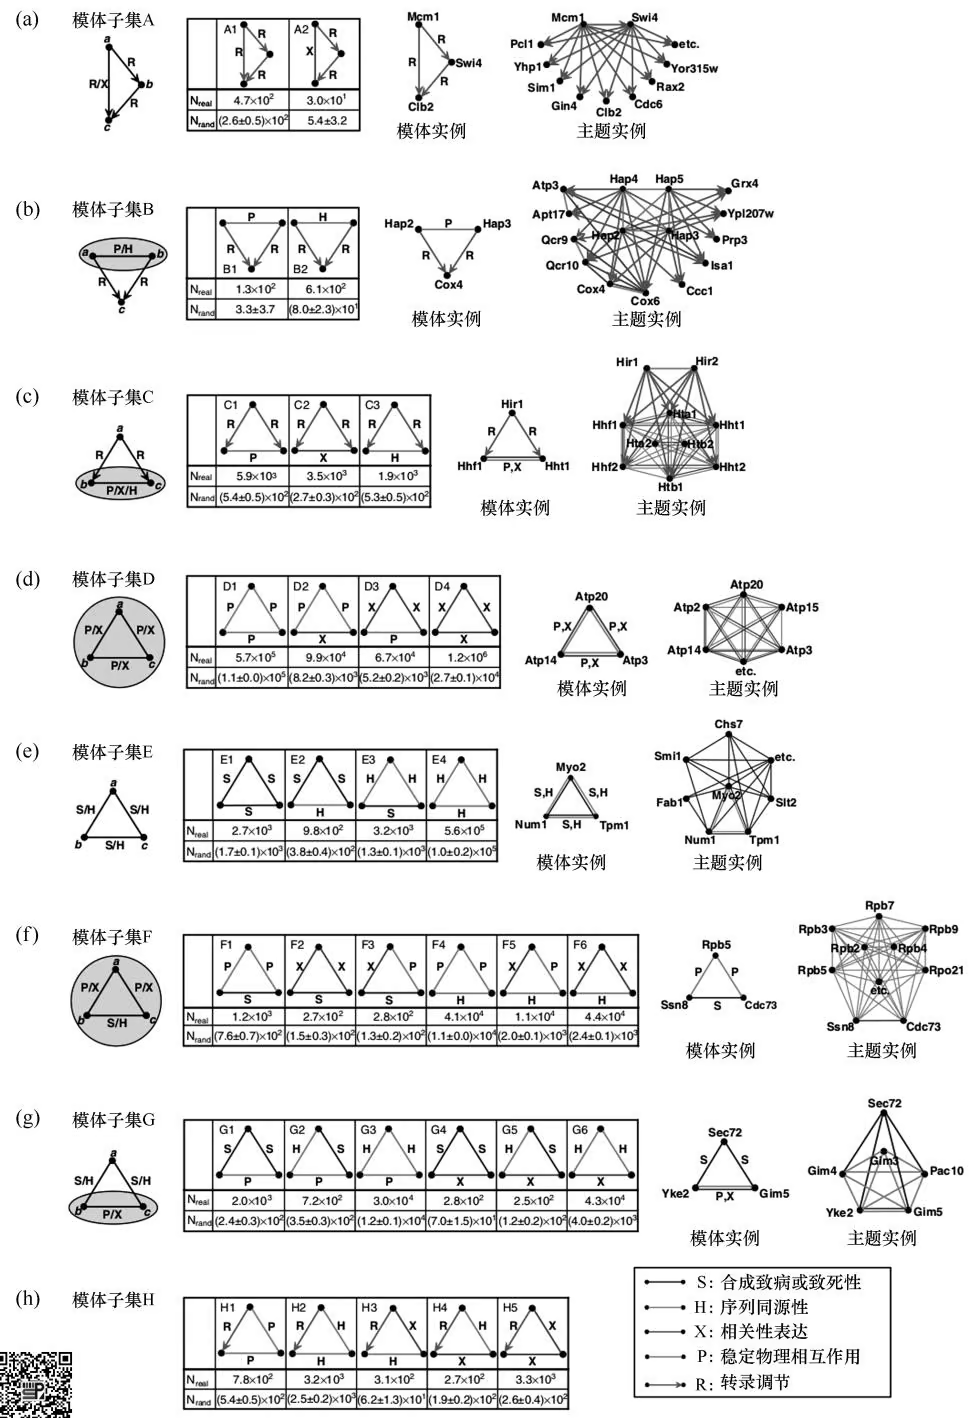
图中从左至右依次为模体子集、模体统计学列表、模体实例和形成的网络主题实例,每一种颜色的连线表示5种相互作用类型的一种,注解见右下角。(a)向前反馈主题;(b)共点主题;(c)调控复合物主题;(d)蛋白质复合物主题;(e)整合SSL/同源网络近邻簇主题;(f)补偿复合物主题;(g)补偿蛋白和复合物/过程主题;(h)其他未分类主题
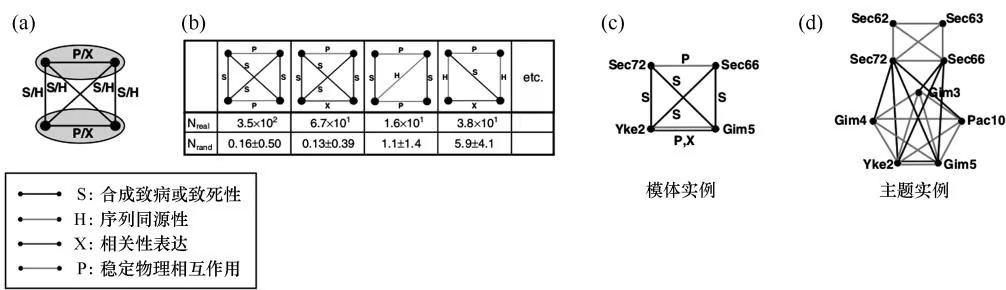
(a)~(d)依次为模体、模体统计学列表、模体实例和形成的网络主题实例
第八节 虚拟细胞
系统生物学结合先进的测量技术及大规模生物网络建模与分析,建立“虚拟细胞”(virtual cell)是学科发展的长远目标和必然趋势。
虚拟细胞亦称为人工细胞(artificial cell)或电子细胞(e-cell),它是在实验数据及理论的基础上,结合生命科学、计算机科学、数学等学科的原理和技术,对细胞的结构和功能进行分析和整合,构建的一种对细胞内外部生命活动现象及过程进行模拟和预测的虚拟系统,以期探索细胞生命活动的潜在规律(Tomita,2001;Palsson,2000)。因此,虚拟细胞亦称人工细胞或人工生命。解析并建立一套细胞工厂和生物纳米机器将成为科学家奋斗的目标(张先恩,2008)。
一般认为,虚拟细胞主要由4部分组成:控制界面,计算机存储、分析和控制系统,数学计算系统,反应界面。其构建过程一般要经过生物数据收集、整理,数据的计算分析,向虚拟细胞数学模型的转化,以及虚拟细胞的测试和维护。虚拟细胞构建是十分复杂的,不同的细胞、不同的虚拟对象和实现的功能,其构建的形式有很大差异,需要反复验证和不断完善。以虚拟细胞为平台和工具,借助于强大信息处理能力的计算机辅助人脑进行工作,不但可以使人们更好地掌握和利用细胞生命活动的规律和知识,创造人工生命,加速生命科学和信息科学的发展,改变人类生活和生存环境,而且必将成为医学、生物学、药学、营养学、生态、环境、农业等学科研究和产业领域中不可替代的工具(冯团诚和庄南生,2007)。
目前世界上比较著名的有两种虚拟细胞:① E-CELL,一种原核细胞能量代谢的模型,是Masura Tomita领导的研究小组于1997年在日本Keio大学成功地建立的世界上第一个虚拟细胞模型;② Virtual Cell(Schaff et al., 1999),一种真核细胞钙转运的模型,是美国康涅狄格大学Leslie M. Loew和James C. Schaff领导的研究团队于1999年建立的。由于虚拟细胞的强大功能和应用前景,虚拟细胞模型如雨后春笋不断地被研究人员开发出来,如Cyber-Cell、Karyote、CellX、RouletteCyte、VirusX、M3、JigCell、Mcell、BioNetGen、SysBio-OM、In Silico Cell、CELLmicrocosmos等。
第九节 生物学网络的构建、分析与可视化
网络天然存在于生物学系统中,如信号转导网络、基因调控网络和代谢网络等。对复杂网络的研究不仅能帮助寻找关键节点,也是对生物学系统整体的探索。如今,海量多组学数据的生成提供了前所未有的大量关系数据,网络分析已经是生物信息学研究中不可或缺的重要手段。
生物学网络脱胎于图论,以结构、关系、路径等拓扑性质为特征,是一种用网络图像体现关系模型的方法。生物学网络可用来研究多种类型的关系数据,如不同分子之间的结构相似性关系;药物-靶点之间的靶向关系;不同基因之间的共表达关系;不同类型RNA之间的调控关系等。生物学网络的研究是现代系统生物学重要的组成部分,也是目前相对最成熟的领域。本节将以最常用的网络软件Cytoscape为例,介绍网络构建、分析及可视化的方法。
一、Cytoscape 简介
Cytoscape 是由美国西雅图系统生物学研究所开发并于 2002 年发布的开源软件,主要用于分子互作网络可视化和复杂网络分析。目前软件的最新版本是 3.9.0。Cytoscape 可以运行在各种操作系统平台上。官方网址:http://cytoscape.org/。
Cytoscape 需要在 Java 运行环境的支持下使用,因此在安装 Cytoscape 之前,用户的计算机应具备 Java(https://java.com)。Cytoscape 提供了不同操作系统平台的安装包下载,可以按照自己操作系统的配置选择对应版本下载安装。
相比于其他网络可视化软件,Cytoscape 的优势体现在:操作丰富,包含大量插件,支持多种格式的导入与导出,并且能良好支持生物数据专用的文件格式(如 SBML)。Cytoscape 在系统生物学领域的应用尤为突出,并且可以应用于生物学之外的领域,它还提供了官方 JavaScript 库用于网页开发。而同样有类似特性的软件包括 R 和 Gelphi。但是它们相对于 Cytoscape,不足在于:R 主要面向统计计算,要进行网络分析和可视化,需要安装一些第三方的软件包,并且它完全由命令行输入代码操作,需要使用者有一定编程基础;而 Gelphi 并非针对生物学网络开发的软件,相对于 Cytoscape 功能较少,开发成熟程度也较差。
相比之下,R 同样具有丰富的软件包和精细的图像导出预设,熟练使用后可以实现更加复杂的互作网络生成和分析,在学术研究领域也是比较好的选择;Gelphi 更加轻便、简化,适合生物学互作关系网络研究的初学者,此外它具备更加美观的预设和内建的统计分析模块。
由于 Cytoscape 是开源软件,由核心开发团队和众多开发者共同开发维护,随着软件版本的更新,相信 Cytoscape 的功能会越来越丰富与强劲。
二、Cytoscape 基本操作
(一) 认识界面
Cytoscape 在 2013 年发布 3.0 版本后,发生了较大的变化。以 3.5.1 版本为例,Cytoscape 软件的界面更加模块化(图 9-31)。界面顶端是菜单和工具栏,用于执行各种对网络和文件的操作。占据界面左侧的是控制台,可以管理、调整并筛选网络中的节点和连线。界面最突出的区域是可视化区域,用于展示和移动网络可视化。可视化区域的下方是数据栏,以列表的形式展现网络中节点与连线的具体信息。
(二)基本网络操作
- 节点和连线的操作 在可视化区域右键点击唤出快捷菜单,实现节点和连线的创建(Add)。在可视化区域中可实现节点的移动(左键拖动),节点和连线的删除或剪切(Delete 键或 Ctrl+X),视图的放大缩小(鼠标滚轮)。
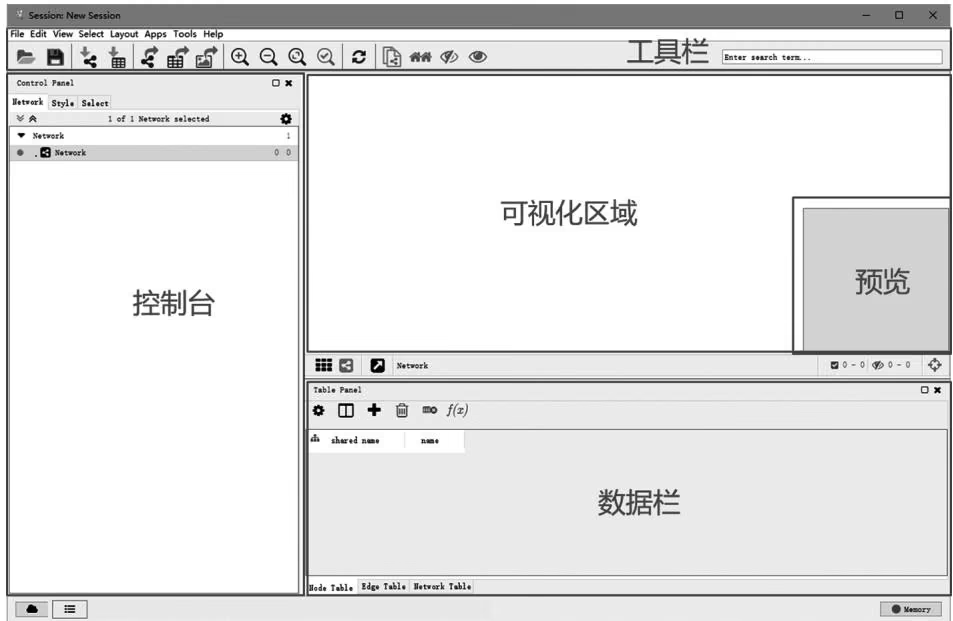
节点和连线的样式改变 在可视化区域右键点击唤出快捷菜单,对选中节点和连线的样式进行单独设置。在控制面板的 Style 栏中实现网络全局、映射调整和对选中节点和连线的样式进行单独设置。
网络分析 在菜单栏中选择 NetworkAnalyzer,运行网络分析,在数据栏生成新的列展示网络节点和连线的具体属性,计算节点的度与连线的加权。
子网络的构建 选择感兴趣的节点,使用菜单栏或工具栏的选项构建子网络,选择相应层级的邻接节点构建多层子网络。
(三)文件操作
导入网络文件 通过菜单栏或工具栏导入文件,选择文件位置,选择数据格式和属性,导入网络视图。在导入网络的过程中,可以通过对话框与 Cytoscape 交互,调整输入数据的分隔格式。Cytoscape 对不同文件的格式有良好的适应性,可以导入用各种符号分隔的数据表。
导入表格 通过菜单栏或工具栏导入表格文件,这些表格文件多为网络节点或连线的属性注释。选择文件位置,选择数据格式和属性,导入数据栏,用于后续操作。同样,也可以用于导入网络过程中类似的对话框与 Cytoscape 交互,调整输入数据的分隔格式。
导出网络图像 将所需导出的网络视图调整为适当大小,确保不超出可视化区域边缘。利用菜单栏或工具栏导出图像,选择文件导出位置和图像格式(支持 JPEG、PDF、PNG 等格式)。
三、Cytoscape 实现互作网络可视化
我们使用 Cytoscape 安装目录中的示例数据构建一个简单的蛋白质互作网络。在 sampleData/ 目录中找到 galFiltered.sif,在 Cytoscape 中使用 “导入网络” 操作(图 9-32)。点击顺序为:File→Import→Network→File。观察数据栏可知该文件表示酵母蛋白的两两互作。
在可视化界面即可查看导入的网络,使用菜单栏的 Layouts 菜单调整网络布局。使用控制面板 Style 页面对网络的节点、连线及整体进行手动调整。
也可以使用 “导入表格” 操作加入附加表格文件,作为网络的属性,映射到对应的节点或连线上。在弹出的对话框中完成正确的映射后,观察 Cytoscape 下方数据栏,即可找到增加的节点或连线属性,可以根据此在控制面板的 Style 页面对网络的节点、连线及整体进行批量调整。
如果没有附加表格,也可以直接通过网络分析工具创建网络的基本统计属性(图 9-33)。点击顺序为:Tools → Network Analyzer → Network Analysis → Analyze Network。增加基本统计属性后也可以此为参数设置网络的 Style。
四、Cytoscape 插件
Cytoscape 具备丰富的插件支持。例如,用于 GO 富集分析的 BiNGO,以及用于文献挖掘的 Agilent Literature Search。
可以在菜单中打开插件管理器(图 9-34),搜索所需的插件进行下载安装,也可以通过来自网络或其他位置的 jar 文件安装,安装后即可在菜单栏插件列表中点击运行。Cytoscape 在丰富的插件支持下,功能变得更加强大,也更受多个领域研究人员的青睐。

思考题
简述系统生物学定义。
简述系统生物学与分子生物学的差异。
为什么说整合是系统生物学的灵魂?
概述系统生物学的基本工作框架。
总结酵母双杂交系统的基本原理。
矩阵 M 的每行表示缺失该行的基因情况下其他基因的表达水平,每列表示该基因在各种基因缺失试验下的表达水平。试以此数据为基础构建基因表达数据的网络模型。
表达矩阵 $M$
| $x_0$ | $x_1$ | $x_2$ | $x_3$ | |
|---|---|---|---|---|
| wt | 3.750 | 3.750 | 8.939 | 0.078 |
| $a_0^-$ | — | 3.750 | 8.769 | 0.011 |
| $a_1^-$ | 3.750 | — | 8.769 | 0.086 |
| $a_2^-$ | 3.750 | 3.750 | — | 5.476 |
| $a_3^-$ | 3.750 | 3.750 | 8.939 | — |
以细菌化学趋向为例,查阅文献开展构建信号转导模型的工作。
总结网络分类法。
学习几种重要的蛋白质相互作用数据库(如 DIP 和 BIND 等)。
从网上学习诸如 KEGG 的储存途径或网络的数据库。
何为网络模体?
如何用网络模体概念推测蛋白质功能?
以酵母蛋白相互作用数据为对象,使用 CytoScape 软件构建相互作用网络图。
学习 PATHBLAST 类似软件,尝试比较酵母、线虫、果蝇蛋白质相互作用网络,从中找出一些保守的网络模体。
何为网络模块化?
列举常见的几种 3 节点网络模体,并说明其对应的网络主题。

主要参考文献
北野宏明.2007.系统生物学基础.刘笔锋,等译.北京:化学工业出版社
陈铭.2007.系统生物学(systems biology)的几大重要问题.生物信息学,5(3):129-136
冯团诚,庄南生.2007.虚拟细胞模型研究进展.生物信息学,2:90-93
张先恩.2008.细胞工厂和生物纳米机器.生命科学,20(30):364-368
Albert R, Jeong H, Barabasi A L. 2000. Error and attack tolerance of complex networks. Nature, 406: 378-382
Aronheim A, Zandi E, Hennemann H, et al. 1997. Isolation of an AP-1 repressor by a novel method for detecting protein-protein interactions. Mol Cell Biol, 17: 3094-3102
Betzig E, Patterson G H, Sougrat R, et al. 2006. Imaging intracellular fluorescent proteins at nanometer resolution. Science, 313 (5793): 1642-1645
Boeke J D, LaCroute F, Fink G R. 1984. A positive selection for mutants lacking orotidine-5’-phosphate decarboxylase activity in yeast: 5-fluoro-orotic acid resistance. Mol Gen Genet, 197: 345-346
Boogerd F C, Bruggeman F J, Hofmeyr J H S, et al. 2008. 系统生物学——哲学基础. 孙之荣, 等译. 北京: 科学出版社
Brent R, Ptashne M. 1985. A eukaryotic transcriptional activator bearing the DNA specificity of a prokaryotic repressor. Cell, 43: 729-736
Chi K R. 2009. Super-resolution microscopy: breaking the limits. Nature Methods, 6: 15-18
Chien C T, Bartel P L, Sternglanz R, et al. 1991. The two-hybrid system: a method to identify and clone genes for proteins that interact with a protein of interest. Proc Natl Acad Sci USA, 88: 9578-9582
Drewes G, Bouwmeestery T. 2003. Global approaches to protein-protein interactions. Current Opinion in Cell Biology, 15: 199-205
Elowitz M B, Leibler S. 2000. A synthetic oscillatory network of transcriptional regulators. Nature, 403 (6767): 335-338
Fearon E R, Finkel T, Gillison M L, et al. 1992. Karyoplasmic interaction selection strategy: a general strategy to detect protein-protein interactions in mammalian cells. Proc Natl Acad Sci USA, 89: 7958-7962
Fields S, Song O K. 1989. A novel genetic system to detect protein-protein interactions. Nature, 340: 245-246
Fromont-Racine M, Mayes A E, Brunet-Simon A, et al. 2000. Genome-wide protein interaction screens reveal functional networks involving Sm-like proteins. Yeast, 17 (2): 95-110
Gavin A C, Bösche M, Krause R, et al. 2002. Functional organization of the yeast proteome by systematic analysis of protein complexes. Nature, 415: 141-147
Goit L, Bader J S, Brouwer C, et al. 2003. A protein interaction map of Drosophila melanogaster. Science, 302:1727-1736
Ho Y, Gruhler A, Heilbut A, et al. 2002. Systematic identification of protein complexes in Saccharomyces cerevisiae by mass spectrometry. Nature, 415: 180-183
Hope I A, Struhl K. 1986. Functional dissection of a eukaryotic transcriptional activator protein, GCN4 of yeast. Cell, 46: 885-894
Huang B, Wang W, Bates M. 2008. Three-dimensional super-resolution imaging by stochastic optical reconstruction microscopy. Science, 319: 810-813
Ideker T, Galistki T, Hood L. 2001. A new approach to decoding life: system biology. Annu Rev Genomics Hum Genet, 2: 343-372
Ito T, Chiba T, Ozawa R, et al. 2001, A comprehensive two-hybrid analysis to explore the yeast protein interactome. Proc Natl Acad Sci USA, 98: 4569-4574
Jeong H, Mason S P, Barabasi A L, et al. 2001. Lethality and centrality in protein networks. Nature, 411: 41-42
Jiang R, Tu Z D, Chen T, et al. 2006. Network motif identification in schochastic networks. PNAS, 103: 9404-9409
Johnsson N, Varhavsky A. 1994. Split ubiquitin as a sensor of protein interactions in vivo. Proc Natl Acad Sci USA, 91: 10340-10344
Keegan L, Gill G, Ptashne M. 1986. Separation of DNA binding from the transcription-activating function of a eukaryotic regulatory protein. Science, 231: 699-704
Kitano H. 2002. Systems biology: a brief overview. Science, 295 (5560): 1662-1664
Leanna C A, Hannink M. 1996. The reverse two-hybrid system: a genetic scheme for selection against specific protein/protein interactions. Nucleic Acids Res, 24: 3341-3347
Lee W P, Jeng B C, Pai T W, et al. 2006. Differential evolutionary conservation of motif modes in the yeast protein interaction network. BMC Genomics, 7: 89
Legrain P, Selig L. 2000. Genome—wide protein interaction maps using two-hybrid systems. FEBS Letters, 480: 32-36
Levchenko A, Bruck J. Sternberg P W.2000. Combination of biphasic response regulation and positive feedback as a general regulatory mechanism in homeostasis and signal transduction. In Foundations of Systems Biology. The MIT Press
Li S M, Aemstopher C M, Bertin N, et al. 2004. A map of the interactome network of the metazoan C. elegans. Science, 303: 540-543
Licitra E J, Liu J O. 1996. A three-hybrid system for detecting small ligand-protein receptor interactions. Proc Natl Acad Sci USA, 93: 12817-12821
Luban J, Goff S P. 1995. The yeast two-hybrid system for studying protein-protein interactions. Current Opinion in Biotechnology, 6: 59-64
Ma J, Ptashne M. 1988. Converting a eukaryotic transcriptional inhibitor into an activator. Cell, 55: 443-446
Masaru T. 2001. Whole-cell simulation: a grand challenge of the 21st century. Trends Biotechnol, 19 (6): 205-211
Miyodai F, Nakayama Y, Tomita M. 2003. E-cell simulation system and its application to the modeling of circadian rhythm. Seikagaku, 75 (1): 5-16
Osborne M A, Dalton D, Kochan J P. 1995. The yeast tribrid system-genetic detection of tansphosphorylated ITAM-SH2-interactions. Biotechnology, 13: 1474-1478
Ouzounis C A, Karp P D. 2000. Global properties of the metabolic map of Escherichia coli. Genome Res, 10: 568-576
Ozenberger B A, Young K H. 1995. Functional interaction of ligands and receptors of the hematopoietic superfamily in yeast. Mol Endocrinol, 9: 1321-1329
Palsson B. 2000. The challenges of in sifico biology. Nat Biotechnol, 18: 1147-1150
Putz U, Skehel P, Kuhl D. 1996. A tri-hybrid system for the analysis and detection of RNA-protein interactions. Nucleic Acids Res, 24: 4838-4040
Rain J C, Selig L, de Reuse H, et al. 2001. The protein-protein interaction map of Helicobacter pylori. Nature, 409: 211-215
Raul J F, Venkatesan K, Hao T. 2005. Towards a proteome-scale map of the human protein-protein interaction network. Nature, 437: 1173-1178
Rust M J, Bates M, Zhuang X. 2006. Sub-diffraction-limit imaging by stochastic optical reconstruction microscopy (STORM). Nature Methods, 3: 793-795
Schiestl R H, Gietz R D. 1989. High efficiency transformation of intact yeast cells using single stranded nucleic acids as a carrier. Curr Genet, 16: 339-346
Schwikowski B, Uetz P, Fields S. 2000. A network of protein-protein interactions in yeast. Nat Biotechnol, 18:1257-1261
Sharan R, Suthram S, Kelley R M, et al. 2005. Conserved patterns of protein interaction in multiple species. PNAS, 102: 1974-1979
Sherman F, Fink G R, Hicks J B. 1986. Methods in Yeast Genetics. Cold Spring Harbor: Cold Spring Harbor Lab
Spiro P A, Parkinson J S, Othmer H G. 1997. A model of excitation and adaptation in bacterial chemotaxis. Proc Natl Acad Sci USA, 94: 7236-7268
Sulston J E, Schierenberg E, White J G, et al. 1983. The embryonic cell lineage of the nematode Caenorhabditis elegans. Dev Biol, 100 (1): 64-119
Thomas A K, Stefan J, Marcus D, et al. 2000. Fluorescence microscopy with diffraction resolution barrier broken by stimulated emission. Proc Natl Acad Sci USA, 97: 8206-8210
Uetz P, Giot L, Gagney G, et al. 2000. A comprehensive analysis of protein-protein interactions in Saccharomyces cerevisiae. Nature, 403: 623-627
Uetz P, Pankratz M J. 2004. Protein interaction maps on the fly. Nature Biotechnology, 22 (1): 43-44
Walhout A J, Sordella R, Lu X, et al. 2000. Protein interaction mapping in C. elegans using proteins involved in vulval development. Science, 287: 116-122
Yeger L E, Sattath S, Kashtan N, et al. 2004. Network motifs in integrated cellular networks of transcription-regulation and protein-protein interaction. Proc Natl Acad Sci USA, 101: 5934-5939
Zhang J, Lautar S. 1996. A yeast three-hybrid method to clone ternary protein complex components. Anal Biochem, 242: 68-72
Zhang L V, King O D, Wong S L, et al. 2005. Motifs, themes and thematic maps of an integrated Saccharomyces cerevisiae interaction network. J Biol, 4: 6
第十章 合成生物学
读者对其有较为深入的了解。
合成生物学是21世纪的新兴科学,其目的是通过人工设计和构建自然界中不存在的生物系统来解决能源、材料、健康和环保等问题。本章简要介绍合成生物学的基本概念和内容,并通过经典实例使人的了解。
第一节 合成生物学概述
合成生物学的发展以细胞生物学、分子生物学、遗传学、信息科学、电气工程学、计算科学等相关学科的发展为基础。2000年以后,在Drew Endy、Jay Keasling、Ron Weiss和James J. Collins等的推动下,合成生物学作为一门崭新的学科得到了飞速的发展。
一、合成生物学的定义
合成生物学是指按照一定的规律和已有的知识,①设计和建造新的生物零件、装置和系统;②重新设计已有的天然生物系统为人类的特殊目的服务。
简单地说,合成生物学就是通过人工设计和构建自然界中不存在的生物系统来解决能源、材料、健康和环保等问题(张春霆,2007)。
为了正确理解复杂的生物系统机制,“合成”将是“分析”的必要补充。只有通过人工构建各种生物分子、基因线路和代谢通路,才能更好地验证人类对于各种生物现象的理解。此外,合成生物学工程化的理念和工具必将加速生物学的发展。
二、合成生物学的工程本质
合成生物学区别现有生物学其他学科的主要特点,即“工程化”。合成生物学家力图通过工程化方法,将复杂的人工生物系统合理简化、设计和重新构建,用以探索人工生物系统的应用(Brent,2004;Baker et al.,2006;Matthias and Sven,2006;Bhutkar,2005)。
合成生物学的工程化研究涉及最关键的3个工程化概念:对生物系统的标准化、解构和抽提(Endy,2005;Keasling,2005;Nelson and Cox,2000)。标准化包括建立生物功能的定义、建立识别生物部件的方法及标准生物部件的注册登记、构建具有统一接口(如统一的酶切位点等)的生物部件库等;解构指将复杂系统分解成简单的要素,在统一框架下分别设计;抽提则包括建立装置和模块的层次,允许不同层次间的分离和有限的信息交换、开发重设计和简化的装置与模块等,如图10-1所示。生物系统的层次化结构设计是合成生物学工程化本质的典型体现。具有一定功能的DNA序列组成最简单的生物部件(part),不同功能的生物部件按照一定的逻辑和物理连接组成复杂的生物装置(device),不同功能的device协同运作组成更加复杂的生物系统(system),含有多种不同功能system的生物体彼此通讯、互相协
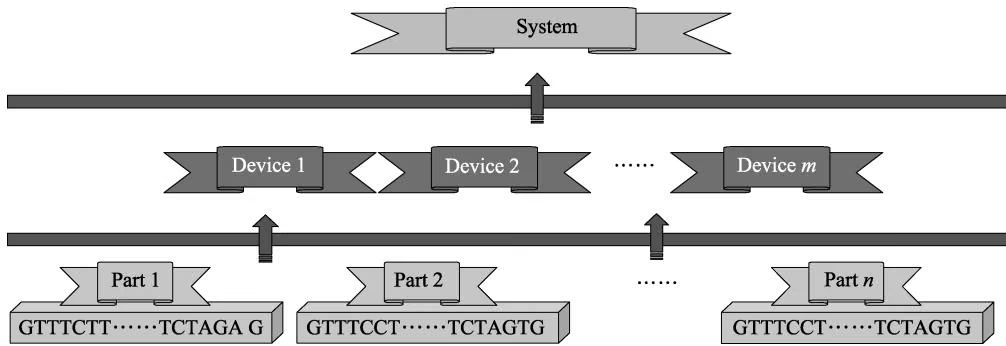
调组成更复杂的多细胞生物系统。
1)生物部件:基因线路中最简单、最基本的标准化模块称为生物部件。part 是指具有特定功能的核苷酸、蛋白质或者 DNA 序列,能够通过标准化组装方法与其他 part 组装成具有更复杂功能的模块。part 按照其功能可以划分为终止子、蛋白质编码基因、报告基因、信号传递组件、引物组件、标记组件(tag)、蛋白发生组件、转化器、启动子等类别。常用的转录调控 part 主要有 LacI-Plac、cI-Pl 及 TetR-Ptet 对等。
2)生物装置:有了上述标准化的 part,就可以利用转录激活因子、转录抑制子、转录后机制(如 DNA 修饰酶)和核糖核酸调节因子(riboregulator)等构建稍微复杂些的生物装置 / 设备。
3)生物系统:为了得到更加复杂的调控行为,可将装置按照串联、反馈或前馈等形式进行连接,组成更加复杂的级联线路或者调控网络,即所谓的生物系统。
为了推动合成生物学的发展,来自美国麻省理工学院(MIT)、哈佛大学、加利福尼亚大学旧金山分校(UCSF)等的专家学者联合成立了一个非营利性的“生物积块基金委员会”(The BioBricks Foundation,BBF),大力推动各种标准化生物零件库的构建和共享。我们将具有标准的4种酶切位点的人工构建的生物零件称为生物积块(biobrick)。每一个biobrick都有详细的注释,包括该片段的示意图、碱基顺序(不包括前缀和后缀)、片段功能的阐述,以及其他使用者提供的使用经验等(宋凯,2010)。
只要按照标准化的操作,就可以保证连接后的 biobrick 仍然具有相同的 4 个标准酶切位点,可以用同样的方法与其他标准片段连接。如此循环往复,即可以由简单到复杂,逐层构建更加复杂的基因线路(Knight,2003;Shetty et al., 2008)。
三、合成生物学的研究内容
(一)生物分子的合成与模块化
合成生物学的研究重心是具有截然不同于自然系统特性和功能的崭新生物系统的开发和工程化,因此,它离不开各种标准化生物分子的研制和开发,这方面的研究主要包括以下几个部分。
蛋白质的人工合成与模块化 合成生物学的某些设计,需要功能新颖且相对独立、可以被自由组装的蛋白质模块,对蛋白质的需求远比自然界能够提供的种类多得多。因此需要人工构建和开发崭新的标准蛋白质模块,如人工设计多锌指 DNA 结合蛋白等(Sera and Uranga, 2002; Dreier et al., 2005; Segal et al., 1999)。
核酸分子的人工合成 核酸分子的人工合成包括 DNA 和 RNA 序列的人工合成。合成基因可以用来重设计目标基因序列、编码区域或者调控重要信号(蛋白质初始化、核糖体结合位点、启动子等),为适应特殊宿主或模拟生物体而改变密码子用法等。而人工构建的具有特定功能的 Riboregulator 则可以实现翻译水平的调控。
(二)生物底盘的简化与模块化
各种人工构建的生物模块难免会被植入生物体中进行繁殖和培养。生物体自身的各种代谢通路、信号转导通路和各种内源噪声对于人工模块功能的执行无疑是一种干扰。同时,天然生物基因功能的多效性和冗余性也给各种模拟算法的有效应用带来了障碍。因此,许多合成生物学家致力于生物底盘的简化和模块化,力图净化宿主细胞的代谢内环境,其中尤以最小基因组 $^{①}$ 和必需基因的研究成果最为显著(Hashimoto et al., 2005;Glass et al., 2005;Forster and Church, 2006;Pennisi, 2005)。
(三)基因线路的设计与构建
20 世纪中期,F. Jacob 和 J. Monod 提出了调节基因表达的操纵子模型,F. Jacob 认为细胞的行为是通过目的性的调控实现的,而他的这一思想被认为是合成生物学的主要研究内容之一——“基因线路”的雏形(Jacob and Monod,1961;Monod and Jacob,1961)。
遗传线路(genetic circuit)俗称“基因线路”(gene circuit),在合成生物学中是指由各种调节元件和被调节的基因组合成的遗传装置(genetic device),在给定条件下可调、可定时定量地表达基因产物 $^{②}$ 。
(四)合成代谢网络
目前合成代谢网络主要是利用转录和翻译控制单元调控酶的表达以合成或分解代谢物。此类系统中主要是以代谢物浓度作为控制元件的输入。例如,将酿酒酵母中合成焦磷酸异戊酯(isopentyl pyrophosphate)的甲羟戊酸类异戊二烯途径(mevalonate isoprenoid)的整个代谢网络转入大肠杆菌中,通过结合插入的紫穗槐-4,11-二烯合酶(amorpha-4,11-diene synthase),制造大量的抗疟疾药物——青蒿素的前体物质。
(五)多细胞系统研究
基于细胞间交流的多细胞系统的开发,主要是研究多细胞间的同步基因表达、信号交流、异步功能配合等。利用人工构建的群体效应机制,目前研究者已经开发了许多具有崭新功能的多细胞系统,如能够达到高细胞浓度的双稳态开关系统等(Balagadde et al., 2005)。
(六)数学模拟和功能预测
考虑到构建实际系统的高成本和耗时性,利用计算模型的辅助,通过各种数学工具抽提模拟单元的动力学特性和网络连通性,提供系统变量的描述等则是为实验提供预测信息、指导实验优化、降低实验成本的主要方法(Hasty et al., 2002)。
四、合成生物学引发的思考
与 20 世纪七八十年代基因工程的相关争论非常类似,合成生物学一出现立刻引起了社会各界的广泛关注。
概括而言,合成生物学被科学家、非政府组织和媒体所广泛关注的道德、社会、法律方面相关的问题大体可归结为:伦理道德规范、对环境无控制的排放、生物恐怖主义、生物垄断及人工生物的创造等(Bhutkar,2005;Balmer and Martin,2008;Bügl et al.,2007;Kumar and Rai,2007;Rai and Boyle,2007;Church,2005;Chopra and Karnma,2006)。
所幸的是,合成生物学界从未对合成生物可能对人类造成的威胁避而不谈,相反,相应的道德规范和防范措施已经成为所有国际会议的主要议题之一,几乎任何一篇关于合成生物学的综述都指出需要道德规范的探讨、国际调控和付诸实际的行动。第二届合成生物学国际会议也发表宣言支持科学界采用维护人类安全行为的策略。可以预见,未来合成生物学仍然会在人类激烈的争论中继续前进。
第二节 合成生物学基础研究经典实例
2000 年世界著名科学期刊 Nature 的第 403 期发表了 James J. Collins 课题组的 “Toggle Switch” 和 Elowitz 课题组的 “Repressilator” 两篇科学论文。这两篇文章的研究内容虽然没有取得立竿见影的实际应用价值,却为全世界的科研人员开辟了一片充满生机的广阔天空,称其为合成生物学的 “开山之作” 一点也不为过!2010 年,为纪念这两篇旷世经典,Nature 专门出版了一期纪念专刊,总结和展望合成生物学这 10 年来的发展,由此可见这两篇文章影响的深度和广度。下面我们也以这两篇文章的内容为例,引出合成生物学基础研究的一些经典实例。
一、在大肠杆菌中构建双稳态开关
(一)基因线路设计
图 10-2 中有两种不同的启动子,启动子 1 和启动子 2 分别控制着阻遏子 2 和阻遏子 1 基因序列的表达状态;阻遏子 2 和阻遏子 1 基因表达的产物会分别阻遏启动子 2 和启动子 1 的启动。阻遏子 2 下游报告基因的表达产物可以作为输出信号表征系统当前所处的状态。由于上下游基因的启动和相互阻遏,整个系统共有两种稳定的输出状态。①状态 A:启动子 1 启动而启动子 2 关闭的状态,此时,启动子 2 下游的报告基因无法开启,系统无特定的输出产物。②状态 B:启动子 2 启动而启动子 1 被关闭的状态,此时,启动子 2 下游的报告基因同时被开启,可以检测到报告基因的产物。
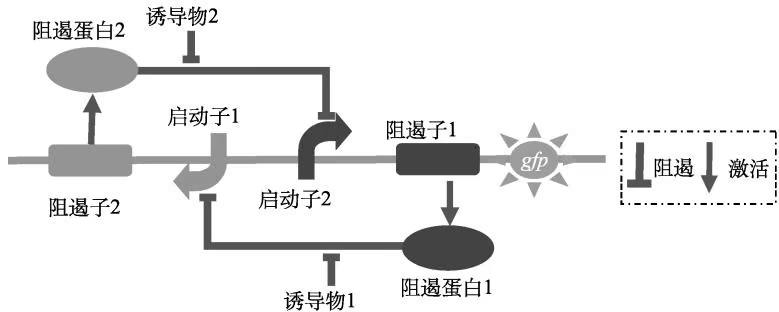
系统的两个外部输入信号——诱导子1和诱导子2加入可以实现系统在两种状态之间的转换,是人工控制状态切换的手段。当系统稳定于A状态时,通过加入诱导子2,可以解除阻遏子2对启动子2的阻遏作用,使得阻遏子1表达,阻遏启动子1,终止阻遏子2的表达,一段时间以后系统从A状态翻转至B状态,即使解除诱导子2的输入,系统依然会稳定于状态B。同理,加入诱导子1作用一段时间,也可以使系统从状态B切换到状态A。如果将诱导子1和诱导子2的加入看作是对开关的“拨动”,那么每次拨动,系统就会稳定于相应的状态,而不需要其他外界信号来维持。
(二)基因线路实现
为了实现上述设计的基因线路逻辑功能,必须选择恰当的基因功能模块。作者共选取了3种启动子-阻遏子-诱导子方案,分别如下。
A. 启动子:Ptrc-2;阻遏子:lacI;诱导子:异丙基- $\beta$ -D硫代半乳糖苷(isopropylthio- $\beta$ -D-galactoside,IPTG)。
B. 启动子:Pls1con;阻遏子:cIts;诱导子:温度。
C. 启动子:PltetO1;阻遏子:tetR;诱导子:脱水四环素(anhydrotetracycline,aTc)。
为了能够形象地显示系统的状态,选取绿色荧光蛋白作为系统的报告蛋白。通过检测基因 gfp Pmut3 表达出来的绿色荧光蛋白(GFP)mut3 的荧光值表征系统状态。
(三)数学模型建立
为了更好地研究双稳态开关系统的性状,预测和指导实验,Collins 等建立了数学模型模拟系统的行为,并得出如下指导性结论。
系统模拟图如图 10-3 所示。其中 u、v 分别表示两种阻遏蛋白的量; $a_{1}$ 和 $a_{2}$ 为两种启动
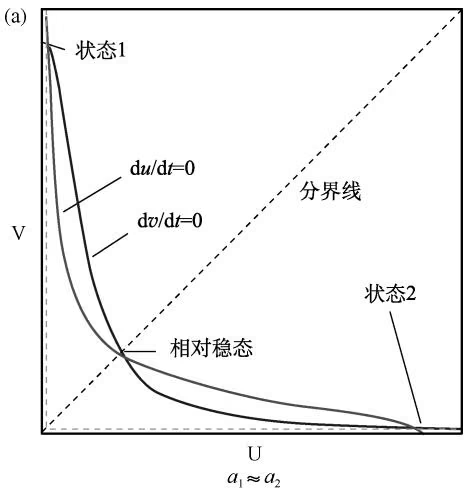
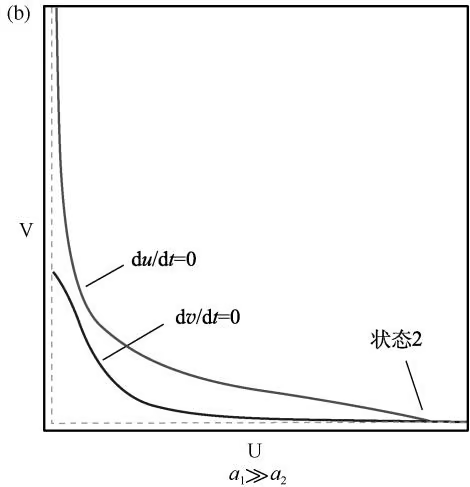
(a)中当两种启动子的启动能力比较相近,即 $a_{1}$ 和 $a_{2}$ 的数值比较接近时,双稳态开关的仿真模拟如图中两条黑实线所示。两种黑线共有3个交点,当系统的状态位于两条实线在 $45^{\circ}$ 对称线上的交点时,为系统的不稳定点。另外两个点为稳定的状态点,当系统状态发生微小的波动后,系统会恢复到原来的状态。(b)为当两种启动子的能力(包括核糖体结合位点)相差比较大时(如 $a_{1}\gg a_{2}$ )系统模拟的状态图,此时系统只有一个稳态
子(包含核糖体结合位点共同作用)在没有阻遏蛋白时的表达速率。当两种启动子的启动能力比较相近,即 $a_{1}$ 和 $a_{2}$ 的数值比较接近时,整个系统有两个稳定状态,分别对应 V 含量相对较多的状态 1 和 U 含量相对较多的状态 2。当两种启动子的能力(包括核糖体结合位点)相差比较多的时候,如 $a_{1} \gg a_{2}$ ,系统只有一个稳定状态,不存在双稳态情况。
(四)功能检测
所有的双稳态开关都被转入大肠杆菌 JM2.300 菌种中验证其功能。所有的 6 种双稳态开关(4 种 pTAK 载体及 2 种 pIKE 载体的双稳态开关),以及 3 种对照实验的结果如图 10-4 所示。以加入 IPTG 的初始时刻为 0 时刻点,从图 10-4 中可以看出,在加入 IPTG 以前,系统中的荧光量较少,在加入 IPTG 6h 以后,所有的双稳态开关及对照质粒 pTAK102 的系统中荧光值都升至了较高水平。当重新放置于新的培养基中培养 5h 以后,除了开关 pIKE105 及对照质粒 pTAK102 以外,其他开关的荧光量都基本维持较高水平,说明系统从初始对应于荧光量较低的状态翻转并维持在另一种对应于荧光量较高的稳定状态。接下来的 7h 内,在另一种诱导子(升高温度或者引入 aTc)的作用下,荧光值处于高水平的开关全部降到了低水平,而作为对照实验的 pTAK106 和 pIKE108 质粒荧光值升到了高水平。在放入新的培养基以后,所有的开关荧光值都基本维持稳定,说明系统又翻转回对应于荧光值较低的稳态。由此可见,双稳态开关的功能已经基本实现。
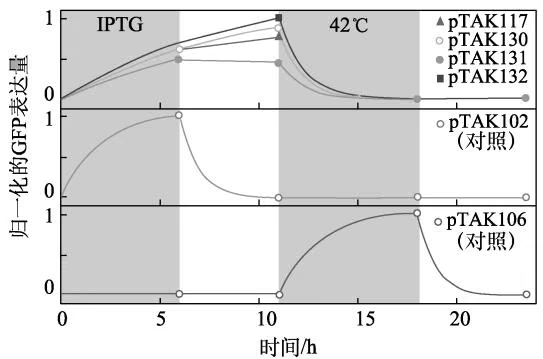
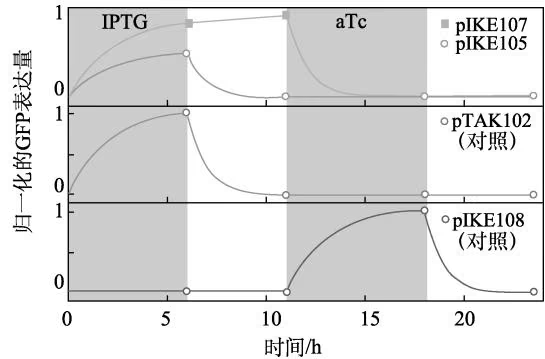
二、构建 Repressilator 基因振荡器
如果将 3 个表达产物相互阻遏的基因模块串联成一个环状结构,利用基因模块间的彼此阻遏和解阻遏即可实现振荡器的功能,这就是 Elowitz 等构建的首例基因振荡器。该振荡环实现了在没有外加输入作用下,生物系统中基因表达按照特定周期变化的功能。下面我们就来讲解 Repressilator 的构建和实验结果。
(一)基因线路设计
由 Elowitz 等设计完成的 Repressilator 的基因线路如图 10-5 所示。
上述振荡器的状态转换可具体表述如下。当 $Pl_{lacO1}$ 启动子启动时,产生的 TetR-lite 蛋白会阻遏下游 $Pl_{tetO1}$ 启动子,CI-lite 蛋白无法产生, $P_{R}$ 启动子的阻遏被解除, $P_{R}$ 下游的基因顺利表达,产生 LacI-lite 蛋白并阻遏下游 $Pl_{lacO1}$ 启动子, $Pl_{lacO1}$ 启动子的状态从 “开启” 转换为 “关闭”,下游基因停止产生 TetR-lite 蛋白, $Pl_{lacO1}$ 启动子的阻遏被解除,状态由“关闭”转换为“开启”,下游基因产生 CI-lite 蛋白去阻遏 $P_{R}$ 启动子,导致 $P_{R}$ 启动子的状态从“开启”转换为“关闭”; $P_{R}$ 启动子的被阻遏使得 LacI-lite 蛋白无法继续产生, $Pl_{lacO1}$ 启动子的阻遏被消除,其状态由“关闭”翻转为“开启”,下游基因表达 TetR-lite 蛋白阻遏 $Pl_{tetO1}$ 启动子。如此往复,实现整个振荡器周而复始的状态转换。
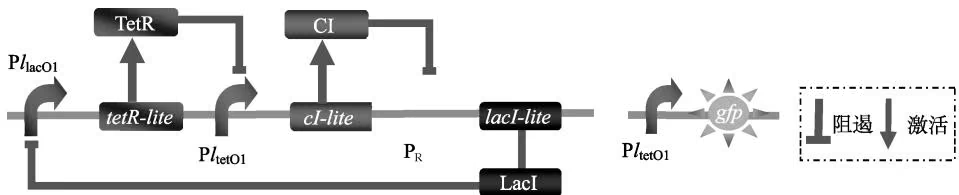
作为输出信号,荧光蛋白的表达量可以表征系统的状态。当系统状态在3个阻遏基因顺序开启的过程中振荡的时候,TetR蛋白的浓度也会发生振荡,其对启动子 $P l_{lacO1}$ 阻遏作用的强弱出现相应的振荡,导致下游绿色荧光蛋白(GFP)的表达量也随着TetR浓度的变化而变化,即随着Repressilator的周期变化而变化。
(二)功能检测
从图 10-6 中可以看到,细胞的荧光值按照大约 150min 的周期进行振荡,统计得到细胞振荡的平均周期为 $(160\pm40)$ min,不同于细胞分裂的周期。由于荧光蛋白的降解周期大于振荡器的振荡周期,荧光蛋白还未完全降解时系统即进入下一振荡循环,因此系统的荧光值呈现振荡上升趋势。
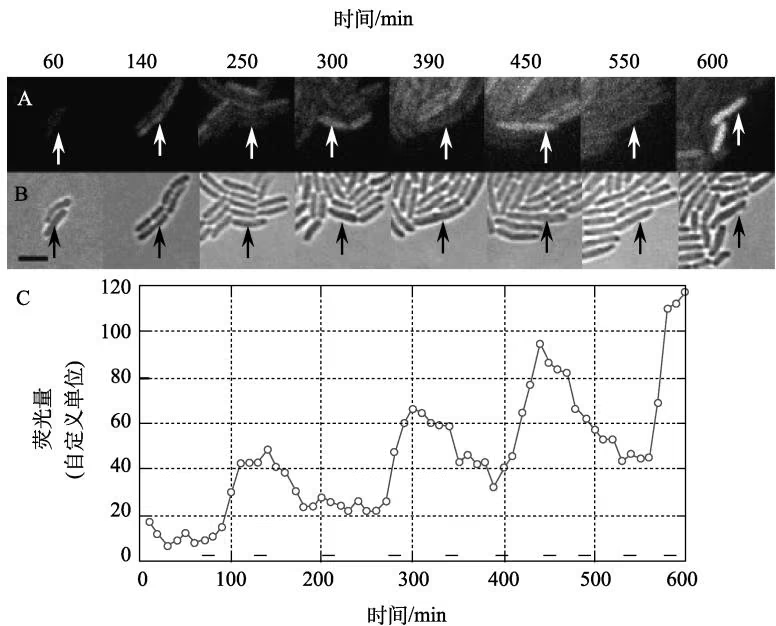
三、逻辑门功能基因线路
图 10-7(a)所示为一种“与”门功能的基因线路,IPTG、aTc 为系统输入,GFP 为系统输出,其逻辑图和真值表如图 10-7(b)和图 10-7(c)所示。启动子 1 组成型表达 lac 和 tet R 基因的多顺反子,启动子 2 同时被 LacI 或 TetR 蛋白阻遏。当 LacI 或 TetR 存在时,与启动子 2 结合阻止其启动,gfp 基因的表达被关闭。只有当 IPTG 和 aTc 同时存在时,才能同时阻止 LacI 和 TetR 与启动子 2 结合,启动子 2 顺利启动,gfp 基因的表达被开启,系统有 GFP 蛋白存在(Hasty et al., 2002)。
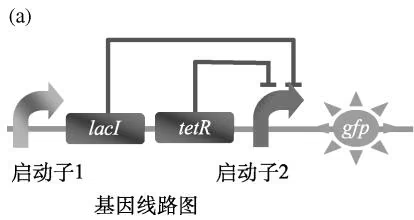
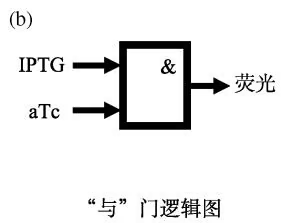
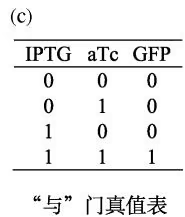
图 10-8(a)为模拟逻辑 “或” 门功能的基因线路。LacI 阻遏启动子 2,TetR 阻遏启动子 3。IPTG 可以解除 LacI 对启动子 2 的阻遏,开启其后的 gfp 基因;aTc 可以解除 TetR 对启动子 3 的阻遏,开启其后的 gfp 基因。因此当 IPTG 或 aTc 中的任何一个存在时,均可以导致 gfp 基因的表达,从而实现以 IPTG 和 aTc 为输入、GFP 为输出的逻辑 “或” 门功能,其逻辑图和真值表如图 10-8(b)和图 10-8(c)所示。
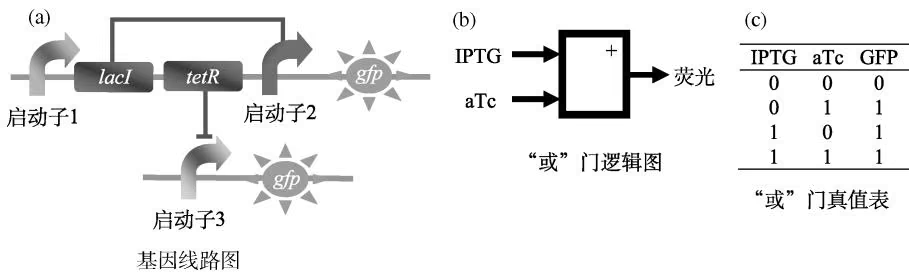
逻辑门功能基因线路的构建方式还有很多种,已有的文献和成功实例也很多,随着合成生物学的飞速发展,逻辑门已经成为了基因线路中最为基础的部件之一。
四、人工多细胞图案系统
为了深入研究和模拟信号分子的介导机制,Basu 等(2005)设计了可以在中心细胞一定范围内形成发光带的人工多细胞图案系统。图 10-9 为发光带系统基因线路图。
信号发生器细胞在接收到外界信号以后,开启 luxI 基因表达,催化信号分子 AHL 的生成。这种信号分子可以穿越细胞膜扩散到环境中。由于扩散形成的浓度梯度,距离发生器越远的地方,AHL 信号分子的浓度越低。
(a)
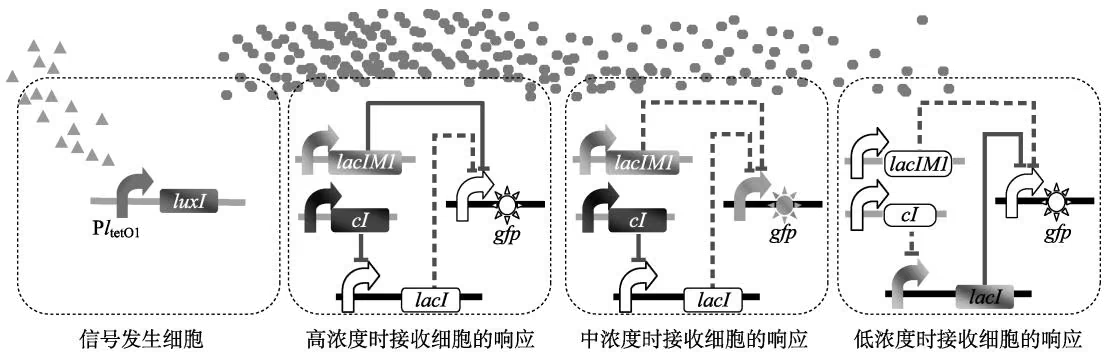
信号接收器细胞表达 LuxR 蛋白,这种蛋白质能与 AHL 信号分子结合,开启下游 $\lambda$ 噬菌体 cI 基因和修饰过的乳糖操纵子 lacIM1 基因的表达。当接收器距离发生器细胞过近时,由于 AHL 信号分子浓度较高,导致 CI 蛋白和 LacIM1 蛋白过量表达,LacIM1 蛋白阻遏荧光蛋白的启动子,此区域内无荧光蛋白产生。相反,当接收器距离发生器过远时,由于信号分子过少,CI 蛋白和 LacIM1 蛋白都只有极少量表达,无法阻遏下游基因,野生型的 lacI 基因顺利表达,其产生的 LacI 蛋白阻遏荧光蛋白的表达,此区域内仍无荧光蛋白产生。只有当接收器离发生器距离适当的时候,适量的信号分子浓度引起适量的 CI 蛋白和 LacIM1 蛋白的表达,由于 CI 对于下游启动子的阻遏作用明显比 LacIM1 要强烈,所以野生型 lacI 基因基本不能表达,同时,lacIM1 基因表达的量也不足以阻遏下游荧光蛋白的表达,因此会在这个特定区域内形成环状荧光带。
如果在不同响应阈值的接收细胞中接入不同颜色的荧光蛋白并按设定顺序涂抹在琼脂固体培养基上,则可得如图 10-10 所示的实验结果。其中,图 10-10(a)为可见光下的培养皿图,图 10-10(b)和图 10-10(c)为在荧光显微镜观察下的放大图。

如果在多个区域同时放置信号发生细胞,就可以形成如图 10-11 中多种不同形状的颜色区域。图 10-11(a)为有 2 个信号发生器区域的实验结果图;图 10-11(b)为有 2 个信号发生器区域的浓度不一致时的实验结果图,左侧浓度高的信号发生器区域相应的环状荧光带的半径要大些;图 10-11(c)为有 3 个信号发生器区域的实验结果图;图 10-11(d)为有 4 个高浓度信号发生器区域的实验结果图。
(a)
(b)
(c)
(d)
图 10-11 发光带组成的多种形状颜色区域(Basu et al., 2005)

第三节 合成生物学应用研究经典实例
一、合成青蒿素的微生物工厂
疟疾是发生最频繁的人类寄生虫病,对于全球卫生事业的冲击仅次于结核病,每年在全球约有5亿宗病例,导致超过100万人死亡。世界卫生组织曾指出疟疾平均每30s杀死一个5岁以下的儿童。由于疟原虫快速产生的抗药性,许多广为人知的高效抗疟药物氯喹(chloroquine)、奎宁(quinine,又称为金鸡纳霜)和甲氟喹(mefloquine)等都已经基本失效,在某些地方,甚至发现有的疟原虫对目前所有价格低廉的一线药物都有交叉抗药性。为此,全世界范围内掀起了研制新型抗疟疾药物的热潮。继氯喹、奎宁、甲氟喹等药物之后,主要来源为植物提取的青蒿素是目前最有效的抗疟特效药。
Keasling(2005)和他的研究小组首先在大肠杆菌中设计了一条合成青蒿素前体紫穗槐二烯(amorphadiene)的生物合成途径。整条生物合成途径(图10-12)共分为以下几步。①将大肠杆菌中常见的化学物质乙酰辅酶A转变成甲羟戊酸;②将甲羟戊酸转化成焦磷酸异戊酯(isopentanyl pyrophosphate,IPP)或二甲(基)丙烯焦磷酸酯(dimethylallyi pyrophosphate,DMAPP);③将IPP或者DMAPP转化成法尼基环焦磷酸酯(farnesyl pyrophosphate,FPP);④利用ADS基因编码的产物,将FPP转化成紫穗槐二烯(Ro et al.,2006)。IPP和DMAPP是所有类异戊二烯的通用前体物,只要再引入恰当的催化酶基因,Keasling等开发的新菌株就可作为其他类异戊二烯化合物的生物合成平台。由此可见,这项研究成果具有巨大的应用潜力。
他们的工作大概可以分为以下几部分(Martin et al., 2003)。
1)净化大肠杆菌的代谢内环境。Keasling等引入了ispC基因,利用其产物将大肠杆菌原有的非甲羟戊酸途径切断,从而斩断所有未知因素对于非甲羟戊酸途径生物合成IPP和DMAPP的影响,净化大肠杆菌的代谢内环境。
2)合成和优化编码紫穗槐二烯合酶的基因 ADS。为了克服在原核生物中实现植物基因的表达这一困难,提高萜类合酶和紫穗槐二烯的表达量,Keasling 课题组合成和优化了 ADS 基因,使其在大肠杆菌中大量表达。通过合酶的高表达,克服微生物萜类合成的瓶颈。
3)将酿酒酵母中的甲羟戊酸途径转入大肠杆菌。为了提高细胞内 FPP 的浓度,将酿酒酵母中编码甲羟戊酸途径的 8 个基因做成操纵子转入大肠杆菌中并使其表达。同时为简化操作的复杂性,将这 8 个基因分成两类操纵子,上游操纵子通过三步酶促反应将普遍存在的前体物乙酰辅酶 A 转化成为甲羟戊酸;下游操纵子将甲羟戊酸转化成为 IPP 和(或)DMAPP。
4)平衡和优化合成途径。人工构建的合成紫穗槐二烯多步反应的许多中间产物(包括IPP),在高浓度时可导致菌体中毒。因此,必须协调IPP有关的基因以平衡其合成与消耗,确保在其能够杀伤大肠杆菌以前及时转化为紫穗槐二烯。
2006 年,在此项成果的基础上,研究人员修改了他们的最初方案,将酿酒酵母菌引入这项研究。利用工业酿酒酵母中工程化的甲羟戊酸途径、取自黄花蒿(Artemisia annua)的紫穗槐二烯合酶和细胞色素 P450 氧化还原酶(cytochrome P450 monooxygenase,CYP71AV1)共同作用来生产高浓度更直接的青蒿素前体衍生物——青蒿酸(artemisinic acid)(Ro et al., 2006)。
相比于常规的青蒿植物提取,4.5%干重的酵母能够生产1.9%的青蒿酸和0.16%的青蒿素,耗时仅4~5天,而植物提取却要几个月。此外,相比于植物提取青蒿素,微生物合成青蒿酸的方法不会受到诸如气候等因素的影响,制造出的青蒿素比从青蒿中提取的青蒿素纯度更高,且更加可靠和廉价。此外,这种新改良的大肠杆菌和酵母菌还可被改造用来生产其他类异戊二烯类化学物质。任何一家公司均可以对这些工程菌做相应的改造,加入一定数量的与目标产物合成有关的基因,即可得到任何一种类异戊二烯物质,用于其他疾病的治疗和其他物质的生产。由此可见,Keasling等的研究成果无疑是合成生物学在实际应用方面的一个里程碑,被评为当年的“世界十大科技进展”之一。
二、大肠杆菌成像系统
2005 年前后,加利福尼亚大学旧金山分校(UCSF)的 Christopher A. Voigt 课题组利用合成生物学手段在生物胶片方面取得了突破性进展,获得了人类继光学成像、电子学成像之后的又一种成像方式——微生物成像。
Voigt 课题组开发的这种微生物成像系统包含一种人工合成感应激酶,使大肠杆菌菌落能够发挥生物胶片的功能,通过光照产生分辨率高达 100 兆像素 / 平方英寸 $^{①}$ 的二维化学图像。不仅如此,这种对于微生物基因表达的空间调控,能够 “印制” 出复杂的生物元素,可用于研究微生物特定空间和时间控制下磷酸化步骤的信号转导途径等多种复杂的代谢通路。为此,年仅 30 岁的助理教授 Voigt 被 MIT 的《技术评论》杂志授予 2006 年 35 岁以下 35 名(TR35)重大技术创新奖。Voigt 课题组的 “大肠杆菌成像系统” 包括 3 个主要部分(Anselm et al., 2005)。
光感应器 大肠杆菌本身并没有感光系统,无法对光照刺激作出响应。因此,研究者将取自集胞藻的藻胆青素(phycocyanobilin,PCB)合成基因(ho1 和 pcyA)构建在质粒上转入大肠杆菌,这两个基因表达的产物能够将血红素转化为藻胆青素(藻胆青素是藻胆蛋白光敏色素的生色团,能够接受光照刺激)。有了含有这两个基因的质粒的帮助,大肠杆菌就有了能够感受光照刺激的 PCB,也就具有了感受光照刺激的功能。
应答调节器 除了感受光照刺激,还需构建应答调节器以便执行基因表达调控的功能。大肠杆菌中的“渗透压感应器”EnvZ-OmpR双组分系统能够调节孔蛋白 $^{①}$ (porin)作为对渗透压刺激的响应。EnvZ-OmpR系统由EnvZ和OmpR两种蛋白质组成,前者是一种组氨酸激酶,在高渗环境下能发生自身磷酸化,起感应器的作用;后者是反应调节子,含有天冬氨酸残基,能接受来自EnvZ的磷而被磷酸化,磷酸化的OmpR可作为转录因子而将来自EnvZ的信号输出,对ompC基因的启动子进行调控。
研究者通过特殊的处理手段将 EnvZ-OmpR 双组分系统与光敏色素脱辅基蛋白 Cph 进行交联,组成 Cph-EnvZ 嵌合体光感应系统,并优化其连接肽链的长度,挑选出响应最强烈的 Cph8 嵌合体作为最终实际应用的感应系统。
- 成像器 为了使这个感光系统产生“可视化”的图像效果,研究人员选用了特殊的大肠杆菌菌种,同时引入了lacZ基因。将lacZ基因与大肠杆菌染色体上的ompC基因做成融合基因,由OmpR蛋白控制这个融合基因的表达。lacZ基因编码的LacZ蛋白能够催化S-gal(一种稳定的可溶于水的DNA染色剂)产生黑色化合物。
由此,整个成像系统的所有部分构建完成,如图 10-13(a)所示。当有外界光照刺激时,感光蛋白接受光照刺激并阻遏 EnvZ 蛋白的自磷酸化过程,EnvZ 蛋白通过使 OmpR 蛋白也无法磷酸化,从而将 ompC 基因的启动子关闭,作为融合基因的 lacZ 基因也无法表达,此区域中无黑色化合物产生;相反,无光照的区域,EnvZ 的自磷酸化过程顺利进行,通过 OmpR 蛋白的磷酸化开启 ompC 基因的启动子,lacZ 基因顺利表达,编码的 LacZ 蛋白催化事先加入培养基中的 S-gal 染色剂产生黑色化合物,此区域为黑色。由此可见,有光照的区域为菌落原有的颜色,无光照的区域呈现黑色,随着照射在菌落上光照区域形状的不同,培养基会呈现不同的图像,如图 10-13(b)所示。

思考题
试举出一两个自然生物系统中存在的“非”门逻辑结构现象。
阅读参考文献 Bügl 等(2007),试画出带有“记忆”功能的“与”门逻辑线路图。
针对合成生物学所涉及的伦理道德问题和社会安全问题,您有哪些建议?

主要参考文献
宋凯. 2010. 合成生物学导论. 北京: 科学出版社
张春霆. 2007. 合成生物学: 我国急需发展的前沿科学. 前沿科学, 3: 55
Baker D, George C, Collins J J, et al. 2006. Engineering life: building a fab for biology. Sci Am, 294 (6): 44-51
Balagadde F K, You L, Hansen C L, et al. 2005. Long-term monitoring of bacteria undergoing programmed population control in a microchemostat. Science, 309 (5731): 137-140
Balmer A, Martin P. 2008. Synthetic biology: social and ethical challenges. An independent review commissioned by the Biotechnology and Biological Sciences Research Council (BBSRC)
Basu S, Gerchman Y, Collins C H, et al. 2005. A synthetic multicellular system for programmed pattern formation. Nature, 434 (7037): 1130-1134
Bhutkar A. 2005. Synthetic biology: navigating the challenges ahead. J Biolaw Bus, 8 (2): 19-29
Brent R. 2004. A partnership between biology and engineering. Nat Biotechnol, 22 (10): 1211-1214
Bügl H, Danner J P, Molinari R J, et al. 2007. DNA synthesis and biological security. Nat Biotechnol, 25 (6): 627-629
Chopra P, Kamma A. 2006. Engineering life through synthetic biology. In Silico Biol, 6: 401-410
Church G. 2005. Let us go forth and safely multiply. Nature, 438 (24): 423
Dreier B, Fuller R P, Segal D J, et al. 2005. Development of zinc finger domains for recognition of the 5’-CNN-3’ family DNA sequences and their use in the construction of artificial transcription factors. J Biol Chem, 280: 35588-35597
Elowitz M B, Leibler S. 2000. A synthetic oscillatory network of transcriptional regulators. Nature, 403: 335-338
Endy D. 2005. Foundations for engineering biology. Nature, 438: 449-453
Forster A C, Church G M. 2006. Towards synthesis of a minimal cell. Mol Syst Biol, 2: 45
Gardner T S, Cantor C R, Collins J J. 2000. Construction of a genetic toggle switch in Escherichia coli. Nature, 403: 339-342
Glass J I, Assad-Garcia N, Alperovich N, et al. 2005. Essential genes of a minimal bacterium. Proc Natl Acad Sci USA, 103: 425-430
Hashimoto M, Ichimura T, Mizoguchi H, et al. 2005. Cell size and nucleoid organization of engineered Escherichia coli cells with a reduced genome. Mol Microbiol, 55: 137-149
Hasty J, McMillen D, Collins J J. 2002. Engineered gene circuits. Nature, 420 (14): 224-230
Jacob F, Monod J. 1961. Genetic regulatory mechanisms in the synthesis of proteins. J Mol Biol, 3: 318-356
Keasling J. 2005. The promise of synthetic biology. Bridge Natl Acad Eng, 35: 18-21
Knight T. 2003. Idempotent Vector Design for Standard Assembly of BioBricks, MIT Artificial Intelligence Laboratory. http://hdl.handle.net/1721.1/21168
Kumar S, Rai A. 2007. Synthetic biology: the intellectual property puzzle. Tex Law Rev, 85: 1745-1768
Levskaya A, Chevalier A A, Tabor J J, et al. 2005. Engineering Escherichia coli to see light. Nature, 438: 441-442
Liang J, Luo Y, Zhao H M. 2011. Synthetic biology: putting synthesis into biology. Wiley Interdisciplinary Reviews: Systems Biology and Medicine, 3 (1): 7-20
Martin V J J, Pitera D J, Withers S T, et al. 2003. Engineering a mevalonate pathway in Escherichia coli for production of terpenoids. Nat Biotechnol, 21: 796-802
Matthias H, Sven P. 2006. Synthetic biology: putting engineering into biology. Bioinformatics, 22 (22): 2790-2799
Monod J, Jacob F. 1961. General conclusions: teleonomic mechanisms in cellular metabolism, growth, and differentiation. Cold Spring Harbor Symposia on Quantitative Biology, 26: 389-401
Nelson D L, Cox M M. 2000. Lehninger Principals of Biochemistry. 3th ed. New York: Worth Publishers
Pennisi E. 2005. Synthetic biology remakes small genomes. Science, 310: 769-770
Rai A, Boyle J. 2007. Synthetic biology: caught between property rights, the public domain, and the commons. PLoS Biol, 5 (3): e58
Ro D K, Paradise E M, Ouellet M, et al. 2006. Production of the antimalarial drug precursor artemisinic acid in engineered yeast. Nature, 440 (13): 940-943
Segal D J, Dreier B, Beerli R R, et al. 1999. Toward controlling gene expression at will: selection and design of zinc finger domains recognizing each of the 5’-GNN-3’ DNA target sequences. Proc Natl Acad Sci USA, 96:2758-2763
Sera T, Uranga C. 2002. Rational design of artificial zinc-finger proteins using a nondegenerate recognition code table. Biochem, 41: 7074-7081
Shetty R P, Endy D, Knight T F. 2008. Engineering biobrick vectors from biobrick parts. J Biol Eng, 2: 5
本章提要
本章主要介绍分子进化与系统发育的基本概念和理论,阐述几种分子系统发育树构建方法的基本原理,并说明了构建系统发育树的基本步骤,以 MEGA 等常用软件和在线工具为例,介绍系统发育树的应用。
了生物进化的重要著作《物种起源》(The Origin of Species),首次提出了进化论的观点。不久,德国学者海克尔(Ernst Heinrich Haeckle,1834~1919)依据进化论的思想绘制出了一棵“生命之树”,不仅丰富了达尔文的进化论学说,也使生命之树成为进化论中的一个标志性概念,重建地球上所有生命进化史的生命之树成为进化生物学家的梦想。然而,由于形态和生理特征的进化方式极其复杂,加上古生物的化石资料不够完整,“生命之树”存在不少争议,对分类单元何时与祖先分歧等细节性问题含糊不清。DNA等分子序列由于本身相对稳定性的进化演变过程和巨大的信息量等优势,大大提高了对物种间系统发育关系的推断能力。
第一节 分子进化与系统发育概述
20 世纪 50 年代以前,科学家们主要通过古生物学、形态学、胚胎发生学、比较解剖学、生物地理学、生理学和遗传学等方面的知识来研究生物进化的历程。50 年代以后,随着分子生物学和分子遗传学的兴起,生物学家开始从分子水平上探讨生物进化的原因和机制,并取得了显著的进展。在长期的进化过程中,生物大分子在分子水平上的变异会被积累起来,形成与其祖先存在很大差异的生物大分子。因此,在核酸和蛋白质分子组成的序列中,蕴藏着大量生物进化的遗传信息。根据各种生物间在分子水平上的进化关系,可以建立分子进化的系统发育树,估测物种间的亲缘关系,直观地阐明物种间的进化历程。
一、分子水平的进化
分子水平的进化主要是指在生物进化过程中,构成生物体的大分子物质,如蛋白质、核酸的演变过程。由于分子生物学的迅猛发展,许多生物大分子的结构已经基本了解。在对某些同源蛋白质(或核酸)进行比较时,发现不同生物间同源蛋白质(或核酸)在结构上存在差异。分子进化是发生在生物分子层次上的进化,是生物进化层次中最基础层次上的进化。在分子水平上,进化过程涉及在 DNA 中发生插入、缺失、倒位、替换等变异。如果发生变异的 DNA 片段编码某种多肽,那么这类变异就可能使多肽链中的氨基酸序列发生变化。
(一) 分子进化的特点
生物进化过程中生物大分子的演变,包括前生命物质的演变、蛋白质分子和核酸分子的演变,以及细胞器和遗传机构(如遗传密码)的演变。分子进化的研究可以为生物进化过程提供佐证,为深入研究进化机制提供重要依据。在生物大分子的层次上来观察进化改变时,看到的是一个非常不同于表型进化的过程。分子进化有两个显著特点,即进化速率的相对恒定性和进化的保守性。
- 生物大分子进化速率相对恒定 研究发现,以核酸和蛋白质一级结构分子序列中的核苷酸或氨基酸的替换数作为进化改变量,进化时间以年为单位,生物大分子随时间的改变(即分子进化速率)几乎是恒定的。一些资料表明,生物大分子进化中一级结构的改变或替换只与进化经历的时间相关,而与表型进化速率不相关。为什么生物大分子的进化速率如此稳定呢?一种可能的解释是:大分子一级结构中组成单元的替换是一个没有特殊驱动和控制的随机过程。不同物种同类型(同源)的核酸和蛋白质大分子,被认为有着相同的起源。研究这些大分子一级结构的改变,检测出不同物种间大分子序列中的核苷酸或氨基酸的替换数,再结合地质学上有关化石方面的数据,就可以确定生物大分子随时间而改变的速度,即分子进化速率。
随着不同生物来源的大量蛋白质序列的确定,Zuckerkandl 和 Pauling(1965)发现,来源于不同生物系统的同一血红蛋白分子的氨基酸随着时间的推移,以几乎一定的比例相互置换着,即氨基酸在单位时间以同样的速度进行置换,即某一蛋白质在不同物种间的取代数与所研究物种间的分歧时间接近正线性关系,进而将分子水平的这种恒速变异称为“分子钟”(molecular clock)。
- 生物大分子进化的保守性 生物大分子进化的保守性是指功能上重要的大分子或大分子的局部在进化速率上明显低于那些功能上不重要的大分子或大分子局部。例如,DNA 密码子中的同义替换比变义替换发生的频率高,因为前者不会引起对应的蛋白质分子氨基酸序列的任何改变。内含子内的碱基替换速率也相当高,大致等同于或略高于同义替换。假基因是丧失功能的基因,其替换速率更高。功能上重要的生物大分子和大分子的局部的进化保守性说明大分子进化并非完全随机。
(二)分子进化的中性学说
20 世纪 60 年代以后,随着分子生物学和分子遗传学的发展,许多生物大分子的一级结构逐渐清晰,使得估计进化过程中 DNA 和氨基酸等分子替换的速率及遗传变异模式成为可能。通过比较不同生物的某些功能相同的蛋白质或核酸的氨基酸或核苷酸序列的差异,人们发现,亲缘关系近的差异较小,亲缘关系远的差异较大,与物种的表型进化情况基本一致。人们又陆续发现蛋白质中氨基酸的置换是随机而非模式性的;DNA 在哺乳动物种系的总变异速率远远高于形态上的变异速率,并远远超出人们预期的大约 0.5 核苷酸 /(基因组·年);蛋白质电泳表明物种内存在大量的变异,即广泛的种内多态性,且这些多态性并无可见的表型效应,与环境条件亦无明显相关。以上这些都是新达尔文主义与综合进化理论所难以解释的。
Kimura(1968)根据核酸、蛋白质中的核苷酸及氨基酸的置换速率,以及这些置换所造成的核酸及蛋白质分子的改变并不影响生物大分子的功能等事实,提出了分子进化中性学说(neutral theory of molecular evolution)。分子进化的中性学说认为多数或绝大多数突变都是中性或近中性的,即无所谓有利或不利,自然选择对它们不起作用,因此对于这些中性突变不会发生自然选择与适者生存的情况。生物的进化主要是中性突变在自然群体中进行随机的“遗传漂变”的结果,而与选择无关,这些突变全靠一代又一代的随机漂变而被保存或趋于消失,从而形成分子水平上的进化性变化或种内变异。King 和 Jukes(1969)用大量的分子生物学资料进一步充实了这一学说。
中性学说揭示了分子进化的基本规律,是解释生物大分子进化现象的重要理论。中性学说强调遗传漂变和突变压在分子进化中的作用,是对综合进化论的重要补充和修正。中性学说一方面承认自然选择在表型进化中的作用,另一方面又强调分子水平上进化现象的特殊性。
(三)基因组计划与分子进化
人类基因组计划(human genome project,HGP)由美国科学家于1985年率先提出,于1990年正式启动。美国、英国、法国、德国、日本和中国科学家共同参与了这一耗资达30亿美元的基因组测序计划。人类基因组计划最主要的目的是测出人类基因组DNA的30亿碱基对的序列,发现所有人类基因,找出它们在染色体上的位置,破译人类全部遗传信息,解码生命,了解生命的起源,了解生命体生长发育的规律,认识种属之间和个体之间存在差异的起因,认识疾病产生的机制,以及长寿与衰老等生命现象,从而为疾病的诊治提供科学依据。
基因组计划已经基本完成,人类已经进入“后基因组学”时代。当前,基因组学研究重心已开始从揭示生命的所有遗传信息转移到在分子整体水平上对基因功能的研究,这种转向的一个标志是产生了功能基因组学这一新学科。随着生物学技术和计算技术的发展,逐渐形成了一种新的全局方法——基因组表达图谱(转录分析,如在 mRNA 水平上通过 DNA 芯片技术检测大量基因的表达模式)和大规模蛋白质图谱(蛋白组分析)方法。在使用全局方法进行研究时,研究人员同时检测大量基因的表达水平,从而在整体水平上获得关于基因功能及基因之间相互作用的信息,通过对不同物种、不同进化水平的生物的相关基因之间进行比较分析,揭示基因在生命系统中的地位和作用,解释整个生命系统的组成和作用方式。
(四)研究分子进化的意义
迄今为止,人类对于自然界和人类社会自身的发展还一直处于探索中。丰富多彩的生物界是怎样形成的?地球上最初的原始生命又是怎样产生的?综合众多学者长期深入的研究认为,生命的起源和发展需要经过两个过程。第一个过程是生命起源的化学进化过程(发生在地球形成后的10多亿年之间),即由非生命物质经过一系列复杂的变化,逐步变成原始生命的过程。第二个过程是生物进化过程(发生在30亿年以前原始生命产生到现在),即由原始生命继续演化,从简单到复杂,从低等到高等,从水生到陆生,经过漫长的过程直到发展为现今丰富多彩的生物界,并且继续发展变化的过程。在长期的自然选择过程中,微小的有利变异得到积累变为显著变异,从而产生了适应特定环境的生物新类型,这就是生物进化的原因。而以核酸和蛋白质为代表的生物大分子,在生物进化过程中起到“参与者”与“见证者”的作用;通过研究核酸和蛋白质这些生物大分子在物种间的变异速率,探讨进化过程,对研究生命起源具有重要意义。
二、分子系统发育分析的基本概念
(一)分子系统发育树的基本概念
从生物大分子的信息推断生物进化的历史,或者说“重塑”系统发生(谱系)关系,是分子系统学的任务。假如生物大分子进化速率是相对恒定的,那么大分子进化改变的量只与大分子进化所经历的时间呈正相关。如果我们将不同种类生物的同源大分子的一级结构做比较(假定这些大分子的结构顺序已知),其差异量(氨基酸或核苷酸替换数)只与所比较的生物由共同祖先分异以后所经历的独立进化的时间成正比。用这个差异量来确定所比较的生物种类在进化中的地位,并由此建立系统树,称为分子系统树。建立分子系统树的理论前提是
生物大分子进化速率相对恒定。
在研究生物进化和系统分类中,常用一种类似树状分支的图形来概括各种(类)生物之间的亲缘关系,这种树状分支的图形称为系统发育树(phylogenetic tree)。通过比较生物大分子序列差异的数值构建的系统树称为分子系统树(molecular phylogenetic tree)。分支的末端和分支的联结点称为结(node),代表生物类群,分支末端的结表示仍生存的种类。系统树可能有时间比例,或者用两个结之间的分支长度变化来表示分子序列的差异数值。
(二)有根树和无根树
系统发育树可分为有根树(rooted tree)和无根树(unrooted tree)两类(图11-1)。如图11-1(a)所示的是一棵有根树,而图11-1(b)显示的是一棵无根树,图中的A、B、C、D为所研究的分类单元。有根树是具有方向的树,包含唯一的节点,将其作为树中所有物种的最近共同祖先。最常用的确定树根的方法是使用一个或多个无可争议的同源物种作为“外群”(outgroup),这个外群要足够近,以提供足够的信息,但又不能太近,以致不能和树中的种类相混。把有根树去掉根即成为无根树。所谓“无根”,是指树系中代表时间上最早的部位(最早的共同祖先)不能确定,只反映分类单元之间的距离而不涉及谁是谁的祖先的问题。一棵无根树在没有其他信息(外群)或假设(如假设最大支长为根)时不能确定其树根。无根树是没有方向的,其中线段的两个演化方向都有可能。树系的末端代表现代生存的物种,称为顶结(terminal node),也称为外结(external node)或顶端(tip);树内的分支点叫内结(internal node);两结之间的连接部分称为分支或支(branche),也可称之为节(segment)或连接(link)。达到并终止于顶结的支叫周支(peripheral branch),未达到顶结的其他的支称为内支(interior branch)。系统发育树的支长表示进化距离的差异,通常进化树的标尺代表了每1000个核酸或蛋白质分子中的突变速率。
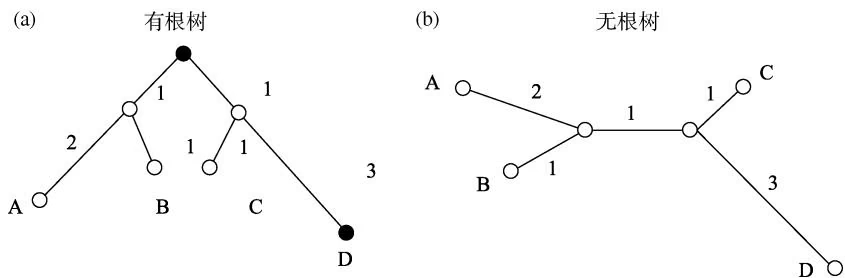
在一个无根的双分叉(每个内结有3个分支)的树系中,假如顶结数目为N,那么内结数目为N-2,分支(节)的数目为2N-3(其中内枝数目为N-3,周枝数目为N)。
(三)物种树和基因树 / 蛋白质树
基于单个同源基因差异构建的系统发生树称为基因树(gene tree)比称为物种树(species tree)更为合理,因为这种树代表的仅仅是单个基因的进化历史,而不是它所在物种的进化历史。物种树最好通过综合多个基因数据的分析结果而产生。
构建分子系统树,是在进行序列测定获得原始序列资料后,由计算机排序,使各分子的序列同源位点一一对应,然后计算相似性或进化距离。在此基础上,使用适当的计算机软件根据各生物分子序列的相似性或进化距离构建系统树。
Woese(1998,2000)根据某些代表生物 16S rRNA 或 18S rRNA 的序列比较,首次提出了一个涵盖整个生命界的系统树,而后又进行了多次修改和补充,图 11-2 就是近年提出的一个全生命系统树,该系统树勾画了生物进化的大致轮廓。从图 11-2 中可以看出,这是有根的树,根部的结代表地球上最先出现的生命,它是现有生物的共同祖先,生物最初的进化就从这里开始。16S rRNA 或 18S rRNA 序列分析表明,它最初先分成两支:一支发展成为今天的细菌(真细菌);另一支是古菌——真核生物分支,它在进化过程中进一步分叉,分别发展成古菌和真核生物。因此,该系统树所反映的进化关系表明,古菌和真核生物属“姊妹群”,它们之间的关系比它们与真细菌之间的关系更加密切。从该系统树中还可以看出,古菌分支的结点离根部最近,其分支距离也最短,这表明它是现存生物中进化变化最少、最原始的一个类群。真核生物则离共同祖先最远,它们是进化程度最高的生物种类。
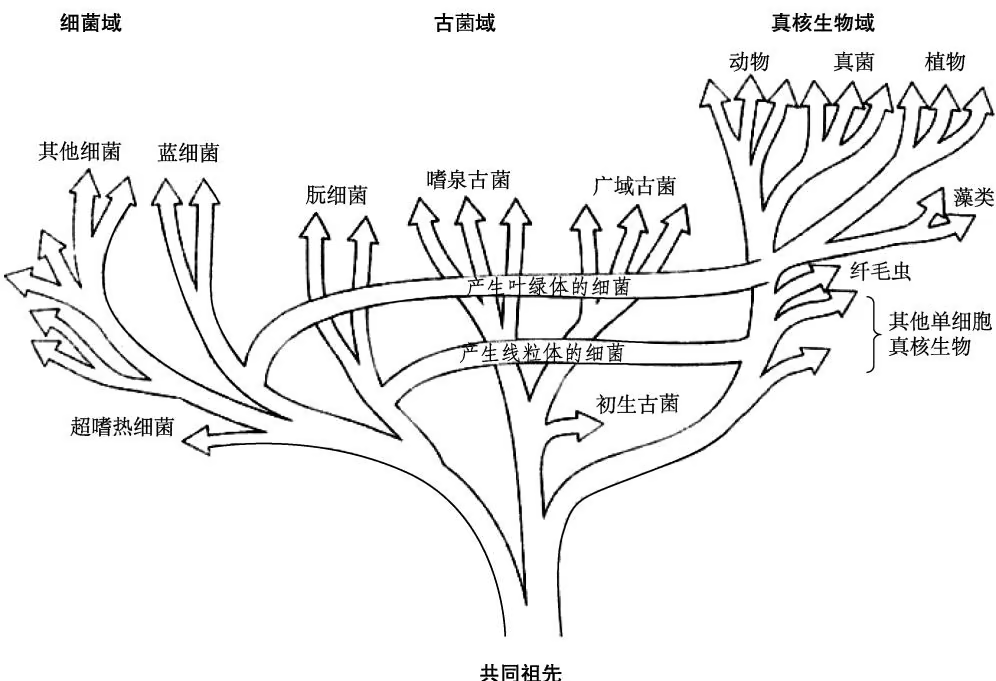
近年来,随着分子生物学的不断发展和基因组测序计划的实施,基因组的巨量信息推进分子进化研究再次成为生命科学中最引人注目的领域之一。这些重大问题包括遗传密码的起源、基因组结构的形成与演化、进化的动力、生物进化等。随着越来越多生物基因组的测序完成,人们开始从基因组水平上探索进化奥秘,从而发展和深化传统进化思想与分子进化分析方法。由于生命的蓝图是用 DNA 来书写的,因而人们可以通过比较 DNA 序列来研究不同生物之间的进化关系,构建 “进化树”。分子进化研究最根本的目的就是从物种的一些分子特性出发,从而了解物种之间的生物系统发生的关系。
分子生物学研究的深入也对现有进化理论提出挑战,促进其理论进一步完善。例如,人们发现,某些病毒的进化历史可能不是一种树状结构,而是一种网状结构如人畜共患病病毒位于不同的“树枝”上。因此,如果用“进化树”理论来研究病毒进化历史,就会存在缺陷。如何构建更为全面的进化网络,是摆在科学家面前的一项崭新课题。
第二节 分子系统发育树的构建方法
利用统计方法重建系统发育树分别独立地起始于形态学性状的数值分析法(Sneath and Sokal,1973)和分析基因频率数据的群体遗传学(Cavalli-Sforza and Edwards,1967)。分子进化的研究也出现在20世纪60年代,DNA技术革命使人们认识到DNA记录着进化的历史和信息。随着人类基因组计划的实施,分子数据每年以指数的方式逐步增长,所以利用核苷酸和氨基酸序列数据来重建系统发育树越来越受到人们的重视。分子系统发育分析是根据生物大分子序列差异来评估物种或分子间的进化的。尤其强调的是生物大分子,它与传统的形态学和基因频率数据有着明显的不同。
利用生物大分子数据重建系统进化树,目前最常用的有4种方法,即距离法、最大简约法、最大似然法和贝叶斯推断法。其中,最大简约法主要适用于序列相似性很高的情况;距离法在序列具有比较高的相似性时适用;最大似然法和贝叶斯法可用于任何相关的数据序列集合。
一、基于距离的系统发育树构建方法
基于距离的系统发育树构建方法的基本思路是:首先获取分类群间进化距离的度量,然后再依据距离度量来重建一棵系统发育树,并使得该树能最好地反映已知序列之间的距离。这类方法有非加权分组平均(unweighted pair group method with arithmetic mean,UPGAM)法、Fitch-Margoliash(FM)法、最小进化(minimum evolution,ME)法、最小二乘(least squares,LS)法和邻接(neighbor-joining,NJ)法等。在此,我们仅介绍非加权分组平均法、最小二乘法和邻接法的计算方法。
(一)非加权分组平均法
在所有的基于距离的系统发育树的重建方法中,非加权分组平均(UPGMA)法是最简单的一种方法。这种方法最早由 Sokal 和 Michener(1958)提出,并经过 Sneath 和 Sokal(1973)的改良而最终形成的。UPGMA 的基本思想是首先通过两两比对,计算出遗传距离;然后对遗传距离进行合并,重新计算出遗传距离,并将其作为进化树的分支长度;最后根据分支长度绘制进化树。UPGMA 主要适用于在基因替代速率恒定时,尤其是用基因频率数据来构建分子系统发育树时。该方法是建立在沿着树的所有分支的突变率相等的假设之上的,因此在不同分支间进化速率有较大差异或有同源序列的平行进化时常得出错误的拓扑结构。
- 算法 在 UPGMA 方法中,进化距离测度通过对所有序列对计算而获得。例如,若存在 5 条序列,它们之间的距离表示成矩阵形式为
| 序列 1 | 序列 2 | 序列 3 | 序列 4 | |
|---|---|---|---|---|
| 序列 2 | $d_{12}$ | |||
| 序列 3 | $d_{13}$ | $d_{23}$ | ||
| 序列 4 | $d_{14}$ | $d_{24}$ | $d_{34}$ | |
| 序列 5 | $d_{15}$ | $d_{25}$ | $d_{35}$ | $d_{45}$ |
在上面的距离矩阵中, $d_{ij}$ 表示第 i 条和第 j 条序列之间的距离。
序列的聚合起始于一对距离最小的序列。假设上述矩阵中 $d_{12}$ 为所有距离值 $d_{ij}$ 中的最小值,则序列 1 和序列 2 的聚合形成距离 $b=d_{12}/2$ 的一个分支点(假设自这个分支点到序列 1 和序列 2 的距离相同)。序列 1 和序列 2 聚合成一个复合序列或称为集合 $l=(1-2)$ ,而 l 和另一序列 k 的距离为 $d_{lk}=(d_{1k}+d_{2k})/2$ 。由此可以得到新的距离矩阵,即
| 集合 $l$ | 序列 3 | 序列 4 | |
|---|---|---|---|
| 序列 3 | $d_{i3}$ | ||
| 序列 4 | $d_{i4}$ | $d_{34}$ | |
| 序列 5 | $d_{i5}$ | $d_{35}$ | $d_{45}$ |
假设 $d_{l3}$ 为上一距离矩阵中的最小值,则集合 $l=(1-2)$ 和序列 3 合并为一新的集合 $m=(1-2-3)$ ,分支点为 b=d_{l3}/2=(d_{13}+d_{23})/(2\times2) 。新集合与其余各序列 k 之间的距离为 $d_{mk}=(d_{1k}+d_{2k}+d_{3k})/3$ 。由此得到的新的距离矩阵为
| 集合m | 序列4 | |
|---|---|---|
| 序列4 | $d_{m4}$ | |
| 序列5 | $d_{m5}$ | $d_{45}$ |
若距离 $d_{m4}$ 为以上距离矩阵中 3 个距离值的最小值,则将集合 m 与序列 4 合并为一新的集合 $n=(1-2-3-4)$ ,分支点为 b=d_{m4}/2=(d_{14}+d_{24}+d_{34})/(3\times2) 。因为在本例中仅有 5 条序列,则序列 5 会最后并入进化树,分支点为 b=(d_{15}+d_{25}+d_{35}+d_{45})/(4\times2) 。
若在第 2 个距离矩阵中不是 $d_{l3}$ 最小,而是 $d_{45}$ ,在这种情况下,首先将序列 4 和序列 5 合并为一个新的集合 $m=(4-5)$ ,分支点为 $b=d_{45}/2$ ,则形成的新的距离矩阵为
| 集合 $l$ | 序列3 | |
|---|---|---|
| 序列3 | $d_{l3}$ | |
| 集合 $m$ | $d_{lm}$ | $d_{3m}$ |
其中, $d_{3m}=(d_{34}+d_{45})/2$ ; $d_{lm}=(d_{14}+d_{15}+d_{24}+d_{25})/4$ 。
假设 $d_{lm}$ 为上述距离矩阵中的最小值,则集合 l 和 m 进行合并,最后序列 3 并入进化树。
通过上述分析过程可以看出,两个集合 A 和 B 之间的距离可以由以下公式计算,即
$$
d _ {\mathrm{AB}} = \sum_ {i j} d _ {i j} / (r s)
$$
式中,r 和 s 分别为集合 A 和集合 B 内的序列数; $d_{ij}$ 为集合 A 中的序列 i 和集合 B 中的序列 j 间的距离,这两个集合之间的分支点为 $d_{AB}/2$ 。
- 实例 设有 4 段序列,分别为 A:TAGG;B:TACG;C:AAGC;D:AGCC。利用 UPGMA 方法构建系统发育树。
首先利用序列间不同的分子数目作为序列间遗传距离的度量,则可以得到如下所示的距离矩阵。
| A | B | C | |
|---|---|---|---|
| B | 1 | ||
| C | 2 | 3 | |
| D | 4 | 3 | 2 |
其中,A 和 B 之间的遗传距离值 $d_{12}$ 最小,所以首先将 A 和 B 序列合并聚合,其分支点为 $b=d_{12}/2=0.5$ ,设合并之后的集合为 AB,此集合与 C 和 D 之间的遗传距离分别为 $(2+3)/2=2.5$ 和 $(4+3)/2=3.5$ ,其余值保持不变。则形成如下所示的距离矩阵
| AB | C | |
|---|---|---|
| C | 2.5 | |
| D | 3.5 | 2 |
此时,C 与 D 之间的遗传距离值 $d_{34}$ 最小,所以再将 C 与 D 进行合并聚合,其分支点为 $b=d_{34}/2=1$ ,设合并之后的集合为 CD。此时,集合 AB 与集合 CD 之间的遗传距离为 $(2.5+3.5)/2=3$ 。最后集合 AB 和集合 CD 进行合并聚合,归为一类,分支点为 $b=3/2=1.5$ 。最终,可以得到如图 11-3 所示的系统发育树。
(二)最小二乘法
如果进化谱系间的核苷酸替代速率不同,利用 UPGMA 法常常会给出错误的拓扑结构。在这种情况下,应该使用一些能容许各个分支核苷酸替代速率有所不同的方法,最小二乘法便是这样一种方法。
最小二乘法的基本思想是将成对距离矩阵作为给定数据,通过匹配那些尽可能近的距离来估计一棵树上的枝长,即对给定的和预测的距离差数的平方和最小化。预测距离是沿连接两个物种的通路的枝长总和计算的。距离差数平方和的最小值是树与距离相拟合的测度,它可以用作树的分值。
- 算法 设 $d_{ij}$ 是分类单元 i 和 j 的实际观察距离(或序列之间经过计算得到的遗传距离); $e_{ij}$ 是分类单元 i 和 j 在系统发育树中的距离,用于系统发育树推断的一般最小二乘法主要是将残差平方和最小化,即
1 | R _ {S} = \sum_ {i = 1} ^ {n} \sum_ {j \neq i} (d _ {i j} - e _ {i j}) ^ {2} = \min |
该方法为标准最小二乘法,在标准最小二乘法中,所有可能的拓扑结构的 $R_{S}$ 相比后, $R_{S}$
最小的拓扑结构即为最终的树。
除了上述的标准最小二乘法外,1967年Fitch和Margoliash又提出了加权最小二乘法,计算残差平方和的方法为
1 | R _ {S} = \sum_ {i = 1} ^ {n} \sum_ {j \neq i} W _ {i j} (d _ {i j} - e _ {i j}) ^ {2} |
式中, $W_{ij}$ 为 $1/d_{ij}$ 。
- 实例 对 Brown 等(1982)的线粒体数据在 K80 模型(Kimura,1980)下计算得到其遗传距离(表 11-1)。将这些遗传距离将作为观察数据,利用最小二乘法得出树 [(人、黑猩猩)、大猩猩、猩猩] 及它们的枝长 $t_0$ 、 $t_1$ 、 $t_2$ 、 $t_3$ 和 $t_4$ (图 11-4)。
表 11-1 Brown 等所测线粒体 DNA 序列的成对距离
| 人 | 黑猩猩 | 大猩猩 | |
|---|---|---|---|
| 黑猩猩 | 0.0965 | ||
| 大猩猩 | 0.1140 | 0.1180 | |
| 猩猩 | 0.1849 | 0.2009 | 0.1947 |
最小二乘标准的示意图
在这棵树上,人与黑猩猩之间的预测距离为 $t_{1} + t_{2}$ ,人与大猩猩之间的预测距离为 $t_{1} + t_{0} + t_{3}$ ,依此类推。
则距离的残差平方和为
1 | \begin{array}{r l} R _ {S} & = \sum_ {i = 1} ^ {n} \sum_ {j \neq i} (d _ {i j} - e _ {i j}) ^ {2} \\ & = (d _ {1 2} - e _ {1 2}) ^ {2} + (d _ {1 3} - e _ {1 3}) ^ {2} + (d _ {1 4} - e _ {1 4}) ^ {2} \\ & + (d _ {2 3} - e _ {2 3}) ^ {2} + (d _ {2 4} - e _ {2 4}) ^ {2} + (d _ {3 4} - e _ {3 4}) ^ {2} \end{array} |
其中,距离 $d_{ij}$ 为已知,则 $R_{S}$ 是 5 个未知枝长 $t_{0}$ 、 $t_{1}$ 、 $t_{2}$ 、 $t_{3}$ 和 $t_{4}$ 的函数。通过最小二乘法拟合,得到最小化的
$R_{S}$ 的枝长估计值为: $t_{0}=0.008\ 840$ 、 $t_{1}=0.043\ 266$ 、 $t_{2}=0.053\ 280$ 、 $t_{3}=0.058\ 908$ 、 $t_{4}=0.135\ 795$ 。对应的距离的残差平方和为: $R_{S}=0.000\ 354\ 7$ 。
(三)邻接法
邻接法也是一种利用距离进行分子系统发育分析的方法,它由 Saitou 和 Nei 在 1987 年首先提出。在构建系统发育树时,由于该方法取消了非加权分组平均法关于分子钟速率相等的假设,所以该方法在进化分支上允许发生趋异的次数可以不同,该方法通过确定距离最近(或相邻)的成对分类单元来使系统树的总长度尽可能达到最小。与非加权分组平均法相比,邻接法在算法上相对复杂,它跟踪的是树上的节点而不是分类单元。
- 算法 邻接法的基本思想是:在构建系统发育树时,首先将序列构建一棵星状树,算出总树枝长度;然后将两个序列作为聚合群(邻居)与其他序列分离开来,再算总枝长,合并两个序列使算出的总枝长在各种合并方式中是最短的;将合并的序列作为一个序列再重复上述过程;全部序列合并完后,即整个循环直到只剩下一个类为止,画出进化树。
在每一次循环中,都要在树中寻找两个分类单元的直接祖先。对于节点 x,到其他节点的距离 $d_{x}$ 的计算方法为
1 | d _ {x} = \frac {1}{n - 2} \sum_ {x \neq y} d _ {x y} |
式中, $d_{xy}$ 为分类 x 和分类 y 之间的距离,是动态更新的距离矩阵 D 中的元素。为了使所有分支长度的和最小(或称为最小进化原则),选择 $d_{xy}-d_{x}-d_{y}$ 最小的一对节点 x 和节点 y 进行归并(图 11-5)。
邻接方法构建系统发育树的一般步骤如下所述。
1)计算第 i 终端节点(即分类单元)的净分歧度 $r_{i}$ ,计算方法为
图 11-5 寻找一对节点 x 和 y,使这两个节点靠近,但同时远离其他节点
$$
r _ {i} = \sum_ {k = 1} ^ {N} d _ {i k}
$$
式中,N 为终端节点数; $d_{ik}$ 是节点 i 和节点 k 之间的距离, $d_{ik}=d_{ki}$ 。
2)计算并确定最小速率校正距离(rate-corrected distance) $M_{ij}$ ,方法为
$$
M _ {i j} = d _ {i j} - \frac {r _ {i} + r _ {j}}{N - 2}
$$
3)定义一个新节点 u,u 节点由节点 i 和 j 聚合而成,节点 u 与节点 j 的距离为
$$
\begin{array}{r} S _ {i u} = \frac {d _ {i j}}{2} + \frac {r _ {i} - r _ {j}}{2 (N - 2)} \ S _ {j u} = d _ {i j} - S _ {i u} \end{array}
$$
节点 u 与系统发育树其他节点 k 的距离为
$$
d _ {k u} = \frac {d _ {i k} + d _ {j k} - d _ {i j}}{2}
$$
4)从距离矩阵中删除节点 i 和 j 的距离,N 值(总节点数)减去 1。
5)如果尚余2个以上的终节点,返回步骤1)重新计算,直至系统发育树完全构建。
- 实例 设有 4 段序列,分别为 A:TAGG; B:TACG; C:AAGC; D:AGCC,利用邻接法构建系统发育树。
1)两两比对,并计算遗传距离。
2)构建一棵星状树,算出总树的树枝长度。星状树如图 11-6 所示,其分支长分别为
$$
\begin{array}{l} a + b = d _ {\mathrm{AB}} = 1 \ a + c = d _ {\mathrm{AC}} = 2 \ a + d = d _ {\mathrm{AD}} = 4 \ b + c = d _ {\mathrm{BC}} = 3 \ b + d = d _ {\mathrm{BD}} = 3 \ c + d = d _ {\mathrm{CD}} = 2 \end{array}
$$
利用序列间的距离求出星状树(图 11-6)的总枝长 $S_{0}$ ,即
$$
S _ {0} = a + b + c + d = \left(d _ {\mathrm{AB}} + d _ {\mathrm{AC}} + d _ {\mathrm{AD}} + d _ {\mathrm{BC}} + d _ {\mathrm{BD}} + d _ {\mathrm{CD}}\right) / 3 = 5
$$
3)筛选出第1对邻居。
先将序列 A 和序列 B 作为邻居与其他序列分离开来,如图 11-7 所示。
设 $S_{AB}$ 为当 A 与 B 为邻居时的总枝长,根据图 11-7,可以利用序列两两之间的距离求出 $S_{AB}$ 。
1 | arrayr l S _ AB & = a + b + c + d + e |
同理求得 $S_{AC}=5$ 、 $S_{AD}=5.5$ 、 $S_{BC}=5.5$ 、 $S_{BD}=5$ 、 $S_{CD}=4.5$ 。
由此可知,在上述树中,当序列 A 和 B 为邻居或者序列 C 和 D 为邻居时,整棵树的总枝长最短。以序列 A 和 B 为邻居与序列 C 和 D 为邻居时计算出的最终结果是相同的,现在分析一下以 A 和 B 为邻居时的情况。枝长 a 和枝长 b 分别为
1 | arrayr l a & = [ d _ AB + (d _ AC + d _ AD ) / 2 - (d _ BC + d _ BD ) / 2 ] / 2 |
将序列 A 和 B 合并为一个集合 H,这时需要计算出 H 到其他序列之间的距离,其距离矩阵为
| H | C | |
|---|---|---|
| C | 2 | |
| D | 3 | 2 |
4)重复第2)步和第3)步驯化操作,继续选出邻居,直至全部序列合并成一类。利用3个序列构建一颗星状树,如图11-8所示。利用这3段序列之间的距离求出星状树总枝长,即
1 | S _ 0 ^ = h + c + d = (d _ HC + d _ HD + d _ CD ) / 2 = 3. 5 |
先将集合 H 与 C 作为邻居与其他序列分离开来,得如图 11-9 所示的树。
则总枝长 $S_{HC}$ 为
1 | arrayr l S _ HC & = h + c + f + d |
同理可以求得 $S_{HD}=3.5,\quad S_{CD}=3.5$ 。
由此可以看出,当 H、C、D 任意两段序列为邻居,或者三序列呈星状树时,整棵树的总
枝长均为 3.5,采用上述的树都得到相同的结果。
现分析 H 与 C 为邻居时的情况,其枝长分别为
1 | arrayr l & h = (d _ HC + d _ HD - d _ CD) / 2 |
将集合 H 与序列 C 合并为一新的集合 J,则集合 J 与序列 D 之间的距离为
1 | arrayr l d _ JD & = (d _ HD + d _ CD - d _ HC ) / 2 |
- 画出进化树。根据以上的计算结果,可以画出如图 11-10 所示的系统发育树。
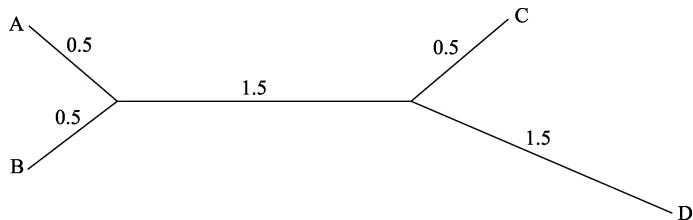
二、最大简约法
最大简约(maximum parsimony)法是一种常用的系统发生学分析的方法,根据离散性状[包括形态学性状和分子序列(DNA 和蛋白质等)]的变异程度,构建生物的系统发育树,并分析生物物种之间的演化关系。在最大简约法的概念下,生物演化应该遵循简约性原则,所需变异次数最少(演化步数最少)的演化树可能为最符合自然情况的系统树。在具体的操作中,分为非加权最大简约分析(或称为同等加权)和加权最大简约分析,后者是根据性状本身的演化规律(如 DNA 不同位点进化速率不同)而对其进行不同的加权处理。
在最大简约分析中,只有在两个以上分类单元中存在差异的性状或位点才能为构建系统发育树提供有效的信息,对于 DNA 序列来说,这样的位点称为简约性信息位点(parsimony-informative site)。对于简约性信息位点,要在两个以上分类单元中存在差异,并且要有两个以上不同的状态。因此,数据集中在所有分类单元中状态恒定的位点和只出现一次的变异的位点都是非简约性信息位点(uninformative site)。
对一组数据的分析可能得到多棵同等简约树,即这些系统树具有同样的演化步数,在后续的分析中应构建这些同等简约树的合意树,并侧重分析保持率较高的分支。另外,加权简约分析在某种程度上可以提高最大简约法的效力,并可能更真实地反映生物的自然演化过程。由于趋同演化现象的存在,最大简约法有时会使原本具有不同进化过程的生物被归为一支,因此,一般而言,最大简约法大多使用于相近物种之间演化关系的分析。
(一)最大简约法的基本思想
对于系统发育树最直接的计算方式就是沿着各个分支累加特征变化的数目,而简约的含义即代价最小,所以,利用最大简约法构建系统发育树的过程,就是一个对给定分类单元所有可能的树进行比较的过程。针对某一个可能的树,首先对每个位点祖先序列的核苷酸(或氨基酸)做出推断,然后统计每个位点用来阐明差异的核苷酸(或氨基酸)的最小替换数目。在整个树中,所有简约信息位点的最小核苷酸替换数的总和称为树的长度或树的代价。通过比较所有可能的树,选择其中长度最小、代价最小的树作为最终的系统发育树,即最大简约树(maximum parsimony tree)。
最大简约法在分析过程中最大的优势在于可以相当准确地推断出祖先序列。推断祖先核苷酸序列,对于单个核苷酸来说是微不足道的,可是对于基因或基因组,从了解进化过程来看,具有非常重要的作用。利用最大简约法推断出祖先序列,不仅可以填补分子进化研究中的空白,还可以从现存的后代序列中客观推断出中间状态,这也是最大似然法对进化理论的最大贡献。
利用最大简约法构建系统发育树的一般步骤是:①序列比对;②写出所有可能的树;③分析信息位点;④将每棵树的信息位点上的字符替换树相加,寻找最小替换的树。
(二)最大简约树的搜索策略
当所分析的序列数或者物种数(m)比较小时,如一般情况下 m<10,就可以直接计算出所有可能树的长度并确定最大简约树,这类寻找最大简约树的方法称为穷举式搜索。但是,树的数量会随着序列或者物种数目的增长而呈指数增长,当 m 很大时就基本不可能检查所有的树。此时有两种方法用来搜索最大简约树,一个是分支界限法,另一个是启发式搜索法。
- 分支界限法 分支界限法最早由 Hardy 和 Penny 于 1982 年引入简约分析,该方法的基本思想是:树长明显超过预先检测的树被忽略掉,通过估计一群可能有更短树长的树来决定最大简约树,它包含两个基本步骤。①为最大简约树的树长设定一个上限 L,L 的值可以采用随机选择的任何一棵初始树的长度;②树的生长过程,即在描述部分物种之间关系的树中每次增加一个分支。在分析过程中,如果发现比建立初始上限的树替换数更小的树,L 的值将随之修正。
与穷举搜索法一样,分支界限法能够保证在分析完成时没有遗漏的更加简约的树;它还有比穷举搜索快的优点,所以能够分析多达20条序列,但是该方法当m在20左右或者20以上时耗时较长。
- 启发式搜索法 当序列数或物种数比较大的时候,由于所能生成的树的数目会呈指数级增长,这时再采用穷举搜索几乎不能完成。因而必须采用近似而更加有效的算法,但是这样的算法不一定能找到最大简约树。常采用的方法为启发式搜索法。
启发式搜索法并不逐个分支地构建所有可能的树,而是通过子树分支交换(branch swapping),把它们嫁接到该步分析汇总找到的那棵树的其他位置上,从而产生一棵拓扑结构与初始树相类似的树。首先构造出一棵初始树,从初始树开始搜索更短的树。在第一轮分析中,初始树产生出若干棵新树,其中所有比初始树短的新树都在第二轮中被剪枝和嫁接。不断重复这个过程,直到某一轮通过剪枝和嫁接无法产生与前一轮等长或更短的树。
在启发式搜索中,采用的方式是逐步加入来寻找最大简约树。基本思路是:首先建立3个物种的初始树,接下来将第4个物种插入初始树的3个分支中的一个,用MP法计算树长;对另外2个分支也采用同样的方法进行计算,记录3个树长中的最小值;然后,有最小树长的4个物种树将用于下一个物种的插入;不断重复这一过程,至包含所有物种的树产生为止,这时就是临时的MP树。接下来采用分支交换策略来找到一个树长更小的树,满足一定条件则停止交换,此时得到的树就是最大简约树。
- 实例 设有 4 段序列,分别为 d1:TAGG;d2:TACG;d3:AAGC;d4:AGCC,利用最
大简约法构建系统发育树。
首先写出所有可能的树,由于这是4个类群,所以有3种进化树的类群,如图11-11所示。
根据多序列的比对可知,这 4 段序列的 4 个位点均为信息位点。首先来分析第一个信息位点中的碱基替换情况,如图 11-12 所示,在 3 种结构的树中信息位点的替换情况依次是 1 次、2 次和 2 次。
同理可得第二信息位点在 A、B 和 C 3 种树的碱基替换情况依次是 1 次、1 次和 1 次;第三信息位点的碱基替换为 2 次、1 次和 2 次;第四信息位点的替换情况为 1 次、2 次和 2 次。
最后汇总一下 A、B 和 C 3 种树的碱基替换分别为 5、6 和 7。在这 3 种树中,树 A 具有最少的替换数,所以树 A 即为最大简约树。
三、最大似然法
最大似然(maximum likelihood,ML)法是一种比较成熟的参数估计的统计方法。该方法在当样本很大时,可以获得参数估计的最小方差。最大似然的参数估计方法最早是由高斯(C. F. Gauss)提出来的,而后由费舍尔(R. A. Fisher)于1912年重新提出,并证明了这一方法的性质。利用最大似然法构建系统发育树,最早是由Cavalli-Sforza和Edwards于1967年提出的,最初用于构建基于基因频率的系统发育树。Felsenstein将该方法引入基于核苷酸的系统发育树的构建,然后又拓展到氨基酸序列数据。
利用最大似然法构建系统进化树基于两条基本假设:不同的性状进化是独立的;物种发生分化后的进化是独立的。最大似然法试图避免其他方法的局限性。与距离法不同的是,最大似然法试图充分利用所有资料而不是将资料减缩为距离的集合;与最大简约法的不同之处在于其进化概率模型采用了标准的统计方法。所以,最大似然法的计算量也是最大的。
最大似然法是一类完全基于统计方法的系统发育树构建方法。在 ML 法中,以一个特定的替代模型分析既定的一组序列数据,使所获得的每一个拓扑结构的似然率均为最大,挑出其最大似然值最大的拓扑结构,并将其选为最终树。所考虑的参数不是拓扑结构而是每个拓扑结构的枝长,并对似然值求最大来估计枝长。单个位点的似然值是指在核苷酸替代模型中该位点每个可能被取代或再现的概率之和,进化树的似然值就是所有位点似然值的乘积。最大似然法的核心是在比对中充分考虑每个核苷酸的概率。例如,转换出现的概率大约是颠换的3倍。设一个3条序列的比对中,如果发现其中有一列为一个C、一个T和一个G,则认为C和T所在的序列之间的关系很有可能更接近。
(一) 算法
在最大似然法中,以一个特定的替代模型分析既定的一组序列数据,使所获得的每一个拓扑结构的似然值均为最大,筛选出其最大似然值的拓扑结构为最终树。
我们首先解释一下怎样计算一个给定的 DNA 树的似然值。考虑一个简单的 4 类群的树,并假定这个 DNA 序列为 n 个核苷酸长度,且没有插入或缺失,如图 11-13 所示。
根据图 11-13,假设进化是从树的一个内部节点 d5 开始,则任意一个位点 X(序列比对排列后的 X 列)的似然函数为
$$
l _ {X} = f _ {d 5} \cdot P _ {d 5 d 1} (V 1) \cdot P _ {d 5 d 2} (V 2) \cdot P _ {d 5 d 6} (V 5) \cdot P _ {d 5 d 3} (V 3) \cdot P _ {d 5 d 4} (V 4)
$$
式中, $l_{X}$ 为似然函数; $f_{d5}$ 为节点 d5 为某个字符时的概率; $P_{d5d1}$ (V1)为从节点 d5 的字符替换到节点 d1 的字符的概率,依此类推。
上式中的概率 $P_{ij}(V)$ 和 $P_{ii}(V)$ 可用下式来表示:
$$
\begin{array}{c} P _ {i j} (V) = f _ {j} \cdot (1 - e ^ {- V}) \ P _ {i i} (V) = f _ {i} + (1 - f _ {i}) e ^ {- V} \end{array}
$$
式中, $P_{ij}(V)$ 为字符 i 替换到字符 j 的概率; $P_{ii}(V)$ 为字符 i 不变的概率; $f_{j}$ 为字符 j 的出现频率; $f_{i}$ 为字符 i 的出现频率;V 为枝长。V 表示分支上的字符预期替代数,因此 $V \geqslant 0$ 。用最大似然法对上述 4 个序列进行系统发育分析,就是要计算一棵树中每一个位点(序列比对排列后的每一列)中所有可能的字符替换情况的 $l_{X}$ ,再求这些 $l_{X}$ 之和 $l_{sum}$ ,然后求所有位点的 $l_{sum}$ 之积 L,最后比较每棵树的 L,取最大值的树作为结果。
(二)实例
下面举例说明最大似然法构建系统发育树的过程。
设 d1: AAC; d2: AAT; d3: GGC; d4: GGT 为 4 个物种的 DNA 序列,请根据这 4 段序列用最大似然法构建系统发育树,假设枝长都为 0.1。
经多序列比对之后,计算 4 条序列中 A、T、G、C 的平均核苷酸频率:
$$
f _ {\mathrm{A}} = 4 / 1 2 = 1 / 3; f _ {\mathrm{T}} = 2 / 1 2 = 1 / 6; f _ {\mathrm{G}} = 4 / 1 2 = 1 / 3; f _ {\mathrm{C}} = 2 / 1 2 = 1 / 6
$$
在本例中,涉及 3 个不同的拓扑结构,如图 11-14 所示。
假设树A的两个内部节点分别为 $d5$ 与 $d6$ ,并假设进化是从树A的一个内部节点 $d5$ 开始,则任意一个位点(即任一列) $X$ 的似然函数为
1 | \begin{array}{r l} l _ {1 \text {sum}} & = l _ {1 \mathrm{AA}} + l _ {1 \mathrm{AG}} + \dots + l _ {1 \mathrm{TT}} \\ & = f _ {\mathrm{A}} \cdot P _ {\mathrm{AA}} (0. 1) \cdot P _ {\mathrm{AA}} (0. 1) \cdot P _ {\mathrm{AA}} (0. 1) \cdot P _ {\mathrm{AG}} (0. 1) \cdot P _ {\mathrm{AG}} (0. 1) \\ & + f _ {\mathrm{A}} \cdot P _ {\mathrm{AA}} (0. 1) \cdot P _ {\mathrm{AA}} (0. 1) \cdot P _ {\mathrm{AC}} (0. 1) \cdot P _ {\mathrm{CG}} (0. 1) \cdot P _ {\mathrm{CG}} (0. 1) \\ & + \dots \\ & + f _ {\mathrm{T}} \cdot P _ {\mathrm{TA}} (0. 1) \cdot P _ {\mathrm{TA}} (0. 1) \cdot P _ {\mathrm{TT}} (0. 1) \cdot P _ {\mathrm{TG}} (0. 1) \cdot P _ {\mathrm{TG}} (0. 1) \\ & = 8. 7 1 \times 1 0 ^ {- 3} \end{array} |
这个公式的总项数是 16 项,因为节点 5 和节点 6 各有 4 种不同的核苷酸。
同理可得第2位点和第3位点的似然值为: l_{2\mathrm{sum}} = 8.71 \times 10^{-3} , l_{3\mathrm{sum}} = 6.67 \times 10^{-5}
则树 A 的对数似然函数值为: $\ln L_{\mathrm{A}}=\ln\left(l_{1\mathrm{sum}}\cdot l_{2\mathrm{sum}}\cdot l_{3\mathrm{sum}}\right)=-19.10$
同理可以获得树 B 和树 C 的对数似然函数值为: $\ln L_{B}=-21.12,\quad\ln L_{C}=-24.55$
通过比较可知,树 A 的对数似然值为最大,则树 A 即为所求的最大似然进化树。
在上例中,为了方便计算,我们首先确定了系统发育树的枝长,而在实际中,枝长是通过最大似然法进行估计的,所以计算量就要复杂得多。
四、贝叶斯推断法
贝叶斯推断(Bayesian inference,BI)法是最近几年发展起来的一种构建系统发育树的统计学方法。与最大似然法相比,贝叶斯推断法的优势主要在于其一方面运行速度较快,能够处理较大的数据集;另一方面可以提供了衡量可信性的有效参数——后验概率(posterior probability,PP),后验概率最大的树即为最优的系统发育树。
系统发育树的贝叶斯推断是建立在后验概率的基础上的,基本思想为
1 | P (\text { Tree } \mid \text { Data }) = \frac {P (\text { Data } \mid \text { Tree }) \cdot P (\text { Tree })}{P (\text { Data })} |
被用于整合树的先验概率 $P$ (Tree)和似然 $P$ (Data|Tree),可以获得树的后验概率分布。树的后验概率 $P$ (Tree|Data)可视为该树为真的可能性。
因为后验概率不仅涉及所有的树,而且每一棵树还整合了枝长和替代模型参数值的所有可能组合,所以不可能采用常规的分析方法解决。最常用的是 MCMC(Markov chain Monte Carlo)方法,其基本思想是构造出一条马尔可夫链,该链的状态空间为统计模型参数和不变的后验分布参数,然后通过计算机模拟获得后验概率。实际计算时,通常是同时建立多个马尔可夫链,每隔若干代抽取 1 棵树,当其全部由动态进入静态后,再运算若干代,然后忽略动态下的抽样,仅对静态下的抽样计算合意树,分支出现的频率即后验概率,该方法同时还给出模型参数的平均数、方差和置信区间。贝叶斯推断法将先前的系统发育树构建和评估这两个过程合二为一,最后得到的树不仅反映了系统发育关系的最佳估计,而且提供了有关分支的确切支持强度。
有关贝叶斯推理、马尔可夫模型理论部分内容见第十二章第四节、第五节。
第三节 系统发育树构建及应用
一、构建系统发育树的步骤
利用生物大分子序列进行系统发育树的构建,一般分为4个步骤:①选择适合的分子序
列;②多序列比对;③选择适合的建树方法;④系统发育树的评估。
(一)选择适合的分子序列
生物体不同株系后代的 DNA 在进化过程中将会累积突变,并导致大分子序列产生分歧(DNA、RNA 和蛋白质序列)。而分子系统发育分析即利用这些存在一定分歧的同源序列来构建系统发育树。
系统发育树可以用 DNA、RNA 或蛋白质序列数据来构建。通常情况下,对于系统发育分析,DNA 序列所包含的信息量要比蛋白质序列多。所以,利用 DNA 序列比利用蛋白质序列将更加精确地获取系统发育树,原因包括多个方面:
1)基因的编码区可以发生同义或非同义替换事件,利用 DNA 序列不仅可以获取引起氨基酸改变的非同义替换的信息,更能获得不引起氨基酸改变的同义替换的信息。
2)通过比较非同义替换 $(d_{\mathrm{N}})$ 和同义替换率 $(d_{\mathrm{S}})$ 可以显示出基因序列是经历了正选择还是纯化选择。纯化选择表现为氨基酸序列的改变会受到限制,而反映在DNA序列上是 $d_{N}<d_{S}$ ,由于大部分蛋白质序列要维持功能的稳定性,故经历纯化选择作用的比较多;正选择在DNA序列上的表现为 $d_{N}>d_{S}$ ,正选择更容易引起蛋白质序列的改变,并促进基因形成新的功能。
3)非编码区由于受到较小的进化选择压力,会发生更多的中性突变,也可用于系统发育树的构建。
4)利用 DNA 序列还可以对转换和颠换的速率进行估计。
基于 DNA 序列能够比蛋白质序列提供更多的信息量,在当一个基因的改变非常慢时,或者当研究进化关系的物种具有非常近的亲缘关系时,利用 DNA 序列往往是比较好的选择。而当被研究的物种间进化距离比较远,以至于任何一个 DNA 序列相对而言都是饱和的,导致在系统发育树构建时会损失信息量,此时利用蛋白质的 20 种氨基酸来替代只有 4 种核苷酸的 DNA,则会产生比较好的效果。
(二)多序列比对
多序列比对不仅是生物信息学的核心问题之一,也是系统发育分析中的一个基础步骤和关键环节。多序列比对的结果将直接影响系统发育分析的结论。如果对一组序列进行了错误的比对,依然可以生成一棵系统发育树,但是这样建立的系统发育树没有任何生物学意义。因此在为系统发育分析准备多序列比对时,有一些问题也需要特别注意。
若采用的是基因的编码序列构建系统发育树,由于核苷酸序列翻译成氨基酸序列时是按照三联体密码的形式进行的,因此这类核苷酸序列比对后产生的空位数目也应该是3或3的倍数。如果产生的空位不是3或3的倍数,说明多序列比对的结果不正确,或没有生物学意义。对这类数据最好的办法是按照氨基酸序列比对,然后根据氨基酸比对的结果,相应调整核苷酸序列比对结果。
进行系统发育树的构建,根据二级或三级序列结构进行比对比直接利用一级序列进行比对的可信度要好,这主要是因为复杂结构的保守性高于简单特征(核苷酸、氨基酸)的同源保守性;此外,通过复杂结构的比对程序还可以搜索到一些特殊的关联位点,这些位点是进化的功能区域。例如,核糖体基因的二级结构通常为茎环(stem loop)结构,茎区多为保守的,而环区则高度可变。若在进行比对的类群中有相应的二级结构,则应该根据二级结构来进行比对。
当序列分歧度很大或者有大的插入 / 缺失(indel)片段时,如何处理这些区域中 indel 状态的位点将取决于进化模型的所有要素(包括核苷酸转换或颠换速率),而且相关的参数在前导树与比对推导的进化树中应该保持一致。所以,在进行多序列比对时,一方面,比对参数应该随着进化的分支动态变化,以保证降低碱基错配的概率;另一方面,比对参数应该随时调整,以防止过多近似序列导致的信息量不足。
(三)选择适合的建树方法
本章前面介绍了几种构建系统发育树的方法,其中最大简约法主要适用于序列相似性很高的情况;距离法在序列具有比较高的相似性时适用;而最大似然法和贝叶斯推断法可用于任何相关的数据序列集合。从计算速度来看,距离法的计算速度最快,其次是最大简约法和贝叶斯推断方法,然后是最大似然法。在实际应用中,既要考虑计算速度,又要考虑分子数据的特点和方法的应用范围。
在构建系统发育树的所有方法中,距离法是一种纯数学算法,通过序列两两之间的差异决定发育树的拓扑结构和枝长,它将发育树的构建和最优树的确定融合在一起,构建发育树的过程也就是寻找最佳树的过程。距离法的计算速度比较快,然而值得注意的是,距离法在将原始数据转换成距离矩阵时难免会丢失一些进化信息。
最大简约法和最大似然法是从数学角度在评价树的最优标准的基础之上找到使目标函数最优的树。最大简约法能快速分析出序列之间的系统发育关系,所构建的系统发育树中的短分支更接近于真实。但当 DNA 序列的进化速率在不同分支上相差很大或亲缘关系太远时,最大简约法的单一突变图谱可能会得出似是而非的结论。由于没有考虑核苷酸的突变过程,使得长分支末端的序列由于趋同进化而显示较好的相似性,趋同现象违背了简约法则,导致的结果是对“长枝吸引”的敏感。
最大似然法充分考虑了所有可能的突变路径,能完全利用数据的系统发育信息。然而,最大似然法构建系统发育树的核心在于对核苷酸替代模型的选择,不同位点的核苷酸替代速率不一致,在核苷酸替代一般模型中包含了反映进化过程的参数,但是并非替代模型越复杂,结果就越理想。此外,由于计算每个树的似然值算法的复杂性,以及基于最优标准算法的复杂性,使得最大似然法在分类群较多时十分费时,这也是其应用的最大障碍。
贝叶斯推断法的分析结果取决于所有可能参数值,寻找对参数的最广泛的支持,因而可以得到比最大似然法更好的结果,尤其是相对参数的数据量较少时,往往可以得到比最大似然法更加可靠的结果。然而,贝叶斯推断法的后验概率对先验概率十分敏感,而先验概率分布与进化模型参数(分支长度、拓扑结构和核苷酸替代模型)息息相关,所以其值完全依赖于数学上的计算,没有考虑生物学背景知识,因此该方法具有一定的主观性,在客观证据十分确凿的情况下就不宜再使用。
(四)系统发育树的评估
在系统发育树的构建过程中,我们可以根据各种构建系统发育树方法的特点选择合适的方法。一棵用距离法、最大简约法或最大似然法构建的系统发育树可以看作是一个点估计,对这个点估计最好加上一个可靠性测度。
- 重复抽样检验 评价系统发育树中每一分支的可靠性,在统计学上用重复抽样的方式来排除随机误差的影响。目前主要有两种重复抽样检验方法来检验系统发育树的可靠性:自展检验(bootstrap)和折刀法(jack knife)。
自展检验是一种现代统计技术,该方法利用计算机随机地进行重采样,以确定采样误差和一些参数估计的置信区间。该方法用来推断系统发育树的可靠性,可以与任何一种系统发育树构建方法联合使用,但在树的构建方法上必须是一致的。
自展检验的基本原理是:从原始数据集中的重新抽样替换来产生伪数据集,这样的数据集称为自展样本(bootstrap sample);然后用这样的伪数据集来构建系统发育树,称为自展树(bootstrap tree);重复上述过程,产生成百上千的重新抽样的伪数据集,并同时生成对应的自展树;最后检验自展树对最终系统发育树各个分支的支持率。具体做法是:将最终系统发育树与各个自展树进行比较,其中在各个自展树中都有出现或大量出现的那些部分将具有较高的置信度。产生相同分组的自展树的数目常常被标注在系统发育树的相应节点旁,表示该树中每个部分的相对置信度。
如果不同位点具有一致的系统发育信号,自展样本将不会发生什么冲突,导致所有的或大部分分支都具有较高的自展支持率(bootstrap support proportion);如果数据缺乏信息或者不同位点包含相冲突的信号,自展样本间将有较多差异,导致大多数分支的自展支持率比较低。自展值越高表示对相关分支的支持越强。
折刀法与自展检验的不同之处在于抽样的方式。该方法是由 Muller 和 Ayala 提出的,Lanyon 对该方法进行了改进,基本思想为:每次去掉一个可变分类单元(OUT),然后再对剩余的所有 OUT 进行分析。由此可见,折刀法产生的新数据小于原始数据。
- 内支检验 了解一棵树的可靠性是检验其每个内部分枝的可靠性。内支检验(interior branch test)是通过检验内支长度是否显著大于零而评价构建的系统发育树的一种检验方法。内支检验的基本思想是:若一棵树的拓扑结构是正确的,则表明正确拓扑结构的所有分支长度估计的期望值为0或者正值,而不正确的拓扑结构中至少有一个内部分支长度为负值,且该分支产生了序列间的一个不正确分区。因此,如果一棵树的内部分支被确定是负值,那么该树的拓扑结构很可能就是错误的。
假设我们要评价图 11-15 中系统发育树的拓扑结构的可靠性,如果两个内部分支 b 和 c 都比 0 大,则这棵树的拓扑结构被认为是可靠的。因此,首先设定无效假设 $b \leqslant 0$ 和 $c \leqslant 0$ ,则对应的备择假设为 b 和 c 的长度均大于 0。在假定无效假设为正确的情况下,即假设内部分支 $b \leqslant 0$ 的情况下可以用计算 b 的估计值的标准差 $s_{b}$ 来检验。当替代数很大时,b 大致遵循正态分布,此时便可以通过正态标准离差 $u = b / s_{b}$ 来检验无效假设,此时应该采用一尾测验的方式。
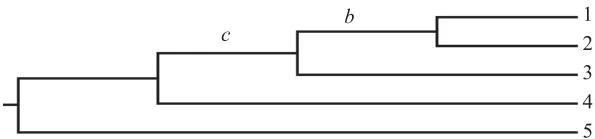
系统发育树的内支检验方法能方便地应用于由距离法构建的系统发育树,因为只有正确树的所有内部分支才可能是正值。但在最大简约法和最大似然法构建的系统发育树中,不管拓扑结构如何,所有内部分支都是正值,因此就很难建立一种检验无效假设的分析方法。
二、常见系统发育树的软件简介
(一) PHYLIP
包,是由美国华盛顿大学(University of Washington)的 Joseph Felsenstein 教授开发的。该软件 1980 年首次发布,其可以在 DOS、UNIX、Windows 和 Macintosh 等多个平台下安装并应用。PHYLIP 由 35 个独立的程序组成,这些程序都能实现特定的功能,基本上包括了系统发育分析的所有方面。PHYLIP 主要包括几个程序组:分子序列组、距离矩阵组、基因频率组、离散字符组、进化树绘制组。
分子序列组:蛋白质序列组,如 protpars、proml、promlk、protdist;核苷酸序列组,如 dnapenny、dnapars、dnamove、dnaml、dnamlk、dnainvar、dnadist、dnacomp。
距离矩阵组:fitch、kitsch、neighbor。
基因频率组:gendist、contrast、contml。
离散字符组:pars、mix、penny、move、dollop、dolpenny、dolmove、clique、factor。
进化树绘制组:drawgram、drawtree、consense、treedist、retree。
Phylip 软件包的文档是非常详细的,对于每个独立的程序,都有一个独立的文档,详细地介绍了该程序的使用及其说明。此外,Phylip 软件包还包括程序的 C 语言源代码。
利用 Phylip 构建系统发育树,首先须根据分析数据,选择适当的程序,若分析的是 DNA 数据,就在核酸序列分析类中选择程序,如 dnapenny、dnapars、dnamove、dnaml、dnamlk、dnainvar、dnadist、dnacomp 等;若分析的是离散数据,如突变位点数据,就在离散字符组里面选择程序,然后再选择适当的分析方法,如对于系统发育树的构建方法可以选择简约法(DNAPARS)、似然法(DNAML、DNAMLK)、距离法(DNADIST)等。选择好程序后,执行,读入分析数据,默认的读取数据的源文件为 infile,选择适当的参数,进行分析,结果自动保存为 outfile、outtree。outfile 是一个记录文件,记录了分析的过程和结果,可以直接用文本编辑器(如写字板)打开。outtree 是分析结果的树文件,可以用 Phylip 提供的绘树程序打开查看,也可以用其他的程序来打开,如 treeview。
Phylip 的下载地址为:http://evolution.genetics.washington.edu/phylip.html。
(二) PAUP

PAUP(phylogenetic analysis using parsimony)是最著名的进行系统发育分析的商业软件。该软件最初的版本叫 PAUP,主要是应用简约法进行系统发育分析。2001 年,Swofford 教授推出整合了最大似然法和距离法的 PAUP 4.0,并于 2002 年推出光盘版的 PAUP 4.0 Beta。目前 PAUP 4.0 有好几个版本,这些版本分别适用于 Macintosh、Windows 和 Portable 等操作平台,具有一个简单的、菜单式操作的界面。
利用 PAUP 进行系统发育树的构建,默认的数据输入格式为 Nexus。此外,PAUP 也可以输入 PHLIP、GCG-MSF、NBRF-PIR 和 HENNIG86 等其他格式的数据文件。使用 PAUP 构建系统进化树的程序都有多种选项:MP 选项包括任意特征权重方案的说明;距离法中可以选择 NJ、ME、FM 和 UPGMA 等模式。有关这些方法和模型的详细说明可以从 “帮助” 中获得。将参数设为 “estimate”,执行 “describe tree” 命令,可以评估任何系统发育树的参数。
PAUP 的下载地址为:http://paup.sc.fsu.edu/。
(三) MEGA

MEGA(molecular evolutionary genetics analysis)是目前应用较多的构建系统发育树和分子进化遗传分析的免费软件包之一,由美国亚利桑那州立大学的 Kumar 教授开发并于 1994 年首次发布。该软件最初为 DOS 版本,随后有适合 Windows、Mac 和 Linux 的版本可下载。过去 20 多年来,该软件经历了 9 次主要升级,目前 MEGA 的最新版本为 2021 年发布的 MEGA11。MEGA4 是其中最为经典的版本,在分子进化和系统发育研究中得到了广泛的应用。MEGA5 增加了 TBR(tree bisection reconnection)和 SPR(subtree pruning regrafting)来进行种系发生的重建,新增了最大似然法建树功能。MEGA6 新增了 Timetree 功能,可基于 Reltime 方法估计进化树分歧点的发生时间。MEGA X 的主要功能模块包括:通过网络进行数据的搜索、多序列比对、序列编辑、DNA 或蛋白质的替代模型预测、遗传距离的估计、系统发育树的构建、选择压分析、进化假说检验等。该软件能够对核酸(DNA 和 mRNA 等)序列和氨基酸序列及遗传距离进行系统发育树的构建。在建树的方法上,其提供了最常用的距离法(UPGMA、ME 和 NJ)、MP 法和 ML 法,对所获得的树均可进行自展检验及标准误估计可靠性检验。MEGA 突出的特点是菜单化操作方式,操作简单方便,极易掌握,可以满足一般进化分析的需要。
MEGA 的下载地址为:http://www.megasoftware.net/。
(四) TREE-PUZZLE

TREE-PUZZLE 是对分子序列采用最大似然法构建系统发育树的软件包,包含有可以在 Windows、Linux 和 Macintosh 等多个平台下运行的版本。该软件包应用 quartet puzzling(一种最大似然估计方法)构建系统发育树,还可以计算特定树的序列间最大似然距离和分支长度。该软件包支持所有常见的核苷酸序列和蛋白质序列进化模型。此外,该程序还包括数个统计测试。该程序具有详细使用手册及程序源代码。
TREE-PUZZLE 的下载地址为:http://www.tree-puzzle.de/。
(五) MrBayes

MrBayes 是一种采用贝叶斯推断法进行系统发育树构建的软件。该软件以 NEXUS 格式输入数据,数据可以是核苷酸序列或氨基酸序列,也可以是限制性位点序列或以 0、1 表示的形态数据。MrBayes 软件可以通过不同方法汇总模型参数的后验分布,包括系统发育树的布局和分支长度,该软件还可以推导位点进化速率。
MrBayes 软件的下载地址为:http://mrbayes.sourceforge.net/。
(六) PhyML

2003 年,Guindon 等根据最大似然法原理,采用更加简便的爬山算法来同时估计树的拓扑结构和树的分支长度。与传统的最大似然法相比,该方法更加简便、快速和有效。基于此算法,Guindon 等推出了利用该算法计算最大似然系统发育树的 PhyML(PHYlogenetic inference using maximum likelihood)程序,并于 2005 年推出了 PhyML 的网络在线运行版。该软件能够利用 DNA 序列或氨基酸序列构建最大似然树,在构建最大似然树的软件中是速度比较快的。
PhyML 在线版的地址为:http://atgc.lirmm.fr/phyml/。
三、系统发育分析示例
以下将用两个例子来说明系统发育分析的具体过程。数据为来自 13 个脊椎动物物种线粒体基因组中细胞色素 b 基因编码的氨基酸序列,其一是采用本地计算机上的 MEGA 软件构建系统发育树,其二是利用网络上在线运行的软件构建系统发育树。
脊椎动物中的线粒体 DNA(mtDNA)包含有 13 个编码蛋白质的基因。mtDNA 的全序列在很多生物中都已经获得。mtDNA 序列及其基因编码的氨基酸序列是目前研究生物系统发育、种群遗传变异和分化,以及难以用外部形态特征来区别的近缘种、种下分类单元鉴定等方面应用最为广泛的分子序列之一。mtDNA 的细胞色素 b(cytochrome b,Cytb)基因是一种编码蛋白质的基因,是目前结构和功能研究得最清楚的基因之一。Cytb 基因在碱基组成上具有偏好性,且具有种间差异。Cytb 基因中同时存在较快和较慢进化的密码子位点,以及保守区域和突变区域,从而使得 Cytb 基因可以应用于系统分类研究。1989 年,第一对关于脊椎动物 Cytb 基因部分片段的扩增引物出现后,Cytb 基因被广泛地应用于系统分类学研究,目前认为它是对物种种上和种下分类阶元进行系统进化研究得较好的序列。本例选取来自哺乳动物、爬行动物、鸟类和鱼类共计 13 个物种的 Cytb 基因编码的氨基酸序列构建系统发育树。
(一)利用 MEGA X 构建系统发育树
MEGA 由于其菜单化操作方式,操作简单方便、极易掌握,是目前应用最多的构建系统发育树的软件之一。本例拟利用 MEGA X 软件对脊椎动物中线粒体细胞色素 b 基因构建系统发育树。
- 序列获取 来自 13 个物种的脊椎动物的线粒体细胞色素 b 基因编码的氨基酸序列均用 Entrez 检索方式获取,检索登录号见表 11-2。
表 11-2 13 种脊椎动物细胞色素 b 基因编码的氨基酸序列检索登录号
| 种类 | 中文名称 | 拉丁名 | 蛋白质登录号 |
| 哺乳动物 | 长须鲸 | Balaenoptera physalus | P24950 |
| 蓝鲸 | Balaenoptera musculus | P41285 | |
| 西藏黄牛 | Bos taurus | YP_209217 | |
| 人 | Homo sapiens | YP_002124314 | |
| 鸟类 | 原鸡 | Gallus gallus | NP_006926 |
| 鸵鸟 | Struthio camelus | NP_115452 | |
| 绿头鸭 | Anas platyrhynchos | YP_001382257 | |
| 爬行动物 | 拟鳄龟 | Chelydra serpentina | YP_002213663 |
| 两栖动物 | 非洲爪蟾 | Xenopus laevis | NP_008146 |
| 青蛙 | Rana nigromaculata | NP_116779 | |
| 鱼类 | 虹鳟 | Oncorhynchus mykiss | NP_008302 |
| 泥鳅 | Crossotoma lacustre | NP_008315 | |
| 鲤鱼 | Cyprinus carpio | NP_007094 |
在 NCBI 中分别获取相应的蛋白质序列,并将序列按照 FASTA 格式保存到新建的纯文本文件中,然后将纯文本文件名修改为 “cytb.fasta”。
- 使用 MEGA X 进行多序列比对 MEGA 软件的 “Alignment Explorer” 模块集成了用于进行多序列比对的程序 “ClustalW”,利用该程序可以实现多序列比对。
打开 MEGA 软件,选中 cytb.fasta 文件,将该文件拖到 MEGA 软件中,会弹出 “Alignment Explorer” 模块对话框,如图 11-16 所示。
在 “Alignment Explorer” 模块对话框中选择 “Alignment” → “Align by ClustalW” 命令,会弹出如图 11-17 所示的进行多序列比对参数设置的 “ClustalW Options” 对话框。参数一般采用默认设置即可,单击 “OK” 按钮,即可进行多序列比对。
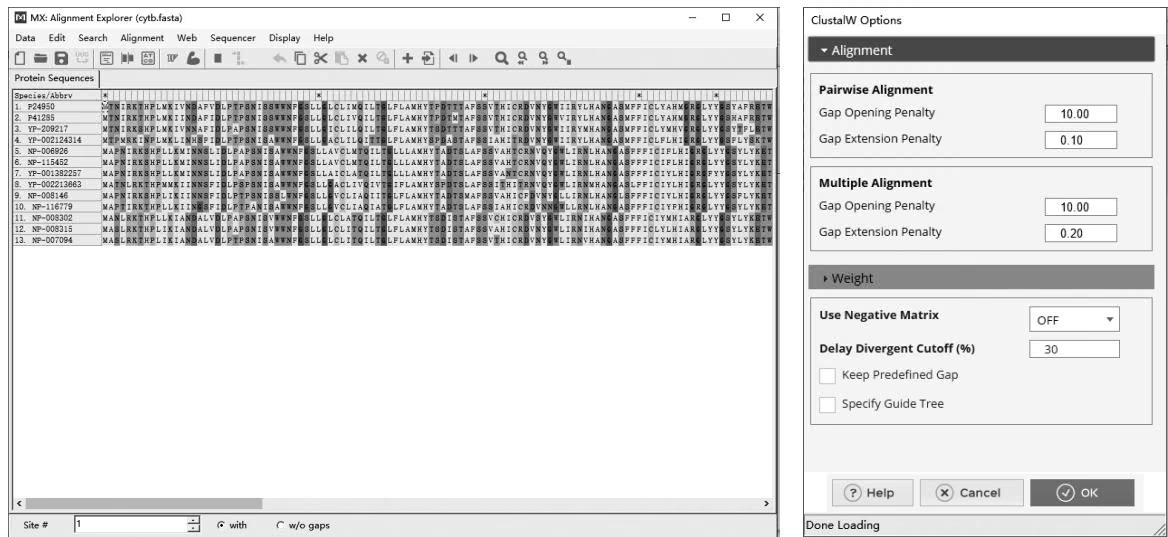
图 11-17 “ClustalW Options”
对话框
多序列比对结束后,在 “Alignment Explorer” 模块对话框中选择 “Data” → “Export Alignment” → “MEGA Format” 命令,将多序列比对的结果输出,输出的文件名为 “cytb.meg”。
- 使用 MEGA X 进行系统发育树的构建 关闭 “Alignment Explorer” 模块对话框。选中 cytb.meg 文件,将该文件拖到 MEGA 软件中,MEGA 软件一方面会自动打开 “Sequence Data Explorer” 模块对话框,另一方面会显示全部菜单,如图 11-18 所示。
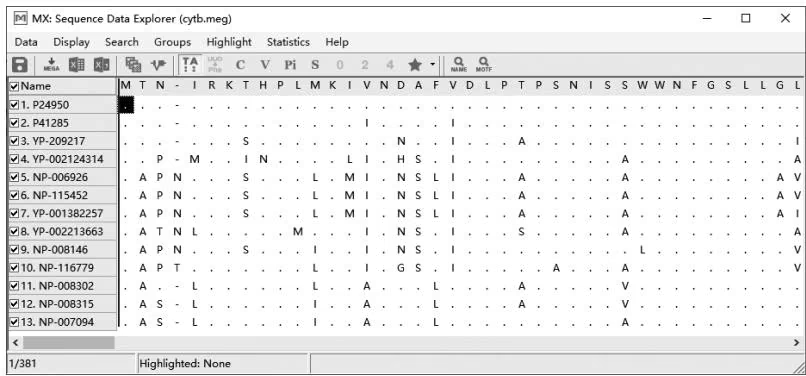
序列输入 MEGA 软件,就可以进行进化树分析。MEGA 软件提供了 5 种构建系统发育树的方法,并同时可以对系统发育树进行检验。这 5 种方法分别是:邻接法、最小进化法、非加权组内平均法、最大简约法和最大似然法。此处仅以构建邻接(NJ)树为例,介绍操作过程。在 MEGA 的主窗口中选择 “Phylogeny” → “Construct/Test Neighbor-Joining Tree”,选择多序列比对后的输出文件 “cytb. meg”,将弹出如图 11-19 所示的 “Analysis Preferences” 对话框,用于进行系统发育树构建中参数的设置。在此处,“Test of Phylogeny” 选择 “Bootstrap method”;“No. of Bootstrap Replications” 设置为 500 次;计算距离的替代模型 “Model/Method” 选择泊松校验(Poisson correction),随机数种子由系统默认;“Gaps/Missing Data
Treatment”采用“Pairwise deletion”模型。设置完成,单击“OK”按钮,开始计算。
计算所耗用的时间与序列的数目及序列中信息位点的含量成正比,计算完成后,会弹出“Tree Explorer”窗口(图11-20)。该窗口有两个结果,一个是原始树(original tree),另一个是bootstrap验证过的一致树(bootstrap consensus tree),树枝上的数字表示bootstrap检验中该树枝的支持率(百分比)。
在得到了系统发育树后,可以根据需要对其进行编辑和美化。双击序列名可以更改序列的名称,最终得到的系统发育树如图 11-21 所示。值得注意的是,这种单纯的基于某一个或一种 DNA 序列或蛋白质序列构建的系统发育树只能提供物种进化的部分信息,而不能完全代表物种进化的全过程。
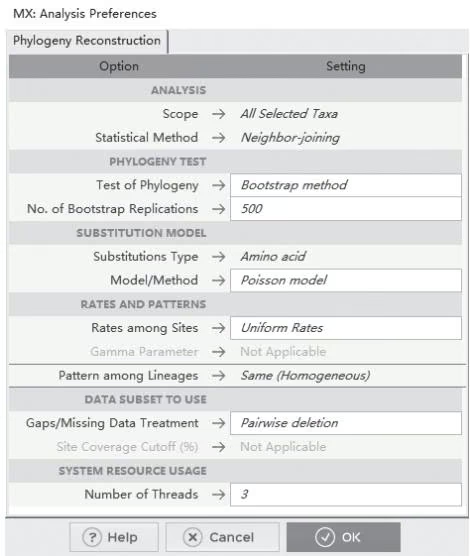
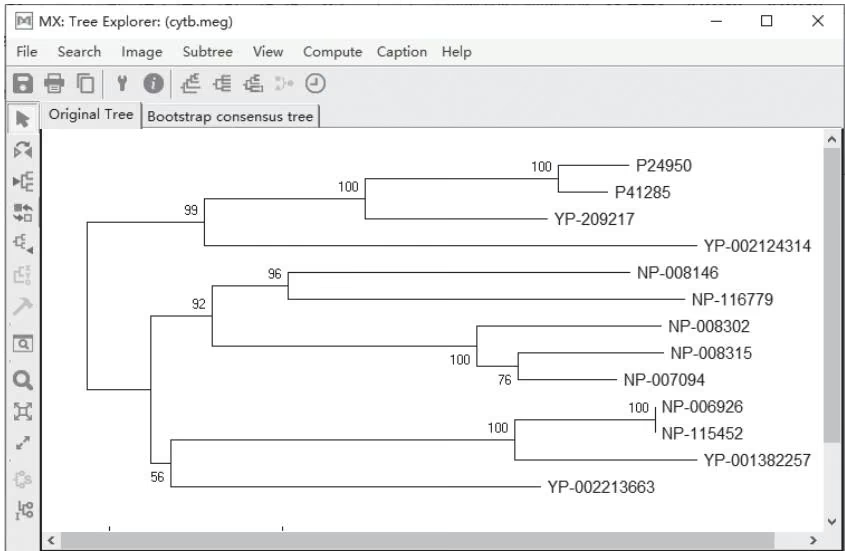
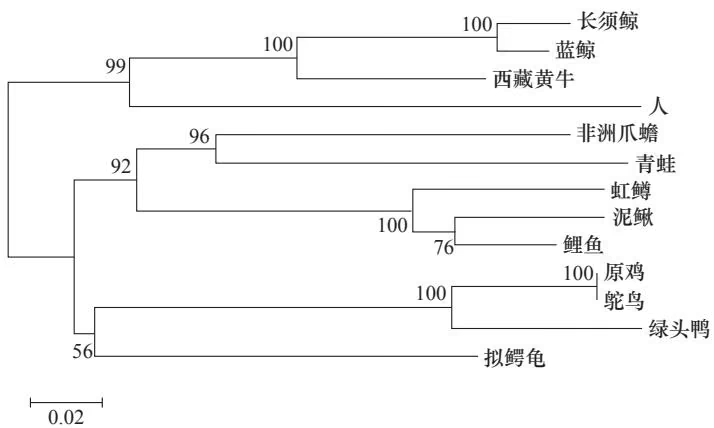
(二)利用在线分析软件构建系统发育树
随着互联网的普及,很多研究机构提供了很多对生物学数据进行在线分析的工具,如在前面所述的 PhyML,即可以通过在线分析构建系统发育树。在这方面,法国巴斯德研究所(Institute of Pasteur)做出了卓越的贡献,在其构建的在线生物信息分析平台 Mobyle 中系统集成了进行数据库搜索(databases search)、序列格式转换和序列编辑(sequence format conversion and sequence edition)、序列比对和比较(sequences alignment and comparison)、系统发育分析(phylogeny)、蛋白质序列分析(protein sequence analysis)、核酸序列分析(nucleic sequence analysis)和结构分析(structure analysis)等在线分析软件,如图 11-22 所示。在系统发育分析模块中,该平台提供了简约法程序(parsimony method programs)、距离矩阵法程序(distance matrix method programs)、最大似然法程序(maximum likelihood method programs)、距离计算(computation of distance)和系统发育树的操作与可视化(manipulation and visualization of phylogenetic tree)等在线分析工具。
Mobyle 的地址为:http://mobyle.rpbs.univ-paris-diderot.fr/。
在此,我们利用 Mobyle 的在线生物软件分析平台来对上例中脊椎动物线粒体细胞色素 b 基因构建系统发育树。
- 利用 ClustalW 进行多序列比对 在图 11-22 所示的 Mobyle 在线生物软件分析平台网站页面中选择多序列比对和比较模块中的 “多序列比对(multiple alignment)”,在弹出的新页面中选择 “clustalw-multialign” 工具,这时将弹出如图 11-23 所示的利用 ClustalW 进行多序列比对的操作界面。选择 “序列文件(sequence file)” 项目组中的 “粘贴(paste)” 单选项。将细胞色素 b 基因编码的蛋白质序列按照 fasta 格式粘贴到其下面的序列框中。在数据类型的下拉列表中选择 “蛋白质(protein)”,其余多序列比对参数(multiple alignments parameters)按照默认方式。单击 “RUN” 按钮,将会对该数据进行多序列比对。
- 利用 PhyML 在线分析软件进行系统发育树的构建 执行上述操作之后,ClustalW 在线软件将进行多序列比对。比对完成后,将生成如图 11-24 所示的多序列比对结果页面。
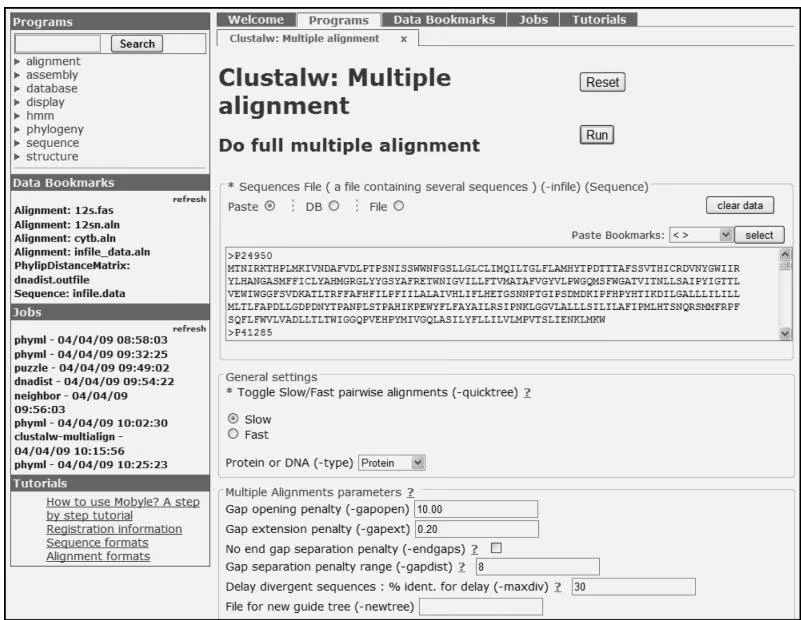
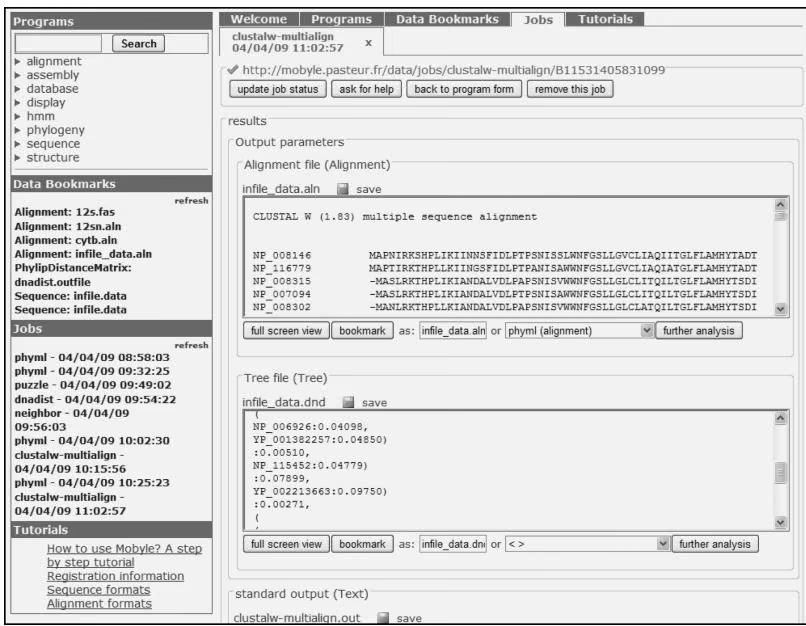
其中,“Alignment file”框中的内容即为多序列比对的结果,该结果的文件名为“infile_data.aln”,单击文件名旁的“save”按钮即可将该多序列比对结果文件下载到本地计算机上。
拟对该数据采用最大似然法构建系统发育树,可以选择 PhyML 程序进行。单击在多序列比对结果窗口的下方 “further analysis” 按钮,可以对该多序列比对结果进行进一步分析,但需要先选中进行下一步分析的方法。在 “further analysis” 按钮前的下拉列表框中选择 PhyML,单击 “further analysis” 按钮,将弹出如图 11-25 所示的 PhyML 程序操作页面。
在 PhyML 操作页面的 “sequence alignment” 项目组中选择 “Results” 单选项,表示利用前面多序列比对的结果构建系统发育树。在 “数据类型(Data type)” 单选项组中选择 “氨“氨基酸(Amino Acides)”模式。在“输入选项(Input Options)”中输入 bootstrap “抽样次数(Number of bootstrap sets to analyse)”为 100。选择“氨基酸替换模型(Amino-acid substitution model)”为 JTT,其余参数为默认。单击“RUN”按钮,将在线利用 PhyML 构建最大似然树。
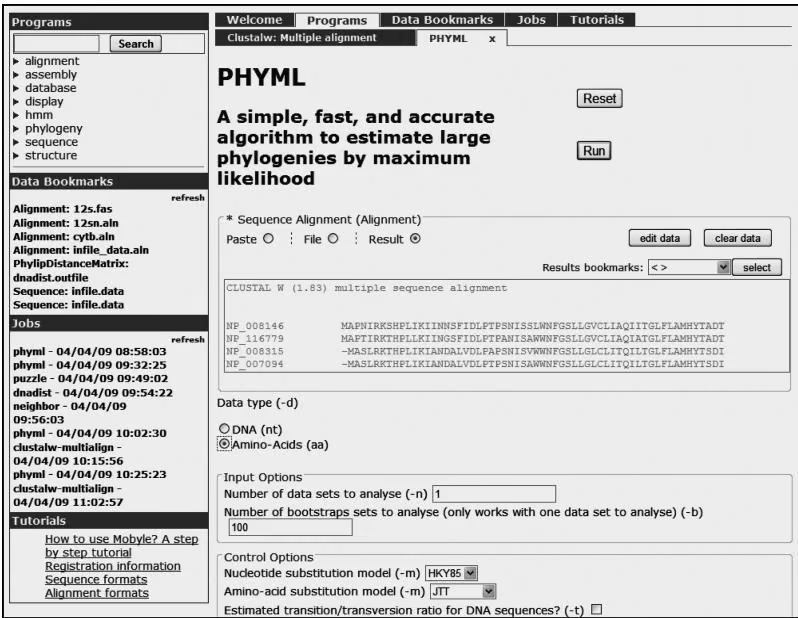
计算所耗用的时间与序列的数目及序列中信息位点的含量成正比。运算完成后,将弹出如图 11-26 所示的 PhyML 系统发育树结果输出页面。构建的系统发育树的拓扑结构将显示在 “Output tree” 框中,并同时生成一个名为 “infile_data_phylipi_phyml_tree.txt” 的文件,该文件可以通过单击 “save” 按钮下载到本地计算机上。
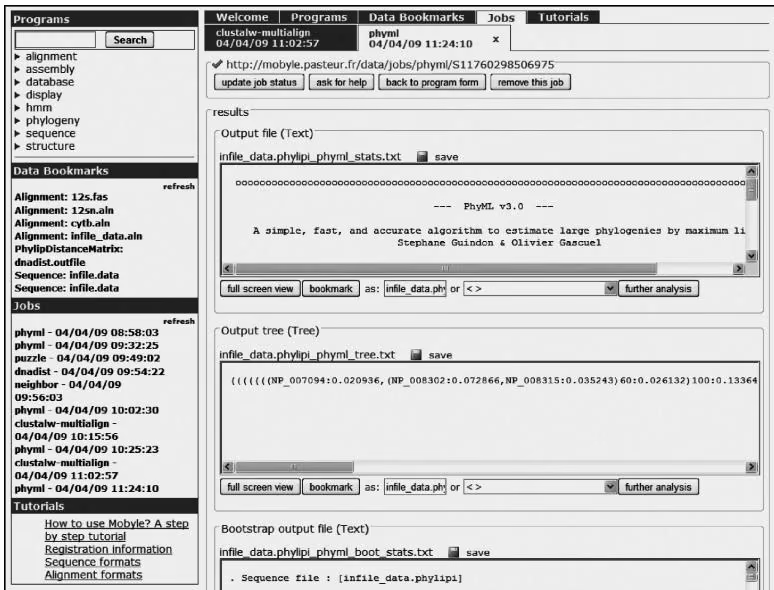
- 系统发育树的展示 系统发育树文件 “infile_data_phylipi_phyml_tree.txt” 可以通过树展示软件(如 TreeView、MEGA 等)进行展示。
将系统发育树的文件名改为后缀名为“.nwk”格式,将该文件拖到MEGA软件中,则在MEGA软件的“Tree Explorer”模块中显示系统发育树,如图11-27所示。按照以前介绍的方式,可以将序列名改为物种名称。最终利用PhyML在线分析软件构建的最大似然树如图11-28所示。
在确定系统发育树的拓扑结构以后,可以使用 iTOL(Interaction Tree of Life,http://itol.embl.de/)对系统发育树进行美化。iTOL 是一个展示、注释和管理进化树的在线工具,并可以将绘制的系统发育树以高质量的位图或矢量图的方式导出。
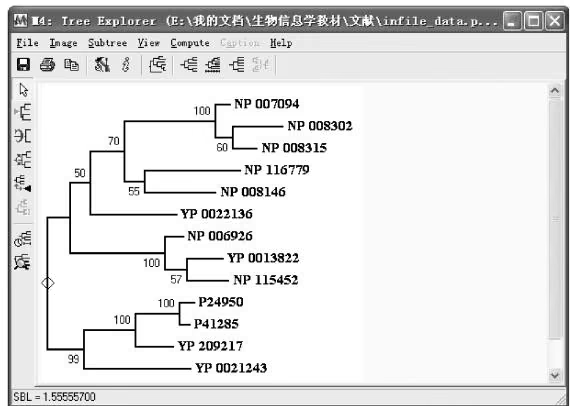

思考题
什么是中性学说?中性学说对分子进化有什么影响?
什么是分子钟假说?
利用生物大分子数据重建系统进化树的方法有哪些?各有何特点?
什么是 bootstrap sample 及 bootstrap tree?
尝试用表 11-2 的数据,并选择一建树工具进行系统进化树的构建。

主要参考文献
李桂源,钱骏.2004.基于 WWW 的生物信息学应用指南.长沙:中南大学出版社
李建伏,郭茂祖.2006.系统发生树构建技术综述.电子学报,34(11):2047-2052
李涛,赖旭龙,钟扬.2004.利用 DNA 序列构建系统树的方法.遗传,26(2):205-210
王禄山,高培基.2008.生物信息学应用技术.北京:化学工业出版社
许忠能.2008.生物信息学.北京:清华大学出版社
薛庆中.2009.DNA和蛋白质序列数据分析工具.北京:科学出版社
杨子恒.2008.计算分子进化.钟扬,张文娟,梅旖,等译.上海:复旦大学出版社
张原,陈之端.2003.分子进化生物学中序列分析方法的新进展.植物学通报,20(4):462-468
赵国屏.2002.生物信息学.北京:科学出版社
钟扬,张亮,赵琼.2001.简明生物信息学.北京:高等教育出版社
Bonet M, Steel M, Warnow T, et al. 1998. Better methods for solving parsimony and compatibility. J Comput Biol, 5:391-407
Brown W M, Prager E M, Wang A, et al. 1982. Mitochondrial DNA sequences of primates: tempo and mode of evolution. J Mol Evol, 18: 225-239
Cavalli-Sforza L L, Edwards A W. 1967. Phylogenetic analysis. Models and estimation procedures. Am J Hum Genet, 19: 233-257
Cummings M P, Otto S P, Wakeley J. 1995. Sampling properties of DNA sequence data in phylogenetic analysis. Mol Biol Evol, 12: 814-822
Edwards A W F, Cavalli-Sforza L L. 1964. Reconstruction of evolutionary trees. In: Heywood V H, McNeill J. Phenetic and Phylogenetic Classification. No. 6. London: Systematics Association Pub, 67-76
Felsenstein J. 1981. Evolutionary trees from DNA sequences: a maximum likelihood approach. J Mol Evol, 17:368-376
Felsenstein J. 1988. Phylogenies from molecular sequences: Inference and reliability. Annual Review of Genetics, 22: 521-565
Felsenstein J. 1993. Phylogeny Inference Package(PHYLIP). Version 3.5. Seattle: University of Washington
Fitch W M, Margoliash E. 1967. Construction of phylogenetic trees. Science, 155: 279-284
Guindon S, Lethiec F, Duroux P, et al. 2005. PHYML Online—a web server for fast maximum likelihood-based phylogenetic inference. Nucleic Acids Res, 33: W557-W559
Holder M, Lewis P O. 2003. Phylogeny estimation: traditional and Bayesian approaches. Nat Rev Genet, 4: 275-284
Huelsenbeck J P, Larget B, Miller R E, et al. 2002. Potential applications and pitfalls of Bayesian inference of phylogeny. Syst Biol, 51: 673-688
Huelsenbeck J P, Ronquist F. 2001. MRBAYES: Bayesian inference of phylogenetic trees. Bioinformatics, 17: 754-755
Huelsenbeck J P, Ronquist F, Nielsen R, et al. 2001. Bayesian inference of phylogeny and its impact on evolutionary biology. Science, 294: 2310-2314
Khan H A, Arif I A, Bahkali A H, et al. 2008. Bayesian, maximum parsimony and UPGMA models for inferring the phylogenies of antelopes using mitochondrial markers. Evol Bioinform Online, 4: 263-270
Kimura M. 1968. Evolutionary rate at the molecular level. Nature, 217: 624-626
Kimura M. 1980. A simple method for estimating evolutionary rates of base substitutions through comparative studies of nucleotide sequences. J Mol Evol, 16: 111-120
King J L, Jukes T H. 1969. Non-Darwinian evolution. Science, 164: 788-798
Krane D E, Raymer M L. 2004. 生物信息学概论. 孙啸, 陆祖宏, 谢建明, 等译. 北京: 清华大学出版社
Kumar S. 1996. A stepwise algorithm for finding minimum evolution trees. Mol Biol Evol, 13: 584-593
Kumar S, Gadagkar S R. 2000. Efficiency of the neighbor-joining method in reconstructing deep and shallow evolutionary relationships in large phylogenies. J Mol Evol, 51: 544-553
Lakner C, van der Mark P, Huelsenbeck J P, et al. 2008. Efficiency of Markov chain Monte Carlo tree proposals in Bayesian phylogenetics. Syst Biol, 57: 86-103
Li W H. 1986. Evolutionary change of restriction cleavage sites and phylogenetic inference. Genetics, 113: 187-213
Lim A, Zhang L. 1999. WebPHYLIP: a web interface to PHYLIP. Bioinformatics, 15: 1068-1069
Mount D W. 2003. 生物信息学: 序列与基因组分析. 钟扬, 王莉, 张亮, 主译. 北京: 高等教育出版社
Nakhleh L, Jin G, Zhao F, et al. 2005. Reconstructing phylogenetic networks using maximum parsimony. Proc IEEE Comput Syst Bioinform Conf, 93-102
Naylor G J, Brown W M. 1998. Amphioxus mitochondrial DNA, chordate phylogeny, and the limits of inference based on comparisons of sequences. Syst Biol, 47: 61-76
Nei M, Kumar S. 2002. 分子进化与系统发育. 吕宝忠, 钟扬, 高莉萍, 等译. 北京: 高等教育出版社
Pauplin Y. 2000. Direct calculation of a tree length using a distance matrix. J Mol Evol, 51: 41-47
Pearson W R, Robins G, Zhang T. 1999. Generalized neighbor-joining: more reliable phylogenetic tree reconstruction. Mol Biol Evol, 16: 806-816
Penny D. 1982. Towards a basis for classification: the incompleteness of distance measures, incompatibility analysis and phenetic classification. J Theor Biol, 96: 129-142
Pevsner J. 2006. 生物信息学与功能基因组学. 孙之荣主译. 北京: 化学工业出版社
Ranwez V, Gascuel O. 2002. Improvement of distance-based phylogenetic methods by a local maximum likelihood approach using triplets. Mol Biol Evol, 19: 1952-1963
Retief J D. 2000. Phylogenetic analysis using PHYLIP. Methods Mol Biol, 132: 243-258
Ronquist F, Huelsenbeck J P. 2003. MrBayes 3: Bayesian phylogenetic inference under mixed models. Bioinformatics, 19: 1572-1574
Saitou N, Nei M. 1987. The neighbor-joining method: a new method for reconstructing phylogenetic trees. Mol Biol Evol, 4: 406-425
Schmidt H A, Strimmer K, Vingron M, et al. 2002. TREE-PUZZLE: maximum likelihood phylogenetic analysis using quartets and parallel computing. Bioinformatics, 18: 502-504
Schmidt H A, von Haeseler A. 2007. Maximum-likelihood analysis using TREE-PUZZLE. Baxevanis D B, Davison R D M, Page G A, et al. Current Protocols in Bioinformatics. New York: Wiley and Son
Sneath P H A, Sokal R R. 1973. Numerical Taxonomy. In: The Principles and Practice of Numerical Classification. San Francisco CA: W. H. Freeman and Co
Sokal R R, Michener C D. 1958. A statistical method for evaluating systematic relationships. University of Kansas Science Bulletin, 38: 1409-1438
Sourdis J, Nei M. 1988. Relative efficiencies of the maximum parsimony and distance-matrix methods in obtaining the correct phylogenetic tree. Mol Biol Evol, 5: 298-311
Steel M, Penny D. 2000. Parsimony, likelihood, and the role of models in molecular phylogenetics. Mol Biol Evol, 17: 839-850
Takezaki N, Nei M. 1994. Inconsistency of the maximum parsimony method when the rate of nucleotide substitution is constant. J Mol Evol, 39: 210-218
Tamura K, Dudley J, Nei M, et al. 2007. MEGA4: molecular evolutionary genetics analysis(MEGA) software version 4.0. Mol Biol Evol, 24: 1596-1599
Toha J, Soto M A, Chinga H. 1989. Algorithm for construction of phylogenetic trees. Z Naturforsch, 44: 312-316
Tuffley C, Steel M. 1997. Links between maximum likelihood and maximum parsimony under a simple model of site substitution. Bull Math Biol, 59: 581-607
Wilgenbusch J C, Swofford D. 2003. Inferring evolutionary trees with PAUP*. In: Wilgenbusch J C, Swofford D. Current Protocols in Bioinformatics. New York: Wiley and Son
Woese C R. 1998. The universal ancestor. Proc Natl Acad Sci USA, 95: 6854-6859
Woese C R. 2000. Interpreting the universal phylogenetic tree. Proc Natl Acad Sci USA, 97: 8392-8396
Zuckerkandl E, Panling L. 1965. Evolutionary divergence and convergence in proteins. In: Bryson V, Vogel H I. Evolving Genes and Proteins. New York: Academic Press